
从不可见中学习:带有隐藏动作的离线强化学习
Learning from the Unseen: Offline Reinforcement Learning with Hidden Actions
📝 TLDR
标准离线强化学习假设动作可被无误差观测,但现实中常仅记录到含噪的动作代理,导致策略评估严重有偏。本文研究无限视野折扣MDP中隐藏动作下的离策略评估,利用下一状态作为未观测动作的代理,证明策略值可识别性,提出基于影响函数的多重稳健估计量LURE,并建立其渐近正态性以支持统计推断。这是首个面向离线RL隐藏动作的研究,通过仿真和MIMIC-III脓毒症管理任务验证了方法有效性。
🧭 速览
现实场景中真实动作常未被记录,现有离线RL仅依赖含噪代理动作,造成策略值估计偏差,难以指导决策。
利用下一状态作为隐藏动作的代理,证明策略值可识别性;提出基于影响函数的LURE多重稳健估计量,具备渐近正态性。
仿真显示LURE在多种模型误设组合下保持一致;MIMIC-III脓毒症管理任务验证了其在真实场景的有效性。
首次系统研究离线RL隐藏动作问题,扩展了离线RL方法在动作观测受限场景下的适用性。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
这篇论文首次系统研究了离线强化学习中「隐藏动作」问题——当数据集中记录的动作并非真实动作、而只是带有噪声的代理时,如何可靠地评估目标策略的价值。研究利用 MDP 自身的下一状态作为隐藏动作的代理,推导出可识别的策略值估计量 LURE。该估计量具有多重稳健性(在多种模型正确指定的组合下仍保持一致)以及渐近正态性,支持有效的统计推断。在仿真实验和 MIMIC-III 脓毒症管理任务中,LURE 在动作误分类率高达 30% 时仍能准确估计策略价值,而现有方法则产生了严重偏差。
研究背景与动机
离线强化学习旨在利用已收集好的交互数据评估新策略的价值,避免了在线学习的交互成本。然而,标准算法的理论分析隐含了一个通常不成立的假设:数据中的动作是真实发生的、无误差记录的动作。在现实场景中,这一假设往往难以满足。
以电子健康记录为例,医护人员的给药决策可能被延迟录入系统,或因文档错误而与实际行为不符;在机器人领域,传感器只能观测到带有测量误差的执行信号;在金融交易中,订单的执行状态也可能与下单意图存在偏差。这些情况下,研究者拿到的「动作」实际上是真实动作的噪声代理。当直接将代理动作当作真实动作输入标准离策略评估方法时,偏差不可避免,且这种偏差会随着时间步累积放大,最终导致误导性的策略决策。
已有文献在因果推断领域对测量误差问题有丰富的研究积累,特别是针对隐藏治疗变量的识别与估计方法。然而,这些方法大多局限于静态设定,无法直接迁移到具有顺序决策特征的马尔可夫决策过程中。离线强化学习领域的现有工作——无论是基于重要性采样的方法、基于模型的方法,还是双重稳健方法——都假设动作变量可无偏观测。因此,如何在隐藏动作的设定下进行可靠的离策略评估,是一个既重要又未被充分探索的问题。
方法
论文的核心创新在于发现并利用 MDP 的下一状态 作为隐藏动作的自然代理。这一选择并非偶然:给定当前状态 和真实动作 ,下一状态通过转移核 生成,因此本身就携带了关于 的信息。这与外部引入代理变量的传统测量误差模型形成鲜明对比——在这里,代理变量内嵌于 MDP 的动态结构之中。
基于这一观察,作者建立了一套完整的识别与估计框架。首先需要三个可识别条件:覆盖性要求行为策略的支持包含目标策略的支持;相关性要求回报、代理动作和下一状态都与真实动作在给定当前状态时条件相关;条件独立性则假设在给定 时,回报和代理动作独立于下一状态。这组条件看似严格,但在许多实际场景中可以自然满足——例如在脓毒症管理中,当日用药决策(真实动作)既影响患者短期生理指标(下一状态),也直接影响当日观察到的给药记录(代理动作)和临床结果(回报)。
在可识别性定理的支撑下,作者推导了策略值的影响函数。与标准 OPE 中直接包含动作变量的影响函数不同,这里需要构造可观测的替代函数,使其在投影意义上与完整数据下的最优影响函数一致。通过巧妙的数学构造,引入以下形式的对偶函数:
这一函数满足 ,从而在条件期望的意义下完美替代了原始影响函数中对真实动作的依赖。
基于这一观测影响函数,作者提出了 LURE(Learning from the Unseen: Robust Estimator)估计量,其特点在于多重稳健性。与传统的双重稳健估计量(在模型和重要性权重之一正确时一致)不同,LURE 在四种不同的正确指定组合下都能保持一致。具体而言,对于二元动作情况,只要以下四组条件之一成立,估计量即为一致:代理动作模型和回报模型正确指定;下一状态均值模型和回报模型正确指定;密度比权重和代理动作模型正确指定;或者密度比权重、代理动作模型、下一状态均值模型和测量误差密度函数正确指定。这种多重稳健性显著增强了对模型误设的容错能力。
估计的具体实现采用了 EM 式的迭代策略。E 步利用当前估计的各分量模型计算每个观测属于各类真实动作的后验概率;M 步则以此后验概率为权重,通过加权监督学习更新各 nuisance 组件,包括行为策略、测量模型、回报模型、转移核等。这一交替更新过程自然地处理了后验概率与生成模型之间的耦合估计问题。
此外,作者还将 Uehara 等人的 minimax 密度比估计方法推广为加权形式,在权重 下求解密度比函数,并通过加权 Fitted Q Evaluation 迭代求解目标策略的 Q 函数。由于动作标签在数值上的任意性,算法还需要通过比较条件期望的大小来对齐真实标签。
实验与结果
论文在三个仿真环境和一组真实数据上验证了 LURE 的有效性。仿真环境涵盖了从简单的表格 MDP 到连续状态的线性 MDP,再到 OpenAI Gym CartPole 任务,系统地检验了方法在不同复杂度下的表现。每个环境中设定了四个不同程度的动作误分类率(5% 到 30%),以模拟代理动作与真实动作之间的偏差。
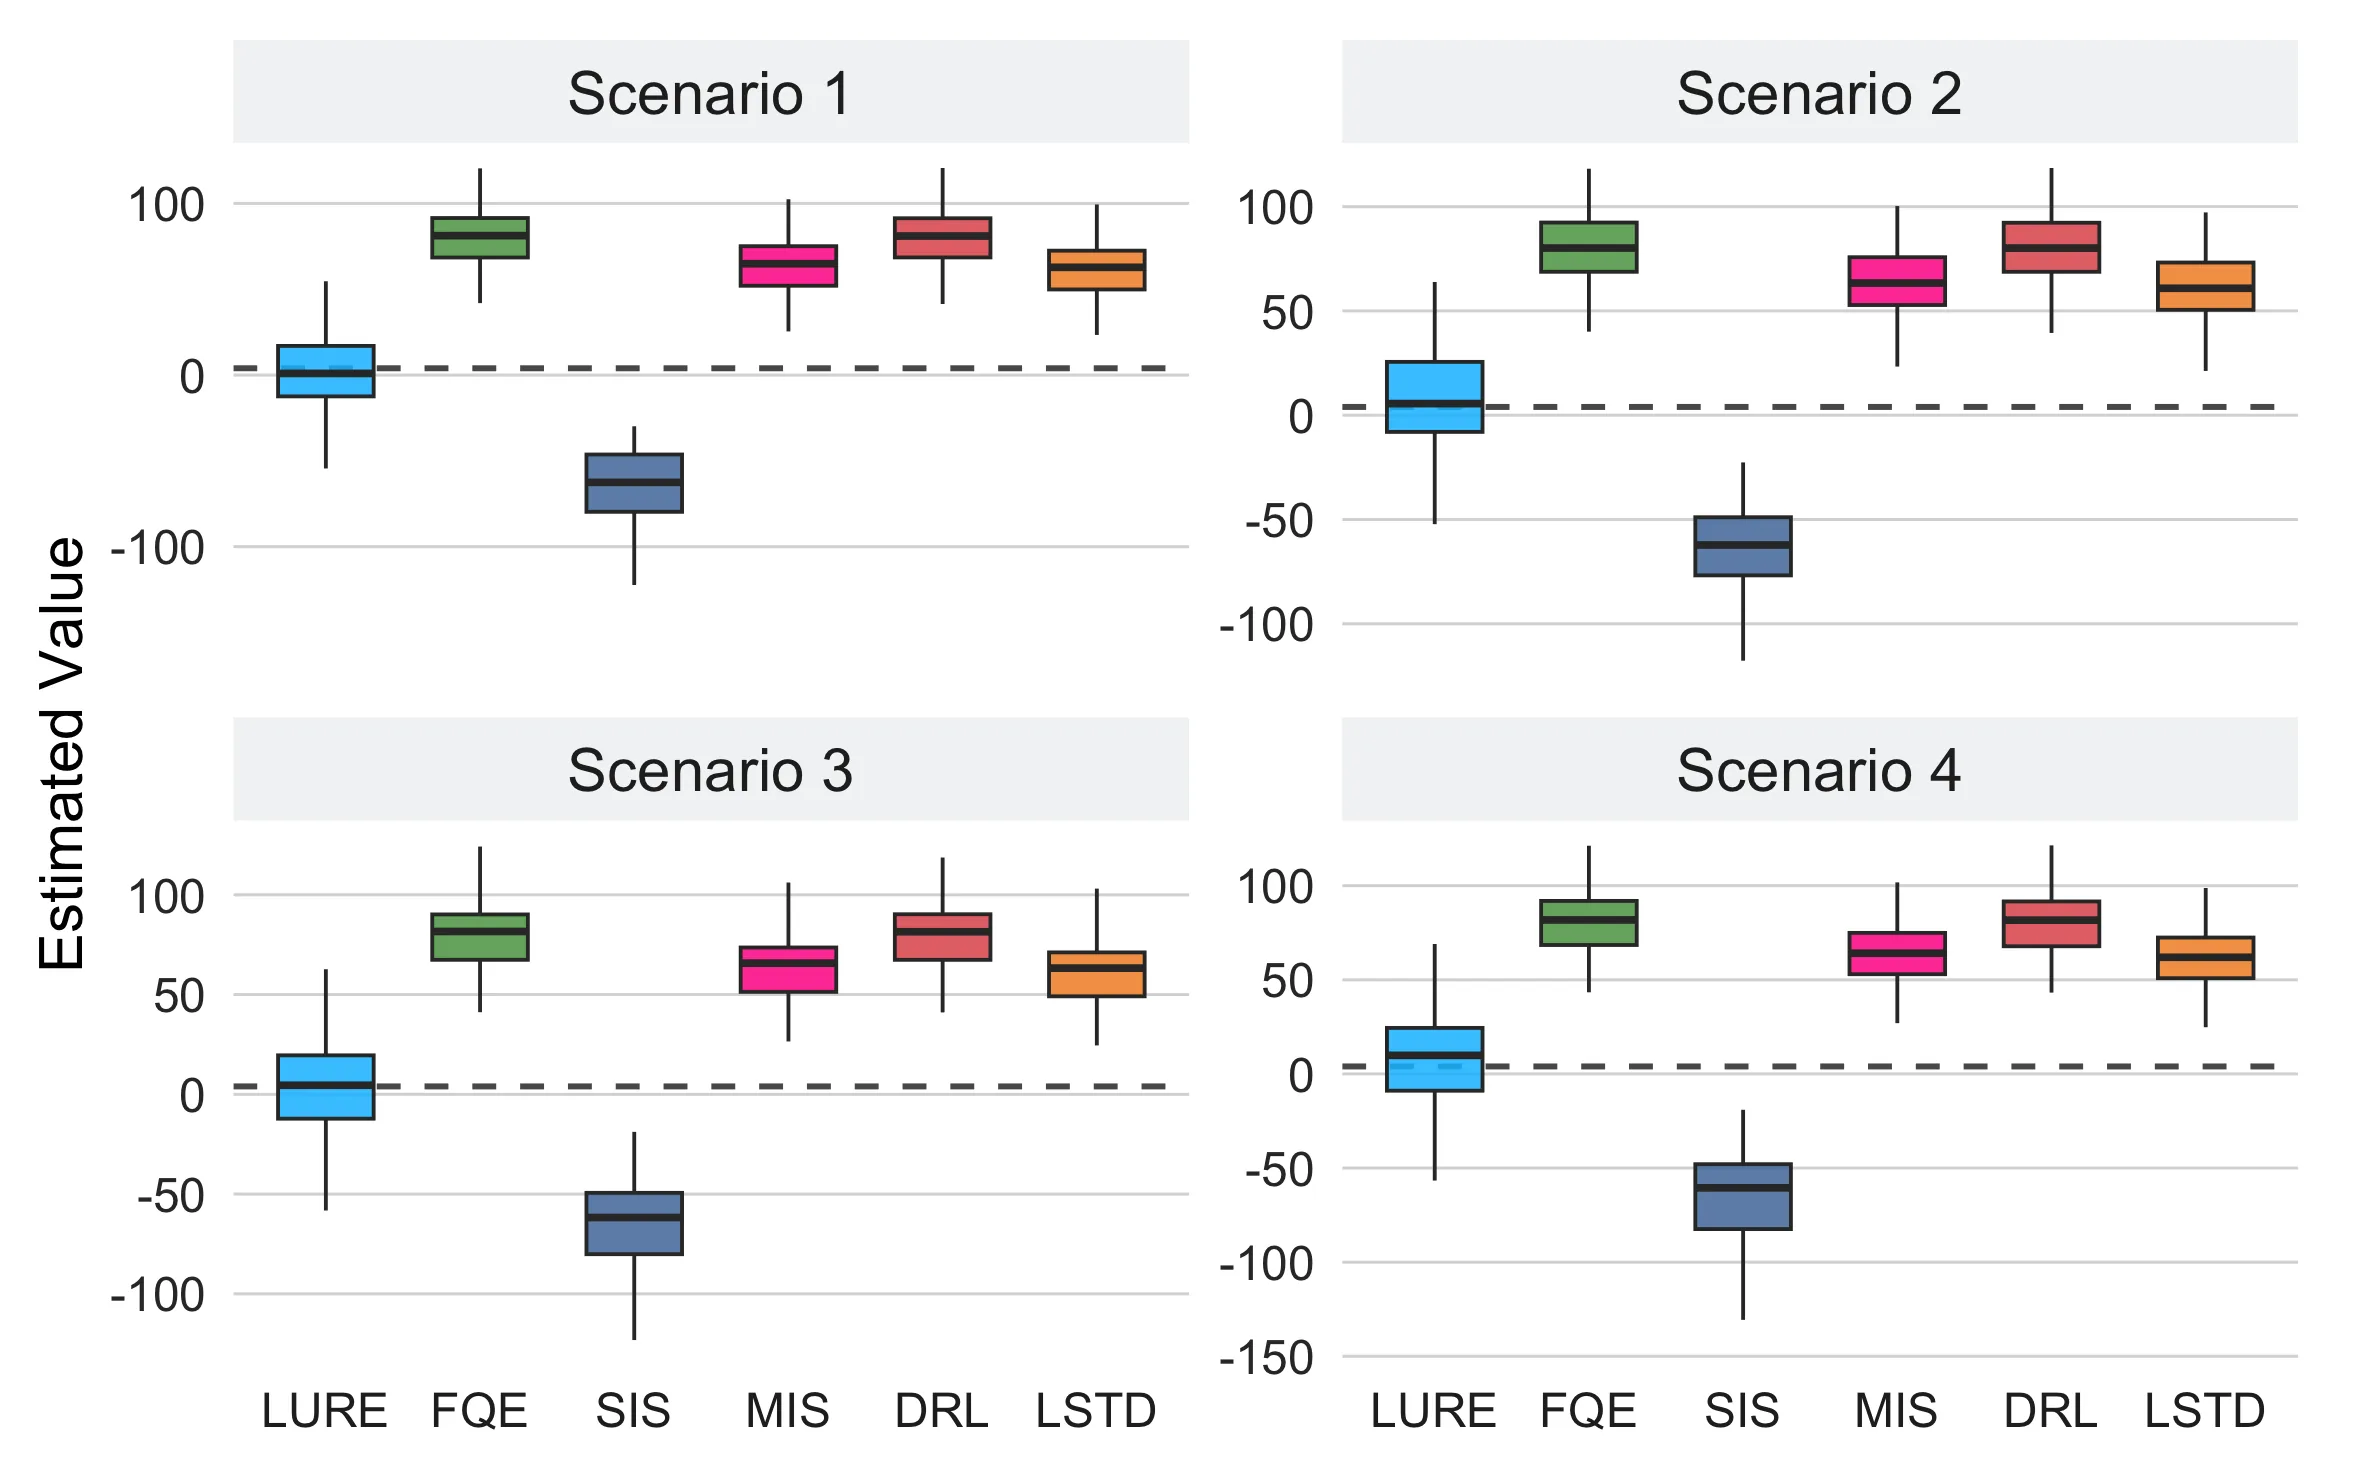
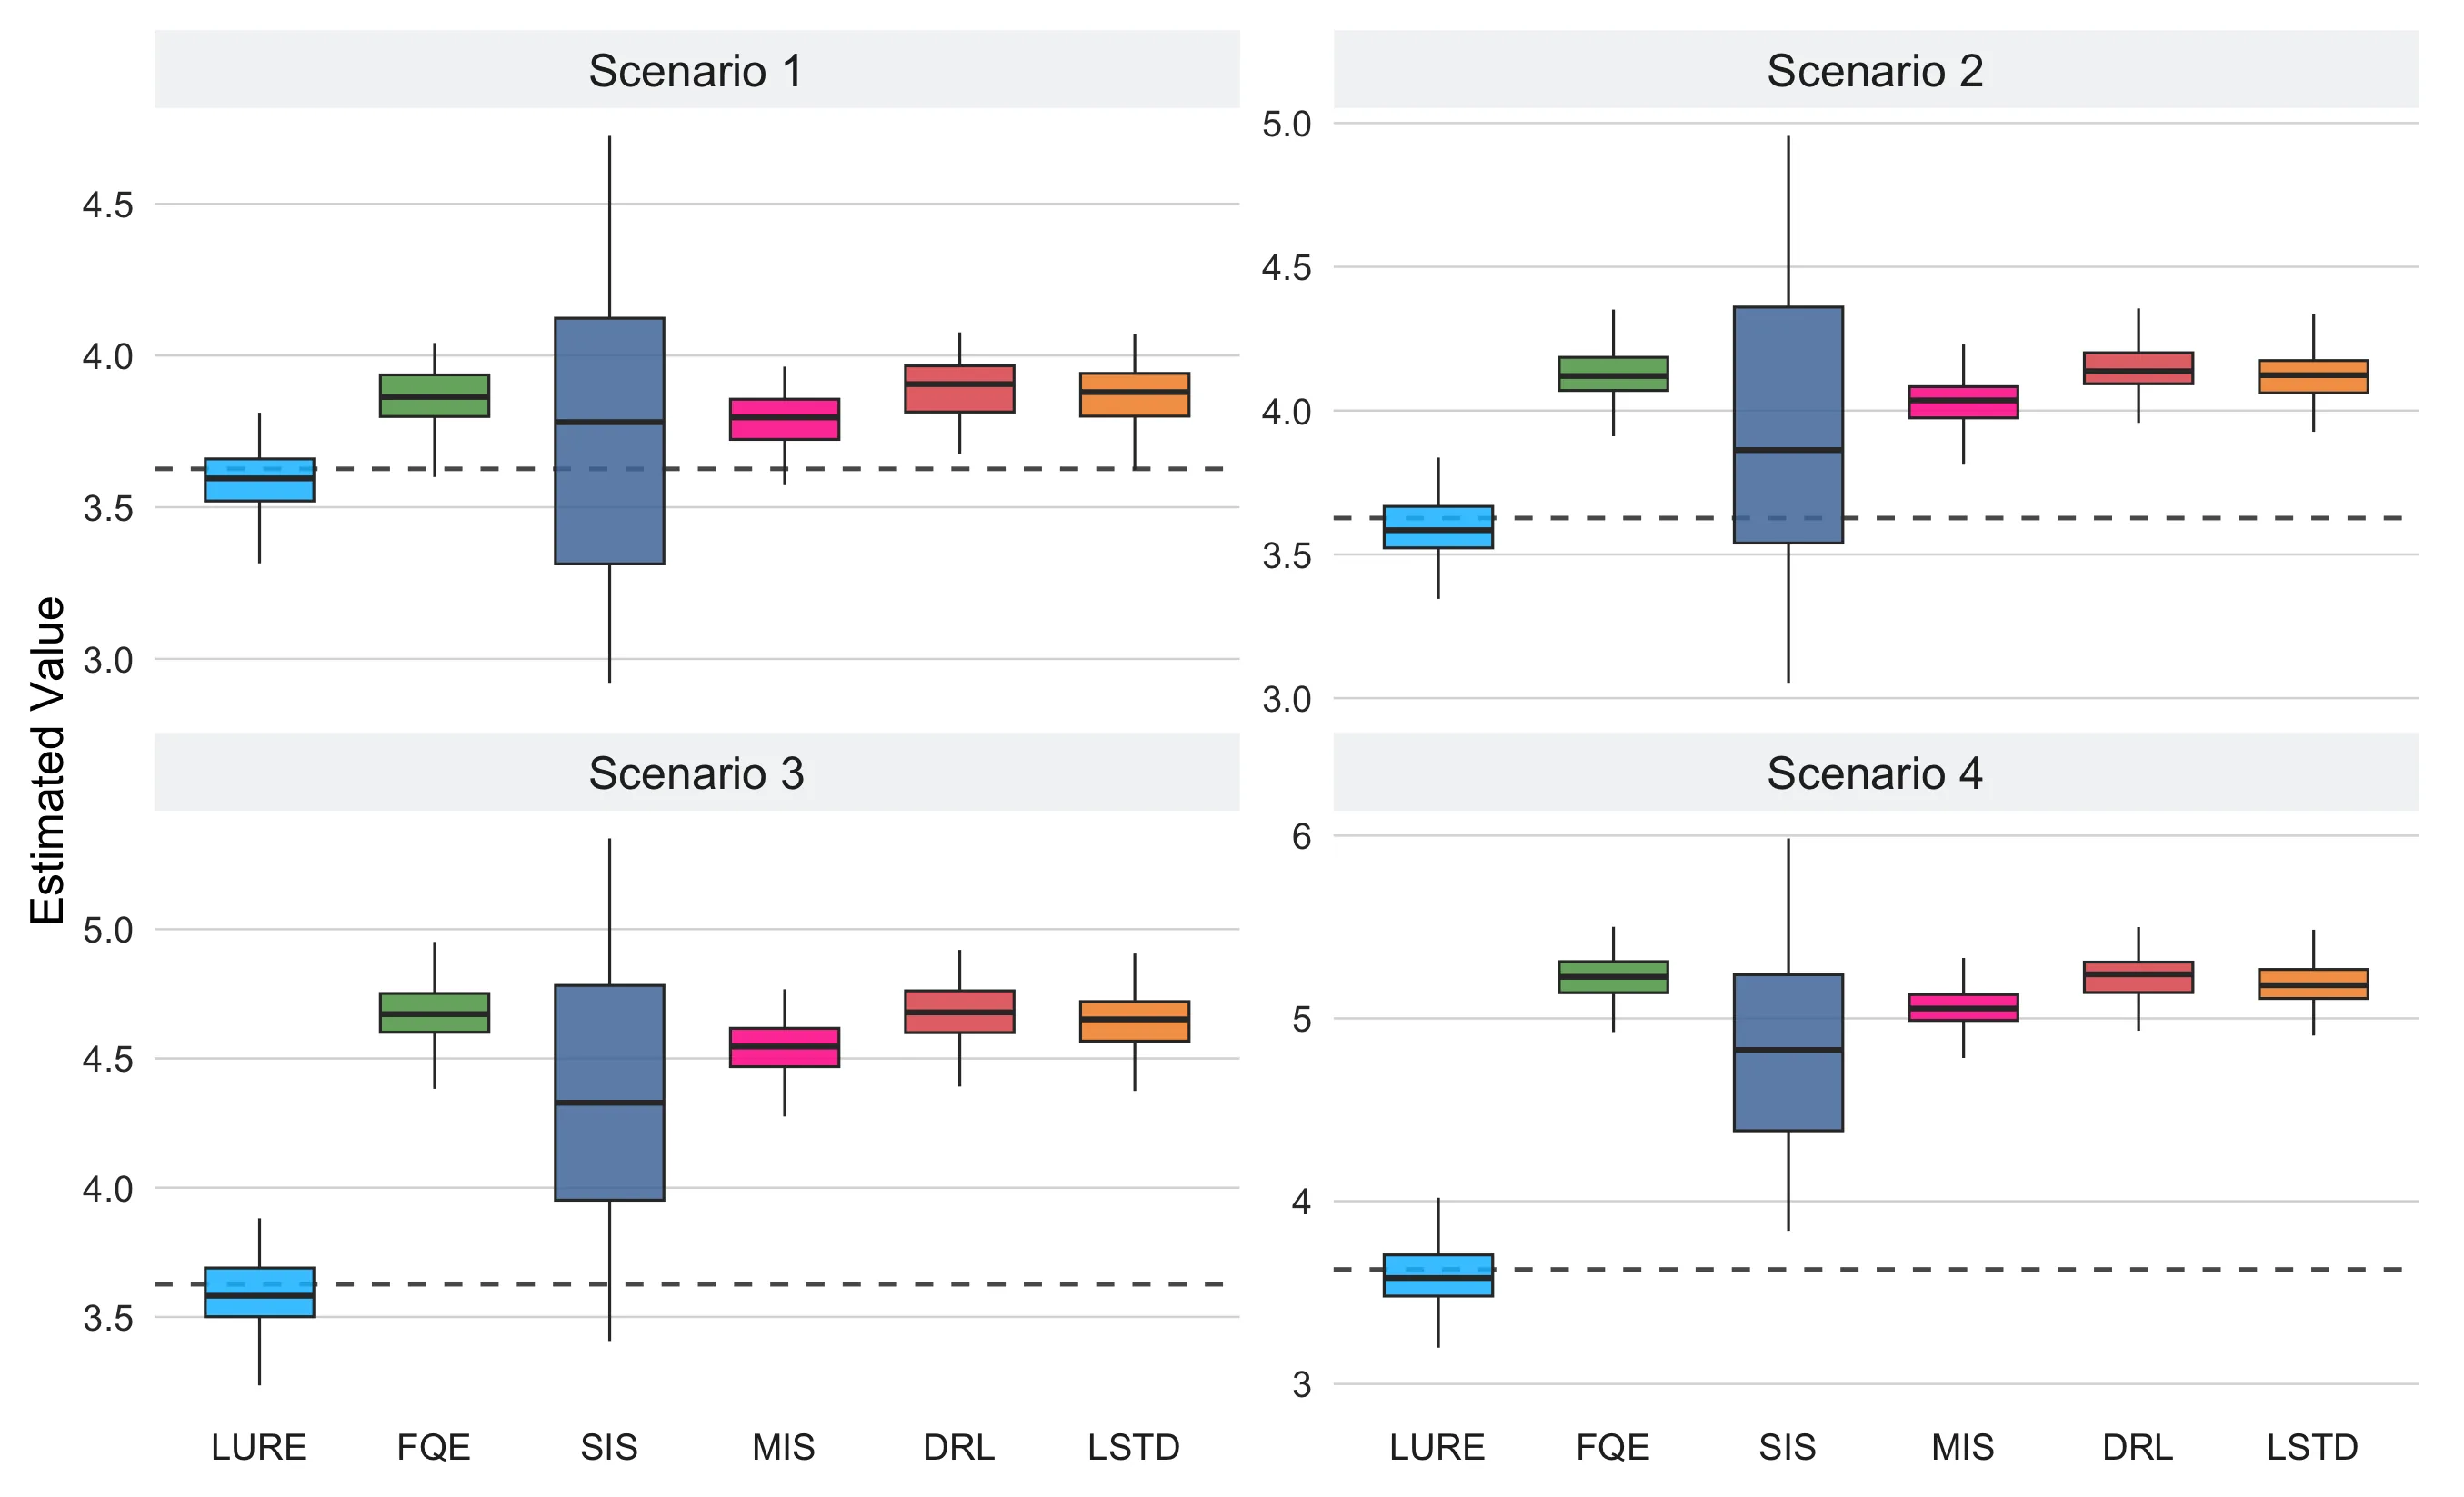
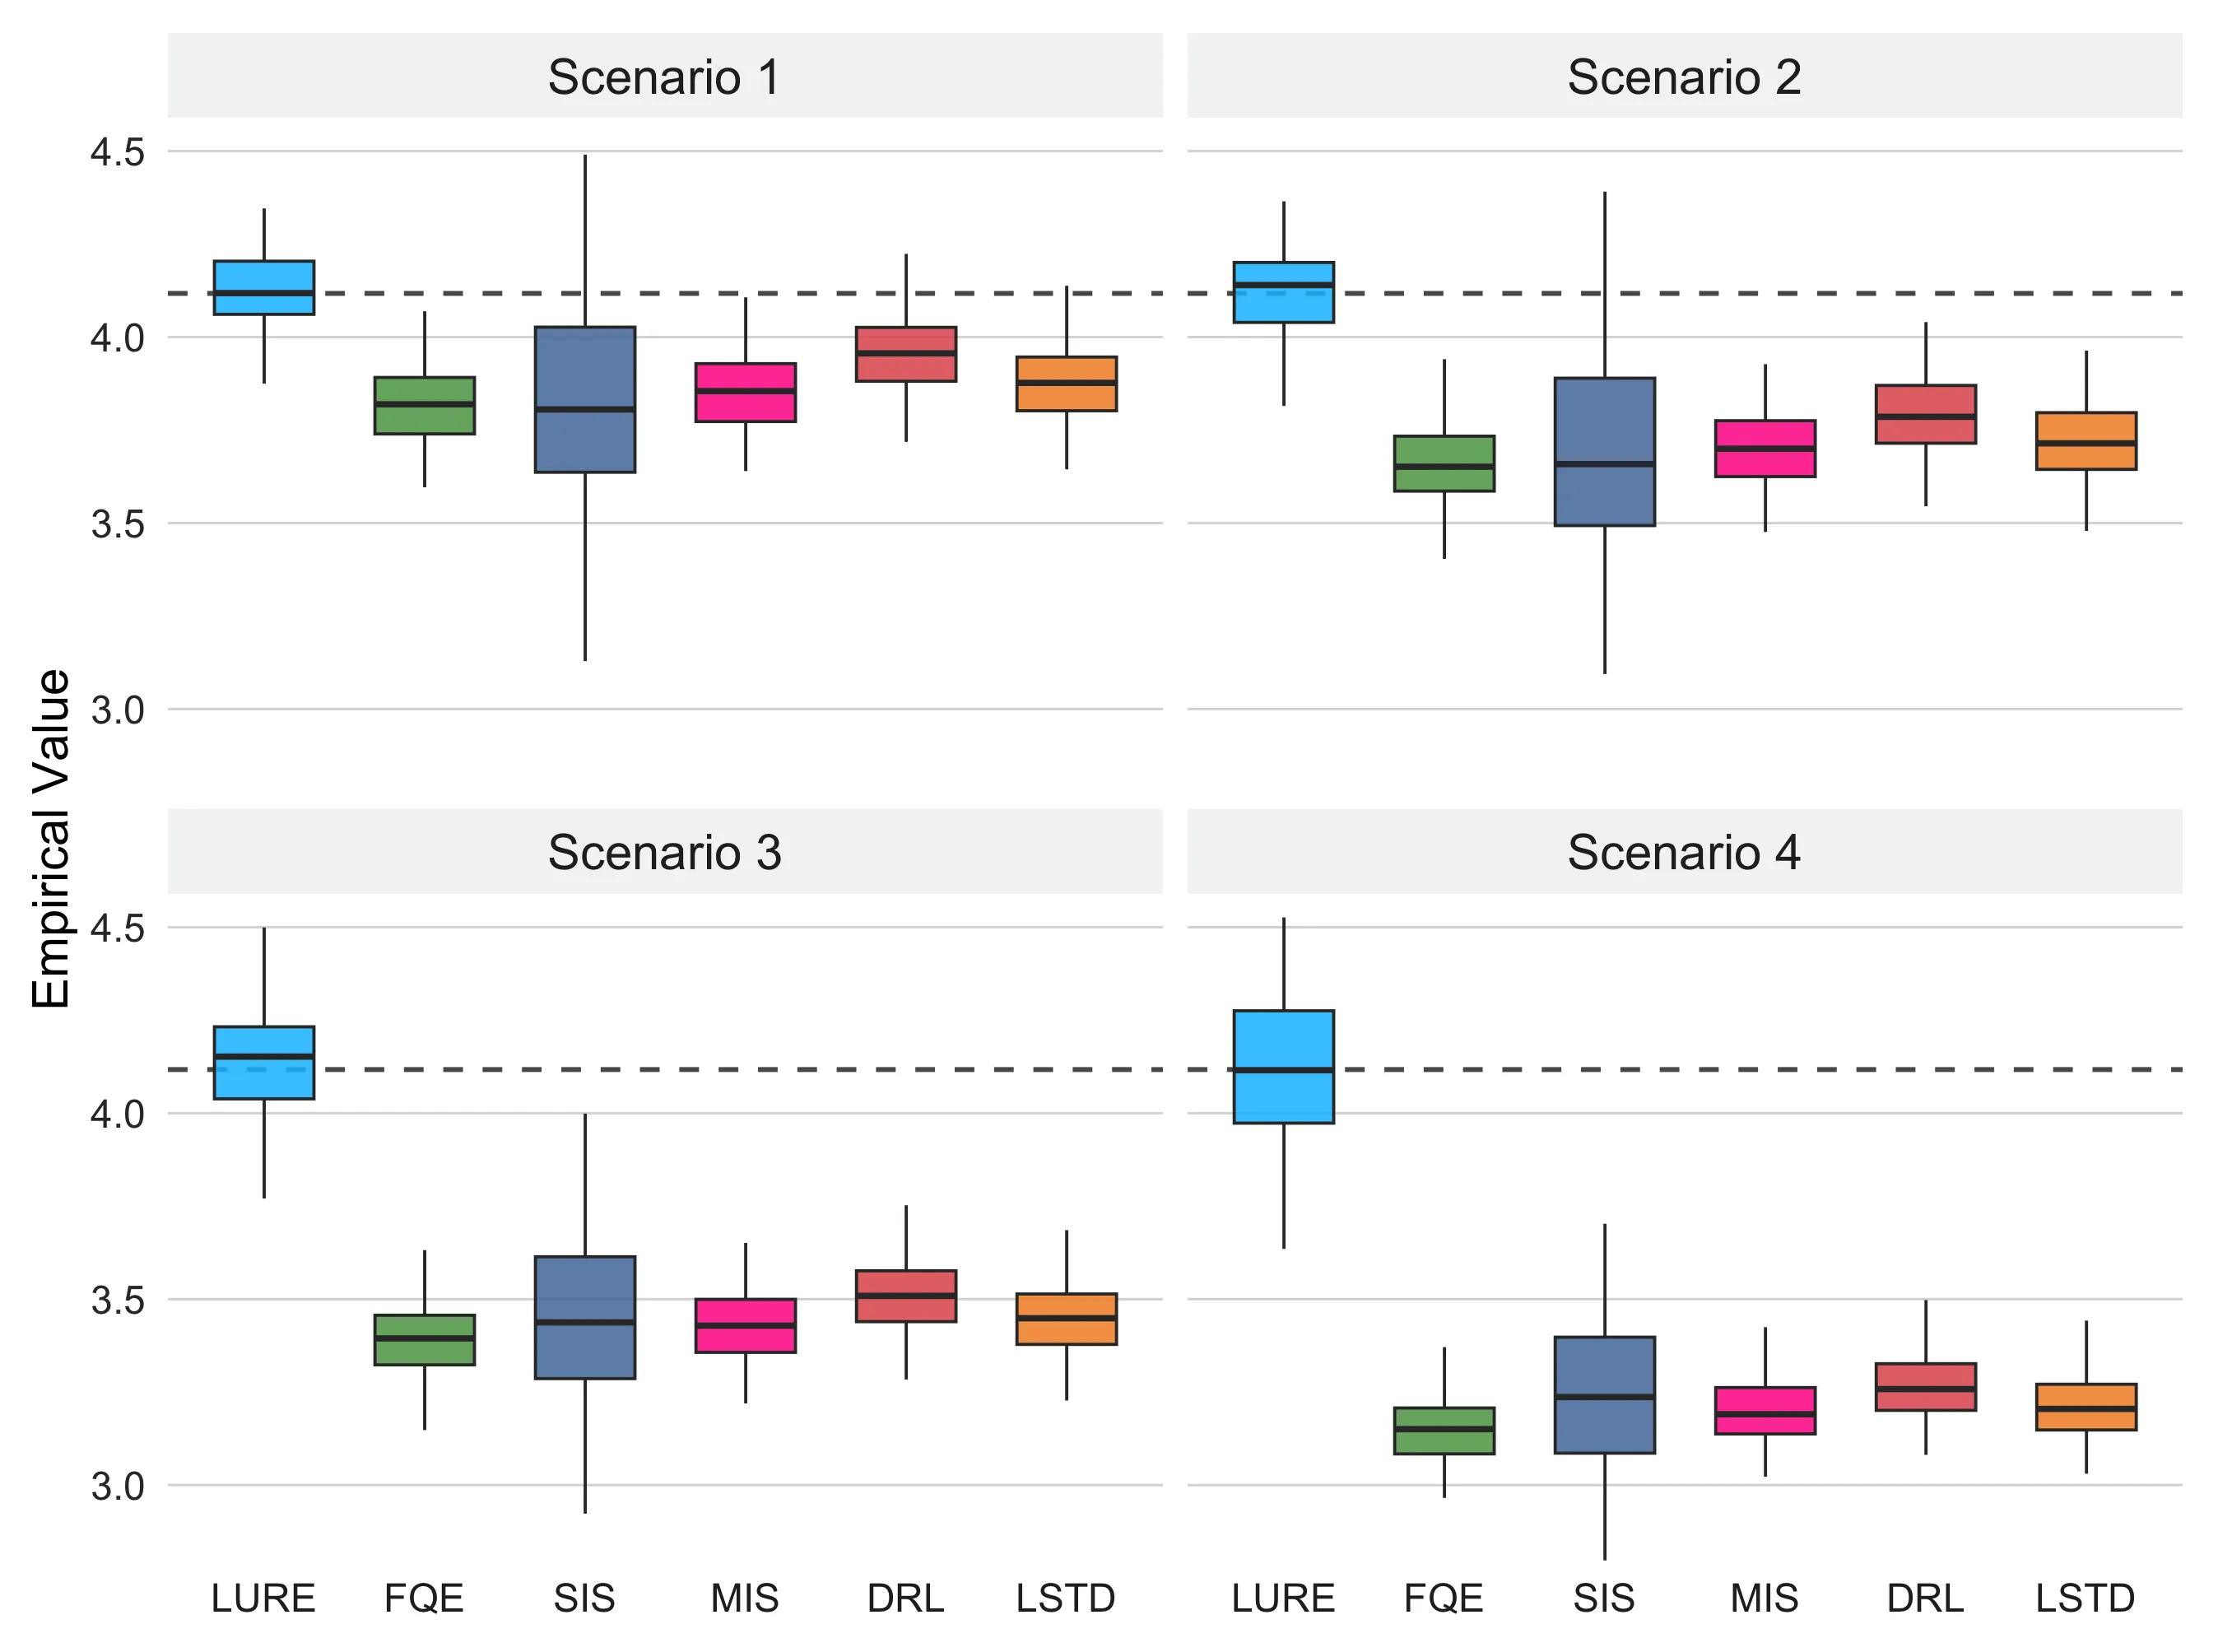
实验结果表明,在动作误分类存在时,所有五种基线方法——包括直接使用代理动作的 FQE、重要性采样方法 SIS、边际重要性采样 MIS、以及双重稳健方法 DRL——都产生了明显的估计偏差,且偏差随误分类率上升而恶化。相比之下,LURE 在所有仿真环境中始终以真实策略值为中心,95% 置信区间的经验覆盖率在 91% 到 98% 之间,接近名义水平,验证了其渐近正态性理论的可靠性。
真实数据实验基于 MIMIC-III 数据库的脓毒症管理任务,目标是评估三种不同的治疗策略:始终使用静脉输液、始终不使用静脉输液、以及基于 SOFA 评分自适应调整的策略。这里的隐藏动作问题体现在静脉输液记录可能与实际给药行为不一致。结果显示,LURE 估计下三种策略的置信区间互不重叠,明确指出始终使用静脉输液策略(估计 SOFA 评分为 62.10)是三者中最优的,而 DRL 方法在忽视动作测量误差后,得到的三个置信区间全部重叠,无法区分策略优劣。这一对比深刻说明了在存在隐藏动作时忽略测量误差可能导致完全错误的临床建议。
讨论与可借鉴点
论文的首要贡献在于开创性地识别并解决了离线强化学习中动作不可观测这一现实挑战。其理论框架的核心洞见——利用 MDP 自身的下一状态作为隐藏动作代理——优雅而自然,避免了为测量误差问题额外引入外部工具变量或假设的复杂性。多重稳健性的引入对实践具有重要价值:在真实的离线学习场景中,行为策略、测量模型、转移核等 nuisance 组件通常都依赖建模假设,几乎不可能全部正确指定,多重稳健条件显著放宽了对模型规格的要求。
论文也存在若干局限。首先,二元动作的设定是理论分析的自然起点,但许多实际决策问题涉及多分类甚至连续动作,扩展这一框架需要额外的技术努力。其次,实验中的动作误分类率在 5% 到 30% 之间属于中等程度,当测量误差更大时方法的稳健性尚待检验。再者,LURE 的计算涉及 EM 迭代和二次规划的交替优化,计算复杂度随状态空间维度增长,可能面临可扩展性挑战。
从更广泛的角度看,这项工作为离线强化学习的鲁棒性研究开辟了新方向。未来的研究可以探索在部分可观测 MDP 设定下更弱的可识别性条件、发展针对隐藏动作的策略优化方法、以及将类似的多重稳健框架推广到在线强化学习的探索-利用权衡中。对于实践者而言,当数据中的动作变量存在测量误差时,直接套用标准 OPE 方法可能是危险的——即使这种误差看似微小,其累积效应也可能导致决策偏差,此时 LURE 提供了一个有理论保障的替代方案。
摘要
标准的离线强化学习(RL)算法通常假设数据集中的动作是无误差观测的。然而,在许多现实应用中,真实动作是未被观测的,只能获得带有噪声的代理,这导致现有的强化学习方法产生有偏且可能具有误导性的结论。我们研究带有隐藏动作的无限视野折扣马尔可夫决策过程中的离策略评估。通过利用下一状态变量作为未观测动作的自然代理,我们建立了策略价值的可识别性,并提出了一种基于影响函数的估计器,称为 LURE(从不可见中学习:鲁棒估计器)。LURE 具有多重鲁棒性,在多种正确指定的冗余分量组合下仍保持一致性,并且渐近正态,从而支持有效的统计推断。据我们所知,这是首个研究带有隐藏动作的离线强化学习的工作。我们通过仿真实验以及基于 MIMIC-III 数据库的脓毒症管理应用,验证了 LURE 的有效性。
Abstract
Standard offline reinforcement learning (RL) algorithms typically assume that the actions in the dataset are observed without error. However, in many real-world applications, the true actions are unobserved and only noisy proxies are available, causing existing RL methods to yield biased and potentially misleading conclusions. We study off-policy evaluation in infinite-horizon discounted Markov decision processes with hidden actions. By leveraging the next-state variable as a natural proxy for the unobserved action, we establish identification of the policy value and propose an influence-function-based estimator called LURE (Learning from the Unseen: Robust Estimator). LURE is multiply robust, remaining consistent under several combinations of correctly specified nuisance components, and is asymptotically normal, enabling valid statistical inference. To our knowledge, this is the first work to address offline RL with hidden actions. We demonstrate LURE's effectiveness through simulations and a sepsis management application using the MIMIC-III database.
论文详细总结(自动生成)
论文总结:从不可见中学习——带有隐藏动作的离线强化学习
1. 核心问题与整体含义
研究动机
标准离线强化学习(offline RL)算法普遍假设数据集中记录的动作是无误差可观测的。然而在电子健康记录(EHR)、隐私保护数据收集、动作标注错误等现实场景中,真实动作经常是完全未观测的(latent),研究者只能获得含有噪声的代理动作 。若将 直接当作真动作进行评估,现有离策略评估(OPE)方法会产生严重偏差,并可能导致错误的临床或商业决策。
本文解决的三个核心难题
- 可识别性:在真实动作不可观测时,策略值 是否仍可从观测数据中唯一确定?
- 估计有效性:经典 OPE 方法(如 FQE、MIS、DRL)涉及潜在动作 ,无法直接应用。
- 不确定性量化:在隐藏动作设定下,尚无有效的置信区间与假设检验方法。
应用背景
论文以 MIMIC-III 脓毒症管理为最终应用场景,其中静脉输液给药的真实记录可能与实际给药行为不一致(由于延迟记录、文档错误、行政编码差异等),使标准 OPE 在该场景下不可靠。
2. 方法论
2.1 核心思想
利用下一状态 作为隐藏动作的自然代理(proxy)。由于下一状态通过转移核 依赖于真实动作 ,本身就携带关于 的信息。给定三个可识别条件(覆盖性、相关性、条件独立性),可以同时识别行为策略、测量模型与转移核。
2.2 关键技术
假设条件(Assumption 3.1):
- (i) 覆盖性:行为策略支持包含目标策略支持;
- (ii) 相关性:、、;
- (iii) 条件独立性:;
- (iv) 代理假设:对所有 ,。
可识别性定理(Theorem 1):在上述假设下,策略值 在观测数据分布下可唯一识别。
2.3 LURE 估计量
基于观测数据的影响函数(Theorem 2):
其中关键的可观测对照函数:
满足 ,从而在投影意义下与完整数据的影响函数一致。
2.4 EM 式冗余估计流程
后验概率初始化:。
- M 步(加权监督学习):以 为权重,更新行为策略 、测量模型 、回报模型 、下一状态均值 、转移密度 、回报密度 。
- E 步(后验更新):
- 加权密度比估计:将 Uehara et al. (2020) 的 minimax 公式推广为加权形式:
- 加权 FQE(Algorithm 1):在权重 下用回归迭代求解 。
- 标签对齐:由于动作标签在数值上任意,通过比较 的大小分配真实标签。
- K 折交叉拟合:缓解过拟合偏差,控制经验过程余项。
2.5 理论性质
- 有限样本误差界(Theorem 3):
其中 为标签选择误差, 为二阶余项。
- 多重稳健性(Corollary 1):对每个 ,只要以下四组条件之一成立即可保证一致性:
1. 、 与 一致;
2. 、 与 一致;
3. 、、 一致;
4. 、、、 一致。
- 渐近正态性(Theorem 4):在 条件下,
- 方差估计量 的一致性见 Proposition 1,支持 Wald 型置信区间。
3. 实验设计
数据集与场景
三组合成仿真 + 一组真实数据,共 四个实验环境:
1. 表格 MDP(Tabular MDP):3 状态、 二元动作、;转移核与回报函数显式给定;可解析计算真值。
2. 连续状态一般 MDP:,线性特征建模。
3. OpenAI Gym CartPole:4 维状态,附加立方 B 样条建模,改写动力学并加入坐标偏移。
4. MIMIC-III 脓毒症数据集:500 名 ICU 患者、 决策阶段、46 维状态、。
仿真设定
- 条轨迹、,每组 100 次重复;
- 误分类率 (四个 Scenario);
- 代理变量基于 Pearson 偏相关系数最大的下一状态分量选取。
对比基线(Benchmark)
- SIS(Sequential Importance Sampling, Precup 2000)
- FQE(Fitted Q Evaluation, Ernst et al. 2005)
- LSTD(Least-Squares Temporal Difference, Shi et al. 2022)
- MIS(Marginalized Importance Sampling, Uehara et al. 2020)
- DRL(Doubly Robust Reinforcement Learning, Kallus & Uehara 2022)
所有基线方法均直接用观测代理 代替真动作,预期在误分类存在时产生显著偏差。
评估指标
- 经验分布与真实值的偏差;
- 95% Wald 置信区间的经验覆盖率(模拟场景);
- MIMIC-III 中三个目标策略(always-IV、no-IV、SOFA-tailored)的估计 SOFA 值与置信区间。
4. 资源与算力
论文未提供任何关于 GPU 型号、数量、训练时长或计算预算的具体信息。实验规模(N=50、T=50、100 次重复、三个仿真环境 + MIMIC-III)相对较小,可在常规 CPU 工作站完成。文章中提到的二次规划(minimax 密度比估计)也并非计算密集型任务,但具体的硬件资源、并行度、超参数调优时长等细节完全缺失,这是论文透明度的一个明显短板。
5. 实验数量与充分性
实验规模
- 仿真:3 个环境 × 4 个误分类率 × 100 次重复 = 12 大组、共约 4 800 次轨迹估计。
- 真实数据:1 组 MIMIC-III 应用,3 个目标策略。
- 覆盖率表:表格 MDP、一般 MDP、OpenAI Gym 三列各报告 4 个 Scenario 下的 95% 置信区间经验覆盖率,介于 0.91–0.98。
- 图表:Figure 3、4、5 分别给出三个模拟环境在 4 个误分类率下的估计分布图;Table 2 给出 MIMIC-III 应用结果。
客观性与公平性
- 公平性方面:所有方法在相同的数据切分、特征工程、样本量与重复次数下评估,基线包括直接法、重要性采样法与双重稳健方法,涵盖 OPE 主流三大类。
- 局限性:
- 基准有限:未与近期专门处理测量误差或缺失数据的 OPE 方法(如 Schennach 2024 系列、Hu & Shiu 2018 等)比较;事实上 Zhou & Tchetgen Tchetgen (2024) 是静态版本但未直接比较。
- 超参数敏感性与稳健性展示不足:EM 算法的初始化、标签对齐阈值、交叉拟合折数 等未做敏感性分析。
- 多重稳健性条件未实证:Corollary 1 给出四种成立条件,但实验未人为制造特定的模型误设来验证其组合的稳健性。
- 类别覆盖:仅给出二元动作推导,分类动作的扩展放在附录 A.8,未提供相应仿真。
- 样本量小: 较小;MIMIC-III 仅 500 名患者,外部有效性受限。
6. 主要结论与发现
理论结论
- 在隐藏动作、MDP 假设、合理的覆盖与分离条件下,无限视野折扣策略值 仍然可识别,且识别所需的代理变量恰好是 MDP 自身的下一状态。
- 提出的 LURE 估计量具有多重稳健性(4 类鲁棒条件)和渐近正态性,支持有效统计推断。
- 一致性条件比单稳健(doubly robust)更弱,对实际建模的容错性更强。
实证结论
- 在 3 个仿真环境中,5 种基线方法的估计均出现明显偏差,并随误分类率 上升而恶化;LURE 在所有 下始终以真实值为中心。
- 95% 置信区间经验覆盖率 0.91–0.98,接近名义水平。
- 在 MIMIC-III 脓毒症 应用中:
- LURE 偏好 always-IV 策略(估计 SOFA = 62.10,CI [60.16, 64.04]);
- SOFA-tailored 策略次之(65.92,[64.30, 67.53]);
- no-IV 策略最差(68.63,[67.03, 70.22]);
- LURE 三组区间互不重叠;而 DRL 三组置信区间全部重叠,凸显考虑隐藏动作对决策的实质影响。
7. 优点
- 问题新颖性:首次系统刻画并解决离线 RL 中的隐藏动作问题,填补了静态隐藏治疗因果推断(Zhou & Tchetgen Tchetgen, 2024)与顺序决策间的空白。
- 方法论亮点:
- 巧妙地将 MDP 的下一状态作为隐藏动作代理,无需额外外部代理;
- 推导的观测影响函数在 Lemma 3 框架下与完整数据 EIF 投影等价;
- EM 式重加权自然处理了后验概率与生成模型的耦合估计问题;
- 加权 minimax 密度比估计和加权 FQE 推广了 Uehara et al. (2020) 与 Ernst et al. (2005);
- 提出 4 类多重稳健性条件,超越经典 doubly robust;
- 通过标签对齐 + 交叉拟合解决了序数标签模糊性和过拟合偏差。
- 理论的完整性:从可识别性、影响函数、有限样本误差界到渐近正态、方差一致性,逻辑链完整;附录 70+ 页证明详尽。
- 应用价值:在 MIMIC-III 脓毒症管理这一真实高风险场景中展示了实质结论差异,具有临床决策参考价值。
- 可扩展性:附录给出从二元到 元分类动作的推广路径。
8. 不足与局限
- 算力信息缺失:未报告任何硬件、训练时长或并行化设置,难以复现与推广评估。
- 多重稳健性缺乏实证验证:仅给出理论,未进行人为模型误设的消融实验来展示 4 类鲁棒条件的现实意义。
- 基线覆盖不够全面:未与静态隐藏处理方法(如 Zhou & Tchetgen Tchetgen 2024)或测量误差 OPE 专门方法对比;基线置信区间在存在偏差时失效,但其覆盖率未被系统性报告。
- 样本规模有限:仿真 ,仅 100 次重复;MIMIC-III 仅 500 名患者。小样本下渐近结果的可推广性需要更多验证。
- 超参数与算法稳定性未深入分析:EM 初始化策略、收敛阈值、交叉拟合折数 、代理变量选取(Pearson 偏相关)等关键设计选择未做敏感性研究。
- 测量误差类型受限:仅讨论二元动作,且误分类仅以状态独立方式建模;实际 EHR 误分类常依赖于状态(如患者严重程度),文章虽在 Assumption 3.1 中提及但未专门给出实证。
- 类别推广缺少实证:附录给出 元动作的矩阵逆形式,但缺乏仿真验证。
- 政策优化未涉及:仅做 OPE,未直接给出隐藏动作下的最优策略搜索方法;下游 decision-making 仍是开放问题。
- 隐私与公平性视角缺失:作为动机之一的"隐私保护数据收集"未在方法中显式建模或评估。
- 隐藏状态/隐藏奖励问题未触及:作者在结尾指出未来工作可推广至更复杂依赖(隐藏状态、隐藏奖励)。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。