
📝 TLDR
在 Game of Hidden Rules (GOHR) 中,学习型决策智能体内部是否编码可解释概念仍是开放问题。本文针对双规则隐藏规则任务,在不提供规则标签的前提下,使用稀疏自编码器(SAE)分析自回归 Transformer 智能体的决策 token 表征。结果显示 SAE 维度对形状与桶等概念具有高度选择性,并对应探测规则与负反馈后切换等可解释策略,为揭示智能体的隐式规则推断机制提供了证据。
🧭 速览
学习型决策系统的内部表征是否包含解释其行为的概念尚不明确,缺乏对规则推断过程的可视化分析。
在双规则 GOHR 任务上固定权重的自回归 Transformer 智能体,对其决策 token 嵌入训练稀疏自编码器进行解耦。
SAE 维度对所选形状与桶等概念高度选择性覆盖,并能识别探测规则与负反馈切换等策略。
SAE 有效恢复智能体对隐藏规则的隐式推断结构,为策略表征的可解释性提供新证据。
🆚 方法对比
GOHR(隐藏规则博弈)
- 规则可控,便于验证策略行为
- 隐藏变量已知,实验者可验证
- 支持稀疏反馈下的策略推断分析
- 仅两规则设置,任务复杂度有限
- 规则仅依赖形状,属性冗余较简单
- 需设计紧凑任务以保证可解释性
Tokenized Autoregressive Transformer策略
- 能将状态与交互历史联合编码
- 固定权重后便于冻结分析
- 在形状-桶映射任务中表现有效
- 未显式使用规则分类器,规则信息隐式
- 依赖试探-反馈循环才能推断规则
- 观察属性比实际所需更丰富,含干扰特征
稀疏自编码器(SAE)分析
- 高选择性维度覆盖大多数相关决策
- 可恢复形状、桶等简单概念结构
- 能识别试探与切换等可解释策略
- 仅在决策token嵌入上训练,覆盖有限
- 事后分析,不参与智能体决策过程
- 稀疏维度与概念的对齐依赖选择性阈值
Probe-and-Switch策略
- 提供自然的成功行为基线假设
- 可直接在rollout中验证存在性
- 与SAE发现的策略维度对应清晰
- 仅为直觉策略,非正式学习算法
- 依赖首次试探被接受或拒绝的证据
- 在更长或更复杂规则下未必适用
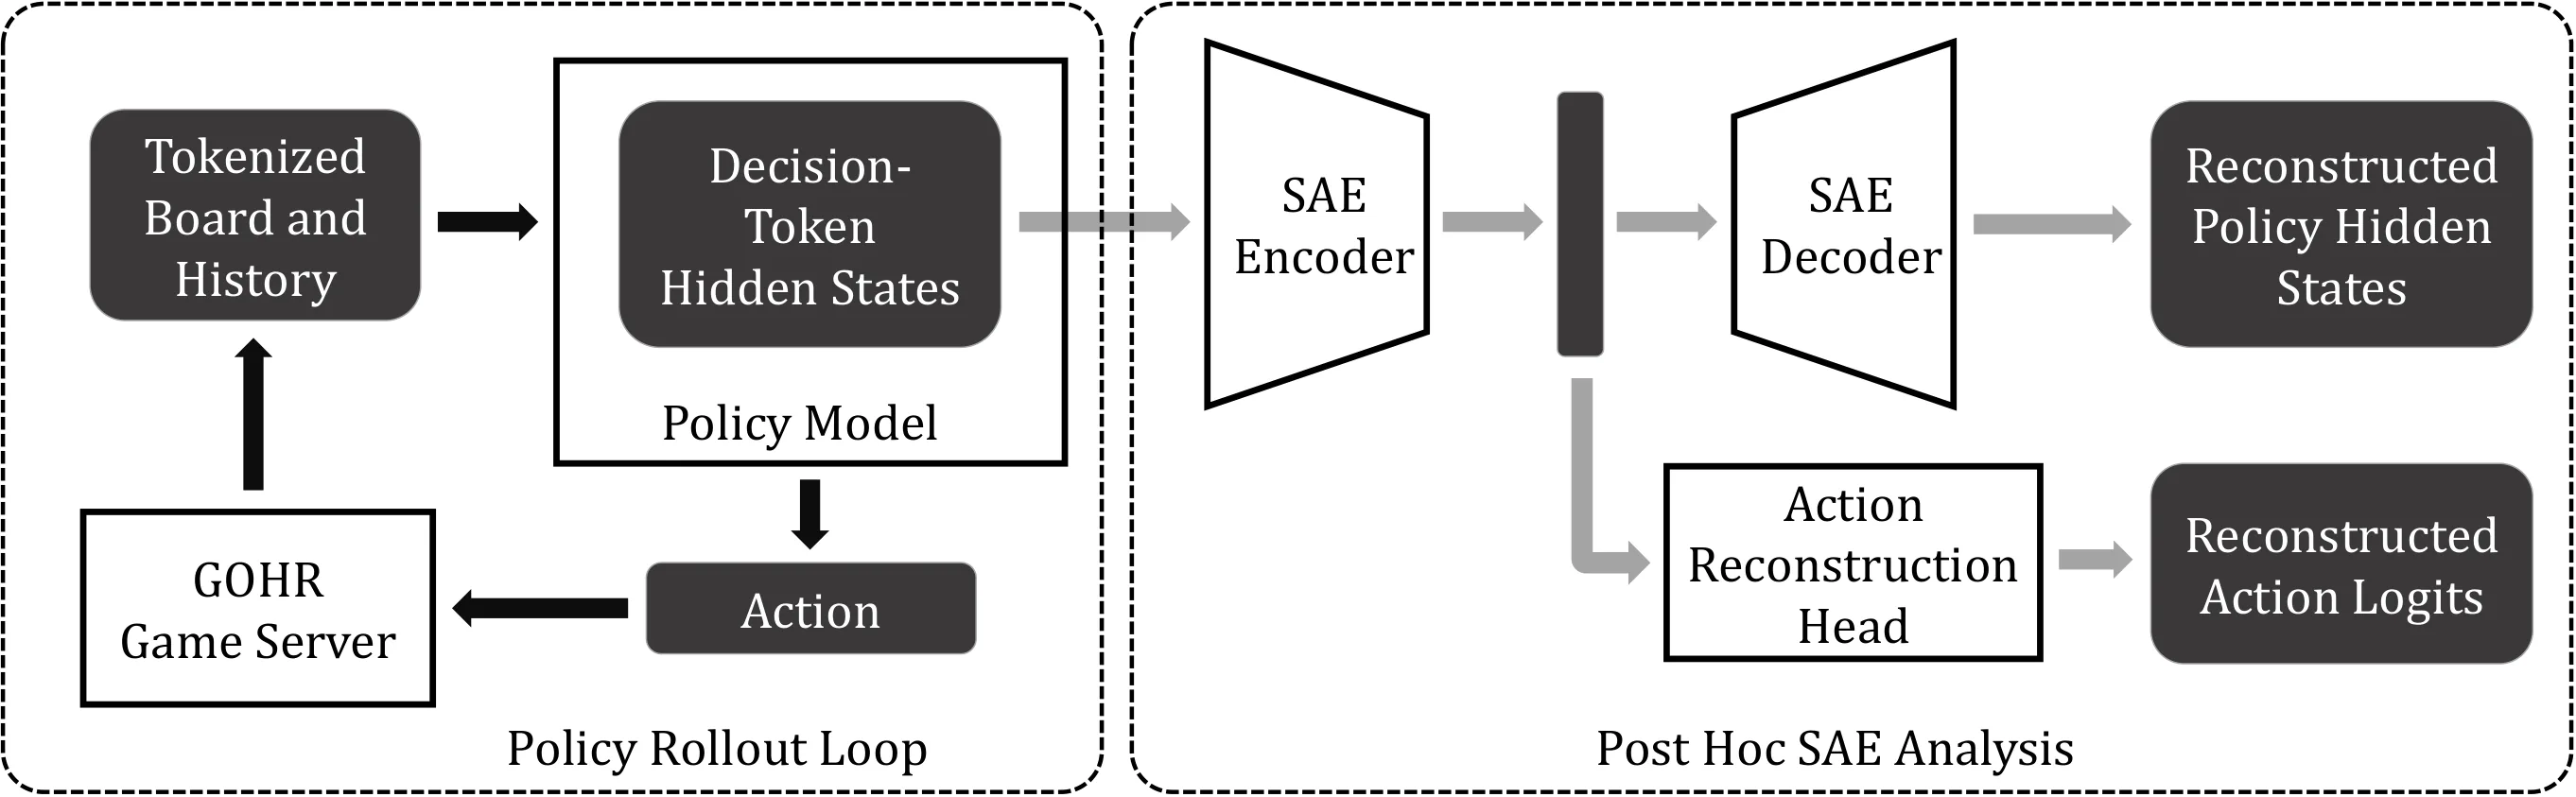
本文以GOHR为受控环境,用冻结的Transformer策略收集隐藏状态,再用事后SAE在决策token嵌入上做稀疏分解,将行为层面的试探-切换策略与表征层面的概念选择性维度对应起来。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
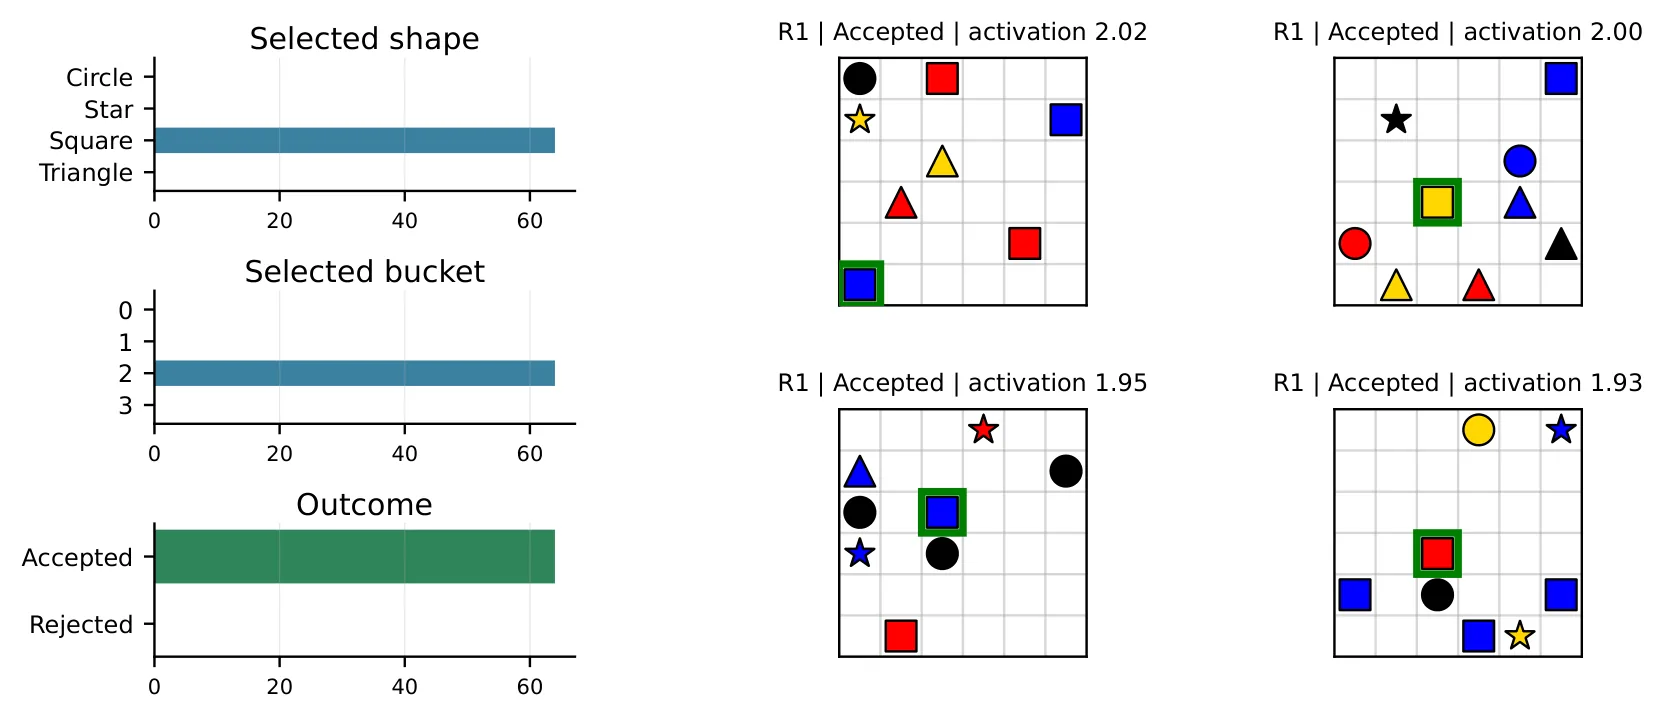
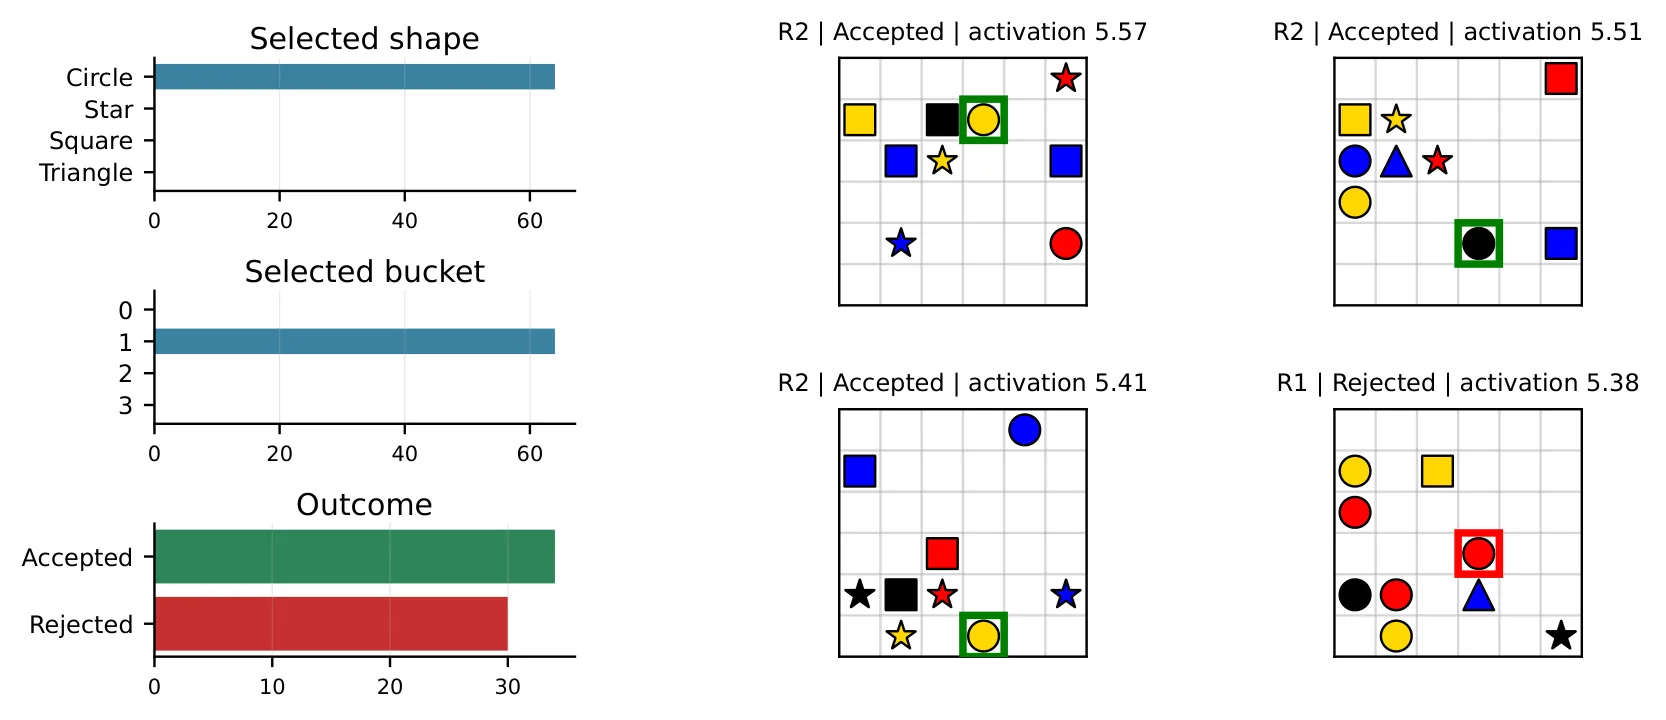
TL;DR
这篇论文在 GOHR(隐藏规则博弈)环境下研究了一个自回归 [[Transformer]] 智能体是否在其内部表征中编码了可解释的概念。研究者使用 [[稀疏自编码器(SAE)]] 对智能体的决策 token 嵌入进行了解析,发现 SAE 的维度能够选择性地对应形状、桶这类简单概念,以及"探测一条规则假设"和"收到负反馈后切换策略"这类复杂行为策略,证明即便在没有显式规则标签的情况下,智能体内部仍然存在可解释的结构化表征。
研究背景与动机
在游戏对局、医疗诊断、金融交易等许多真实场景中,人类希望依赖学习型决策系统来辅助判断,但往往难以理解这些系统"为什么会做出某个决策"。一个核心问题是:智能体的内部表征中,是否真的包含了能够帮助我们解释其行为的语义概念?
GOHR(Game of Hidden Rules,隐藏规则博弈)是一个专门为此设计的实验平台。在这个博弈中,智能体需要在不直接获知规则内容的情况下,通过与环境交互来推断和应用隐藏规则。然而在此之前,研究者并不清楚学习型策略是否会在其内部真正形成对规则的抽象表征,还是仅仅依赖某种"黑箱"式的模式匹配来完成决策。
这篇论文的切入点正在于此:使用 [[稀疏自编码器(SAE)]] 这一可解释性工具,对一个经过双规则任务训练的 [[Transformer]] 智能体的决策表征进行"解剖",直接检验其中是否存在可映射到人类可理解概念的结构。
方法
论文的核心方法围绕 [[稀疏自编码器(SAE)]] 的训练与分析展开。
首先,智能体面临的是一个"双规则隐藏规则任务":环境中存在两条不同的隐藏规则,它们都将物体的形状映射到某个目标桶,但具体的对应关系不同。智能体通过与环境的交互——即尝试某个动作并观察"接受/拒绝"的反馈——来推断当前回合遵循的是哪条规则。关键在于,正确的规则在智能体真正做出一个信息量足够大的动作并获得反馈之前,是无法被确定的。这确保了任务要求智能体必须进行主动的规则推断,而不仅仅是被动地记住输入-输出的统计规律。
智能体的决策由一个自回归 [[Transformer]] 模型产生,输出的是分词化的决策 token。研究者从这些决策 token 对应的嵌入向量中采集了大量样本,用于训练 SAE。SAE 的核心思想是通过一个稀疏约束,将高维的原始嵌入空间映射到一个维度更高但稀疏的潜在空间——每个潜在维度在大多数情况下接近零,只有在特定语义特征被激活时才会显著取值。
作者选择 SAE 的理由在于:稀疏性天然地促进了概念的可分离性。当潜在维度足够稀疏时,同一个维度不太可能同时编码多个不相关的语义特征,从而使得每个维度更可能对应单一的人类可理解概念。相比于直接对嵌入向量做探测(probing),SAE 提供了一种更彻底的特征分解。
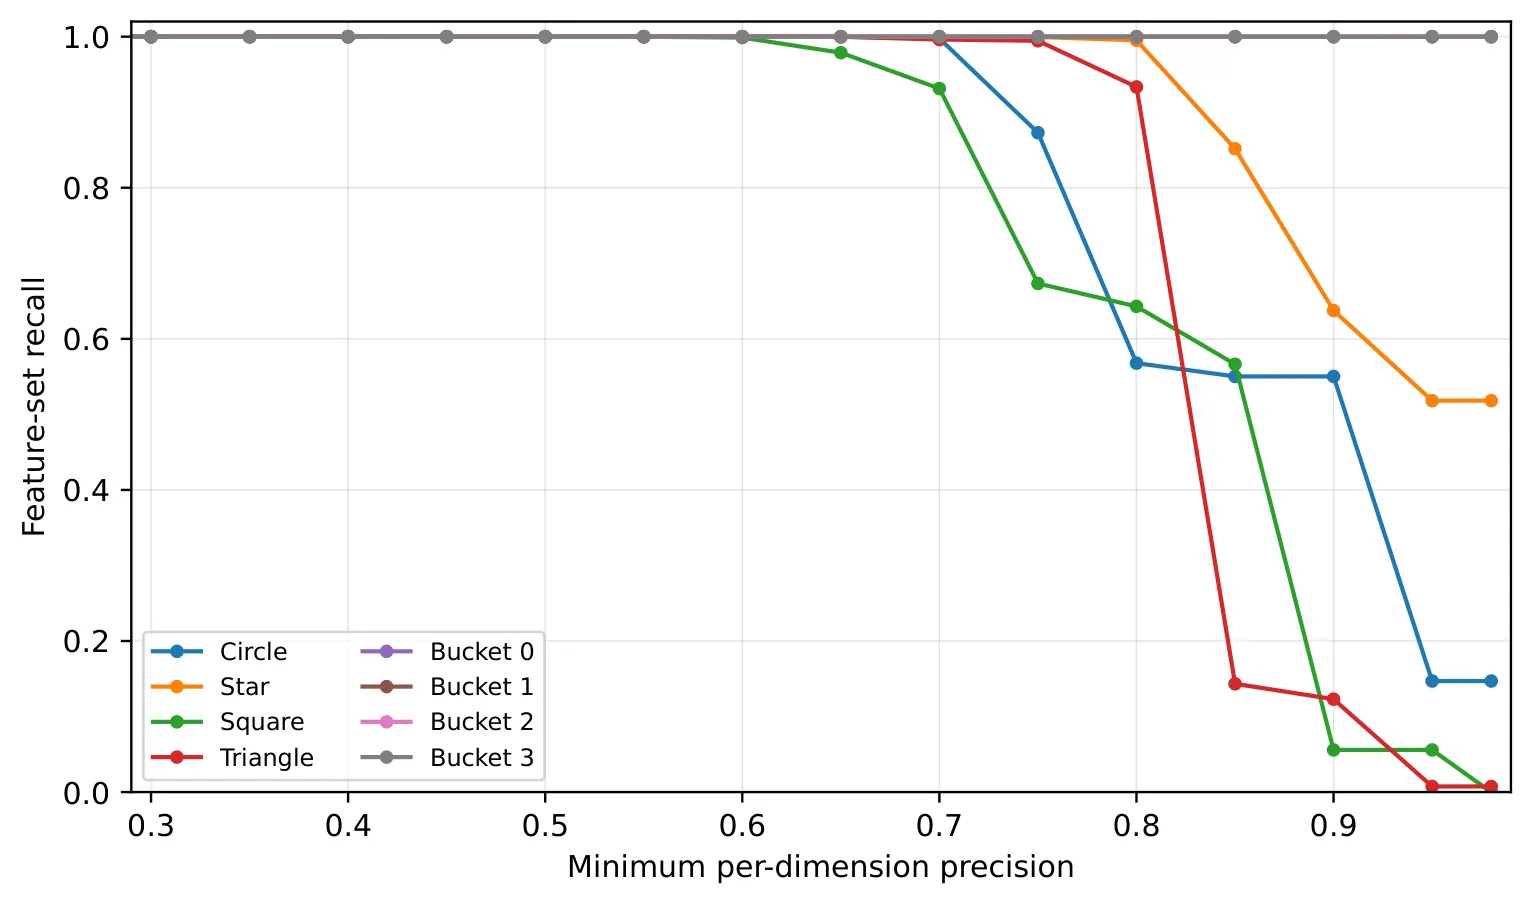
在后续分析中,研究者将留存测试集中的决策样本用简单概念(如"选择的形状"、"选择的桶")进行人工标注,然后检验那些对某一概念高度选择性的 SAE 维度能否覆盖该概念出现的大部分决策。这一过程用于验证 SAE 维度与概念之间的对应关系是否具有统计上的覆盖性和选择性。
实验与结果
实验结果表明,SAE 在智能体决策嵌入上学习到的特征具有清晰的可解释性。
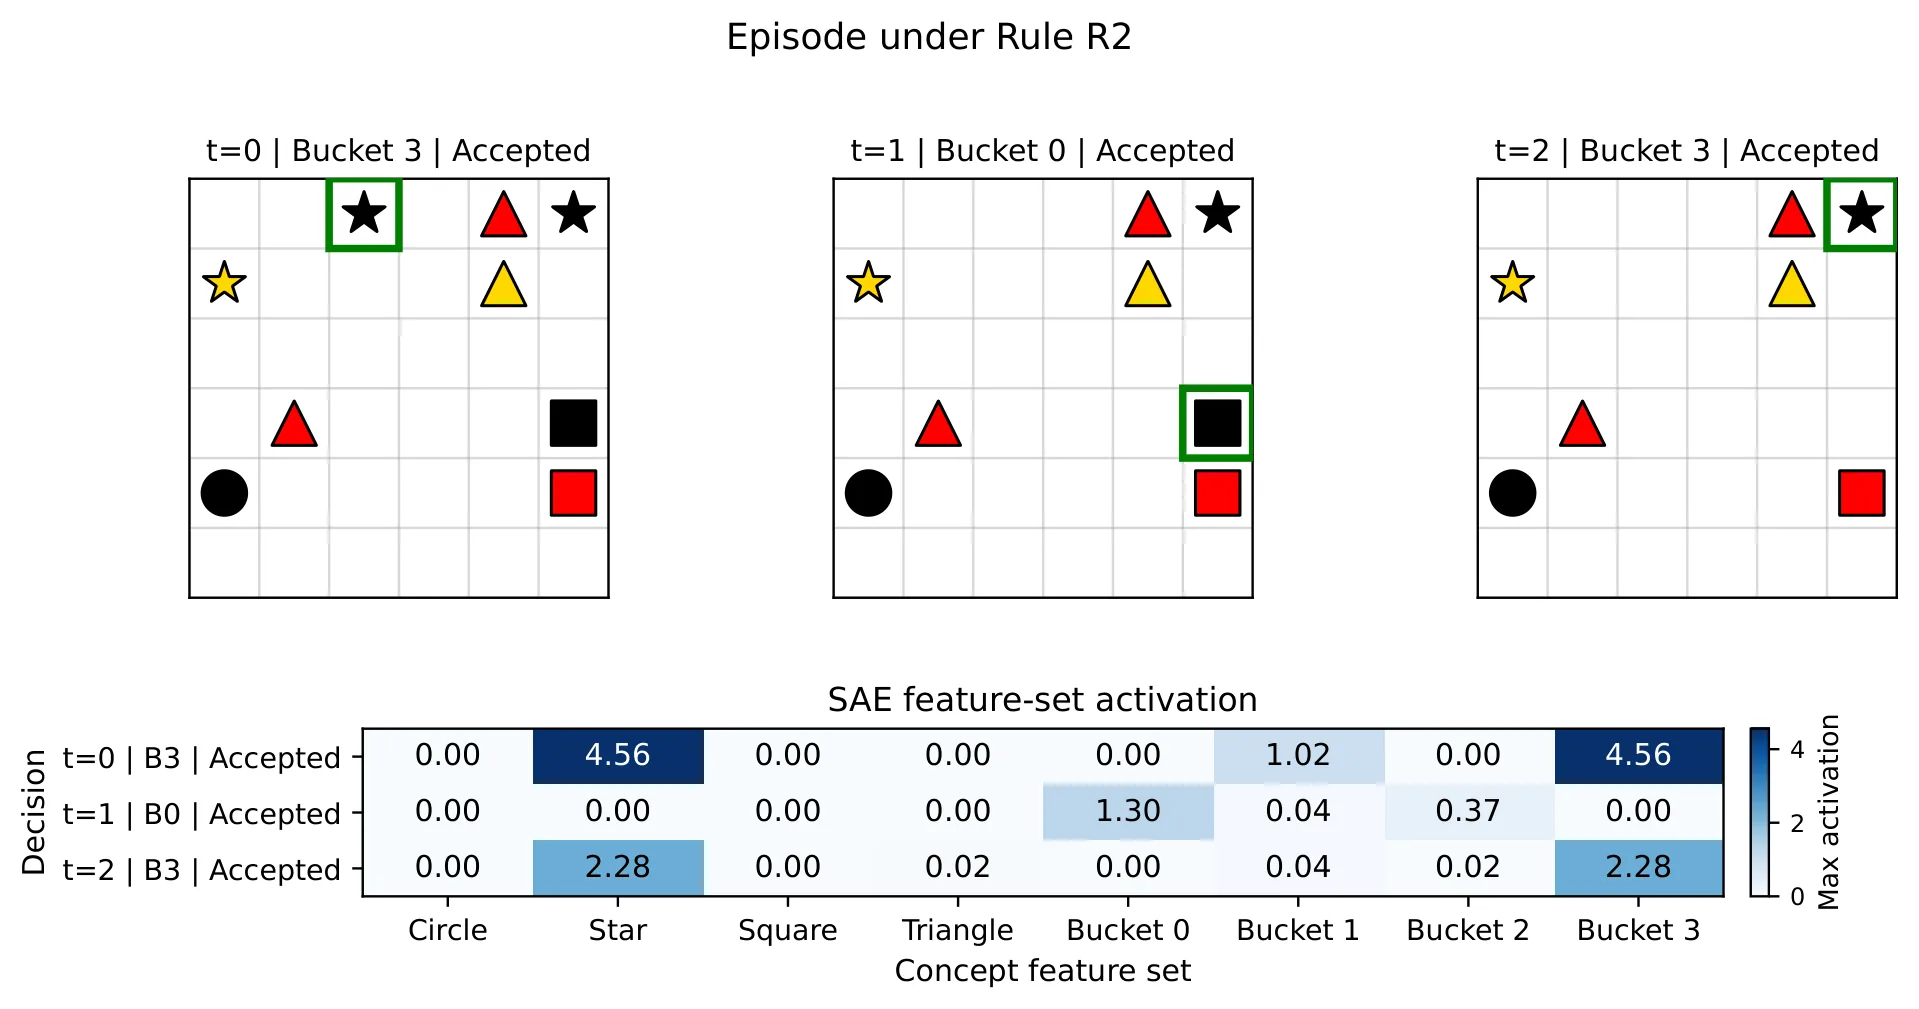
在概念选择性方面,当用形状和桶这类基础概念对留存决策进行标注后,高度选择性的 SAE 维度能够覆盖该概念出现的大部分决策。举例来说,某个 SAE 维度可能仅在智能体选择"圆形"物体时显著激活,而几乎不响应其他形状;另一个维度则可能专门对应"将物体放入左侧桶"这一动作。这种高度选择性说明智能体的内部表征确实将决策空间分解为了语义上有意义的维度。
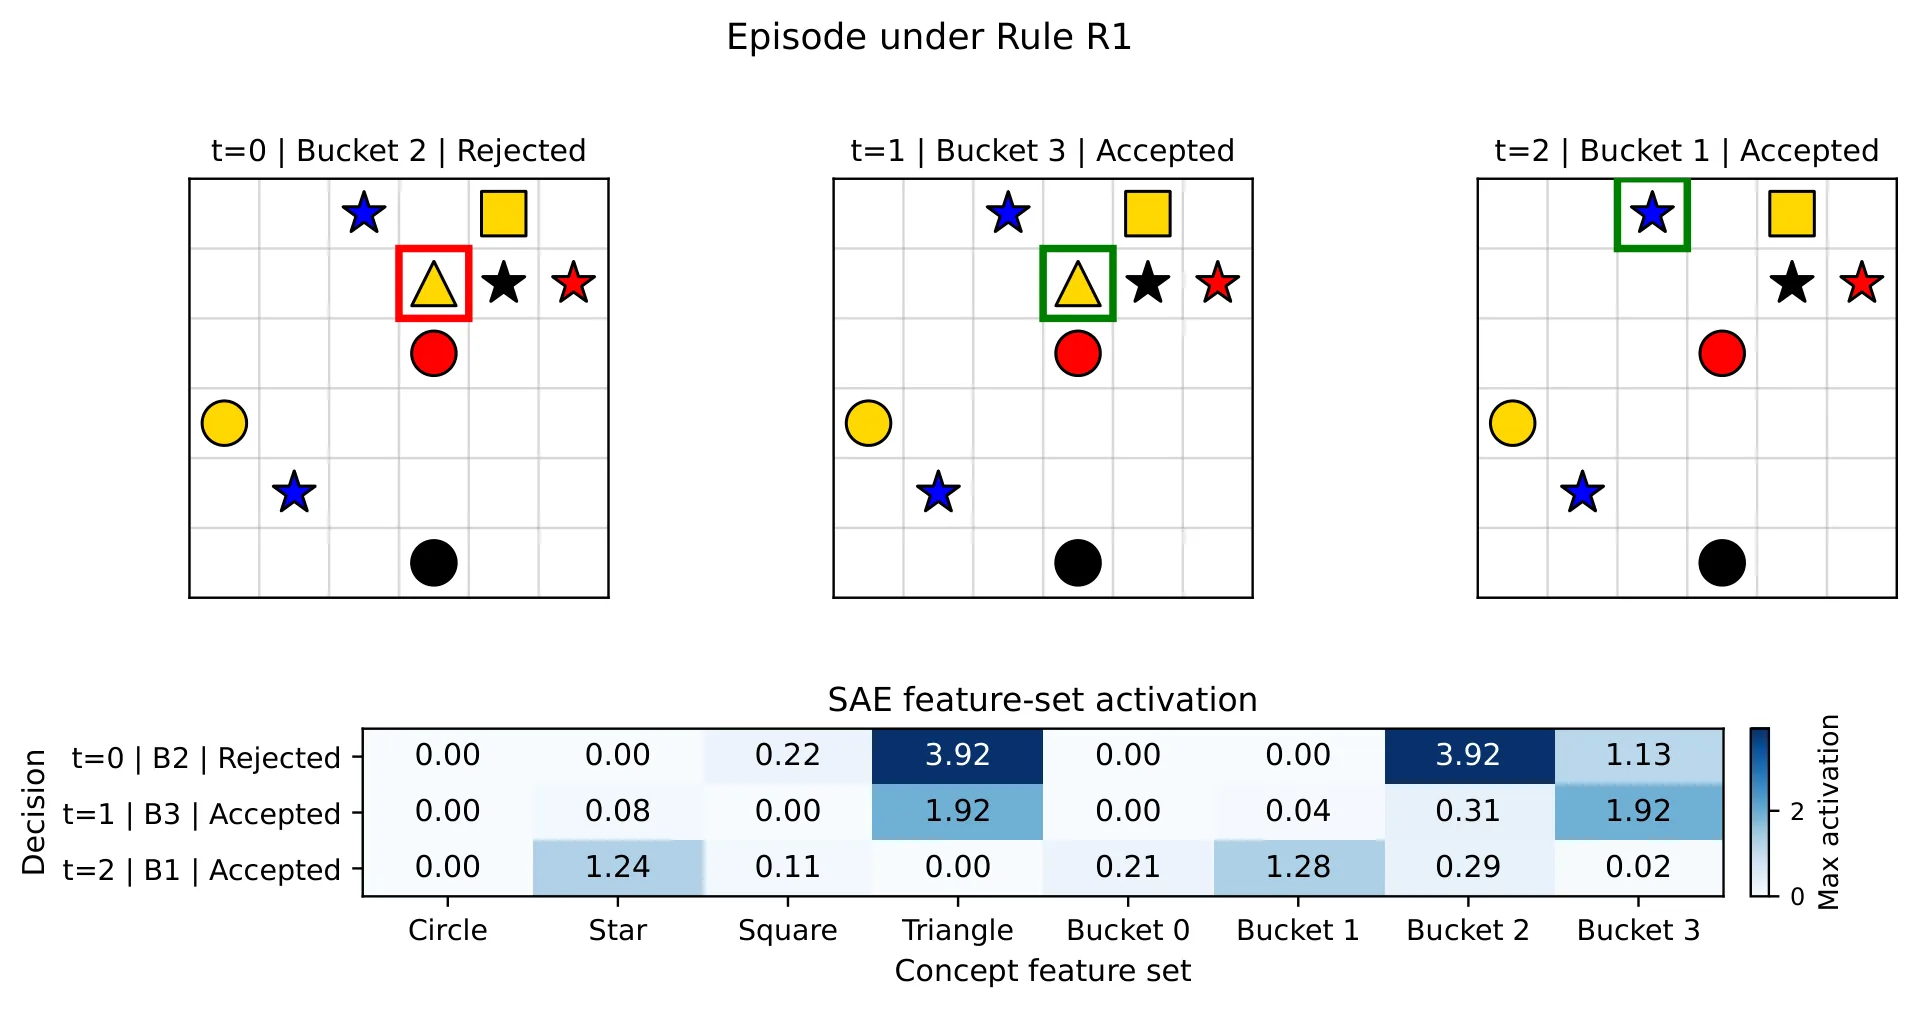
更值得关注的是,研究者发现 SAE 维度还与更复杂的策略行为对应。具体而言,存在一些维度能够选择性地标记"探测一条规则假设"的决策——即智能体故意尝试一个能快速区分两条规则的动作;还有维度对应"在收到负面反馈后切换策略"的决策模式。这意味着智能体不仅编码了静态的概念,还编码了具有时序性和条件性的行为策略。
综合来看,这些结果为"智能体通过隐式推断来学习规则"这一假设提供了直接的表征层面的证据:智能体内部确实存在可被解析的结构化知识,而不仅仅是黑箱式的输入-输出映射。
讨论与可借鉴点
这篇论文的核心贡献在于展示了 [[稀疏自编码器(SAE)]] 在发现决策智能体内部概念结构方面的有效性。它提示我们,即便在缺乏显式规则监督的情况下,具有足够表达能力的模型(如 Transformer)仍然可能自发地在其表征中组织出可解释的知识模块。
对于可解释性研究方向而言,一个重要启示是:稀疏性约束是实现特征可分离的关键。在训练下游任务模型时如果同时考虑表征的稀疏性,可能有助于后续的可解释性分析。这一思路对构建"可解释优先"的决策系统具有参考价值。
论文也诚实地指出了若干局限。首先,SAE 维度与策略行为的对应关系需要人工解释,尚未实现完全自动化的概念发现。其次,实验设定相对简单(仅两条规则),在更复杂的规则空间中的泛化性有待验证。此外,SAE 本身的选择(如维度数、稀疏性系数)可能影响发现的稳定性,如何系统性地选择这些超参数仍是一个开放问题。
未来的探索方向可以包括:在大规模规则库上检验 SAE 的鲁棒性、设计自动化的概念归因方法以减少人工依赖,以及将这种表征分析方法与强化学习中的策略优化更紧密地结合。对于想要深入 [[Transformer]] 可解释性研究的实践者来说,本文提供了一个从表征分析角度切入的成功范例。
摘要
解释学习型决策系统的一个核心挑战在于判断其内部表征是否包含有助于解释其行为的概念。我们在隐藏规则博弈(Game of Hidden Rules, GOHR)中针对一个分词化的自回归 Transformer 智能体报告了可解释性实验。我们聚焦于一个紧凑的双规则任务,其中两条隐藏规则都将物体形状映射到目标桶,但采用不同的排列方式。该策略在从这两条隐藏规则中采样的回合上进行训练,然后以固定权重进行评估。它从未被赋予规则标签,也不使用显式的规则分类器;任何规则信息都必须从交互历史中隐式推断。在这一设定中,正确的规则在智能体尝试一个能带来信息量的动作并观察接受/拒绝反馈之前是不可识别的。在智能体决策令牌嵌入上训练的稀疏自编码器(SAE)恢复了这种结构。当对留存决策用所选形状或桶等简单概念进行标注时,对某一概念高度选择性的 SAE 维度能够覆盖该概念出现的大部分决策。单个 SAE 维度还对应于可解释的策略,例如探测一条规则假设以及在收到负面反馈后切换策略。
Abstract
A central challenge in interpreting learned decision-making systems is to determine whether their internal representations contain concepts that help explain their behavior. We report interpretability experiments for a tokenized autoregressive Transformer agent in the Game of Hidden Rules (GOHR). We focus on a compact two-rule task in which both hidden rules map object shapes to target buckets, but with different permutations. The policy is trained on episodes sampled from these two hidden rules and then evaluated with fixed weights. It is never given a rule label and does not use an explicit rule classifier; any rule information must be inferred implicitly from interaction history. In this setting, the correct rule is not identifiable before the agent tries an informative move and observes accept/reject feedback. Sparse autoencoders (SAEs) trained on the agent's decision-token embeddings recover this structure. When held-out decisions are labeled by simple concepts such as the chosen shape or bucket, SAE dimensions that are highly selective for a concept cover most decisions where that concept is present. Individual SAE dimensions also correspond to interpretable strategies such as probing one rule hypothesis and switching after negative feedback.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。