
端点回放:压缩深度强化学习中的近期回放缓冲区
Endpoint Replay: Compressing the Recency Buffer in Deep Reinforcement Learning
📝 TLDR
深度强化学习中的经验回放普遍依赖百万级大容量recency buffer,存在显著存储冗余且尺寸多年未变。本文提出Endpoint Replay方法,通过仅存储n步连接序列端点的代表性转移,以约小一个数量级的缓冲区维持等效记忆跨度。实验在Pinball环境和Atari 2600基准上匹配传统大缓冲区的性能,同时避免朴素压缩策略引入的系统性偏差,为降低DRL存储开销提供新思路。
🧭 速览
DRL中经验回放普遍使用百万级大容量recency buffer,存储冗余大且尺寸长期不变,急需更高效的压缩方案。
存储n步连接序列两端端点的代表性转移,用小缓冲区维持等效记忆跨度,实现有针对性的稀疏回放。
在Pinball和Atari 2600上以小约一个数量级的存储匹配大缓冲区性能,避免朴素压缩的系统偏差。
端点采样是一种简单有效的经验回放压缩策略,为DRL降低存储开销提供可行方向。
🆚 方法对比
Endpoint Replay
- 10-50倍存储压缩下匹配大缓冲区性能
- 链式n步构造保证bootstrap目标锚定
- 在Pinball和12个Atari游戏中验证有效
- 无需生成模型即可保留大缓冲区优势
- 仅在确定动态下证明策略迭代收敛
- 仍需小recency buffer和核心集双重结构
- 实验仅覆盖Pinball和Atari两类环境
- 依赖期望损失调参增加实现复杂度
n-step Expectile Sarsa
- 缓解旧策略产生的悲观偏差
- 证明n≥1时Bellman算子收敛
- 相比IQL扩展至n步bootstrap场景
- 固定点与n的有序关系有理论保证
- 固定点依赖于n而非真实期望回报
- 确定动态下收敛到最优策略有局限
- 期望回归参数τ需额外调优
- 理论分析未覆盖随机动态场景
Standard Recency Buffer (DQN)
- 实现简单且泛用于多数off-policy算法
- 一百万容量提供宽广记忆视野
- 均匀采样避免优先级引入的偏差
- 与DreamerV3、SAC等主流算法兼容
- 存储需求大且冗余度高
- 一百万规模数十年未变缺乏创新
- 均匀采样无法突出重要经验
- 对计算和内存资源要求较高
Reservoir-sampling Coresets
- 保持样本分布的统计代表性
- 存储需求低于全量缓冲区
- 流式采样适合在线场景
- 存在未锚定bootstrap目标问题
- 孤立转移无法传播价值信息
- 在控制实验中性能下降明显
- 无法解决本文识别的偏差问题
MeDQN
- 正则化目标网络支持极小缓冲区
- 为压缩缓冲区提供正则化思路
- 未能在10-50倍压缩下匹配大缓冲区
- 性能被Endpoint Replay超越
- 依赖额外正则化机制增加复杂度
Prioritized Experience Replay
- 基于TD误差加权突出重要经验
- 在表格规划中有动机支持
- 能加速价值传播
- 在DRL中成功有限
- 引入优先级偏差需额外修正
- 仍依赖大缓冲区作为基础设施
Equal-sized Recency Buffers
- 直接对比的公平基线
- 揭示压缩策略与简单缩减的差异
- 性能低于Endpoint Replay压缩方案
- 存储减少时记忆视野同步缩短
- 无法利用链式结构加速价值传播
Continual RL Compressed Buffers
- 面向持续学习的跟踪能力
- 比全量缓冲区更高效
- 目标不同:消除而非压缩replay
- 未解决未锚定bootstrap问题
- 在本文场景下未被作为基线对比
Endpoint Replay通过链式n步构造和Expectile Sarsa解决传统coreset的未锚定bootstrap问题,在10-50倍压缩下匹配大缓冲区性能,优于reservoir-sampling coresets、MeDQN和等大小缓冲区,同时与持续RL压缩和生成模型方法在目标定位上形成互补。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 12 张)
展开查看 12 张图
TL;DR
经验回放是深度强化学习的基石技术,但自 DQN 以来沿用的百万级缓冲区设计多年未变,存储开销巨大且冗余明显。Endpoint Replay 提出一种巧妙的压缩思路:不再存储完整的近期转移集合,而是只保留 步序列的端点,通过端点之间的"链接"关系维持有效记忆跨度,同时避免朴素压缩引入的价值估计漂移问题。实验表明,这种方法在 Pinball 和 Atari 2600 上以仅 2%–10% 的存储空间即可匹配标准大缓冲区的性能。
研究背景与动机
自 DQN 将 [[经验回放]] 引入深度强化学习以来,几乎所有 off-policy 算法都依赖一个容量约一百万的 FIFO 近期缓冲区配合均匀采样来打破数据的时间相关性。这套设计在过去近十年里几乎未发生本质变化。然而,随着强化学习向持续学习和更大规模应用演进,这种大容量缓冲区暴露出两个显著问题:一是存储开销成为资源受限场景的瓶颈,二是大量转移之间存在高度冗余——特别是连续状态之间的转移价值信息高度重叠。
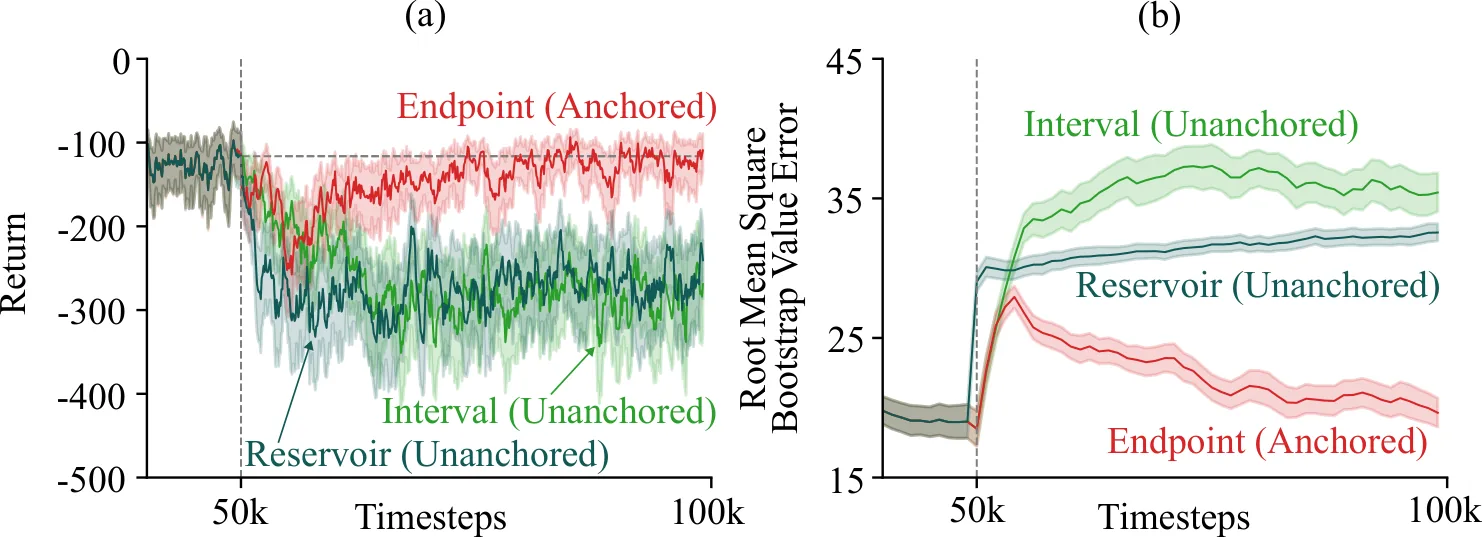
一个自然的想法是:我们能否将缓冲区压缩 10 倍甚至 50 倍,同时保留大缓冲区的核心优势?过去的研究者尝试过多种朴素压缩策略,包括 reservoir sampling、间隔采样和独立 transition coreset,但这些方法在实验中均遭遇了显著性能下降。本文的贡献在于首次识别并形式化了这些朴素压缩策略失败的根本原因——无锚定 bootstrap 目标(unanchored bootstrap targets)。
具体而言,当我们对转移进行任意压缩时,被选中的转移之间的 bootstrap 状态-动作对往往相互独立,不在同一链条上。这意味着 -step 目标中的 bootstrap 项 本身不会被任何转移更新,导致 Q 值在价值传播过程中发生系统性"漂移"。这个问题在离线强化学习中也以"out-of-sample action"的形式出现,但此前未被显式地与在线回放缓冲区压缩联系起来。
方法
Endpoint Replay 的核心设计围绕三个组件展开:小型近期缓冲区 、压缩缓冲区 ,以及连接两者的滞后缓冲区(lag buffer)。
小型近期缓冲区 存储最新的 条标准 1-step 转移 ,用于执行标准 [[DDQN]] 更新。这部分与传统设计无异,保证算法在最近期经验上拥有精确的价值估计。
压缩缓冲区 存储从 老化出来的转移,但采用链式 -step 元组格式:
这里的关键洞察是:端点 本身也是 中另一条 -step 元组的起点。通过这种链接关系,bootstrap 目标被"锚定"——每次更新的 bootstrap 状态都来自数据库中真实存在的转移,从而避免了价值漂移。
滞后缓冲区 的作用是缓冲最多 条刚从 推出的转移。当积累满 条(或遇到终止步 )时,将其聚合成一个 -step(或 -step)转移写入 。这个设计确保链式结构不会因为 episode 边界而断裂。
在控制场景下,作者发现 -step 目标存在固有的悲观偏差——因为目标来自较旧、次优的策略。为缓解这一问题,论文提出 -step Expectile Sarsa,对 的样本使用非对称损失函数:
其中 时更多关注正大误差(即上界),从而抵消悲观偏差。注意这里使用 SARSA 而非 max 操作——即 ,其中 来自数据集中的真实动作而非贪婪选择。论文证明这进一步强化了锚定效果。
从 [[Bellman 算子]] 的角度,论文建立了 -step Expectile Bellman 算子 的理论性质:对任意 和 ,该算子是 -压缩映射,保证唯一不动点存在。同时,当 时,较长的 步对应较小的 expectile 值,建立了不同步长之间的序关系。
实验与结果
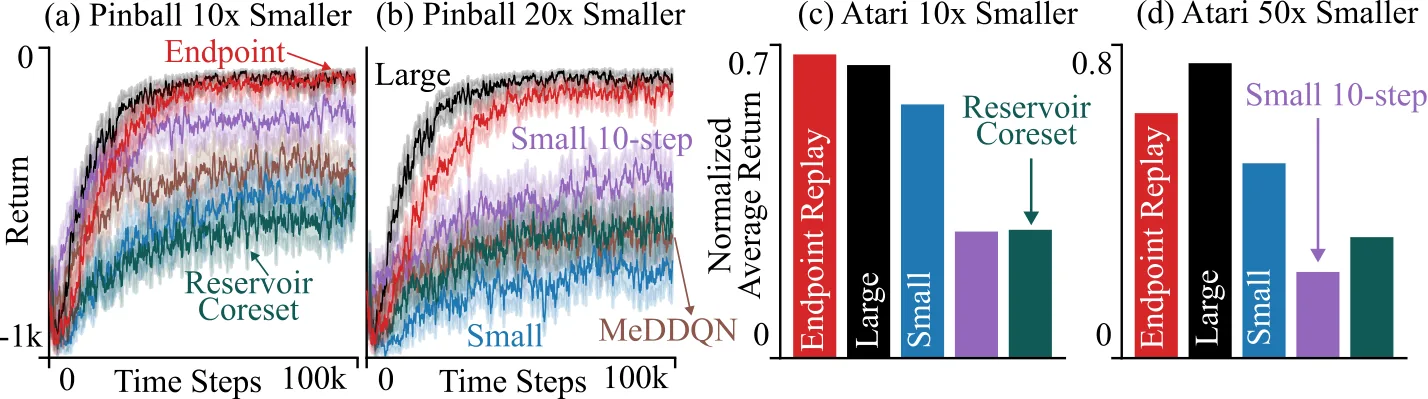
实验在 Pinball 环境(低维连续控制)和 Atari 2600 基准(12 个精选游戏,50M 帧训练)上进行,对比了多种基线:标准大缓冲区(Pinball 10k,Atari 1M)、朴素小缓冲区、reservoir sampling coreset、interval coreset,以及 MeDDQN(仅 Pinball)。
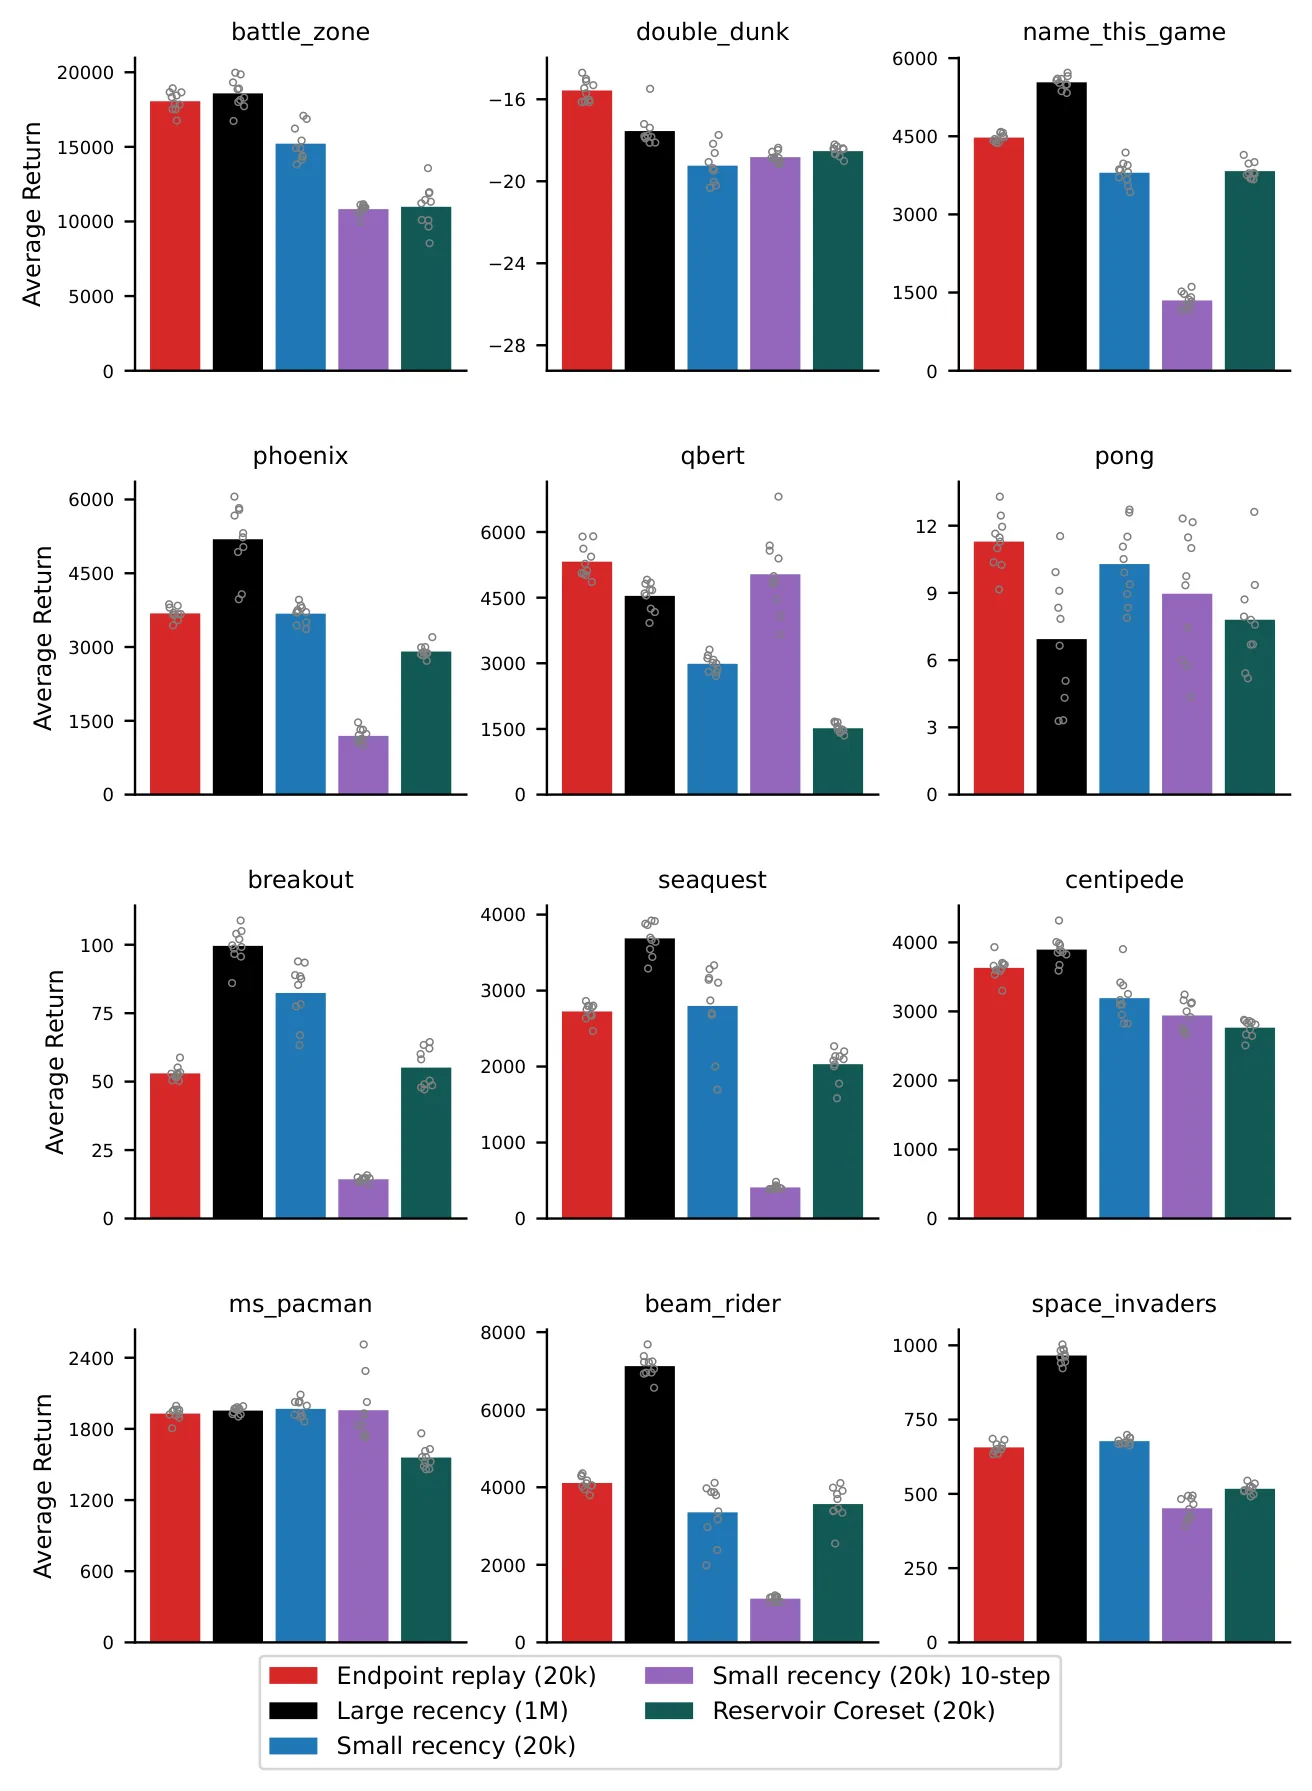
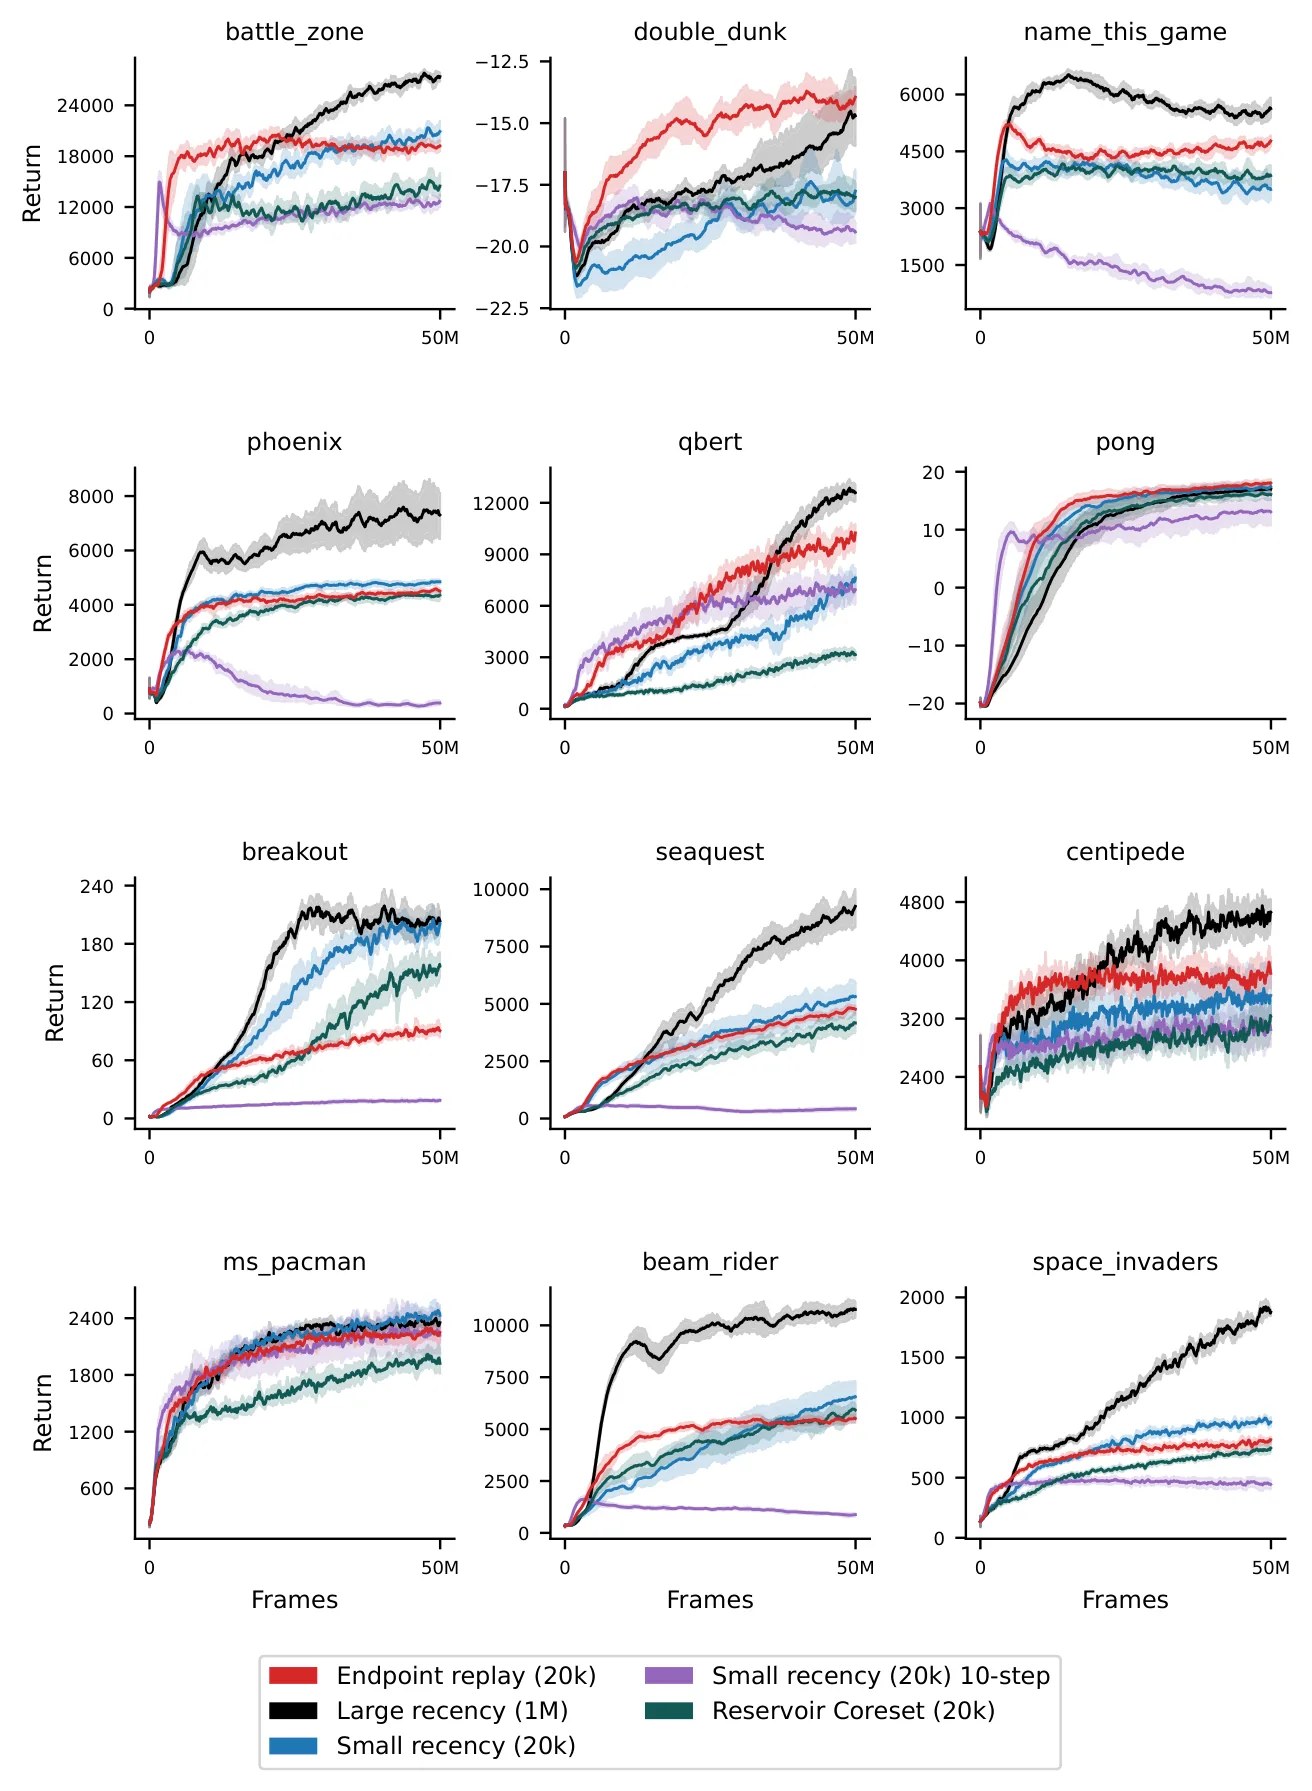
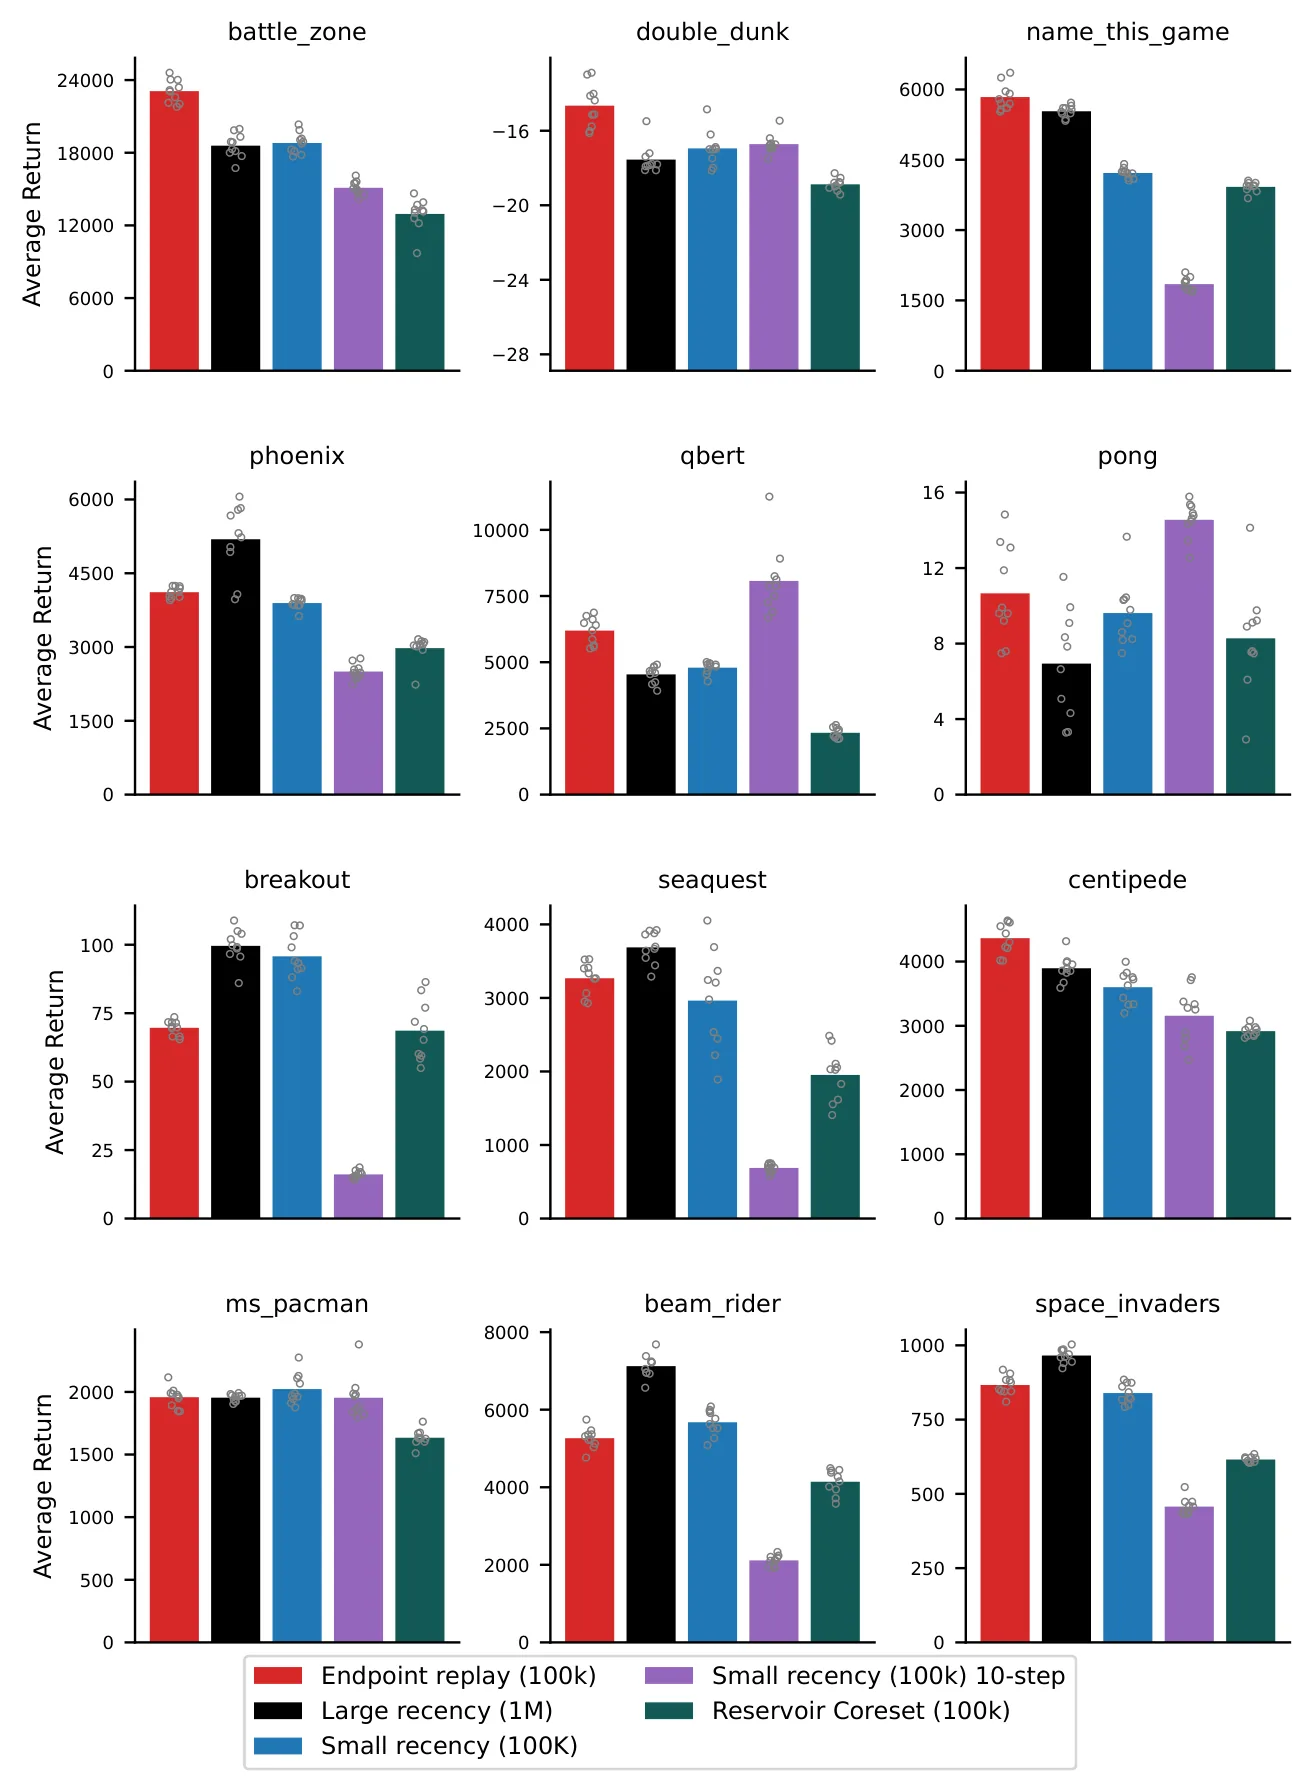
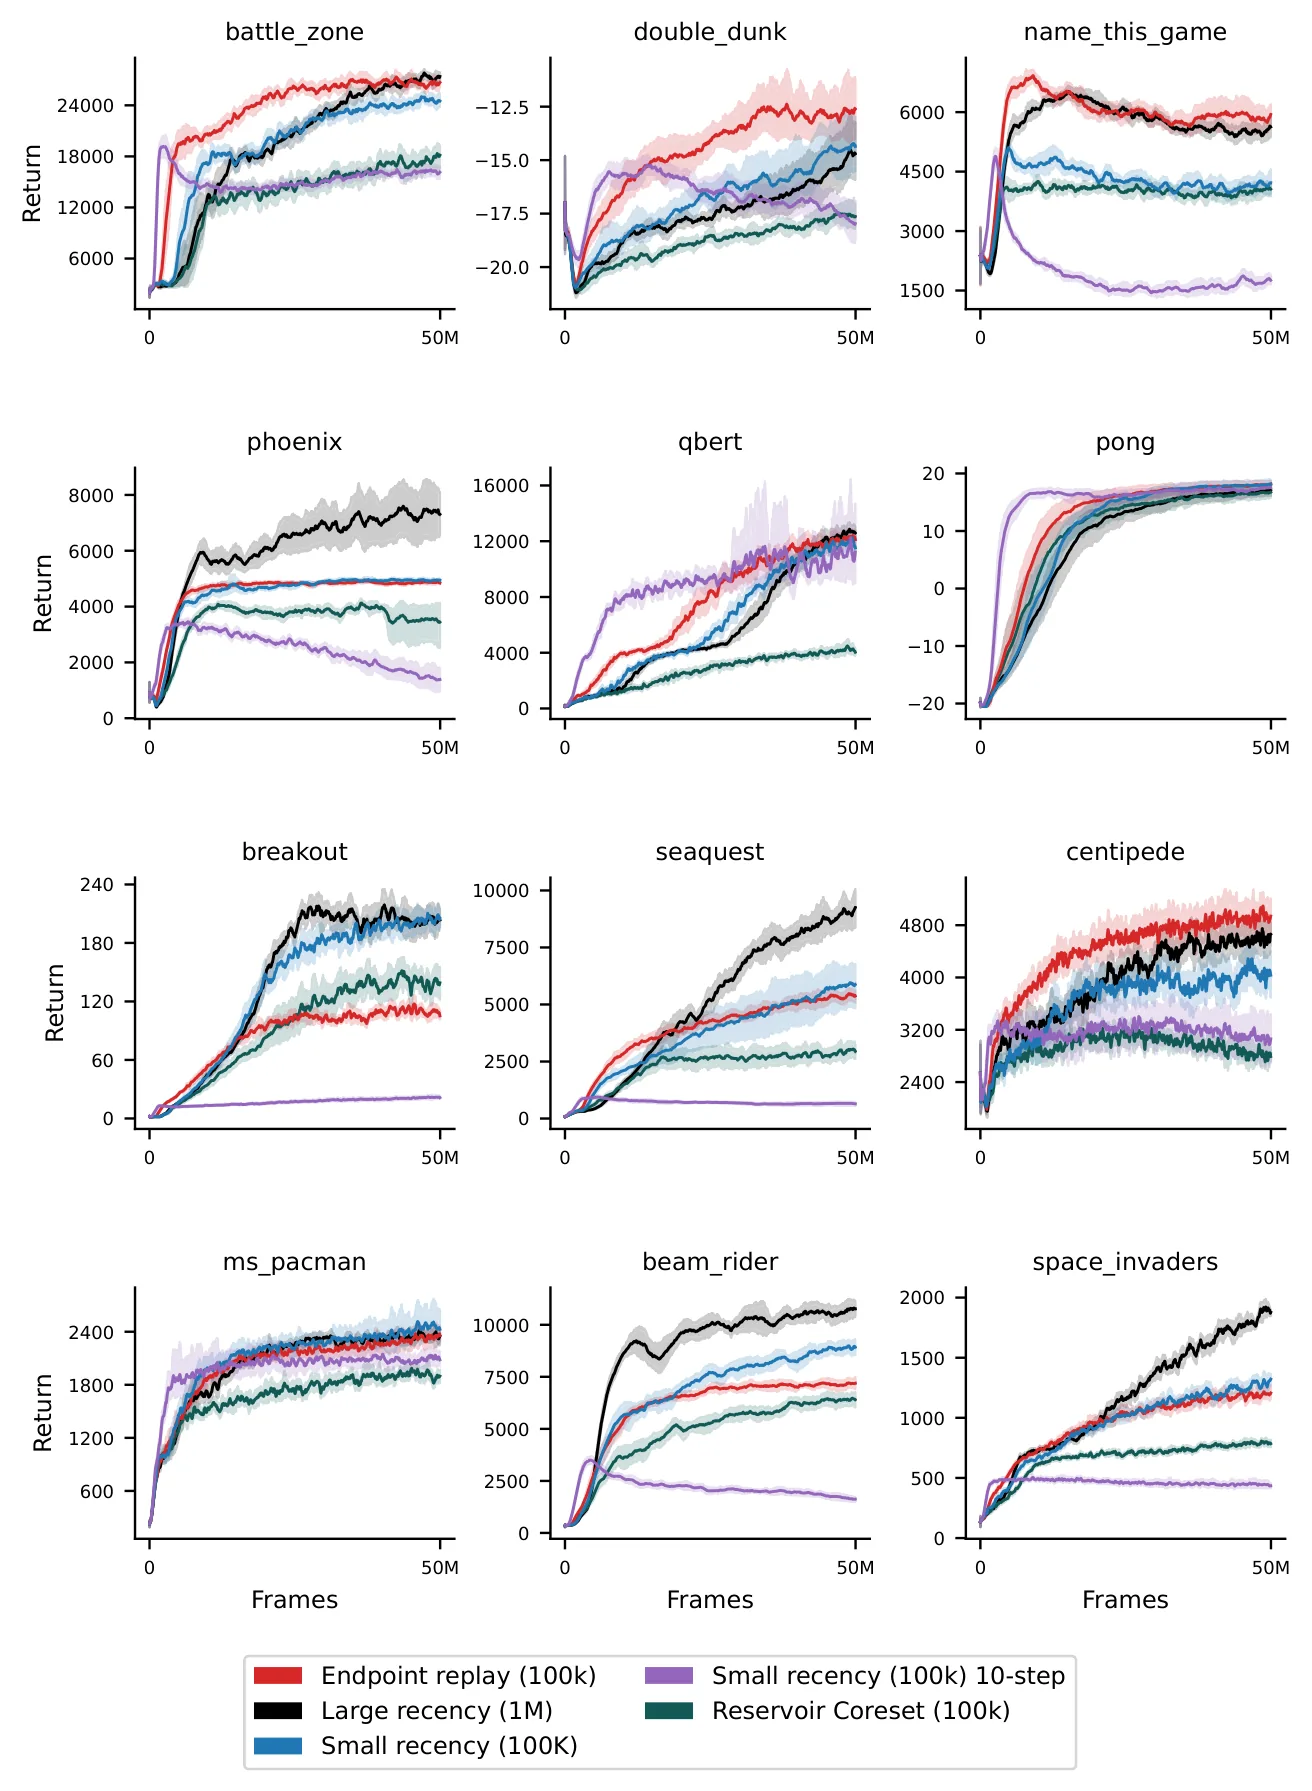
结果显示,Endpoint Replay 在两种环境、两种缓冲区规模(Atari 20k 与 100k)下均显著优于所有朴素压缩基线。在 Atari 100k 配置(相当于 10× 压缩)下以 82/120 的统计显著胜出数超越小缓冲区;在更极端的 20k 配置(50× 压缩)下胜出数为 80/120。
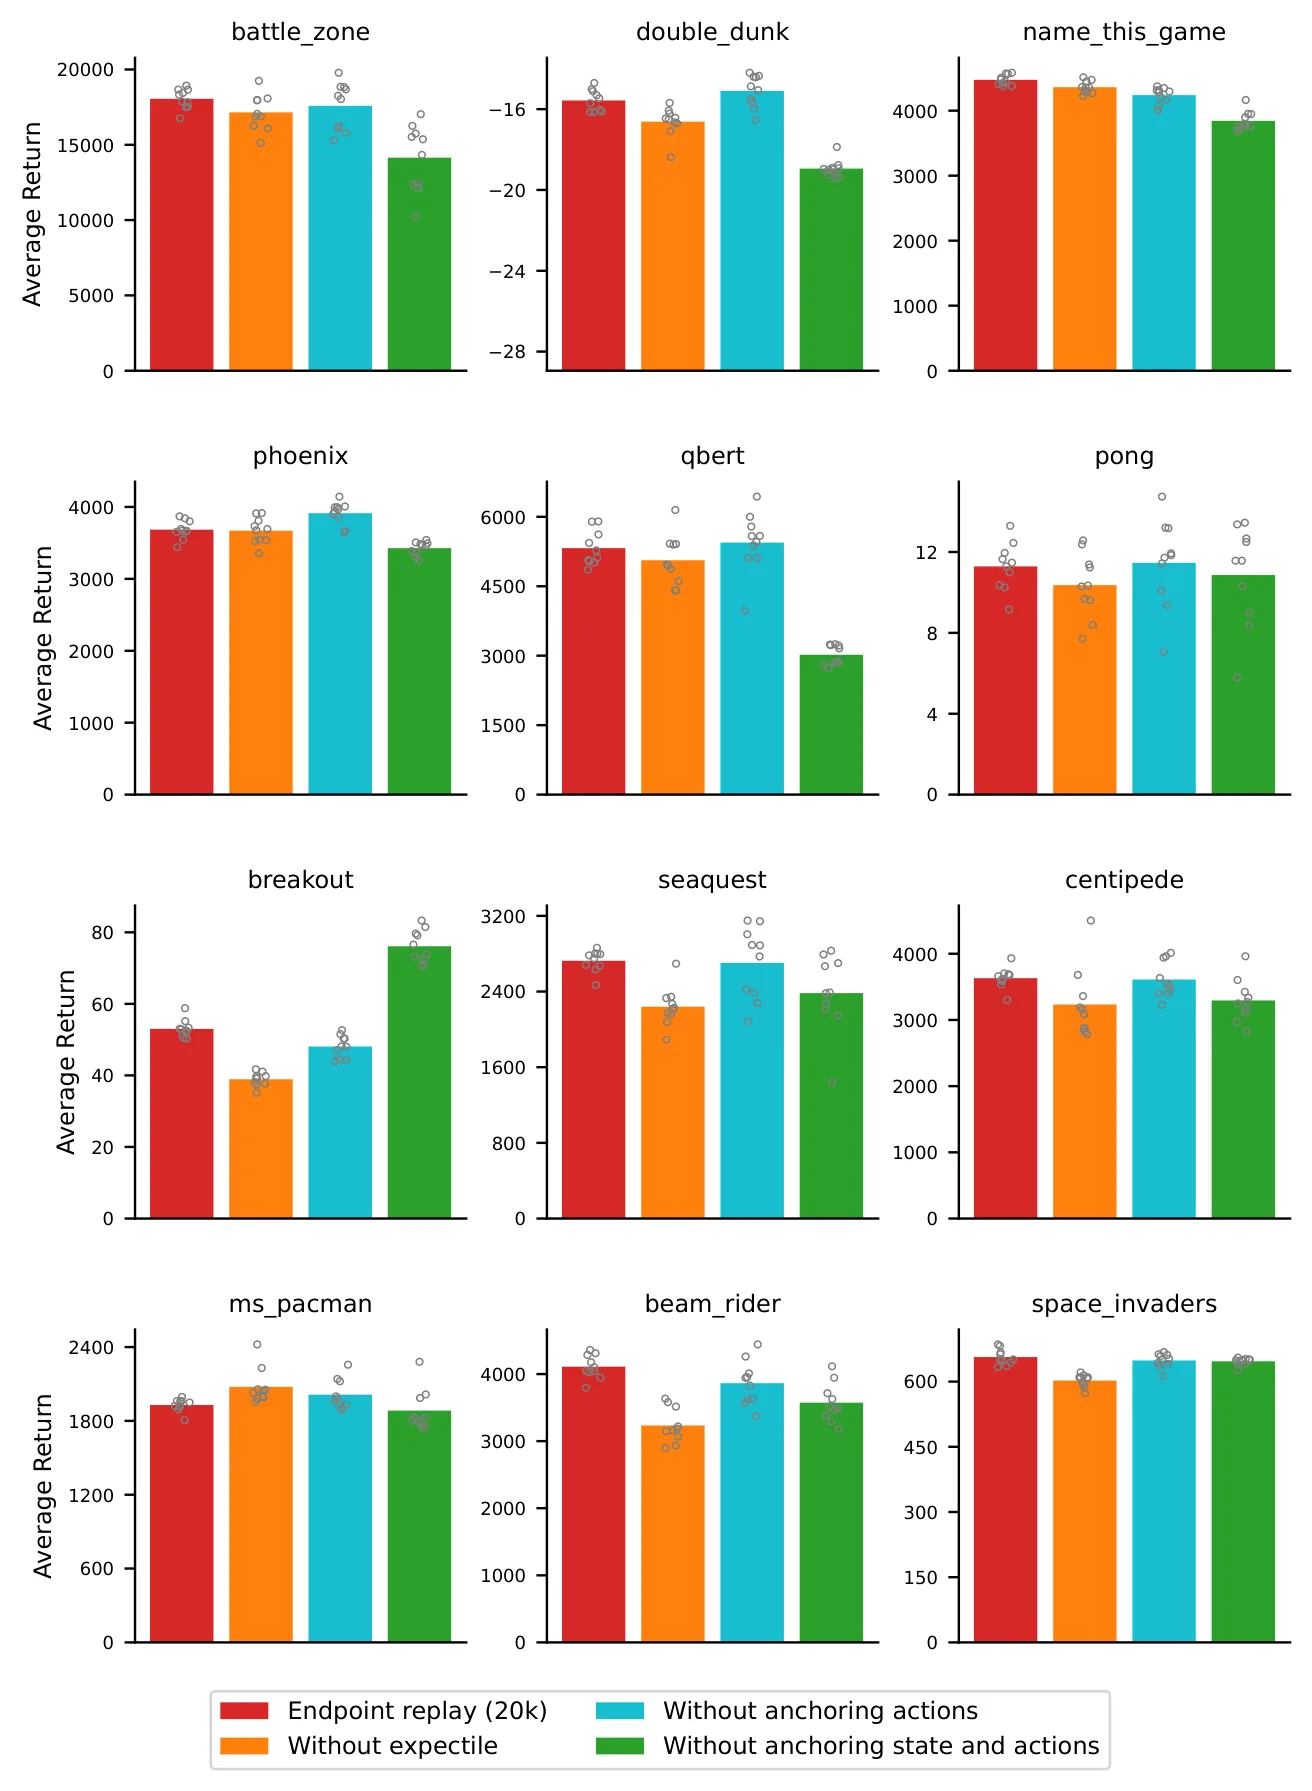
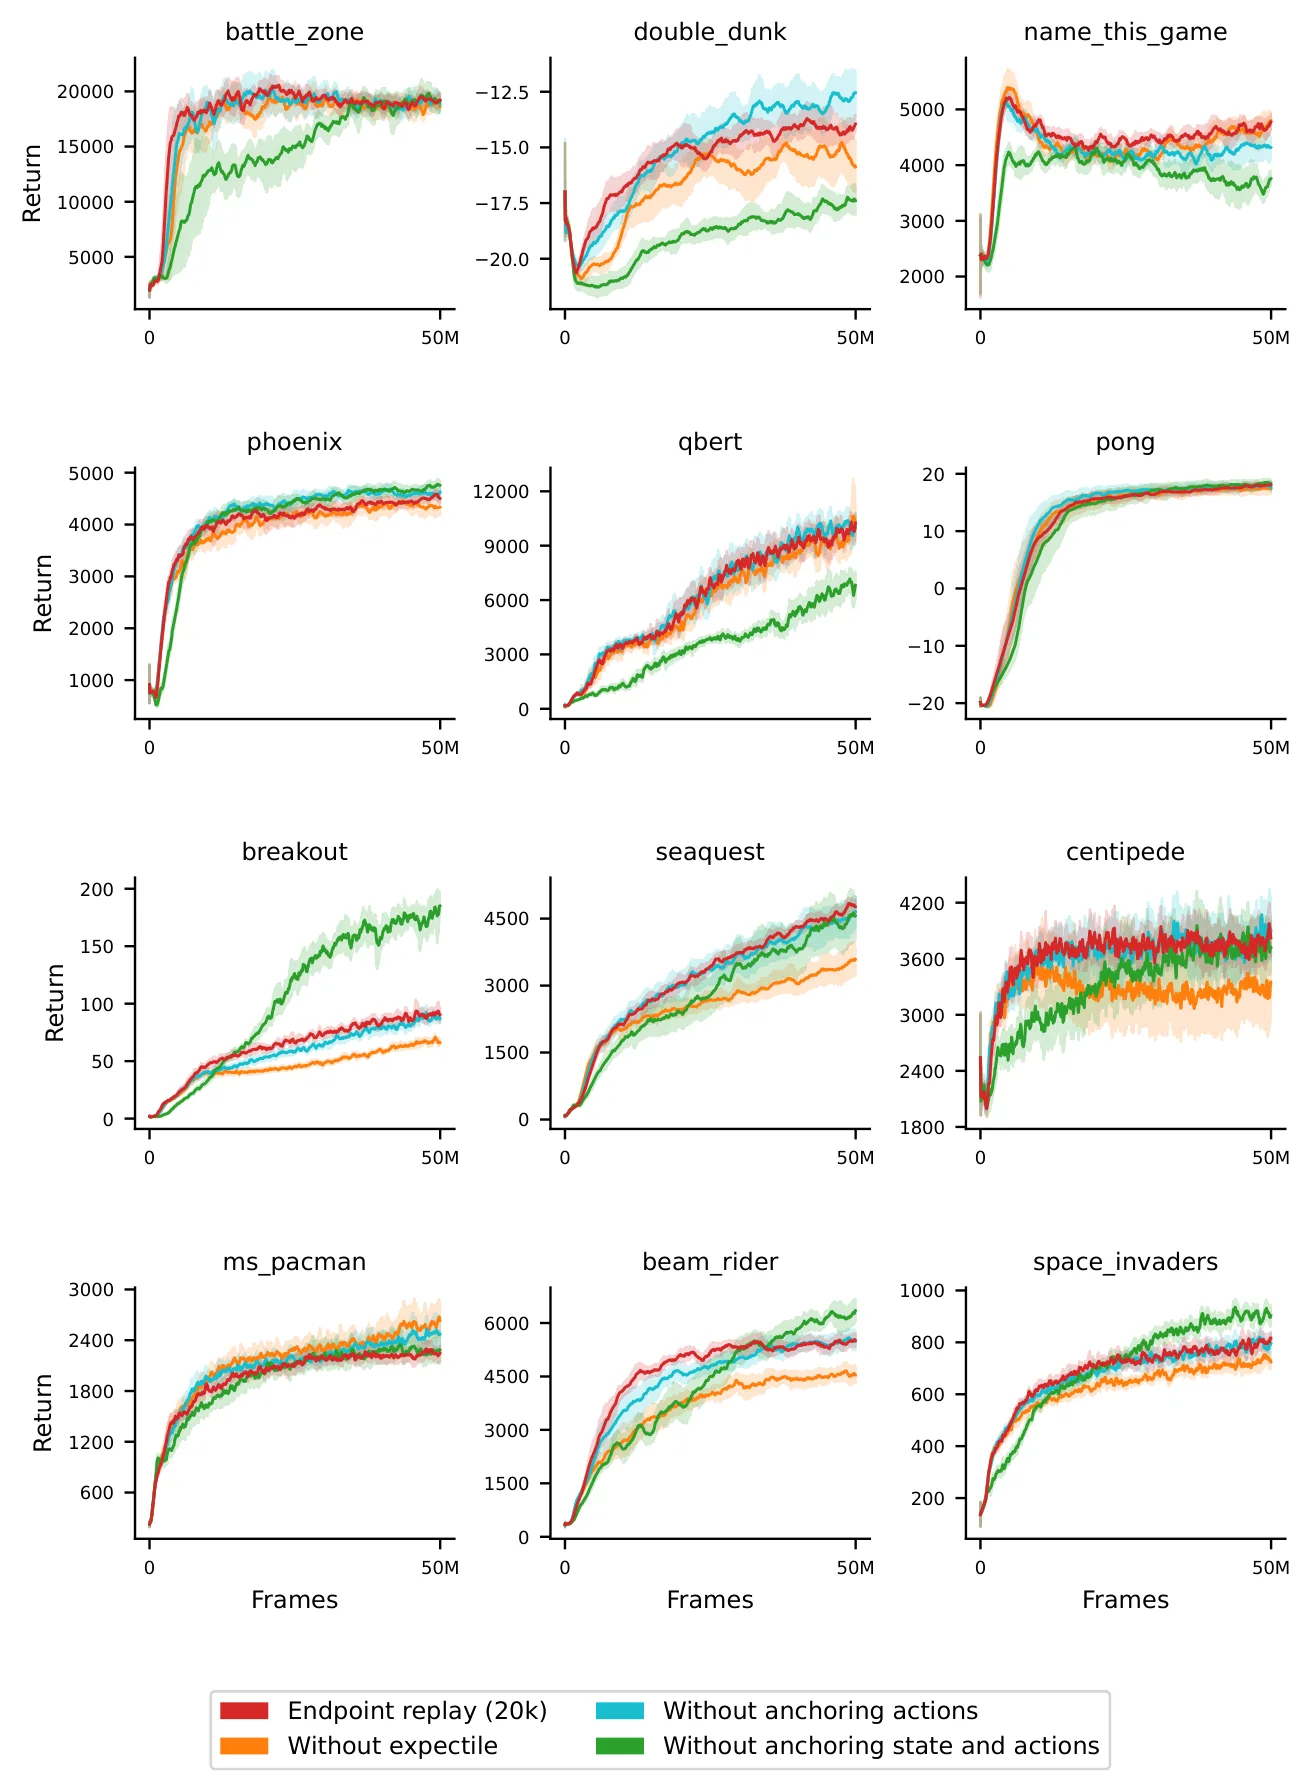
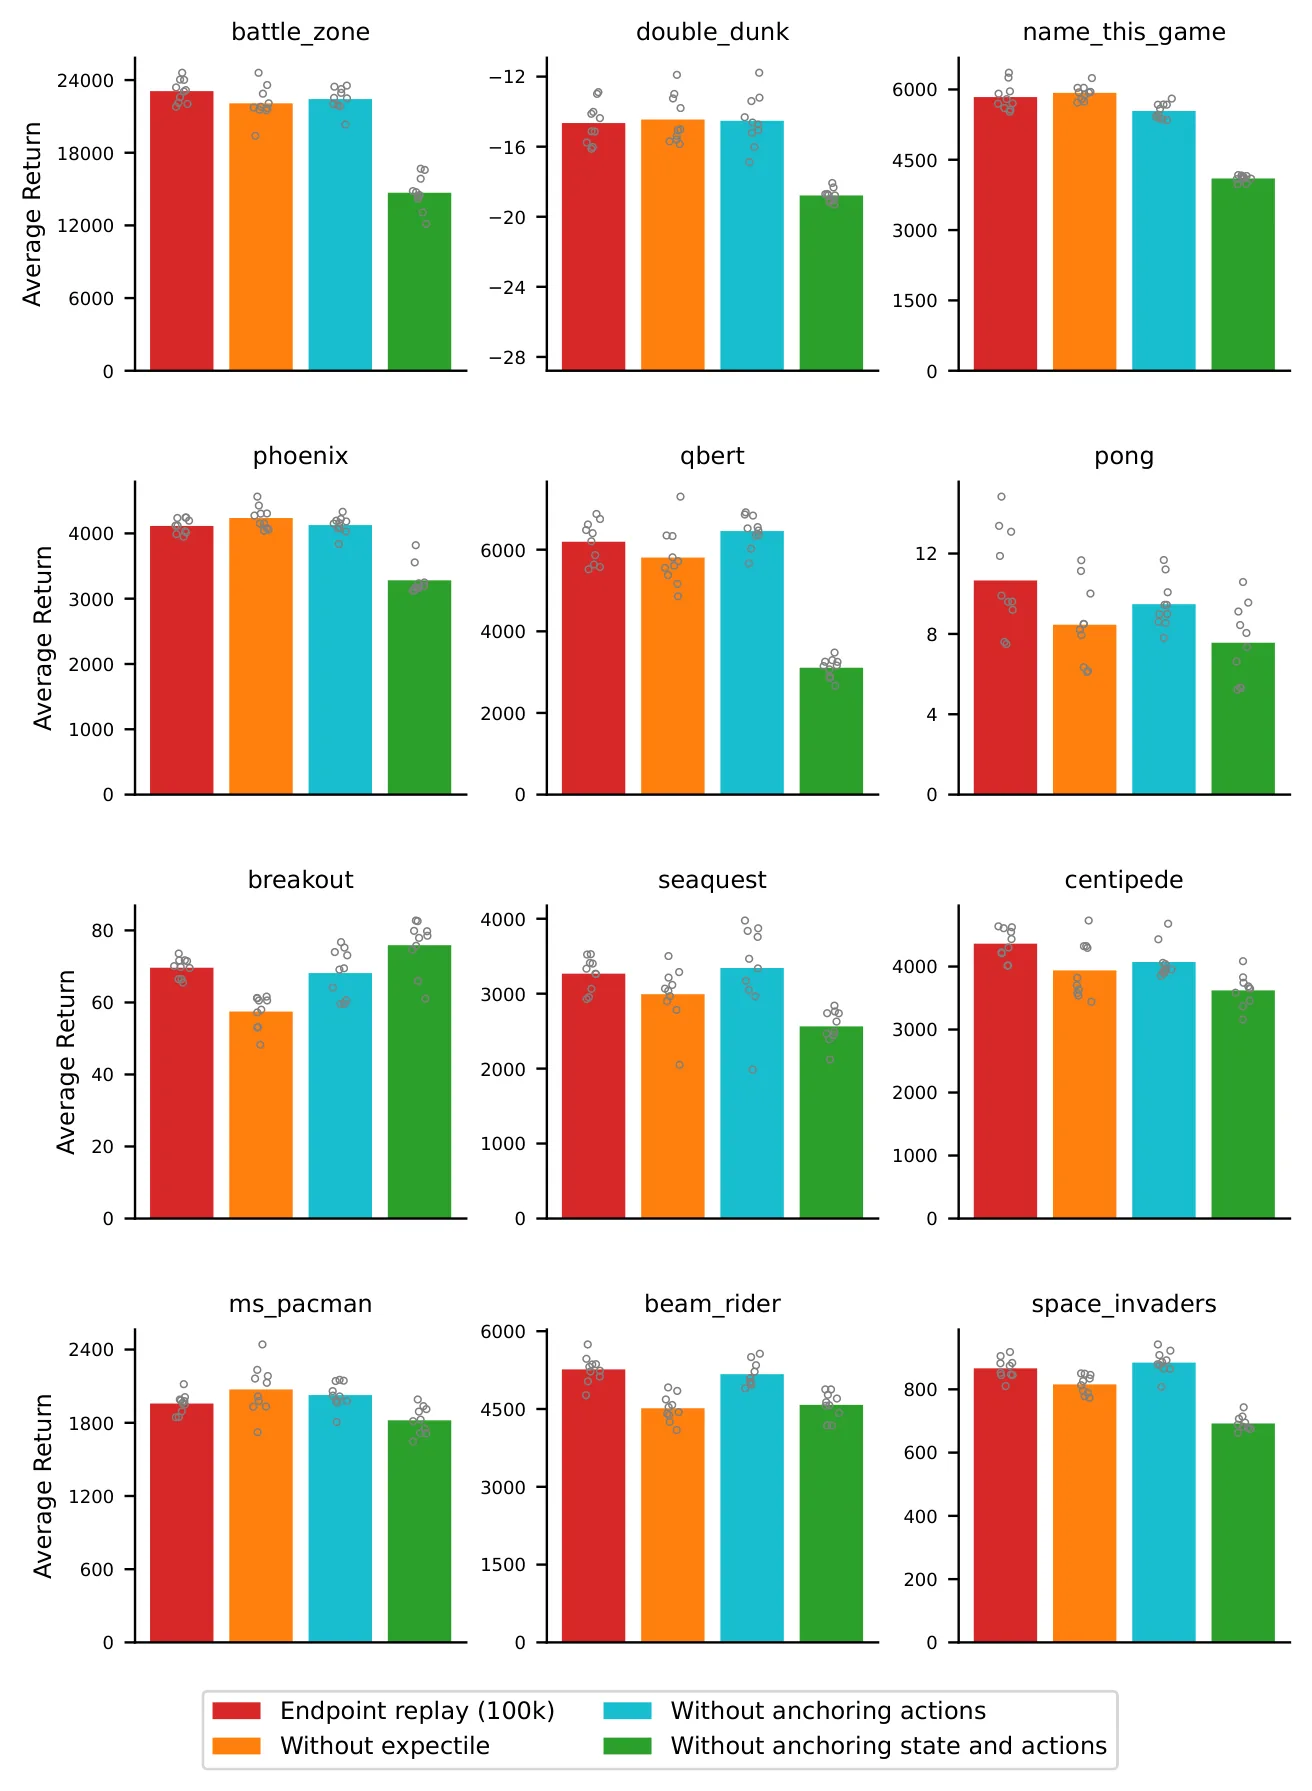
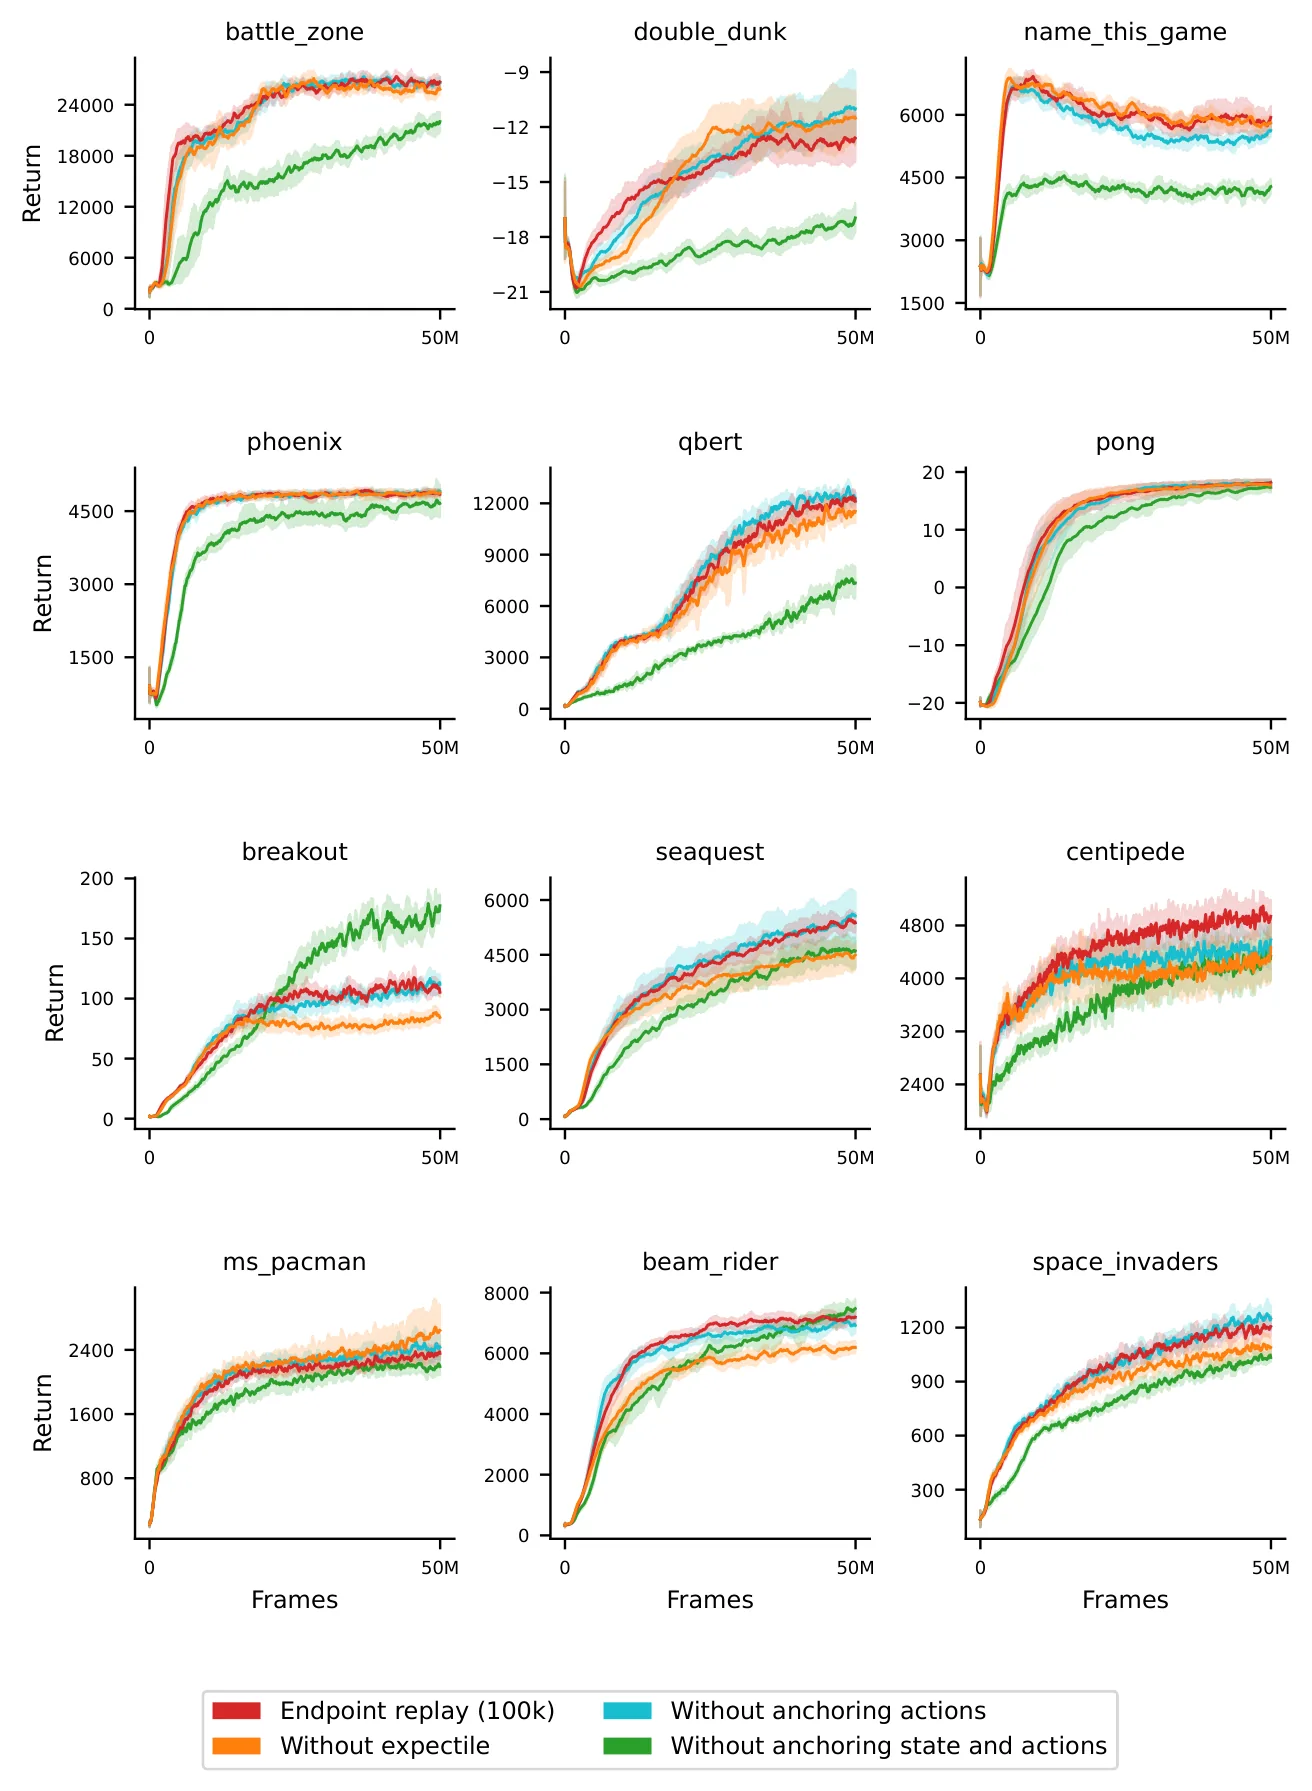
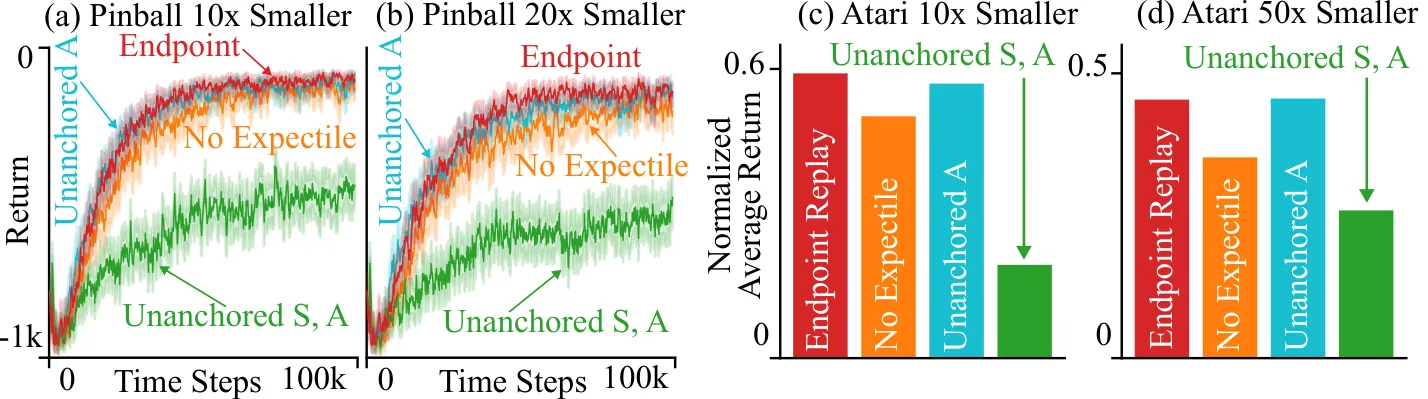
消融实验进一步揭示了各组件的贡献:去掉 expectile 损失后性能显著下降,尤其在 20× 压缩配置下以 93/120 败北,说明该组件对缓解悲观偏差至关重要;仅去掉 action 锚定(改用 DDQN 而非 SARSA)的差异在 Atari 中未达统计显著,但仍优于完全无锚定的版本。
值得注意的一个现象是,在某些 Atari 游戏中,Endpoint Replay 略逊于大缓冲区基线。作者将这一现象归因于小缓冲区在某些任务上本就可能优于大缓冲区的已知现象(Fedus et al., 2020),而非方法本身的缺陷。
讨论与可借鉴点
Endpoint Replay 的核心价值在于揭示了一个此前未被系统研究的问题——[[bootstrap]] 目标中的锚定缺失如何导致朴素压缩策略失效。这一定性分析具有超越本文的通用意义,为后续的缓冲区压缩研究提供了明确的失败模式诊断。
从工程角度看,该方法提供了清晰的实用配置:默认 : = 、采样比 、、,这为后续工作提供了可复现的基线设置。算法仅需在标准 DQN 框架上增加三段缓冲和一种非对称损失函数,实现成本较低。
然而,该方法也存在明确的应用边界。首先,expectile 损失在面对高随机性 MDP 时会"追逐环境随机性",可能加剧而非缓解价值估计偏差——论文仅在确定性或低随机性环境中验证其安全性。其次,-step Expectile 贪心在理论上可能产出期望回报更低的策略(论文给出了一个确定性 MDP 反例),这一现象在实验中有待进一步量化。此外,方法目前仅针对 DQN 家族的 value-based 算法,对策略梯度方法(SAC、PPO 等)的适用性尚不明确。
总体而言,Endpoint Replay 为降低 DRL 存储开销提供了一条可行路径,同时通过理论与实验的结合深化了我们对回放缓冲区作用机制的理解。对于资源受限场景和持续学习应用,这一方法值得作为 baseline 进行尝试和进一步改进。
摘要
经验回放仍然是深度强化学习(DRL)工具箱中最实用、最有用的算法工具之一。除了优先级回放的有限成功以及针对大型异步系统的专门方法外,大多数 DRL 算法都使用一个大型的均匀采样的近期回放缓冲区——其大小甚至一直未变,保持在一百万。我们能否存储更少的数据、减少冗余,或更有效地将经验串联起来以加速价值传播,同时仍能保留大型缓冲区的性能?在本文中,我们研究了一种简单的压缩方法,该方法存储由一系列相连的 步序列的端点所导出的代表性转移。通过在较小的近期回放缓冲区中精心筛选这些端点,我们的方法在保持与标准大型缓冲区相当的有效的记忆视野的同时,所需的存储量少了约一个数量级。通过经验评估,我们证明了这种方法能够避免朴素压缩策略中固有的系统偏差,并在 Pinball 环境与 Atari 2600 基准测试中达到与传统大型缓冲区相匹配的性能。
Abstract
Experience replay remains one of the most practical and useful algorithmic tools in the deep reinforcement learning (DRL) toolbox. Aside from the limited success of prioritized replay and specialized approaches for large asynchronous systems, most DRL algorithms make use of a large, uniformly sampled recency buffer---even the size, one million, remains unchanged. Could we store less data, reduce redundancy, or more effectively chain experience together to speed up value propagation and still retain the performance of large buffers? In this paper, we investigate a simple compression approach that stores representative transitions derived from the end-points of a chain of connected -step sequences. By curating these end-points in a smaller recency buffer, our method maintains an effective memory horizon comparable to a standard large buffer while requiring an order of magnitude less storage. Through empirical evaluation, we demonstrate that this approach prevents the systematic bias inherent in naive compression strategies and matches the performance of traditional large buffers in the Pinball environment and the Atari 2600 benchmark.
论文详细总结(自动生成)
论文总结:Endpoint Replay:压缩深度强化学习中的近期回放缓冲区
1. 核心问题与研究动机
- 背景:自 DQN 以来,几乎所有 off-policy 深度强化学习(DRL)算法都沿用同一套经验回放"配方"——容量约一百万的 FIFO 近期缓冲区(recency buffer)+ 均匀采样。该设计自 DQN 以来近十年未发生本质变化,存储开销巨大、冗余明显。
- 核心问题:能否将 recency buffer 的容量压缩 10× 至 50×,同时保持大缓冲区的性能?这一目标与持续 RL 中压缩缓冲区以应对非平稳性、以及 MeDQN 等方法压缩缓冲区以节省资源的路线不同——本文目标是保留大缓冲区的优势(更长记忆跨度、稀疏奖励传播、抗灾难性遗忘等),而非彻底消除回放。
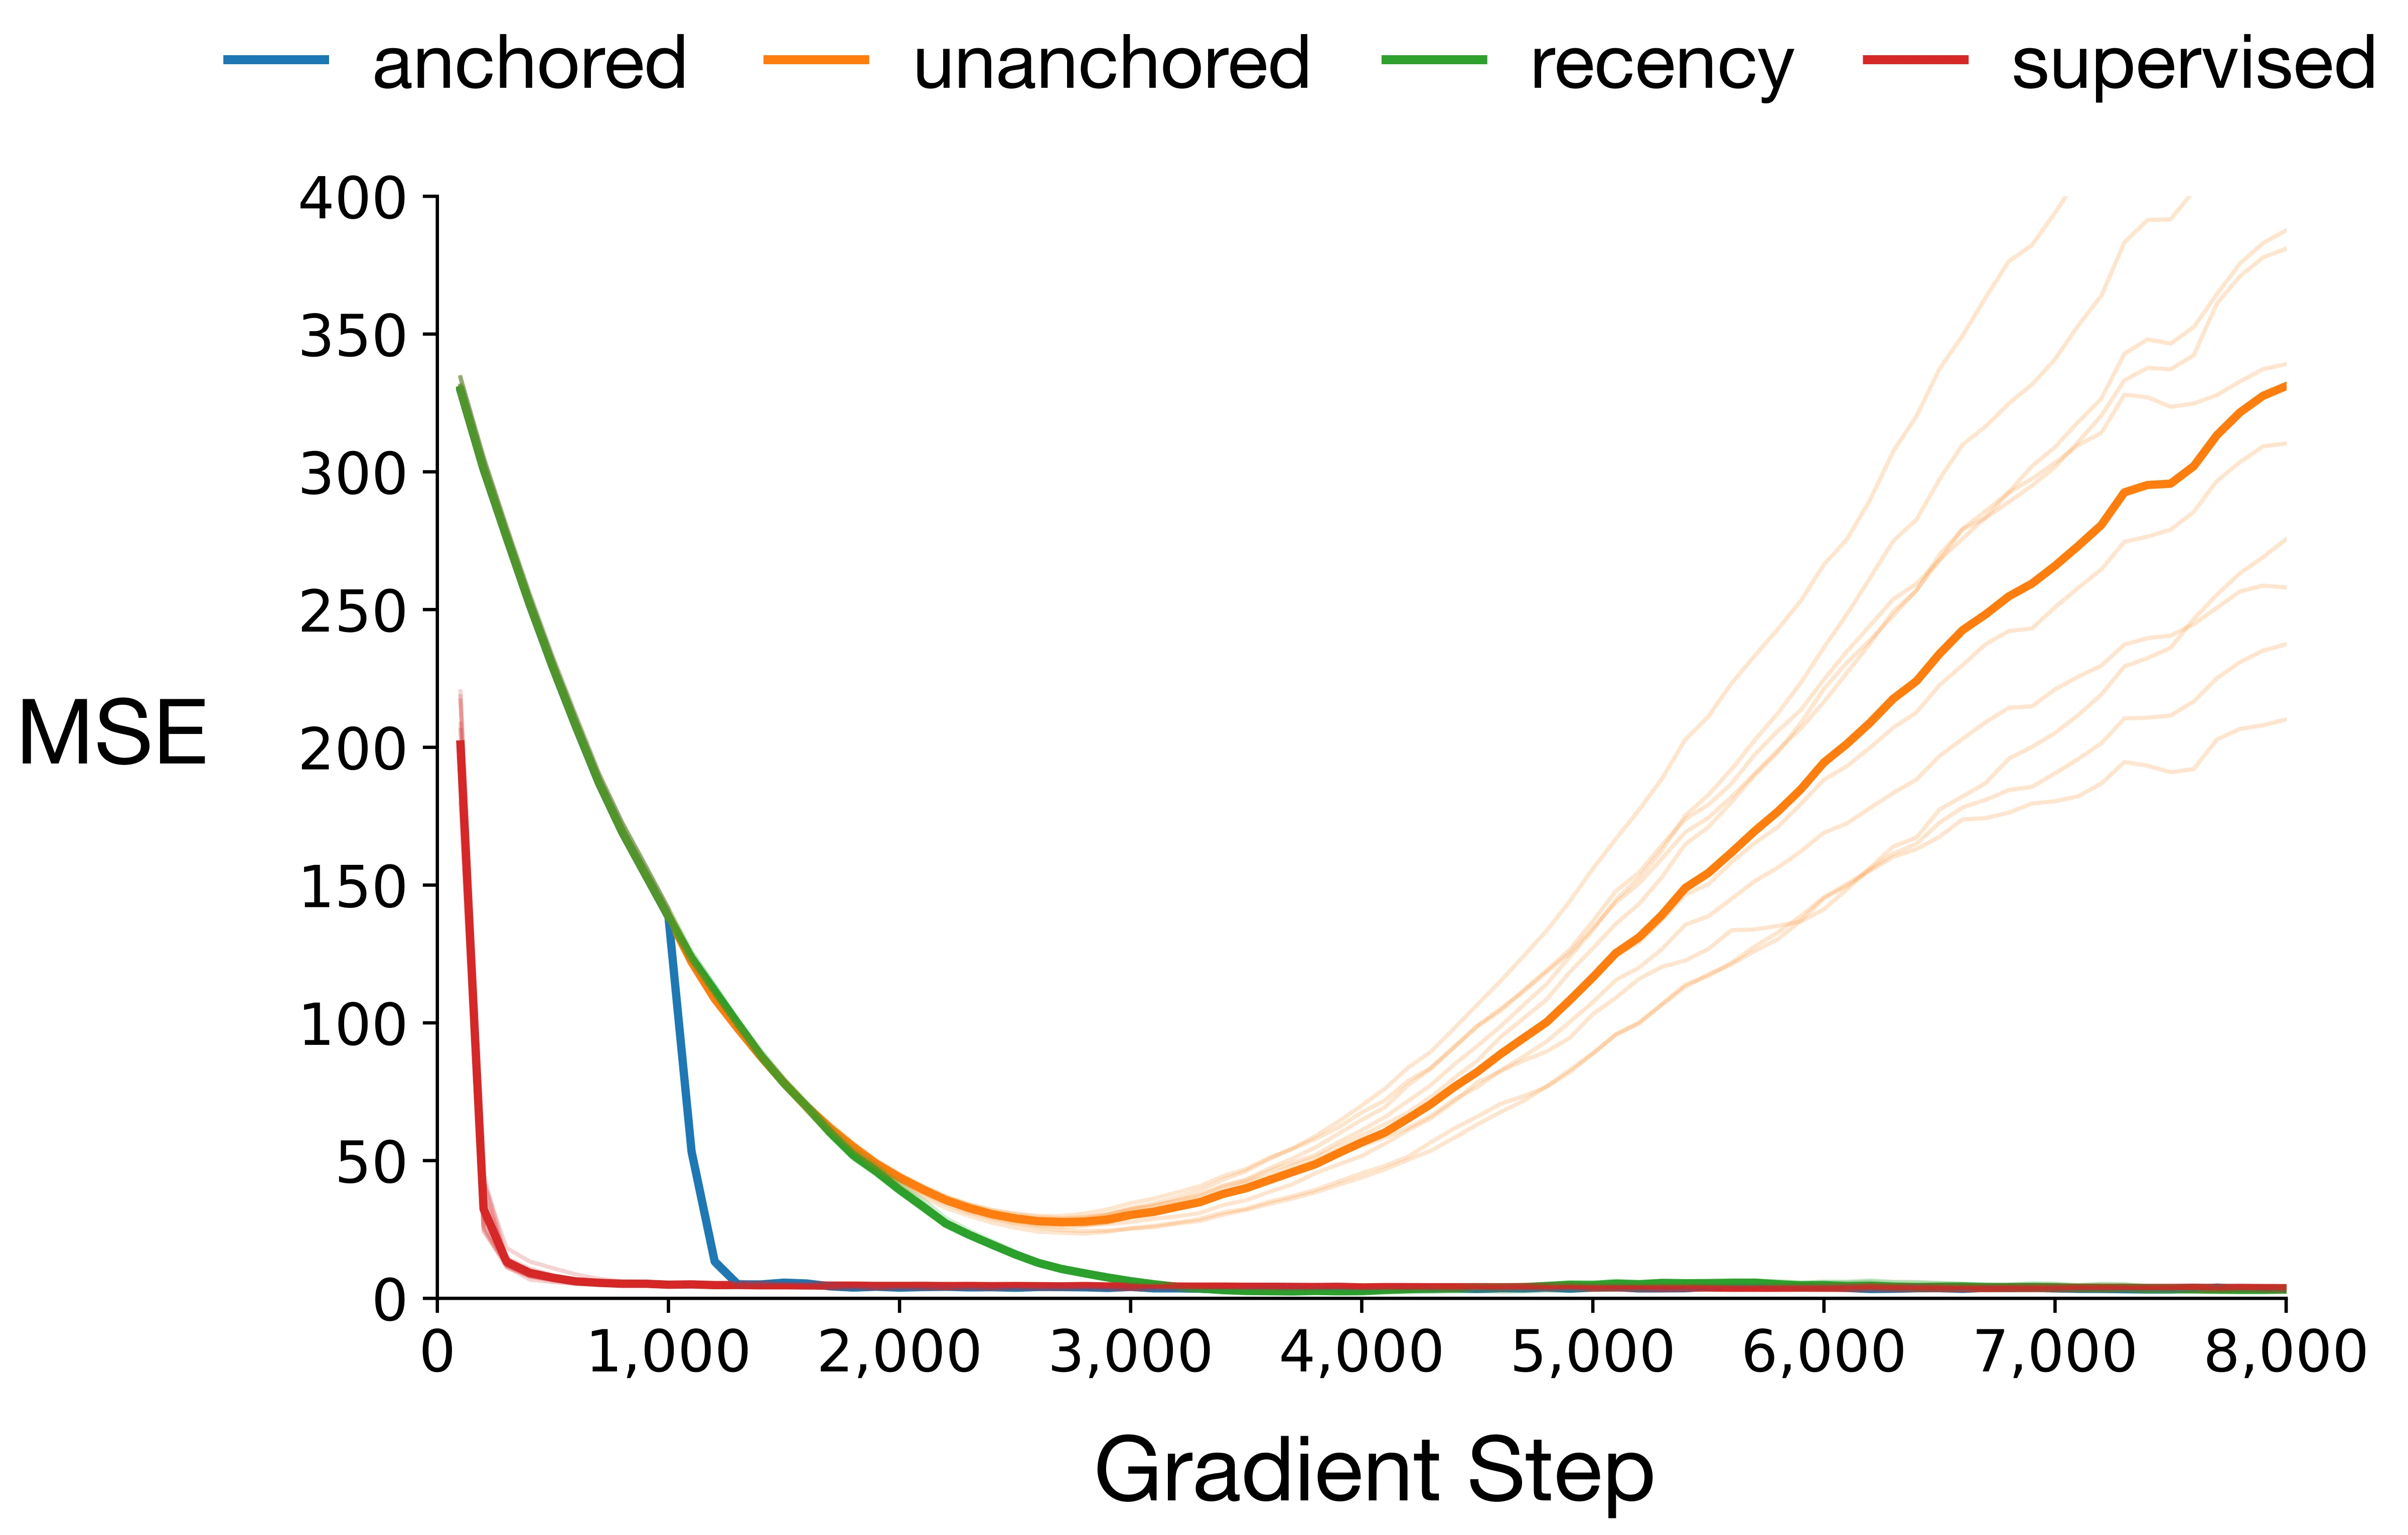
- 关键洞察:朴素压缩策略(如 reservoir sampling、间隔采样、独立 transition coreset)会引发一个之前未被识别的问题——无锚定 bootstrap 目标(unanchored bootstrap targets):被压缩后的 coreset 中的转移是孤立的,其 bootstrap 状态-动作对 本身不会被任何转移更新,导致 Q 值被泛化"漂移",价值估计严重失真。
2. 方法论
2.1 核心思想
Endpoint Replay 由两个缓冲区和一个修正的损失函数组成:
- 小型近期缓冲区 :存储最新的 条 1-step 转移,用于标准 DDQN 更新。
- 压缩缓冲区 :存储从 老化出来的转移,但以链式 -step 元组形式:
通过将多个 1-step 转移压缩为单个 -step 转移,把中间状态丢掉,但保证 bootstrap 状态 本身也是 中另一条 -step 元组的起点——从而实现"锚定"。
- 滞后缓冲区(lag buffer):缓存最多 条刚从 推出的转移,满 条(或遇到终止步 )后聚合成一个 -step(或 -step)转移写入 。
2.2 Expectile Sarsa:缓解 -step 目标的悲观偏差
在控制场景下,-step 目标来自较旧、次优策略,存在悲观偏差。为此引入 -step Expectile Sarsa,即对 的样本使用非对称损失:
其中目标为 (用数据集中真实动作而非 max,保证 action 也被锚定)。 上的样本仍使用标准 DDQN 更新;批采样按 比例(默认 )。
2.3 理论结果
- -step Expectile Bellman 算子的收敛性(定理 1):对任意 、, 是 -压缩:
保证唯一不动点 (相应地 )存在。
- 不同 之间的序关系(定理 2):对 、:
即步长越长,-step expectile 值越小(嵌套 expectile 更大)。
- 策略迭代收敛(定理 3 + 推论 1):在单调 expectile 贪心条件 紧致且对贪心封闭假设下,策略迭代收敛到 内最优 ;当环境动力学确定时, 即标准最优策略。
- 反直觉例子(命题 1):在确定性 MDP 中,expectile 贪心可能产出比当前策略期望回报更低的策略。
3. 实验设计
3.1 环境与基准
| 环境 | 说明 |
|---|---|
| Pinball | 4 维状态,5 动作,连续物理导航;奖励设为 /步,最大 1000 步终止 |
| Atari 2600(12 个游戏) | Atari-5(Bellemare 等精选)+ 7 个多样性问题(Pong、Breakout、Seaquest、Centipede、Ms. Pac-Man、Beam Rider、Space Invaders) |
3.2 对比基线
- 大 recency 缓冲区:Pinball 10k;Atari 1M(标准配置)
- 小 recency 缓冲区(10×/20×/50× 压缩):1-step DDQN 与 10-step DDQN 两个变体
- Reservoir sampling coreset(Isbelle & Cosgun, 2018)
- MeDDQN(Lan et al., 2022,DDQN 版)—— Pinball 含此基线,Atari 因计算成本省略
- Interval coreset(每 步采一条独立转移)
- 消融:无 expectile(Squared loss)、仅无 action 锚定、无 state & action 锚定
3.3 超参数
- 网络:Pinball 两层 32 单元 ReLU;Atari 标准 DQN 卷积网络
- 优化器:Adam;学习率沿用大缓冲区基线调优值(Pinball ;Atari )
- (所有实验固定);批大小 32;采样比 (:);
4. 资源与算力
- 论文未明确披露所用 GPU 型号与数量、集群规模、训练总机时等算力信息。
- 仅可从实验规模间接推断:
- Pinball 实验在 100 个独立随机种子上运行,训练 50k–100k 步;
- Atari 实验在 12 个游戏 × 10 个种子 × 50M 帧下进行,加上消融、20k 与 100k 两个缓冲区配置,总训练量较大;
- Atarti 环境设置采用粘性动作(sticky actions),关闭 no-op,使用 Dopamine 代码框架。
5. 实验数量与充分性
| 类别 | 数量 |
|---|---|
| Pinball 主实验(图 3a/3b) | 2 缓冲区规模(1k、500)× 100 种子 |
| Pinball 受控实验(图 1、图 2) | 100 种子 |
| Atari 主实验(图 3c/3d) | 12 游戏 × 10 种子 × 2 缓冲区规模 |
| Atari 消融(图 4) | 3 消融项 × 2 缓冲区规模 × 12 游戏 × 10 种子 |
| 个体游戏图(补充) | 每个游戏都给出学习曲线与误差棒 |
- 充分性:
- 覆盖了预测与控制两种设定,分别验证 unanchored 问题;
- 在两个迥异的环境族(连续低维 Pinball vs. 高维像素 Atari)上验证;
- 多组消融清晰区分了 expectile 与锚定的贡献;
- 使用 Sign test()报告统计显著性;
- 在 Atari 100k 配置下以 82/120 胜出 Small、20k 配置下 80/120 胜出 Small;expectile 消融在 100k 与 20k 配置下分别以 79/120 与 93/120 胜出。
- 可能的客观性顾虑:
- Atari 仅 12 个游戏(远少于 57 或完整 100+),对 50 游戏的代表性有限;
- 50M 帧的训练长度对于部分复杂游戏可能不足以充分收敛;
- 部分 Atari 游戏中 Endpoint replay 略输于大基线,作者归因于 small buffer 在某些游戏本就可能优于 large buffer 的现象(Fedus et al., 2020; Zhang & Sutton, 2017)。
6. 主要结论与发现
- 10×–50× 压缩有效:Endpoint Replay 在 Pinball 与 12 个 Atari 游戏上,使用仅 10%–2% 存储即可匹配甚至略微超过大缓冲区的性能。
- Unanchored bootstrap 是朴素 coreset 失败的根因:在预测与控制实验中独立证明该机制,并展示 chaining -step 元组 + SARSA(而非 max)更新可消除之。
- Expectile 损失缓解悲观偏差:消融显示去掉 expectile 后性能显著下降,尤其在 20× 更小配置(93/120 种子胜出)。
- Action 锚定贡献次要:Sarsa vs. DDQN 差异在 Atari 中未达统计显著,但仍优于无 action 锚定。
- 理论保证:首次给出 -step()Expectile Bellman 算子的 -压缩性、唯一不动点、不同 值的序关系以及(确定性环境下)策略迭代收敛至最优策略的证明。
7. 优点
- 识别并形式化了一个新问题——unanchored bootstrap targets——不仅解释了过去 coreset 工作的失效,还与离线 RL 中"out-of-sample action"问题建立了清晰联系。
- 理论与实践结合紧密:不仅给出算法,还提供完整的 Bellman 算子收敛性证明、序关系定理与策略迭代收敛定理,并把 的选择与偏差-方差保守性联系起来。
- 算法简洁实用:仅需在 DQN 框架中加入 / / 滞后缓冲三段、一种 损失、混合批次采样,工程实现成本低。
- 实验设计细致:预测 + 控制双重验证,Pinball + Atari 跨域,消融因素分明,统计检验(Sign test)规范。
- 明确的实用配比:默认 : = 、采样比 、、 为后续工作提供可复现基线。
8. 不足与局限
- 高随机性环境:作者明确指出 expectile 损失会"追逐环境随机性"(把高方差奖励的右尾拉高),因此在高随机性 MDP 中可能不适用,仅在确定性或低随机性环境中安全;可通过 衰减到 0.5 部分缓解,但未在随机环境中系统验证。
- 理论上的策略改善不等价于期望回报改善:命题 1 反例说明 expectile 贪心可能产出期望回报更低的策略;这一差距在实验中未量化讨论。
- Atari 覆盖度有限:仅 12 个游戏,且训练 50M 帧,对部分复杂游戏可能未充分收敛;与 MeDDQN 的 Atari 对比因算力被省略。
- MeDDQN 排除的可能原因:作者在 Pinball 中对 MeDDQN 调优后表现仍较差,归因于其需随机生成状态-动作对,在带障碍物的 Pinball 中常生成无效样本;但这一现象是否在 Atari 中同样存在未经验证。
- 更新密度权衡:coreset 样本期望更新数被刻意压低以模拟"大缓冲区里的低更新频率",但代价是 coreset 容量若进一步缩小,性能可能下降——论文未系统研究容量-性能边界。
- 应用范围:方法针对 DQN 家族的 off-policy value-based 算法,未涉及策略梯度方法(SAC、PPO 等),也未与生成式回放(synthetic replay)或分布式 RL 框架结合测试。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。