
套娃智能体:面向长周期机器学习工程的子智能体展开
Matryoshka Agent: Unfolding Sub-Agents for Long-Horizon Machine Learning Engineering
📝 TLDR
机器学习工程任务需要长链路决策与迭代调试,单体Agent难以同时处理超长噪声上下文与庞大解空间。本文提出分层Agent框架Matryoshka Agent,由高层Orchestrator维持紧凑探索状态并下发策略指令,低层Sub-Agent通过标准化工具接口直接与环境交互执行方案。实验显示Qwen3-4B-Instruct作Orchestrator性能可比o4-mini,Qwen3-30B-Coder获得最高36.7%相对提升,验证了框架的有效性与可扩展性。
🧭 速览
单Agent处理MLE长链路任务时同时面临超长噪声上下文、庞大解空间与有限模型容量的三重压力,难以兼顾策略探索与具体执行。
分层Agent框架:Orchestrator维护紧凑探索状态并下发战略指令,Sub-Agent经标准化Tool接口执行具体方案,并配合高效训练范式。
Qwen3-4B-Instruct作Orchestrator性能接近o4-mini;Qwen3-30B-Coder取得最高36.7%相对性能提升,多模型多任务验证框架有效。
Matryoshka Agent解耦策略探索与执行,降低长上下文推理负担,是长链路MLE与复杂智能体任务的可扩展高效范式。
🆚 方法对比
Matryoshka Agent
- 解耦策略探索与执行,降低长上下文负担
- Qwen3-4B达o4-mini级Orchestrator性能
- Qwen3-30B-Coder获最高36.7%相对增益
- 适用于多种模型类型与规模,扩展性强
- 多层协调增加系统复杂度
- 依赖工具层接口设计与实现质量
- 训练范式设计与调试成本较高
Orchestrator
- 维护紧凑跨轮状态,减少上下文噪声
- 高层策略决策与执行解耦清晰
- 通过轨迹级排序RL高效优化
- 依赖准确的状态摘要质量
- 策略决策质量直接影响整体效果
Sub-Agents
- 使用全新上下文,避免历史噪声累积
- 专注具体方案实现、运行与调试
- 直接与环境交互,反馈及时准确
- 缺乏长程记忆能力
- 与Orchestrator协调存在通信开销
Solution Refinement Tree采样
- 复用共享执行前缀,降低环境交互成本
- 收集结构化方案对比作为偏好信号
- 支持高效生成轨迹级训练数据
- 树结构构造实现复杂度较高
- 依赖有效的前缀共享机制设计
轨迹级排序强化学习
- 提供轨迹级偏好信号,优化Orchestrator
- 在线排序学习适配昂贵环境交互
- 支持Orchestrator高效策略改进
- 对奖励信号与对比质量较敏感
- 训练稳定性受采样策略影响
Monolithic Agent
- 架构简单,无需多层协调开销
- 信息流直接,无中间抽象层
- 需管理极长且含噪声的上下文
- 在有限模型容量下效果受限
- 探索广阔方案空间能力不足
Matryoshka Agent通过分层架构将策略探索与执行解耦,相比Monolithic Agent显著降低长上下文负担;其Orchestrator、Sub-Agents与Tools三层协同配合,配合Solution Refinement Tree采样和轨迹级RL实现高效训练,相比Matryoshka-Pilot等传统控制器-生成器框架在长程MLE任务上具有更好的可扩展性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
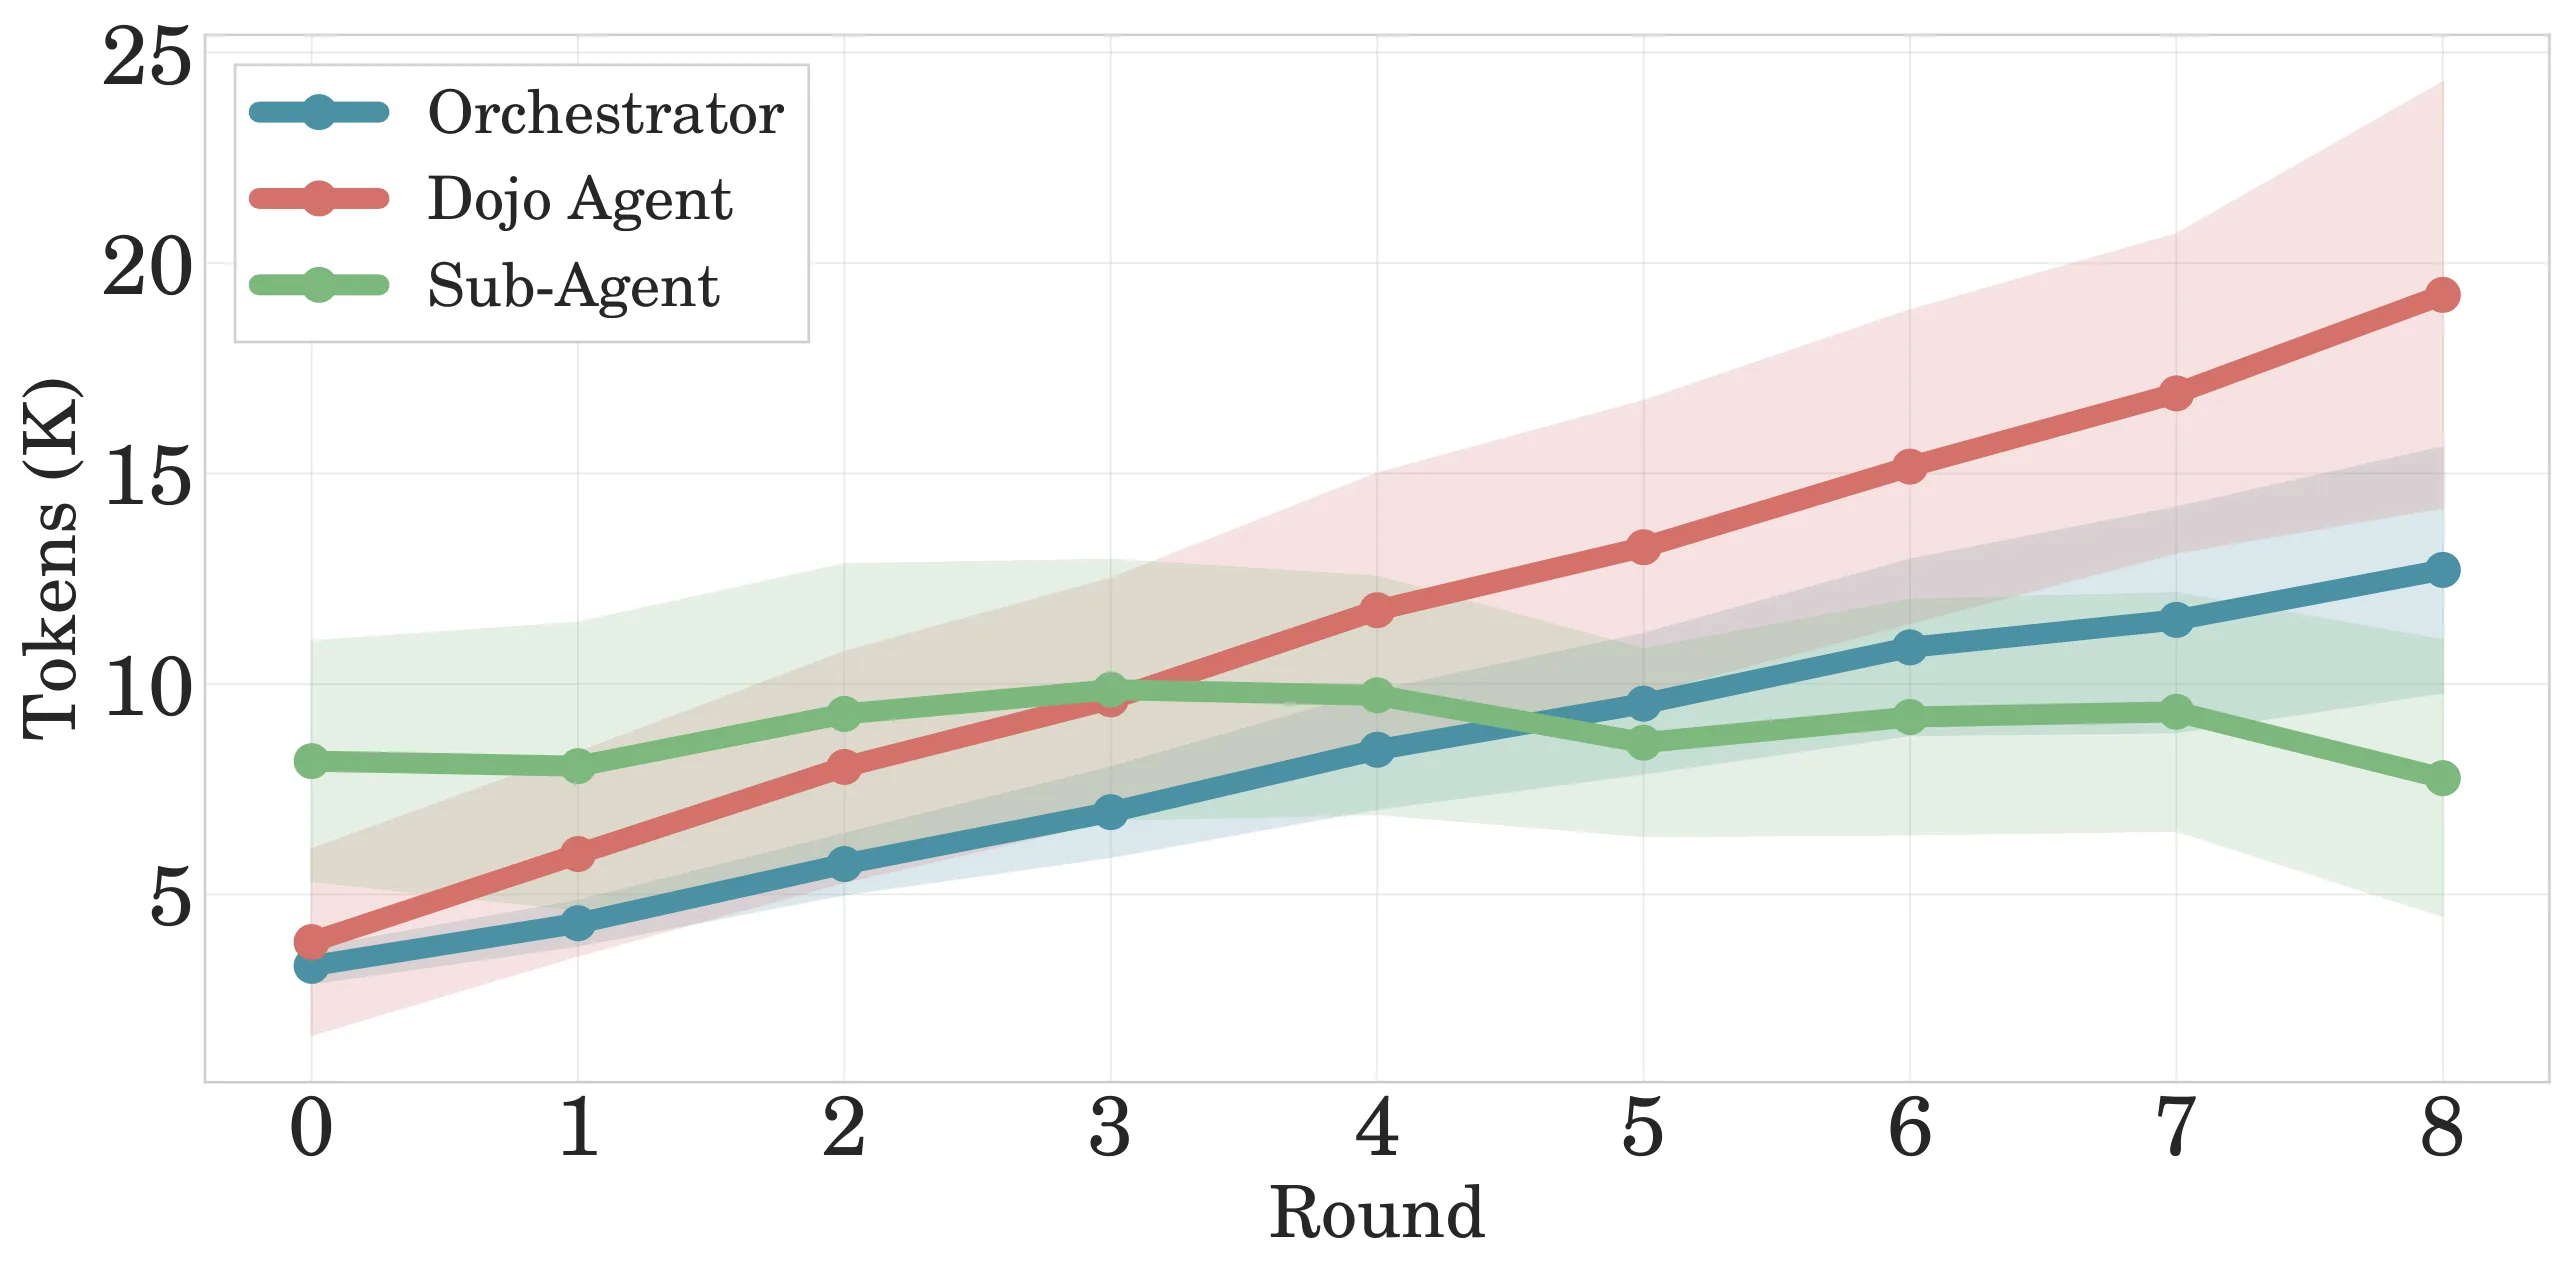
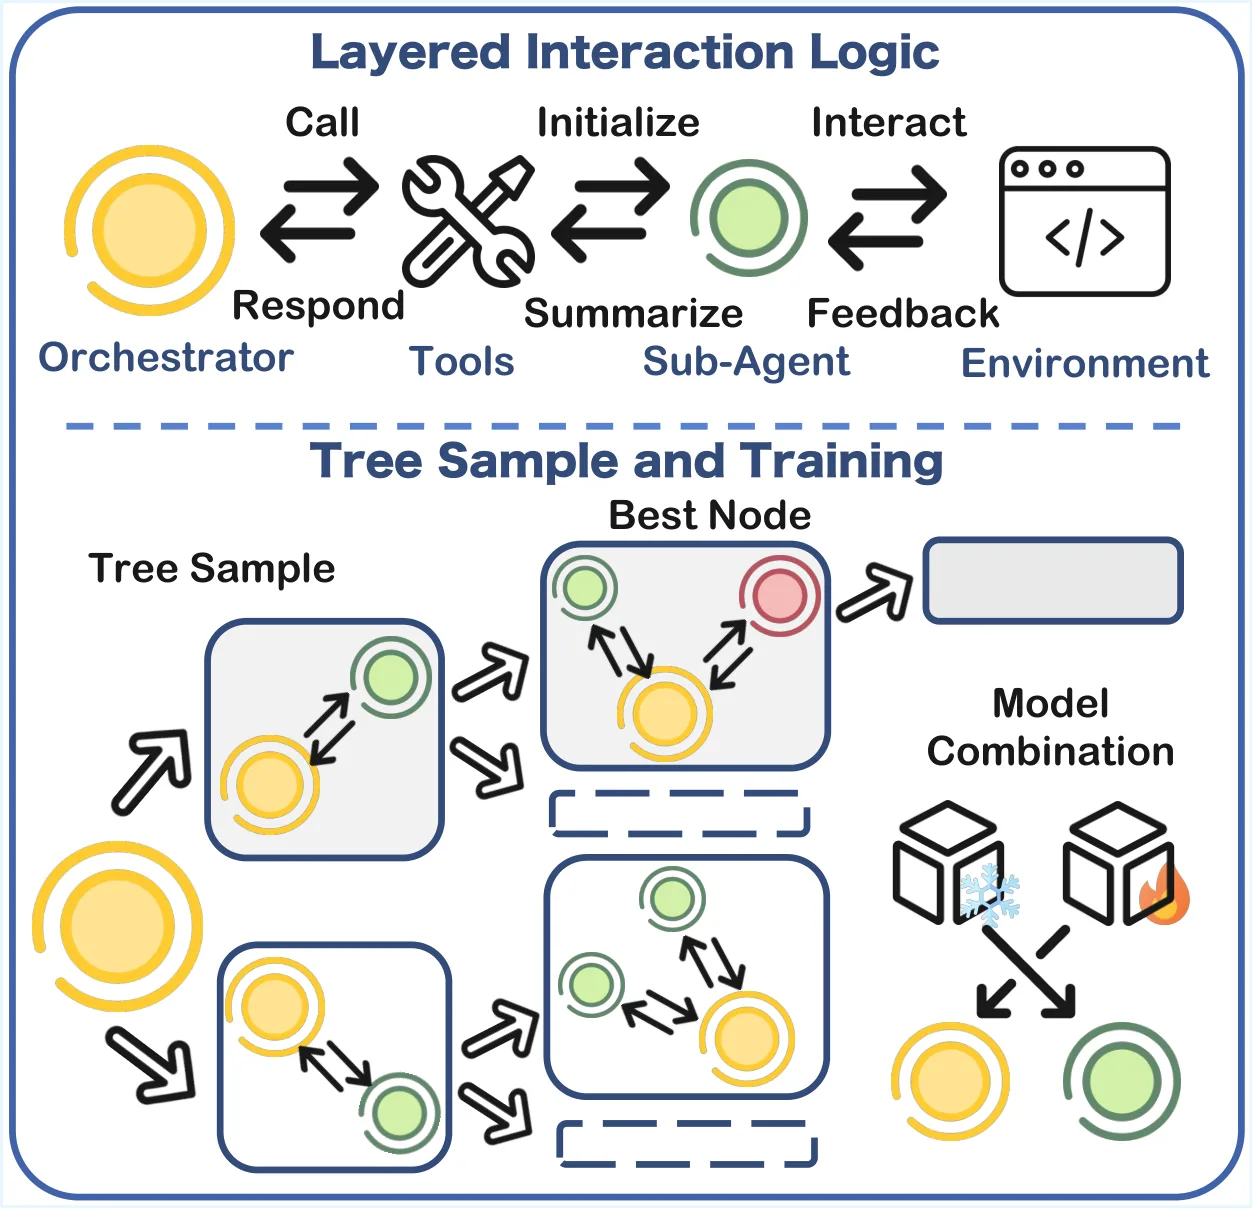
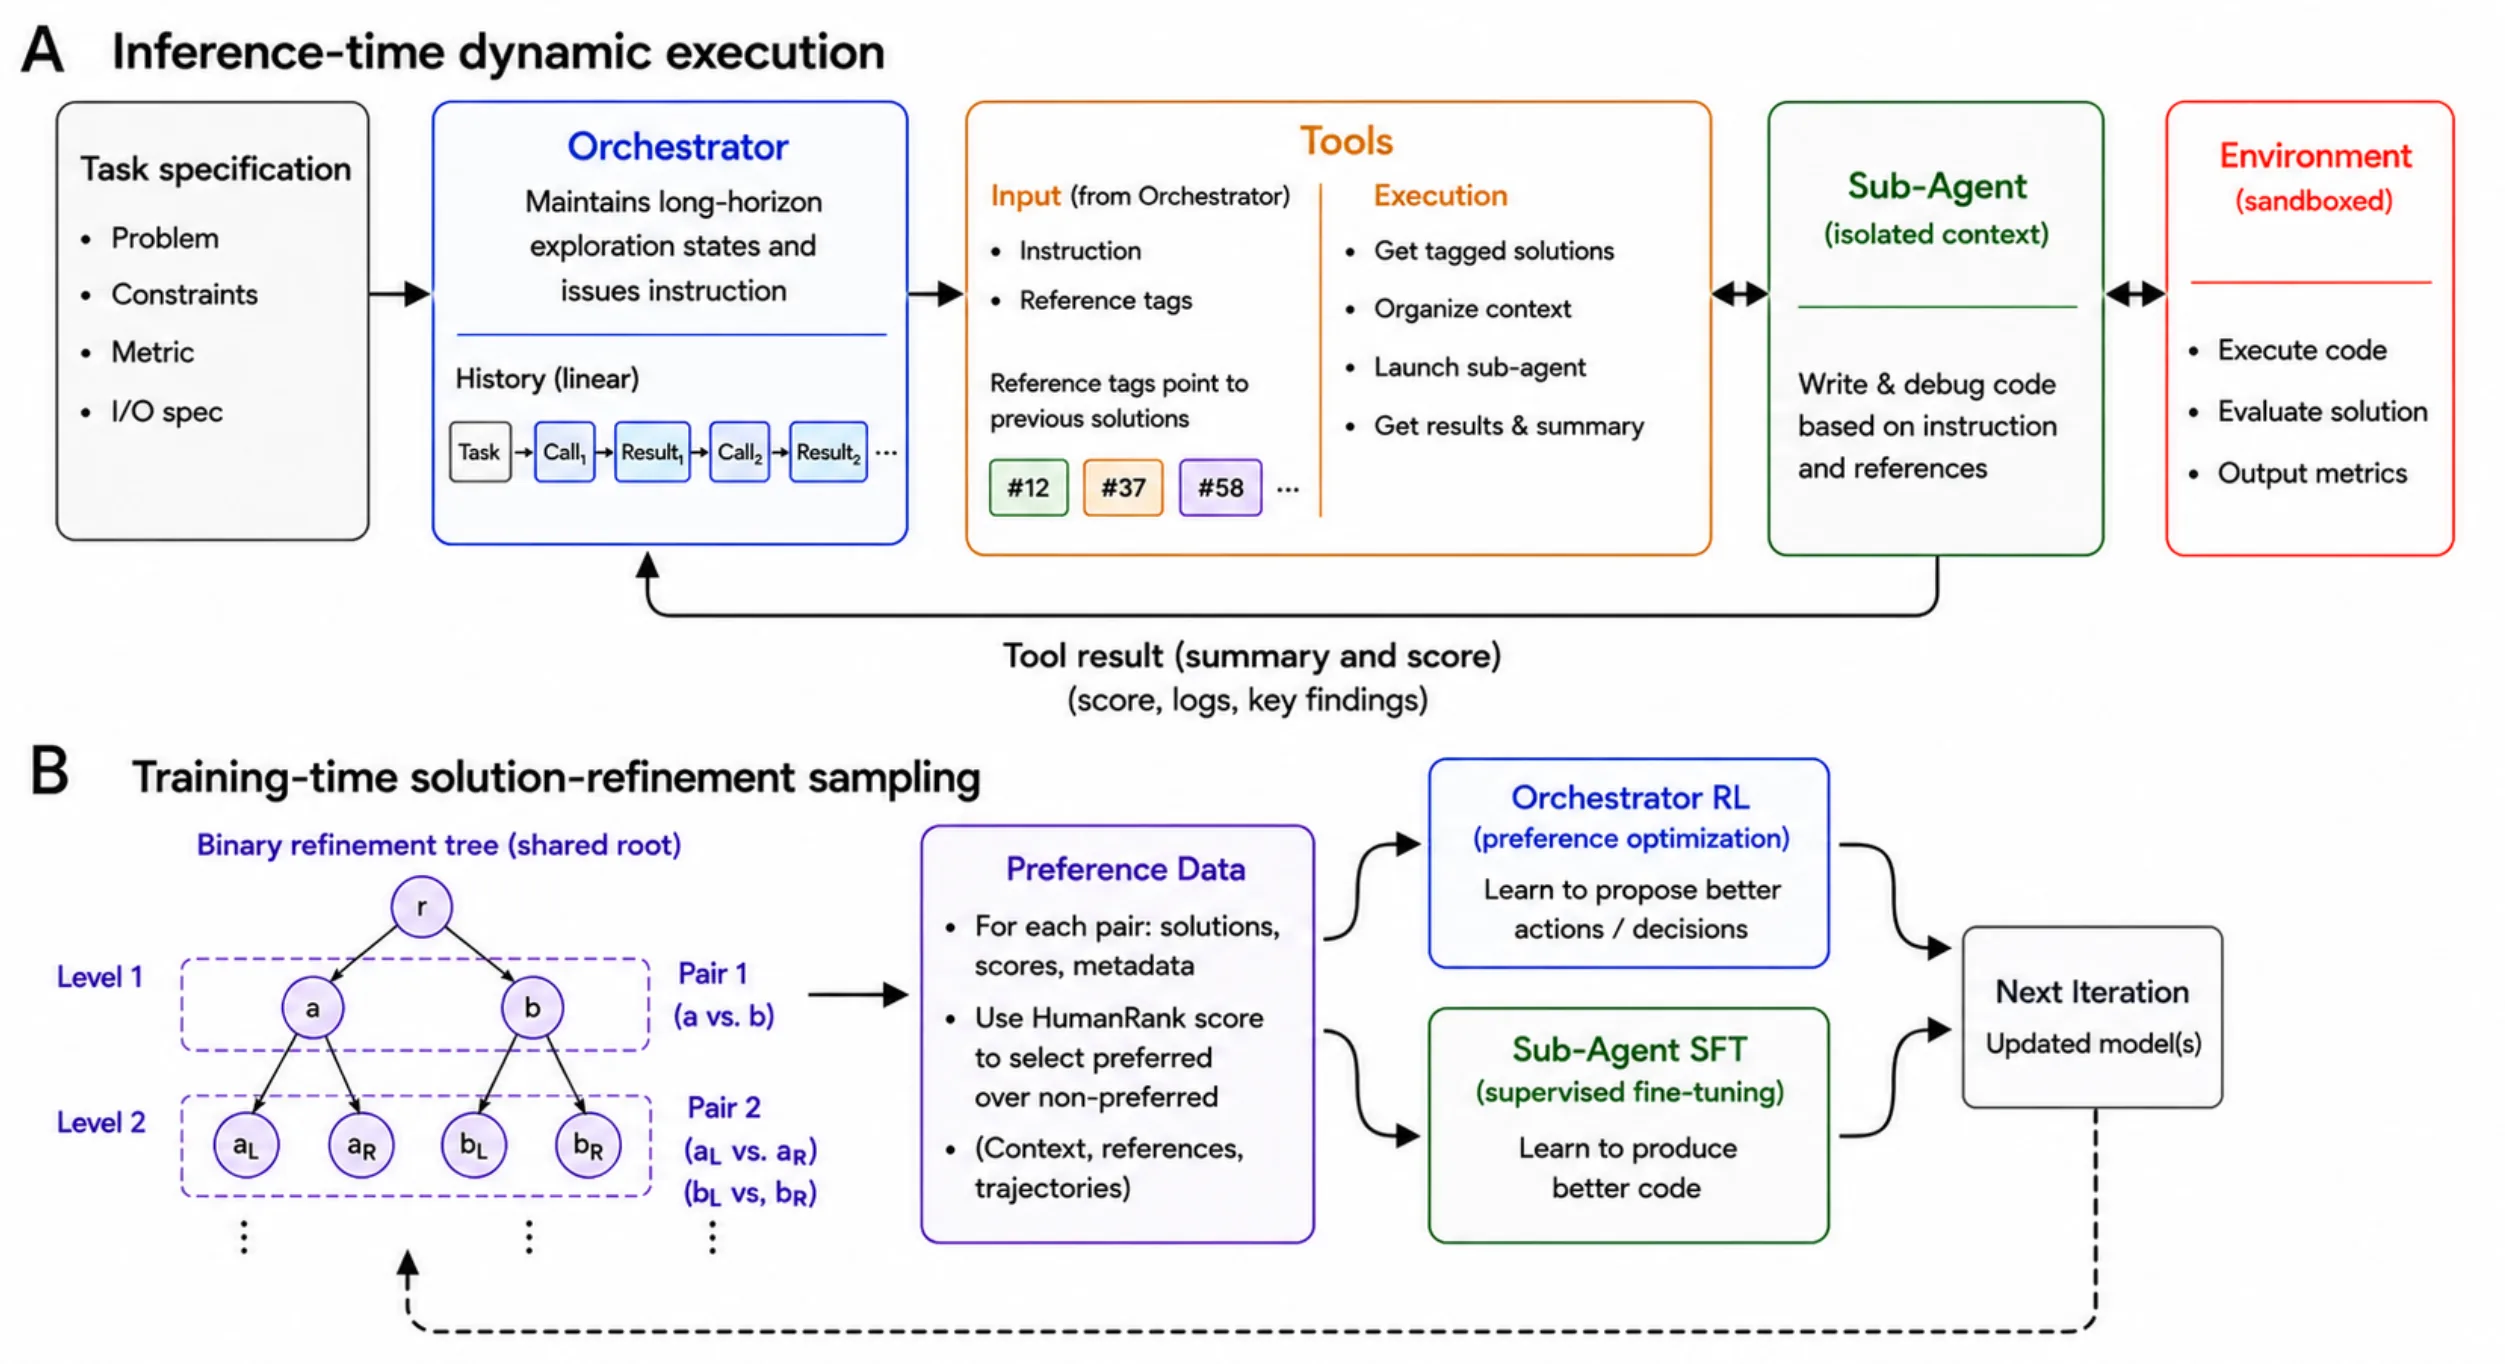
TL;DR
本文提出套娃智能体(Matryoshka Agent)框架,通过将复杂机器学习工程任务分解为高层编排器与低层子智能体的协作层次,显著降低了长上下文推理负担。实验表明,采用 Qwen3-4B-Instruct 作为编排器即可达到与 o4-mini 相当的性能,而将框架应用于 Qwen3-30B-Coder 可获得最高 36.7% 的相对提升。
研究背景与动机
机器学习工程任务具有独特的挑战性:开发者需要在迭代式的方案调试与改进过程中进行长周期决策,每一次方案尝试都可能引发新的环境反馈,进而触发下一轮探索。这种反馈驱动的交互模式使得任务呈现出典型的长链路特征,智能体必须同时管理极为冗长且充满噪声的上下文信息、探索庞大的解空间,并在有限的模型容量与计算预算下保持有效性。
传统的单体智能体方案在这种场景下面临根本性困难。当一个智能体需要同时承担战略规划、方案生成、环境交互和结果评估等多重职责时,其上下文窗口很快就会被各种中间状态、错误信息和调试日志填满。这不仅导致推理成本急剧攀升,更严重的是,[[上下文窗口]]在承载大量噪声后,真正有价值的信息往往被稀释,智能体的决策质量随之下降。特别是在资源受限的边缘部署场景中,让一个小模型承担全部职责几乎是不可能完成的任务。
如何将长周期决策的战略性思考与代价高昂的具体执行相分离,使不同能力的模型各司其职?这一问题的答案引导研究者走向了层次化智能体架构的设计思路。
方法
套娃智能体的核心设计理念可以用一个直观的类比来理解:如果把解决复杂机器学习工程任务比作组织一场大型科研项目,那么一个高效的项目管理体系需要清晰的层级分工。项目负责人(Orchestrator)不需要亲自编写代码或调试环境,而是专注于维护项目的整体进展状态、判断当前瓶颈、制定下一阶段的战略方向;具体的代码实现、环境配置、实验运行则交给各个专项负责人(Sub-Agent)执行,他们通过标准化的接口与基础设施交互,确保执行的一致性与可复现性。
在架构层面,高层级的编排器维护一个紧凑的、面向长周期的探索状态表征。这种状态表征经过精心设计,只保留对战略决策最关键的信息——当前已尝试的方案路线、各项尝试的效果对比、剩余的计算预算、以及对未来探索方向的初步判断。当编排器判断需要尝试某个新方向时,它会生成一条策略指令,该指令描述期望达成的目标以及基本的技术思路,但不会规定具体的实现细节。
低层级的子智能体接收这些策略指令后,通过标准化的工具接口与执行环境直接交互。这种标准化接口设计至关重要:它屏蔽了底层环境的复杂性,使得不同类型的子智能体可以使用统一的模式调用代码执行、文件操作、命令运行等基础能力。子智能体的职责是将高层指令转化为具体的操作序列,观察执行结果,提取关键的反馈信息(如错误类型、性能指标变化等),并将这些信息汇报给编排器。
这种设计带来几个关键优势。首先,战略层面的推理被限制在相对简短的上下文中,[[上下文窗口]]的利用率大大提高,噪声占比显著降低。其次,子智能体的执行失败不会污染高层推理状态——如果一次尝试没有达到预期效果,编排器只需在探索状态中记录这一事实,然后转向其他方向的探索。第三,不同能力的模型可以被分配到最适合的层级:推理能力强但计算资源有限的模型承担编排职责,而专门针对代码生成优化的模型则作为子智能体执行具体的实现工作。
论文还详细描述了套娃智能体的训练范式。在训练过程中,编排器和子智能体的能力需要协同发展,但又各有侧重。编排器的训练强调战略决策的质量——它需要学会从有限的反馈信息中推断出方案失效的原因,并制定出能够有效探索解空间邻域的新策略。子智能体的训练则更关注执行层面的效率——它需要准确地理解高层指令的意图,在给定的约束条件下找到可行的实现路径,并在执行过程中处理各种异常情况。
实验与结果
实验在涵盖多种模型类型与规模的机器学习工程任务上进行,旨在验证框架的有效性与可扩展性。基线对比包括传统的单体智能体方案以及其他层次化智能体架构。
一个令人瞩目的结果是编排器选择对性能的影响。当使用 Qwen3-4B-Instruct 作为编排器时,套娃智能体框架能够达到与使用 o4-mini 作为编排器相近的效果。这说明框架本身的设计对于降低高层推理难度具有实质性贡献——一个小规模的推理模型在层次化架构下完全可以胜任战略规划任务,而无需依赖最强大的闭源模型。
对于子智能体的选择,实验表明针对性的优化能够带来显著收益。将 Qwen3-30B-Coder(专门针对代码生成任务优化的模型)作为子智能体部署在套娃智能体框架中,可以获得最高达 36.7% 的相对性能提升。这一提升来源于代码生成质量的改善与执行效率的提高——子智能体能够更准确地理解技术指令的含义,生成更高质量的实现代码,减少因代码错误导致的反复调试。
实验还考察了不同任务复杂度下框架的表现差异。在需要多轮迭代调试的复杂任务中,层次化设计的优势更加明显:随着交互轮次的增加,单体智能体的性能往往出现明显衰减,而套娃智能体能够保持相对稳定的探索效率。这验证了框架在长周期任务中的鲁棒性。
讨论与可借鉴点
套娃智能体框架为复杂长周期任务的问题求解提供了一种新的范式思考。它揭示了层次化分解在降低[[推理成本]]和提高系统可扩展性方面的潜力——通过将战略探索与具体执行相解耦,不同能力的模型可以被高效地组合使用,而不是被迫用一个大模型处理所有环节。
这一设计的局限性与可探索方向同样值得注意。首先,层次化架构引入了额外的通信开销——编排器与子智能体之间需要通过标准化接口传递信息,这种传递过程中是否存在信息损失?如何设计更高效的指令格式来最小化这种损失?其次,当前的框架假设子智能体的执行结果是可被清晰观察和评估的,但在某些需要主观判断或创意设计的任务中,这种假设可能不成立。再次,框架的训练范式仍在探索中,如何高效地联合优化两个层级的模型能力,使它们学会更好地协作,是一个尚未完全解决的问题。
从更广泛的角度看,套娃智能体展示的层次化设计思想具有普遍参考价值。对于任何需要处理长上下文、面对庞大解空间、同时受限于计算资源的复杂任务,将问题分解为不同粒度的子问题、让不同能力的组件各司其职,可能比试图用一个统一的智能体解决所有问题更为可行。这种分而治之的思路,或许是走向更强大、更高效人工智能系统的一条重要路径。
摘要
机器学习工程(MLE)任务需要在迭代式的方案调试与改进过程中进行长周期决策,且伴随着代价高昂、由反馈驱动的环境交互。为此类任务开发并训练一个单体智能体从根本上是困难的,因为它必须同时管理极为冗长且充满噪声的上下文、探索广阔的解空间,并在有限的模型容量与计算预算下保持有效性。为应对这些挑战,我们提出套娃智能体(Matryoshka Agent),一个面向复杂长周期任务的统一层次化智能体框架。套娃智能体将智能体的问题求解分解为一个协调一致的决策与执行层次结构:高层级的编排器维护紧凑的、面向长周期的探索状态并发布战略性指令,而较低层级的子智能体通过直接的环境交互执行具体解决方案尝试,并由标准化的工具接口进行中介。这种设计将战略探索与代价高昂的执行相解耦,显著减轻了长上下文推理的负担,并实现了高效的迭代式精炼。我们进一步为套娃智能体开发了一套高效的训练范式。在涵盖多种模型类型与规模的广泛 MLE 任务上的实验结果表明,套娃智能体是长周期 MLE 任务与复杂智能体问题求解的一种有效且可扩展的范式。值得注意的是,套娃智能体使 Qwen3-4B-Instruct 达到了与 o4-mini 相当的编排器性能。将套娃智能体应用于 Qwen3-30B-Coder 可带来最高达 36.7% 的相对性能提升。
Abstract
Machine learning engineering (MLE) tasks require long-horizon decision making over iterative solution debugging and refinement, under expensive and feedback-driven environment interactions. Developing and training a monolithic agent for such tasks is fundamentally challenging, as it must simultaneously manage extremely long and noisy contexts, explore vast solution spaces, and remain effective under limited model capacity and computational budgets. To address these challenges, we propose Matryoshka Agent, a unified hierarchical agent framework for complex long-horizon tasks. Matryoshka Agent decomposes agentic problem solving into a coordinated hierarchy of decision making and execution: a high-level Orchestrator maintains compact, long-horizon exploration states and issues strategic instructions, while lower-level Sub-Agents execute concrete solution attempts through direct environment interaction, mediated by standardized Tool interface. This design decouples strategic exploration from costly execution, substantially reducing the burden of long-context reasoning and enabling efficient iterative refinement. We further develop an efficient training paradigm for Matryoshka Agent. Experimental results on a broad range of MLE tasks with diverse model types and scales demonstrate that Matryoshka Agent is an effective and scalable paradigm for long-horizon MLE tasks and complex agentic problem solving. Notably, Matryoshka Agent enables Qwen3-4B-Instruct to reach Orchestrator performance comparable to o4-mini. Applying Matryoshka Agent to Qwen3-30B-Coder results in at most 36.7% relative performance gain.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。