
📝 TLDR
开放智能体系统中智能体与任务集合动态变化,传统多智能体强化学习依赖固定状态与动作空间假设,难以适应。现有填充掩码或图方法仅能部分处理开放性。PLATO采用基于指针网络的动作网络,直接对当前任务集输出分布,无需掩码或重训练;并以集中式图神经网络评论器编码智能体-任务交互。该方法在任务与智能体双开放马可夫博弈下被证明良定义,在MOASEI野火抑制任务中取得优于现有方法的零样本泛化表现。
🧭 速览
开放智能体系统中智能体与任务数量动态变化,挑战传统MARL的固定空间假设,现有方法存在人工边界或仅处理单一维度开放性的局限。
基于指针网络的动作网络直接对当前任务集输出分布,结合集中式GNN评论器编码智能体-任务交互图,采用MAPPO在CTDE范式下训练。
在MOASEI野火抑制环境中表现强劲,零样本泛化能力优于现有OASYS基线方法,且结果更具一致性。
PLATO形式化了任务与智能体双开放马可夫博弈,证明了其在无界状态与动作空间下的良定义性,为开放多智能体系统提供了统一方案。
🆚 方法对比
PLATO
- 首个联合处理AO和TO的MARL架构
- 指针网络直接输出当前任务分布
- 无需掩码或重训练即可适应变化
- 零样本泛化优于现有最优基线
- 集中式GNN批评家依赖全局信息
- 仅在野火领域评估,泛化待验证
- 指针网络随任务规模有计算开销
MOHITO
- 显式针对任务开放性设计
- 交互超图表达力强,可表示AO
- 基于TaO-MG有正式定义
- 未明确建模或评估随机性AO
- 处理AO时依赖限制性假设
DICG
- 引入灵活的协调结构
- 对AO和TO提供有限支持
- 仍在有界和填充输入内运作
- 非明确为开放性而设计
DGN
- 通过图卷积实现智能体协调
- 可适应变化的智能体邻域
- 不建模任务开放性
- 假设固定动作集与图结构
Padding/Masking方法
- 实现简单,计算开销低
- 兼容现有固定维度MARL方法
- 引入人工边界,限制开放性
- 无法处理无界智能体或任务空间
PLATO通过指针网络与GNN批评家联合处理AO和TO,无需填充或掩码;相比MOHITO、DICG和DGN等基线,在零样本泛化和无界空间适应性上更具优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 18 张)
展开查看 18 张图
TL;DR
PLATO 提出了一种面向开放多智能体系统的新型学习框架,通过指针网络直接对动态变化的任务集合输出动作分布,结合集中式图神经网络评论家编码智能体-任务交互。该方法在任务与智能体双开放的马尔可夫博弈中被证明数学上良定义,在 MOASEI 野火抑制任务中展现出优于现有基线的性能与更一致的零样本泛化能力。
研究背景与动机
开放智能体系统(OASYS)在现实世界中极为普遍:无人机编队可能遭遇设备故障导致智能体退出,火灾救援场景中新火点会不断出现,工厂生产线上的机器人可能根据订单需求动态增减。在这些场景中,智能体集合与任务集合都会随时间发生不可预测的变化——研究者将前者称为智能体开放性(AO),后者称为任务开放性(TO)。
传统多智能体强化学习(MARL)通常假设固定的状态空间和动作空间,这与开放系统的本质需求形成了根本矛盾。现有方法试图缓解这一矛盾,但都存在明显局限:填充与掩码方法需要人为设定智能体或任务的最大数量,实际上仍依赖固定空间假设,当系统规模超过预设边界时便失效;基于图或超图的方法虽然表达能力更强,但通常只能处理单一维度的开放性,且对随机性建模不足。这些方法共同的问题在于,它们将开放性视为需要“绕过”的障碍,而非系统本身的自然特性来加以利用。
方法
PLATO 的核心思路是从根本上重新设计动作选择机制:不再让策略网络从固定索引集合中选择动作,而是让它直接根据任务的内容和特征来“指向”当前应该执行的任务。
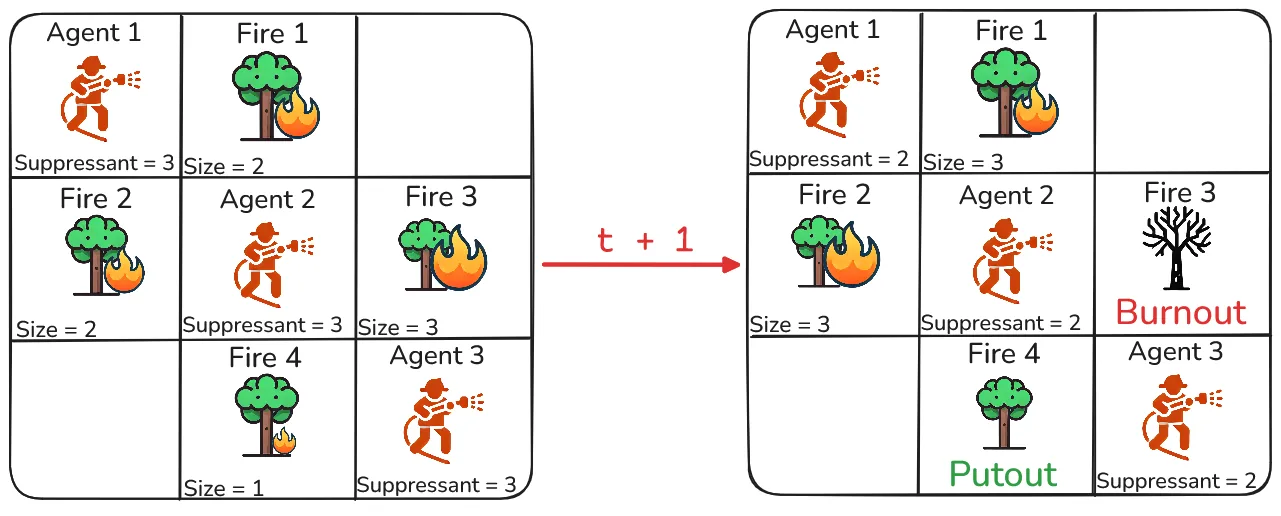
这种方法的形式化基础是任务与智能体开放马尔可夫博弈(TaAgO-MG)。作者将开放系统的动态变化建模为一个生成器 ,它同时作用于任务集 与智能体集合 ,按时序生成当前博弈实例。当新火点出现时,动作空间同步扩展;当智能体退出时,动作空间相应收缩。这种设计使得开放性不再是需要处理的异常情况,而是系统描述的有机组成部分。
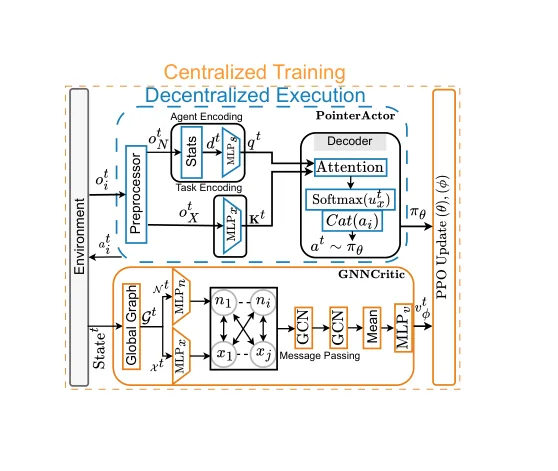
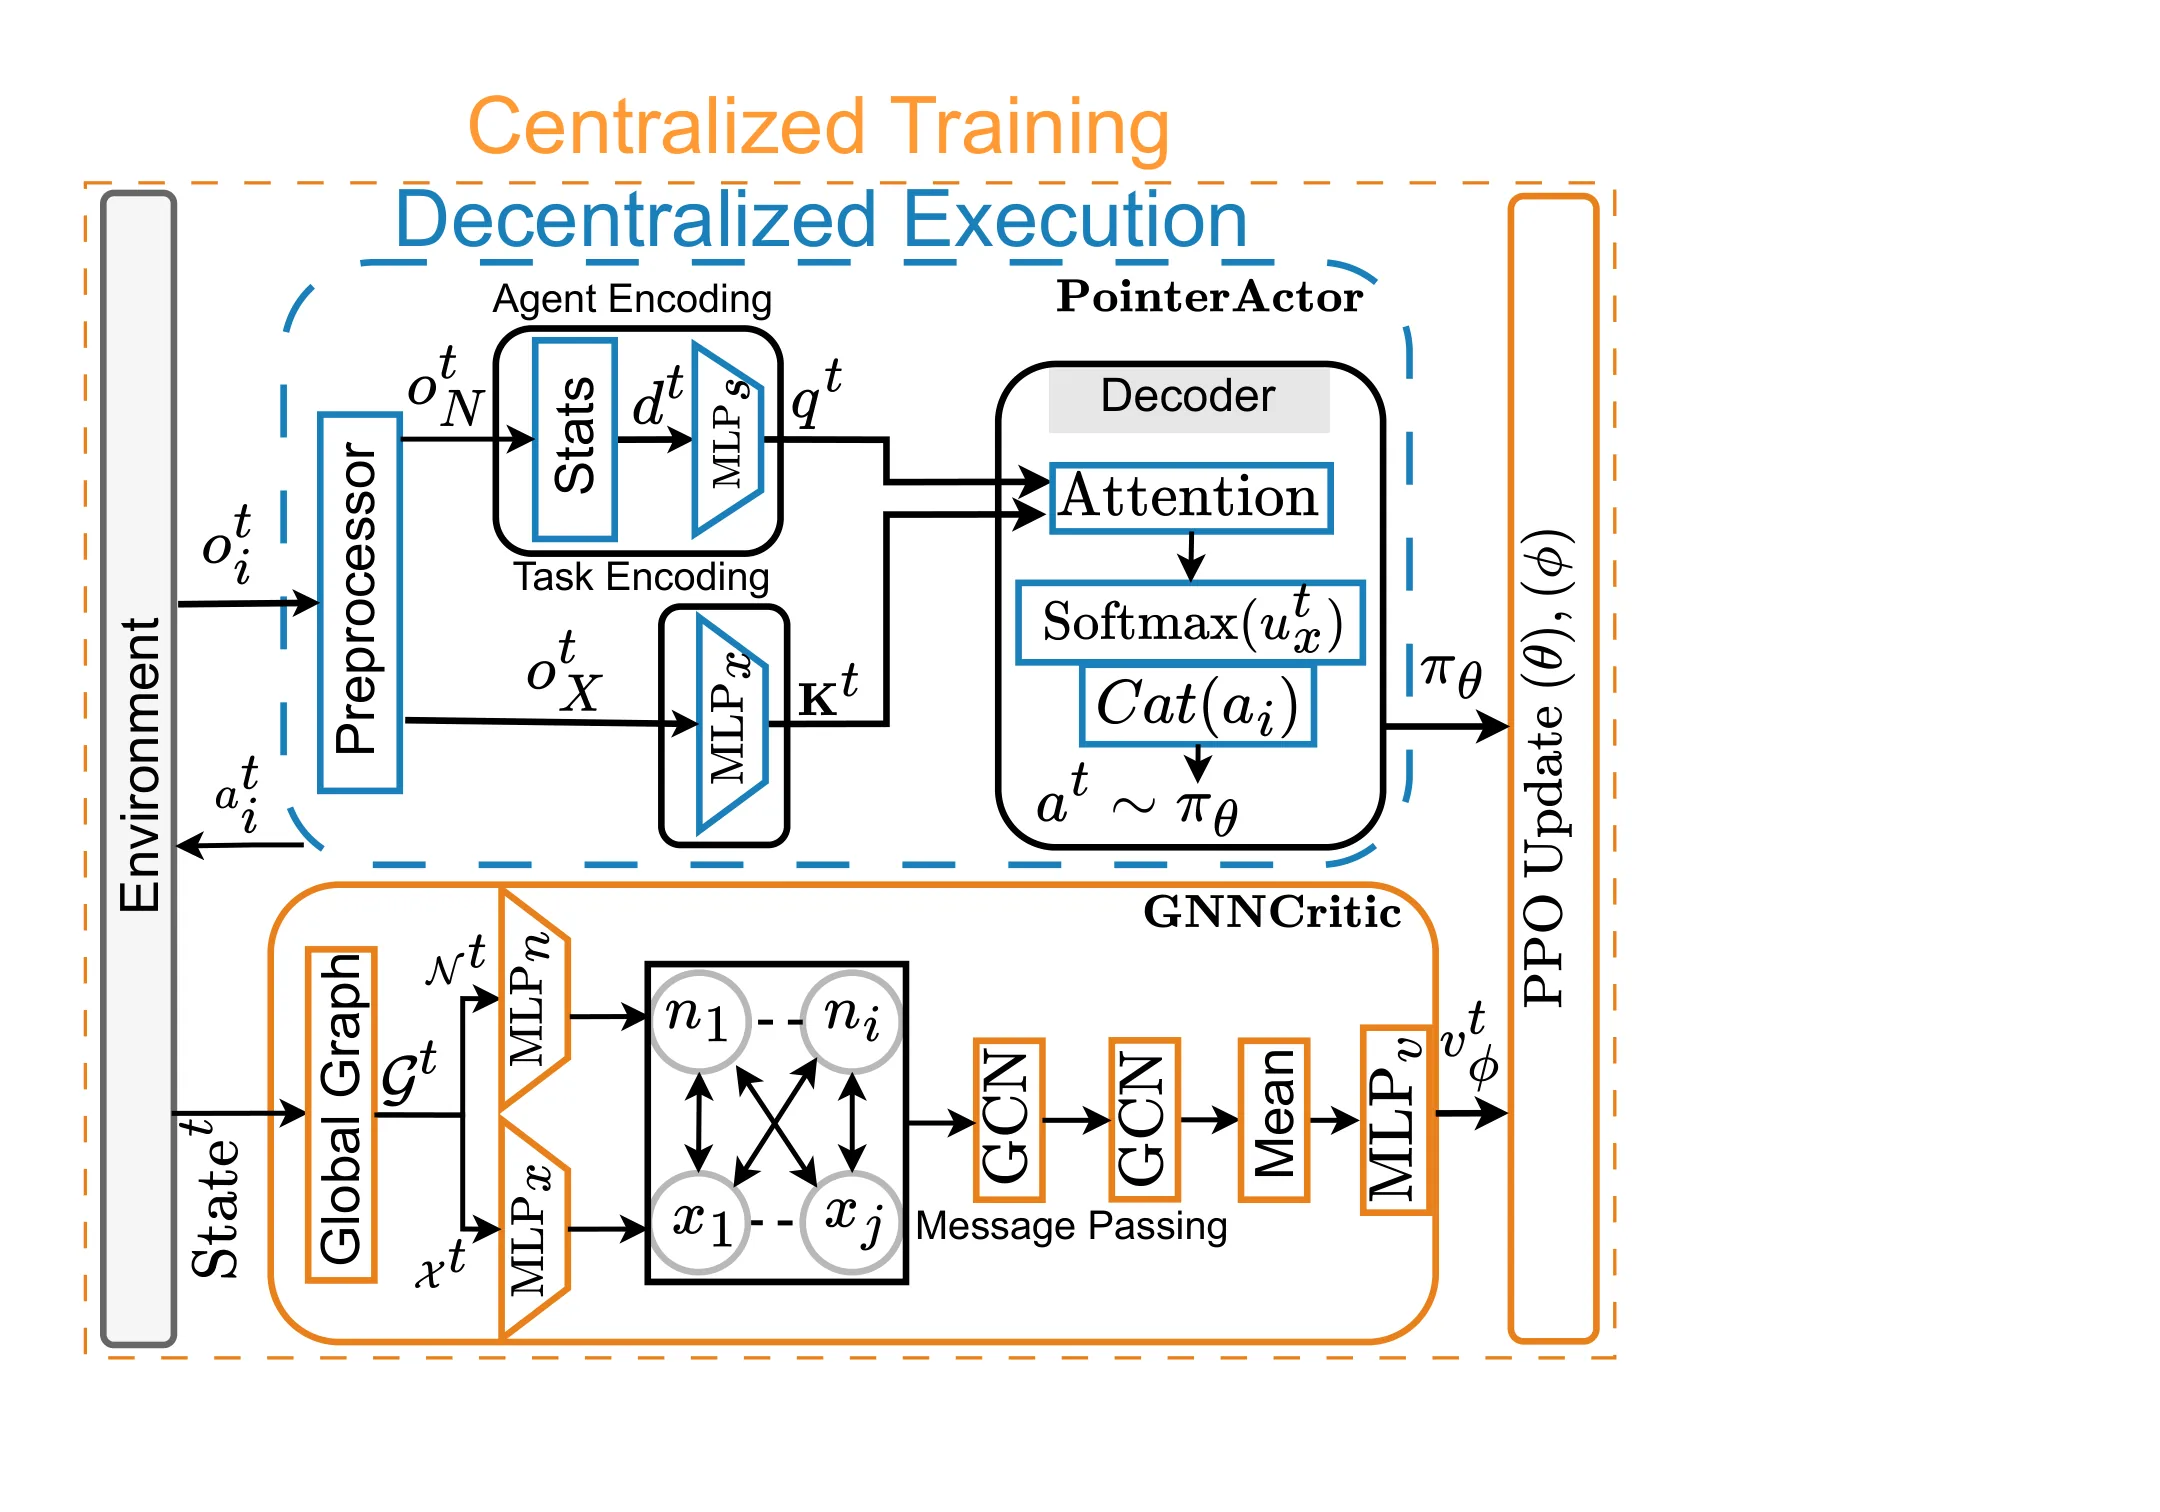
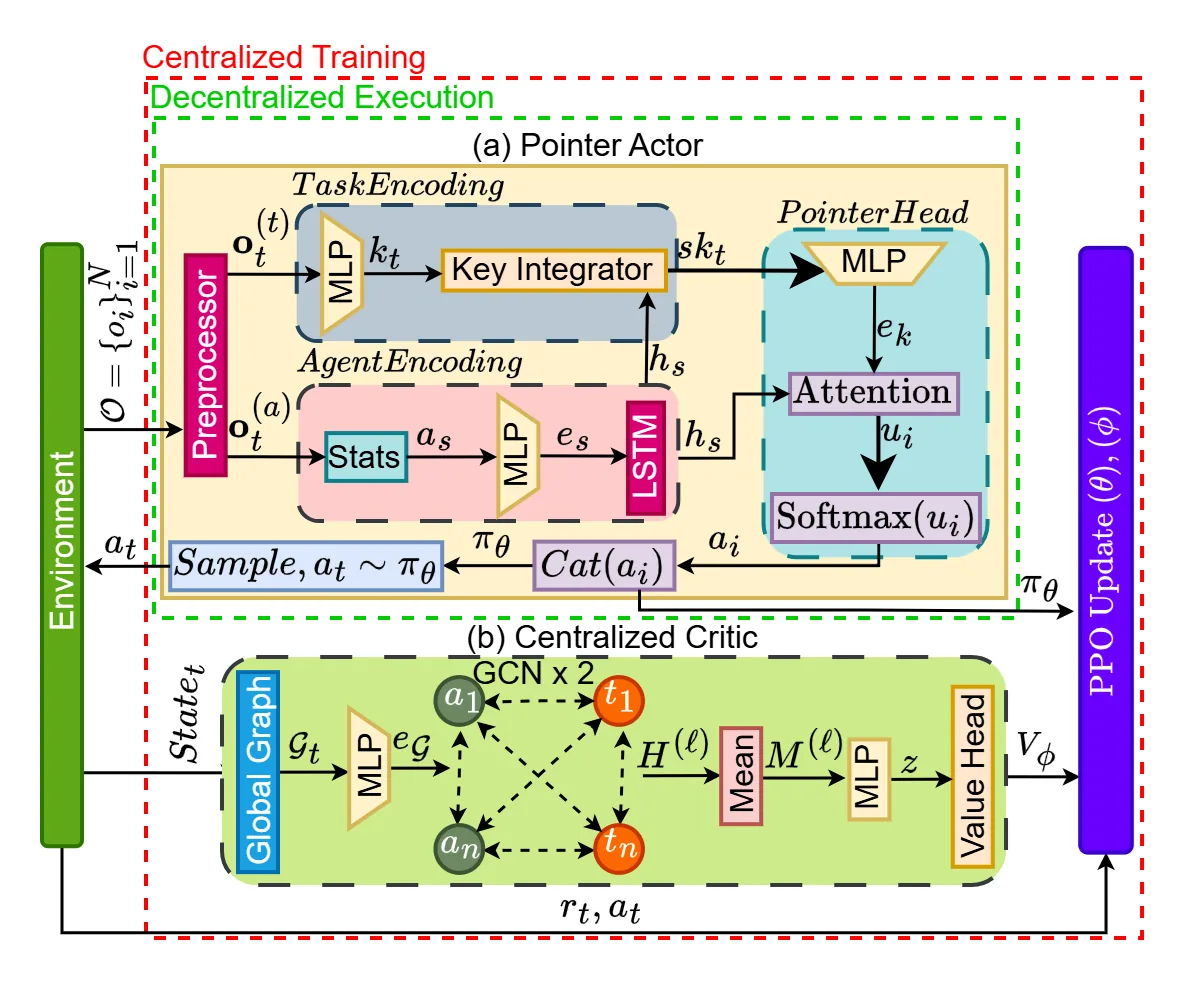
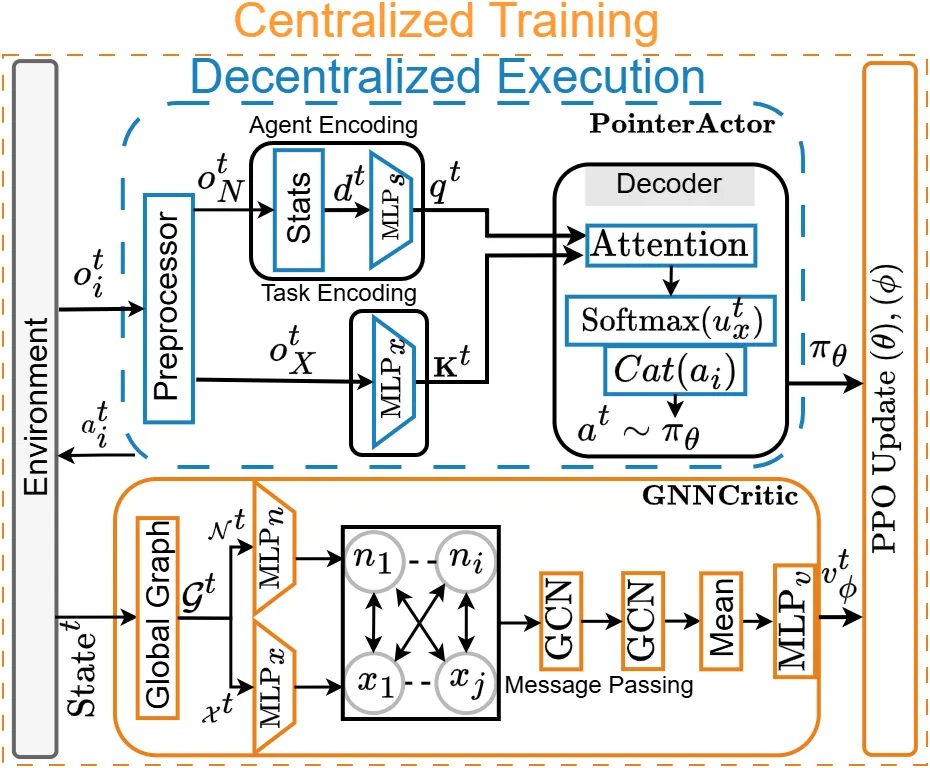
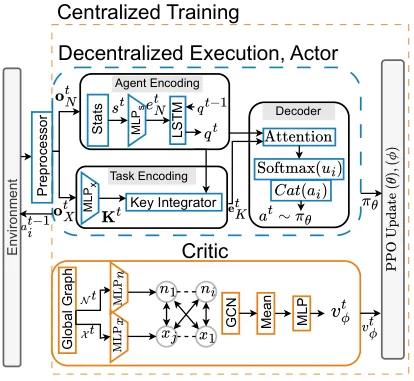
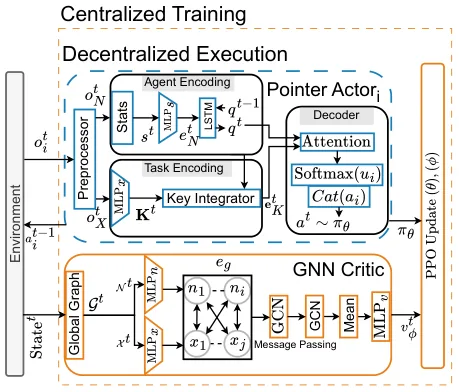
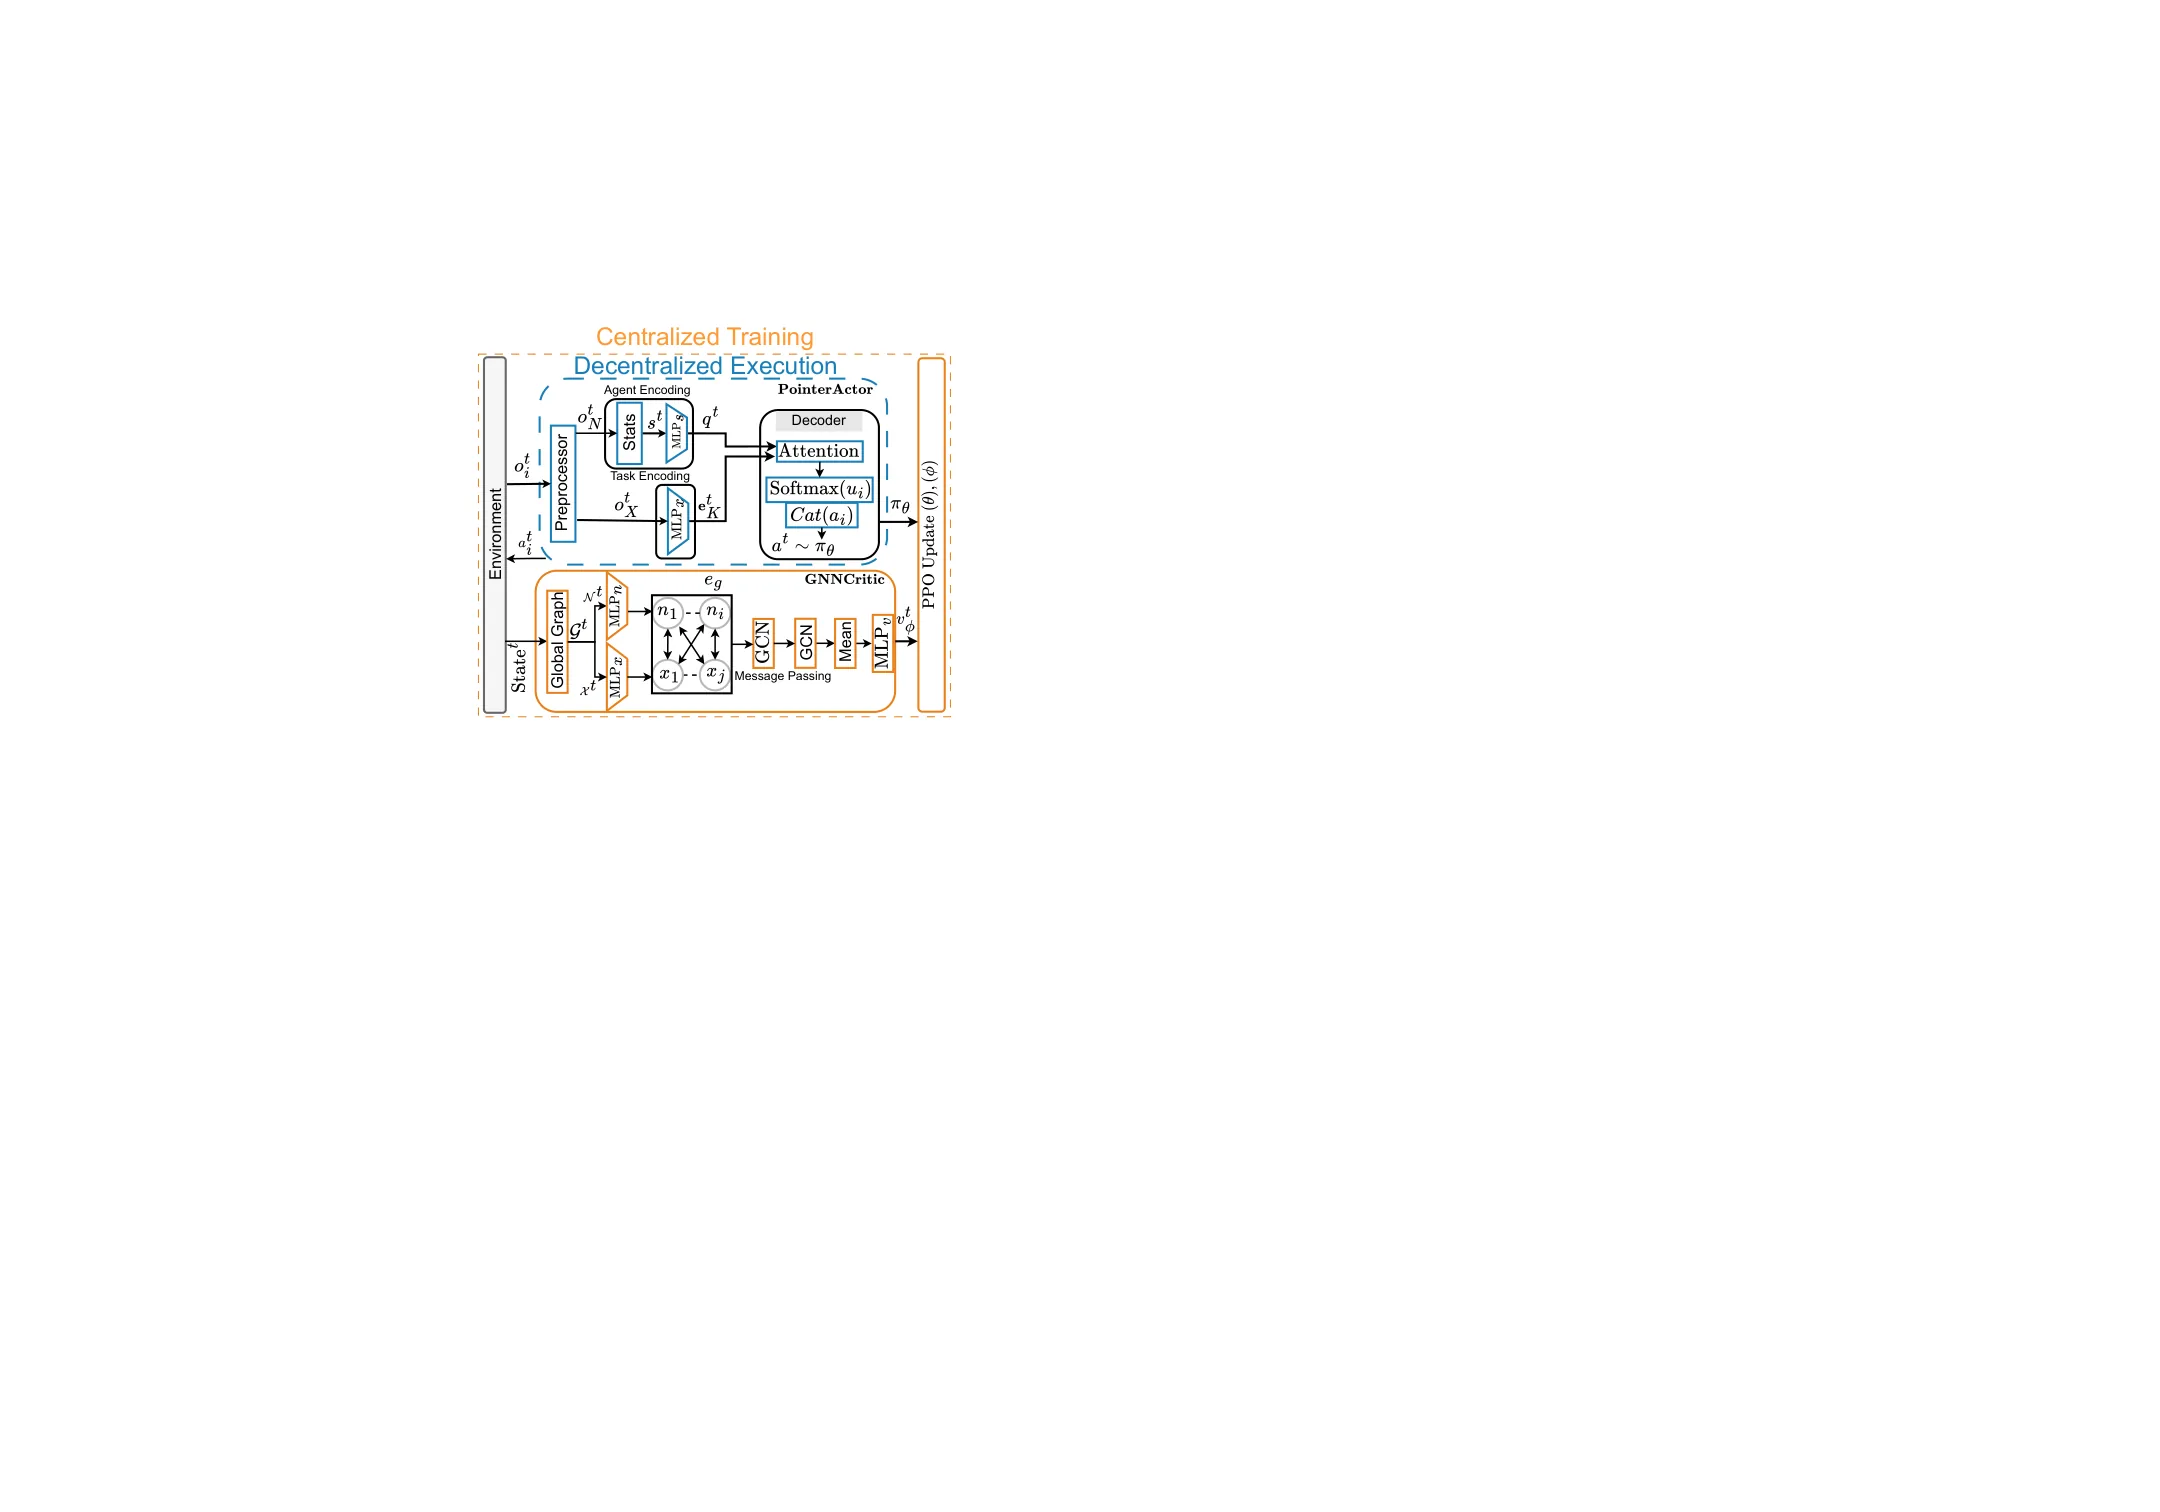
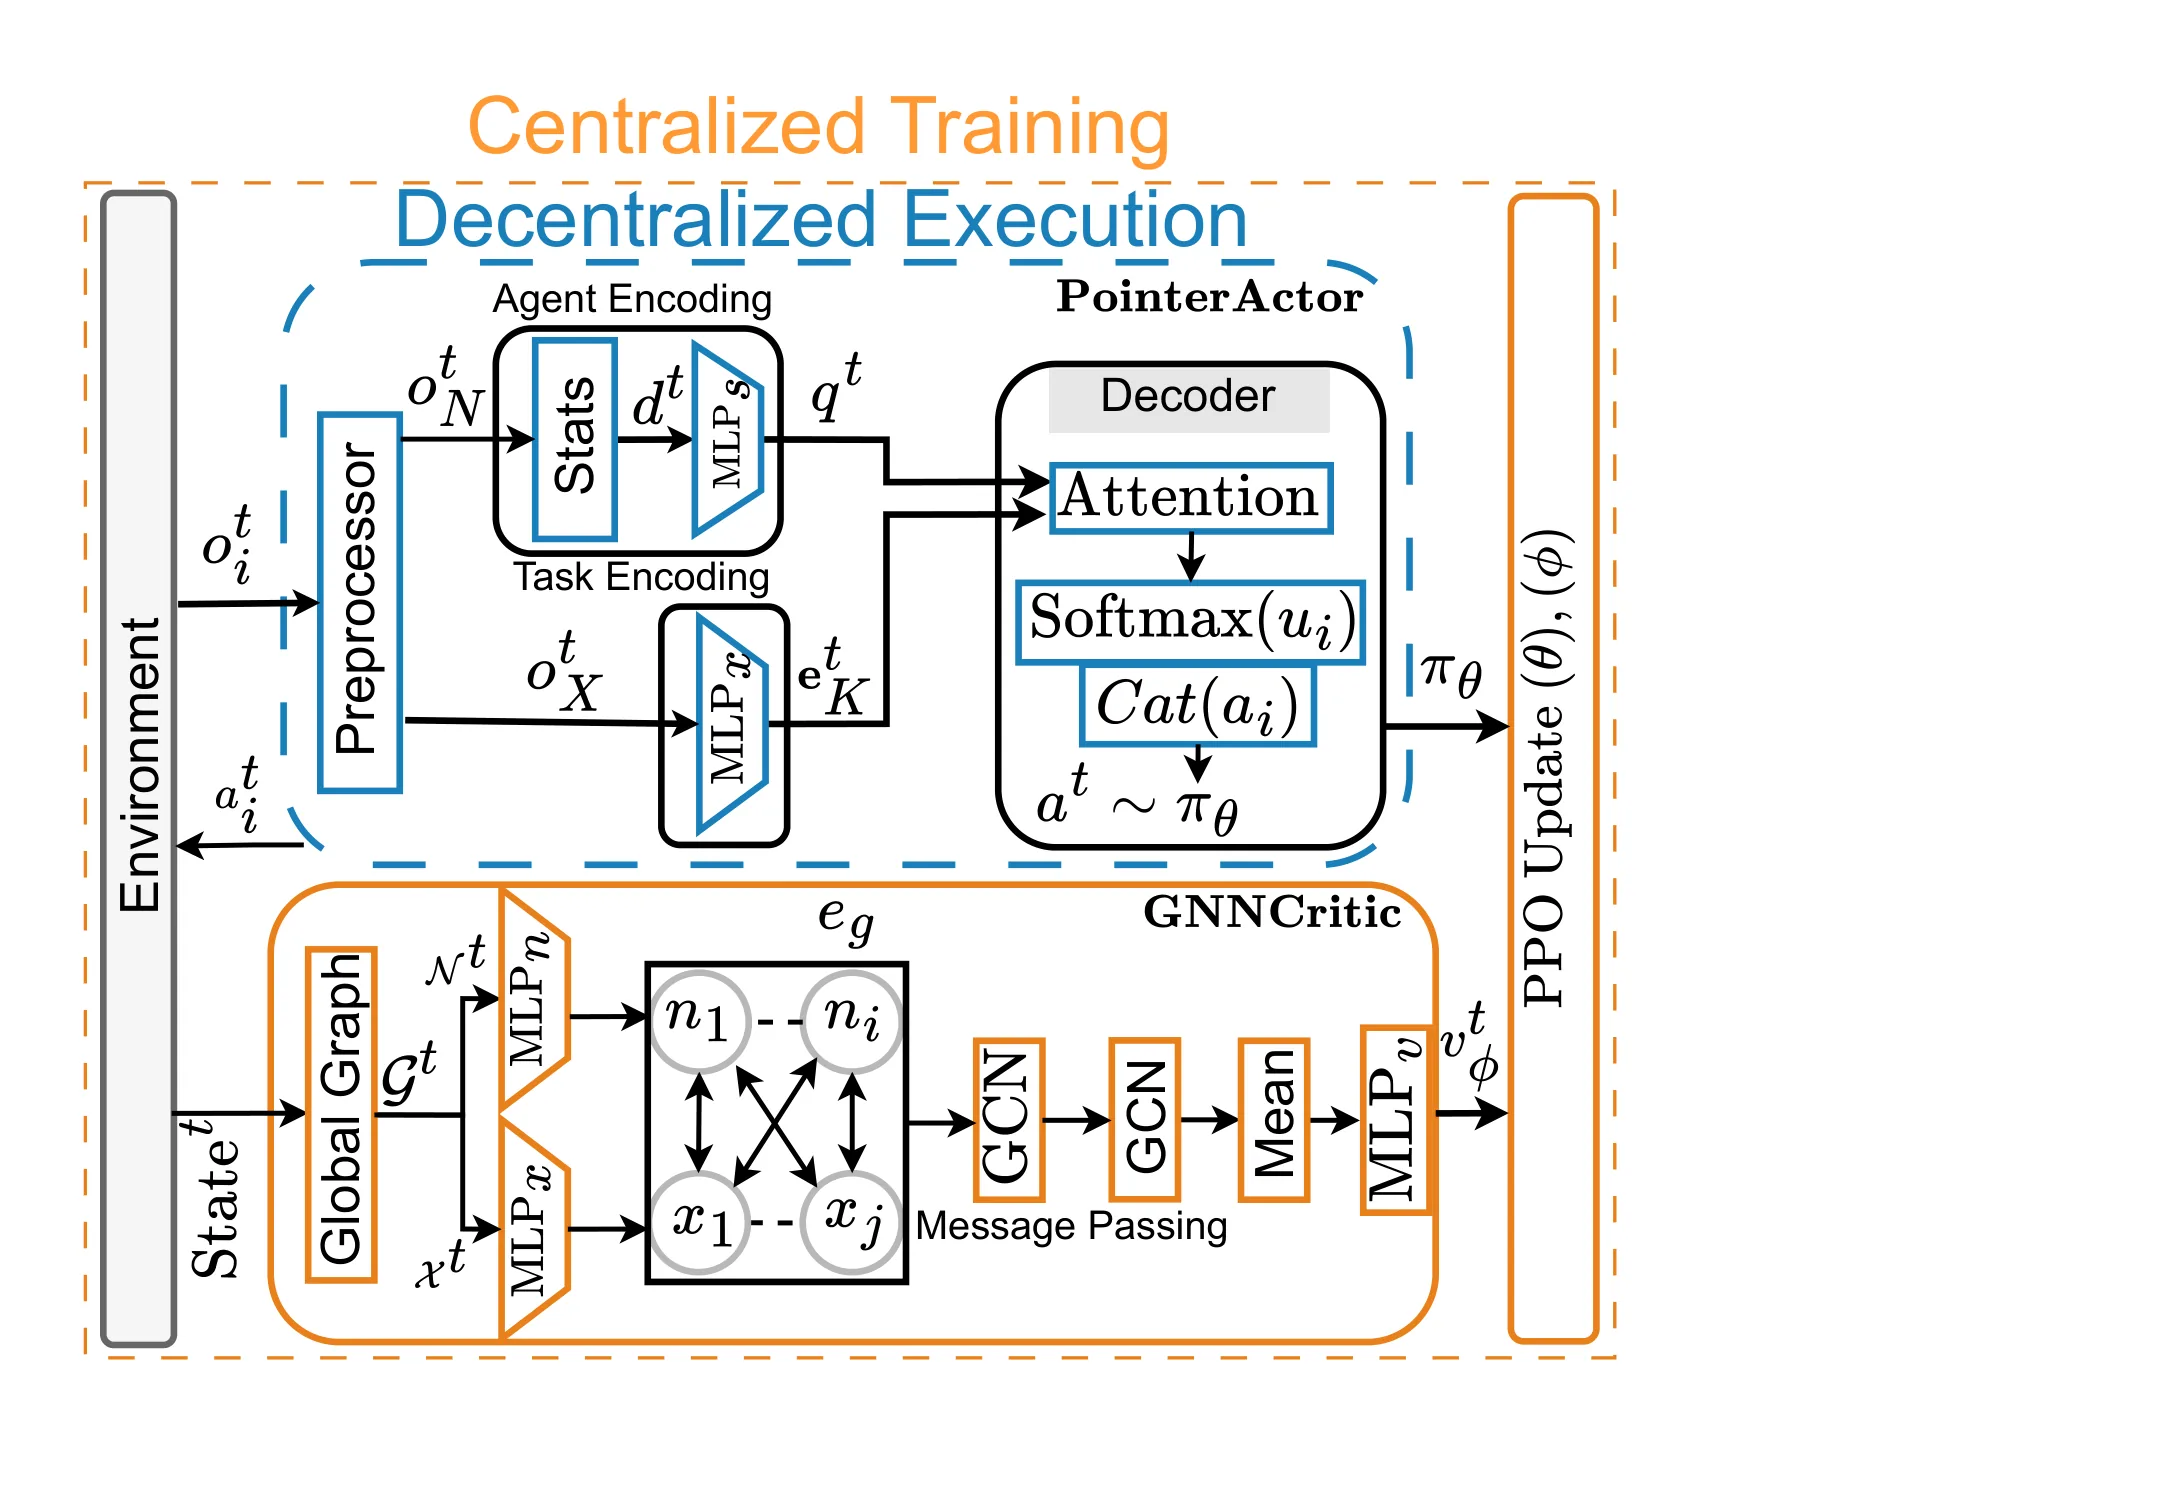
执行器采用指针网络架构,将观测分解为智能体特征矩阵与任务特征矩阵两部分。对于智能体集合,作者计算四个置换不变统计量——均值、方差、最小值、最大值——来构造固定长度的查询向量。这确保了无论多少个智能体参与,查询向量的维度始终保持一致。对于任务集合,每个任务独立编码后与查询向量计算注意力得分,最终 softmax 归一化得到选择概率。关键在于引理 2 的证明:当任务集合变化时,不同任务间的对数优势比保持不变,这意味着策略对任务集合变化的响应是“自然”的——系统不需要重新训练来适应新任务。
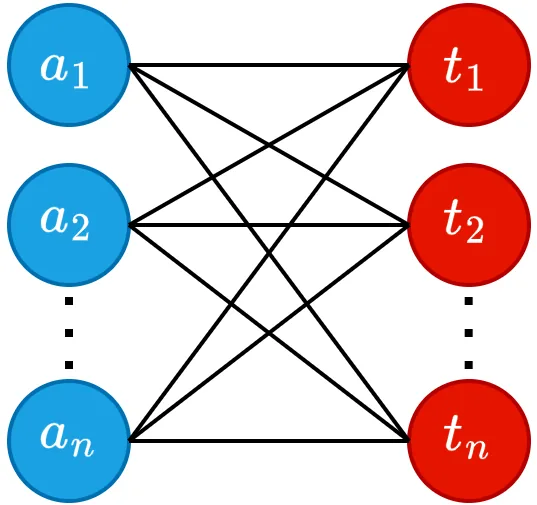
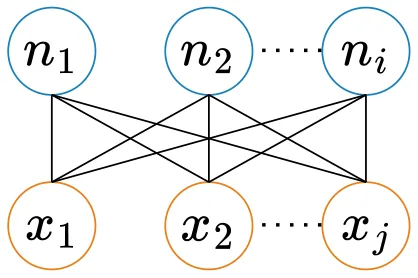
评论家部分采用两层图神经网络,将全局状态编码为智能体-任务二部图。消息传递机制让每个智能体节点和任务节点相互聚合邻域信息,最终通过均值池化与 MLP 输出状态价值。由于图结构本身会随任务和智能体组成而改变形状,评论家天然适应开放性。
训练在集中训练、分散执行的范式下进行,使用多智能体近端策略优化(MAPPO)配合 GAE 估计优势函数。复杂度分析表明每步训练成本仅与当前活跃智能体和任务数量相关,不随固定上界爆炸。
实验与结果
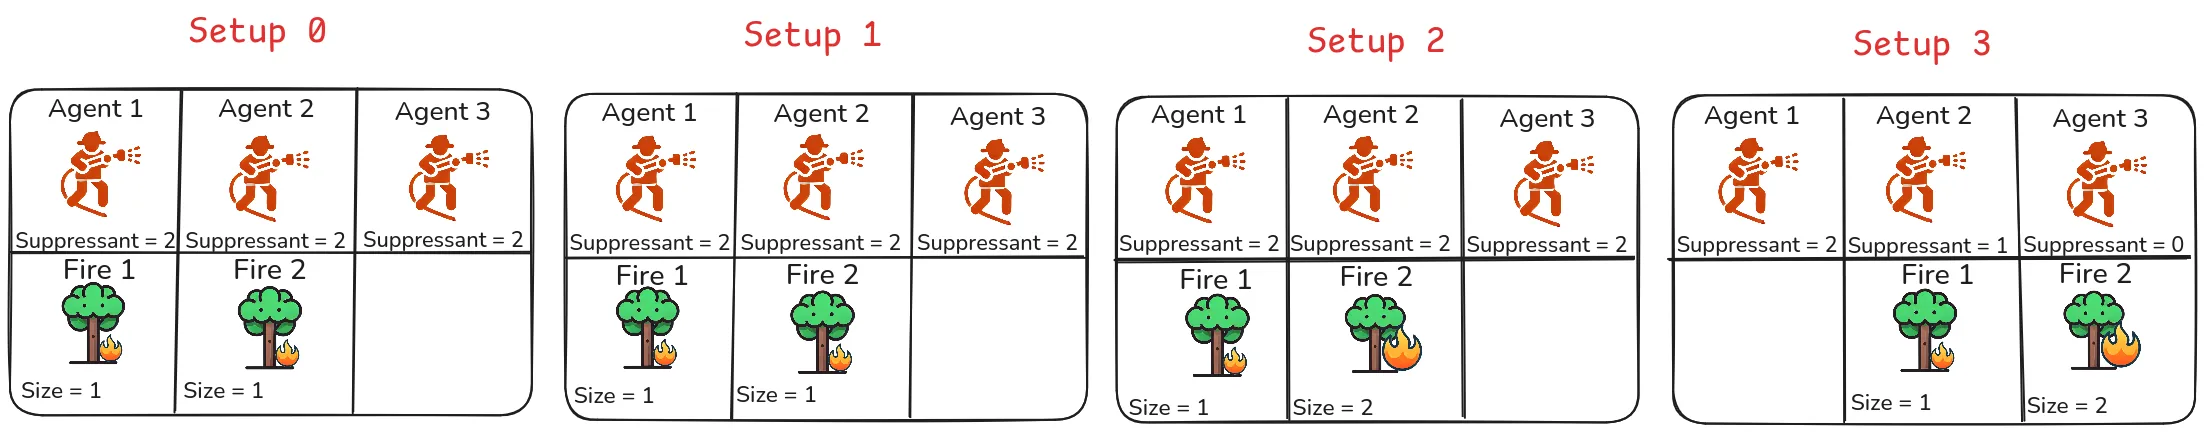
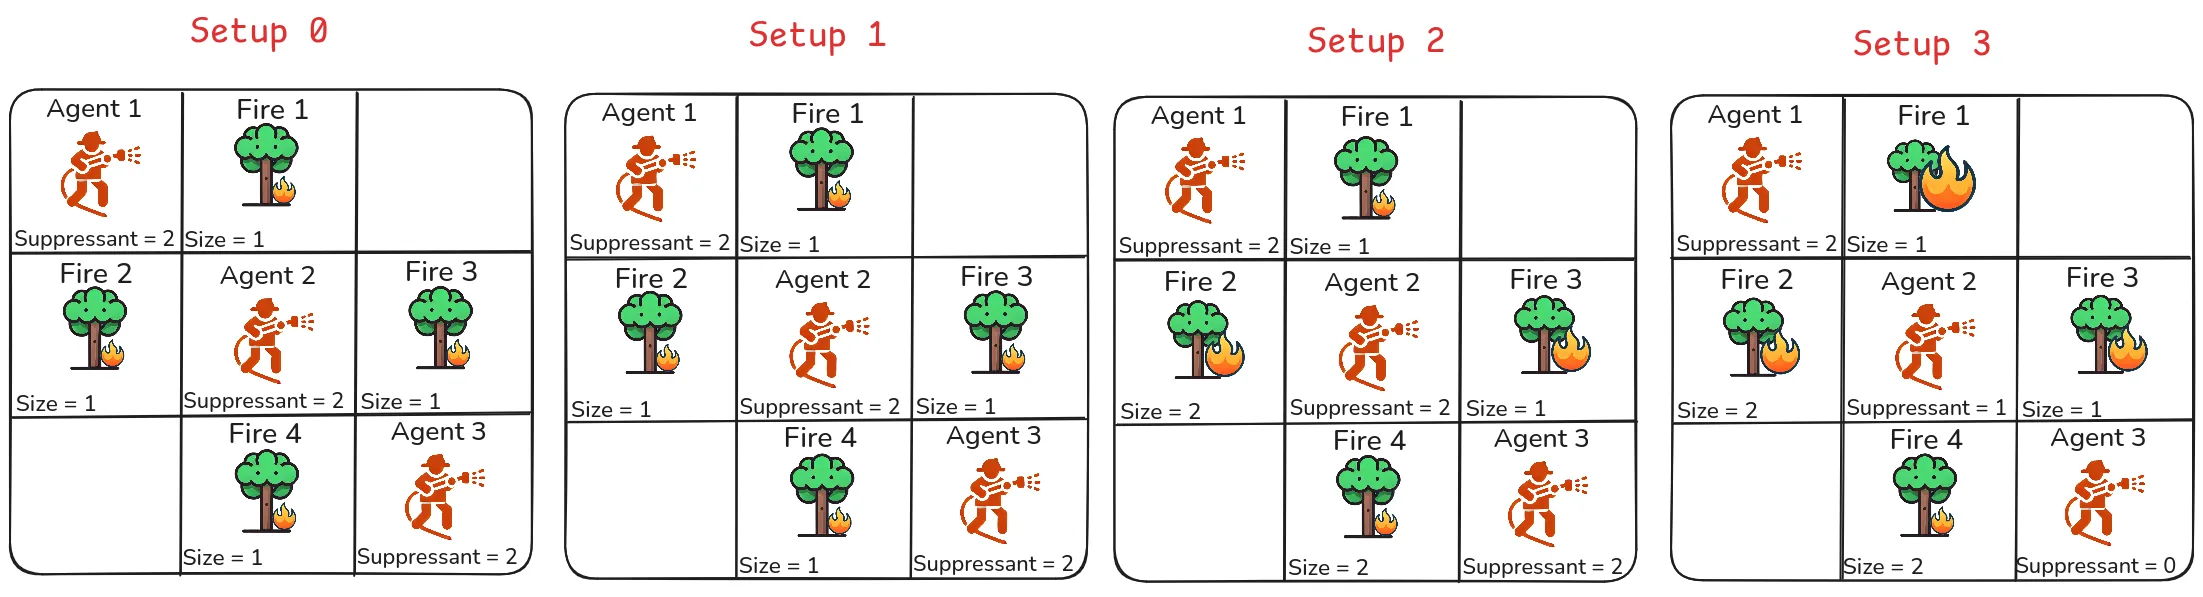
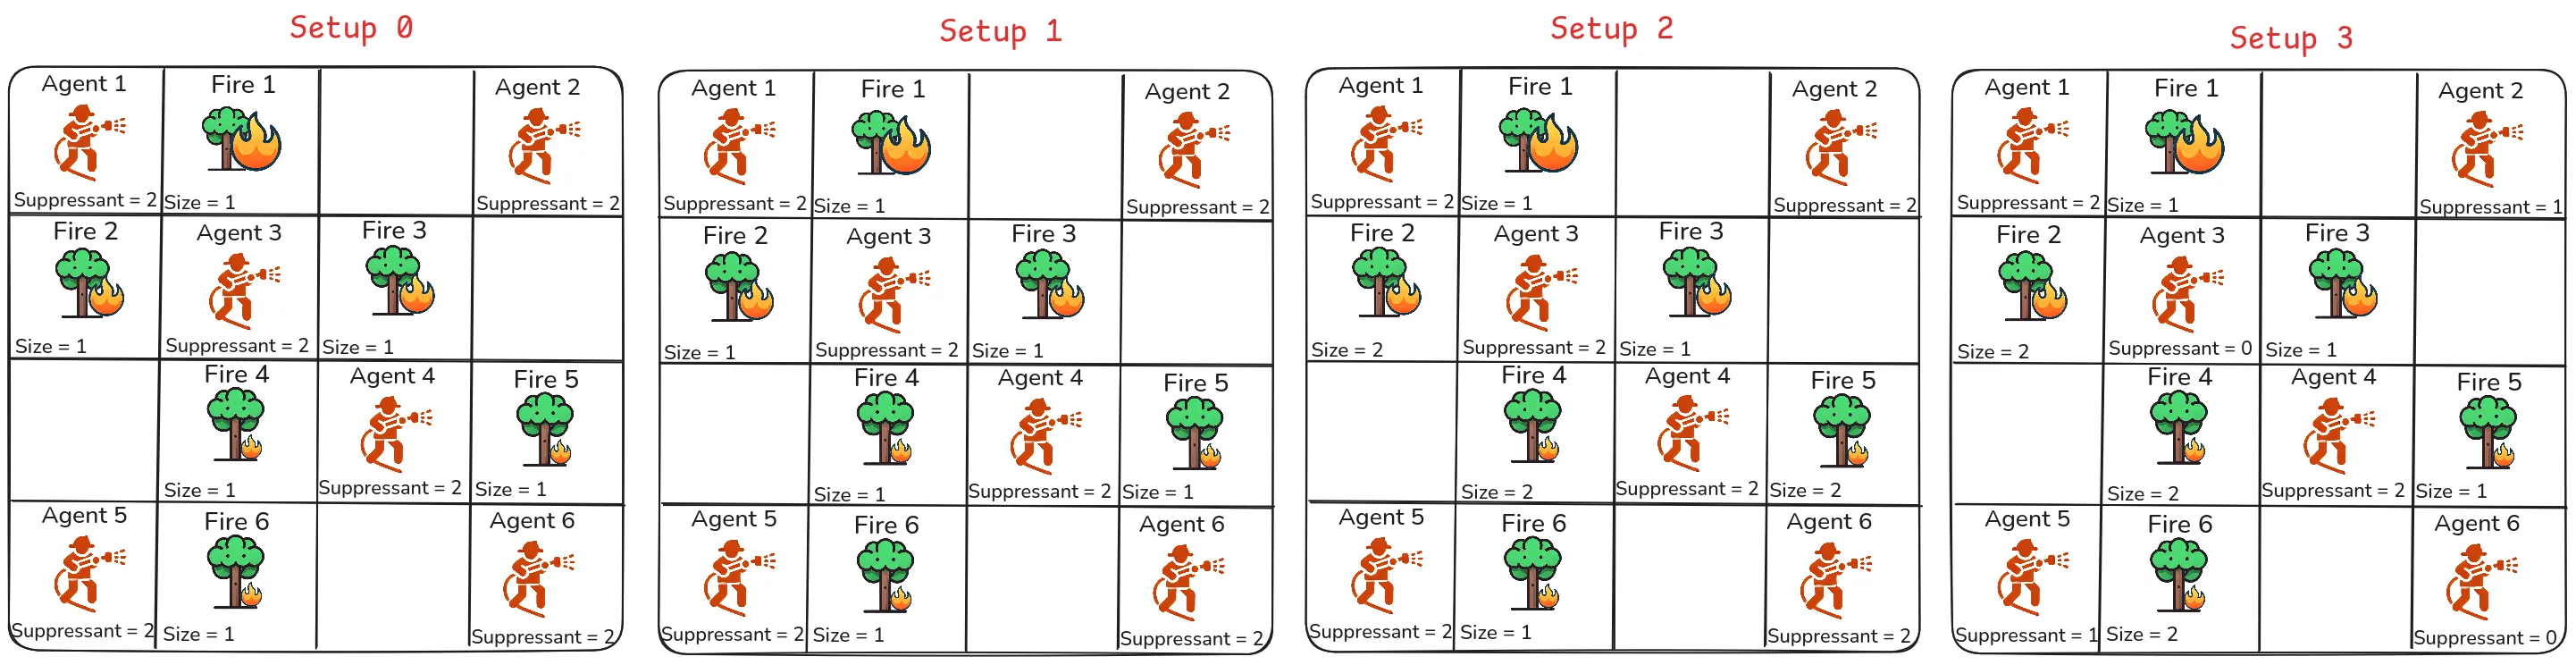
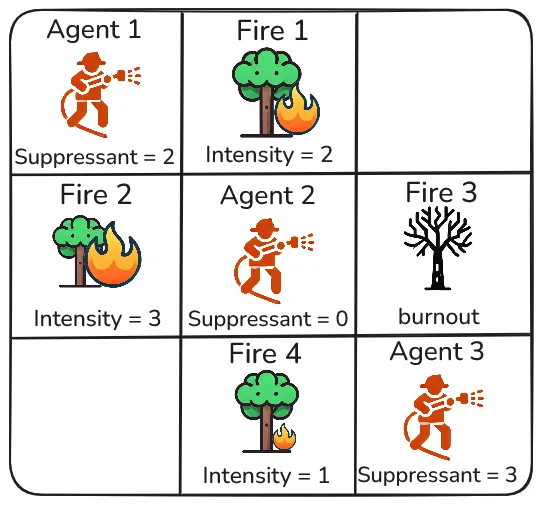
实验在 MOASEI 野火抑制领域进行,模拟智能体使用灭火剂扑灭网格中随机出现的火点。研究者设计了四种难度递增的实验设置,从封闭场景逐步引入内生任务扩散、外生随机点燃以及智能体补给失败率。
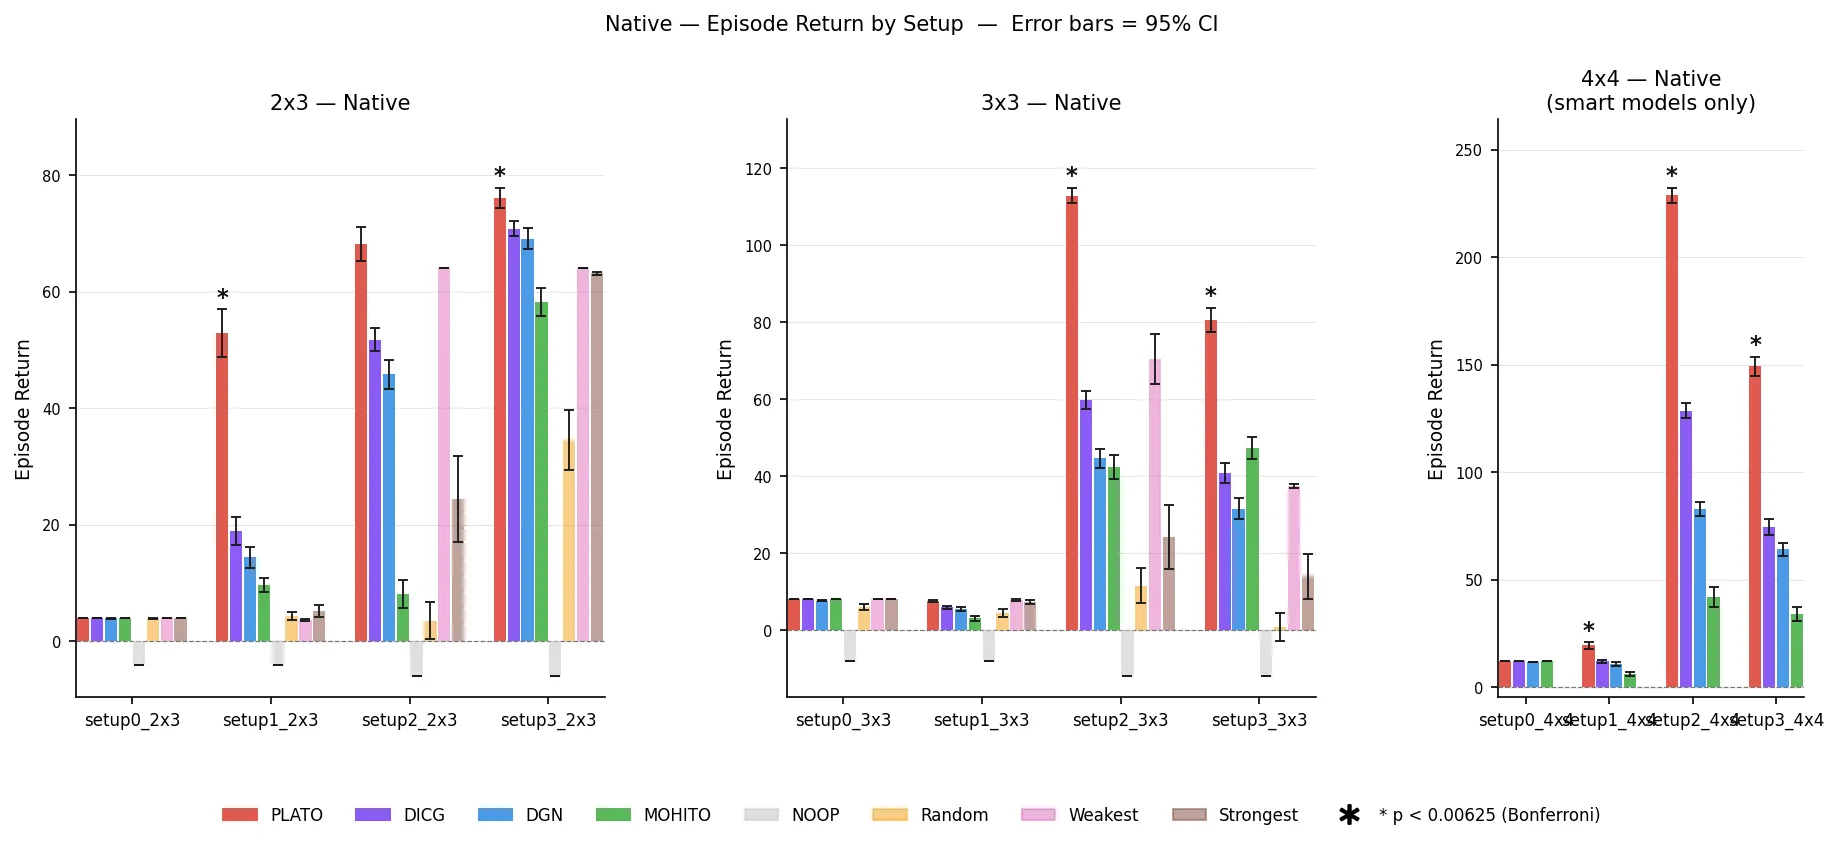
在 与 网格的困难场景下,PLATO 取得最高回合回报且具有统计显著性。特别值得注意的是,在封闭场景下所有智能方法性能持平,而开放性越高 PLATO 的优势越明显。每扑救奖励指标进一步显示 PLATO 在资源分配效率上的优势——它不仅扑灭更多火点,还能更精准地将有限灭火剂投向高优先级目标。
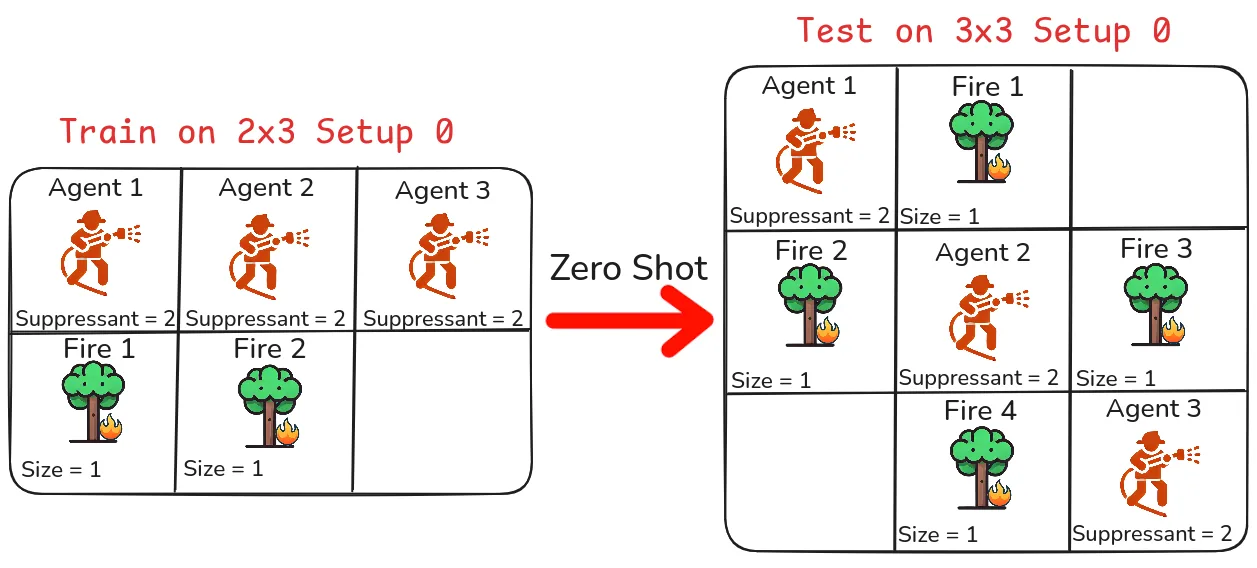
零样本泛化实验最具说服力:训练于 或 网格的策略直接部署到更大的未见网格上。PLATO 展现出明显更稳定的迁移能力,而基线方法随开放性增大出现显著退化。DGN 在大网格上几乎失效,MOHITO 在某些配置下产生负回报,PLATO 则保持了相对一致的策略质量。
消融实验揭示了有趣的现象:LSTM 编码器在分布外场景下优于 MLP 编码器,表明时间记忆对处理开放性有帮助;注意力打分函数与编码器的交互存在复杂效应,简单的结论难以成立。
讨论与可借鉴点
PLATO 在方法论层面的最重要贡献在于证明了一种可能性:当动作空间本身具有结构(这里是任务的内容语义)时,我们可以设计出天然适应空间变化的策略。指针网络将“选择哪个索引”转化为“指向哪个任务”,这个视角转换值得在更多场景中借鉴。
该工作的局限性也需要正视。当前形式化假设每个任务仅需一个动作,无法处理路径规划等需要序列决策的复杂任务;完全可观测假设排除了部分可观测场景;算力消耗(数千 CPU 天)也限制了大规模验证的可能。此外,MOHITO 基线仅针对任务开放性设计,将其用于同时包含 AO 与 TO 的场景存在公平性争议。
对于后续研究,一个有价值的探索方向是结合大型语言模型来理解任务语义,使指针网络的“软”能力从简单特征匹配扩展到真正的语义推理。另一个方向是将 PLATO 的思想与课程学习结合,渐进式增加开放性来训练更鲁棒的策略。
摘要
开放智能体系统(OASYS)在现实世界领域中越来越普遍,在这些领域中智能体和任务的集合会随时间发生不可预测的变化。这种开放性,包括智能体开放性(AO)和任务开放性(TO),对多智能体强化学习(MARL)构成了根本性挑战,因为后者通常假设固定的状态和动作空间。现有方法仅部分地应对了开放性:填充和掩码方法引入了人为边界,而近期的基于图或超图的方法仅处理了某一维度的开放性,且仍然依赖于限制性假设。在本文中,我们提出了用于智能体与任务开放性的指针学习器(PLATO),它是一种基于指针网络的执行者,结合了集中式的图神经网络(GNN)评论家,并在集中训练、分散执行的范式下通过多智能体近端策略优化进行训练。我们基于指针的执行者直接对当前任务集合输出分布。这直接支持变化的动作空间,无需掩码或重新训练。我们的 GNN 评论家将智能体-任务交互编码为一个随任务和智能体组成而改变形状的图。这些组件共同考虑了智能体开放性和任务开放性,且不存在现有方法的有界性限制。我们在任务与智能体开放马尔可夫博弈(TaAgO-MG)中形式化了 PLATO,扩展了先前的任务开放性表述,并证明了其在由此产生的无界状态和动作空间上是良定义的。我们使用开放智能体系统评估倡议方法(MOASEI)的野火扑救领域对 PLATO 进行了评估,这是一个专为开放多智能体系统评估而设计的环境,并且我们证明了 PLATO 在 OASYS 中相较于最先进的基线方法具有更强的性能和更一致的零样本泛化能力。
Abstract
Open agent systems (OASYS) are increasingly prevalent in real-world domains where the sets of agents and tasks change unpredictably over time. Such openness, including agent openness (AO) and task openness (TO), poses a fundamental challenge to multi-agent reinforcement learning (MARL), which typically assumes fixed state and action spaces. Existing methods address openness only partially: padding and masking approaches introduce artificial bounds, while recent graph-based or hypergraph methods handle one dimension of openness but still depend on restrictive assumptions. In this paper, we introduce Pointer Learner for Agent and Task Openness (PLATO), a pointer-network-based actor combined with a centralized graph neural network (GNN) critic, trained with multi-agent proximal policy optimization under a centralized training and decentralized execution paradigm. Our pointer-based actor outputs distributions directly over the current task set. This directly supports changing action spaces without masking or retraining. Our GNN critic encodes agent-task interactions as a graph that changes shape with task and agent composition. Together, these components consider AO and TO without the boundedness of existing approaches. We formalize PLATO in a Task-and-Agent-Open Markov Game (TaAgO-MG), extending prior task-open formulations, and prove it is well-defined over the resulting unbounded state and action spaces. We evaluate PLATO with the Methods for Open Agent Systems Evaluation Initiative (MOASEI) wildfire suppression domain, an environment designed for open multi-agent system evaluation, and we demonstrate strong performance and more consistent zero-shot generalization than state-of-the-art baselines in OASYS.
论文详细总结(自动生成)
PLATO 论文总结
一、核心问题与研究动机
开放智能体系统(OASYS)广泛存在于现实场景中,智能体集合与任务集合会在执行过程中动态变化(即智能体开放性 AO 与任务开放性 TO)。传统多智能体强化学习(MARL)通常假设固定的状态空间和动作空间,难以直接应对这种"无界"动态变化。现有方法的不足主要体现在:
- 填充与掩码方法(如 DICG、DGN)会引入人为设定的最大智能体/任务数量边界,本质上仍依赖固定空间假设;
- 图/超图方法(如 MOHITO)虽然具备一定表达能力,但通常仅处理单一维度(仅 TO),且对 AO 的随机性建模不足。
本文的核心问题是:能否设计一种无需重新训练、无需人工设定边界,且能同时联合处理 AO 与 TO 的 MARL 方法?
二、方法论
2.1 形式化扩展:TaAgO-MG
作者在 MOHITO 的 Task-Open Markov Game(TaO-MG)基础上扩展,提出 任务与智能体开放马尔可夫博弈(TaAgO-MG):
其中生成器 同时作用于任务集 与智能体集合 ,按时序生成当前博弈:
当新火点 出现或智能体 退出时, 与 同步更新动作空间与奖励函数。
2.2 PLATO 整体架构(CTDE 范式)
PLATO 由两部分组成:
- 指针执行者(Pointer Actor):分散执行,直接基于当前任务集生成动作分布;
- GNN 评论家(Centralized Critic):集中训练,将全局状态编码为智能体-任务二部图。
训练使用 MAPPO(多智能体近端策略优化),GAE 估计优势。
2.3 指针执行者(核心创新)
观测 经预处理分解为智能体特征矩阵 与任务特征矩阵 。
(1)智能体编码(应对 AO):对 计算四个置换不变统计量:
再经 MLP 得到固定长度查询向量 。
(2)任务编码(应对 TO):对每个任务独立编码:
外加一个常驻的 NO-OP 键。
(3)单步指针解码器:采用 Bahdanau 加性注意力计算得分:
softmax 后得到策略:
关键引理(Lemma 2)证明:任务到来或离开只会改变归一化常数 ,不会改变剩余任务间的对数优势 ,即支持集自适应且排序一致。
2.4 GNN 评论家
将全局状态编码为二部图 ,节点嵌入 经两层 GCN 消息传递(带残差连接),最后通过均值池化与 MLP 值头输出标量价值:
证明评论家同样具有置换不变性。
2.5 复杂度分析(Theorem 2)
即每步训练成本仅与当前活跃智能体与任务数量相关,不随固定上界而爆炸。
2.6 算法流程(Algorithm 1)
- 第 3 行:;
- 第 5 行:;
- 第 6 行:GAE 计算优势 ,PPO-clip 更新 ,MSE 更新 。
三、实验设计
3.1 评测环境
MOASEI 野火抑制(Wildfire) 域,规则 网格。三种智能体/任务规模:、、(零样本扩展至 )。
3.2 四种实验设置
| Setup | 扩散 (内生 TO) | 随机点燃 (外生 TO) | 补给成功率 (AO) |
|---|---|---|---|
| S0 | × | × | 无限 |
| S1 | ✓ (0.6) | × | 1.0 |
| S2 | × | ✓ (0.6) | 0.8 |
| S3 | ✓ + ✓ | 0.6 (最严苛) |
3.3 对比基线
智能基线(3 个):
- DGN:图卷积强化学习,固定动作集;
- DICG:深度隐式协调图,使用填充输入;
- MOHITO:超图 Actor-Critic,仅处理 TO。
朴素启发式基线(4 个):NOOP、Random、Weakest(弱火优先)、Strongest(强火优先)。
3.4 评价指标
- 回合回报(Episode Return):性能主指标;
- 每扑救奖励(Reward per Fight):效率指标;
- 补充指标:扑灭数、燃尽数、NOOP 比例;
- 零样本泛化:训练后直接部署到未见过的更大网格。
3.5 统计检验
采用 Shapiro-Wilk 自适应双侧检验(正态时 t 检验,否则 Wilcoxon 符号秩检验),Bonferroni 校正:主结果 ,零样本/消融 。
四、算力与资源
- 硬件:HPC 集群 Linux 节点,双 Intel Xeon Gold 6348 CPU @ 2.60 GHz,共 56 核,纯 CPU 计算,未使用 GPU;
- 单次训练:约 3–5 CPU-天;
- 完整实验套件(含所有方法、所有网格、所有 Setup 及 Optuna 调参):约 6000–10000 CPU-天;
- 环境库:使用 free-range-zoo(Patino et al., 2025);
- 超参调优:Optuna TPE 采样器,每方法 50 试次。
五、实验数量与充分性
- 网格规模:3 个(、、);
- Setup 数:4 个(S0–S3);
- 每方法评价:50 个评估种子 × 3 个 checkpoint = 150 回合;
- 零样本迁移方向:;;
- 消融实验:4 变体(MLP/LSTM 编码器 × 加性/点积打分器)的 因子设计,原生与零样本两组评估;
- 多重比较:主结果 8 模型族、零样本 4 模型族、消融 4 模型族,分层 Bonferroni 校正;
- 种子协议:全局 42、训练 300、评估 200–249 三层种子,互不相交,确保评估与训练分布不重叠。
整体而言,实验在网格维度、Setup、评估指标、统计检验、消融维度上都较充分。
六、主要结论与发现
1. 性能:在 与 的 S2、S3 场景下,PLATO 取得最高回合回报且具统计显著性;在 S0(封闭场景)所有智能方法持平。
2. 效率:PLATO 在 S2/S3 下保持最高的每扑救奖励,证明抑制剂分配更优。
3. 零样本泛化:在未训练过的更大网格上,PLATO 比基线更具一致性;MOHITO 在 S2()出现负回报,DGN 随开放性增大明显退化。
4. 消融结论:
- Q1(时间记忆 LSTM 是否有用?):原生评估中无显著差异;零样本 S3 下
lstm+add显著优于mlp+add,说明 LSTM 在分布外场景更有价值。 - Q2(打分函数影响):
lstm+add在 S3 零样本下显著优于lstm+dot;mlp+dot在零样本 S0 简单场景下最优。两者无绝对优劣,存在编码器-打分器的交互效应。
5. 良定义性:证明 PLATO 在无界状态/动作空间上是良定义的,且具置换不变性。
七、优点
1. 方法上的根本性创新:将动作选择从固定索引分类转化为基于内容的指针,彻底摆脱了填充、掩码与重新训练,使策略天然支持 TO;
2. 置换不变查询构造:采用均值、方差、最小、最大四个聚合统计量,避免智能体集合出现"混叠",并严格证明良定义性;
3. 形式化扩展清晰:将 TaO-MG 自然扩展为 TaAgO-MG,并给出形式化保证(Theorem 1、Lemma 1–3);
4. 双侧耦合优势:动作空间与智能体集合均变化时仍能保持对数优势排序不变,是真正意义上"零样本"适应;
5. 统计方法严格:Shapiro-Wilk 自适应检验 + 分层 Bonferroni 校正 + 三层种子协议,结论可信度高;
6. 可解释性:通过 Lemma 2/3 的对数优势分析,能精确刻画任务/智能体到来或离开时策略的响应方式。
八、不足与局限
1. 每个任务仅一个动作的假设:当前 TaAgO-MG 形式化要求 与任务 一一对应,无法处理"任务含多个可选动作"的场景(如路径规划中的多步决策);
2. 完全可观测假设:假设所有任务和智能体对当前智能体可见,无法直接应用于部分可观测环境;
3. 算力消耗极大:纯 CPU 计算 6000–10000 CPU-天,若加入更大规模网格与更多智能体,可扩展性仍需评估;
4. 任务奖励结构相对单一:野火域奖励仅与火点大小相关,未涉及复杂的合作/竞争奖励耦合;
5. 基线公平性争议:MOHITO 仅针对 TO 设计,将其用于 AO+TO 场景评估存在"先天劣势",对比公平性需要审慎解读;
6. 零样本仅在网格大小维度:未测试智能体数量、任务到达速率、奖励函数变化等更广泛的分布偏移;
7. 未涉及"框架开放性"(FO):智能体目标、偏好、能力的变化被显式留作未来工作;
8. 编码器-打分器交互尚无理论解释:消融仅揭示 lstm+add 在 OOD 下更优,但缺乏对为何 LSTM 与加性注意力产生协同效应的深层理论分析;
9. 方差仍然较大:尤其 S3 下 PLATO 回报标准差(如 S3 中 )相对均值仍不可忽略,说明开放环境下策略稳定性有提升空间。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。