
📝 TLDR
语言模型对齐通常依赖监督微调或基于人类反馈的强化学习,这些方法需要大量偏好标注。论文提出PARED方法,受逆强化学习启发,仅利用专家演示数据即可恢复出可检查、可重用的隐式奖励函数。该方法通过轻量判别器在响应级特征空间中分离演示与策略自身采样,实现推理时重排序与对抗式在线策略优化。实验表明PARED既能直接提升基础策略,也能在标准SFT之后进一步增益,并支持面向不同受众的上下文对齐。
🧭 速览
现有语言模型对齐方法依赖偏好标注或人类反馈,但能否仅从演示中恢复出可复用、可检查的隐式奖励仍未充分探索。
PARED通过轻量判别器在小规模响应级特征空间中分离专家演示与策略自身采样,恢复显式奖励函数。
在推理时重排序与对抗式在线策略RL中均提升基础策略性能,并在SFT后继续带来增益,同时支持面向不同受众的上下文对齐。
PARED表明演示数据本身即可提供任务级监督,无需额外偏好标注,为语言模型对齐提供了可解释且可灵活复用的奖励信号。
🆚 方法对比
PARED
- 无需任务特定偏好标注
- 恢复的奖励显式且可检查
- 支持推理时和训练时使用
- 可用于受众条件上下文对齐
- 依赖人工选择的特征空间
- 排除长度等特征可能影响效果
- 需在线重训判别器增加复杂度
Supervised Fine-Tuning (SFT)
- 简单直接且训练稳定
- 充分利用演示数据
- 不能恢复显式奖励目标
- 无法检查或审计对齐目标
RLHF
- 策略梯度优化探索更广
- 奖励模型可重用和审计
- 需要大量人工偏好标注
- 存在奖励黑客风险
DPO
- 绕过显式奖励模型训练
- 训练稳定高效
- 偏好损失难以解释检查
- 对演示数据利用不充分
Classical/Adversarial IRL (GAIL, MaxEnt IRL)
- 从演示中推断奖励函数
- 理论上有奖励恢复保证
- 恢复的奖励与策略同样不透明
- 难以解释和审计实际含义
VARL (concurrent work)
- 判别器与可验证奖励结合
- 可减少验证器利用问题
- 依赖独立验证器
- 不适用于无验证器场景
Best-of-N Reranking
- 无需额外模型训练
- 可与任何生成模型配合
- 推理时计算成本高
- 性能受限于候选多样性
PARED借鉴经典IRL框架但约束到低维特征空间,使奖励可解释且无需偏好标注;相比SFT/RLHF/DPO仅利用演示或偏好的单一信号,PARED同时支持推理时重排序和在线策略RL,并天然支持上下文对齐,是VARL在无验证器场景下的互补方案。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
这篇论文提出了 PARED 方法,通过改造经典的逆强化学习思路,仅凭专家演示数据就能恢复出一个可解释的对齐奖励函数。实验表明,恢复出的奖励既能直接提升基础策略,也能在标准监督微调之后继续优化,并且支持同一模型根据不同受众(如成人与儿童)生成定制化回复——在 4,000 条演示的设定下达到 88.4% 的胜率提升。
研究背景与动机
语言模型对齐是让模型的输出行为可靠地反映人类期望属性的核心问题,典型目标包括有用性、安全性、指令遵循等。当前主流方法分为两大范式:[[监督微调]]基于专家演示让模型学会"怎么做",而 [[强化学习]](如 RLHF)或 [[偏好学习]](如 DPO)则依赖偏好比较信号驱动优化。然而这两条路都留下了一个尚未被充分回答的问题——演示样本本身究竟编码了多少对齐信息?这些信息能否被显式提取为一个可检查、可重用的奖励函数,并在策略层面继续优化?
[[逆强化学习]] 的研究传统正好切中这个问题的核心:它假设专家行为背后存在一个隐式的奖励函数,智能体的目标正是最大化这个奖励。如果能把这一思路迁移到语言模型场景,理论上可以从专家演示中"反推"出奖励,进而指导策略优化。但经典 IRL 和对抗式 IRL(GAIL)恢复出的奖励通常与最终策略紧密耦合,不具备透明性和可审计性。PARED 的切入点正在这里:保留 IRL 从演示推断奖励的思路,但要求恢复出的奖励必须是显式函数——定义在少量人工选择的响应级特征上,从而天然可解释、可审查。
方法
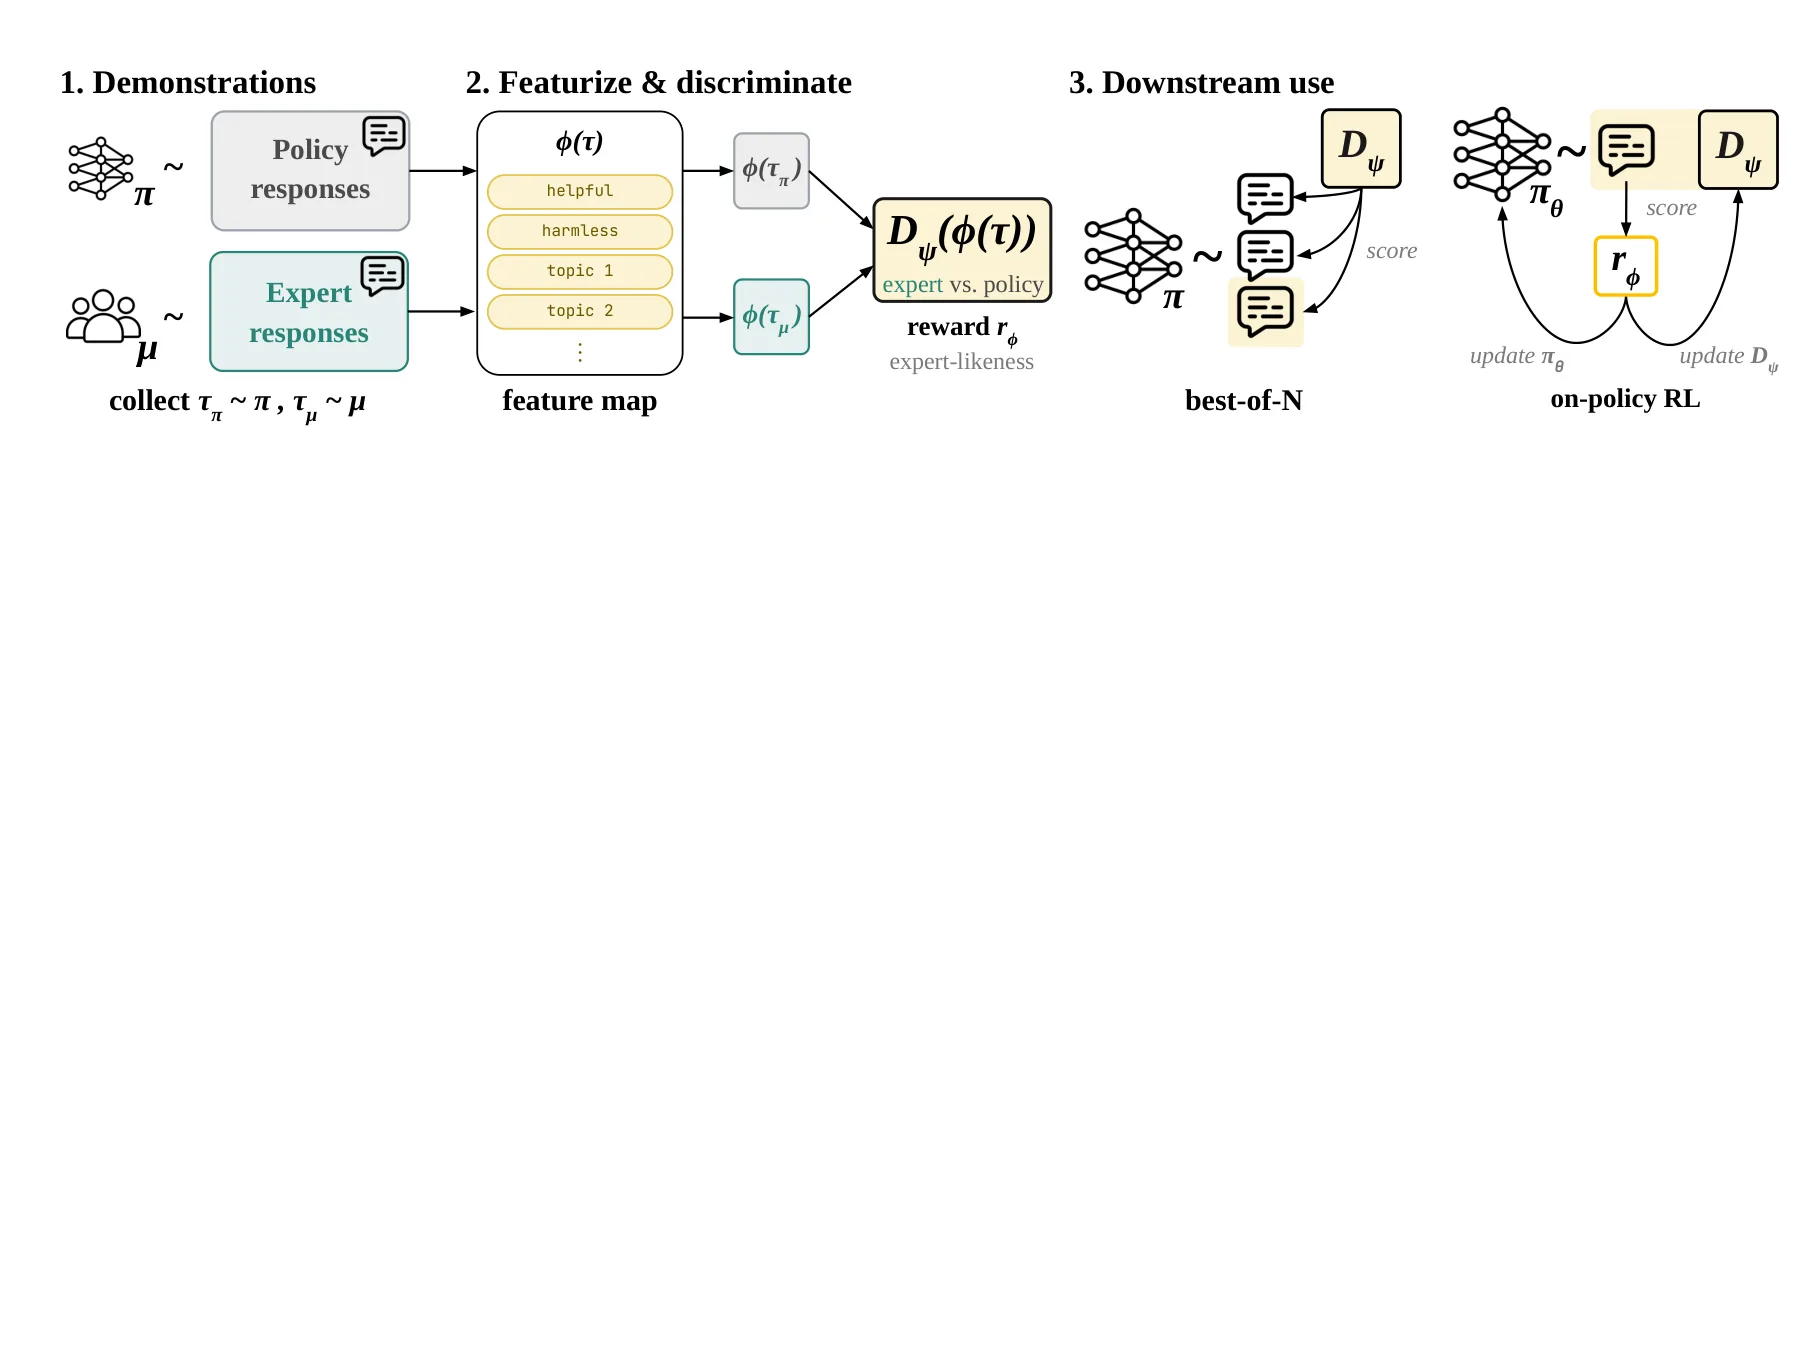
PARED 的核心设计可以概括为一个投影+判别的两阶段过程。给定一条交互轨迹 (其中 是包含用户 prompt 和受众标签的上下文, 是模型生成的完整回复),方法首先将其投影到一个低维的特征空间 ,再训练一个判别器 在这个特征空间里区分"专家演示"与"策略自采样的完成"。
特征空间的选择是整个方法的设计关键。论文选用了七维特征向量:其中两维来自 [[LLM即评判]] 范式下另一个语言模型对 helpfulness 和 harmlessness 的 1-10 评分(归一化后),另外五维是 TF-IDF 向量经 LDA 降维得到的文档-主题占比分布。值得注意的是,响应长度特征被刻意排除在外——这并非随意决定,而是因为长度是策略优化中最容易被利用的"作弊通道",论文的诊断实验显示长度与奖励的相关系数高达 0.92-0.98,必须从特征设计层面就截断这条捷径。
判别器本身是一个带有 L2 正则化的逻辑回归,但训练目标采用了标准的 GAN 式对抗形式:
其中 是专家演示分布, 是当前策略的采样分布。论文证明,当策略与演示无法被区分时(即达到均衡),恰好满足 ,其中 是特征的多项式展开——这与经典 IRL 的特征期望匹配解释一脉相承。最终的奖励函数就是判别器的对数几率:。
PARED 提供了两种使用方式。推理时可以直接做 best-of-N 重排序,从同一批候选完成中挑选奖励最高的,无需更新任何模型权重。训练时则可以驱动 [[强化学习]] 优化:策略一边采样新完成,一边用最新的判别器估计奖励,通过 GRPO 算法(一种 KL 正则化的策略梯度方法)更新策略参数:
为支持"同一 prompt 对不同受众输出不同内容"的上下文对齐需求,论文为每个受众群体(如成人与儿童)训练独立的判别器,但让策略参数完全共享。这种设计让单一模型能根据受众标签灵活调整风格,而无需为每个群体单独微调。
实验与结果
实验在 Anthropic 的 HH-RLHF 数据集上进行,构建了 HH-Large(4,000 条演示)、HH-Small(500 条平衡子集)两种训练规模,并设计了成人与儿童两个受众条件。演示由 GPT-5.1 响应系统 prompt 生成,评分使用 Gemma-3-27b-it,打分模型与被优化模型(Qwen2.5-3B-Instruct + LoRA)来自不同模型家族以降低评估偏差。
在基础策略(Instruct checkpoint)上直接应用 PARED 的在线强化学习,4,000 演示设定下达到了 84.6% 的 side-by-side 胜率。更值得关注的是 post-hoc 增益实验:先做标准监督微调(SFT-HH-Large),再在其基础上应用 PARED 强化学习,仍能获得 88.4%(frozen 判别器)和 86.2%(online 判别器)的额外胜率提升。这说明演示数据中蕴含的监督信号并未被标准 SFT 充分榨取,[[逆强化学习]] 视角的奖励恢复能挖掘出额外的优化空间。
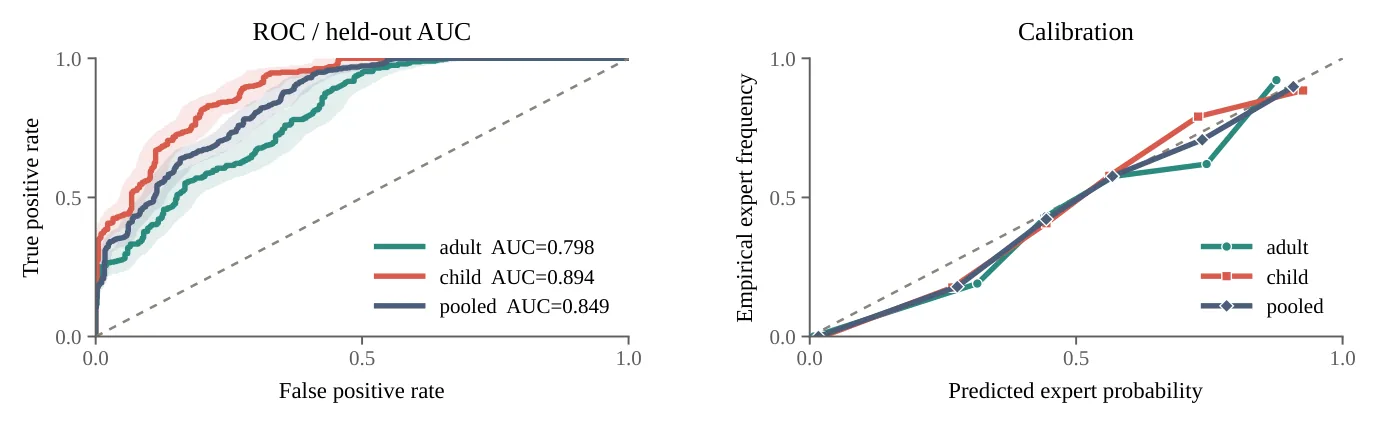
低数据场景的消融同样验证了方法的数据效率:在仅有 500 条演示时,ab-initio PARED 达到 70.7% 胜率,显著优于同等数据量的 SFT-HH-Small(58.0%)。诊断指标显示,判别器在 held-out 集上达到了 0.849 的 AUC,且按受众分解(成人 0.798 / 儿童 0.894)的差异说明不同群体确实需要不同的对齐策略。
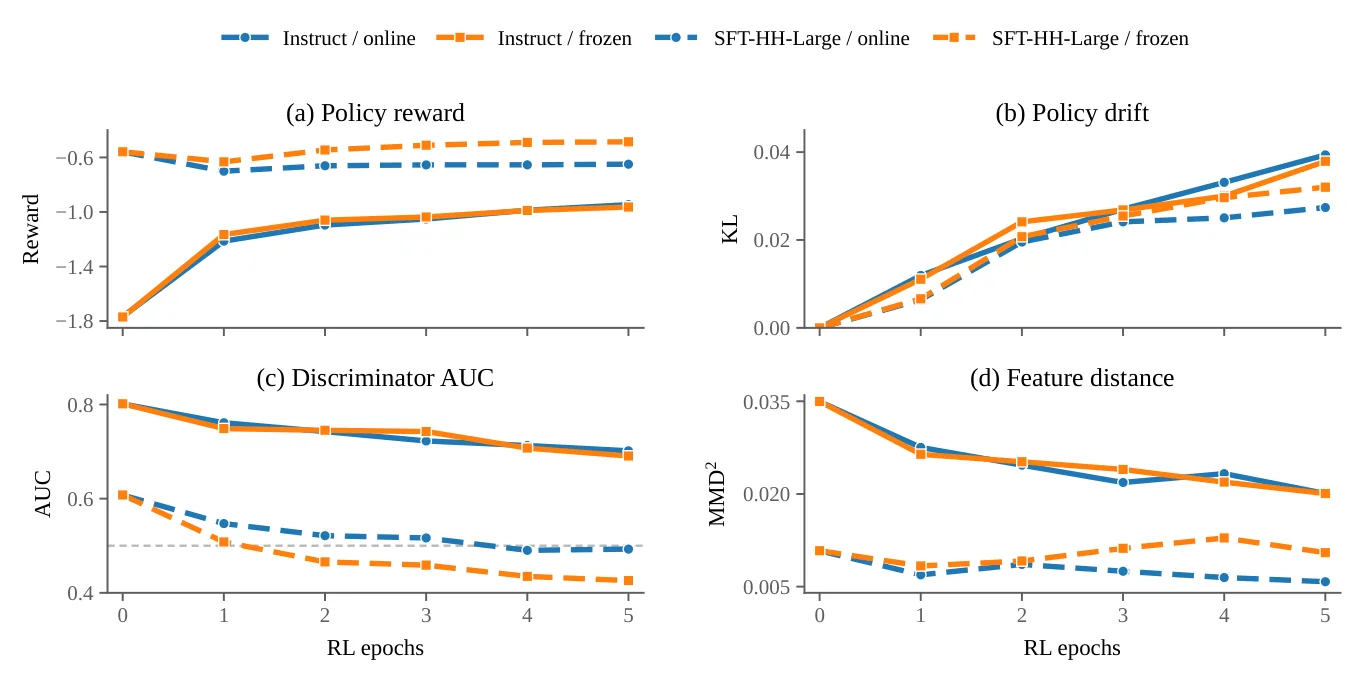
论文还主动暴露了方法的风险点:当判别器冻结训练时,AUC 在训练推进过程中出现反转——这正是经典的 reward hacking 现象,说明策略在绕过判别器的监督。online 调度(定期用最新采样重训判别器)部分缓解了这个问题,但也引入了训练不稳定的代价。
讨论与可借鉴点
PARED 展示了一条不依赖偏好标注的对齐路径:演示本身即任务定义,判别器从演示分布中提取监督信号,策略优化在这一信号驱动下向专家行为靠拢。这种"演示即奖励"的范式在标注成本高、偏好定义模糊的场景下尤为有价值。
然而方法的边界也很清晰。奖励函数的能力上界由特征空间决定——如果关键的对齐属性没有被选入 ,判别器就无法学到相应的奖励。演示由 GPT-5.1 生成而非真实人类行为,结论能否迁移到人类专家场景需要进一步验证。评估虽然引入了 order-swap 和多模型分工,但仍是单一 LLM 评判,缺乏人类判断的交叉校验。
对后续研究而言,PARED 的"特征空间可人工指定"设计值得借鉴——它为融合多元监督信号提供了灵活的接口:LLM 打分、主题分布、毒性检测、格式合规性等都可以自然地编码为特征维度。更重要的是,这种可解释的奖励形式为"对齐审计"提供了技术基础——研究者可以检查判别器权重,识别哪些特征被过度依赖,从而在系统层面规避奖励 hack 的风险。
摘要
语言模型对齐旨在使模型行为可靠地反映期望的属性,如有用性、安全性和遵循指令。当前的对齐方法通常使用监督微调(基于演示样本)或强化学习(基于验证器或人类反馈衍生的奖励)。这些范式留下一个尚未充分探索的重要问题:仅凭演示样本能否产生一个可被检查、重用并在策略上(on-policy)优化以对齐 AI 的隐式奖励?受逆强化学习的启发,我们提出了从演示中估计的投影对齐奖励(Projected Alignment Reward Estimated from Demonstrations,PARED)。PARED 将专家演示背后隐含的奖励恢复为响应级特征集合上的显式函数,该函数由一个轻量级判别器学习得到,该判别器在特征空间中区分演示样本与策略自身生成的样本。与标准奖励模型不同,PARED 不需要任务特定的偏好标注:演示样本提供了任务特定的监督,并可通过 AI 反馈作为额外的监督维度加以增强。通过涉及推理时重排序和对抗性在策略强化学习的实验,我们表明恢复出的奖励能够在不使用监督损失的情况下改进基础策略,并在标准监督微调之后进行优化时获得进一步的提升。此外,我们证明 PARED 可用于上下文对齐,即单个策略可以根据不同受众的偏好进行定制。
Abstract
Language model alignment aims to make model behavior reliably reflect desirable properties such as helpfulness, safety, and instruction following. Current approaches typically use supervised fine-tuning on demonstrations or reinforcement learning with rewards derived from verifiers or human feedback. These paradigms leave an important question underexplored: can demonstrations alone yield an implicit reward that can be inspected, reused, and optimized on-policy to align AI? Motivated by inverse reinforcement learning, we introduce Projected Alignment Reward Estimated from Demonstrations (PARED). PARED recovers the implicit reward underlying expert demonstrations as an explicit function over a small set of response-level features, learned by a lightweight discriminator that separates demonstrations from the policy's own samples in this feature space. Unlike a standard reward model, PARED requires no task-specific preference annotations: demonstrations provide the task-specific supervision, which can be augmented with AI feedback as additional dimensions of supervision. Through experiments involving inference-time reranking and adversarial on-policy RL, we show that the recovered reward improves a base policy without a supervised loss and yields further gains when optimized after standard supervised fine-tuning. Additionally, we demonstrate that PARED can be used for contextual alignment, in which a single policy can be tailored to the preferences of different audiences.
论文详细总结(自动生成)
论文总结:Inverse RL Helps Align AI by Imitating Humans
1. 核心问题与研究动机
论文关注语言模型对齐中的关键缺口:现有方法主要依赖两类监督信号——监督微调(SFT)基于演示样本、RLHF / DPO 等偏好优化方法基于偏好比较。然而,这两类范式都没有充分回答一个问题:仅凭演示样本,能否恢复一个可检查、可重用、并能在策略上进行优化的隐式奖励?
- SFT 只能让模型模仿专家行为,但不会暴露专家行为背后的"目标函数",因此得到的策略不透明、难以审计;
- 偏好优化依赖昂贵的人工或 AI 偏好标注,且往往把奖励隐式嵌入策略参数;
- 逆强化学习(IRL)虽然能从演示中恢复奖励,但经典与对抗式 IRL 恢复出的奖励通常与训练出的策略一样不透明。
论文的定位是:将 IRL 思路引入 LM 对齐场景,但仍把奖励显式化、可审计化,并探索一种无需偏好标注、仅依靠演示的对齐新范式。
2. 方法论:PARED 框架
2.1 核心思想
PARED(Projected Alignment Reward Estimated from Demonstrations)的核心思想可以概括为一句话:把专家演示和当前策略的输出都投影到一个小维度、人工可指定的响应级特征空间,再用一个轻量逻辑判别器区分两类样本;判别器的"专家相似度"就是对齐奖励。
这样做的关键意义:
- 演示样本天然提供任务级监督,无需任何偏好标注;
- AI 反馈(如 LLM-as-judge 打分)可以作为额外的监督维度自然融合进特征空间;
- 因为特征空间是人工选择的,奖励天然具有可解释性、可审计性。
2.2 关键技术细节
轨迹表示:把响应级轨迹记为 ,其中 是上下文(含用户 prompt 与受众标签), 是完整回答。论文中的具体特征映射为:
其中 是用 google/gemma-3-27b-it 对 helpfulness 与 harmlessness 打的 1–10 分(除以 10 归一化), 是 TF-IDF + 5 主题 LDA 得到的文档-主题占比。最终特征图排除了长度,因为长度会在策略优化中变成可利用的捷径。
奖励估计:判别器目标为标准的 GAN 式对抗极大极小:
PARED 用的是 degree-2 多项式展开的逻辑回归(L2 正则化),即保留一阶项、平方、交叉项,因此有精确的特征期望匹配解释(Abbeel & Ng 2004; Ho & Ermon 2016):当策略无法区分自己与专家时,恰好有 。
奖励定义为:
策略更新使用 GRPO 优化 KL 正则化目标:
2.3 两种使用方式
1. 推理时重排序(best-of-N):从同一组候选中选取 最高的完成,无需任何权重更新;
2. 对抗式 on-policy RL:策略一边采样新完成,一边用最新完成的对比分布重新拟合或冻结判别器,再用判别器分数作为奖励驱动策略梯度。
2.4 上下文对齐(Contextual Alignment)
为支持"同一 prompt 对不同受众"产生不同响应,对每个受众 adult, child 训练独立判别器 ,但保持单一共享策略 ,其中 。组合奖励为 ,KL 正则化目标保持不变。
3. 实验设计
3.1 数据与场景
- 基础 prompt:Anthropic/hh-rlhf,分别取 1,000 个 helpfulness 与 1,000 个 harmlessness prompt,共构成 4,000 条 HH-Large-Train 演示;同时构造 HH-Large-Test(1,998 条)与 HH-Small-Train(500 条平衡子集);
- 专家演示生成:在每条 prompt 前加受众特定的 system prompt,由 GPT-5.1(snapshot gpt-5.1-2025-11-13)采样一次;
- 受众条件:成人(general adult)和儿童(vulnerable child 9–13 岁)两个对照设置;
- 评估协议:400 条 held-out prompt × 2 受众,用
google/gemini-2.5-flash做 order-swapped side-by-side 自动评判(swap-order 不一致视为平局,Wilson 95% CI)。
3.2 Benchmark 对比
没有传统的单一公开 benchmark;论文使用自建 prompt × AI 评判的协议,平行比较:
- vs. base 模型
Qwen/Qwen2.5-3B-Instruct; - vs. SFT checkpoint(SFT-HH-Large、SFT-HH-Small),验证 post-hoc 增益;
- head-to-head frozen vs. online 判别器调度;
- 在 4,000 / 500 / 100 三种数据规模上的消融。
3.3 模型与训练设置
- 被优化策略:
Qwen/Qwen2.5-3B-Instruct+ LoRA(rank 16, α=32,所有线性层); - 判别器:每受众一个逻辑回归 + L2 正则,最多 5,000 次迭代;
- SFT:AdamW,lr=1.25×10⁻³,cosine schedule,3% warmup,1 epoch;
- PARED RL:AdamW,lr=1×10⁻⁵,KL 系数 β=0.01;
- 生成:vLLM,温度 0.7,最大长度 2048,每 prompt 4 条完成。
3.4 评估 Prompt 与生成协议
论文附录 C 完整公开了所有 prompt 模板,包括成人专家 prompt、儿童专家 prompt、通用策略 sampling prompt、5 种 best-of-N 变体块、helpfulness/harmlessness 评分 prompt、side-by-side 评测 prompt。
4. 算力与资源消耗
- 论文正文与附录未明确报告 GPU 型号、数量、训练时长等具体算力信息;
- 致谢中提到"研究由 Coefficient Giving 资助,部分计算由 Texas Advanced Computing Center (TACC) 提供",未给出具体硬件配置;
- 可推断的消耗:判别器是低维逻辑回归、成本极低;PARED RL 主实验约 5 个 epoch(每 epoch 250 步),与典型 LLM fine-tuning 规模相当,但缺少精确数值。
5. 实验数量与充分性
论文做了相当系统的实验矩阵:
| 维度 | 数量 |
|---|---|
| 数据规模 | 100 / 500 / 4,000 演示 |
| 初始化 | ab-initio(Instruct)+ post-hoc(SFT checkpoint) |
| 判别器调度 | frozen + online |
| 使用方式 | best-of-N 重排序 + on-policy RL |
| 受众条件 | adult + child(始终分别报告) |
| 诊断 | 长度消融、reward-model-only vs topics-only 消融、bootstrapped ROC 与 calibration、按受众的 win-rate 分解、MMD² 距离、AUC 曲线、check-point sweep |
| 跨模型对照 | GPT-5.1 生成演示、gemma-3-27b-it 打分、Qwen2.5-3B 训练、gemini-2.5-flash 评判 |
总体上实验设计较为系统,重点关注了:
- 区分 ab-initio 与 post-hoc 两种范式;
- 跨数据规模鲁棒性(含 100 条演示的边界情况);
- frozen vs online 调度的 trade-off;
- 按受众分解的 fairness 检查(防止一项受众变好掩盖另一项变差)。
但仍存在可质疑之处:
- 仅一个 base 模型 + 仅一种特征实例化,限制方法可推广性结论;
- 仅一个 LLM 评判(即使做了 order-swap,也未与人类判断交叉校验);
- 500 条 demo 的"最佳 checkpoint"是基于同 held-out 集选出,可能乐观,作者已在文中明确提示。
6. 主要结论与发现
- Best-of-N 重排序:仅靠恢复的奖励,PARED 在 16 候选中以 63.4% 胜率(800 prompt × 2 受众,聚合)击败随机候选;
- On-policy RL(4,000 demos):
- ab-initio PARED:84.6% vs base Instruct(online schedule);
- post-hoc PARED 在 SFT-HH-Large 之上再获 88.4% 胜率(frozen)和 86.2%(online);
- 表明演示数据中蕴含监督学习未榨取的优化信号;
- 低数据规模:500 demos 时 ab-initio PARED 仍达 70.7% vs base,优于 SFT-HH-Small 的 58.0%;
- 诊断结论:
- held-out AUC = 0.849(按受众 0.798 / 0.894),奖励可分离演示与策略补全;
- average MMD² 从 0.035 下降至 0.020,证明策略确实在被推向演示的特征分布;
- 长度特征是"可控捷径"(相关系数 0.92–0.98),必须在实验设计层排除;
- frozen 判别器随训练推进会出现 AUC 反转,提示 reward hacking;
- 按受众分解未发现此消彼长,所有 headline 增益在成人与儿童两侧都成立。
7. 优点
- 可解释奖励:因为奖励仅是低维特征上的判别器输出,可以人工审查权重、识别 shortcut(论文中长度被识别的过程即为示例);
- 任务级监督信号:演示数据本身即定义任务,无需额外偏好标注,使"演示就是奖励"成为可能;
- 统一推理与训练信号:同一判别器分数既可用于 best-of-N 选样,也可用于 RL,pipeline 一致;
- 方法论的灵活性:特征空间由实践者选择,可自然融入 AI feedback(如 LLM-as-judge 打分);
- 严肃的诊断视角:作者主动暴露了奖励 hack(frozen 调度下 AUC 反转、长度 shortcut)、checkpoint selection 偏差、SFT-vs-PARED 的不同失败模式,并做了 100 demos 这种边界场景;
- 设计上去耦合:演示生成、打分、训练、评判分别使用 4 个不同模型家族(GPT-5.1、Gemma-3-27B、Qwen2.5-3B、Gemini-2.5-flash),降低自评偏好。
8. 不足与局限
- 奖励能力受限:判别器只能学到 暴露出的属性,特征空间选择直接决定 alignment 行为的可塑范围;
- 数据来源单一:演示由 GPT-5.1 prompt 而来,并非真实人类行为,结论是否迁移到人类演示并不确定;
- 判别器信号在策略接近演示分布时必然衰减:这是所有 discriminator-based 奖励的共性问题,frozen 调度尤其明显;
- 评估的潜在偏差:
- 单一 LLM 评判,且优化目标的某些坐标(LDA 主题)可能也来自同一家族模型;
- 部分胜率提升可能源自评判偏好的风格或长度效应;
- 500 demos 的 checkpoint 是同评测集选出,置信区间为描述性而非统计性;
- 覆盖范围有限:仅一个 base policy、一种特征实例化、两类受众;扩展到其他语言/任务/用户嵌入的可行性未经验证;
- 无法替代偏好优化:PARED 不是 SFT 的替代品;论文明确指出 post-hoc 模式是在 SFT 之上叠加奖励优化,而不是绕开 SFT;
- 奖励过度优化风险:和其他 learn-reward-then-RL 的方法一样,理论上仍受 reward over-optimization 风险(Gao et al., 2022);作者已在文中承认;
- 缺乏完整算力披露:未给出 GPU 型号 / 总训练时长,外部难以评估方法实际部署成本。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。