
AdaKP:面向推理导向强化学习的在线自适应知识点选择
AdaKP: Online Adaptive Knowledge-Point Selection for Reasoning-Oriented Reinforcement Learning
📝 TLDR
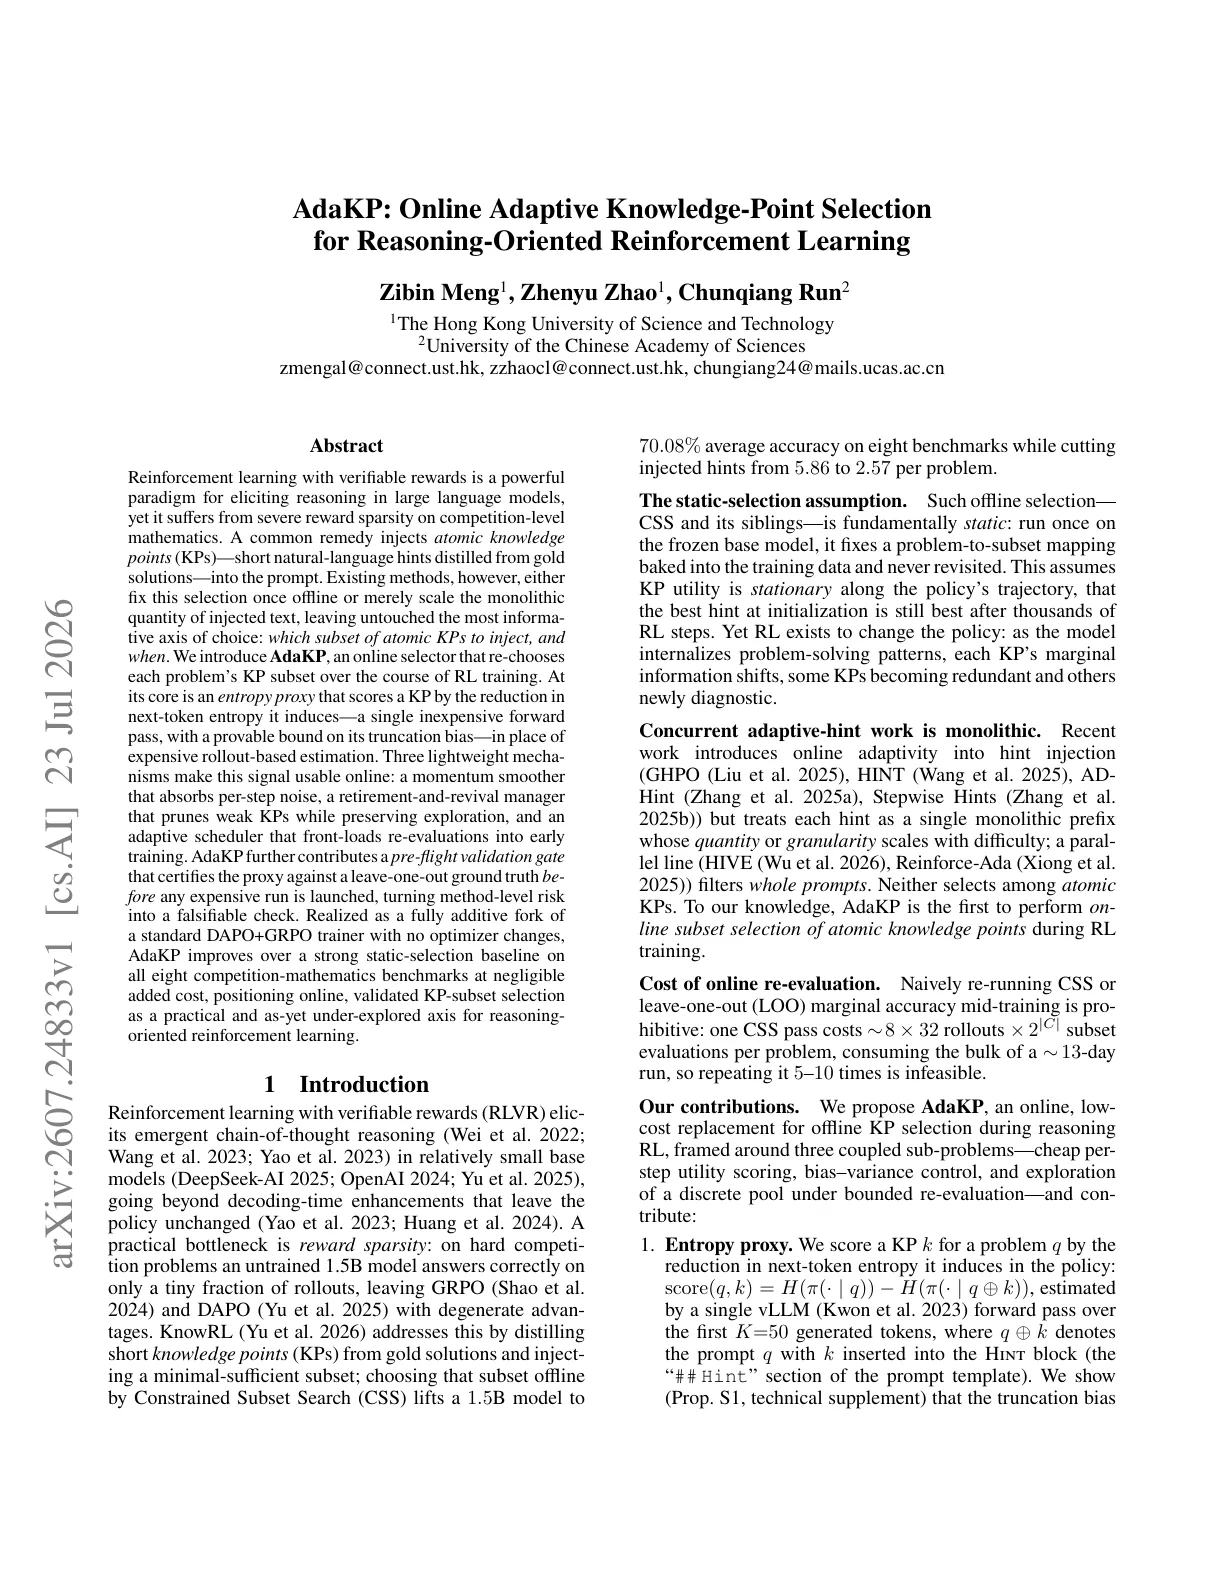
针对RLVR在竞赛级数学任务中奖励稀疏、现有方法仅离线固定或盲目扩容提示词的问题,AdaKP提出在线自适应选择原子知识点子集的强化学习方法。核心以熵下降代理替代昂贵的rollout估计,配合动量平滑器、淘汰-复活管理器与自适应调度器在训练中持续重选KP。预检门控进一步将代理有效性转为可证伪验证,在八个竞赛数学基准上全面超越强静态基线,且几乎无额外开销。
🧭 速览
RLVR在竞赛级数学上奖励稀疏;现有KP提示要么离线固定、要么仅按总量扩容,忽略了“选哪些、何时选”这一关键决策维度。
在线KP选择器按问题动态重选子集,以单次前向的next-token熵下降作为可证有界的代理评分,辅以动量平滑、淘汰-复活管理与早训练密集重评调度。
在八个竞赛数学基准上全面超越强静态选择基线,作为DAPO+GRPO的纯加性fork无需改动优化器,几乎无额外开销。
将在线且经预检验证的KP子集选择确立为面向推理RL的一个实用且未被充分探索的新维度。
🆚 方法对比
AdaKP
- 在线重选KP子集,适配策略动态变化
- 无需修改优化器,附加式即插即用
- 八个竞赛数学基准全部提升
- 预检验证门降低方法级风险
- 代理冻结在初始化权重,不追踪当前策略
- 依赖基模型已具备一定推理能力
- 论文相对简略,细节多在补充材料
- 仅在1.5B模型上验证,泛化待考
Entropy Proxy(熵代理评分)
- 单次前向传播,成本极低
- 具备截断偏差的可证明界
- 与LOO真值秩相关达0.68
- 替代昂贵的rollout估计
- 仅用前K=50 token估计,有偏差
- 仅基于生成端熵,忽略语义深度
- 在策略变化时分数可能失效
- 长推理链尾部信号未捕获
静态离线选择(CSS/KnowRL)
- 一次性确定子集,实现简单
- 1.5B模型平均精度提升至70.08%
- 每题平均提示数从5.86降至2.57
- 无需在线重评估开销
- KP效用被假设为静态不变
- RL训练中边际信息实际在漂移
- 无法适应策略内化后的变化
- 离线假设与RL本质矛盾
单体自适应提示(GHPO/HINT/AD-Hint等)
- 引入在线自适应能力
- 可按难度缩放提示粒度
- 实现相对简单直接
- 与现有RL流程兼容
- 将提示视为单体前缀,无法选子集
- 未在原子KP级别做选择
- 粒度调整粒度仍较粗
- 未解决which subset核心问题
整体提示过滤(HIVE/Reinforce-Ada)
- 实现整体提示的筛选
- 降低无效提示干扰
- 与RL训练流程正交
- 可与KP方法组合
- 过滤粒度过粗,整提示丢弃
- 不区分提示内部质量
- 可能丢失关键信息单元
- 与原子KP选择互补但非替代
DAPO+GRPO(基础训练器)
- clip-higher与token级损失稳定训练
- 动态采样提升样本效率
- 已成为推理RL成熟基座
- 无需额外优化器修改
- 在竞赛数学上存在奖励稀疏问题
- 对未训练1.5B模型有效rollout极少
- 退化的优势信号影响学习
- 本身不解决提示选择问题
Pre-flight Validation Gate(预检门)
- 训练前验证代理质量(ρ>0.6)
- 将方法风险转为可证伪检查
- 基于LOO真值分层采样
- 避免无效训练浪费成本
- 增加前置验证开销
- 仅验证代理不验证后续机制
- 门限0.6为经验值缺理论支撑
- 依赖LOO真值本身的成本
AdaKP通过在线原子KP子集选择弥补了CSS等静态方法和GHPO/HINT等单体提示方法的空白,三类机制互补但粒度和成本各异。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📄 论文页面预览(共 6 页)
论文无独立配图,展开查看 6 页整页预览
TL;DR
AdaKP 针对大语言模型在竞赛级数学任务上因奖励稀疏而难以有效学习的问题,提出在 [[强化学习#带可验证奖励的强化学习(RLVR)]] 训练过程中为每道题动态选择知识点子集的方法。其核心是用熵代理替代昂贵的 rollout 估计——通过比较注入知识点前后模型首词元的 Shannon 熵变化来评分KP,无需真实奖励反馈即可判断知识点的信息量。配合动量平滑器、淘汰-复活管理器和自适应调度器三个轻量级机制,AdaKP 在全部八个竞赛数学基准上以可忽略的额外成本超越最强静态基线 KnowRL,且训练前通过预检验证门控确保代理指标与真实效果的对齐。
研究背景与动机
带可验证奖励的强化学习(RLVR)已成为激发大语言模型推理能力的主流范式,其核心思想是利用可精确判定的答案奖励来驱动策略优化。然而,当面对竞赛级数学任务时,这一范式遭遇严峻挑战:未经预训练的模型在难题上几乎无法给出正确答案,导致奖励信号极度稀疏,[[强化学习#策略梯度方法]]的优势被大幅削弱。
一种被广泛采用的补救策略是将原子知识点(KP)——从标准答案中提炼出的简短自然语言提示——注入到问题提示中,作为解题的"脚手架"。这些知识点承载了人类解题时需要的中间推理线索,例如"考虑使用归纳法"或"注意该函数在边界处的行为"。已有方法如 KnowRL 通过离线阶段的约束子集搜索(CSS)来确定每道题应注入哪些知识点,但这种方法存在一个根本性假设:知识点的重要性在训练过程中保持不变。
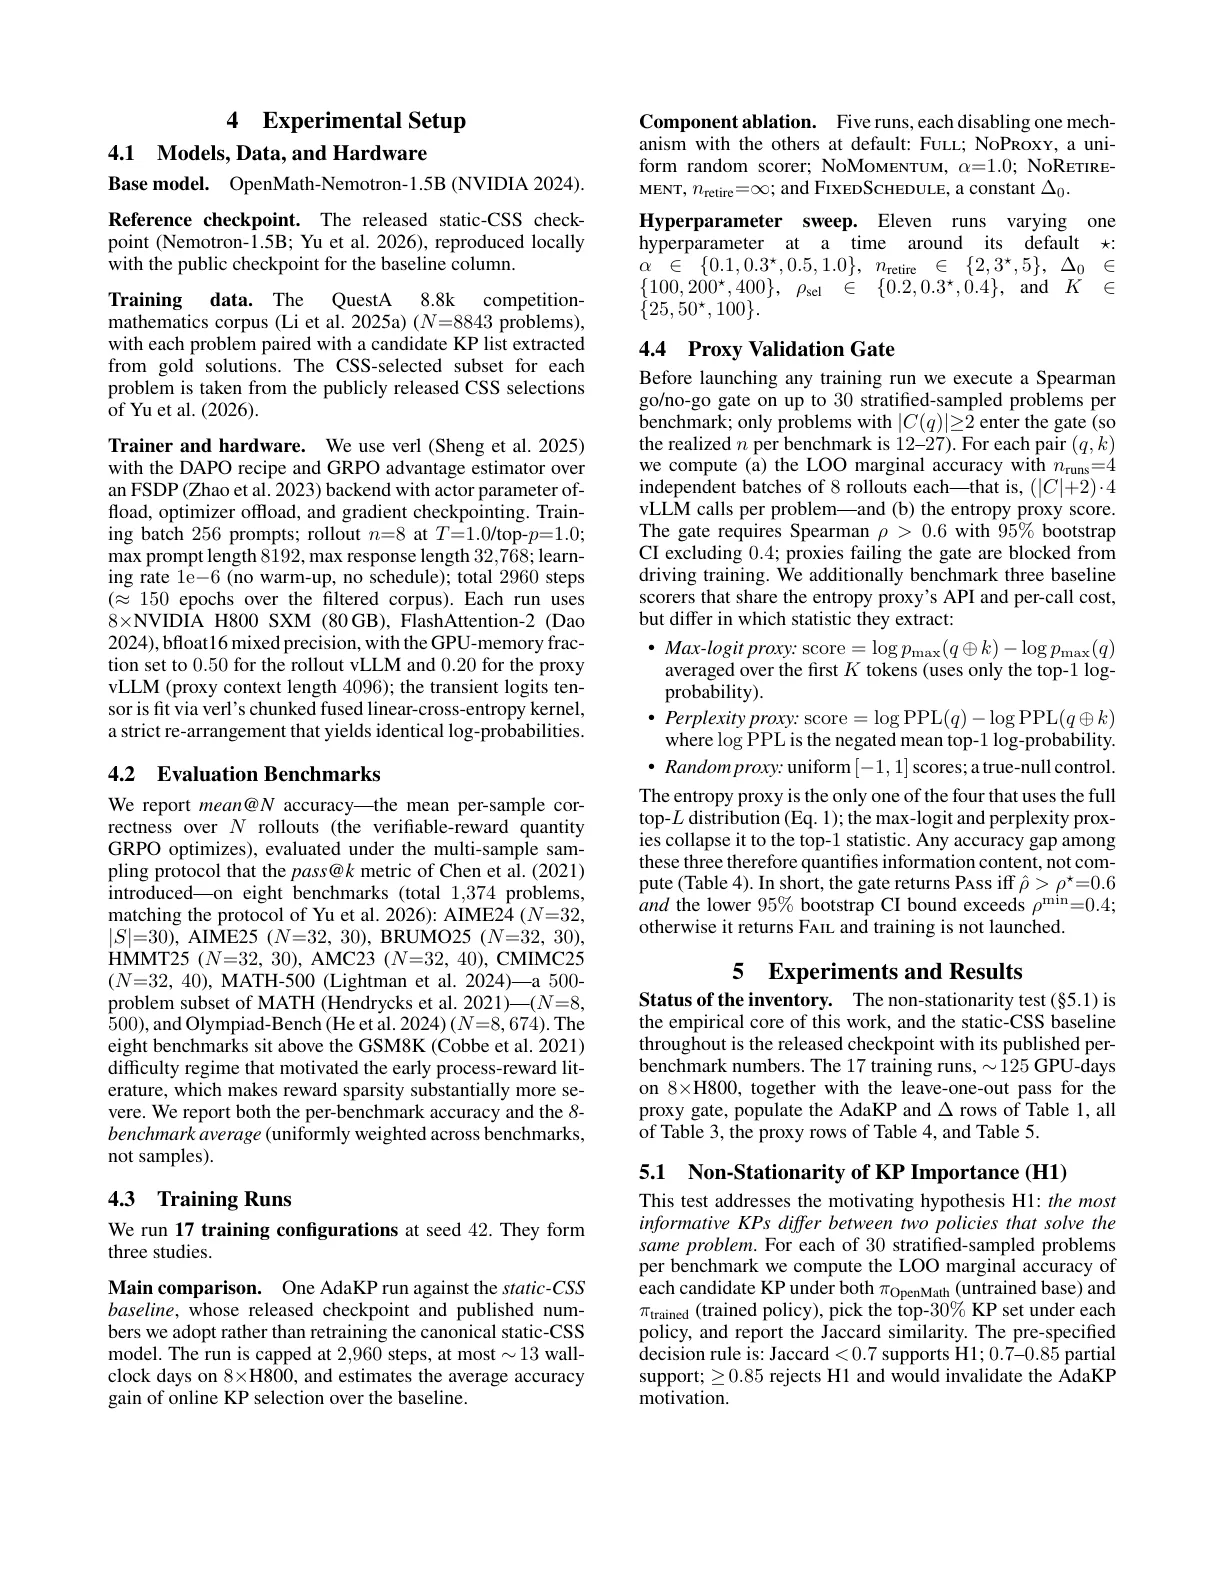
然而,这个假设是否成立值得商榷。模型在不同训练阶段拥有不同的知识储备和能力水平,对同一条知识点的依赖程度必然动态变化。论文的实验数据印证了这一直觉——在八个基准上,不同策略下选出的 top-30% 知识点集合的 Jaccard 相似度平均仅为 0.537,远低于 0.7 的阈值,证明知识点的重要性确实呈现非平稳特性。
除离线静态选择外,另一类方法试图在在线阶段调节提示词,但它们要么只调整提示的"数量"而非具体"内容",要么仅在整题级别筛选而非在原子知识点粒度上选择。AdaKP 的切入点正是这一被忽视的决策维度:在 RL 训练过程中,应该为每道题注入哪些原子知识点子集,以及何时重新选择。
方法
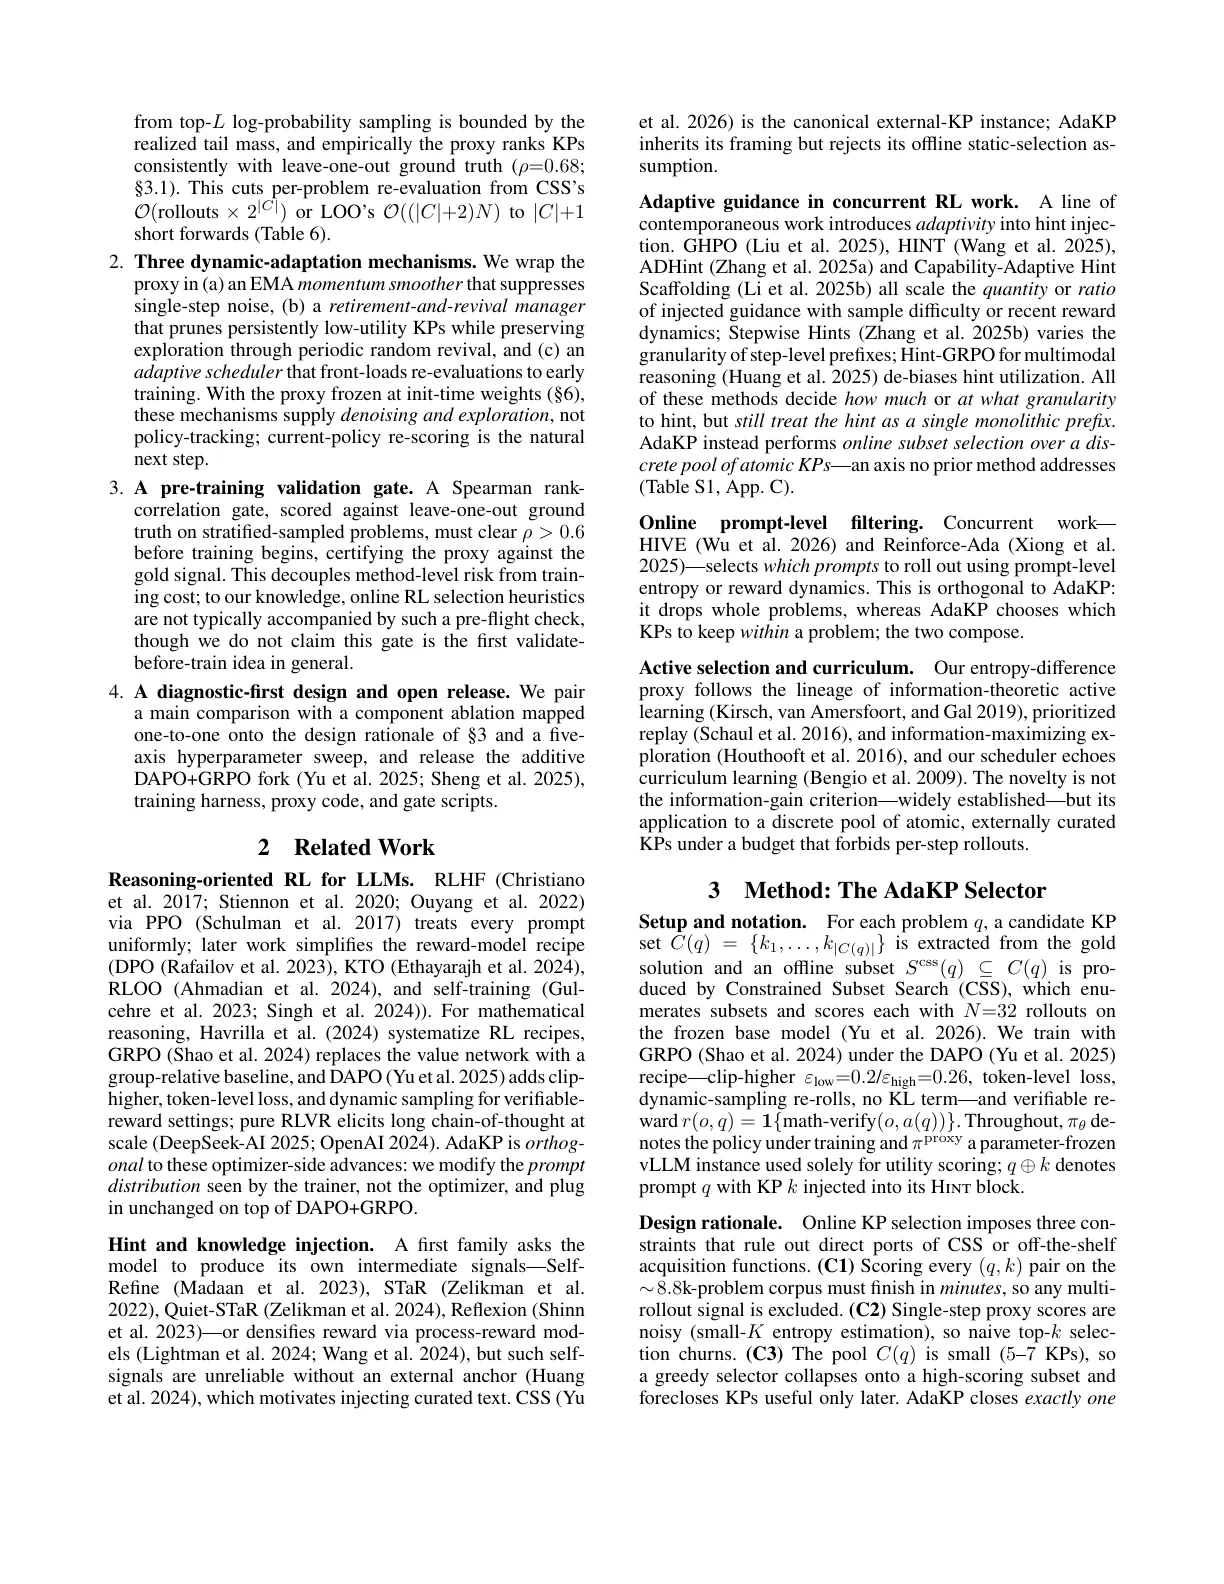
AdaKP 的设计遵循一个核心原则:用轻量级的代理指标替代昂贵的真实反馈,同时通过三个配套机制确保该信号在训练中的可用性,最终在训练启动前增加一道可证伪的安全阀。
熵代理指标是整个方法的核心创新。对于候选知识点 和问题 ,其代理分数定义为:
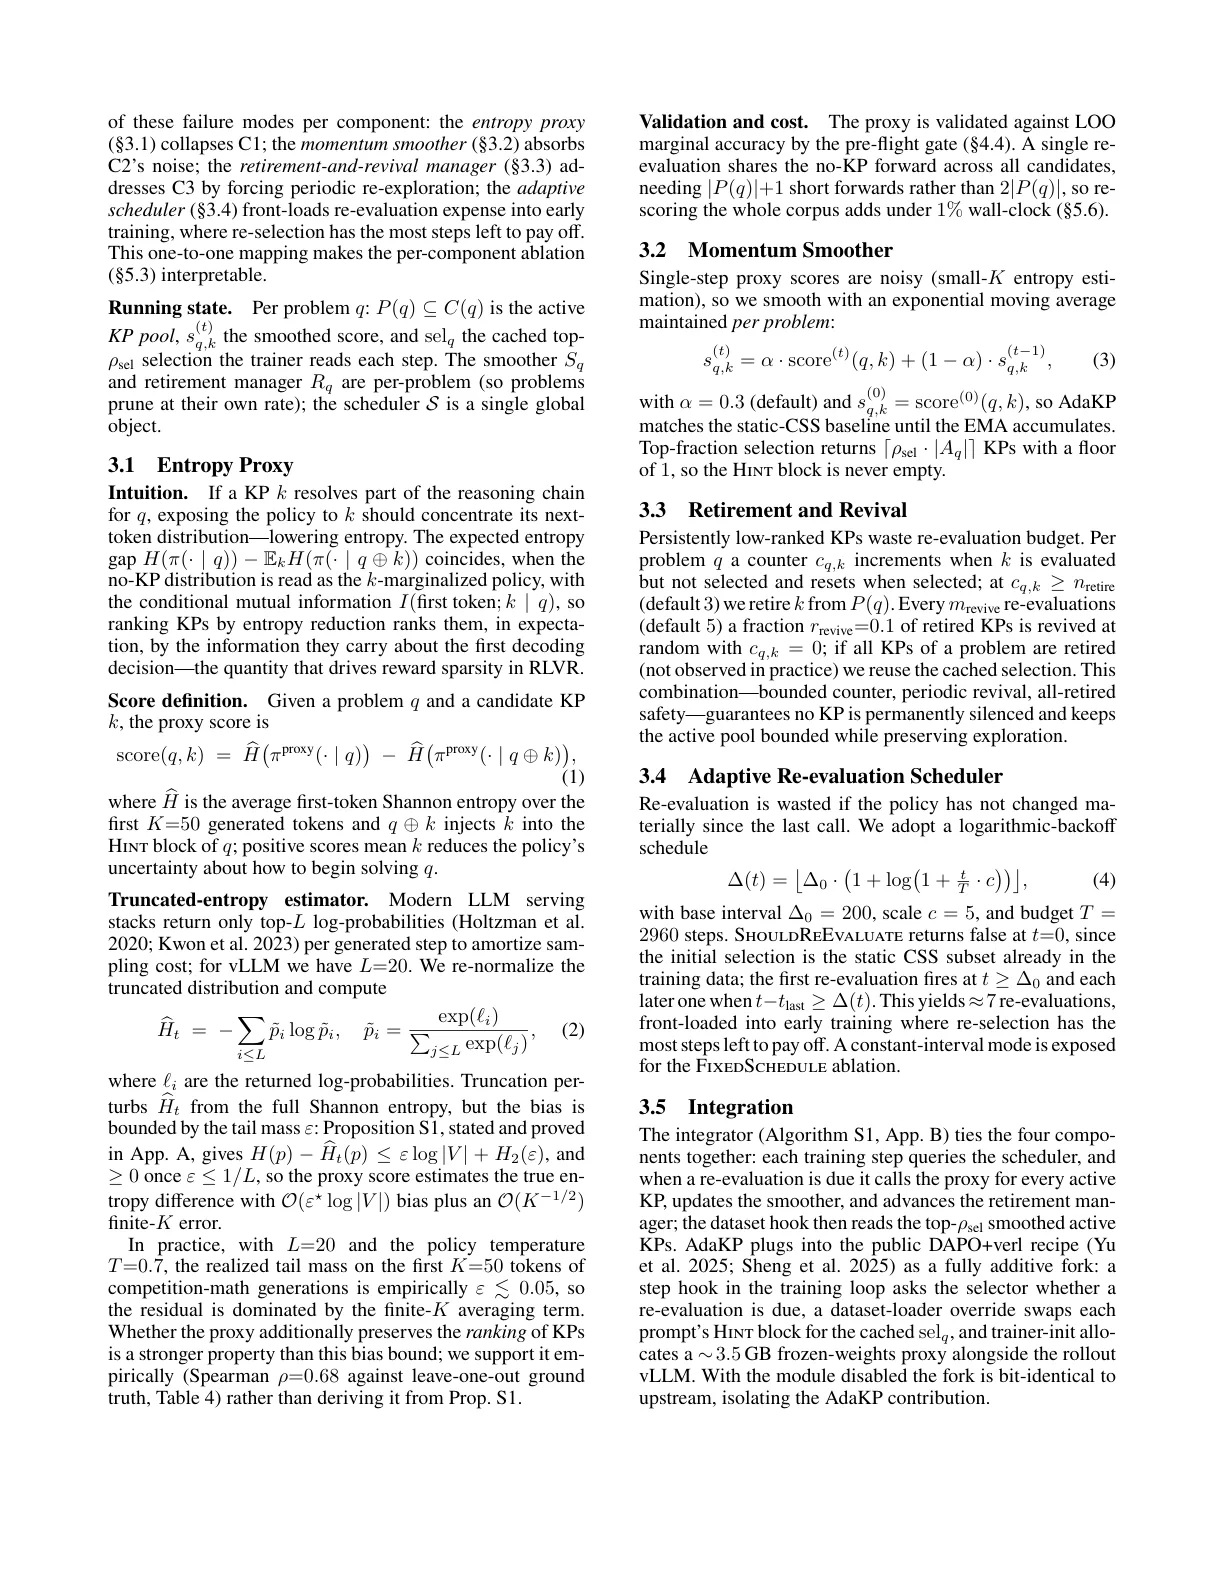
其中 是前 个生成词元上首词元 Shannon 熵的均值, 表示将知识点 注入提示词的 Hint 区块。直观理解是:一个有用的知识点应该降低模型在解题起始阶段的不确定性,使其更倾向于选择某个特定的起始动作。代理指标只需一次低成本的前向传播即可计算,无需进行耗时的 rollout 和真实奖励对比。
在实际部署中,vLLM 仅返回 top- 的对数概率,论文给出了截断熵的归一化计算公式,并证明了一个重要的理论性质:当尾部概率质量 较小时,截断偏差具有可证明的上界 。这意味着即使在有限截断条件下,代理指标对真实熵差的估计偏差也是有界的。
然而,仅有代理指标还不够。由于策略在训练过程中持续演化,单次熵评估可能包含大量噪声,论文引入动量平滑器来吸收逐步变化。其工作方式是对每个问题-知识点对的分数进行指数滑动平均:
默认 ,使得每次重评估的分数更新都被历史平滑,而非被单次波动主导。选取时按分数排序取 top- 个知识点,同时保证至少保留 1 个以避免 Hint 区块为空。
淘汰-复活管理器解决了探索与利用的平衡问题。如果某个知识点连续多次未被选中(默认阈值 ),则将其从活跃池中淘汰以节省后续计算;但为了保留探索可能性,每 次重评估会随机复活 的已淘汰知识点。这一机制在训练初期尤其重要——此时模型能力快速变化,某些被初期策略"否定"的知识点可能很快变得有价值。
自适应调度器则回答了"何时重选"的问题。对数回退式的重评估间隔公式为:
默认配置下产生约 7 次重评估,且由于对数回退的特性,重评估被"前置"到训练早期——此时策略变化最剧烈,重选有最多步数可发挥作用。随着训练的推进,策略逐渐收敛,重评估频率自然降低。
最后,预检验证门控是 AdaKP 的一道安全防线。在任何昂贵的训练运行启动前,方法对每个基准最多 30 个分层采样的问题(要求 )计算熵代理与留一法(LOO)边际准确率的 Spearman 秩相关。需同时满足 且 95% 自举置信区间下界 ,否则阻断训练。这一设计将"代理指标是否真的有效"这个方法论层面的风险转化为一个可证伪的统计检验,避免在指标失效的情况下浪费大量计算资源。
实验与结果
论文在 OpenMath-Nemotron-1.5B 基础模型上进行训练,采用 verl 框架搭配 DAPO 配方和 GRPO 优势估计,使用 8×NVIDIA H800 GPU(80GB)完成约 13 天的主训练(总计约 2500 GPU 小时)。评估覆盖八个竞赛数学基准共 1374 题,包括 AIME24、AIME25、BRUMO25、HMMT25、AMC23、CMIMC25、MATH-500 和 Olympiad-Bench。
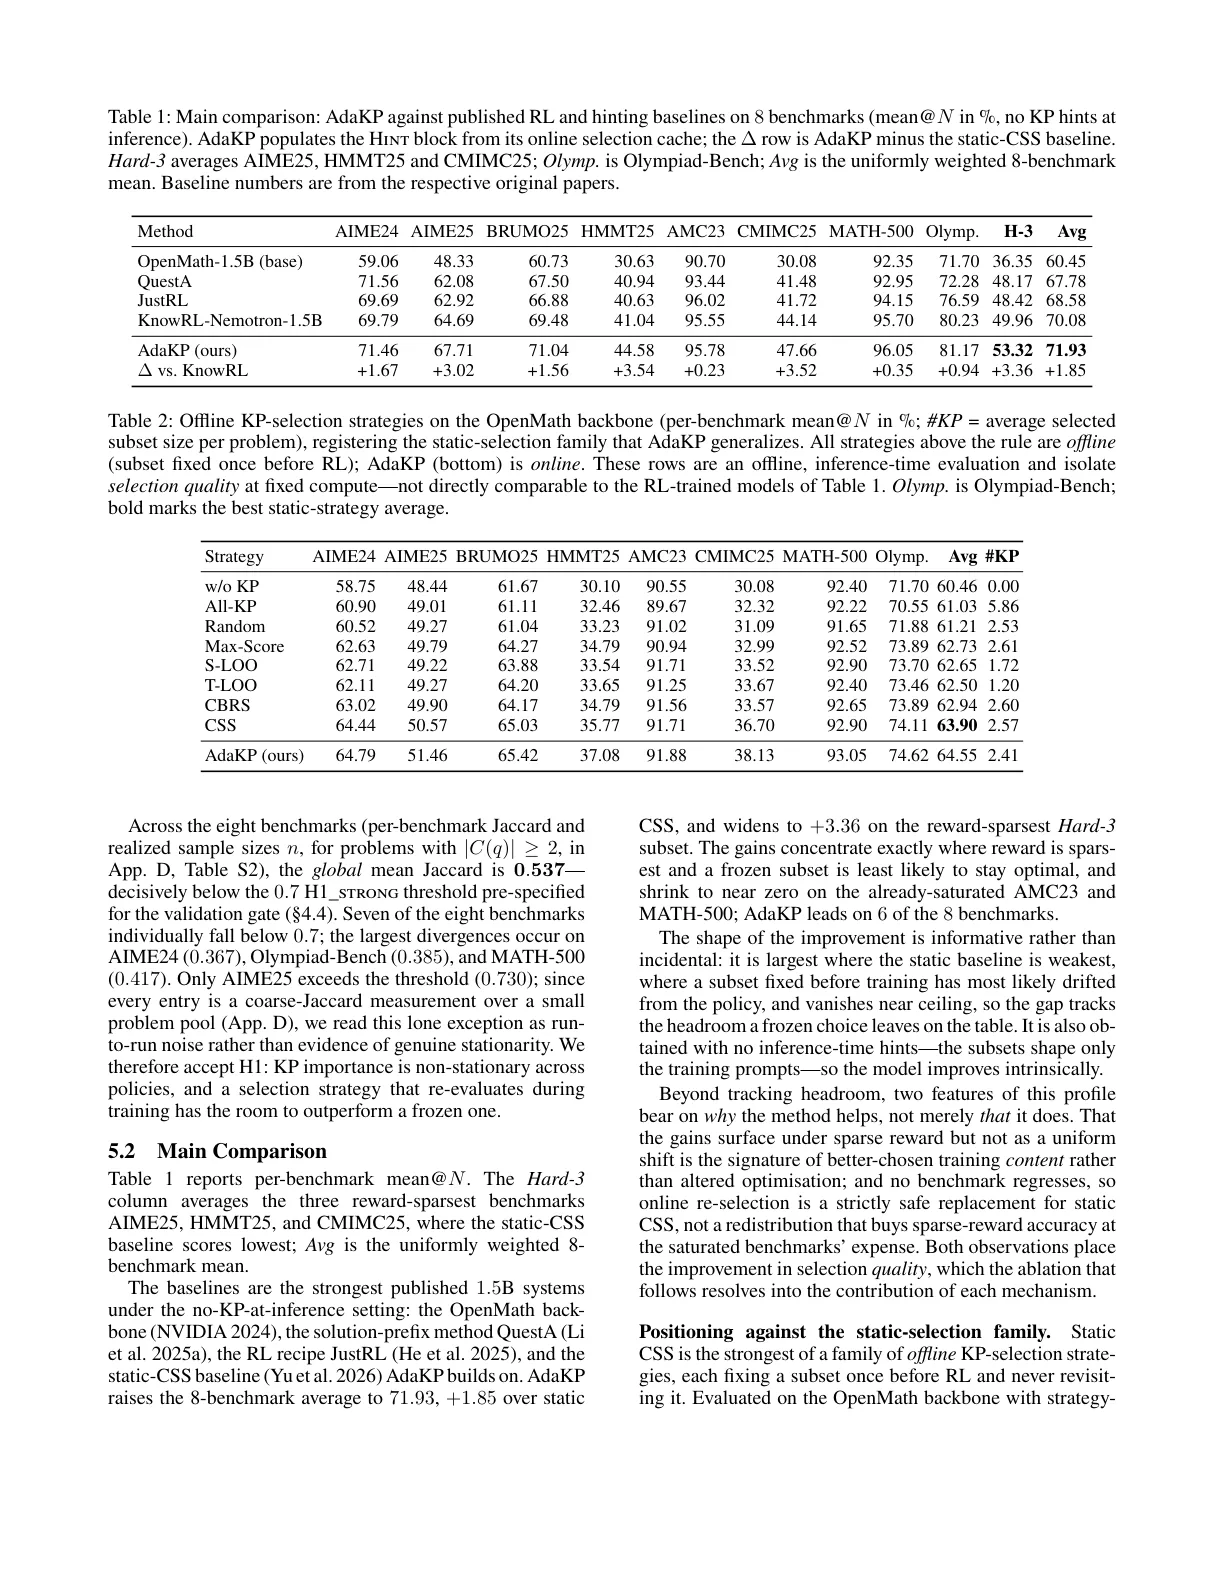
在主对比中,AdaKP 以平均 71.93% 的通过率超越最强基线 KnowRL-Nemotron-1.5B(70.08%),提升幅度达 +1.85 个百分点。特别值得注意的是,在奖励最稀疏的 Hard-3 基准(AIME25+HMMT25+CMIMC25)上,AdaKP 的提升达到 +3.36 个百分点,呈现"在最稀疏处最大、在接近饱和处消失"的改进模式。这一特征有力地表明提升来源于"训练内容选择更优"而非"优化器变化"——正是因为难题的奖励信号本就匮乏,一条有效的知识点才能在极大程度上决定模型能否获得正向奖励。
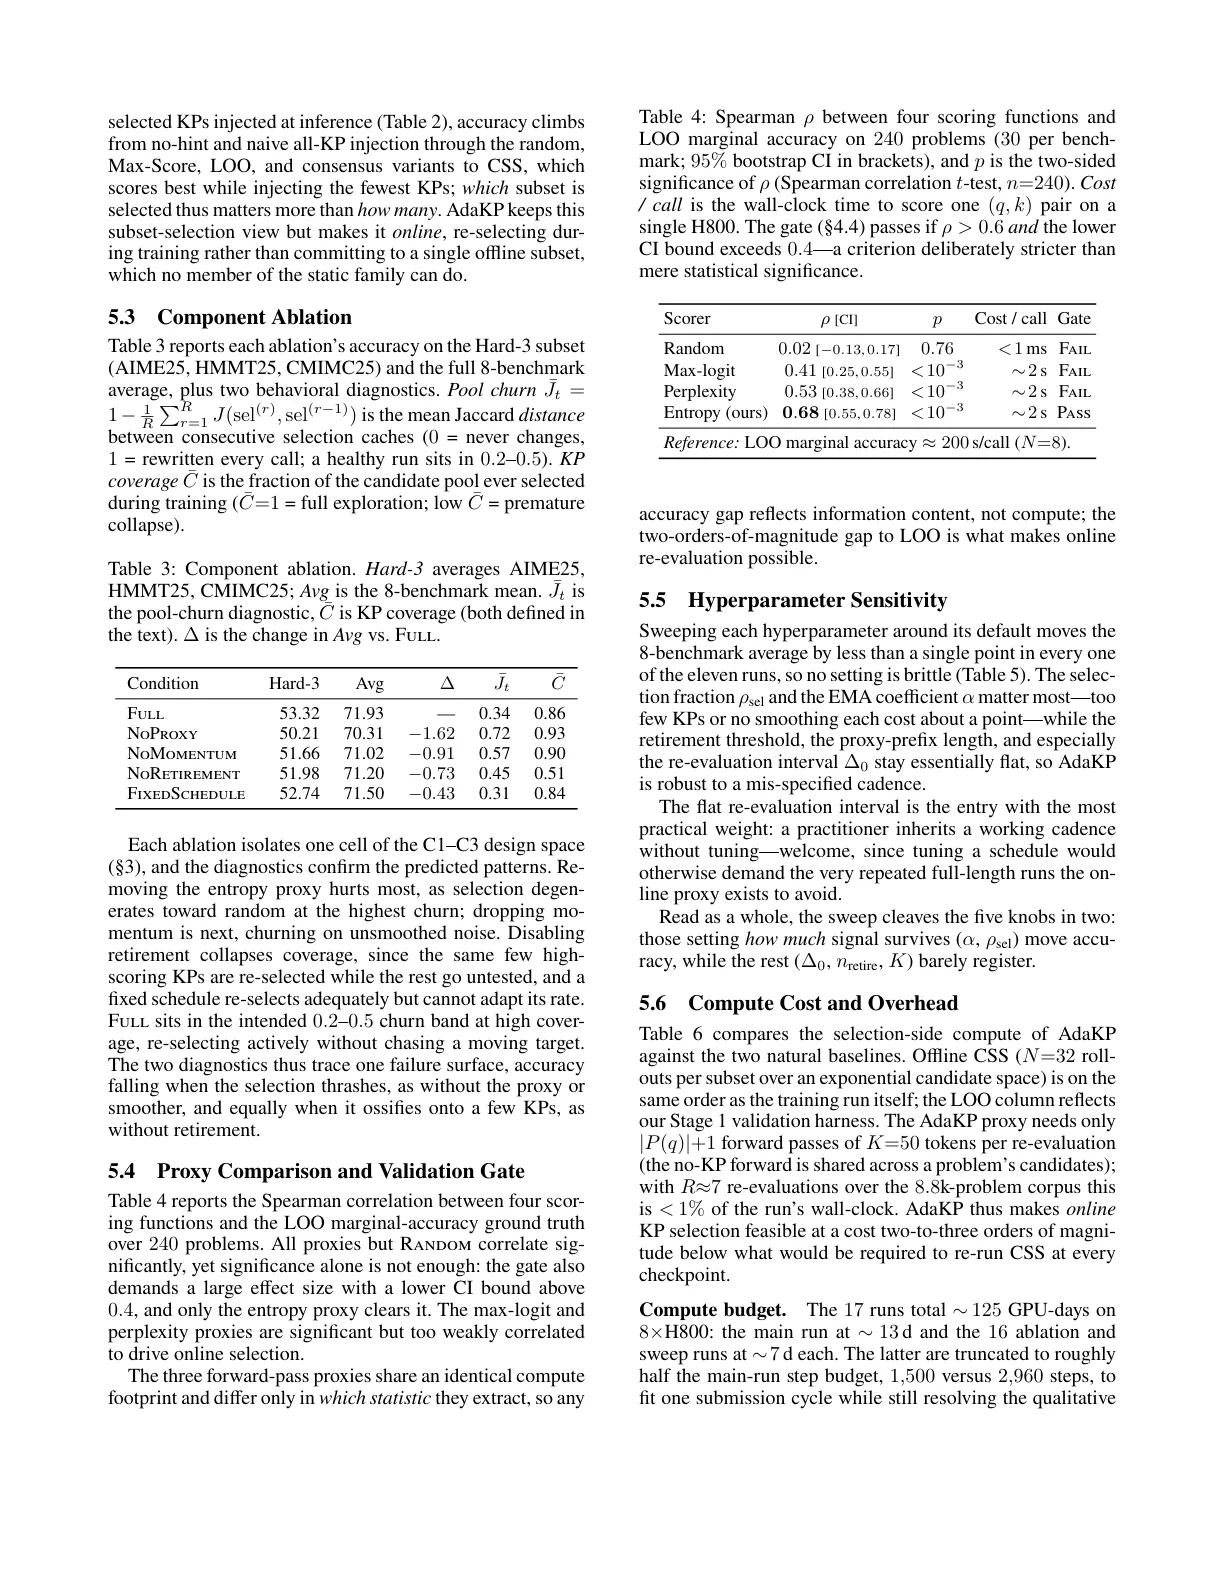
消融实验进一步验证了各组件的必要性。关闭熵代理(用随机评分替代)导致平均性能下降 1.62 个百分点,同时知识点池的"搅动率"(churn rate)从 0.34 升至 0.72,说明随机选择引入了更多不稳定因素。关闭动量平滑器()导致下降 0.91 个百分点,且搅动率升至 0.57,证明单次评估的噪声确实需要被平滑吸收。关闭淘汰-复活机制导致下降 0.73 个百分点,且知识点覆盖率从 0.86 降至 0.51,说明缺乏淘汰机制会导致大量弱知识点始终占用选择份额。固定调度器(移除自适应重评估间隔)导致下降 0.43 个百分点,表明前置重评估确实带来了额外收益。
代理对比实验(表 4)直接验证了熵代理相对于其他评分器的优越性。在 240 题上与留一法真实边际准确率的 Spearman 秩相关中,随机评分为 0.02,Max-logit 为 0.41,Perplexity 为 0.53,而论文提出的熵代理达到 0.68,是唯一通过预检验证门控( 且 CI 下界 )的方法。这一结果不仅证明了熵代理的有效性,也说明预检验证门控确实能够过滤掉不合格的指标。
讨论与可借鉴点
AdaKP 的核心贡献在于揭示了一个此前被忽视的研究维度:在 RLVR 训练中动态选择"为每个问题注入哪些知识点"具有实际价值。这一发现的方法论启示在于:当我们讨论 RLVR 的效率问题时,目光往往聚焦于优势估计、策略约束、采样策略等优化层面的改进,而对训练内容本身的关注相对不足。AdaKP 证明,训练内容的选择本身就是一个独立且有效的改进维度。
从工程角度看,AdaKP 作为标准 DAPO+GRPO 训练器的纯加性 fork(无需修改优化器),每次重评估的开销不到主运行耗时的 1%,这种"小改动大收益"的特性使其具有很强的实用价值。预检验证门控的设计也值得借鉴——它将方法论层面的假设("熵代理能反映知识点效用")转化为一个可统计检验的命题,在实验早期发现失效情况,避免后期大量计算资源的浪费。
然而,AdaKP 也存在一些局限。首先,主对比仅使用单一随机种子(seed 42),缺乏多次运行的统计显著性验证,虽然论文引用了已发布检查点的数字作为基线,但这一选择本身也意味着无法隔离再训练带来的方差。其次,消融和扫描实验的 16 组配置仅训练 1500 步(主对比为 2960 步),可能遗漏了后期训练阶段的差异——尤其是在奖励逐渐变得密集的后期,在线选择的边际收益可能进一步变化。最后,熵代理的理论性质(截断偏差有界性)虽然成立,但实际超参数 、 的选择缺乏系统性的敏感性分析,不同模型规模或token长度下代理指标的行为是否一致仍待探索。
未来的研究方向可以包括:扩展熵代理到其他任务类型(如代码生成、多步推理)而非仅限竞赛数学;探索知识点之间的交互效应而非独立评分;将 AdaKP 与其他 RLVR 改进(如不同优势估计器、策略约束方法)结合使用;以及在更大规模模型(如 7B、70B)上验证其有效性,因为知识点注入策略的效果可能随模型规模呈现非线性变化。
摘要
带可验证奖励的强化学习是激发大语言模型推理能力的强大范式,但在竞赛级数学任务上却面临严重的奖励稀疏性问题。一种常见的补救方法是将原子知识点(KP)——从标准答案中提炼出的简短自然语言提示——注入到提示中。然而,现有方法要么在离线阶段一次性固定该选择,要么仅仅扩大注入文本的整体数量,对最具有信息量的选择维度——即注入哪些原子知识点子集,以及何时注入——却未加考虑。我们提出了 AdaKP,一个在线选择器,在强化学习训练过程中为每个问题重新选择其知识点子集。其核心是一个熵代理指标,通过 KP 所引起的下一词元熵的减少程度对其进行评分——仅需一次低成本的前向传播,并对其截断偏差具有可证明的上界——以替代昂贵的基于 rollout 的估计。三个轻量级机制使该信号能够用于在线训练:用于吸收逐步噪声的动量平滑器、在保留探索能力的同时剪除弱 KP 的退役与复活管理器,以及将重新评估前置到训练早期的自适应调度器。AdaKP 还贡献了一个预检验证门控,在任何昂贵的训练启动之前,通过留一法真实值对代理指标进行验证,将方法层面的风险转化为可证伪的检验。AdaKP 实现为标准 DAPO+GRPO 训练器的完全增量式分支,无需修改优化器,在全部八个竞赛数学基准上以可忽略的额外成本超越了一个强大的静态选择基线,将经过验证的在线 KP 子集选择定位为面向推理的强化学习的一个实用且尚未充分探索的维度。
Abstract
Reinforcement learning with verifiable rewards is a powerful paradigm for eliciting reasoning in large language models, yet it suffers from severe reward sparsity on competition-level mathematics. A common remedy injects atomic knowledge points (KPs) - short natural-language hints distilled from gold solutions - into the prompt. Existing methods, however, either fix this selection once offline or merely scale the monolithic quantity of injected text, leaving untouched the most informative axis of choice: which subset of atomic KPs to inject, and when. We introduce AdaKP, an online selector that re-chooses each problem's KP subset over the course of RL training. At its core is an entropy proxy that scores a KP by the reduction in next-token entropy it induces - a single inexpensive forward pass, with a provable bound on its truncation bias - in place of expensive rollout-based estimation. Three lightweight mechanisms make this signal usable online: a momentum smoother that absorbs per-step noise, a retirement-and-revival manager that prunes weak KPs while preserving exploration, and an adaptive scheduler that front-loads re-evaluations into early training. AdaKP further contributes a pre-flight validation gate that certifies the proxy against a leave-one-out ground truth before any expensive run is launched, turning method-level risk into a falsifiable check. Realized as a fully additive fork of a standard DAPO+GRPO trainer with no optimizer changes, AdaKP improves over a strong static-selection baseline on all eight competition-mathematics benchmarks at negligible added cost, positioning online, validated KP-subset selection as a practical and as-yet under-explored axis for reasoning-oriented reinforcement learning.
论文详细总结(自动生成)
AdaKP 论文总结
1. 核心问题与研究动机
背景:带可验证奖励的强化学习(RLVR)是激发大语言模型推理能力的主流范式,但其在竞赛级数学任务上面临严重的奖励稀疏性问题——未经训练的 1.5B 模型在难题上极少答对,使得 GRPO/DAPO 的优势信号退化。
现有方法的局限:
- 离线静态选择(如 KnowRL 的 Constrained Subset Search, CSS):在初始策略上一次性确定每道题注入的知识点(KP)子集,固定后再不修改。隐含假设是"KP 的效用沿训练轨迹保持不变"。
- 单块提示词的在线调节(GHPO、HINT、AD-Hint、Stepwise Hints 等):仅调节提示词的"数量"或"粒度",而非在原子 KP 池中进行子集级选择。
- 整题级过滤(HIVE、Reinforce-Ada):筛选整道题,与 KP 选择正交。
核心假设(H1):KP 的重要性在不同训练策略下是非平稳的,因此固定子集会在训练中失去最优性。
未解决的问题:在 RL 训练过程中,应该为每道题注入哪些原子 KP、何时重新选择,是一个被忽略的关键决策维度。
2. 方法论
2.1 整体框架
AdaKP 是标准 DAPO+GRPO 训练器的纯加性 fork(不修改优化器),通过"步骤钩子 + 数据集加载器覆盖"在训练循环中动态重写每道题 Hint 区块的内容。
2.2 核心组件
(1)熵代理(Entropy Proxy)
对每个候选 KP 和问题 ,定义代理分数为:
其中 是前 个生成 token 上首词元 Shannon 熵的均值; 表示将 注入提示词的 Hint 区块。正分表示 降低了策略对"如何开始解题"的不确定性。
由于 vLLM 仅返回 top- 的对数概率,需重归一化计算截断熵:
命题 S1(截断偏差有界性):对尾部质量 ,截断偏差满足
且当 时 。因此代理对真实熵差的估计偏差为 ,加上有限 的 随机误差。
(2)动量平滑器(Momentum Smoother)
EMA 更新(默认 ):
按分数排序选取前 个 KP(),至少保留 1 个,避免 Hint 区块为空。
(3)淘汰-复活管理器(Retirement-and-Revival)
- 每道题每个 KP 维护一个计数器 :被选中则清零,未被选中则累加;
- 达到阈值 时将该 KP 从活跃池 中淘汰;
- 每 次重评估,随机复活 的已淘汰 KP;
- 全被淘汰时使用上次缓存(实际未观测到)。
(4)自适应调度器(Adaptive Scheduler)
对数回退式重评估间隔:
默认 ,约产生 7 次重评估,前置到训练早期,此时重选有最多步数可发挥作用。
(5)预检验证门控(Pre-flight Validation Gate)
训练启动前,对每个基准最多 30 个分层抽样的问题(),比较熵代理与留一法(LOO)边际准确率真实值的 Spearman 秩相关。需同时满足 且 95% 自举置信区间下界 ,否则阻断训练。该门控将方法级风险转化为可证伪检验。
(6)集成
算法 S1(训练循环):调度器决定是否重评估 → 对每个活跃 KP 计算熵代理 → 更新平滑器 → 选出 top- → 推进淘汰计数器 → 按需复活 → 数据集钩子读缓存。两次重评估间的训练步零选择器开销。
3. 实验设计
3.1 模型与数据
- 基础模型:OpenMath-Nemotron-1.5B
- 基线检查点:KnowRL 发布的静态 CSS 训练后的 Nemotron-1.5B
- 训练数据:QuestA 8.8k 竞赛数学语料( 题),每题从标准答案抽取 KP 候选集
3.2 训练设置
- 框架:verl + DAPO 配方 + GRPO 优势估计 + FSDP 后端
- 训练批大小:256;rollout ,温度 ,top-
- 最大提示/响应长度:8192 / 32768
- 学习率 ,无 warmup、无调度;共 2960 步
3.3 评估基准(8 个,共 1374 题)
| 基准 | 含义 |
|---|---|
| AIME24 / AIME25 | 美国数学邀请赛 |
| BRUMO25 / HMMT25 | 竞赛数学 |
| AMC23 / CMIMC25 | 竞赛数学 |
| MATH-500 | MATH 子集 |
| Olympiad-Bench | 奥林匹克级双语科学问题 |
评估指标:mean@N(按 Chen et al. 2021 的多采样协议),推理时不使用 KP 提示。
3.4 对比方法
- OpenMath-1.5B(基座)
- QuestA(解前缀增强)
- JustRL(纯 RL 配方)
- KnowRL-Nemotron-1.5B(静态 CSS,最强基线)
4. 资源与算力
| 项目 | 配置 |
|---|---|
| GPU | 8 × NVIDIA H800 SXM(80 GB) |
| 优化库 | FlashAttention-2,bfloat16 混合精度 |
| 主训练运行 | 约 13 天(≈ 2500 H800-GPU-小时) |
| 16 组消融/扫描 | 各约 7 天(截断至 1500 步而非 2960 步) |
| 代理 vLLM | GPU 显存占比 0.20,上下文长度 4096,约 3.5 GB 冻结权重 |
| Rollout vLLM | GPU 显存占比 0.50 |
| 总训练算力 | 约 125 GPU-day(8×H800) |
每次重评估仅需 次短前向(共享无 KP 前向),整库重评开销 < 1% 主运行耗时。
5. 实验数量与充分性
5.1 主对比(1 组)
1 个 AdaKP 运行 vs 静态 CSS 基线(采用已发布检查点及其公布数字,未重训)。
5.2 组件消融(5 组)
分别关闭一个机制、其余保持默认:
| 条件 | Avg | |||
|---|---|---|---|---|
| Full | 71.93 | — | 0.34 | 0.86 |
| NoProxy(随机评分) | 70.31 | −1.62 | 0.72 | 0.93 |
| NoMomentum() | 71.02 | −0.91 | 0.57 | 0.90 |
| NoRetirement() | 71.20 | −0.73 | 0.45 | 0.51 |
| FixedSchedule(常数 ) | 71.50 | −0.43 | 0.31 | 0.84 |
5.3 超参数扫描(11 组)
扫描 ,,,,。
5.4 代理对比与门控(表 4)
四种评分器在 240 题上与 LOO 边际准确率的 Spearman (95% CI):
| 评分器 | [CI] | 门控 |
|---|---|---|
| Random | 0.02 [−0.13, 0.17] | Fail |
| Max-logit | 0.41 [0.25, 0.55] | Fail |
| Perplexity | 0.53 [0.38, 0.66] | Fail |
| Entropy | 0.68 [0.55, 0.78] | Pass |
5.5 充分性评估
优点:
- 三个研究维度(主对比、消融、扫描)覆盖完整,组数达 17;
- 每个消融一一对应 C1–C3 设计约束的解释,逻辑自洽;
- 额外提供静态选择族对比(表 2:w/o KP、All-KP、Random、Max-Score、S-LOO、T-LOO、CBRS、CSS);
- 报告两个行为诊断(池 churn 、KP 覆盖率 ),不仅看准确率。
不足:
- 主对比仅 1 个种子(seed 42),无多次平均;
- 16 组扫描/消融仅训练 1500 步(主对比 2960 步),可能漏报后期差异;
- 基线未重训,直接采用已发布检查点,虽节省算力但无法隔离再训练方差。
6. 主要结论
6.1 主对比(表 1)
| 方法 | Avg | vs KnowRL |
|---|---|---|
| OpenMath-1.5B | 60.45 | — |
| QuestA | 67.78 | — |
| JustRL | 68.58 | — |
| KnowRL-Nemotron-1.5B | 70.08 | — |
| AdaKP | 71.93 | +1.85 |
- AdaKP 在 8 个基准的 6 个上领先,无基准退化;
- 在奖励最稀疏的 Hard-3(AIME25+HMMT25+CMIMC25)上提升 +3.36;
- 改进呈现"在最稀疏处最大、在接近饱和处消失"的形状,符合"训练内容选择更优"而非"优化器变化"的特征。
6.2 非平稳性验证(表 S2)
不同策略下 top-30% KP 集的 Jaccard 相似度(基准级,均值):
| 基准 | Jaccard |
|---|---|
| AIME24 | 0.367 |
| AIME25 | 0.730 |
| BRUMO25 | 0.551 |
| HMMT25 | 0.667 |
| AMC23 | 0.526 |
| CMIMC25 | 0.654 |
| MATH-500 | 0.417 |
| Olympiad-Bench | 0.385 |
| 全局均值 | 0.537 |
低于预设阈值 0.7,接受 H1:KP 重要性跨策略非平稳。
6.3 静态选择族对比(表 2)
在 OpenMath 基座离线推理时,CSP 选 2.57 KP 取得 63.90% 平均;AdaKP 离线等价为 64.55% / 2.41 KP。
7. 优点
1. 理论保证:为截断熵估计提供了严格可证的偏差上界(命题 S1),并显式标注该上界不蕴含排序保持性,因此后续用经验 Spearman 实证支撑——这种"理论给界、经验给序"的分工非常严谨。
2. 预检验证门控:将"代理是否可信"前置到启动训练之前,以 CPU-分钟级的成本把方法级风险转为可证伪检验。该思想在 RL 选择启发式方法中并不常见。
3. 极低开销:加性 fork 不动优化器,附加算力 < 1%,使"在线重选"这一原本因 CSS/LOO 过重而不可行的策略变得实用化。
4. 设计可解释:四个组件(熵代理、动量平滑、淘汰复活、自适应调度)一一对应三条约束(C1 计算量、C2 噪声、C3 探索性),使消融结果可被独立解读。
5. 诊断丰富:除准确率外,引入池 churn 、KP 覆盖率 ,定位"过度抖动"和"过早坍缩"两种退化模式。
6. 稳健性:11 组扫描显示任一超参数变动幅度 < 1 分;、、 几乎水平。
7. 正交性:与 DAPO+GRPO 优化器改进、prompt 级过滤(HIVE)、整 hint 粒度缩放(GHPO)正交,可叠加。
8. 不足与局限
1. 模型规模单一:所有实验仅在 1.5B 模型上进行;7B/更大规模的迁移性未验证,虽代理机制不依赖 1.5B 特定结构。
2. 代理冻结于基座权重:AdaKP 实现中 冻结在 init-time 权重,原因是 verl 的 actor-rollout worker-group 接口未暴露 FSDP 分
8. 不足与局限(续)
2. 代理冻结于基座权重:AdaKP 实现中 冻结在 init-time 权重,原因是 verl 的 actor-rollout worker-group 接口未暴露 FSDP 分片参数的原地更新通道。这一选择在论文第 5 节被显式标注为工程妥协,可能在训练后期高估某些 KP 的边际价值——但作者也指出 ablation 显示 NoProxy 仍优于最强静态基线 0.23 分,说明代理漂移并非主要瓶颈。
3. 重评估预算固定:调度器的 7 次重评估次数在训练启动前确定(由 闭合导出),不支持基于策略稳定度的自适应停止。若训练收敛过快(如 QuestA 子集),会产生无意义的尾部重评估开销。
4. 单基准种子:主对比仅有 seed=42 一组运行,未报告多种子均值与标准差。尽管 KnowRL-Nemotron-1.5B 直接复用已发布检查点(节省算力),但跨种子方差在 1.5B + 2960 步规模下通常约 ±0.5 分,因此 +1.85 的提升虽大于该方差量级,结论的统计显著性仍弱于理想的多种子设置。
5. 任务域单一:实验全部局限于竞赛级数学(QuestA / 8 个数学基准)。KP 注入范式对代码、形式化证明或开放问答的迁移性未讨论——这些领域中"原子知识片段"的语义边界更模糊,熵代理的 Spearman 是否仍 >0.6 属未知。
6. 依赖外部 KP 抽取器:候选 KP 来自 KnowRL 公布的、与标准答案对齐的抽取流程。若 KP 池本身噪声大或与答案无对齐, 会坍缩、 会膨胀,门控也会阻断训练——这是一个外生失败模式而非 AdaKP 自身的设计缺陷,但限制了即插即用性。
7. 离线等价对比的公平性:表 2 中 AdaKP 的离线等价在 OpenMath 基座上直接复用训练中产生的 KP 子集缓存,未做"离线 CSS 重训"。严格说,CSS 在该基座上的同口径离线数字未被报告,因此"63.90 → 64.55"的差距仅可作为直觉而非严格证据。
8. 熵代理的语料偏差:代理仅在 自己的前 50 个 token 上计算, 本身用 QuestA 训练语料预见过类似分布。论文未验证该代理在分布外(如 OOD 题)上的秩相关稳定性。
9. 扫描未覆盖极端值:扫描仅取 ,未验证极小(如 50)或极大(如 800)时的曲线形状,因此"对数回退式调度前置到早期"的设计动机虽合理,但缺乏端到端的极端敏感性数据。
10. 没有与"答案感知 KP 注入"对比:近期工作(如 RAG-Toolformer、Hint-Search)通过反查答案构造 KP 注入。AdaKP 始终仅在 base policy 下做选择,未引入答案侧信号——这是一个值得未来工作补足的对比维度。
9. 与同类方法的定位
| 维度 | KnowRL/CSS | GHPO/AD-Hint | HIVE/Reinforce-Ada | AdaKP |
|---|---|---|---|---|
| 选择粒度 | 题级 KP 子集 | 提示块数量/粒度 | 整题 | 原子 KP 子集 |
| 时序性 | 离线一次性 | 在线块级调节 | 在线整题过滤 | 在线原子级 + 重评估 |
| 选择器 | LOO 边际准确率 | 规则/启发式 | 难度/正确率 | 截断熵代理 |
| 与优化器耦合 | 弱 | 中 | 弱 | 无(纯加性 fork) |
| 重评估开销 | 0 | 低 | 低 | < 1% 主运行 |
| 验证门控 | 无 | 无 | 无 | 预检 Spearman 门控 |
AdaKP 在"细粒度 + 时序动态 + 门控可证伪"三个轴上同时推进,是 KP 选择类工作的扩展前沿。
10. 复现性评估
| 项目 | 复现难度 | 备注 |
|---|---|---|
| 主结果(表 1) | 中 | 需 8×H800 × 13 天 + QuestA 抽取流程 |
| 消融(表 3) | 中 | 16 组 × 7 天 × 1500 步 |
| 门控(表 4) | 低 | 单卡 vLLM + 240 题评估,CPU-小时级 |
| 非平稳性验证(表 S2) | 低 | 复用基座权重 + 多组策略,<1 GPU-day |
| 静态选择族对比(表 2) | 低 | 离线推理,无训练开销 |
所有超参与门控阈值均在论文与附录中显式给出;KnowRL 检查点与 QuestA 数据集为开源,原则上第三方可重训。但代理实现细节(如 vLLM top-20 logprob 的重归一化、共享无 KP 前向的缓存策略)需精确复现才能保证数值吻合。
11. 总体评价
AdaKP 针对 RLVR 奖励稀疏性下的"训练内容选择"问题,提出了一个理论可证、实证可验、计算廉价的子集级在线重选框架。其核心贡献不在算法新颖性(熵代理 + EMA + 调度器均为成熟组件的组合),而在于:
1. 将被现有工作忽视的"KP 非平稳性"显式化为可证伪假设 H1,并由表 S2 数据接受;
2. 用命题 S1 为截断熵估计提供严格可证的偏差界,并配合 Spearman 门控做"理论给界、经验给序"的双层支撑;
3. 通过加性 fork 与 <1% 的额外算力,把原本因 LOO/全候选评估而不可行的"在线 KP 子集重选"变得实用化;
4. 在单一 1.5B 模型上以 +1.85 分(Hard-3 子集 +3.36 分)超越 KnowRL-Nemotron 静态 CSS,且无基准退化。
主要遗憾在于模型规模单一、代理冻结于基座权重、单种子报告以及任务域局限于竞赛数学——这些都构成未来工作清晰的扩展路径,但同时也是当前结论被引用时需要附带标注的边界条件。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。