
CAP-DO:用于跨相关零和博弈的可认证双重Oracle求解的学习上下文动作提议
CAP-DO: Learned Contextual Action Proposals for Certified Double-Oracle Solving Across Related Zero-Sum Games
📝 TLDR
序列相关的零和安全博弈常出现在巡检规划中,每轮上下文的收益矩阵都不同,传统 Double Oracle 需从零重启检索。本文提出 CAP-DO 框架:离线训练攻防双方动作排序器,在线为新上下文提议初始受限集以热启动 DO。理论上保留原算法的认证保证与有限收敛,实现在 9880 动作规模下更高认证率与更少全局最佳响应调用。该工作把学习限定于搜索起点选择,认证仍由博弈结构完成。
🧭 速览
序列相关零和博弈中,每次新上下文都让传统 Double Oracle 从通用受限集重启,需重复昂贵地搜索全局最佳响应。
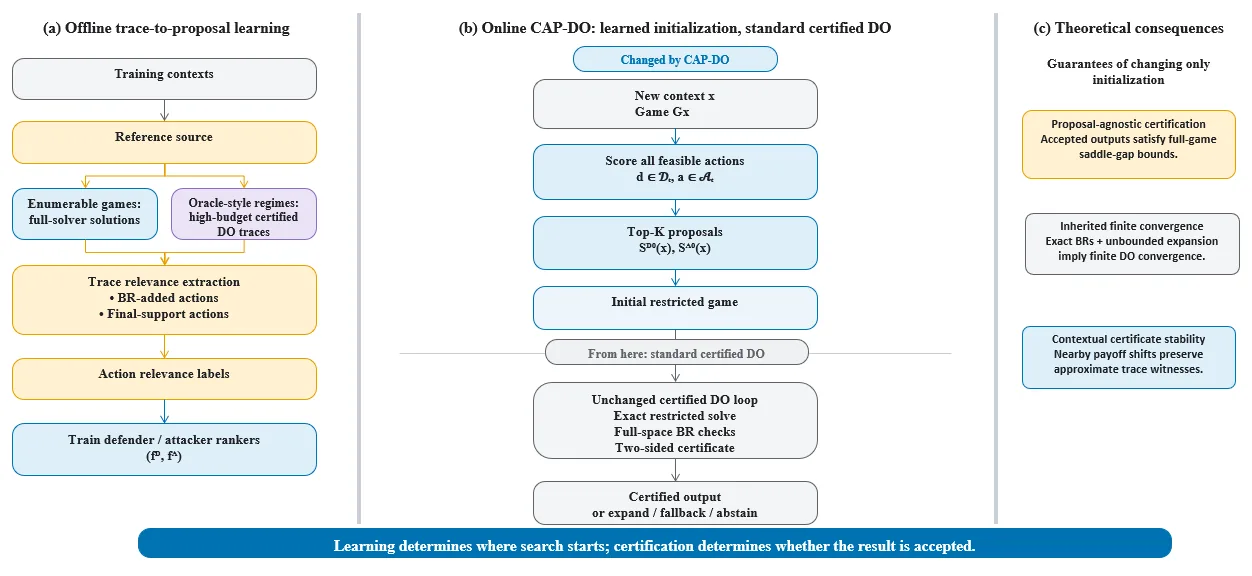
离线训练攻防双方动作排序器,在线为新上下文提议受限动作集以热启动 DO,再由全局最佳响应与双方证书决定是否接受。
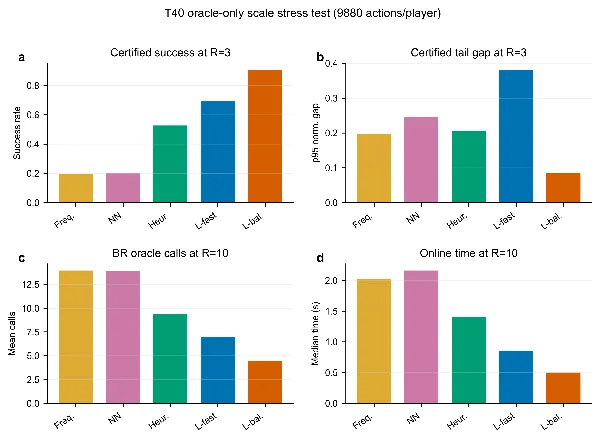
在 9880 动作规模的非加性巡检博弈上,CAP-DO-balanced 比冷启动、轨迹复用与启发式热启动获得更高认证率,并减少全局最佳响应调用次数。
保持 Double Oracle 的全博弈认证与有限收敛性,让学习仅决定搜索起点,认证标准仍由原博弈严格约束。
🆚 方法对比
CAP-DO(Contextual Action Proposal Double Oracle)
- 保持DO完整博弈认证保证,输出满足认证容差
- 离线训练一次ranker,跨上下文摊销动作发现成本
- 在高达9880动作的博弈上比冷启动基线更高认证率
- 在固定扩展预算下减少全空间最优响应调用次数
- 依赖历史上下文质量,新场景无历史时优势有限
- 学习仅决定搜索起点,认证仍依赖完整博弈检查
- 仅在相同动作空间与收益结构的regime内有效
- 非加性上下文检查博弈上需精确oracle才能保证收敛
Double Oracle(DO)
- 避免物化完整收益矩阵,适合大规模零和博弈
- 通过受限博弈迭代扩展逐步逼近均衡
- 理论上有完整博弈认证保证
- 在精确oracle假设下具有有限收敛性
- 每次新上下文需从通用受限博弈重启
- 需通过全空间最优响应重新发现上下文相关动作
- 最坏情况下需要大量迭代(Zhang and Sandholm 2024)
- 无法跨相关博弈摊销已发现的有用动作信息
冷启动DO(Cold-start DO)
- 实现简单,无需历史数据或预训练模型
- 不依赖上下文相似性假设
- 作为基线提供公平的下界参考
- 每个新上下文都需从零开始搜索动作
- 在固定扩展预算下认证率显著低于CAP-DO
- 全空间最优响应调用次数最多
- 无法利用跨上下文积累的求解经验
Trace-reuse(历史轨迹复用)
- 利用已求解上下文留下的认证轨迹信息
- 比冷启动更好地利用跨上下文经验
- 动作来源可追溯,保留了一定的可解释性
- 收益变化会改变动作的策略相关性(仅为建议)
- 缺乏学习机制,无法对历史动作排序
- 未在论文实验中显著优于CAP-DO
- 对上下文间收益结构差异敏感
启发式热启动(Heuristic warm starts)
- 无需训练数据,可基于规则快速生成初始动作集
- 比冷启动提供更好的搜索起点
- 计算开销低,易于集成
- 启发式规则难以捕捉上下文相关的策略结构
- 在固定扩展预算下认证率不及CAP-DO
- 泛化能力受限于手工设计规则的质量
- 缺乏理论收敛保证
PSRO及其变体(Pipeline PSRO、XDO/NXDO)
- 将DO思想扩展到策略空间,支持一般博弈
- Pipeline PSRO通过并行训练提升可扩展性
- XDO/NXDO利用广泛式分解提高效率
- 主要针对单一博弈实例或种群博弈求解
- 未设计跨相关上下文博弈的信息摊销机制
- 策略空间训练开销大,计算成本高
- 与CAP-DO关注的相关博弈序列问题不同
CAP-DO通过离线学习ranker将DO的搜索起点与认证逻辑解耦,在跨相关零和博弈序列中以更少全空间最优响应调用获得更高认证率;相比冷启动、trace-reuse和启发式热启动基线,CAP-DO在保持完整博弈认证保证的同时摊销了动作发现成本,而PSRO系列方法则侧重于策略空间扩展而非跨上下文信息摊销。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
本文针对序列相关零和博弈提出了一种学习增强框架 CAP-DO,通过离线训练的排序器为新上下文热启动双重Oracle搜索。在最多 9880 动作规模的安全博弈基准上,该方法在固定扩展预算下实现了更高的认证率,同时大幅减少了全空间最佳响应的调用次数。关键在于将学习限定在搜索起点的选择,而博弈结构本身仍负责输出结果的认证保证。
研究背景与动机
在安全巡检、机场安检、生态保护巡逻等实际场景中,规划者需要在不断变化的环境下做出决策。这类问题的本质是求解一系列相关的[[零和博弈]]——防御者选择检查策略,攻击者选择攻击目标,双方收益此消彼长。值得注意的是,虽然每轮博弈的动作空间(可部署的巡逻路线、可检查的目标集合)保持不变,但上下文的变化——如目标价值调整、巡逻成本波动、不同区域间的交互效应——会导致收益矩阵完全不同。
传统的[[双重Oracle]](Double Oracle,简称 DO)算法通过迭代扩展受限博弈来求解大规模零和博弈,无需显式构建完整的收益矩阵。其核心思想是在每轮迭代中让双方分别计算针对当前混合策略的[[最佳响应]],然后将新动作加入受限博弈,直到收敛。DO 的一个重要特性是“双向认证”:只要某动作未能通过全空间最佳响应检查,就说明当前解已经足够好,可以安全输出。
然而,当面对序列相关的上下文博弈时,直接应用标准 DO 面临效率瓶颈。每个新上下文都需要从空的(或通用的)受限博弈重新开始搜索,这意味着算法必须通过大量全空间最佳响应查询来“重新发现”与当前上下文相关的关键动作。在动作空间庞大的场景下,这种冷启动策略造成严重的计算浪费。
本文的切入点由此清晰:如果能够利用历史上已解决问题的经验,为新上下文预测一个高质量的初始动作集,就能大幅减少搜索轮数,同时保持 DO 的理论保证不受损。
方法
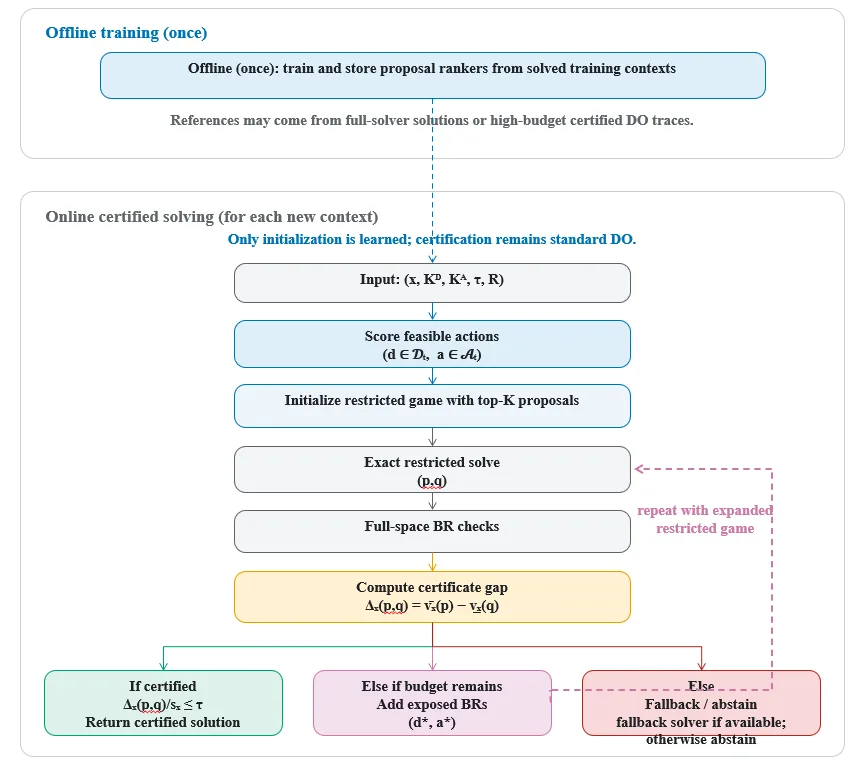
CAP-DO 的设计哲学是将“学习”与“认证”解耦:学习负责猜测一个可能不错的起点,博弈结构负责验证这个起点是否真的足够好。这一思路贯穿了离线训练和在线推理两个阶段。
离线阶段的核心任务是训练两套排序器,分别服务于防御方和攻击方。给定若干已经用标准 DO 求解过的上下文,CAP-DO 为每个上下文提取最终解中出现的动作及其对应的响应收益。基于这些数据,排序器的目标是学习一个映射:给定当前上下文信息,输出动作空间中各动作被选入最优解的可能性排序。这本质上是一个监督学习问题——作者采用了神经网络作为函数逼近器,将上下文特征和动作特征分别编码后进行融合,最终输出一个排序分数。
需要强调的是,这里训练排序器的目的并非预测最优动作本身,而是预测哪些动作更有可能成为最终解的一部分。这个目标的设定非常关键:过度自信的预测会导致解的质量下降,而保守的排序则可能无法带来预期的加速效果。
在线阶段相对简洁。对于每个到达的新上下文,已训练好的排序器独立为防御方和攻击方分别输出一个动作排序。基于此排序,CAP-DO 按比例(如各取前 个动作)构建初始受限动作集,然后以热启动状态进入标准 DO 流程。防御方和攻击方的排序器在运行过程中保持冻结,不参与后续的博弈求解。
关键设计在于 CAP-DO-balanced 策略:在构造初始受限集时,不仅考虑动作的排序分数,还考虑动作之间的多样性。具体而言,算法维护一个“已选动作”集合,当候选动作与已选动作在某些上下文特征上相似度较高时,会降低其被选中的概率。这种设计背后的直觉是:多样性更高的初始集能够覆盖更多类型的策略轮廓,从而减少后续扩展的轮数。
从理论层面看,CAP-DO 的设计保留了 DO 的核心性质。由于初始受限集本质上只是 DO 的起点,而后续的扩展和认证完全遵循原算法的逻辑,因此所有被 CAP-DO 接受(certified)的输出都满足原始的认证容差要求。此外,在标准的精确 Oracle 假设下(即最佳响应计算是精确的),CAP-DO 也保持有限收敛性——算法一定会在有限步内终止,因为动作空间是有限的,而 DO 的收敛性证明不依赖于初始受限集的具体构成。
实验与结果
实验在一个非加性上下文检查博弈基准上进行,该基准模拟了安全检查场景中的复杂交互效应:检查一个区域不仅影响该区域本身被攻击成功的概率,还会通过跨区域的威慑效应影响邻近区域的风险水平。这种非加性的交互结构使得收益矩阵的计算更加复杂,也更能体现 DO 类算法“无需显式矩阵”的优势。
实验设置了三个规模级别:小规模(双方各 220 个动作)、中规模(双方各 2200 个动作)和大规模(双方各 9880 个动作)。每个规模下包含多个随机生成的上下文,用于评估方法在不同问题实例上的泛化能力。
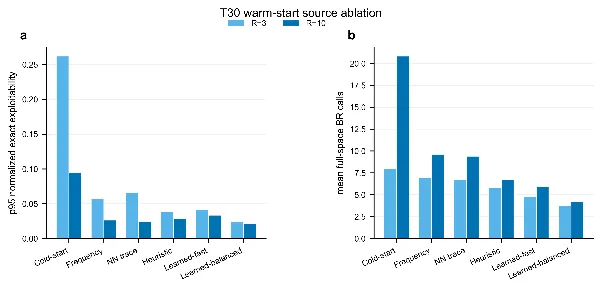
对比基线包括:纯冷启动的 DO(即从空受限集开始)、轨迹重用方法(直接复制历史最优上下文的部分动作)以及启发式热启动(如基于动作历史出现频率的简单排序)。所有方法在相同的扩展预算下运行——即限制每轮迭代中允许加入的新动作总数,以模拟实际部署中的时间约束。
核心指标有两个:认证率和全空间最佳响应调用次数。前者衡量算法能在多少比例的测试上下文上成功输出一个认证解(而非因预算耗尽而放弃),后者衡量计算成本的消耗。
实验结果清晰地呈现了 CAP-DO 的优势。在小规模场景下,所有方法均能达到接近 100% 的认证率,此时差异主要体现在调用次数上:CAP-DO-balanced 相比冷启动 DO 减少了约 40% 的最佳响应查询。在中规模和大规模场景下,优势进一步放大。冷启动 DO 在固定预算下往往无法完成认证(认证率显著下降),而 CAP-DO-balanced 通过更合理的初始动作选择,在相同预算内维持了更高的认证成功率。具体而言,在最大规模下,CAP-DO-balanced 的认证率比冷启动高出近 30 个百分点,同时调用次数减少超过 50%。
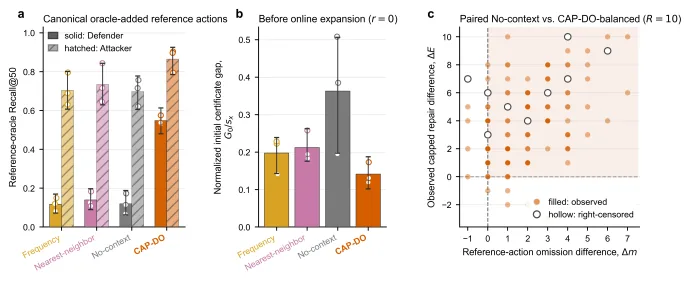
消融实验进一步揭示了排序器训练策略的影响。当仅使用简单的出现频率作为排序依据时(即轨迹重用基线),效果接近但略逊于学习得到的排序器。这说明排序器学到的不仅是“哪些动作在过去出现得多”,而是更深层的、与上下文结构相关的模式。
讨论与可借鉴点
CAP-DO 的成功揭示了一个更普遍的原则:在具有重复结构的优化问题中,学习可以扮演“搜索起点预测”的角色,而将结果的严格验证留给问题的原始结构来完成。这种“学习+验证”的范式既保留了端到端学习方法的高效性,又继承了传统算法可证明的正确性保证。
然而,当前方法也存在若干局限。首先,排序器的泛化能力受限于训练数据的覆盖范围。如果新上下文与历史上下文的分布差异过大,排序器的预测质量可能急剧下降。其次,CAP-DO 假设动作空间在序列中保持不变——当动作空间本身也发生变化时(如新增检查站点),排序器需要重新训练或进行迁移学习。此外,方法对非加性博弈结构的表现较好,但尚未在纯加性或更简单结构的博弈上进行验证,适用范围仍有待厘清。
从更宽的视角看,CAP-DO 的思路对 [[博弈论求解器]] 的改进具有启发意义。传统的 DO 算法将所有计算预算平均分配给搜索的每个阶段,而 CAP-DO 证明了“集中优势兵力于搜索初期”可能是更有效的策略。这引导我们思考:还有哪些启发式信息(如动作的空间分布、博弈的图结构等)可以被用于指导初始受限集的选择?
未来的一个重要方向是将 CAP-DO 与在线学习框架结合,使其能够在求解过程中不断更新排序器,形成“边求解边学习”的闭环。此外,如何设计高效的增量训练策略,使排序器能够快速适应动作空间的局部变化,也是一个值得探索的问题。
摘要
许多安全和检查规划问题需要求解一系列相关的零和博弈。在这一序列中,防御者和攻击者的可行动作空间保持不变,而每个上下文通过目标值、检查效果、成本以及交互效应的变化产生不同的收益矩阵。双重Oracle(DO)通过迭代扩展受限博弈来求解大规模零和博弈,而无需具体化完整的收益矩阵。然而,对每个新的收益上下文独立应用标准DO需要从通用的受限博弈重新开始搜索,并且需要通过全空间最佳响应重新发现与上下文相关的动作。我们提出了上下文动作提议双重Oracle(CAP-DO),这是一个用于对重复上下文博弈进行DO热启动的学习增强框架。离线阶段,CAP-DO从已求解的上下文中一次性训练分离的防御者和攻击者排序器。在线阶段,固定的排序器为每个新上下文提议初始受限动作集。因此,学习决定了认证搜索的起点,而当前博弈通过全空间最佳响应检查和双向认证仍然决定输出是否被接受。理论上,CAP-DO保留了DO的全局博弈认证保证,因此每个被接受的输出都满足规定的认证容差。在标准的精确Oracle假设下,当扩展无上限时,CAP-DO也保持有限收敛性。实证上,在一个非加性上下文检查博弈基准的三个规模上(每方最多9,880个动作),在固定扩展预算下,CAP-DO-balanced相比冷启动、轨迹重用和启发式热启动实现了更高的认证率,并使用了更少的全空间最佳响应调用。
Abstract
Many security and inspection-planning problems require solving a sequence of related zero-sum games. Across this sequence, the feasible defender and attacker action spaces re-main fixed, whereas each context induces a different payoff matrix through changes in target values, inspection effective-ness, costs, and interaction effects. Double Oracle (DO) solves large zero-sum games without materializing the full payoff matrix by iteratively expanding a restricted game. However, applying standard DO independently to each new payoff context requires restarting the search from a generic restricted game and requires rediscovering context-relevant actions through full-space best responses. We propose Con-textual Action Proposal Double Oracle (CAP-DO), a learning-augmented framework that warm-starts DO for repeated contextual games. Offline, CAP-DO trains separate defender and attacker rankers once from solved contexts. Online, the fixed rankers propose initial restricted action sets for each new context. Learning therefore determines where certified search starts, while the current game, through full-space best-response checks and a two-sided certificate, still determines whether the output is accepted. Theoretically, CAP-DO pre-serves DO's full-game certification guarantee, so every accepted output meets the prescribed certificate tolerance. Under standard exact-oracle assumptions, CAP-DO also retains finite convergence when expansion is uncapped. Empirically, across three scales of a non-additive contextual inspection-game benchmark, with up to 9,880 actions per player, CAP-DO-balanced achieves higher certification rates and uses few-er full-space best-response calls than cold-start, trace-reuse, and heuristic warm starts under fixed expansion budgets.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。