
📝 TLDR
强化学习智能体在安全关键场景中部署广泛,模糊测试成为暴露其异常行为的重要手段。然而现有RL模糊测试方法评估标准不一,难以横向比较。本文开展首个系统性实证研究,从有效性、多样性、效率和实用性四个维度统一评测了五种SOTA方法及随机基线。结果显示吞吐量导向方法(如MDPFuzz)在崩溃发现上表现最优,多样性导向方法(如SeqDivFuzz)更能挖掘多样化崩溃行为。研究还证实模糊测试生成的崩溃可显著提升智能体鲁棒性并支持跨方法泛化的安全监控。
🧭 速览
RL智能体广泛部署于机器人、自动驾驶等安全关键场景,庞大状态空间亟需有效测试方法,而现有RL模糊测试方法评估标准与基线不一,难以可靠比较优劣。
在统一配置下评测5种SOTA RL模糊测试方法与随机基线,覆盖MountainCar、BipedalWalker、CARLA三个递增复杂度环境,并从四个互补维度进行系统分析。
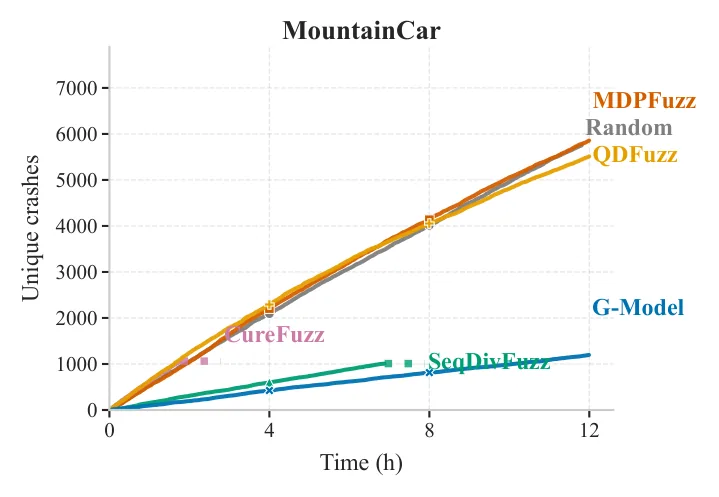
MDPFuzz在崩溃发现的有效性和效率上最优,SeqDivFuzz在多样性上领先;生成的崩溃可提升智能体鲁棒性,并支持跨方法泛化的安全监控。
倡导组合互补的模糊测试策略并采用多层次多样性分析,为RL测试研究者和实践者提供可落地的指导建议。
🆚 方法对比
MDPFuzz
- 吞吐量导向,崩溃发现效率高
- GMM引导生成测试输入,触发崩溃能力强
- 在统一配置下表现优越
- 崩溃多样性可能不足
- 依赖GMM建模,环境适应性受限
- 不同实现版本影响结果可比性
SeqDivFuzz
- 显式鼓励探索,多样性发现能力强
- 能揭示多样化崩溃行为
- 适合多层次多样性分析
- 崩溃发现效率可能不及吞吐量方法
- 探索策略带来额外计算开销
- 在简单环境中优势可能被掩盖
基于扩散模型的模糊测试(Li et al.)
- 学习正常输入分布后生成异常输入
- 生成式方法覆盖更广状态空间
- 为RL模糊测试奠定基础
- 扩散模型训练成本较高
- 实际效果受分布学习质量影响
- 下游实用性未被充分验证
随机测试(Random Testing)
- 实现简单,作为随机性下界
- 无需训练或建模开销
- 提供公平对比的基线
- 崩溃发现能力远低于专用方法
- 覆盖效率低,缺乏引导机制
- 难以暴露复杂场景中的边缘情况
RL模糊测试实证评估框架(本研究)
- 首个系统性实证研究,四维度评估
- 统一配置实现公平对比
- 包含随机测试基线和下游实用性分析
- 覆盖方法数量有限(5种SOTA)
- 依赖基准环境选择,结果泛化待验证
- 无法穷尽所有RL测试场景
本文在统一框架下对比了5种SOTA RL模糊测试方法及随机测试基线,发现MDPFuzz等吞吐量导向方法在崩溃发现效率上最优,而SeqDivFuzz等探索导向方法在崩溃多样性上更胜一筹,两者具有互补性,结合使用可实现更全面的RL测试覆盖。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
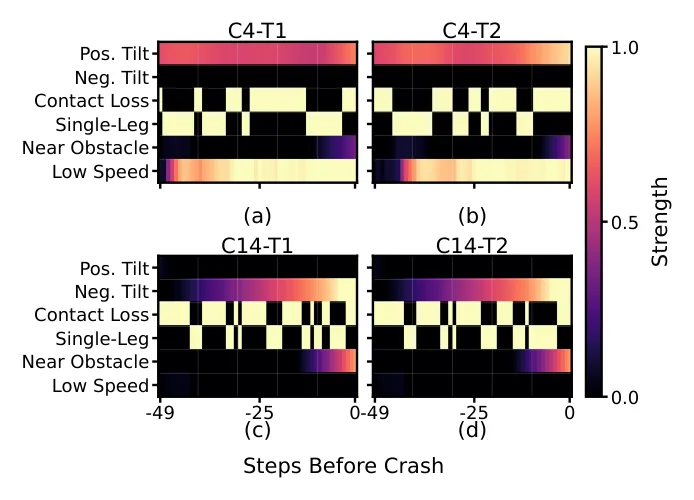
TL;DR
本文首次对强化学习模糊测试方法开展系统性实证研究,统一评测了五种前沿方法及随机基线,从有效性、多样性、效率、实用性四个维度揭示了不同策略的优劣:吞吐量导向的方法擅长快速发现崩溃,而多样性导向的方法能挖掘更丰富的异常行为。更重要的是,模糊测试生成的崩溃样本可切实提升智能体鲁棒性并支撑具有强泛化能力的安全监控系统。
研究背景与动机
随着[[强化学习]]技术在[[机器人控制]]、自动驾驶、无人机等安全关键领域的广泛部署,RL 智能体在复杂环境中可能出现预料之外的异常行为,这些行为一旦在真实场景中触发,可能导致严重后果。模糊测试(Fuzz Testing)作为一种自动化测试范式,近年来被引入 RL 领域,通过生成多样化的输入来探索智能体的状态空间,从而暴露潜在的崩溃点。
然而,当前 RL 模糊测试研究存在一个根本性问题:各方法在评估设置、基线选择和评价指标上缺乏统一标准,导致研究者难以横向比较不同方法的真实表现。一些论文强调发现崩溃的数量,另一些则关注崩溃类型的多样性,还有些关注测试效率——这种评估维度的碎片化,使得社区难以判断哪些方法真正有效,也阻碍了研究成果向实践应用的转化。
本文的切入点正是这一评估真空。研究团队意识到,要推动 RL 模糊测试领域健康发展,必须建立一个系统性的基准评测框架,从多个互补的视角审视现有方法,并在此基础上提炼出可操作的指导建议。
方法
研究团队设计了一套多维度的评测框架,围绕四个核心维度展开系统评估。
有效性(Effectiveness) 衡量方法发现崩溃的能力,核心指标是发现的独特崩溃数量及其覆盖的状态空间区域。研究采用状态空间覆盖率与崩溃发现率作为主要度量。
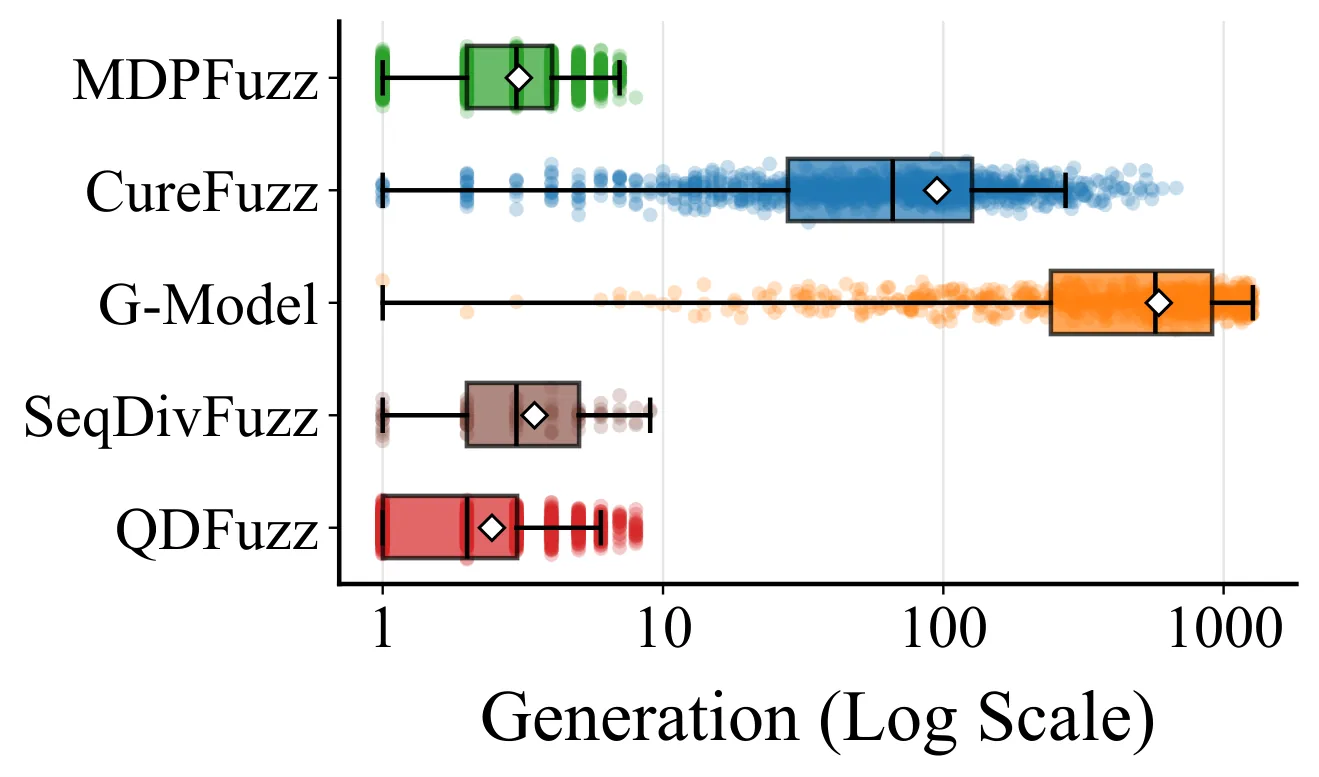
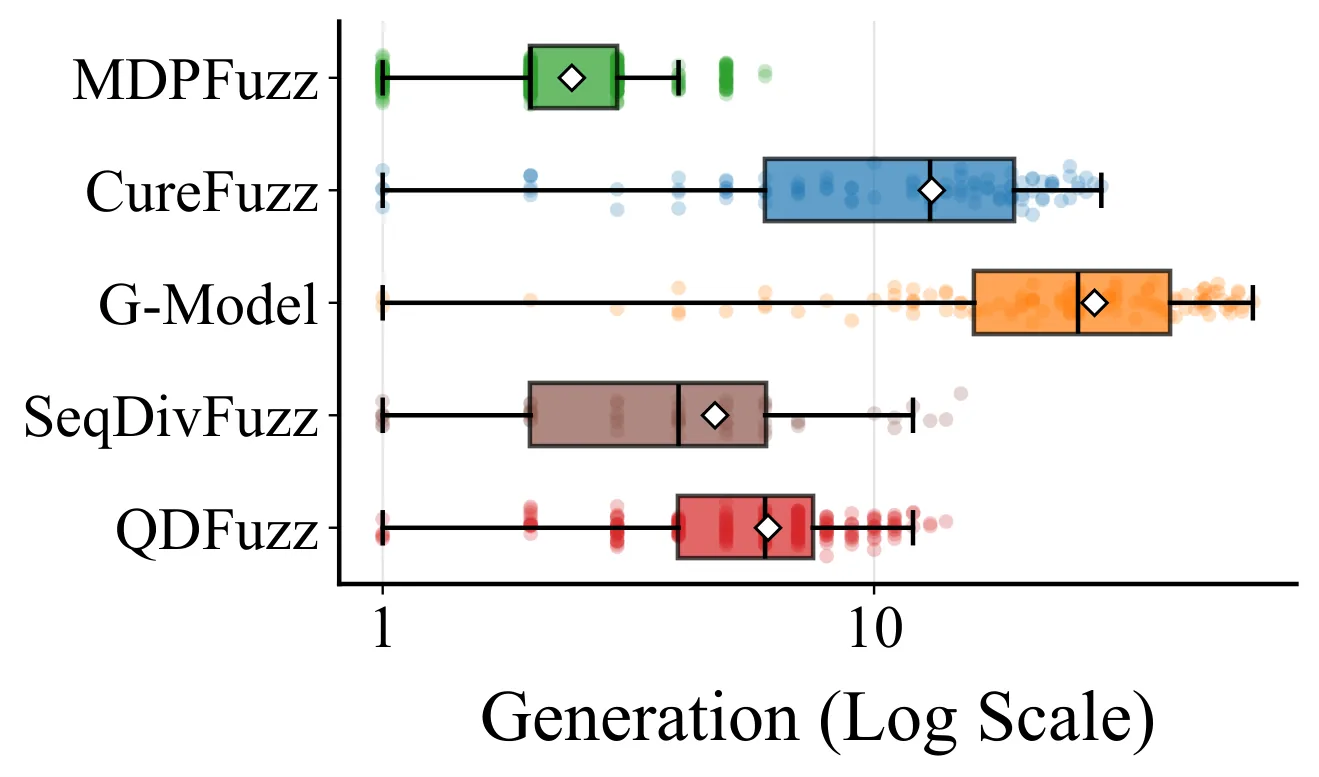
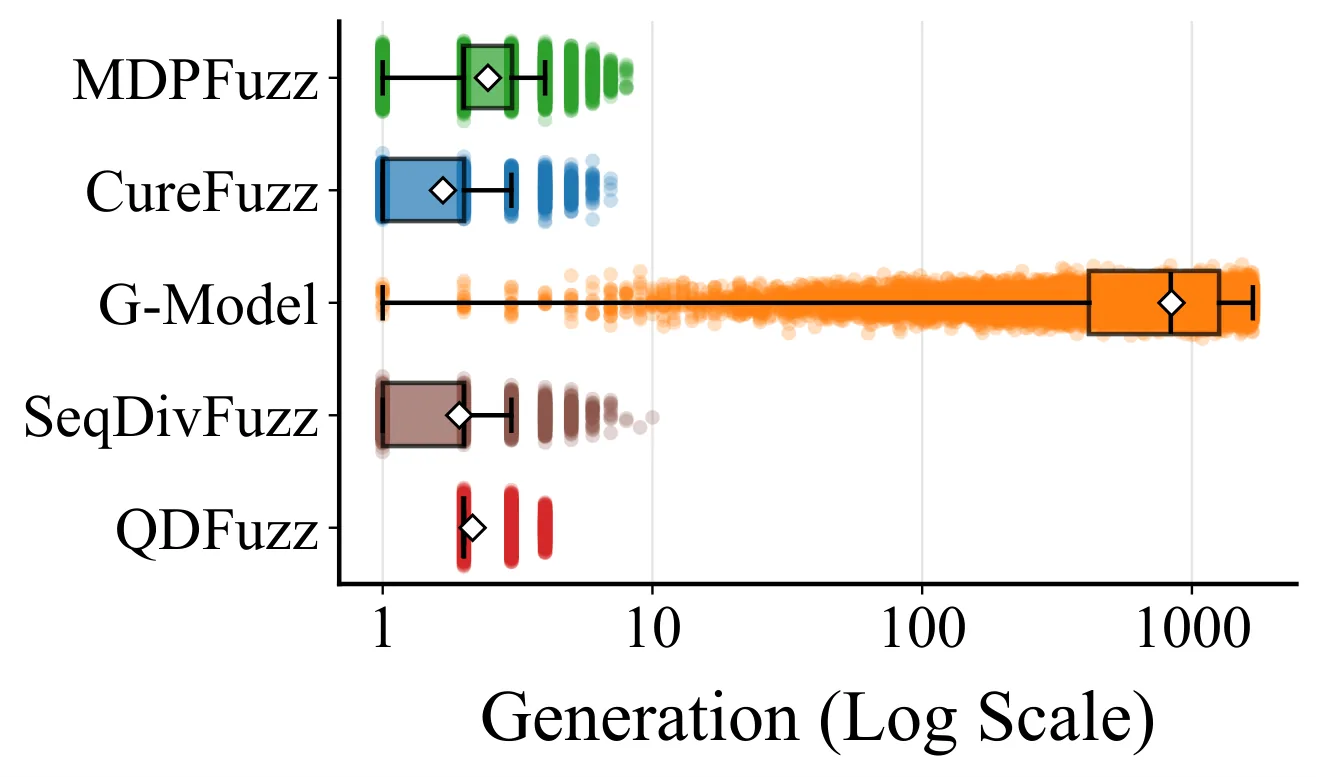
多样性(Diversity) 评估方法能否挖掘出不同类型的崩溃行为。团队设计了多层次的多样性分析:输入层面的多样性关注测试场景的差异程度,行为层面的多样性考察崩溃时智能体表现出的异常模式差异,以及结果层面的多样性分析崩溃对智能体后续行为的影响。
效率(Efficiency) 关注单位时间内方法能够完成的工作量,用吞吐量(throughput)来衡量,即单位时间生成的测试用例数量与发现的崩溃数量之比。
实用性(Practical Utility) 是最具实践价值的维度,研究进一步探索了模糊测试发现的崩溃样本能否真正服务于下游任务:将其用于安全监控器的训练,以及作为增强数据提升智能体的鲁棒性。
在实验配置上,团队选取了三个复杂度递增的标准环境——MountainCar、BipedalWalker 和 CARLA,覆盖了从简单控制任务到自动驾驶场景的跨度。被测方法包括五种前沿方案(MDPFuzz、SeqDivFuzz 等)以及随机测试作为基线,所有方法在相同硬件环境、统一超参数下运行以确保公平比较。
实验与结果
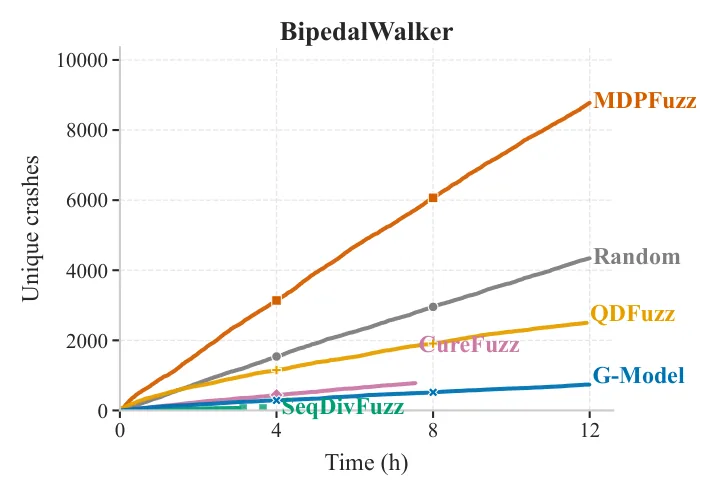
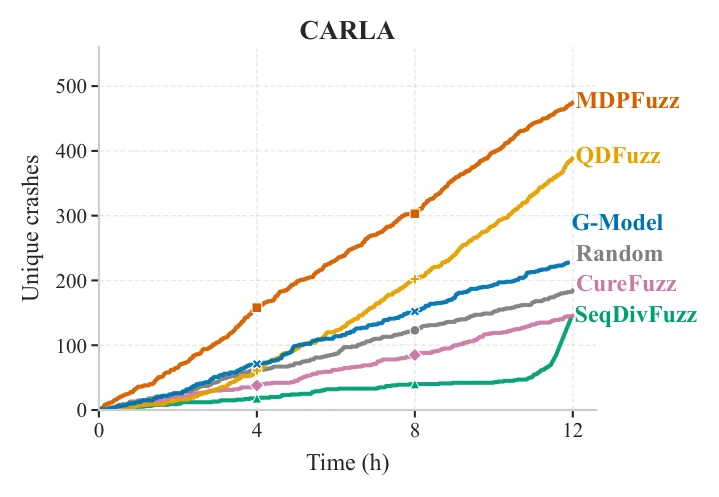
实验结果揭示了不同方法策略的本质差异。吞吐量导向的方法如 MDPFuzz 在崩溃发现的有效性与效率上表现突出,其设计思路是最大化测试用例的生成速率,通过大量快速采样来提高发现崩溃的概率。数据显示,在相同时间预算下,这类方法的崩溃发现数量显著高于其他方案。
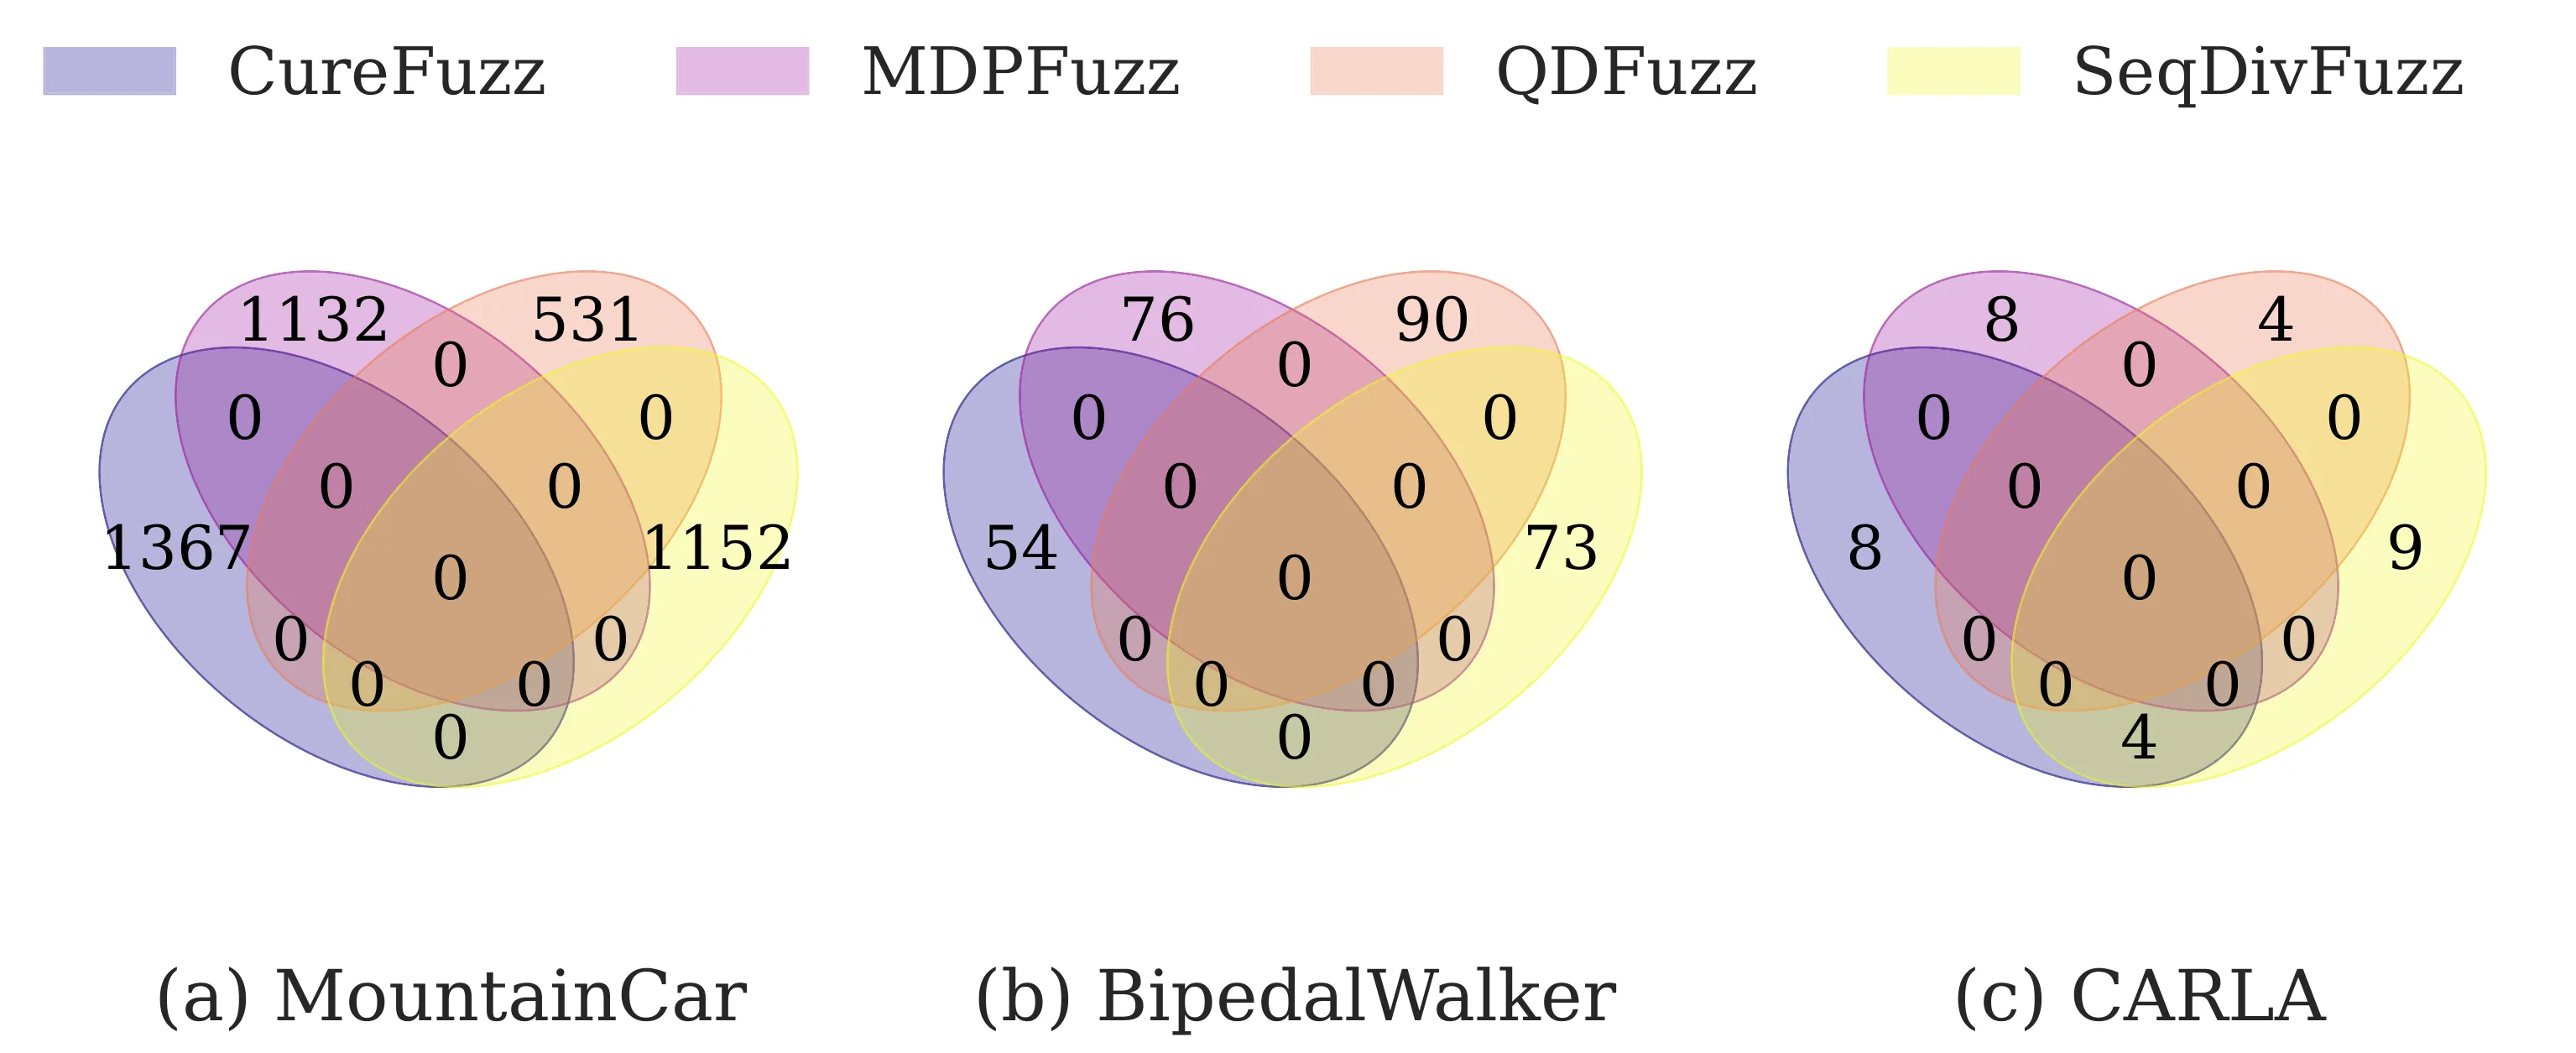
相比之下,显式设计用于鼓励探索的方法如 SeqDivFuzz 展现了截然不同的优势。虽然其单位时间吞吐量较低,但在多样性维度上明显胜出——它能够发现更多类型的独特崩溃行为,覆盖更广泛的状态空间区域。这说明探索性设计虽然牺牲了部分效率,却换取了更全面的异常覆盖。
值得注意的是,两类方法并非相互排斥而是互补的。组合策略实验表明,当将吞吐量导向与多样性导向方法串联使用时,可以同时获得较高的崩溃发现率和较丰富的崩溃类型覆盖。这一发现对实践者具有重要参考价值:在资源有限时,可以先用高吞吐量方法快速定位明显崩溃,再用多样性方法补充探索边界情况。
更具实践意义的是实用性验证。研究团队将模糊测试生成的崩溃样本用于两类下游任务:训练安全监控器和使用[[对抗训练]]增强智能体鲁棒性。结果表明,仅需少量模糊测试生成的对抗样本就能显著提升智能体对类似异常的抵抗能力,而且训练得到的安全监控器展现出跨方法的泛化能力——在一个模糊测试方法上训练得到的监控器,能够有效检测其他方法生成的异常,这大大增强了方法的实用价值。
讨论与可借鉴点
本研究为 RL 模糊测试领域提供了首个系统性的实证基准,其价值不仅在于具体数字结论,更在于方法论层面的示范。四个评估维度的设计思路——特别是将实用性纳入考量——提醒研究者不应仅关注测试技术本身,还应追问测试产出的最终用途。
研究也存在一定局限。首先,实验环境虽然覆盖了递增的复杂度,但与真实世界的工业部署场景仍有差距,CARLA 模拟器虽接近自动驾驶场景,却无法完全复现现实中的传感器噪声与物理交互复杂性。其次,崩溃的定义在本文中相对保守,主要关注导致智能体任务失败的明显异常,对于更微妙的安全性退化(如奖励黑客行为)覆盖不足。
对后续研究的启发是明确的:单一维度的优化难以满足 RL 测试的多元需求,组合策略与多层次分析应当成为标准实践。对于希望在实际项目中应用模糊测试的工程师,论文建议采用"先广后深"的策略——先用高吞吐量方法建立基线覆盖,再用多样性方法挖掘边界情况,最终将发现的异常样本转化为安全监控或对抗训练的宝贵数据资源。
摘要
强化学习(RL)智能体日益被部署于机器人、自动驾驶和无人机控制等安全关键领域,在这些领域中,意外行为可能导致严重的现实后果。模糊测试作为一种探索强化学习智能体庞大状态空间并暴露崩溃的有前景的方法,近年来受到了广泛关注。尽管已有众多强化学习模糊测试方法被提出,但现有研究在评估设置、基线方法和评价指标上往往存在差异,因而难以对其相对有效性与实际可用性得出可靠的结论。为填补这一空白,我们提出了首个全面的实证研究,从四个互补的视角系统性地评估强化学习模糊测试方法:有效性、多样性、效率与实际可用性。我们在统一配置下,对五个最先进的方法以及随机测试在三个复杂度递增的环境(MountainCar、BipedalWalker 和 CARLA)中进行了基准测试,并进一步评估了所发现的崩溃对智能体鲁棒性提升与安全监控的下游实用价值。我们的研究结果揭示了几项重要洞见:例如,以吞吐量为导向的方法(如 MDPFuzz)在崩溃发现方面表现出更优的有效性与效率;而显式设计用于鼓励探索的方法(如 SeqDivFuzz)则擅长揭示多样化的崩溃行为。我们还表明,模糊测试生成的崩溃能够切实提升智能体的鲁棒性,并实现具有强跨方法泛化能力的精准安全监控。除了这些实证发现之外,我们还提炼出针对研究者与实践者的可行指导建议,强调了组合使用互补的模糊测试策略以及采用多层次多样性分析以实现更全面、更实用的强化学习测试的优势。
Abstract
Reinforcement Learning (RL) agents are increasingly deployed in safety-critical domains such as robotics, autonomous driving, and drone control, where unexpected behaviors may lead to severe real-world consequences. Fuzz testing has recently emerged as a promising method for exploring the vast state spaces of RL agents and exposing crashes. Although numerous RL fuzzing methods have been proposed, existing studies often differ in evaluation settings, baselines, and metrics, making it difficult to draw reliable conclusions about their relative effectiveness and practical usefulness. To address this gap, we present the first comprehensive empirical study that systematically evaluates RL fuzzing methods from four complementary perspectives: effectiveness, diversity, efficiency, and practical utility. We benchmark five state-of-the-art methods alongside random testing under unified configurations across three environments of increasing complexity (MountainCar, BipedalWalker, and CARLA), and further assess the downstream usefulness of detected crashes for agent robustness improvement and safety monitoring. Our results reveal several key insights. For instance,throughput-oriented methods like MDPFuzz demonstrate superior effectiveness and efficiency in crash discovery, while methods explicitly designed to encourage exploration like SeqDivFuzz excel at uncovering diverse crash behaviors. We also show that fuzzing-generated crashes can meaningfully improve agent robustness and enable accurate safety monitoring with strong cross-method generalization. Beyond these empirical findings, we distill actionable guidance for both researchers and practitioners, highlighting the benefits of combining complementary fuzzing strategies and adopting multi-level diversity analysis to achieve more comprehensive and practical RL testing.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。