
去中心化共识学习网络:无需集中式奖励的主题专家轮换
Decentralised Consensus Learning Networks: SME Rotation Without Centralised Reward
📝 TLDR
本文提出一种去中心化多智能体学习框架,专业能力通过同行共识而非集中奖励信号涌现,并在多达一万个智能体上进行评估。
🧭 速览
去中心化多智能体共识学习框架通过同行验证形成专业能力。
方法与实现细节请参考摘要与正文。
结果与对比结论请参考摘要与正文。
总体而言,该工作在所述任务上展示了有效性,并提供了可复用的思路或工具。
🆚 方法对比
中心化奖励学习范式
- 产生显著成果,收敛稳定可靠
- 优化方向明确,易于工程化部署
- 依赖预定义且稳定的奖励函数
- 在争议性、高维知识领域失效
- 对社会学习率高的体系创新存在天花板
- 强加单一外部裁决者于知识定义
去中心化共识学习网络(DCLN)
- SME轮换覆盖率达90-100%,广泛分布
- 拓扑不变、规模不变(N=30至10000)
- 无需真实标签,基于同行一致性推断能力
- 67-86%专业知识轮换发生于收敛后
- 仅为概念验证,不适合实际部署
- 未在任何实际基准上超越监督学习
- 社会项相关性导致创新噪声被压制
- 高维下专业知识集中于单一智能体
SME动态轮换机制
- 动态分配非固定标签,避免寡头锁定
- 采用前百分位能力等级公正赋权
- 后收敛期轮换随网络规模增强
- 84次仿真验证鲁棒性强
- 高维下轮换健康度显著下降
- 专业身份高度集中于单一节点
- 轮换强度依赖维度D而非独立参数
向量信念与级联动力学(Phase 2/3)
- 揭示信念维度D诱发的五种动力学相
- 级联动力学模拟健康知识生态的选传播
- 收敛时间异质性体现选择性收敛
- 高维平衡态在D=150-200跨种子鲁棒
- 高维下共识仅达0.76-0.83非完全一致
- 专业集中度随D单调上升不可避
- ETA与D非独立设计杠杆,多样性受限
本文提出去中心化共识学习网络(DCLN)作为中心化奖励范式的替代方案,通过同行验证而非外部裁决实现专业知识涌现;DCLN在SME轮换广度和拓扑无关性上优于传统中心化范式,但在高维信念空间中面临专业知识集中和创新能力受限的固有结构性约束。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 15 张)
展开查看 15 张图
TL;DR
本文提出一种去中心化的多智能体学习框架,智能体的专业能力不是由中心服务器分配,而是通过同伴之间的共识验证自然涌现。实验在30到10,000个智能体的规模上验证了该框架,发现主题专家身份能够动态轮换而非固定分配,且在高维信念空间中会出现一种有趣的涌现现象:与集体信念最一致的单一智能体会被网络公认为专家。
研究背景与动机
现代人工智能学习系统几乎普遍依赖集中式奖励信号来指导智能体的行为演化。无论是游戏AI中的分数、机器人控制中的任务完成度,还是语言模型训练中的人类反馈,强化学习的核心范式都是围绕着一个外部定义的"正确答案"展开。然而,这种设计选择带来了一个深层问题:谁有权定义什么是正确的、有价值的知识?
这种集中式奖励机制在单智能体或封闭系统中尚可运作,但当涉及多智能体协作、去中心化知识生成、或需要动态适应新环境的场景时,单一外部定义就成了瓶颈。更为根本的是,集中式奖励往往需要ground truth作为参照,而在许多现实问题中,根本不存在客观的"正确答案"——知识的价值可能本身就是社会性的、情境依赖的。
这篇论文的切入点正是要回答一个看似简单却极其深刻的问题:能否让专业能力在没有中心权威定义的情况下,通过智能体之间的互动自然涌现?换句话说,如果去掉"标准答案"这个锚点,一群分散的智能体能否自行判断谁更可信,进而让真正的专家自发浮现?
方法
要理解这套框架的设计逻辑,我们需要逐层拆解它的核心机制。
首先是信念表示与更新。论文同时探索了标量信念和向量信念两种表示方式。标量信念适用于简单的二元判断或单一维度的问题,而向量信念则能够刻画高维认知空间——比如同时判断多个议题的立场,或在特征空间中描述复杂的知识状态。每个智能体维护自己的信念向量,并通过与邻居的交互来更新它。
信任分配机制是整个框架的核心创新点。传统的多智能体系统通常根据真实标签或预设标准来评估智能体能力,但本框架完全抛弃了这一做法。信任被定义为基于同伴一致性的推断:当一个智能体的行为或判断与其多个同伴高度吻合时,它的可信度就会上升。具体而言,如果智能体A的信念与智能体B、C、D都接近,那么B、C、D会倾向于给A更高的信任权重。这种信任是动态的、局部的——每个智能体独立判断,不存在中心化的信任评级机构。
共识驱动的信念更新遵循加权社会共识原则。每个智能体在更新自己的信念时,会参考邻居的信念,但参考的程度由信任权重决定。如果智能体i信任智能体j,那么j的信念对i的新信念会有更大的影响。形式上可以写作:
其中 是 t 时刻智能体 i 对 j 的信任权重,所有权重归一化后求和。
最后,主题专家(SME)身份的动态分配是框架中最具启发性的设计。SME不是预先指定的固定角色,而是根据实时的能力排名动态分配。具体做法是:每隔一定周期,系统计算每个智能体在共识网络中的"一致度"——即与周围智能体信念的对齐程度——然后将排名在前百分位的智能体标记为SME。这意味着谁是专家不是固定的,而是随时间流动的:当一个智能体持续保持高一致度时,它获得SME身份;当它的判断开始偏离主流时,身份可能被其他更一致的智能体取代。
实验与结果
实验的规模本身就是一个看点:84次仿真运行,覆盖从30到10,000个智能体的跨度,测试了多种图拓扑结构(完全图、随机图、网格等)、稀疏大规模网络场景,以及从标量到500维的信念维度扫描。这种多维度的参数空间探索旨在验证框架的稳健性和可扩展性。
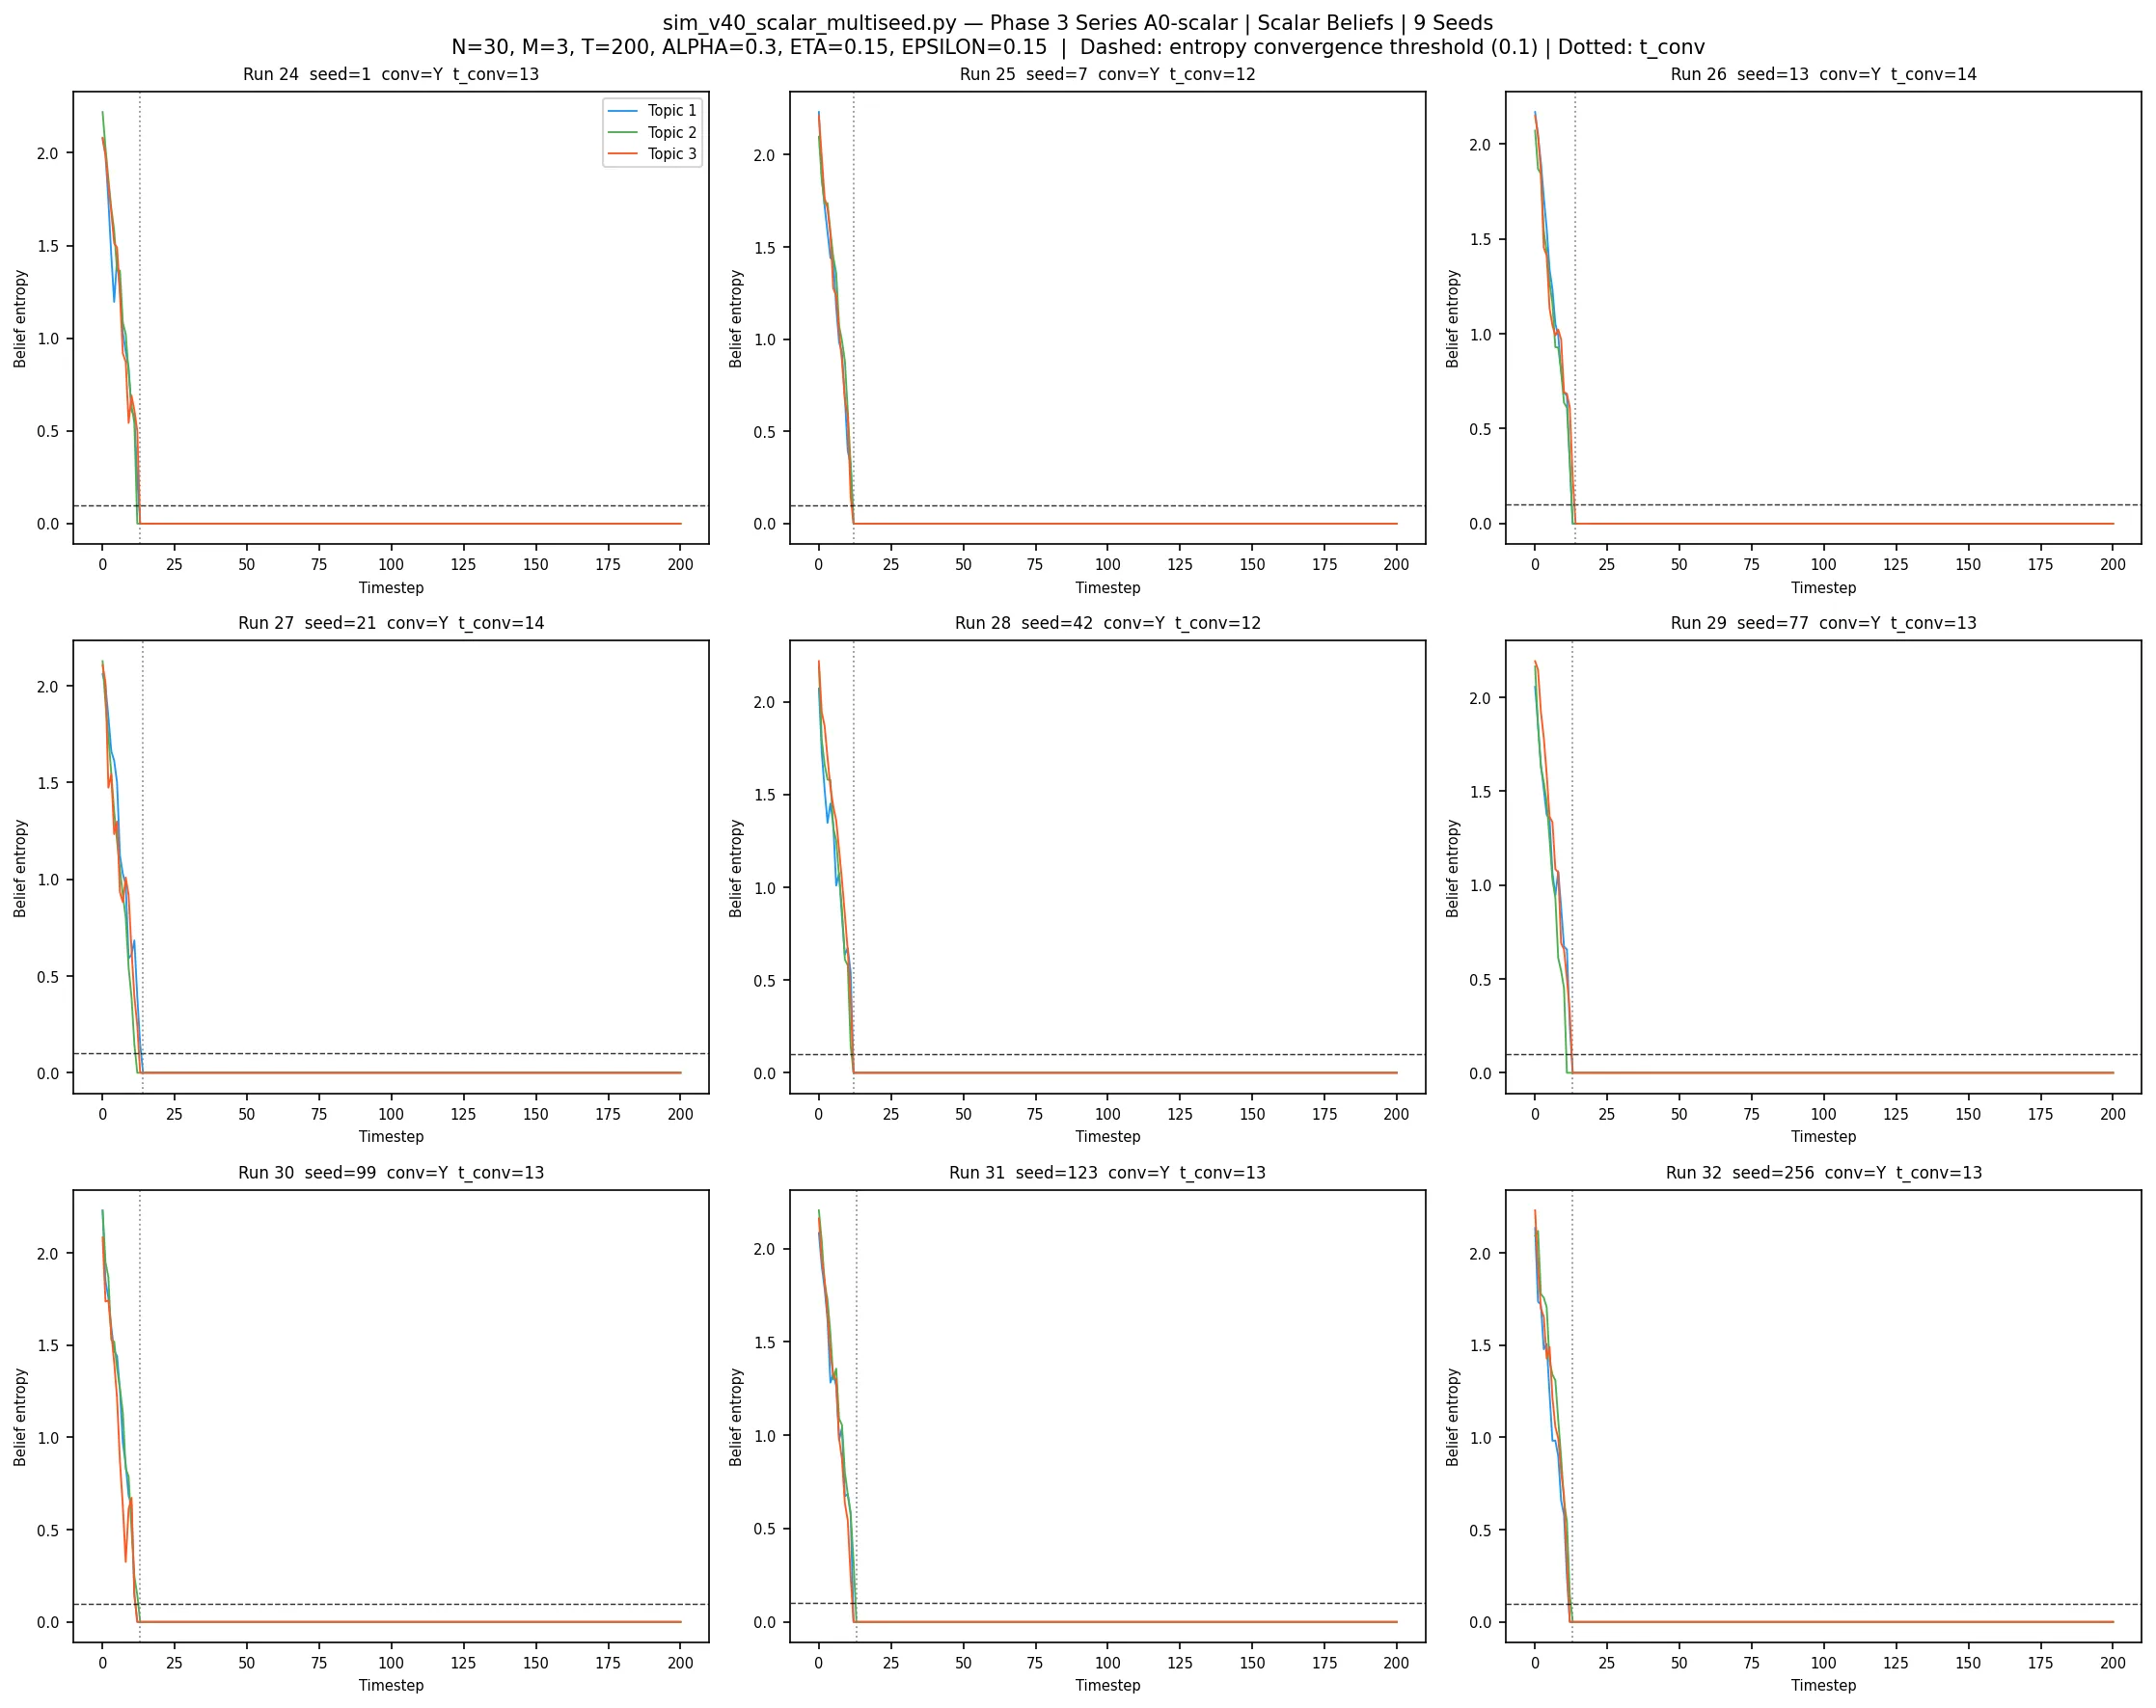
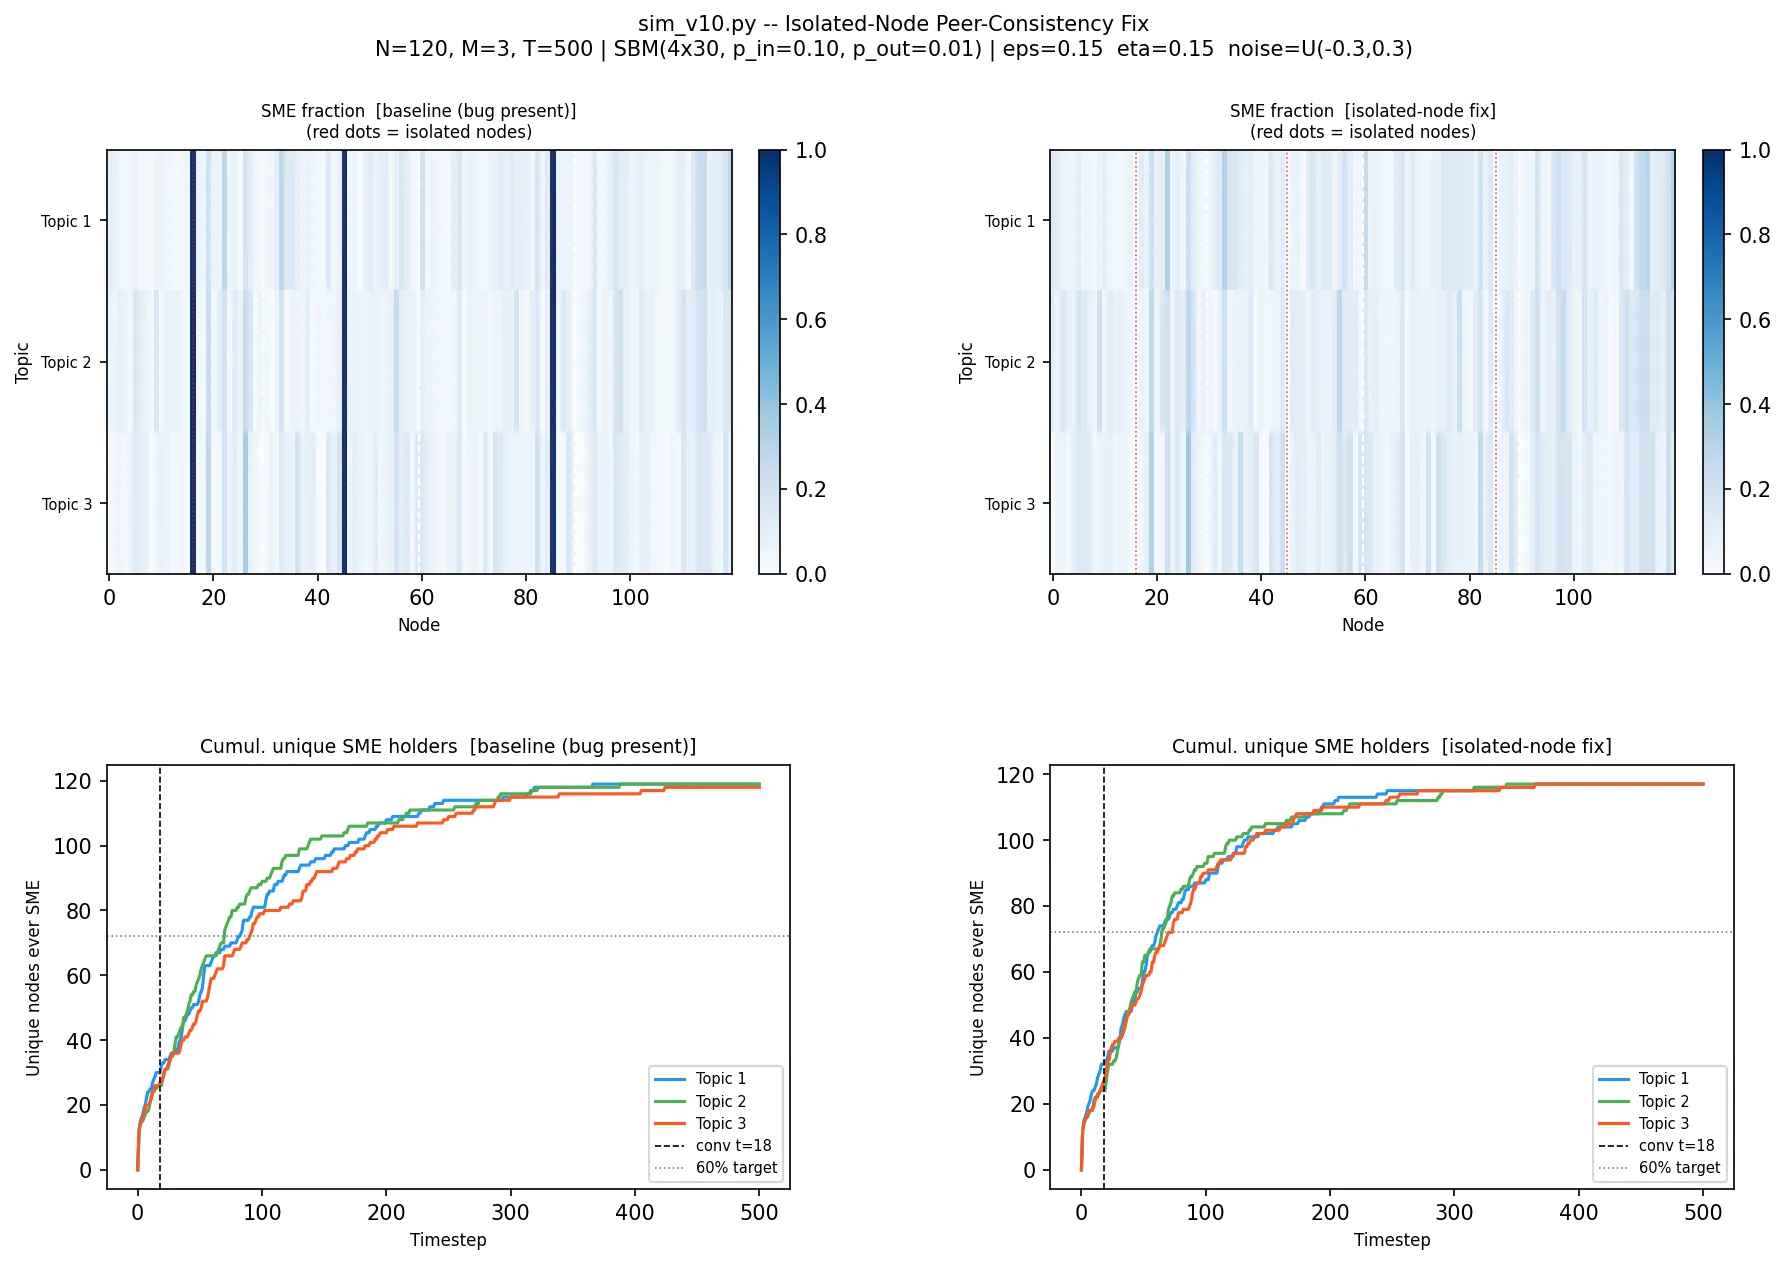
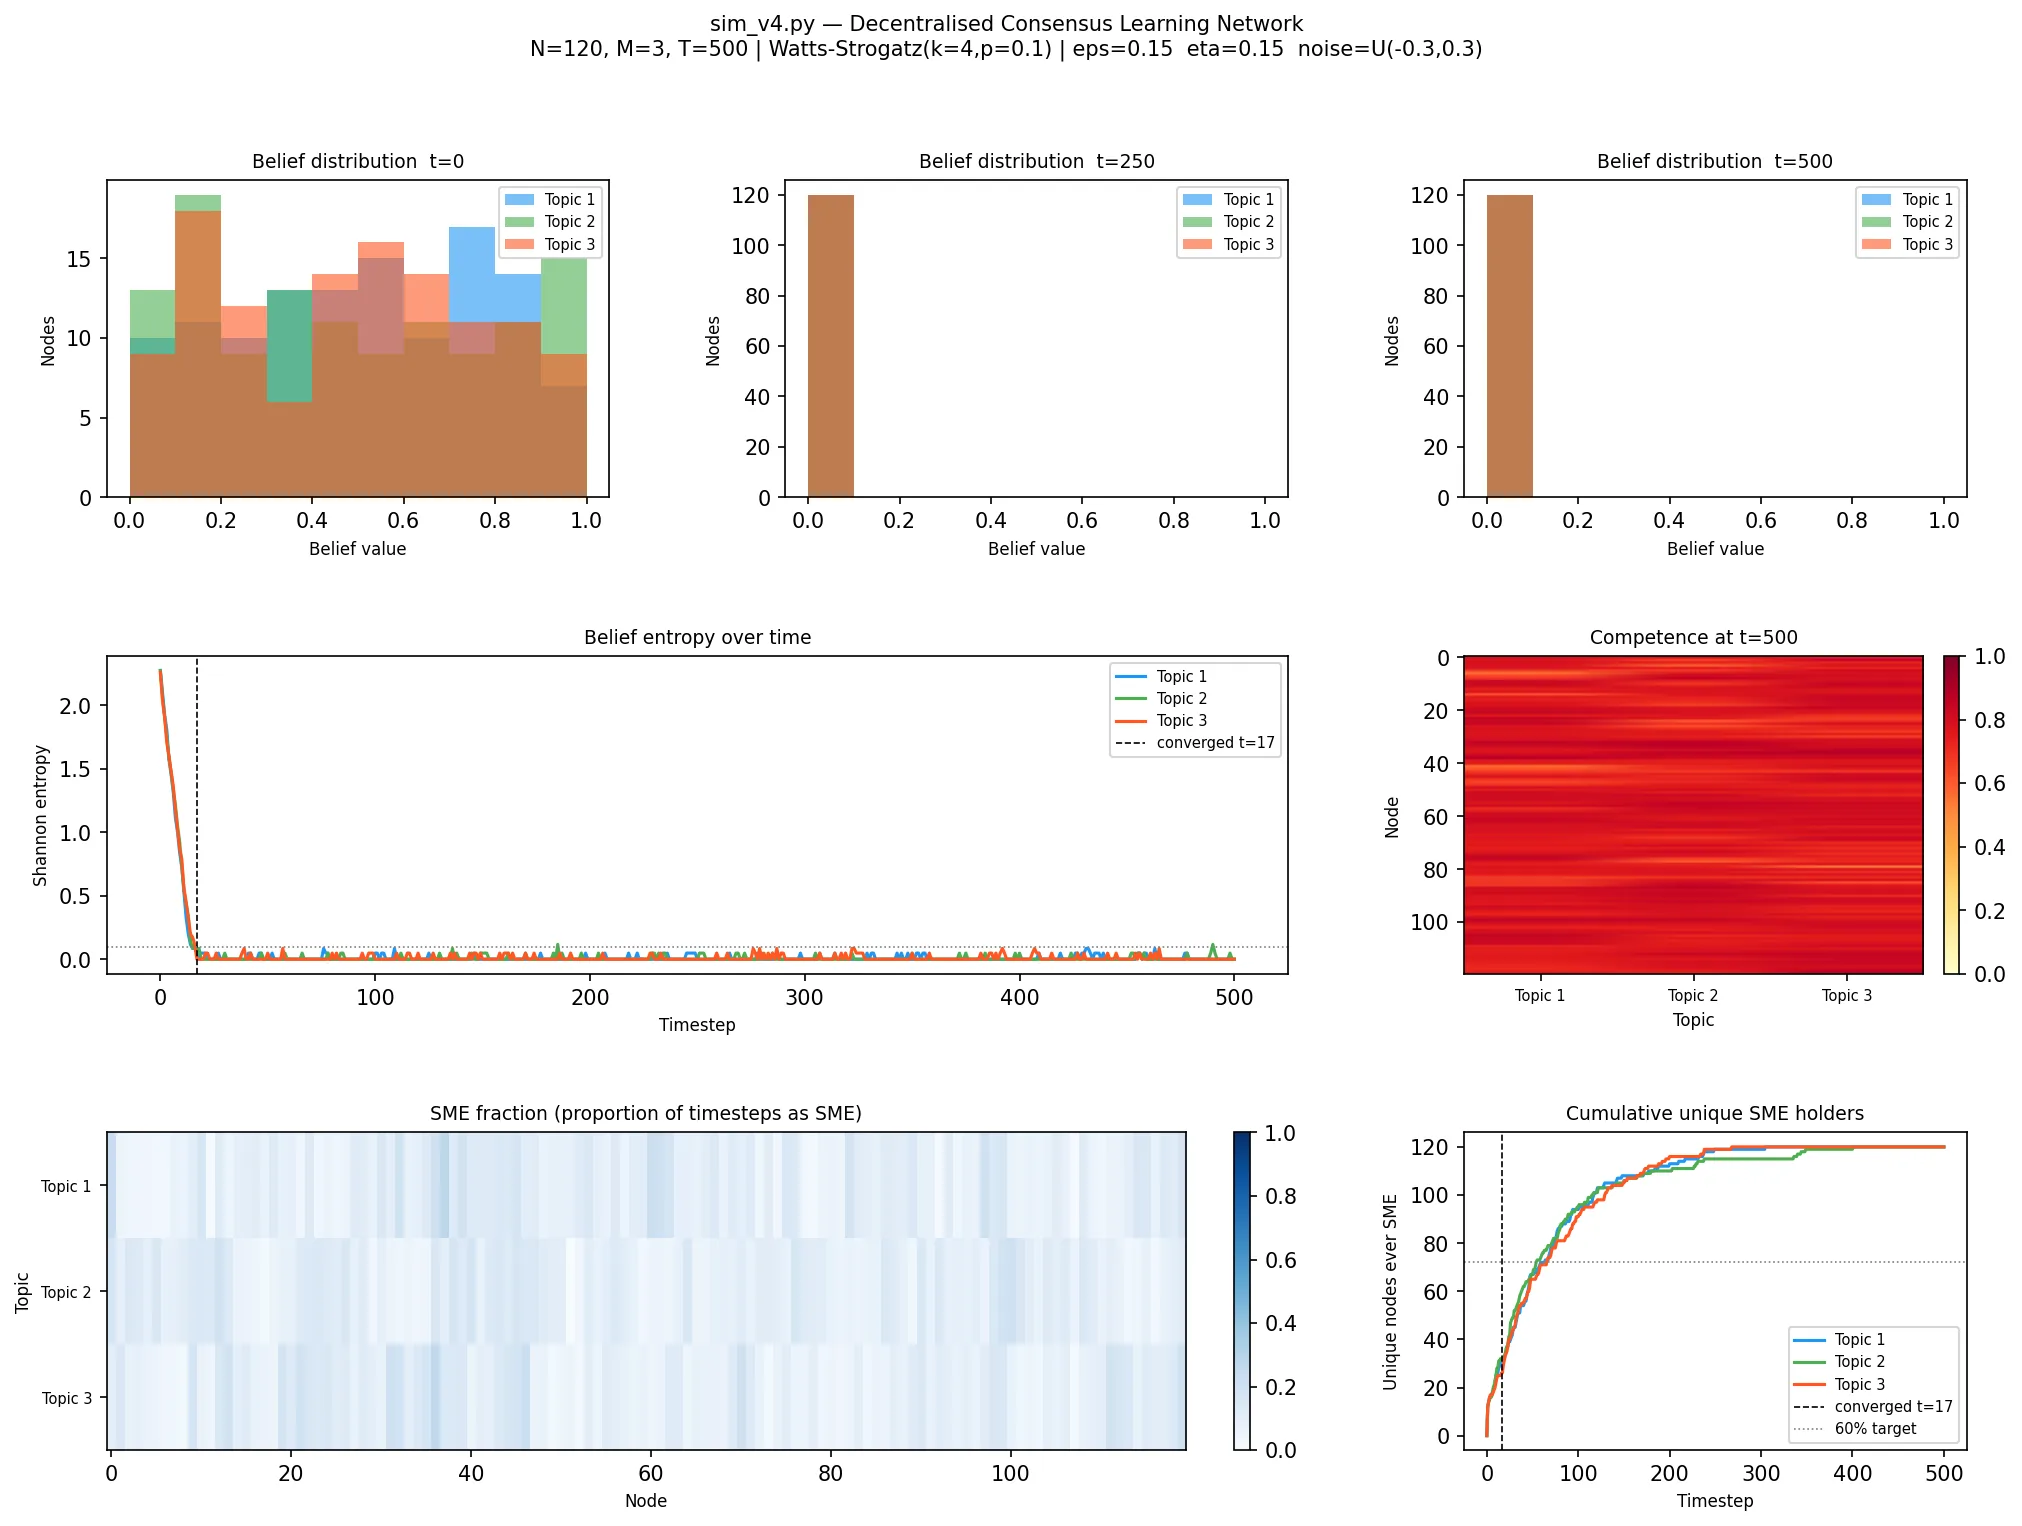
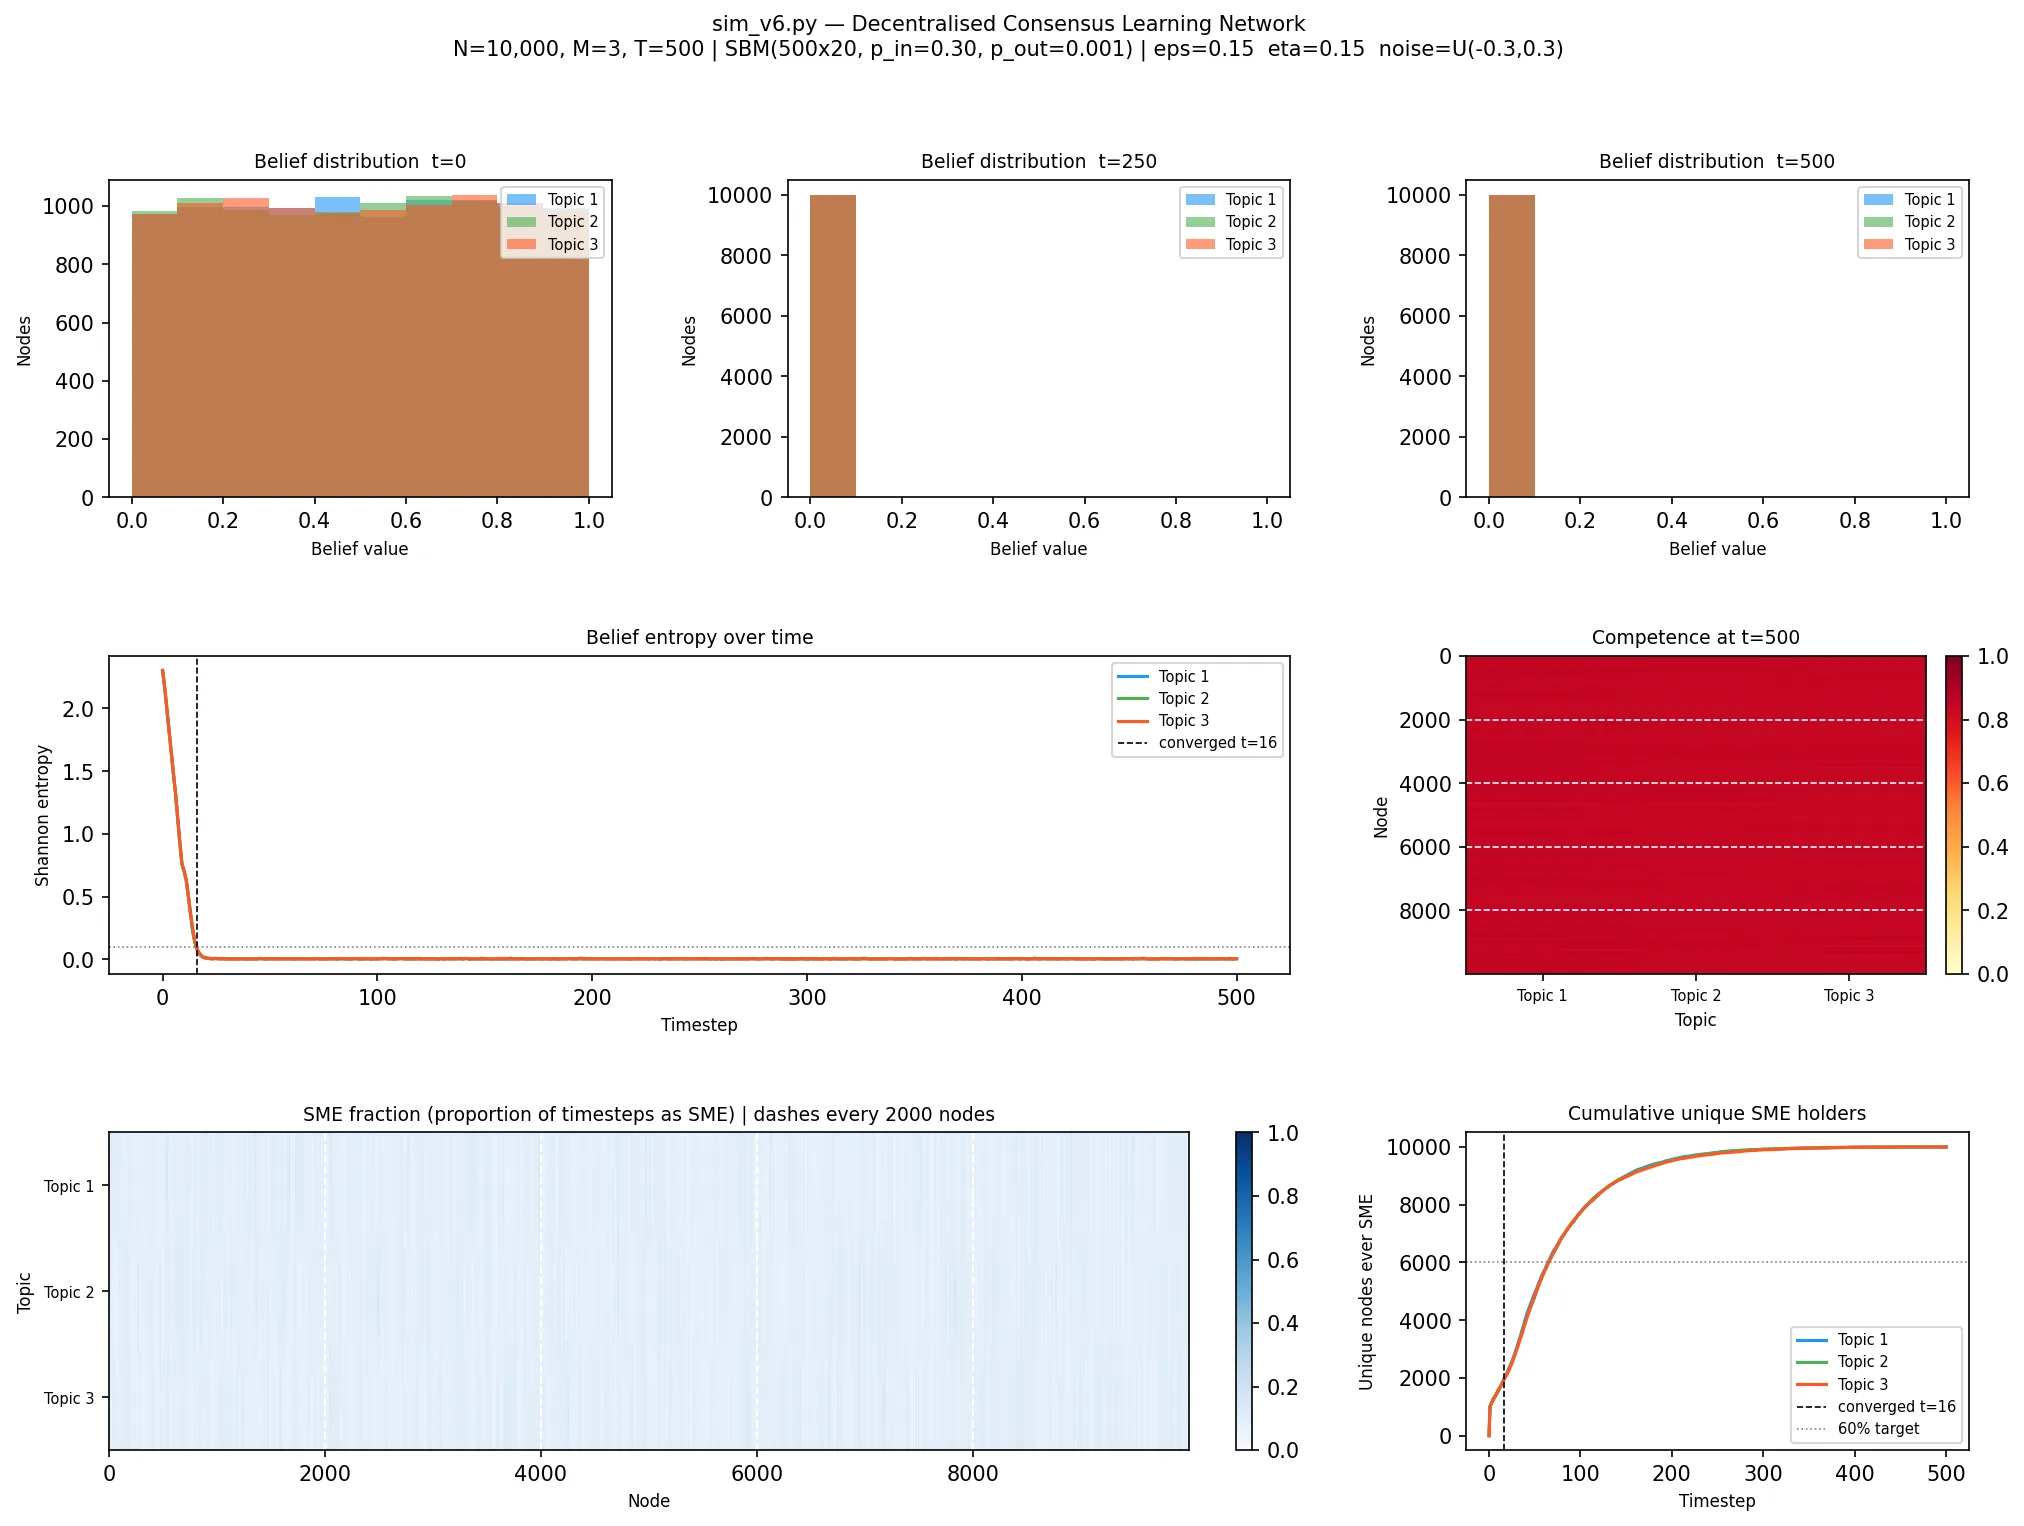
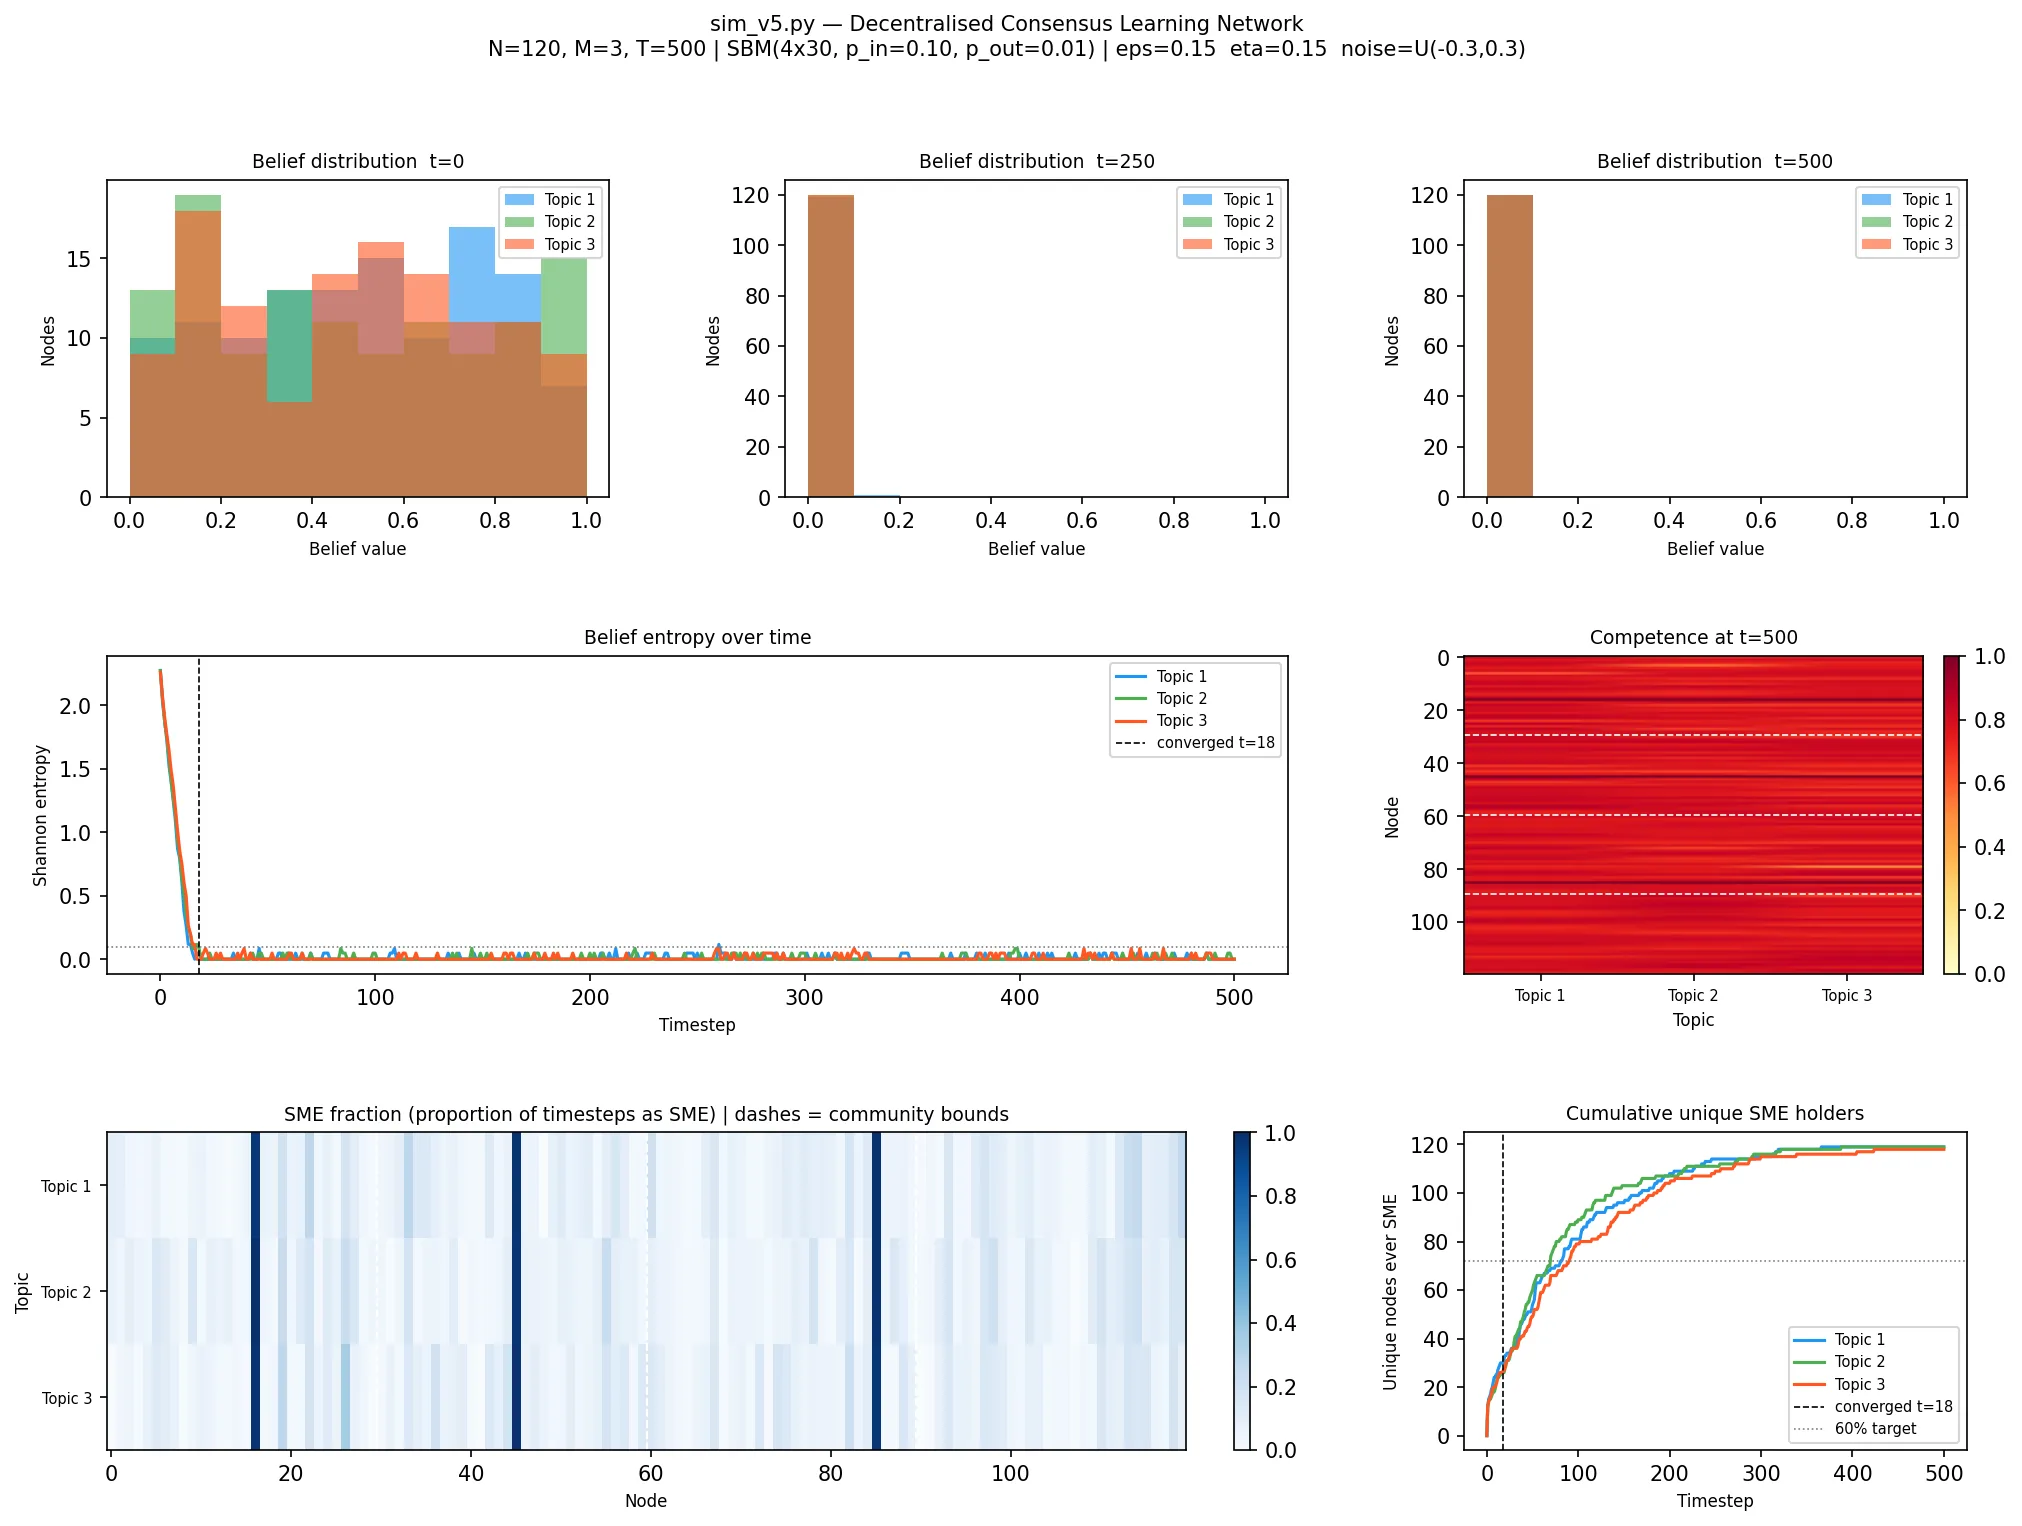
第一阶段的实验结果揭示了SME轮换机制的核心属性:稳健性、持久性、拓扑不变性和规模不变性。无论网络拓扑如何变化、无论智能体数量从几十到上万,实验结果显示90%到100%的智能体都曾获得过SME身份。这说明专家身份确实是在流动的,而不是被少数节点垄断。更值得注意的是,大多数专业能力的更替发生在信念已经收敛之后——这与直觉相反,通常人们会认为能力强的智能体应该主导收敛过程,但实验表明恰恰是收敛之后,不同智能体之间的一致性程度才开始分化,从而触发了专家身份的重新洗牌。
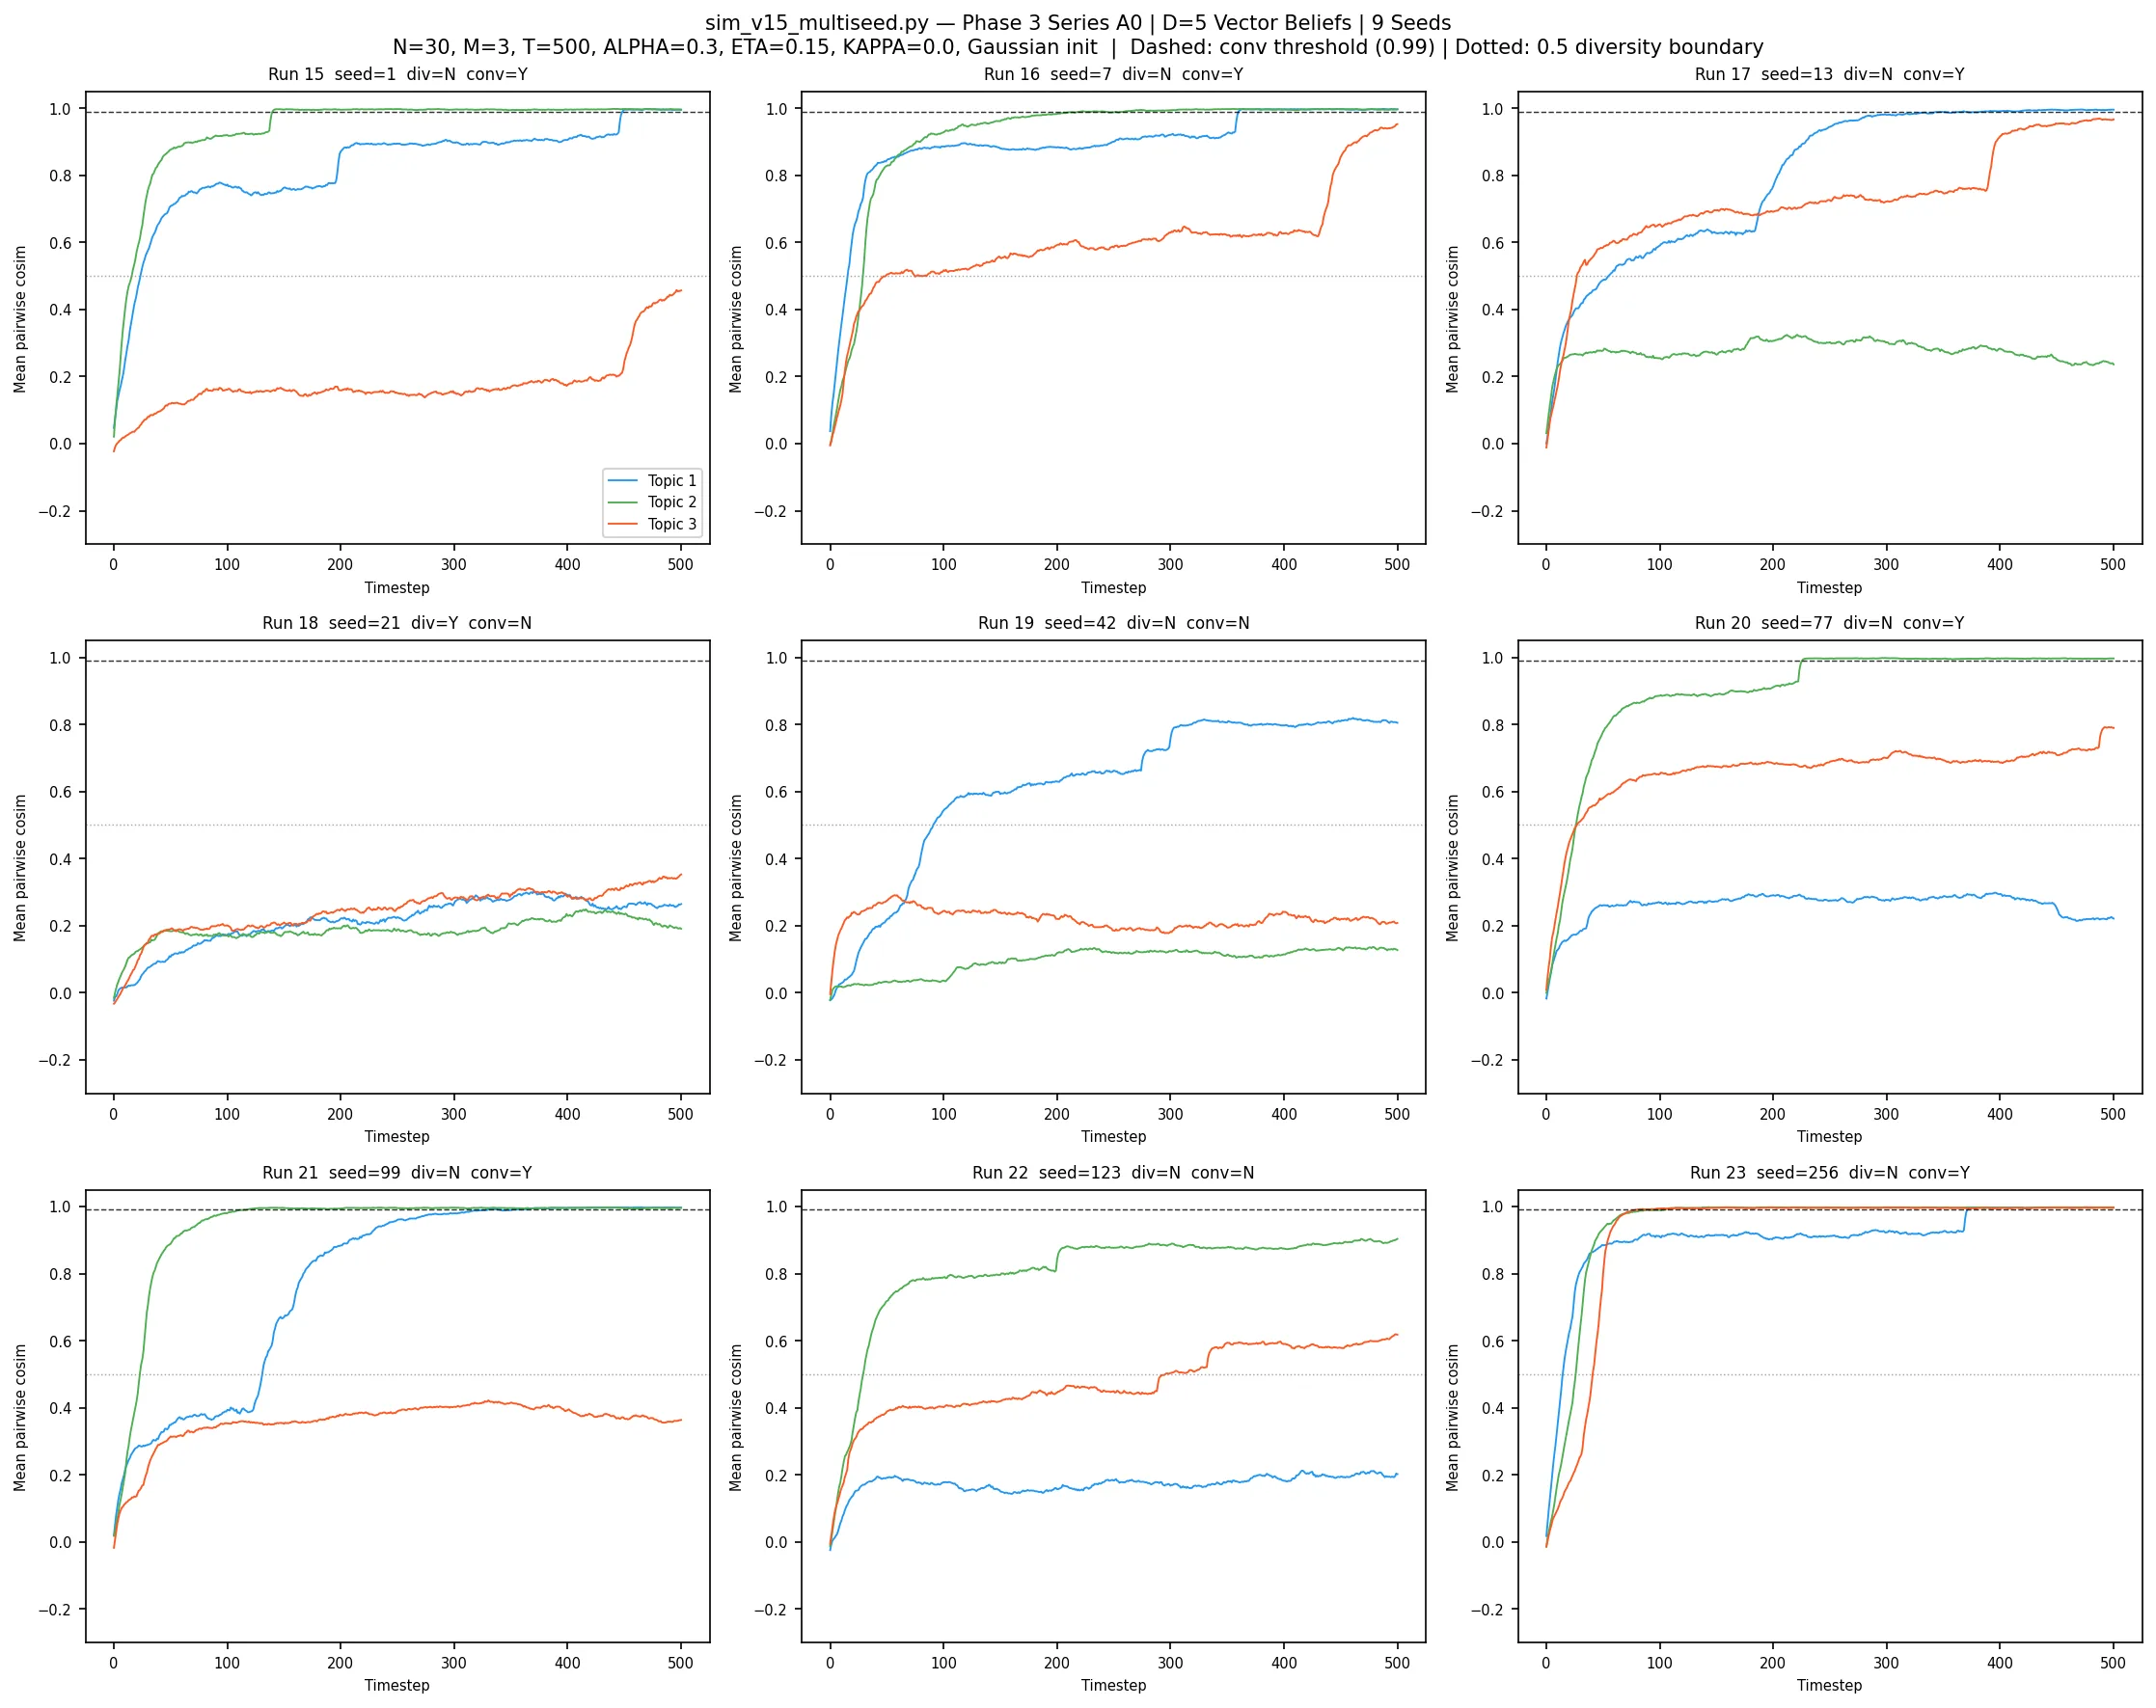
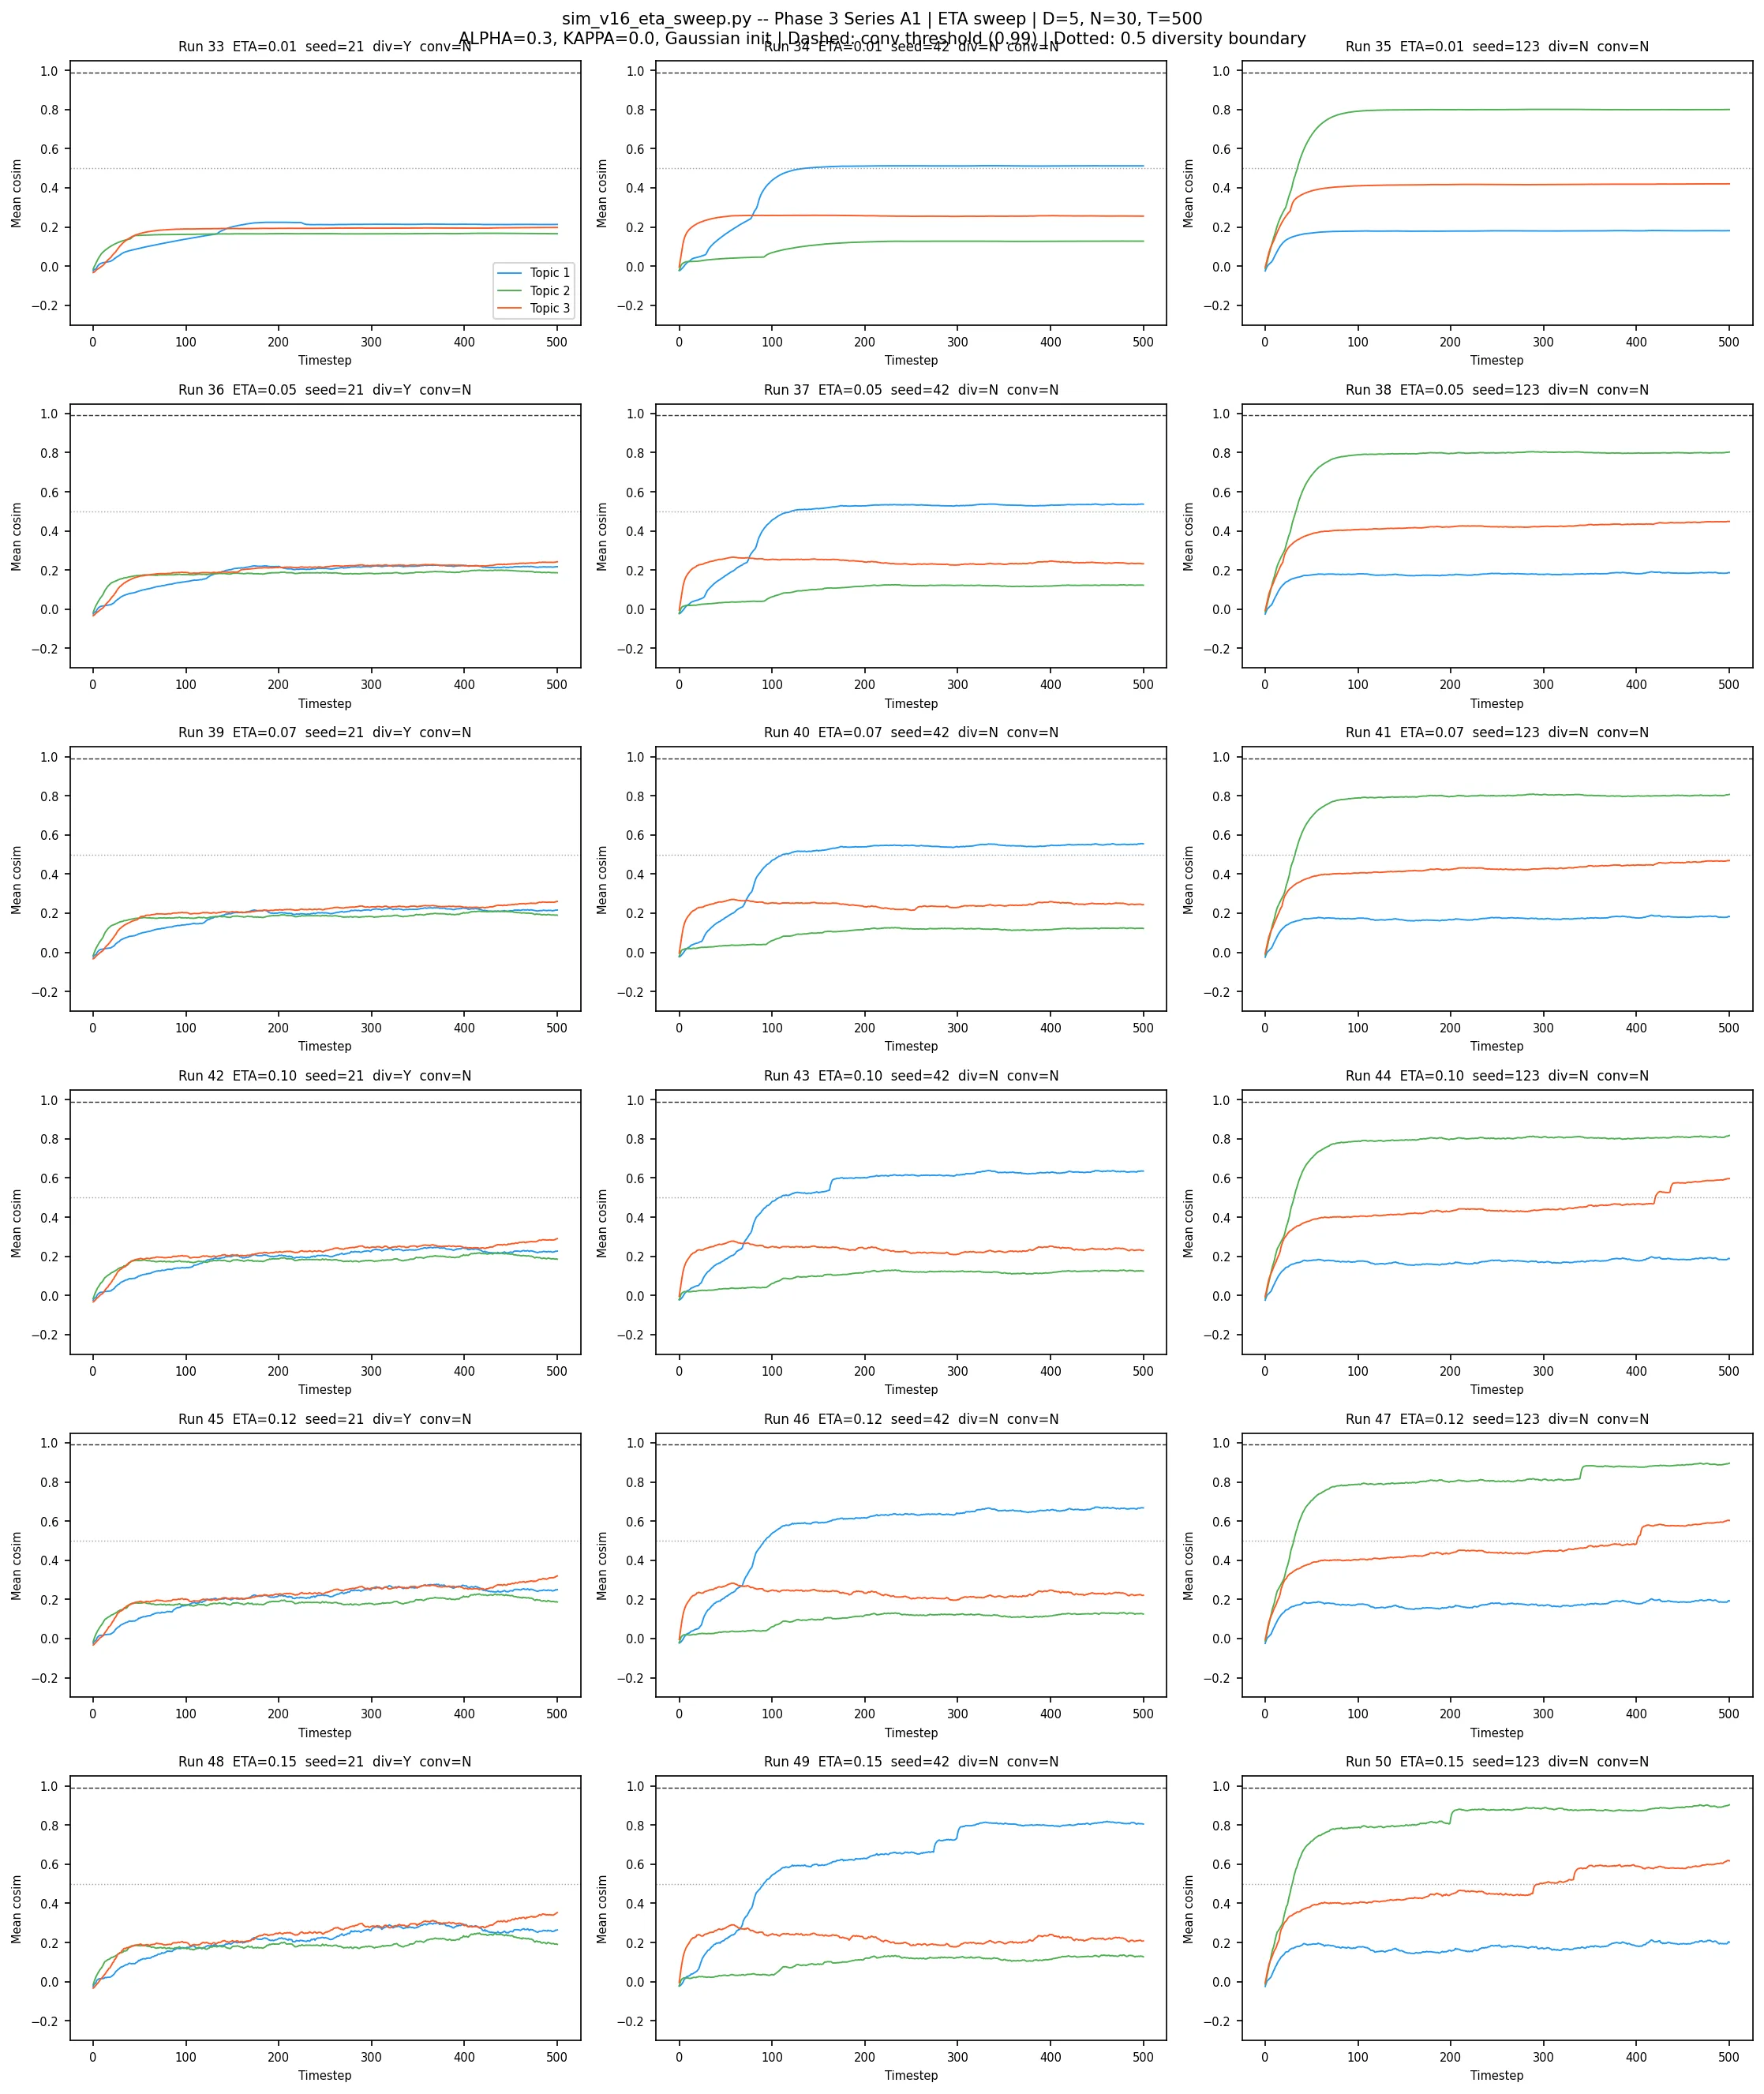
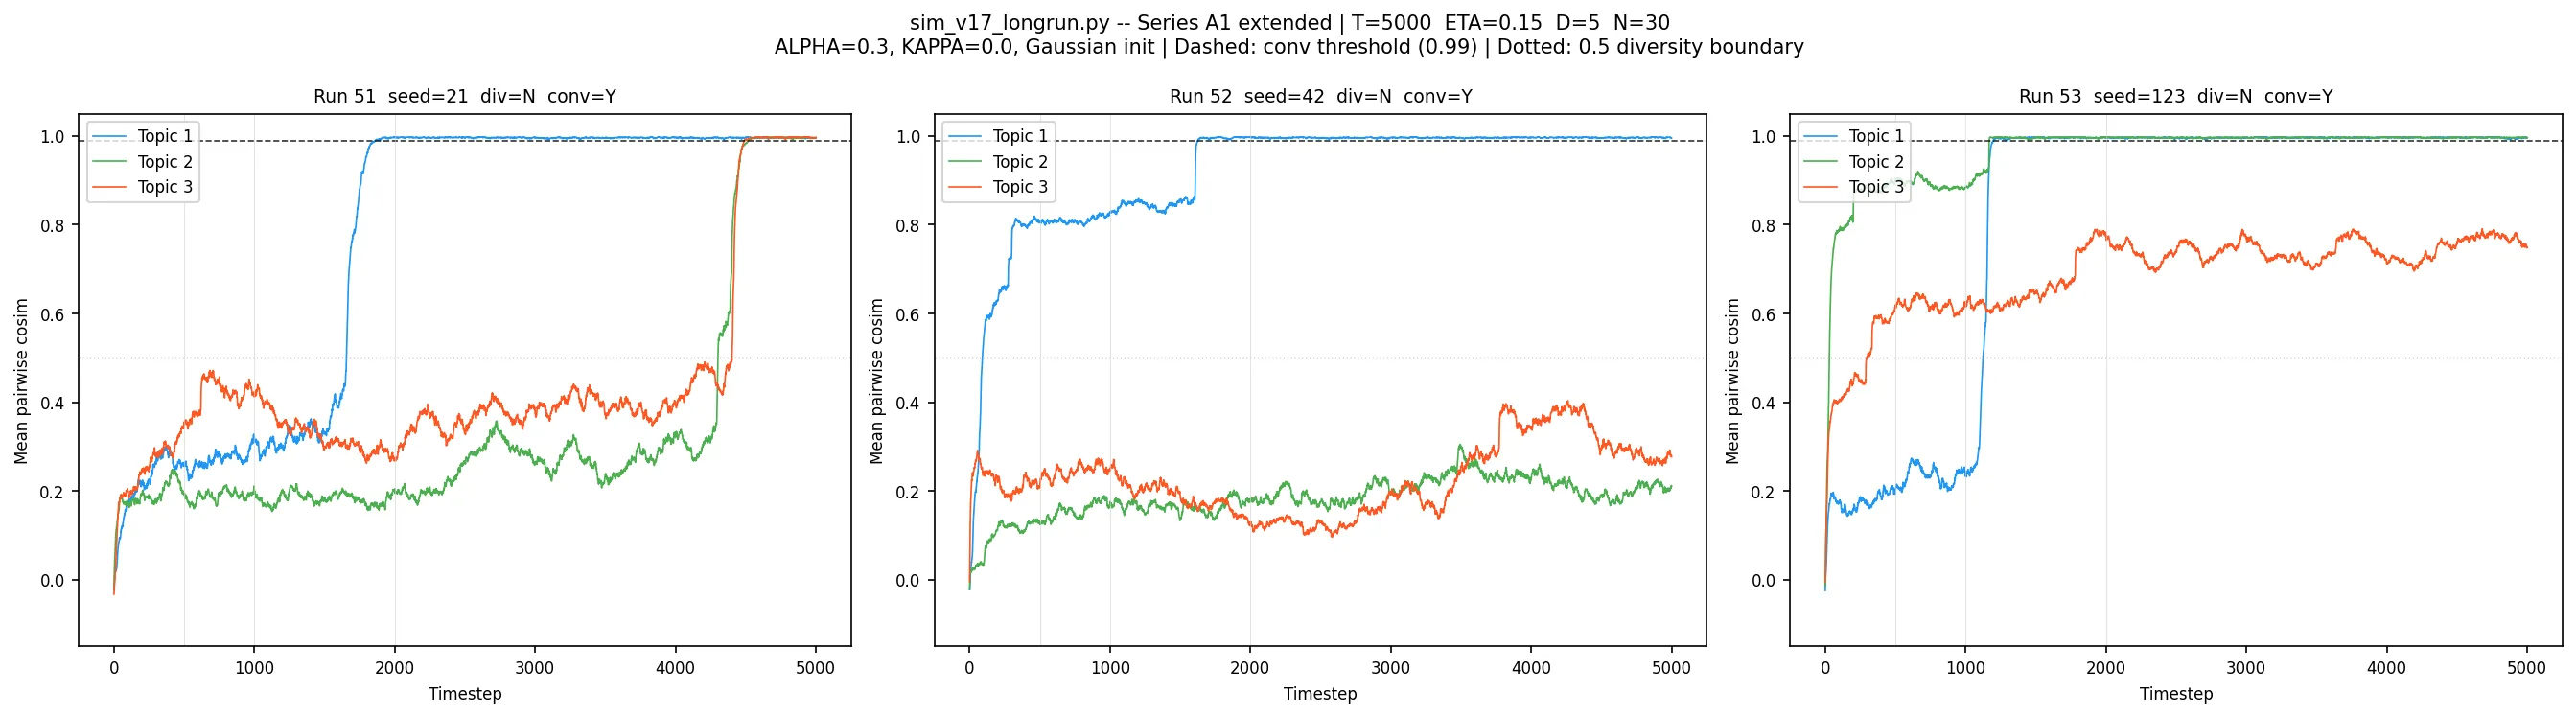
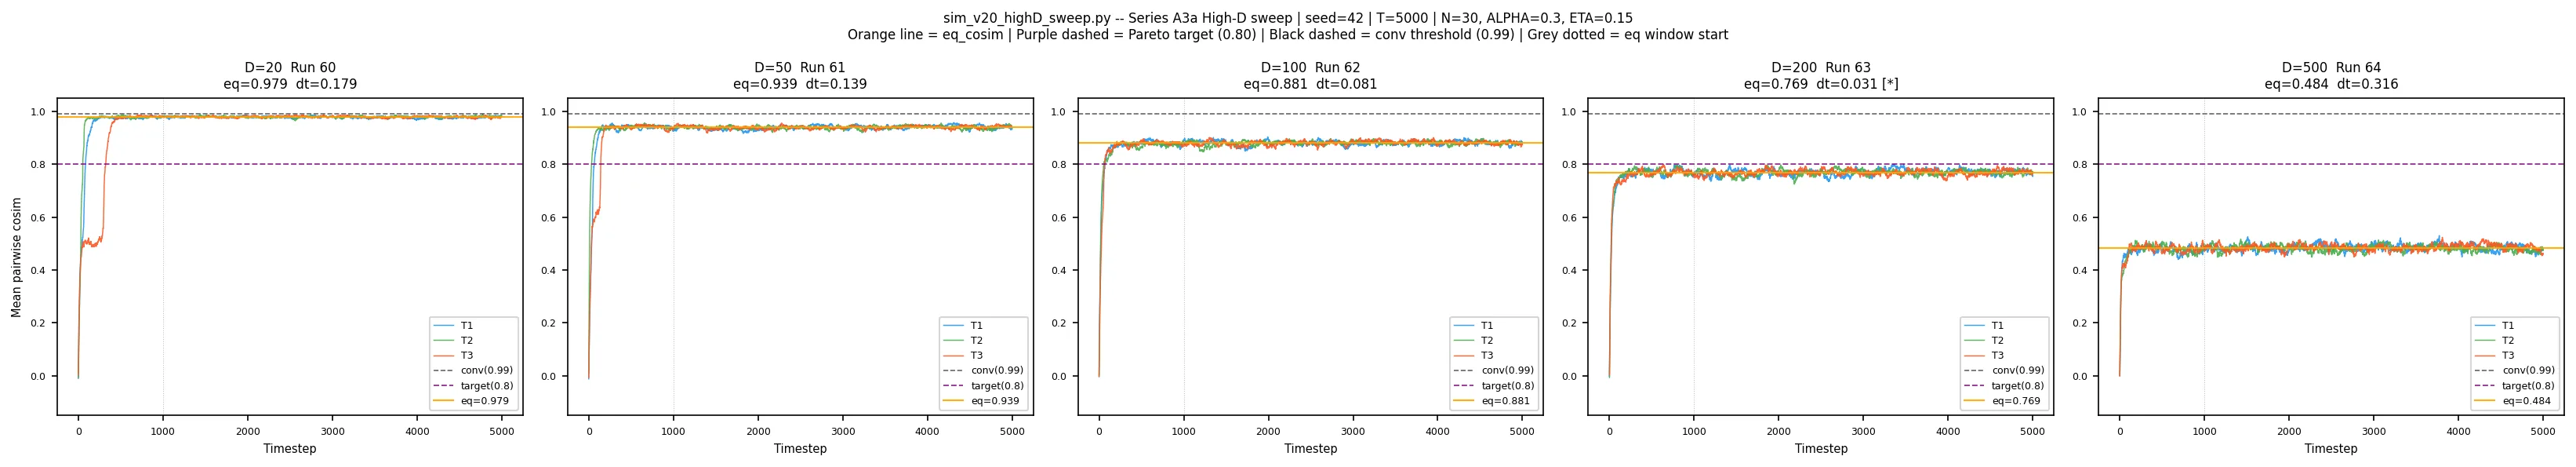
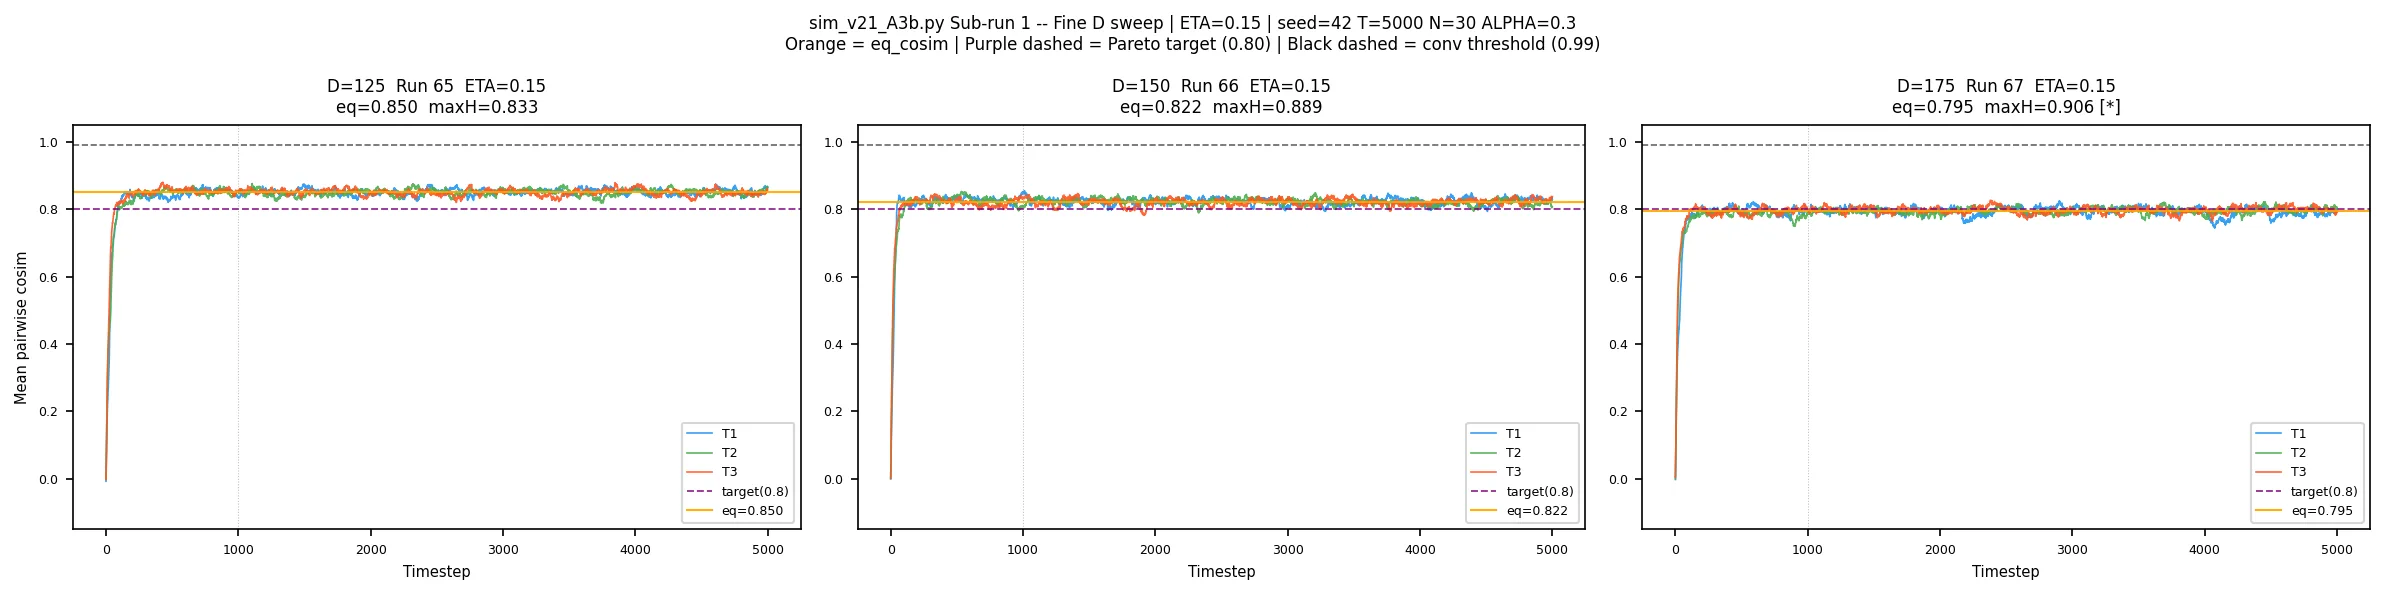
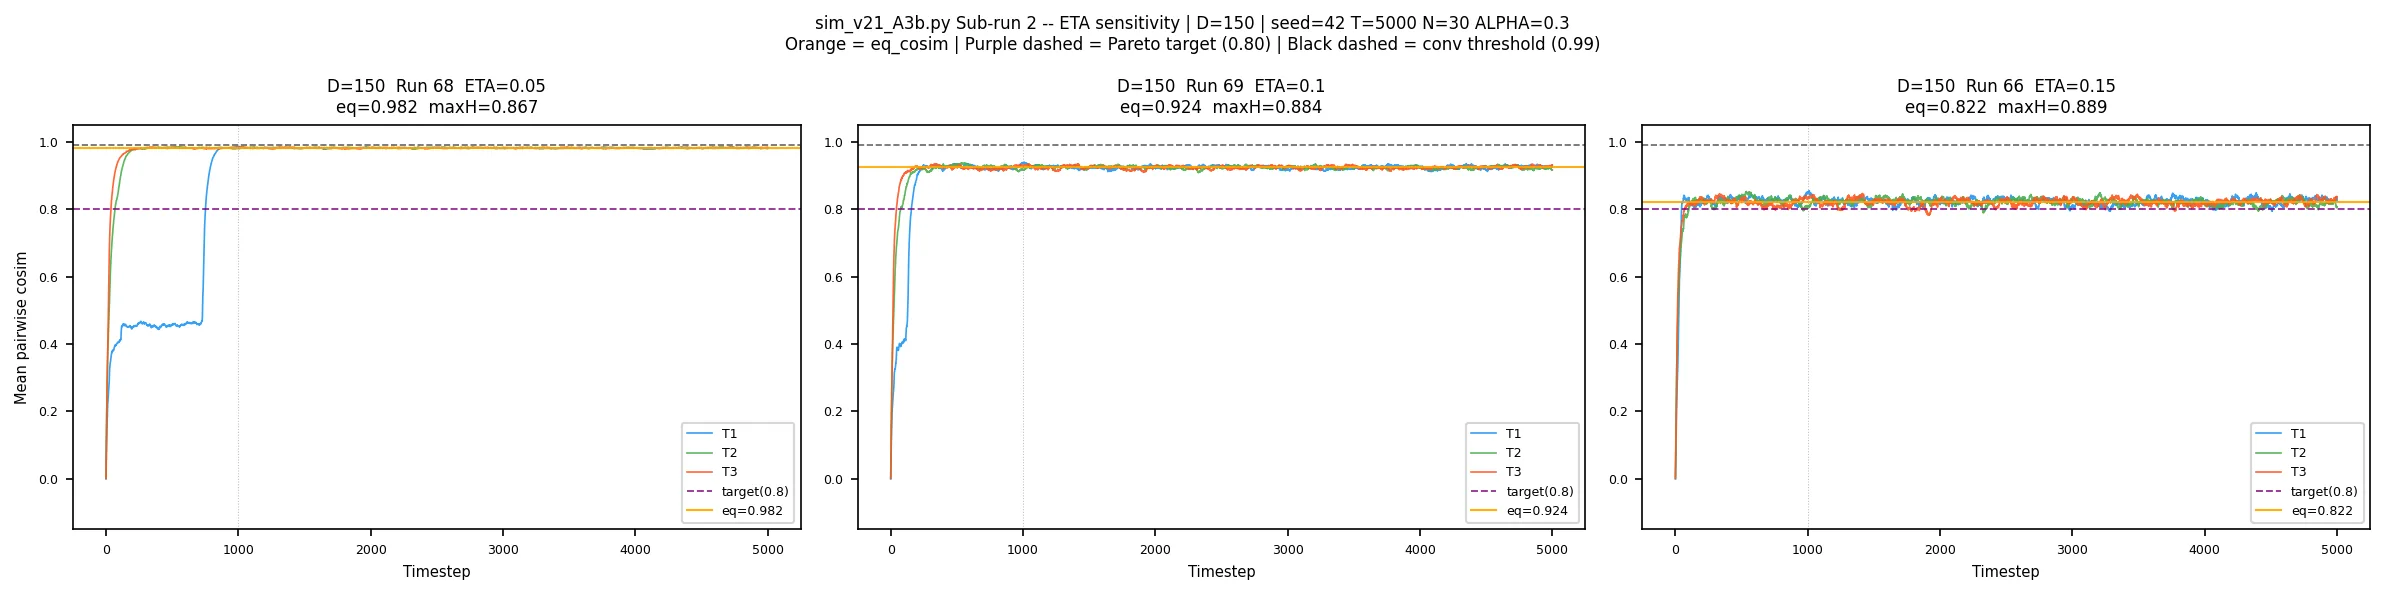
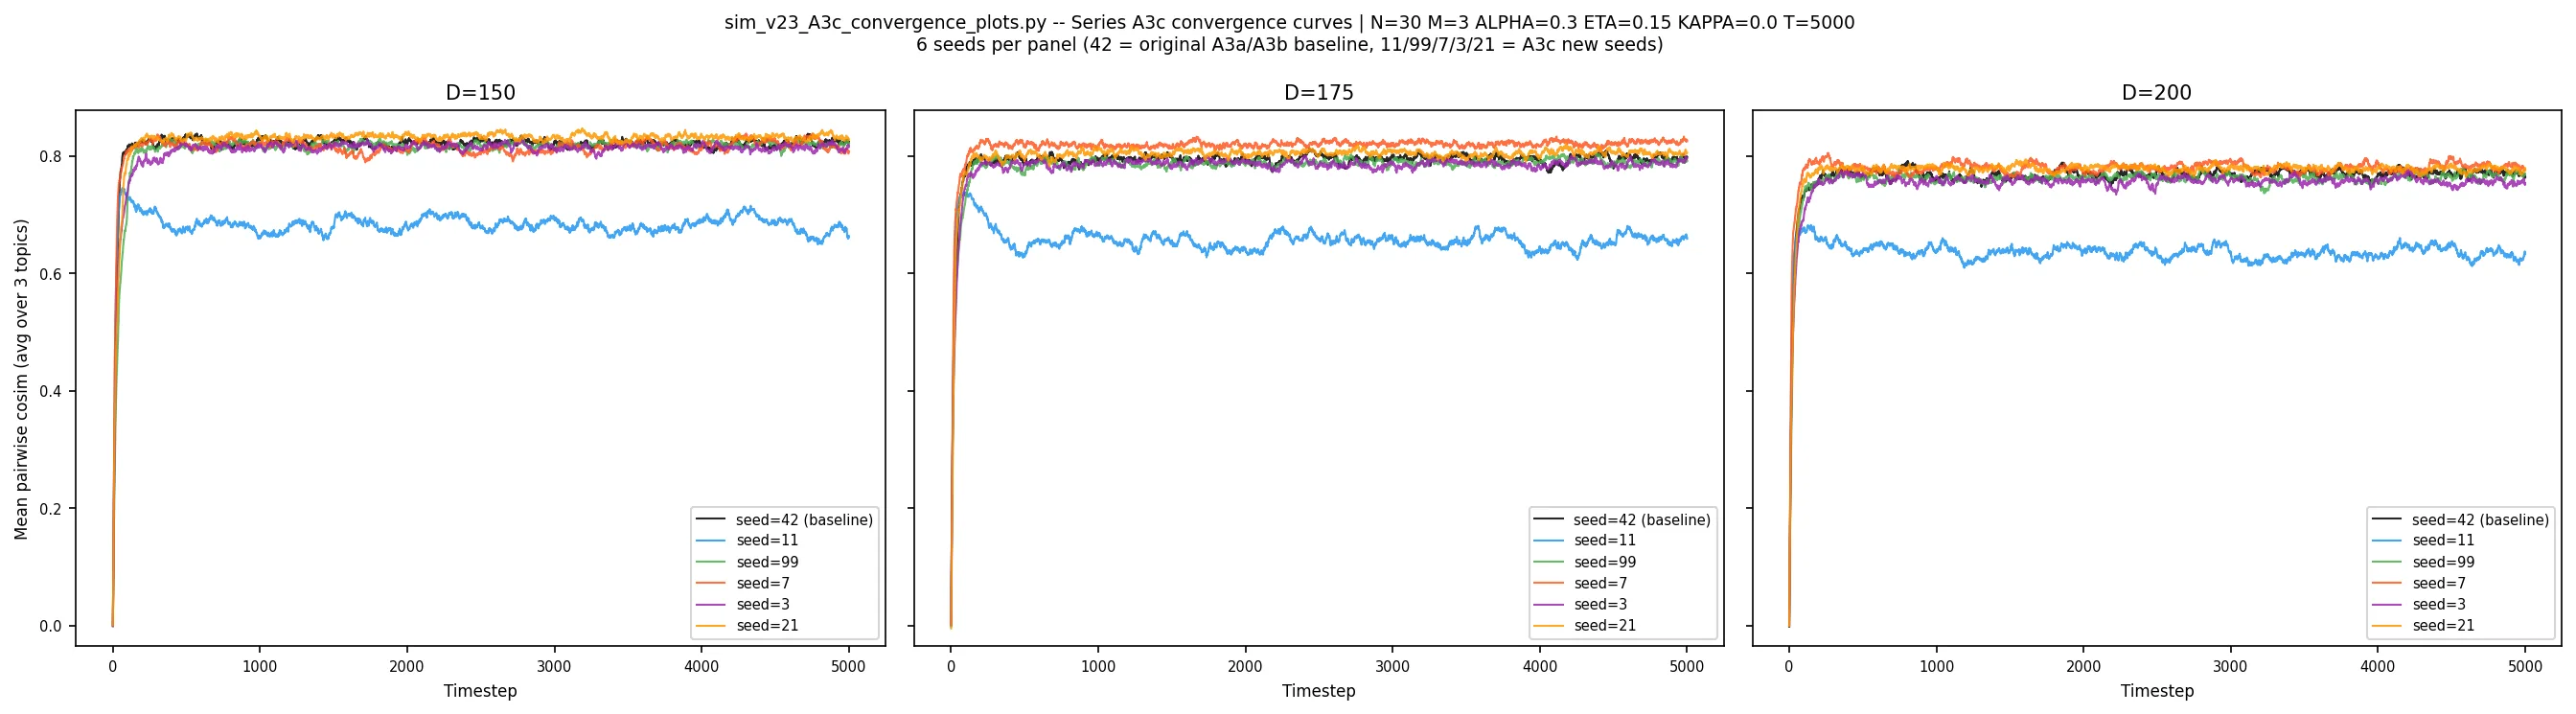
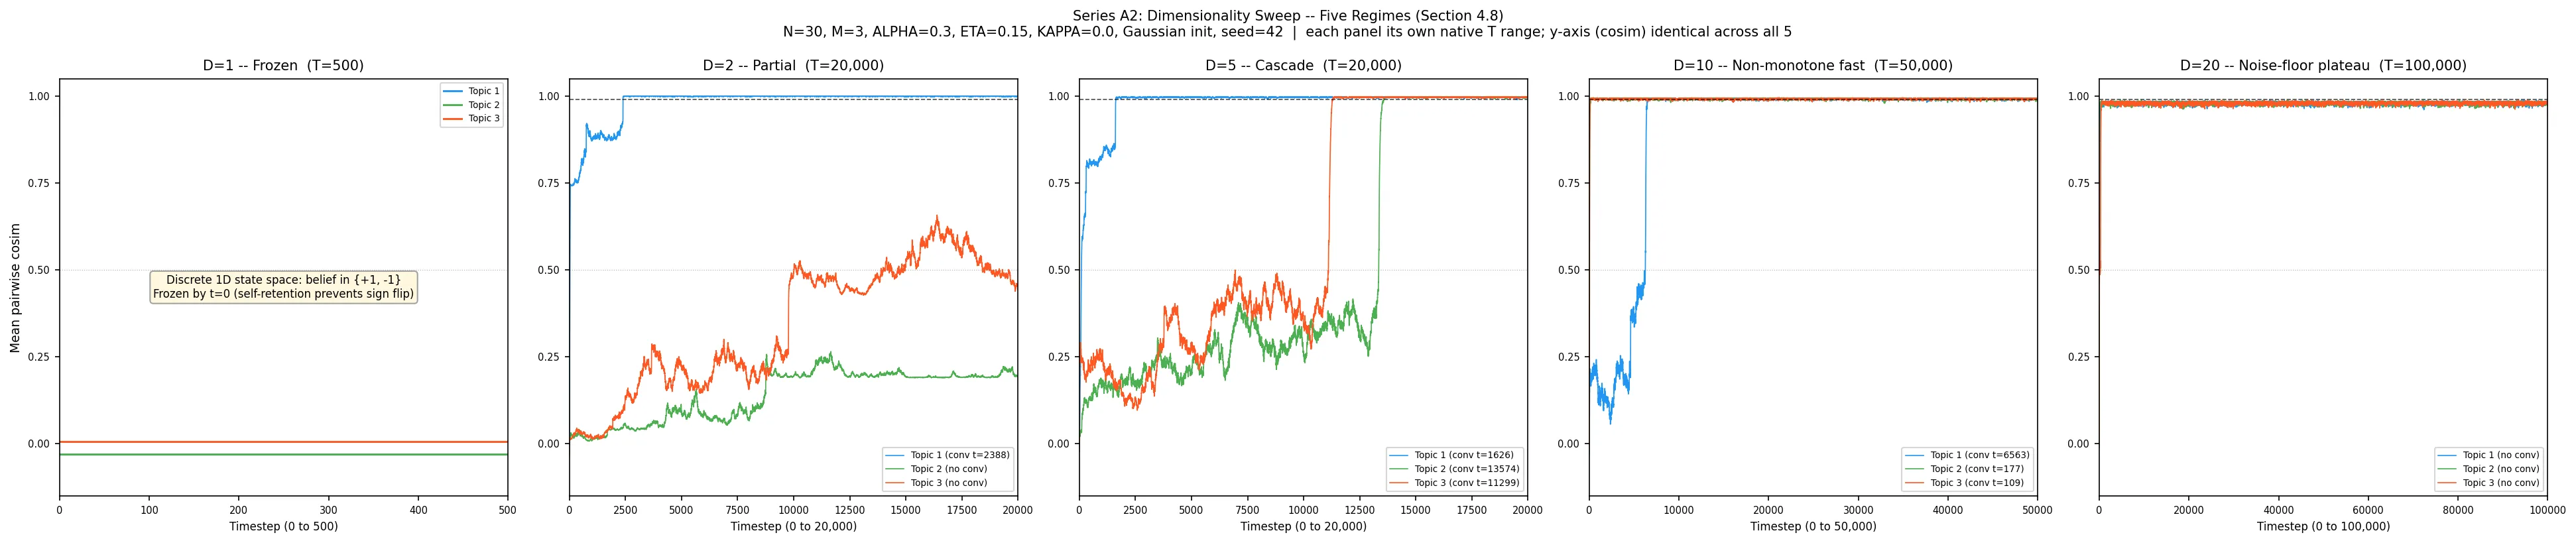
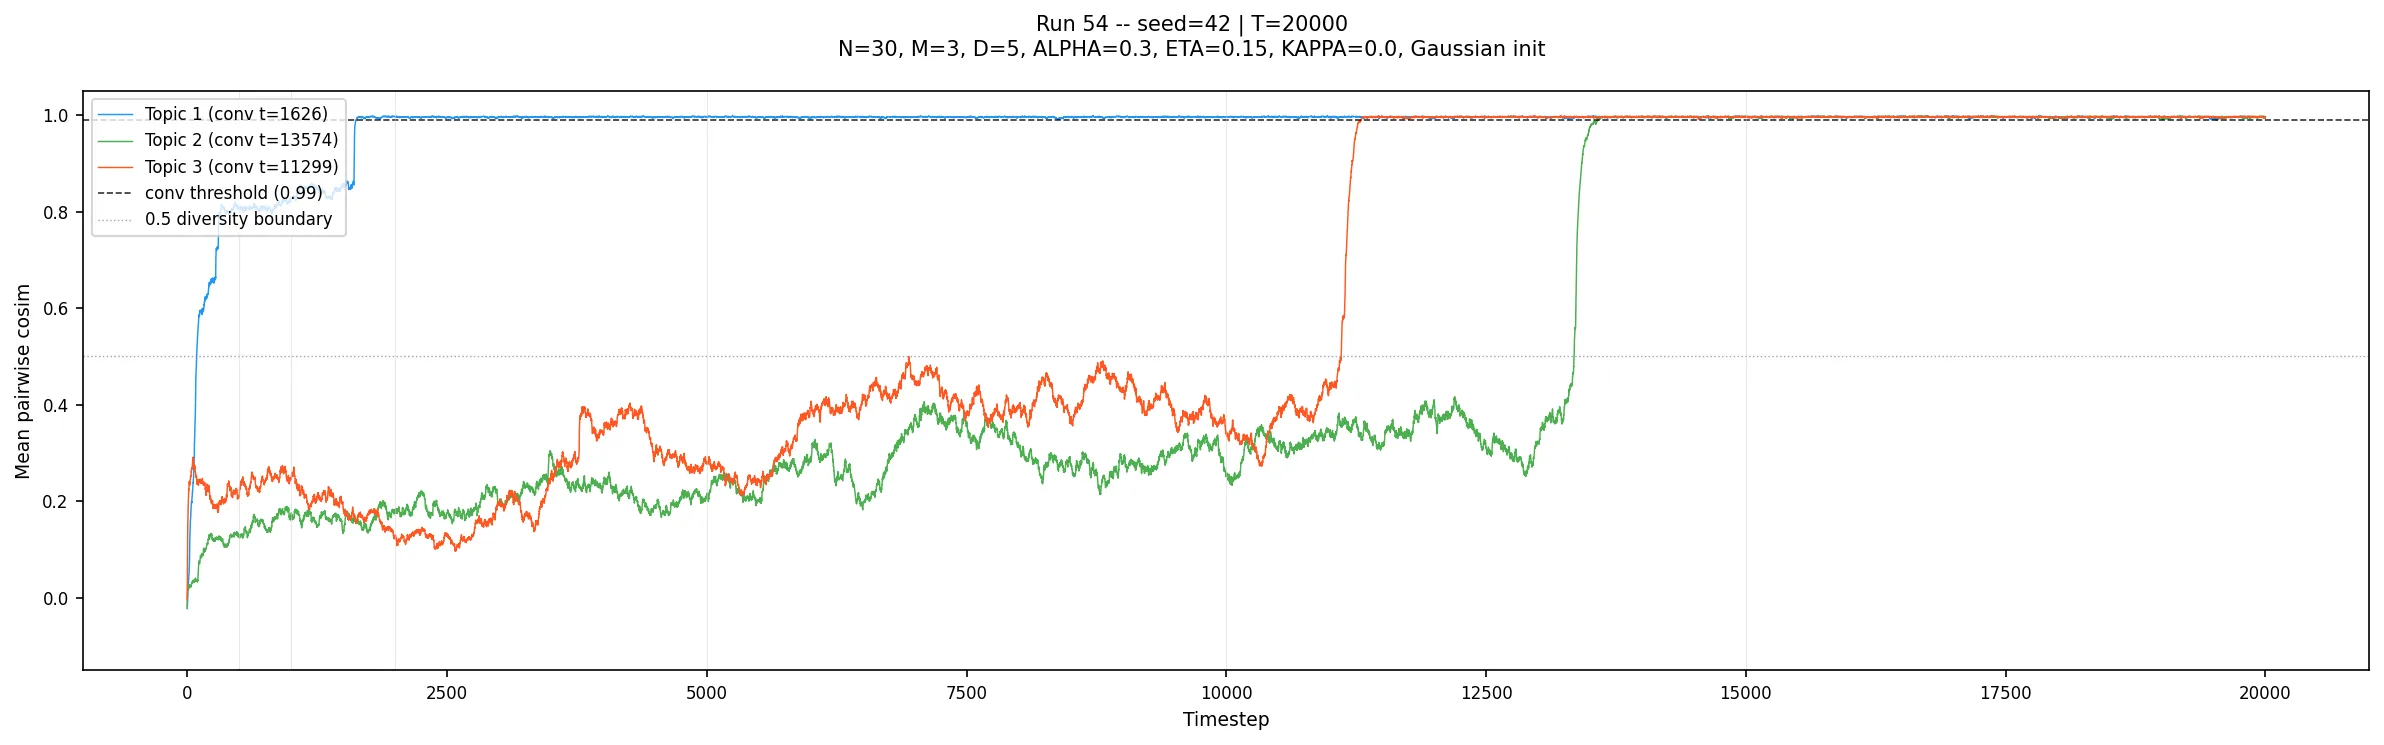
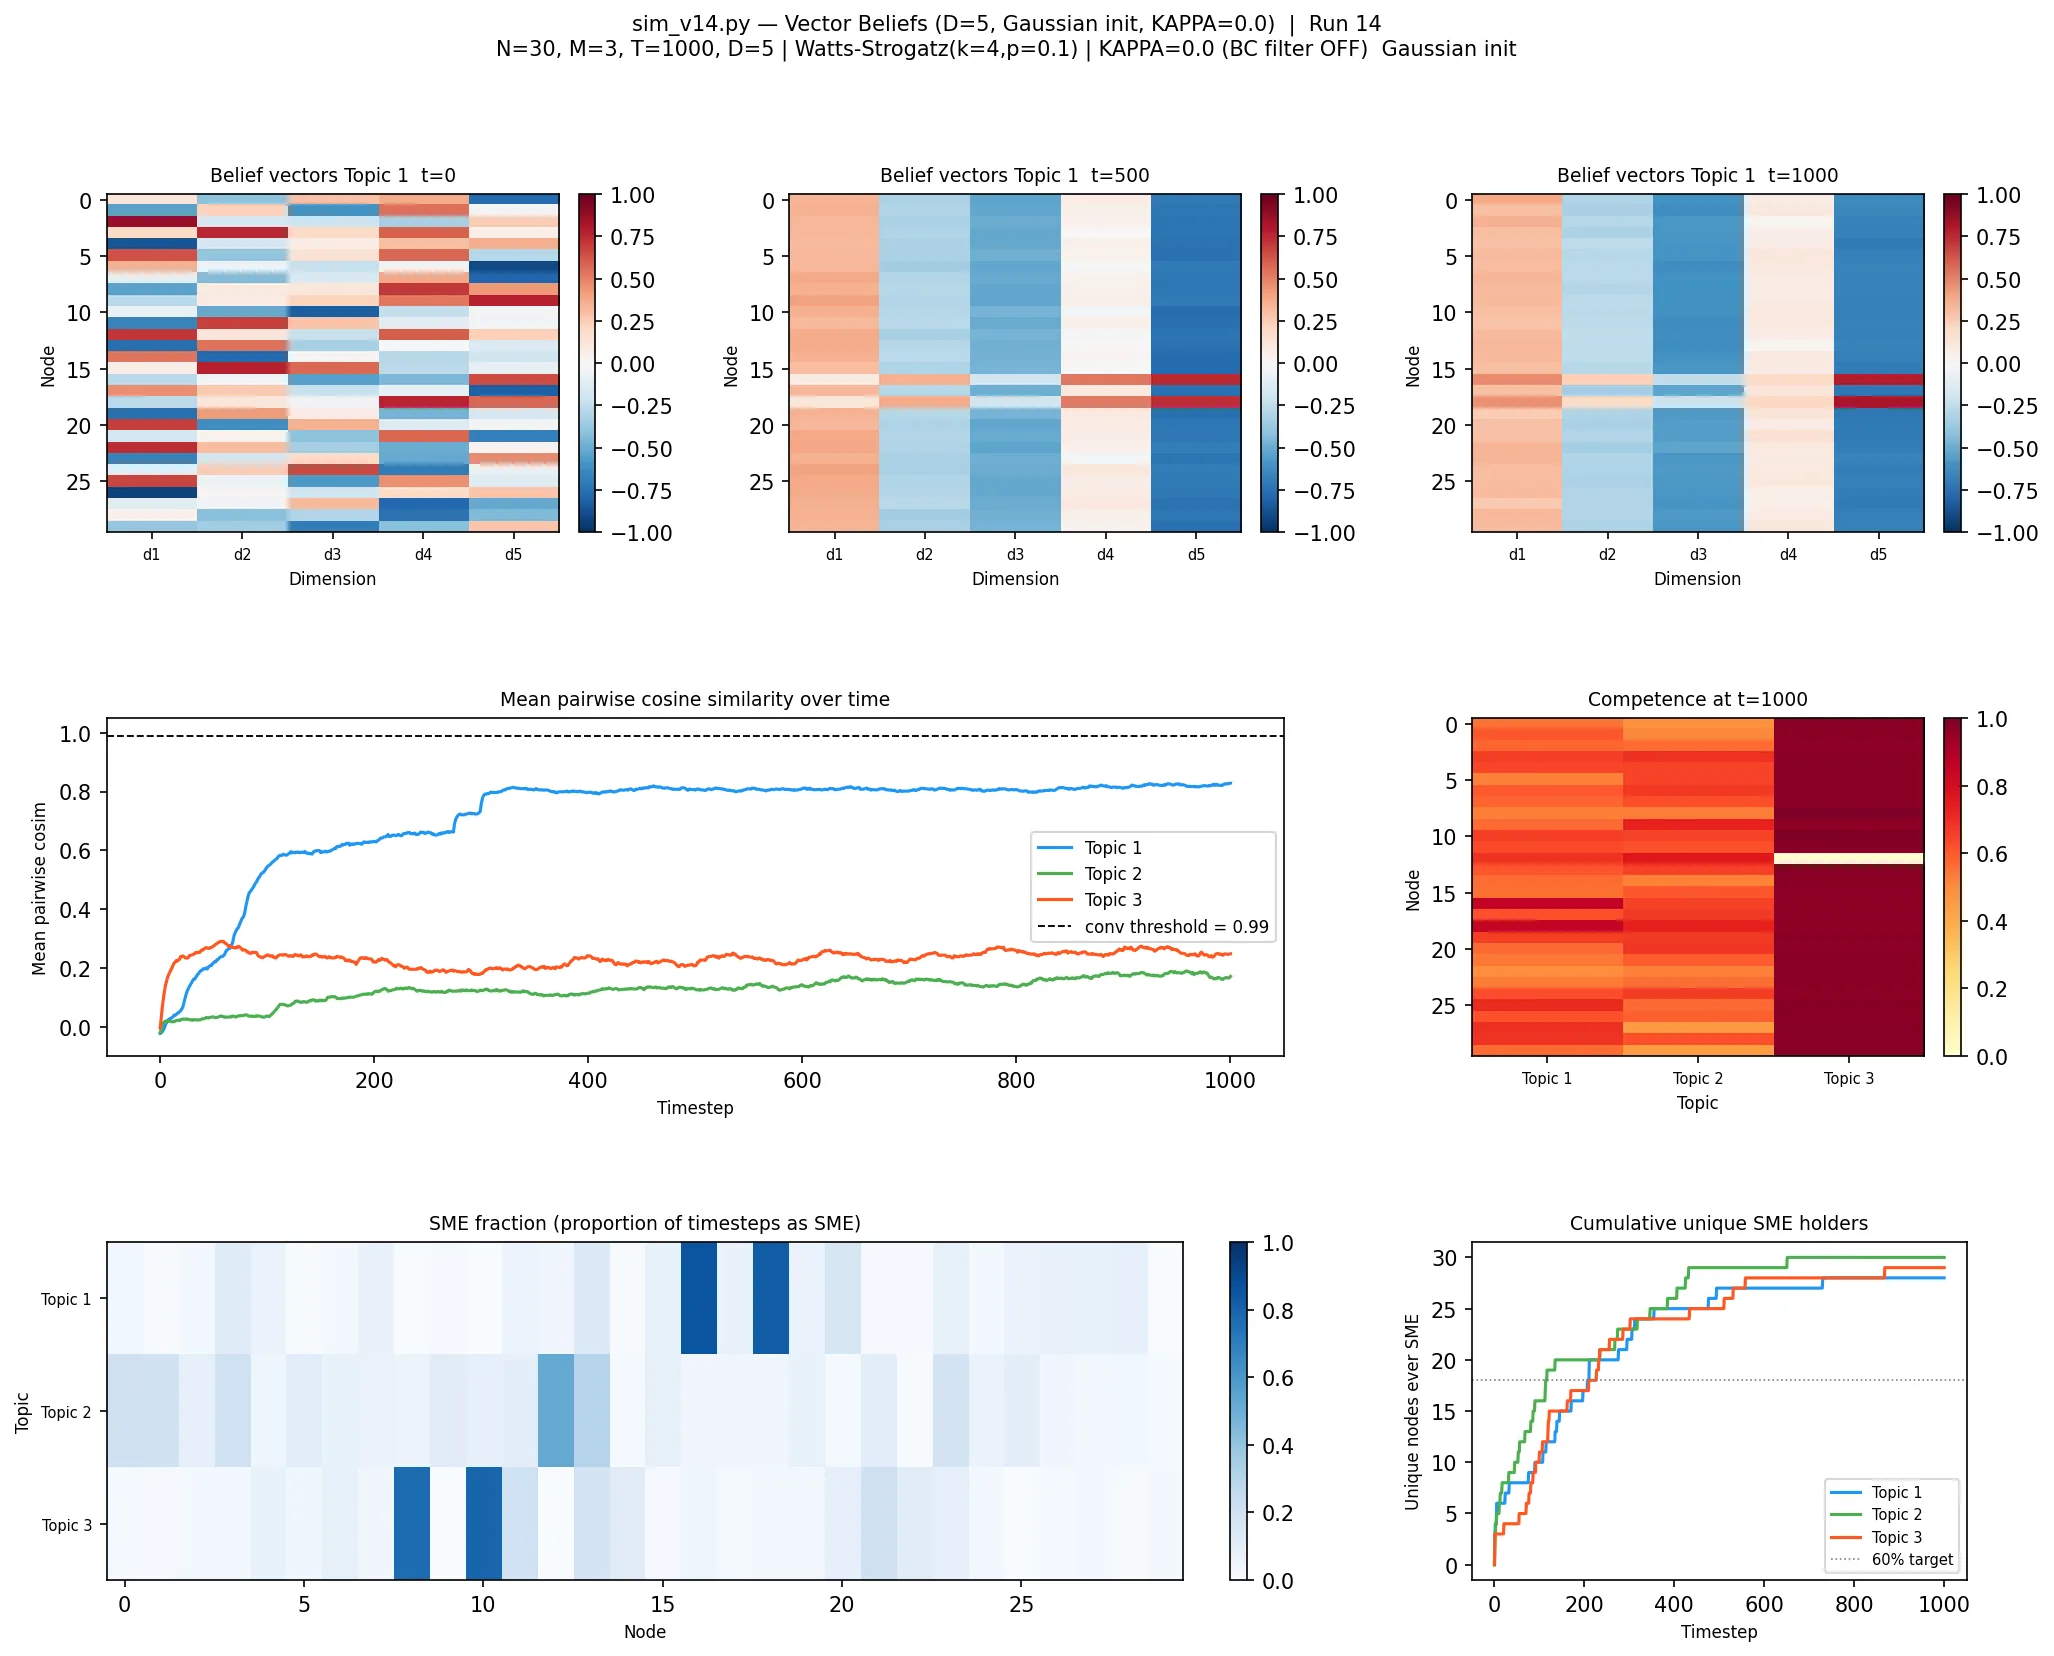
第二和第三阶段聚焦向量信念,引入了更丰富的动力学行为。研究发现,随着信念维度增加,网络展现出五种不同的收敛机制。在高维度区间(D=150-200)出现了一个关键转折:网络达到稳定的"部分共识"状态——并非所有维度都收敛,但专业能力高度集中于单一智能体。ETA敏感性分析进一步确认,这种集中化现象是由信念维度本身驱动的,而非随机噪声的影响。
研究团队将这一现象解读为去中心化学习的涌现性质:在复杂的高维共识空间中,与集体信念最一致对齐的智能体会自然涌现为被公认的专家。这是一种不需要中心授权的权威形成机制。
讨论与可借鉴点
这项研究最深刻的意义或许不在于具体的算法,而在于它提出的问题框架:当去掉集中式奖励之后,知识与权威如何从分散的交互中涌现?实验结果暗示,信念维度是一个关键变量——低维空间中专家身份趋于分散,高维空间中则趋于集中。这可能为理解人类社会的知识分工提供某种计算模型。
研究的局限同样值得注意。首先,这是在模拟环境中的实验,真实世界的去中心化系统(如社交网络、开源社区)存在更多噪声和信息失真。其次,框架假设智能体的目标函数是趋同而非保持分歧,但某些场景下认知多样性本身就是有价值的。此外,"与集体一致"作为能力的代理指标存在风险:当大多数智能体持有错误信念时,一致性反而会放大错误。
对于多智能体系统和去中心化学习领域而言,这篇论文提供了一个值得深挖的研究方向——如何设计机制让能力评估和信任分配在无中心协调的情况下稳定运作,以及如何在共识达成与多样性保持之间找到平衡。
摘要
集中式奖励信号主导着现代人工智能学习系统,但它们强加了关于正确或有价值知识的单一外部定义。我们提出了一种去中心化的、基于共识的多智能体学习框架,其中专业能力通过同伴验证而非预设奖励而涌现。智能体通过加权社会共识来更新信念,而信任则依据从同伴一致性中推断出的能力来分配,而非依据真实标签。主题专家(SME)身份作为前百分位的能力排名被动态分配,而非作为固定标签。
我们在84次仿真运行中评估了该框架,涵盖30到10,000个智能体、多种图拓扑、稀疏大规模网络、标量与向量信念表示、维度扫描(D=1–500)、多种子稳健性测试以及参数敏感性分析。第一阶段表明,SME轮换具有稳健性、持久性、拓扑不变性和规模不变性:90%至100%的智能体获得SME身份,大多数专业能力的更替发生在信念收敛之后,并随网络规模的增大而增加。第二和第三阶段表明,向量信念引入了具有级联动态的异质收敛,并揭示了随信念维度增加而出现的五种不同的动力学机制。在高维度(D=150–200)下,网络达到稳定的部分共识,而专业能力则越来越集中于单一智能体。ETA敏感性分析表明,这种集中性是由信念维度而非随机噪声所驱动。我们将这种行为解释为去中心化学习的一种涌现性质:在复杂的高维共识空间中,与集体信念最一致对齐的智能体会自然涌现为被公认的专家。
Abstract
Centralised reward signals dominate modern AI learning systems, but they impose a single external definition of correct or valuable knowledge. We present a decentralised, consensus-based multi-agent learning framework in which expertise emerges through peer validation rather than prescribed reward. Agents update beliefs via weighted social consensus, while trust is allocated according to competence inferred from peer consistency instead of ground truth. Subject-matter expert (SME) status is assigned dynamically as a top-percentile competence rank rather than a fixed label. We evaluate the framework across 84 simulation runs spanning 30 to 10,000 agents, multiple graph topologies, sparse large-scale networks, scalar and vector belief representations, dimensionality sweeps (D=1-500), multi-seed robustness tests, and parameter sensitivity analyses. Phase 1 shows that SME rotation is robust, persistent, topology-invariant, and scale-invariant: 90-100% of agents attain SME status, with most expertise turnover occurring after belief convergence and increasing with network size. Phases 2 and 3 show that vector beliefs introduce heterogeneous convergence with cascade dynamics and reveal five distinct dynamical regimes as belief dimensionality increases. At high dimensionality (D=150-200), the network reaches stable partial consensus while expertise becomes increasingly concentrated in a single agent. ETA sensitivity analysis demonstrates that this concentration is driven by belief dimensionality rather than stochastic noise. We interpret this behaviour as an emergent property of decentralised learning: in complex high-dimensional consensus spaces, the agent most consistently aligned with the collective belief naturally emerges as the recognised expert.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。