
从专有模型到开源模型:通过多智能体协议蒸馏弥合智能体搜索中的分布差距
From Proprietary to Open-Source: Bridging the Distribution Gap via Multi-Agent Protocol Distillation in Agentic Search
📝 TLDR
智能体搜索通过多步推理与检索交错解决知识密集任务,但基于结果的强化学习仅提供稀疏监督信号,且从专有模型蒸馏存在分布鸿沟。本文提出多智能体协议蒸馏MAPD,以结构化JSON协议作为中间表征,将离线多智能体系统的探索轨迹转换为任务类型、推理计划与抽取式事实。在7个QA基准上Qwen3-1.7B达39.4%、Qwen3-4B达44.4%平均成功率,跨多种专有教师鲁棒泛化,有效缓解风格漂移与冗长退化。
🧭 速览
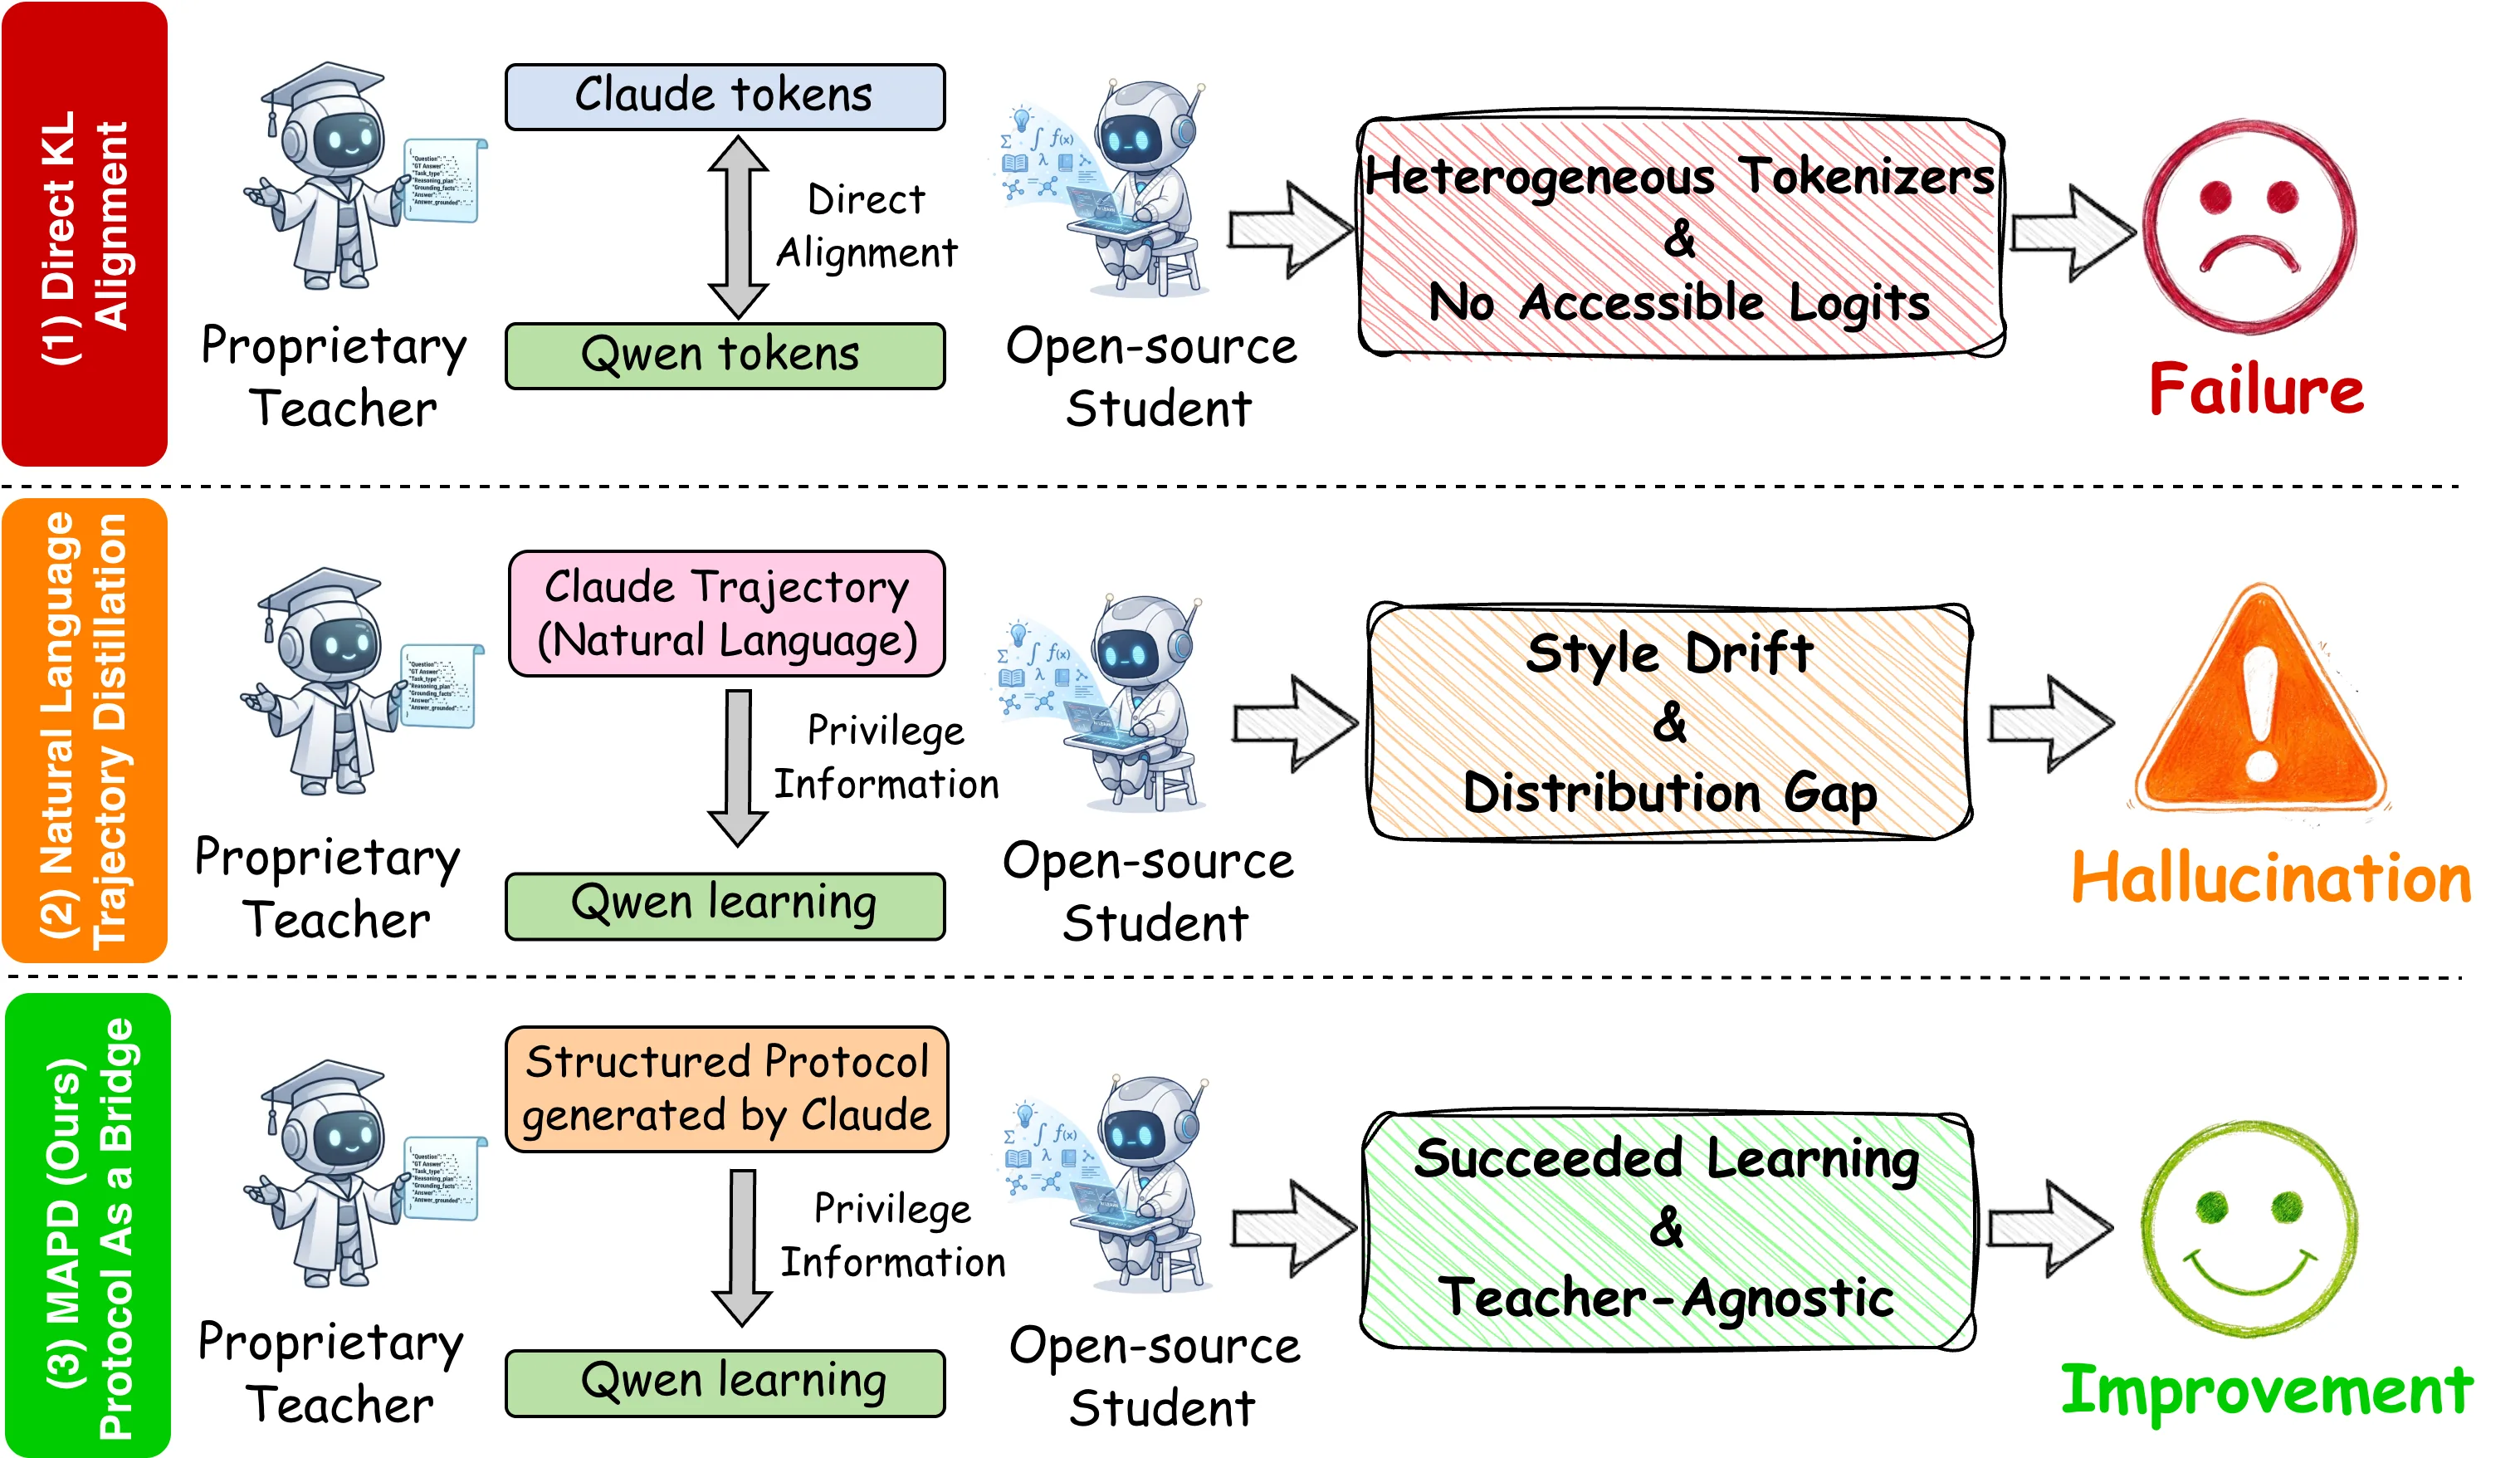
智能体搜索中RL监督稀疏,专有模型蒸馏受限于隐藏logits与风格模仿,难以传递核心推理能力。
提出MAPD框架,将离线多智能体系统的探索轨迹转为结构化JSON协议,作为学生策略特权分支的密集蒸馏信号。
在7个QA基准上平均成功率达39.4%(Qwen3-1.7B)和44.4%(Qwen3-4B),优于多种蒸馏与RL基线。
MAPD跨多种专有教师鲁棒泛化,有效缓解风格漂移与冗长退化,为异构蒸馏提供结构化协议新路径。
🆚 方法对比
MAPD (Multi-Agent Protocol Distillation)
- 在Qwen3-1.7B和4B上分别达39.4%和44.4%成功率
- 对多种专有教师模型泛化稳健
- 有效缓解风格漂移和冗长退化
- 在7个QA基准上优于竞争蒸馏与RL方法
- 依赖离线多智能体系统生成协议,增加复杂度
- 需依赖专有教师模型提供监督信号
Outcome-based Reinforcement Learning
- 提供最终结果的奖励信号
- 可直接优化任务成功率
- 监督信号稀疏,难以指导多步推理
- 难以有效对齐中间推理过程
Logit-matching Distillation
- 传统蒸馏方法,理论成熟
- 专有模型隐藏logits,无法直接匹配
- 分词器不匹配阻碍直接对齐
Natural Language Trajectory Imitation
- 不依赖隐藏logits,实现简单
- 可直接从专有模型获取轨迹数据
- 仅传递表层风格伪影而非核心推理能力
- 易导致风格漂移和冗长退化
Offline Multi-Agent System (MAS)
- 分解查询、检索证据、修复失败搜索
- 将探索轨迹转为结构化JSON协议
- 生成任务类型、推理计划和抽取事实
- 多智能体协作带来额外计算开销
- 协议质量受MAS组件能力限制
Privileged Branch Student Policy
- 提供稠密蒸馏信号补充稀疏RL目标
- 利用协议中间表示对齐教师分布
- 策略架构更复杂,训练开销增加
- 特权分支在推理时需移除,存在不一致
MAPD通过结构化JSON协议作为中间表示,联合蒸馏与RL,在稀疏结果监督和稠密过程监督之间取得平衡,相比纯RL更有效,相比传统logit匹配和轨迹模仿更稳健地桥接分布差距。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 29 张)
展开查看 29 张图


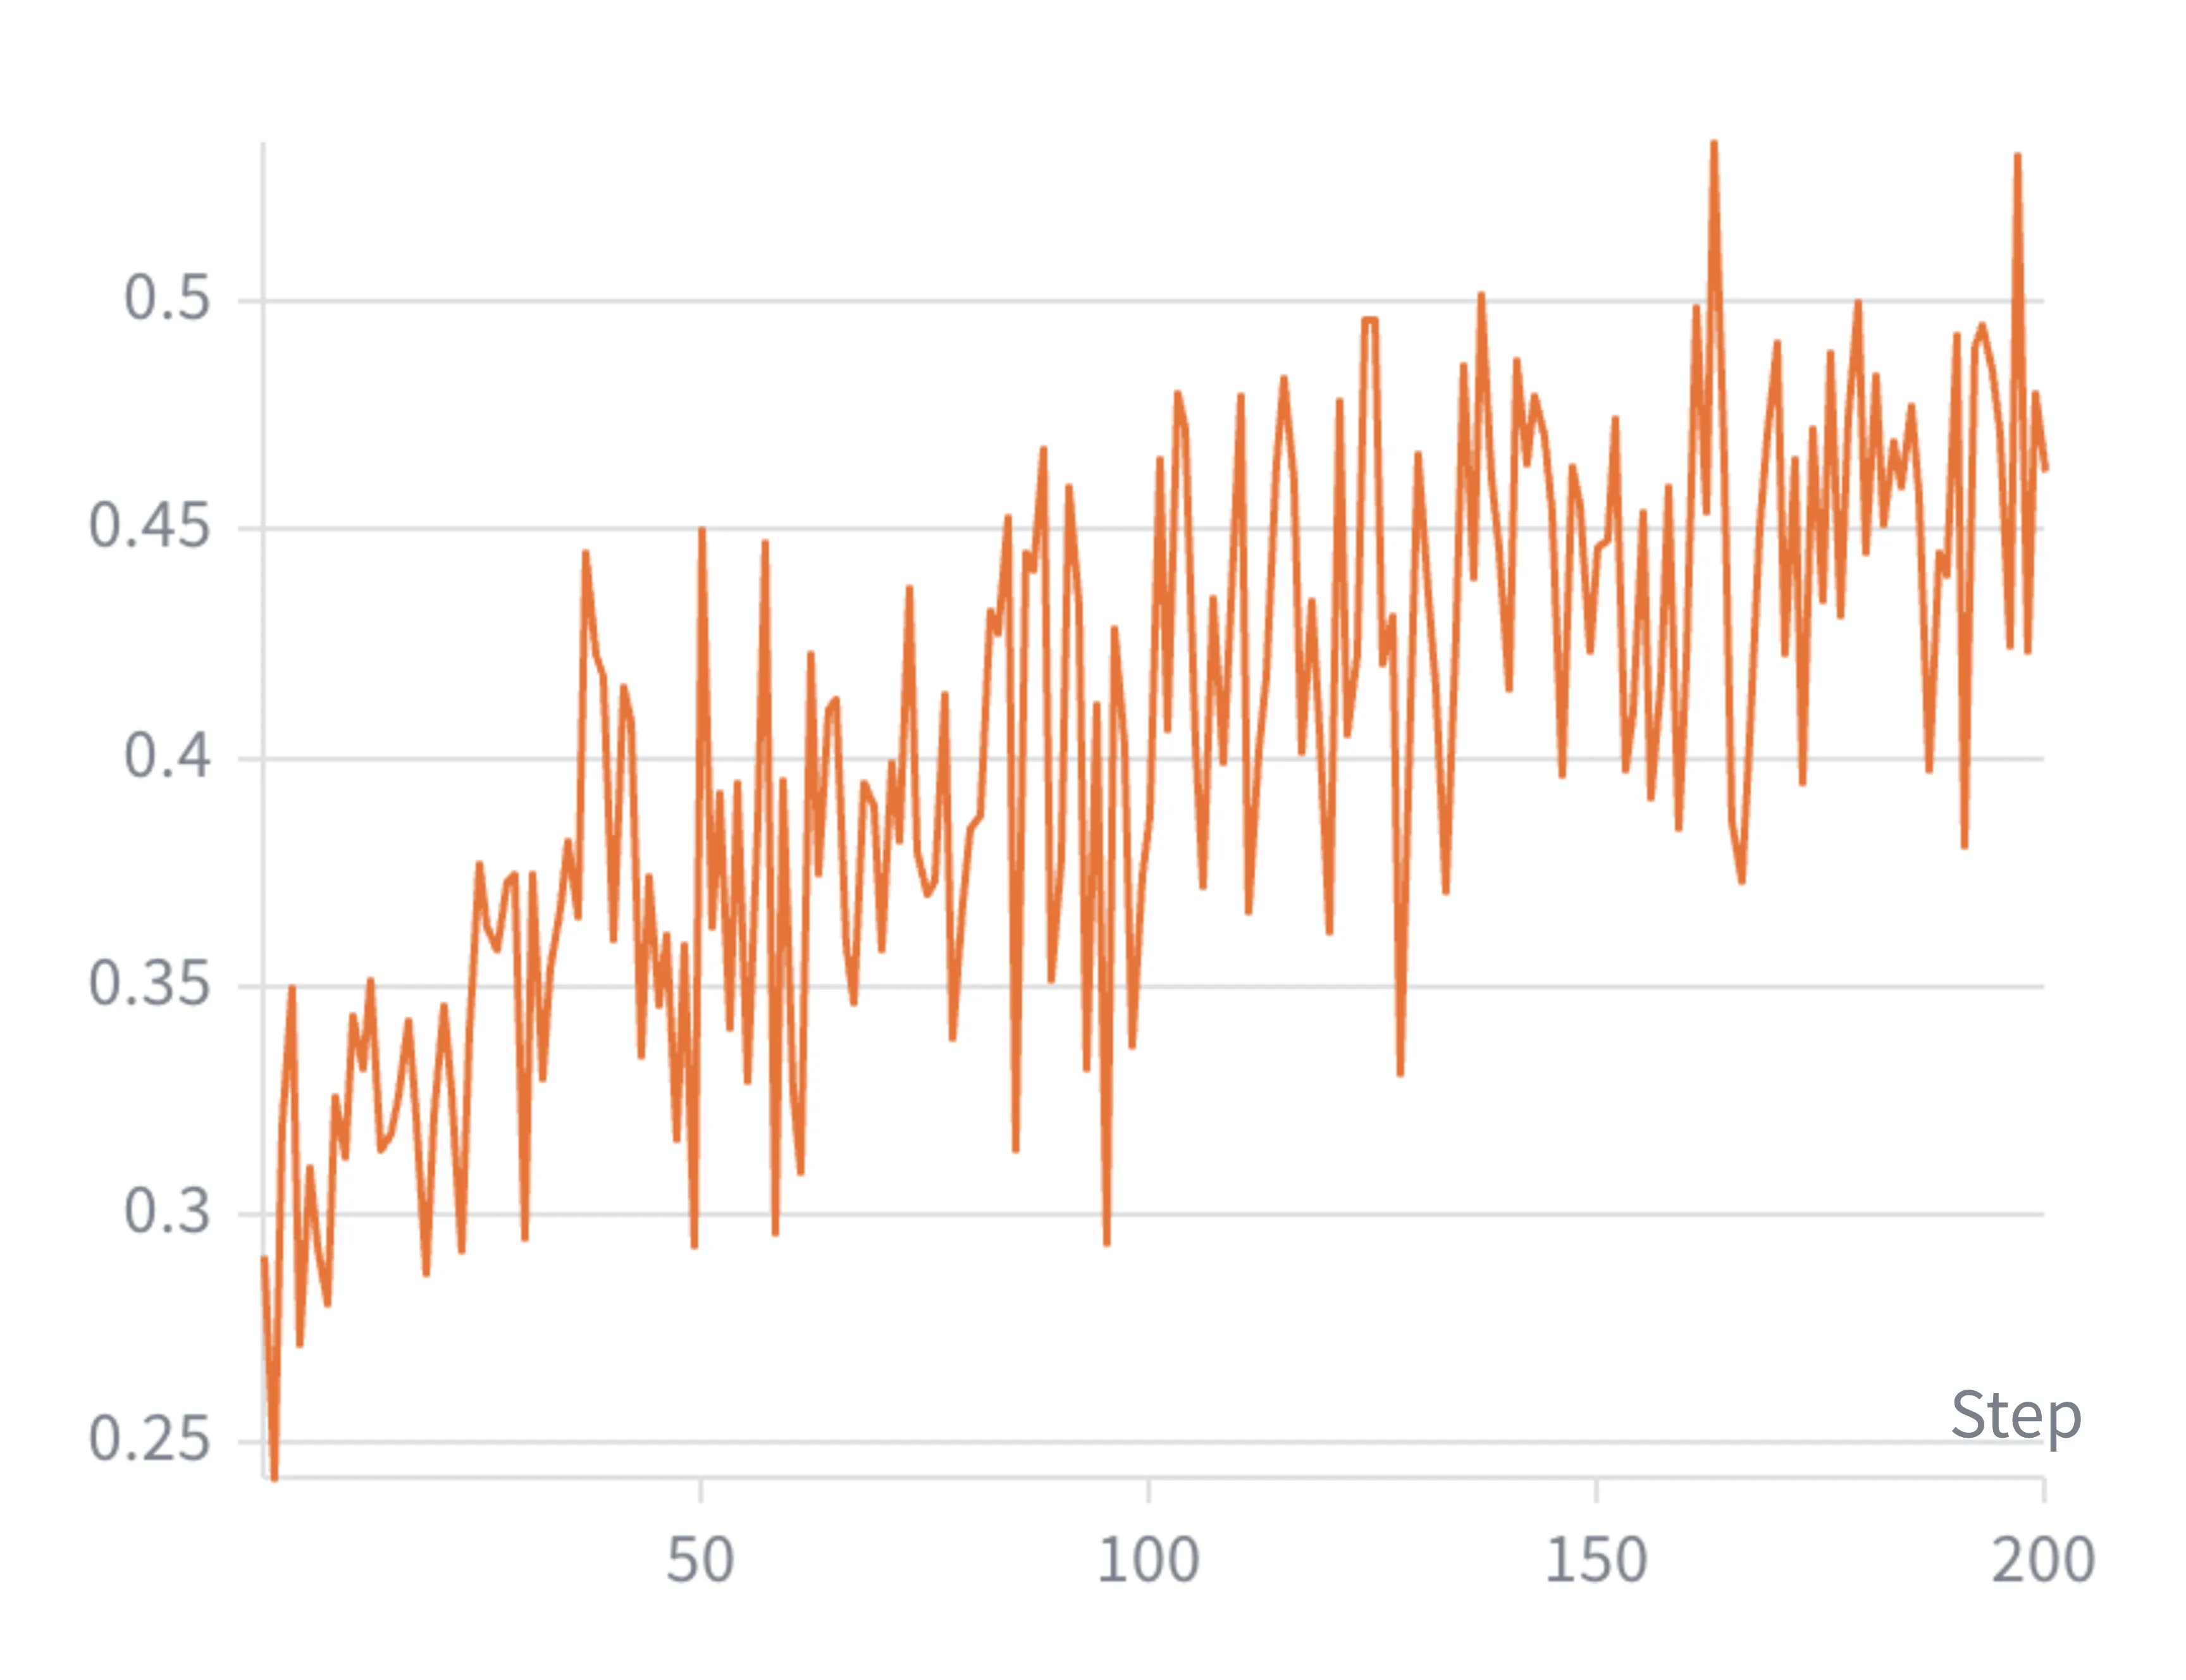
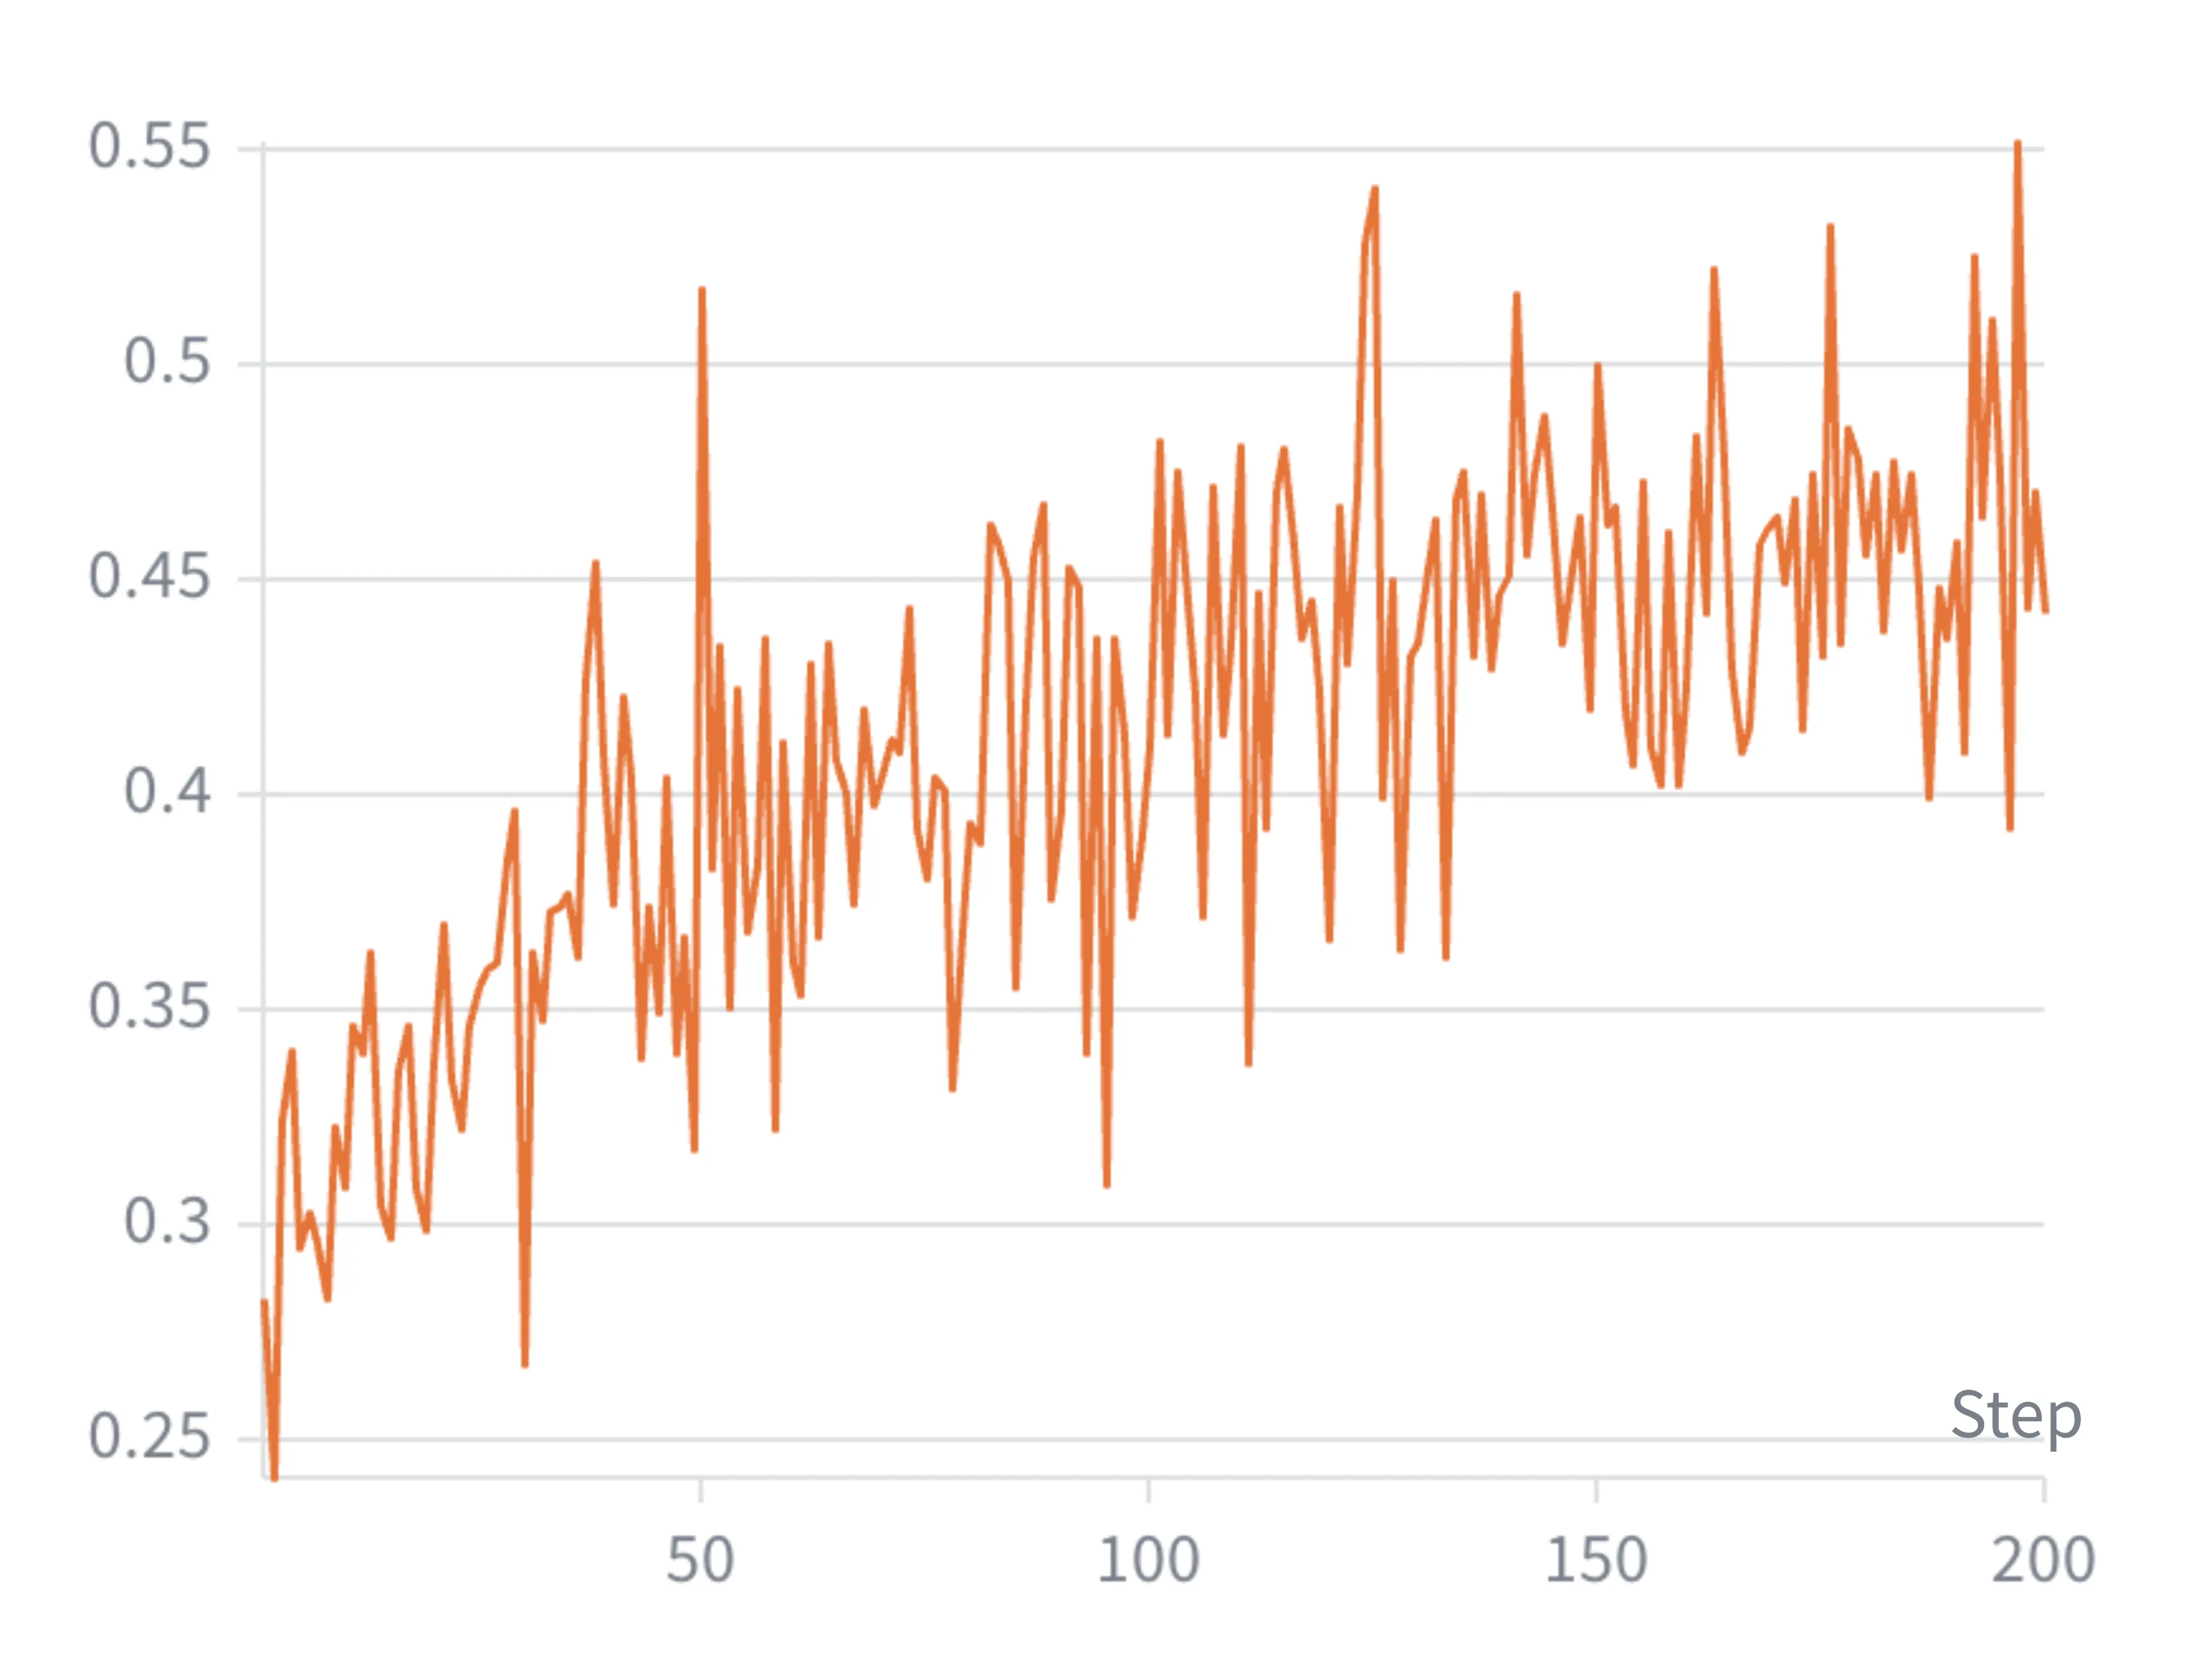
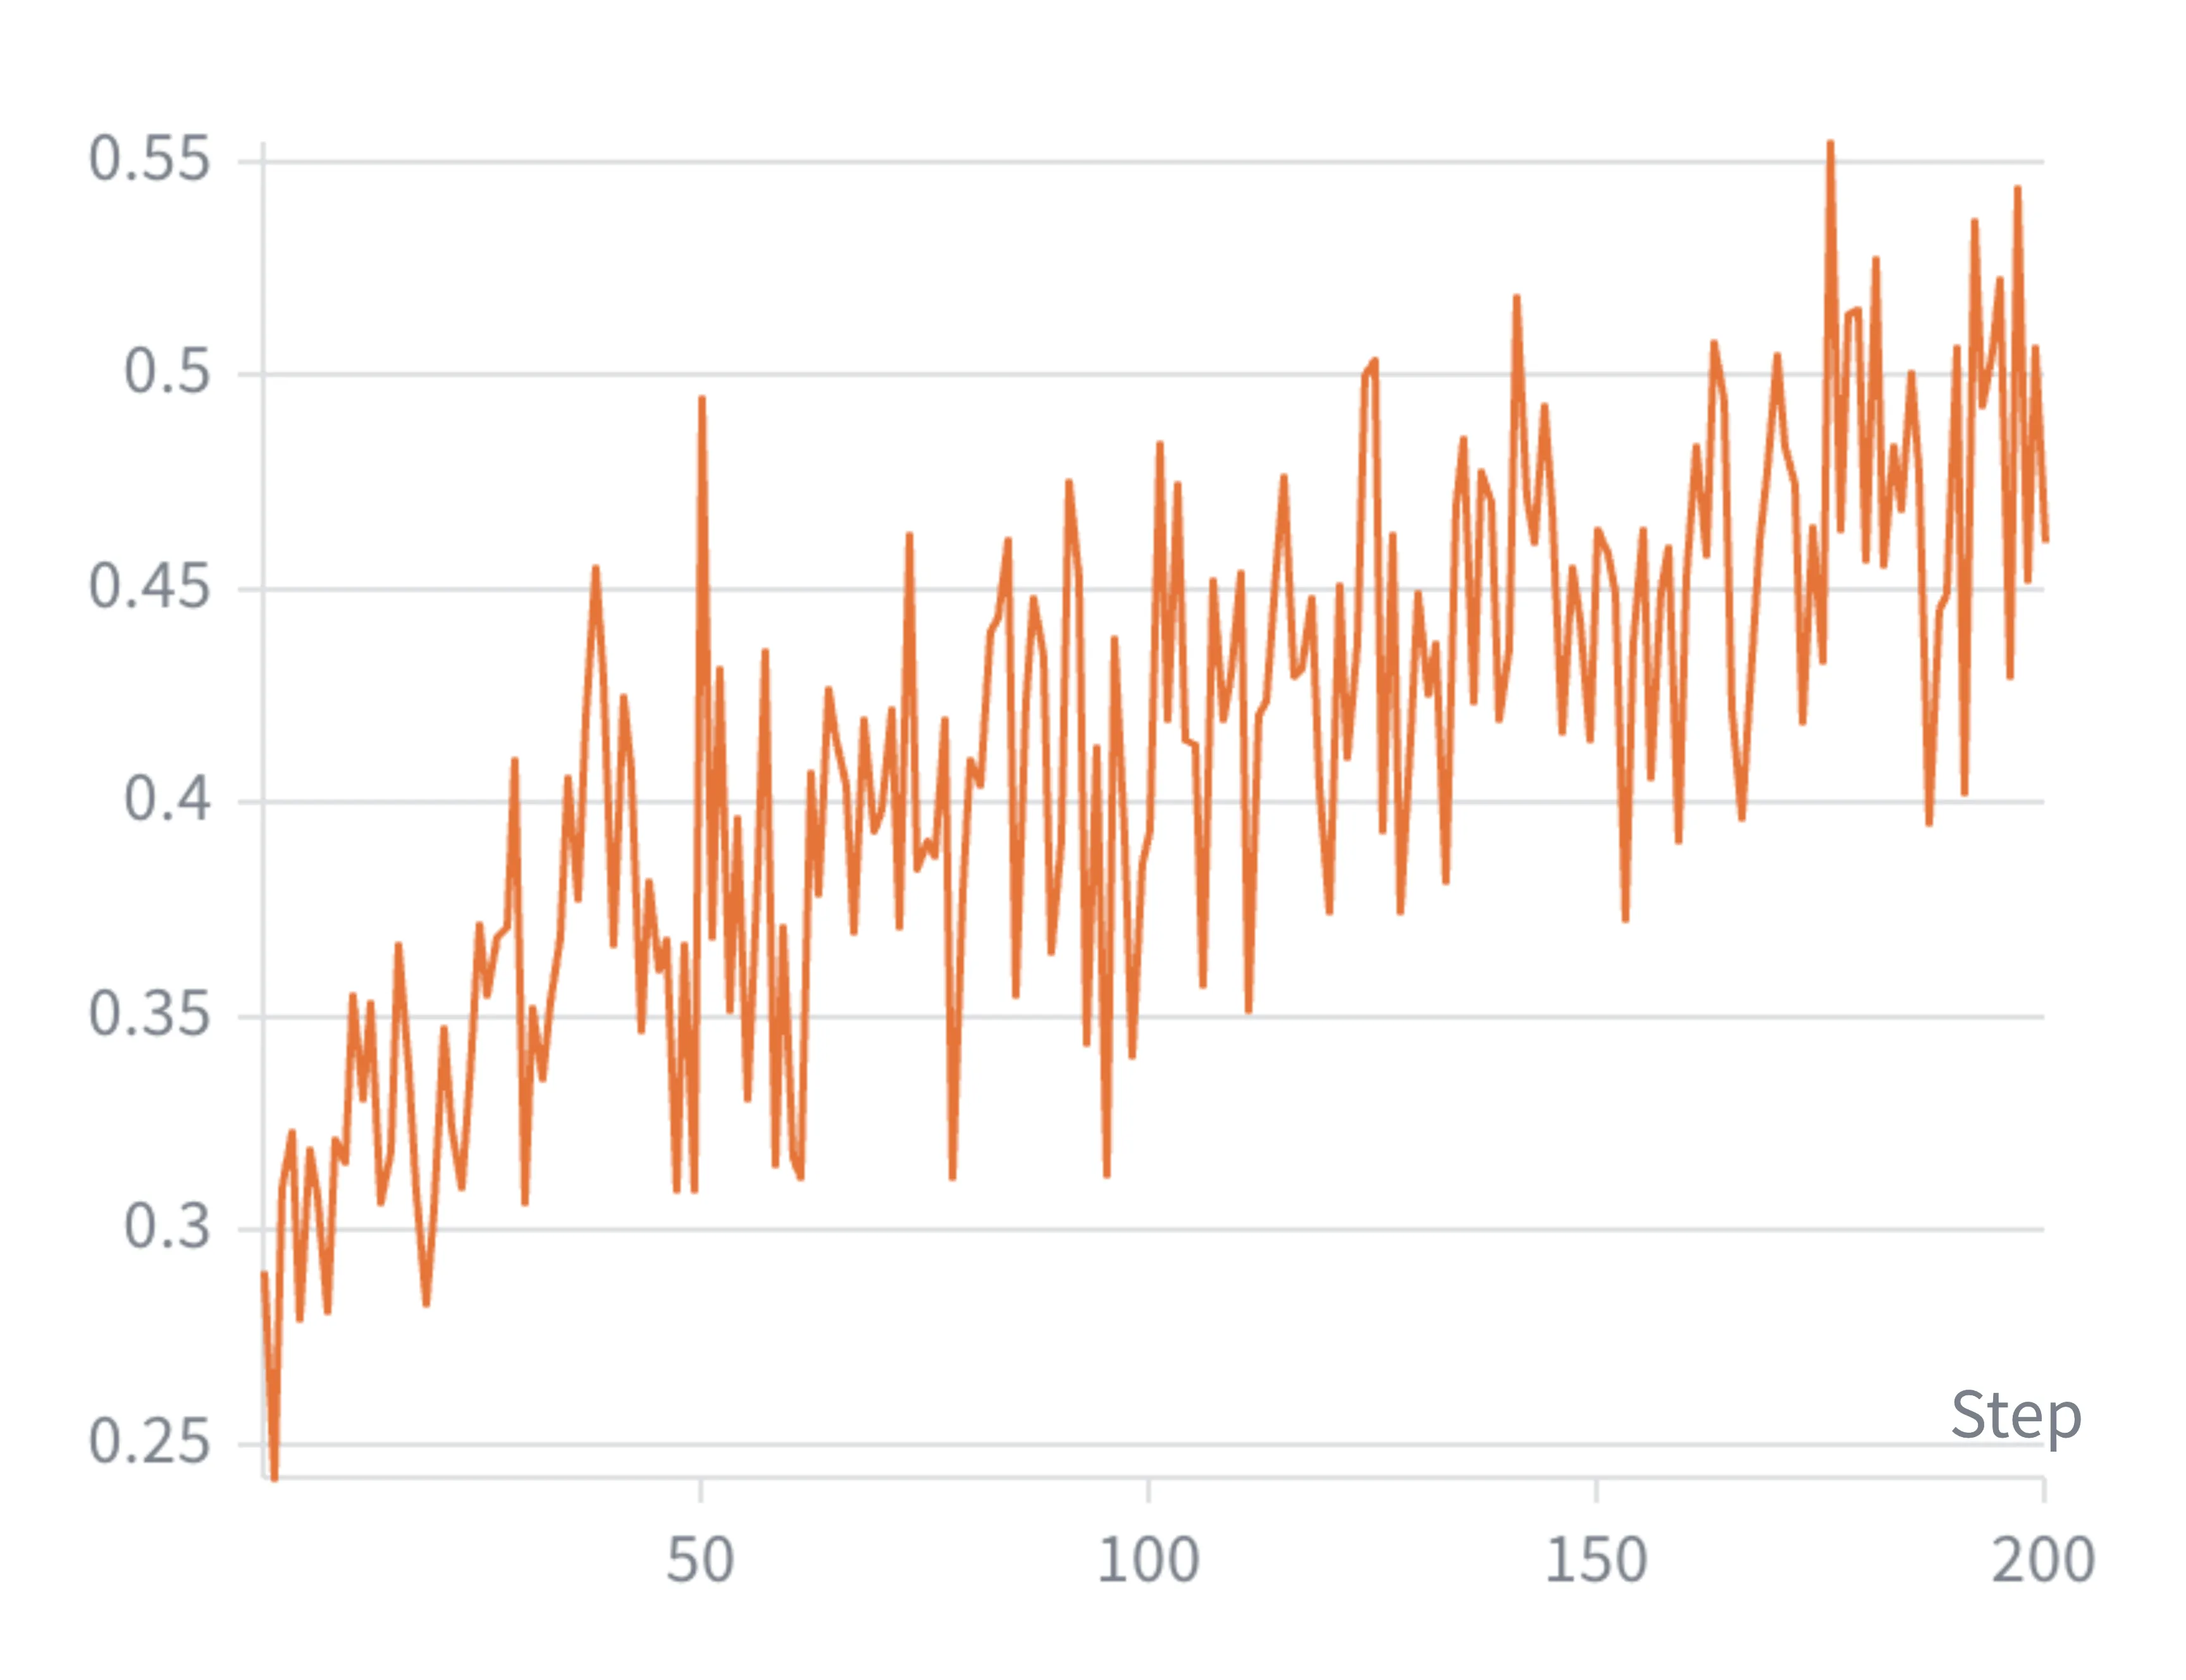
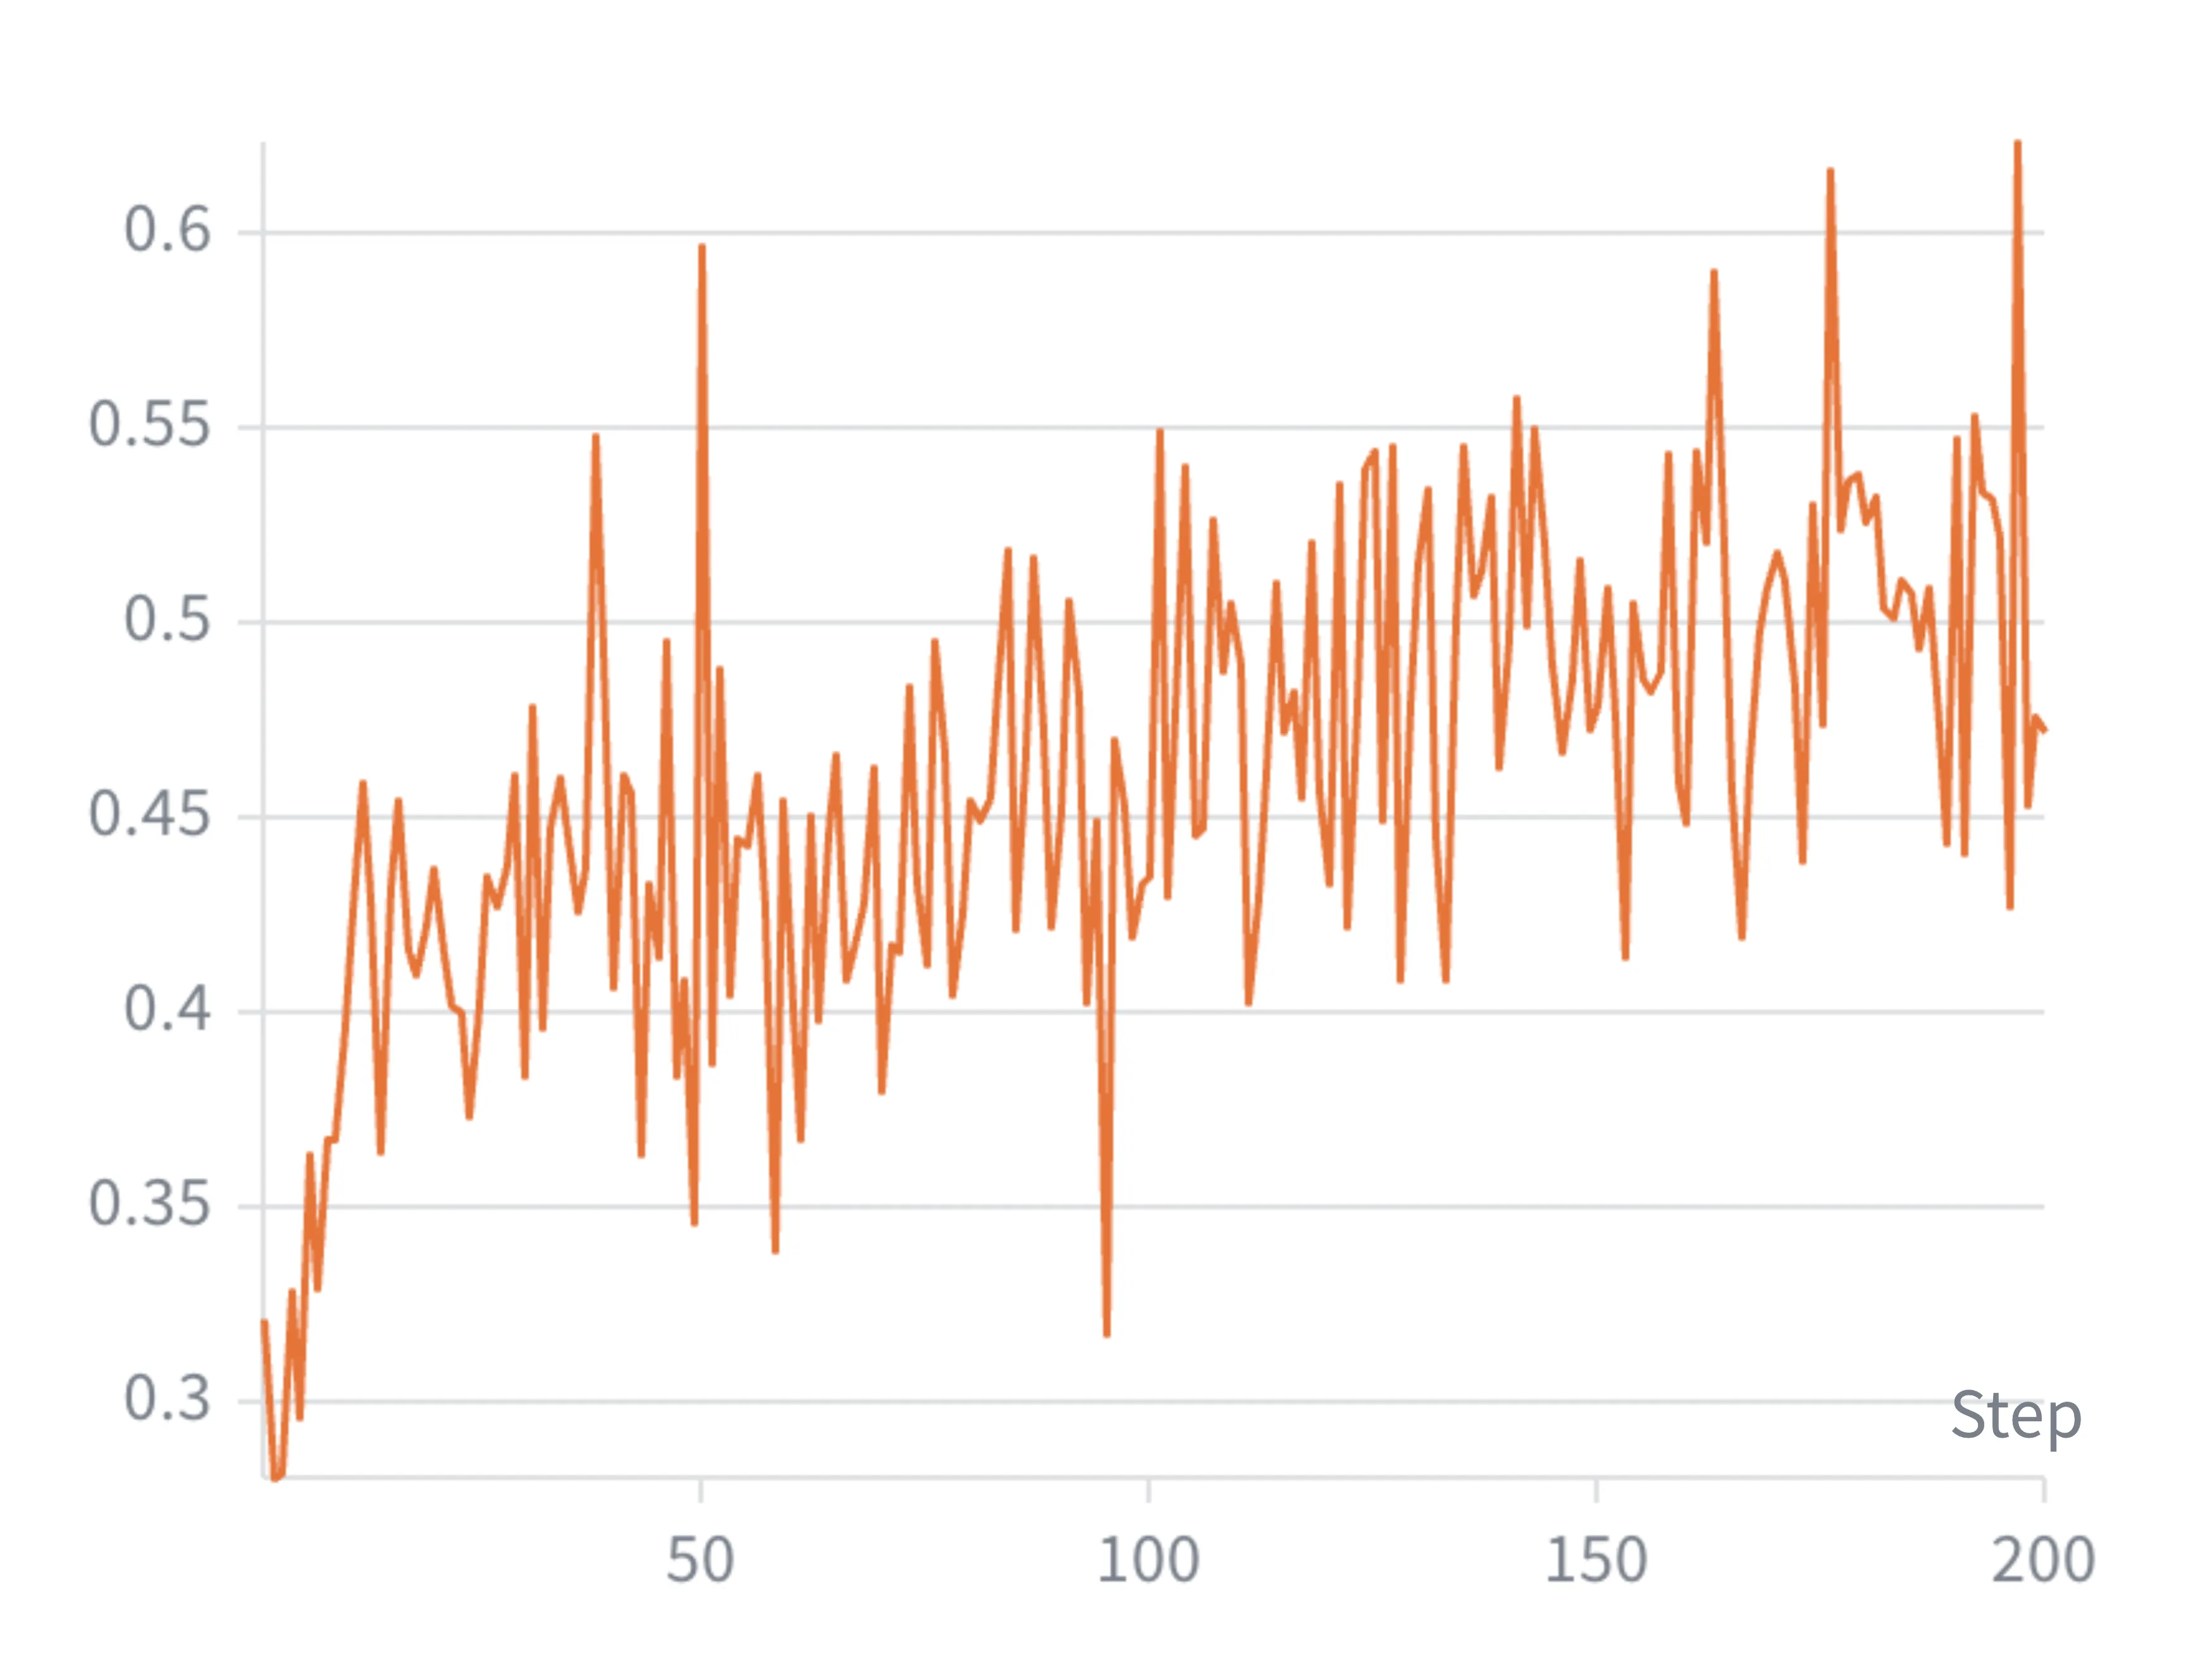
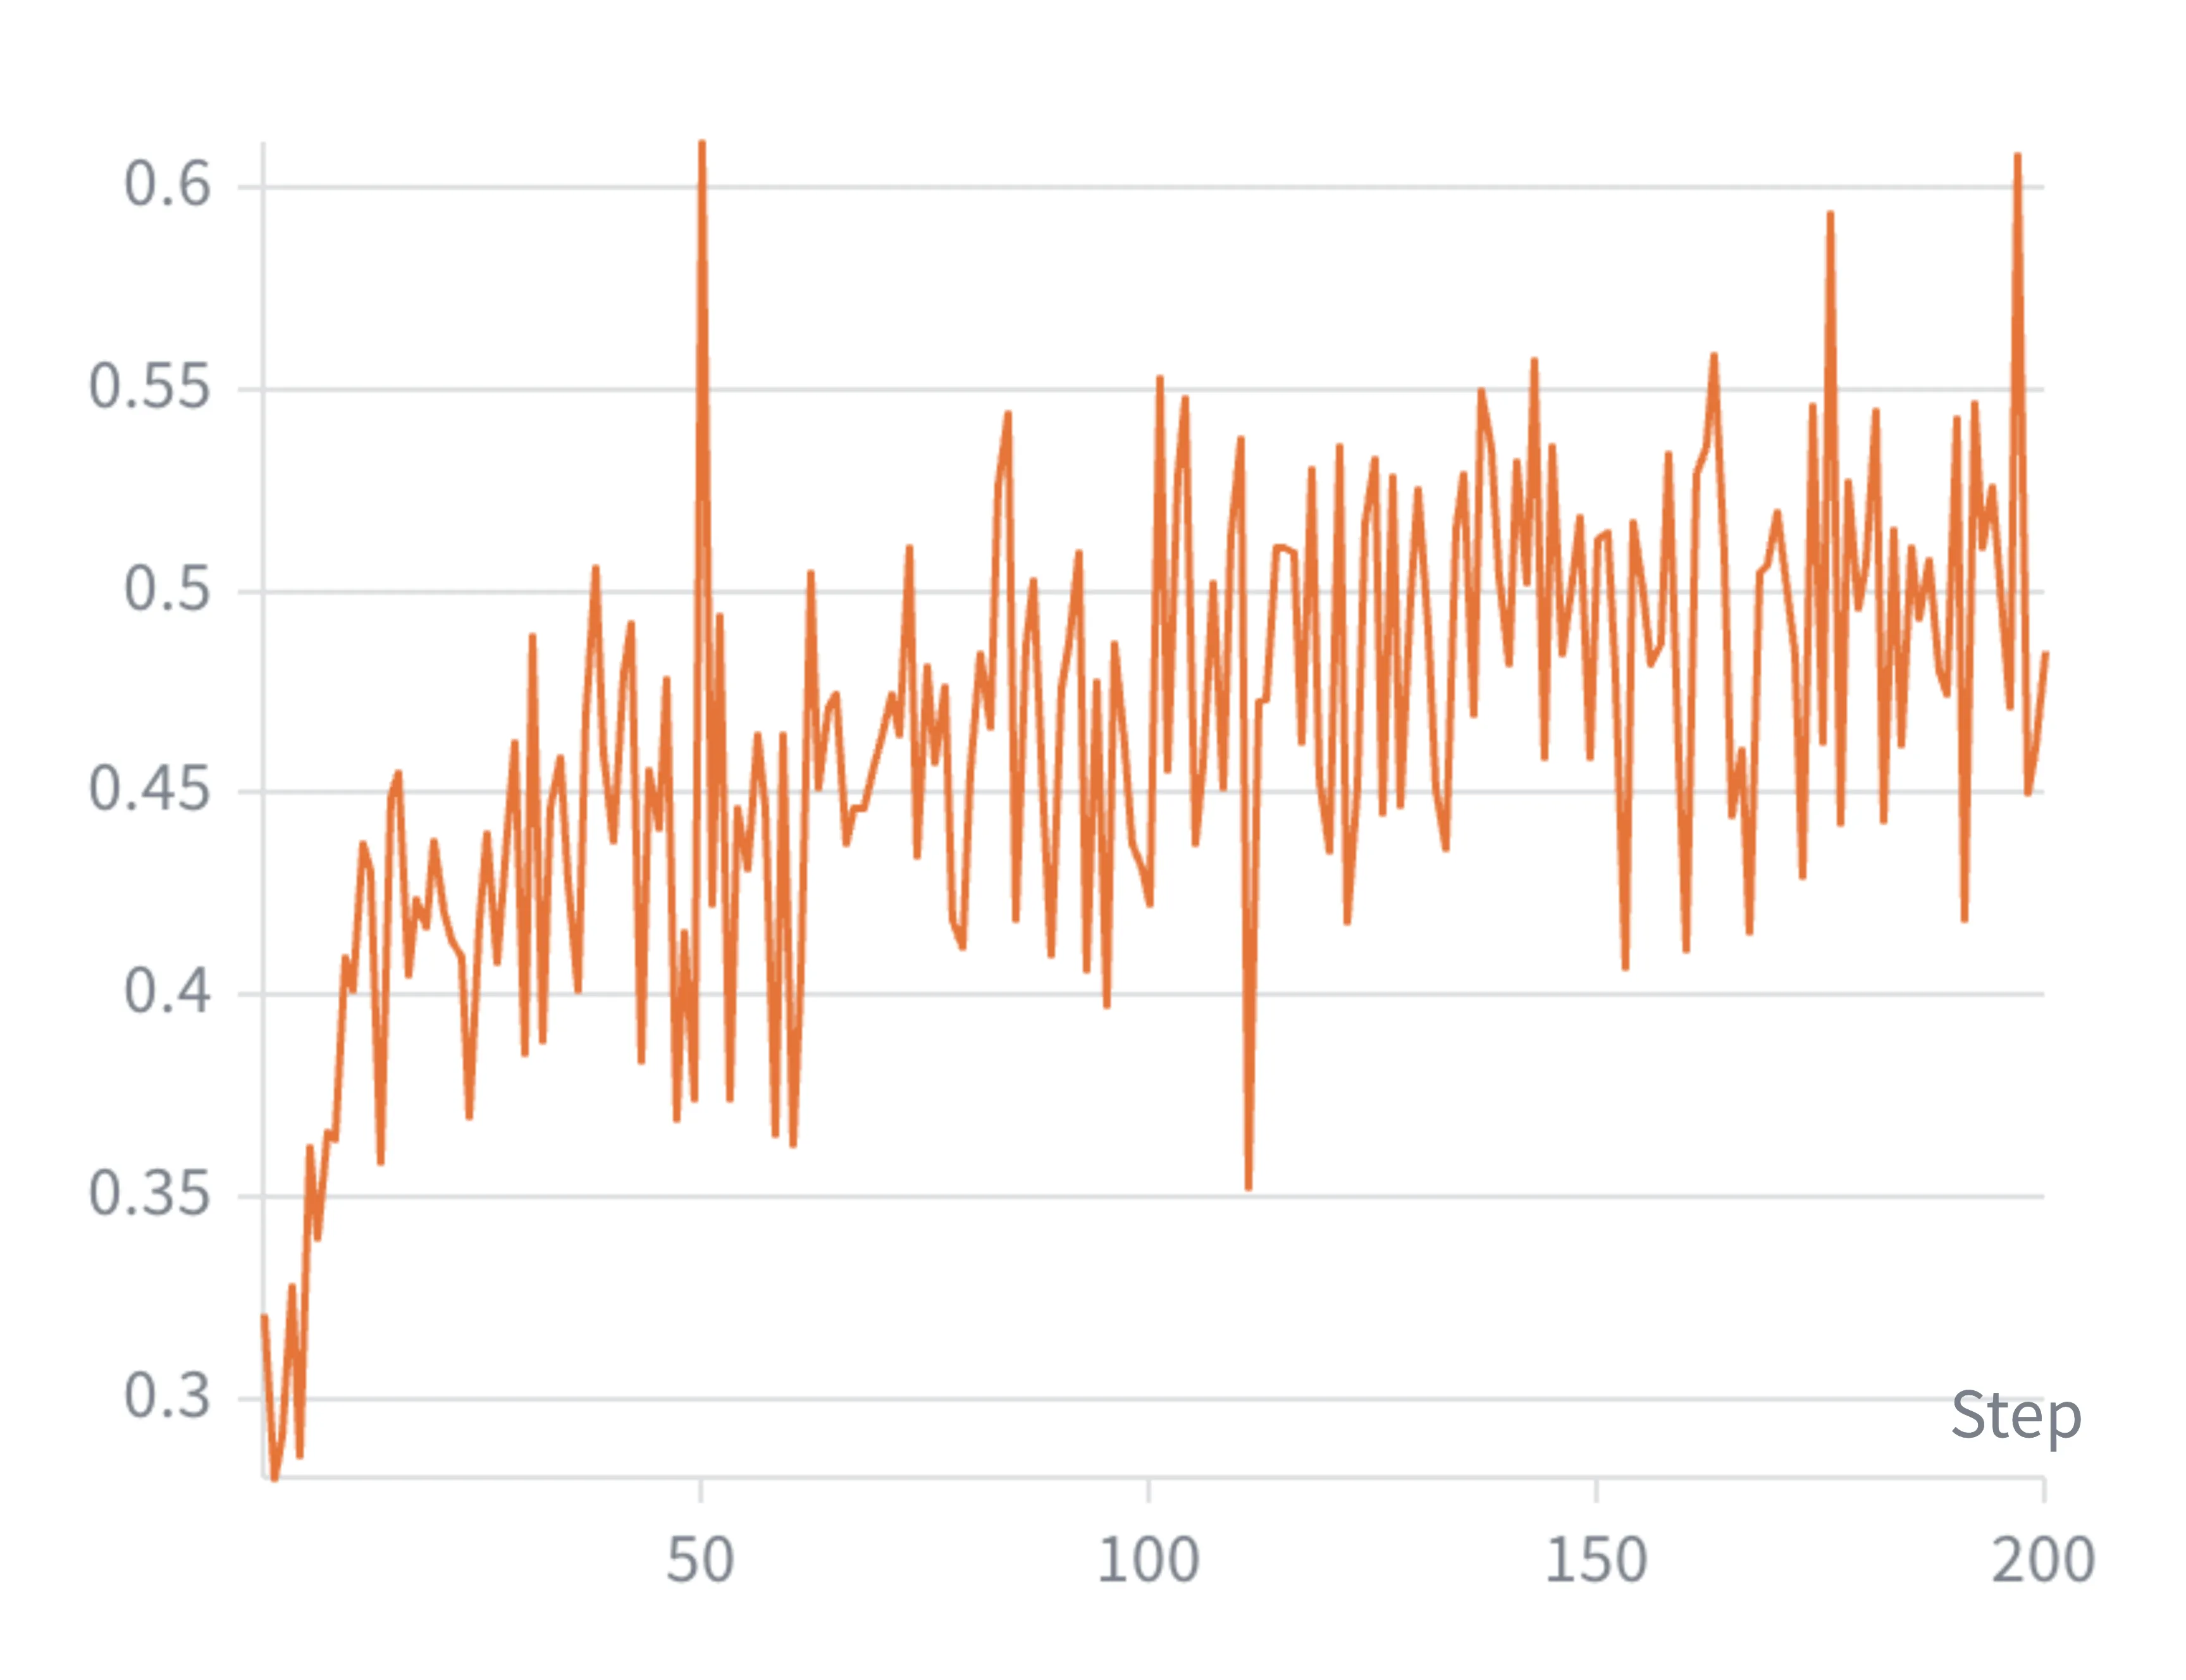
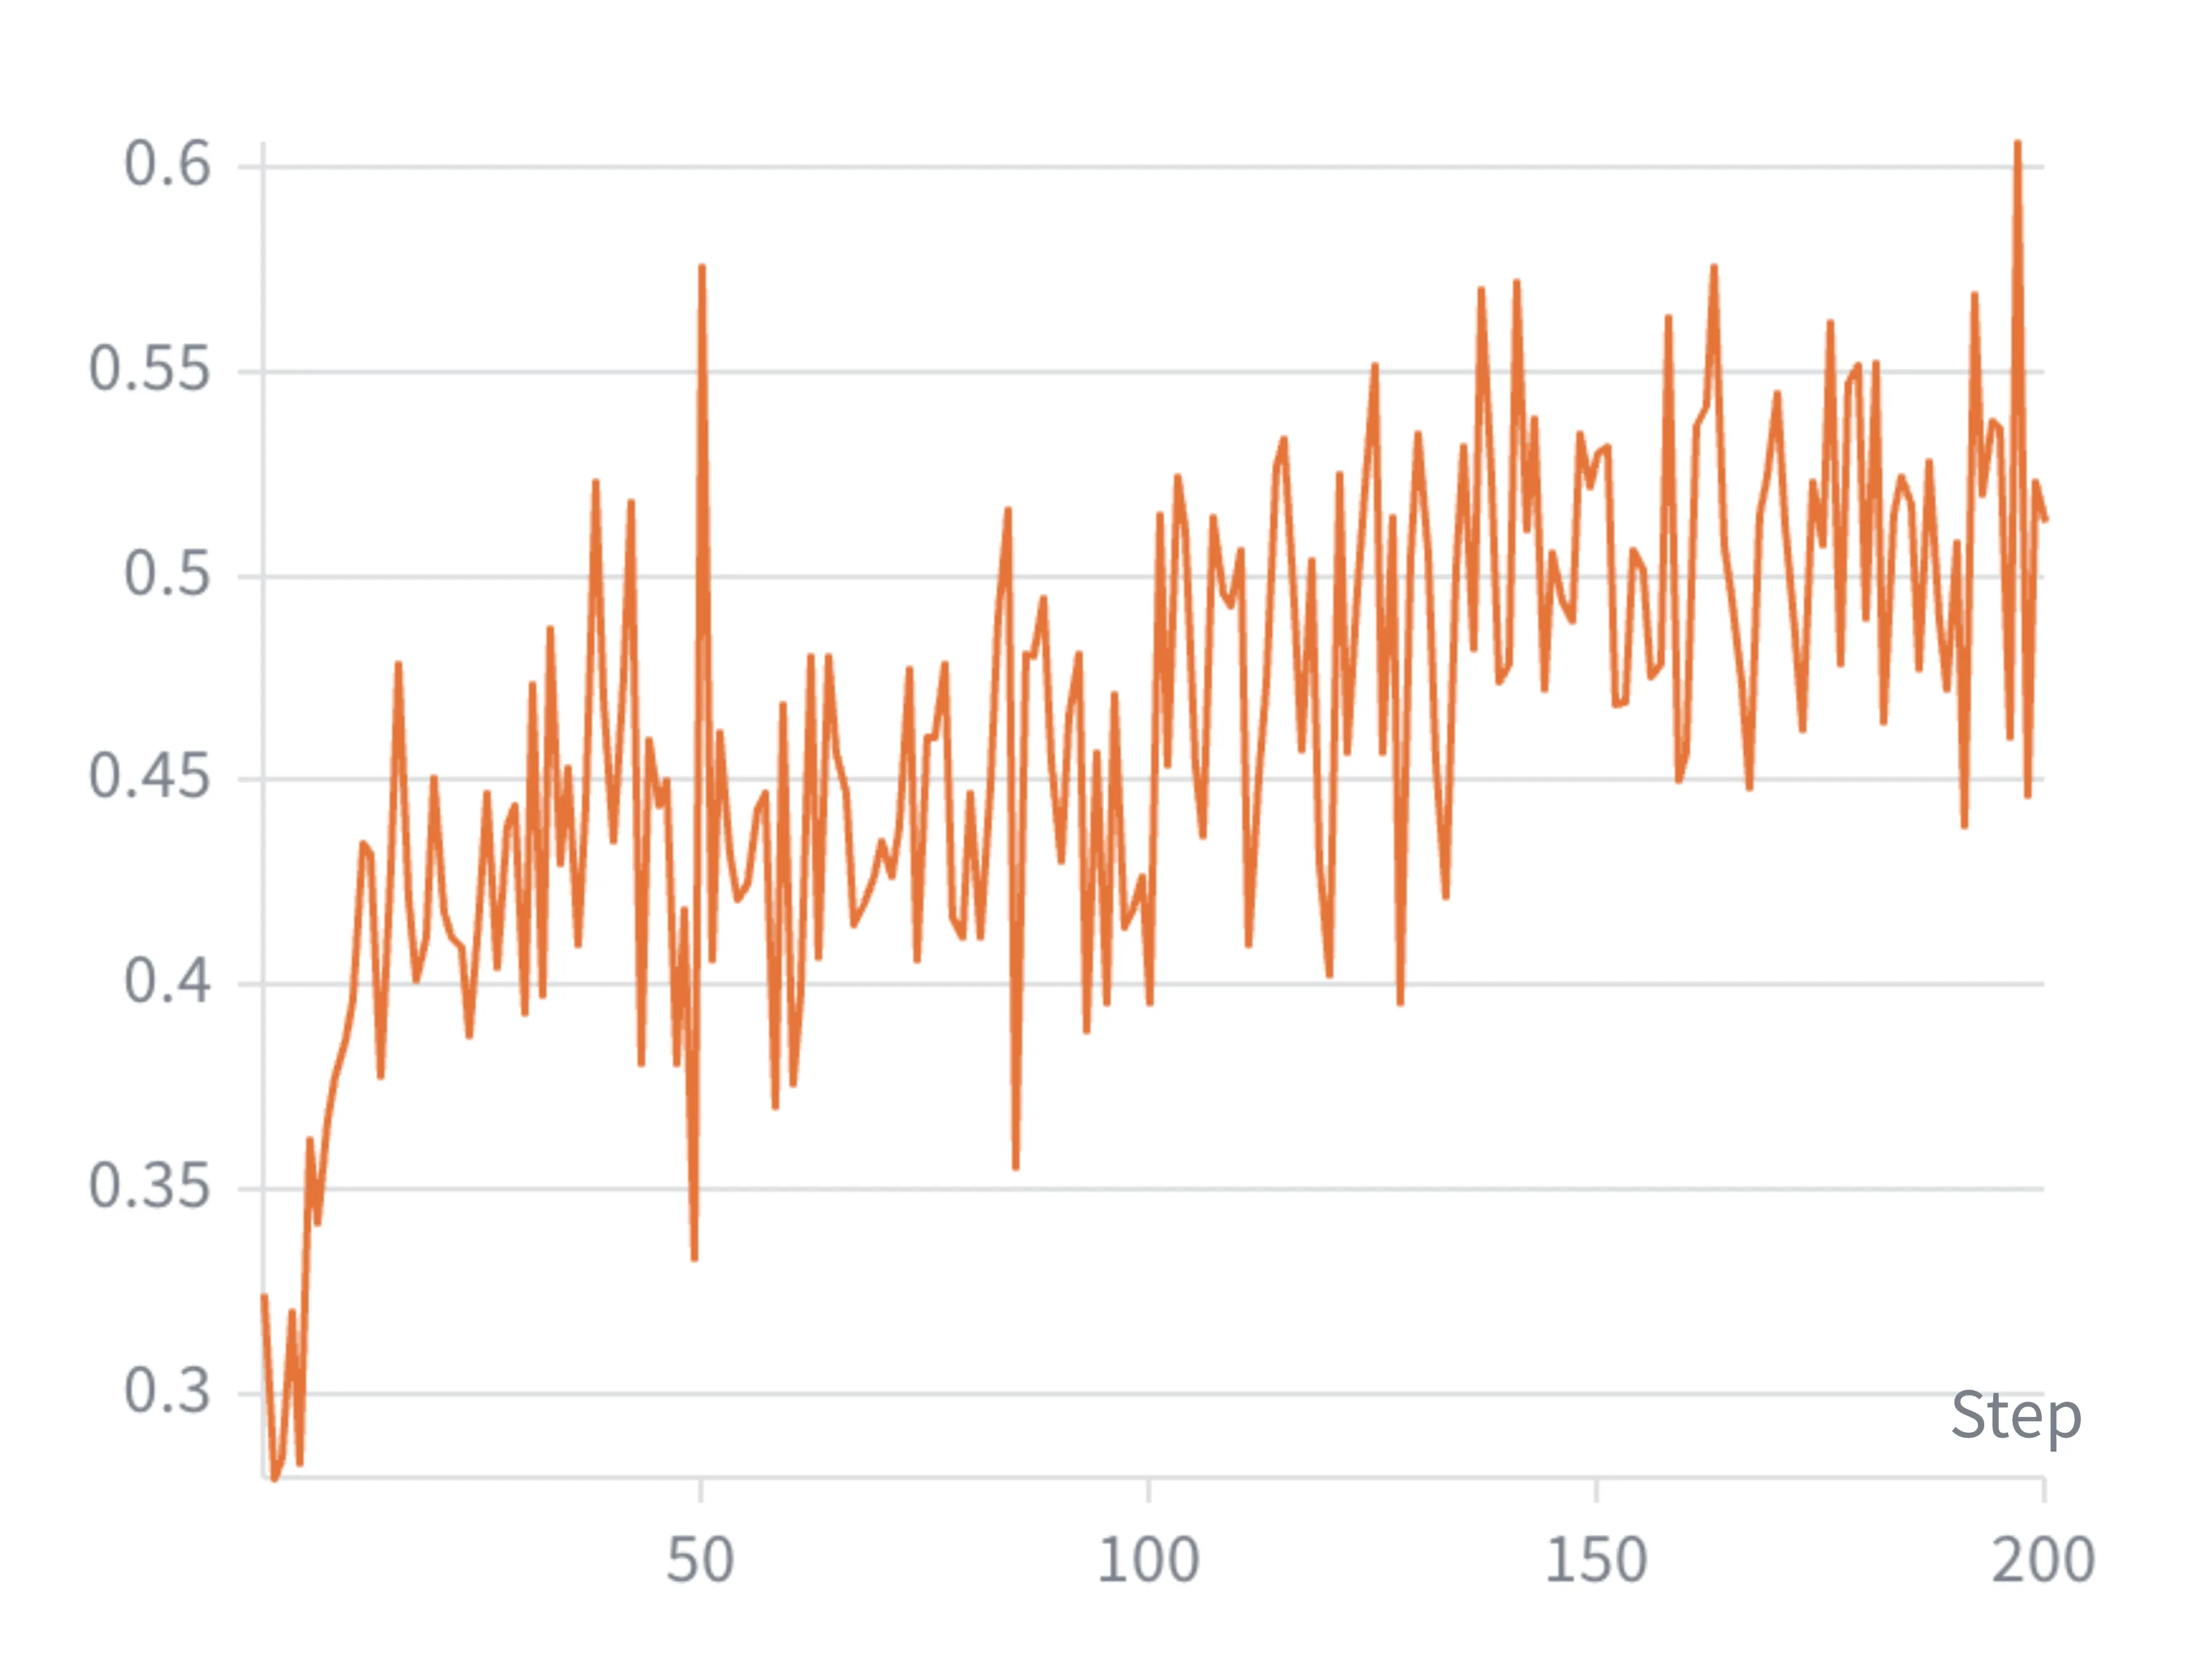
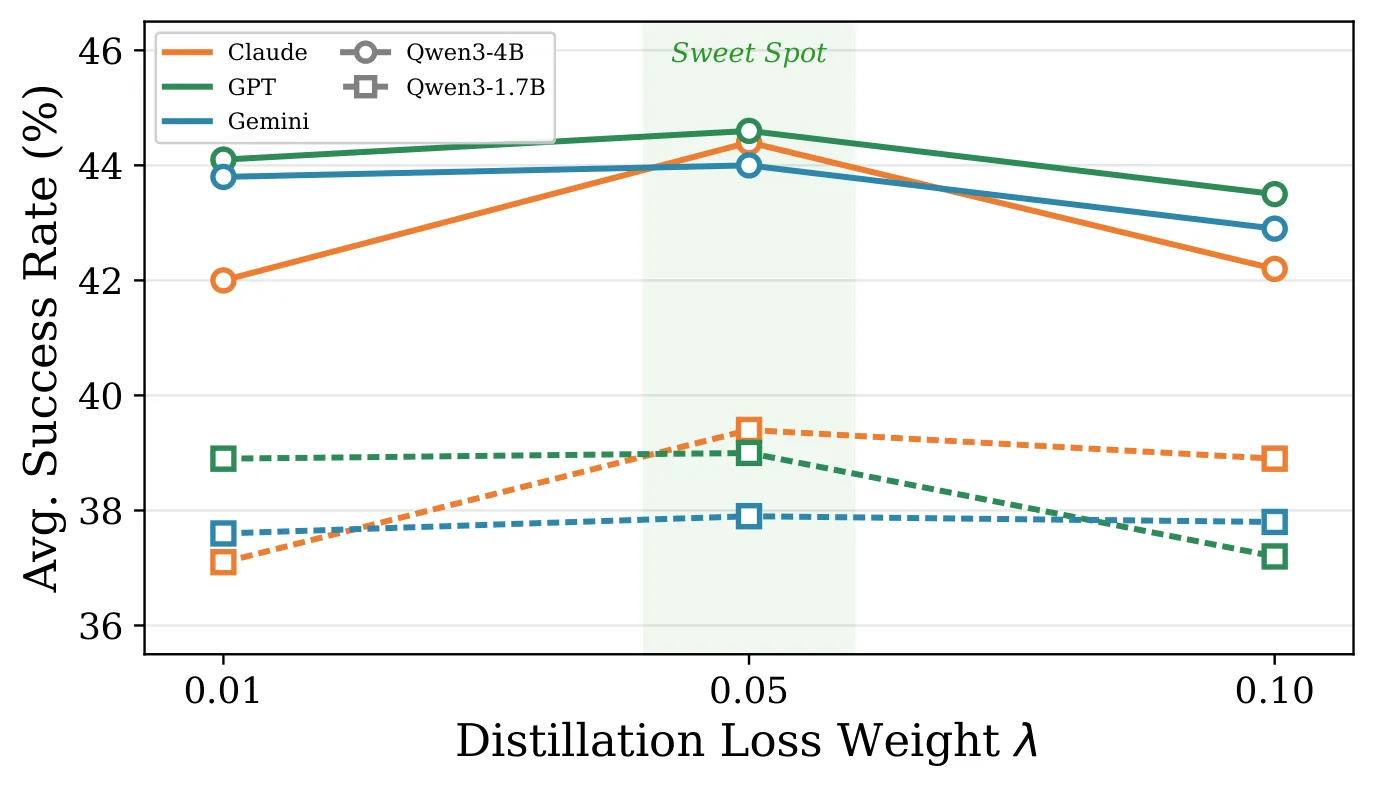
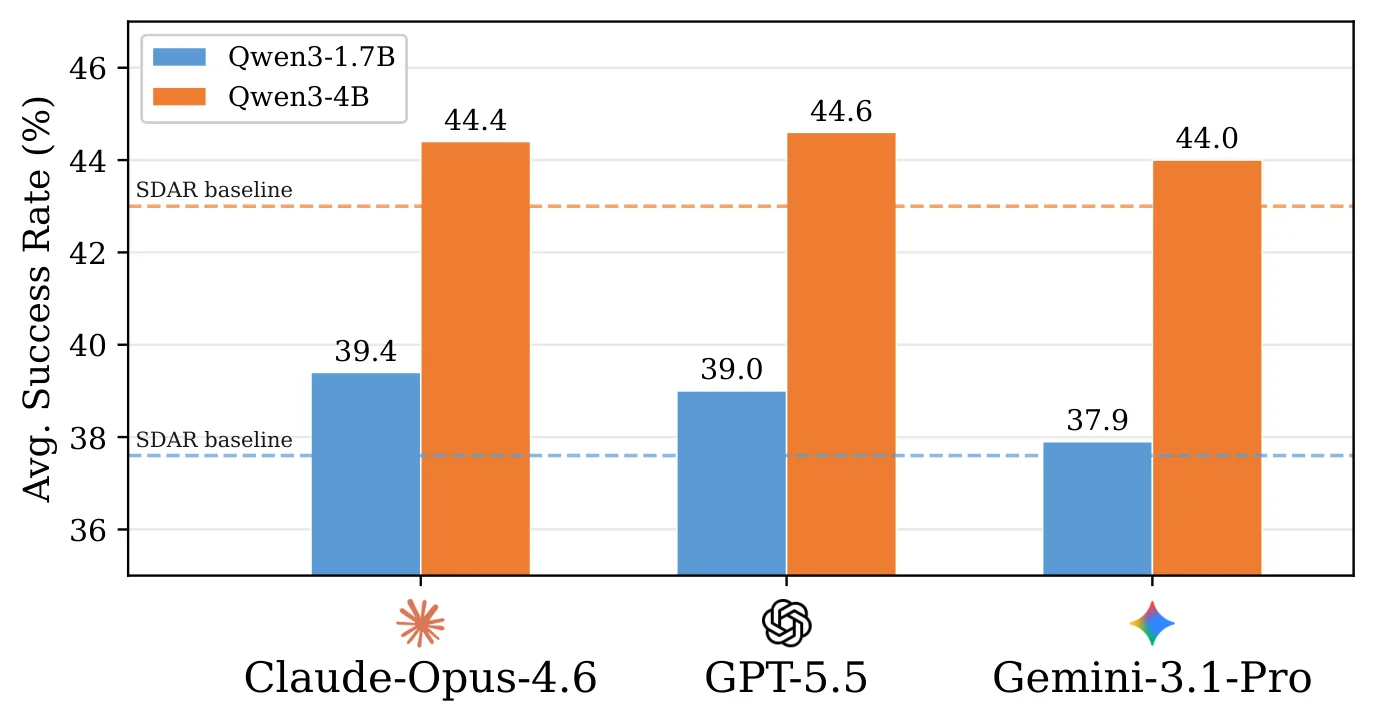
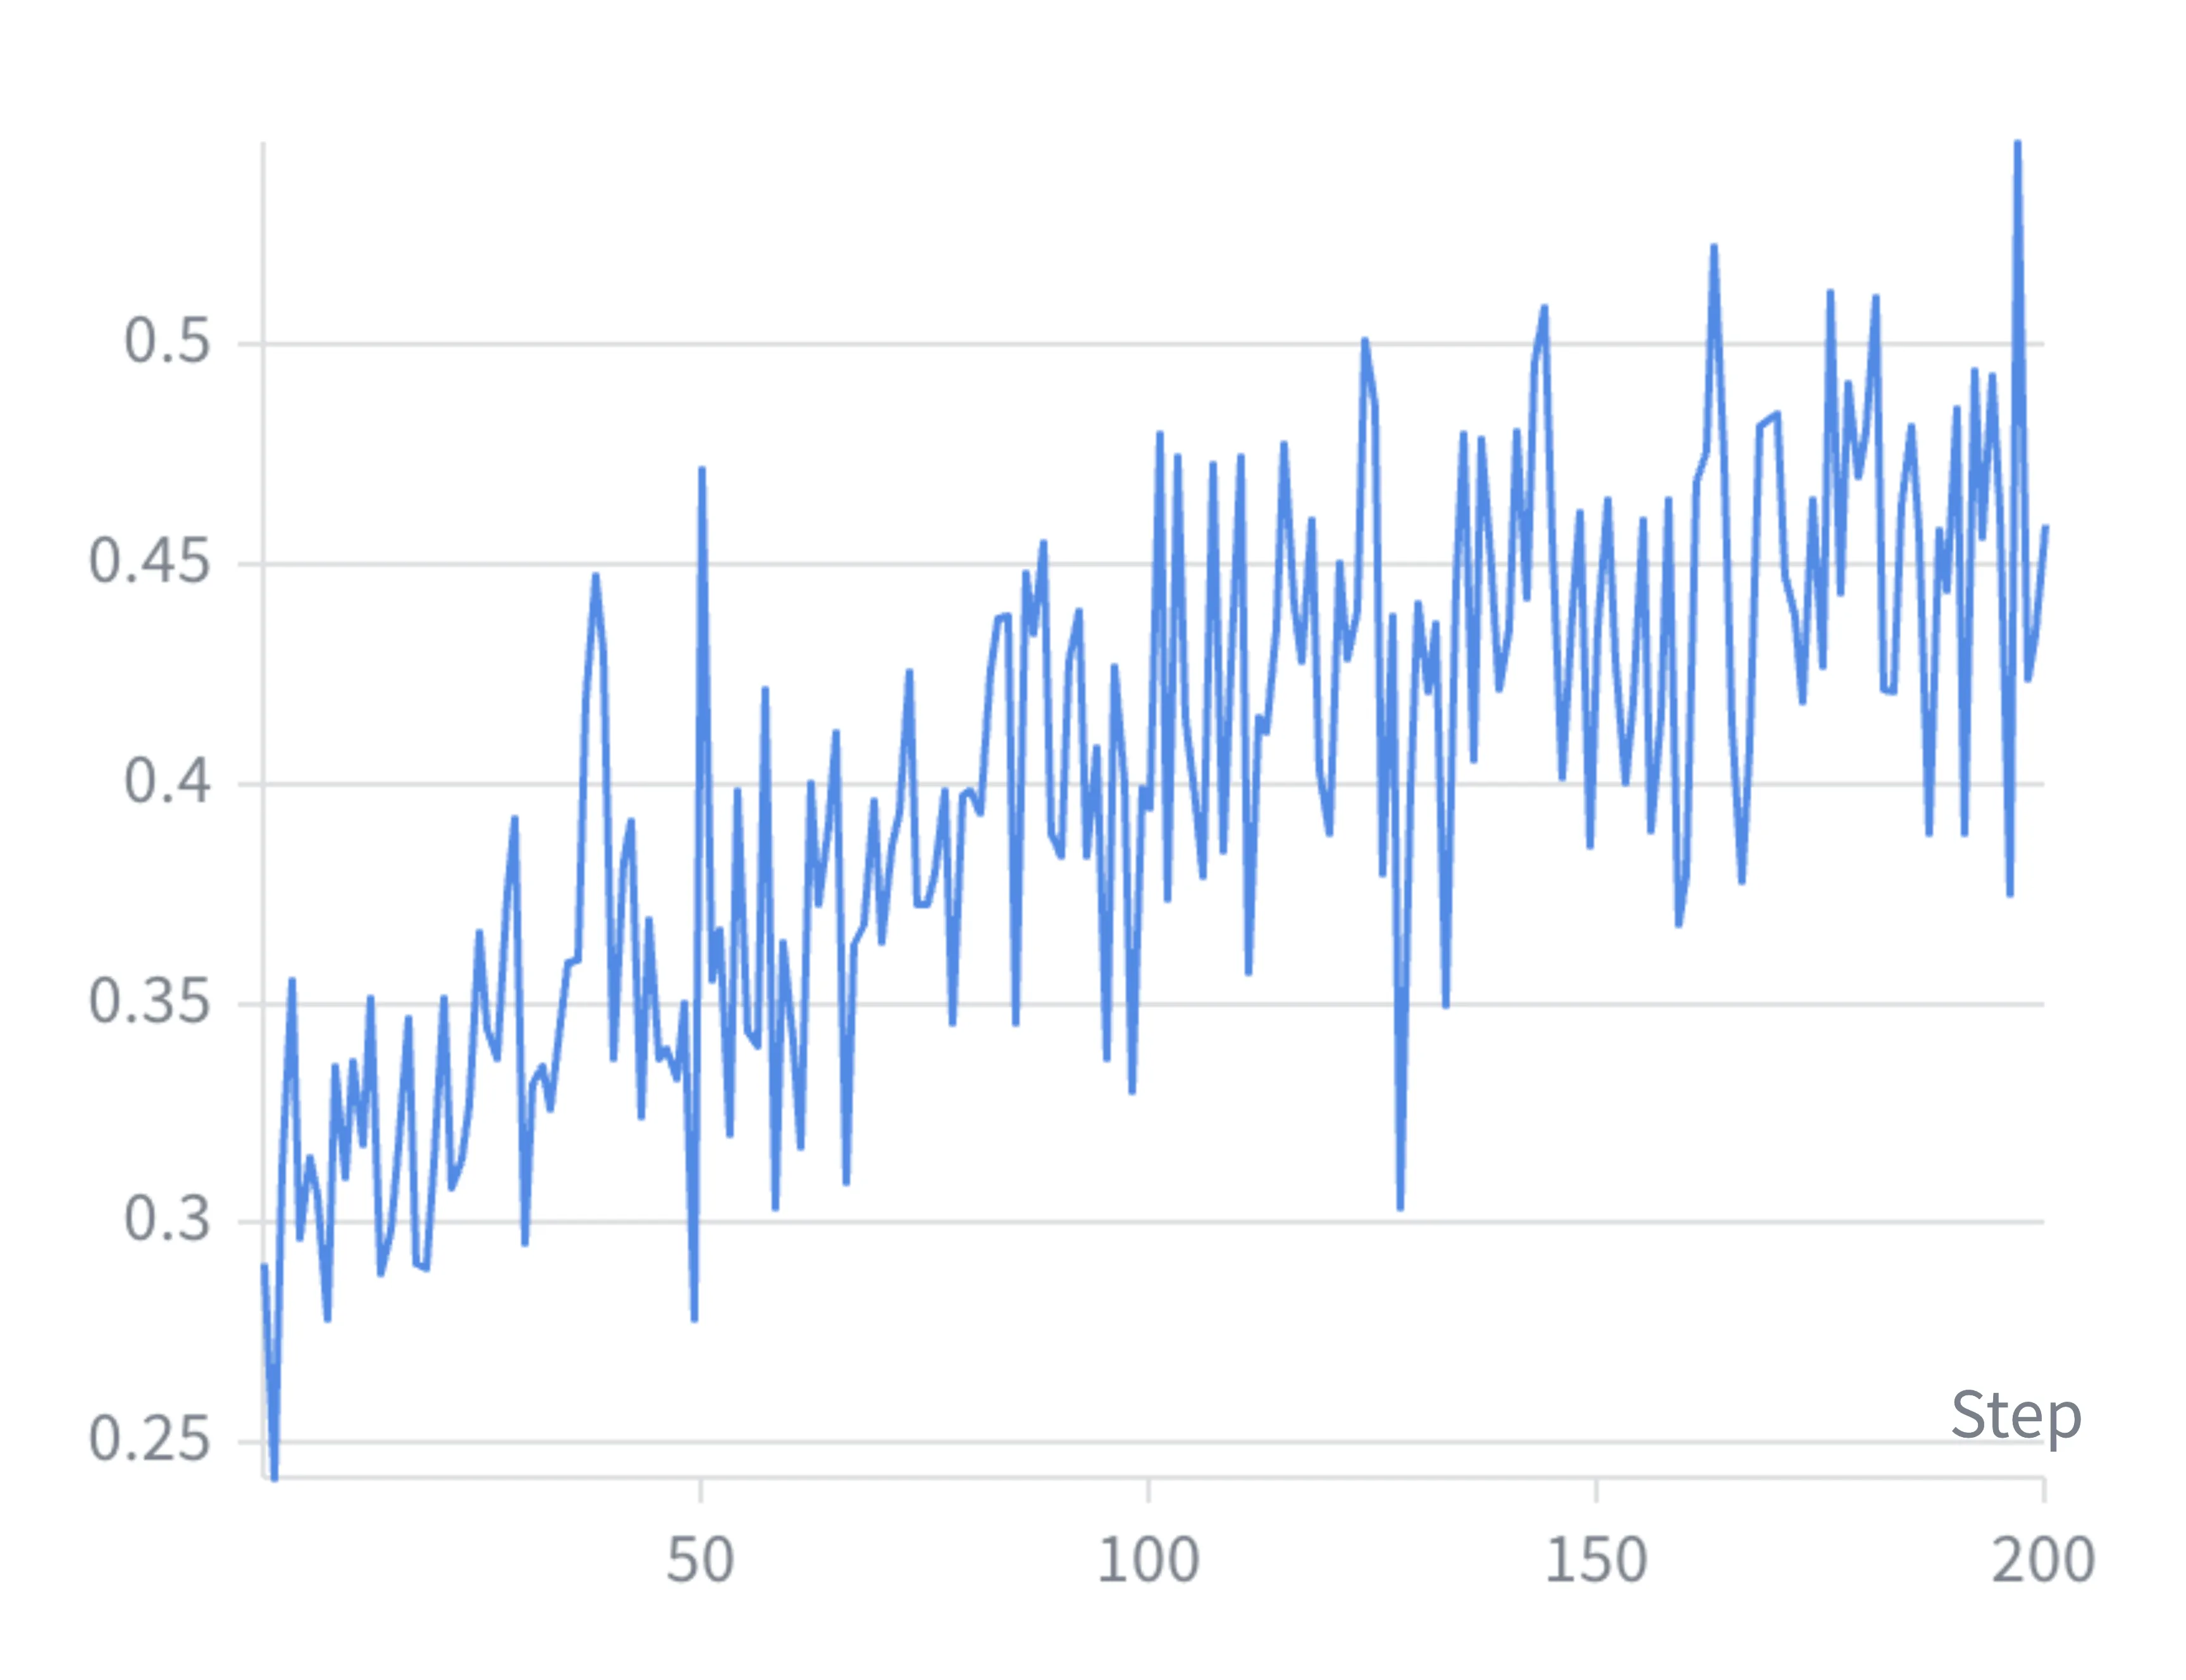
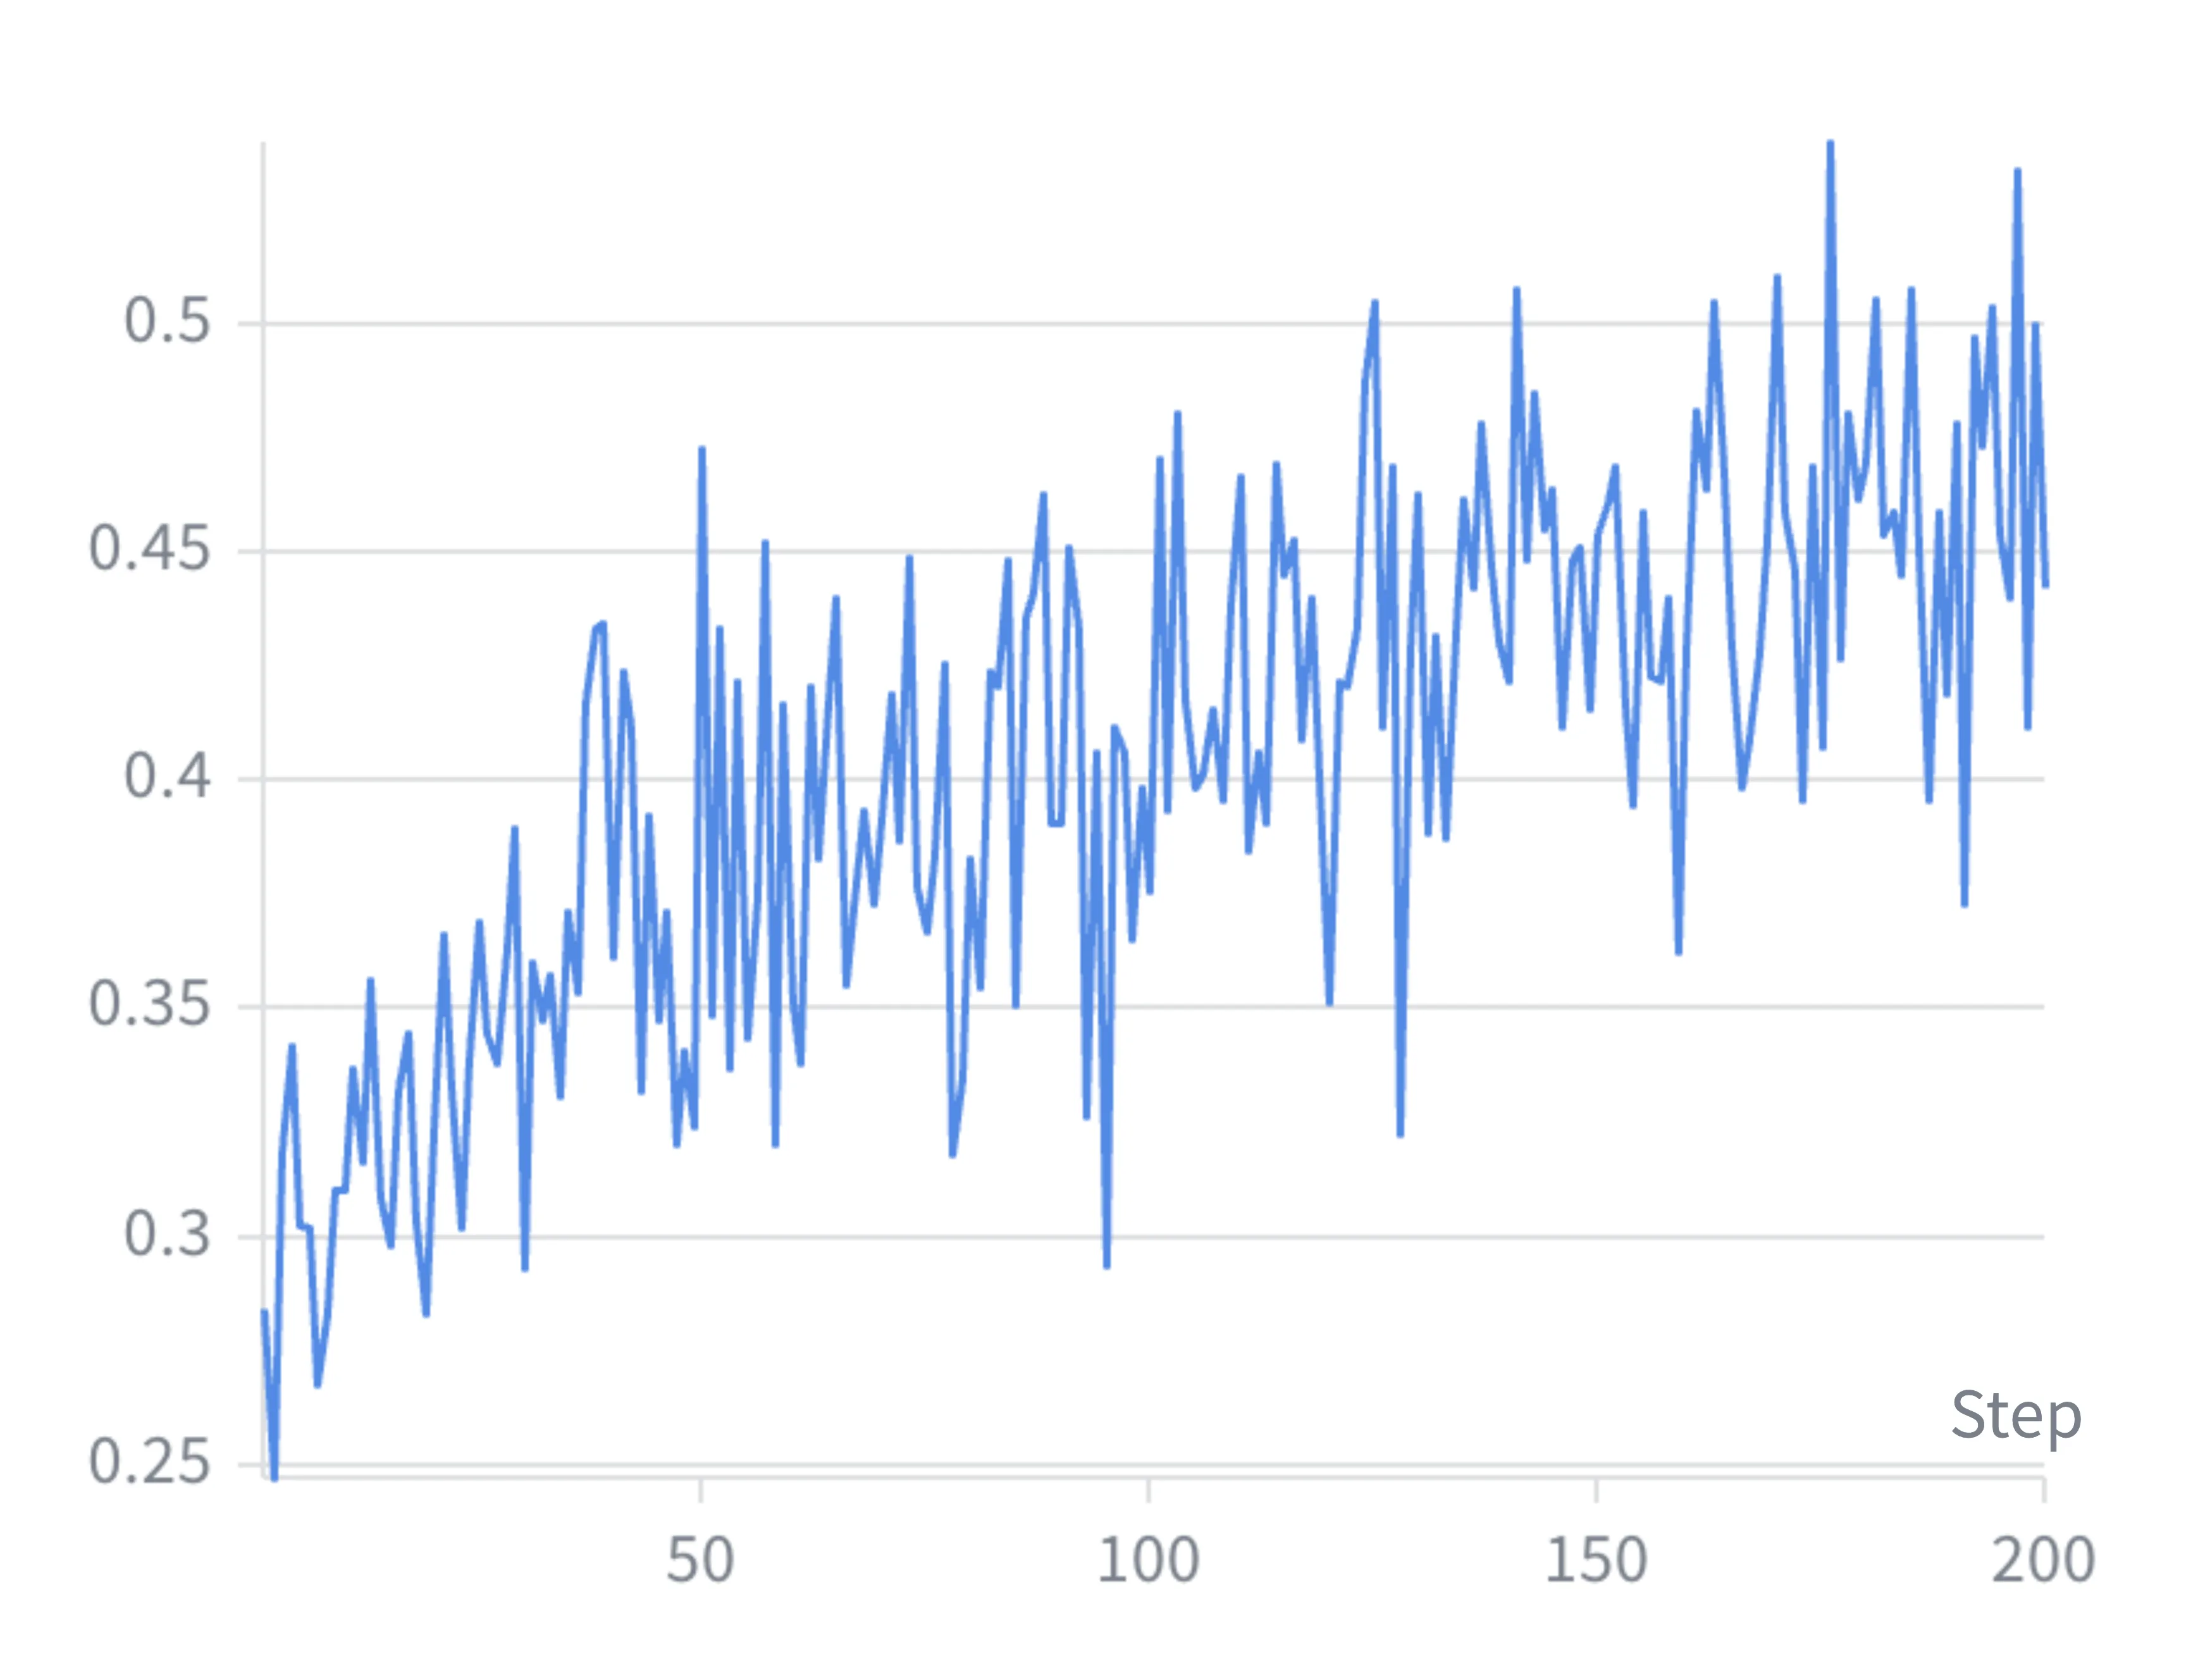
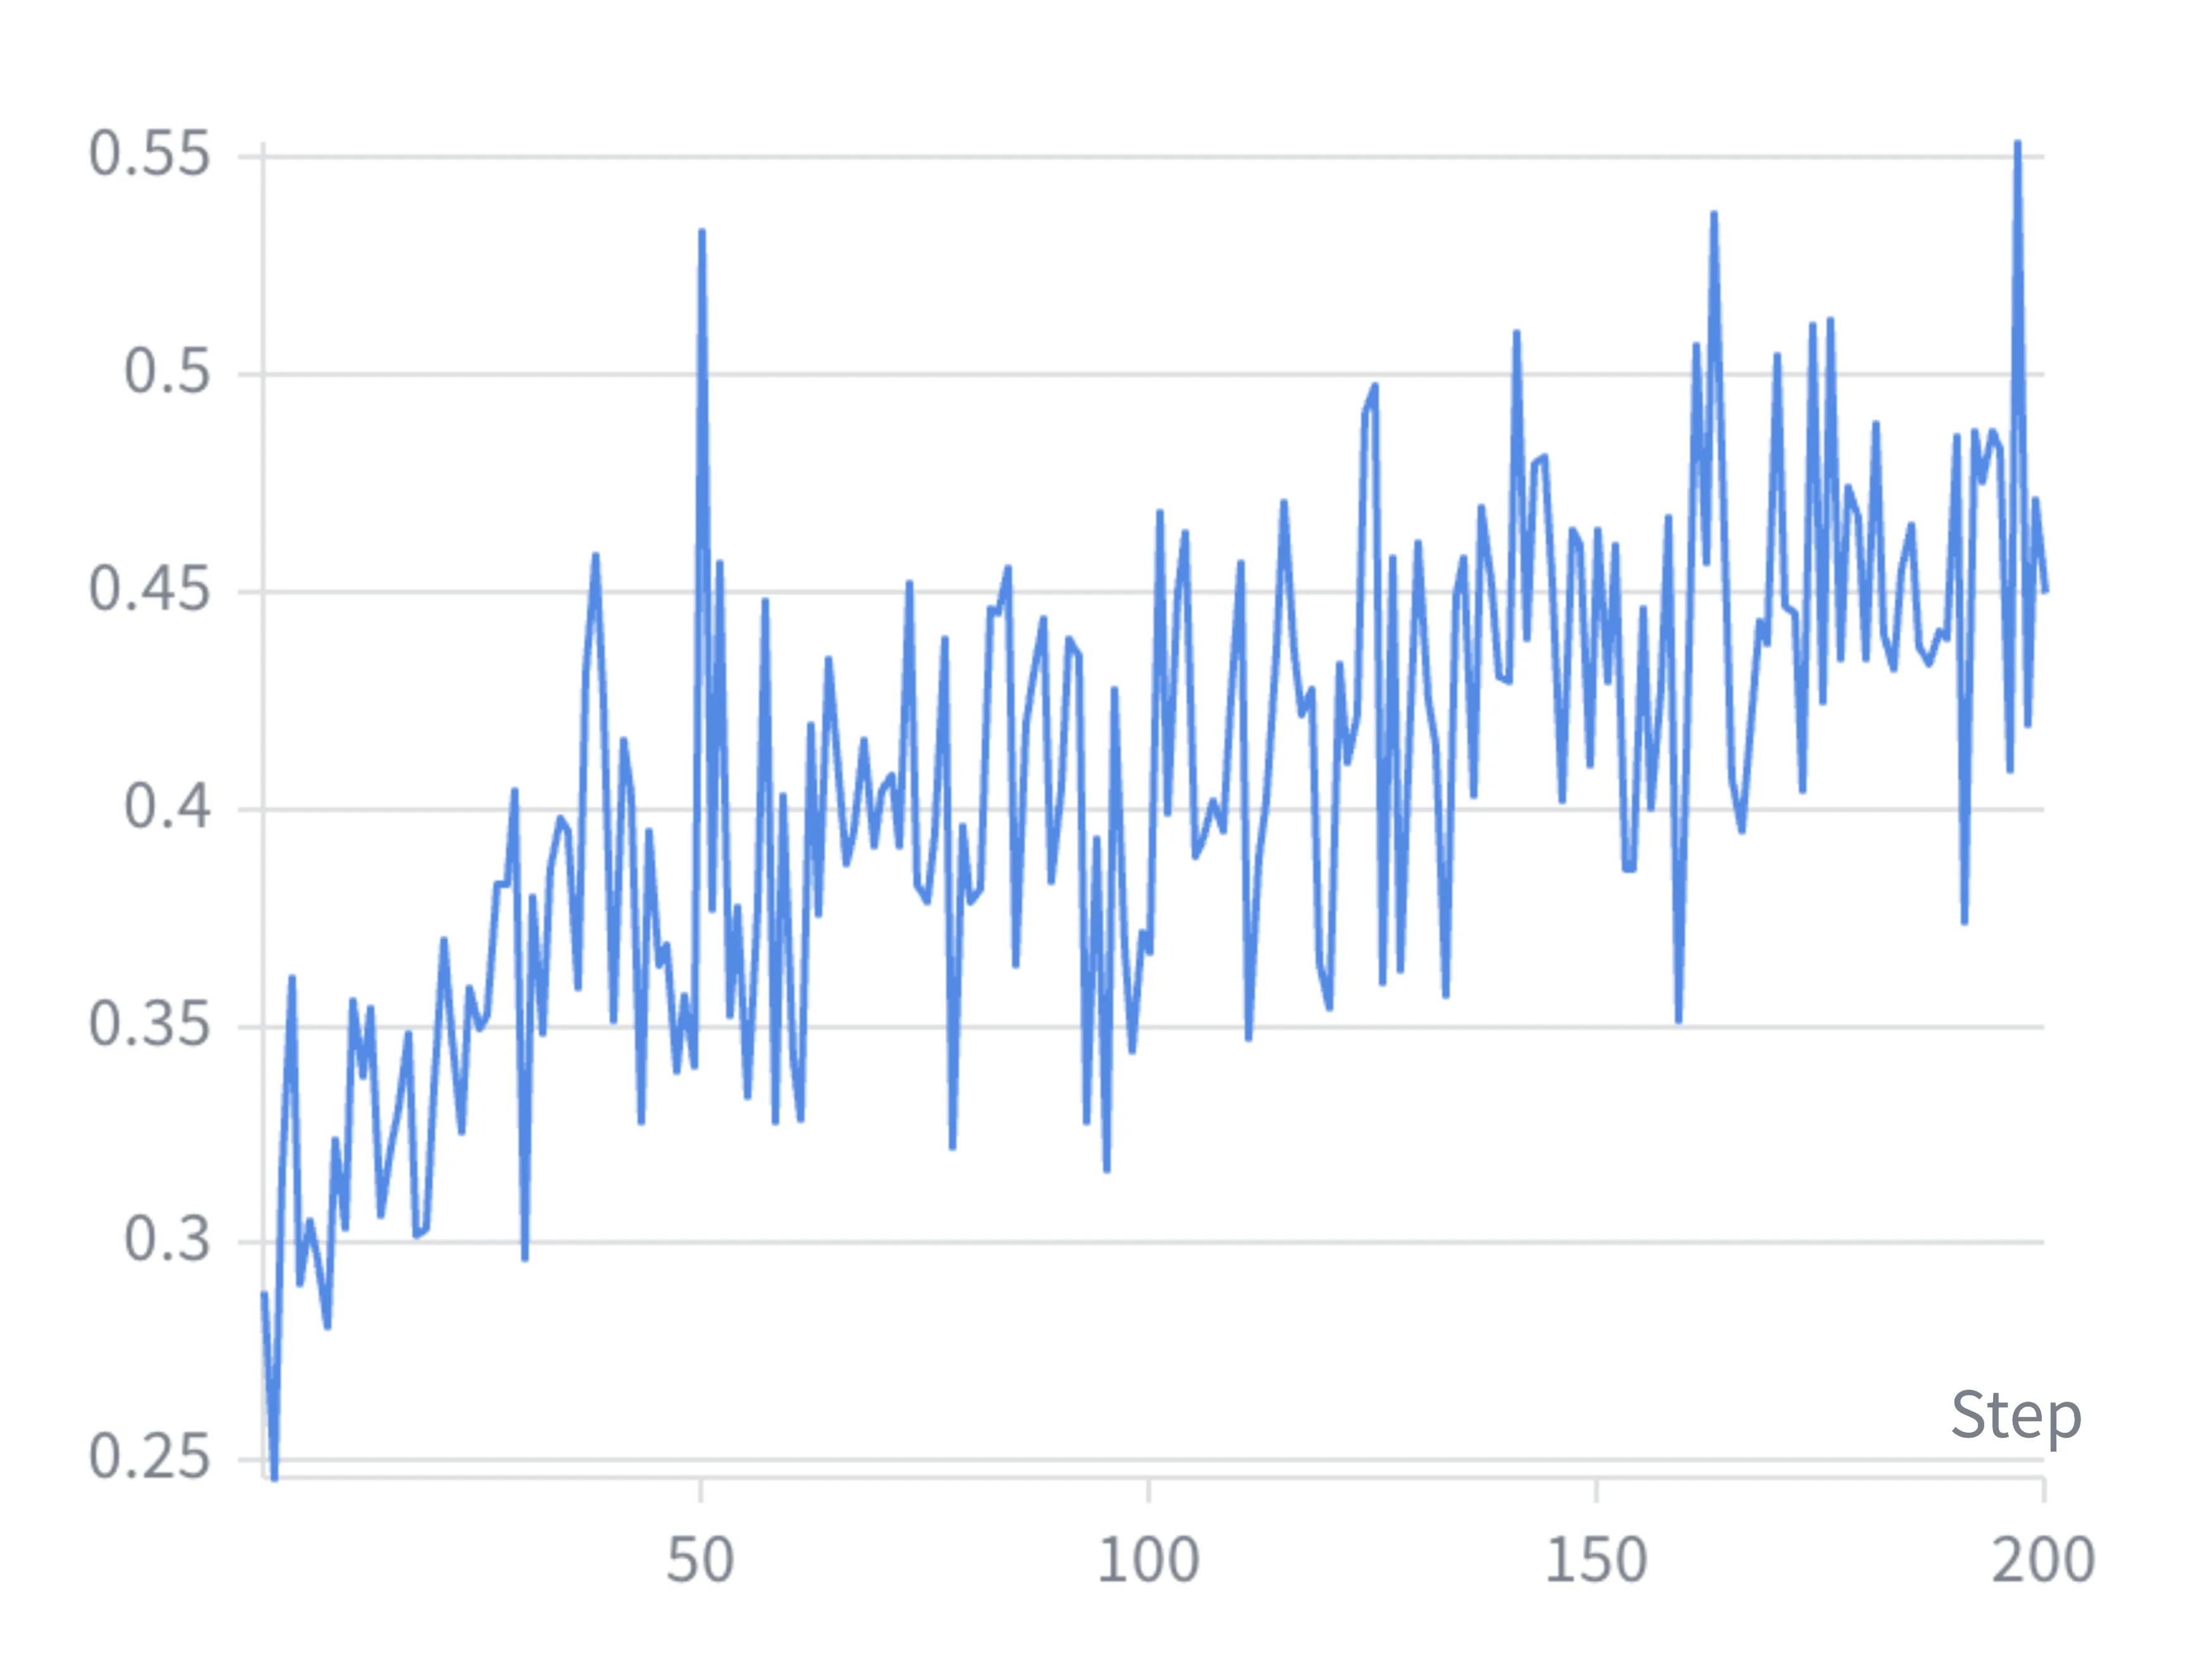
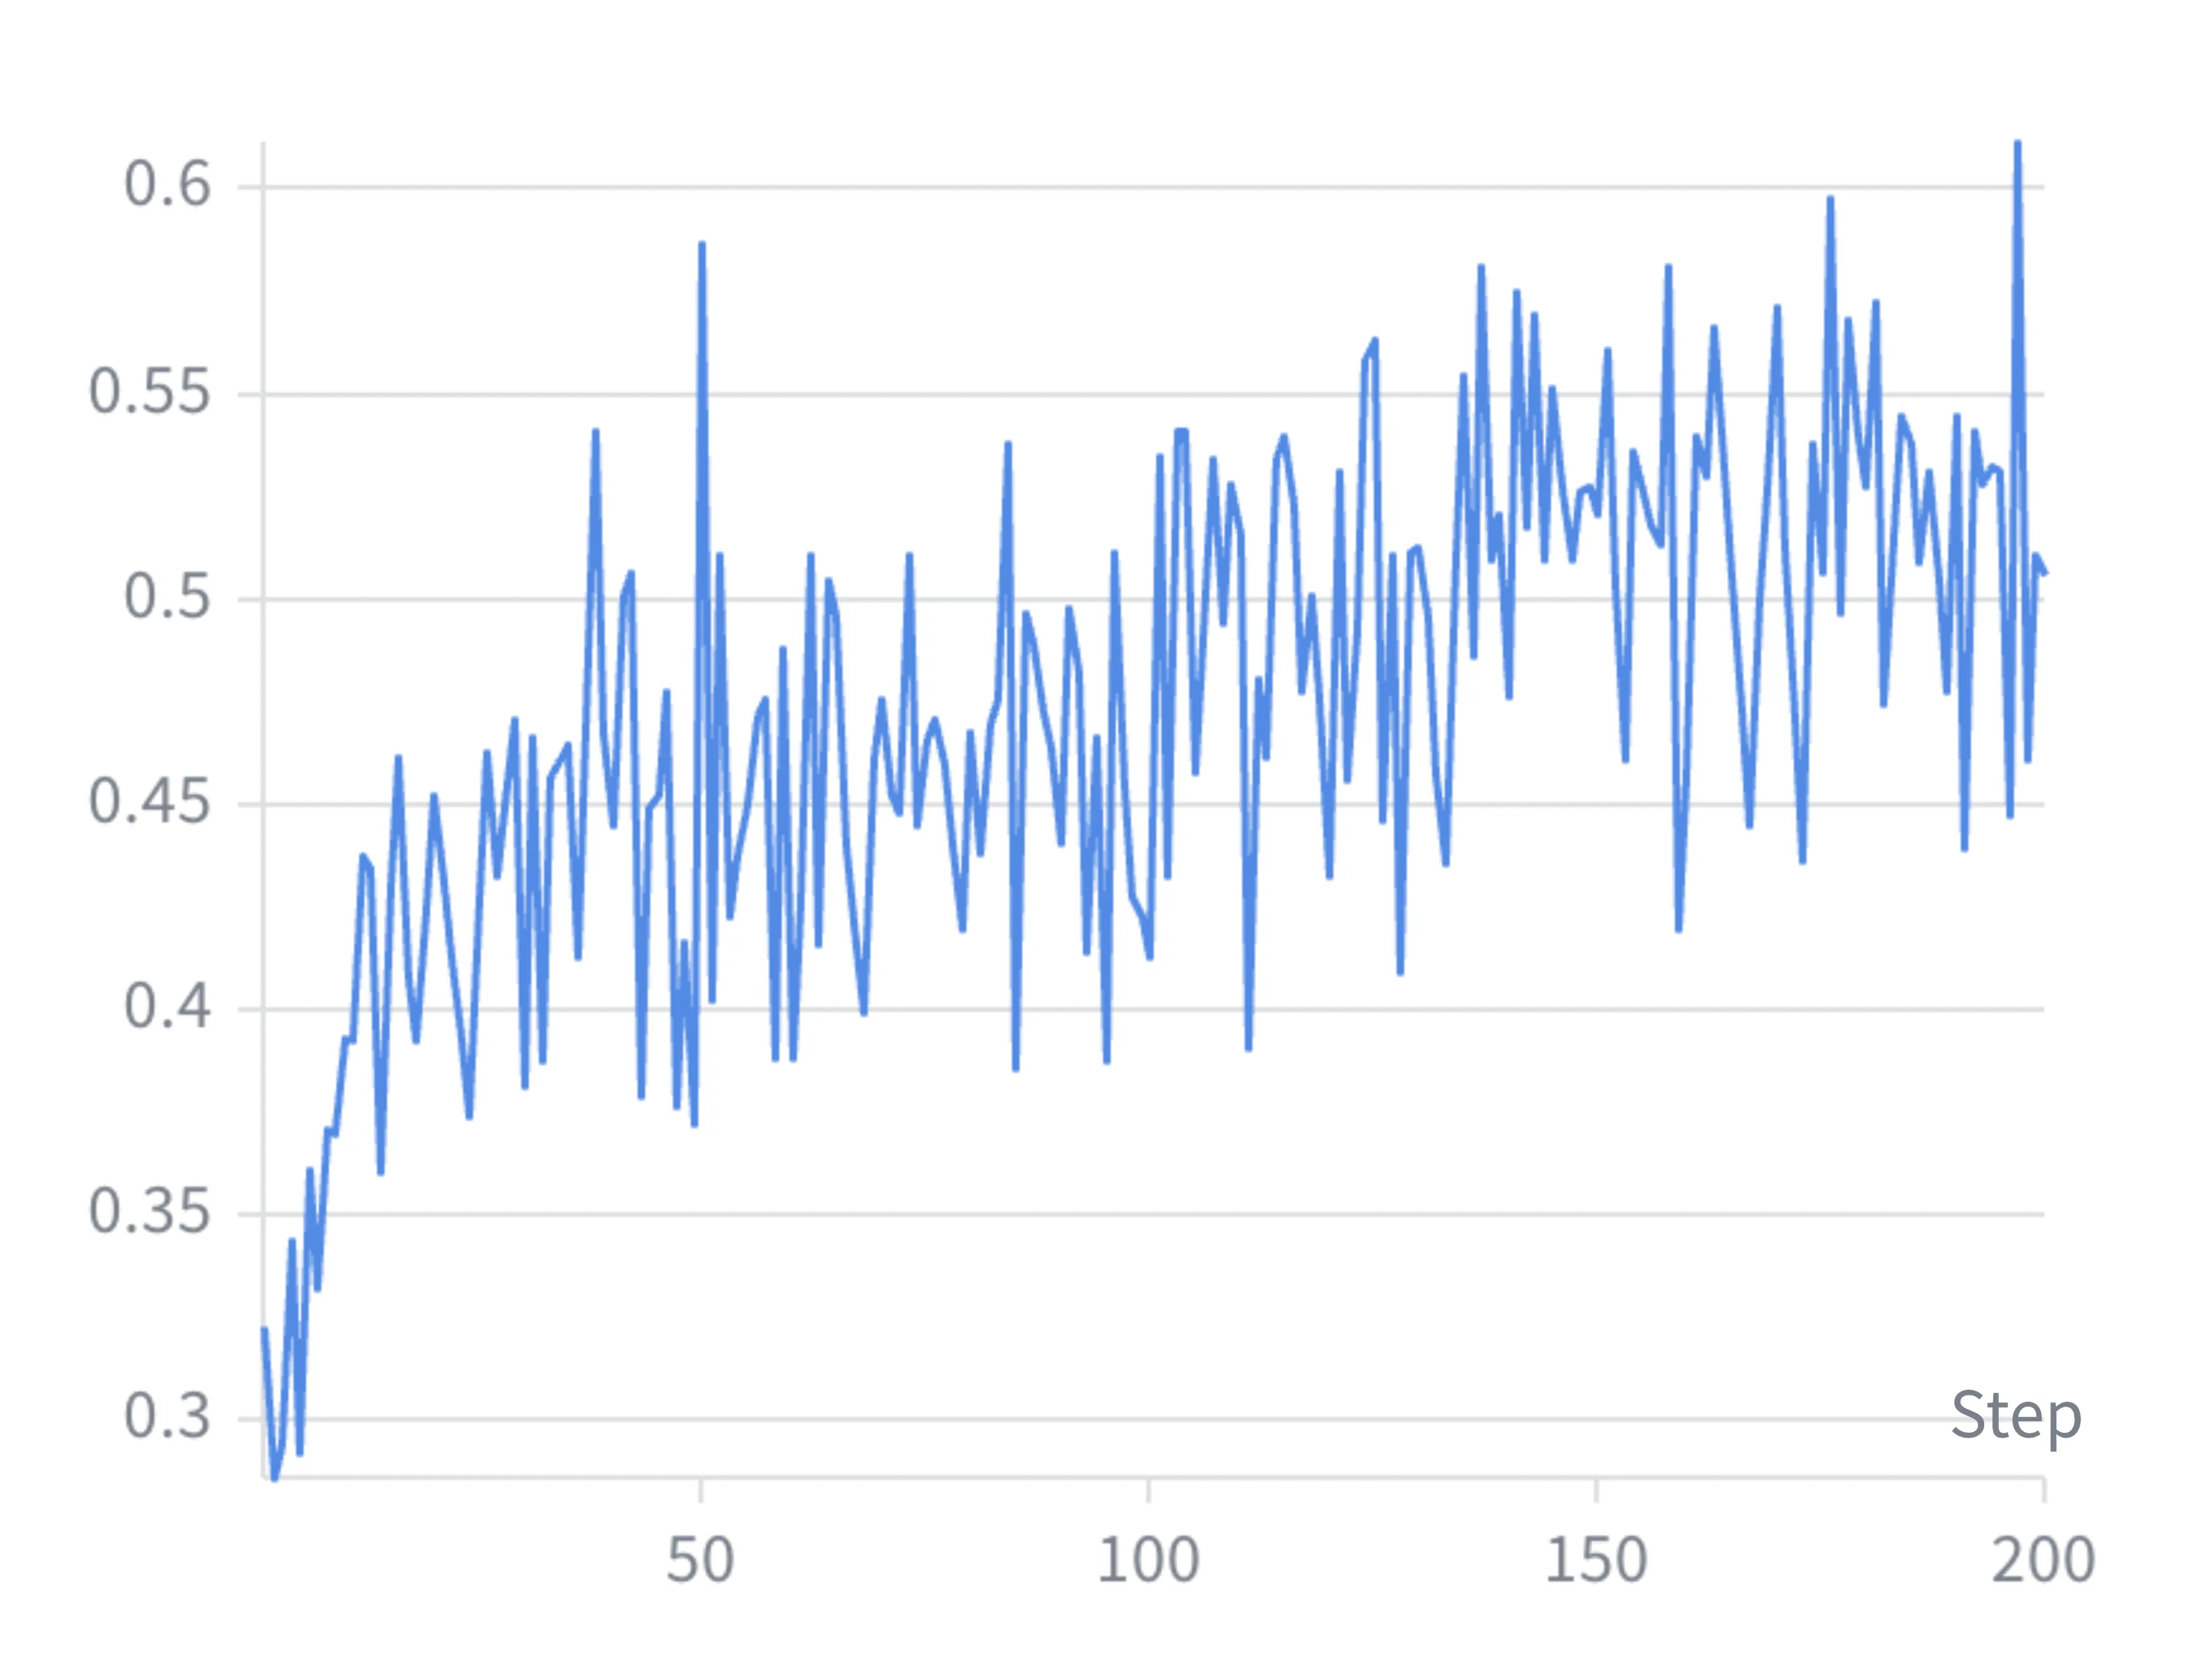
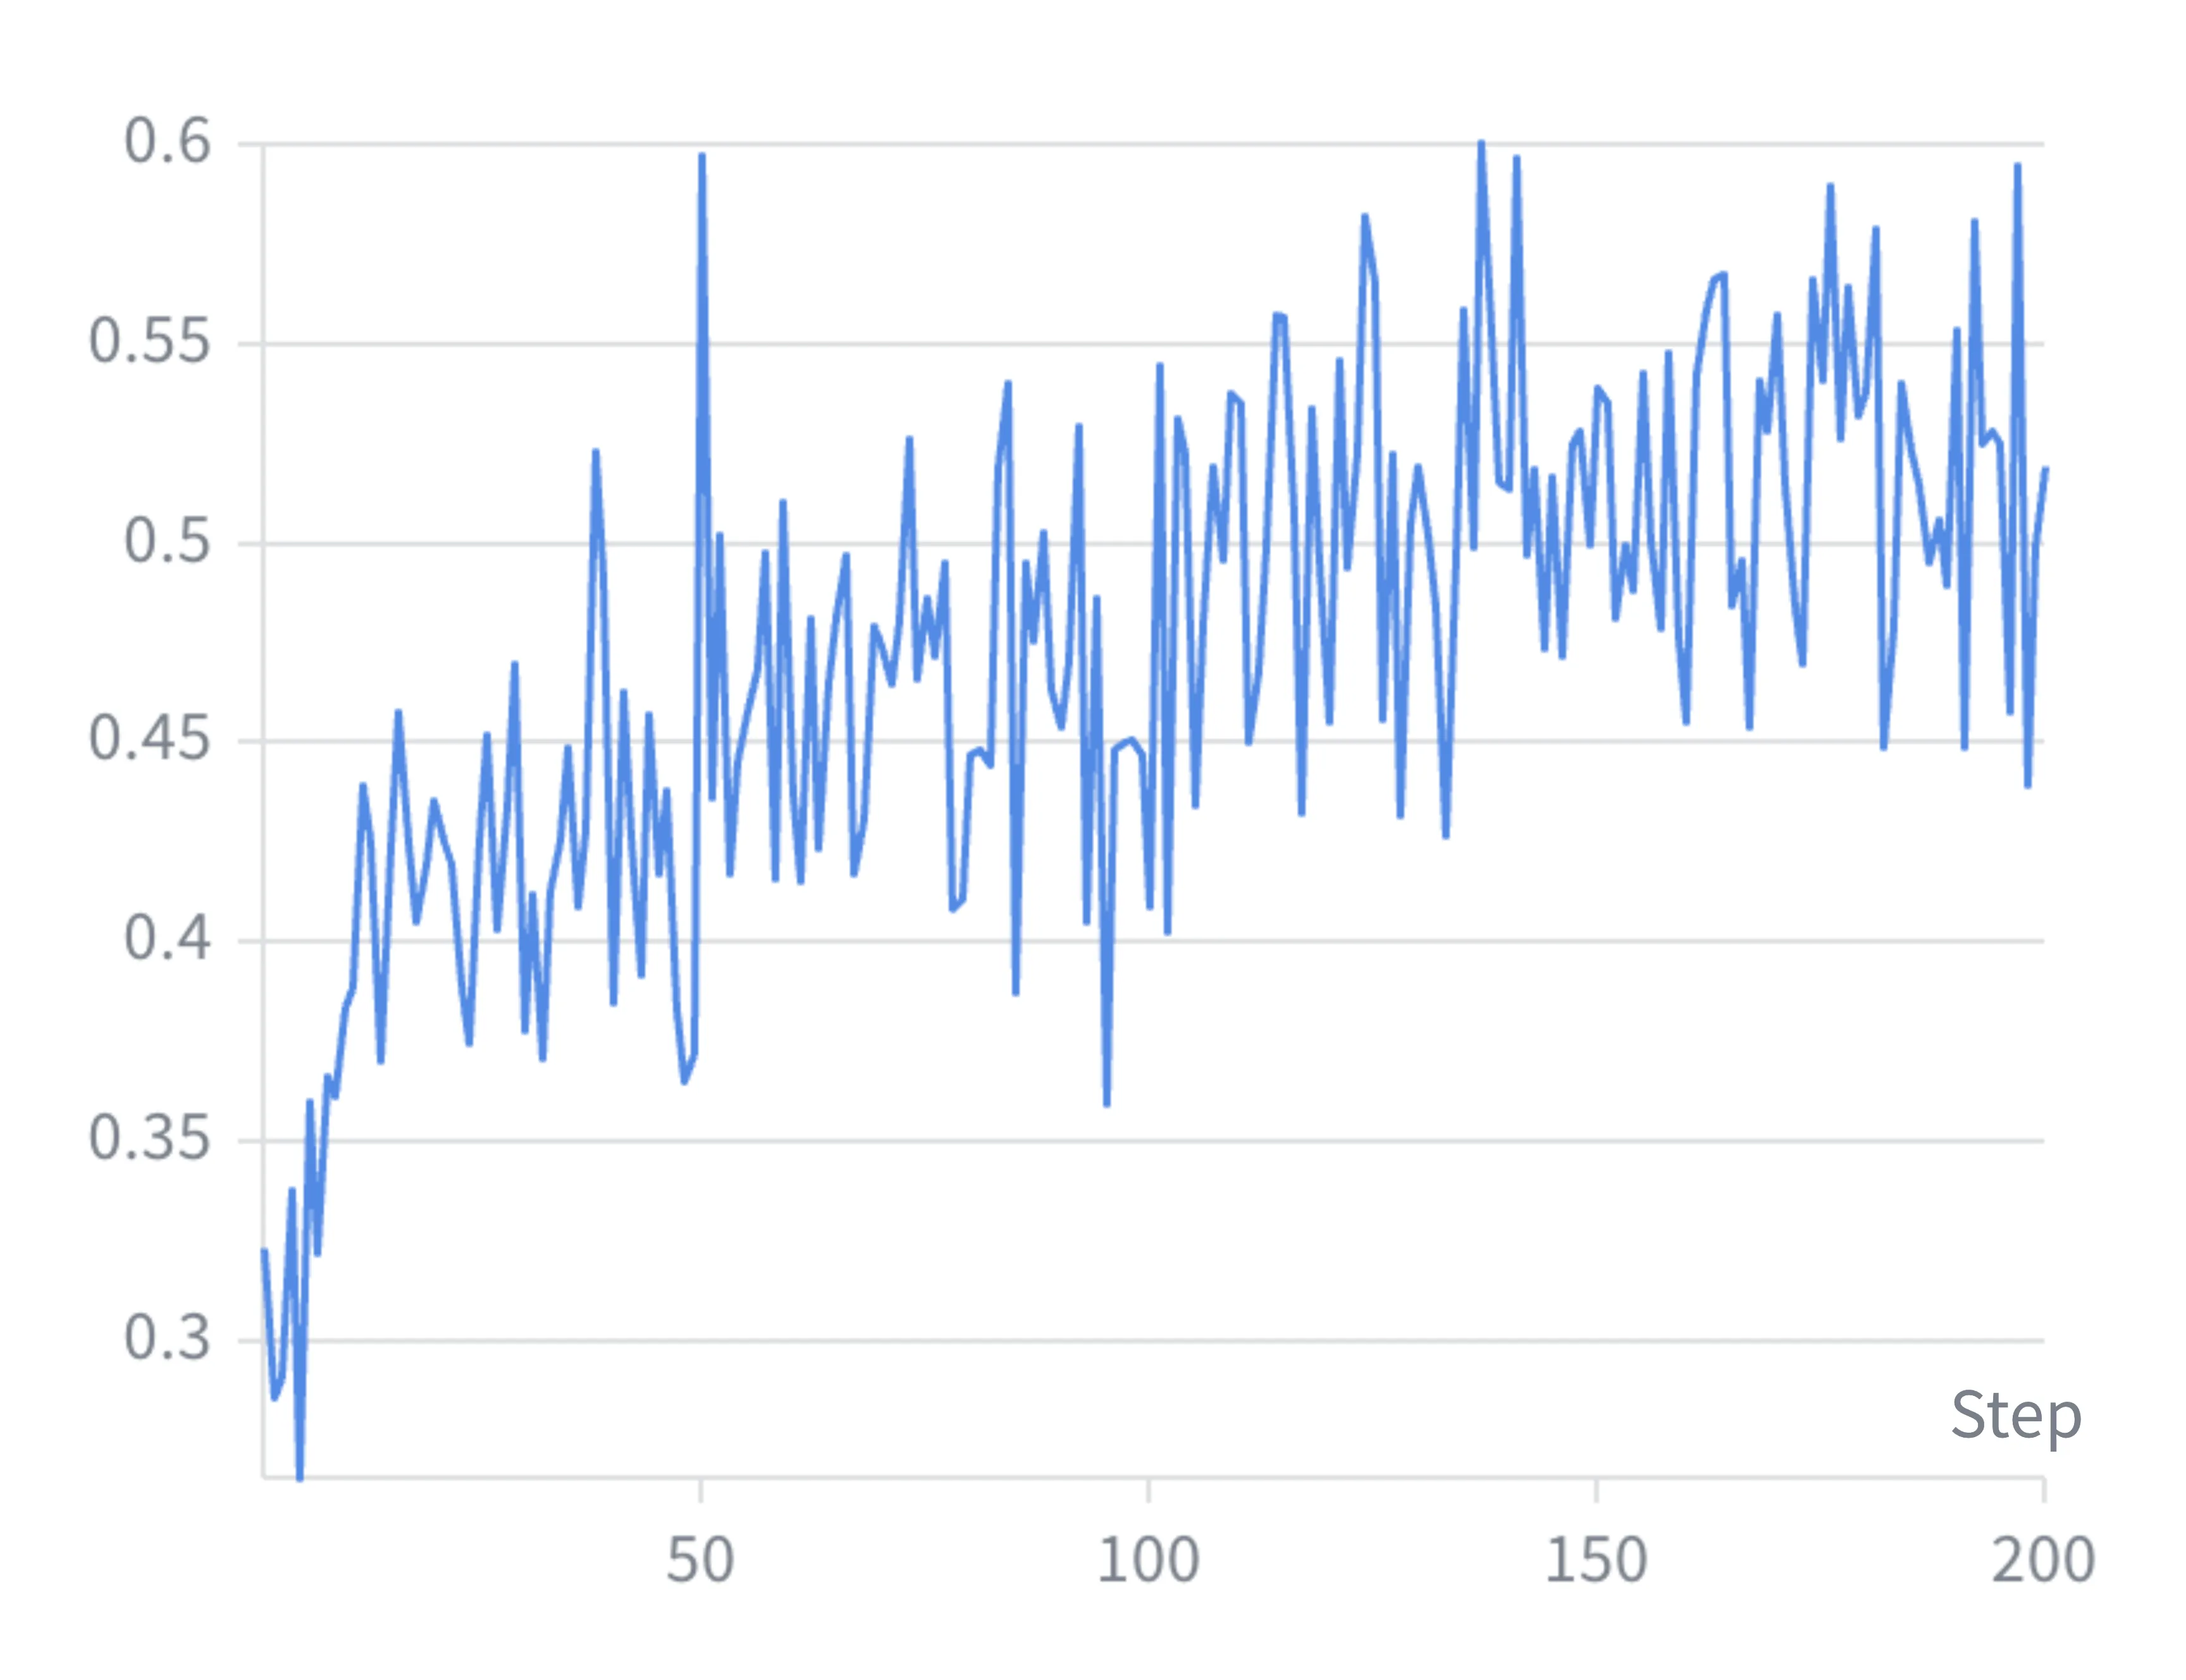
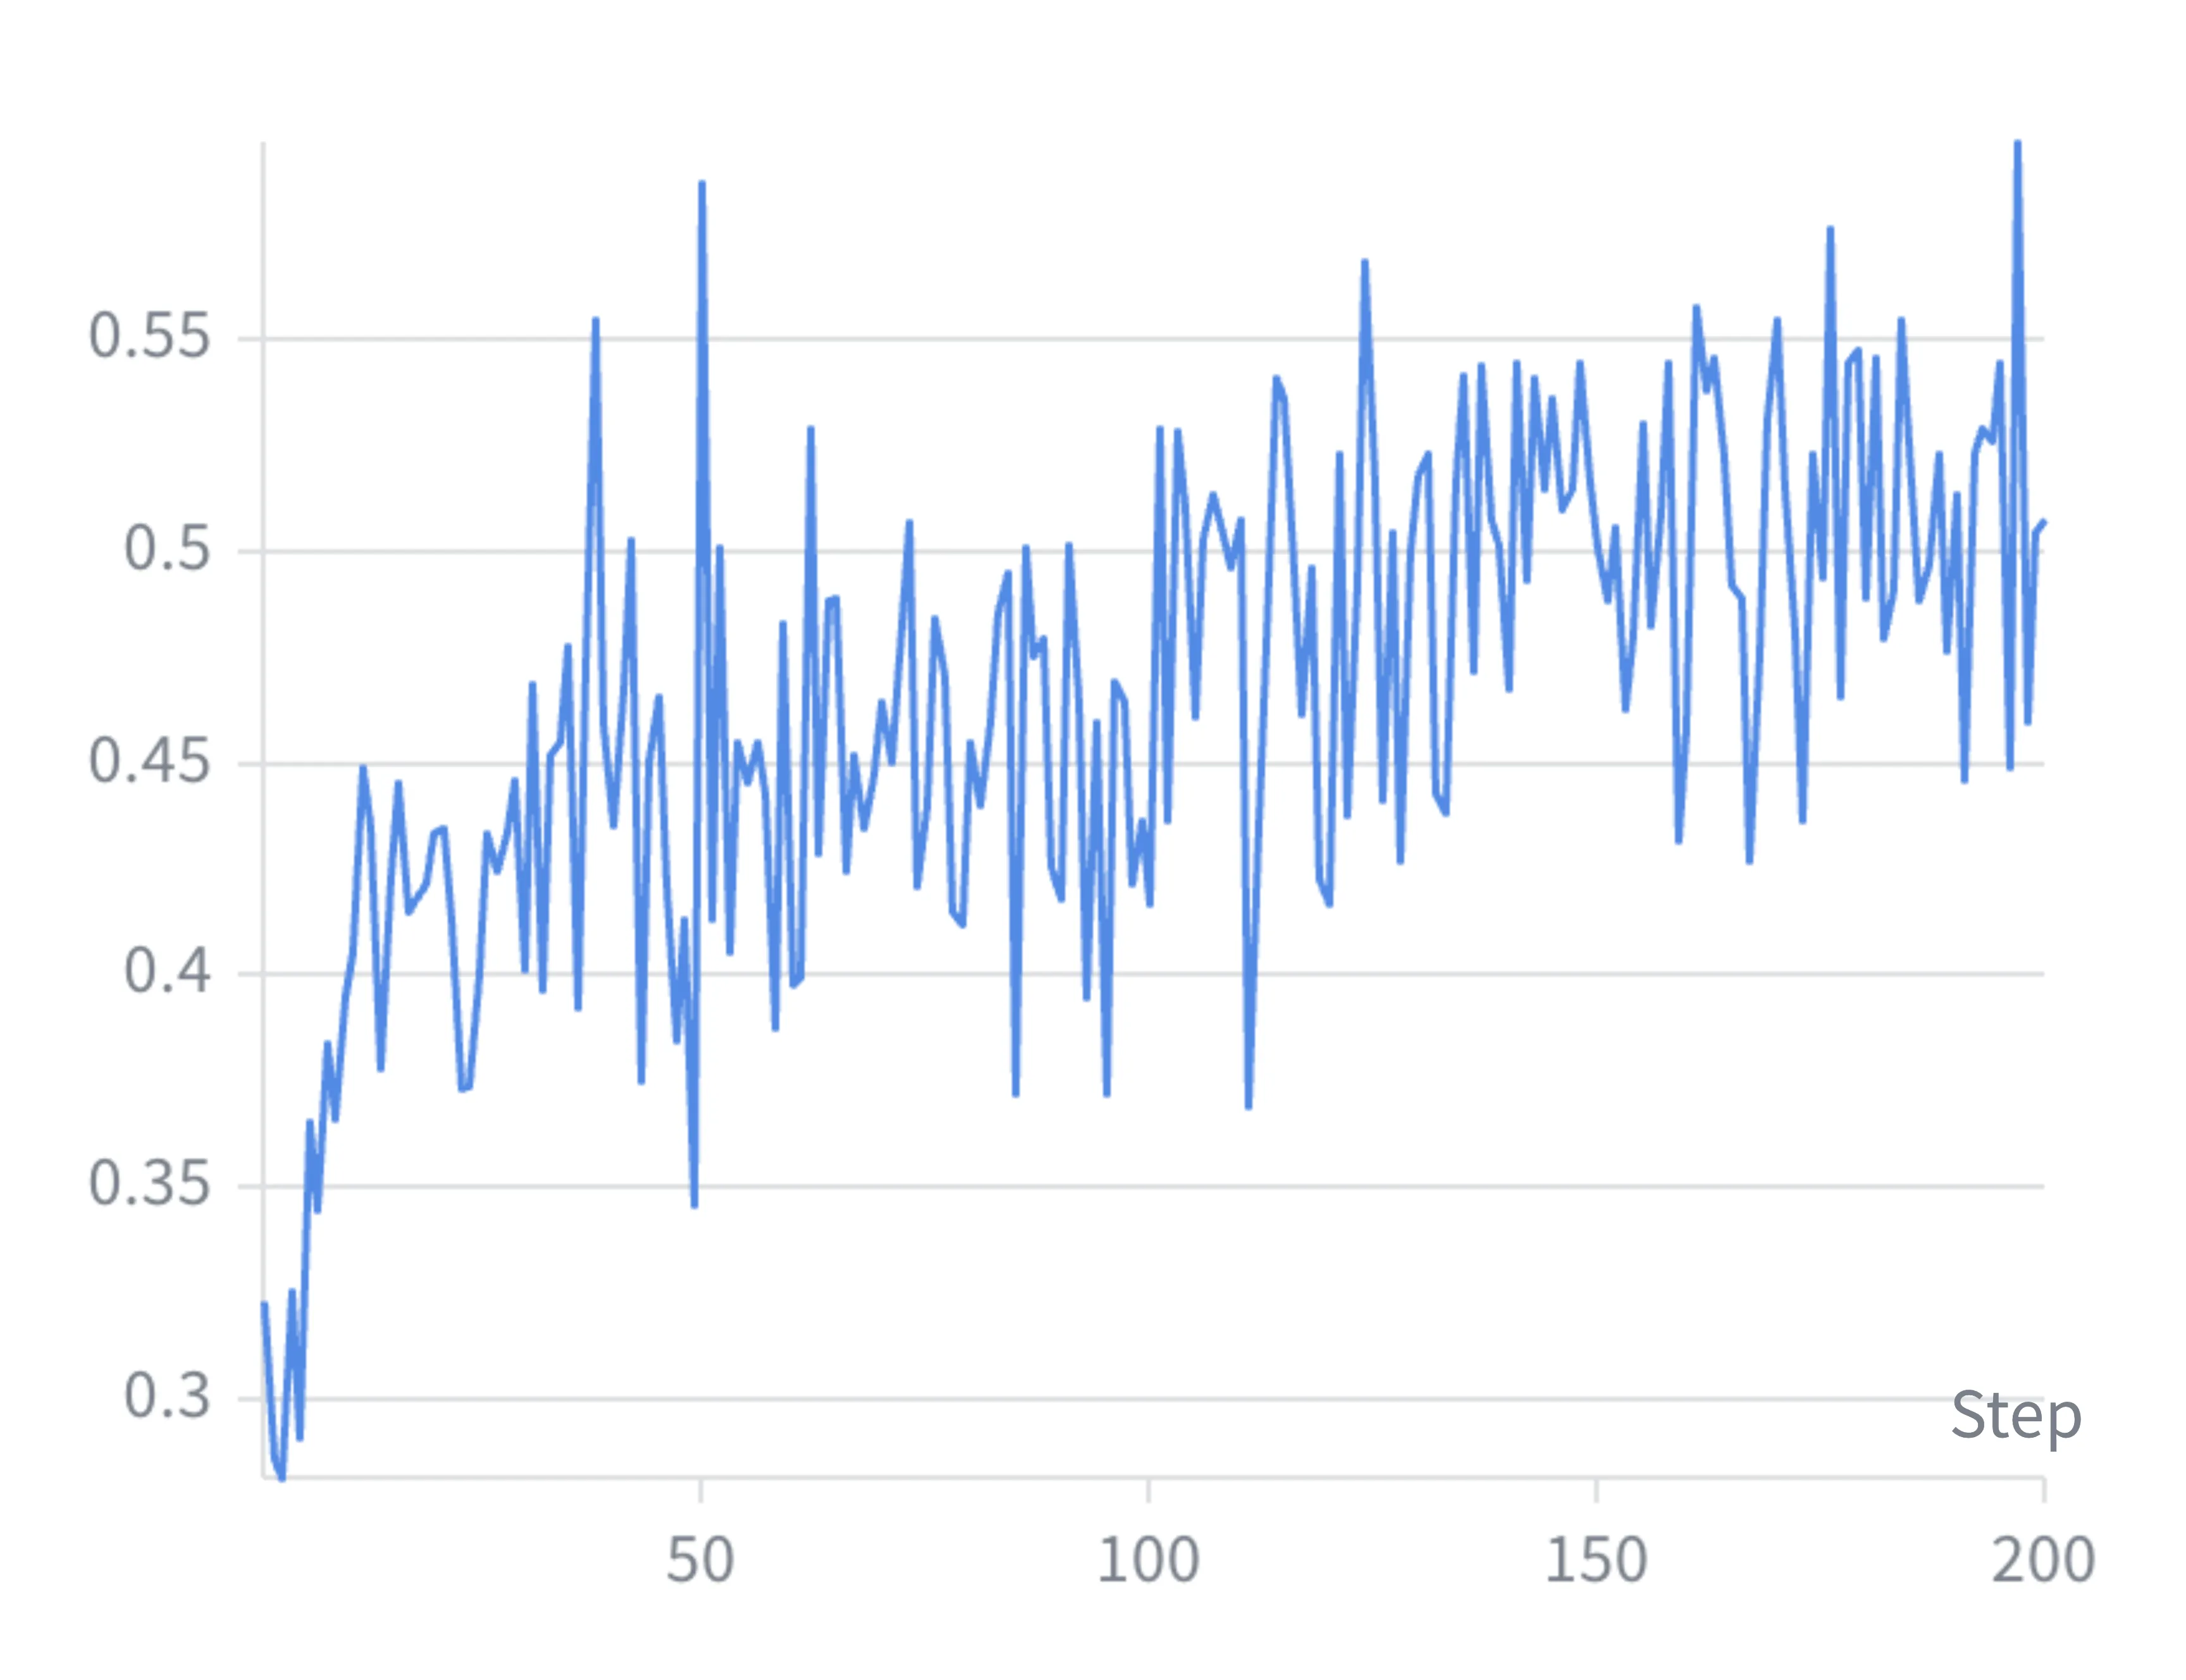
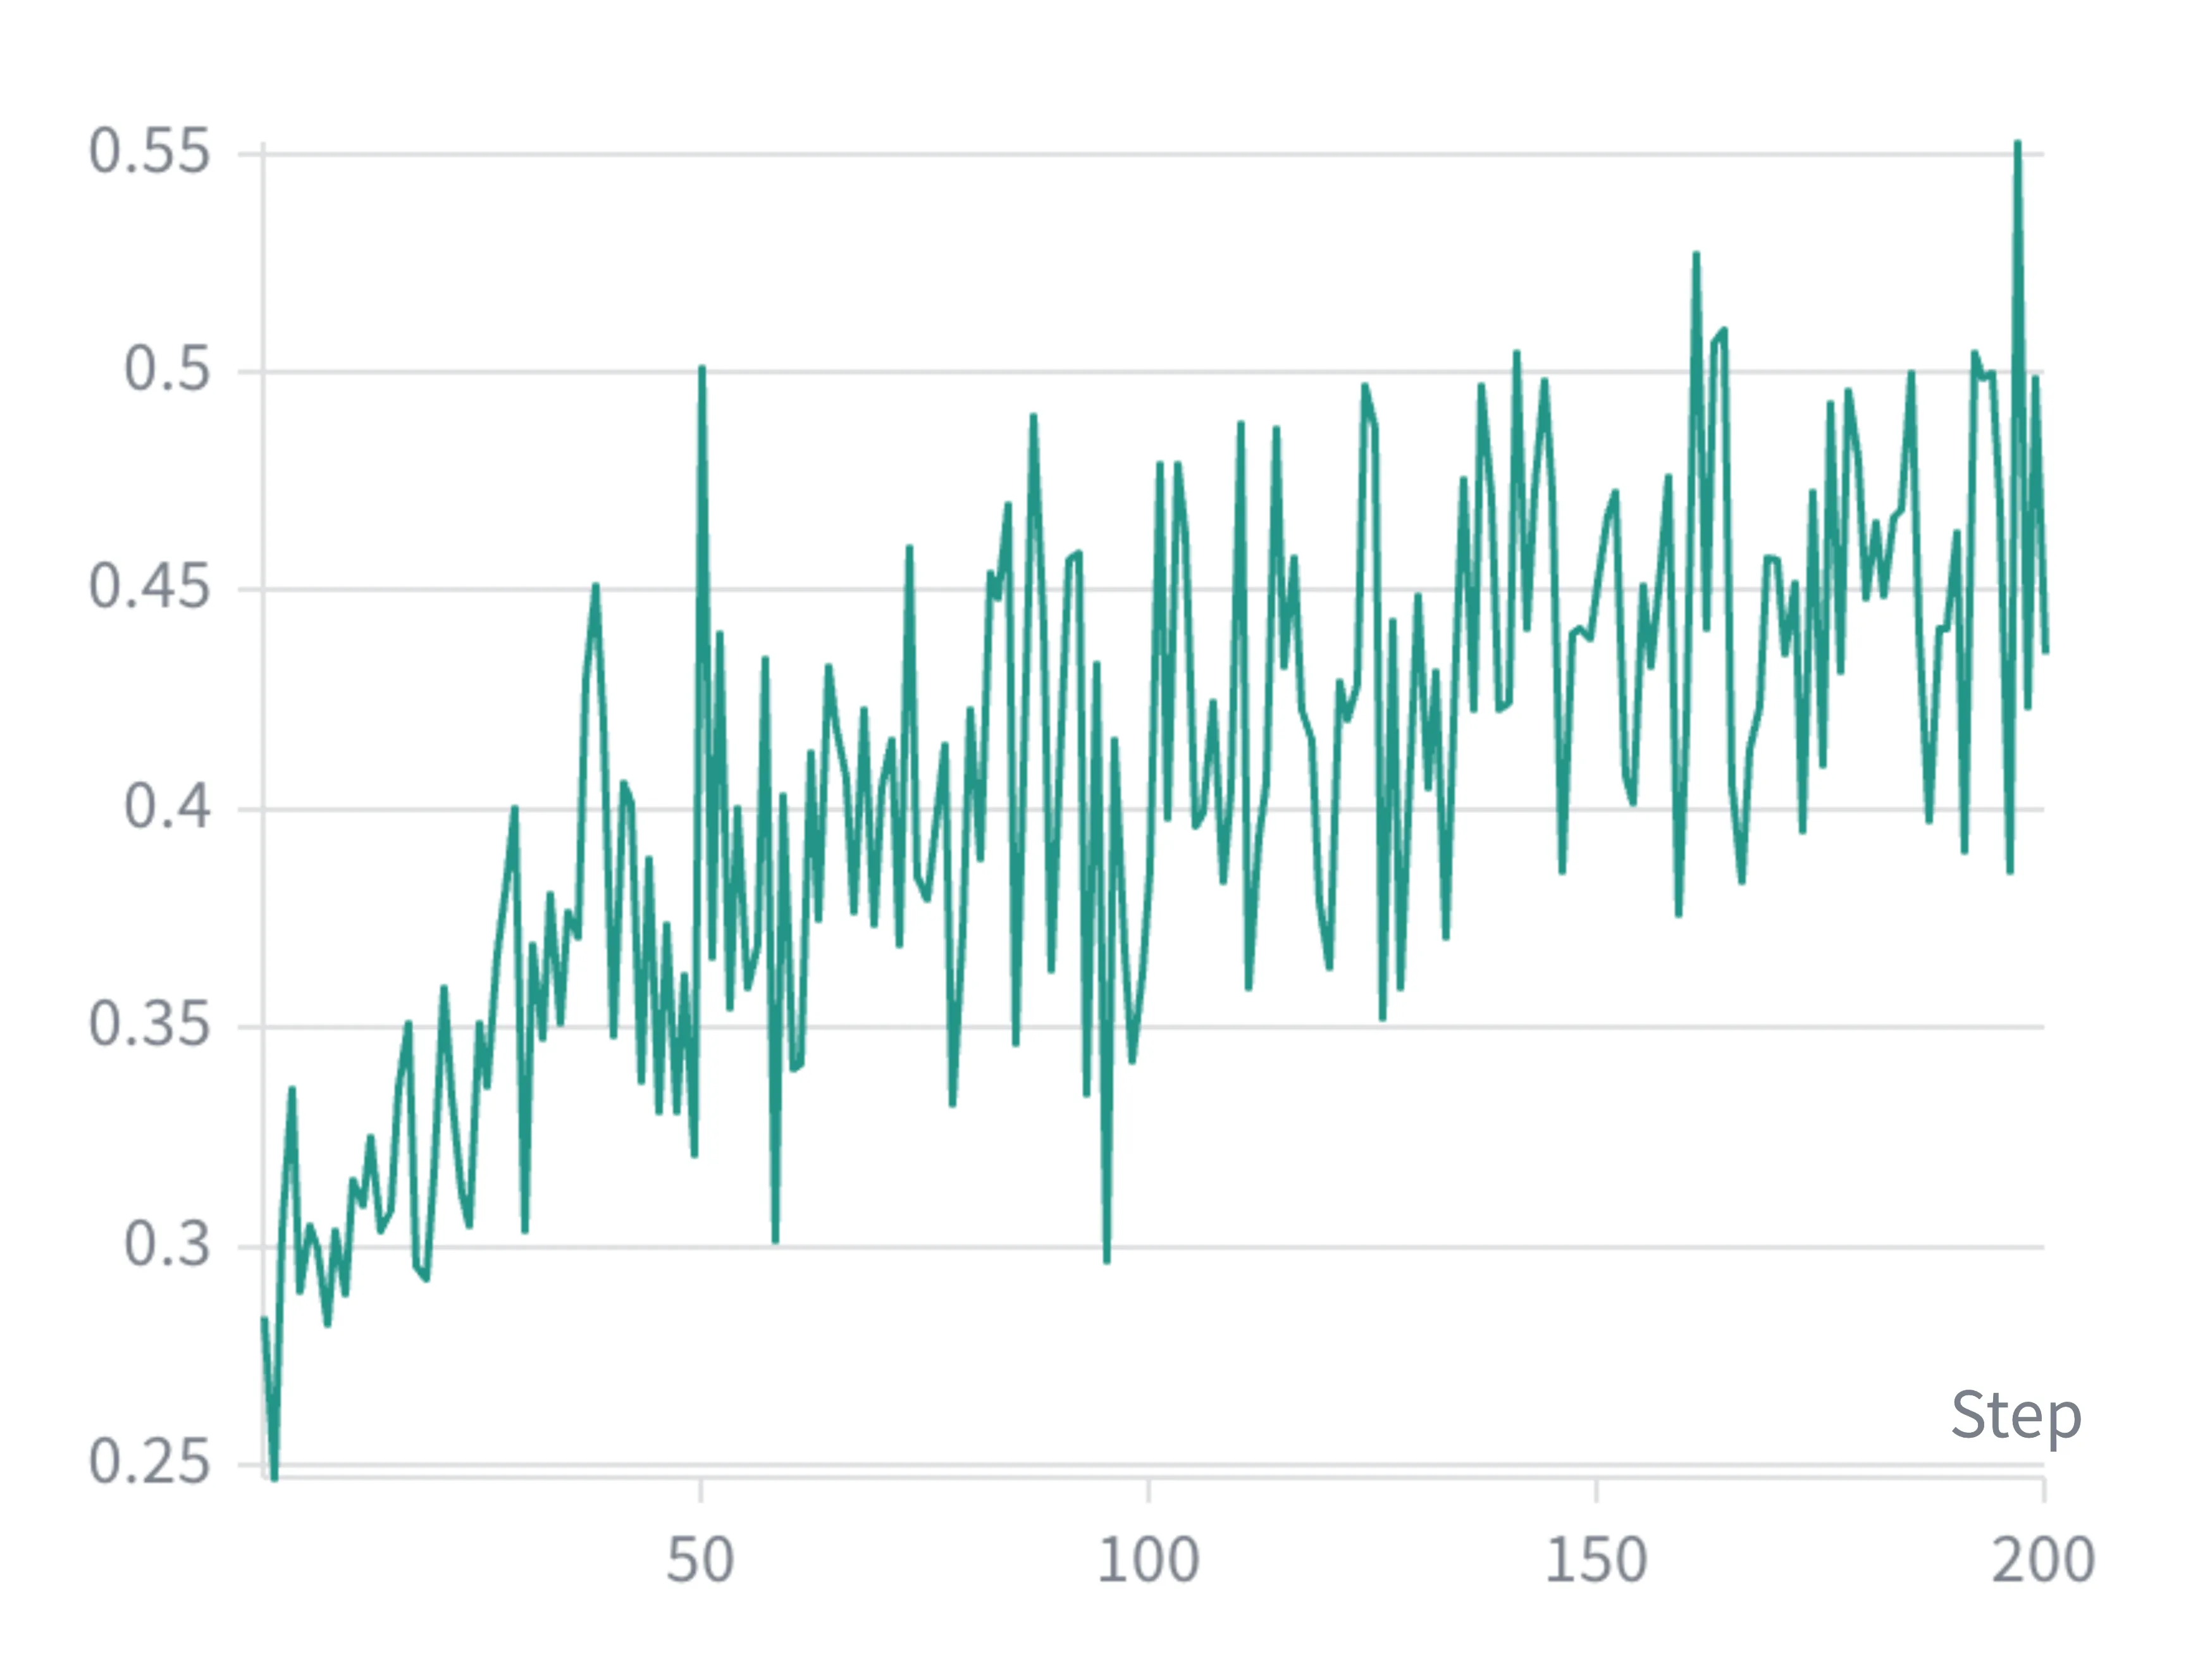
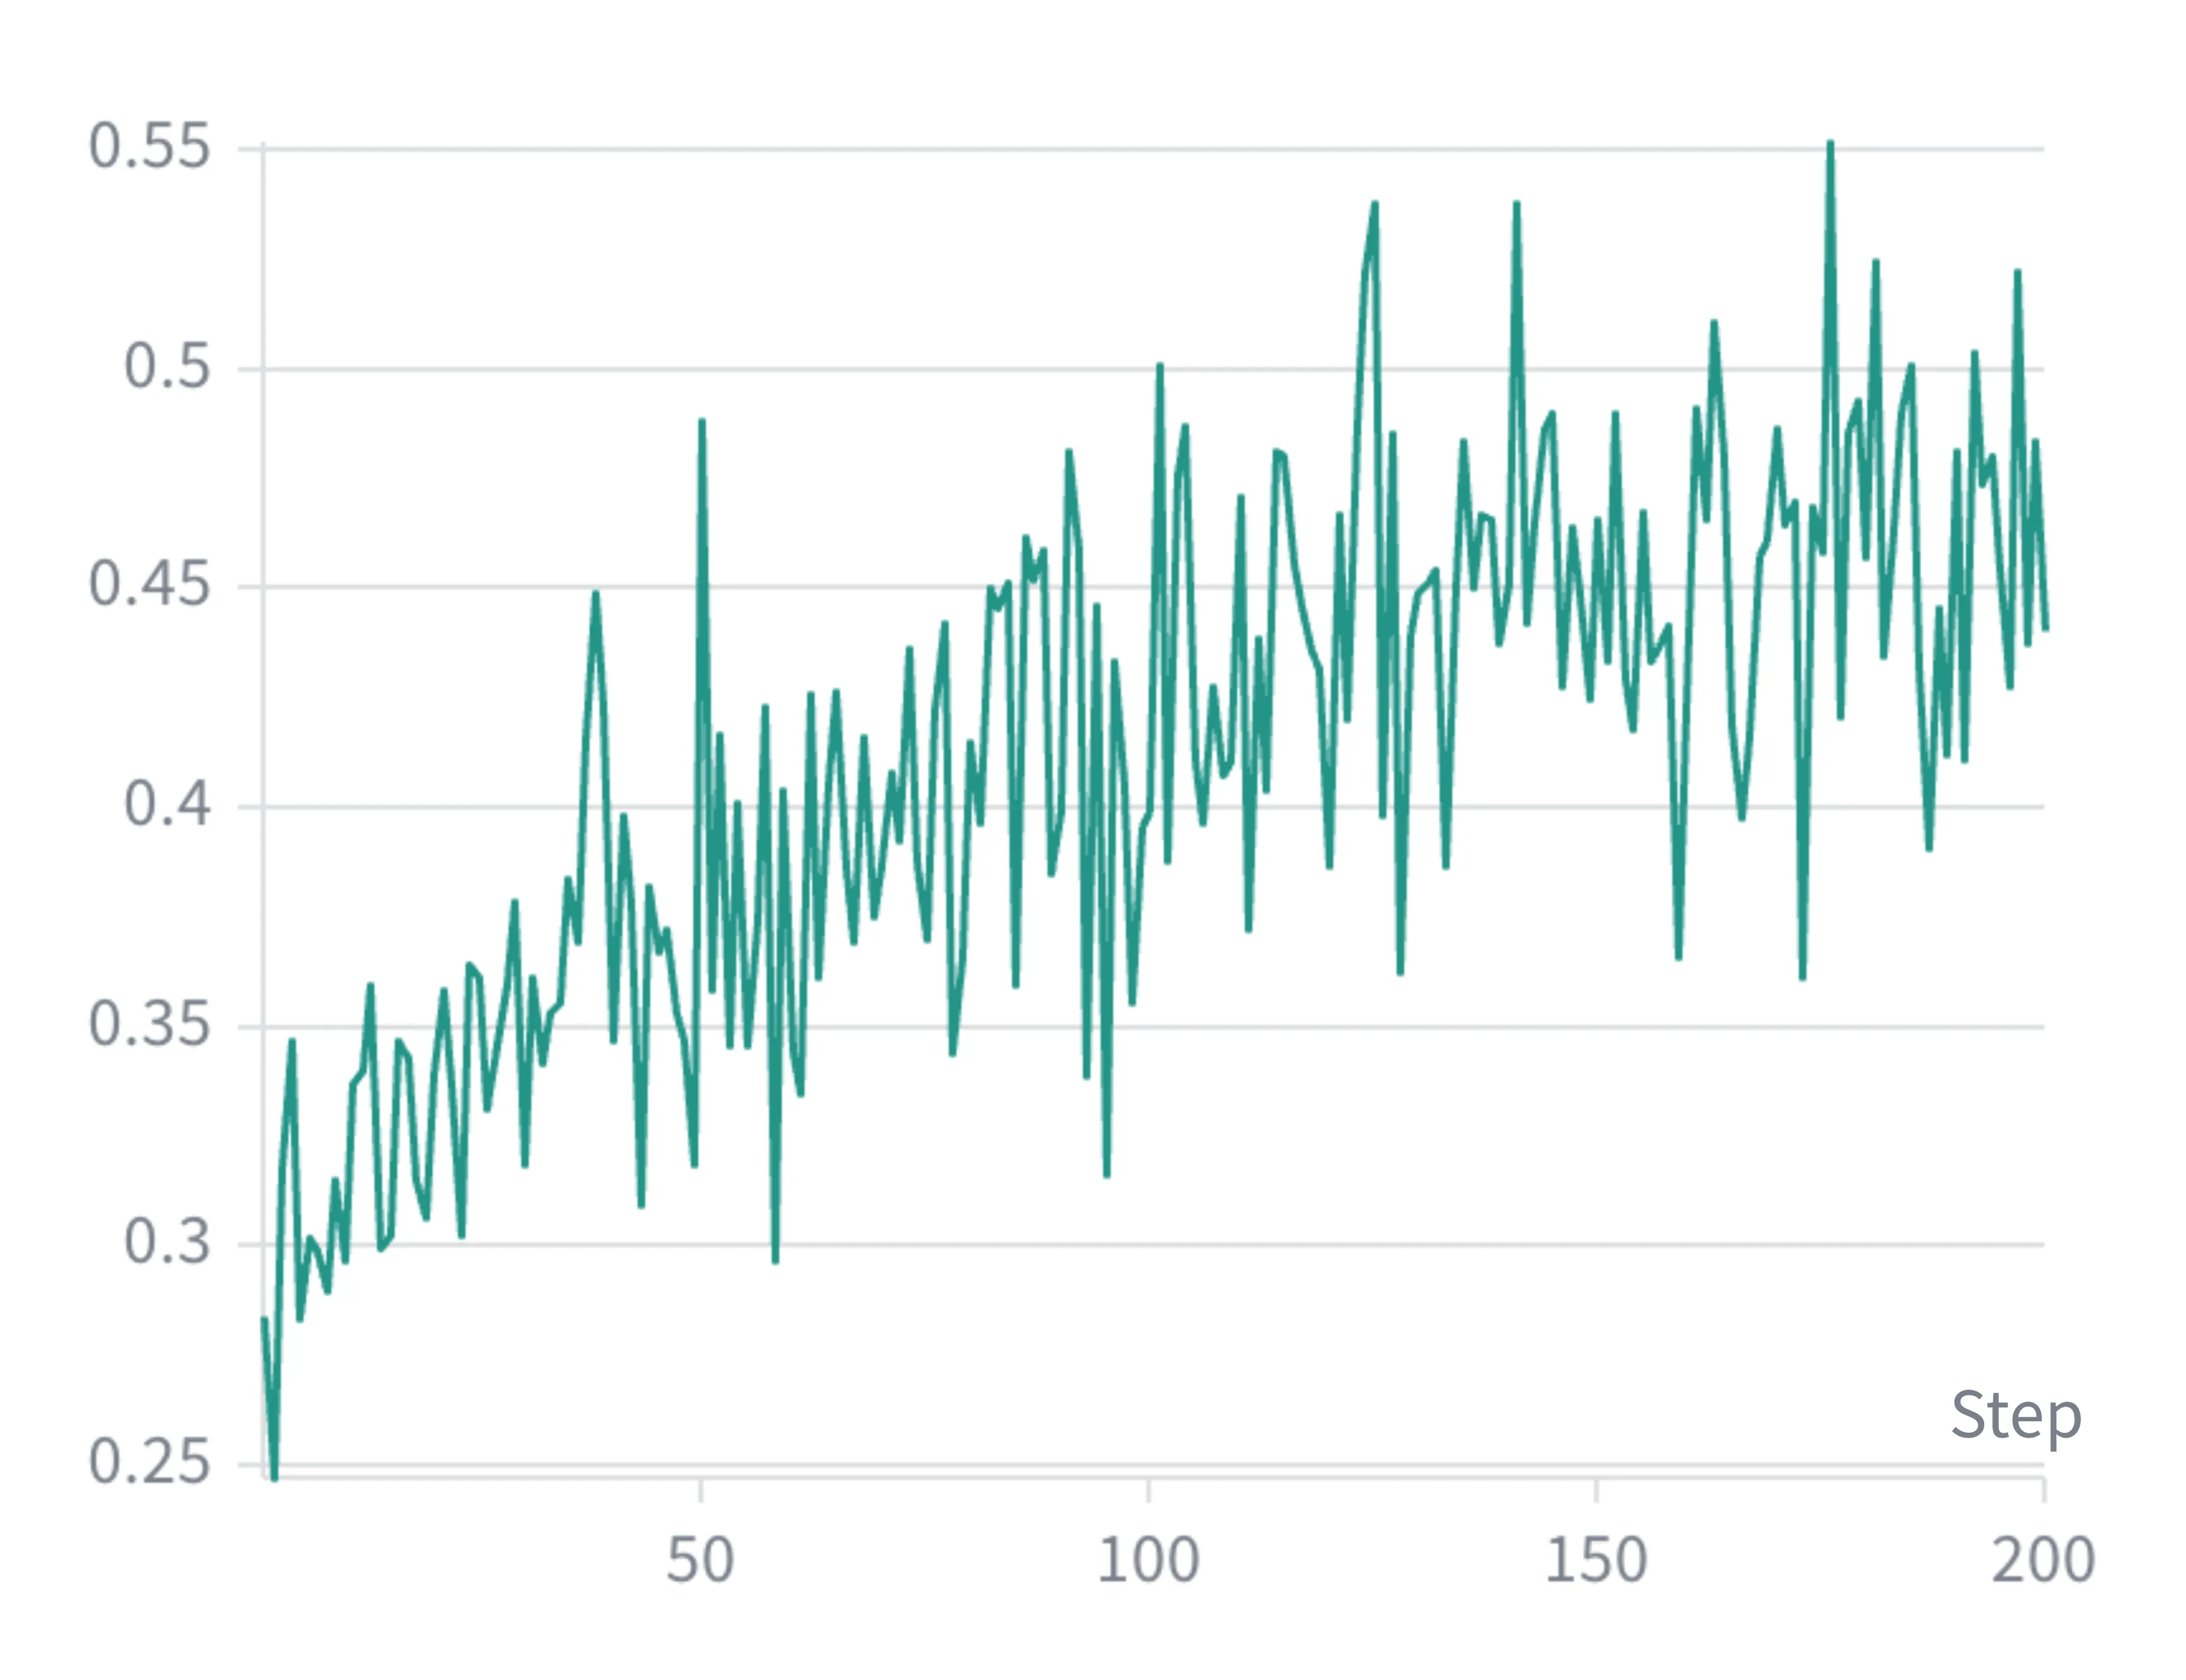
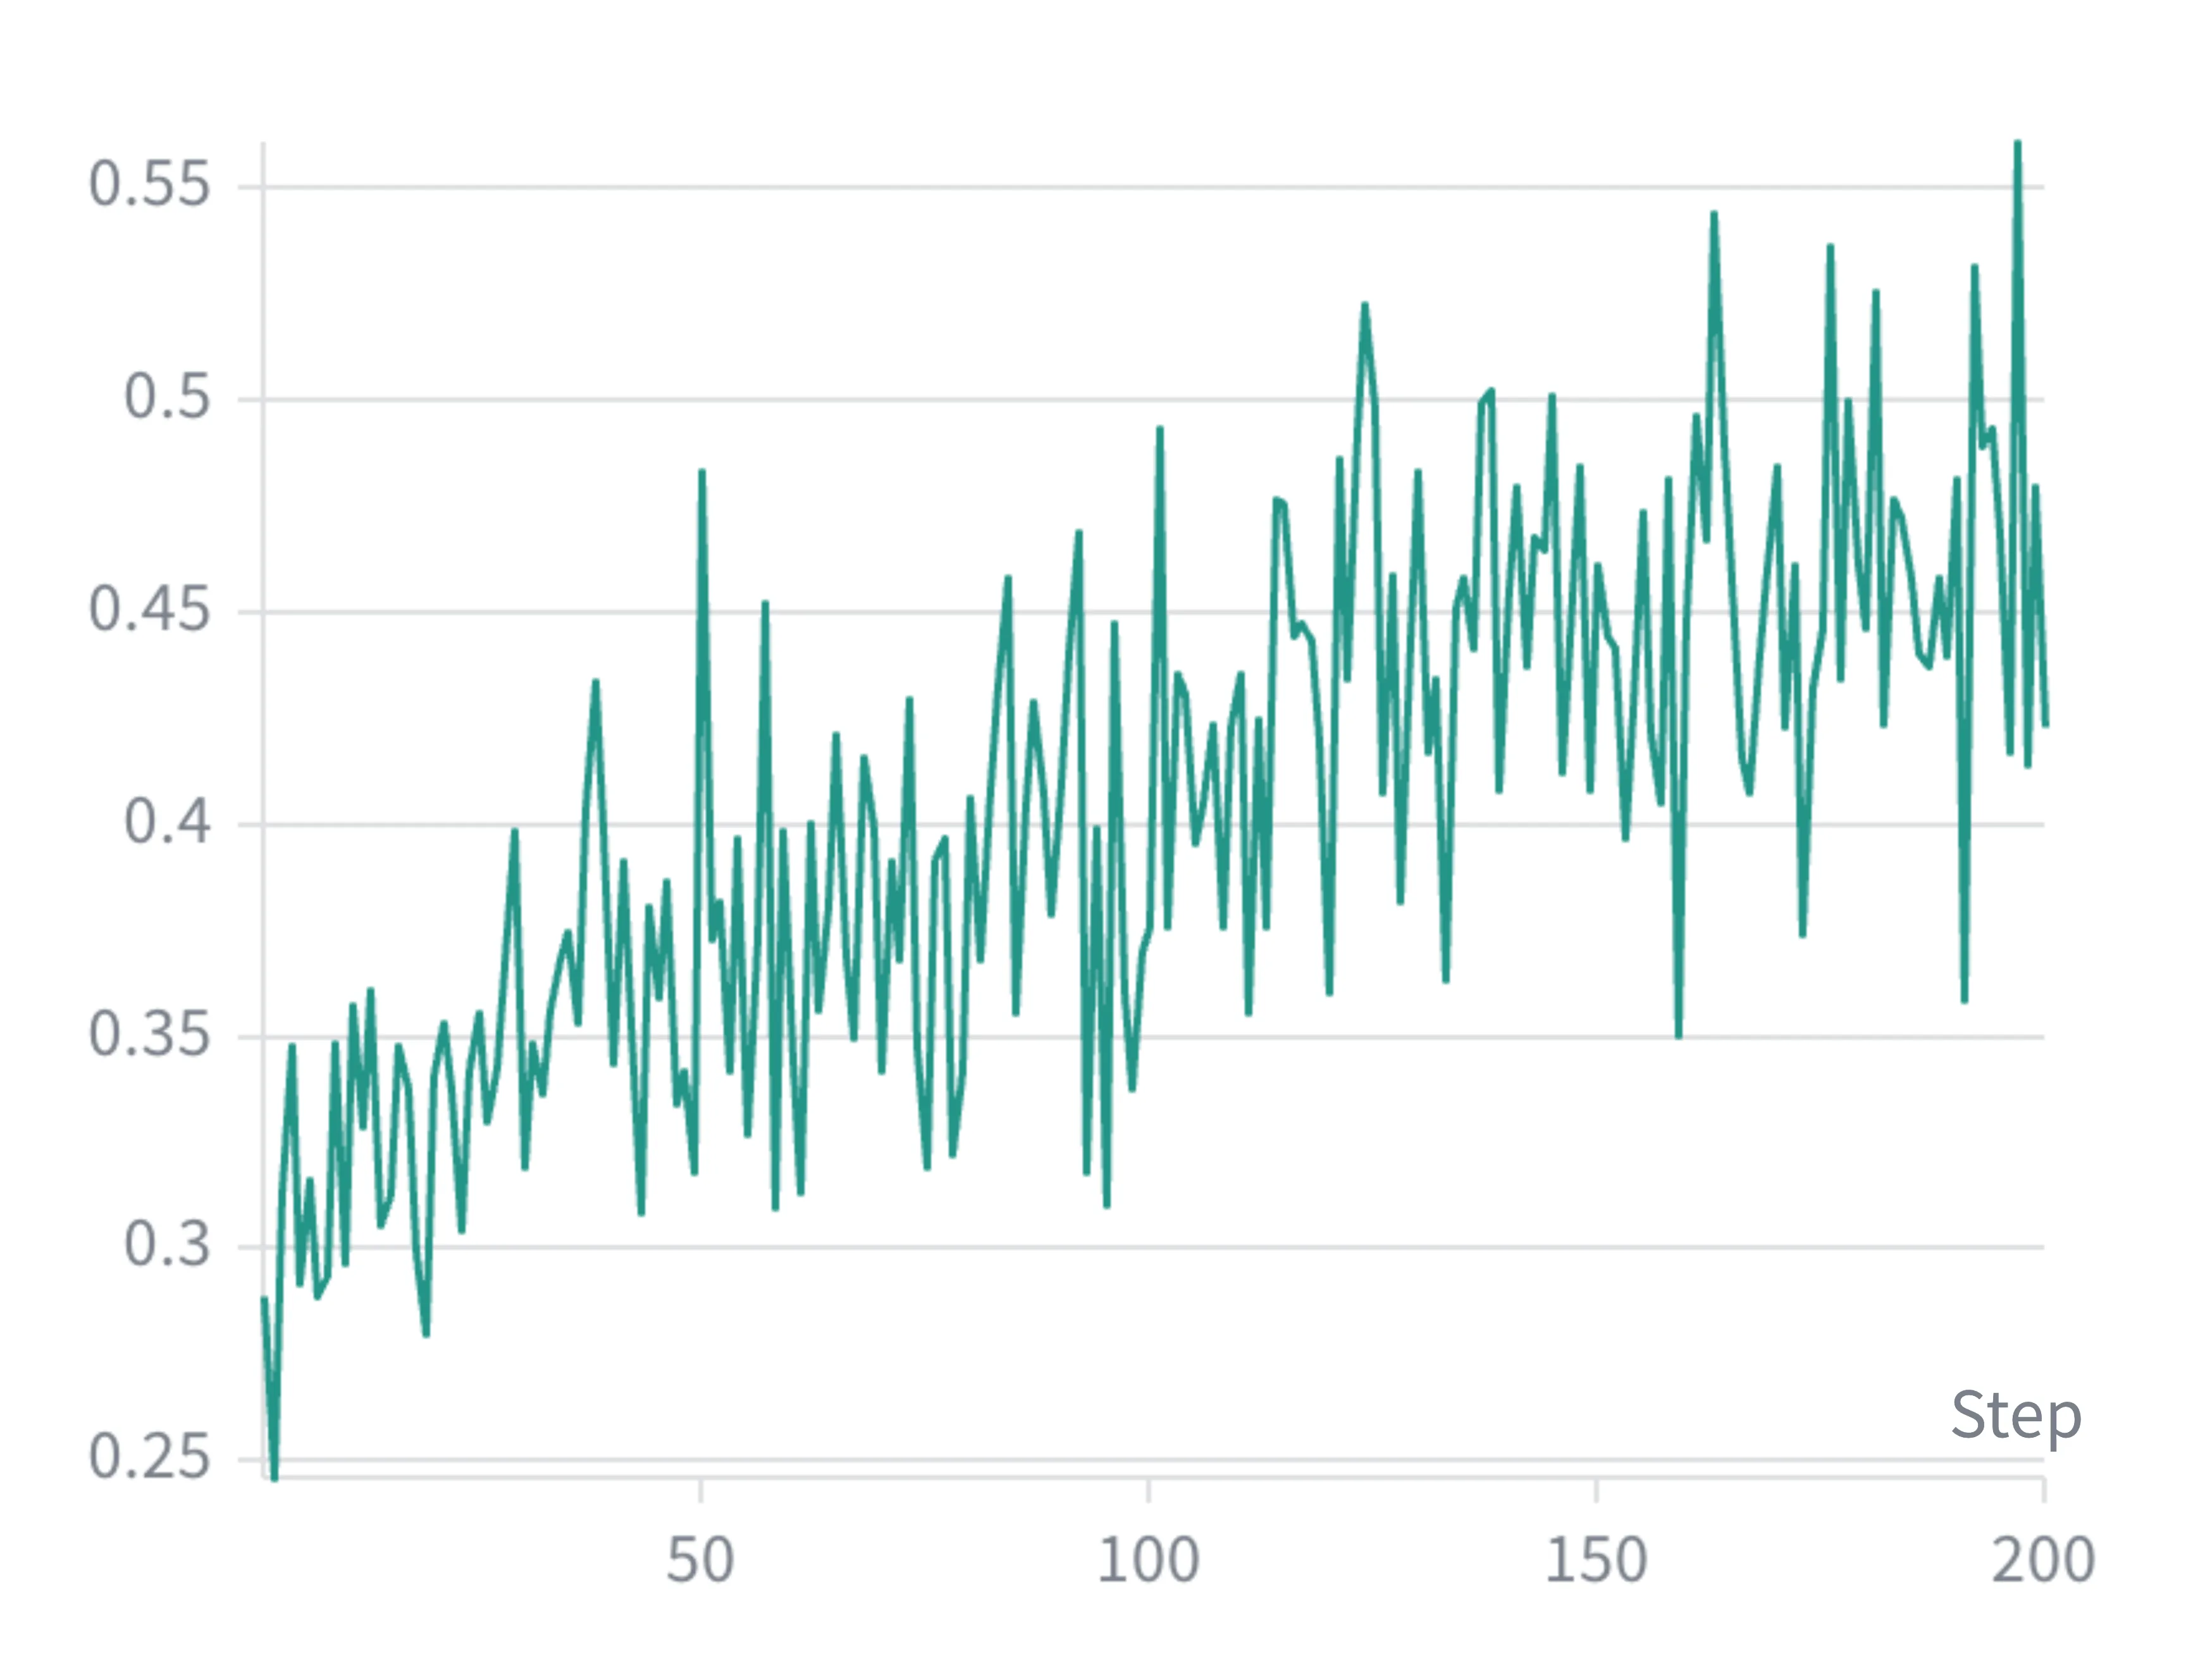
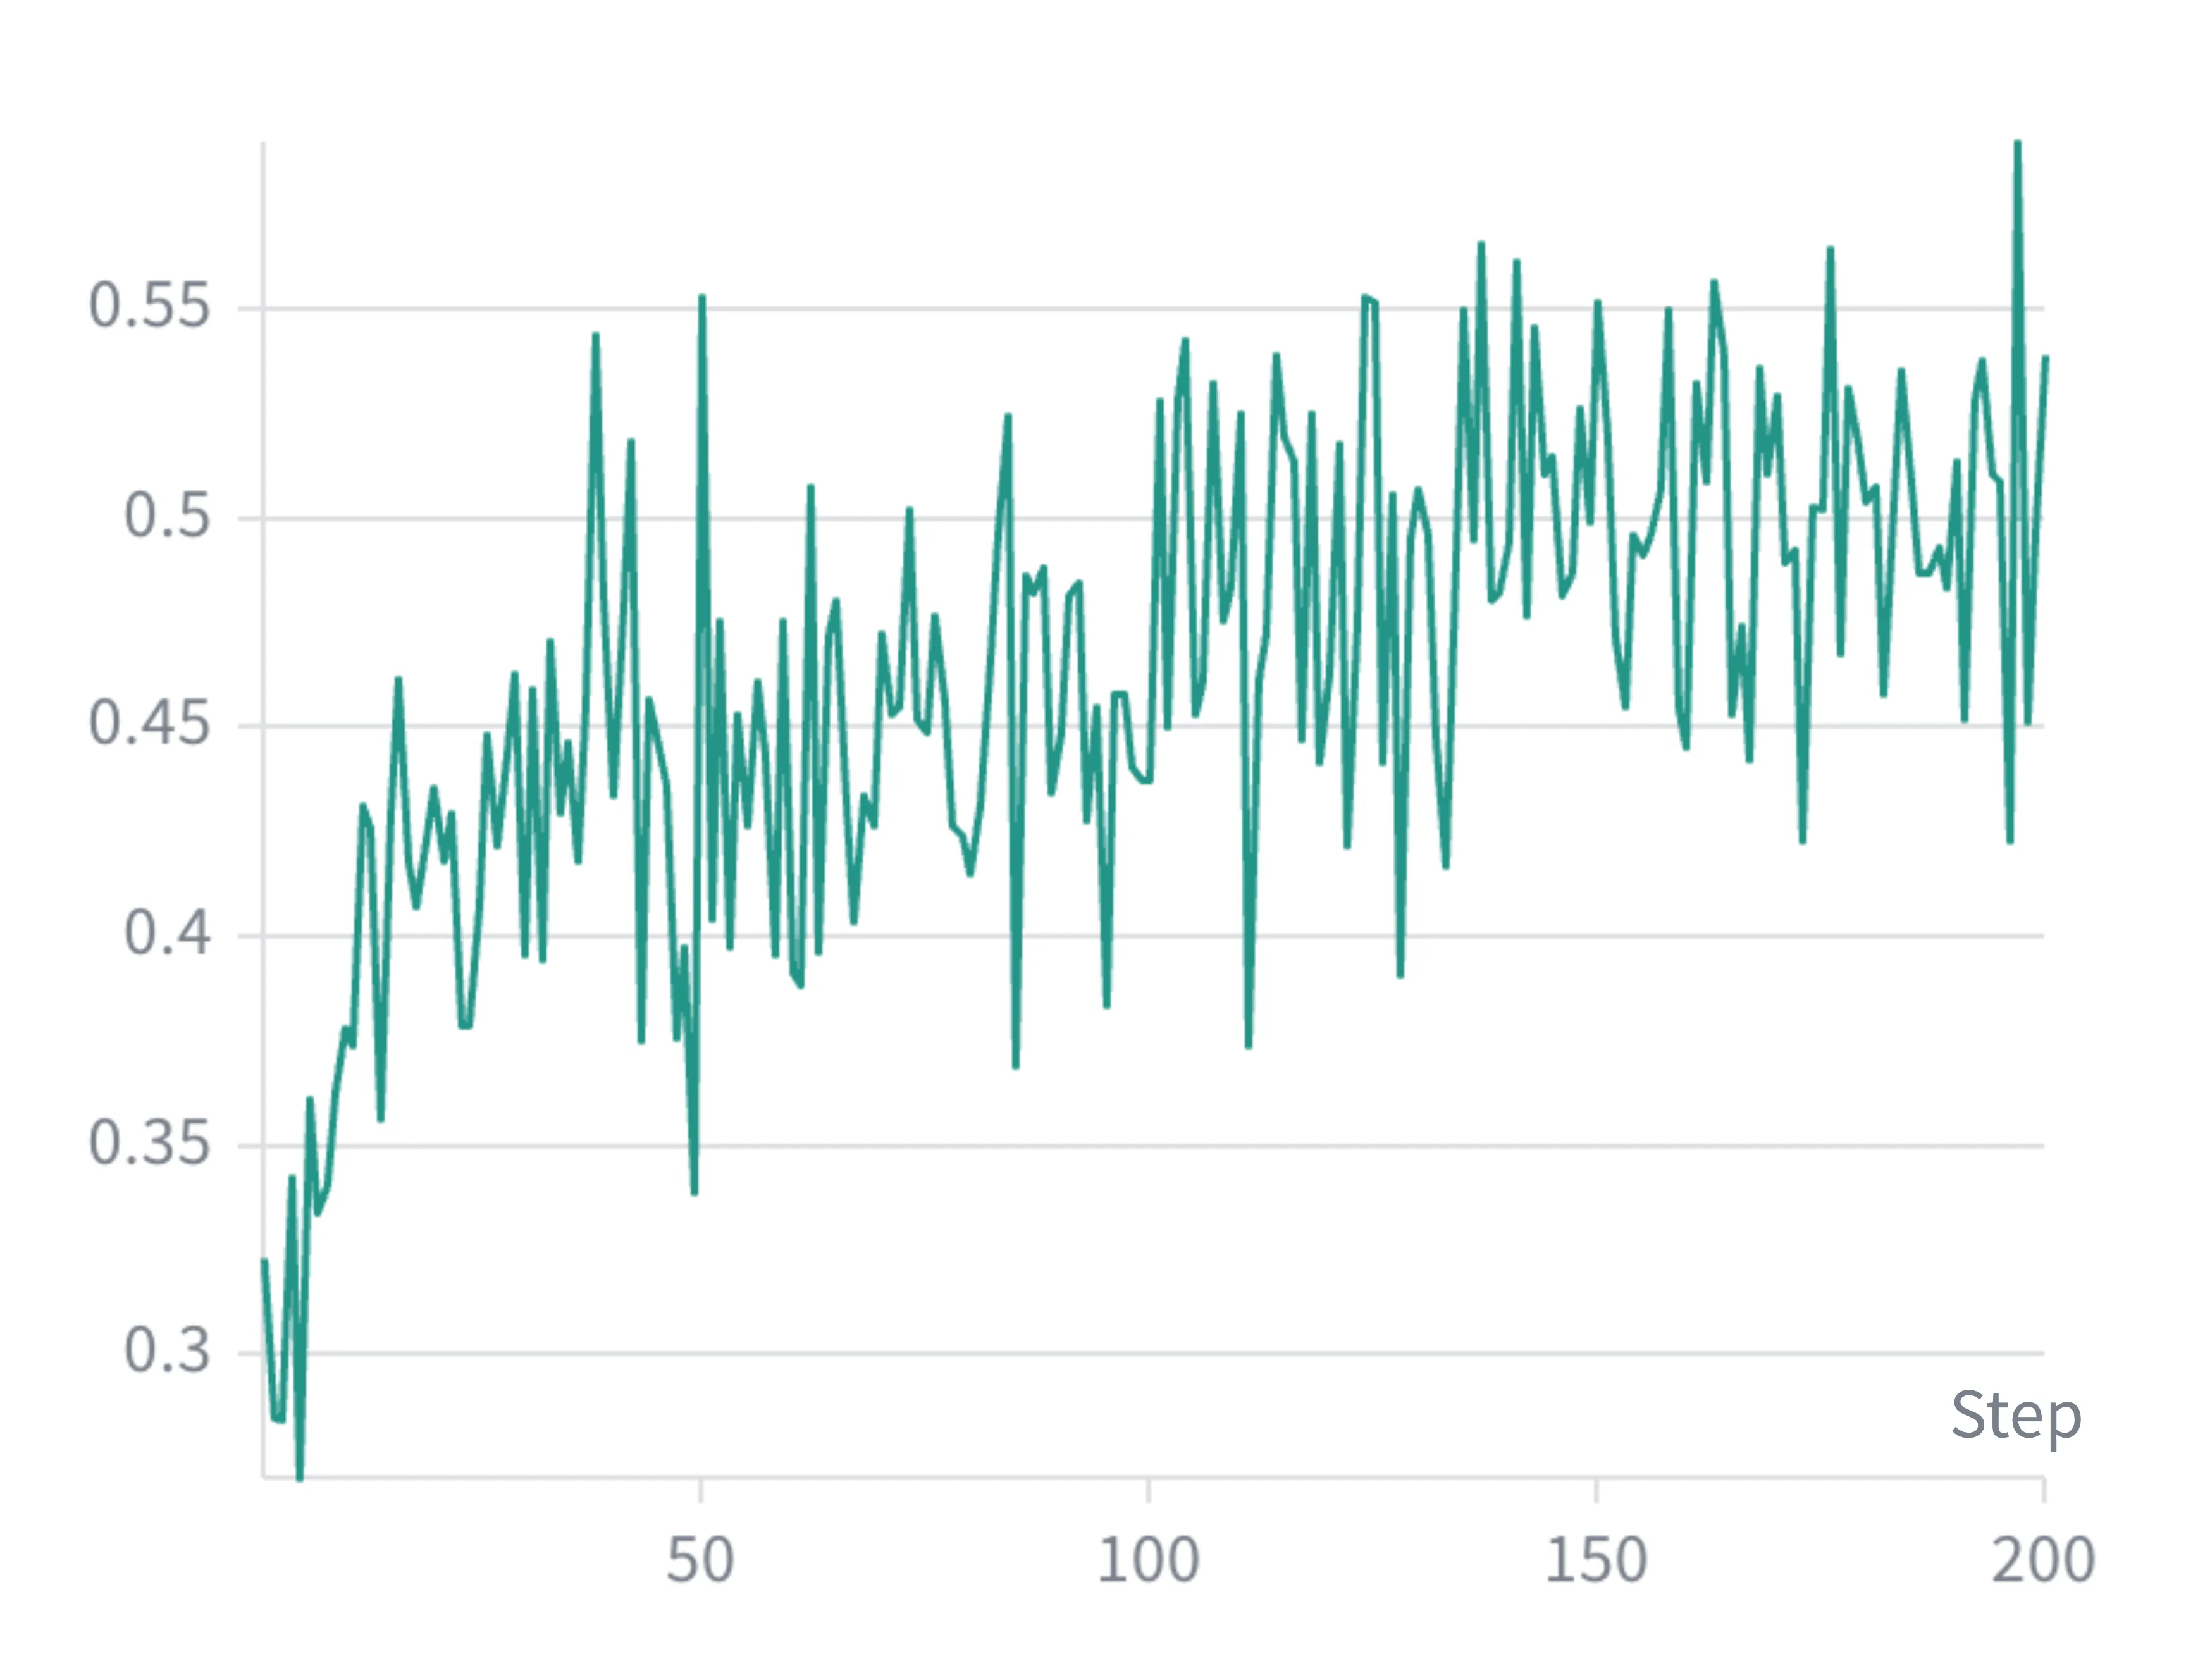
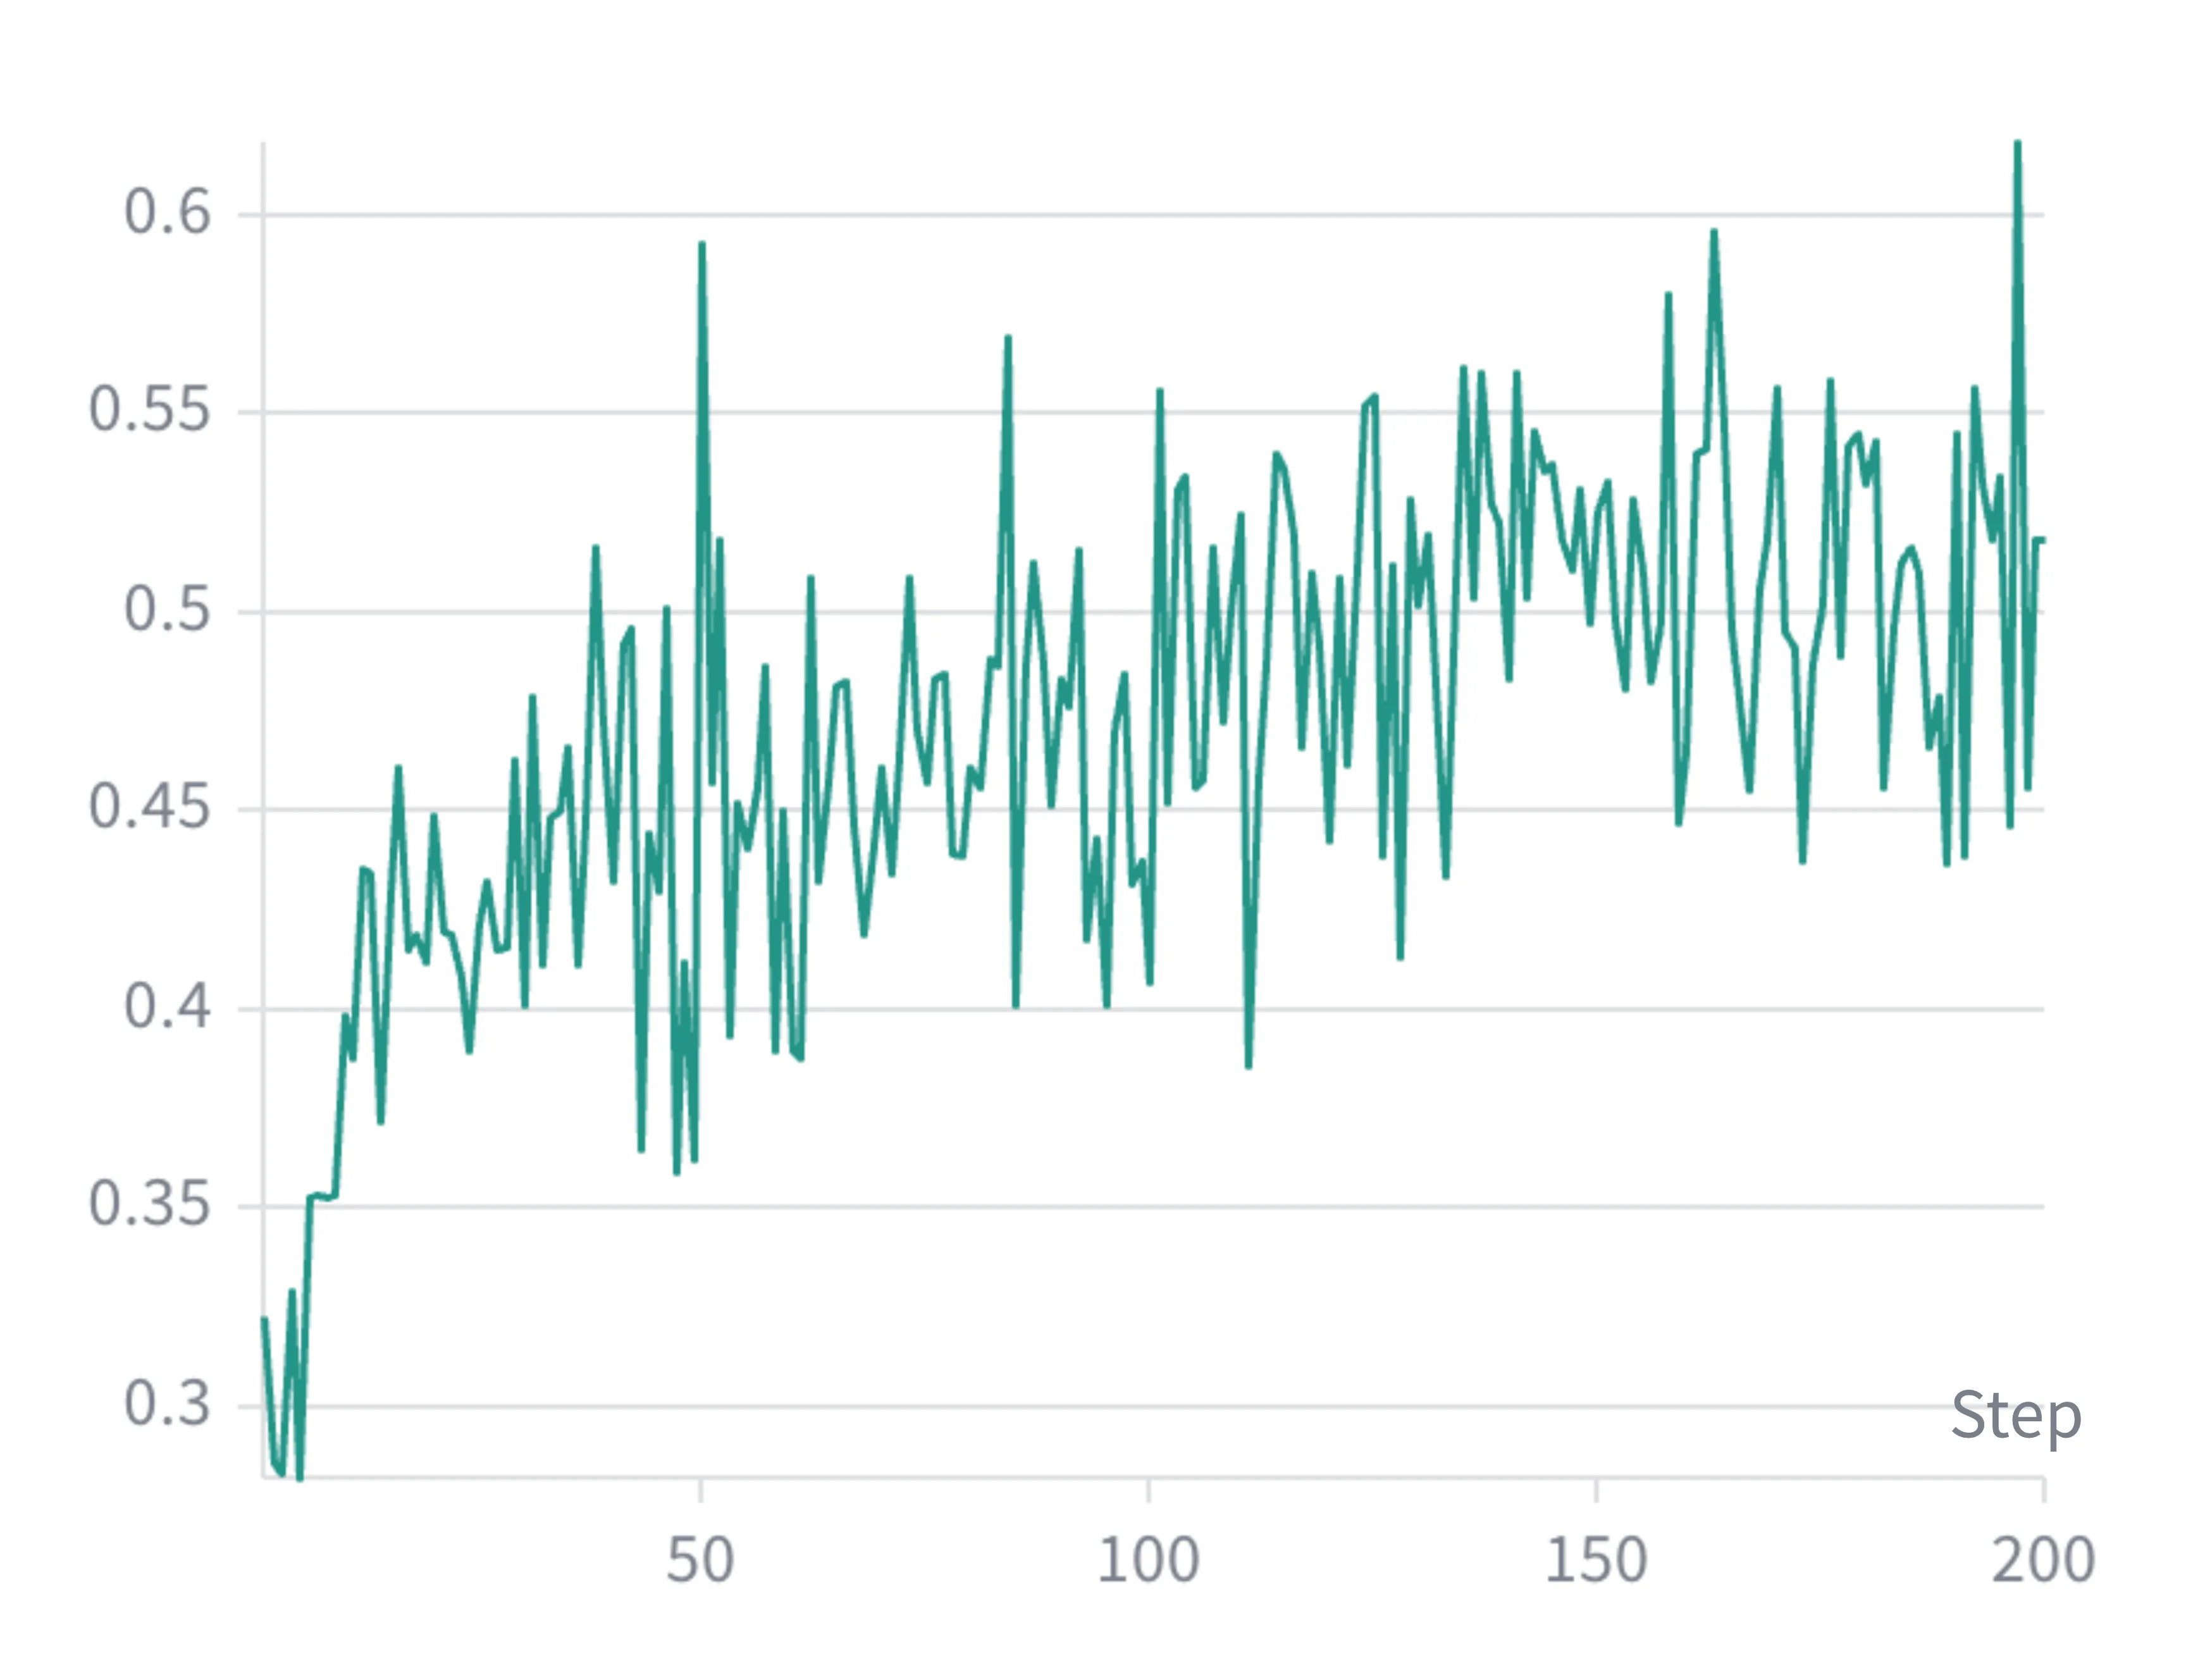

TL;DR
这篇论文针对大模型智能体搜索中的知识蒸馏难题,提出了多智能体协议蒸馏(MAPD)方法。它用结构化的 JSON 协议作为中间表征,将离线多智能体系统的探索轨迹转化为任务类型、推理计划和事实依据,在蒸馏过程中既保留了稠密的监督信号,又避免了风格漂移。实验在七个问答基准上验证了有效性,Qwen3-1.7B 达到 39.4%、Qwen3-4B 达到 44.4% 的平均成功率,且能跨不同专有教师模型稳定泛化。
研究背景与动机
大语言模型在解决知识密集型任务时,往往需要将多步推理与外部检索交替进行——这就是所谓的智能体搜索(agentic search)。这类任务要求模型不仅能生成连贯的推理链,还要在合适的时机调用检索工具获取最新或精确的知识。以往优化这类能力的主流方法是通过基于结果的强化学习(RL),即根据最终答案是否正确来给予奖励信号。然而,这种信号是极其稀疏的——模型只知道最终对了还是错了,中间每一步推理的质量完全得不到反馈。就像一个学生在做应用题时,只有分数没有批改,进步自然缓慢。
知识蒸馏提供了一条更直接的路径:用能力强大的专有模型(如 GPT-4)作为教师,传授推理能力给学生模型。但这条路走起来远没有听起来那么简单。传统的 logits 匹配(logit-matching)要求学生模型能访问教师模型的输出 logits——而专有模型根本不开放这个接口,不同模型使用的 tokenizer 也不兼容。更粗糙的做法是直接让学生的模仿教师输出的自然语言轨迹,但论文指出这只是在学表面文章——措辞风格、段落长度、格式模板,而非真正的推理能力。
除了蒸馏端的问题,还有一个更深层的矛盾:智能体搜索本身的轨迹质量高度不稳定。同一个查询,不同的检索顺序、不同的证据选择会导出完全不同的推理路径,有时甚至会走进死胡同需要回退重来。这种异质性使得轨迹本身就不适合作为简单的模仿目标。
方法
MAPD 的核心洞察是:蒸馏的目标不应该是让“学生模仿教师的说话方式”,而应该是让“学生习得教师推理过程中真正有价值的中间产物”。基于这一思路,MAPD 引入了一个精心设计的结构——协议(Protocol),以 JSON 格式作为教师与学生之间的中间表示。
整个流程分为两个阶段。
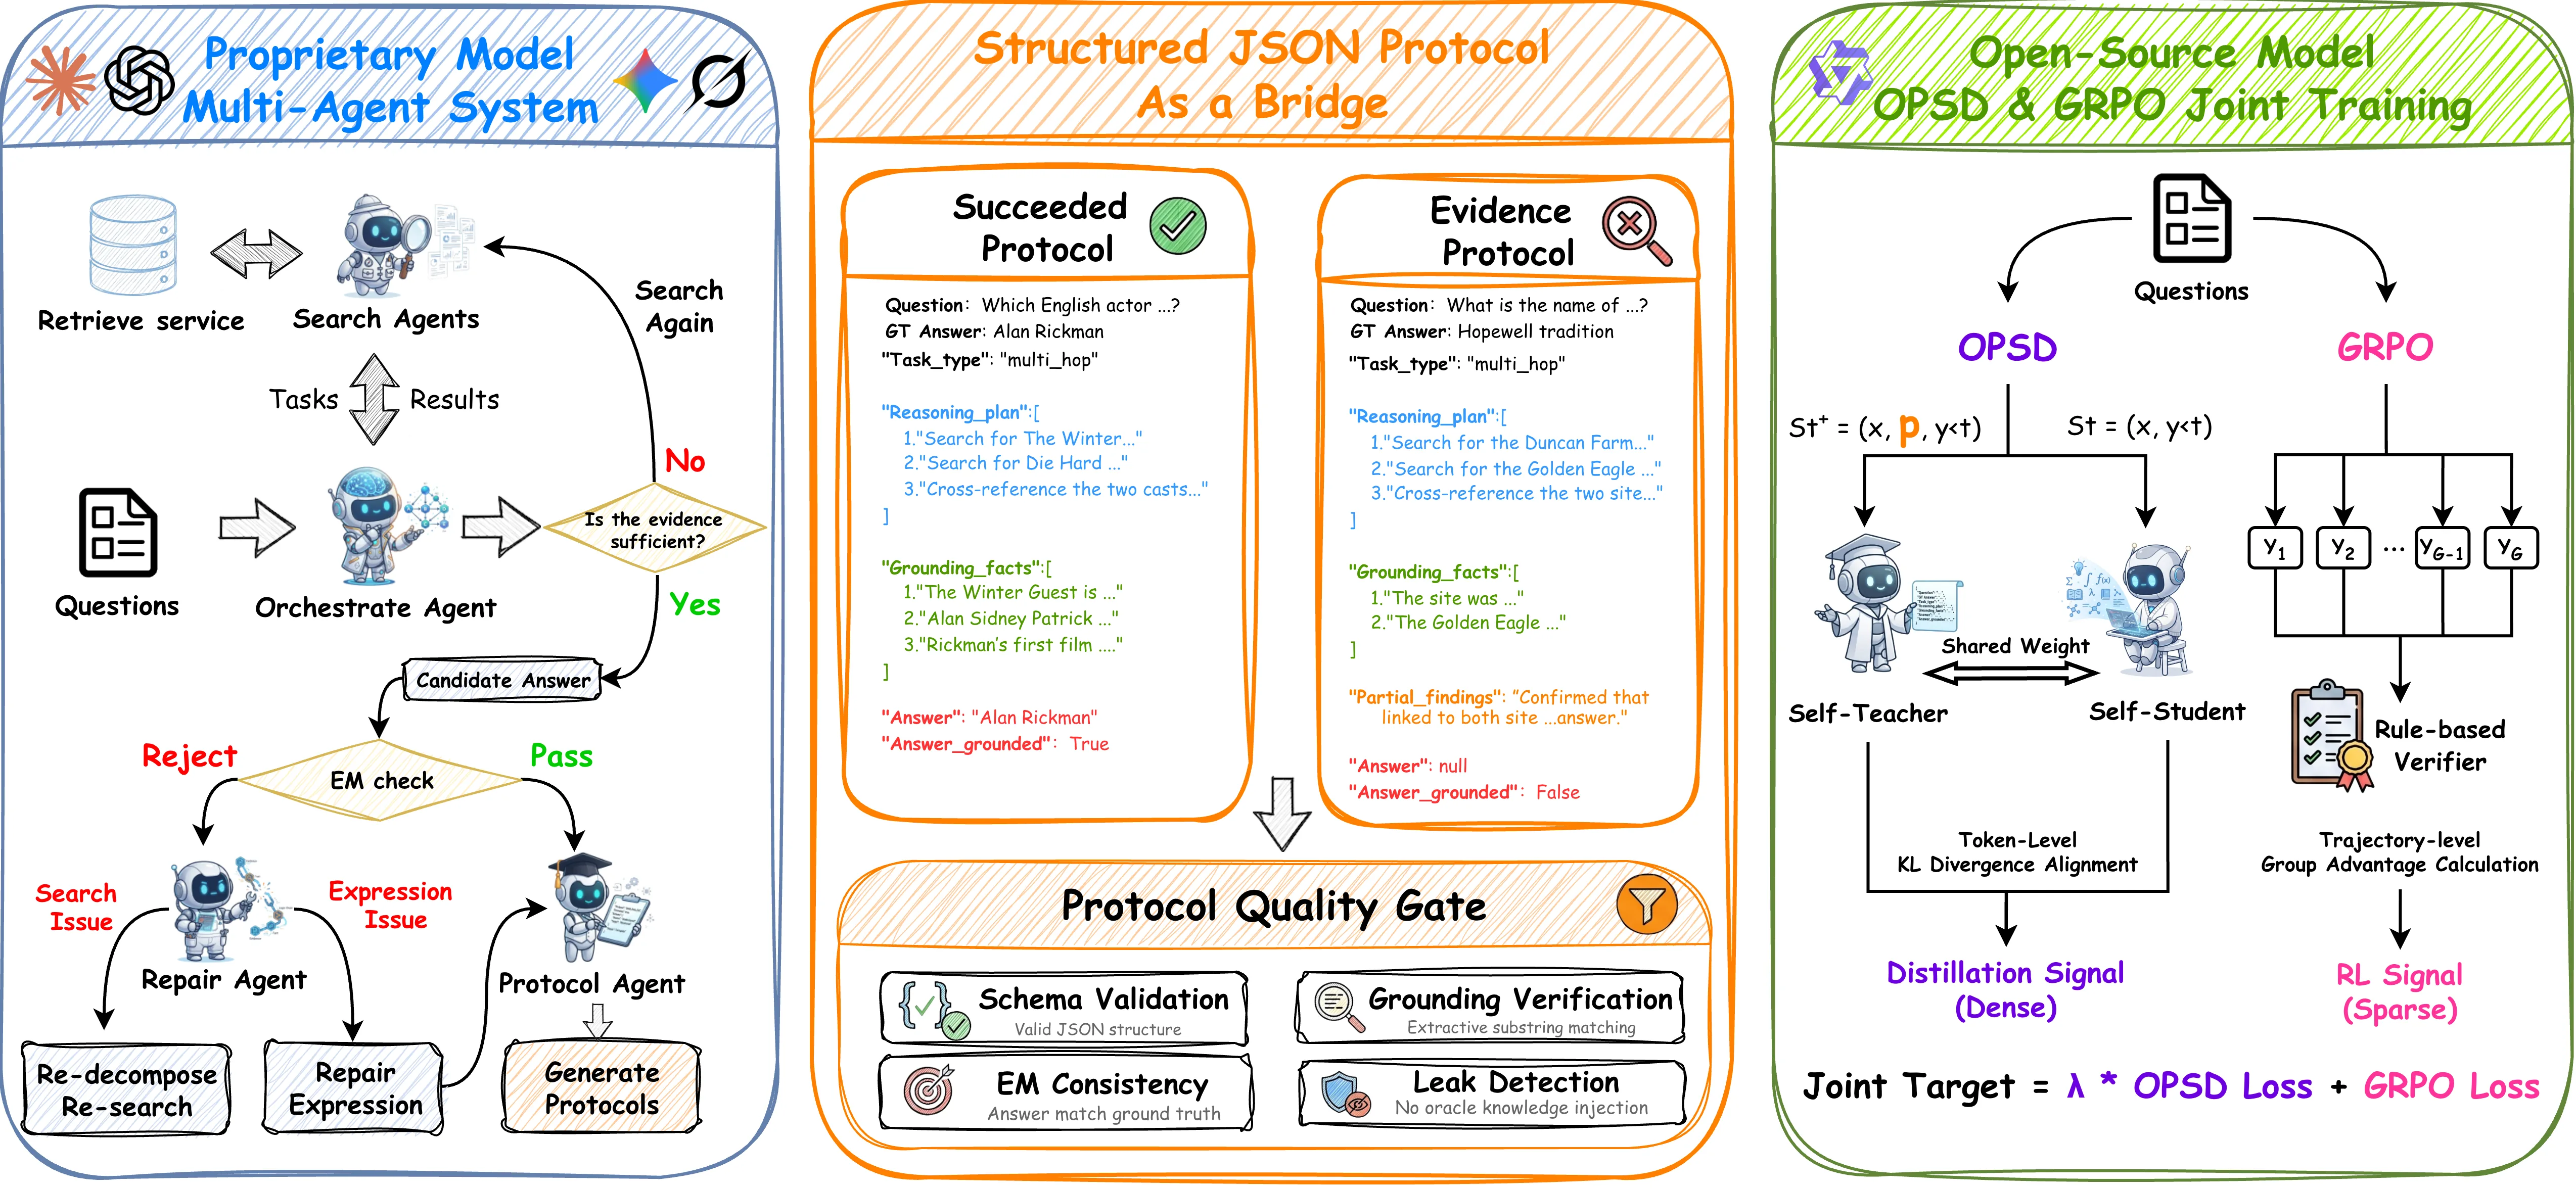
第一阶段是协议生成。 论文构建了一个离线多智能体系统(MAS),它不依赖在线的专有模型 API,而是使用已有的工具来模拟真实的智能体搜索过程。这个多智能体系统对每个用户查询做三件事:首先判断任务类型(是事实型问答、多跳推理还是比较型问题);然后制定一个分步骤的推理计划,明确每一步要检索什么、推理什么;最后从检索返回的文档中抽取支撑事实作为依据。最终这些信息被组织成一个 JSON 协议,其中包含 task_type(任务类型)、plan(推理计划列表,每个步骤包含工具调用指令和预期产出)、以及 grounding_facts(抽取的事实片段)。整个轨迹到协议的转换过程由 LLM 自动完成,相当于把一段混乱的自然语言探索过程翻译成了一张结构化的“施工蓝图”。
第二阶段是协议蒸馏训练。 这里的设计最为精妙。学生的策略模型被分成两条路径:一条是普通分支,接收用户查询后直接输出回复;另一条是特权分支(privileged branch),在输入中额外包含了由教师生成的协议。关键在于,协议仅作为输入上下文提供给学生模型,用于引导其分布向教师的推理结构靠拢,但学生模型输出的 token 序列本身并不包含协议内容——它只生成最终的答案和推理过程。
在训练目标上,MAPD 同时优化两个信号:一是稀疏的强化学习目标,即从最终答案正确与否给出的奖励;二是来自特权分支的稠密蒸馏信号——特权分支的 token 分布为普通分支提供了每一步应该如何思考的参考。由于协议的存在,这种蒸馏信号是结构化的:它不是一句一句地模仿教师的措辞,而是从任务类型和推理计划的层面告诉学生“遇到这类问题应该分几步走,每一步查什么、怎么用查到的信息”。这种抽象层次上的对齐,恰好避开了 tokenizer 不匹配和风格迁移的问题。
论文还特别强调了风格归一化(style-normalization)的重要性。在生成协议时,系统刻意抹去了自然语言轨迹中的冗余表述——删除重复的思考过程、冗长的自我对话和无关的上下文碎片,只保留推理的核心逻辑链。这一步是防止学生学到不必要风格偏好的关键。
实验与结果
实验在七个问答基准上进行,涵盖了单跳问答、多跳推理和长格式生成等多种任务类型。基线方法包括传统的 RL 优化(SFT + PPO)、直接轨迹模仿、以及几种已有的蒸馏方法。
核心结果方面,使用 Qwen3-1.7B 作为学生模型时,MAPD 达到了 39.4% 的平均成功率,相比基线方法有显著提升;当模型规模扩大到 Qwen3-4B 时,成功率进一步提升至 44.4%。特别值得注意的是,这些结果是通过从不同专有模型(GPT-4、Claude 等)蒸馏得到的,但协议层面的抽象表征使得训练好的学生模型对教师模型的来源并不敏感——换用不同教师生成的协议进行训练,最终性能差异在统计上不显著。这说明 MAPD 学到的是一种通用的推理策略,而非对某个特定教师风格的复刻。
在消融实验中,论文逐一验证了协议各组成部分的贡献。移除 task_type 后,模型在任务分类敏感的问题上性能下降最明显,说明任务类型判断为后续推理计划提供了重要的元认知指导;移除 plan 仅保留事实依据时,模型能给出正确答案但推理链不够连贯;而完整保留三项协议内容的模型在所有维度上均表现最优。此外,对比实验清晰地展示了风格归一化的效果:直接模仿自然语言轨迹的学生模型在训练后期出现了明显的冗长化退化——生成的文本越来越长但有用信息密度越来越低,而基于协议蒸馏的模型始终保持精炼的输出。
讨论与可借鉴点
MAPD 最有价值的贡献或许不在于某个具体的技术模块,而在于它提出的一种设计哲学:将“风格”与“能力”解耦后分别蒸馏。传统的蒸馏方法试图让学生完整复现教师的输出,而 MAPD 认识到真正值得传递的不是教师怎么说,而是教师怎么想——推理的结构和逻辑骨架才是核心,措辞和格式只是外在表现形式。这一思想对于其他存在风格异质性的蒸馏场景(如代码生成、数学推理)同样具有启发意义。
协议作为中间表示的设计还带来了一个副产品:可解释性。由于协议中明确记录了任务类型和推理计划,我们可以直接检查模型决策背后的逻辑链条,而不只是看最终答案对不对。这对于需要审计和调试的场景非常有价值。
当然,MAPD 也有其局限。首先,协议生成依赖一个离线多智能体系统,如果该系统本身在某些复杂任务上能力不足,生成的协议质量就会成为瓶颈。其次,协议的结构需要人工定义——论文使用了固定的 JSON schema,但对于不同领域可能需要重新设计。更大的开放问题是:这种协议层面的蒸馏能否泛化到没有检索环节的纯推理任务上?还是说它本质上依赖于“检索-推理交错”这一特定任务结构?
从更宽的视角看,这篇论文回应了一个正在变得越来越重要的问题:当模型能力越来越强但部署成本越来越高时,如何高效地将强大模型的能力迁移到更小、更经济的模型上?MAPD 给出的答案——结构化协议作为桥梁、结合强化学习的稠密信号——提供了一条有前景的思路,值得在更多样的任务和模型组合上进一步验证。
摘要
智能体搜索通过将多步推理与检索交错进行,使大语言模型能够解决知识密集型任务,然而使用基于结果的强化学习(RL)进行优化只能提供稀疏的监督信号。知识蒸馏可以提供更稠密的指导,而具有强大推理能力的先进专有模型是有潜力的教师模型。虽然从专有模型蒸馏可以增密这种监督信号,但传统的 logits 匹配方式由于隐藏的 logits 和不匹配的 tokenizer 而无法实施;而原始的自然语言轨迹模仿传递的是浅层的风格化表象,而非核心的推理能力。为解决异构蒸馏问题并弥合分布差距,我们提出了多智能体协议蒸馏(MAPD),这是一个将蒸馏与强化学习相结合的联合框架,使用结构化的、风格归一化的协议作为中间表示。一个离线多智能体系统(MAS)对每个查询进行分解,检索支持证据,修复失败的搜索,并将得到的探索轨迹转换为包含任务类型、推理计划和抽取式事实依据的 JSON 协议。在训练过程中,该协议仅被提供给学生策略的一个特权分支,其 token 分布与稀疏的强化学习目标共同提供稠密的蒸馏信号。在七个问答基准测试上的广泛评估表明,MAPD 始终优于现有的蒸馏和强化学习方法,在 Qwen3-1.7B 上达到了 39.4% 的平均成功率,在 Qwen3-4B 上达到了 44.4%。至关重要的是,该框架在不同的专有教师模型之间具有鲁棒的泛化能力,同时有效缓解了学生策略的风格漂移与冗长化退化问题。
Abstract
Agentic search enables large language models to solve knowledge-intensive tasks by interleaving multi-step reasoning with retrieval, yet optimizing this with outcome-based reinforcement learning (RL) provides only sparse supervision. Knowledge distillation can supply denser guidance, and advanced proprietary models with their strong reasoning capabilities are promising teachers. While distilling from proprietary models can densify this supervisory signal, conventional logit-matching is precluded by hidden logits and mismatched tokenizers, whereas raw natural language trajectory imitation transfers superficial stylistic artifacts rather than core reasoning competence. To address the heterogeneous distillation problem and bridge the distribution gap, we propose Multi-Agent Protocol Distillation (MAPD), a joint distillation and RL framework uses a structured, style-normalized protocol as an intermediate representation. An offline multi-agent system (MAS) decomposes each query, retrieves supporting evidence, repairs failed searches, and converts the resulting exploration trace into a JSON protocol containing the task type, reasoning plan, and extractive grounding facts. During training, the protocol is provided only to a privileged branch of the student policy, whose token distributions furnish a dense distillation signal alongside the sparse RL objective. Extensive evaluations across seven QA benchmarks demonstrate that MAPD consistently outperforms competitive distillation and RL, achieving average success rates of 39.4\% on Qwen3-1.7B and 44.4\% on Qwen3-4B. Crucially, the framework generalizes robustly across diverse proprietary teachers while effectively mitigating the student policy from style drift and verbosity degeneration.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。