
ACRL:自适应控制训练-推理差异以实现稳定的强化学习
ACRL: Adaptive Control of Training-Inference Discrepancy for Stable Reinforcement Learning
📝 TLDR
针对大语言模型强化学习训练中由训练与推理引擎的架构分离及精度差异导致的不稳定问题,本文提出自适应控制强化学习方法ACRL。该方法在训练过程中实时监测并动态调控训练-推理差异,使其维持在合理范围内,兼顾训练稳定性与策略熵提升以增强探索。在FP8量化推理场景的实验表明,ACRL能稳定RL训练,精度匹配BF16基线并优于重要性采样修正方案。
🧭 速览
LLM强化学习训练中,训练引擎与推理引擎的架构分离及低精度量化差异导致显著的训练-推理不一致,引发训练不稳定。
ACRL在训练中实时感知并自适应调控训练-推理差异,使其收敛至合理区间,天然提升策略熵以增强探索能力。
FP8推理场景下ACRL稳定了RL训练过程,最终精度匹配BF16基线水平,并优于传统重要性采样修正方案。
ACRL通过自适应控制训练-推理差异,为低精度推理部署下的LLM强化学习训练提供了一种稳定且有效的通用方案。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 17 张)
展开查看 17 张图
TL;DR
大语言模型强化学习训练中,训练引擎与推理引擎之间的架构差异以及量化精度不一致会导致严重的训练不稳定问题。ACRL(自适应控制强化学习)通过在训练过程中实时监测训练-推理差异,并按四象限规则动态调控策略梯度,使差异收敛到合理区间。实验表明,在 FP8 量化推理场景下,ACRL 不仅能稳定训练过程,还能达到甚至超越 BF16 基线的精度,同时计算开销可忽略不计。
研究背景与动机
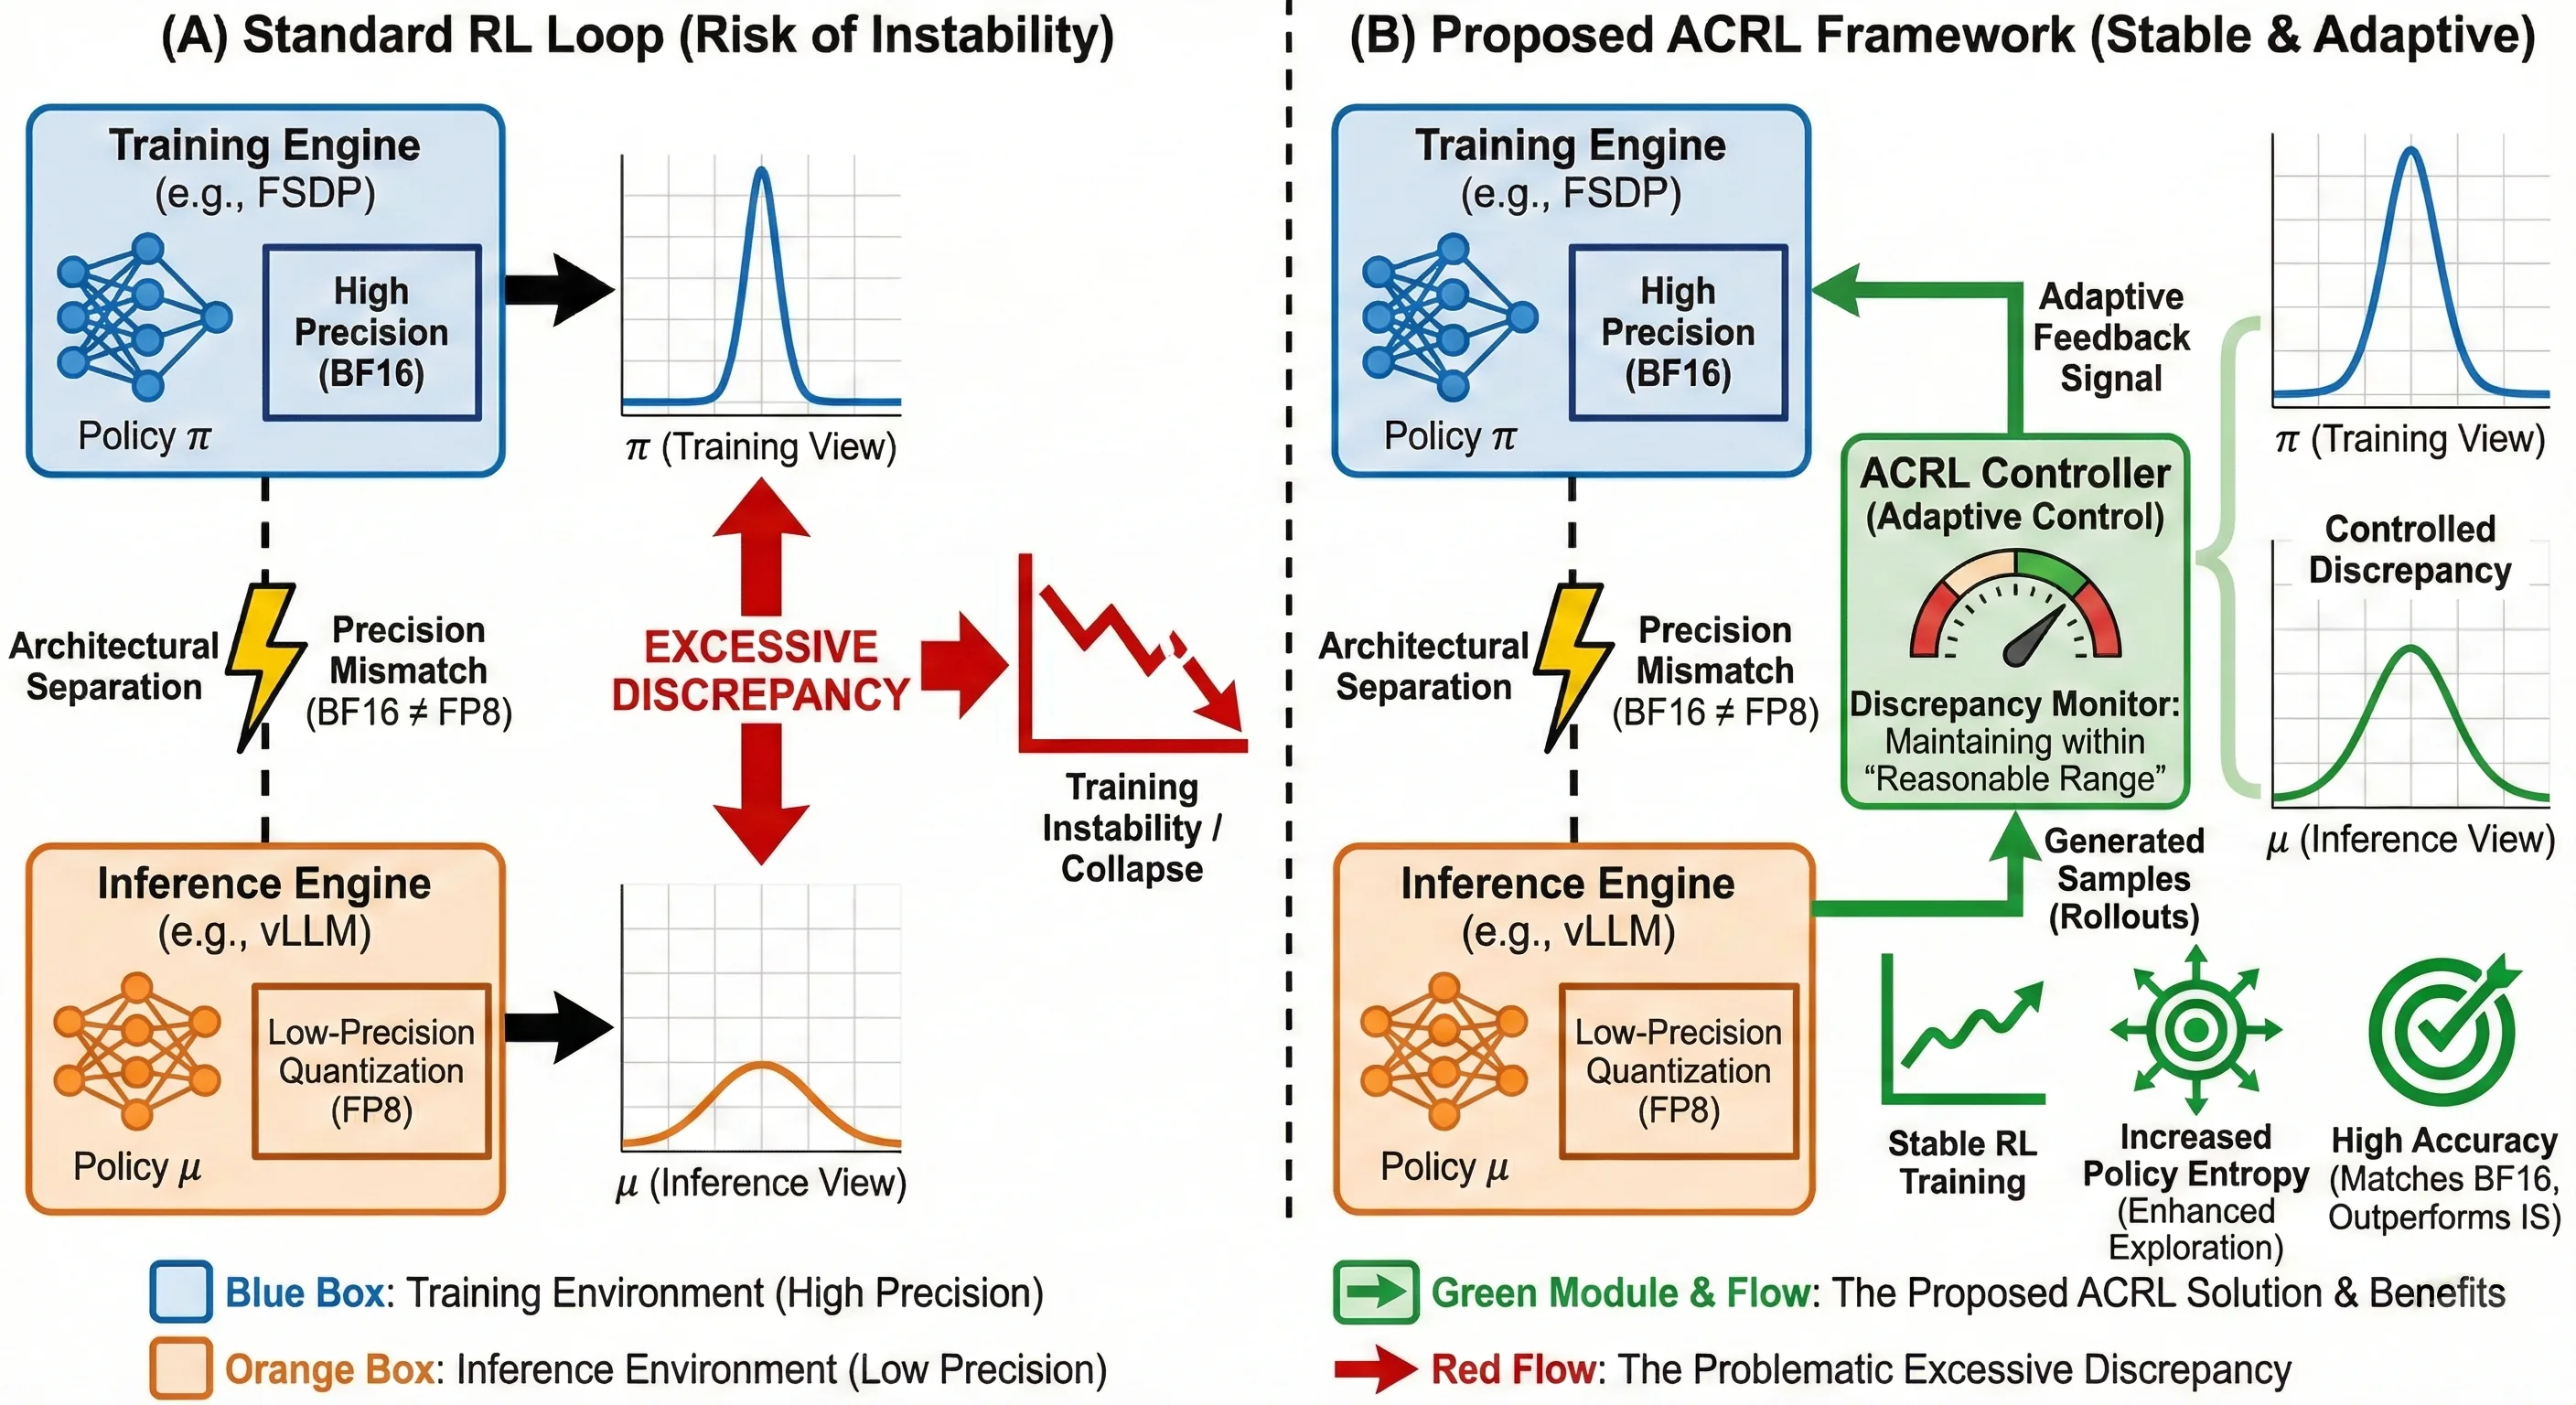
大语言模型的对齐训练正越来越多地依赖强化学习方法,无论是 GRPO、PPO 还是 DAPO,都需要在训练过程中反复采样、评估和更新策略。然而,现代 RL 训练框架普遍采用训练与推理解耦的架构:训练侧使用 FSDP 或 Megatron 进行高精度计算,推理侧则调用 vLLM、SGLang 等推理引擎生成样本。这种架构分离虽然提升了资源利用率,却也埋下了不稳定的种子。
训练-推理差异主要来自两个层面。架构层面的差异相对隐蔽——训练引擎与推理引擎即使运行相同的模型权重,其底层算子实现、并行策略、CUDA 内核选择也可能存在细微差别。这些差异在单次前向传播中几乎不可察觉,但在强化学习的循环采样过程中会逐渐累积。精度层面的差异更为直接:推理侧为追求效率普遍采用 FP8、MXFP8 或 INT8 等低精度量化,而训练侧为保证梯度精度仍使用 BF16,两者的概率分布会产生系统性偏移。当这种偏移在 roll-out 循环中反复放大,模型行为会逐渐偏离训练目标,最终导致训练崩溃或精度显著下降。
针对这一问题的现有方案各有缺陷。重要性采样(IS)修正思路下,Token 级截断 IS(TIS)会引入有偏梯度估计,方差较大;序列级掩码 IS(MIS)则更为激进——在高差异场景下,单序列的整体重要性比会降至 量级,导致梯度几乎完全消失。精度对齐方案要求推理侧也使用 BF16 或 FP16 精度,这直接牺牲了低精度推理的效率收益,且无法应对架构分离带来的差异来源。
本文的核心洞察在于:训练-推理差异既非越小越好,也非越大越坏,关键在于将其维持在合理范围内。因此,ACRL 摒弃了被动修补的思路,转而建立一套主动调控差异的闭环机制。
方法
ACRL 的设计哲学是将训练-推理差异视为一个可观测、可调控的变量,而非需要消除的噪声。其核心包含差异度量、参考值设定和自适应梯度调整三个环节。
首先需要量化差异。对于给定序列中的第 个 token 在第 步,定义训练策略与推理策略的概率绝对距离:
其中 为训练引擎给出的概率分布, 为推理引擎给出的概率分布。这一度量直接反映了两套系统在 token 级决策上的分歧程度。
参考值 是调控的目标锚点。论文选择训练第 0 步时计算的平均差异作为基线:
这个设计假设在训练初期,模型尚未受到差异累积的影响,此时的差异水平可视为"自然状态",应当被维持而非消除。
关键在于 ACRL 的自适应梯度调整机制。在标准 PPO/GRPO 的裁剪目标基础上,ACRL 引入了自适应权重 来调控每个 token 的梯度贡献:
其中重要性比率 ,自适应指数定义为:
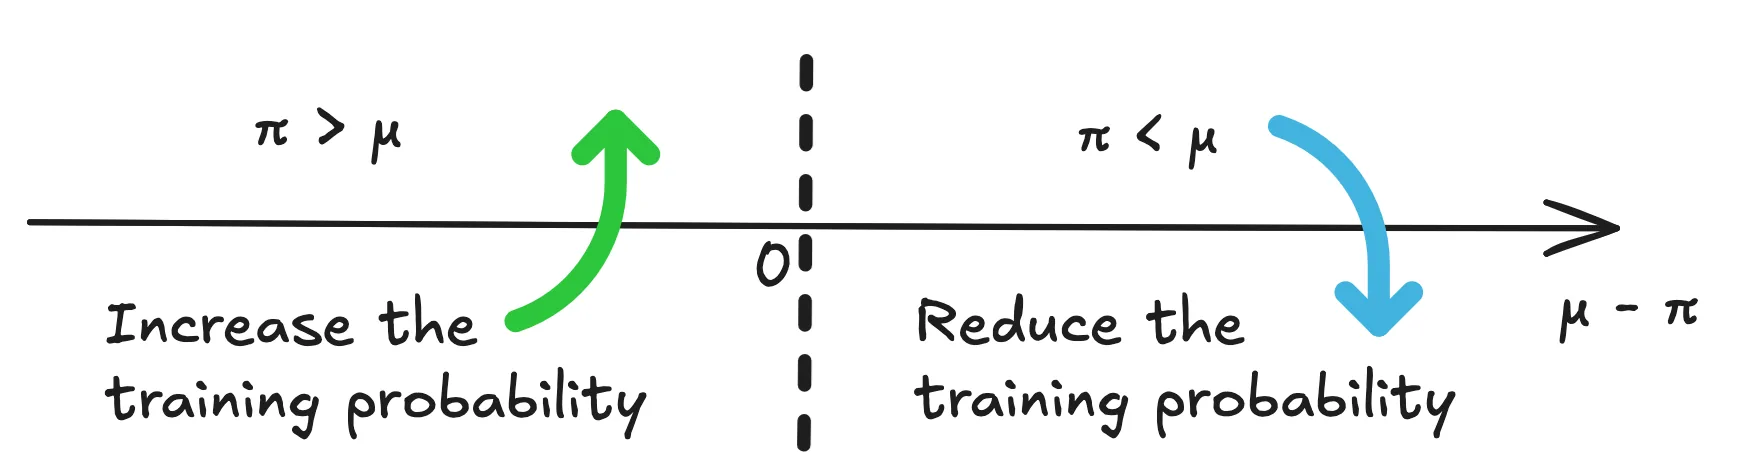
这里的 控制调控强度, 是截断阈值, 表示当前序列级的训练-推理差异, 是优势函数。 的符号与幅度同时编码了调控方向(当前差异 相对于参考值 的偏离)和调控强度。
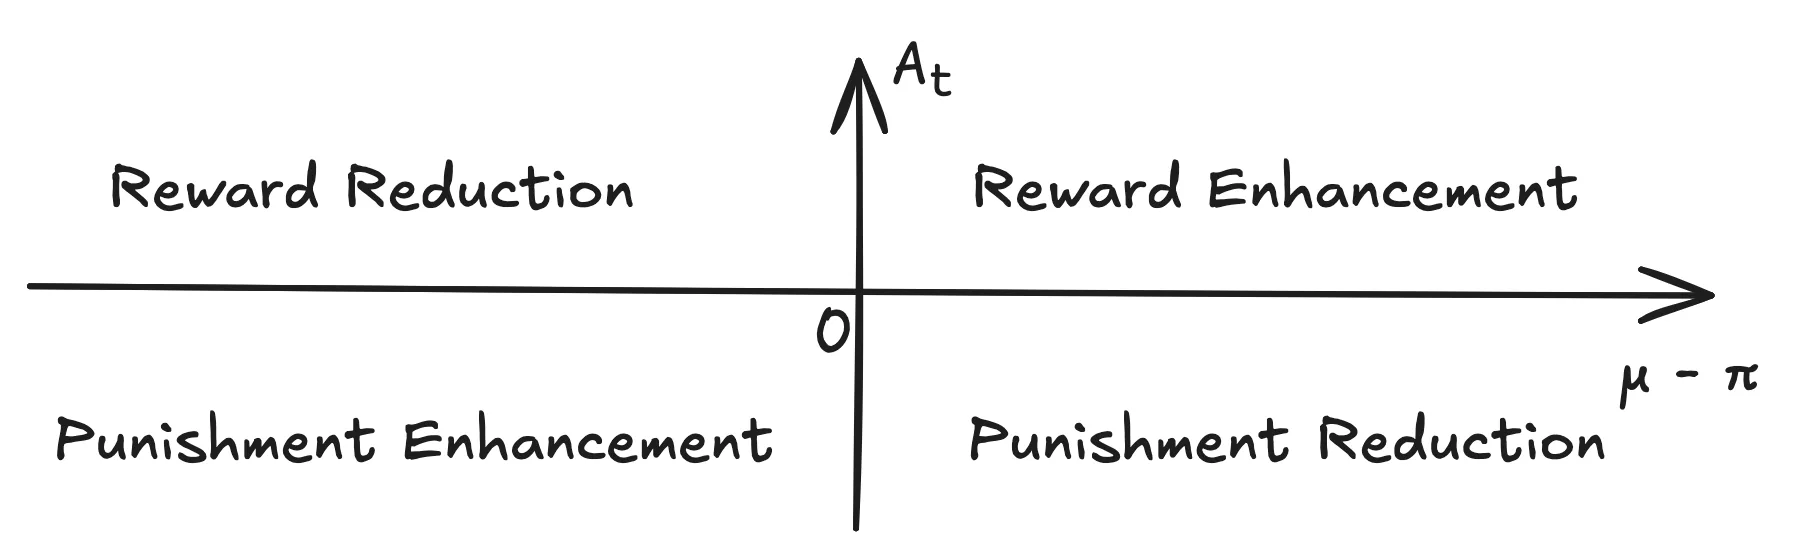
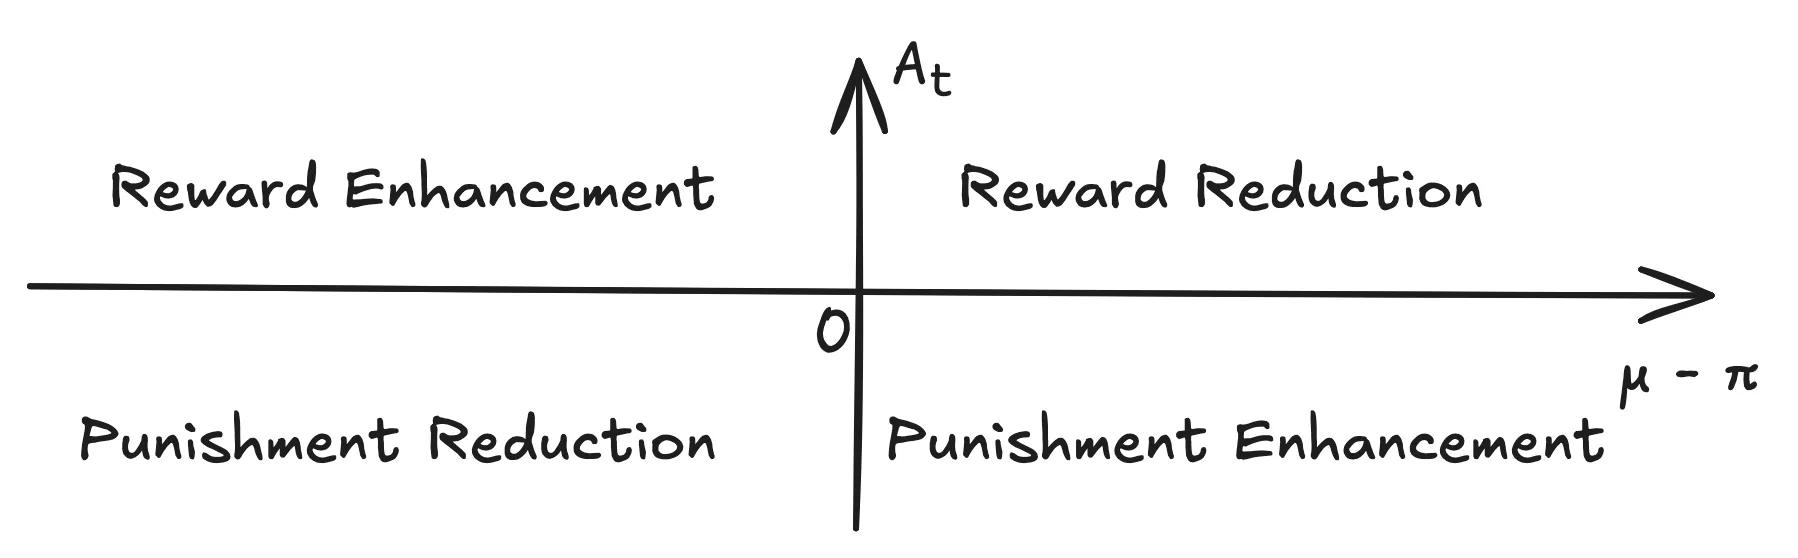
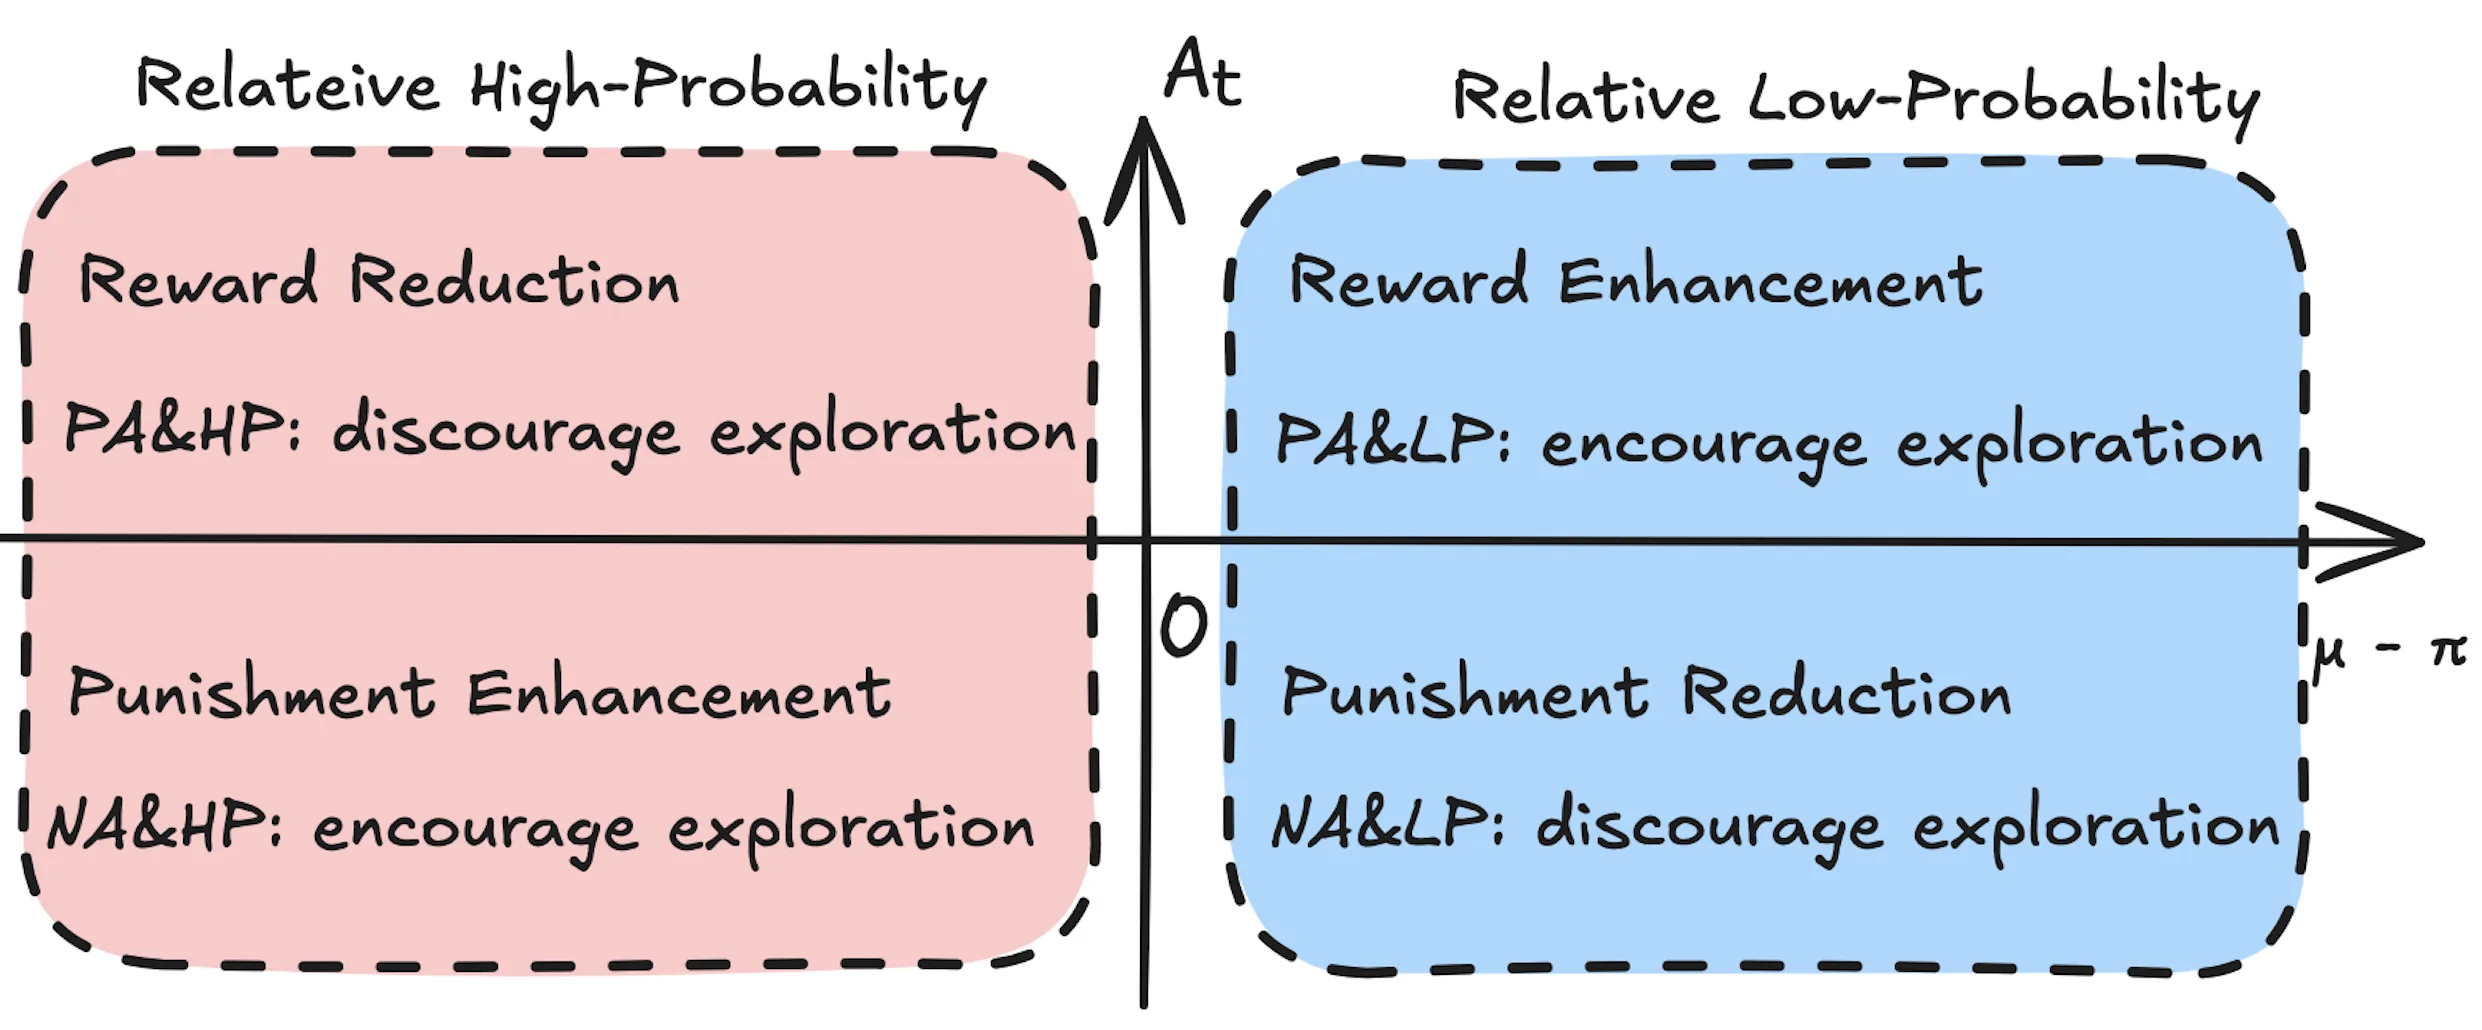
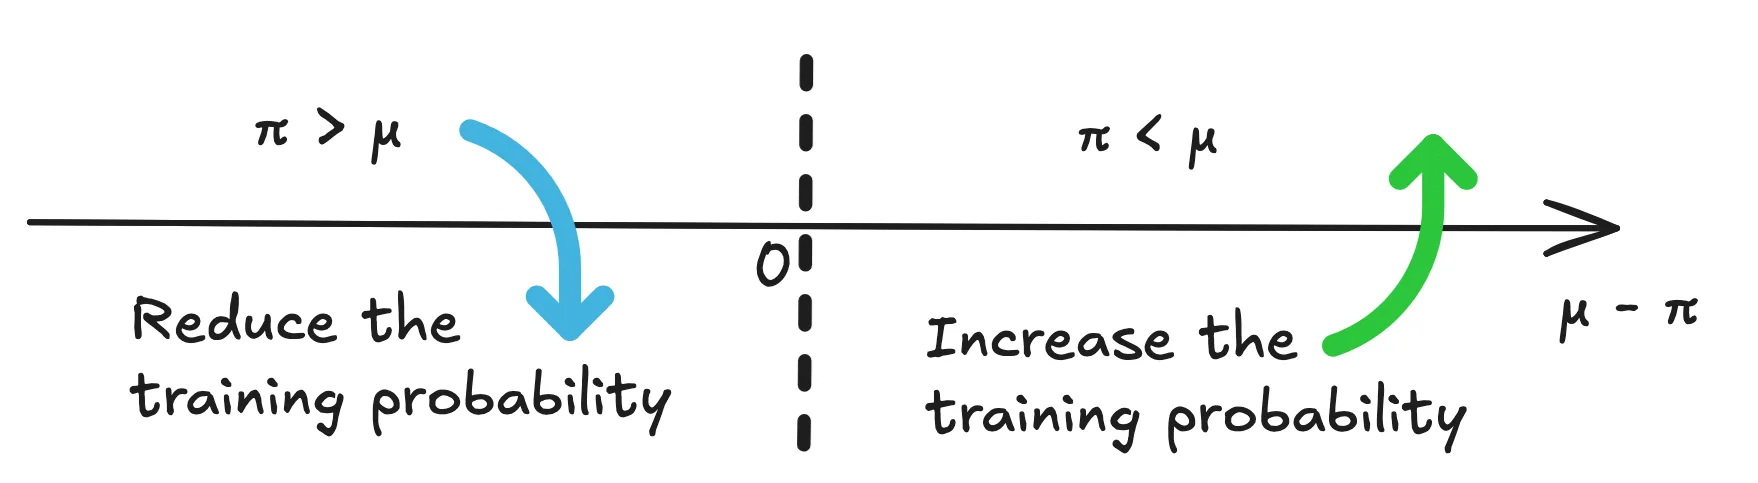
具体调控遵循四象限概率调整(AGPA)规则:将 token 分为四个区域——正优势且推理概率高于训练(PA&HP)、正优势且推理概率低于训练(PA&LP)、负优势且推理概率高于训练(NA&HP)、负优势且推理概率低于训练(NA&LP)。当 时,系统增强 PA&LP 和 NA&HP 的梯度(这些区域天然减少差异),抑制 PA&HP 和 NA&LP 的梯度。当 时,则执行反向操作,主动放大差异以维持适度的探索能力。
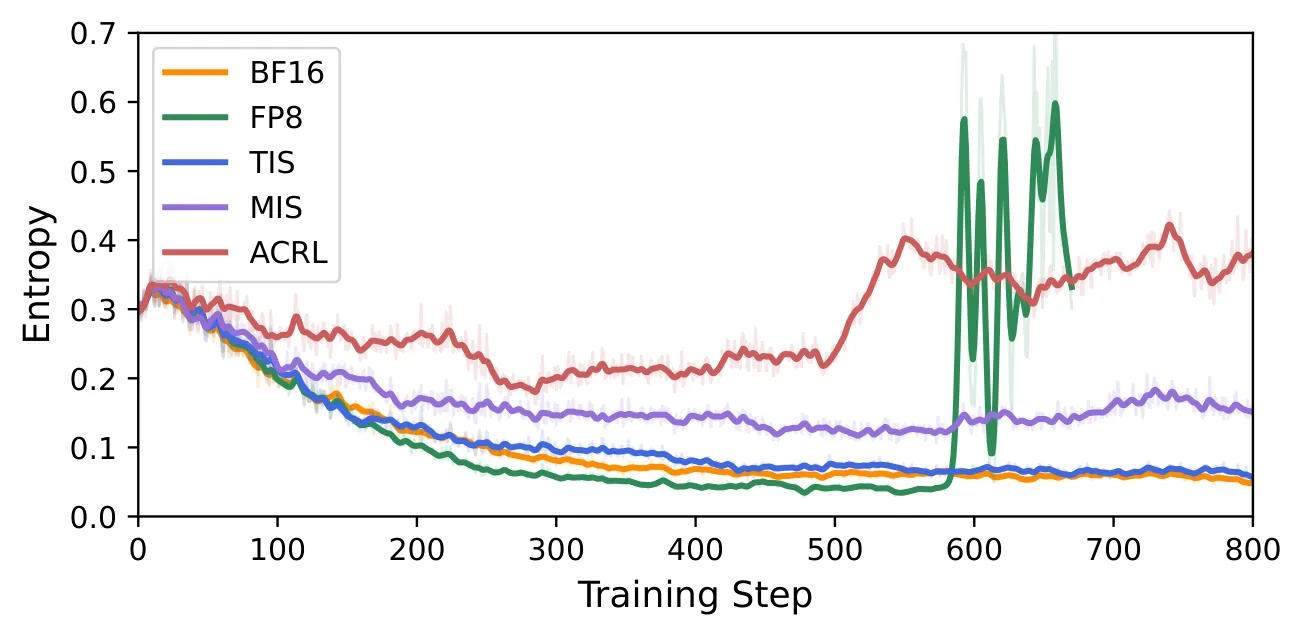
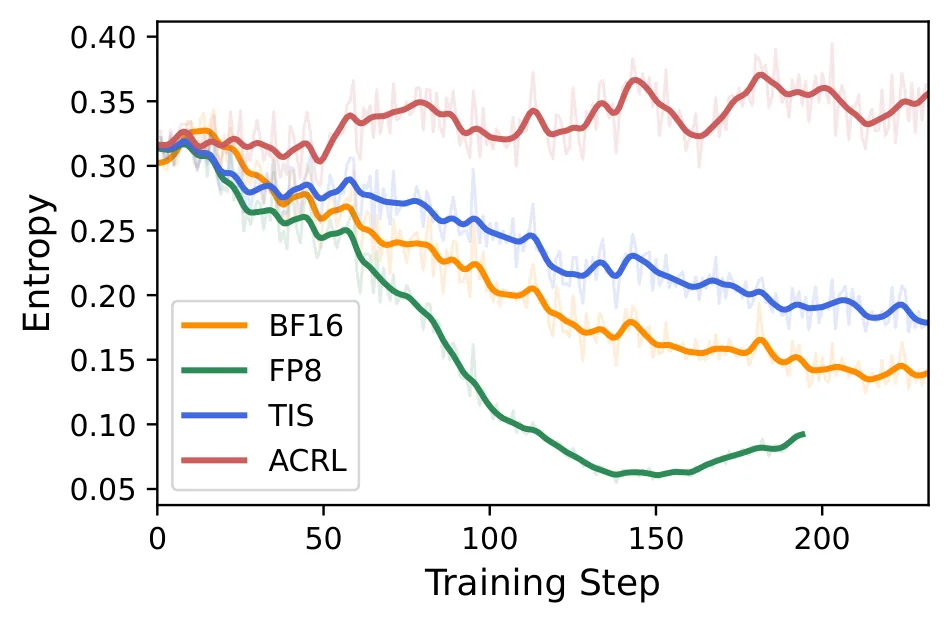
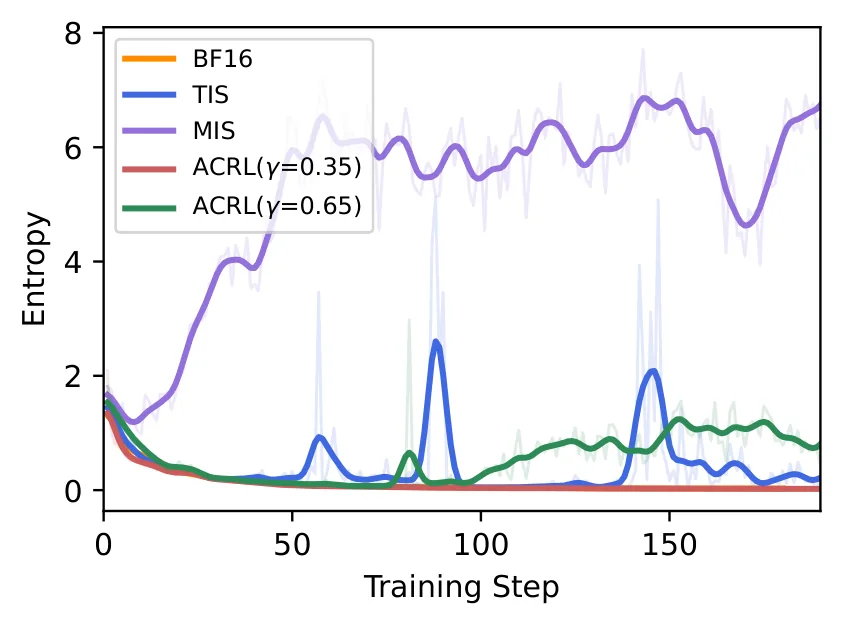
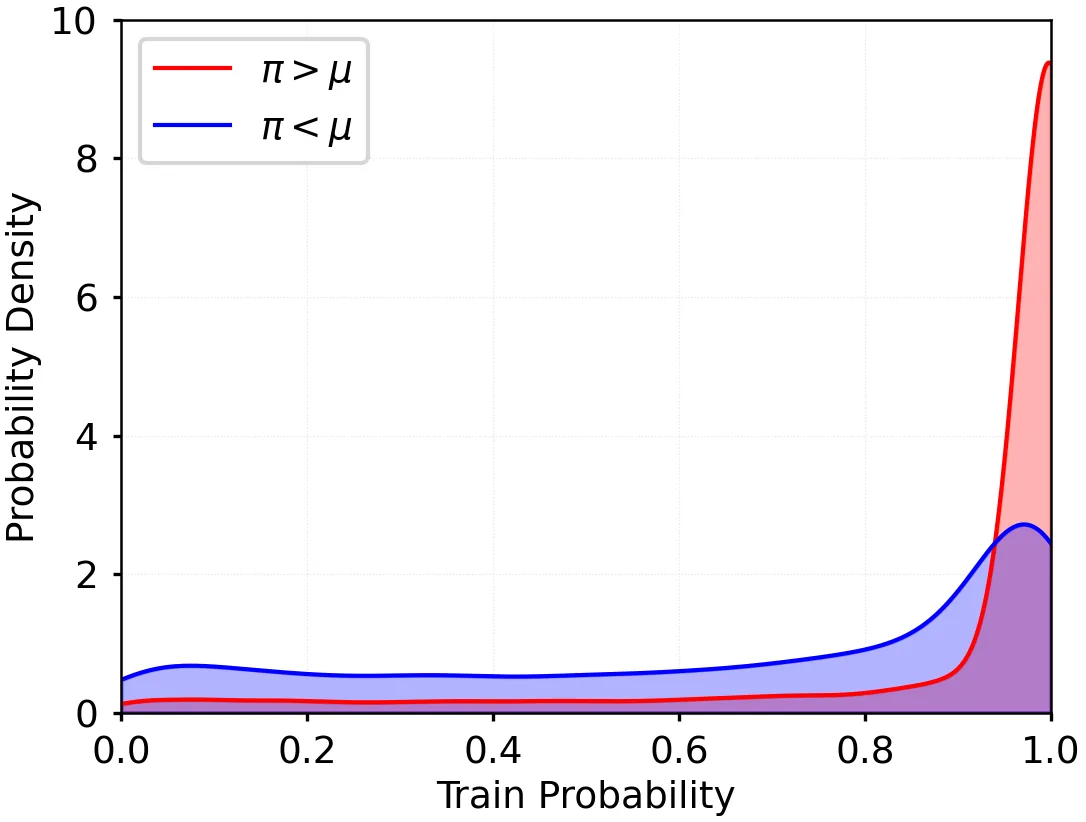
一个值得注意的副产品是探索增强。论文通过概率密度分析表明,当训练与推理策略存在差异时, 与 区域之间存在随机占优关系,而 ACRL 在减少净差异的过程中会自然提升策略熵,无需额外的熵正则项。这意味着 ACRL 在稳定训练的同时,内在地增强了模型的探索能力。
实验与结果
实验在 VeRL 框架上进行,采用 vLLM 作为推理引擎、FSDP 进行分布式训练。测试覆盖了从 3B 到 32B 的多种模型架构(Qwen2.5-3B-Instruct、Qwen2.5-7B-Base、Qwen3-32B 稠密模型以及 Qwen3-30B-A3B MoE 专家混合模型),并验证了 GRPO、PPO、DAPO 等多种 [[强化学习算法]] 的兼容性。推理侧采用 FP8 量化(per-token 激活 / per-channel 权重),训练侧保持 BF16 精度。
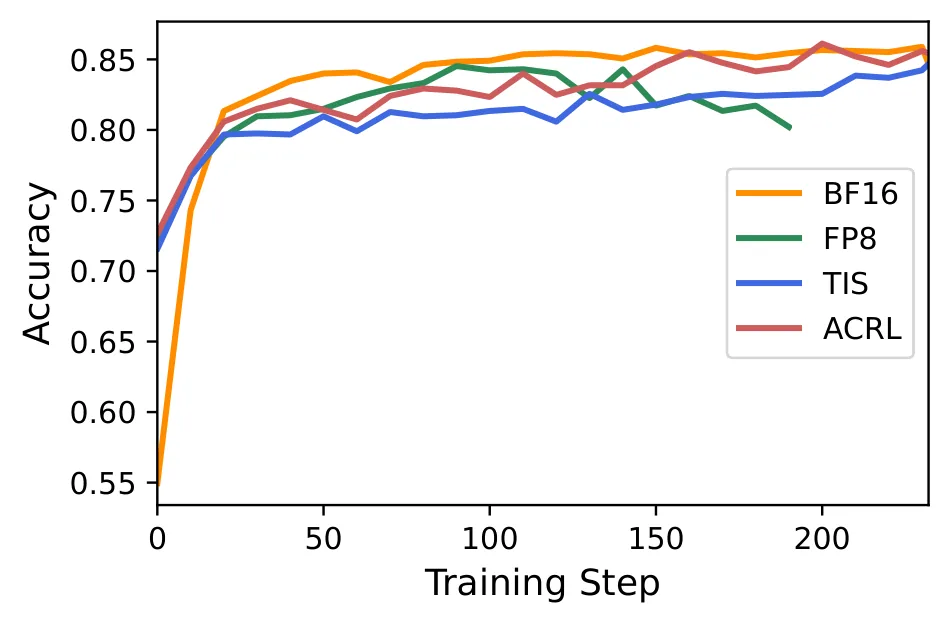
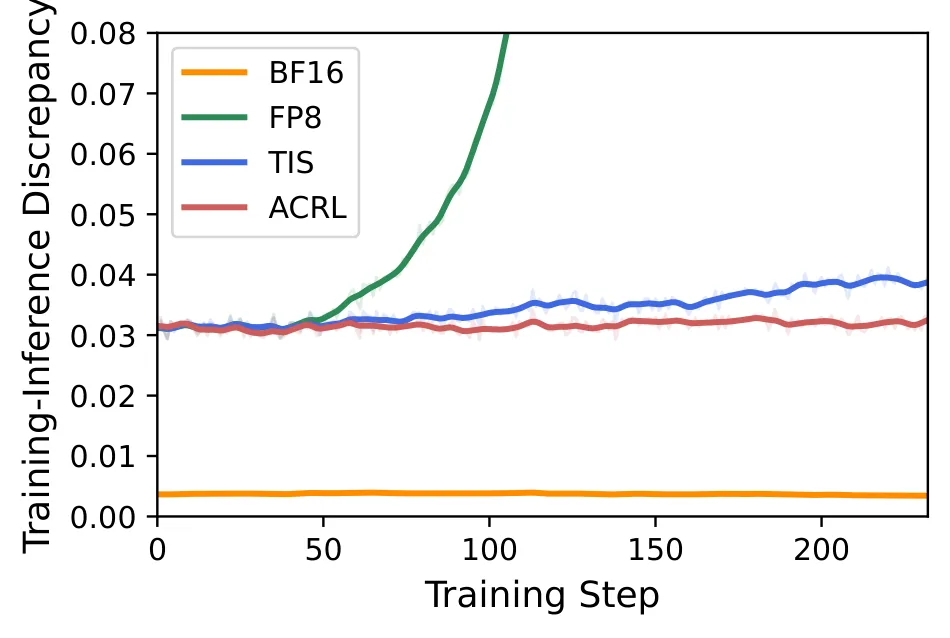
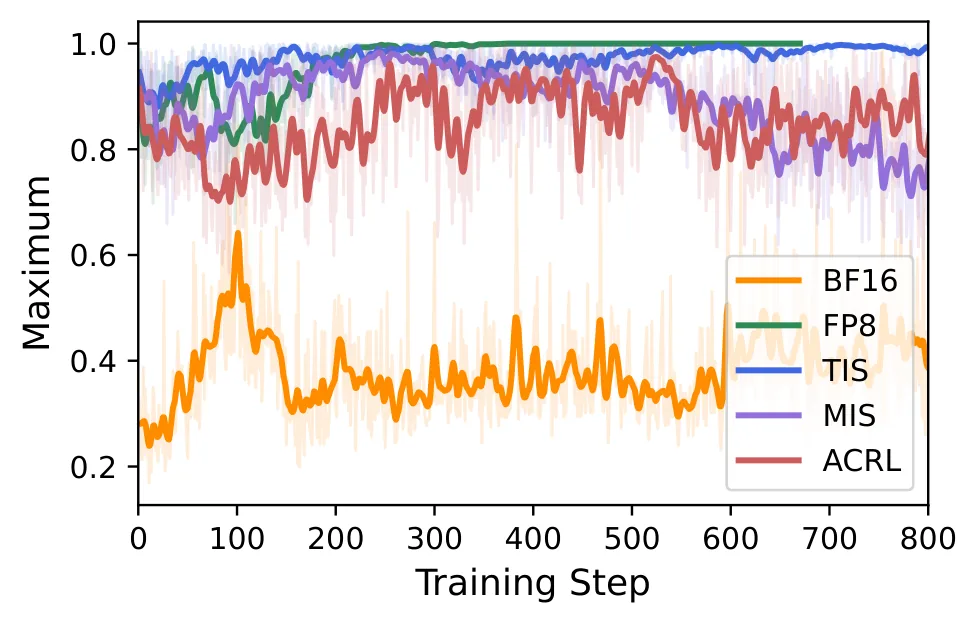
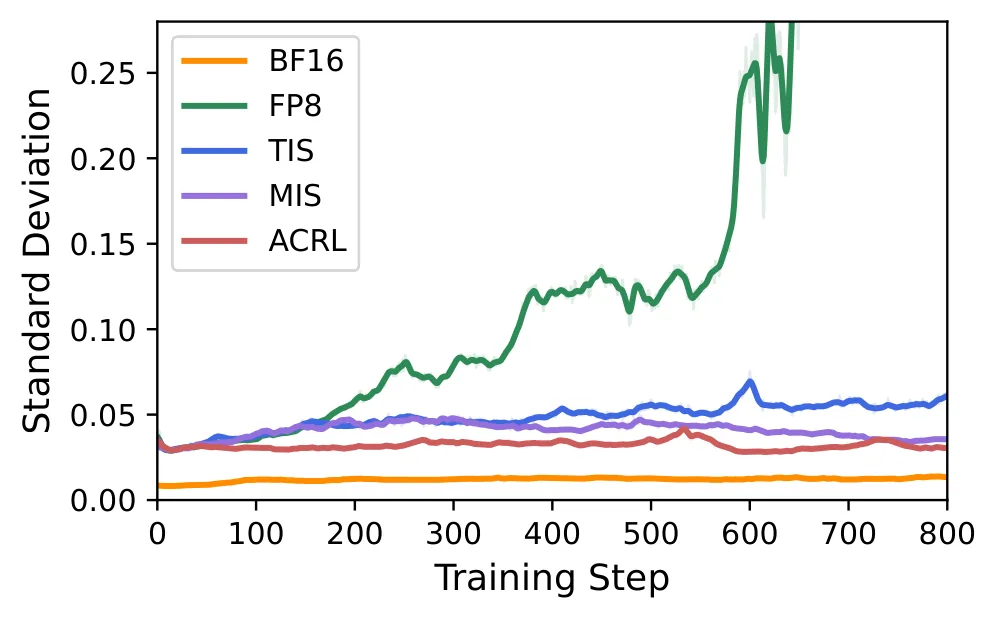
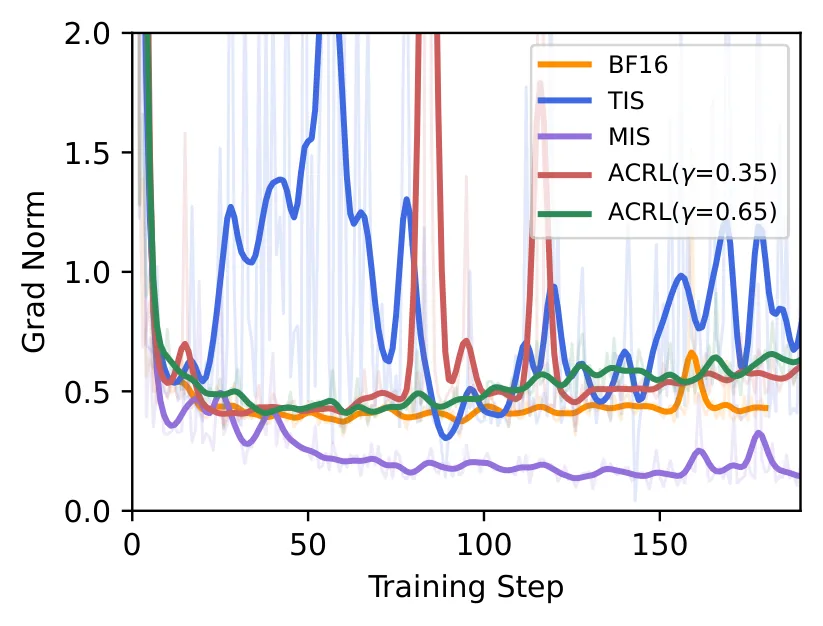
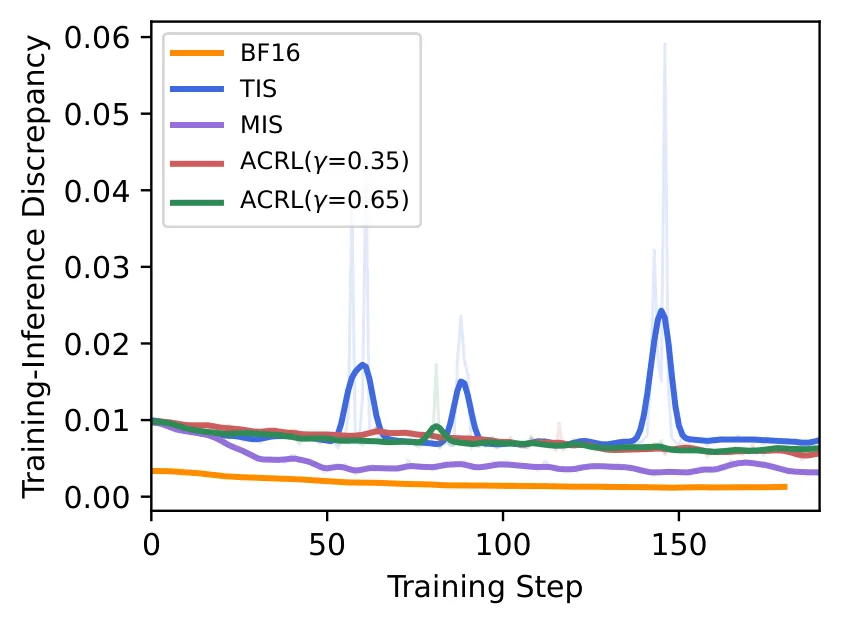
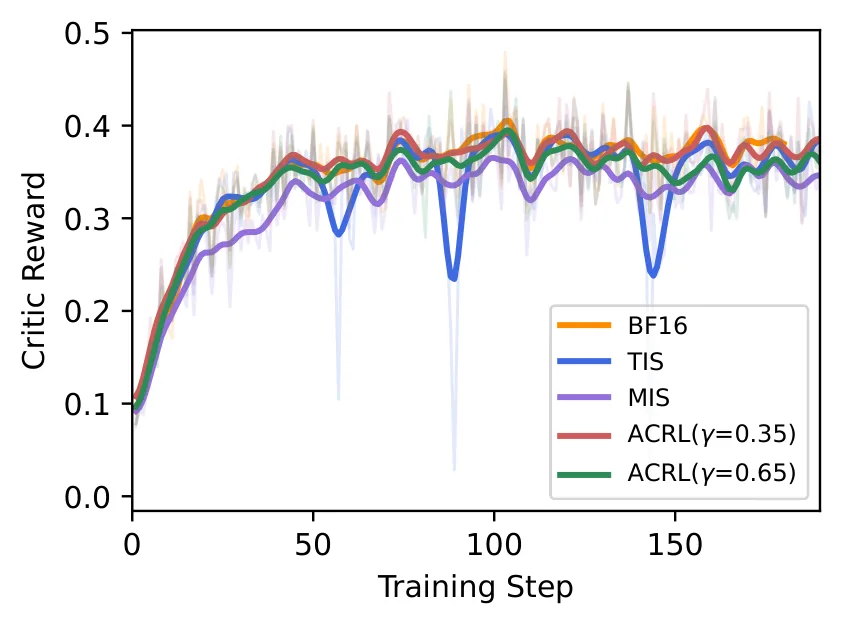
稳定性验证是首要目标。在 GSM8K 数学推理任务上,FP8 无修正基线在训练中期出现明显的性能震荡和崩溃,而 ACRL 能够将训练-推理差异持续稳定在参考值附近,波动幅度显著小于 TIS 和 MIS 方法。截断 FP8 的极端压力测试进一步证明,在差异远超正常范围的场景下,TIS 和 MIS 均无法维持训练稳定,ACRL 则仍能恢复至 86.13% 的准确率。
精度对齐甚至超越是更令人惊喜的结果。Qwen2.5-3B 在 GSM8K 上,ACRL 的 final-200 步平均准确率达到 87.05%,高于 BF16 基线的 86.60%。Qwen2.5-7B 在困难数学集(MATH500、AIME-24/25 等)上,ACRL() 平均 36.39%,也优于 BF16 基线的 35.11%。这意味着 ACRL 成功消除了所谓的"量化税"——在低精度推理的高效率下,仍能保持甚至提升最终性能。
算法泛化性同样得到验证。在 PPO 算法下,ACRL 与 BF16 基线持平(87.34%);在 DAPO 算法下,FP8 基线直接崩溃,但 ACRL 恢复至 88.63%,显著超越 BF16。模型架构层面,32B 稠密模型和 30B MoE 模型在 MXFP8 量化下均表现稳定,final-200 平均均超过对应 BF16 基线。任务迁移方面,MMLU-Pro 通用推理 benchmark 上,FP8 推理配合 ACRL 的准确率为 0.4534,略高于 BF16 基线的 0.4484。
消融实验证实了双向控制的必要性。持续压低差异(仅当 时调控)的变体相比 ACRL 损失了 0.91 个百分点;直接回退到标准 GRPO 则出现明显的 crash-recover 模式。这说明差异过小同样有害——过度抑制差异会导致模型过度拟合推理策略,丧失探索多样性。
计算开销是工程部署的重要考量。ACRL 自身的额外计算时间约为 0.059 秒,占单步训练周期(56.496 秒)的约 0.1%,几乎可以忽略不计。这使得该方法在生产环境中的集成成本极低。
讨论与可借鉴点
ACRL 最大的贡献在于提出了一个统一的原则框架:训练-推理差异不是需要消除的噪声,而是需要维持在合理区间的动态变量。这种思路跳出"被动修补"的窠臼,为解决 [[强化学习训练]] 中广泛存在的训练-推理不一致问题提供了新范式。
从工程角度看,ACRL 的设计极为轻量。它仅需在训练循环中增加序列级的差异测量和 token 级的权重调整,无需修改推理引擎、无需重新校准量化参数、也无需引入额外的正则项。这种可插拔性使其可以无缝集成到现有的 RLHF 训练流程中。
论文也坦诚承认了若干局限。首先,参考值 基于训练第 0 步的静态设定,对于超长训练或权重剧烈漂移的场景可能失效。其次,超参数 的敏感性较高——实验显示 即导致崩溃,而 则无法有效稳定训练,需要在目标模型上进行小规模调参。此外,论文主要验证了数学推理和 MMLU-Pro 等客观评测场景,对于主观性奖励场景(如创意写作、代码生成、对话安全对齐)尚未覆盖。
另一个值得深思的问题是指标选择。ACRL 采用绝对距离作为差异度量,而 KL 散度等更精细的度量方式可能捕捉到不同层面的差异信息,这在未来的工作中值得探索。
对于从事 LLM 对齐研究或 RL 系统工程的实践者而言,ACRL 提供了一个关键启示:当训练流程中存在多个异构组件时,主动调控组件间的行为差异往往比强制对齐更能兼顾稳定性与效率。这种思想或许可以推广到其他存在训练-部署差异的场景,如模型压缩、量化感知训练、以及多模态模型的跨模态对齐等问题中。
摘要
大语言模型(LLMs)的强化学习(RL)训练常因训练与推理之间的差异而面临不稳定问题。这种训练-推理差异源于两个主要因素:训练引擎与推理引擎之间的架构分离,以及推理采用低精度量化而训练采用更高精度计算。为应对高训练-推理差异所导致的训练不稳定问题,我们提出了其自适应控制的原则与方法。我们提出了自适应控制强化学习(ACRL),该方法能够自适应地将训练-推理差异维持在合理范围内,从而确保强化学习训练的稳定性。除稳定化外,ACRL 还能内在地提升策略熵,从而增强探索能力并提高准确率。实验结果表明,当推理引擎采用 FP8 量化时,ACRL 能够持续将训练-推理差异维持在合理范围内,并稳定强化学习训练。此外,ACRL 不仅能达到 BF16 基线的准确率,还能优于重要性采样(IS)修正方法。
Abstract
Reinforcement Learning (RL) training for Large Language Models (LLMs) often suffers from instability due to the discrepancy between training and inference. This training-inference discrepancy stems from two primary factors: an architectural separation between training and inference engines, and the use of low-precision quantization in inference versus higher-precision computation in training. To address training instability issues caused by high training-inference discrepancy, we present the principles and methods for its adaptive control. We propose Adaptive Control Reinforcement Learning (ACRL), which adaptively maintains the training-inference discrepancy within a reasonable range to ensure stable RL training. Beyond stabilization, ACRL inherently increases policy entropy, thereby enhancing exploration and improving accuracy. The experimental results show that when the inference engine utilizes FP8 quantization, ACRL consistently maintains the training-inference discrepancy within a reasonable range and stabilizes RL training. Furthermore, ACRL not only matches the accuracy of the BF16 baseline but also outperforms importance sampling (IS) fixes.
论文详细总结(自动生成)
ACRL:自适应控制训练-推理差异以实现稳定的强化学习 —— 论文总结
1. 核心问题与研究动机
- 问题背景:大语言模型(LLM)的强化学习(RL)后训练(如 GRPO、PPO、DAPO)正成为主流对齐手段,但训练过程常面临严重的训练-推理不一致(Training-Inference Discrepancy),引发梯度偏差累积,最终导致训练崩塌(collapse)与精度损失。
- 差异的两大来源:
- 架构分离:现代 RL 框架(如 VeRL)将训练引擎(FSDP/Megatron)与推理引擎(vLLM/SGLang)解耦,两者底层算子、并行策略、内核实现不同。
- 精度差异:推理端为加速采用 FP8、MXFP8、INT8 等低精度量化,而训练端仍用 BF16/FP16,概率分布出现系统性偏移。
- 现有方案的局限:
- Token 级截断重要性采样(TIS):引入有偏梯度估计,方差大。
- 序列级掩码重要性采样(MIS):单序列整体 IS 比在高差异下趋于 量级,梯度消失。
- 精度对齐方案(BF16/FP16 统一):牺牲了低精度推理的效率收益,且无法泛化到其他差异来源(如算子内核不一致)。
- 本文目标:提出一种主动调控训练-推理差异的方法,使其收敛到合理区间,而非被动修补或简单对齐。
2. 方法论
2.1 核心思想
将训练-推理差异视为可调控变量,结合序列级测量与Token 级梯度调整,按四象限规则动态增强/抑制奖励与惩罚幅度,使差异收敛到由初始权重导出的参考值 。
2.2 关键技术细节
(1)差异度量(绝对距离):
(2)参考值 (基线):在训练第 0 步,由 baseline 数据集或初始权重计算的平均差异:
(3)ACRL 梯度目标函数:
其中自适应权重:
- :控制强度超参数;:截断阈值。
- :当前序列级训练-推理差异。
- 的符号与幅度同时编码调控方向( vs )与强度(差异偏离度)。
(4)四象限概率调整规则(AGPA):
- 当 (差异过大):减小差异
- 象限 I():增强正向更新
- 象限 II():抑制正向更新
- 象限 III():增强负向更新
- 象限 IV():抑制负向更新
- 当 (差异过小):反向规则,主动放大差异以保持探索。
(5)探索增强机制:作者通过概率密度图(Figure 6)证明 区域与 区域存在随机占优关系,并结合经验事实(PA&LP、NA&HP 提升熵,PA&HP、NA&LP 降低熵),论证 ACRL 在减少差异的净效果下天然提升策略熵。
(6)有偏性声明:作者明确指出自适应指数 使 ACRL 成为有偏估计,但借鉴 PPO/GRPO 裁剪的工程惯例,权衡理论无偏性与实际稳定性。
3. 实验设计
3.1 数据集与基准
- 数学推理:GSM8K、KlearReasoner-MathSub-30K(训练)、AIME-24、AIME-25、AMC-23、HMMT25、MATH500。
- 通用推理:MMLU-Pro(14 个领域,12000 题)。
3.2 模型与基线
- 模型规模:Qwen2.5-3B-Instruct、Qwen2.5-7B-Base、Qwen3-32B(稠密)、Qwen3-30B-A3B(MoE)。
- 量化方案:FP8(nearest-around,per-token 激活 / per-channel 权重)、MXFP8、截断 FP8(stress test)。
- RL 算法:GRPO(主)、PPO、DAPO。
- 框架:VeRL(vLLM 推理 + FSDP 训练)。
3.3 对比方法
- BF16(高精度基线)
- FP8(无修正基线)
- TIS(Token 级截断 IS)
- MIS(序列级掩码 IS)
4. 资源与算力
- 论文未明确披露所用 GPU 型号、数量、训练总时长等算力信息。
- 仅给出计算开销性能数据:Qwen2.5-3B 在 GRPO + ACRL + FP8 下,单步平均耗时约 56.496 秒,ACRL 函数自身开销仅 0.059 秒,占整个训练步的 。
- 附录提供了 Qwen2.5-3B 与 Qwen2.5-7B 的超参数表(如 batch size、learning rate、rollout.n=8 等),但缺少年级时长统计与硬件细节。
5. 实验数量与充分性
论文共报告了6 大类实验:
1. 稳定性与精度恢复:3B-GSM8K 与 7B-困难数学集上的对比。
2. 泛化性:PPO 与 DAPO 算法迁移;32B 稠密与 30B-A3B MoE 架构迁移;MMLU-Pro 任务迁移。
3. 鲁棒性与压力测试:基准 取值扰动(0.010/0.013/0.016)、截断 FP8 极端差异。
4. 超参敏感性与计算效率: 扫描、单步耗时剖析。
5. 双向控制消融:Continuous Reduction、Fallback to GRPO 两个变体。
6. 评估方法学讨论:用 final-200-step 平均代替单点峰值。
充分性评价:
- 覆盖面较广(多模型、多算法、多任务、多基准、多消融)。
- 不足:
- 未报告多随机种子方差,仅靠 final-200-step 时间平均近似,作者承认"不能替代独立 seed 方差"。
- 单次运行为主,可能存在偶然性。
- 实验范围限于 vLLM+FSDP 组合、FP8 单轮推理。
6. 主要结论与发现
- 稳定化:在 FP8 推理下,ACRL 持续将训练-推理差异维持在参考值附近,且最大差异与方差显著低于 TIS,避免 FP8 训练崩塌。
- 精度对齐甚至超越:3B-GSM8K 上 final-200 平均 87.05% vs BF16 86.60%;7B-困难数学集 ACRL() 平均 36.39% vs BF16 35.11%,消除"量化税"。
- 算法泛化:PPO 下与 BF16 持平(87.34%),DAPO 下 FP8 崩塌但 ACRL 恢复至 88.63%,超越 BF16。
- 架构扩展:32B 稠密与 30B MoE 在 MXFP8 下均稳定且 final-200 平均超过 BF16。
- 任务迁移:MMLU-Pro FP8 推理下 0.4534 vs BF16 基线 0.4484。
- 双向控制必要:消融表明持续压低差异会损失 0.91 pp,回退 GRPO 出现 crash-recover。
- 计算开销可忽略:额外时间约 0.1%。
- 截断 FP8 极限测试:TIS 失败、MIS 消失,ACRL 仍恢复 86.13%。
7. 优点
- 新视角:跳出"被动修补"的窠臼,提出"主动调控差异到合理区间"的统一原则,并把"差异过小"也视为有害(过拟合推理策略)。
- 闭环机制:仅需序列级测量 + 局部 token 调整,无需修改推理引擎,工程上轻量、可插拔。
- 天然探索增强:差异控制与熵提升机制有机耦合,无需额外熵正则。
- 理论-实践平衡坦诚:明确承认有偏估计并以 PPO/GRPO 裁剪先例类比,增强可信度。
- 广泛的实证覆盖:横跨模型规模(3B–32B)、架构(稠密+MoE)、算法(GRPO/PPO/DAPO)、任务(数学+MMLU-Pro)、量化精度(FP8/MXFP8/截断)。
- 公开了完整超参数与领域级分数(附录 Table 13–14)。
8. 不足与局限
- 算力披露不全:未列 GPU 型号/数量、总训练时长,缺乏可复现性参考。
- 多 seed 缺位:所有结果基本为单次训练,缺乏方差与显著性检验。
- 基线稳定性假设风险:作者用 step-0 静态 ,依赖"自然差异底在 900 步内稳定"的经验观察,对超长训练或权重剧烈漂移场景可能失效。
- 超参敏感: 即崩溃, 长期不稳定;需要谨慎调参。
- 指标局限:采用绝对距离作为差异度量,未探索 KL 散度等更精细度量(Remark 4.1 自承)。
- 评估范围狭窄:
- 仅限 vLLM + FSDP 组合;
- 仅单轮推理场景,未覆盖多轮、工具调用、异步 rollout;
- 高精度后端不匹配(如 TF32 vs BF16)的差异未评估;
- 主观性奖励场景(创意写作、代码、对话安全)未验证。
- 个别断言可再加强:如"相对高概率 / 低概率区域的随机占优"为单数据集经验观察,缺乏跨任务理论保证。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。