
📝 TLDR
现实世界强化学习依赖将安全约束编码进策略,现有方法通常在MDP中引入额外代价信号。但在域偏移或障碍物移动导致代价结构变化时,现有策略难以快速重新适应。本文提出SafeDSR,将Deep Successor Representation扩展到约束强化学习,仅通过一个可学习权重矩阵便能解耦动力学、奖励与代价三者的价值函数。该矩阵可监督更新,在二维导航任务中验证方法保持竞争力的同时,对新代价结构具有显著灵活性。
🧭 速览
现有约束强化学习方法在代价函数因域偏移或障碍物移动而改变时缺乏快速适应性,策略过于僵化。
提出SafeDSR,在Deep Successor Representation基础上引入单一可学习权重矩阵,解耦动力学、奖励与代价对应的价值函数。
在可配置二维导航环境中验证,SafeDSR在简单任务上保持竞争力,并能以监督方式快速适应变化后的代价结构。
通过解耦价值函数实现约束强化学习,为代价结构动态变化的现实场景提供更灵活的策略更新机制。
🆚 方法对比
SafeDSR
- 通过解耦动力学与成本,仅需少量交互即可适应成本变化
- 只需更新单个权重矩阵即可适配新成本结构
- 在简单导航任务上与基线方法性能相当
- 仅在简单二维导航环境中验证,泛化性待验证
- 依赖后继特征学习的质量保证
- 缺少对长信用分配任务的详细性能分析
SafeDQN
- 基于值函数方法结合Lagrangian松弛实现约束
- 作为公平对比基线,结构简单直观
- 无需后继表示的额外结构假设
- 成本变化时需完整轨迹回放重新训练
- 缺乏灵活性,难以快速适应动态环境
- 对成本结构变化的适应性差
DSR
- 解耦动力学和奖励,便于奖励变化时快速适应
- 成熟的方法框架,有理论基础
- 本身不处理安全约束问题
- 需扩展才能应用于CMDP场景
CPO
- 将TRPO扩展以处理外部约束,里程碑工作
- 具有理论保证的安全策略优化
- 需完整轨迹回放才能适应成本变化
- 难以快速适应动态变化的环境
- 计算开销较大
CPPO-PID/TRPO-PID
- 使用PID控制器自动调优Lagrangian参数
- 结合PPO/TRPO等成熟算法框架
- 仍需估计未来期望成本
- 无法快速适应成本结构变化
- PID调参增加了系统复杂度
IPO
- 使用内点法保证安全策略保持安全
- 理论上有严格的安全保证
- 需完整轨迹回放适应成本变化
- 内点法计算成本较高
- 实现复杂度大
RCPO
- 多时间尺度方法,引导策略朝向可行集
- 提供不同的目标函数视角
- 需完整轨迹回放适应成本变化
- 多时间尺度调参复杂
P3O
- 通过惩罚和裁剪将约束转化为无约束问题
- 实现相对简单
- 需完整轨迹回放适应成本变化
- 惩罚和裁剪参数敏感
SafeDSR通过后继表示解耦动力学与成本,在成本结构变化时仅需少量交互即可快速适应,而CPO、IPO、RCPO、P3O、CPPO-PID等现有方法均需完整轨迹回放重新训练,在灵活性上存在显著差距;SafeDQN作为同框架下的非后继表示基线,也面临相同的适应性瓶颈。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 23 张)
展开查看 23 张图
TL;DR
本文提出了 SafeDSR(Safe Deep Successor Representation),将深度后继表征扩展到约束强化学习领域。核心创新在于引入一个可学习的权重矩阵,在动力学、奖励与代价三者之间解耦价值函数,从而在代价结构发生变化时只需以监督方式更新该矩阵,而无需重新训练整个网络。在二维导航环境中的实验表明,SafeDSR 在复杂多房间场景下显著优于包括 CPO、PPO-Lag、TRPO-Lag 等在内的 11 种基线方法,同时展现出对新代价结构的快速适应能力。
研究背景与动机
在现实世界的强化学习应用中,将安全约束编码进策略是不可或缺的能力。一个被广泛采用的建模方式是将标准马尔可夫决策过程(MDP)扩展为约束马尔可夫决策过程(CMDP),在奖励信号之外额外引入代价信号 与对应的预算约束 。这种设计使得智能体能够在追求累积奖励最大化的同时,避免累积代价超过预设阈值。
然而,现有的大多数约束强化学习算法——无论是 CPO、PPO-Lag 还是 TRPO-Lag——都默认代价函数在训练过程中保持固定。当代价结构因域偏移、障碍物移动或环境动态变化而发生改变时,这些方法只能从头开始重新训练策略。这种缺乏灵活性的特性严重限制了其在真实场景中的应用价值。以机器人导航为例,如果障碍物的位置发生变化,或者需要动态添加新的禁区,现有的方法将面临昂贵的重新训练成本。
本文的切入点正是这一痛点:能否设计一种方法,使得策略在保持动力学模型不变的前提下,仅通过少量交互就能快速适配新的代价函数?这一问题的解决将大大提升约束强化学习在动态环境中的实用性。
方法
SafeDSR 的核心思想源于对价值函数的重新分解。在传统方法中,Q 函数 同时编码了动力学信息、奖励结构与代价约束,三者紧密耦合。Barreto 等人提出的后继表征(Successor Representation)理论为解耦提供了可能性:该方法将价值函数表示为后继特征 与奖励权重的乘积,即 。
SafeDSR 将这一思想推广到约束强化学习场景。具体而言,智能体学习状态-动作特征 、奖励权重 以及代价权重 ,从而将 Q 函数和安全代价分别表示为:
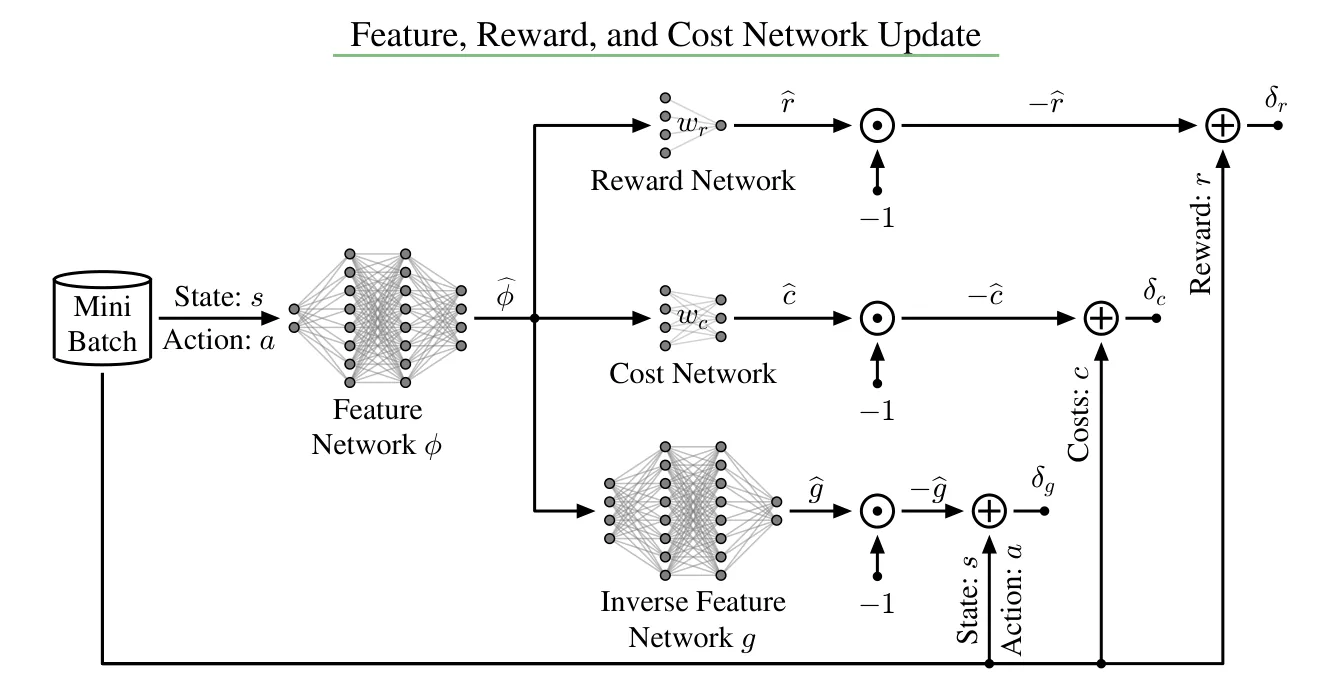
其中 被替换为直接学习的状态-动作特征 。这一设计的精妙之处在于:当代价函数发生变化时,只需以监督方式重新学习代价权重矩阵 ,而无需调整特征网络本身。
在训练目标上,SafeDSR 将原始 DSR 的特征损失扩展为三项:
第一项为奖励重建损失,第二项为代价预测损失,第三项为特征重构损失。这种多任务学习框架确保了特征既包含奖励信息又包含代价信息。
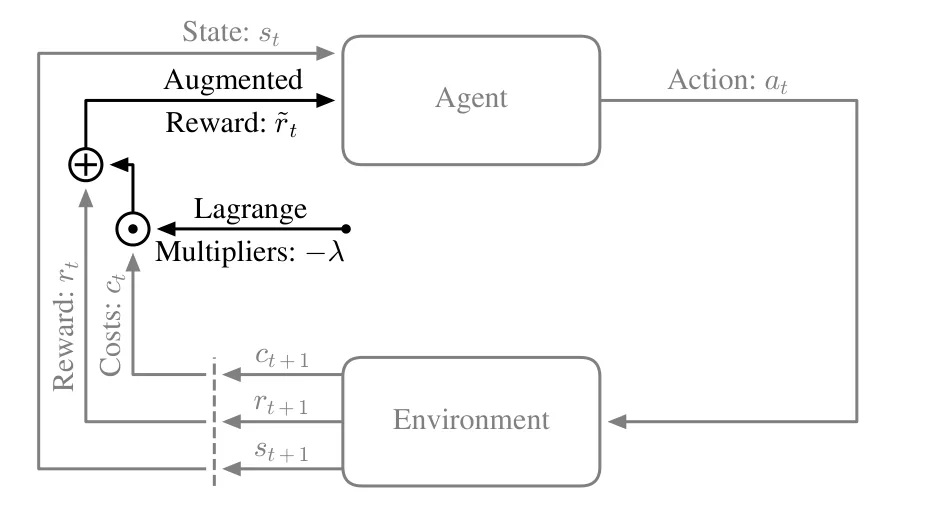
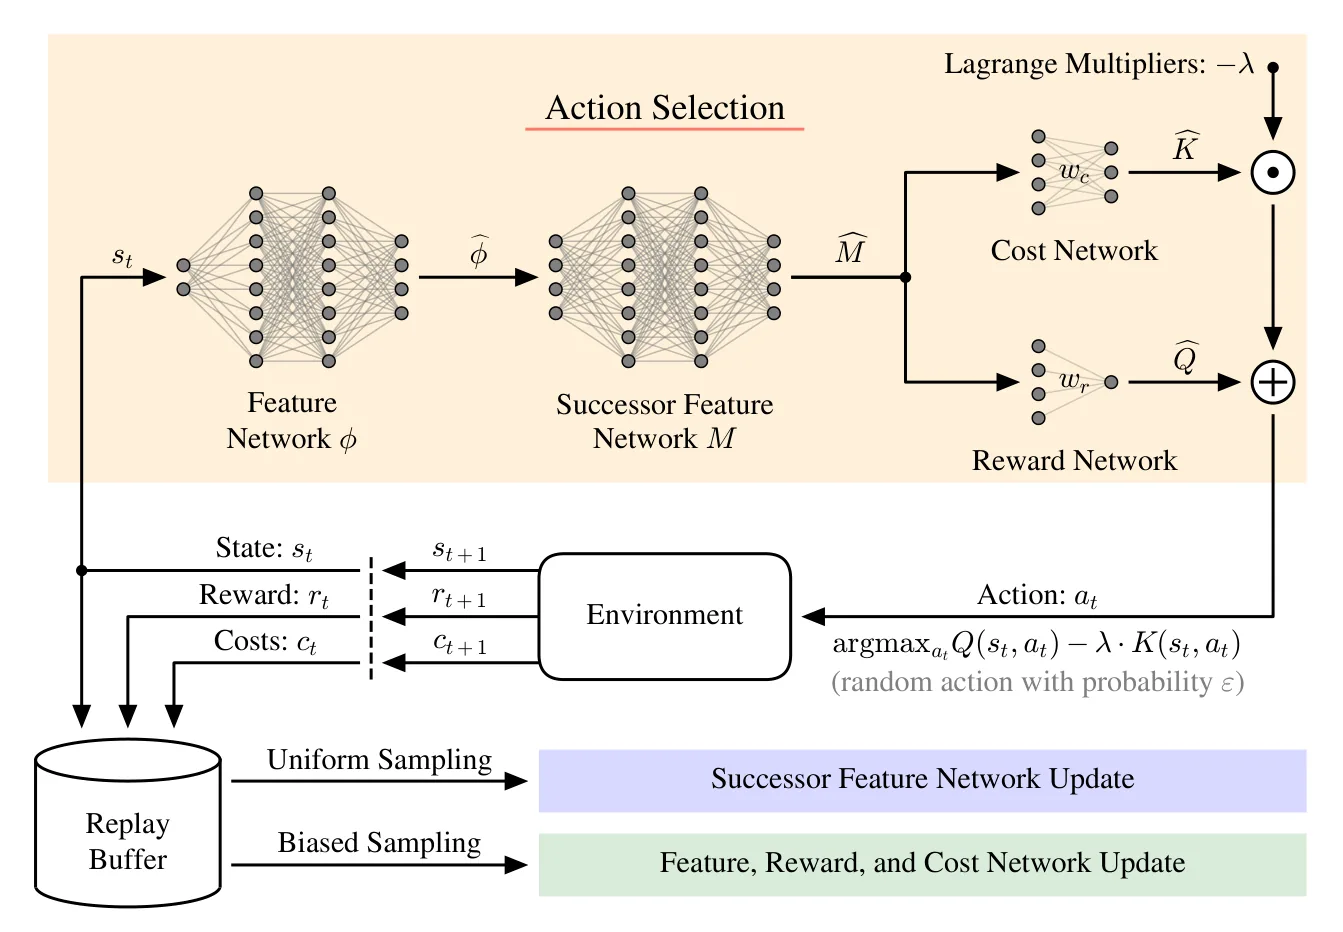
在决策阶段,SafeDSR 采用 Lagrangian 松弛方法,但与 SafeDQN 将 嵌入训练目标不同,SafeDSR 仅在决策时使用 :
这意味着 的变化不会反向拉扯特征网络,实现了训练与决策的解耦。 通过简单的比例控制器在每个回合末更新:
此外,论文还引入了若干关键实现细节:对 做 归一化以稳定训练;在 步后冻结特征网络以保持迁移能力;采用偏置采样策略,以奖励与各代价的倒数概率选择样本,确保智能体充分探索代价较高的区域。
实验与结果
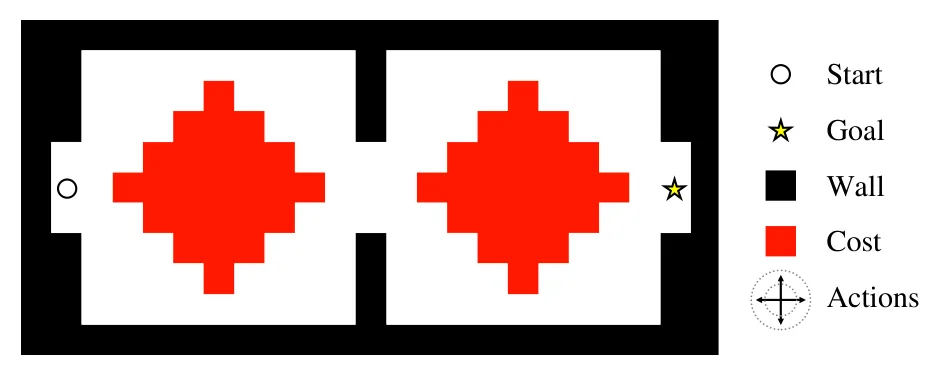
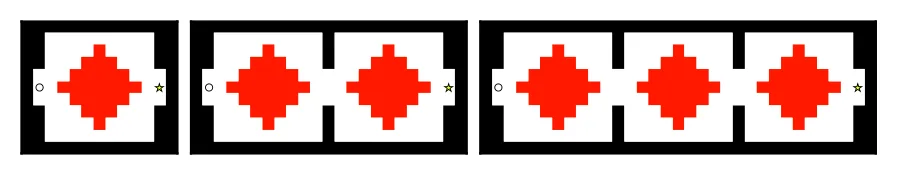
实验在作者自建的二维导航网格环境中进行。该环境支持灵活的拓扑配置(1/2/3 房间)、多种代价分布以及代价结构的动态切换,是研究代价适应问题的理想测试平台。状态为连续的二维坐标,动作空间为四方向离散运动,奖励结构为到达目标得 +1、每步惩罚 -0.01,代价为踏入代价格区域得 +1,预算设为 。
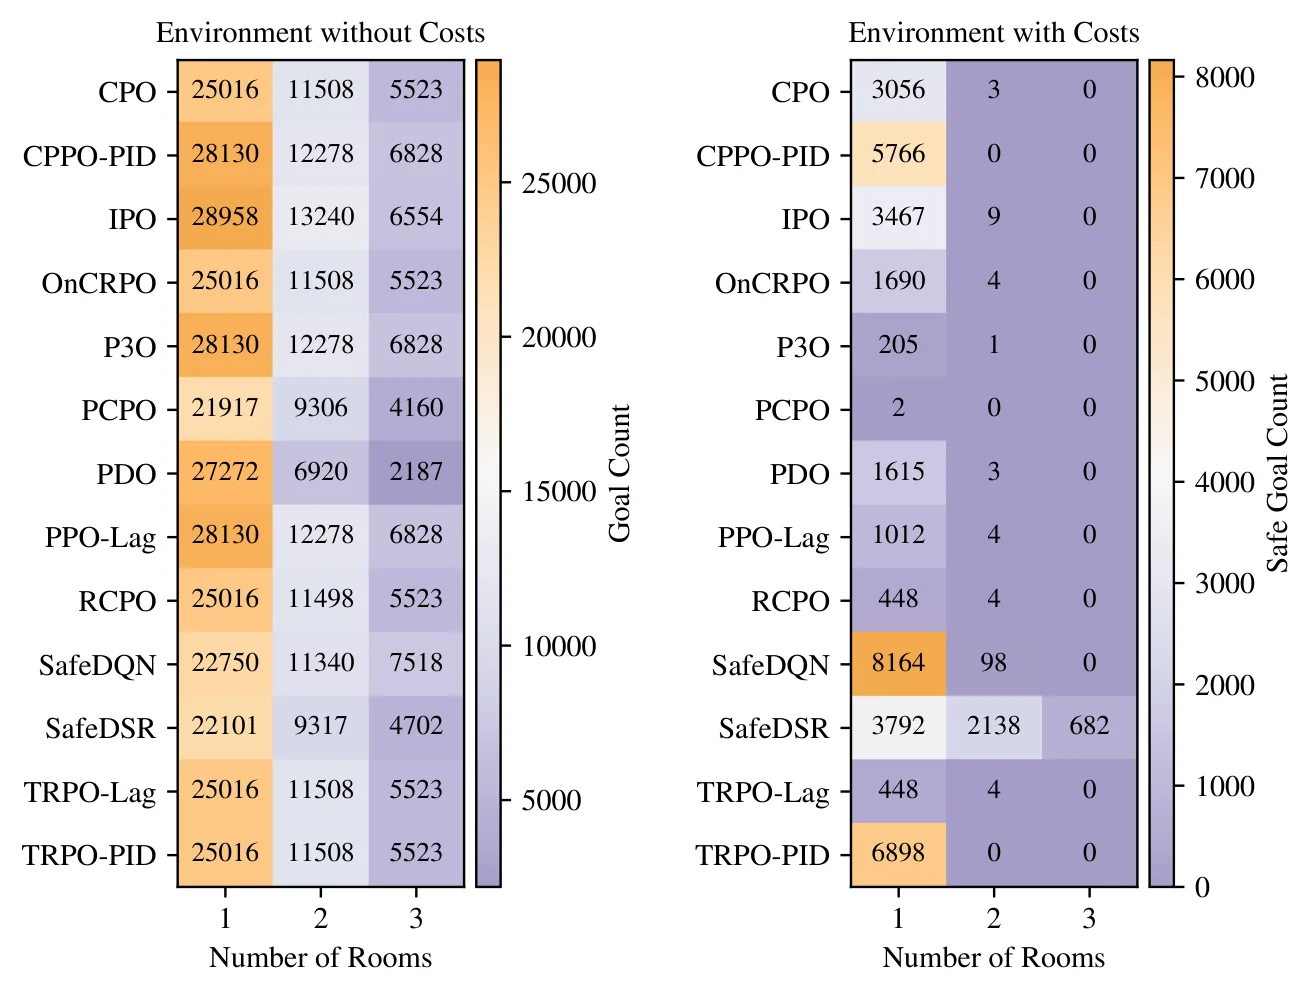
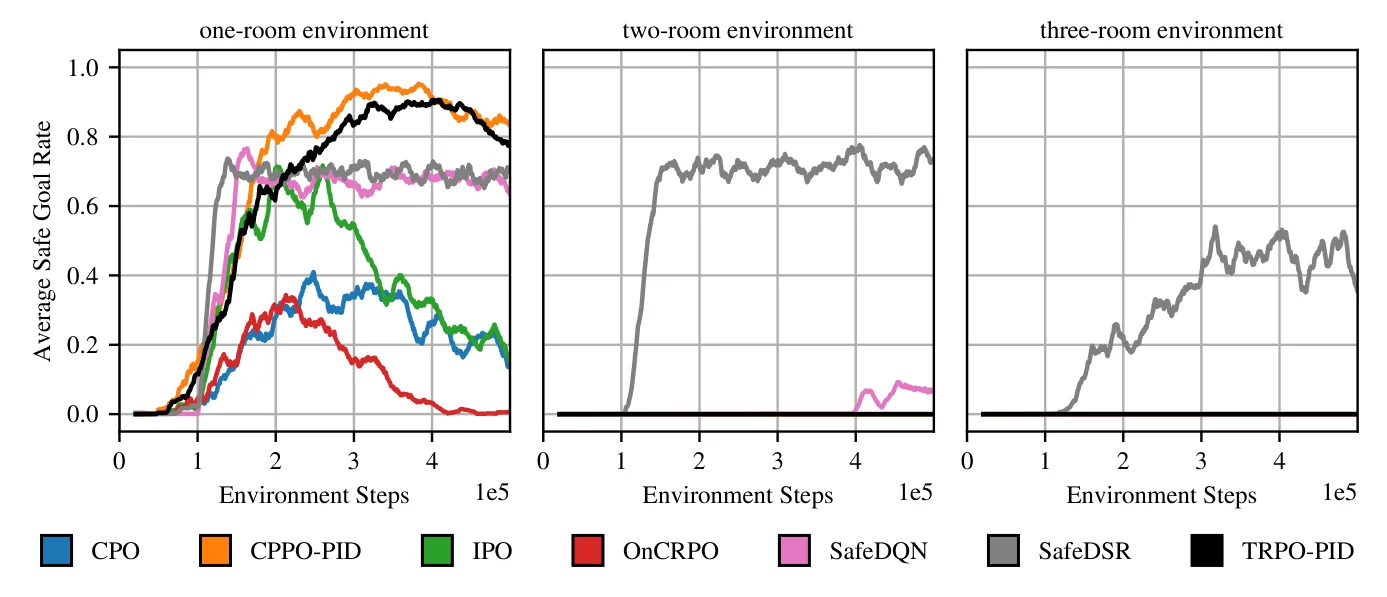
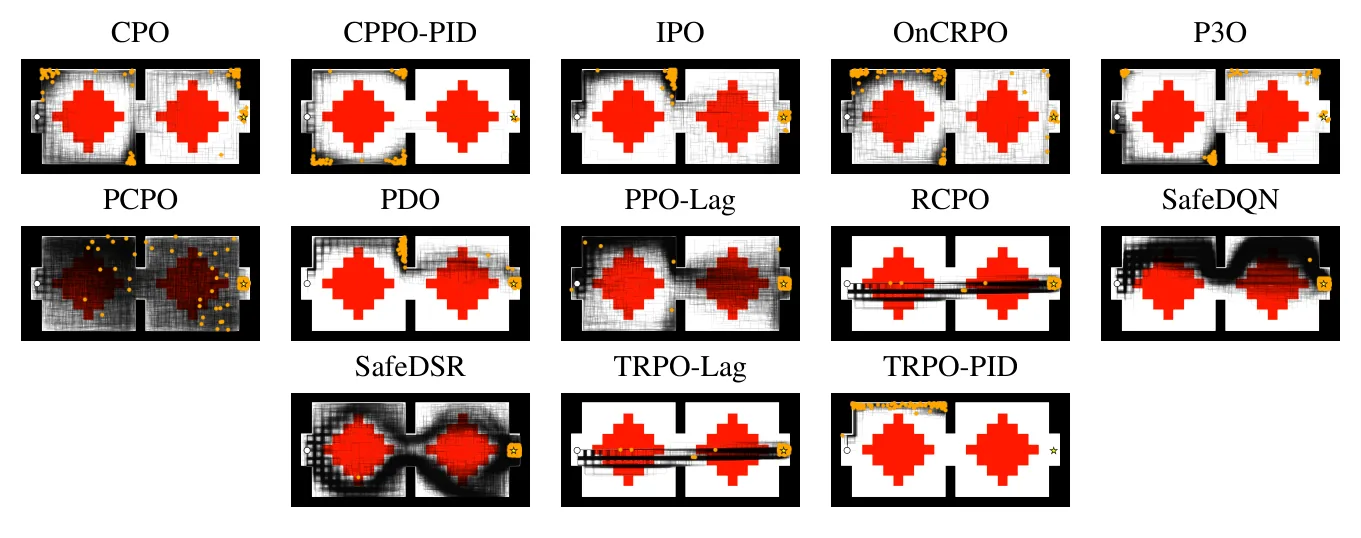
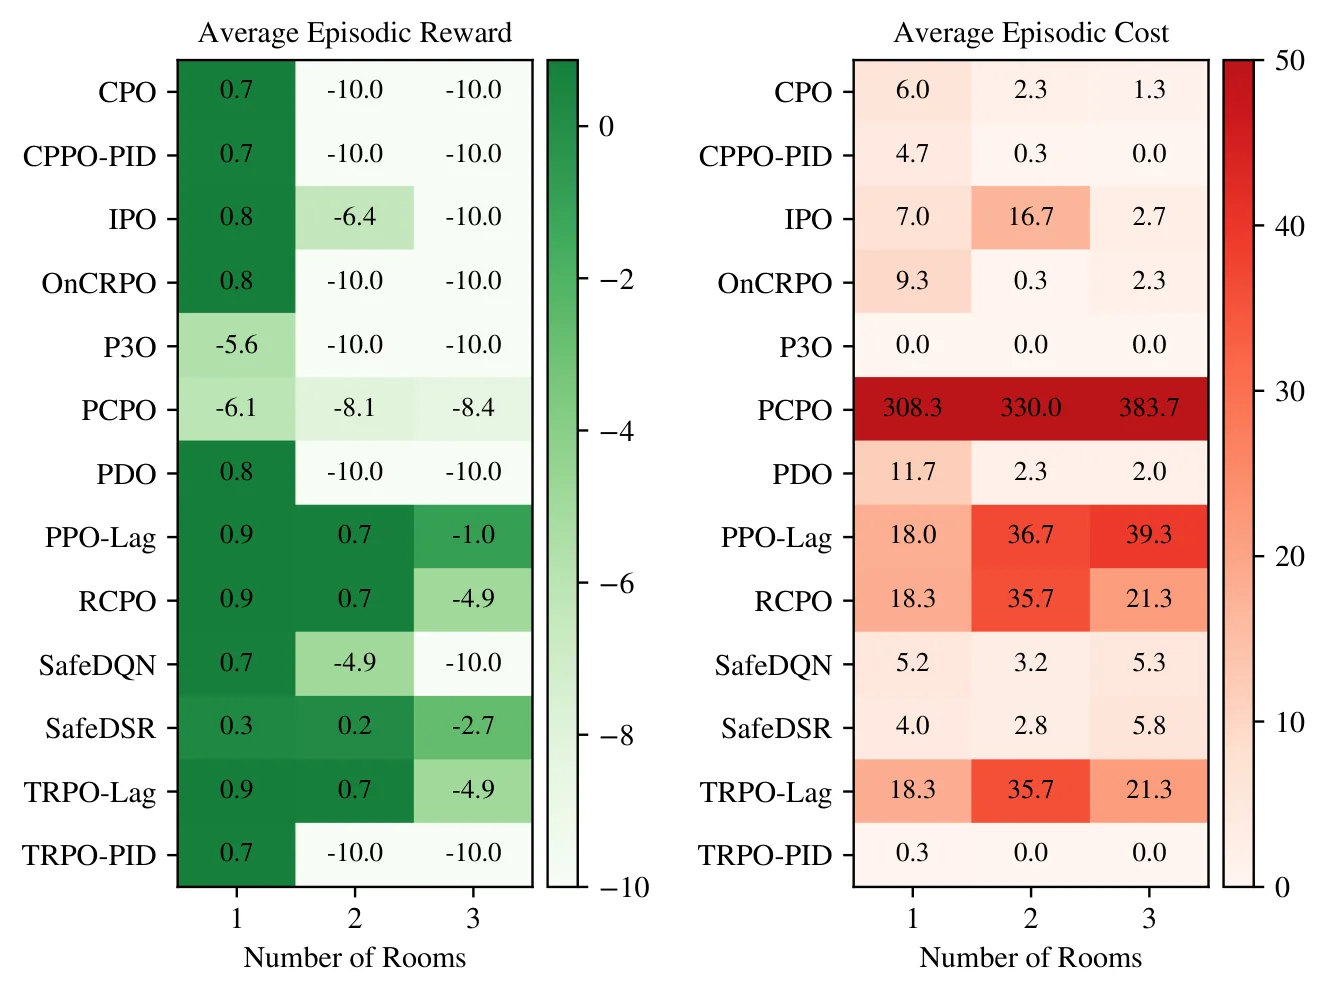
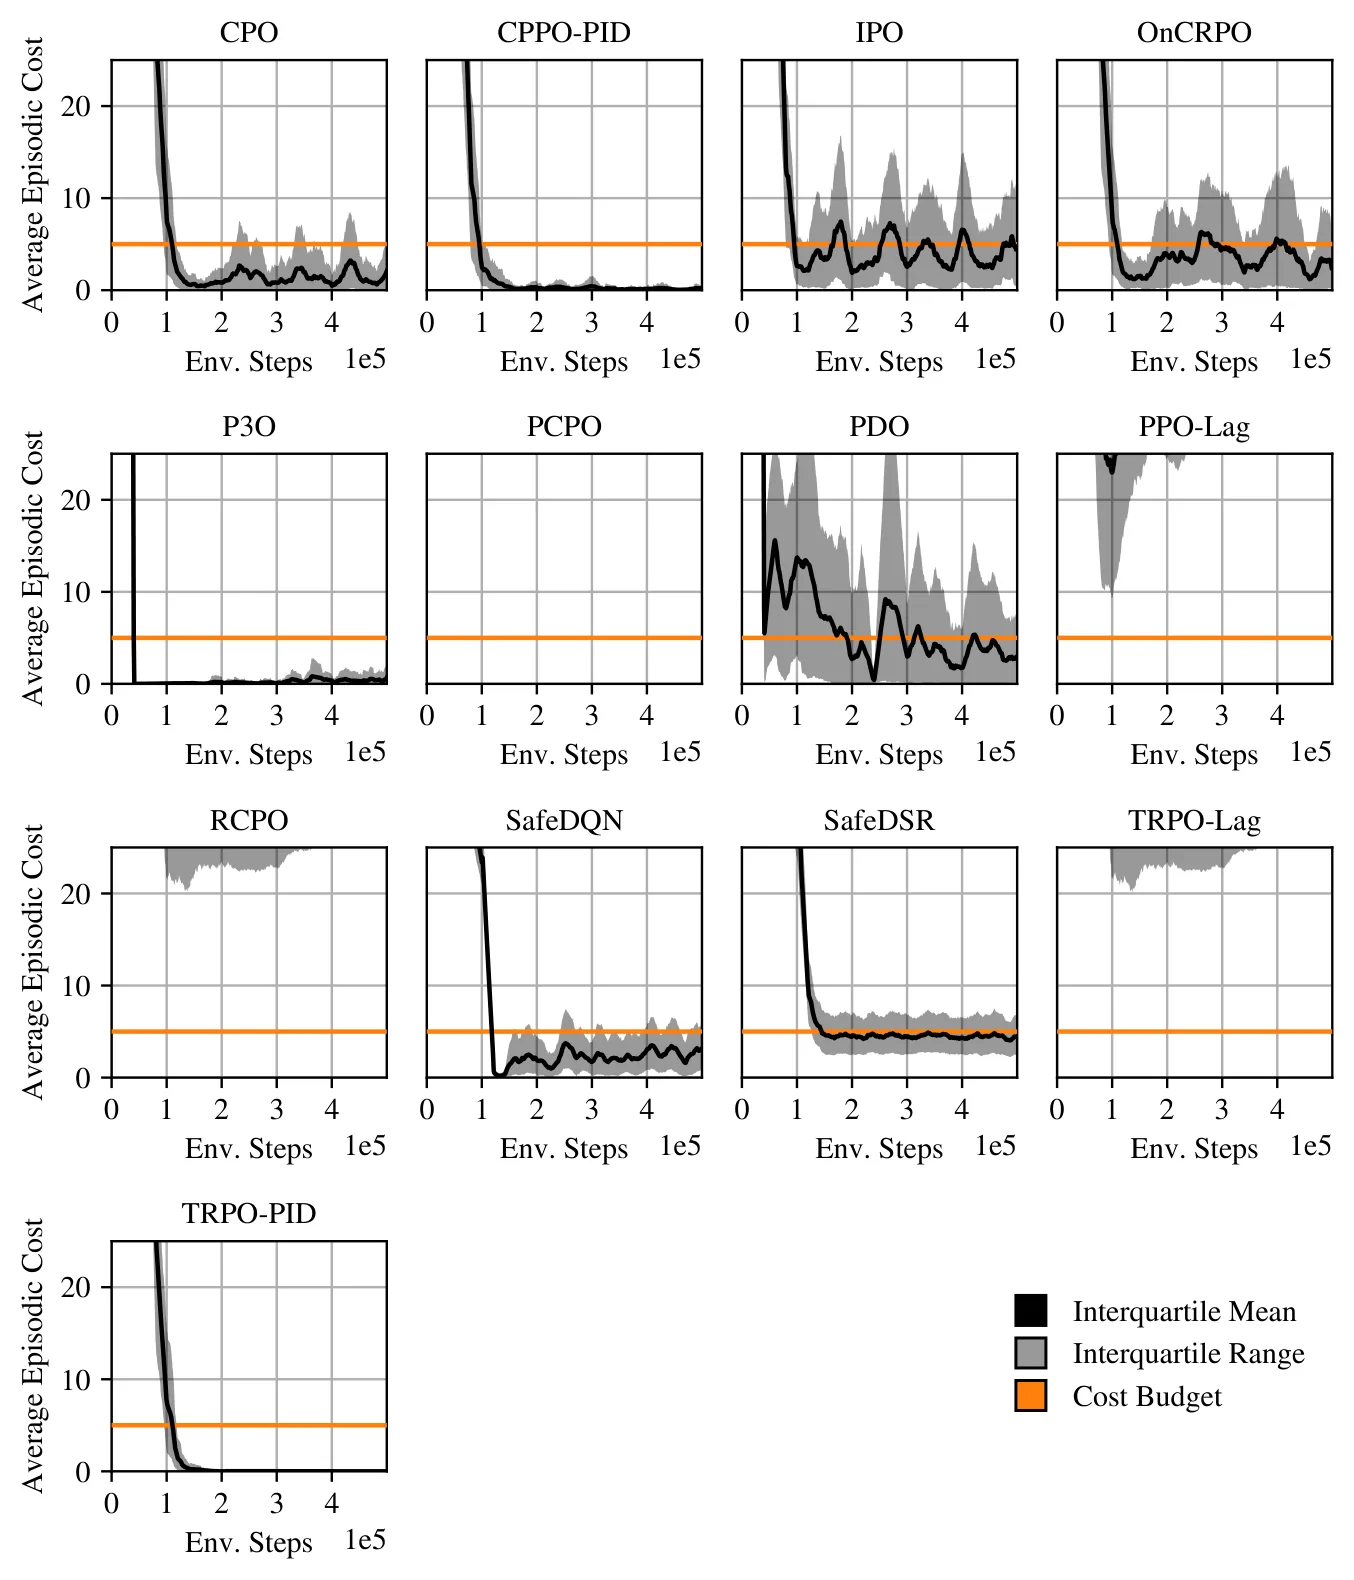
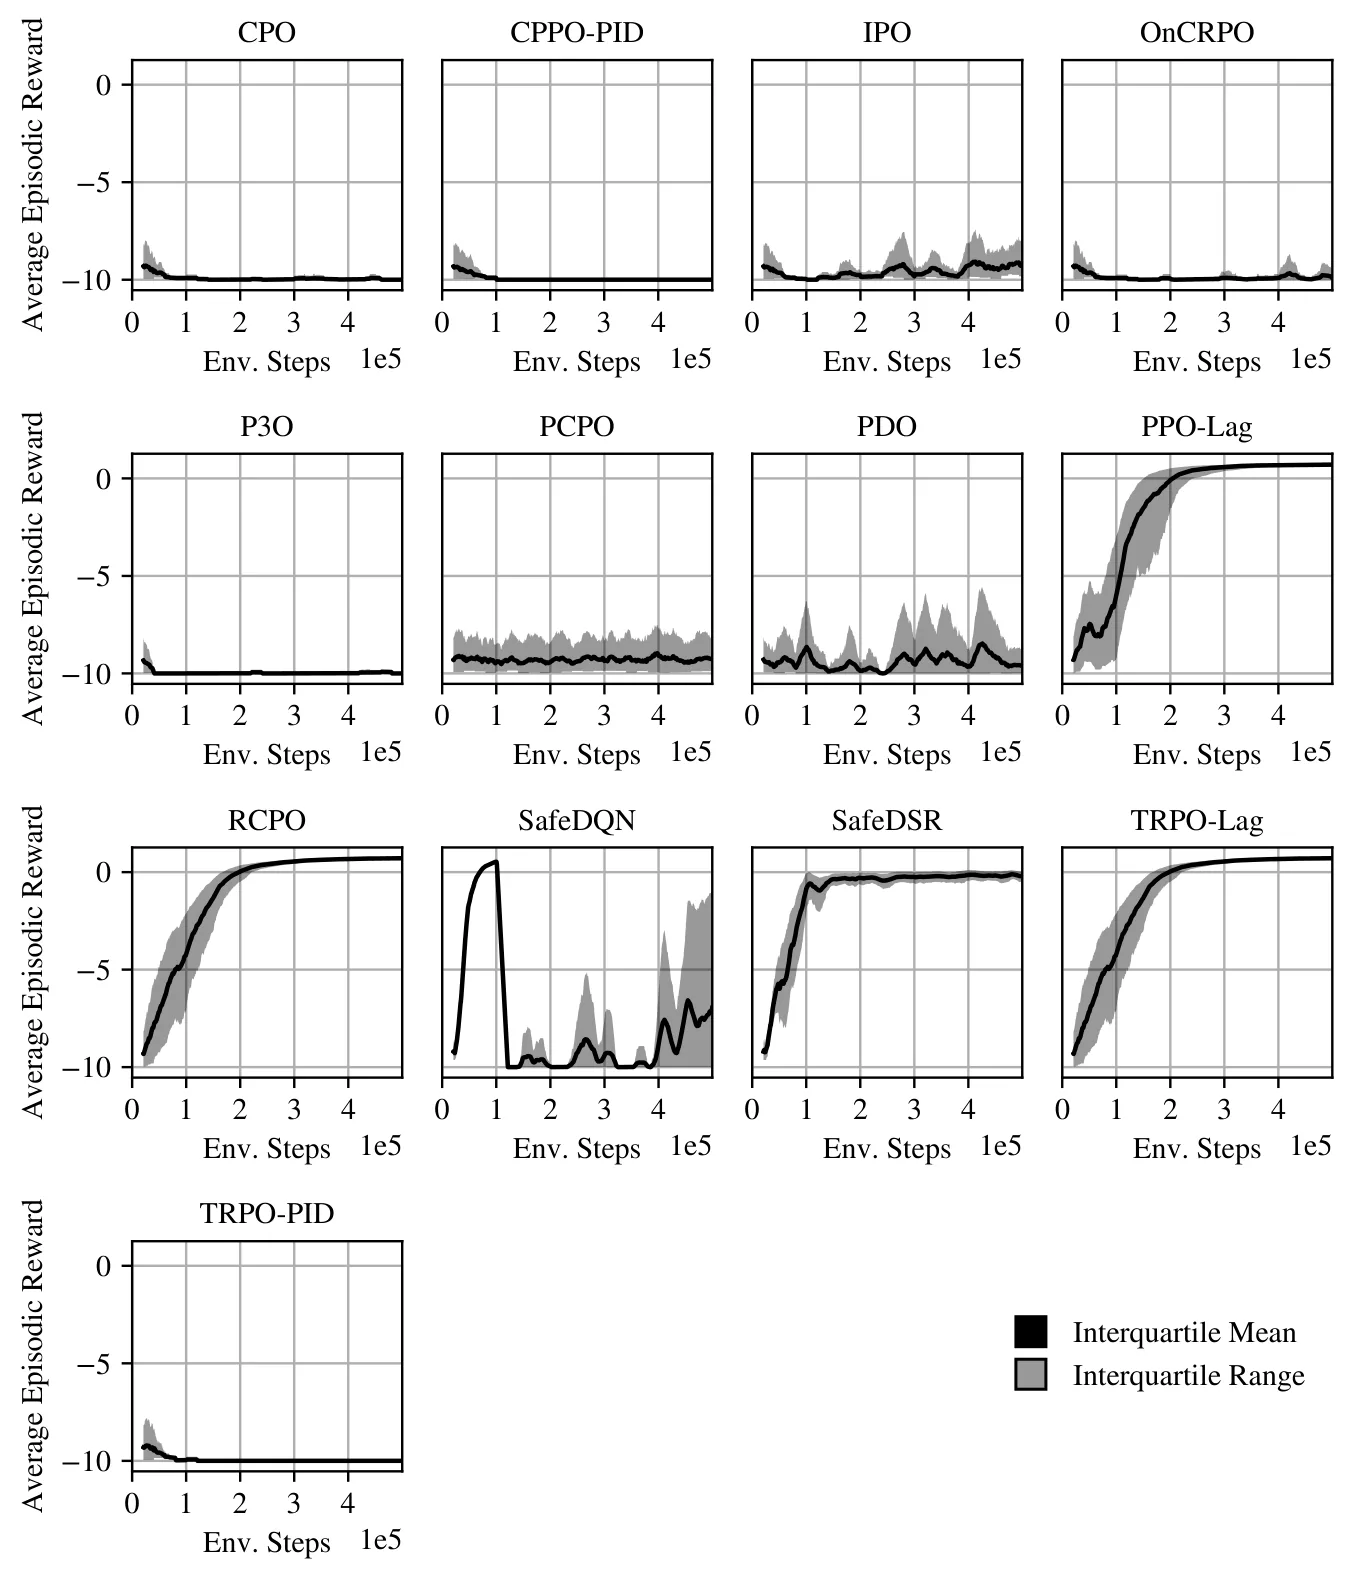
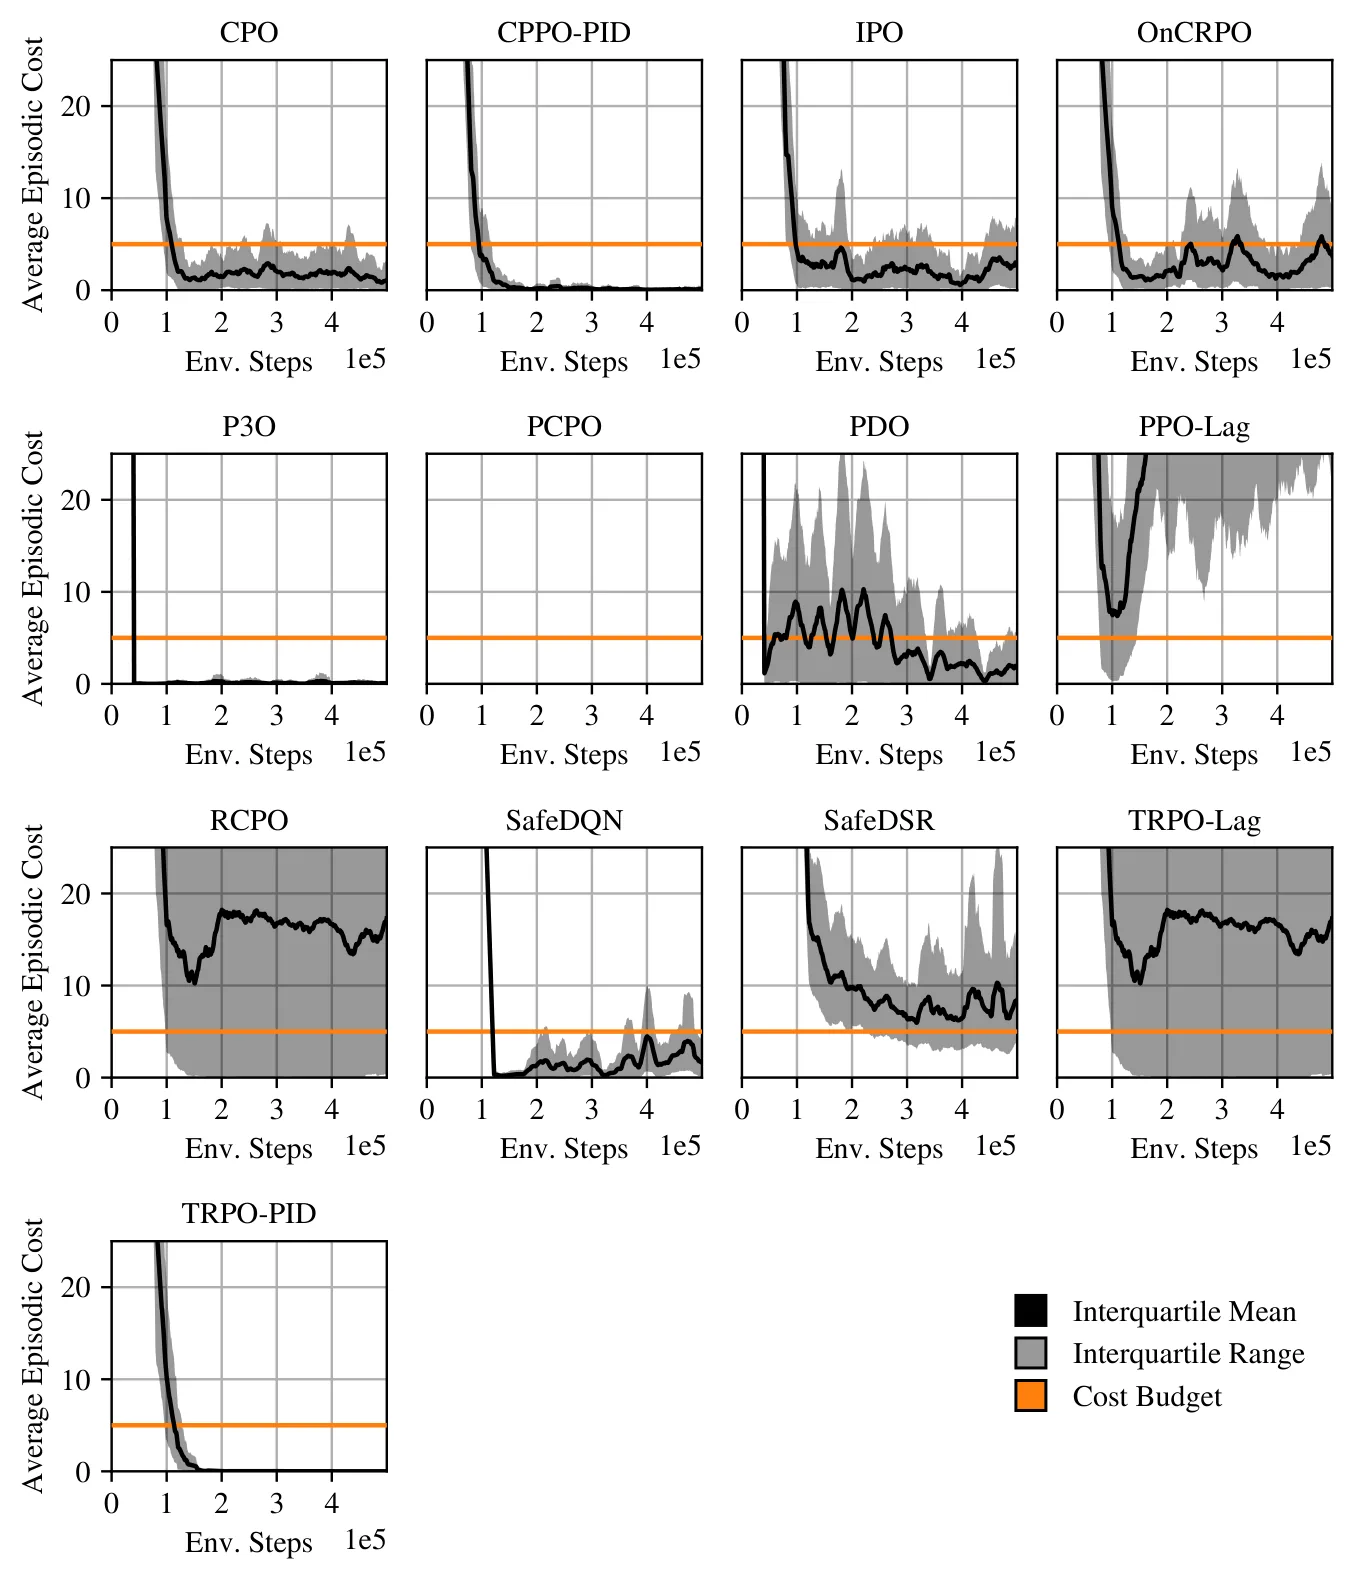
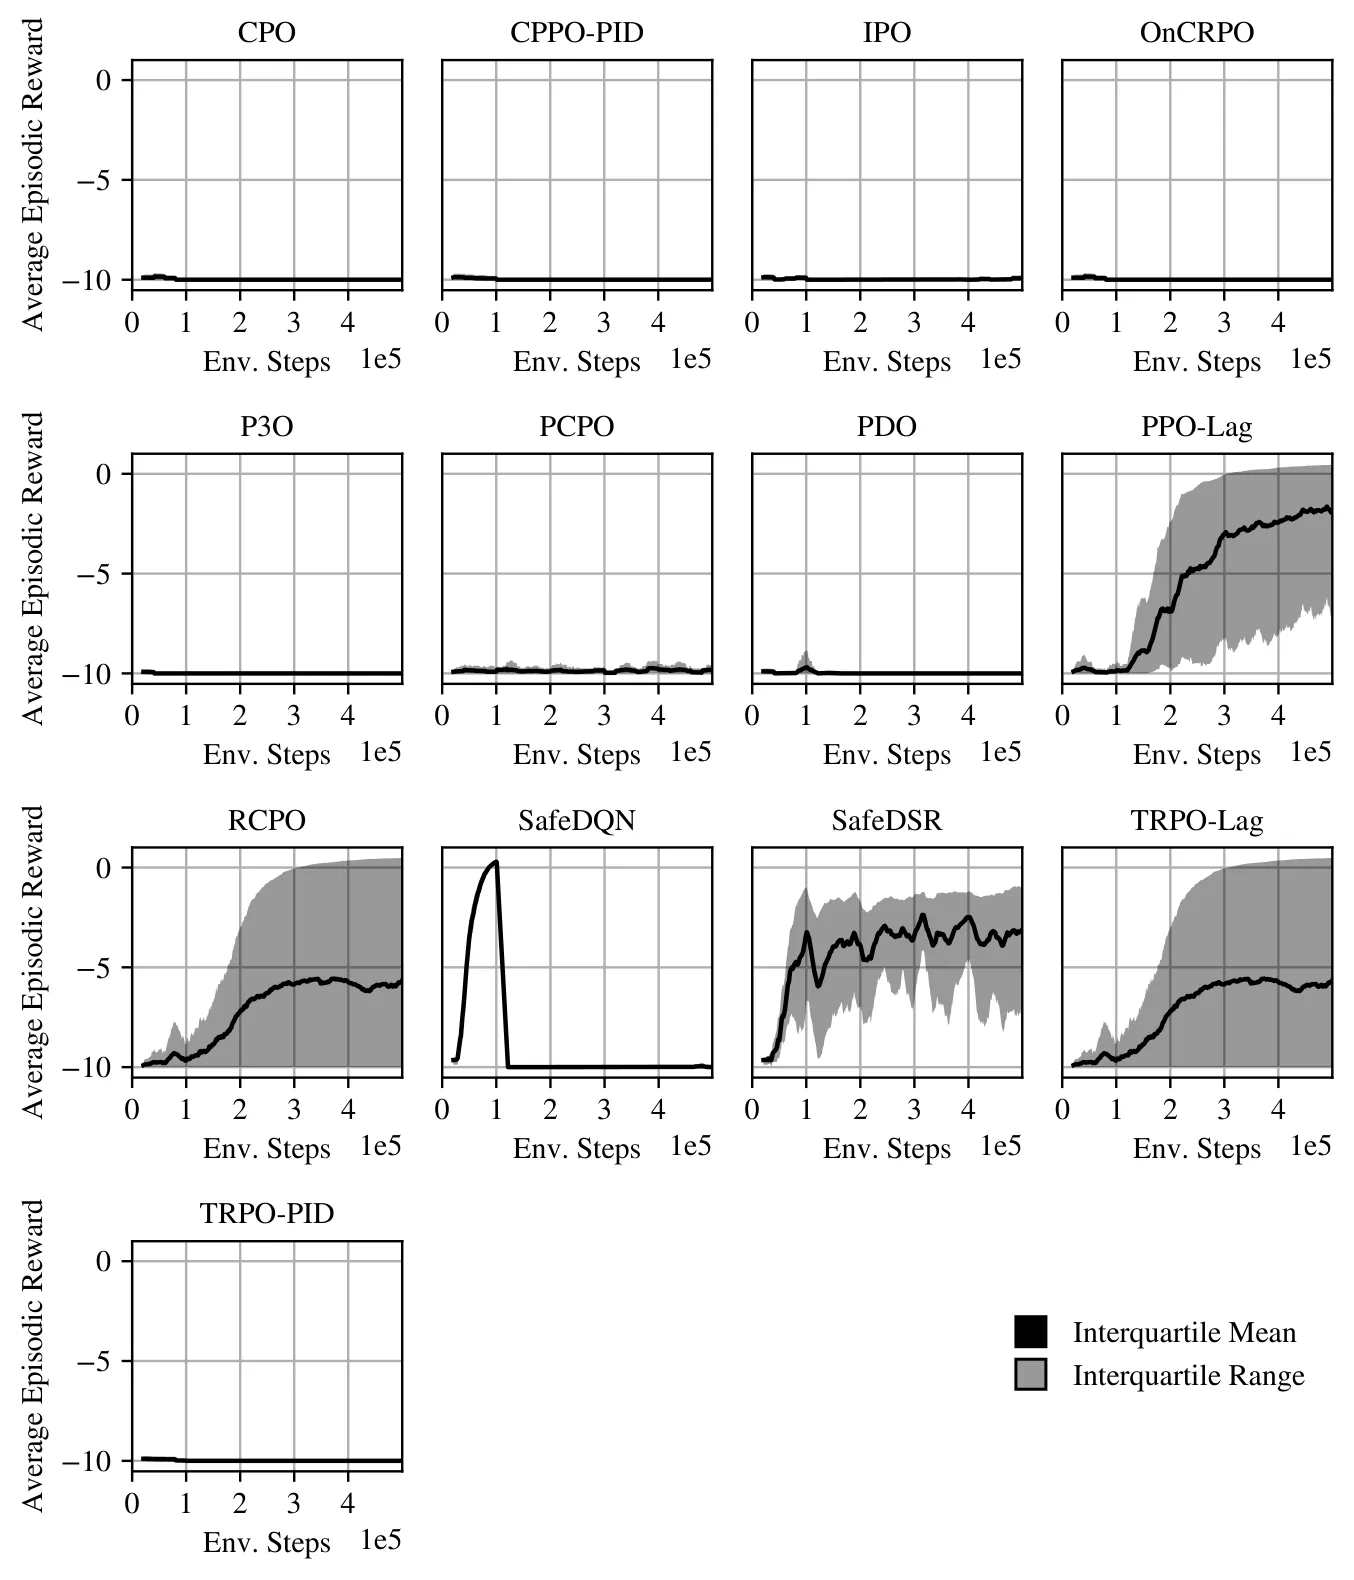
基线对比涵盖了来自 OmniSafe 的 11 种算法以及作者提出的 SafeDQN 基线,共计 13 种方法参与评测。在简单场景下,多个基线(如 CPPO-PID、PPO-Lag、SafeDQN)的表现与 SafeDSR 相当甚至略优。但关键差异出现在复杂场景中:当环境扩展至 2 房间和 3 房间带代价条件时,只有 SafeDSR 能持续找到安全路径,其平均安全目标率分别超过 60% 和 30%,而多数基线要么陷入局部最优(RCPO、TRPO-Lag 卡在角落),要么过度回避代价导致无法完成任务(CPPO-PID),要么严重违反代价约束(PCPO 代价高达 300+)。
消融实验揭示了探索策略的重要性。在同等探索率()下,SafeDSR 的安全目标数(≈2138 IQM)远高于 SafeDQN(≈97.5 IQM),这表明显式学习代价分布比隐式通过 TD 误差感知代价更为高效。
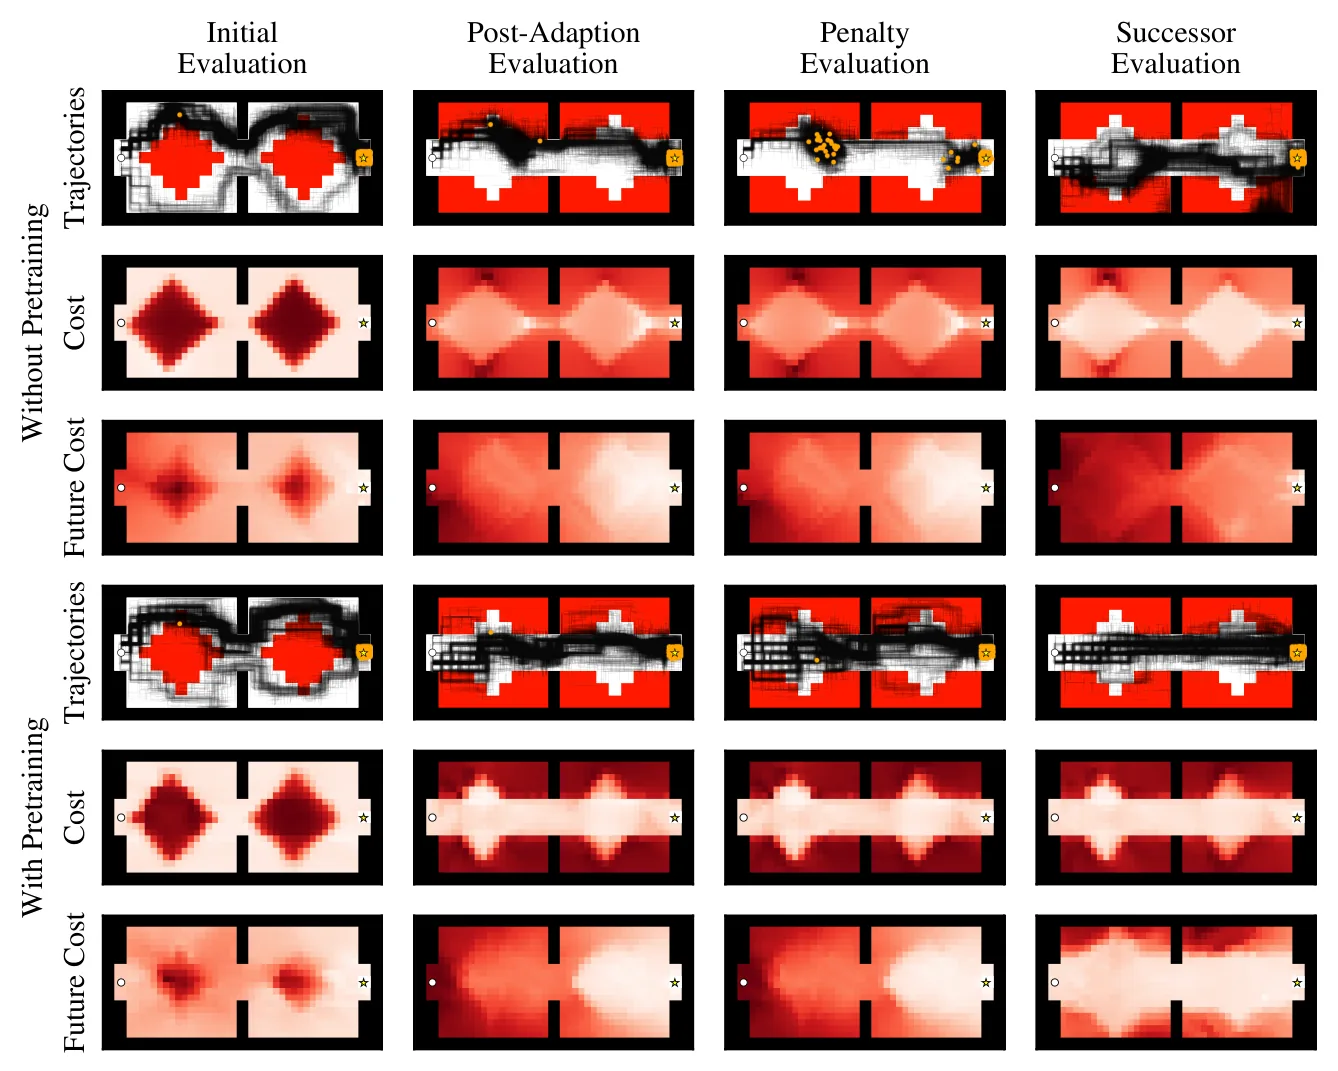
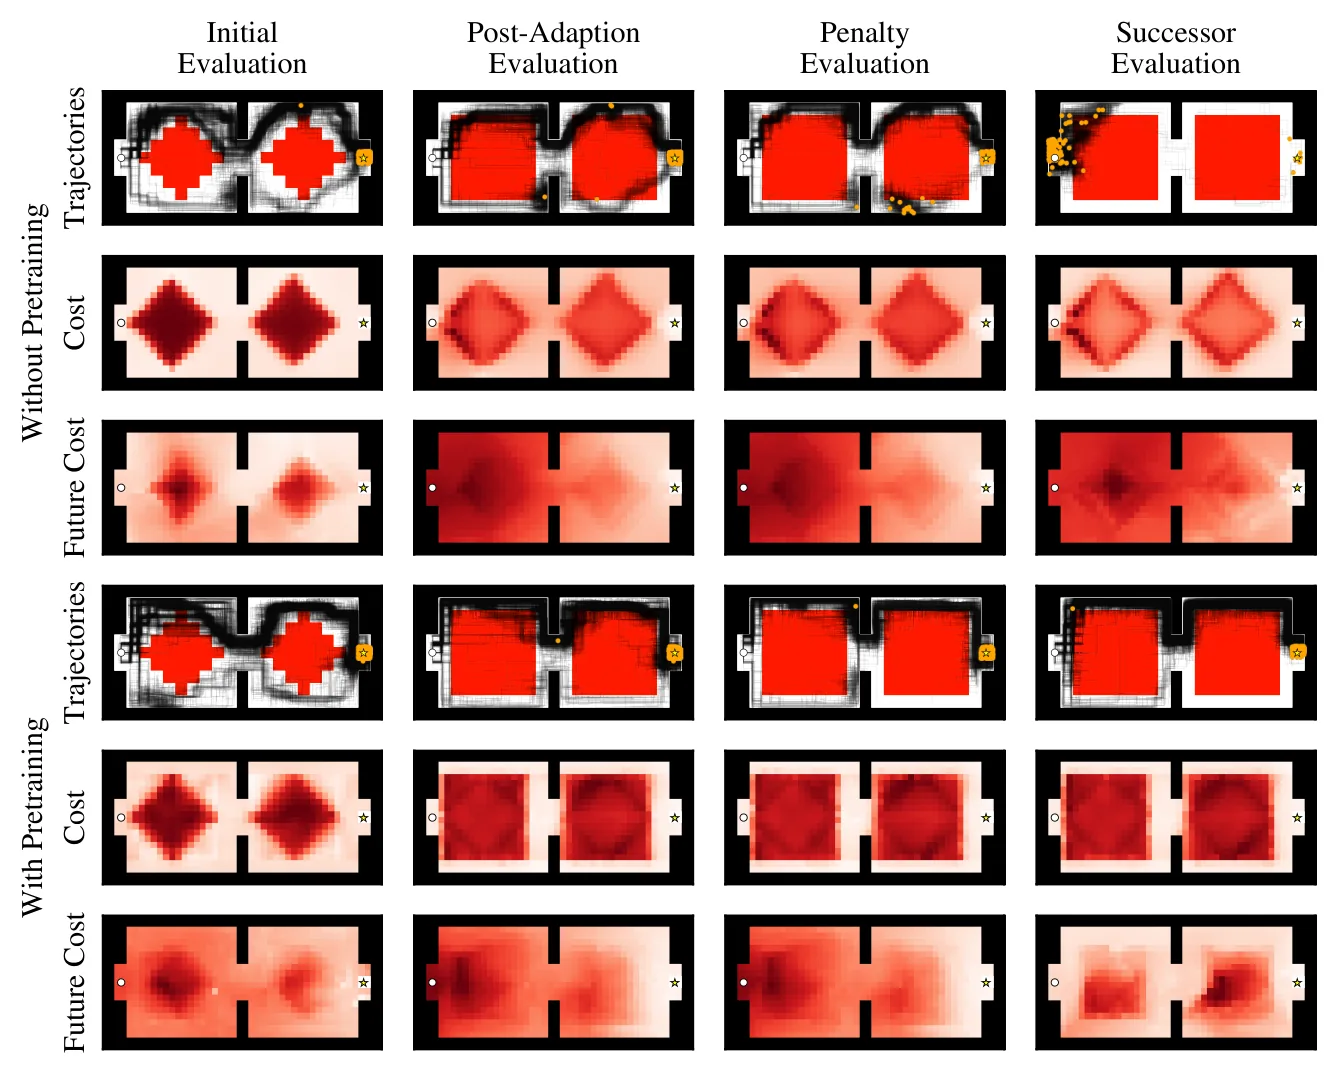
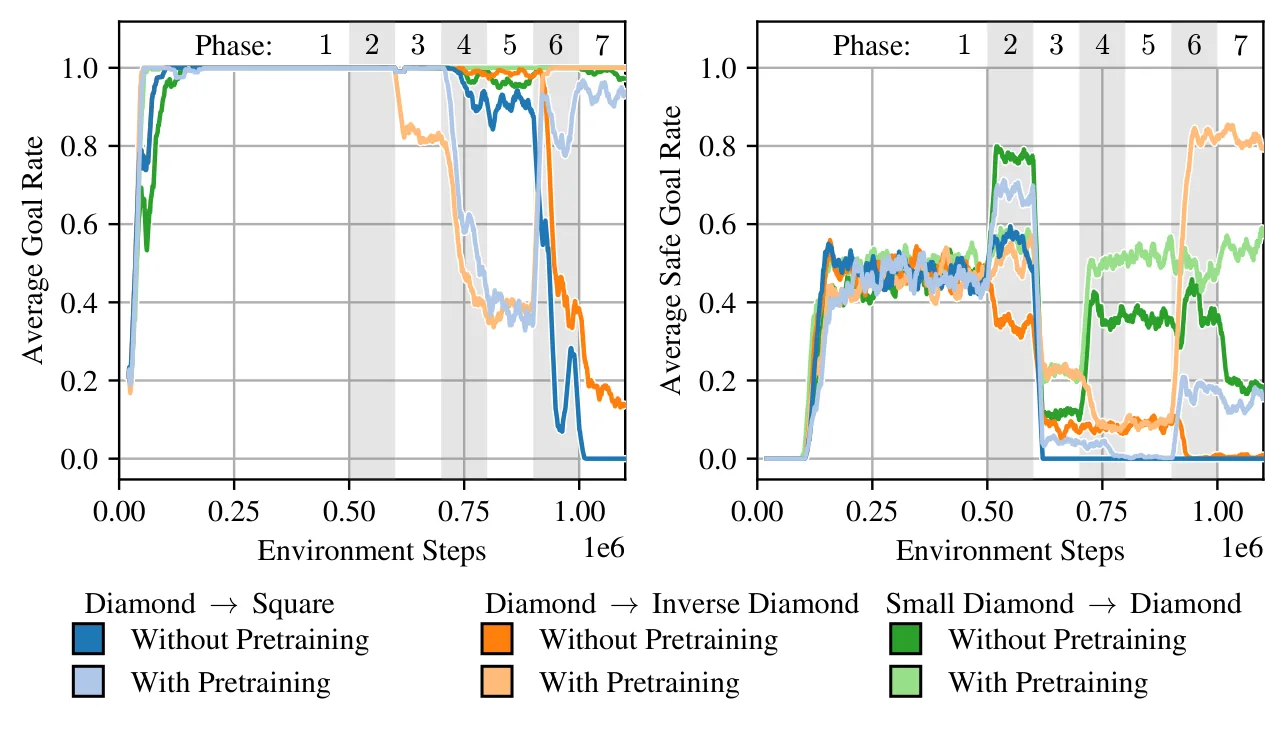
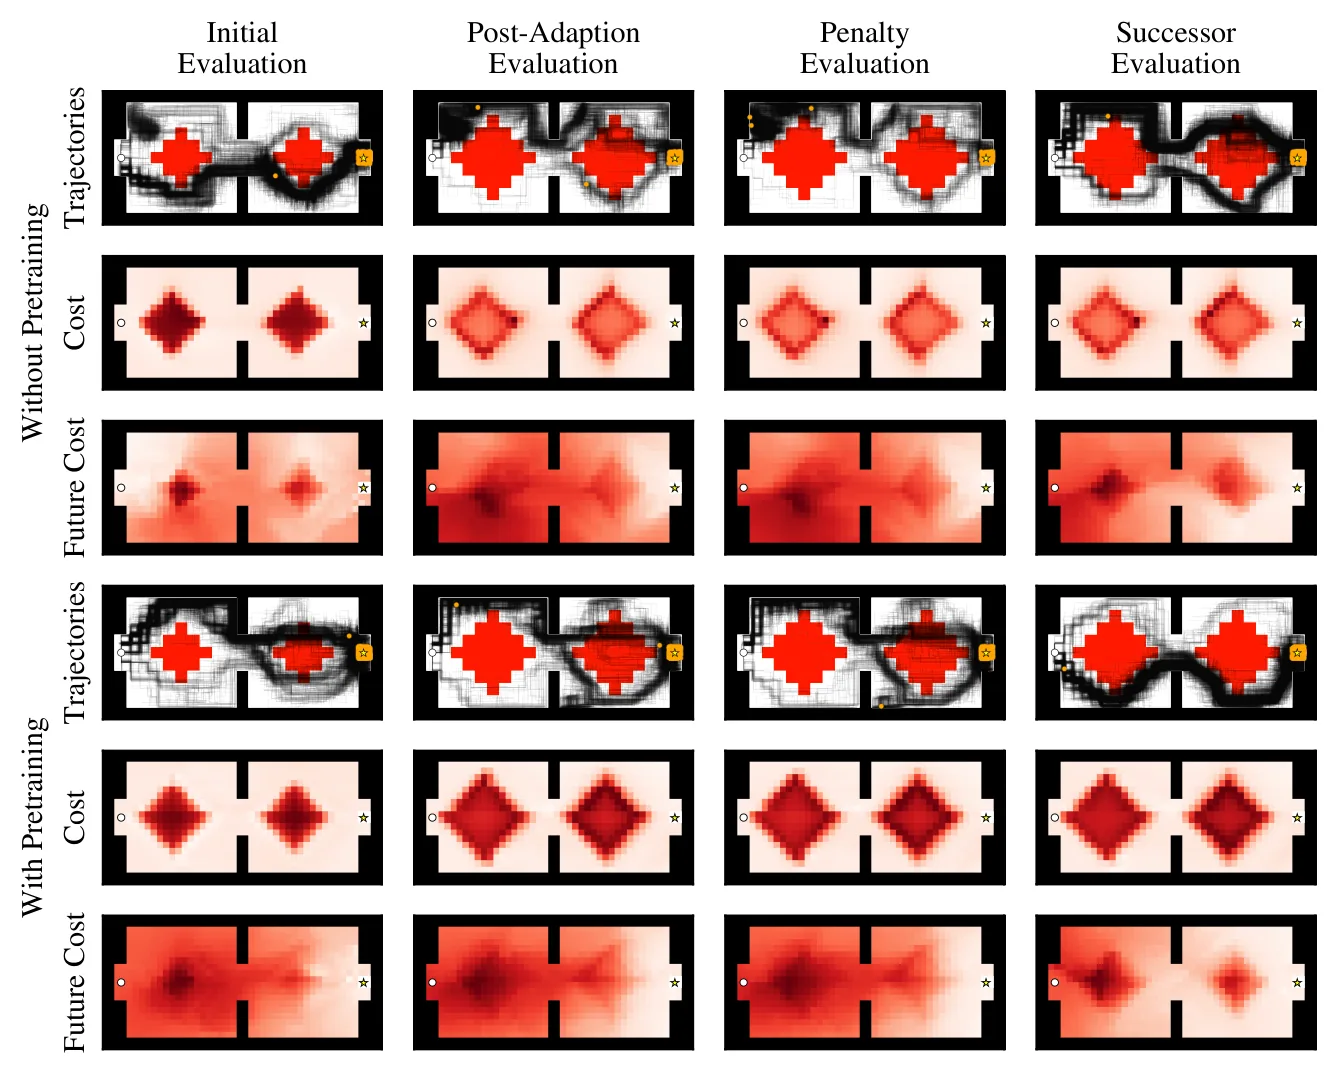
代价结构适应实验进一步验证了方法灵活性。预训练于"钻石"型代价分布的 SafeDSR,在切换到"方形"、"反钻石"或更大"钻石"分布后,能够通过仅更新 和 (或配合 调整)快速恢复可行策略。值得注意的是,即使面对"反钻石"这种对抗性变化——可行区域完全反转——SafeDSR 仍能在少量交互后找到新路径,且预训练的表征显著加速了这一过程。
讨论与可借鉴点
SafeDSR 展示了表征解耦在约束强化学习中的潜力,但仍有明显的局限性。线性假设——奖励和代价必须相对于特征 线性可分——限制了其在高维、非结构化环境(如图像输入)中的应用。当前实现仅支持离散动作空间,连续动作场景需要结合 Actor-Critic 框架方能处理。此外,实验环境的简单性(低维网格、确定性动力学)与真实世界的复杂性存在较大差距。
从方法论角度看,将代价函数变更建模为监督学习问题是一个优雅的思路,它将原本需要从头训练的难题转化为参数高效更新的迁移问题。训练与决策的解耦设计—— 不进入 TD 目标——也值得借鉴,它避免了拉格朗日乘子变化时整个价值网络的震荡。
未来的工作可以在更丰富的环境(如 Safety-Gymnasium)中验证方法的可扩展性,探索特征冻结策略的最优时机,以及引入 PID 控制器替代当前的比例控制器来进一步提升代价适应的稳定性。
摘要
真实世界中的强化学习依赖于将安全约束纳入策略的能力。建模此类约束的一种常见方法是在马尔可夫决策过程中引入额外的成本信号,该信号独立于奖励信号,向智能体通告不良行为。不幸的是,现有方法难以适应成本函数的变化,例如由领域偏移或障碍物随时间移动所引起的变化。适应性的缺失意味着策略过于缺乏灵活性,难以应对复杂的真实世界条件。我们提出了安全深度后继表征(SafeDSR),这是一种允许针对新成本结构快速重训练策略的新方法。SafeDSR 通过引入单一的可学习权重矩阵,将深度后继表征(Kulkarni et al., 2016)扩展到约束强化学习,从而在动力学、奖励和成本之间解耦所学到的价值函数。当环境的成本结构发生变化时,该矩阵可以以监督方式进行更新,而无需调整整个网络。我们在一个可自由配置的二维导航环境中展示了这一能力,并证明我们的方法在一个简单导航任务上具有竞争力,同时显著更加灵活。
Abstract
Real-world Reinforcement Learning depends on the ability to formulate safety constraints into a policy. A common way to model such constraints is to introduce an additional cost signal in the Markov Decision Process, which notifies the agent of unwanted behavior independently of the reward signal. Unfortunately, current methods are hard to adapt to changes in the cost function introduced by, e.g., domain shift or obstacles moving over time. The lack of adaptability means that policies are too unflexible to deal with complex real-world conditions. We propose the Safe Deep Successor Representation (SafeDSR), a novel method that allows quick retraining of policies towards new cost structures. SafeDSR extends the Deep Successor Representation (Kulkarni et al., 2016) to Constrained Reinforcement Learning by introducing a single learnable weight matrix to decouple the learned value function across dynamics, rewards, and costs. This matrix can be updated in a supervised manner instead of having to adapt the whole network if the cost structure of the environment changes. We demonstrate this ability in a freely configurable two-dimensional navigation environment and show that our method is competitive on a simple navigation task while being considerably more flexible
论文详细总结(自动生成)
论文总结:基于后继表征的约束强化学习(SafeDSR)
1. 核心问题与研究动机
- 问题背景:真实世界中的强化学习(RL)需要将安全约束纳入策略。常见做法是将标准 MDP 扩展为约束马尔可夫决策过程(CMDP),在奖励信号之外引入额外的成本信号 与预算 。
- 现有方法的局限性:现有 CRL 算法(如 CPO、PPO-Lag、TRPO-Lag 等)通常假定代价函数 固定不变,当代价结构因域偏移、机器人位置变化、障碍物移动、人员技能变化等原因而改变时,必须从头重新训练策略,代价高昂。
- 研究意义:在机器人导航、电网调度、劳动力排班等实际场景中,灵活应对约束结构变化至关重要。本文目标是让策略能在保持动力学不变的前提下,仅通过少量训练快速适配新的代价函数。
2. 方法论
2.1 整体框架
- 提出 Safe Deep Successor Representation(SafeDSR),将 DSR(Kulkarni et al., 2016)扩展到 CMDP。
- 核心思想:将价值函数解耦为"动力学 + 奖励 + 代价"三部分,使得代价变化时只需更新权重矩阵,无需重新学习动力学。
- 采用 Lagrangian 松弛将 CMDP 转化为无约束优化:
2.2 关键技术细节
(1)后继表征与代价分解
- DSR 学习特征 、奖励权重 、代价权重 ,将 函数和未来期望代价 分别表达为:
- 其中 为后继特征(successor features),刻画期望状态占据。
(2)特征损失扩展
- 将原始 DSR 的特征损失(仅含奖励损失 + 重构损失)扩展为:
(3)决策与代价更新解耦
- 与 SafeDQN 把 Lagrangian 参数 嵌入到训练目标中不同,SafeDSR 仅在决策时使用 :
- 通过比例控制器(proportional controller)在每回合末更新:
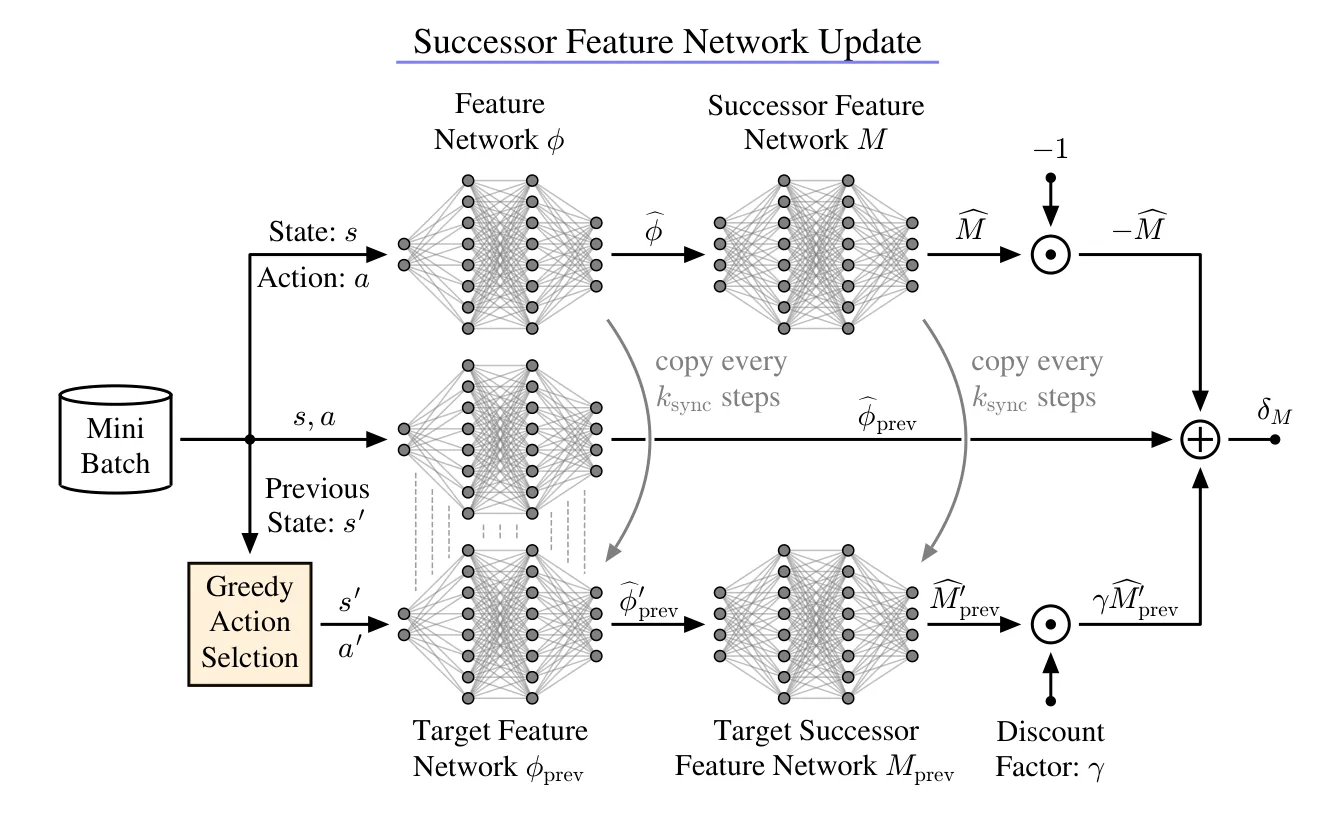
- 后继特征网络 仍按 DQN 风格的时序差分损失训练,但目标由奖励改为 。
- 关键改进:(a) 状态-动作特征 (状态拼接 one-hot 动作);(b) 对 做 归一化;(c) 在 步后冻结 网络(沿用 Barreto et al., 2017);(d) 偏置采样按奖励与各代价的倒数概率进行。
2.3 SafeDQN 基线
- 直接在 DQN 上叠加 Lagrangian 松弛,用 训练 Q 网络;作为对比,凸显 DSR 解耦的优势。
2.4 算法伪代码
- 论文附录 A 给出 SafeDQN(Algorithm 1)和 SafeDSR(Algorithm 2)的完整伪代码,涵盖 -greedy、目标网络同步、特征冻结、双层 mini-batch(均匀采样用于 更新、偏置采样用于 更新)等细节。
3. 实验设计
3.1 环境
- 自建 2D 连续状态/离散动作导航网格:状态 ,四方向离散动作(带 的噪声步长),墙壁反弹,确定性奖励(到达目标得 ,每步 ),每踏入代价格得成本 。
- 单约束(),成本预算 ,折扣因子 。
- 提供 1 房间 / 2 房间 / 3 房间 三种拓扑,以及有 / 无代价两种条件。
3.2 对比方法
- 来自 OmniSafe 的 11 种基线:CPO、CPPO-PID、IPO、OnCRPO、P3O、PCPO、PDO、PPO-Lag、RCPO、TRPO-Lag、TRPO-PID。
- 本文提出的 SafeDQN(自研基线)和 SafeDSR(主方法)。
- 共 13 个算法 × 3 个房间拓扑 × 2 个代价条件,每组 10 个随机种子,训练 500K 环境步。
3.3 评估指标
- Goal Count:训练中到达目标的回合总数。
- Safe Goal Count:到达目标且 的回合数。
- Average Safe Goal Rate:上述安全目标率的滑动均值。
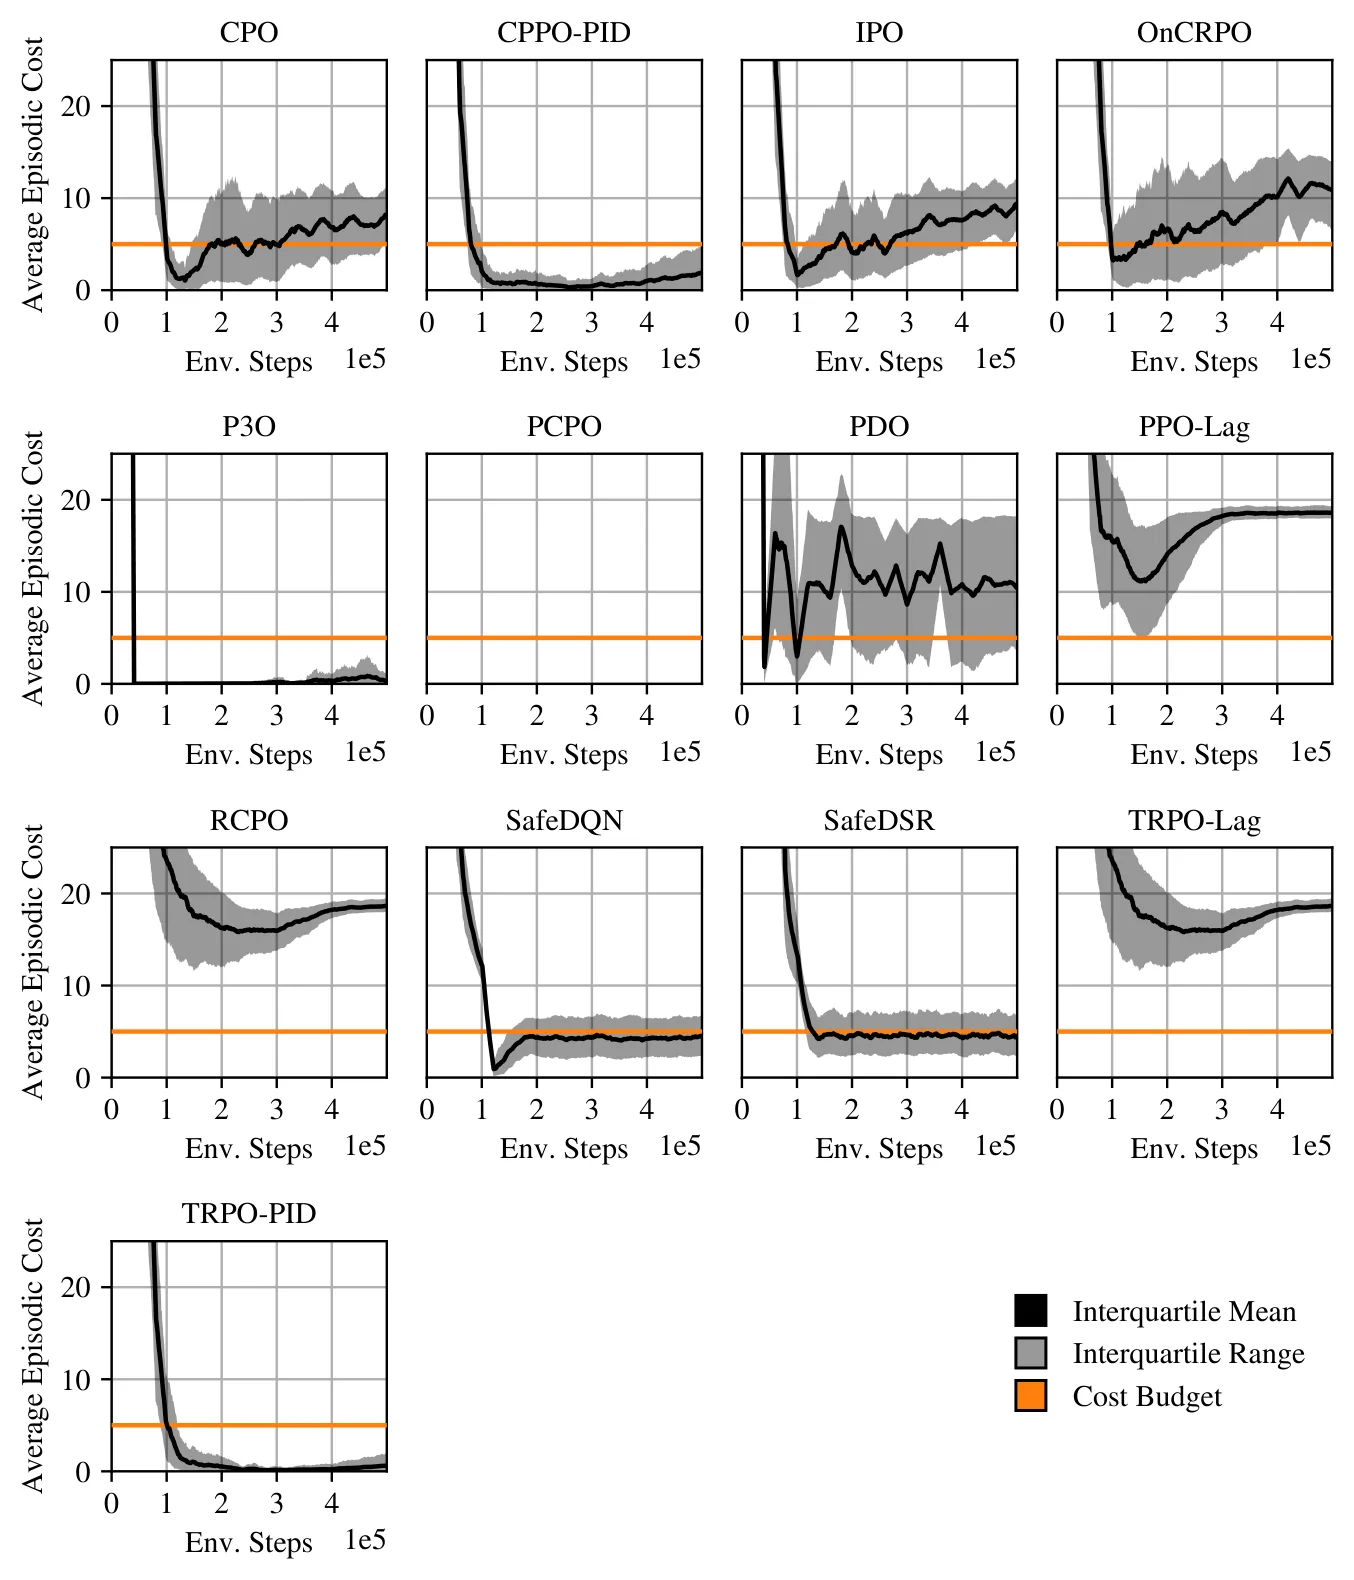
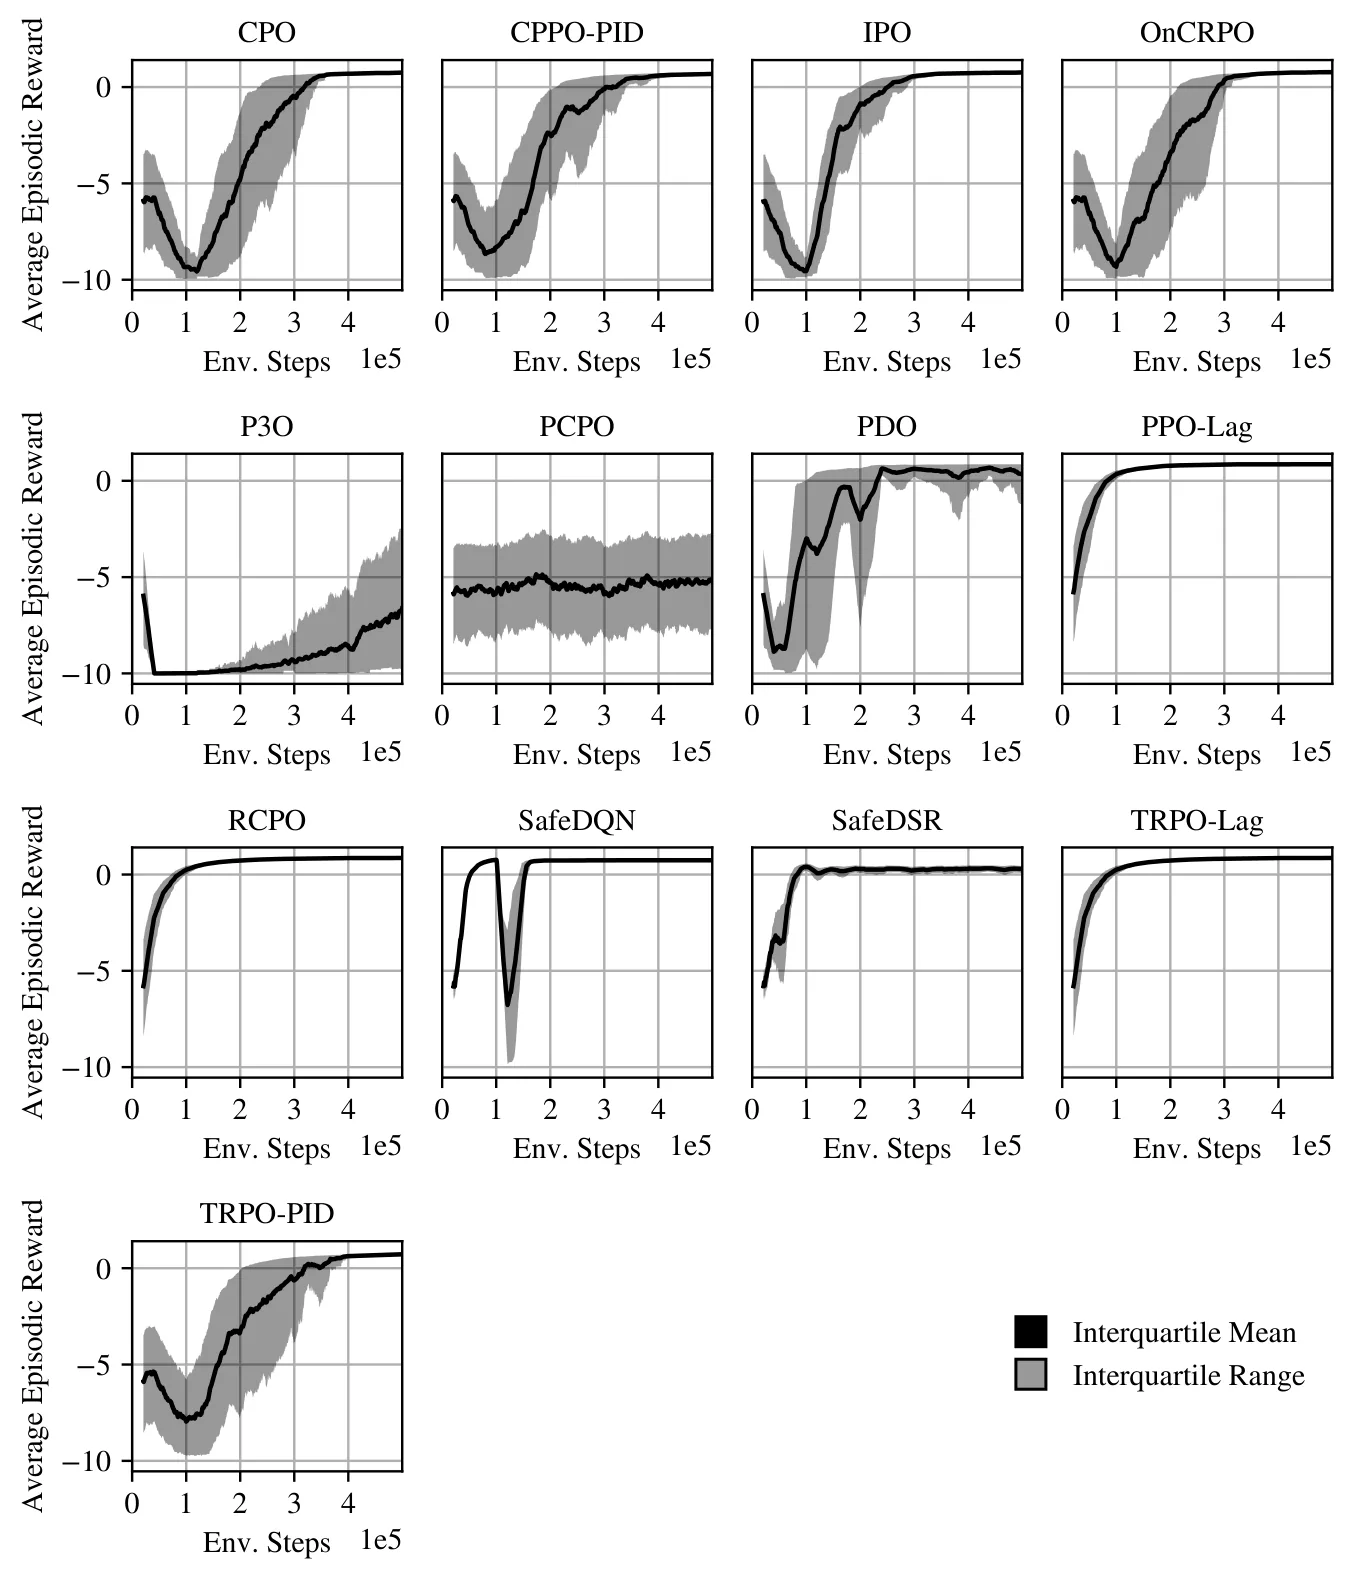
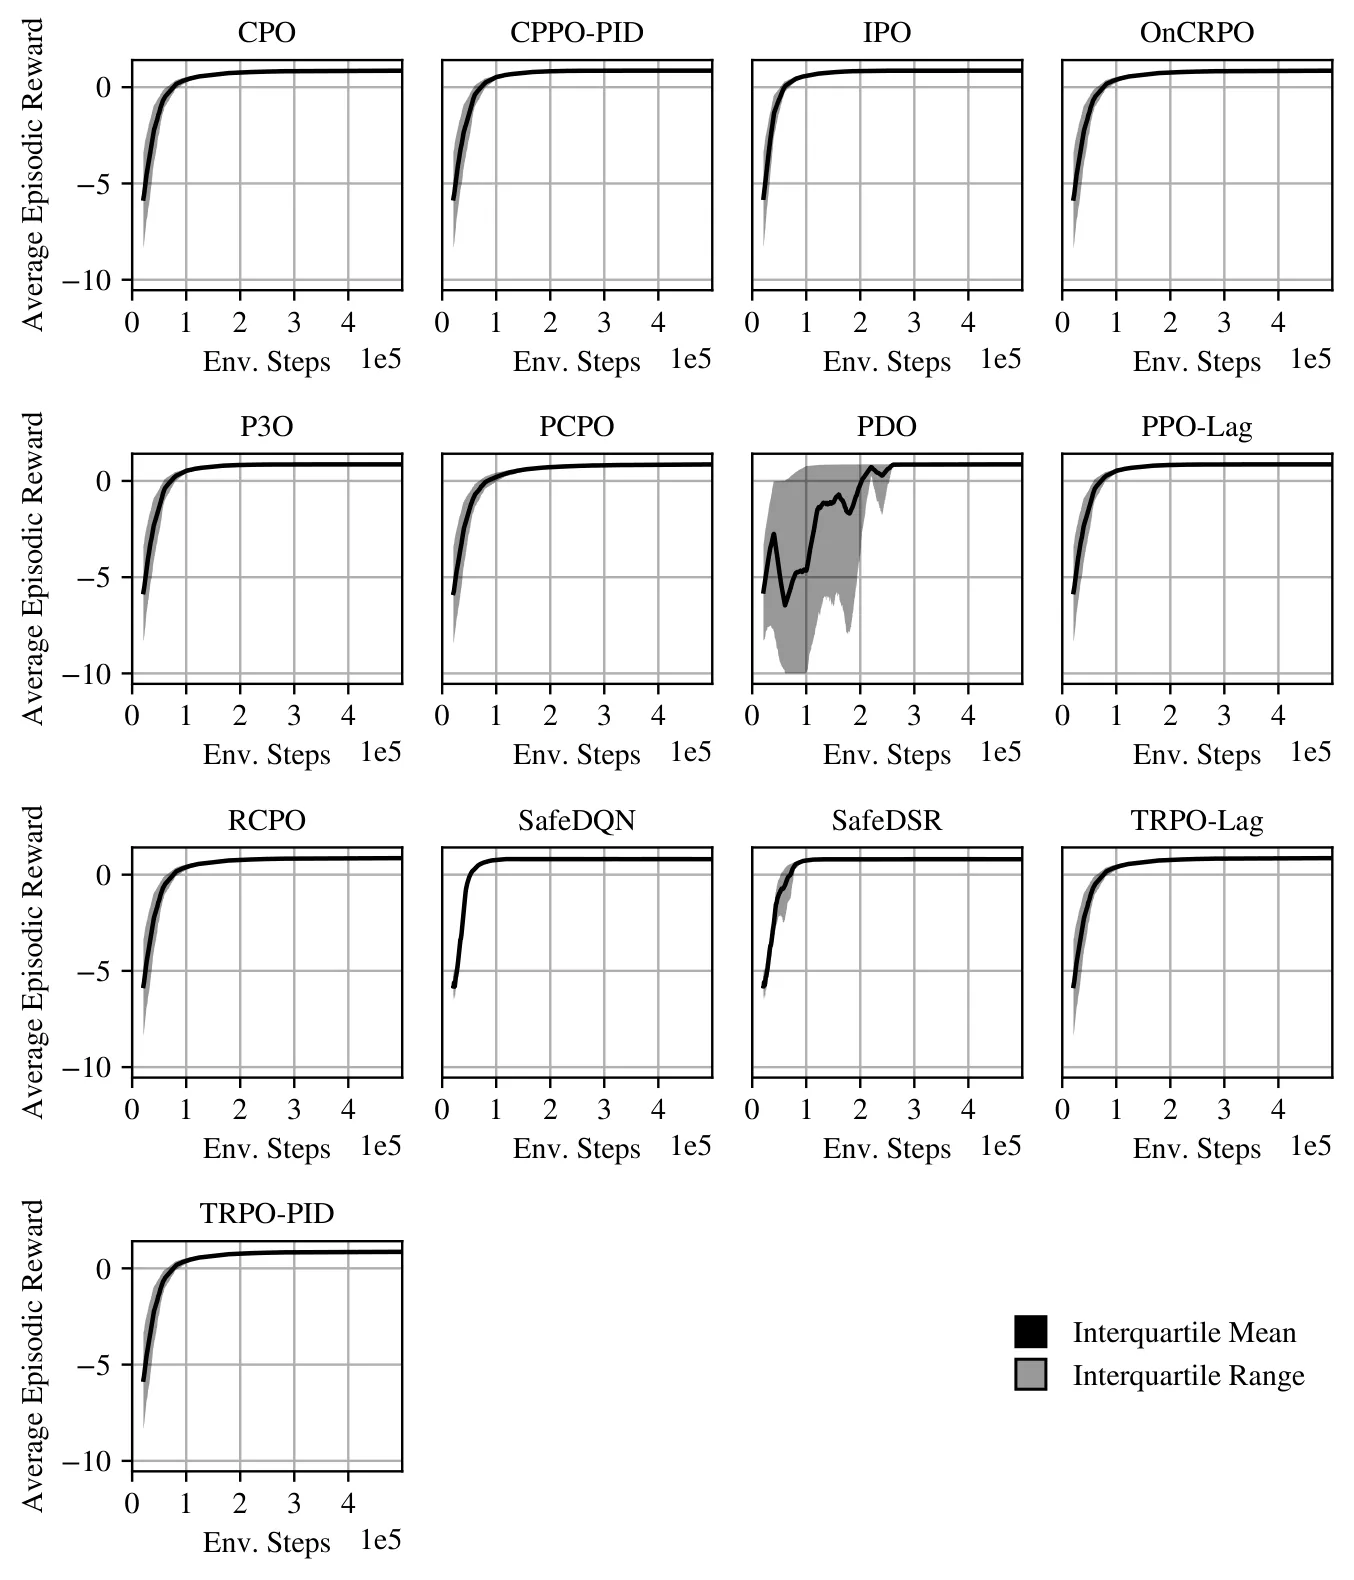
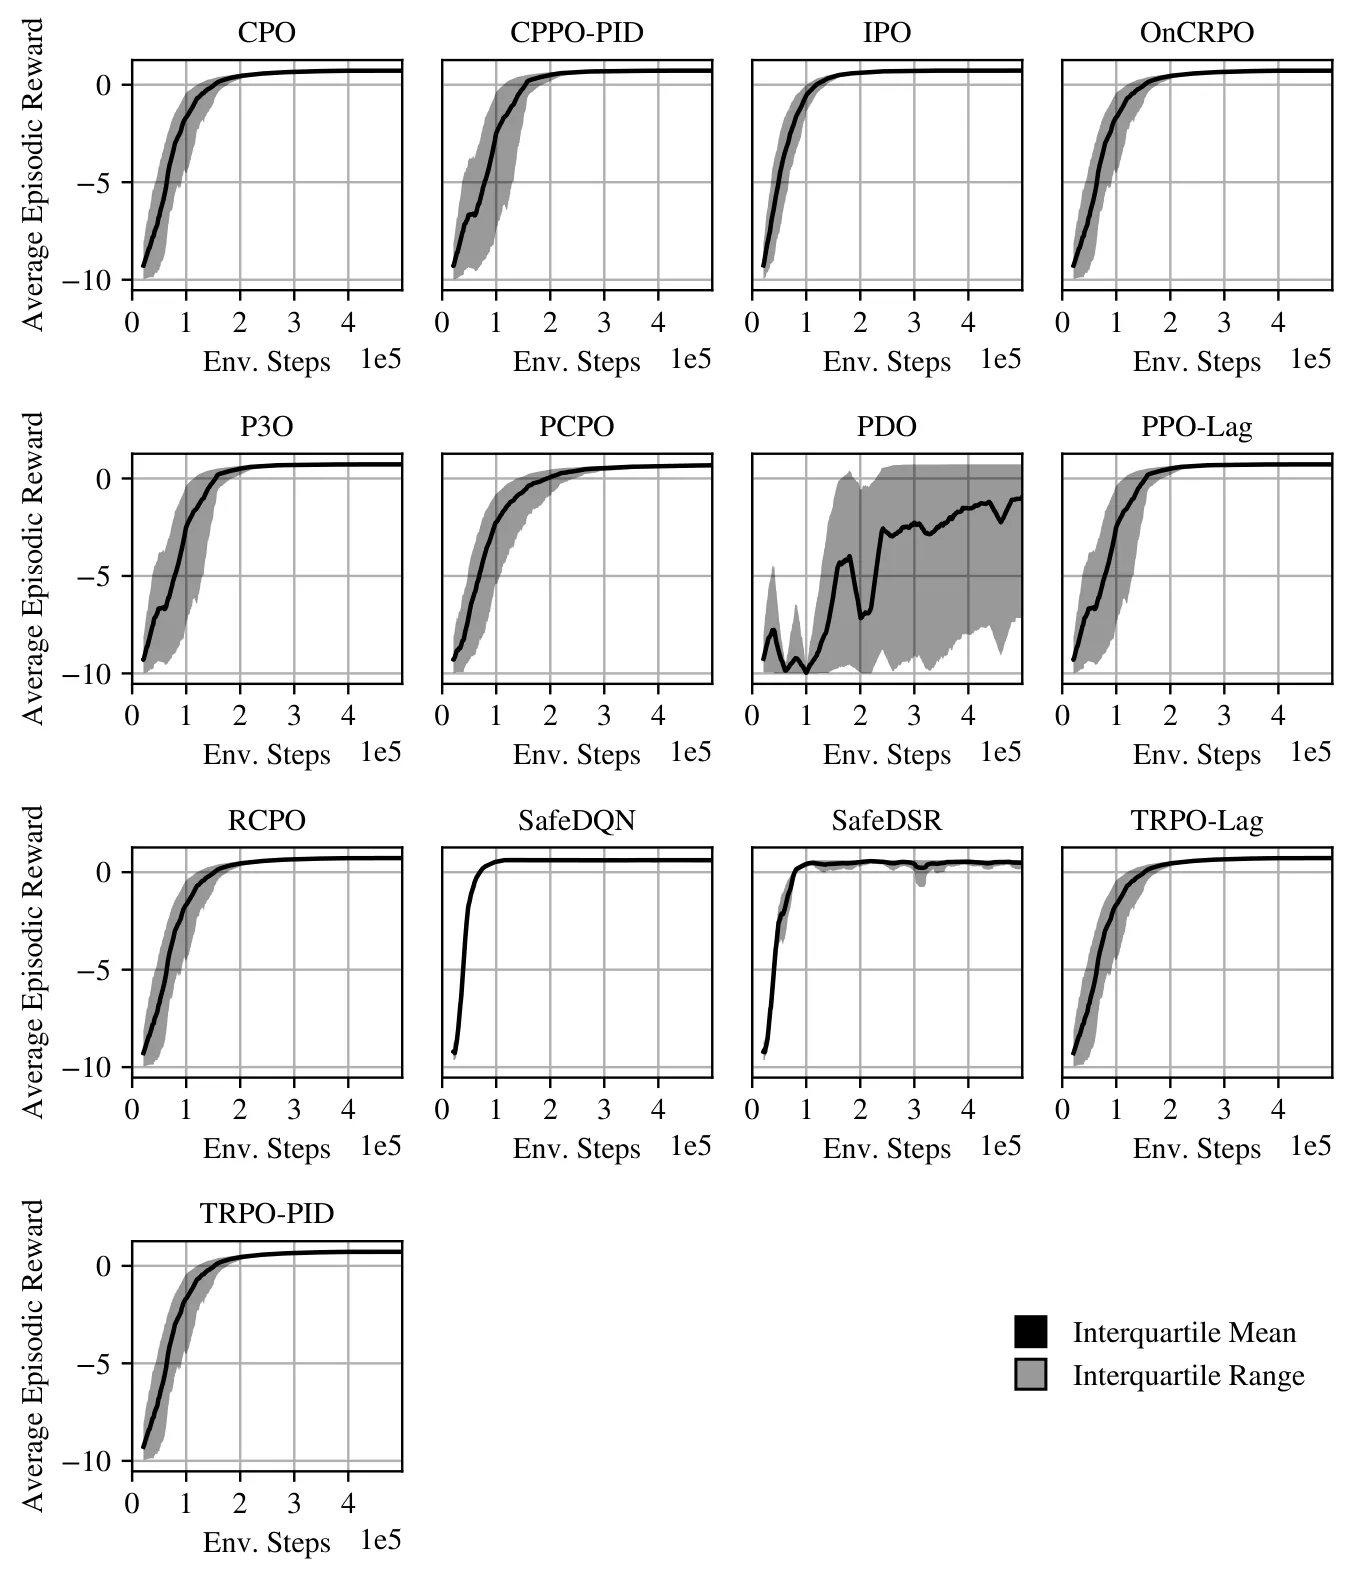
- Average Episodic Reward / Cost:回合平均奖励与成本。
- 报告采用 interquartile mean (IQM) 以抗异常值(rliable 风格)。
3.4 代价结构变化实验(5.4 节)
- 在"钻石"型代价分布上预训练 SafeDSR,然后切换到 (i) "方形",(ii) "反钻石",(iii) 更大的"钻石"。
- 四种评估阶段:初始评估 → 后适配(仅训练 )→ 罚项学习(仅训练 )→ 完整后继特征重训。
- 同时设置预训练 / 无预训练两组对照。
- 使用更简单的 更新规则()以观察适应性。
4. 资源与算力
- 论文未明确说明所用 GPU 型号、数量、训练时长、显存占用等算力信息。
- 仅给出训练总步数(500K 环境步 / 500K–1M 步用于代价变化实验)、batch size(SafeDQN=128, SafeDSR=256)、buffer size、目标网络同步频率等算法超参数,详见附录 B 的 Table 1 与 Table 2。
5. 实验数量与充分性
5.1 实验规模
- 基线对比:13 算法 × 3 拓扑 × 2 代价条件 × 10 seeds ≈ 780 次独立训练。
- 代价变化:3 种新分布 × 4 评估阶段 × 2 预训练条件 = 24 组。
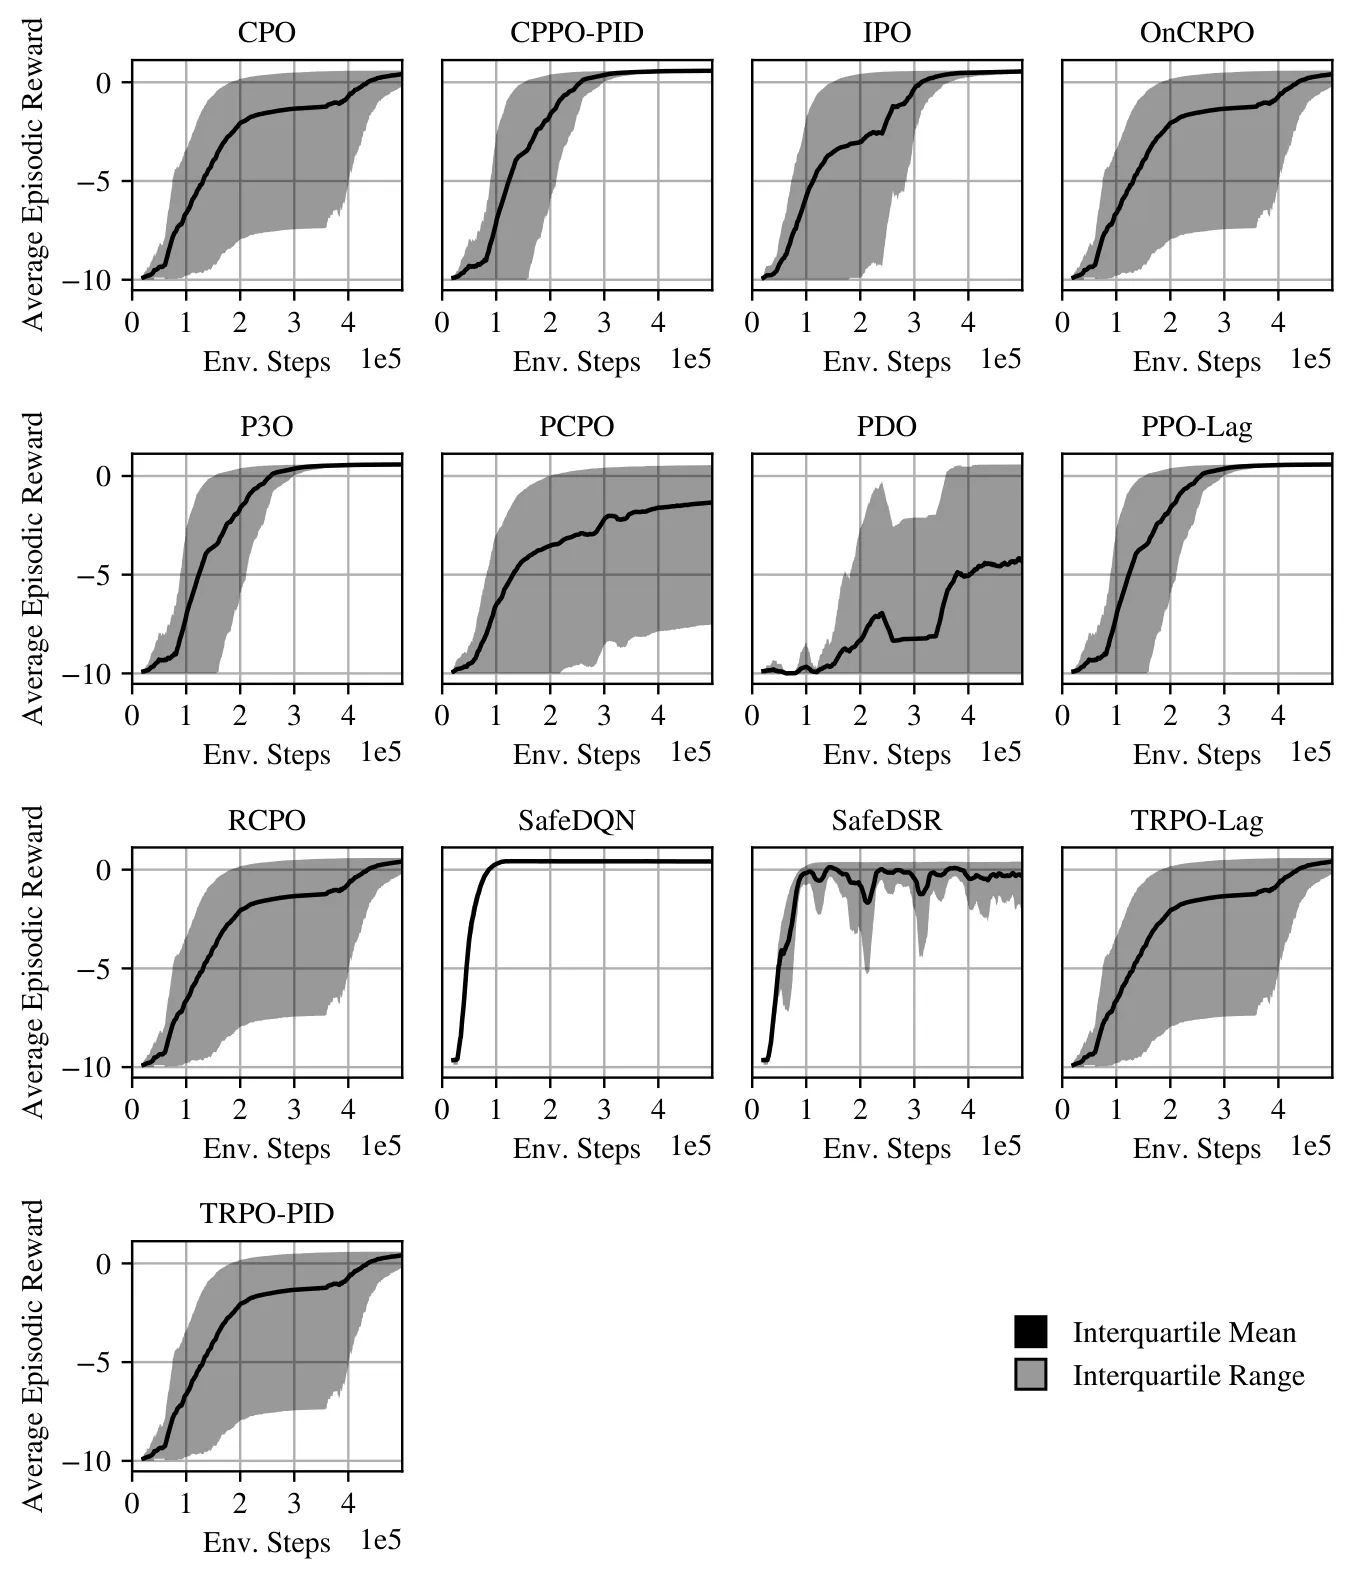
- 辅助分析:附录 F–H 给出 Goal Count、Safe Goal Count、Reward、Cost 的 IQM/分位数表、各算法平均回合奖励/成本的时间序列曲线(6 张),以及代价变化各阶段的安全目标率时间序列。
- 消融与变体:探索率 、Lagrangian 更新延迟()、特征冻结时间 、偏置采样比例(20%)等关键超参数的对比;预训练 vs 无预训练对照;比例控制器 vs PID 控制器的推测性讨论。
5.2 公平性观察
- 作者在文中坦承 OmniSafe 算法使用默认超参,而 SafeDSR 是为该工作专门调参的,SafeDQN 也做了适配,可能导致基线欠优。
- 所有对比均使用 IQM 与分位数报告,统计层面较规范。
- 单环境(连续低维网格 + 离散动作)能否外推到高维、连续动作空间仍是开放问题。
6. 主要结论与发现
- 简单环境表现:在 1 房间无代价或低代价条件下,多个基线(如 CPPO-PID、TRPO-PID、PPO-Lag、SafeDQN)的 Goal Count 与 Safe Goal Count 与 SafeDSR 相当甚至略高。
- 复杂环境表现:在 2 房间与 3 房间带代价条件下,只有 SafeDSR 能持续找到安全路径,其平均安全目标率分别超过 60% 与 30%;多数基线要么陷入局部最优(如 RCPO、TRPO-Lag 卡在角落),要么过度回避代价(如 CPPO-PID),要么代价严重超标(如 PCPO 成本 ≈300+)。
- 解耦收益:在 2 房间带代价条件下,SafeDSR 与 SafeDQN 同样采用 的高探索,但 SafeDSR 的 Safe Goal Count(≈2138 IQM)远高于 SafeDQN(≈97.5 IQM),说明显式学习代价分布更高效。
- 代价结构适应性:即使从"钻石"迁移到"反钻石"这种对抗性变化(可行区域完全反转),SafeDSR 仍能在少量交互后找到可行路径;预训练特征嵌入能进一步加速迁移。
- 关键瓶颈:作者指出许多基线受限于探索策略,而非优化算法本身;这解释了 SafeDSR 与 SafeDQN()在复杂环境中明显占优的原因。
7. 方法与实验的亮点
- 解耦思想新颖:将 CMDP 中的动力学、奖励、代价三者在表征层显式分离,使代价函数变更成为监督学习问题,只需更新一个权重矩阵 。
- 训练与决策解耦: 仅出现在决策阶段,不进入 TD 目标,避免了 变化时整个 Q 网络被重新拉扯的痛点。
- 指标设计:提出 Safe Goal Count / Safe Goal Rate 作为单一、可解释、单调递增的评估指标,避免在 RL 与 CRL 多种奖励/成本度量间做权衡。
- 环境贡献:开源可配置的 2D 约束网格环境,代价分布可调,支持代价变化研究。
- 消融与可视化:附录提供详细轨迹可视化(Figure 7)与多算法时间序列,便于诊断失败模式(卡角、陷入局部最优、过度规避代价等)。
- 代码开源:GitHub 仓库 https://github.com/mgirstl/safedsr 公开。
8. 不足与局限
- 可扩展性受限:DSR 要求奖励/代价相对于特征 线性,在高维、非结构化环境(如图像输入)中往往需要复杂核方法或手工特征工程,难以直接应用。
- 仅限离散动作空间:SafeDSR 沿用 DQN 的 ,无法处理连续动作。作者指出未来可结合 DDPG/SAC/TD3 等 Actor-Critic 框架,但本文未实现。
- 基线对比存在偏差:OmniSafe 算法使用默认超参、SafeDSR 经过专门调参,比较并非完全公平;作者本人也在 5.3 节末尾承认这一点。
- 环境过于简单:单约束、低维、离散动作、确定性奖励的网格任务与 Safety-Gymnasium 等高维基准有较大差距,无法验证方法在更复杂真实场景中的有效性。
- 算力与可复现性细节缺失:未提供 GPU 型号、训练墙钟时间、单次运行耗时等关键信息。
- 参数控制器较简陋:仅使用比例控制,作者推测若采用 PID 控制(参考 Stooke et al., 2020)性能可能进一步提升,但未做对比实验。
- 代价变化实验的公平性争议:不同代价分布的难度差异巨大,绝对奖励/成本不可比;只能依赖轨迹可视化与定性分析。
- 特征冻结带来的冷启动问题:在"反钻石"等对抗变化下,未预训练的模型因从未见过原代价区域而出现"部分可观察"问题,作者仅提出假设但未做系统消融。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。