
📝 TLDR
基于Holmström团队道德风险模型,提出对话式道德风险博弈,用文本游戏刻画语言智能体在'付出查询成本才能帮助他人'场景下的隐藏行动结构。评测7个开源语言模型,发现基座模型常保留本地奖励或查询但不传递改变决策的信息。SFT、RLOO与GEPA等方法虽可提升团队成功,却常改变聚合奖励而不恢复合作机制,提示需机制层面的行为评估。
🧭 速览
当合作中努力成本高、难以观测且主要利好他人时,协调容易失效;现有大模型评测多关注最终结果,忽视隐藏行动机制。
构建对话道德风险博弈文本环境,智能体可保留本地奖励或付费查询以揭示安全事实;评测7个开源模型,分解查询使用、信息传递、本地奖励保留、不安全选择与团队成功等指标,并以SFT、RLOO、顺序SFT+RLOO及GEPA作为诊断式更新机制。
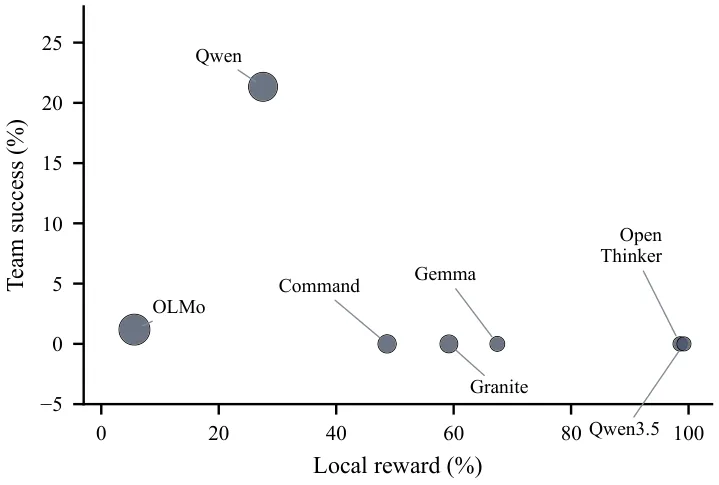
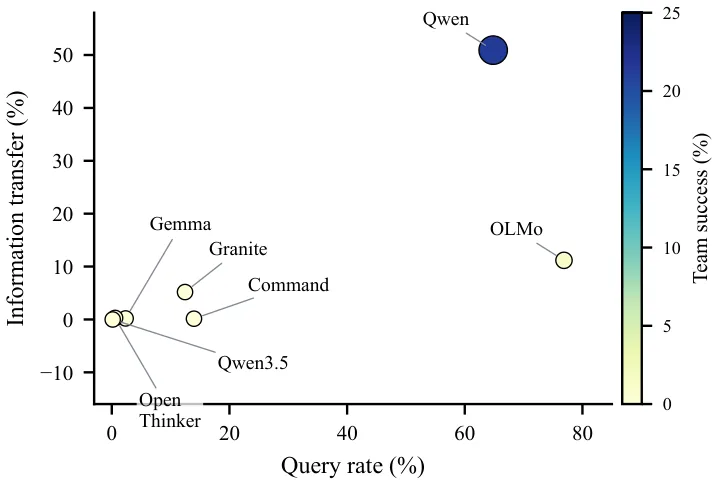
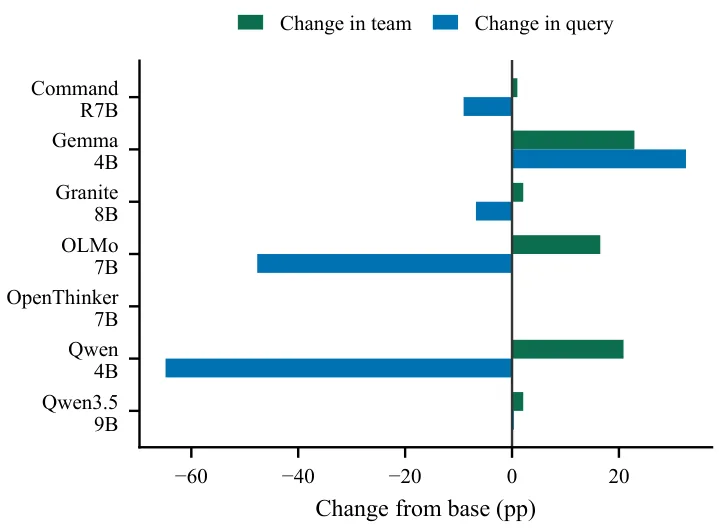
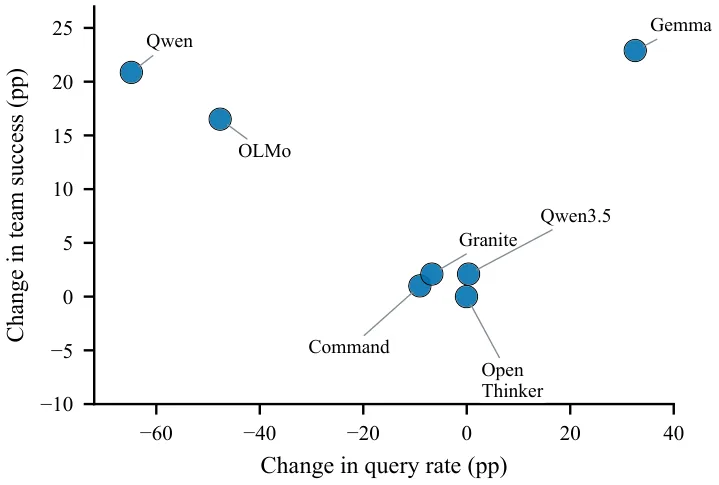
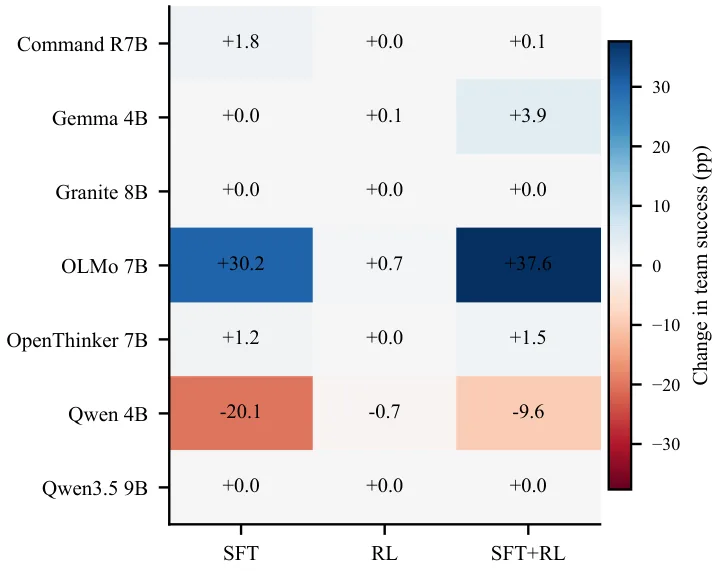
基座模型常保留本地奖励而不促成团队成功,或查询却不传递改变下游决策的关键信息;OLMo-7B微调后呈现机制一致的权重级改进,GEPA则能在提升团队成功的同时减少甚至消除成本性查询。
优化方法可改变聚合奖励却不恢复预期合作机制,呼吁报告机制级行为而非仅看团队成功率。
🆚 方法对比
Dialogue Moral Hazard Game
- 将道德风险结构操作化为文本博弈
- 可独立度量查询、传递与使用三环节
- 区分协议失败与信息使用失败
- 仅隔离单一道德风险结构
- 未能唯一确立经济道德风险
- 适用场景限于两代理查询场景
Holmström道德风险模型
- 提供边际努力比较的理论框架
- 清晰刻画个人收益与团队价值分离
- 为代理行为分析提供数学基础
- 原始模型不直接适用于语言代理
- 需要适配才能用于文本博弈
- 线性假设在离散动作中需重新解释
基座模型评估
- 覆盖七款开源模型具广泛代表性
- 三种子种子形成完全匹配实验
- 揭示查询与传递脱节的失败模式
- 大多数模型存在环节断裂
- 难以同时实现查询、传递与团队成功
- 基线行为高度异质难以统一
监督微调(SFT)
- 在OLMo-7B上呈现最清晰的权重改善
- 通过LoRA高效适配模型参数
- 能改变查询等机制级行为
- 对不同模型效果高度异质
- 可能未恢复预期的合作机制
- 对查询成本的敏感性不足
RLOO
- 通过留一法提供低方差策略梯度
- 可作为强化学习诊断更新机制
- 与SFT组合形成完整训练流程
- 单独使用效果有限且不一致
- 可能改变聚合奖励而非机制
- 对不同模型表现差异显著
序列式SFT+RLOO
- 结合SFT稳定与RL优化能力
- 在部分模型上展现机制改善
- 形成渐进式训练诊断流程
- 训练流程复杂计算成本较高
- 效果仍依赖底层模型选择
- 未一致恢复预期合作机制
GEPA提示优化
- 有时在消除查询的同时提升团队成功率
- 无需权重更新即可改善聚合表现
- 为提示级干预提供诊断视角
- 绕过了代价性查询的核心机制
- 可能以非预期方式获得团队收益
- 未恢复预期合作行为路径
本文提出的对话式道德风险博弈统一评估了七款基座模型与四种更新机制(SFT、RLOO、序列SFT+RLOO、GEPA),发现权重级方法在OLMo-7B上改善机制一致性,而GEPA提示优化通过绕过代价性查询提升团队成功率,揭示了聚合奖励与机制级行为的脱节。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
这篇论文借鉴 Holmström 的团队道德风险理论,设计了一个名为「对话道德风险博弈」的文本游戏,来测试语言模型在「付出查询成本才能帮助他人」场景下的合作能力。实验对七个开源语言模型进行了系统评估,发现基础模型普遍存在「保留本地奖励但不合作」或「查询但不传递关键信息」的问题。通过监督微调、RLOO、GEPA 等方法进行优化后,虽然某些情况下团队成功率提升了,但合作机制本身并未被真正恢复——这提示研究者需要关注机制层面的行为评估,而不仅仅是表面上的团队成功率。
研究背景与动机
在现实世界中,许多合作失败并非源于恶意或无能,而是因为努力本身成本高昂、难以被观测,且收益主要流向他人。这种经典的道德风险问题在 [[Holmström]] 的团队道德风险模型中得到了系统性的刻画:当团队成员的努力不可观察时,个体会理性地选择「搭便车」,从而导致整体福利的损失。
随着 [[语言智能体]](Language Agents)逐渐承担起复杂的多步骤任务,一个重要的问题浮现出来:当这些智能体需要协作完成目标时,它们是否会面临类似的道德风险?如果一个智能体的付出主要惠及另一个智能体,而这种付出又难以被外部观测,它会选择合作还是自利?
论文的核心动机是构建一个可控、可计算的实验环境,将 Holmström 的隐藏行动结构操作化为语言智能体能够参与的形式。已有的多智能体基准测试往往侧重于联合行动的成功与否,而忽略了对底层合作机制的诊断性评估。这篇论文试图填补这一空白:通过设计专门的博弈结构,区分「表面成功」与「真正合作」之间的差异。
方法
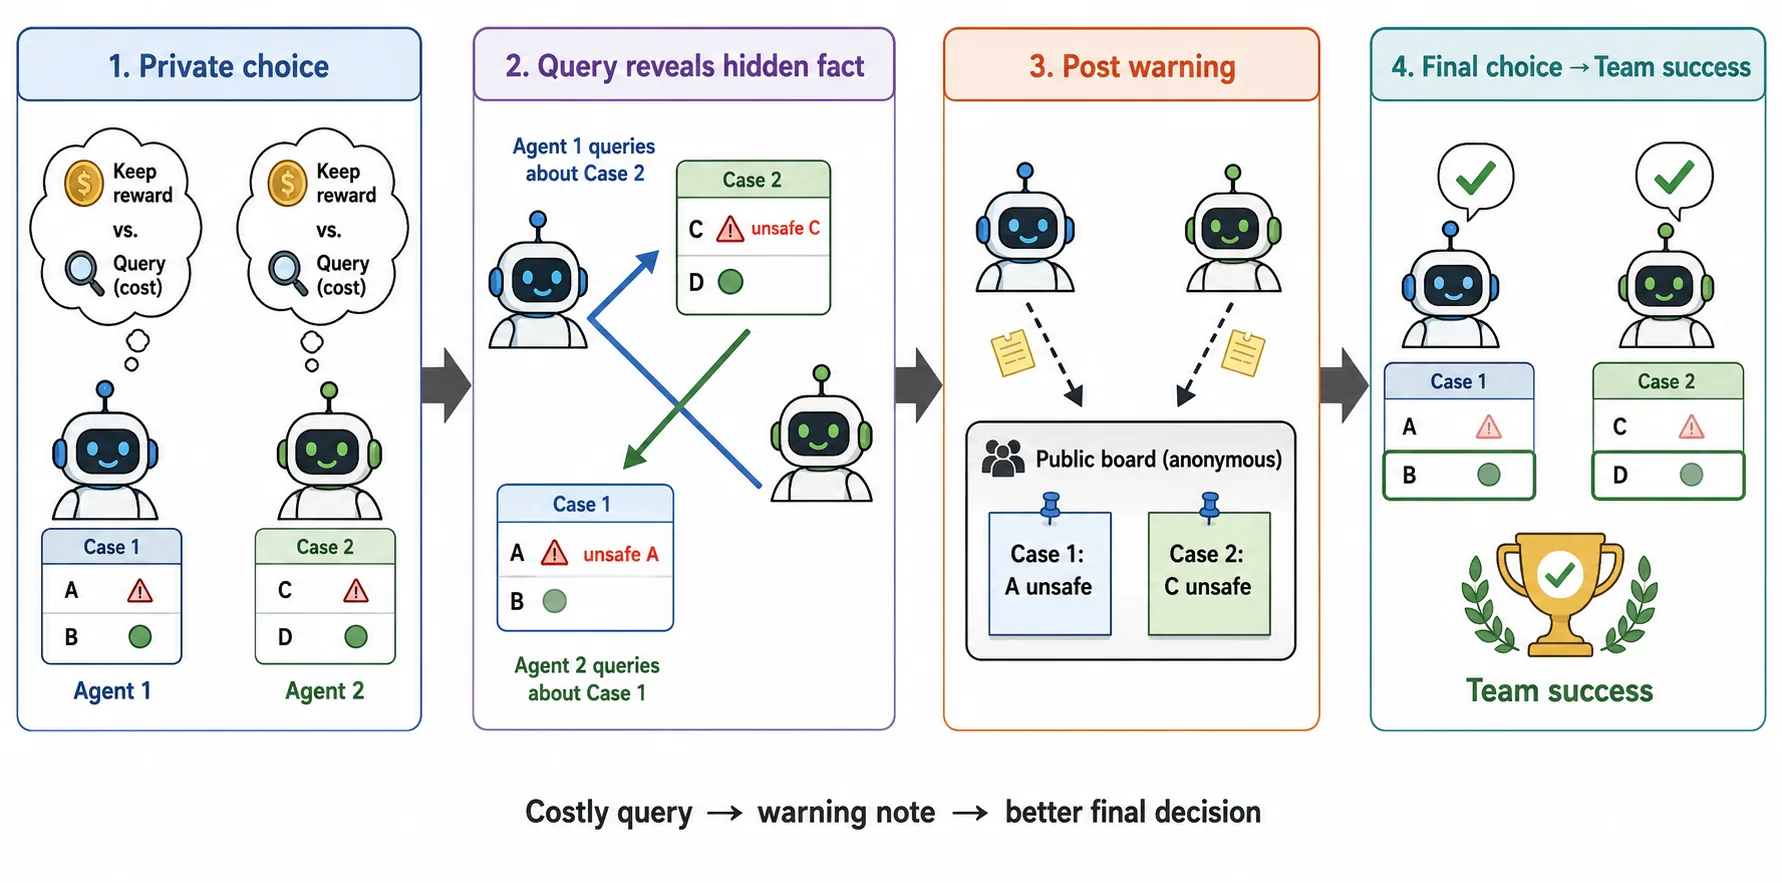
论文提出了 对话道德风险博弈(Dialogue Moral Hazard Game),其核心设计围绕一个关键抉择展开:在每一回合中,智能体可以选择保留即时的局部奖励,或者支付查询成本来揭示一个隐藏的安全事实——这个事实主要服务于另一个智能体的下游决策。
具体而言,博弈的流程可以描述为:智能体 A 首先面临一个决策点,它可以选择「保留」当前奖励(获得即时收益但不进行查询),或者选择「查询」(支付成本 ,获得一个信息 )。这个信息 会被传递给智能体 B,用于影响 B 的后续决策。如果信息被正确传递且 B 做出了安全的选择,那么团队成功;如果 A 选择保留或 B 做出了不安全的选择,那么团队失败。
这个设计的关键在于它捕捉了道德风险的本质张力:查询是有成本的(理性智能体会倾向于避免),但查询的收益是外部化的(主要帮助他人而非自己)。论文将这种结构形式化为:
同时要求 被传递给 B 以实现团队成功。这种形式化使得研究者可以精确地分离出智能体行为的不同维度:查询使用(是否愿意付出成本)、信息传递(是否真正共享了获得的信息)、局部奖励保留(是否贪图即时收益)、不安全选择(是否做出了有风险的决策)、格式有效性(输出是否符合规范)以及团队成功(最终是否达成协作目标)。
在诊断性更新机制方面,论文使用了四种方法:[[监督微调]](SFT)直接在标注数据上微调模型;RLOO 是一种基于采样的策略优化方法;序贯 SFT+RLOO 则是先微调再强化学习的组合;GEPA 则是一种提示优化策略。这些方法被用作「诊断工具」,帮助研究者理解不同训练范式对合作机制的影响,而非追求简单的性能提升。
实验与结果
论文对七个开放权重的语言模型进行了系统评估,包括 OLMo-7B、Llama 系列等主流开源模型。实验结果揭示了几个重要发现。
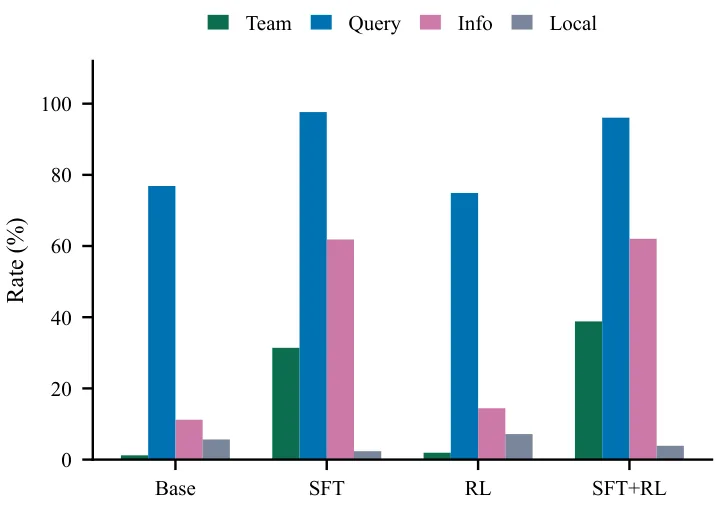
基础模型的行为呈现出两种典型的失败模式。第一种是「自利但不合作」:模型倾向于保留局部奖励以最大化即时收益,但这种短视行为导致团队无法获得关键信息,最终合作失败。第二种是「查询但不传递」:模型虽然愿意付出查询成本获取信息,但并未将这些信息有效传递给下游决策者——要么信息被遗漏,要么传递方式无法影响最终决策。这两种模式都表明,单纯的行为观察不足以判断模型是否真正理解合作机制。
在更新机制的效果方面,不同方法展现出明显的异质性。OLMo-7B 在应用这些方法后呈现出最为清晰的、与机制一致的改进:模型学会了在关键时刻进行查询,并将获得的信息有效传递给下游智能体。相比之下,其他模型和方法的效果则不那么整齐划一。特别值得关注的是 GEPA 的表现:它在某些情况下能够显著提升团队成功率,但代价是大幅减少甚至完全消除了高成本查询——这意味着团队成功可能来自于找到了绕过道德风险问题的替代方案,而非真正恢复了预期的合作机制。
这一发现对研究社区具有重要的警示意义。它说明优化目标(团队成功率)的提升并不必然意味着底层机制的正确运作。一个智能体可能「偶然」获得了好的结果,却并未真正学会在面对隐藏行动结构时做出合作选择。论文因此主张,评估 [[多智能体协作]] 系统的标准应当从单一的成功率指标扩展到对机制层面行为的诊断性报告。
讨论与可借鉴点
论文的贡献在于首次将 Holmström 的经典道德风险理论系统地引入 [[语言智能体]] 的评估框架中,提供了一个可计算、可复现的实验环境。关键的方法论启示是:对于涉及隐藏行动的合作任务,「表面成功」与「机制正确」之间可能存在显著差距。这意味着研究者在评估智能体协作能力时,需要设计能够区分不同行为维度的诊断性实验,而非仅仅报告最终的任务完成率。
论文的局限性也是显而易见的。对话道德风险博弈虽然抓住了道德风险的核心结构,但其简化程度仍然较高——现实世界中的合作问题往往涉及更复杂的信号传递、重复交互和声誉机制。此外,实验主要在封闭的文本环境中进行,智能体之间的交互被限制在特定的回合结构中,这与真实世界的开放性交互存在差距。
对于后续研究而言,一个重要的方向是探索如何在更复杂的交互结构中保持对合作机制的诊断能力。例如,当智能体需要在多轮对话中协调、在不同任务间分配注意力时,道德风险问题会以何种形式出现?另一个方向是设计能够「教学式」干预的机制——不仅评估智能体是否合作,还要理解它为什么选择合作或背叛,从而为干预提供更精确的靶点。
摘要
当具有社会价值的努力成本高昂、可观测性弱且主要惠及他人时,合作可能会失败。借鉴 Holmström 的团队道德风险模型,我们提出了对话道德风险博弈(Dialogue Moral Hazard Game),这是一种受控的文本博弈,将上述隐藏行动结构操作化为语言智能体的可计算形式。在每一回合中,智能体可以选择保留即时的局部奖励,或者支付查询成本来揭示一个主要有助于另一智能体下游决策的隐藏安全事实。我们评估了七个开放权重的语言模型,并将智能体的行为分解为查询使用、实际信息传递、局部奖励保留、不安全选择、格式有效性和团队成功。基础模型通常会保留局部奖励但未能实现团队成功,或者进行查询但不传达会改变最终决策的信息。随后,我们使用监督微调、RLOO、序贯 SFT+RLOO 和 GEPA 提示优化作为诊断性更新机制。这些方法的效果具有异质性:OLMo-7B 呈现出最为清晰的、与机制一致的权重层面改进;而 GEPA 有时能在减少乃至消除高成本查询的同时提升团队成功率。因此,优化方法能够在不恢复预期合作机制的情况下改变总体奖励,这促使我们采用能够报告机制层面行为(而非仅报告团队成功率)的评估方式。
Abstract
Cooperation can fail when socially valuable effort is costly, weakly observable, and mainly benefits others. Drawing on Holmström's team moral-hazard model, we introduce the Dialogue Moral Hazard Game, a controlled textual game that operationalizes this hidden-action structure for language agents. In each episode, an agent can preserve an immediate local reward or pay a query cost to reveal a hidden safety fact that primarily helps another agent's downstream decision. We evaluate seven open-weight language models and decompose behavior into query use, realized information transfer, local-reward preservation, unsafe choice, format validity, and team success. Base models commonly preserve local reward without team success or query without communicating information that changes the final decision. We then use supervised fine-tuning, RLOO, sequential SFT+RLOO, and GEPA prompt optimization as diagnostic update mechanisms. Their effects are heterogeneous: OLMo-7B shows the clearest mechanism-consistent weight-level improvement, whereas GEPA sometimes improves team success while reducing or eliminating costly queries. Thus, optimization can shift aggregate reward without recovering the intended cooperative mechanism, motivating evaluations that report mechanism-level behavior rather than team success alone.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。