
EviBack:通过证据约束教师回退实现搜索智能体强化学习
EviBack: Search-Agent Reinforcement Learning via Evidence-Constrained Teacher Backoff
📝 TLDR
Agentic RAG 系统的强化学习依赖可验证的结果奖励,但全零 rollout 组缺乏对比信号,易掩盖有效搜索行为。EviBack 提出证据约束的 Teacher 回退机制,为全零组提供辅助监督,同时保留 Actor 的可验证奖励,并将证据评估与答案优化解耦,防止参考答案压制证据不足的判断。通过 GPT-5.5 辅助的全自动 APE 流水线,从单提示双任务 Teacher 自动分区标注、消融与选择,得到门控两阶段 Teacher。在七个开放域 QA 基准与三种 Qwen3 规模上,相对 Search-R1 提升 F1,单跳与多跳宏 F1 均上升,搜索次数与重复查询减少。
🧭 速览
全零 rollout 组无可比信号,潜在有效搜索被掩盖,参考答案易压制证据不足判断。
证据约束 Teacher 回退拆分证据评估与答案优化;GPT-5.5 辅助 APE 流水线自动构建门控两阶段 Teacher。
七基准三 Qwen3 规模上 F1 超 Search-R1,单多跳宏 F1 均升,搜索与重复查询减少。
为全零 rollout 提供可信辅助监督,化解证据与答案耦合,是 Agentic RAG 训练的有效方案。
🆚 方法对比
EviBack
- 分离证据评估与答案优化,防止参考答案覆盖证据不足判断
- 在7个QA基准和3个Qwen3规模上超越Search-R1
- 提供辅助监督同时保留Actor可验证奖励
- 减少搜索次数、重复查询和强制终止
- 依赖LLM-as-a-judge,增加推理开销
- 仅在Qwen3系列验证,泛化性待考察
- 两阶段Teacher结构增加系统复杂度
E2E-APE
- 从过程评估约束出发生成评判提示
- 自动执行消融、任务分解、评估和选择
- 降低人工提示设计成本
- 依赖GPT-5.5辅助,增加外部API成本
- 自动流程稳定性缺乏理论保证
- 提示质量受初始种子影响
Manual Teacher
- 设计简单,无需额外自动化流程
- 易于理解和调试
- 人工设计成本高且难以系统优化
- 性能和稳定性有限
- 下游F1和有效答案率低于E2E-APE
Search-R1
- 基于GRPO,无需额外价值模型
- 训练流程相对简洁
- 仅依赖最终答案奖励,信号稀疏
- 忽略中间查询与证据选择质量
- all-zero rollout组无比较信号
LeTS
- 结合过程级信号与结果奖励
- 提供中间步骤的间接信号
- 过程信号仍为间接反映
- 依赖人工设计评估方式
- 信号精细度有限
CW-GRPO
- 直接评估每轮搜索推理过程
- 使用LLM评判提供细粒度反馈
- 依赖人工预定义评判提示
- 每轮评判增加计算开销
- 提示设计稳定性影响性能
APE
- 将提示视为候选指令自动选择
- 为提示优化提供基础范式
- 主要从最终任务性能优化提示
- 不适合过程评估场景
- 缺乏约束引导
GRPO
- 无需额外价值模型
- 通过组内相对优势估计优化
- 在all-zero rollout组中无监督信号
- 奖励设计困难,信号稀疏
EviBack通过证据约束Teacher回退机制解决all-zero rollout组无监督信号问题,E2E-APE自动生成评判提示替代手工设计;相比Search-R1、LeTS和CW-GRPO,EviBack同时融合过程级LLM评判与结果验证奖励,并通过APE流水线实现评判提示的自动优化。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
EviBack 针对 [[强化学习]] 驱动的 [[Agentic RAG]] 系统中全零 rollout 组缺乏对比信号的难题,提出证据约束的 Teacher 回退机制。该方法通过全自动的 APE 流水线生成门控两阶段 Teacher,在保留 Actor 可验证奖励的同时为全零组提供辅助监督,最终在七个开放域 QA 基准和三种 Qwen3 规模上实现 F1 提升,同时减少了搜索次数与重复查询。
研究背景与动机
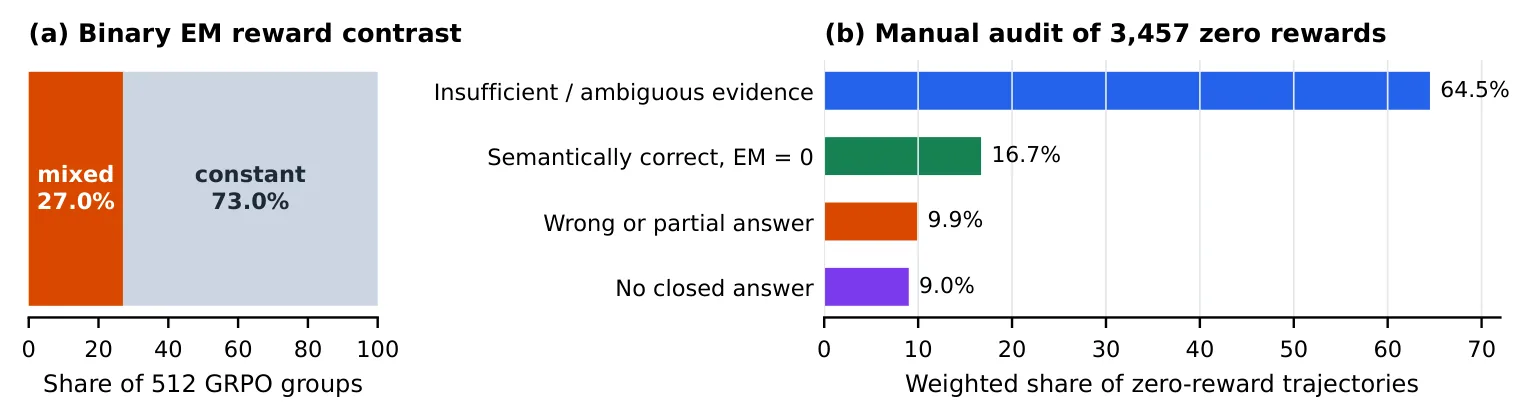
在 [[Agentic RAG]] 系统中,智能体需要通过多轮搜索与推理来回答复杂问题。这类系统的训练通常依赖 [[强化学习]] 框架,从可验证的结果奖励中学习有效的搜索策略。然而,一个关键问题长期困扰着研究者:Rollout 组中那些完全得不到正奖励的样本——即所谓全零 rollout——不提供任何比较信号,导致策略梯度无法区分「真正没用的搜索」和「恰好没得到正确答案的搜索」。这就好比考试时给所有没考满分的学生打零分,失去了改进方向的指引。
传统的解决思路是引入额外的监督信号,比如设计更精细的奖励函数或人为标注数据。但这些方案往往成本高昂,且难以规模化。更棘手的是,即使有参考答案可用,简单地用参考答案来监督搜索行为可能导致另一个问题:答案正确时掩盖了搜索过程中的低效,答案错误时则可能错误地惩罚了有效的探索。
EviBack 的核心洞察在于:证据质量与答案质量并非同一回事。一次有效的搜索可能找到了充分的相关证据,但最终答案仍因推理错误而错误;反之,一次碰巧的正确答案可能建立在薄弱甚至虚假的证据之上。因此,有必要将证据评估与答案优化解耦,前者服务于搜索策略学习,后者则交给 Actor 的可验证奖励独立完成。
方法
EviBack 的设计围绕一个核心目标展开:为全零 rollout 组提供辅助监督,同时不干扰 Actor 原本的可验证奖励机制。其方案包含两个关键组件。
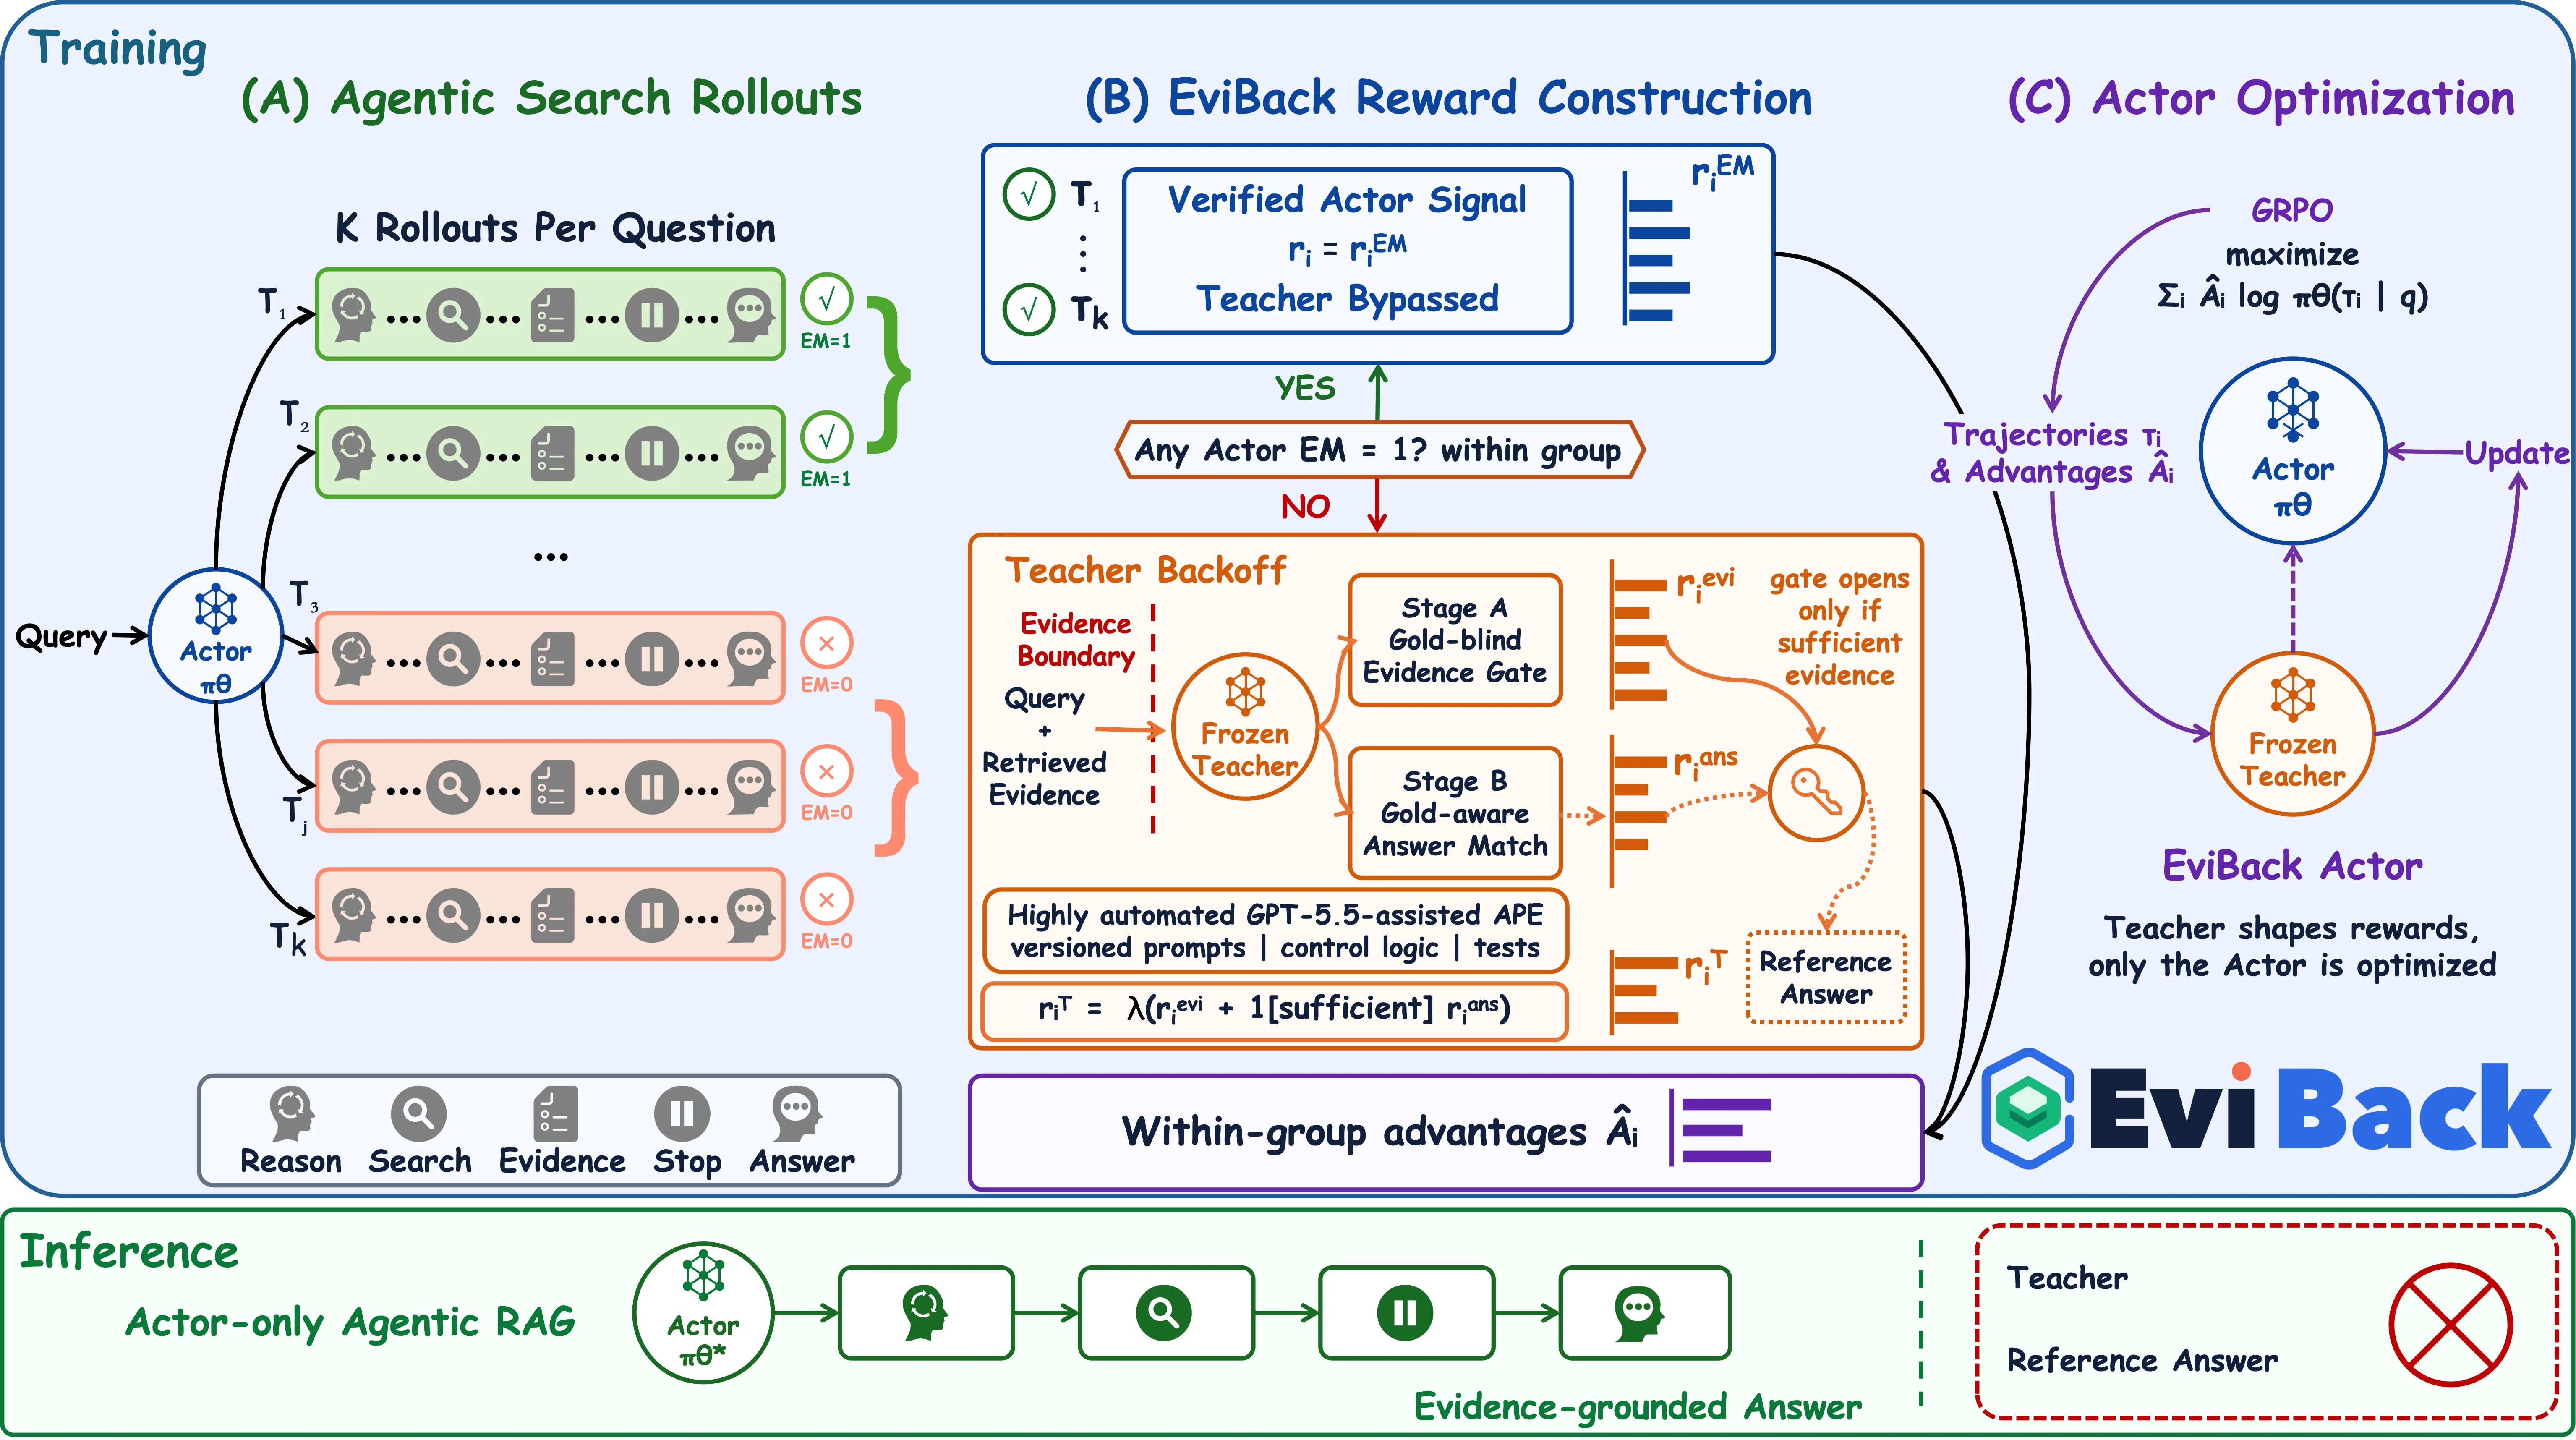
首先是证据约束的 Teacher 回退机制。当一个 rollout 组在 Actor 阶段获得全零奖励时,系统会激活 Teacher 的辅助监督。这里的「回退」比喻的是:当主要学习信号消失时,退而求其次提供一个次优的监督源。但与简单复制参考答案不同,EviBack 的 Teacher 会对搜索过程中收集到的证据进行独立评估。具体而言,Teacher 维护一套证据充足性判断标准——这包括信息覆盖度、来源可靠性、多证据一致性等维度——只有当证据足以支撑某个答案时,才会提供该答案作为监督;若证据本身不足,则 Teacher 的监督信号会是「继续搜索」而非强制给出某个答案。
其次是门控两阶段 Teacher 的结构设计。第一阶段是证据评估阶段,Teacher 判断当前收集的证据是否足以回答问题;如果不足,进入第二阶段——答案优化阶段,此时 Teacher 会基于已有证据给出可能的答案方向或搜索建议。这两个阶段通过一个门控机制串联,门控的决策由证据评估结果决定。这种设计的精妙之处在于:它允许 Teacher 在证据不足时「诚实地说不知道」,而不是被迫给出一个可能误导 Actor 的答案。
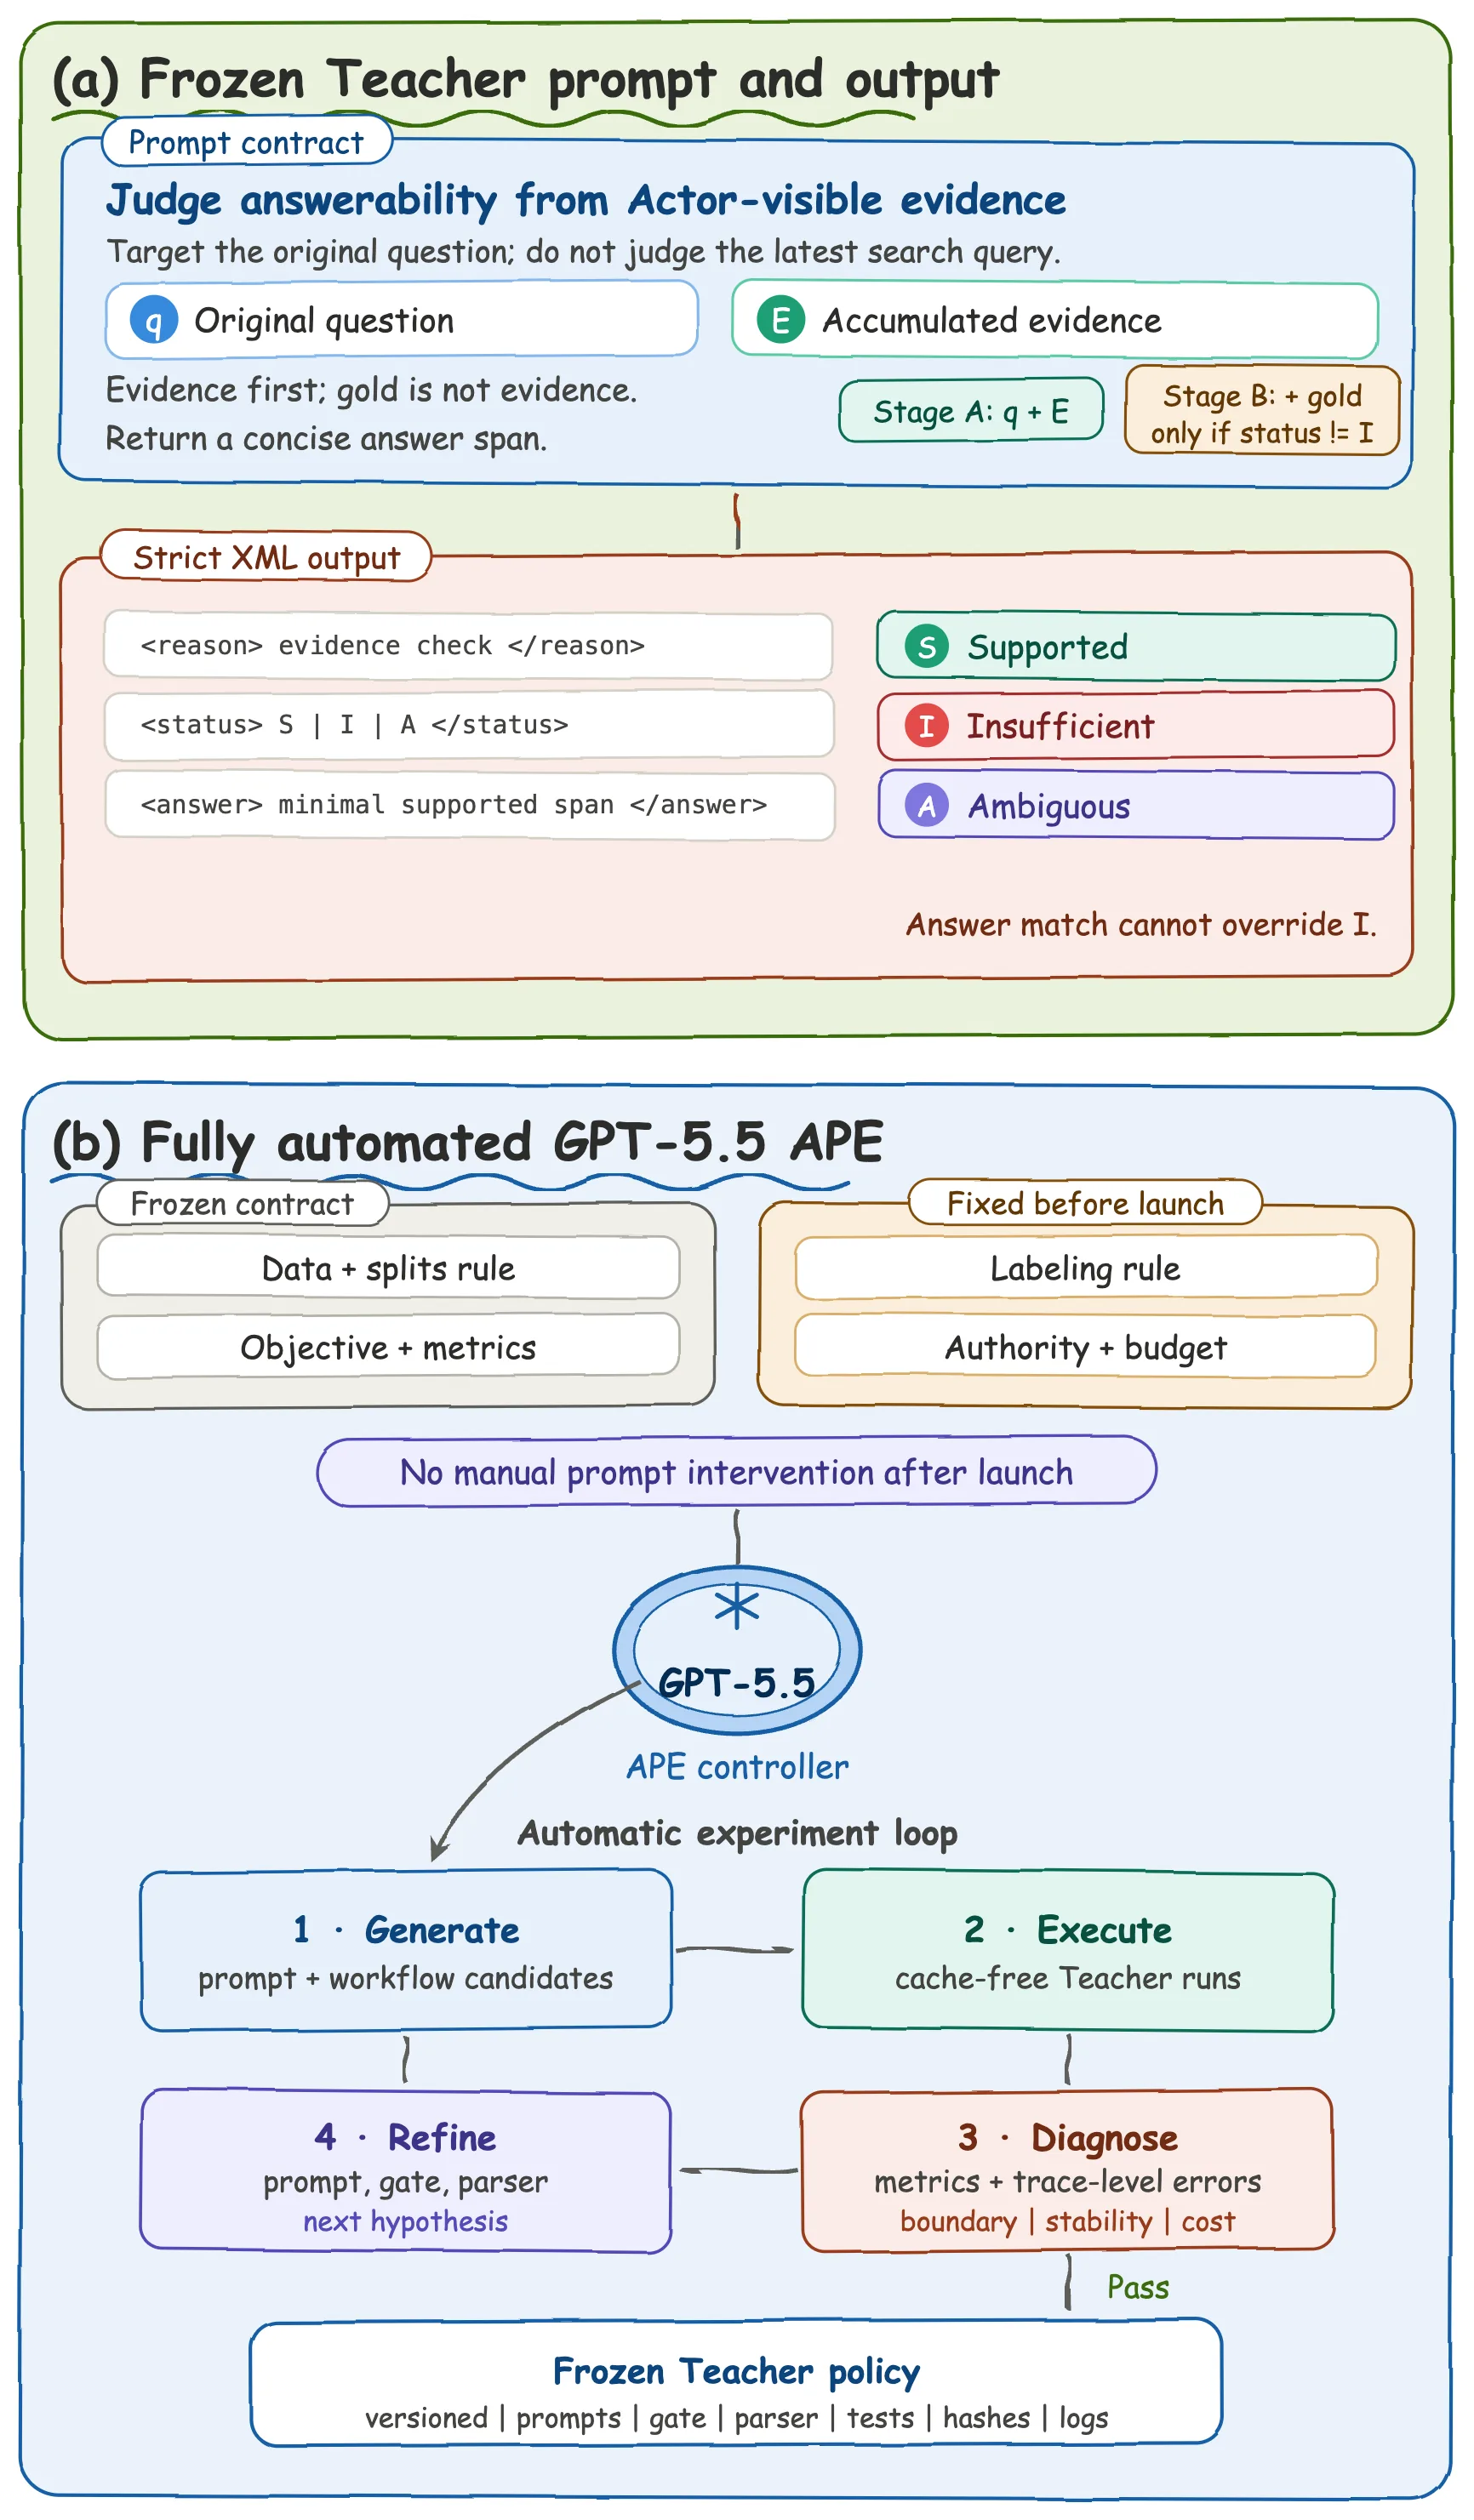
为了自动生成这个门控两阶段 Teacher,论文设计了一条全自动的 APE(Automatic Prompt Engineering)流水线。流程从人工编写的单提示双任务 Teacher 出发——这个初始 Teacher 只需同时具备证据评估和答案优化两个任务的能力,但不包含门控逻辑。随后,系统对 rollout 数据进行自动分区和标注,识别哪些情况下证据充足、哪些情况下不足。通过消融分析确定各组件的贡献度,并执行任务分解将单提示拆解为门控结构。最后,通过评估和选择确定最优的配置。这条流水线的关键优势在于全程无需人工干预,最终得到的 Teacher 在下游任务上的表现优于人工设计的版本。
从数学形式上看,完整的训练目标可以表示为:
其中 是 Actor 的可验证奖励, 是 Teacher 提供的辅助监督,仅在全零奖励时激活, 是平衡两项的系数。这个公式清晰地体现了 EviBack 的核心思想:保留 Actor 的原始奖励信号,只在必要时补充 Teacher 的监督。
实验与结果
实验在七个开放域 QA 基准上进行,覆盖单跳和多跳两类问题复杂度。模型基座选用三种规模的 Qwen3,以验证方法在不同容量模型上的有效性。对比基线包括 Search-R1 以及若干消融变体。
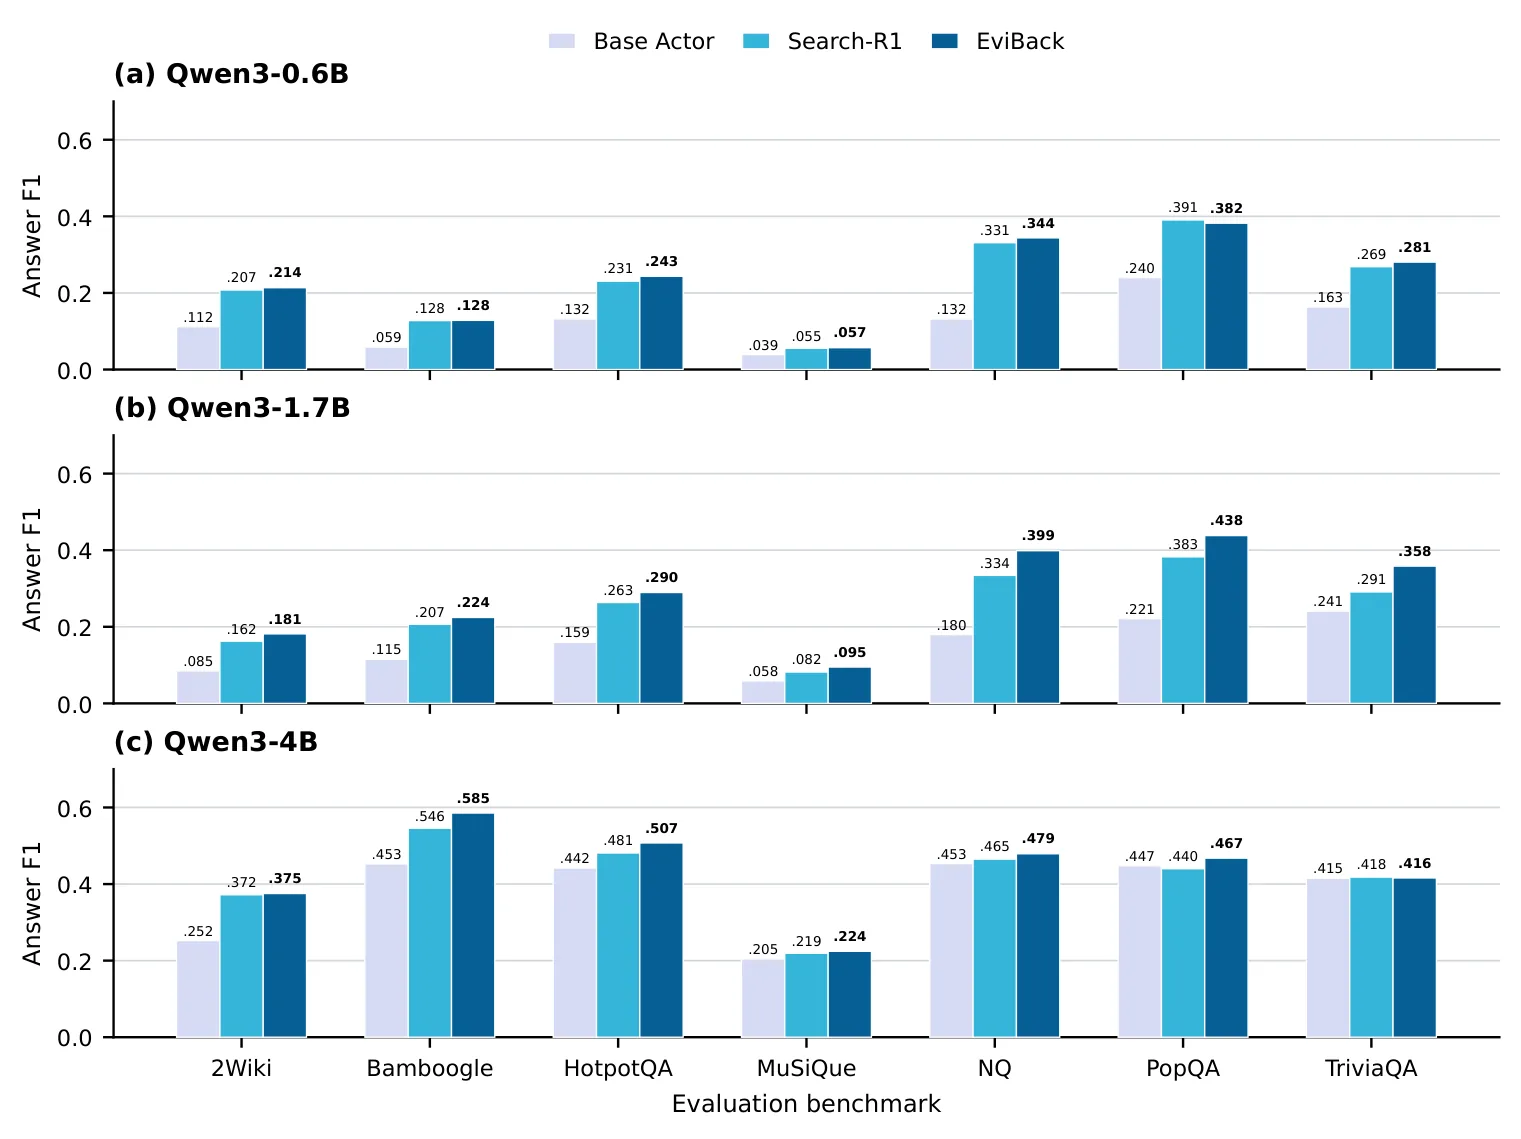
主要结果方面,EviBack 在 F1 指标上全面优于 Search-R1。值得注意的是,这种提升在单跳和多跳问题上均有体现,且多跳问题的宏 F1 提升幅度更大。这一结果符合直觉:多跳问题需要更复杂的搜索路径,更容易出现全零 rollout 的情况,因此从 Teacher 回退机制中获益更多。
搜索效率方面的结果同样令人鼓舞。与基线相比,EviBack 减少了平均搜索次数,同时降低了重复查询的比例。重复查询的减少尤为重要,因为它直接反映了搜索策略的改进——系统学会了在首次搜索失败时改变策略,而非机械地重复同样的查询。强制终止率也有所下降,说明智能体对何时应该停止搜索有了更好的判断。
消融实验进一步揭示了各组件的贡献。门控机制本身带来的提升最为显著,这验证了「证据评估与答案优化解耦」这一设计的核心价值。APE 流水线生成的 Teacher 在各项指标上均优于人工设计的版本,证明了自动化 prompt 优化的有效性。全自动流水线虽然增加了计算开销,但生成的 Teacher 质量更高,长期来看收益大于成本。
讨论与可借鉴点
EviBack 的工作揭示了 [[强化学习]] 中一个常被忽视但极其重要的问题:全零奖励样本并非「无用的负样本」,它们可能蕴含着有效行为的萌芽,只是缺乏比较信号来凸显其价值。将这些样本简单地丢弃或视为等效的负例,会造成学习信号的浪费。EviBack 的思路——设计专门的机制来挖掘这些样本中的潜在价值——值得在其他类似场景中借鉴。
将证据评估与答案优化解耦这一设计哲学也具有广泛的意义。在许多涉及信息检索和推理的任务中,「信息是否充分」与「答案是否正确」本质上是两个独立的问题。传统方法往往将它们混为一谈,导致评估信号之间的相互干扰。EviBack 通过门控机制明确区分这两个阶段,为解决这类问题提供了一种可复用的架构思路。
全自动 APE 流水线的设计同样值得关注。它证明了即使是 Teacher 这样的辅助组件,通过系统性的自动化优化也能获得超越人工设计的性能。这暗示了在大模型时代,「用模型优化模型」可能成为构建复杂系统的一条可行路径。当然,这种方法对底座模型的能力有一定依赖,其可复现性需要在更多样化的环境中验证。
当前研究的局限也是显而易见的。Teacher 本身依赖强大的底座模型(如 GPT-5.5),这限制了方法的部署灵活性。门控决策的准确性尚未得到充分分析——如果 Teacher 对证据充足性的判断本身有偏差,可能会引入新的噪声。此外,实验仅覆盖 QA 任务,在其他类型的 Agentic 场景(如对话、任务规划)中方法的有效性仍有待检验。
对于从事 Agent 系统研究或 [[强化学习]] 应用的研究者而言,EviBack 提供了一个兼具理论洞察和工程价值的范例:它不仅提出了新的问题解决思路,还提供了可操作的自动化 pipeline,为后续研究奠定了可复现的基础。
摘要
强化学习使智能体RAG系统能够从可验证的结果奖励中学习多轮搜索,但全零 rollout 组不提供比较信号,并可能掩盖有用的搜索行为。我们提出 EviBack,一种证据约束的教师回退方法,为此类组提供辅助监督,同时保留可验证的 Actor 奖励。该方法将证据评估与答案优化分离,防止参考答案覆盖证据不足的判断。一个全自动、端到端的 GPT-5.5 辅助 APE 流水线从人工编写的单提示双任务教师出发,自动划分和标注 rollout 数据,并执行消融、任务分解、评估和选择,以生成一个门控的两阶段教师。与人工设计相比,所得到的教师在下游 F1 和有效答案率上有所提升,同时减少了搜索、重复查询和强制终止。在七个开放域问答基准和三种 Qwen3 规模上,EviBack 在 F1 上优于 Search-R1,并提升了单跳和多跳的宏 F1。我们保证代码将在后续阶段公开发布。
Abstract
Reinforcement learning enables Agentic RAG systems to learn multi-turn search from verifiable outcome rewards, but all- zero rollout groups provide no comparative signal and may hide useful search behavior. We present EviBack, an evidence- constrained Teacher backoff that supplies auxiliary super- vision to such groups while preserving verifiable Actor re- wards. It separates evidence assessment from answer refine- ment, preventing reference answers from overriding evidence- insufficiency judgments. A fully automated, end-to-end GPT- 5.5-assisted APE pipeline starts from a manually authored single-prompt dual-task Teacher, automatically partitions and labels rollout data, and performs ablation, task decomposition, evaluation, and selection to produce a gated two-stage Teacher. Compared with the manual design, the resulting Teacher im- proves downstream F1 and valid-answer rate while reduc- ing search, duplicate queries, and forced termination. Across seven open-domain QA benchmarks and three Qwen3 scales, EviBack improves F1 over Search-R1 and raises both single- and multi-hop macro F1. We guarantee that the code will be made publicly available at a later stage.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。