
从认知架构到语言智能体:关于谱系、趋同与迁移鸿沟的机制层面综述
From Cognitive Architectures to Language Agents: A Mechanism-Level Review of Lineage, Convergence, and Migration Gaps
📝 TLDR
智能体研究中记忆、规划、反思、工具使用常被作为特性标签比较,掩盖了控制语义。本文从机制层面连接十个历史认知架构、八种语言智能体运行时与四十二个现代系统,按状态、控制、转移、持久化、失败、学习与资源治理七维重构各机制,并独立编码证据关系与迁移深度。结果显示现代智能体多通过独立收敛而非显式继承实现了多数核心机制,GraSP筛除一项提议缺口后仍剩五组可耦合机制束。本文贡献了差异化机制目录、可审计证据深度框架与可证伪的运行时不变式议程。
🧭 速览
现有综述多以特性标签比较认知架构与语言智能体,掩盖了决定智能体实际运行的控制语义,机制层面的谱系与迁移缺口未被系统梳理。
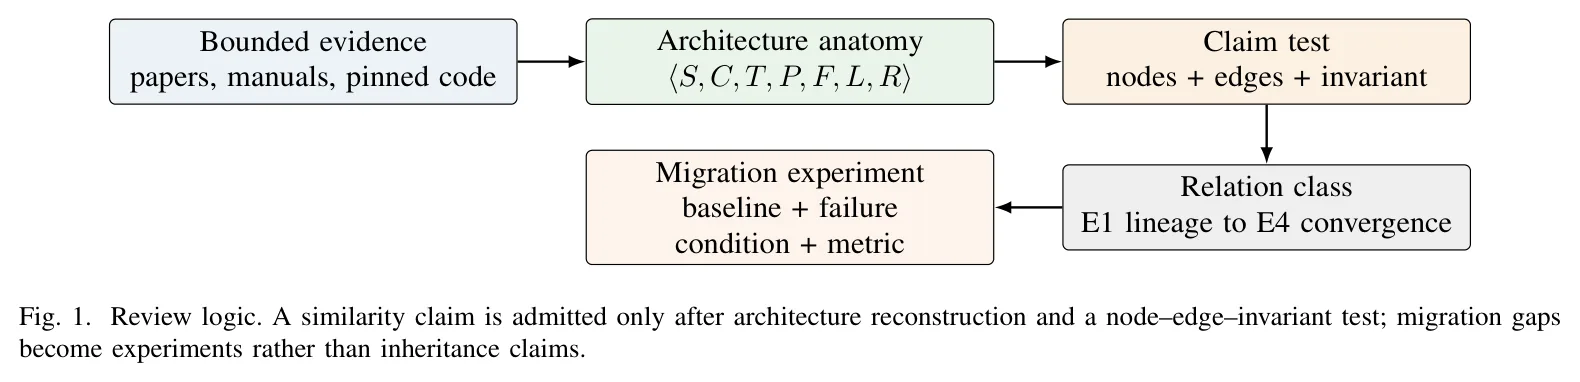
对十个历史认知架构、八种语言智能体运行时与四十二个现代系统,从状态、控制、转移、持久化、失败、学习与资源治理七维重构机制,并独立编码证据关系E1-E4与迁移深度D0-D4。
现代智能体已通过独立收敛实现自适应记忆、失败恢复、动态团队选择等机制;经最近基线筛除后仍存五组机制耦合缺口,涵盖激活延迟、类型僵局、内容竞争、持续意图与不确定性资源分配。
提出差异化机制目录、可审计证据深度框架与可证伪的运行时不变量议程,为多机制耦合研究提供方向。
🆚 方法对比
Distinctive-Mechanism Catalog(七维机制重构框架)
- 从状态/控制/迁移/持久化/失败/学习/资源治理七个维度统一分析
- 跨历史架构与现代系统提供统一比较语言
- 对四十二个现代系统进行机制级映射覆盖广泛
- 七个维度的编码依赖人工判断主观性较高
- 不评估池化效应或共同基准无法排名架构
- 分析语料冻结于2026年7月时效性受限
E1-E4证据关系编码轴
- 区分文献谱系与结构迁移等四种关系类型细致
- 使有据可查的继承与独立趋同可被区分
- 为每个机制提供可审计的证据深度标签
- 四类关系之间的边界判定仍依赖研究者解读
- E1文献谱系证据在现代系统中较为稀缺
- 缺少跨编码者一致性检验的量化报告
D0-D4迁移深度编码轴
- 从概念标签到经验自适应控制律分五级
- D4结果可与历史不变量缺失并存揭示断点
- 使机制迁移的真实实现深度可被定量比较
- 深度等级判定需逐机制阅读文档成本高
- 现代系统文档质量差异影响D值准确性
- 未与任务性能基准挂钩难以验证深度价值
GraSP(最接近基线系统)
- 整合校准多技能选择与类型化编译验证
- 具备有界修复与重规划或ReAct回退能力
- 经对抗性最近基线筛选闭合技能治理缺口
- 作为单一系统无法覆盖其余五组残余耦合
- 其回退机制与有界修复的耦合深度未量化
- 在其他机制维度上的覆盖度未被显式评估
五组残余机制耦合束(研究议程)
- 明确给出插入点、基线、可观测与失败条件
- 涵盖激活-延迟、类型化 impasse、意图持久等关键耦合
- 以可组合运行时不变量形式提出可证伪议程
- 五组耦合均为前瞻性建议尚未经验证
- 仅闭合技能治理一项其余五项仍是开放问题
- 耦合束的可实现性缺乏原型系统支撑
本文以七维机制目录与E1-E4/D0-D4双轴编码为统一分析框架,横向连接十类历史认知架构与四十二个现代系统,并通过GraSP对抗性筛选闭合技能治理缺口,将其余五组机制耦合转化为可证伪的运行时不变量议程。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
TL;DR
这篇综述系统性地梳理了从经典认知架构到当代大语言模型智能体的演化脉络,通过状态、控制、转换、持久化、失败、学习与资源治理七个维度解构各类机制,并将证据关系与迁移深度解耦编码。研究发现现代智能体在多数核心能力上的实现更多是独立趋同而非继承,同时识别出五组尚未耦合的机制束,为后续研究提供了可证伪的实验议程。
研究背景与动机
智能体研究长期面临一个根本性问题:当我们谈论记忆、规划、反思与工具使用时,这些概念往往沦为标签化的特征比较,而非真正揭示智能体运行机制的钥匙。一个声称具备"反思能力"的系统与另一个同样标榜此能力的系统,可能在控制流、数据表示、失败处理等核心层面毫无共通之处。这种标签化导致两个严重后果:一是学术讨论缺乏可操作化的一致基准,二是系统设计者难以从历史积累中汲取有意义的经验。
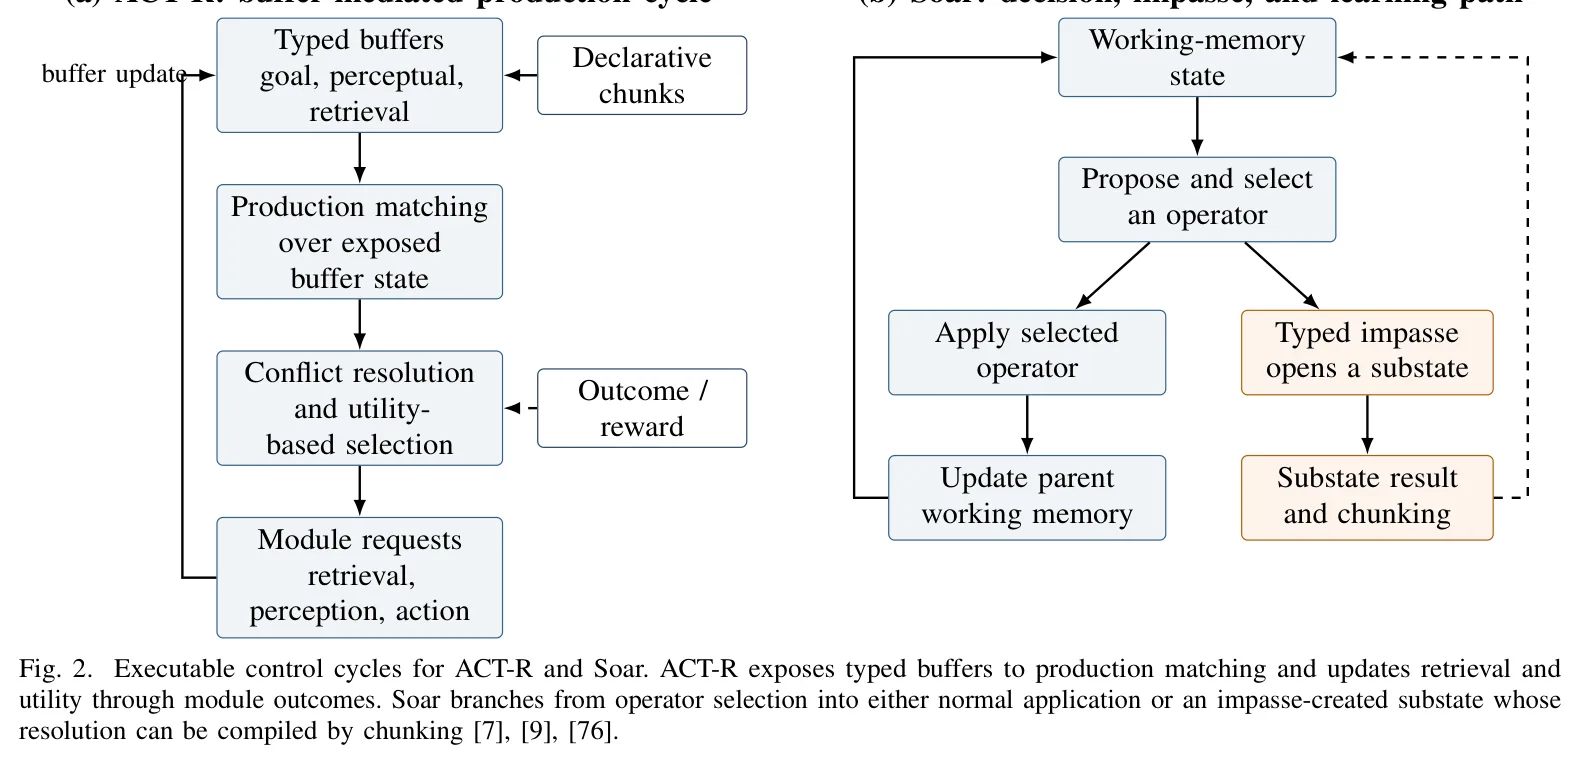
认知架构领域曾产出大量经典系统,其中 [[SOAR]]、[[ACT-R]] 等代表性工作试图从认知科学角度统一智能体的基本组件。然而这些架构与近年来基于大语言模型的智能体系统之间是否存在谱系关联、哪些机制真正实现了迁移,始终缺乏系统性的梳理。与此同时,语言智能体运行时(如 LangChain、AutoGPT 等框架)虽然提供了丰富的工具链,但这些工具背后的设计决策与经典认知架构的洞见之间是否存在对话,更是语焉不详。
本综述的切入点正在于此:不是在特征层面比较"谁有什么",而是在机制层面追问"每种能力是如何控制状态转换、处理失败、分配资源的"。只有这种粒度的分析才能揭示真正的继承关系与独立趋同,为后续研究指出有价值的耦合方向。
方法
作者首先建立了一个涵盖三个层次的实体清单:十个历史认知架构家族、八个语言智能体运行时家族,以及四十二个聚焦具体机制的现代系统。这一选择标准确保了样本既具有历史纵深,又覆盖了当前技术前沿。
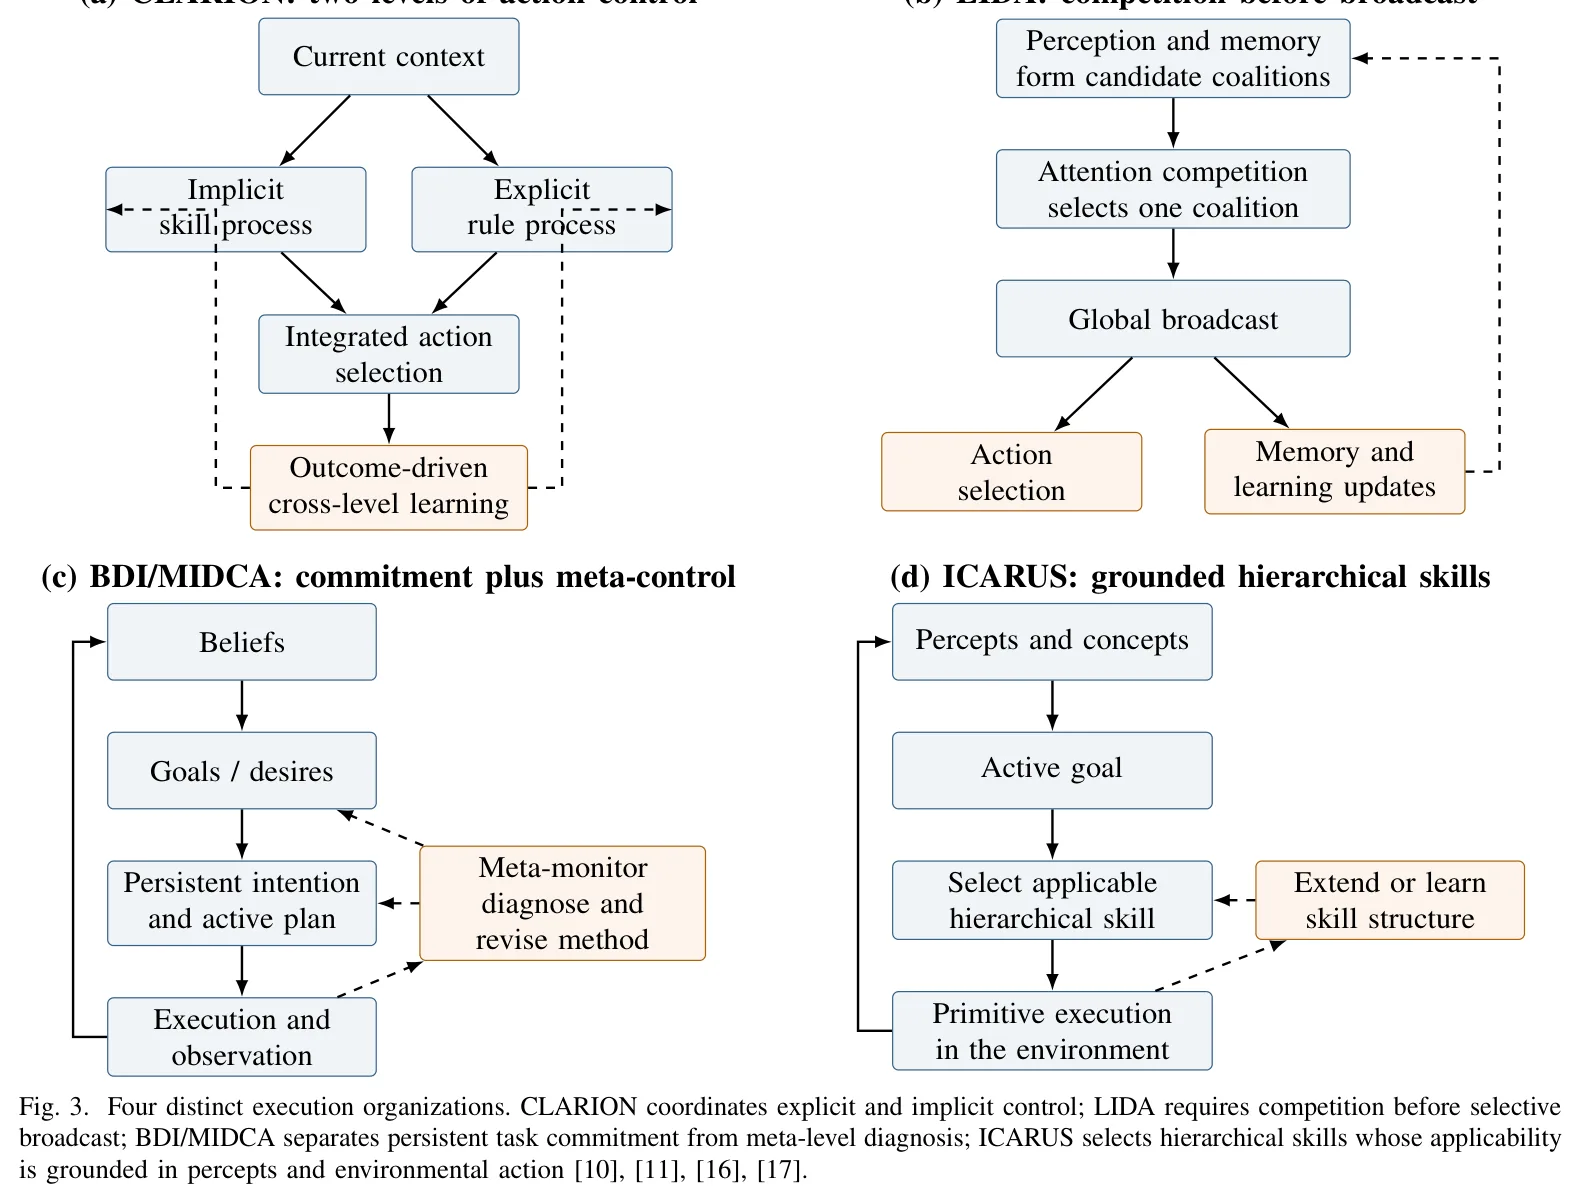
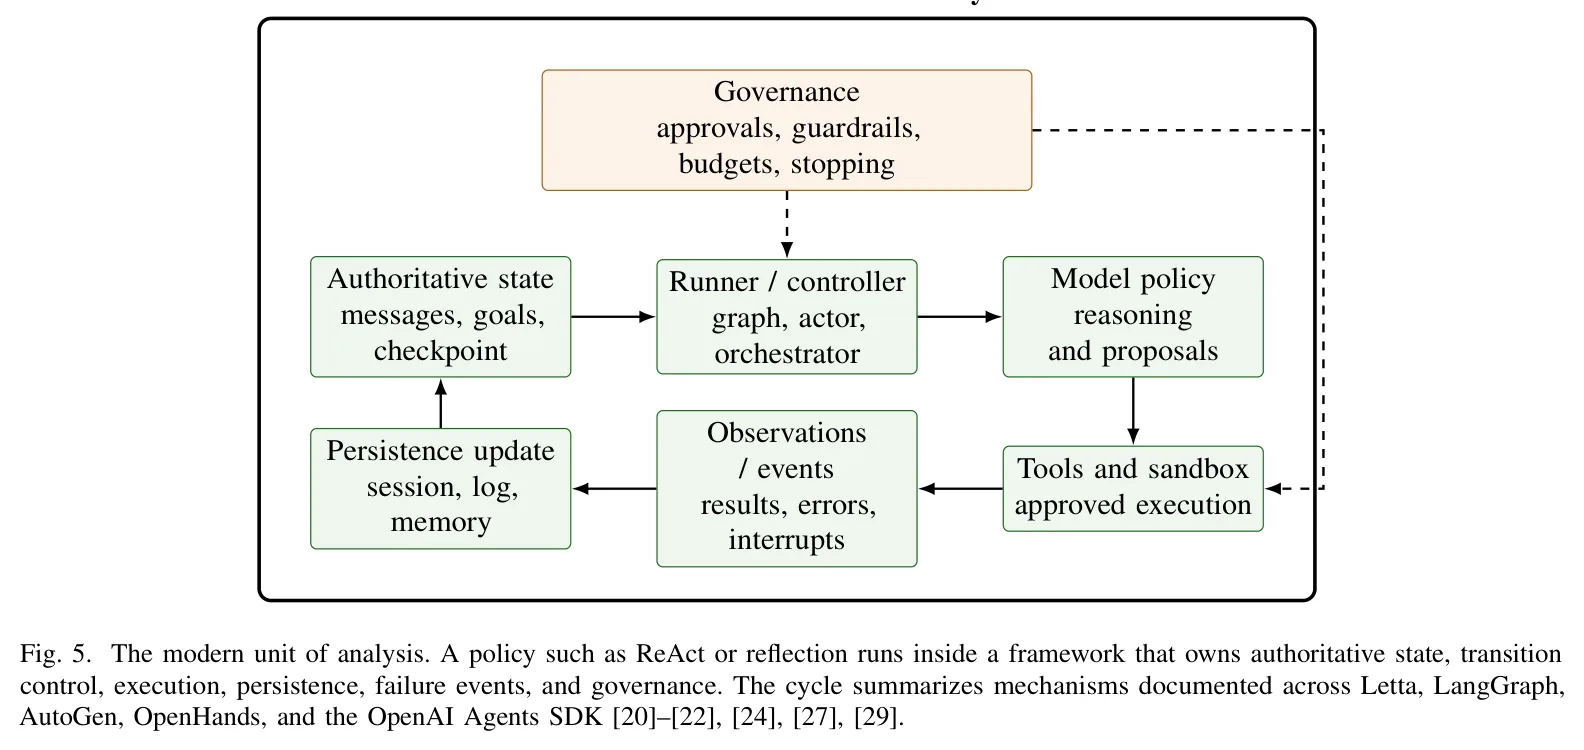
针对每个被分析的系统,作者采用七个维度进行机制重构。状态维度追问系统如何表示当前情境与内部知识;控制维度关注决策权的分配与委托机制;转移维度描述状态如何从一个快照演进到下一个;持久化维度考察信息如何在时间与调用边界间保持连贯;失败维度分析异常处理与恢复策略;学习维度审视经验如何转化为后续行为的改进;资源治理维度则追问计算资源、时间预算与能力边界的管理方式。这七个维度并非任意选定,而是从认知架构文献中提取的元层面需求,能够涵盖大多数已知的机制设计空间。
一个关键的方法论贡献是将证据关系与迁移深度解耦编码。证据关系分为四个层次:E1 表示直接来源引证,E2 表示间接提及或隐含继承,E3 表示功能相似性但无明确关联,E4 表示表面标签匹配。迁移深度则分为五个层次:D0 表示完全迁移且有文档记录,D1 表示核心机制迁移但实现不同,D2 表示启发式借鉴而非系统迁移,D3 表示标签趋同但机制不同,D4 表示仅有表面相似。通过这种二维编码,作者能够区分"声称相似但机制迥异"与"真正继承但实现各异"这两种截然不同的知识迁移模式。
实验与结果
分析结果揭示了一幅参差不齐的演化图景。在自适应记忆、失败恢复、动态团队选择、工作流搜索、技能归纳、资源调度以及不确定性条件化行动等维度上,现代智能体确实实现了相当程度的机制落地。然而,这种落地往往表现为独立趋同而非有据可查的继承——换言之,不同时期的研究者从各自的技术语境出发,独立发现了相似的解决方案,而非系统性地借鉴了前人工作。
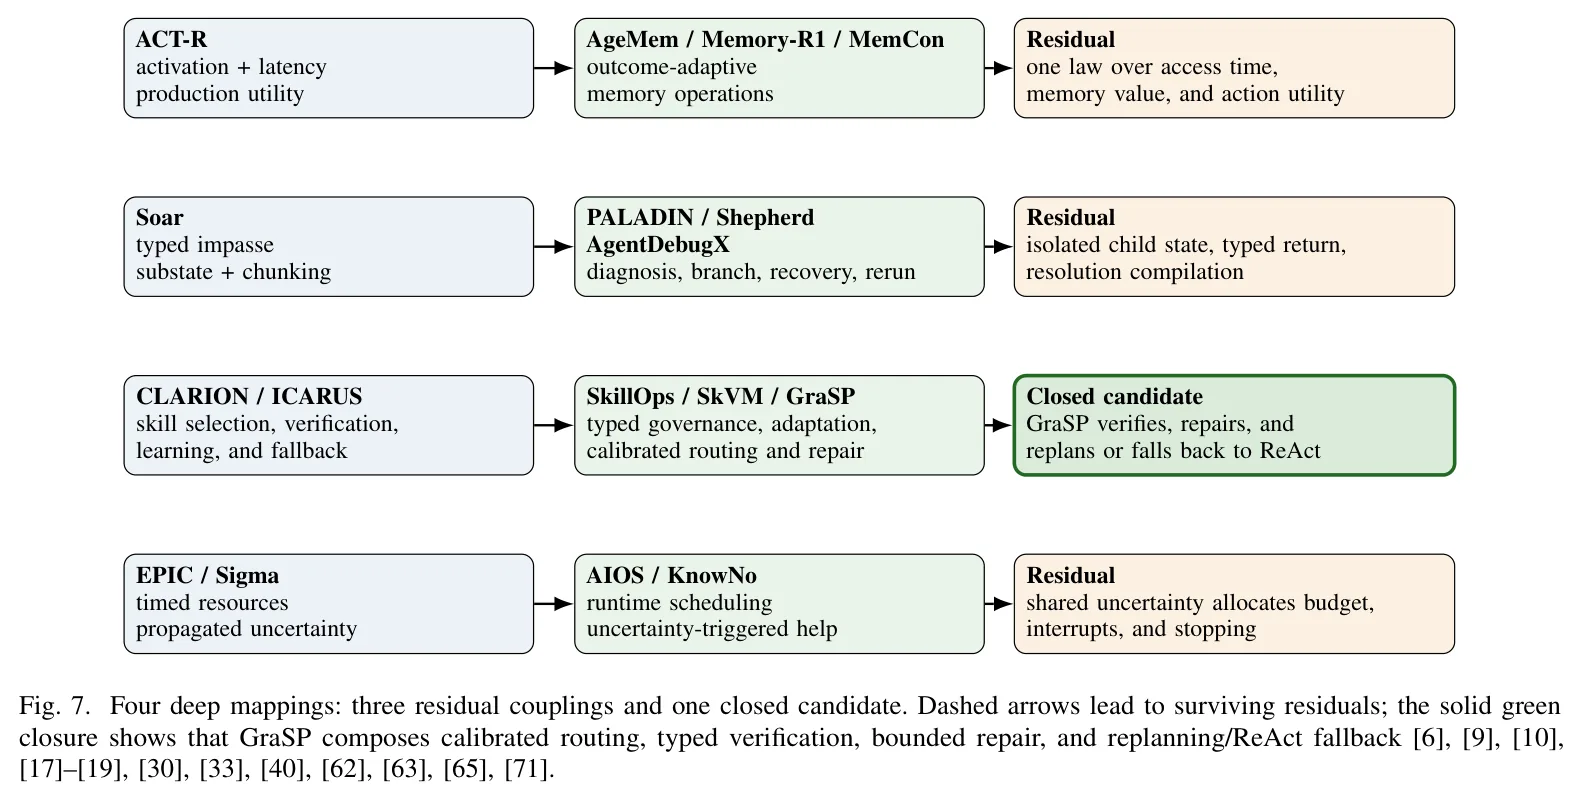
GraSP 系统通过了最接近基线的筛选关闭一个提议缺口。该系统成功整合了校准的多技能选择、类型化编译、验证机制、有界修复,以及重规划或 ReAct 回退策略,形成了一个相对完整的机制闭环。这一结果表明,至少在某些机制束上,领域已经积累了足够成熟的组件,可以进行有意义的组合验证。
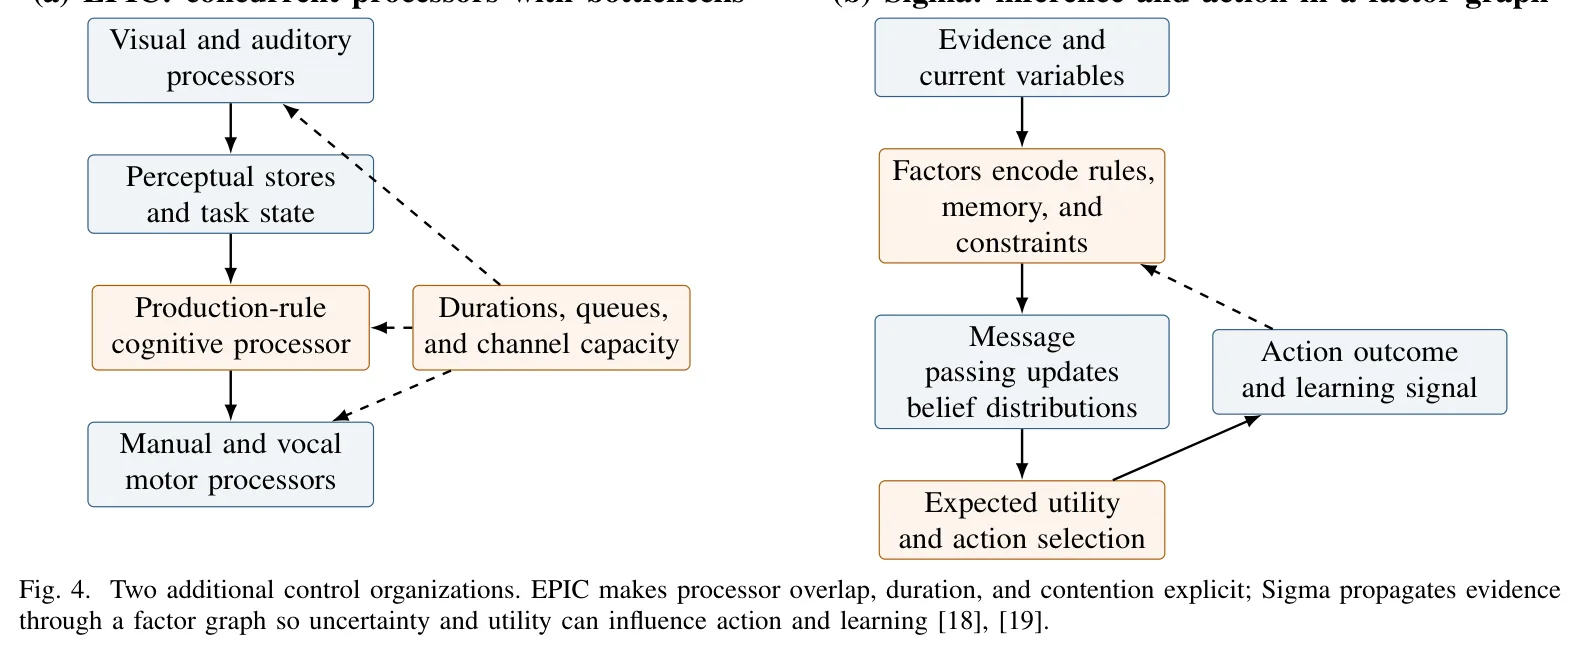
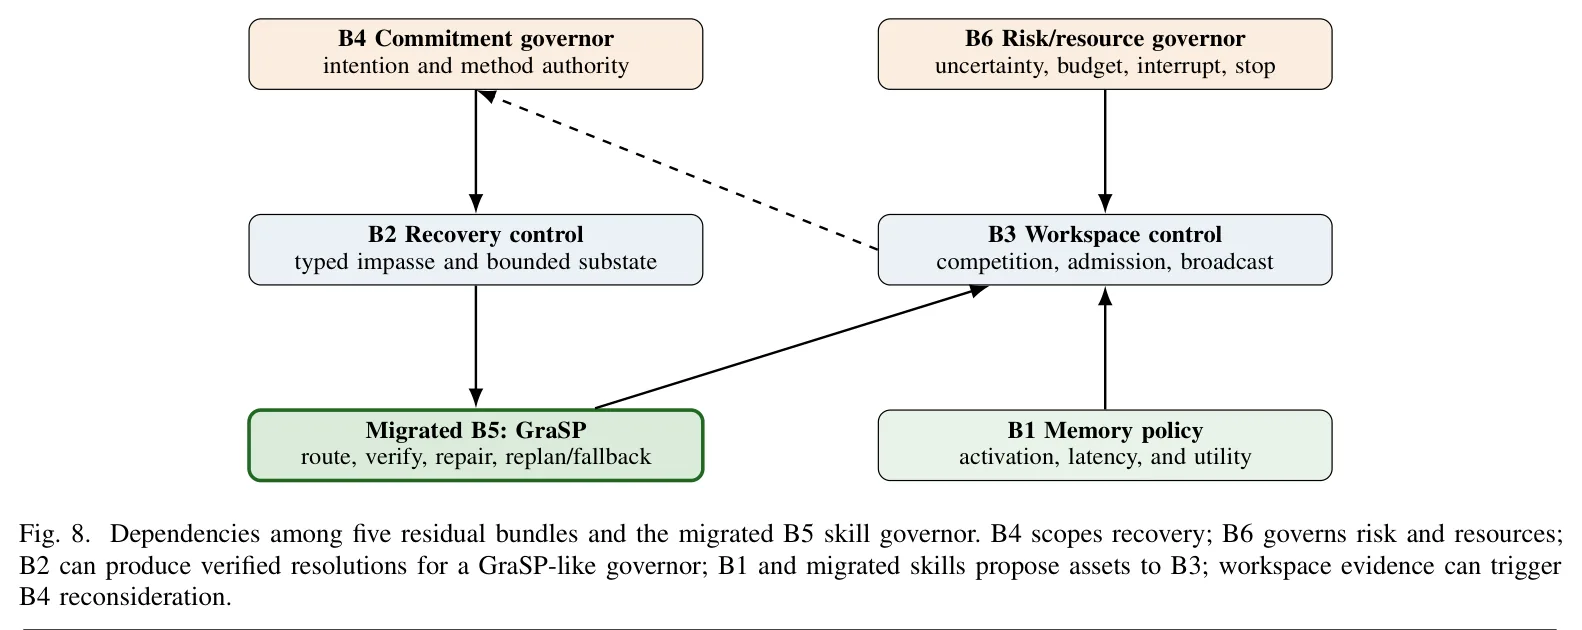
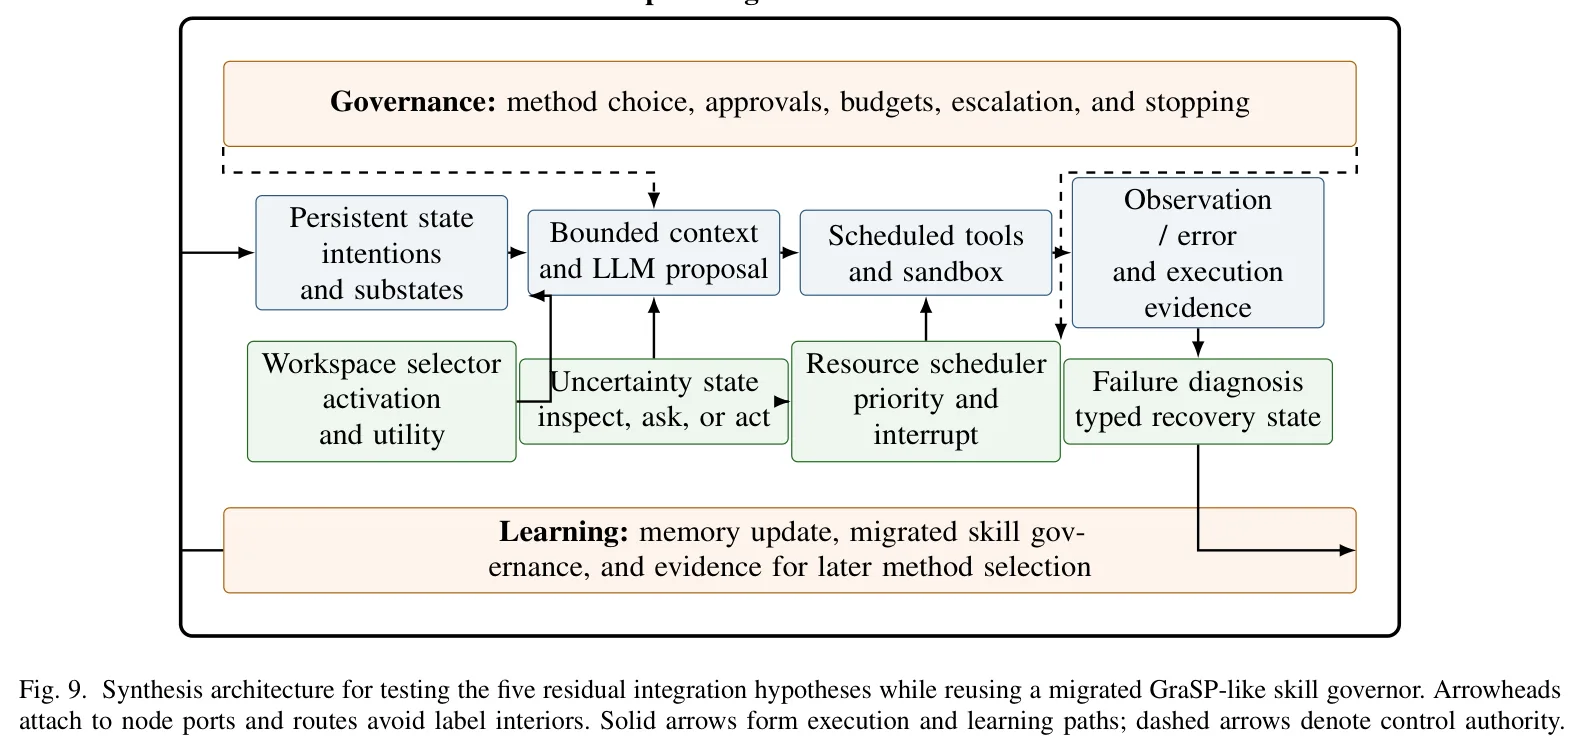
然而,筛选后仍存在五个残余机制束未能耦合。第一束涉及激活延迟与行动效用的权衡;第二束涉及类型化僵局、孤立子状态与解决编译的联动;第三束涉及有界内容竞争、广播与准入学习的协同;第四束涉及持久意图、重新考虑与实时方法权威的层次关系;第五束涉及不确定性、资源分配、中断与停止的联合决策。这些束的共同特征是每个组件单独存在,但缺乏将它们有机整合的控制语义设计。
讨论与可借鉴点
本综述最深刻的方法论启示在于区分了"声称继承"与"真正迁移"。在智能体研究中,标签化比较("这个系统有反思能力")与机制化分析("反思如何通过状态转换、控制委托与失败处理实现")之间存在巨大鸿沟。作者的七维框架为跨越这道鸿沟提供了操作性工具:任何声称具备某种能力的系统,都可以从这七个维度接受审计,揭示其真正的设计决策。
五个残余机制束代表了最具前沿价值的研究议程。以第五束为例,不确定性条件下行动的资源治理本质上要求在探索与利用之间、在响应延迟与决策质量之间、在可中断性与状态一致性之间进行联合优化。单独处理任何一个子问题都可能陷入局部最优,只有将不确定性量化、资源预算约束与中断语义统一建模,才能实现真正意义上的适应性智能体。
本综述的局限同样值得注意。由于分析对象主要是已发表的系统,可能存在发表偏倚,遗漏了工业界未公开的有效实践。此外,七个维度本身是否穷尽了机制设计的必要空间,仍是一个开放问题——例如,多智能体协作中的通信协议与共识机制在本框架中的定位就不够清晰。未来的工作可以沿两个方向延伸:一是在特定机制束上构造可运行的原型系统,直接验证耦合假设;二是将框架拓展到多智能体场景,考察分布式状态控制与全局资源治理的新维度。
摘要
记忆、规划、反思与工具使用常被作为特征标签进行比较,这掩盖了决定智能体实际运行方式的控制语义。本综述将十个历史认知架构、八个语言智能体运行时家族以及四十二个聚焦机制的现代系统联系起来。我们通过状态、控制、转换、持久性、失败、学习与资源治理重构每一种机制,然后将证据关系(E1–E4)与迁移深度(D0–D4)分开编码。所形成的景观是参差不齐的。现代智能体已在自适应记忆、失败恢复、动态团队选择、工作流搜索、技能归纳、资源调度以及不确定性条件化行动等方面将相当多的部分落地,尽管这种落地往往源于独立的趋同,而非有据可查的继承。最强的剩余机遇在于机制之间的耦合。最接近基线的筛选关闭了一个被提出的鸿沟:GraSP 已经结合了校准的多技能选择、类型化编译、验证、有界修复,以及重规划或 ReAct 回退。仍然存在五个残余束:激活与延迟及行动效用;类型化僵局与孤立子状态及解决编译;有界内容竞争与广播及准入学习;持久意图与重新考虑及实时方法权威;以及不确定性、资源分配、中断与停止。我们贡献了一个具有区分性的机制目录、一个可审计的证据深度框架,以及一份可证伪的议程,用于将这些束作为可组合的运行时不变式加以检验。
Abstract
Memory, planning, reflection, and tool use are often compared as feature labels, obscuring the control semantics that determine how an agent actually runs. This review connects ten historical cognitive architectures, eight language-agent runtime families, and forty-two mechanism-focused modern systems. We reconstruct each mechanism through state, control, transition, persistence, failure, learning, and resource governance, then code evidence relation (E1-E4) separately from migration depth (D0-D4). The resulting landscape is uneven. Modern agents have operationalized substantial parts of adaptive memory, failure recovery, dynamic team selection, workflow search, skill induction, resource scheduling, and uncertainty-conditioned action, although often through independent convergence rather than documented inheritance. The strongest remaining opportunities lie in couplings among mechanisms. Closest-baseline screening closes one proposed gap: GraSP already combines calibrated multi-skill selection, typed compilation, verification, bounded repair, and replanning or ReAct fallback. Five residual bundles remain: activation with latency and action utility; typed impasse with isolated substates and resolution compilation; bounded content competition with broadcast and admission learning; persistent intention with reconsideration and live method authority; and uncertainty with resource allocation, interruption, and stopping. We contribute a distinctive-mechanism catalog, an auditable evidence-depth framework, and a falsifiable agenda for testing these bundles as composable runtime invariants.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。