
通过可行动作映射桥接强化学习与最优控制
Bridging Reinforcement Learning and Optimal Control via Feasible Action Mapping
📝 TLDR
受限动力学系统需同时保证递归可行性与任务性能,但强化学习难以严格满足约束,最优控制又缺乏策略灵活性。为此提出FAOC框架,通过优化映射将RL抽象动作转化为OCP的可行参数集合,兼顾安全性与灵活性。该方法在机器人乒乓球实时运动规划中验证,样本效率与闭环性能均优于现有方法。
🧭 速览
受限系统需兼顾递归可行性与任务性能,RL无法严格保证安全约束,OC缺乏策略灵活性。
提出FAOC框架,用基于优化的映射算法将RL静态抽象动作转为OCP的状态相关可行参数集。
在机器人乒乓球实时运动规划仿真中,样本效率与闭环性能均优于现有基线方法。
融合了OC的可预测安全性与RL的策略灵活性,RL动作空间无需专家或启发式设计。
🆚 方法对比
FAOC (Feasible Action for Optimal Control)
- 保证OCP严格可行性,约束满足有理论保障
- 静态抽象动作空间无需专家或启发式设计
- 在样本效率和闭环性能上优于基线
- 双射映射确保所有有效参数可达
- 依赖OCP实时求解,计算开销较大
- 仅在乒乓球仿真中验证,未做实物实验
- 需准确系统模型构建OCP
- 映射算法增加额外实现复杂度
纯强化学习控制器 (Pure RL)
- 能解决跨领域复杂控制问题
- 无需精确系统模型,灵活度高
- 擅长长时域稀疏奖励任务
- 无法严格保证约束满足
- 安全性差,限制实际应用
- 缺乏可行性形式化保证
最优控制/模型预测控制 (OC/MPC)
- 通过约束显式保证安全性
- 融合系统动力学先验知识
- 在未见环境中仍可安全运行
- 非凸长时域问题求解实时性差
- 难以处理稀疏奖励的探索任务
- 复杂任务下可能计算不可行
学习终端代价方法 (Learned Terminal Cost)
- 可处理长时域稀疏奖励信号
- 保留OC的优势特性
- 利用神经网络近似无穷时域代价
- 通常导致OCP非凸
- 严重影响实时可解性
- 训练不稳定,收敛性难保证
参数化OCP+RL方法 (Parameterized OCP)
- 成功结合RL与OC各自优势
- RL可选择OCP参数优化长期奖励
- 静态动作空间含不可行动作
- 排除最优可行参数,降低学习效率
- 需松弛变量或复杂重构处理可行性
FAOC通过可行动作映射统一了纯RL的灵活性与OC的安全性,优于静态参数化OCP+RL方法(避免不可行动作),同时克服了学习终端代价方法的非凸性问题,在可行性和实时性之间取得更好平衡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
TL;DR
FAOC(Feasible Action for Optimal Control)提出了一种将强化学习与最优控制相融合的控制框架,其核心是通过计算高效的优化映射算法,将 RL 智能体输出的抽象动作映射为状态依赖的最优控制问题可行参数集合,从而在保证动力学约束严格满足的前提下兼具最优控制的可预期安全性与强化学习的策略灵活性。在 8 自由度机器人乒乓球的实时运动规划任务中,FAOC 在样本效率与闭环性能两方面均显著优于现有基线方法。
研究背景与动机
运行受约束的动力学系统——比如机器人执行灵巧操作、无人机在复杂环境中飞行——是现代控制领域的核心挑战之一。这类问题要求控制器同时满足两个相互冲突的目标:一方面需要在长时序、非凸、稀疏奖励的任务中做出高质量决策,另一方面必须严格保证系统的递归可行性与安全性约束。递归可行性意味着当前时刻的可行决策不能导致未来时刻陷入不可行状态,安全性约束则直接关系到系统的物理安全。
在技术路线上,强化学习(RL)和最优控制(OC)分别代表了两种典型的解决思路。[[强化学习]]擅长从与环境的交互中学习复杂策略,在处理长时序决策、非凸优化和稀疏奖励信号方面表现出色,但其一个根本性缺陷在于难以严格保证约束满足——即便通过惩罚项或约束优化方法加以引导,理论上也无法排除策略在某些状态下产生不可行动作的可能性。这一点严重制约了 RL 在安全关键场景(如手术机器人、无人驾驶)中的应用。最优控制,特别是[[模型预测控制]](MPC)类方法,通过显式建模系统动力学并求解约束优化问题,能够从理论层面保证约束的严格满足,但其计算复杂度随问题规模急剧增长,在需要实时响应的场景中往往力不从心。此外,传统的 MPC 难以有效处理长视野规划和稀疏奖励信号带来的挑战。
现有融合 RL 与 OC 的尝试存在两个关键痛点。第一,许多方法依赖专家或启发式设计来定义 RL 的抽象动作空间边界,这种人工设定的“可行域”本质上是一种模糊的近似,与真实系统的动力学约束之间存在难以量化的偏差。第二,部分方法尝试将 OCP 的可行性保障托付给 RL,让 RL 隐式学习可行域的形状,但这使得学习任务变得更加困难——智能体不仅要学会完成任务,还要同时学会规避不可行区域,学习效率大幅下降,最终策略的性能上限也因此受到制约。
FAOC 的核心切入点是:与其让 RL 学会“哪些动作是安全的”,不如为 RL 提供一个精确的、计算上可逆的映射,将抽象动作空间 bijectively(双射地)映射到 OCP 的状态依赖可行参数集合。这样 RL 只需要在抽象空间中表达“意图”,而具体的约束满足则由映射层保证,两者各司其职、互不妥协。
方法
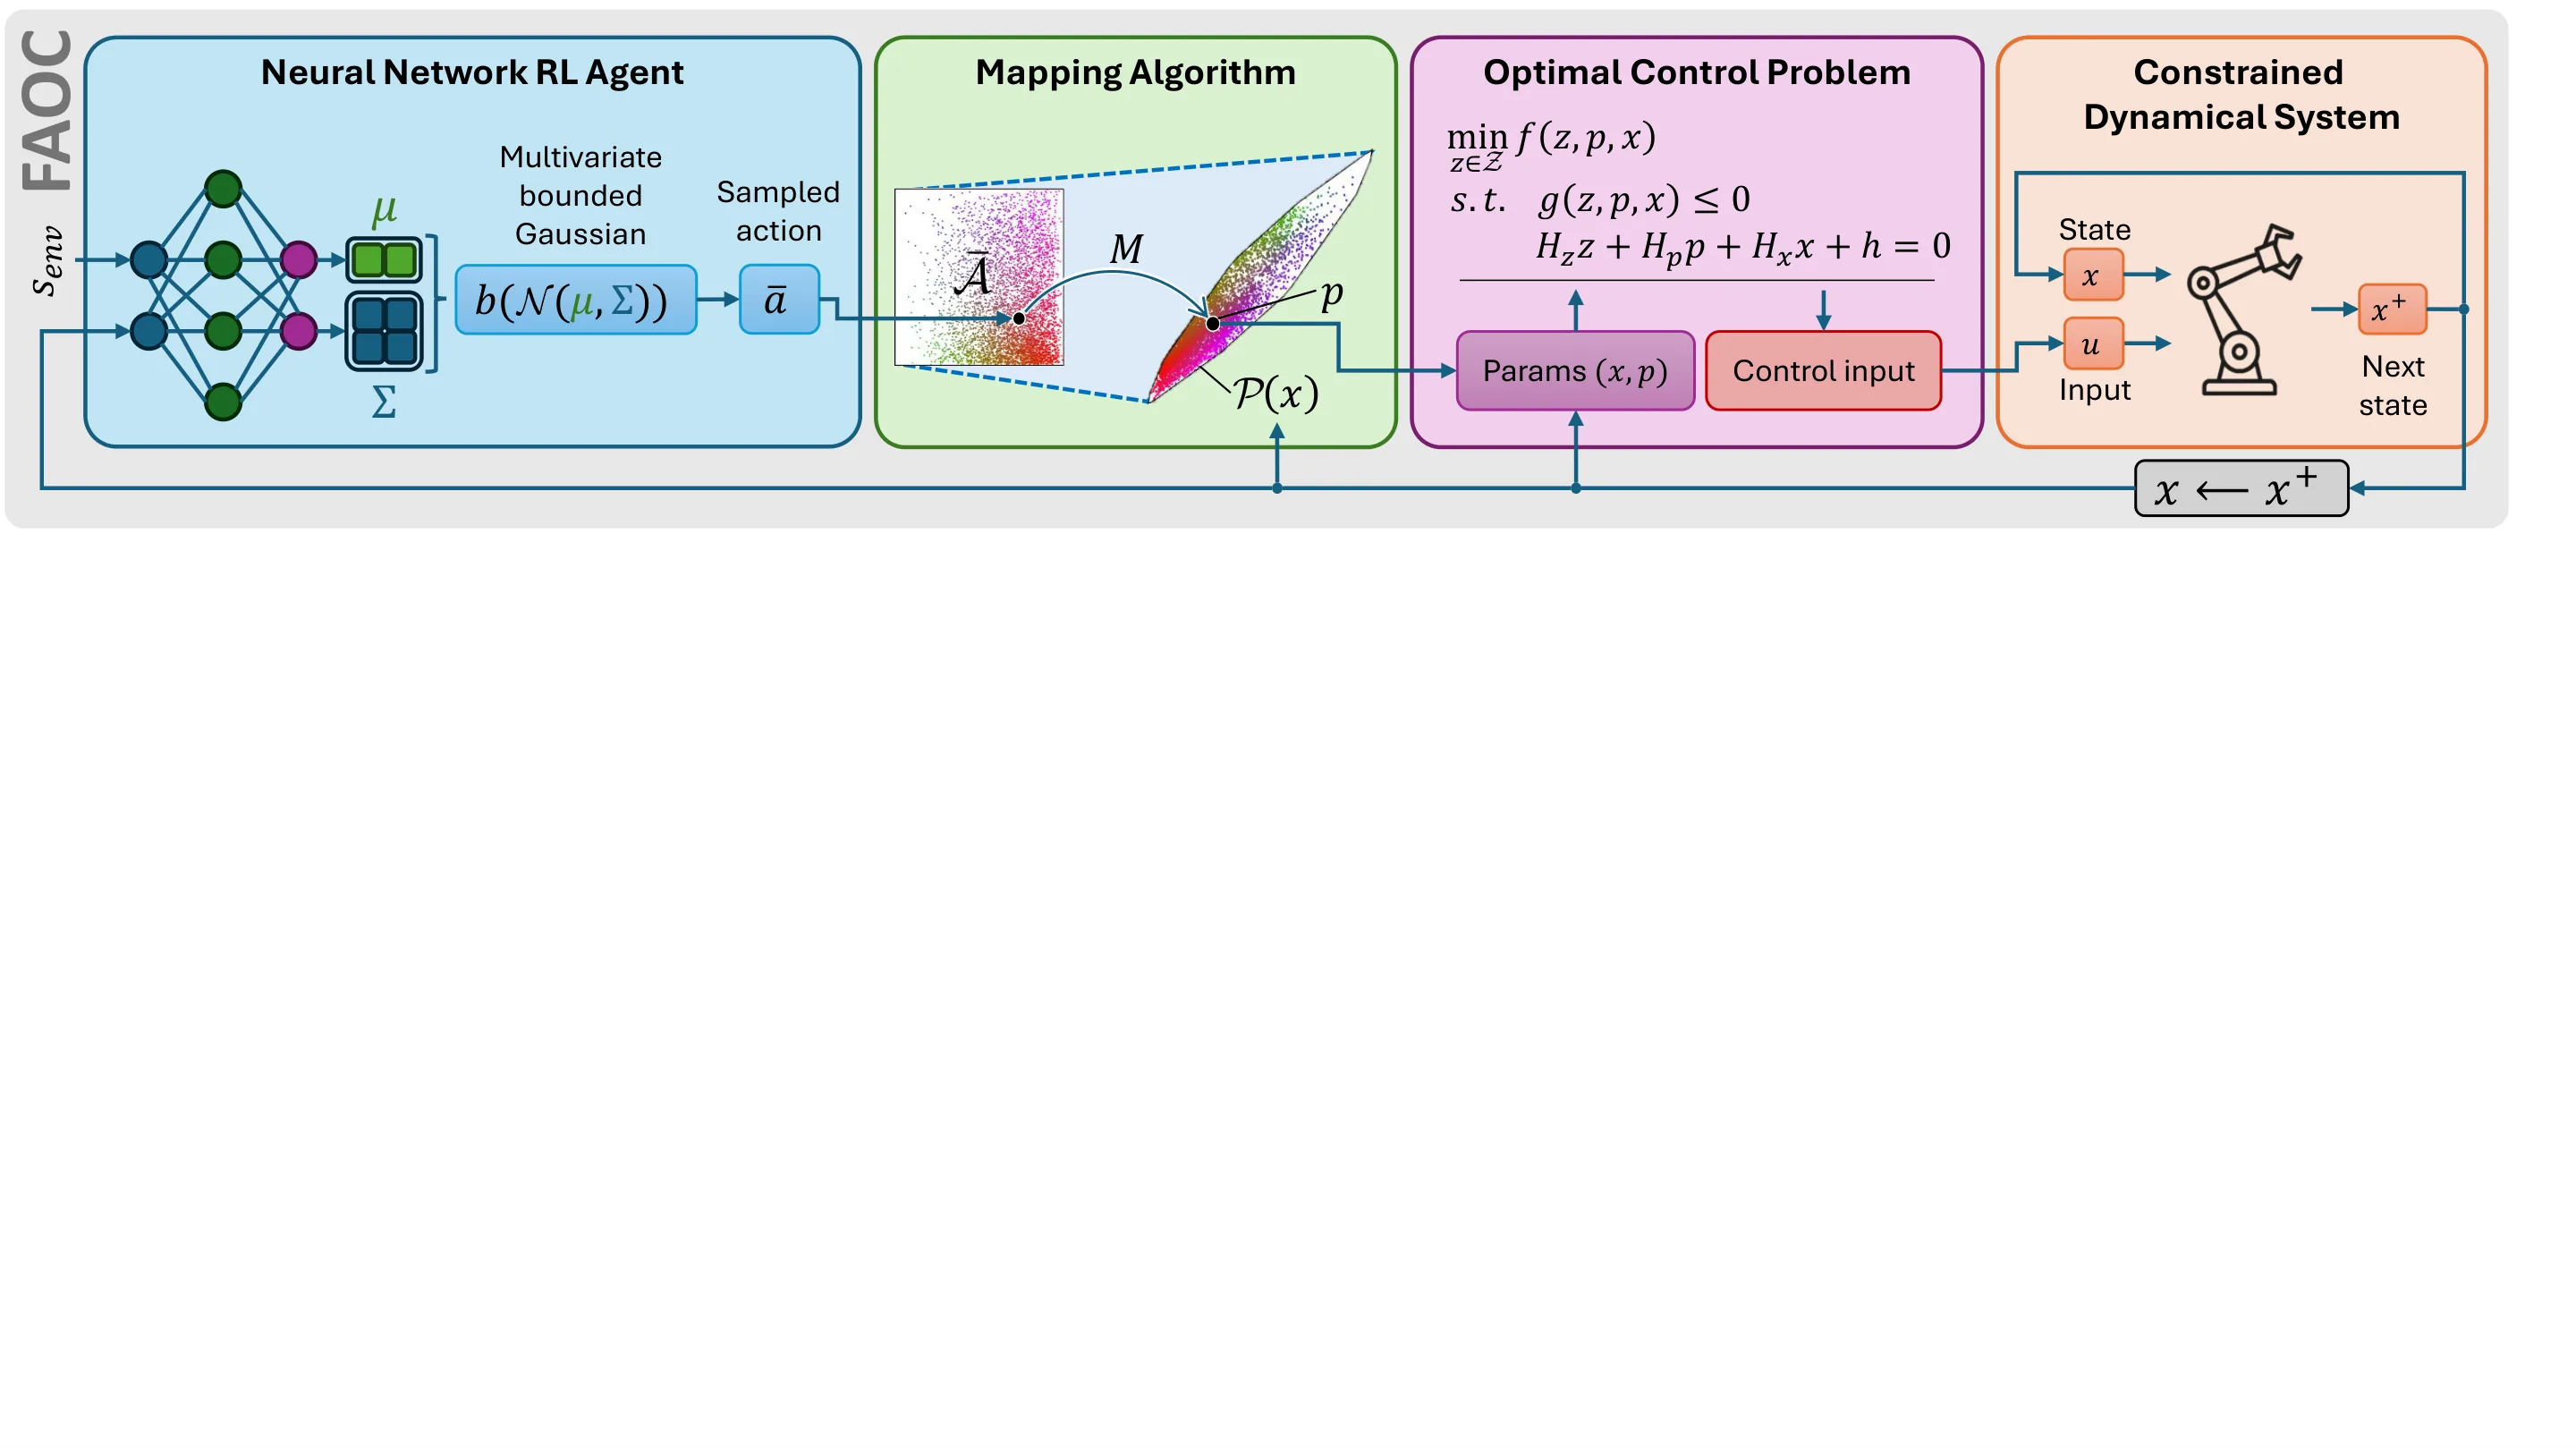
FAOC 的整体框架构成了一个四步闭环的控制系统。第一步,RL 智能体基于当前系统状态 输出一个多元高斯分布的参数 ,这个分布定义在一个静态的抽象动作空间 上,其中 通常远小于状态空间的维度。第二步,也是 FAOC 的核心创新点,映射算法 将抽象动作 映射为状态依赖的可行参数 。这里 是 OCP 在当前状态 下的可行参数集合。第三步,将参数 嵌入 OCP 的特定位置——论文中以终端状态目标 为例——求解该最优控制问题,得到最优控制序列。第四步,将第一个控制输入以开环方式作用于系统,进入下一个控制周期。
映射算法 的设计是该方法的核心,其数学基础建立在一个关键的拓扑性质刻画上。考虑参数化的 OCP:
论文证明,在若干技术条件下——包括 的紧凸性、约束函数关于 的联合凸性、联合可行集在 方向的无衰退性以及存在严格可行内部点——参数集 是一个紧、实心(solid)、凸的集合。推论进一步指出,对于带终端约束 且 行满秩的线性 MPC, 自动具备上述性质。这意味着对机器人关节的位置-速度联合约束(这是乒乓球运动规划中的典型设定),可行参数集在状态空间中形成良好的凸结构,为后续映射算法的设计奠定了理论基础。
通用径向映射算法(Algorithm 1)的设计思想可以直观理解为:在抽象动作空间(基集 )和 OCP 可行参数集(目标集 )之间建立一条“双向道路”。对于任意输入 ,首先将其相对某参考点 做径向展开,计算到达 边界的比例因子 ;然后在目标空间 中,以相同参考点 为中心,沿变换后的方向 展开,计算到达 边界的比例因子 。最终映射结果为:
该设计满足一个关键性质:映射 是严格可逆的(Proposition 1),这意味着不同的抽象动作必然映射到不同的可行参数,绝不会出现两个不同的意图被混为一谈的“action aliasing”问题。
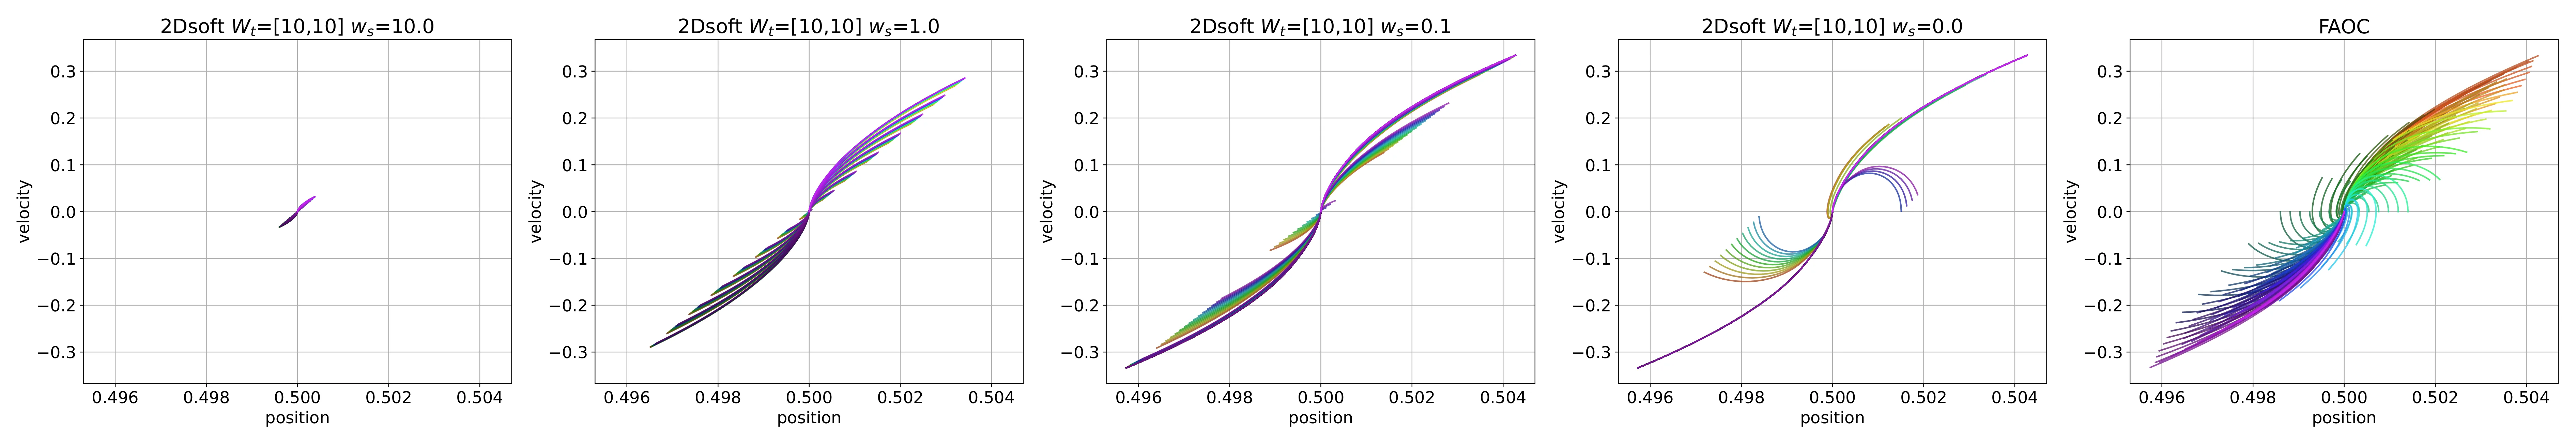
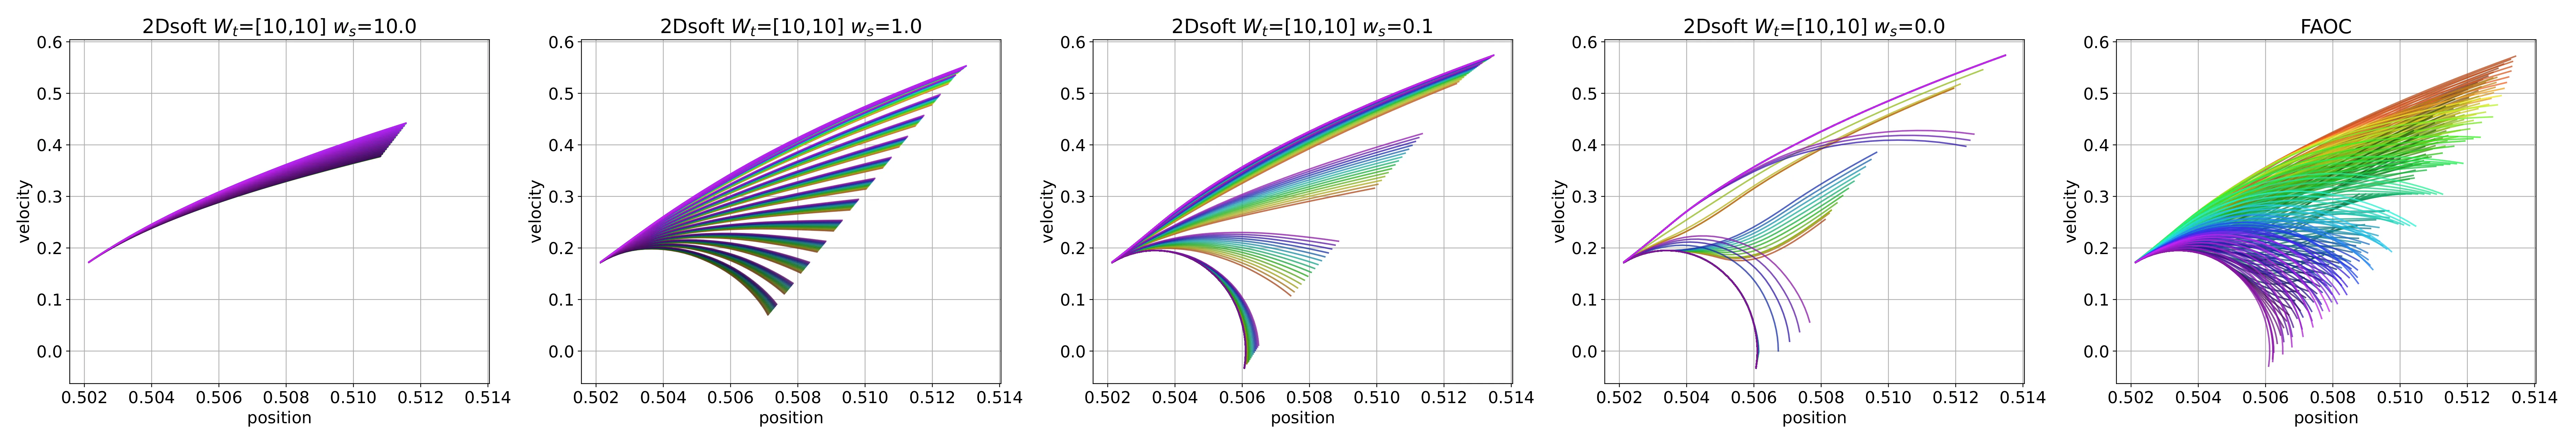
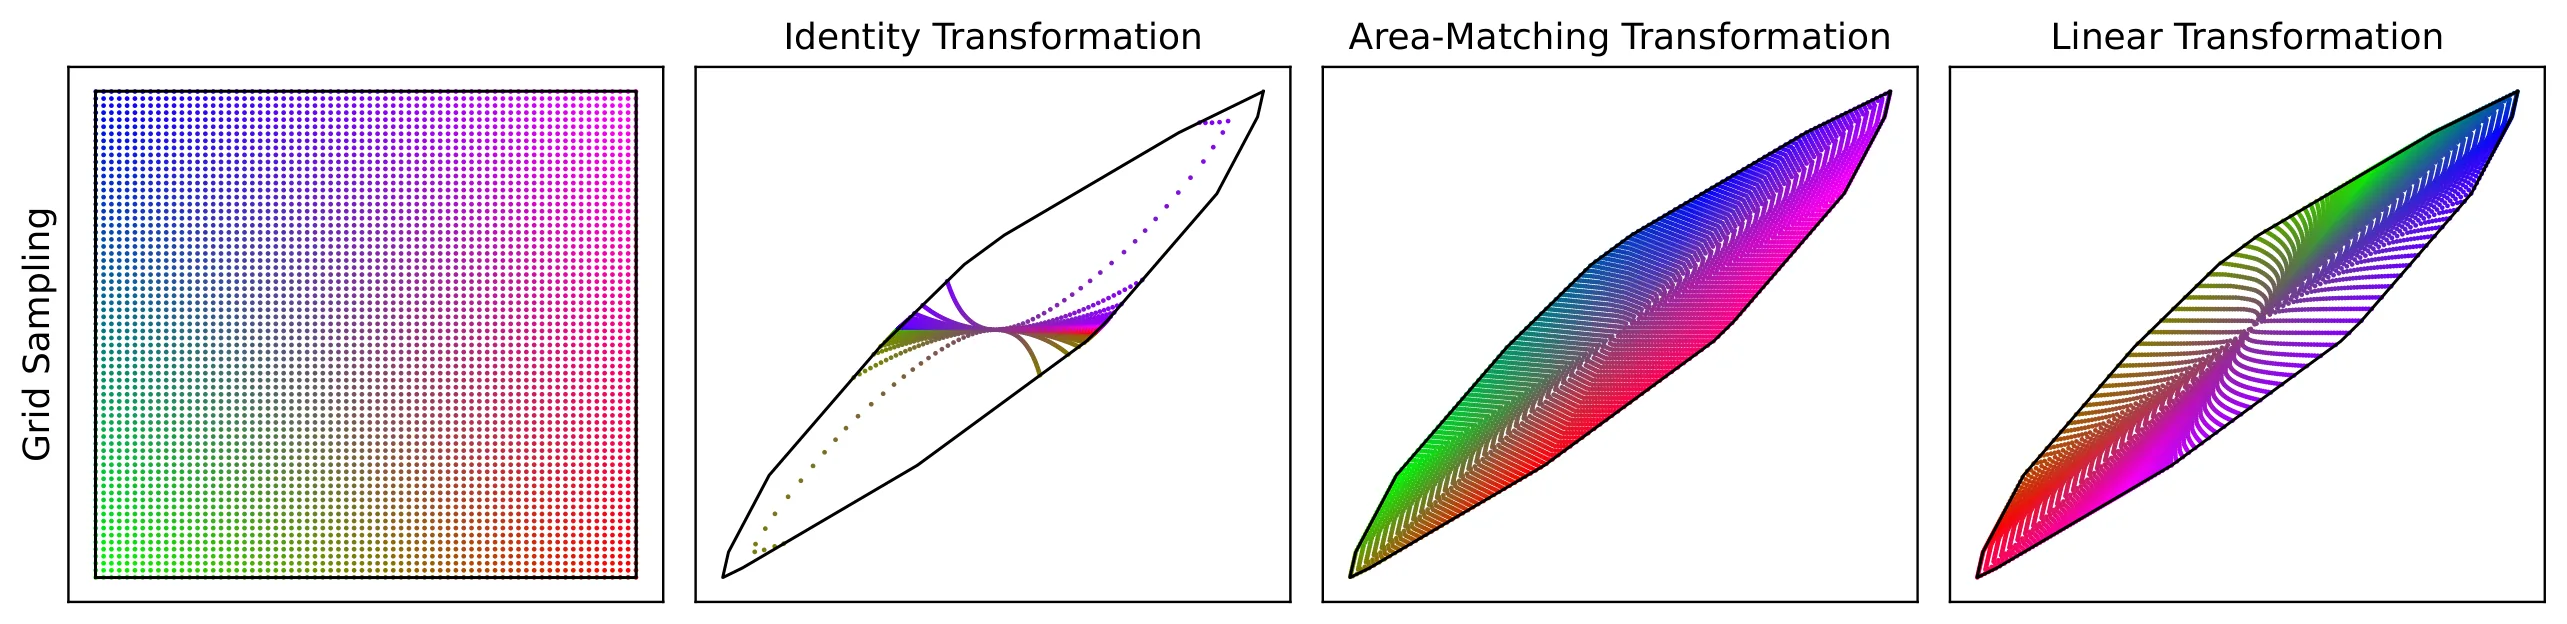
然而,简单径向映射会导致几何畸变问题。当基集和目标集的形状差异较大时(比如矩形与圆形),径向映射会使得目标空间的角点附近被过度压缩、边缘附近被过度拉伸,RL 学到的策略在目标空间中无法精确表达。FAOC 通过两条技术路径缓解这一畸变。第一条路径是二维面积匹配变换(Propositions 2 & 3):通过建立归一化面积函数 ,用极角的空间分布匹配来重新定义方向变换 ,确保映射后边缘的概率密度与原分布一致,但该方法仅适用于二维情形。第二条路径是任意维度的线性变换(Proposition 4):在基集和目标集上分别计算最大内切椭球(MVIE),用椭球作为形状的代理集,映射变换矩阵为 。MVIE 可通过半定规划高效求解,这种方法将非线性畸变转化为线性变换的近似,对高维问题同样适用。
在实时计算层面,FAOC 的一个关键工程贡献是状态无关变换矩阵的计算方法。论文通过构造一个包含初始状态空间 的增广集 ,可以在离线阶段预先计算与状态无关的变换矩阵 ,避免在每个控制周期中在线求解半定规划。这一设计使得整个映射算法在实时控制循环中仅需执行简单的矩阵-向量乘法与边界比例的凸优化查询,计算开销与在线 QP 求解相比可以忽略不计。
实验与结果
实验在 8 自由度机器人乒乓球运动规划任务上进行,这一场景选择极具代表性:乒乓球回球需要在极短的时间内(毫秒级)完成复杂的视觉感知、轨迹预测和运动控制,同时系统的关节角度、角速度、加速度和加加速度都存在严格的物理限制,稍有超出即可能导致电机损坏或失控。
控制架构采用分层设计。高层 RL 策略以 31.25 Hz 的频率(每 32 ms)输出 16 维动作,对应 8 个关节的目标位置与目标速度(航点形式)。底层以 1 kHz 的频率执行关节位置控制。FAOC 在每个高层决策周期内,为每个关节独立求解一个预测时域 、每段时长 8 ms 的最优控制问题,使用分段恒加加速度(jerk)规划轨迹,离散化后得到三积分器动力学模型 :
QP 求解器采用 DAQP,终端约束通过最大控制不变集 刻画,并通过轻度缩小连续时间极限来保证采样后不违反原始约束。
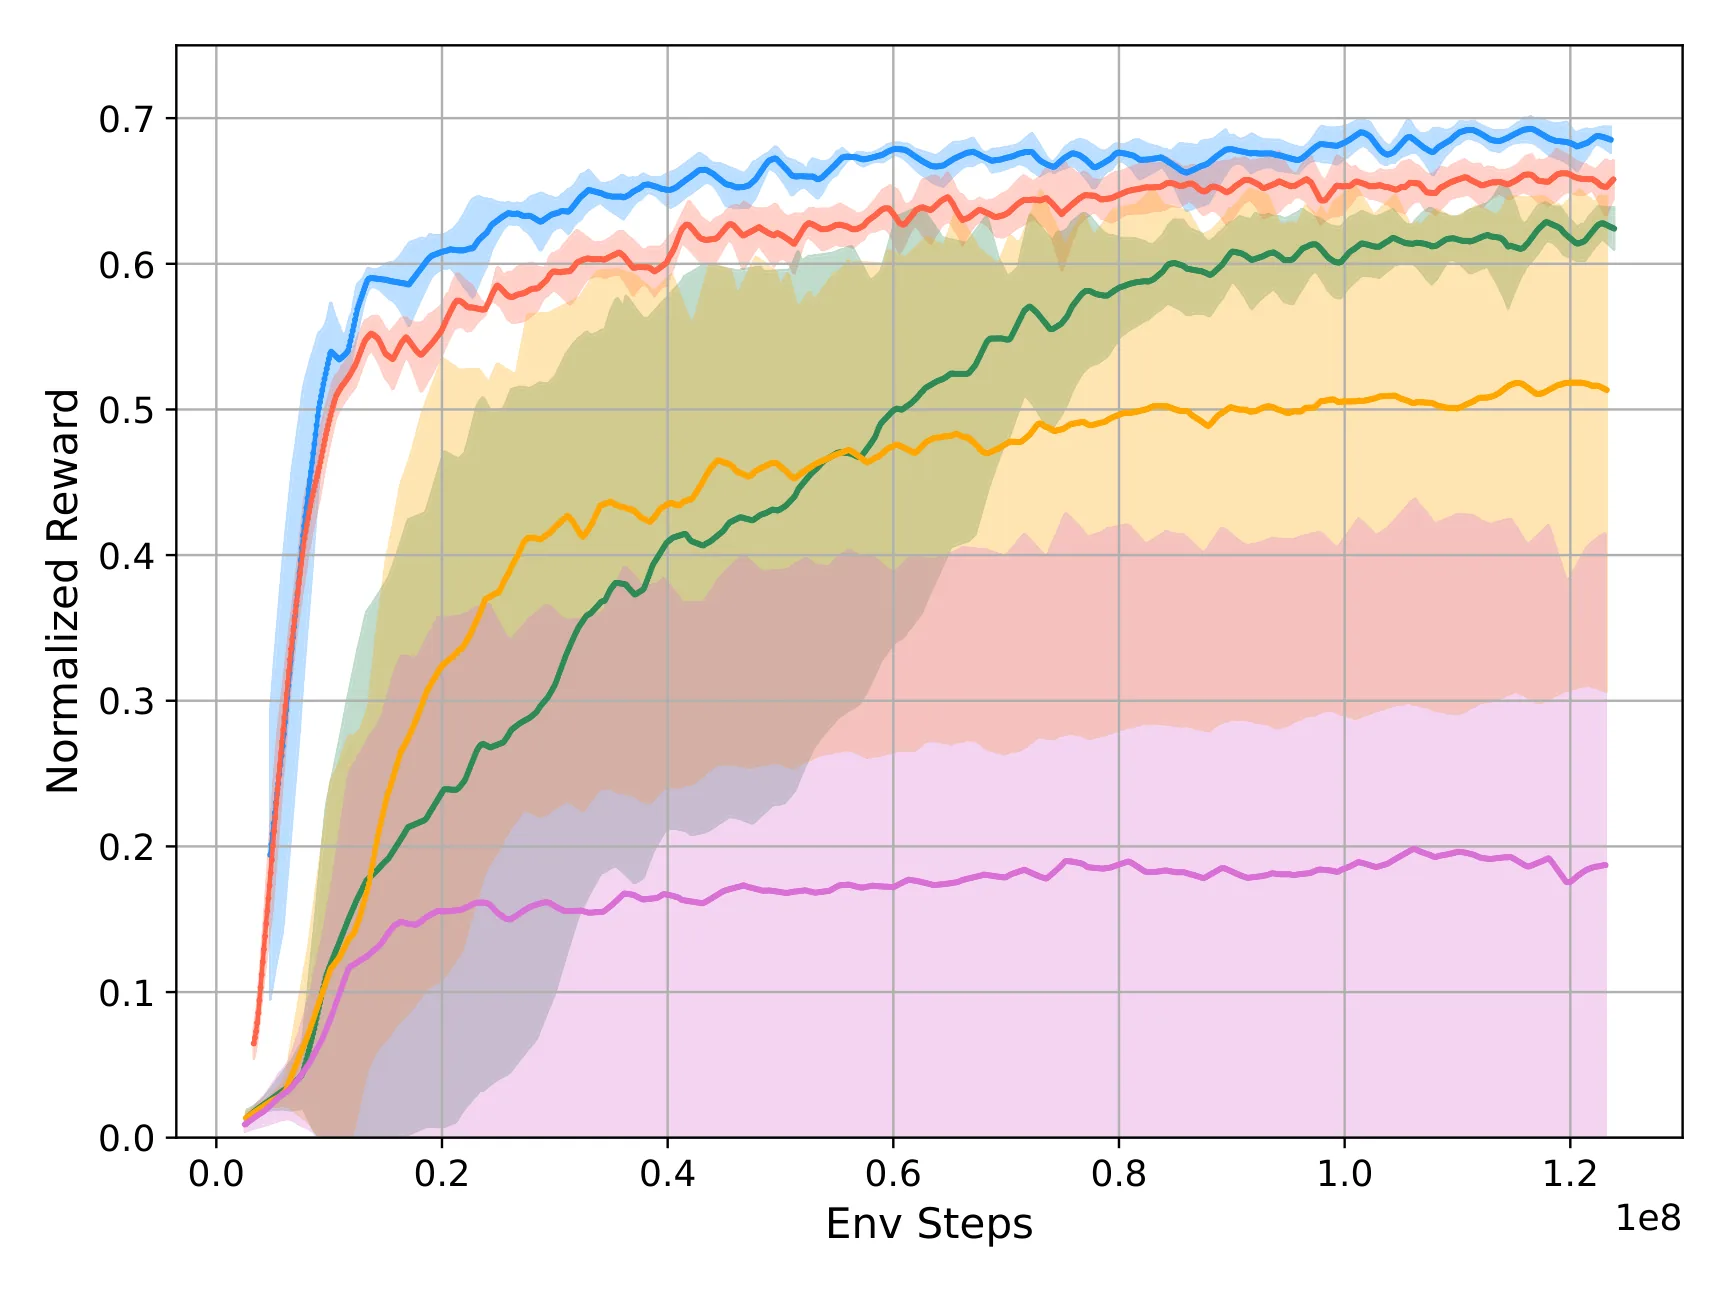
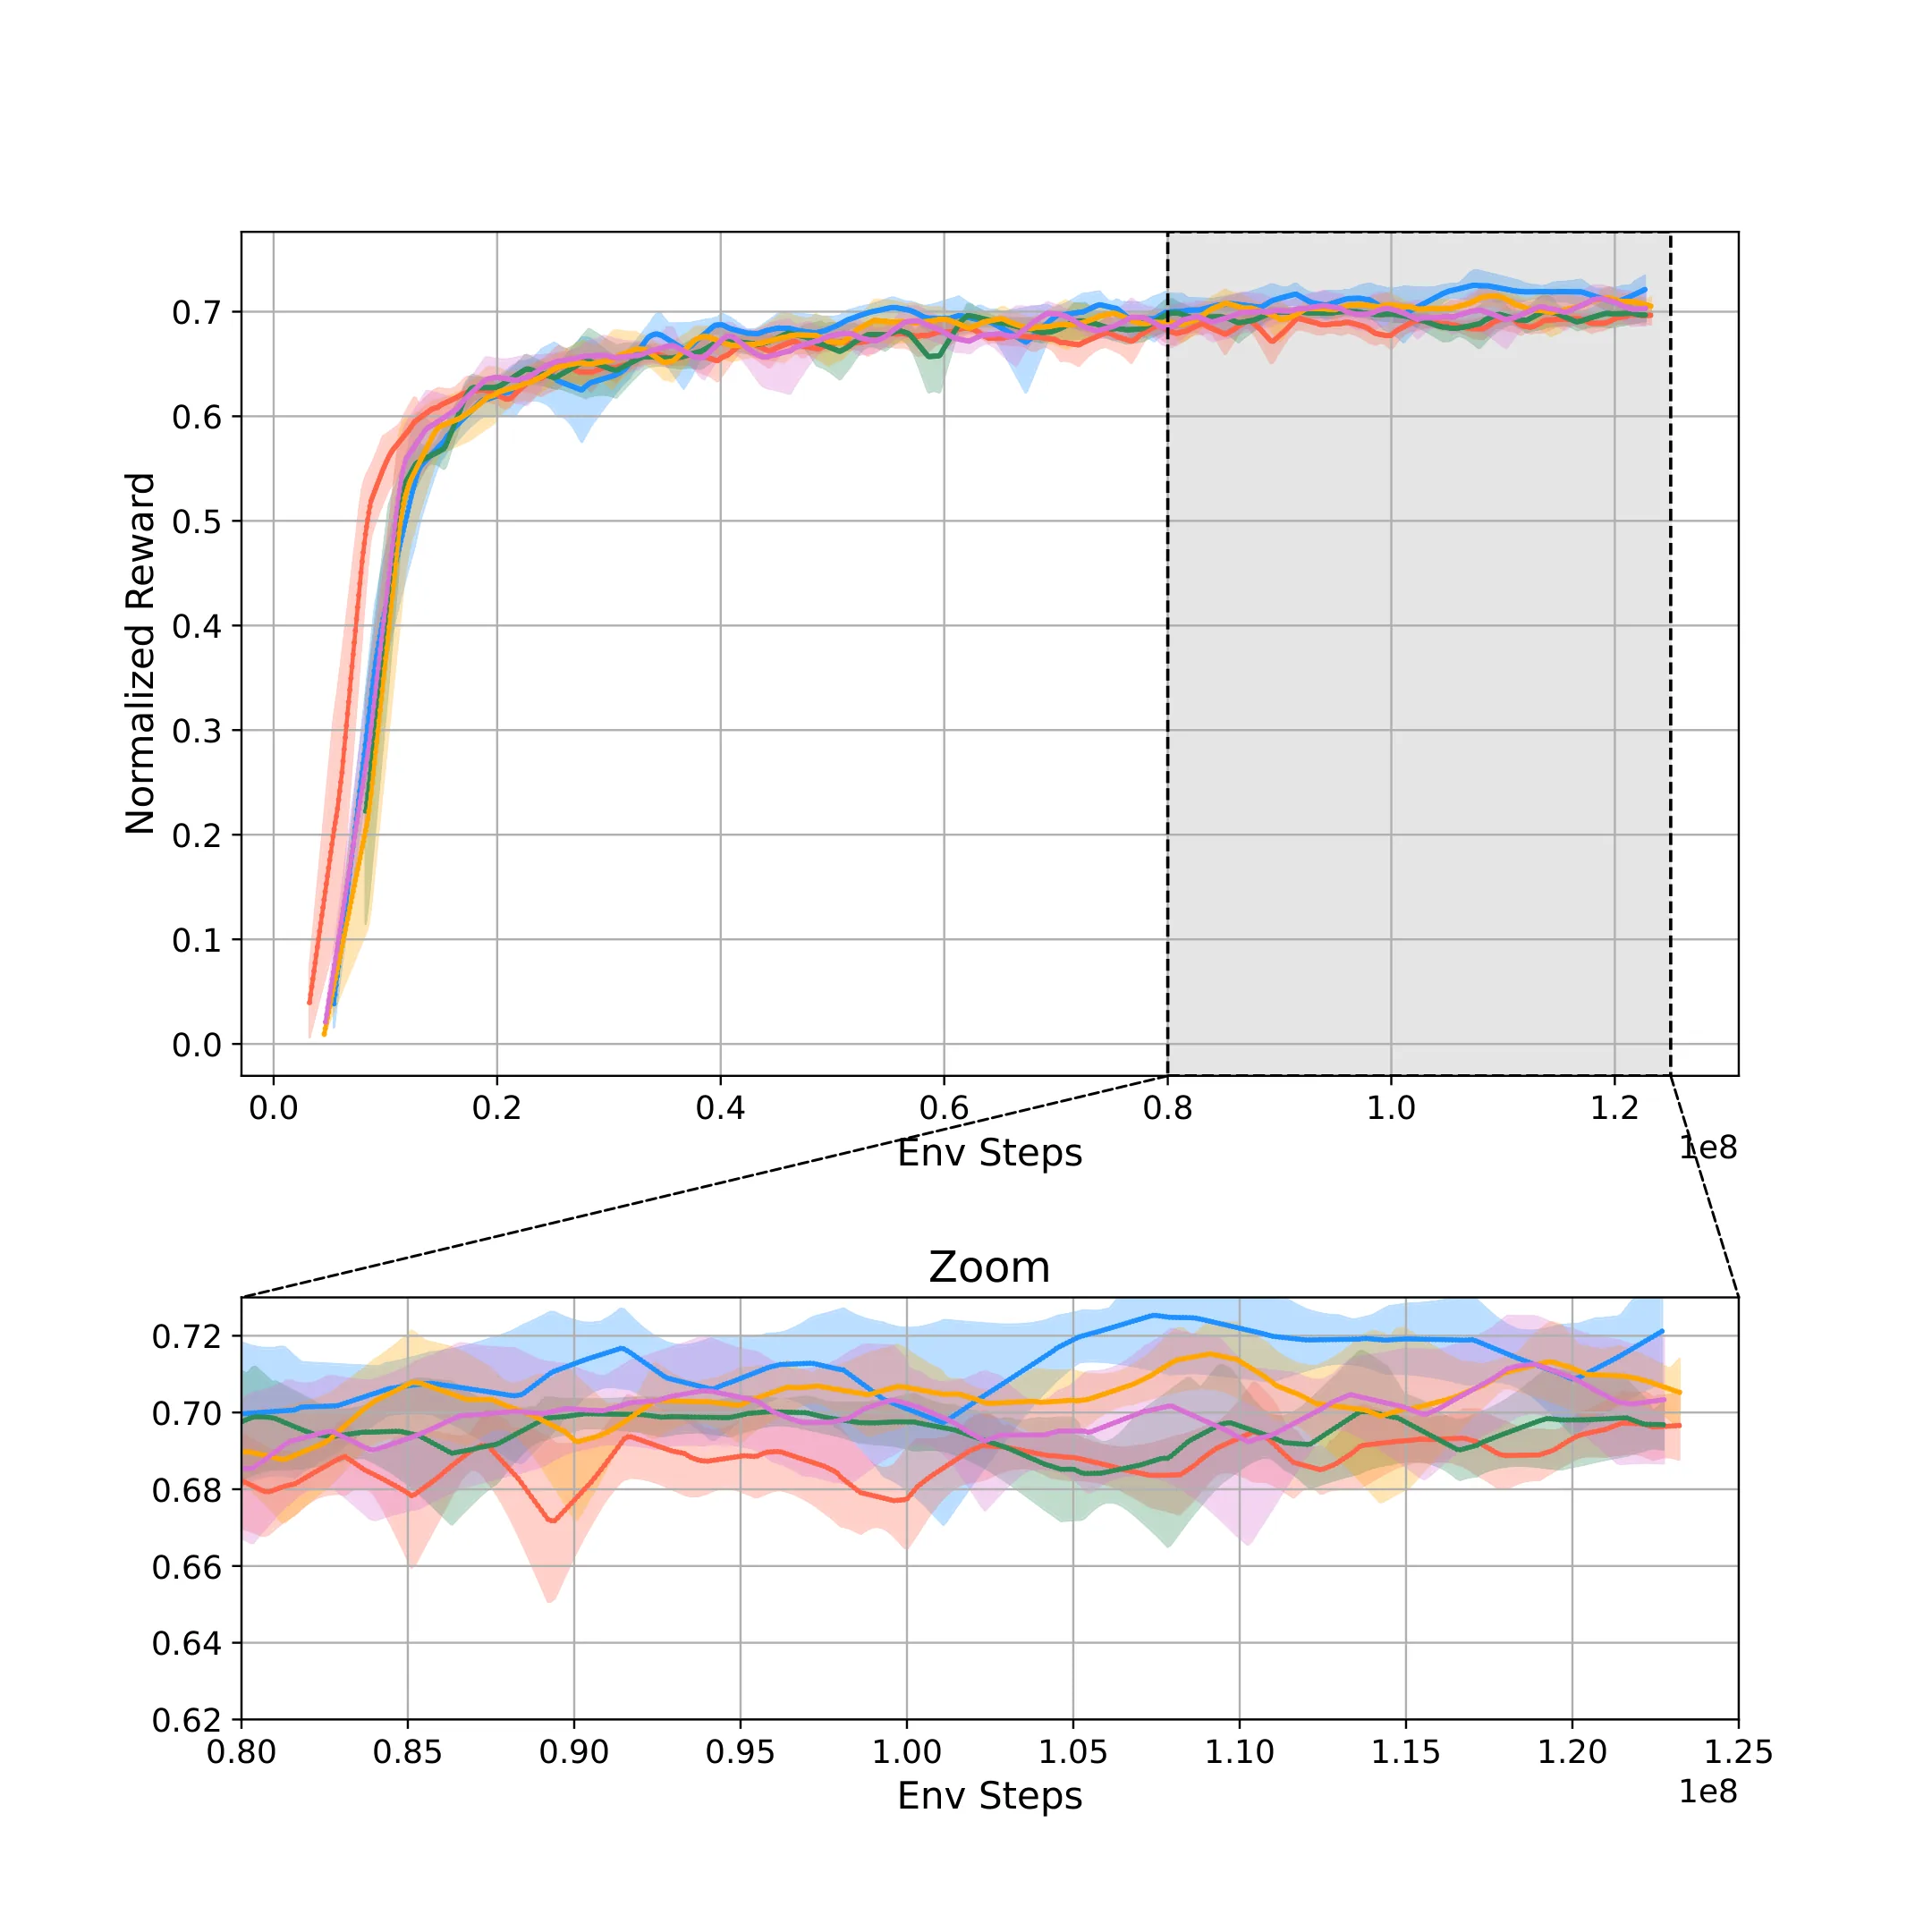
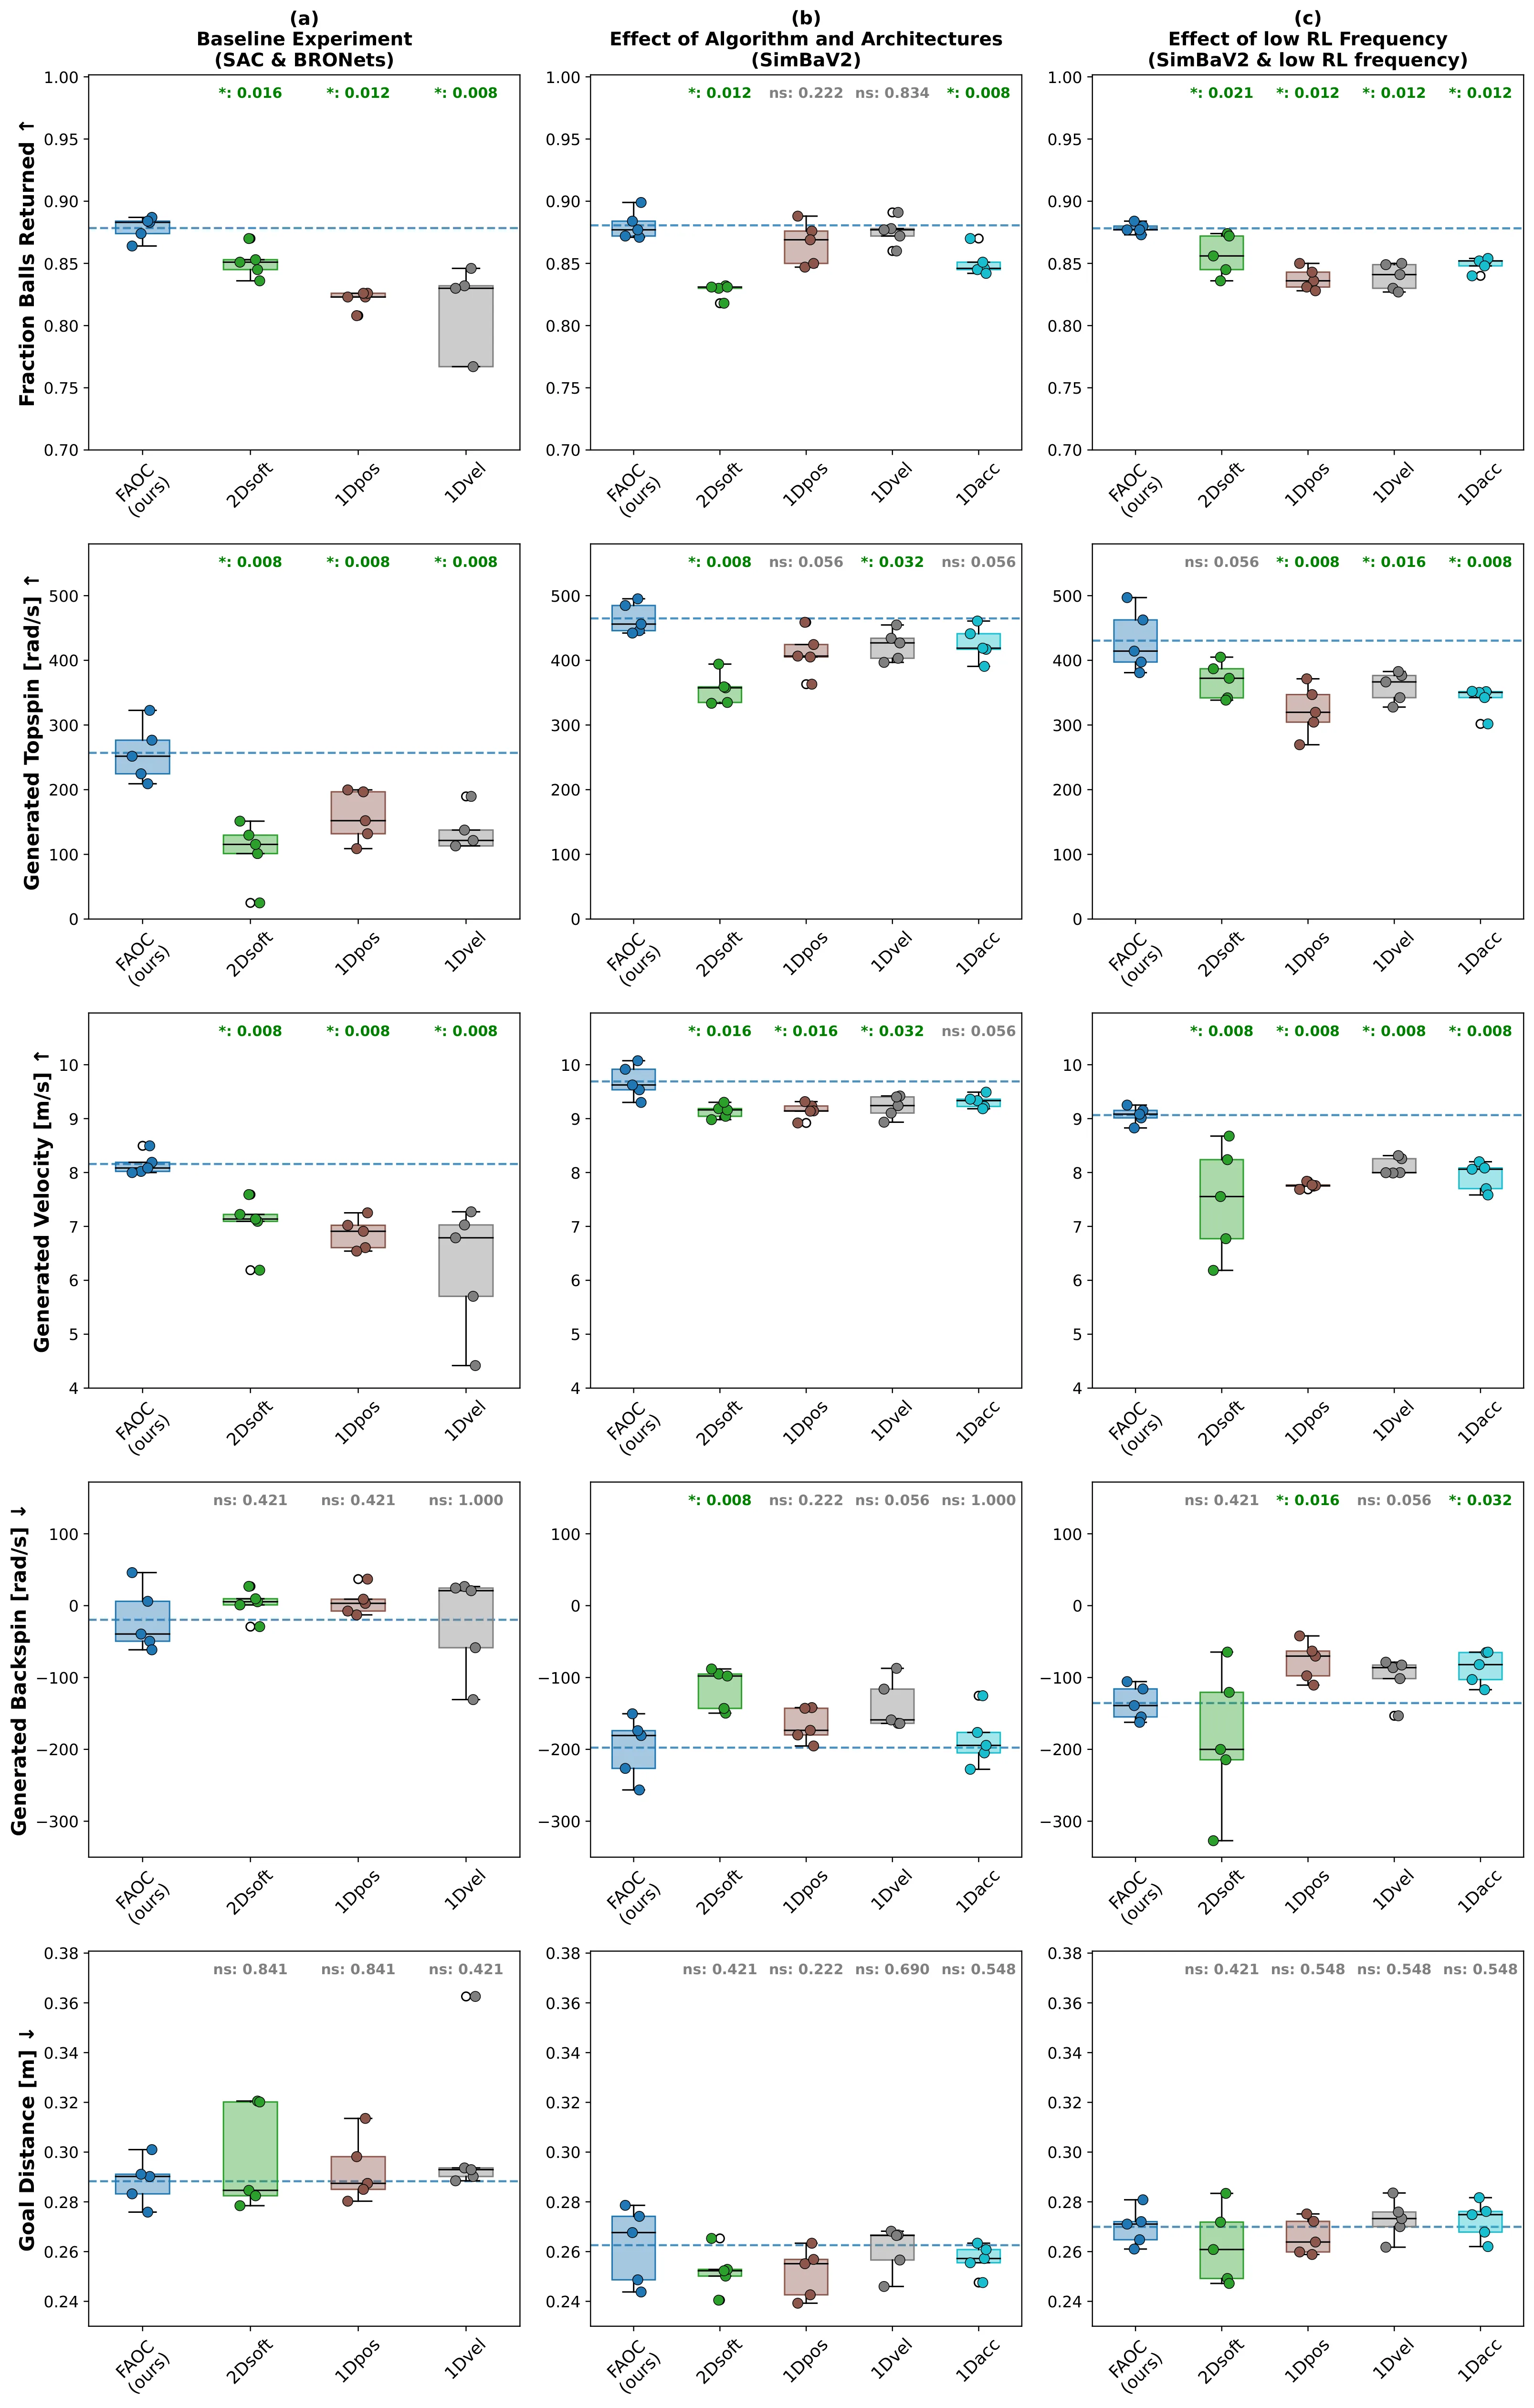
对比实验涵盖多种方法:FAOC(本文方法,带可达性感知映射)、2Dsoft(无映射的软约束基线)、1Dpos/1Dvel/1Dacc(仅控制单一变量的可达性方法)以及 1D 系列维度受限基线。训练采用 SAC 结合 BRONets 架构(基线对比)以及 SimBaV2 结合分类式分布 Critic(大规模实验),学习三项技能:落点控制、上旋/下旋生成、扣杀。评价指标包括回球率(Fraction Balls Returned)、上旋量、回球速度、下旋量和目标距离误差,每项基于 1000 个评估回合和 5 个随机种子进行统计。
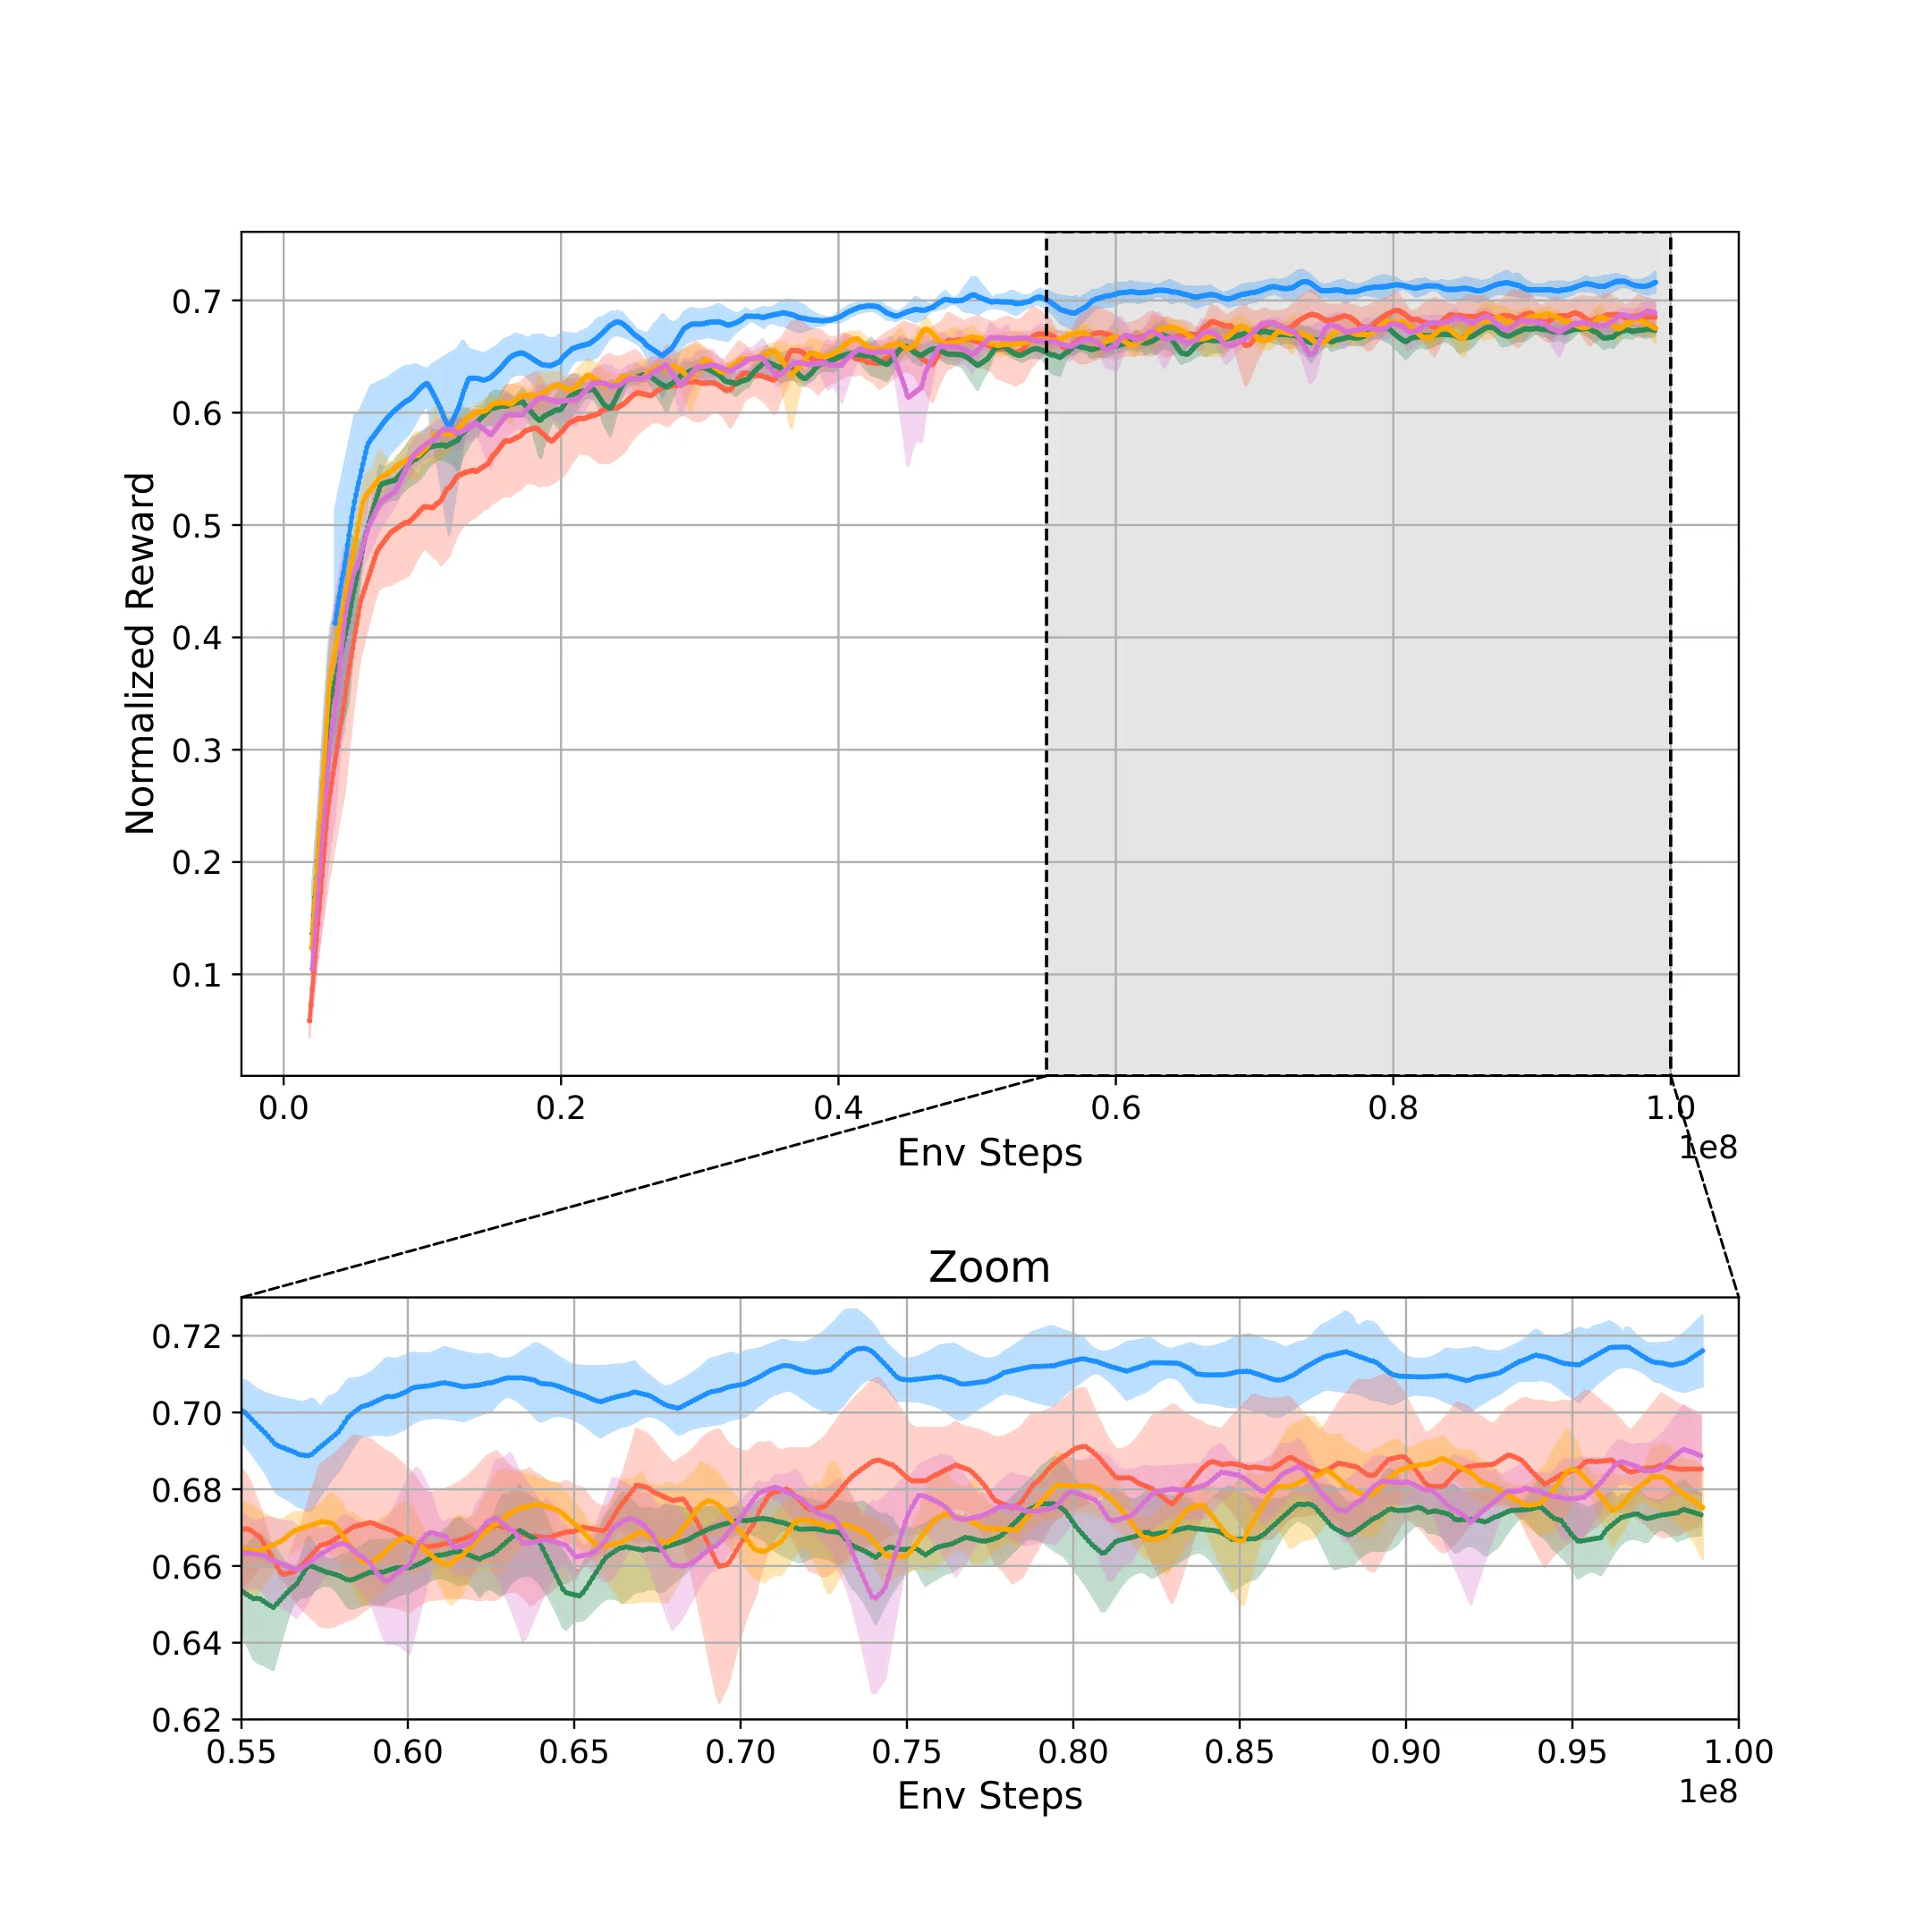
实验结果呈现出一致的模式。在所有三个实验配置下,FAOC 均显著优于对比基线:回球率方面,FAOC 稳定保持在最高水平,与 2Dsoft 的差距尤为显著——这验证了“可达性感知动作空间”设计的价值,因为 2Dsoft 探索了大量不可行航点,严重损害了样本效率;与 1D 系列方法的对比则表明,二维联合动作空间的表达能力远优于一维分离控制。在低 RL 频率(7.8125 Hz,即每 128 ms 决策一次)的压力测试中,FAOC 的性能几乎保持不变,而其他控制器的性能下降明显,这说明 FAOC 的长视野轨迹段可控性设计使系统在感知-决策延迟增加时依然保持鲁棒。
讨论与可借鉴点
FAOC 论文在理论与工程层面都有值得称道之处,但同时也存在若干局限性值得关注。
从理论贡献看,论文给出了 紧实凸性的严格证明,建立了 RL 动作空间到 OCP 可行域之间映射的数学框架,Proposition 1 的严格可逆性证明为“action aliasing”问题的避免提供了理论保证。然而,这一证明依赖于凸性假设,论文虽然通过乒乓球场景展示了“非凸任务 → 凸参数集”这一工作流的可行性,但并未给出非凸可行域的通用处理方法。对于更复杂的约束场景(如回避障碍导致的非凸可达集),映射算法的适用性有待进一步探索。
从实验覆盖看,论文仅在机器人乒乓球单一任务上进行仿真评估,缺乏跨任务迁移性的证据——比如在四足机器人运动、无人机悬停、机械臂操作等不同类型的受限动力学系统上的表现如何?此外,论文未独立报告硬件在环实验结果(仅引用了另一篇真实机器人比赛论文),对感知噪声、模型误差、通信延迟等非理想因素的鲁棒性评估不足。
从工程实践看,FAOC 的设计思路对[[强化学习与最优控制融合]]领域具有重要的借鉴价值。传统的“让 RL 学习可行域”路线相当于让智能体同时完成“规划”与“安全”两个任务,而 FAOC 通过显式映射将两者解耦,RL 只需关注策略层面的“意图表达”,安全性由映射层和 OCP 保证。这种关注点分离的设计哲学值得在其他融合框架中推广。
映射算法的可逆性设计也值得关注。严格可逆保证避免了策略表达能力的损失,而状态无关变换矩阵的离线预计算则解决了实时性瓶颈。这两者的结合——理论优雅性与工程可实现性——是论文能够落地到毫秒级实时控制的关键。
未来研究可以从几个方向展开:一是将 FAOC 扩展到非凸可行域,研究在障碍物回避等场景下的映射算法;二是开展跨任务泛化实验,验证方法在不同受限动力学系统上的通用性;三是探索端到端的可微分化设计,将映射算法嵌入 RL 的梯度更新流程,实现动作空间与策略的联合优化。
摘要
运行受约束的动力系统要求控制器在高效求解复杂任务的同时满足递归可行性与安全性约束。为应对这些相互冲突的需求,我们提出了可行动作最优控制(FAOC),一个将强化学习(RL)与最优控制(OC)相融合的新型控制框架。其核心贡献在于一种计算高效的、基于优化的映射算法,该算法将强化学习智能体的动作从静态的抽象集合映射为状态依赖的最优控制问题(OCP)可行参数集合,从而保证严格满足动力系统的约束。因此,FAOC 有效地结合了最优控制的可预期安全性与强化学习的灵活性。与已有工作相比,强化学习智能体的抽象动作空间无需专家或启发式设计,最优控制问题的构建也不会因强化学习无法保证可行性而妥协。我们将该方法应用于机器人乒乓球实时运动规划任务中,该任务涵盖了上述所有挑战。通过仿真实验,我们表明 FAOC 在样本效率与闭环性能两方面均优于当前最先进的基线方法。
Abstract
Operating constrained dynamical systems requires controllers to efficiently solve complex tasks while enforcing recursive feasibility and safety constraints. To address these competing requirements, we present Feasible Action for Optimal Control (FAOC), a novel control framework integrating Reinforcement Learning (RL) and Optimal Control (OC). The key contribution is a computationally efficient, optimization-based mapping algorithm that transforms the RL agent's action from a static abstract set into a state-dependent feasible parameter set of the Optimal Control Problem (OCP), guaranteeing strict satisfaction of the dynamical system's constraints. Thus, FAOC effectively combines the predictable safety of OC with the flexibility of RL. In contrast to prior work, the abstract action space of the RL agent does not require expert or heuristic design, and the OCP formulation is not compromised by the inability of RL to guarantee feasibility. We apply our approach to real-time motion planning for robot table tennis, which encapsulates these challenges. Via simulated experiments, we show that FAOC outperforms state-of-the-art baselines in both sample efficiency and closed-loop performance.
论文详细总结(自动生成)
论文总结:FAOC——通过可行动作映射桥接强化学习与最优控制
1. 核心问题与整体含义
研究动机与背景
- 受约束的动力学系统(如机器人)要求控制器在高效完成复杂任务的同时,严格保证递归可行性与安全性约束。
- 强化学习(RL)擅长处理长时序、稀疏奖励、非凸策略问题,但难以严格保证约束满足,限制其在真实场景中的应用。
- 最优控制(OC)/模型预测控制(MPC)能显式建模动力学并严格执行约束,但难以处理非凸、长视野、稀疏奖励任务,且在大规模 OCP 下计算可能不可实时。
- 现有 RL-OC 融合方法存在两大问题:
1. 动作空间依赖专家/启发式设计(如人为给定可行边界),导致"边界模糊";
2. OCP 可行性依赖 RL 参数时,RL 必须隐式学习可行域,严重影响学习效率与最终性能。
- 本文目标是设计一个映射算法,把 RL 的抽象动作 bijectively 映射到 OCP 的状态依赖可行参数集,从而兼具 OC 的安全性与 RL 的灵活性。
2. 方法论
2.1 整体框架(FAOC)
FAOC 由四步闭环构成(见图 1):
1. RL 智能体基于状态 输出多元高斯分布的参数 ,通过非线性有界函数 (如 tanh)得到静态抽象动作 ;
2. 映射算法 把 映射为状态依赖的可行参数 ;
3. 将 嵌入 OCP 的"动作编码参数"位置(如终端状态目标 ),求解 OCP;
4. 将最优控制输入以开环方式作用于系统,进入下一周期。
2.2 OCP 可行参数集的拓扑刻画(Lemma 1 & Corollary 1)
- 对通用参数化 OCP:
- 在以下条件下 是紧、实心(solid)、凸集: 紧凸; 关于 联合凸;联合可行集在 方向无衰退方向;存在严格可行内部点;以及 。
- 推论:对带终端约束 的线性 MPC( 行满秩), 自动具备上述拓扑性质。
2.3 通用径向映射算法(Algorithm 1)
针对两个紧、实心、凸集 (基集)、(目标集):
其中 为 到达 的比例, 为 到达 的比例; 为正齐次、可逆、连续的方向变换。
- Proposition 1:在上述条件下 严格可逆(无 action aliasing)。
- 当 为多面体(-表示)时, 可由简单的 half-space ratio test 解析计算。
2.4 缓解几何畸变
- 2D 面积匹配变换(Propositions 2 & 3):定义归一化面积函数
方向变换 用极角 替换,严格保证边际角分布匹配,但仅适用于 。
- 任意维度线性变换(Proposition 4):用椭球代理集 ,得到 。对多面体可由 MVIE(最大内切椭球) 通过 SDP 高效求解。
2.5 隐式目标集的可实时计算
- 将目标集表示为更高维凸集的仿射像:,。
- 内部点计算:通过降低维度的 求 Chebyshev 中心;
- Proposition 6(顶点法):在低维可用;
- Proposition 7(lifting 法):对多面体 利用对偶范数约束,可应用于任意维度。
- 形状矩阵(Proposition 8 & Example 3):通过离线构造包含初始状态空间 的增广集 ,可计算状态无关的 (避免了每次控制循环求解 SDP)。
- 边界比例 :在 上做一次凸优化(最大化 ,约束 ),无需显式几何表达。
2.6 整体实时映射
联合 Proposition 5/6/7(内部点)、Proposition 8(状态无关 )与 (8)( 求解),整套映射算法在实时控制循环中无需显式几何表达,保证可行性。
3. 实验设计
3.1 应用场景
- 8 自由度机器人乒乓球运动规划——真实硬件([1])击败职业选手,本文侧重于仿真比较。
- 控制层级:
- 高层:RL 策略(157 维状态,16 维输出——8 关节的位置+速度航点),频率 31.25 Hz(每 32 ms 决策一次);
- 底层:关节位置控制器 1 kHz;
- FAOC 在每步为每个关节解一个 OCP,规划 32 个 1 ms 控制点。
3.2 OCP 设定(针对每个关节)
- 视野 ,每段 ms,分段恒加加速度(jerk)三次积分得三次样条。
- 离散三积分器 :
- 状态约束为位置/速度/加速度/加加速度限制;终端约束为最大控制不变集 ;通过轻度缩小连续时间极限保证采样后不违反原始约束。
- QP 求解器:DAQP;MCIS 离线用 Qhull 计算。
3.3 对比方法
| 方法 | 类型 | 说明 |
|---|---|---|
| FAOC | 2D + 可达性 | 本文方法 |
| 2Dsoft | 2D 软约束 | 全范围位置-速度盒 + 终端软代价,需手工调节 |
| 1Dpos / 1Dvel / 1Dacc | 1D + 可达性 | [30] 方法,RL 仅控制单一变量 |
| 1D 系列基线(klimits) | 1D 可达性 | 维度受限 |
| 2Dsoft(Clarabel via qpsolvers) | 2D 软约束 | 动作空间含不可行点 |
3.4 训练设定
- 算法:SAC + BRONets(基线实验 5.2)与 SimBaV2 + 分类式分布 Critic + 大网络(5.3、5.4);
- 三项技能(UVFA 形式化):落点控制、上旋/下旋生成、扣杀;
- 每回合单回合仅终末稀疏奖励;训练击球来自合成 + 真实人类数据混合;
- 五个随机种子。
3.5 评价指标
- Fraction Balls Returned:回球率(越高越好);
- Generated Topspin / Velocity:上旋量、回球速度(越高越好);
- Generated Backspin / Goal Distance:下旋量、目标距离误差(越低越好);
- 每点基于 1000 个评估回合,回球率 < 50% 的种子被剔除。
4. 资源与算力
- 论文未明确给出所用 GPU 型号、数量及总训练时长;
- 仅说明网络规模:
- BRONets baseline:actor ≈ 2.57 M 参数,critic ≈ 6.38 M 参数;
- SimBaV2 改造:actor 增大 1.71×(至 ≈ 4.41 M),critic 增大 8.07×(至 ≈ 51.52 M);
- 训练曲线按环境步数给出(图 6):约 步;
- 仿真平台、机器人硬件参数、实时 QP 求解开销未详细报告;
- 开源:代码见 https://github.com/SonyResearch/feasible_action_for_optimal_control。
5. 实验数量与充分性
- 三组对比实验:
1. 基线实验(SAC + BRONets)——验证基础性能;
2. 算法与架构效应(SimBaV2 + 更大网络)——验证 FAOC 的优势与算法无关;
3. 低 RL 频率实验(7.8125 Hz,128 ms 段)——验证长视野下的轨迹段可控性。
- 每组实验比较 5 个控制器 × 5 个种子,并配以统计检验(Mann-Whitney U,标注显著性)。
- 评价指标覆盖回球率、上旋、下旋、回球速度、目标距离五个维度。
- 充足性:
- 优点:多算法、多频率、统计检验、控制变量清晰,论证较严谨;
- 不足:仅在乒乓球单一任务上仿真评估;硬件在环仅引用 [1] 而本文未独立报告真实机器人实验;未做完整消融(仅在 2Dsoft 与 1D 系列间作比较,并未消融 选取、面积匹配 vs 线性变换、内部点求解策略等);评价指标虽多但与真实比赛胜率等业务指标的关联未深入讨论。
6. 主要结论与发现
- FAOC 在所有三个实验中均显著优于基线:回球率、上旋、回球速度显著领先,下旋与目标距离与最强基线无显著差异,但没有基线在任何指标上显著优于 FAOC;
- 2D 可控性优于 1D 系列:维度更完整的 RL 输出带来更高最终性能与更低的种子方差;
- 可达性感知的动作空间优于无约束的动作空间:FAOC 显著优于 2Dsoft,原因是 2Dsoft 探索了大量不可行航点,损害样本效率;
- FAOC 对 RL 频率降低更鲁棒:7.8125 Hz 下 FAOC 性能几乎不变,其余控制器性能下降明显,FAOC 的"轨迹段可控性 + 严格可达性"优势更突出;
- 算法与架构升级(SimBaV2)对所有方法均有益,但 FAOC 的动作空间设计优势仍然存在。
7. 优点
- 理论完整:Lemma 1、Proposition 1–8 给出紧、实心、凸的可行性条件、严格可逆映射、面积匹配与线性变换的抗畸变证明、隐式目标集的实时计算;
- 可计算性强:多面体情形下边界缩放因子由 ratio test 直接解析;内部点用 Chebyshev 中心;状态无关变换矩阵可离线计算,避免在线 SDP;
- 无需专家调参:动作空间(标准超立方体)固定,与 OCP 可行域自适应耦合,免去现有方法中的 等超参;
- 真实任务验证:与 [1] 的真实机器人比赛工作互为补充,证明了从仿真到硬件的可行性;
- 开源:算法与 OCP 实现均已公开;
- 公平、可重复:5 个种子 × 统计检验 × 多算法对比,结论较稳健。
8. 不足与局限
- 任务单一:仅在机器人乒乓球一个场景下评估;缺乏跨任务(如自动驾驶、四足/无人机、Manipulation 等)迁移性证据;
- 硬件结果缺失:本文未独立报告真实机器人实验数据,仅引用 [1],对 FAOC 在感知噪声、模型误差、通信延迟等非理想因素下的鲁棒性未作充分评估;
- 算力与训练成本不透明:未披露 GPU 型号/数量/训练时长,难以复现成本估算;
- 凸性假设限制:映射算法严格依赖目标集 为凸;论文虽在乒乓球中展示了"非凸任务 → 凸参数集"的工作流,但未给出非凸可行域的通用处理方法;
- 实验覆盖偏窄:未消融 (面积匹配 vs 线性变换)、内部点求解(顶点法 vs lifting)、状态无关 vs 状态相关变换矩阵的影响;
- 依赖离线 MCIS 几何计算:当 退化或维度更高时,离线几何预处理是否仍可扩展未深入讨论;
- 安全约束语义模糊:FAOC 强制可达性(feasibility),但对运行过程中的瞬时安全性(如碰撞避免)仍需额外机制保证,论文未明确刻画;
- 业务指标关联薄弱:仿真指标与"打赢职业选手"的真实业务效果之间的因果链不够直接。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。