
📝 TLDR
当前LLM后训练通常针对单一固定推理流程,与部署时多样化的推理时控制器(如CoT、自我一致性、辩论、规划、验证)存在失配,限制迁移到新工作流。论文提出CALM框架,将控制器显式纳入训练循环,通过多任务强化学习学习控制器诱导的交互协议。在turn-level GRPO目标下对控制器组合与可复用推理模块进行模块化分解,实现控制器与模块感知训练。实验表明控制器感知后训练在未见控制器组合及更广控制器迁移上优于单控制器优化。
🧭 速览
后训练方法通常只优化单一固定交互模式,与实际部署中多样化的推理时控制器形成训练-部署失配,限制向新工作流的迁移。
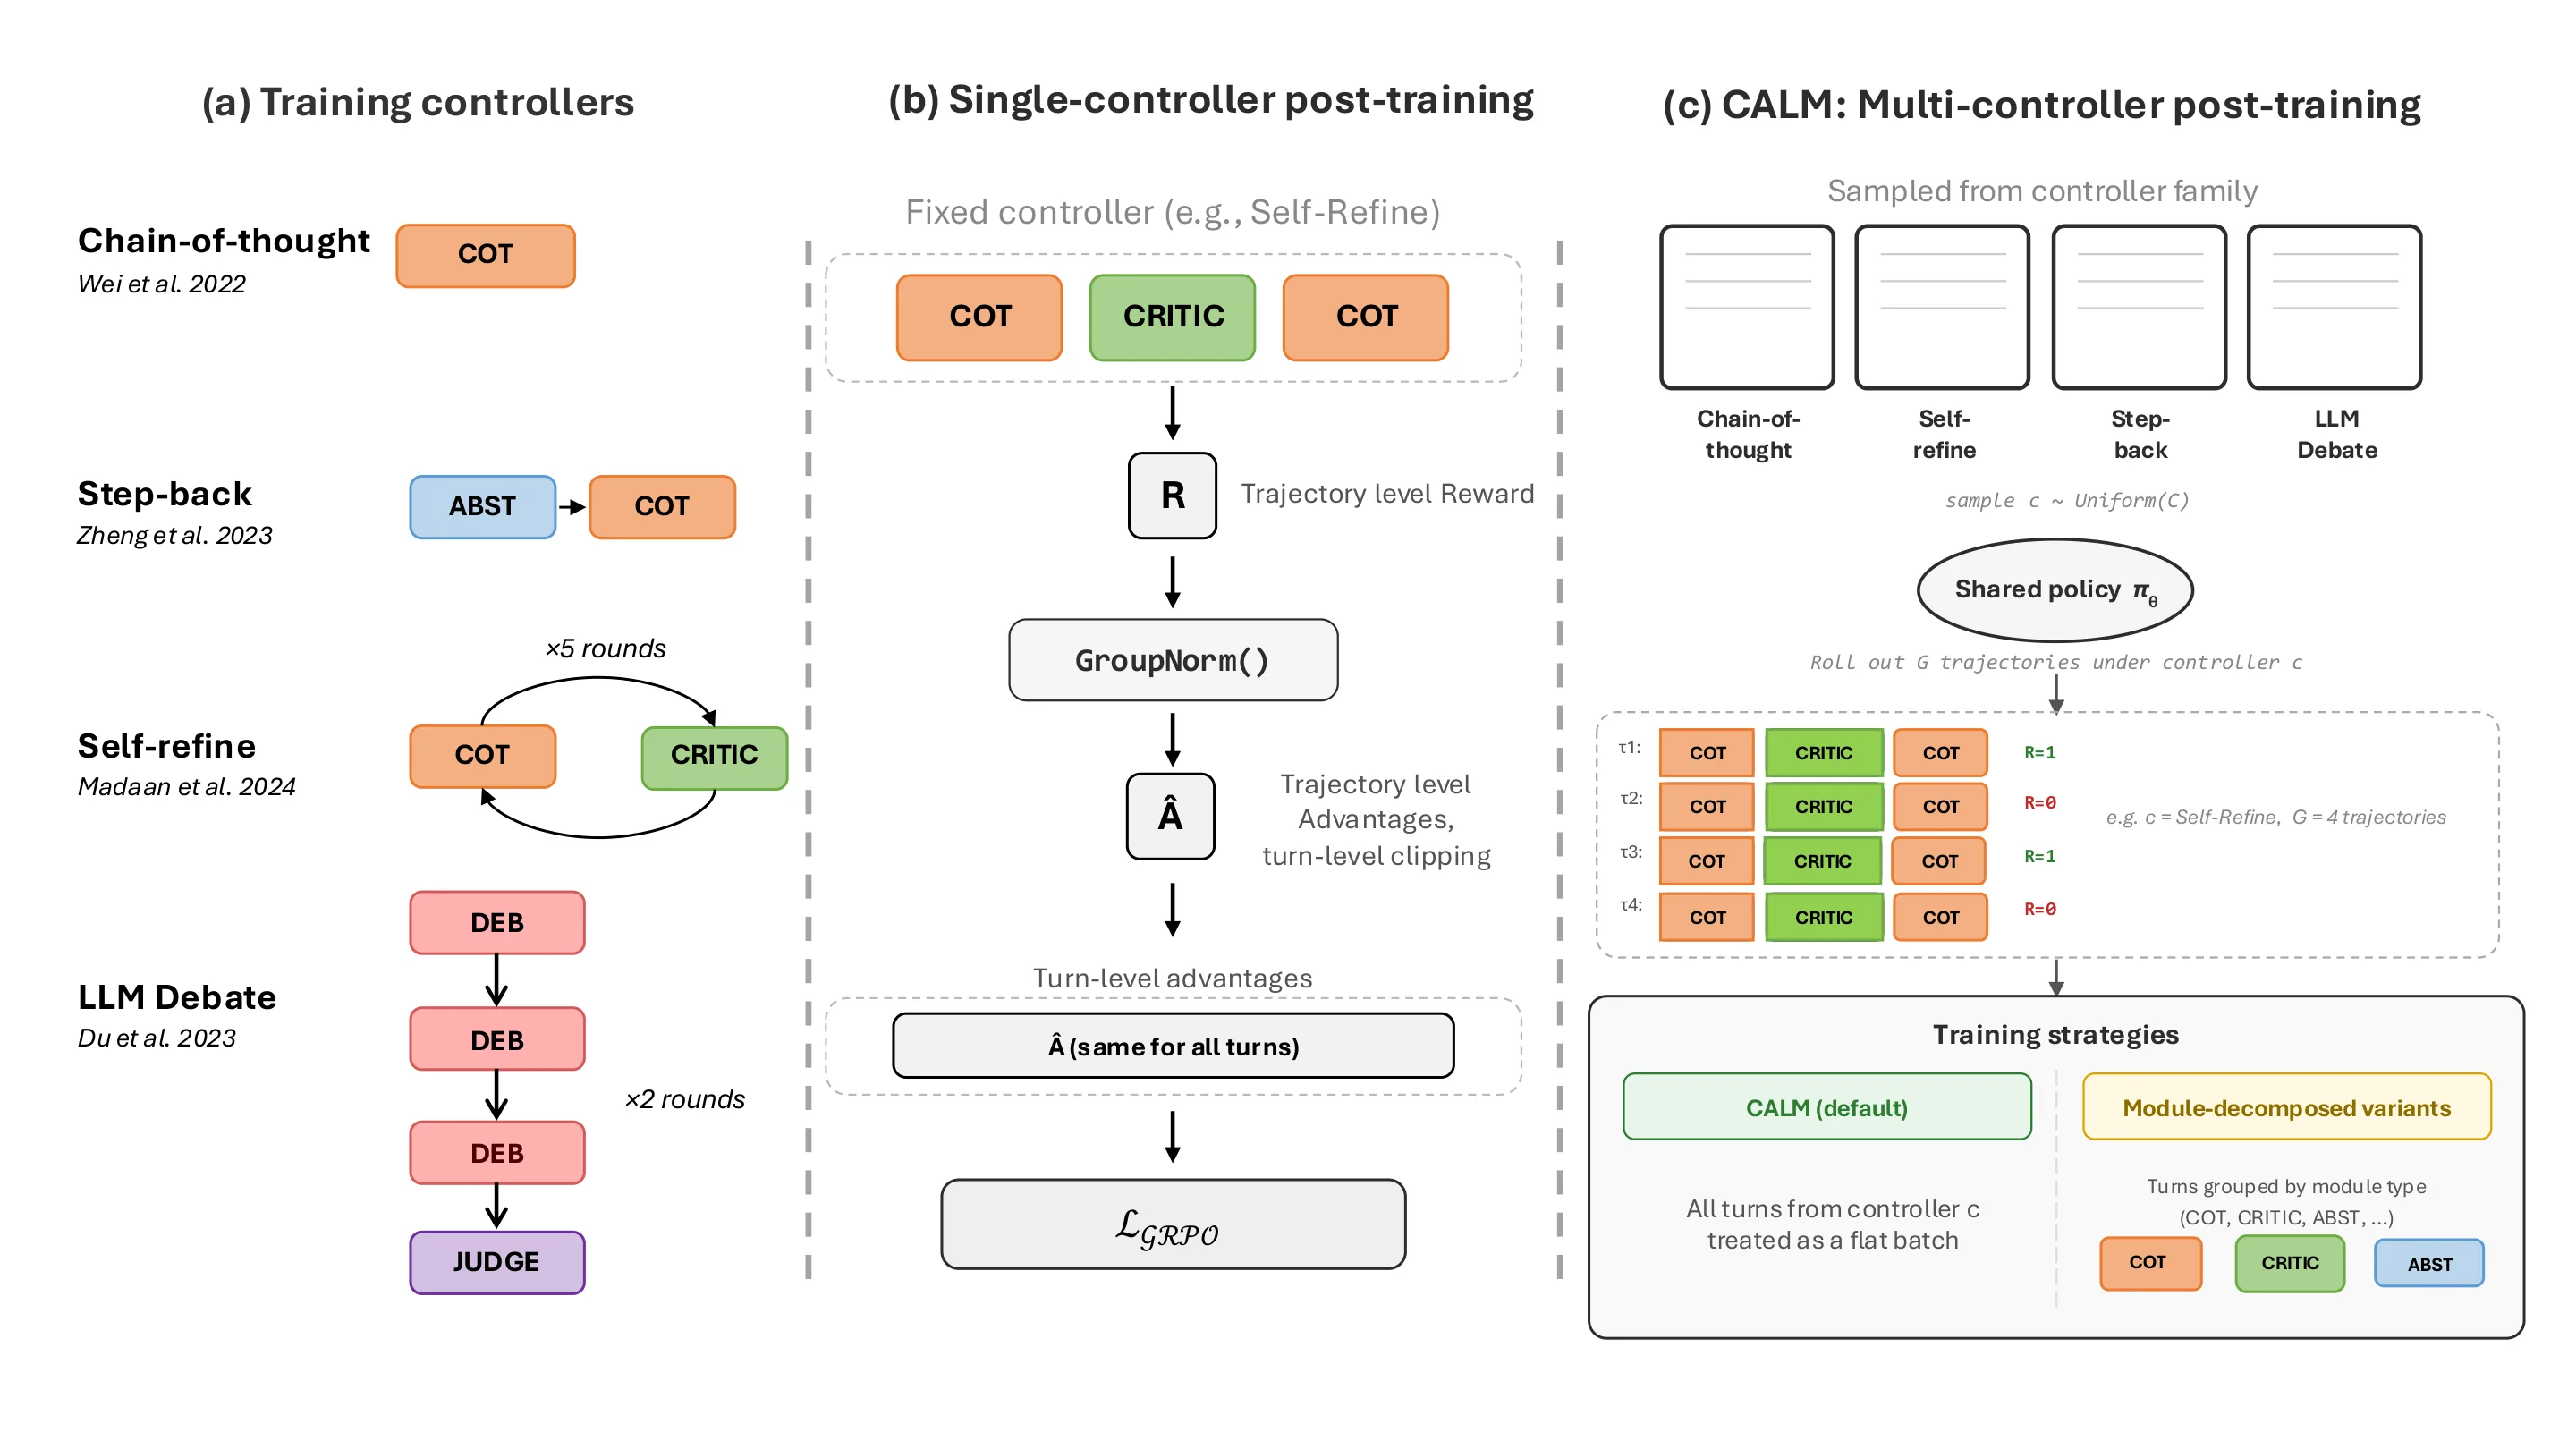
提出CALM控制器感知后训练框架,把控制器建模为多任务RL中的交互协议,并在turn-level GRPO目标下对控制器组合与可复用本地推理模块做模块化分解。
在未见过的控制器组合以及更广泛的控制器迁移场景下,控制器感知后训练均稳定优于单控制器优化,对推理时工作流表现出更好泛化。
将控制器显式纳入训练循环并配合模块化分解,可系统性提升LLM与多种推理时控制器协作的迁移能力。
🆚 方法对比
CALM(Controller-Aware Language Models)
- 在训练循环中显式纳入控制器分布
- 将控制器后训练建模为多任务RL问题
- 在未见过的控制器组合上提升泛化能力
- 支持模块级分解的训练策略空间
- 训练计算开销因多控制器采样增大
- 依赖可执行控制器代码库的实现成本
- 在单一控制器场景下未必优于专用训练
- GRPO多轮信用分配仍非最优
单控制器后训练(Single-controller post-training)
- 训练目标简单、轨迹级奖励信号清晰
- 对固定控制器如Self-Refine效果好
- 实现复杂度低,易于部署
- 易过拟合单一交互模式
- 迁移到新控制器组合时泛化差
- 存在训练-部署不一致问题
- 无法利用共享模块的协同信号
模块分解训练变体(Module-decomposed variants)
- 按模块类型分组,捕捉局部推理能力
- 促进共享模块在不同控制器间的迁移
- 提供更细粒度的训练策略空间
- 丢失了控制器级序列结构信息
- 模块分组策略设计需额外调参
- 奖励信号在模块间分配更稀疏
GRPO多轮变体(Multi-turn GRPO)
- 适配多轮对话型控制器轨迹训练
- 组内归一化优势估计稳定
- 兼容现有RLHF流程
- 轮级优势的信用分配仍粗糙
- 对长轨迹的方差控制有限
- 依赖轨迹级最终奖励
Chain-of-Thought(CoT)
- 引导模型逐步推理提升复杂任务表现
- 作为可复用模块广泛适用于多种控制器
- 实现简单无需额外训练
- 推理链长度增加带来延迟成本
- 在缺少验证环节时易产生幻觉累积
Self-Refine(Madaan et al., 2023)
- 通过自我批评迭代提升输出质量
- 无需额外监督信号即可精炼回答
- 结构清晰易于嵌入控制器组合
- 多轮迭代显著增加推理成本
- 自我评价可靠性受限
- 作为单一训练目标易过拟合
LLM Debate(Du et al., 2023)
- 多角色辩论提升推理多样性与鲁棒性
- 通过对抗性讨论暴露推理缺陷
- 可组合JUDGE模块实现聚合
- 多轮对话导致推理开销倍增
- 辩论角色可能产生风格化偏差
ADAS代码即控制器范式(Hu et al., 2025)
- 控制器以可执行Python程序形式透明可复现
- 支持自动搜索与扩展新组合
- 模块化结构天然支持CALM复用
- 依赖代码执行环境与工程基础设施
- 控制器程序设计需领域专业知识
CALM通过多任务RL在控制器分布上训练,在未见控制器组合上优于单控制器训练基线;模块分解变体进一步利用共享模块提升迁移能力,但以增加训练开销和调参复杂度为代价。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
这篇论文针对大语言模型后训练与实际部署之间的失配问题,提出了 CALM 框架——一种将推理时控制器显式纳入训练循环的后训练方法。通过多任务强化学习框架,CALM 能够让语言模型学习与不同控制器(如思维链、自洽性、辩论、规划、验证等)协作的交互协议,在未见过的控制器组合和更广泛的控制器迁移场景中,显著超越了针对单一控制器优化的传统后训练方法。
研究背景与动机
现代大语言模型的能力不仅取决于基础模型本身的参数规模与预训练质量,还越来越依赖于部署时使用的推理时控制器(inference-time controller)。这些控制器负责组织和调度推理过程,决定模型如何生成中间步骤、如何选择候选答案、如何进行自我验证。思维链提示让模型显式输出推理步骤,自洽性通过采样多个答案并投票得出最终结论,辩论系统让多个模型实例相互反驳,规划控制器将复杂任务分解为子目标序列,验证流程则要求模型检验中间结果的正确性。这些推理策略的组合构成了丰富多样的推理时工作流,是当前提升 LLM 实用性能的重要手段。
然而,现有主流的后训练方法——无论是 [[监督微调]] 还是 [[强化学习]] 阶段的优化——通常假设一个固定的、预定义的交互模式。训练时采用什么格式、什么流程,部署时往往也就固定使用什么。这种做法忽视了推理时控制器多样性的现实,也限制了模型迁移到新工作流的能力。一个针对纯思维链格式微调的模型,可能在面对需要自洽性投票或验证的部署场景时表现平庸;反之,针对特定控制器组合训练的模型,一旦部署环境切换到不同的控制器架构,就可能需要重新训练或大量适配。这种训练与部署之间的失配,本质上反映了当前后训练范式缺乏对推理时计算结构的显式建模能力。
CALM 的核心切入点正在于此:不再将控制器视为部署阶段的外部附加物,而是将其纳入训练循环本身,使语言模型能够学习与多种控制器协作的通用能力。这样做的好处是双重的——模型既能在训练见过的控制器上表现更好,又能在未见过的控制器组合上展现出更强的泛化能力。
方法
CALM 的设计围绕一个关键洞察:推理时控制器可以被理解为可复用局部推理模块(reusable local reasoning modules)的组合。以思维链为例,一个完整的思维链推理过程可以分解为「生成下一步推理」「评估当前推理的合理性」「决定是否继续」等局部能力;自洽性则可以分解为「独立生成候选答案」「评估候选答案的置信度」等模块。不同控制器的差异,本质上体现为这些基础模块的不同组合方式和调度策略。
基于这一洞察,CALM 将控制器感知后训练形式化为 [[多任务强化学习]] 问题。在该框架下,每个控制器对应一个任务,控制器诱导的交互协议定义了强化学习的奖励信号和动作空间。具体而言,论文采用 [[GRPO]](Group Relative Policy Optimization)作为基础优化算法,这是一种策略梯度方法的变体,通过相对优势估计来平衡探索与利用。CALM 的创新之处在于将标准 GRPO 扩展到回合级别(turn-level),使得多控制器混合训练能够自然地诱导出模块级的分解结构。
这一模块级分解具有重要的实际意义。传统做法下,混合不同控制器进行训练时,模型往往只能学到控制器级别的粗粒度策略,即「在这种控制器下应该如何响应」。而 CALM 由于显式建模了模块结构,模型能够学到更细粒度的能力——比如「当需要生成候选推理步骤时应该如何组织语言」「当需要评估候选答案时应该关注哪些维度」。这种模块化分解使得训练信号能够更精准地作用于相应的能力维度,从而提升学习效率和泛化能力。
论文还系统研究了控制器感知训练的两种策略维度:控制器级感知(controller-level awareness)和模块级感知(module-level awareness)。前者关注模型对整体交互协议的理解,后者关注模型对局部推理能力的掌握。两者的结合使得 CALM 能够在不同粒度上建立对推理过程的认知,这是单一控制器优化方案所无法实现的。
实验与结果
论文的实验设计聚焦于验证 CALM 在两个关键场景下的有效性:一是未见过的控制器组合,二是更广泛的控制器迁移。
在未见控制器组合实验中,研究者首先在若干基础控制器及其常见组合上进行训练,然后在完全新颖的控制器组合上进行评估。这种设定直接考验模型的组合泛化能力——这正是训练-部署失配问题最核心的挑战。实验结果显示,经过 CALM 训练的模型在未见组合上的表现显著优于基线方法,说明控制器感知训练确实帮助模型学到了可迁移的推理能力,而非仅仅记住了训练时的特定交互模式。
在更广泛的控制器迁移实验中,训练阶段使用的控制器类型与评估阶段使用的控制器类型存在较大差异。例如,训练时主要使用思维链和自洽性相关的控制器配置,评估时却切换到包含辩论或验证组件的完全不同的工作流。这种设定模拟了实际部署中常见的场景——模型需要在不重新训练的情况下适应新的推理策略。结果表明,CALM 训练出的模型在这种跨控制器迁移任务中展现出明显优势,说明其学到的能力具有更强的通用性和适应性。
消融实验进一步揭示了模块级分解的贡献。当移除模块级感知训练策略,仅保留控制器级感知时,模型的组合泛化能力出现明显下降。这验证了论文的核心假设——细粒度的模块化建模对于控制器感知训练至关重要。
讨论与可借鉴点
CALM 框架的核心贡献在于揭示并初步解决了 LLM 后训练中一个此前未被充分关注的问题:训练范式与推理时计算结构之间的失配。通过将控制器显式纳入训练循环,CALM 为构建真正适配多样化推理工作流的语言模型提供了可行的技术路径。
该工作的一个重要借鉴点在于模块化建模的思路。将复杂的推理控制器分解为可复用的局部模块,不仅使得多任务强化学习的训练信号更加精细,也为后续研究提供了可扩展的设计空间——新的控制器可以被理解为现有模块的新组合,模型只需要在模块层面进行增量适应,而不必从头学习整个交互协议。
当前工作也存在若干局限。模块的划分边界本身依赖于设计者的先验知识,不同的模块划分方式可能产生不同的训练效果。此外,论文的实验主要集中在相对标准的控制器类型上,对于更复杂的、跨多轮的协作式推理场景,CALM 的效果尚待验证。控制器数量和模块数量的scalability也是值得探索的方向——当控制器类型急剧增加时,如何保证训练效率和泛化能力不下降。
从更宏观的视角看,CALM 指向了一个值得关注的研究方向:推理时计算不应仅被视为部署阶段的工程选择,而应成为训练阶段的一等公民。这种 [[训练-推理一致性]] 的追求,与当前其他提升 LLM 推理能力的方向——如测试时缩放、推理时搜索、过程奖励模型等——形成了有意义的互补。未来的研究或许能够在这一方向上继续深化,探索控制器与语言模型共同演化、相互适应的训练范式。
摘要
大型语言模型(LLM)的性能日益依赖于基础模型,同时也依赖于用于组织推理的推理时控制器。然而,现有的后训练方法通常针对单一固定的交互模式进行优化,尽管实际部署依赖于多种控制器,例如思维链、自洽性、辩论、规划以及验证流程。这造成了训练与部署之间的不匹配,并限制了对新工作流的迁移能力。我们提出 CALM(Controller-Aware Language Models,控制器感知语言模型),一种将控制器显式纳入训练循环的后训练框架。我们将控制器感知后训练形式化为针对控制器所引发的交互协议的多任务强化学习,其中控制器是可复用的局部推理模块的组合。该结构还在回合级 GRPO 目标下诱导出混合控制器训练的模块级分解,从而能够对控制器级和模块级感知训练策略进行系统研究。我们在未见过的控制器组合以及更广泛的控制器迁移上对 CALM 进行了评估,结果表明控制器感知后训练能够提升跨推理时工作流的泛化能力,超越单一控制器优化的效果。
Abstract
Large language model (LLM) performance increasingly depends not only on the base model, but also on the inference-time controller used to organize reasoning. Existing post-training methods, however, typically optimize for a single fixed interaction pattern, despite real deployments relying on diverse controllers such as Chain-of-Thought, self-consistency, debate, planning, and verification pipelines. This creates a training--deployment mismatch and limits transfer to new workflows. We introduce CALM (Controller-Aware Language Models), a post-training framework that explicitly places controllers in the training loop. We formulate controller-aware post-training as multi-task reinforcement learning over controller-induced interaction protocols, where controllers are compositions of reusable local reasoning modules. This structure also induces a module-level decomposition of mixed-controller training under a turn-level GRPO objective, enabling a systematic study of controller and module-aware training strategies. We evaluate CALM on held-out controller compositions and broader controller shifts, showing that controller-aware post-training improves generalization across inference-time workflows beyond single-controller optimization.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。