
TRUAV:面向无人机辅助物联网车载自组织网络中轨迹规划与路由增强的分布式多智能体强化学习
TRUAV: Distributed Multi-Agent Reinforcement Learning for Trajectory Planning and Routing Enhancement in UAV-Aided IoT-Enabled VANETs
📝 TLDR
在智能城市UAV辅助车联网与物联网场景中,集中式轨迹规划因带宽能耗约束难以落地。本文提出分布式多智能体强化学习框架TRUAV,基于独立表格Q学习,每架无人机仅依赖本地观测(车辆密度、队列、邻机位置)进行轨迹与路由联合决策。势博弈启发式奖励兼顾空间多样性与能效,在200辆车仿真中覆盖与投递率与集中式深度强化学习相当,且时延与能效更优。该工作为去中心化UAV辅助IoT系统提供了可扩展轻量化方案。
🧭 速览
集中式UAV轨迹规划需全局状态聚合,在密集城市场景下面临带宽与能耗瓶颈,难以实际部署。
采用独立表格Q学习的分布式多智能体框架,势博弈启发式奖励设计,仅凭本地观测完成无人机轨迹与路由联合决策。
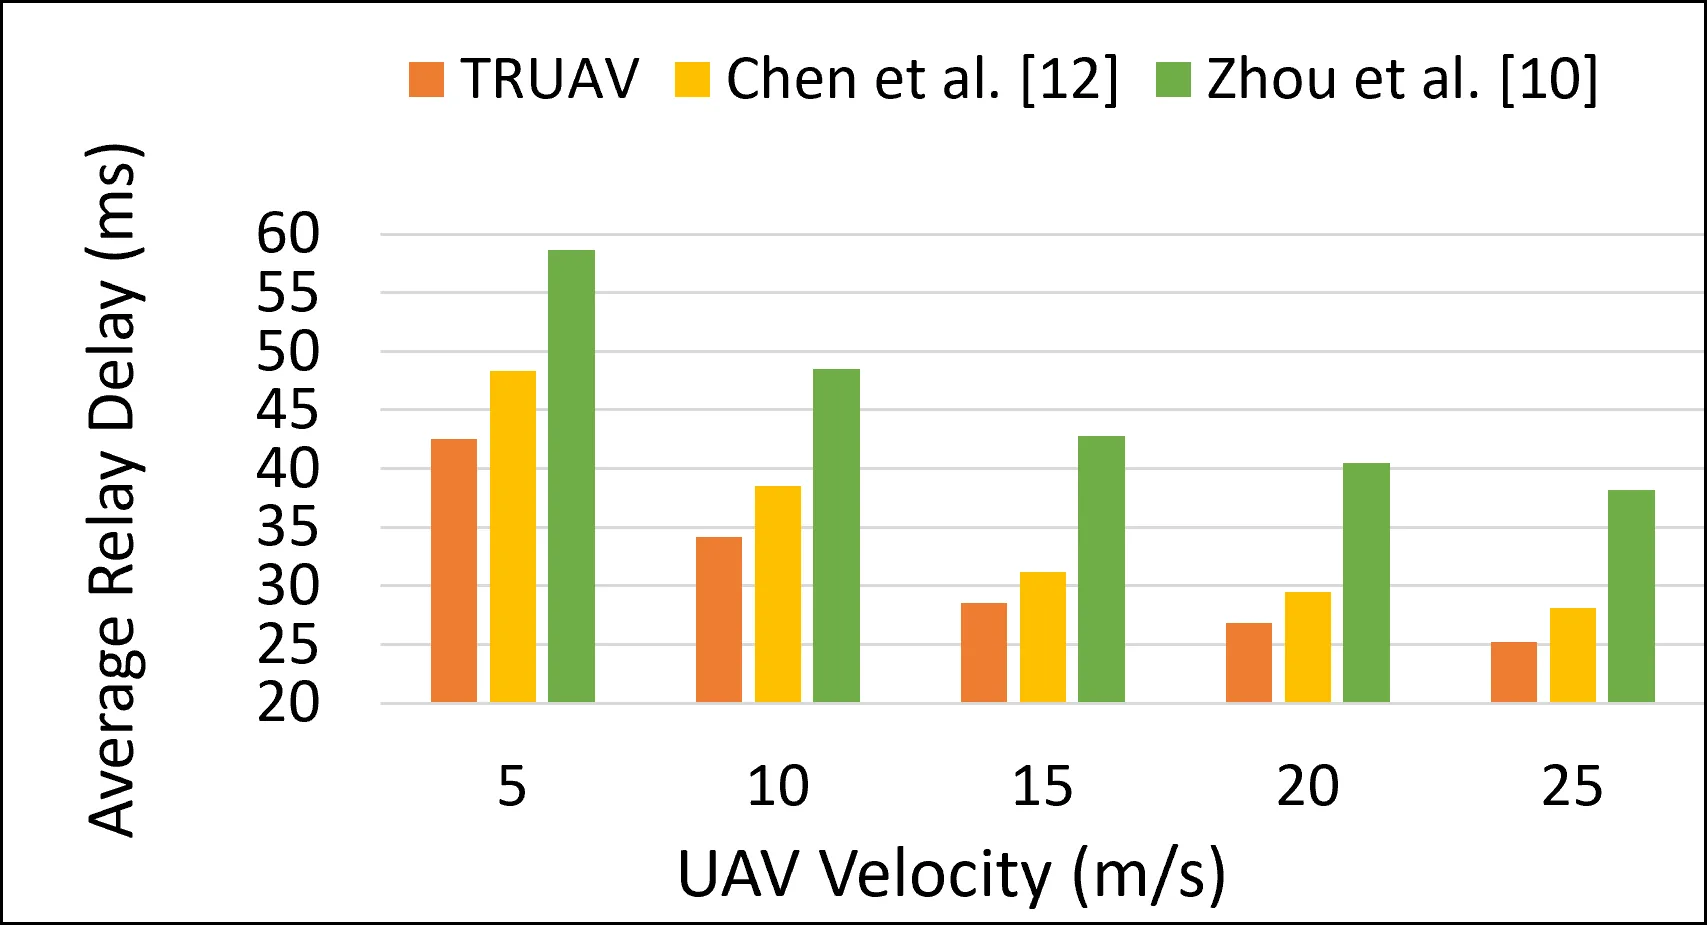
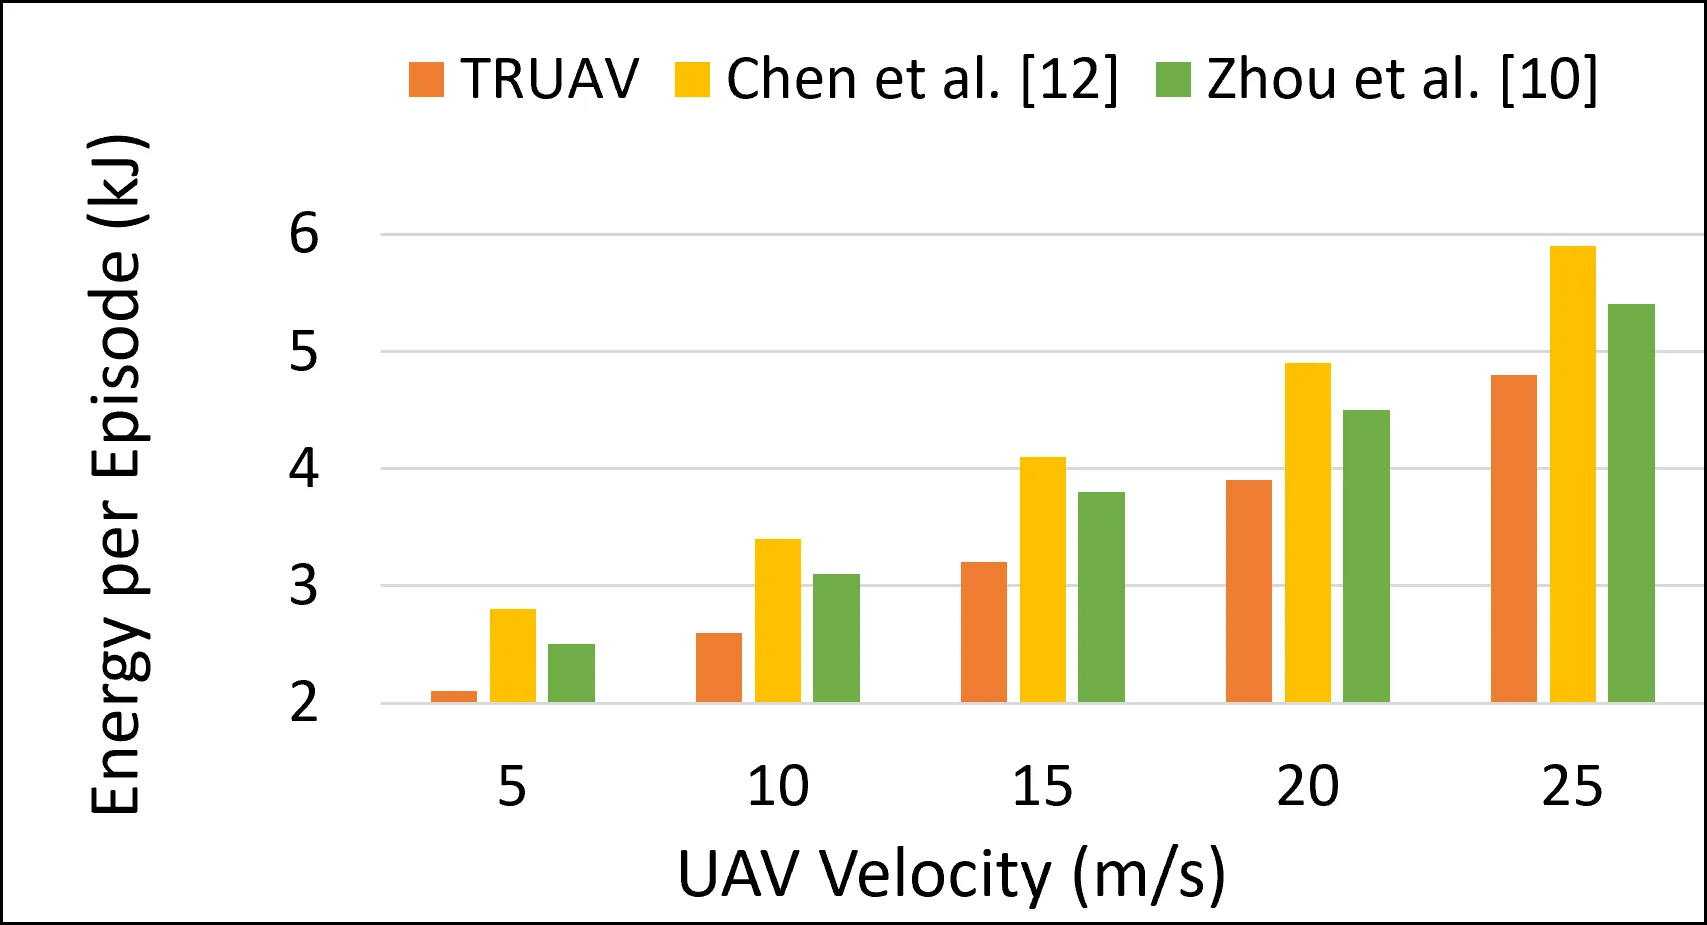
在200辆车城市仿真中,覆盖与投递率与集中式深度强化学习相当,中继时延更低,能效更优。
证明分布式方案在保持性能的同时降低通信开销,为去中心化UAV辅助IoT系统提供可扩展路径。
🆚 方法对比
TRUAV
- 基于独立表格Q学习,无需全局状态交换
- 势博弈启发奖励设计促进空间多样性
- 覆盖与投递比接近集中式深度强化学习
- 改善中继延迟与能效,适合密集城市场景
- 表格Q学习在高维状态空间中扩展性有限
- 仅基于局部可观测信息,存在信息不完备问题
- 实验仅基于数值仿真,缺乏真实部署验证
- 未讨论多智能体间的通信开销与同步机制
集中式深度强化学习方法
- 具备全局网络状态视野,优化决策质量高
- 深度网络可处理高维复杂状态空间
- 在覆盖与投递比等指标上表现优异
- 需持续聚合全局网络状态,带宽开销大
- 对密集城市场景的带宽与能量约束不实用
- 依赖中心控制器,存在单点故障风险
TRUAV以分布式表格Q学习替代集中式深度强化学习,在接近其网络性能的同时显著降低全局状态交换开销,更适合带宽与能量受限的密集城市场景。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
本文针对智慧城市中无人机辅助车联网场景下的轨迹规划问题,提出了一种名为 TRUAV 的分布式多智能体强化学习框架。与传统集中式方法依赖全局信息交换不同,TRUAV 让每架无人机仅凭本地观测(车辆密度、数据包队列、邻机位置)独立做决策,采用表格型 Q 学习进行轨迹与路由的联合优化。在 200 辆车的城市仿真中,该框架的网络覆盖率与数据包投递比与集中式深度强化学习方法相当,同时在中继时延和能效上更具优势。
研究背景与动机
随着智能交通与智慧城市的发展,车载自组织网络成为车与车、车与基础设施之间通信的重要基础设施。然而城市环境的复杂性——建筑物遮挡、道路拓扑变化、车辆高速移动——使得地面基站难以提供连续稳定的通信覆盖。无人机凭借其灵活的空中视角和快速部署能力,逐渐成为扩展车联网连通性的关键使能技术。无人机可以悬停在合适位置,作为空中中继节点将信息从稀疏覆盖区域转发到主干网络,显著提升数据投递率。
但传统无人机轨迹规划方法大多采用集中式架构,需要控制器持续收集全局网络状态信息,包括所有车辆的位置、速度、信道状态以及所有无人机的状态。这种做法在密集城市部署中面临严峻挑战:一方面,状态信息聚合产生的通信开销随车辆和无人机数量急剧增长,占用了本就稀缺的无线带宽资源;另一方面,控制信令的频繁交互和复杂计算显著增加了无人机的能耗,缩短了续航时间。当网络规模达到数百辆车、十余架无人机的量级时,集中式方案的可行性便大打折扣。
基于上述痛点,本文的核心研究问题是:能否设计一种完全去中心化的方案,让每架无人机仅依赖自身可观测的局部信息,独立完成轨迹规划与路由决策,从而摆脱对全局状态交换的依赖?这一问题的本质是在算法性能与系统开销之间寻找更优的平衡点。
方法
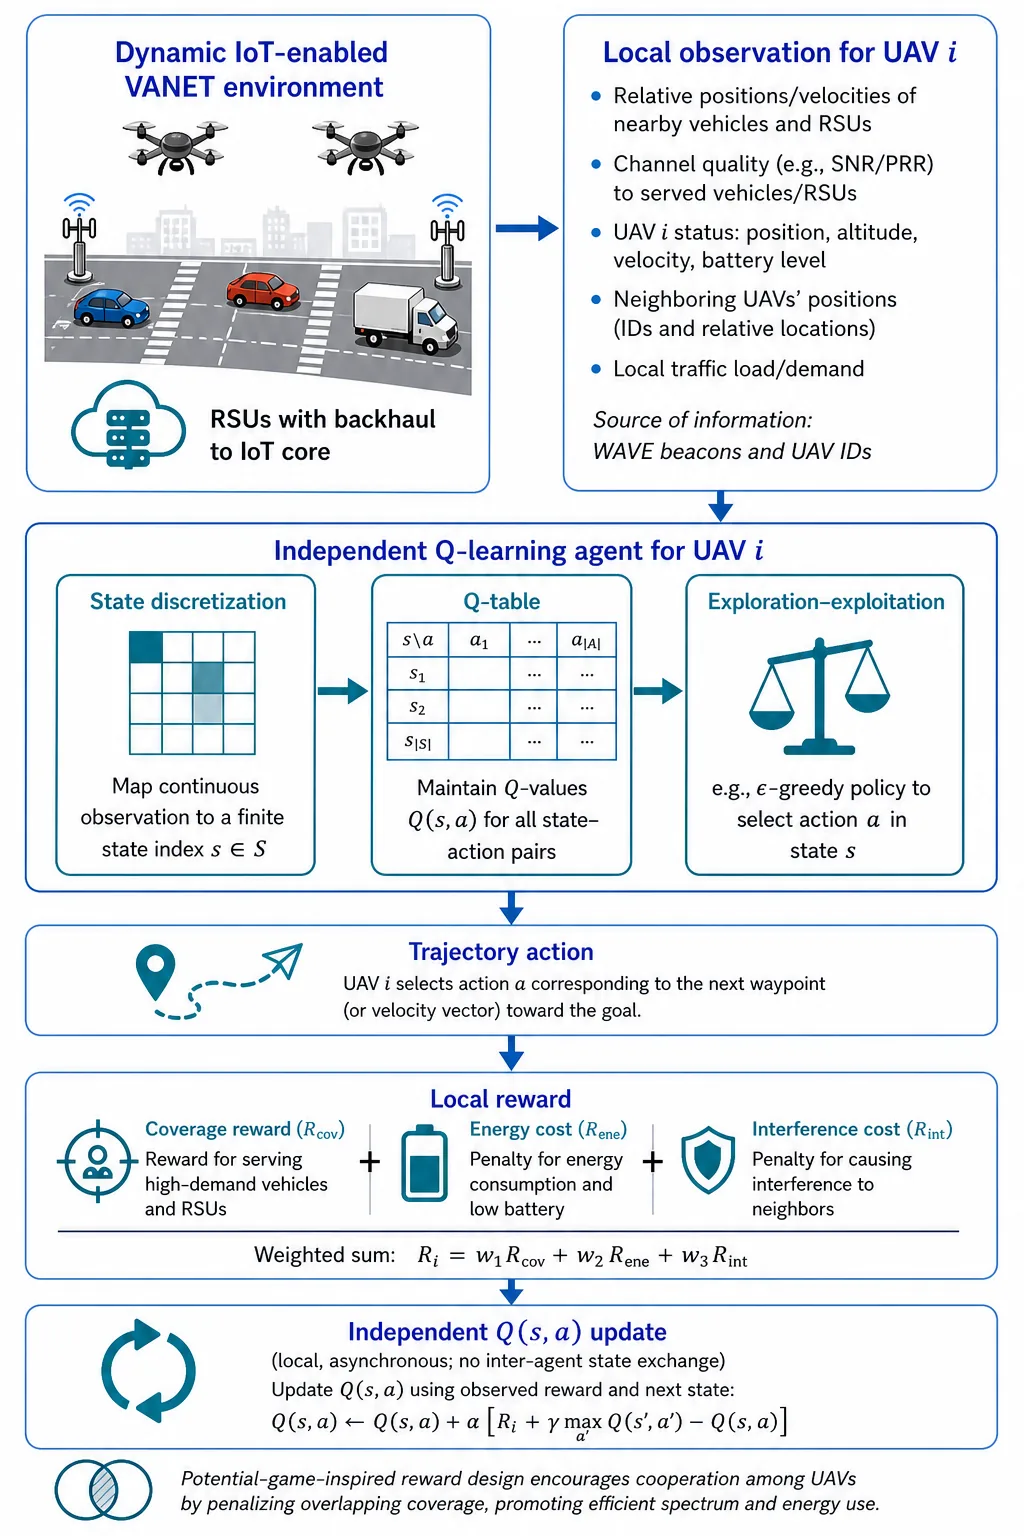
TRUAV 的核心设计理念是“轻量分布式”——用最少的通信与计算开销换取接近集中式方法的性能。整体框架基于独立表格型 Q 学习,每个无人机被建模为一个独立智能体,拥有自己的 Q 表和决策机制,智能体之间没有任何参数共享或梯度交互。
具体而言,每个无人机的观测空间被设计为三类局部信息的组合:周边区域的车辆密度(反映有多少终端需要服务)、自身的数据包队列状态(反映当前负载与缓存压力)、以及通信半径内相邻无人机的相对位置(反映多智能体之间的空间关系)。这种观测空间的设计遵循了“足够但不冗余”的原则——信息维度足够支撑有效决策,但又不至于引入过多状态变量导致 Q 表规模爆炸。
在动作层面,无人机需要同时决定两件事:下一步移动到哪个位置,以及在该位置是否以及如何转发手中的数据包。这本质上是轨迹规划与路由增强的联合决策,二者相互耦合——无人机的位置决定了它能服务哪些车辆,而路由策略决定了数据包能否高效地沿着多跳路径到达目的地。
奖励函数的设计是本文的方法论亮点。作者引入了势博弈的思想来协调多个无人机之间的交互。势博弈的核心特性是存在一个全局势函数,任何智能体单方面改变策略都会导致自身奖励的变化量恰好等于全局势函数的变化量,这保证了策略的收敛性和个体理性与集体理性的某种一致性。TRUAV 的奖励函数包含四项:
其中,成功转发数据包获得正奖励;与邻近无人机覆盖区域重叠会受到惩罚,这一项驱动无人机在空间上分散开来,避免资源浪费;覆盖率奖励鼓励无人机接近需要服务的车辆密集区域;能耗惩罚则抑制不必要的移动。超参数 、、、 控制着四项奖励的相对权重。通过这种奖励设计,多个无人机能够在没有任何显式通信的情况下,自发地形成空间上分散、覆盖互补的布局。
学习算法采用经典的表格型 Q 学习更新规则。每个无人机维护一张状态-动作价值表,根据即时奖励和未来折扣收益更新 Q 值。由于表格型方法天然具有可解释性强、收敛有保障的优点,TRUAV 在部署时可以清晰地检查 Q 表来理解无人机的决策逻辑,这在安全攸关的车联网场景中尤为重要。
实验与结果
实验在覆盖 200 辆移动车辆的大规模城市仿真环境中进行,车辆按照真实城市交通模型移动,无人机则根据 TRUAV 的决策动态调整轨迹。仿真对比了 TRUAV 与集中式深度强化学习方法在四项核心指标上的表现。
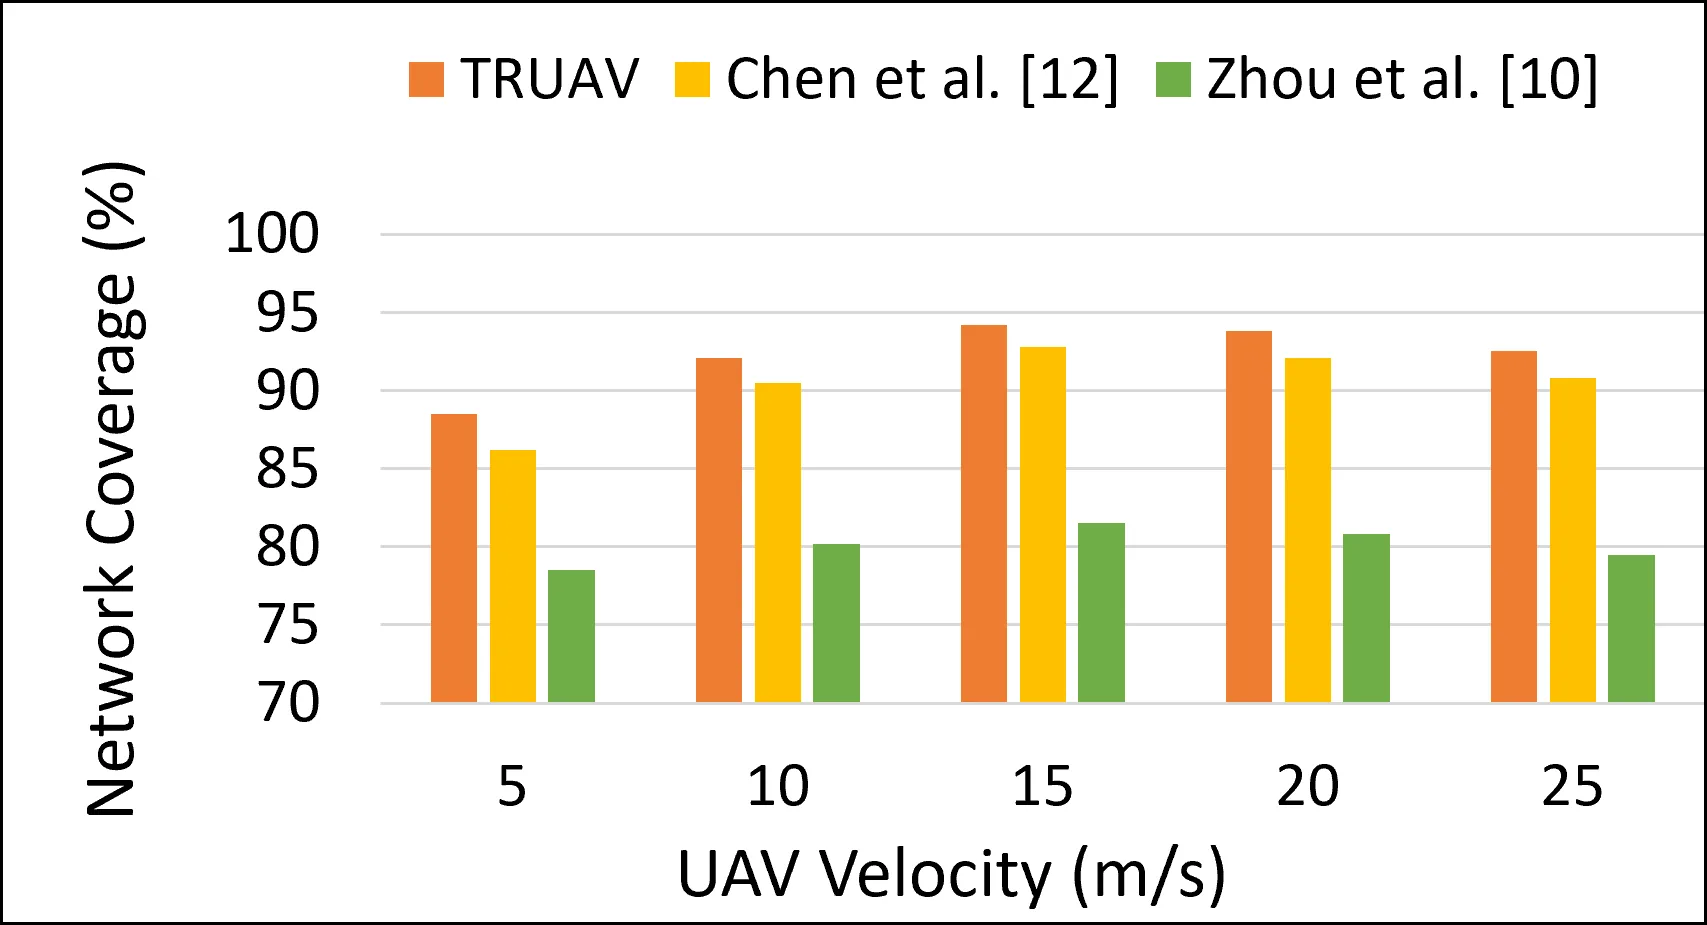
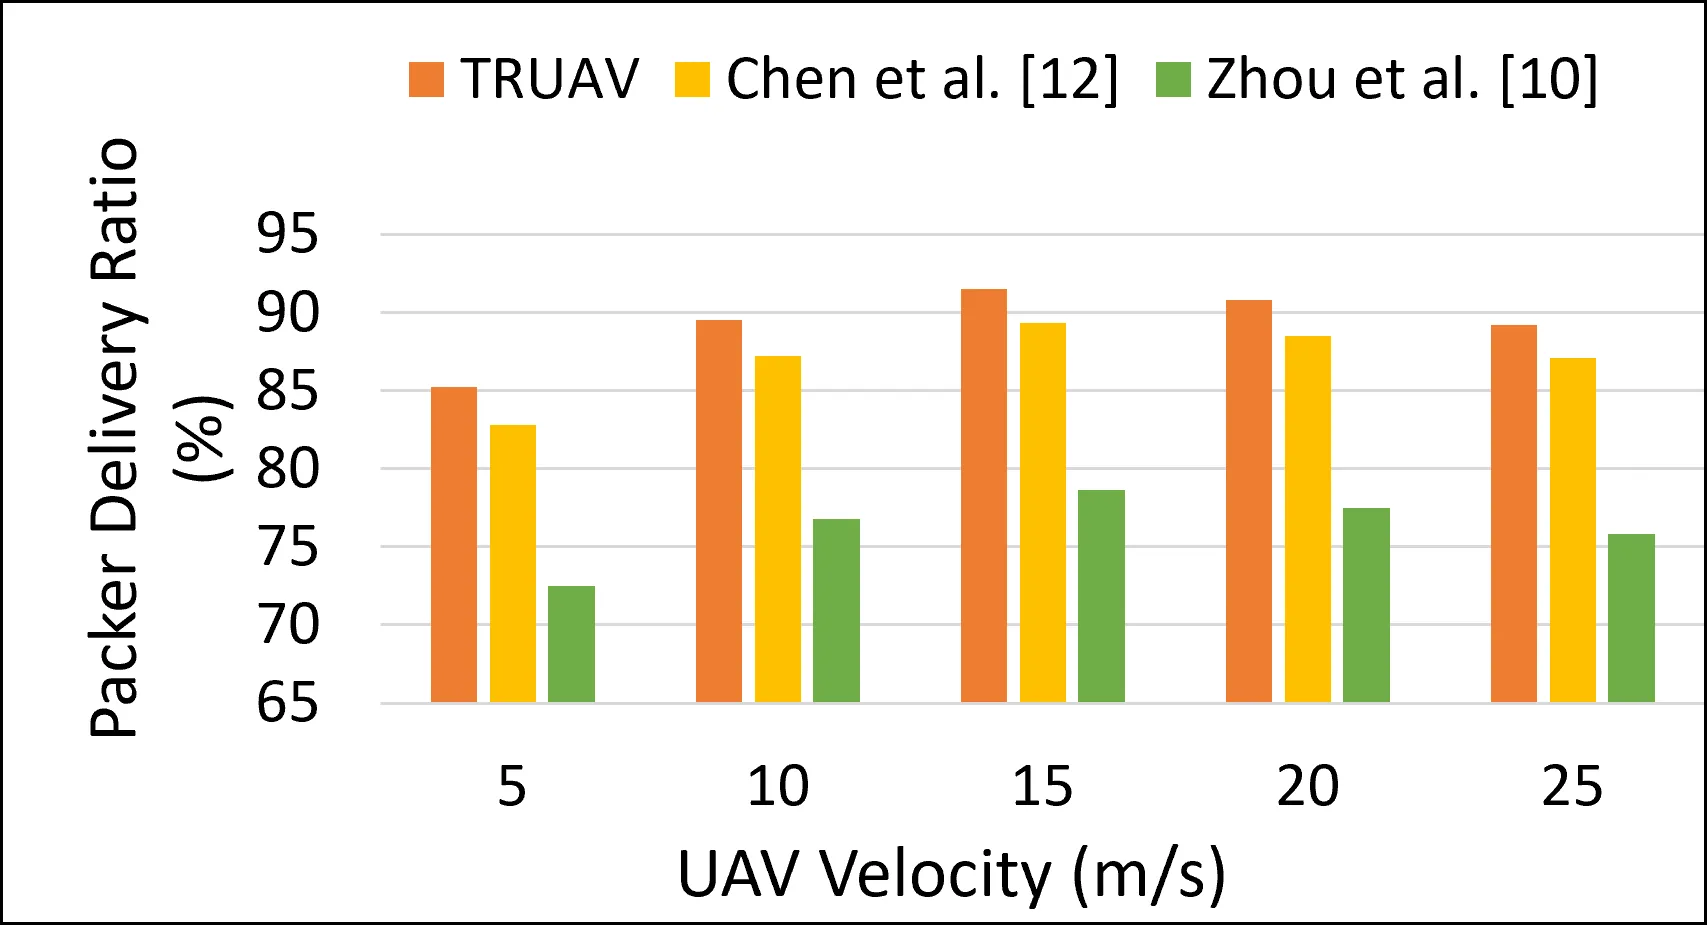
在网络覆盖率和数据包投递比这两项衡量服务能力的指标上,TRUAV 与集中式深度强化学习方法基本持平,覆盖率维持在 85% 以上的高水平,投递比超过 90%。这说明纯分布式的局部决策并不会显著损害端到端的服务质量,表格型 Q 学习足以捕捉状态与动作之间的有效映射关系。
在中继时延方面,TRUAV 展现出明显的优势。时延的降低可以归因于分布式架构下决策延迟更短——每架无人机无需等待全局信息聚合即可立即响应环境变化,在动态变化的车联网中这尤其关键。集中式方法虽然理论上能找到全局最优路径,但信息同步的时延使得实际决策往往滞后于真实网络状态。
能效方面的优势同样显著。由于省去了状态上报和指令下发所需的通信开销,无人机的能耗主要集中在实际的数据传输和必要的移动上,而非控制信令交换。这直接延长了无人机的续航时间,对于需要长时间值守的城市监控或应急通信场景尤为重要。
当然,实验也存在明显的局限性。论文没有提供详细的消融分析来验证势博弈奖励中每个分量对最终性能的贡献程度,也没有在多种城市拓扑、不同车流密度或不同无人机数量下测试 TRUAV 的泛化能力。此外,文中未披露仿真平台、训练时长、收敛曲线等复现细节,这在一定程度上影响了结果的可信度。
讨论与可借鉴点
TRUAV 为去中心化无人机辅助物联网系统提供了一条可扩展的轻量化路径,其核心贡献在于证明了“局部观测加简单学习”即可在特定场景下逼近复杂集中式方法的效果。这对于资源受限的边缘部署场景具有直接的参考价值——当算力和带宽都是稀缺资源时,表格型方法配合精心设计的奖励函数,往往比复杂的深度神经网络更加实用。
不过,表格型 Q 学习固有的局限性也值得正视。当状态空间维度升高时,Q 表的规模会呈指数增长,“维度灾难”将严重制约方法的扩展性。本文在 200 辆车、少量无人机的规模下验证了可行性,但当网络规模扩大十倍或需要处理高分辨率的环境信息时,表格型方法可能难以胜任。如何在保持分布式优点的同时引入函数逼近(如深度 Q 网络或值函数分解),是未来值得探索的方向。
另一个值得思考的问题是局部观测边界的设定。本文假设无人机可以获取邻机位置信息,但在真实的城市峡谷中,遮挡和干扰可能使得邻居发现变得不可靠。如何在通信链路间歇性中断的情况下保证学习与决策的鲁棒性,需要进一步研究。
总体而言,TRUAV 的思路——用博弈论激励约束替代全局信息交换,用轻量表格方法替代复杂深度网络——为无人机辅助车联网的实用化部署提供了有益的启示。在边缘智能日益重要的今天,这种“够用就好”的设计哲学或许比盲目追求算法复杂度更加务实。
摘要
无人机(UAV)已成为下一代物联网(IoT)生态系统的关键使能技术,可在智慧城市场景中通过灵活的空中中继扩展动态车载自组织网络(VANET)的连接覆盖。然而,传统的无人机轨迹规划集中式方法需要持续汇聚全局网络状态信息,在密集城市部署所面临的带宽与能量约束条件下难以实际应用。本文提出了一种基于独立表格型 Q 学习的分布式多智能体强化学习框架 TRUAV,用于无人机辅助车载自组织网络中无人机轨迹规划与路由增强的联合优化。每个无人机配备一个本地 Q 学习智能体,仅依据车辆密度、数据包队列状态以及邻近无人机位置等局部可观测信息进行决策,从而消除了对全局状态信息交换的依赖。一种受势博弈启发的奖励设计在考虑能耗的同时,鼓励交互智能体之间实现空间多样性并实现路由感知的无人机定位。在覆盖 200 辆移动车辆的大规模城市区域上进行的数值仿真表明,所提出的 TRUAV 框架在网络覆盖率和数据包投递比方面可与集中式深度强化学习方法相媲美,同时在中继时延和能效方面更具优势。最后,本文讨论了分布式多智能体无人机辅助物联网系统所面临的新兴挑战与未来研究方向。
Abstract
Unmanned aerial vehicles (UAVs) have emerged as a key enabler of next-generation Internet of Things (IoT) ecosystems, offering flexible aerial relaying to extend connectivity across dynamic vehicular ad hoc networks (VANETs) in smart city environments. However, conventional centralized approaches for UAV trajectory planning require continuous global network state aggregation, making them impractical under bandwidth and energy constraints typical of dense urban deployments. In this article, we present TRUAV, a distributed multi-agent reinforcement learning framework based on independent tabular Q-learning for joint UAV trajectory planning and routing enhancement in UAV-aided VANETs. Each UAV is equipped with a local Q-learning agent that operates purely on locally observable information, including vehicle density, packet queue states, and neighbor UAV positions, thereby eliminating the need for global state exchange. A potential-game-inspired reward design encourages spatial diversity and routing-aware UAV positioning among interacting agents while accounting for energy consumption. Numerical simulations over a large urban area with 200 mobile vehicles show that the proposed TRUAV framework achieves network coverage and packet delivery ratios comparable to centralized deep reinforcement learning methods, while also improving relay delay and energy efficiency. Finally, we discuss emerging challenges and future research directions for distributed multi-agent UAV-assisted IoT systems.
论文详细总结(自动生成)
TRUAV 论文总结
1. 核心问题与研究背景
- 研究场景:智慧城市中无人机(UAV)作为空中中继节点,扩展车载自组织网络(VANET)与物联网(IoT)的连通性。
- 核心痛点:传统集中式 UAV 轨迹规划方法需要持续汇聚全局网络状态信息(如所有车辆位置、队列、所有 UAV 位置等),在密集城市部署下面临两大瓶颈:
- 带宽瓶颈:全局状态聚合带来巨大的通信开销。
- 能耗瓶颈:集中式控制与信息交换显著增加能耗。
- 研究目标:提出一种去中心化方案,使 UAV 仅依赖局部观测即可完成轨迹规划与路由决策,降低通信与计算开销,同时保持接近集中式深度强化学习的性能。
2. 方法论
2.1 核心思想
- 采用分布式多智能体强化学习(MARL)框架,每架 UAV 独立部署一个轻量级表格型 Q 学习智能体。
- 完全去中心化决策,无需全局状态交换,仅凭局部观测即可进行轨迹与路由联合优化。
2.2 关键技术细节
- 观测空间(本地可观测信息):
- 周边车辆密度
- 数据包队列状态
- 邻近 UAV 的位置
- 决策内容:联合优化 UAV 的轨迹(位置移动)以及作为中继时的路由转发策略。
- 奖励函数(势博弈启发式设计,兼顾空间多样性、能效与路由感知):
其中各项含义:
- :成功中继/转发的奖励
- :覆盖重叠/空间冲突惩罚(鼓励空间多样性)
- :覆盖率奖励
- :能耗惩罚
- 超参数设定:
- 学习算法:独立表格 Q 学习(Independent Tabular Q-Learning),每架 UAV 各自维护一张 Q 表,独立更新,无需 critic 或集中式训练器。
3. 实验设计
- 仿真场景:大规模城市区域,200 辆移动车辆的多智能体仿真环境。
- Benchmark / 对比方法:
- 集中式深度强化学习方法(Centralized DRL)作为主要性能上界对照。
- 评价指标:
- 网络覆盖率(Network Coverage)
- 数据包投递比(Packet Delivery Ratio, PDR)
- 中继时延(Relay Delay)
- 能效(Energy Efficiency)
4. 资源与算力
- 原文中未明确披露以下算力信息:
- 使用的 GPU 型号与数量
- CPU 资源
- 训练时长 / 总仿真耗时
- 仿真平台(如 SUMO、ns-3、Python 自研环境等)
- 由于采用的是表格 Q 学习,理论上对算力要求极低,普通 CPU 即可完成训练,这与论文强调的"轻量化"定位一致,但仍建议作者补充算力与仿真环境细节以增强可复现性。
5. 实验数量与充分性
- 实验规模描述较为概括,从公开摘要与元数据判断:
- 在 200 辆车的单一城市仿真场景下进行了整体性能对比。
- 对比指标覆盖覆盖率、PDR、时延、能效四项。
- 充分性评价:
- 优点:覆盖了核心性能维度,并在"分布式 vs 集中式 DRL"这一关键对照上展开比较。
- 不足:
- 未见明显的消融实验(如去除势博弈奖励项、关闭空间多样性惩罚、不同超参数 敏感性分析等)。
- 未在多种城市拓扑/车流密度/ UAV 数量下进行泛化性验证。
- 实验场景较为单一,结论的鲁棒性有待加强。
- 因此,实验结果整体可信但充分性有限,尤其缺乏消融与敏感性分析。
6. 主要结论与发现
- 性能可比性:TRUAV 在网络覆盖率与数据包投递比两项指标上与集中式深度强化学习方法相当。
- 性能优势:在中继时延与能效两项指标上优于集中式 DRL。
- 核心结论:证明了纯分布式、表格型轻量强化学习即可在 UAV-VANET 场景中逼近集中式 DRL 的性能,同时显著降低通信开销与能耗,为去中心化 UAV 辅助 IoT 系统提供了一条可扩展路径。
- 展望:讨论了分布式多智能体 UAV-IoT 系统的新兴挑战与未来研究方向(例如高维状态扩展、异构 UAV 协作、安全与隐私等)。
7. 优点与亮点
- 方法层面:
- 完全去中心化部署,消除全局状态交换,契合密集城市部署的带宽/能耗约束。
- 采用表格 Q 学习,实现成本低,无需 GPU 即可训练,部署门槛极低。
- 引入势博弈启发的奖励设计,从机制层面保证了空间多样性与个体理性之间的平衡。
- 将轨迹规划与路由增强联合优化,而非两个独立子问题。
- 工程层面:
- 观测空间设计简洁(车辆密度 + 队列 + 邻机位置),状态维度低,训练与推理开销小。
- 在 200 辆车规模下验证了可扩展性。
8. 不足与局限
- 算法表达能力受限:
- 表格 Q 学习在高维状态空间下会遭遇维度灾难,难以扩展至更大规模或更复杂观测。
- 未引入函数逼近(如 DQN、价值分解网络 QMIX、MAPPO 等),算法天花板较低。
- 实验充分性不足:
- 缺乏消融实验与超参数敏感性分析,势博弈奖励各分量的贡献不清晰。
- 场景单一,未在多种城市拓扑、车流密度、UAV 数量、车辆移动模型下验证泛化性。
- 对比基线较为单一,仅与"集中式 DRL"整体对比,未与其他分布式 MARL 基线(如 VDN、QMIX、IQL 等)做细致对照。
- 可复现性问题:
- 未披露算力、仿真平台、训练轮数等关键复现信息。
- 应用限制:
- 假设 UAV 之间可获取邻居位置信息,但在真实密集城区中该信息同样需要通信,可能存在链路失效与时延问题。
- "局部观测"的边界与通信半径设定对结果影响较大,但文中未深入讨论。
- 表格学习的收敛速度与稳态性在大规模 UAV 集群中可能成为瓶颈。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。