
面向稀疏奖励长视野强化学习的分层软演员-评论家算法
Hierarchical Soft Actor-Critic for Sparse-Reward Long-Horizon Reinforcement Learning
📝 TLDR
稀疏奖励长周期任务下,强化学习探索效率低下。本文提出两层分层强化学习框架HRL-SAC,高层负责长周期战略规划,低层采用Soft Actor-Critic进行连续控制,两者均结合熵正则化策略优化。在Search-and-Rescue-2基准上的实验表明,该方法在成功率、覆盖效率与收敛性上均优于扁平SAC基线,验证了分层熵正则化策略是解决长周期稀疏奖励强化学习问题的有效方案。
🧭 速览
稀疏奖励与长周期任务使强化学习探索效率低下,扁平策略难以有效分解子目标与时间跨度。
两层HRL框架:高层负责长周期战略规划,低层用SAC实现连续控制,二者均结合熵正则化策略优化。
在SAR-2基准上,HRL-SAC在成功率、覆盖效率与收敛速度上均优于扁平SAC基线。
分层熵正则化策略为长周期稀疏奖励强化学习任务提供了一种有前景的解决方案。
🆚 方法对比
HRL-SAC (Hierarchical Soft Actor-Critic)
- 双层分层结构有效分解长时序任务
- 在高稀疏奖励SAR-2环境中成功率和覆盖率优于flat SAC
- 熵正则化策略提升探索与收敛稳定性
- 结合离策略SAC实现连续控制与高层的子目标规划
- 依赖非平稳转移分布,梯度训练可能不稳定
- 高层子目标设定依赖人工或启发式设计
- 未在大规模或多样化环境中充分验证泛化性
- 计算开销因双层网络结构而高于flat SAC
Flat SAC (Soft Actor-Critic)
- 熵正则化使策略探索充分,收敛较稳定
- 作为off-policy算法样本效率较高
- 支持连续动作空间控制
- 实现相对简单,无需分层结构设计
- 在稀疏奖励长视野任务中探索能力不足
- 信用分配困难,易陷入局部停滞
- 成功率与覆盖率均显著低于HRL-SAC
- 缺乏时序抽象,难以处理延迟奖励
Option Framework
- 形式化了时序扩展动作,奠定HRL理论基础
- 为层次化策略提供数学框架支持
- 支持多种子策略与终止条件灵活组合
- 依赖离散动作空间,扩展到连续控制困难
- 选项发现与学习需要额外机制设计
- 在稀疏奖励深度学习场景中实用性受限
Feudal RL
- 通过Manager与Worker实现多层时序抽象
- 子目标条件化提升信用分配能力
- 支持端到端深度网络训练
- 依赖离散动作空间,连续控制中稳定性不足
- 对奖励设计敏感,训练动态易不稳定
- 子目标空间设计需要领域知识
Option-Critic
- 实现选项内部策略与终止函数的联合学习
- 端到端训练无需手工设计选项
- 可与深度网络结合扩展到复杂环境
- 在连续控制环境中收敛性仍不稳定
- 选项终止学习易导致子策略退化
- 信用分配在高维观测下效率有限
HAC (Hierarchical Actor-Critic)
- 将任务分解为高层目标选择与底层连续控制
- 支持多级子目标层次提升探索效率
- 在稀疏奖励导航中表现优于非分层方法
- 底层策略对高层子目标变化敏感,训练易震荡
- 实现复杂,调参成本较高
- 对高维观测环境的扩展性有待验证
HIRO-A
- 结合离策略修正提升分层学习样本效率
- 高层目标与底层执行解耦改善探索
- 在长视野连续控制中表现较稳定
- 子目标分布非平稳问题仍未完全解决
- 论文中作为近期工作详细比较数据有限
- 对超参数选择较为敏感
HRL-MG (Hierarchical RL with Multi-Goal)
- 多目标机制增强稀疏奖励下导航探索
- 分层架构支持端目标灵活指定
- 在稀疏奖励导航任务中验证有效
- 仅基于离散动作空间设计,不适用连续控制
- 论文未在连续控制基线上做充分对比
- 目标空间设计依赖任务先验知识
本文提出的HRL-SAC通过双层分层结构结合SAC熵正则化,在SAR-2稀疏奖励长视野任务中显著优于flat SAC及其他HRL方法;相比Option、Feudal、Option-Critic等依赖离散动作的早期框架,HRL-SAC更适合连续控制;与HAC、HIRO-A、HRL-MG相比,其在收敛稳定性和覆盖率上更具优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
针对稀疏奖励下长周期任务中强化学习探索效率低的问题,本文提出双层分层强化学习框架 HRL-SAC,通过高层策略负责长期战略规划、低层策略基于 Soft Actor-Critic 算法执行连续控制,两层均采用熵正则化策略优化。实验在 Search-and-Rescue-2 数据集上验证了该方法,成功率相对扁平 SAC 提升约 1.77 倍,覆盖效率提升 2.08 倍,表明分层熵正则化策略是解决长视野稀疏奖励强化学习的有效方案。
研究背景与动机
稀疏奖励下的长视野序列决策是深度强化学习领域长期面临的难题。在搜索与救援这类实际任务中,智能体往往需要在广阔的地图中进行长时间探索,直到最终发现目标才能获得奖励信号。这种延迟且稀少的外部反馈带来了一系列根本性挑战:早期决策点难以获得有效的梯度反馈,导致[[信用分配]]问题严重;长视野下随机探索命中奖励状态的概率随时间呈指数级下降;稀疏奖励还会使[[策略梯度]]估计的方差急剧增大,训练过程极不稳定。
传统的扁平(flat)强化学习方法在面对这类问题时往往力不从心。以标准 [[Soft Actor-Critic|SAC]] 算法为例,它虽然通过最大熵框架改善了探索性,但缺乏时间抽象能力,智能体仍需在每一步做出原子级别的动作决策。这意味着在需要数千步才能完成一次任务的环境中,算法必须从海量低层次的探索中艰难地学习,这不仅样本效率极低,而且容易陷入局部最优。
[[分层强化学习]]的核心思想正是为了解决这一困境。它通过引入时间抽象机制,将复杂的长周期任务分解为多层次的子问题:高层策略负责生成子目标或选择宏观行为,而低层策略则专注于完成具体的短期目标。这种结构不仅有效缩短了[[稀疏奖励]]环境中的有效决策视野,还为信用分配提供了天然的层级结构,成为近年来研究的热门方向。
然而,将分层强化学习与最大熵方法相结合并应用于实际稀疏奖励任务,仍存在稳定性与样本效率方面的挑战。已有的一些分层方法往往只在单一层次引入熵正则化,或者缺乏有效的内在奖励机制来指导低层策略的学习。本文提出的 HRL-SAC 正是针对这些问题的一次系统性尝试。
方法
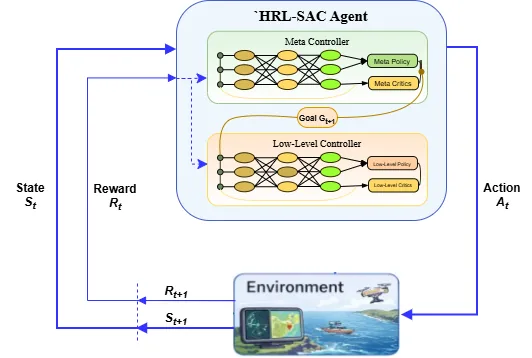
HRL-SAC 的核心设计采用双层分层架构,每一层都承担不同的职责,共同解决稀疏奖励长视野任务中的探索与学习问题。
高层策略(Meta-Controller) 负责长期战略规划。它每隔 步根据当前状态选择一个子目标 ,这个子目标是从状态空间的某个子集中选取的向量,无需手工设计语义。具体而言,子目标通过 生成,其中 是高层策略。在本文的实验设置中,高层策略在离散的 4 个语义目标空间中选择:探索新区域、在特定位置搜索、追踪目标、以及返回基地。这种设计使得高层能够专注于整体的探索策略,而不必纠结于具体的控制细节。
低层策略(Worker) 基于 [[Soft Actor-Critic|SAC]] 算法执行连续动作控制。对于给定的子目标 ,低层策略在接下来的 步内生成原子动作 。低层策略的优化目标采用标准的最大熵形式:
其中 是熵温度参数,用于平衡 exploitation 与 exploration。
为了解决稀疏外部奖励带来的学习困难,低层采用 L2 距离形式的[[内在奖励]]提供密集学习信号:
这里 将下一状态映射到子目标空间。当低层智能体成功接近子目标时,内在奖励为负(越小越好),从而引导低层学会将状态推进到目标位置。这种简单的设计避免了训练额外子目标编码器的复杂性,同时为低层提供了持续的反馈信号。
两层熵正则化的协同是本方法的另一关键设计。与只在一层引入软化的方法不同,HRL-SAC 在高层与低层同时采用[[熵正则化]]策略优化。这种双重软化带来了几个优势:低层的熵正则化防止策略过早收敛到确定性行为,保持足够的探索来应对子目标的动态变化;高层的熵正则化则在更宏观的时间尺度上维持探索多样性,有助于发现更优的长期策略。
高层在时间跨度为 的半马尔可夫决策过程(SMDP)上优化累积外部奖励:
通过将 步的累积外部奖励作为高层的一个"一步"奖励,SMDP 的视角为高层策略提供了清晰的优化目标。
整体算法流程为:每个 meta-step 间隔 步中,低层 SAC 每步基于内在奖励进行更新,高层每 步基于累积外部奖励进行一次更新。这种异步更新机制确保了低层能够快速响应子目标,而高层能够从更高层次审视整体探索策略。
实验与结果
实验在 Search-and-Rescue-2([[SAR-2]])数据集上进行,该数据集包含 1980 张真实场景图像,涵盖人员、救生衣、漂浮物、游泳者、船只、碎片等 6 类目标。环境状态设计为 276 维连续观测向量,包含位置信息、海况天气条件、能见度风速等环境因素,以及目标的检测结果。动作空间为 4 维连续控制,包括二维移动、搜索强度调节和相机变焦。
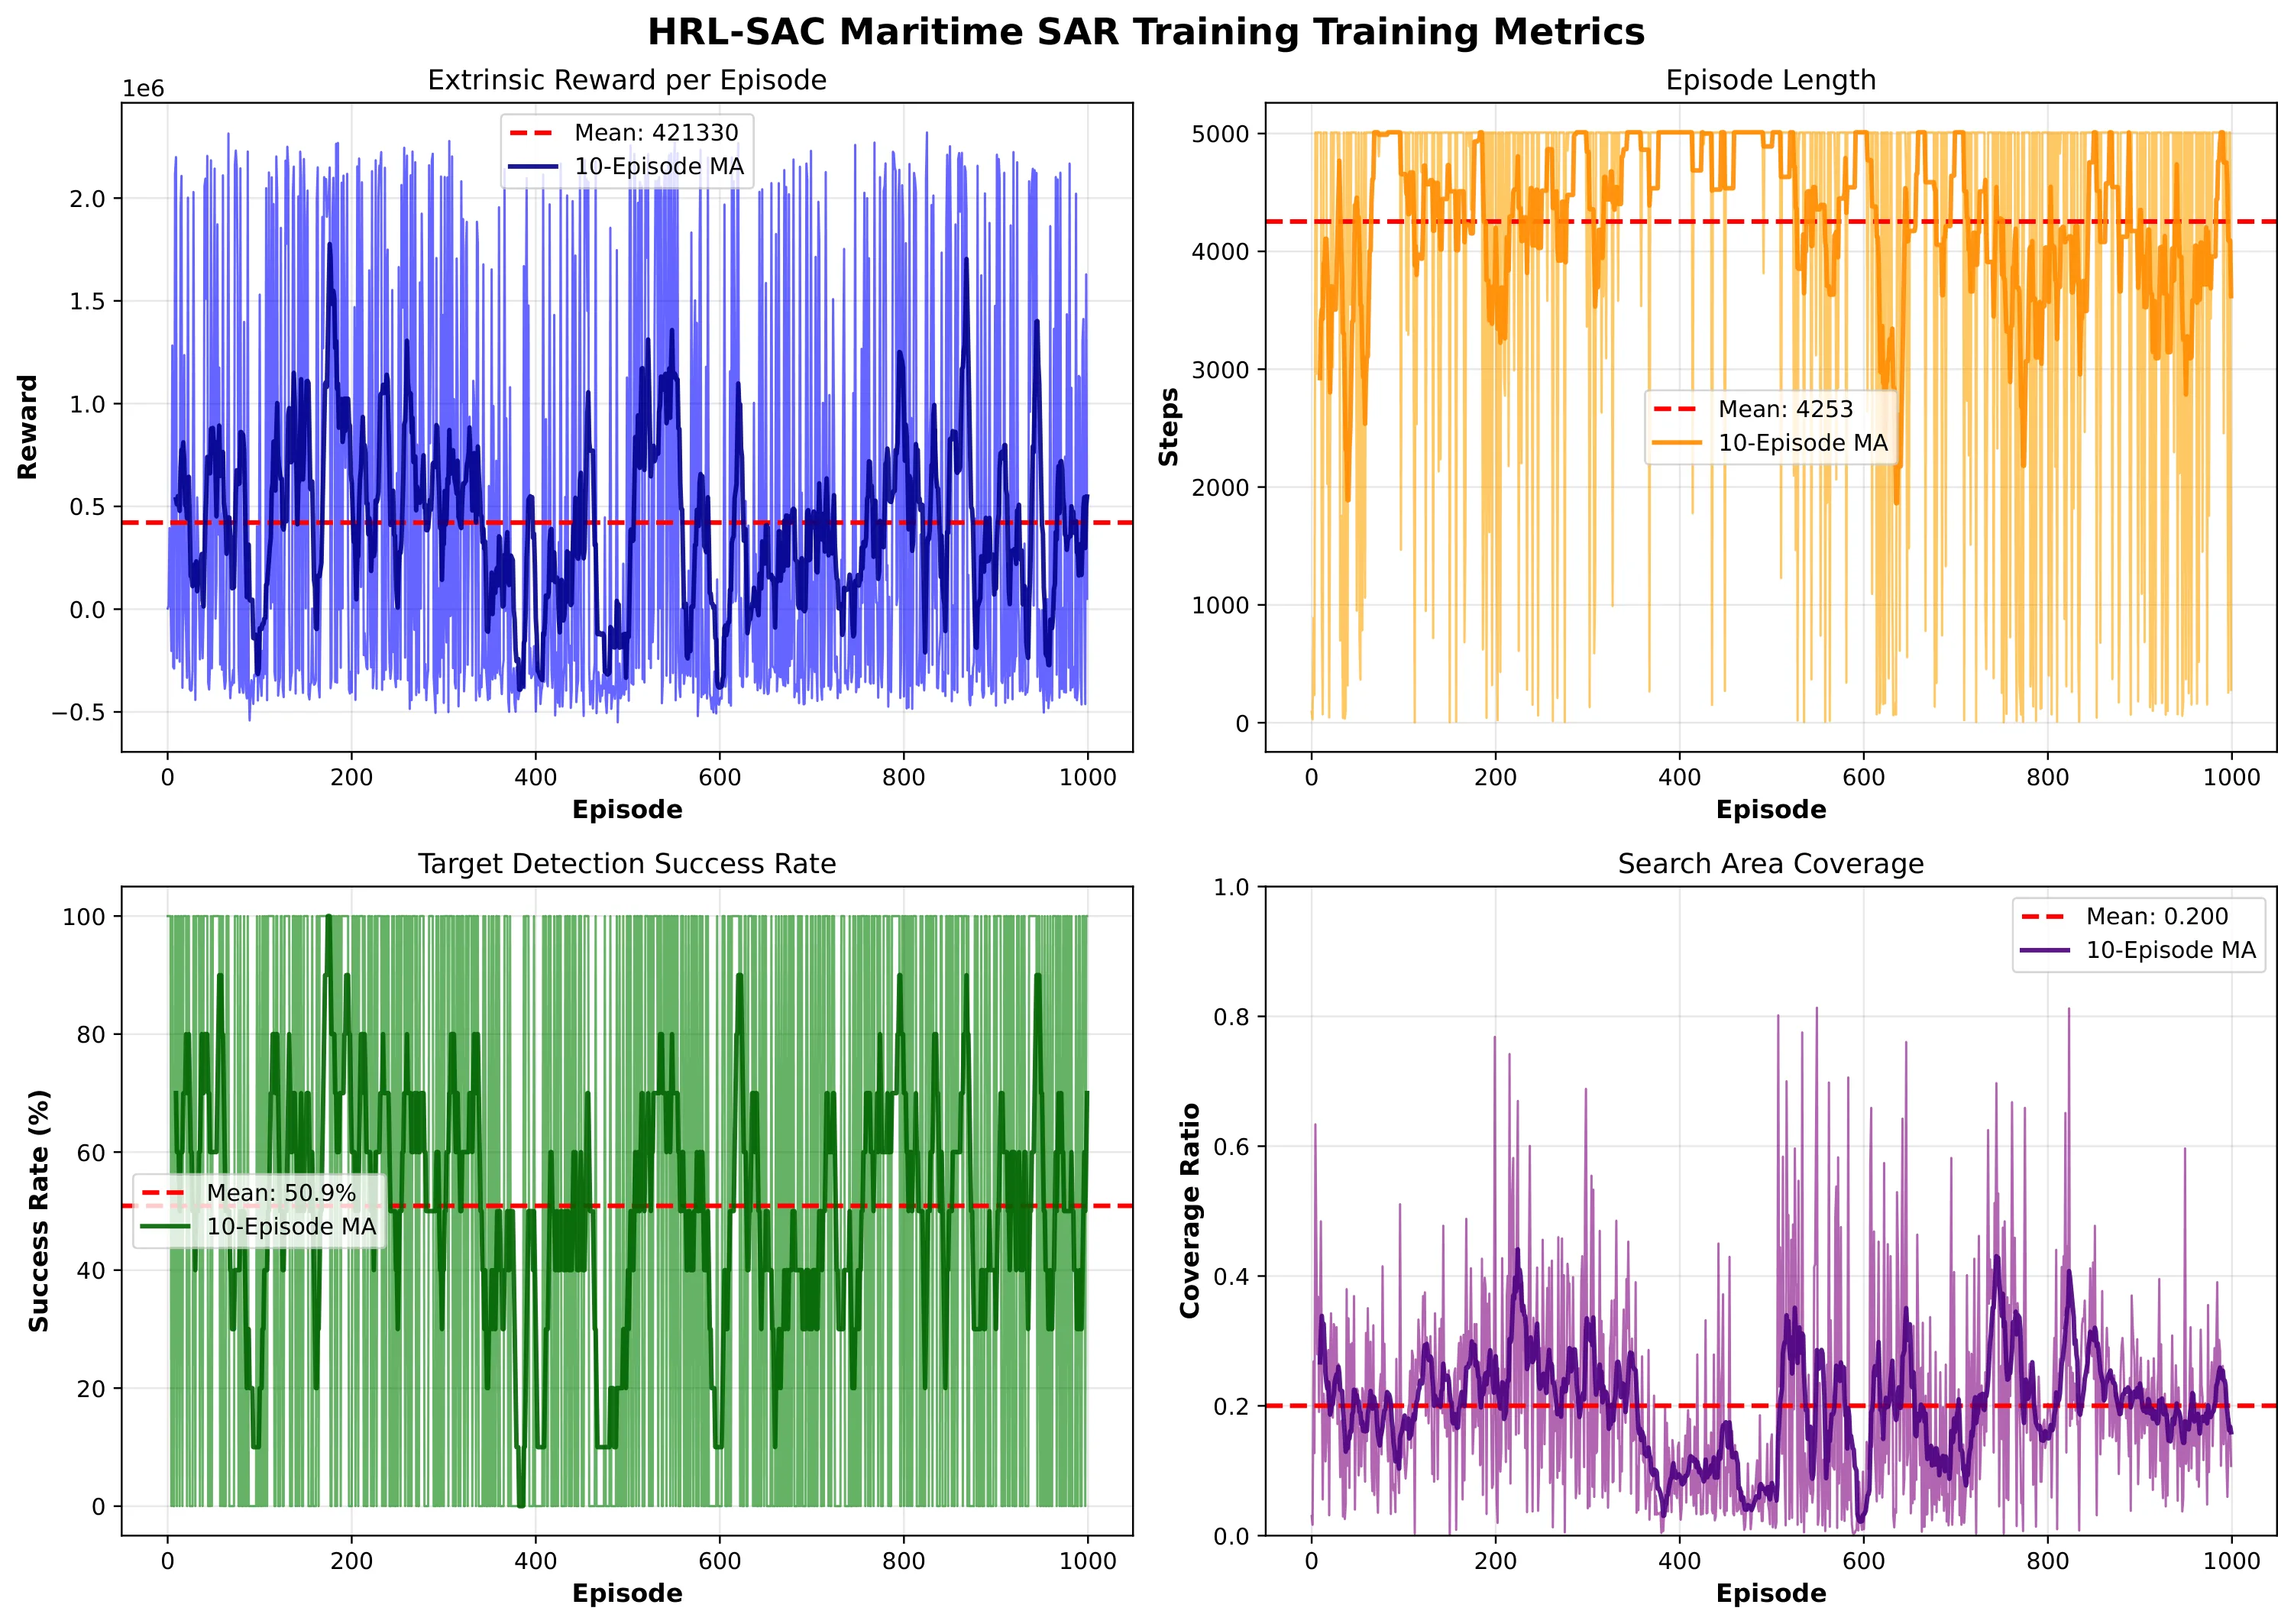
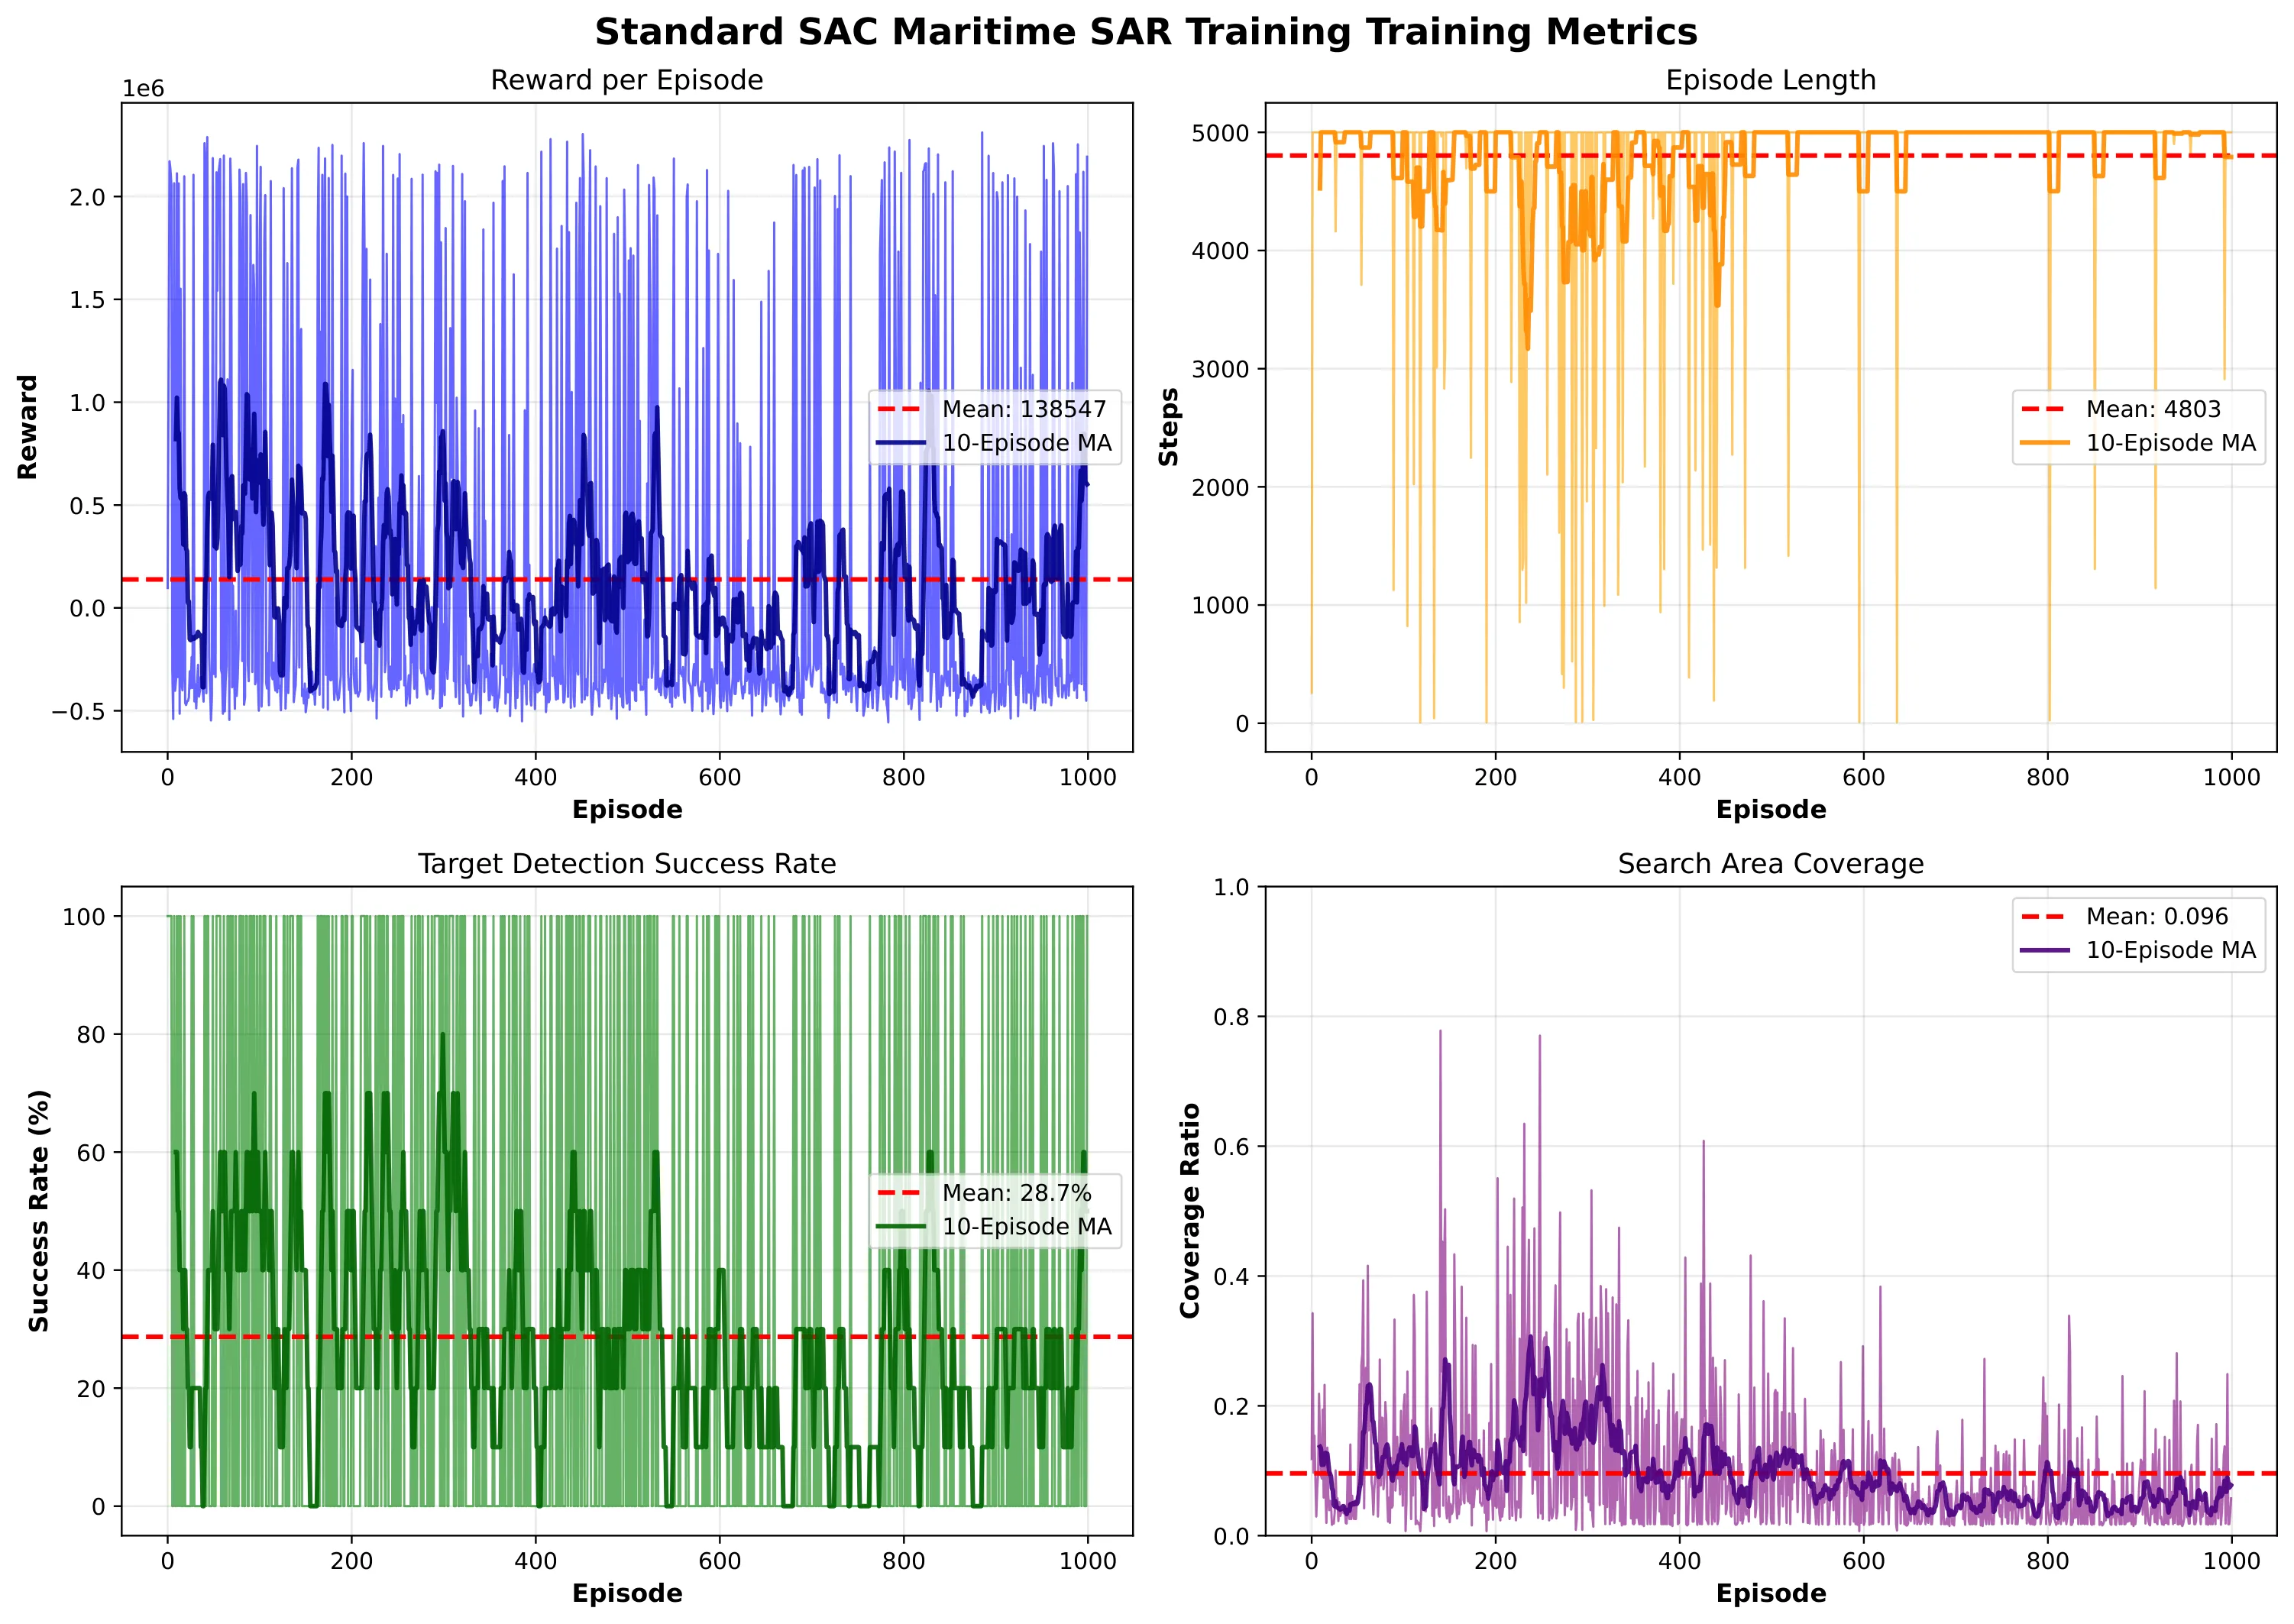
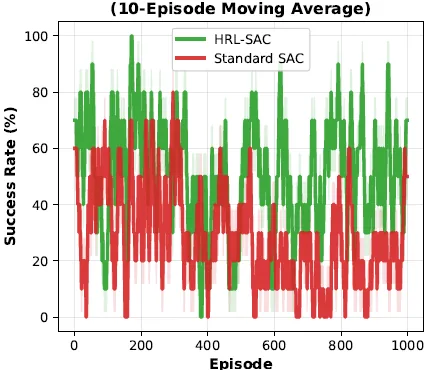
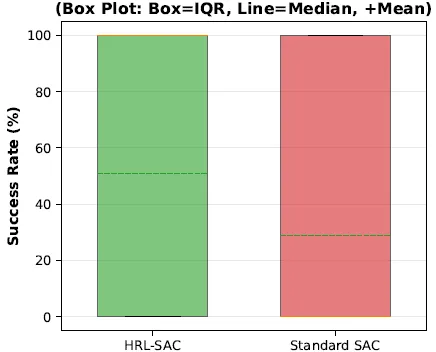
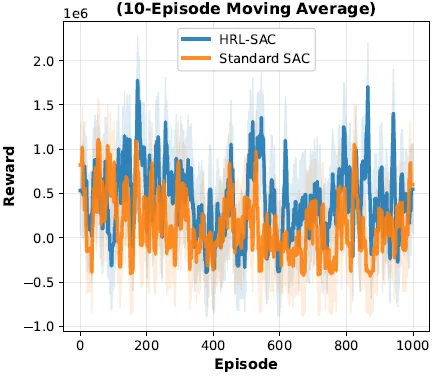
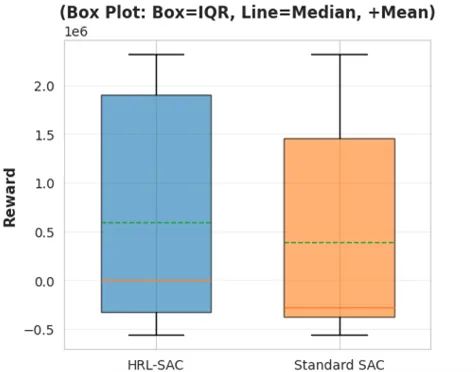
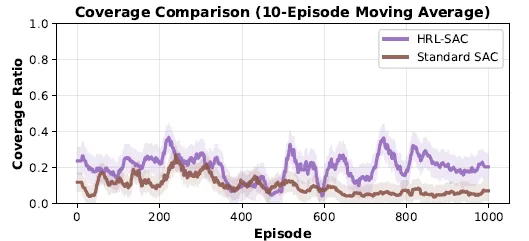
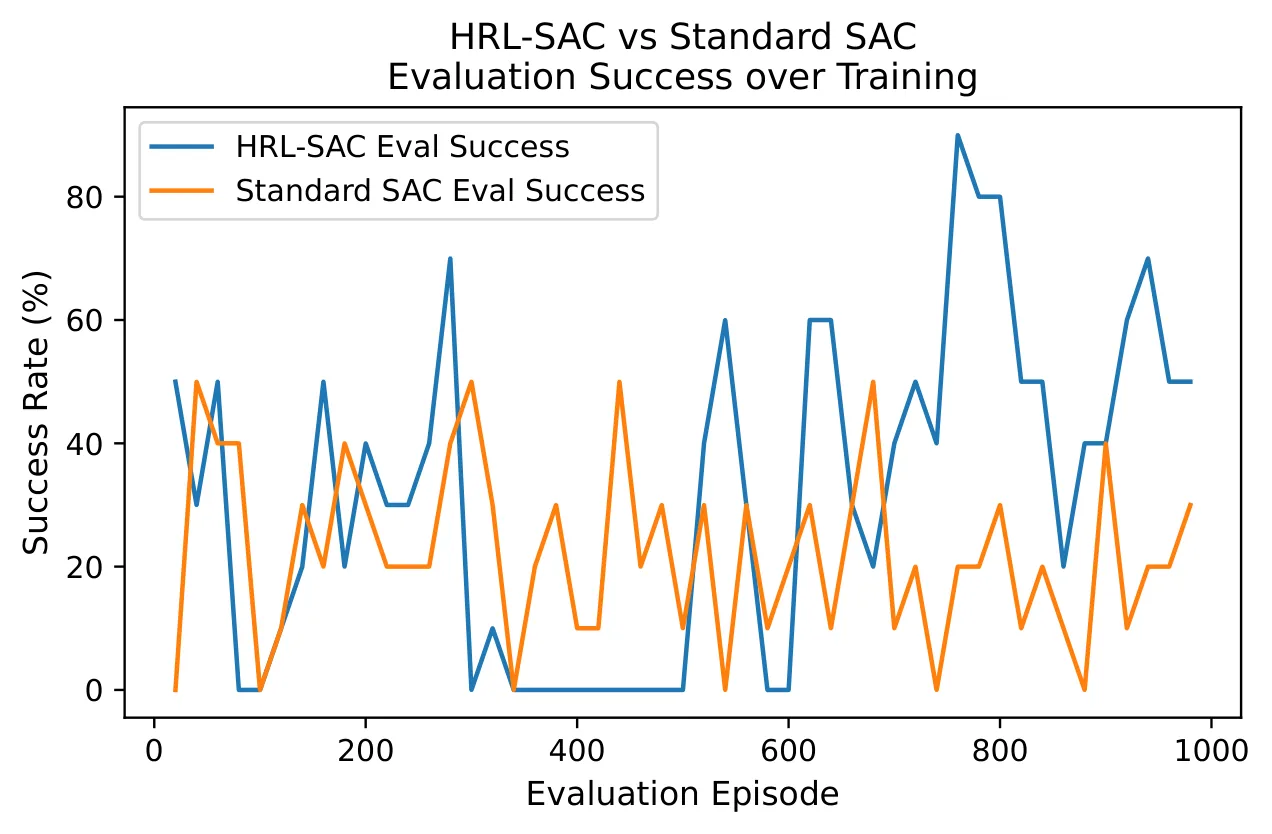
实验对比基线为标准扁平 SAC 方法。训练过程中,HRL-SAC 在约 1000 个 meta-episode(对应约 30,000 环境步)后收敛,其平均累积外部奖励达到 421,330,是标准 SAC(138,547)的 3.04 倍。在成功率指标上,HRL-SAC 达到 50.9%,相比 SAC 的 28.7% 提升了约 1.77 倍;覆盖率指标从 0.096 提升至 0.200,增幅达 2.08 倍。回合平均长度从 4803 步缩短至 4253 步,表明分层策略使智能体能够更高效地完成任务。
在 SAR-2 测试集(199 张图像)上的评估进一步验证了方法的有效性:HRL-SAC 的成功率达到 40.0%,而 SAC 为 30.0%;回合长度从 8054 步大幅缩短至 879 步。这些结果表明,分层结构确实帮助智能体在长视野任务中保持了更高效的探索策略,而双层熵正则化则在保证探索多样性的同时加速了策略的收敛。
然而,值得注意的是,实验结果的标准差较大(成功率的标准差接近均值),且论文仅与单一基线进行对比,缺乏与 HAC、HIRO、Option-Critic 等经典分层强化学习方法以及近年 HRL 改进方法的系统比较,这使得方法的相对改进幅度难以准确评估。此外,实验规模相对有限,测试集仅包含 199 张图像。
讨论与可借鉴点
HRL-SAC 的一个重要贡献在于证明了双层熵正则化设计的有效性。传统的分层强化学习方法往往只在单一层次引入软化,而本文通过在高层与低层同时采用 SAC 风格的熵正则化,实现了探索与 exploit 的平衡。这种设计理念——即在不同时间尺度上维持适度的探索——对于其他分层任务可能具有借鉴意义。
L2 距离形式的内在奖励设计也提供了简洁而有效的思路。相比需要训练额外的子目标生成器或状态编码器的方法,这种基于距离的内在奖励实现简单、计算高效,且在实验中表现出良好的学习效果。这一设计特别适合状态空间定义清晰、子目标可明确度量的场景。
从方法论层面,本文也揭示了分层强化学习在处理[[稀疏奖励]]问题时的潜力。通过将长视野任务分解为高层战略规划和低层短期控制,有效缩短了每个子问题的决策视野,从而缓解了信用分配困难。这提示我们在面对超长序列决策问题时,时间抽象可能是比单纯改进探索策略更根本的解决方案。
局限与未解决问题方面,论文实验的充分性存在一定不足。首先,仅与扁平 SAC 对比缺乏说服力,未来工作应纳入与 HAC、HIRO、SHIRO 等经典 HRL 方法的系统比较。其次,缺乏消融实验来验证"分层结构""内在奖励""双层熵正则化"各自对最终效果的贡献。第三,实验中的随机种子使用情况不明确,且结果方差极大,统计显著性存疑。第四,SAR-2 数据集作为视觉数据集,其图像信息未被强化学习智能体直接利用,真实视觉驱动的 SAR 任务仍有待探索。最后,算力消耗和训练时长等复现细节的缺失也影响了研究的可复现性。
总体而言,HRL-SAC 为稀疏奖励长视野任务提供了一种清晰的分层解决框架,其核心思想——通过时间抽象和双层熵正则化协同处理探索效率问题——具有较好的通用性。然而,更严格的实验验证和与现有 HRL 方法的系统比较将是未来工作的重要方向。
摘要
稀疏奖励长视野任务中的探索对强化学习提出了重大挑战。为了应对这些挑战,我们提出了一种两层分层强化学习(HRL)框架。第一层负责高层战略规划,而低层采用连续控制软演员-评论家(SAC)算法,两者均利用熵正则化策略优化。所提框架使用搜索与救援-2(SAR-2)数据集进行训练与评估。HRL-SAC 有效地解决了具有延迟奖励和连续控制特征的稀疏奖励长视野搜索问题,并在成功率、覆盖效率以及收敛性方面优于扁平 SAC 基线强化学习方法。这些结果表明,分层熵正则化策略是应对长视野稀疏奖励强化学习任务的一种有前景的解决方案。
Abstract
Exploration in sparse-reward long-horizon tasks poses significant challenges for reinforcement learning. To address these challenges, we propose a two-level Hierarchical Reinforcement Learning (HRL) framework. The first level handles high-level strategic planning, while the low-level uses the continuous-control Soft Actor-Critic (SAC) algorithm, and they utilize entropy-regularized policy optimization. The proposed framework was trained and evaluated using the Search-and-Rescue-2 (SAR-2) dataset. HRL-SAC effectively addresses sparse-reward long-horizon search problems characterized by delayed rewards and continuous control, and its outperforming the flat SAC baseline reinforcement learning in terms of success rates, coverage efficiency, and convergence. These findings indicate that hierarchical entropy-regularized policies are a promising solution to tackle long-horizon sparse-reward reinforcement learning tasks.
论文详细总结(自动生成)
论文总结:Hierarchical Soft Actor-Critic for Sparse-Reward Long-Horizon RL
1. 核心问题与研究动机
稀疏奖励(sparse reward)下的长视野(long-horizon)序列决策是深度强化学习长期面临的难题。在搜索与救援(Search-and-Rescue, SAR)等任务中,外部奖励信号极为稀少且高度延迟,扁平(flat)策略由于缺乏时间抽象能力,难以通过随机探索抵达奖励状态,导致:
- 信用分配(credit assignment)失败:早期决策点难以获得有效的梯度反馈;
- 探索效率低下:长视野下随机命中奖励状态的概率随时间呈指数级下降;
- 策略梯度方差大:稀疏奖励导致策略梯度估计噪声极高,训练不稳定。
分层强化学习(Hierarchical RL, HRL)通过将任务分解为高层策略(meta-controller)选择子目标与低层策略(worker)执行原子动作的时间抽象结构来缓解上述问题,但将 HRL 与连续控制的最大熵方法(Soft Actor-Critic)相结合并应用于稀疏奖励 SAR 任务,仍存在稳定性与样本效率方面的挑战。
2. 方法论
2.1 核心思想
论文提出 HRL-SAC:双层分层强化学习框架,高层用离散选项式策略负责长期战略规划,低层用 SAC 进行连续动作控制,两层均使用熵正则化策略优化,并通过 L2 距离形式的内在奖励为低层提供密集学习信号。
2.2 分层策略结构
设 MDP 为 。高层策略每隔 步依据当前状态生成子目标:
子目标空间 定义为状态变量子集,从而无需手工设计。
2.3 低层 SAC 目标
低层策略最大熵目标为:
Soft Bellman 备份为:
2.4 内在奖励(Intrinsic Reward)
为缓解稀疏奖励问题,低层使用 L2 距离形式的内在奖励:
其中 将状态映射到子目标空间,使低层即便在外部奖励缺失时也能获得密集反馈。
2.5 高层 Meta-Policy 优化
高层在时间长度为 的 SMDP 上优化外累积奖励:
2.6 算法流程(Algorithm 1)
每个 meta-step 间隔 步执行:低层 SAC 每步更新(基于内在奖励),高层每 步更新(基于累积外奖励);Polyak 软更新目标网络,熵温度 自动调节。
2.7 理论动机
- 有效视野缩短:从 缩短至 ,从而缓解信用分配;
- 梯度方差降低:;
- 熵正则化改善探索并避免低层策略过早收敛到确定性行为;
- 分层去耦:高层专注于长期探索,低层专注于短期控制。
3. 实验设计
3.1 数据集与环境
- 合成数据集:200 个流程生成的海上 SAR 场景(6 类目标:人、救生衣、漂浮物、游泳者、船只、碎片),用于算法原型验证。
- SAR-2 真实数据集:来自 Kaggle/Roboflow 的 1980 张图像(YOLO-v5 格式),按 70%/20%/10% 划分训练 / 验证 / 测试。
- 环境状态:连续 276 维观测向量(位置、海况、天气、能见度、风速、目标检测 6 维、 搜索网格下采样 64 维、4 维高层目标 one-hot)。
- 动作空间:4 维连续动作( 移动、搜索强度、相机变焦)。
3.2 对比方法
- 基线:标准(扁平)SAC,无分层结构与内在奖励;
- 指标:累积外在奖励、成功率、覆盖率、回合长度、训练稳定性。
> 注:论文仅与扁平 SAC 一个基线对比,未与 HAC、HIRO、SHIRO、HRL-MG 等典型 HRL 方法做直接比较。
4. 资源与算力
论文未明确说明所使用的 GPU 型号、数量、训练时长或计算资源消耗。仅提及:
- 使用相同的计算资源训练以保证可复现性;
- 总训练规模为 1000 个 meta-episode,约 30 000 环境步;
- 网络架构为 3 层 MLP(512 单元)+ LayerNorm + Dropout(0.1)。
这一缺失使实验结果的可复现性大打折扣。
5. 实验数量与充分性
- 实验规模:1000 episode 训练曲线对比(HRL-SAC vs SAC),并在 199 张 SAR-2 测试集上做最终评估。
- 随机种子:声称使用多随机种子,但未报告具体数量。
- 充分性评估:
- 不充分:仅单一基线(flat SAC),缺乏与 HAC、HIRO、SHIRO、option-critic 等 HRL 方法的对比;
- 缺乏消融:未对"分层结构""内在奖励""双层熵正则化"三项核心组件做独立消融实验;
- 指标方差不合理:成功率 、奖励 等标准差几乎与均值同量级,结果波动异常剧烈;
- 总步数矛盾:Table 10 给出 HRL-SAC 0.40M vs SAC 4.80M 的样本数差异,与正文 1000 episode 训练描述存在数据不一致;
- 测试集覆盖不足:199 张测试图像规模过小,且 SAR-2 是视觉数据集,但 RL 智能体并未直接消费图像,仅用其标注生成环境坐标。
6. 主要结论与发现
- HRL-SAC 在 1000 episode 训练后期平均累积奖励达 421 330,是标准 SAC(138 547)的 3.04 倍;
- 成功率 50.9%(SAC 28.7%),相对提升 1.77 倍;
- 覆盖率 0.200(SAC 0.096),提升 2.08 倍;
- 回合长度缩短约 11%(4253 vs 4803 步);
- SAR-2 测试集上 HRL-SAC 成功率 40.0% vs SAC 30.0%,回合长度 879 vs 8054 步;
- 结论:分层熵正则化策略能有效缓解稀疏奖励、长视野任务中的探索与信用分配问题。
7. 优点
- 统一的最大熵框架:在高层与低层同时引入 SAC 风格熵正则化,相比 SHIRO 等仅在单层软化的方法更具一致性;
- L2 内在奖励:实现简单,无需额外训练子目标编码器;
- 时间抽象清晰:高层离散 4 个语义目标(ExploreArea、SearchSpecificLocation、TrackObject、ReturnToBase),可解释性好;
- 软更新 + 双 Q 网络 + 优先经验回放:训练稳定性设计齐全;
- 样本效率提升:相同任务下相对扁平 SAC 收敛速度明显更具优势。
8. 不足与局限
- 方法对比基线单一:仅与扁平 SAC 比较,未与近年的 HAC、HIRO、SHIRO、H-TD3 等 HRL 方法做直接 benchmark,缺乏说服力;
- 无消融实验:未验证"分层结构""内在奖励""熵正则化"各自贡献,影响结论归因;
- 算力与训练细节不透明:未报告 GPU 型号、训练时间、随机种子数;
- 统计显著性问题:标准差极大(与均值同一量级),缺少置信区间或显著性检验;
- 数据描述不一致:Table 10 中"Total Steps"的 0.40M vs 4.80M 与正文 1000 episode × 30 = 30K 步描述矛盾;
- 真实场景适配有限:测试集仅 199 张图像,SAR-2 视觉信息未被 RL 智能体直接利用,难以体现"真实 SAR 数据驱动"的实质价值;
- 任务复杂度受限:奖励函数手工设计(如 +100 目标、-50 碰撞),场景规模( 网格)较小,对真正复杂长视野任务的扩展性存疑;
- Sim-to-Real 差距未讨论:作者在"Future Work"中提及但未在实验中体现。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。