
📝 TLDR
多模态大语言模型在复杂推理任务中常出现中间推理步骤错误却仍输出正确答案的现象,暴露出其依赖虚假捷径而非忠实推理的问题。为此本文提出O²-CritiCuRL课程强化学习框架,通过离线多rollout分析识别步骤重要性并过滤冗余步骤,再以在线渐进式步骤级强化学习引导模型补全关键推理链。该方法在多模态推理基准上取得当前最优性能,并显著提升训练与推理效率。
🧭 速览
多模态LLM推理中间步骤与最终答案不一致,可解释性与可靠性不足,且难以区分关键步骤与冗余步骤。
离线阶段对带步骤标注的轨迹进行多rollout分析以估计步骤重要性并提炼关键步骤;在线阶段采用截断链引导模型推断缺失步骤的渐进式步骤级强化学习。
在多模态推理基准上取得当前最优性能,同时在训练与推理效率上优于现有方法。
所提出的离线-在线课程强化学习范式能有效增强模型对关键推理步骤的聚焦,为提升多模态推理忠实性与效率提供新方案。
🆚 方法对比
O²-CritiCuRL
- 通过关键步骤感知提升推理可靠性
- 离线-在线迭代范式兼顾效率与精度
- 在多模态推理基准上达到SOTA
- 训练和推理效率优于现有方法
- 依赖步骤标注轨迹的质量与完整性
- 多rollout分析带来额外计算开销
- 离线在线阶段耦合增加调参复杂度
GRPO
- 效率高、可扩展性强
- 通过多推理路径探索促进慢思考
- 无需critic网络,训练更稳定
- 仅提供结果级奖励信号
- 无法区分关键步骤与冗余步骤
- 易导致推理过程不可解释
答案级监督方法(如Vision-R1)
- 实现简单,仅需最终答案标注
- 在标准基准上可获得不错准确率
- 无法约束中间推理过程,易产生错误假设
- 模型依赖虚假捷径,可靠性低
- 存在奖励 hacking 风险
步骤级监督方法(如R1-VL)
- 对中间步骤进行约束,增强可解释性
- 比答案级监督更精细的信号
- 难以区分关键步骤与冗余步骤
- 静态监督信号缺乏渐进性
- 推理路径仍可能部分错误
课程学习+强化学习范式
- 由简到难渐进训练,稳定优化过程
- 有效提升推理密集型任务泛化能力
- 与人类学习认知规律一致
- 课程设计依赖先验知识
- 难度调度不当可能限制模型潜力
O²-CritiCuRL通过离线多rollout分析识别关键步骤,再以在线截断链渐进RL强化关键步骤推理,相比Vision-R1的答案级监督和R1-VL的全步骤监督,兼顾了推理准确性与过程可解释性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 16 张)
展开查看 16 张图
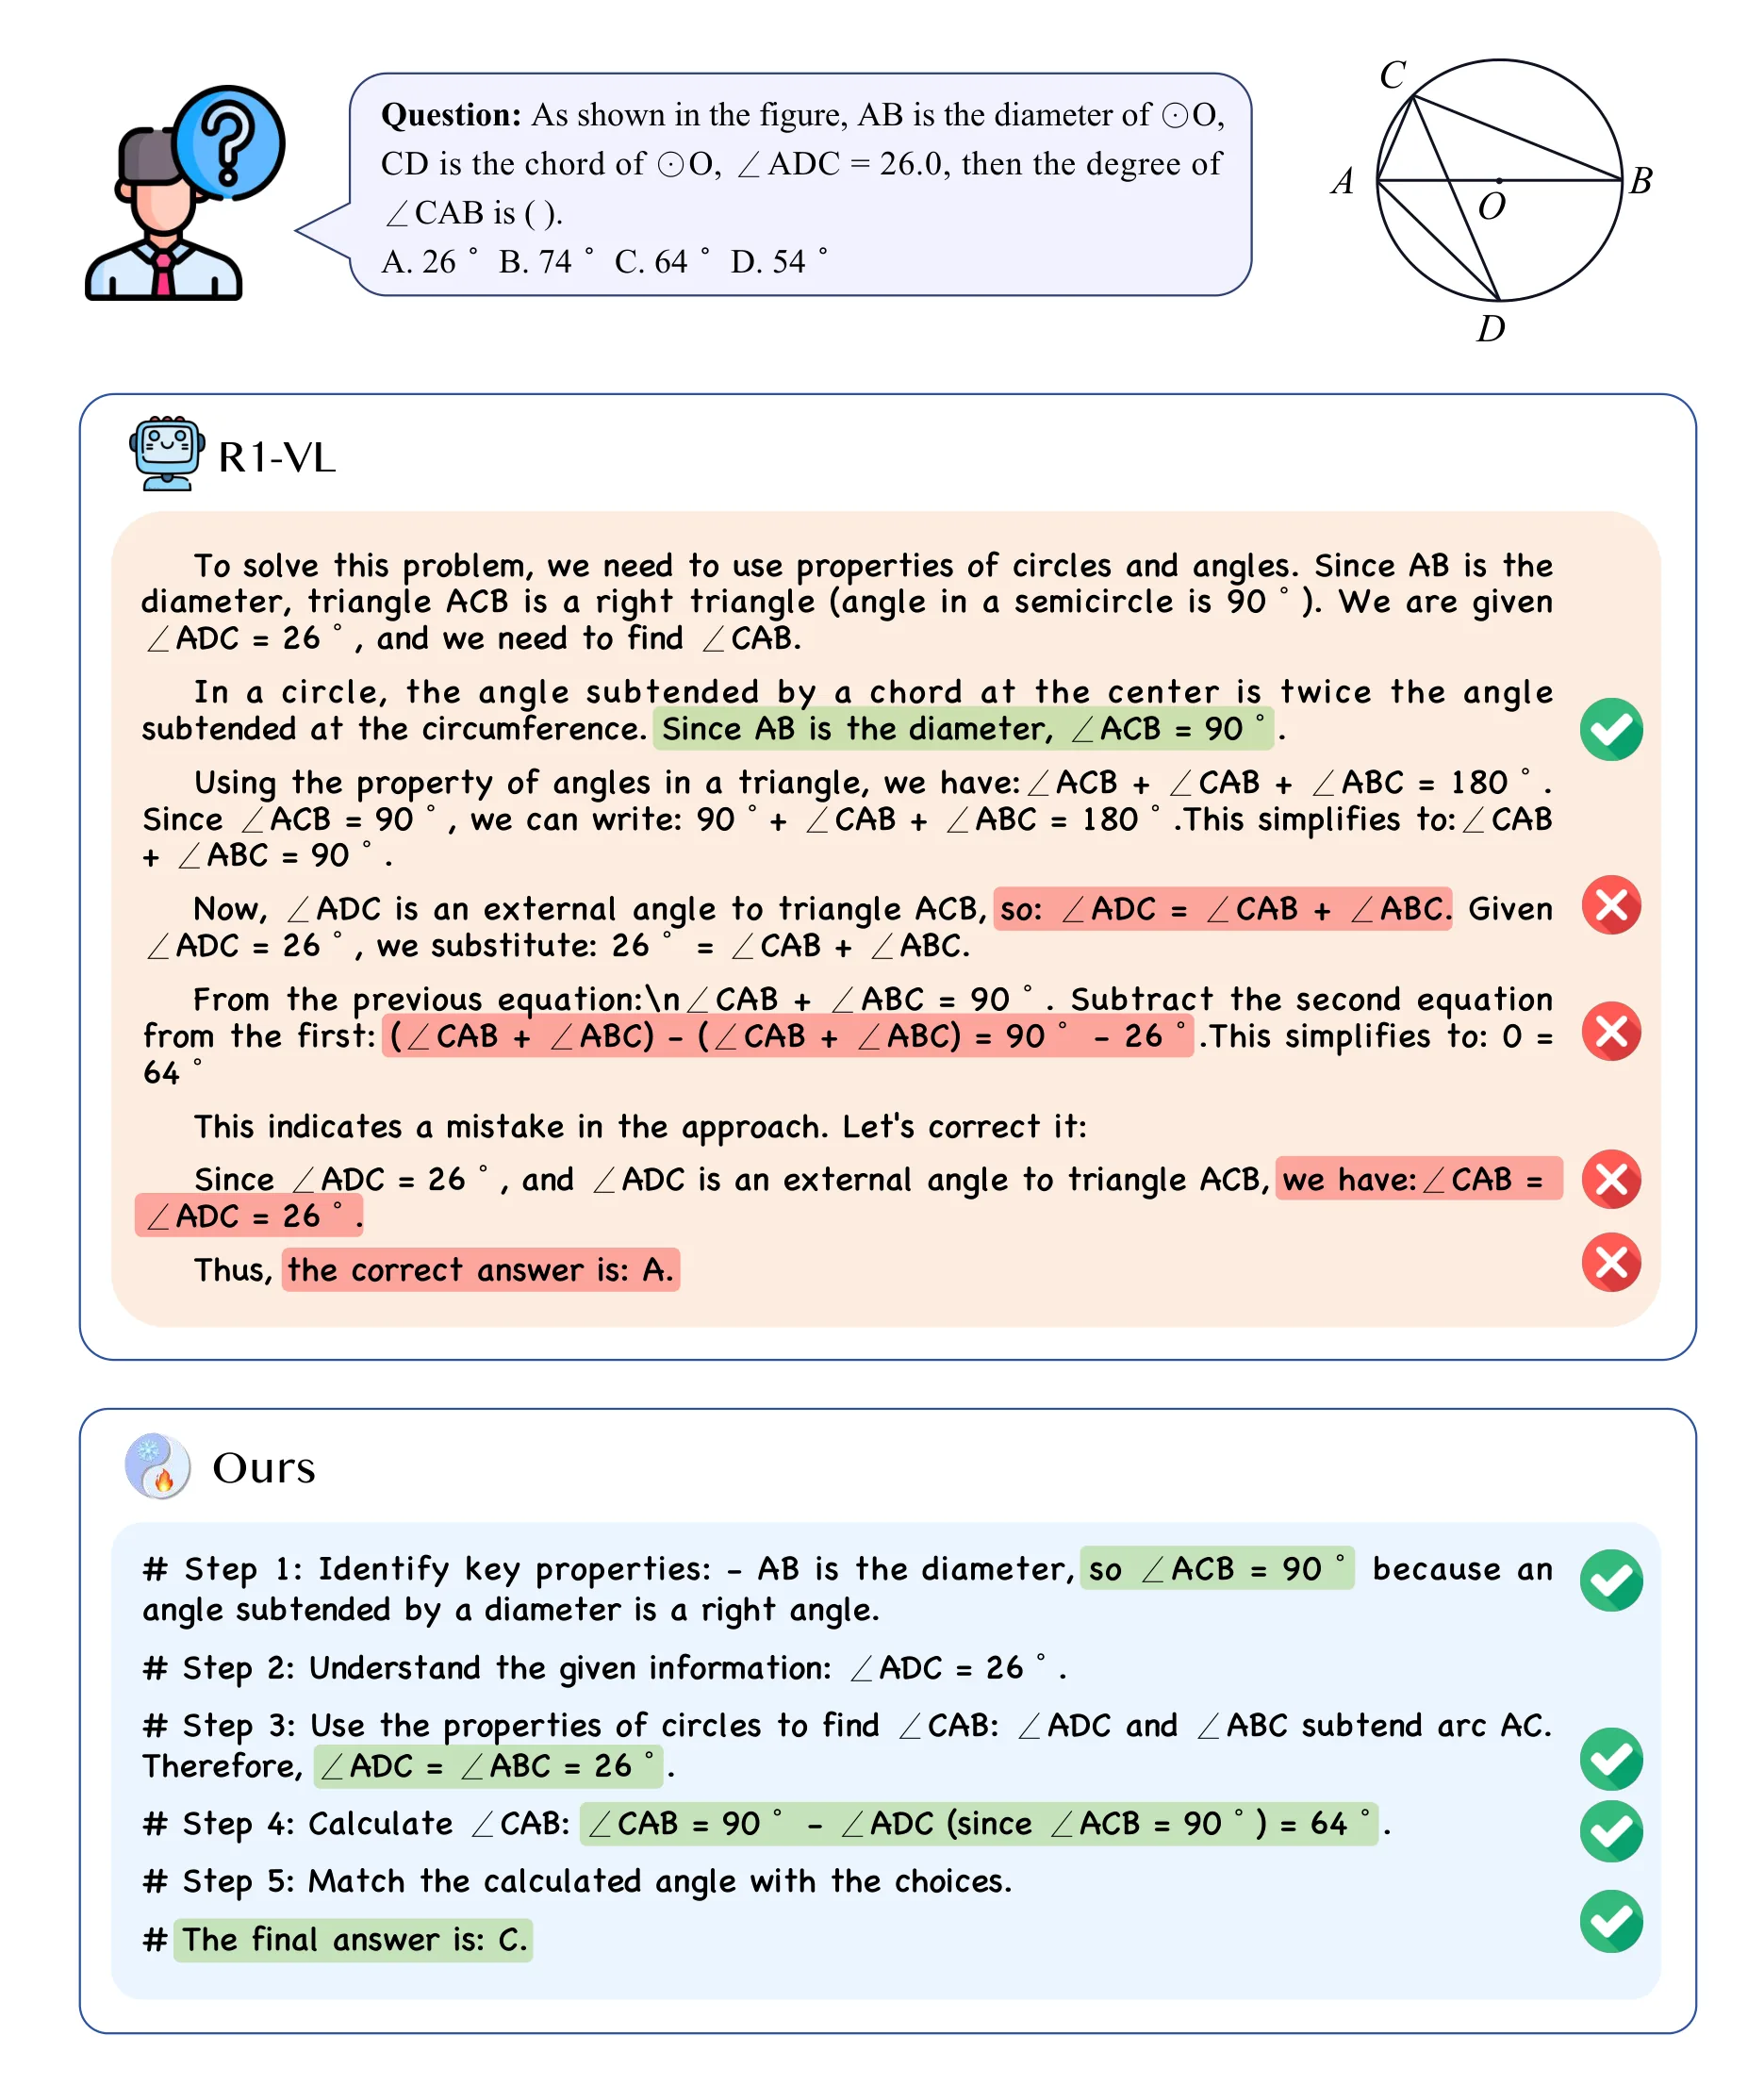
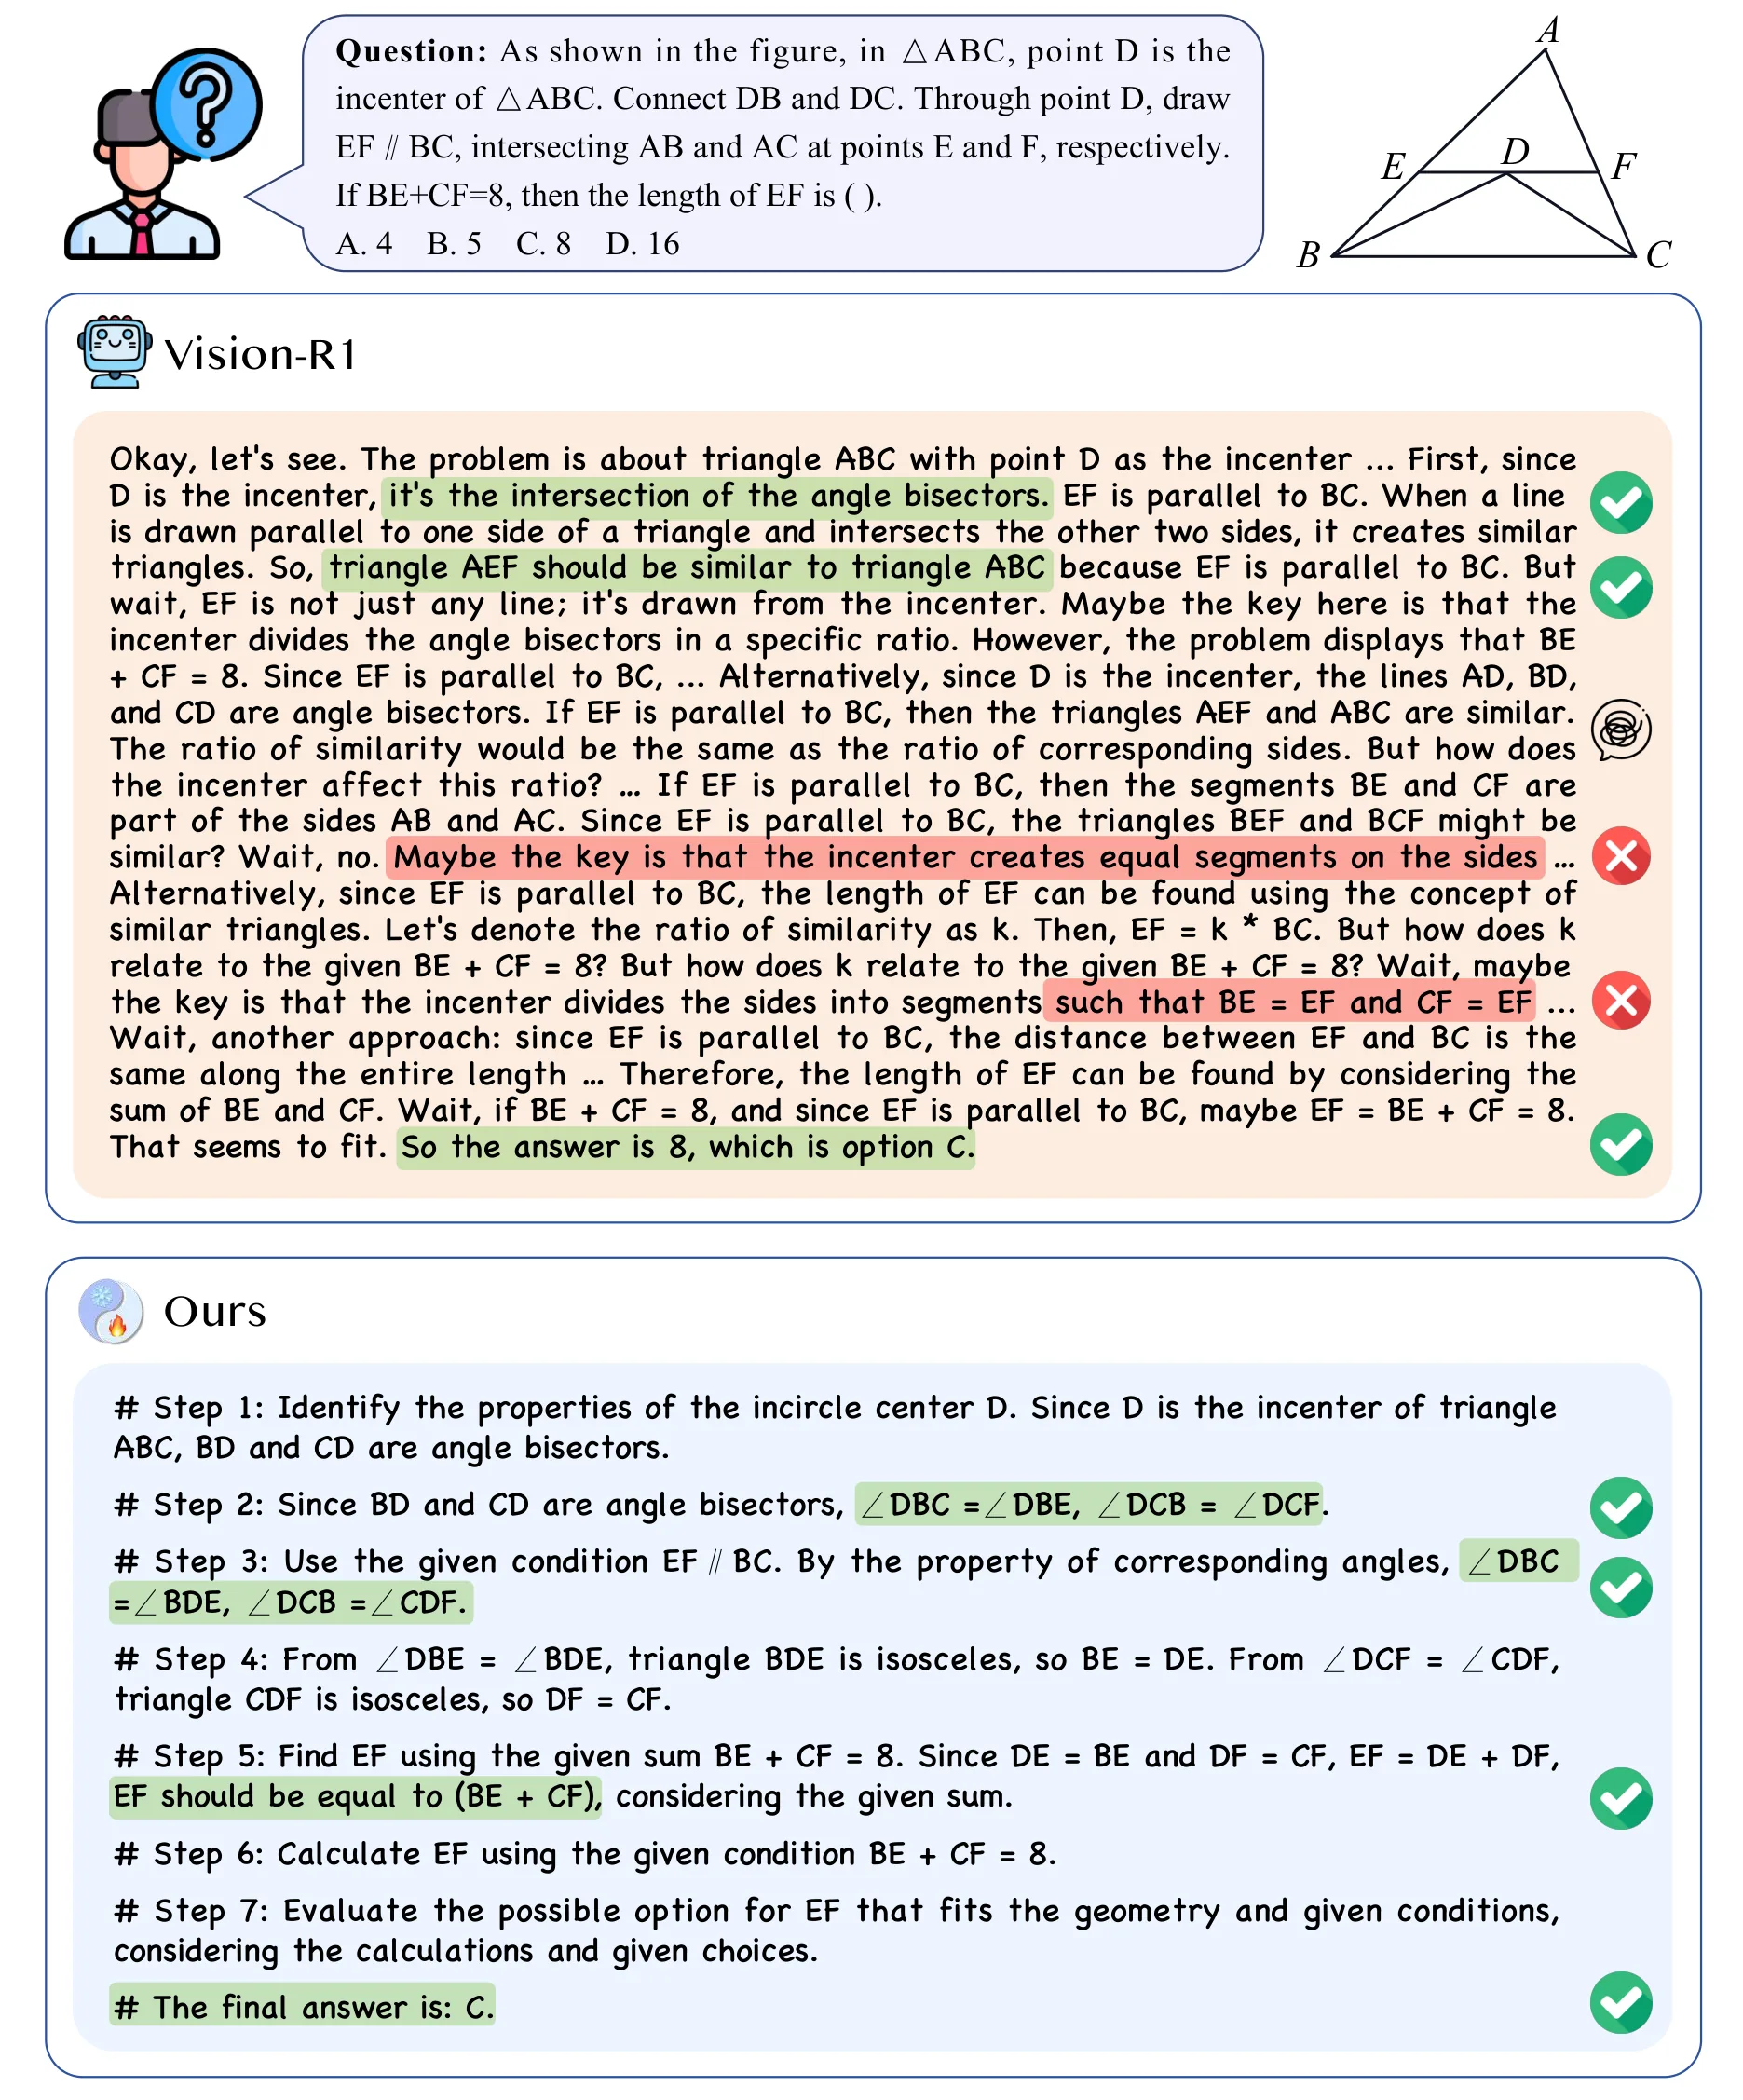
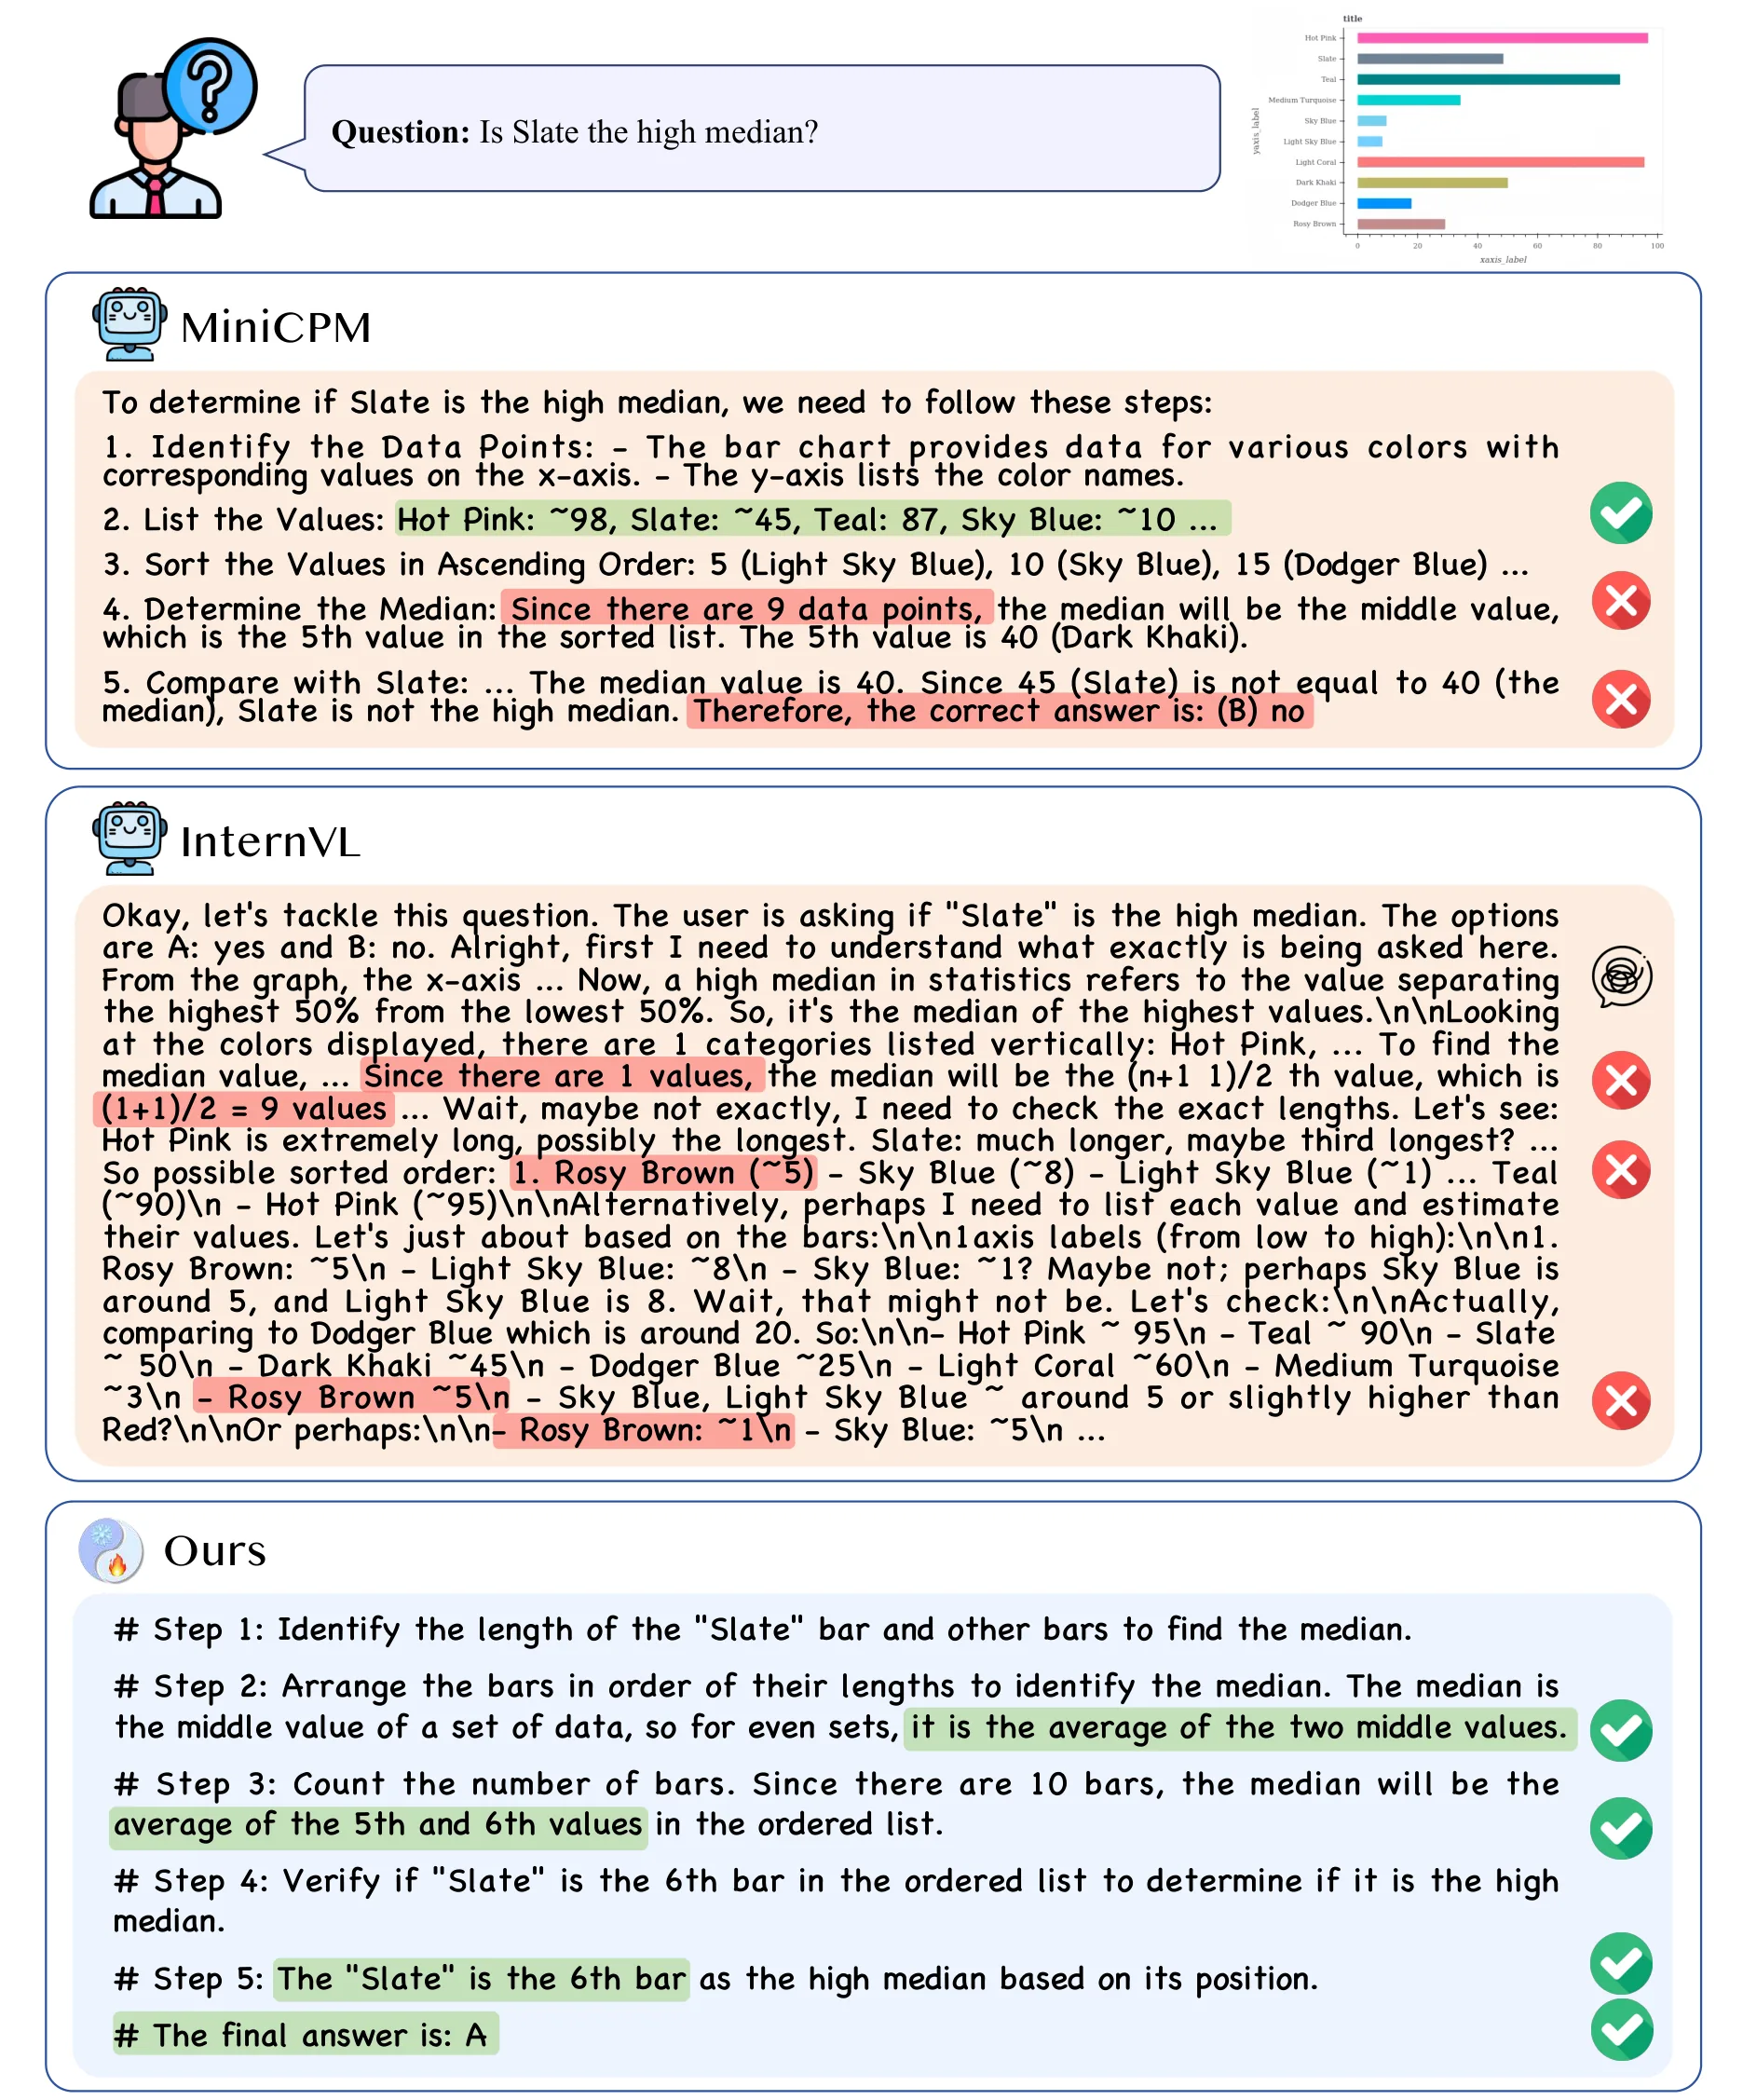
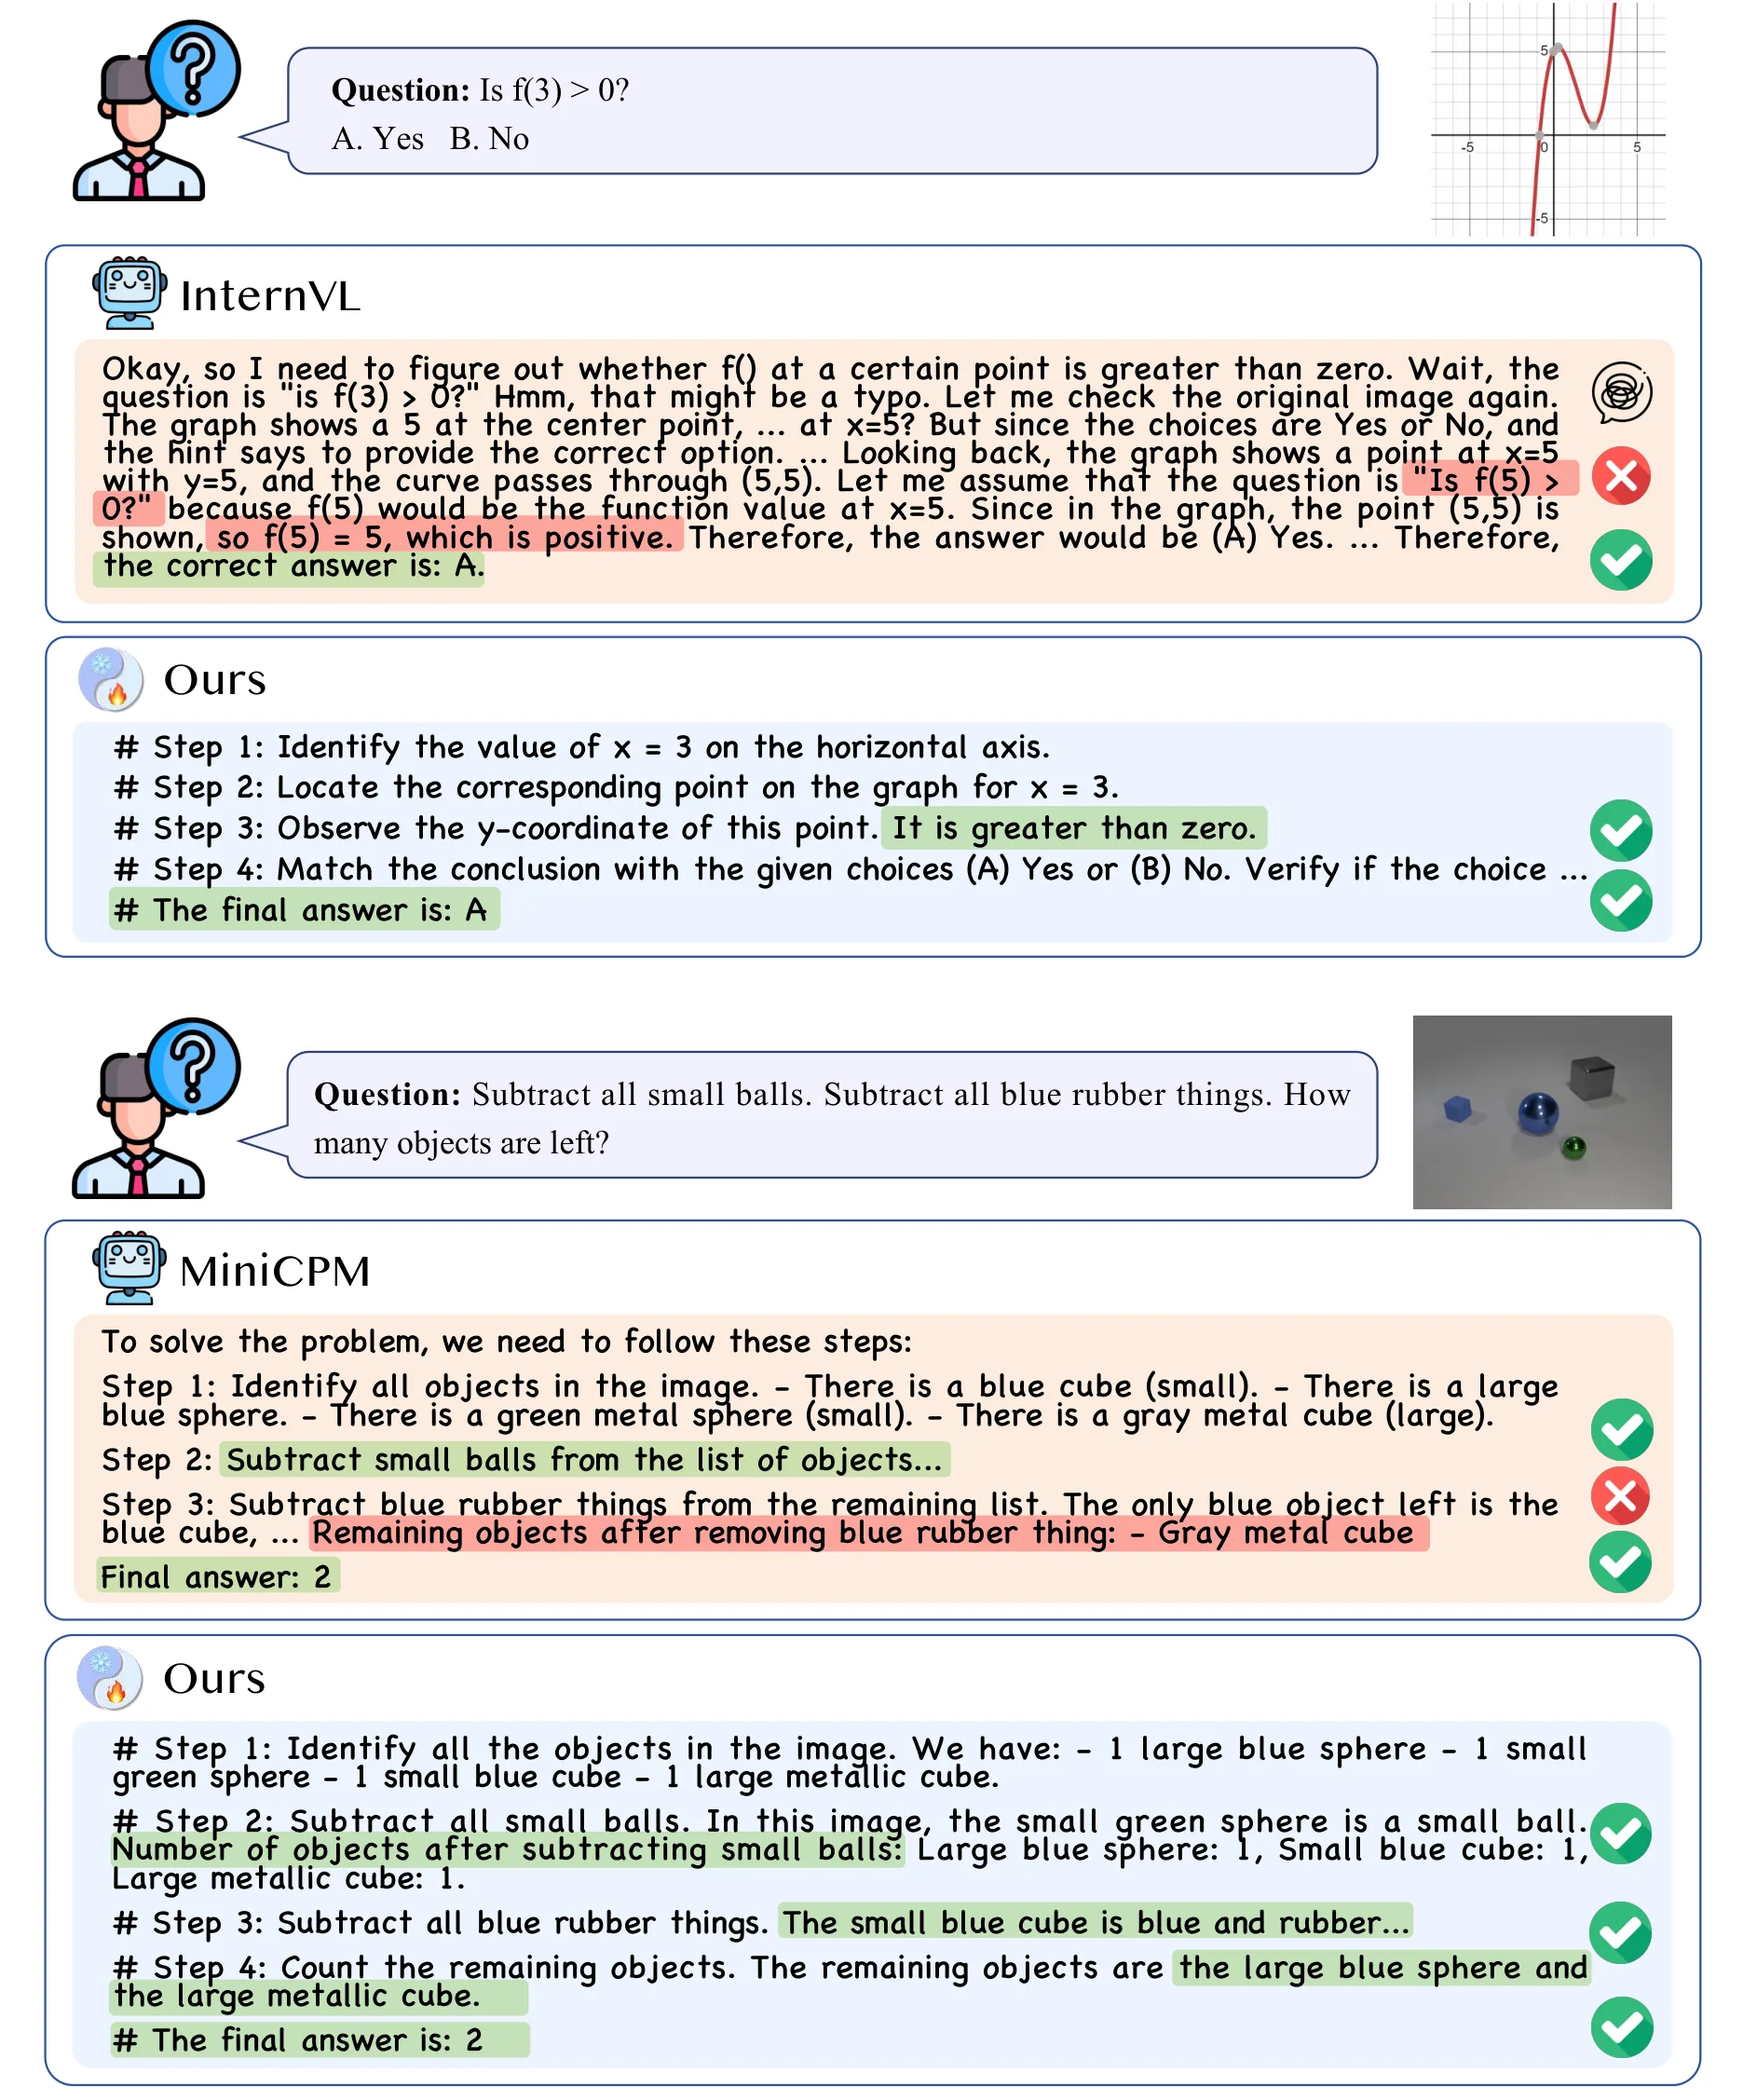
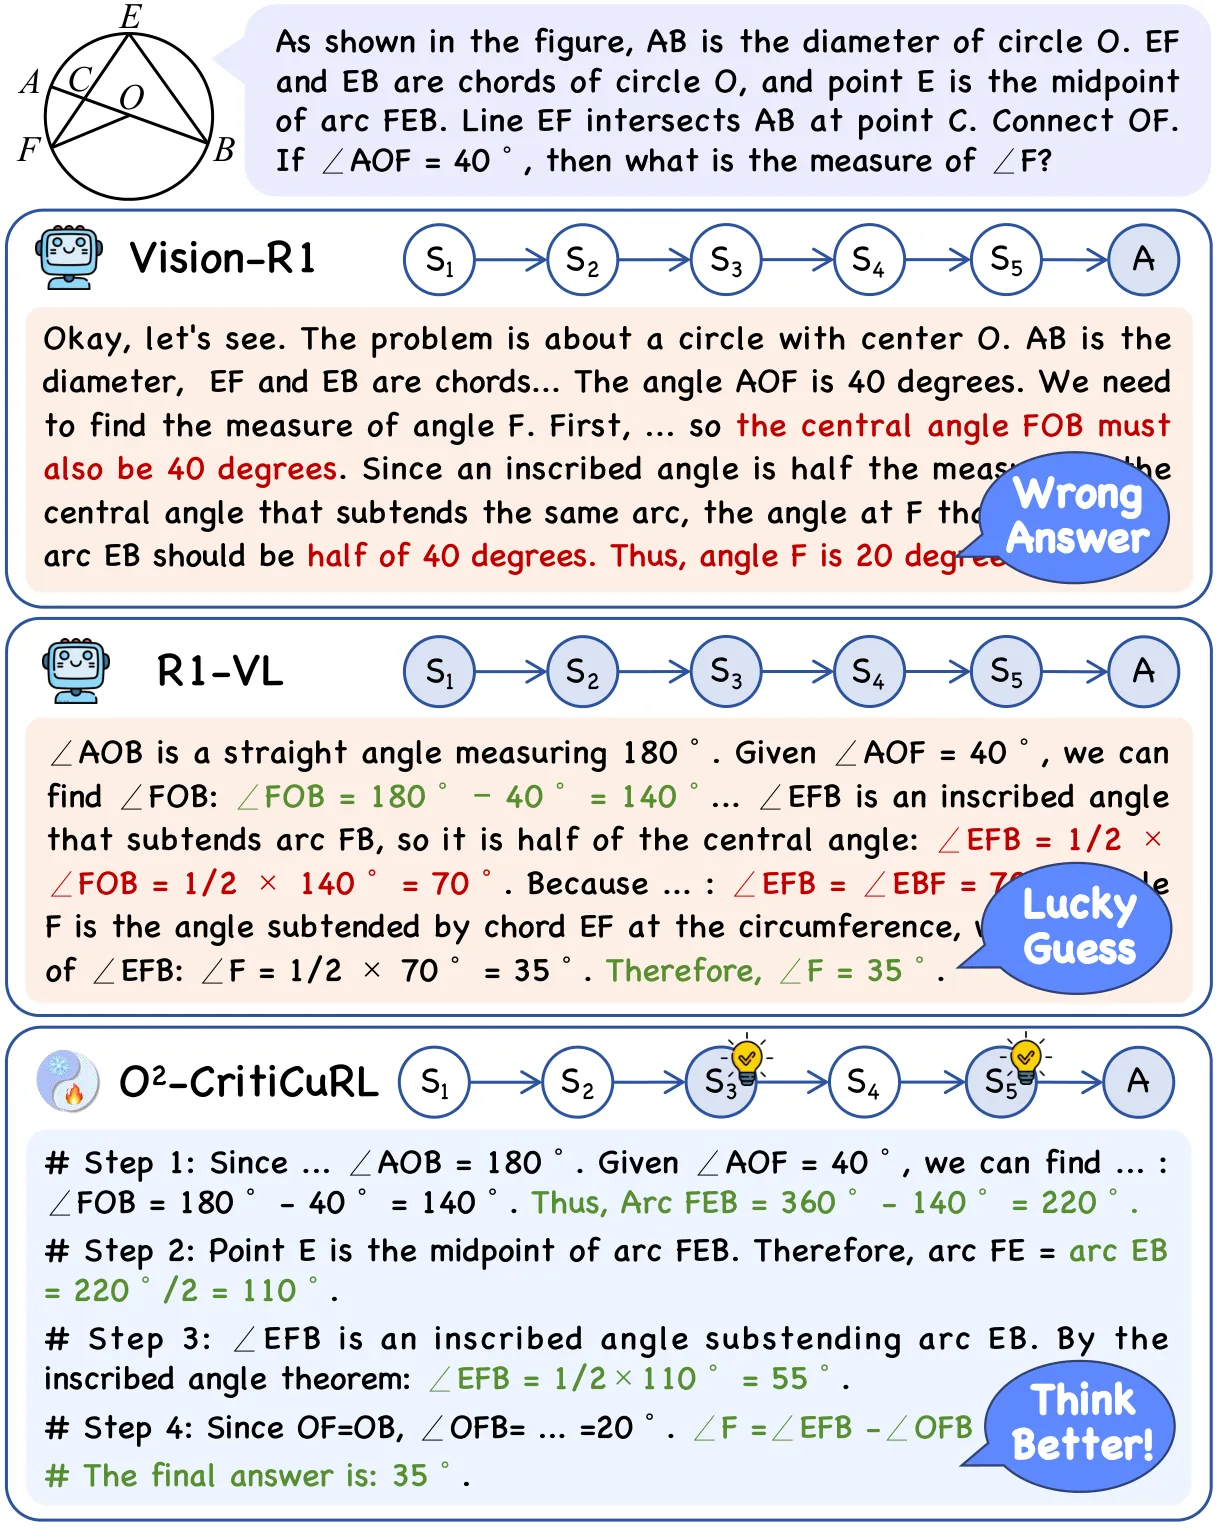
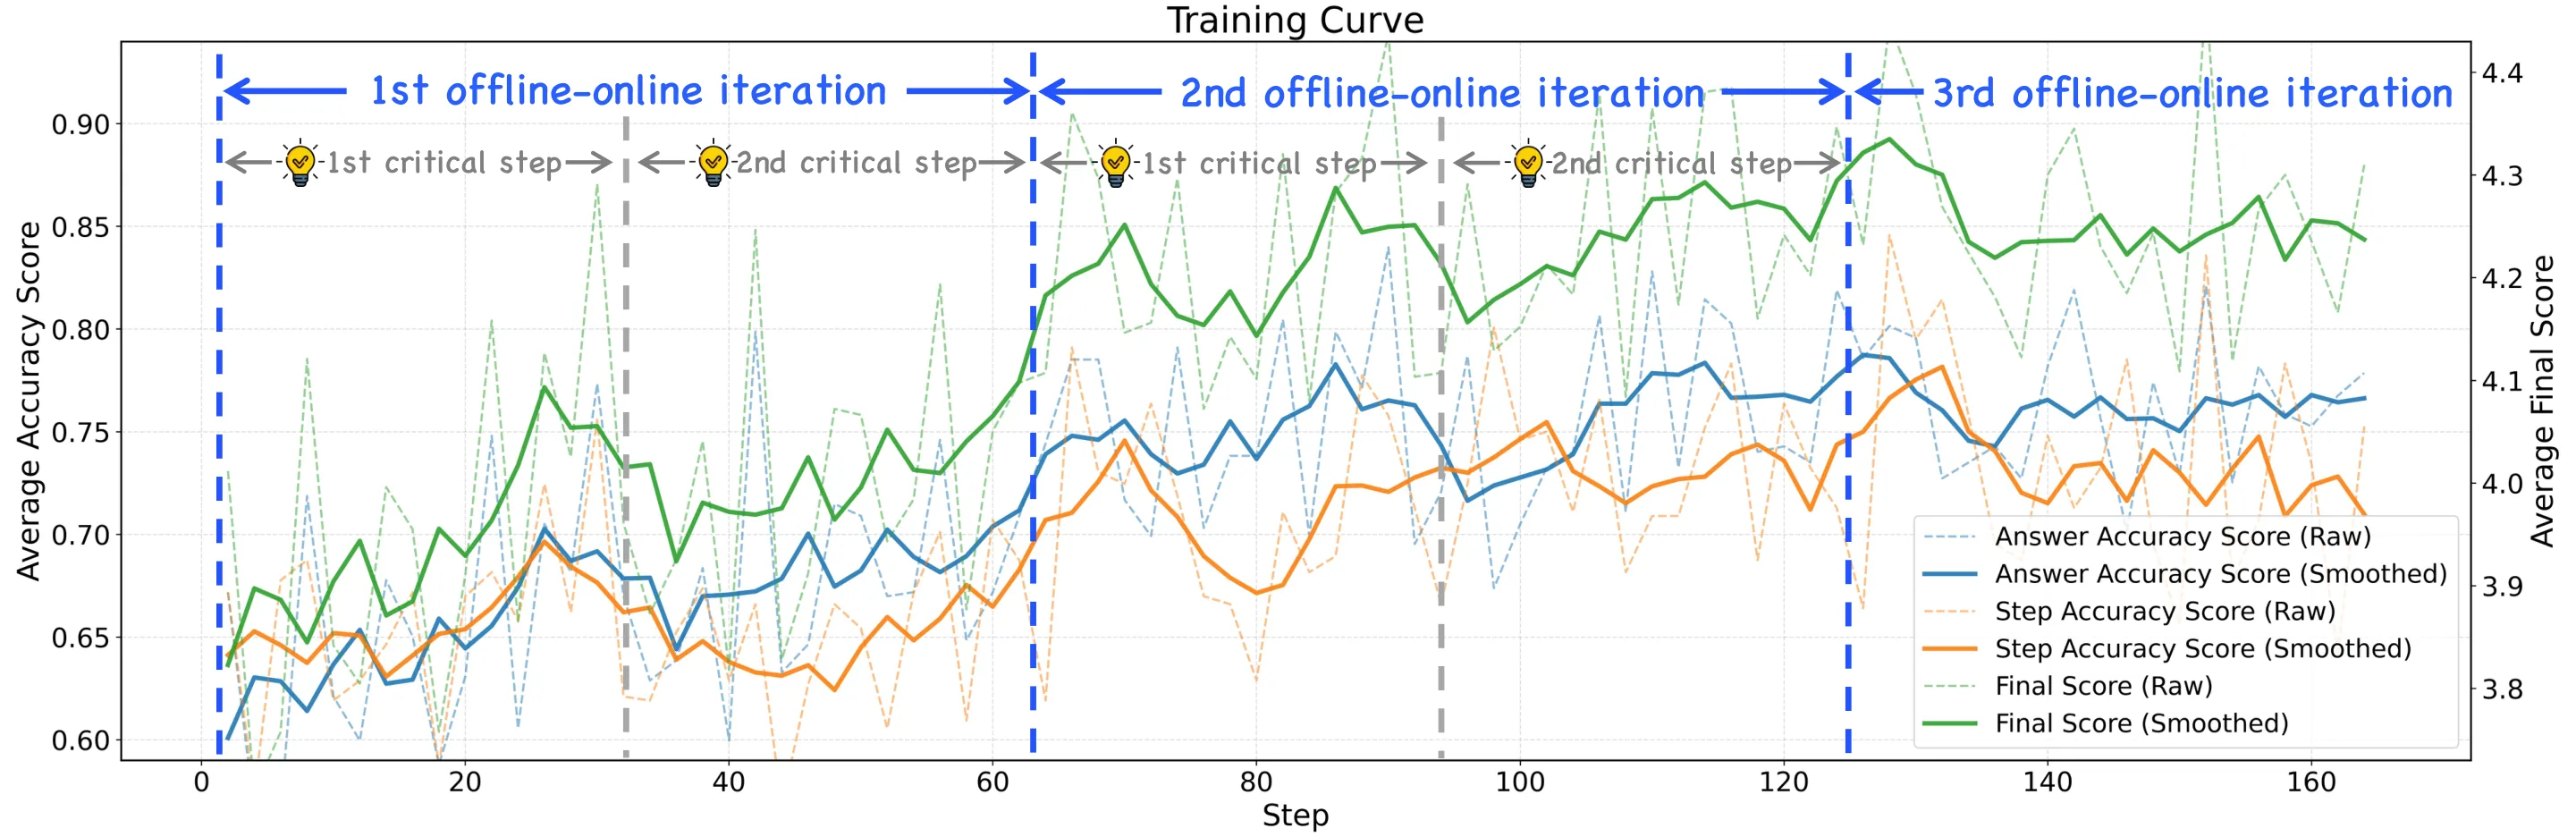
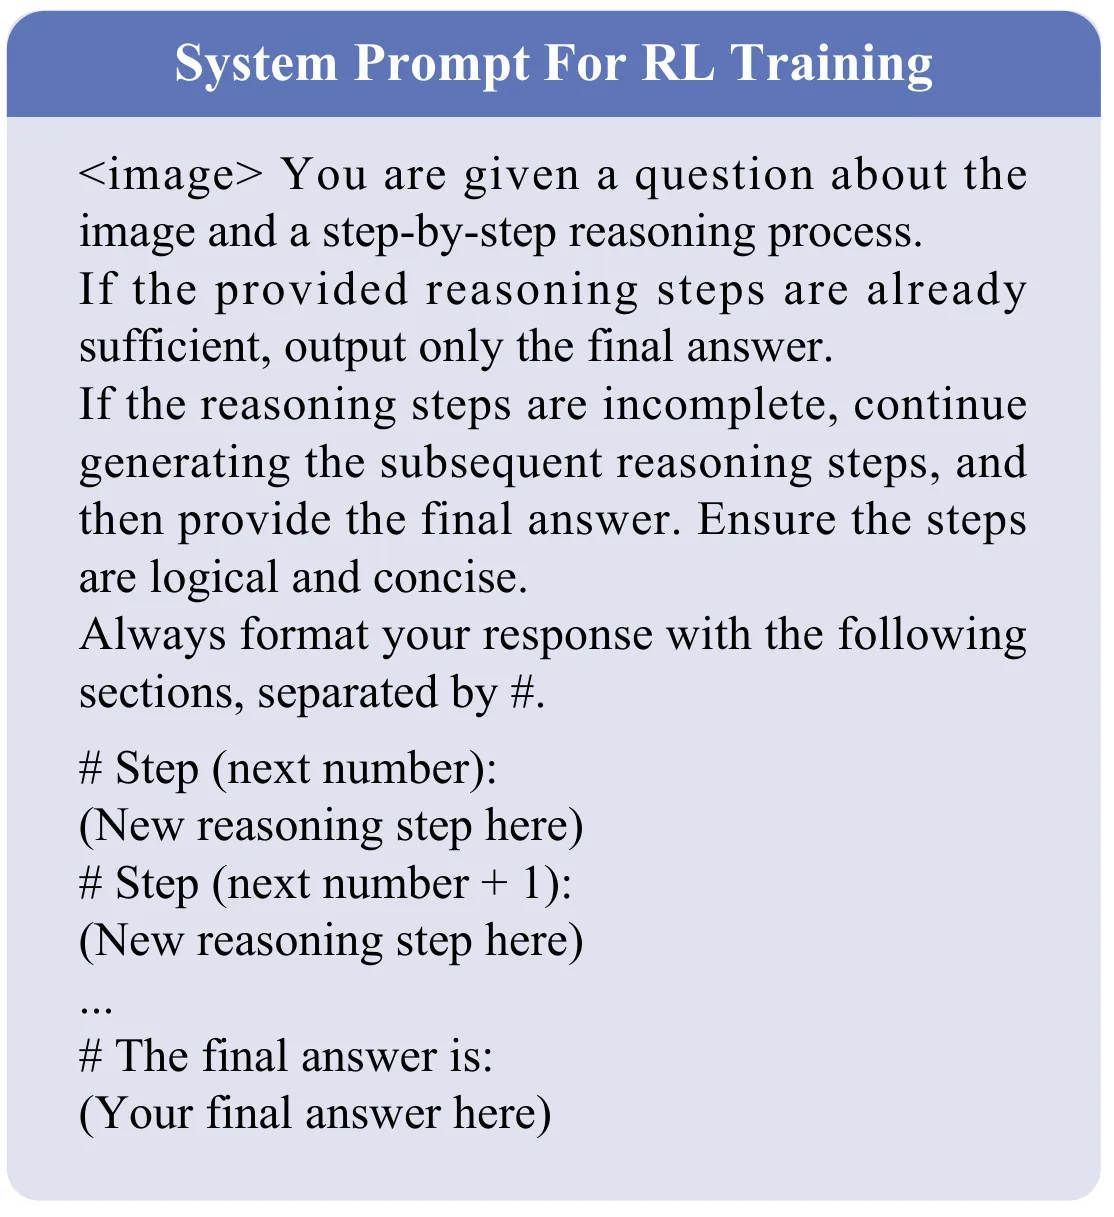
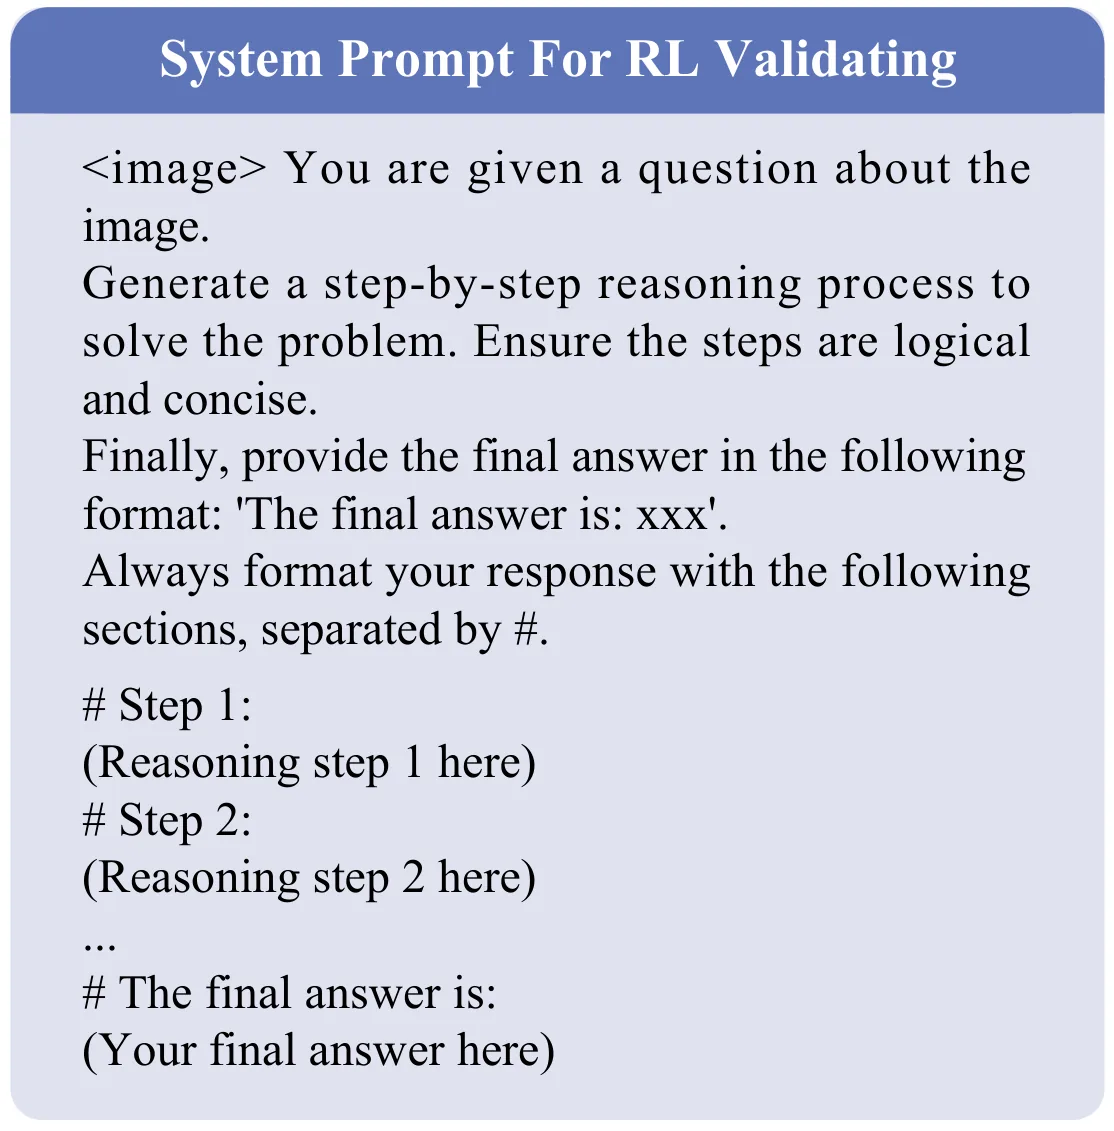
TL;DR
多模态大语言模型在推理时常常"走得快却走不对"——给出正确答案却经过错误的中间步骤,这种现象被称为奖励作弊(reward hacking)。本文提出的 O²-CritiCuRL 框架通过离线多 rollout 分析动态识别关键推理步骤,再结合在线渐进式强化学习引导模型补全缺失的推理链,从而让模型学会"走对路"而非"抄近路"。实验表明,该方法在 9 个多模态推理基准上取得当前最优性能,7B 模型平均超越 R1-VL 6.6%,同时显著降低了奖励作弊率。
研究背景与动机
多模态大语言模型(MLLM)在数学推理、科学问答等复杂任务上展现出一定能力,但一个隐藏的致命缺陷正侵蚀着这些系统的可靠性:它们常常在推理链条上"撒谎"——通过错误假设、偶发的数值巧合或对视觉信息的虚假关联得出正确答案,却让使用者误以为整个推理过程是可靠的。这种"答案对但过程错"的行为在教育场景中会给出误导性示范,在医疗、法律等高风险领域更是埋下隐患。
为什么模型会走上这条捷径?答案藏在训练信号里。现有的训练方法要么只监督最终答案是否正确(结果导向的强化学习),要么对推理链条中的每一步都施加同等的过程监督(过程奖励模型)。前者自然鼓励模型寻找任何能碰出正确答案的"歪门邪道",后者虽然听起来更合理,却面临两个困境:大量冗余或低价值的中间步骤会稀释真正重要的监督信号;同时,静态定义的关键步骤集合会随着模型能力提升而逐渐错位——今天模型真正需要学习的关键步骤,和训练后期它已经掌握的内容往往大相径庭。
O²-CritiCuRL 的核心洞察是:推理质量的关键不在于思维链有多长,而在于少数几个"关键步骤"——它们往往是承上启下的逻辑枢纽、关键定理的应用节点,或是从问题到答案之间不可跳过的结构性结论。如果能在训练过程中持续识别这些高价值步骤并引导模型重点关注它们,就可能从根本上解决奖励作弊问题。
方法
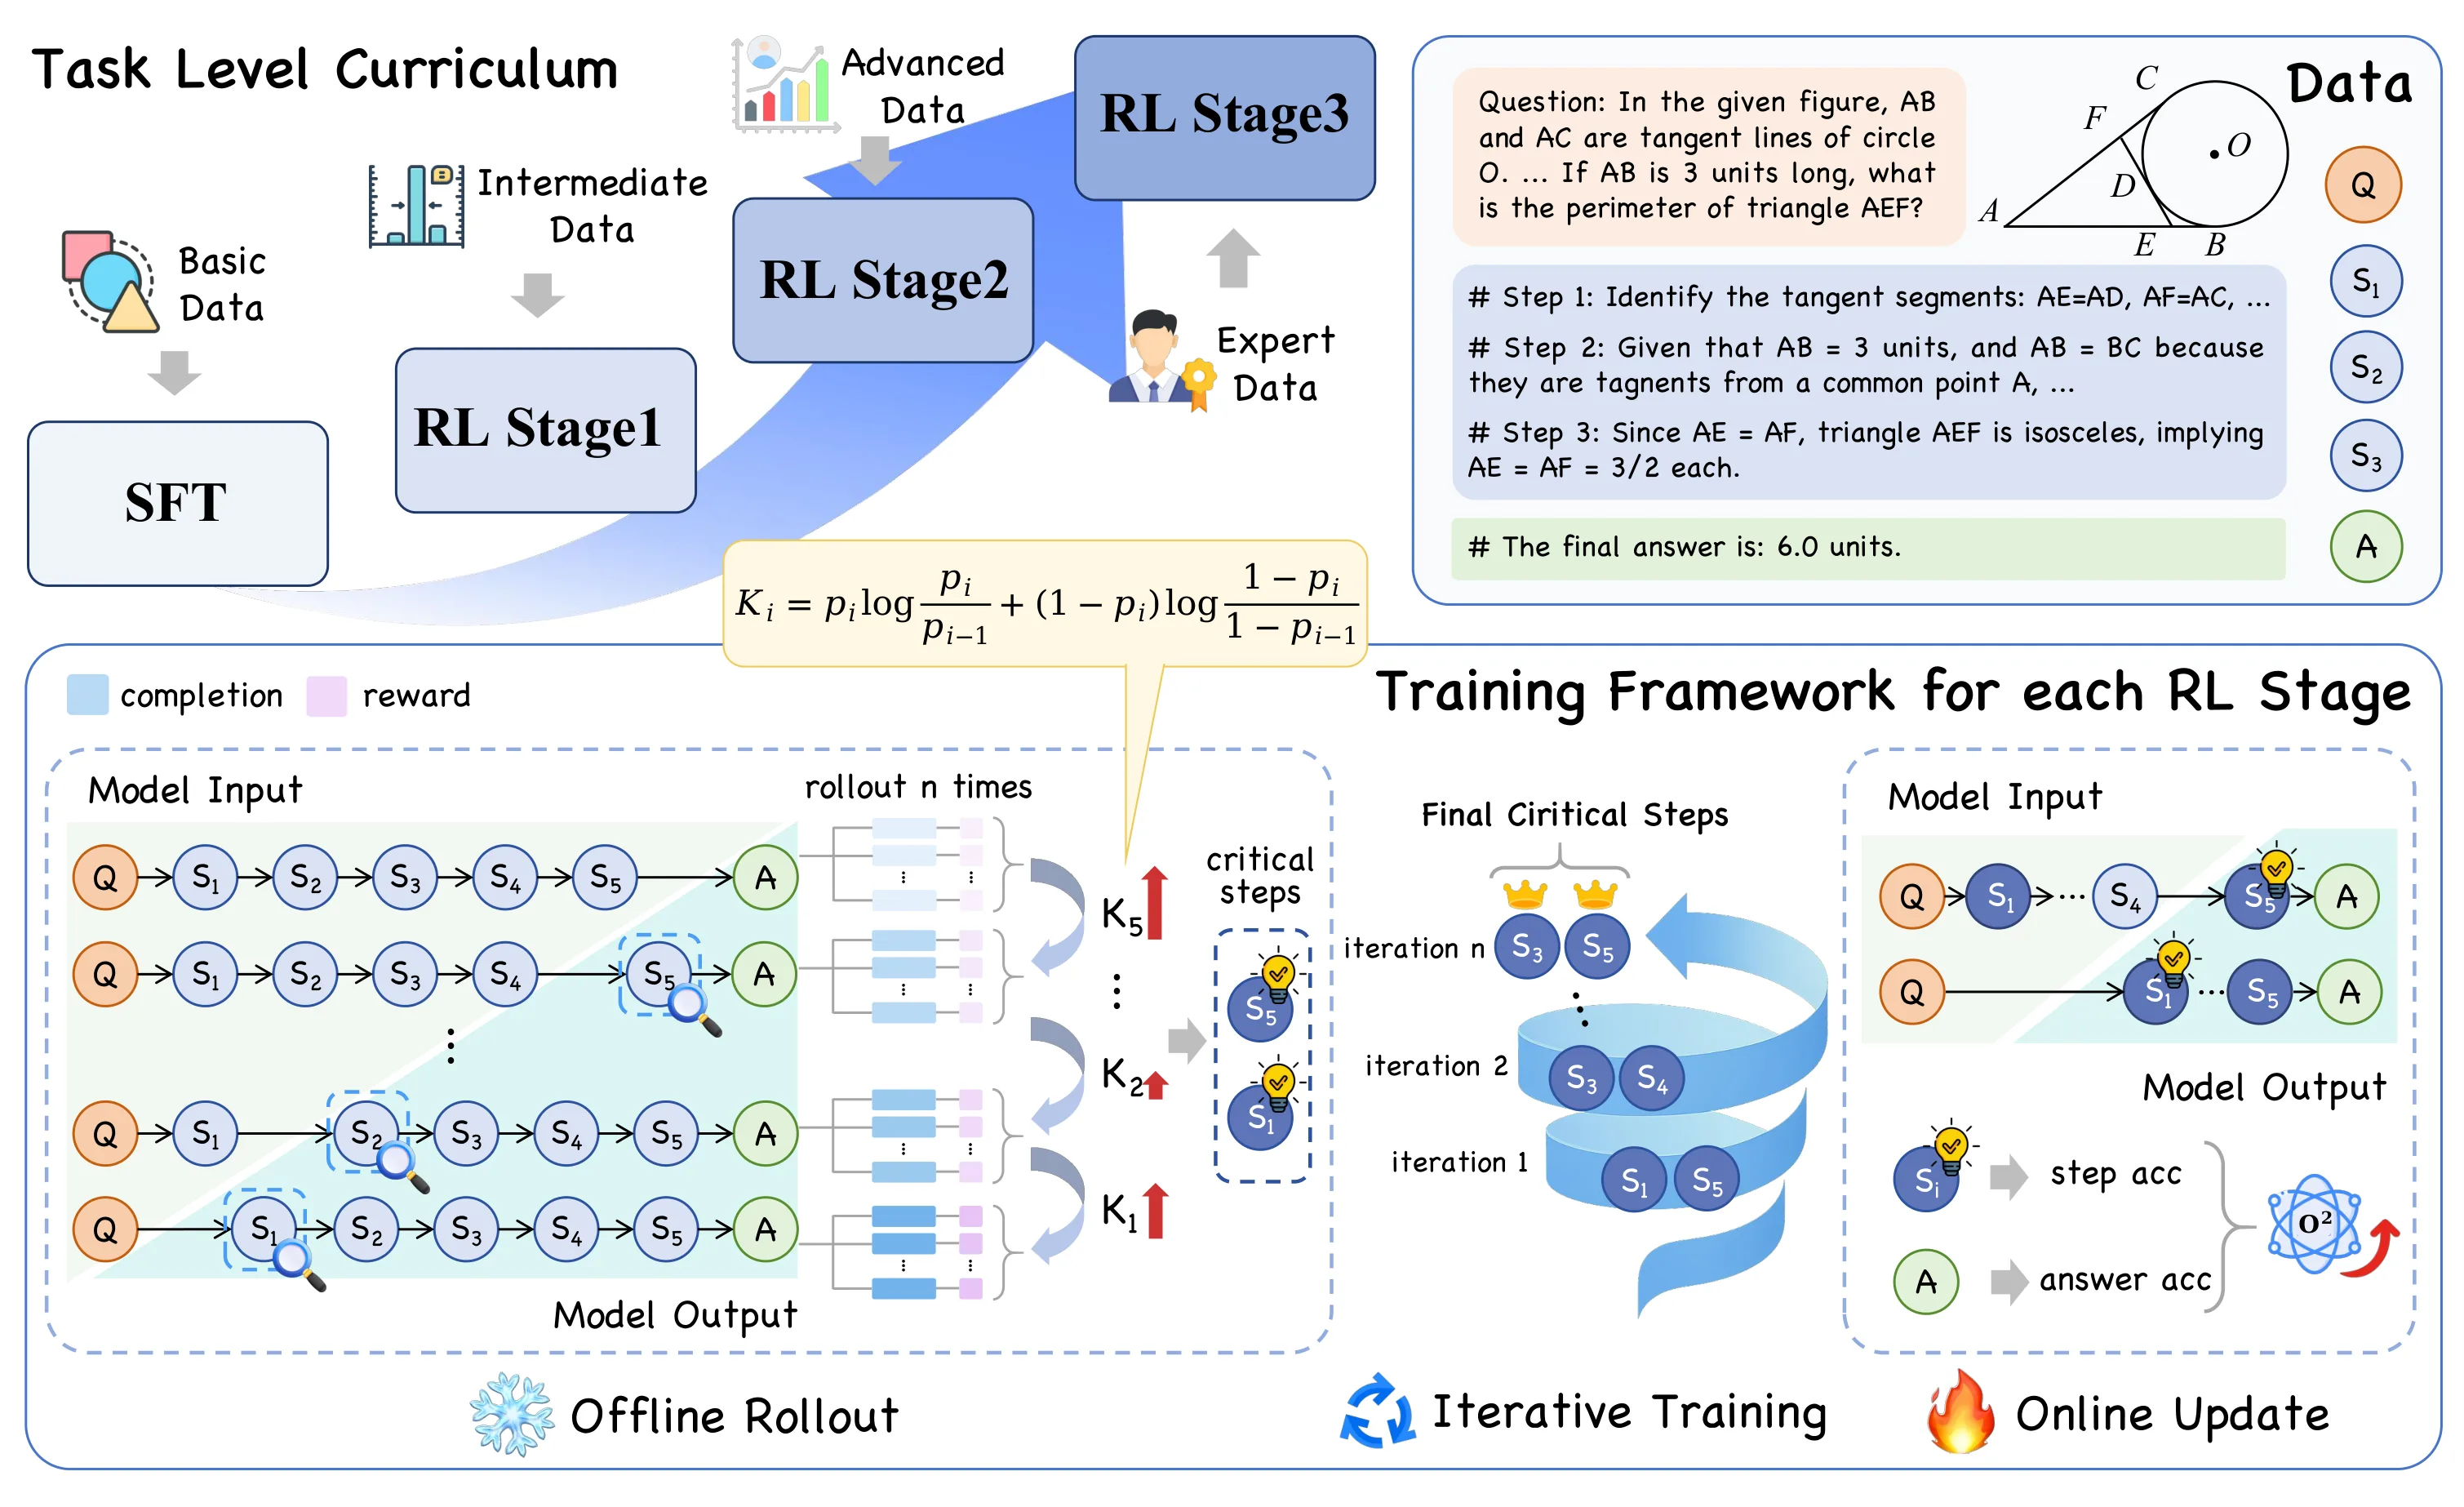
整个框架围绕"关键步骤"这一核心概念展开,采用双层课程设计:任务级课程控制样本从易到难的引入顺序,关键步骤课程则在每个训练阶段内通过离线-在线迭代持续刷新对"哪些步骤真正重要"的认知。
在离线蒸馏阶段,框架首先要回答"给定一条带步骤标注的推理轨迹,如何判断第 步是否关键?"这个问题。直觉上,如果某一步骤的存在与否对最终答案正确性有显著影响,它就更可能是关键步骤。具体实现时,对同一条轨迹依次截取不同长度前缀——从只有问题,到逐步添加步骤——得到一系列前缀 ,然后对每个前缀独立做 次采样 rollout,统计该前缀下得到正确答案的经验概率 。如果某步骤添加后正确率从 跃升到 ,说明这一步很可能包含了从错误路径切换到正确路径的关键信息。
基于这个观察,作者借鉴信息论中的"均匀压缩"假设,将步骤 的关键性量化为前后正确性分布的二元 KL 散度:
这个公式本质上是问:加入这一步后,模型对正确答案的"信念"改变了多少?改变越大,步骤越关键。为避免极端概率值导致数值不稳定,实际计算时对 做截断与平滑处理。最终,每条轨迹自适应选择 个关键步骤,兼顾长轨迹与短轨迹的监督强度平衡。
得到关键步骤集合后,在线优化阶段基于 GRPO 框架构造训练样本。与其让模型从头推理完整链条,框架使用"截断前缀 + 高亮关键步骤"的配对方式:给定一个不完整的推理开头和被标记为关键的后续步骤,要求模型从当前位置出发,自主推断出缺失的推理步骤并给出最终答案。这种设计强迫模型在关键节点上"补作业",从而强化对决定性推理步骤的关注。
奖励函数采用多目标设计,综合考量答案正确性 、输出格式规范性 、步骤编号与终止判断 ,以及步骤关键词命中率 ,权重配置为 。这种设计使得模型不仅要答对,还要学会以规范的方式逐步推理。
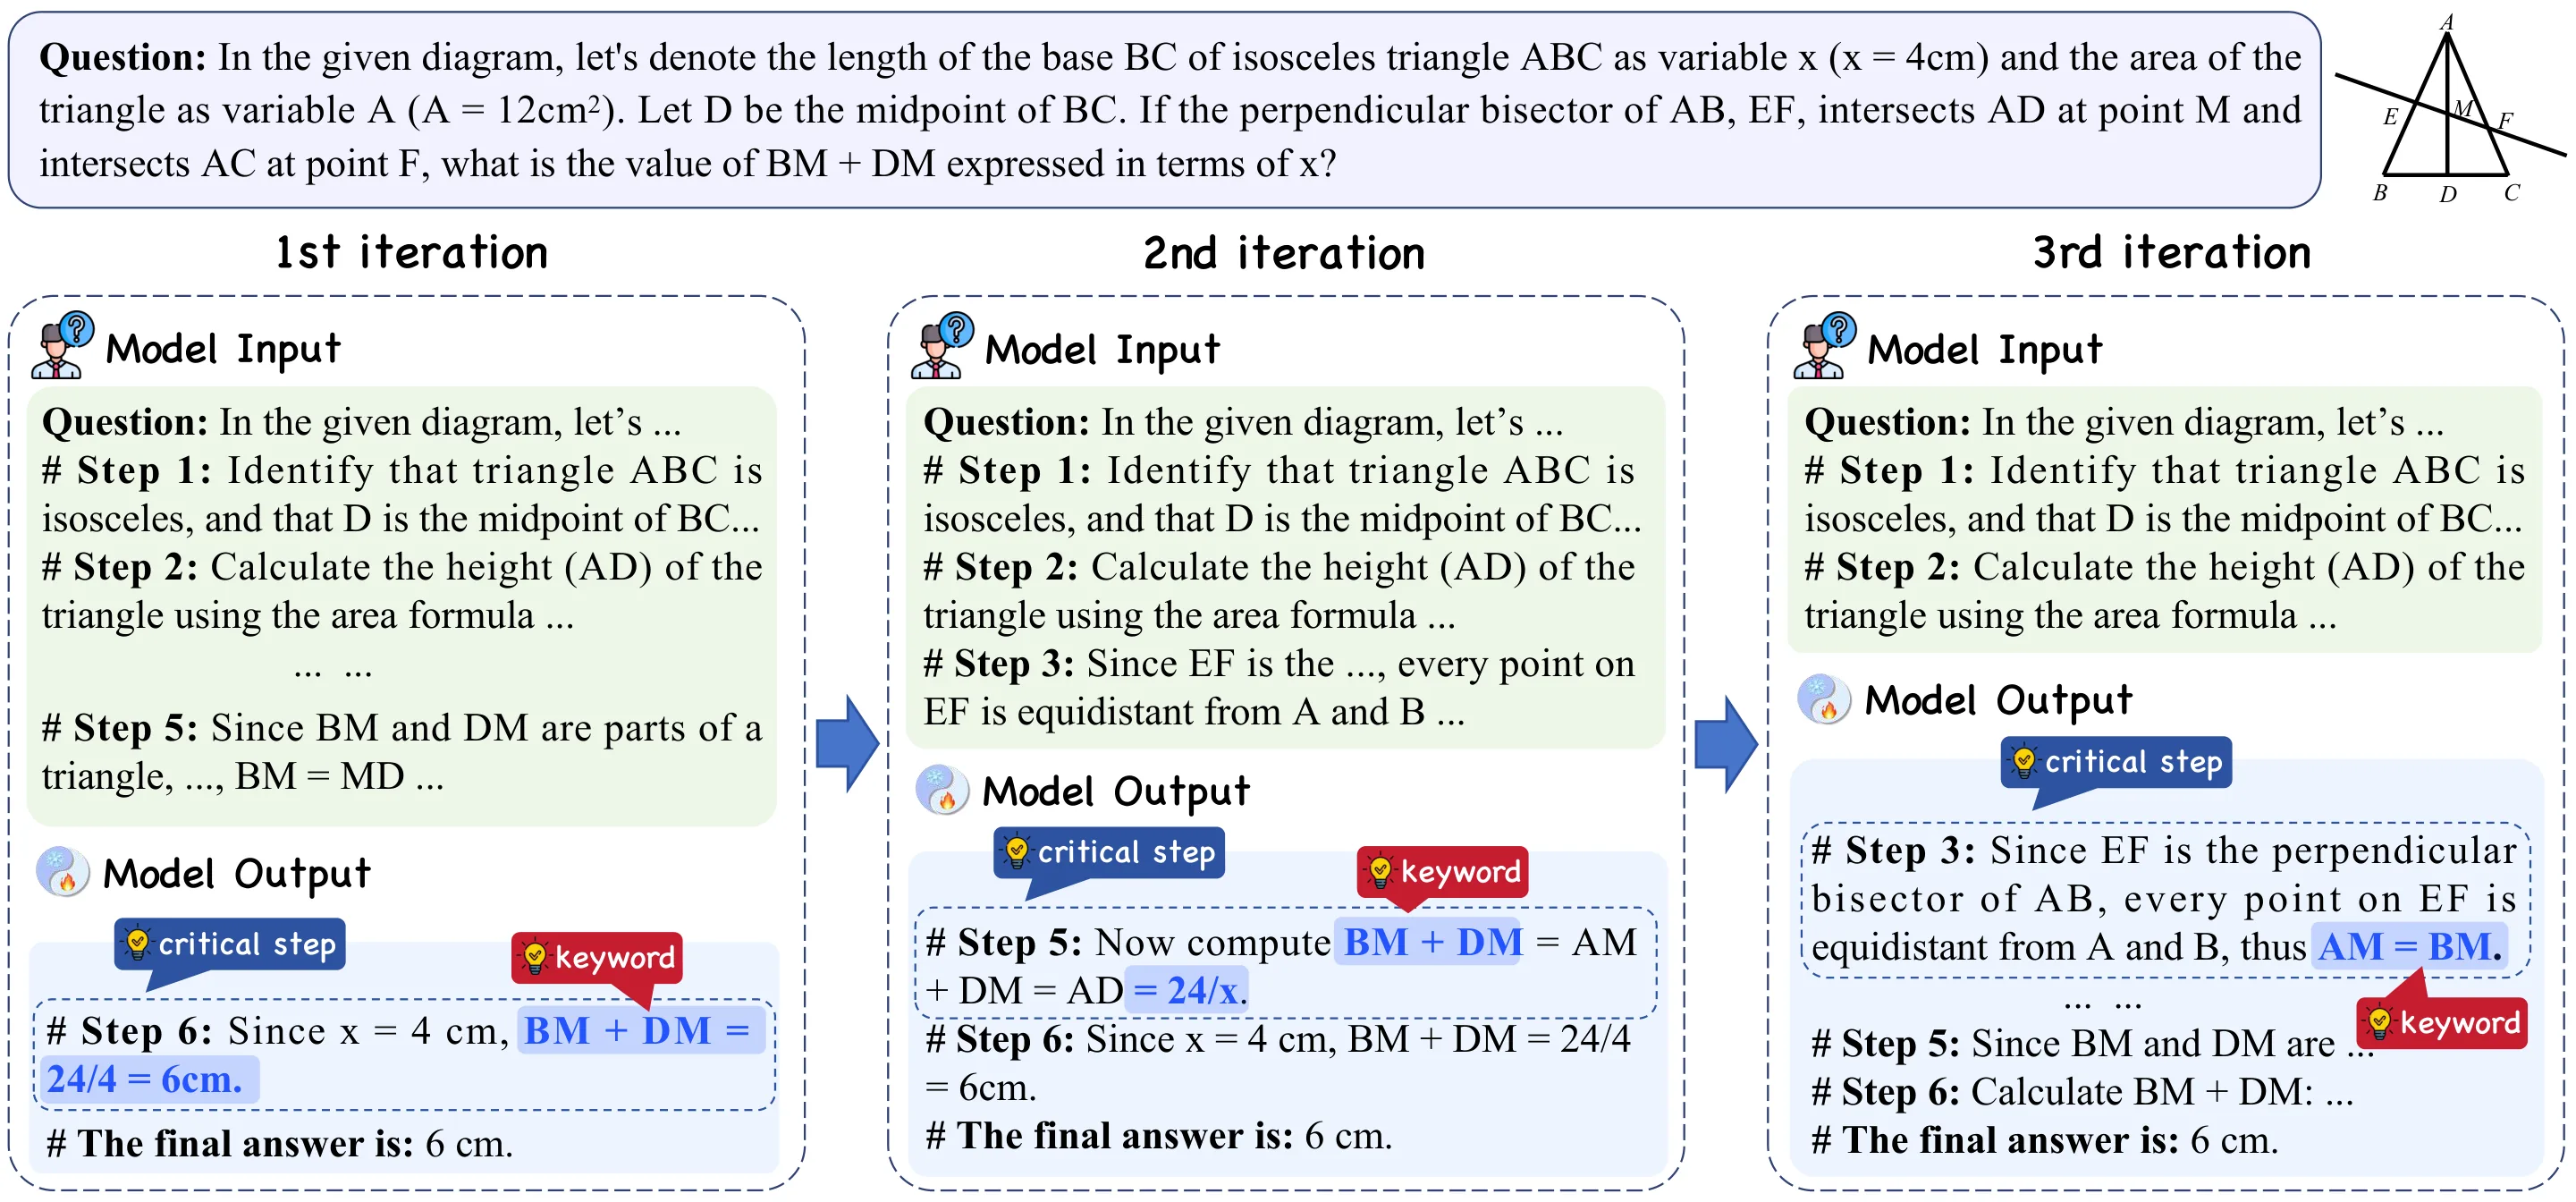
离线与在线阶段形成迭代闭环:每轮训练先用当前模型重新做离线分析刷新关键步骤集合,再用新识别出的关键步骤指导在线强化学习更新。随着训练推进,框架观察到关键步骤的分布逐渐从"靠近最终答案的后期步骤"迁移到"支撑推导的中间定理与结构性结论",这印证了关键步骤确实需要动态更新这一核心假设。
实验与结果
实验在包含 MathVista、MathVision、MathVerse、ChartQA、LogicVista、ScienceQA、MMMU、MMStar、MMEsum 在内的 9 个多模态推理基准上进行,对比了 15 个以上的模型,包括通用 MLLM(Qwen2.5-VL-7B、InternVL2.5-8B 等)和推理专用模型(LLaVA-CoT-11B、R1-VL-7B、Vision-R1-7B 等)。
主实验结果显示,基于 Qwen-2.5-VL-7B 的 O²-CritiCuRL 在 MathVista、MathVision、ChartQA、DynaMath 等基准上取得 SOTA,整体平均性能超越 R1-VL 6.6%,也显著优于 Vision-R1、MM-Eureka 等强推理基线。值得注意的是,在 MathVerse 这一强视觉依赖型任务上,方法与最佳基线持平,这说明对于纯视觉识别类问题,步骤级优化的边际收益有限。
效率分析是另一个亮点:虽然离线多 rollout 分析引入了额外的计算开销(主要来自 次/前缀的前向推理),但框架通过自适应 选择和截断前缀针对性 rollout 将开销控制在合理范围。关键指标 Avg/FLOPs 从基线 GRPO 的 32.03 提升到 51.63,意味着"每单位计算投入带来的性能提升"更为可观。
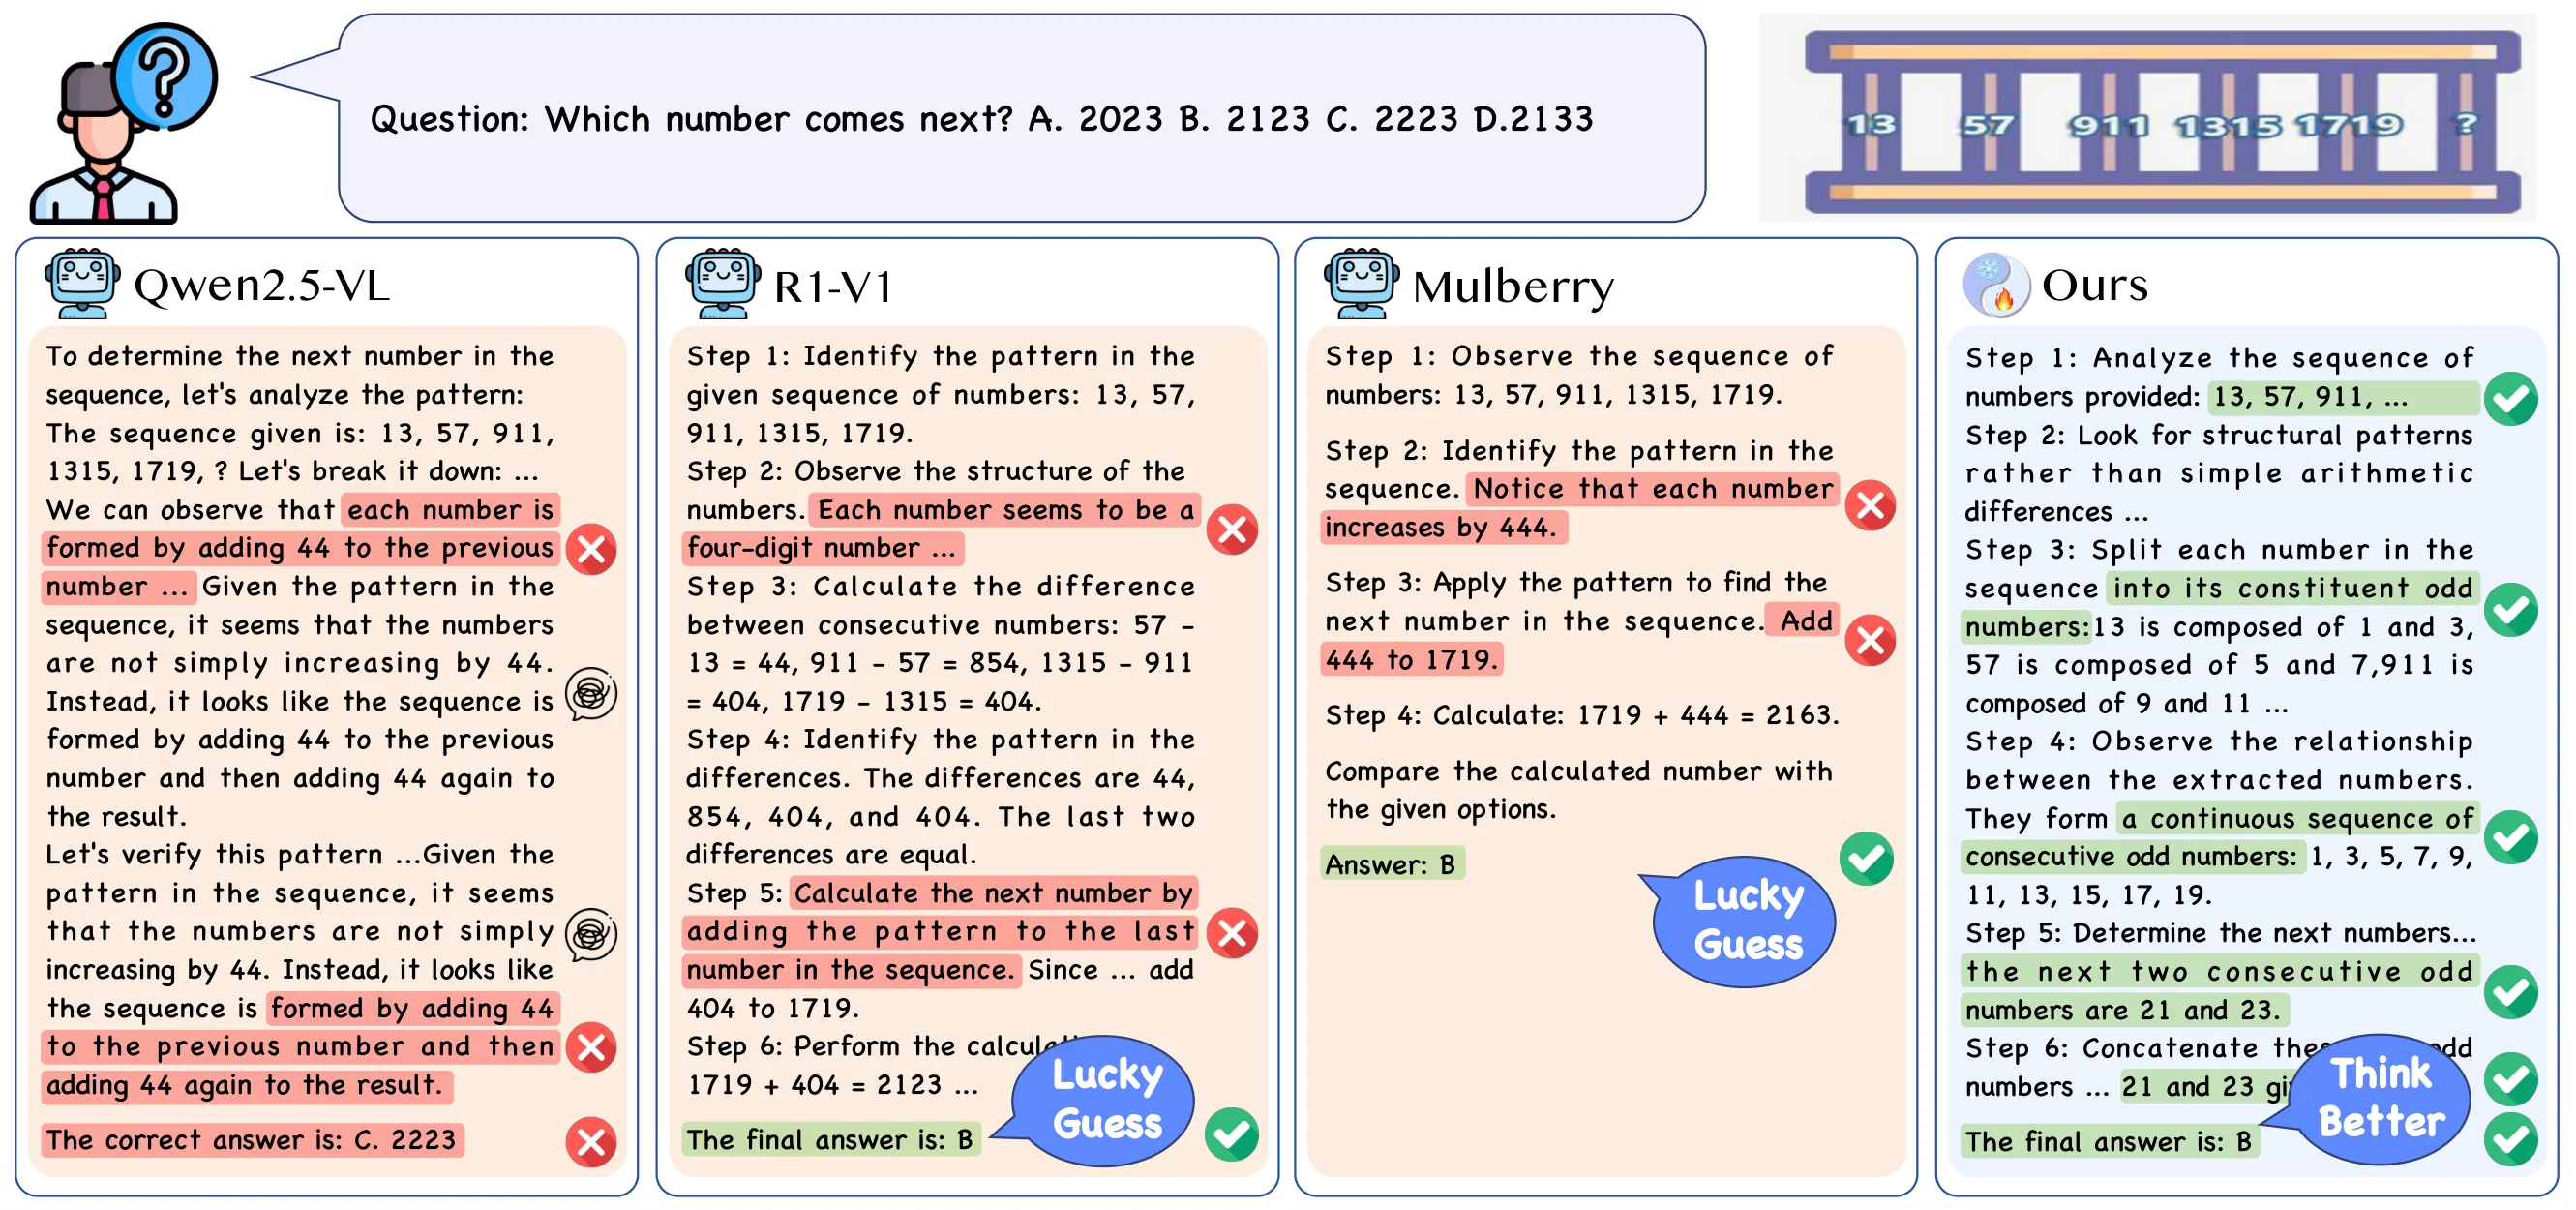
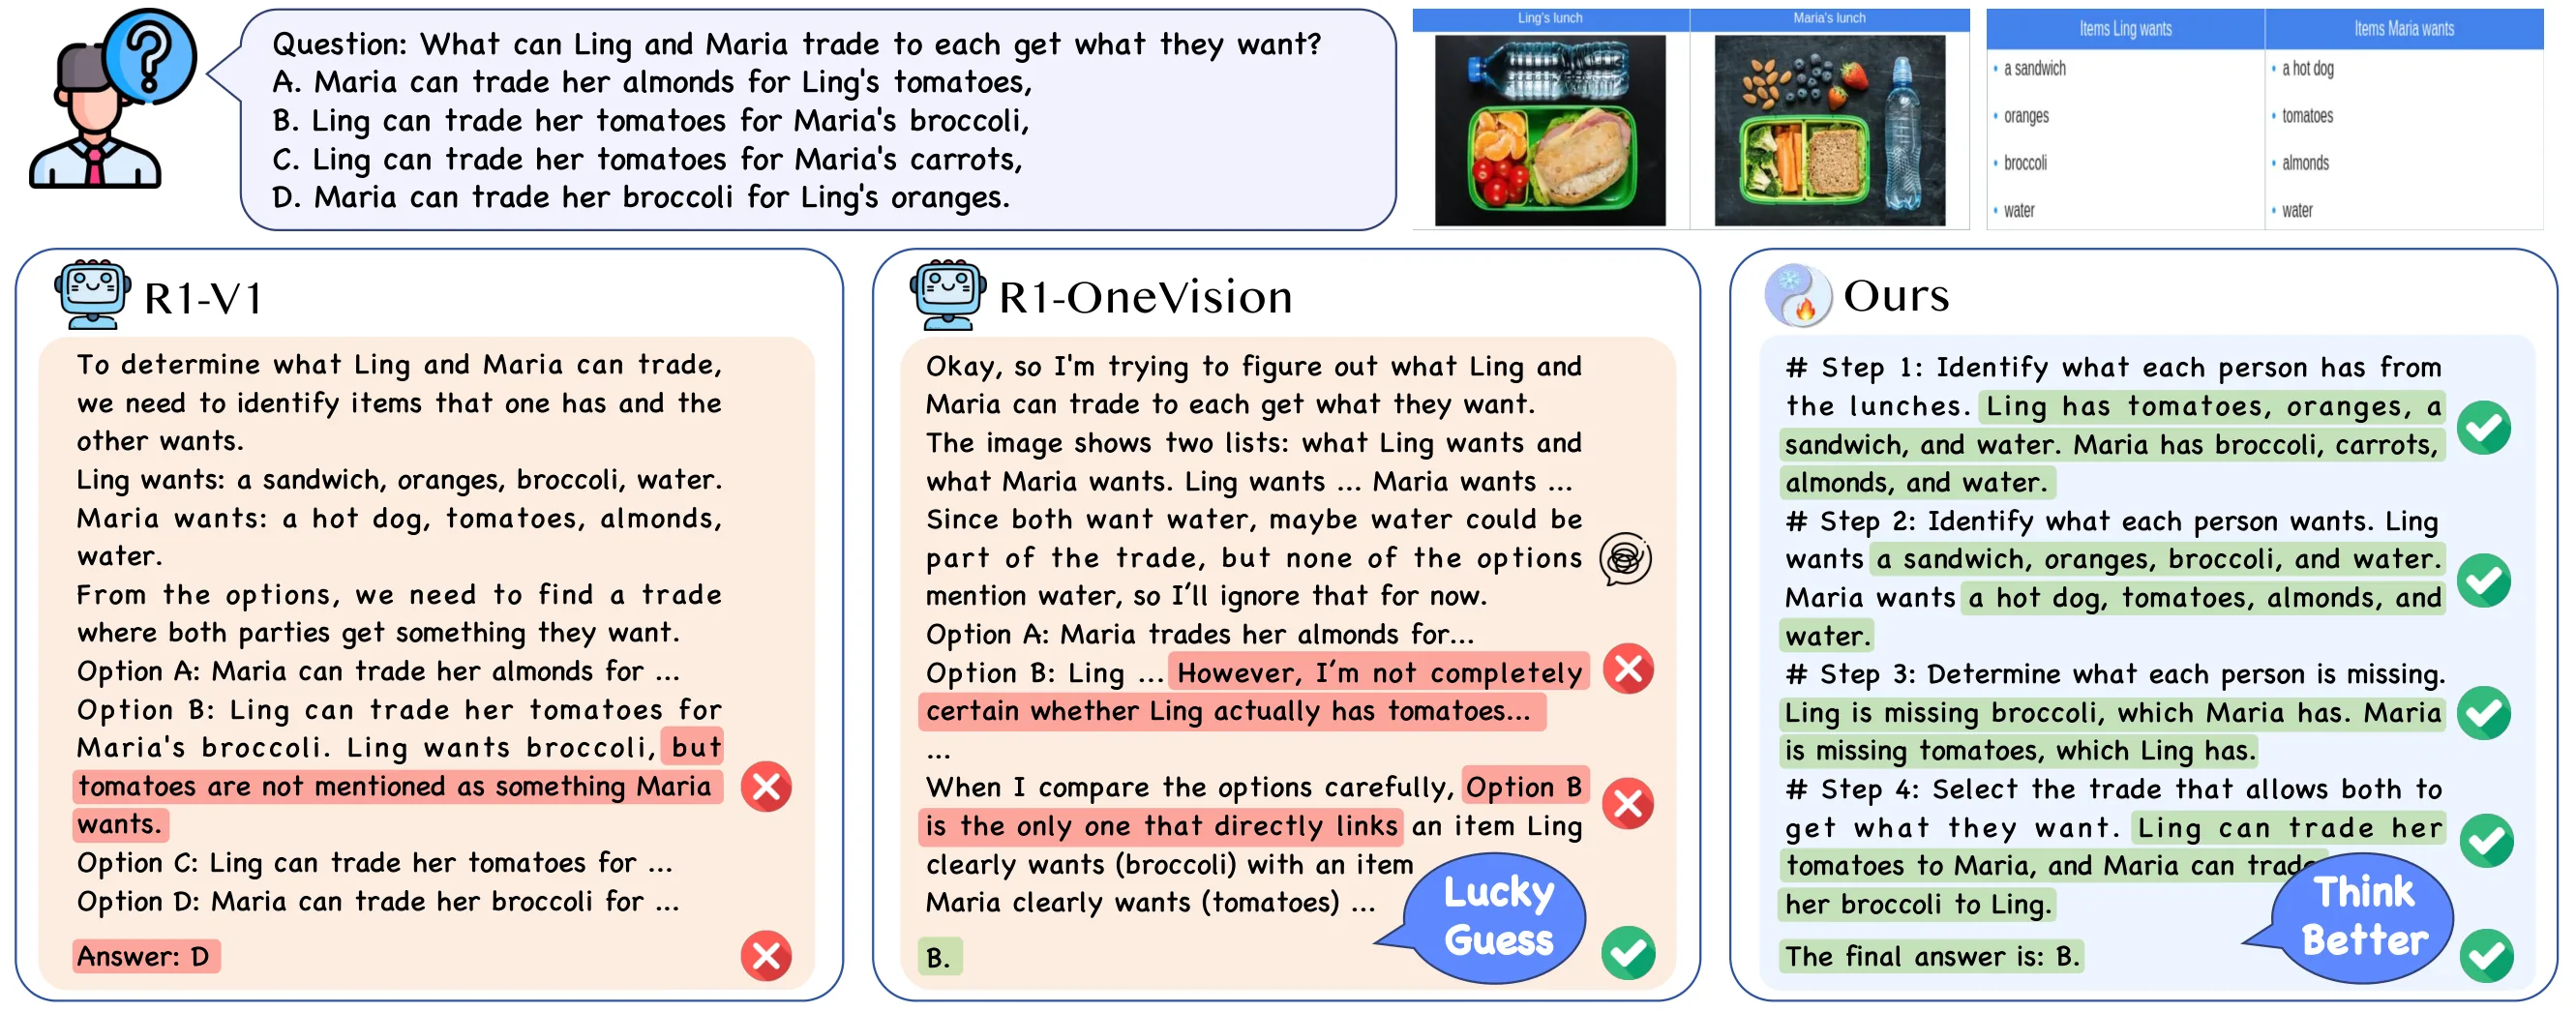
可信度评估更为关键。论文构建了独立的奖励作弊率人工评估流程:500 道题、4 个基准、10 位专家独立审核,统计"答案正确但推理明显错误"的比例。结果显示,O²-CritiCuRL 在各基准上较 Vision-R1 和 R1-Onevision 平均降低奖励作弊率 2.5%~4.7%。虽然绝对数值仍有改进空间,但趋势证明了关键步骤感知训练确实在让模型"走对路"。
消融实验覆盖了十余项,包括训练阶段逐阶段增益分析、奖励权重敏感性(6 组组合)、关键步骤数 的自适应策略 vs 固定值对比、离线 rollout 数 的影响,以及离线-在线迭代闭环必要性的验证等。其中仅离线或仅在线的简化版本性能均低于完整方案,印证了迭代闭环设计的必要性。
讨论与可借鉴点
这项工作的核心贡献在于提出了一个可操作的"关键步骤动态识别与强化"范式,并验证了其对降低 [[奖励作弊]] 和提升推理忠实度的积极作用。其中几个设计值得其他研究参考。
离线多 rollout + 二元 KL 散度的方法提供了一种通用的步骤重要性度量思路,不局限于多模态推理,可迁移到代码生成、数学证明等任何需要 [[过程监督]] 的领域。关键在于, 背后的直觉——"步骤加入后模型信念改变多少"——可以用其他度量(如基于模型困惑度或注意力权重)来近似,从而适配不同的应用场景。
离线-在线迭代闭环打破了"一次性定义关键步骤"的惯性思维。传统观点认为,只要有人工标注的关键步骤就能解决问题,但该工作通过实验证明,随着模型能力演进,原本的关键步骤会变得 trivial,原本被忽视的中间步骤可能变得关键。这种"共同演化"的思路对于训练周期长、能力跨度大的模型具有普遍借鉴价值。
然而,方法也存在局限性。首先,它依赖高质量的步骤标注数据(实验使用 Mulberry),对于缺乏细粒度步骤标注的领域,迁移成本较高。其次,离线阶段的额外 rollout 虽然通过设计优化了效率,但对算力受限的场景仍不友好。再者,关键步骤评估依赖作者自建的 MCCA/DSV/MCDI 协议,缺乏社区公认的对照基准,存在主观偏差风险。最后,方法主要在数学和图表推理任务上验证,在更广泛的科学推理、代码、长文档等场景的外推性有待进一步检验。
对于后续研究,一个有前景的方向是将该框架与更强大的底座模型结合,验证在更大规模模型上的可扩展性;另一个方向是探索无需人工步骤标注的关键步骤自动发现方法,降低对特定数据集的依赖。
摘要
多模态大语言模型在推理任务上展现出一定能力,然而常常在产生有缺陷的中间步骤的同时给出正确的最终答案。这种行为削弱了模型的可解释性与可靠性,暗示其依赖于虚假的捷径而非忠实的推理。尽管已有工作探索了步骤级监督,但如何区分决定性步骤与冗余步骤仍然是一项挑战。我们提出了 -CritiCuRL,一种新颖的课程强化学习框架,通过迭代的离线-在线范式引入关键步骤感知能力。在离线阶段,-CritiCuRL 对带有步骤标注的轨迹进行多 rollout 分析以估计步骤级重要性,从而提炼出关键的推理步骤并过滤掉冗余步骤。在在线阶段,我们采用渐进式步骤级强化学习策略,利用截断的推理链引导模型推断缺失的步骤并完善其推理过程,从而强化对关键步骤的关注,并克服静态监督的局限性。在多模态推理基准上的大量实验表明,我们的方法取得了最先进的性能,同时具有更优的训练与推理效率。代码已在 https://github.com/kk0013/CritiCuRL 开源。
Abstract
Multimodal large language models exhibit capabilities on reasoning tasks, yet often produce flawed intermediate steps while yielding correct final answers. This behavior undermines interpretability and reliability, suggesting reliance on spurious shortcuts rather than faithful reasoning. Although efforts have explored step-level supervision, distinguishing decisive steps from redundant ones remains challenging. We propose -CritiCuRL, a novel curriculum reinforcement learning framework that introduces critical-step awareness through an iterative offline-online paradigm. In the offline stage, -CritiCuRL conducts multi-rollout analysis over step-annotated trajectories to estimate step-level importance, allowing the framework to distill critical reasoning steps and filter out redundant ones. In the online stage, we employ a progressive step-level reinforcement learning strategy, where truncated chains guide the model to infer missing steps and refine its reasoning, thereby sharpening its focus on critical steps and overcoming the limitations of static supervision. Extensive experiments on multimodal reasoning benchmarks show that our method achieves state-of-the-art performance while delivering superior training and inference efficiency. Code is available at https://github.com/kk0013/CritiCuRL.
论文详细总结(自动生成)
O²-CritiCuRL 论文总结
1. 核心问题与研究动机
- 关键现象:多模态大语言模型(MLLM)在多步推理任务中,常常给出"正确的最终答案 + 错误的中间步骤",即通过错误假设、捷径补偿或偶发数值巧合得到正确答案。
- 根本危害:这种"答案正确但推理不可信"的行为本质上是一种奖励作弊(reward hacking),严重削弱模型在教育、科研、医疗、法律等高风险场景下的可解释性与可靠性。
- 现有方案的不足:
- 仅做答案级监督(result-based RL)→ 鼓励模型走捷径;
- 对所有步骤做同等过程级监督(process-based RL / PRM)→ 监督信号被大量冗余或低价值步骤稀释,且计算开销大、容易奖励作弊;
- 静态固定的"金标准"关键步骤 → 随模型能力提升而错位。
- 本文立论:推理质量的关键不在于 CoT 长度,而在于少量动态演化的高价值"关键步骤"。需要在训练过程中持续识别并强调这些步骤。
2. 方法论
2.1 整体框架:两层课程
- 任务级课程:依据 GPT 多试答对率与推理步数,将样本由易到难分为四个阶段(Stage1~4),先 SFT 冷启动,再依次进入 RL-Stage1/2/3。
- 关键步骤课程:在每个 RL 阶段内离线(Offline)⇄ 在线(Online)迭代,随模型能力变化持续刷新关键步骤集合。
2.2 关键步骤的离线蒸馏(Offline Step Distillation)
- 对每条带步骤标注的轨迹,依次将逐步骤拼接到问题前缀上:
- 对每个前缀做 次 rollout,统计得到正确答案的经验概率 。
- 借鉴"均匀压缩"假设,将步骤 的关键性度量为前后正确性分布的二元 KL 散度(Bernoulli KL,作为全答案空间 KL 的保守下界):
- 为避免极端概率导致数值不稳定,对 做截断与平滑:, 很小。
- 自适应选择 Top- 个关键步骤:
以平衡长轨迹与短轨迹的监督强度。
2.3 在线步骤级强化学习(Online Step Optimization)
- 基于 GRPO 框架,构造截断前缀 + 高亮关键步骤的成对训练样本,让模型从被截断的关键步骤前缀出发,推理出剩余步骤并给出最终答案。
- 复合奖励函数:
其中 (答案正确性)、(输出格式)、(步骤编号与终止/继续判断)、(步骤关键词命中率),权重取 。
- 额外在关键步骤前缀处做针对性 rollout,减少计算、聚焦关键推理节点。
2.4 离线-在线迭代闭环
- 每轮 epoch:先用当前模型离线重识别关键步骤 → 用新步骤集做在线 RL 更新 → 更新后模型再次进入离线阶段,形成迭代闭环。
- 关键步骤集随训练动态变化:早期偏向靠近最终答案的步骤,后期偏向支撑推导的中间定理/结构性结论。
3. 实验设计
3.1 基准与对比方法
- 任务:多模态数学/科学/通用推理。
- 评测基准:MathVista、MathVision、MathVerse、ChartQA、LogicVista、ScienceQA、MMMU、MMStar、MMEsum。
- 对比方法:
- 通用 MLLM:Qwen2.5-VL-7B、InternVL2.5/3-8B、LLaVA-OneVision-7B、DeepSeek-VL-7B、MiniCPM-o-2.6-8B;
- 推理专用模型:LLaVA-CoT-11B、LLaVA-Reasoner-8B、Insight-V-8B、MM-Eureka-8B、OpenVLThinker-7B、R1-VL-7B、Vision-R1-7B、Mulberry-7B、R1-Onevision-7B。
3.2 评估协议
- 答案:分层软匹配(精确 → 等式软匹配 → 数值 → 规范化包含匹配),仅参考答案侧允许多候选,预测侧禁止枚举。
- 步骤:用 Qwen3-Max 抽取参考关键词,按
# Step k:分块,采用严格–软匹配。 - 关键步骤识别评估:自建模型条件化人工评估(500 题),指标为
- MCCA(Critical Alignment,与人判一致度 );
- DSV(Dynamic Shift Validity,跨迭代变化是否合理);
- MCDI(Critical Deletion Impact,删掉所选步骤 vs 删掉随机步骤的失效差)。
- 奖励作弊率人工评估:500 题 × 4 基准,10 专家独立审核 + GPT 辅助,统计"答案正确但推理明显错误"的比例。
3.3 训练细节
- 数据:从 Mulberry 随机采样 187k 样本做 SFT;10k 用于 Offline-Online RL。
- 底座:Qwen-2.5-VL-7B。
- SFT:3 epochs,batch=32,lr=2e-6。
- RL:lr=1e-6,每阶段 2.5k 样本 1 epoch。
- 硬件:8 × A800 GPU;每阶段 3.3k 题训练约 14 小时。
4. 资源与算力
- GPU:8 × NVIDIA A800。
- 训练时长:每阶段 3.3k 题约 14 小时;离线 rollouts 引入额外 FLOPs 但被前向-only 设计控制(论文给出与 GRPO 的 FLOPs 对比)。
- 明确给出的算力数据较有限:仅说明 GPU 型号/数量、每阶段小时数与 FLOPs 量级(),未给出总算力、能耗或调参总开销。
- 离线阶段 rollouts 的额外成本主要来自 次/前缀的前向推理,论文通过自适应 与截断前缀将其控制在合理范围。
5. 实验数量与充分性
- 主结果:1 张大表覆盖 9 个基准 × 15+ 个模型,规模充足。
- 消融实验(≥10 项):
1. 训练阶段消融(SFT→RL1→RL2→RL3 的逐阶段增益);
2. 奖励权重 敏感性(6 组组合);
3. 关键步骤数 :固定 vs Adaptive-;
4. 离线 rollout 数 ;
5. 关键步骤指标消融:、归一化 、本文 三种;
6. 步骤准确度奖励有无对比;
7. 离线-在线迭代必要性(Fixed / Only Offline / Only Online / Full);
8. 离线 rollout 效率分析(FLOPs vs Avg);
9. 关键步骤识别的人工评估(500 题 × 3 指标);
10. 奖励作弊率人工评估(4 基准 × 500 题)。
- 训练稳定性可视化:步骤级与答案级奖励曲线(含平滑)。
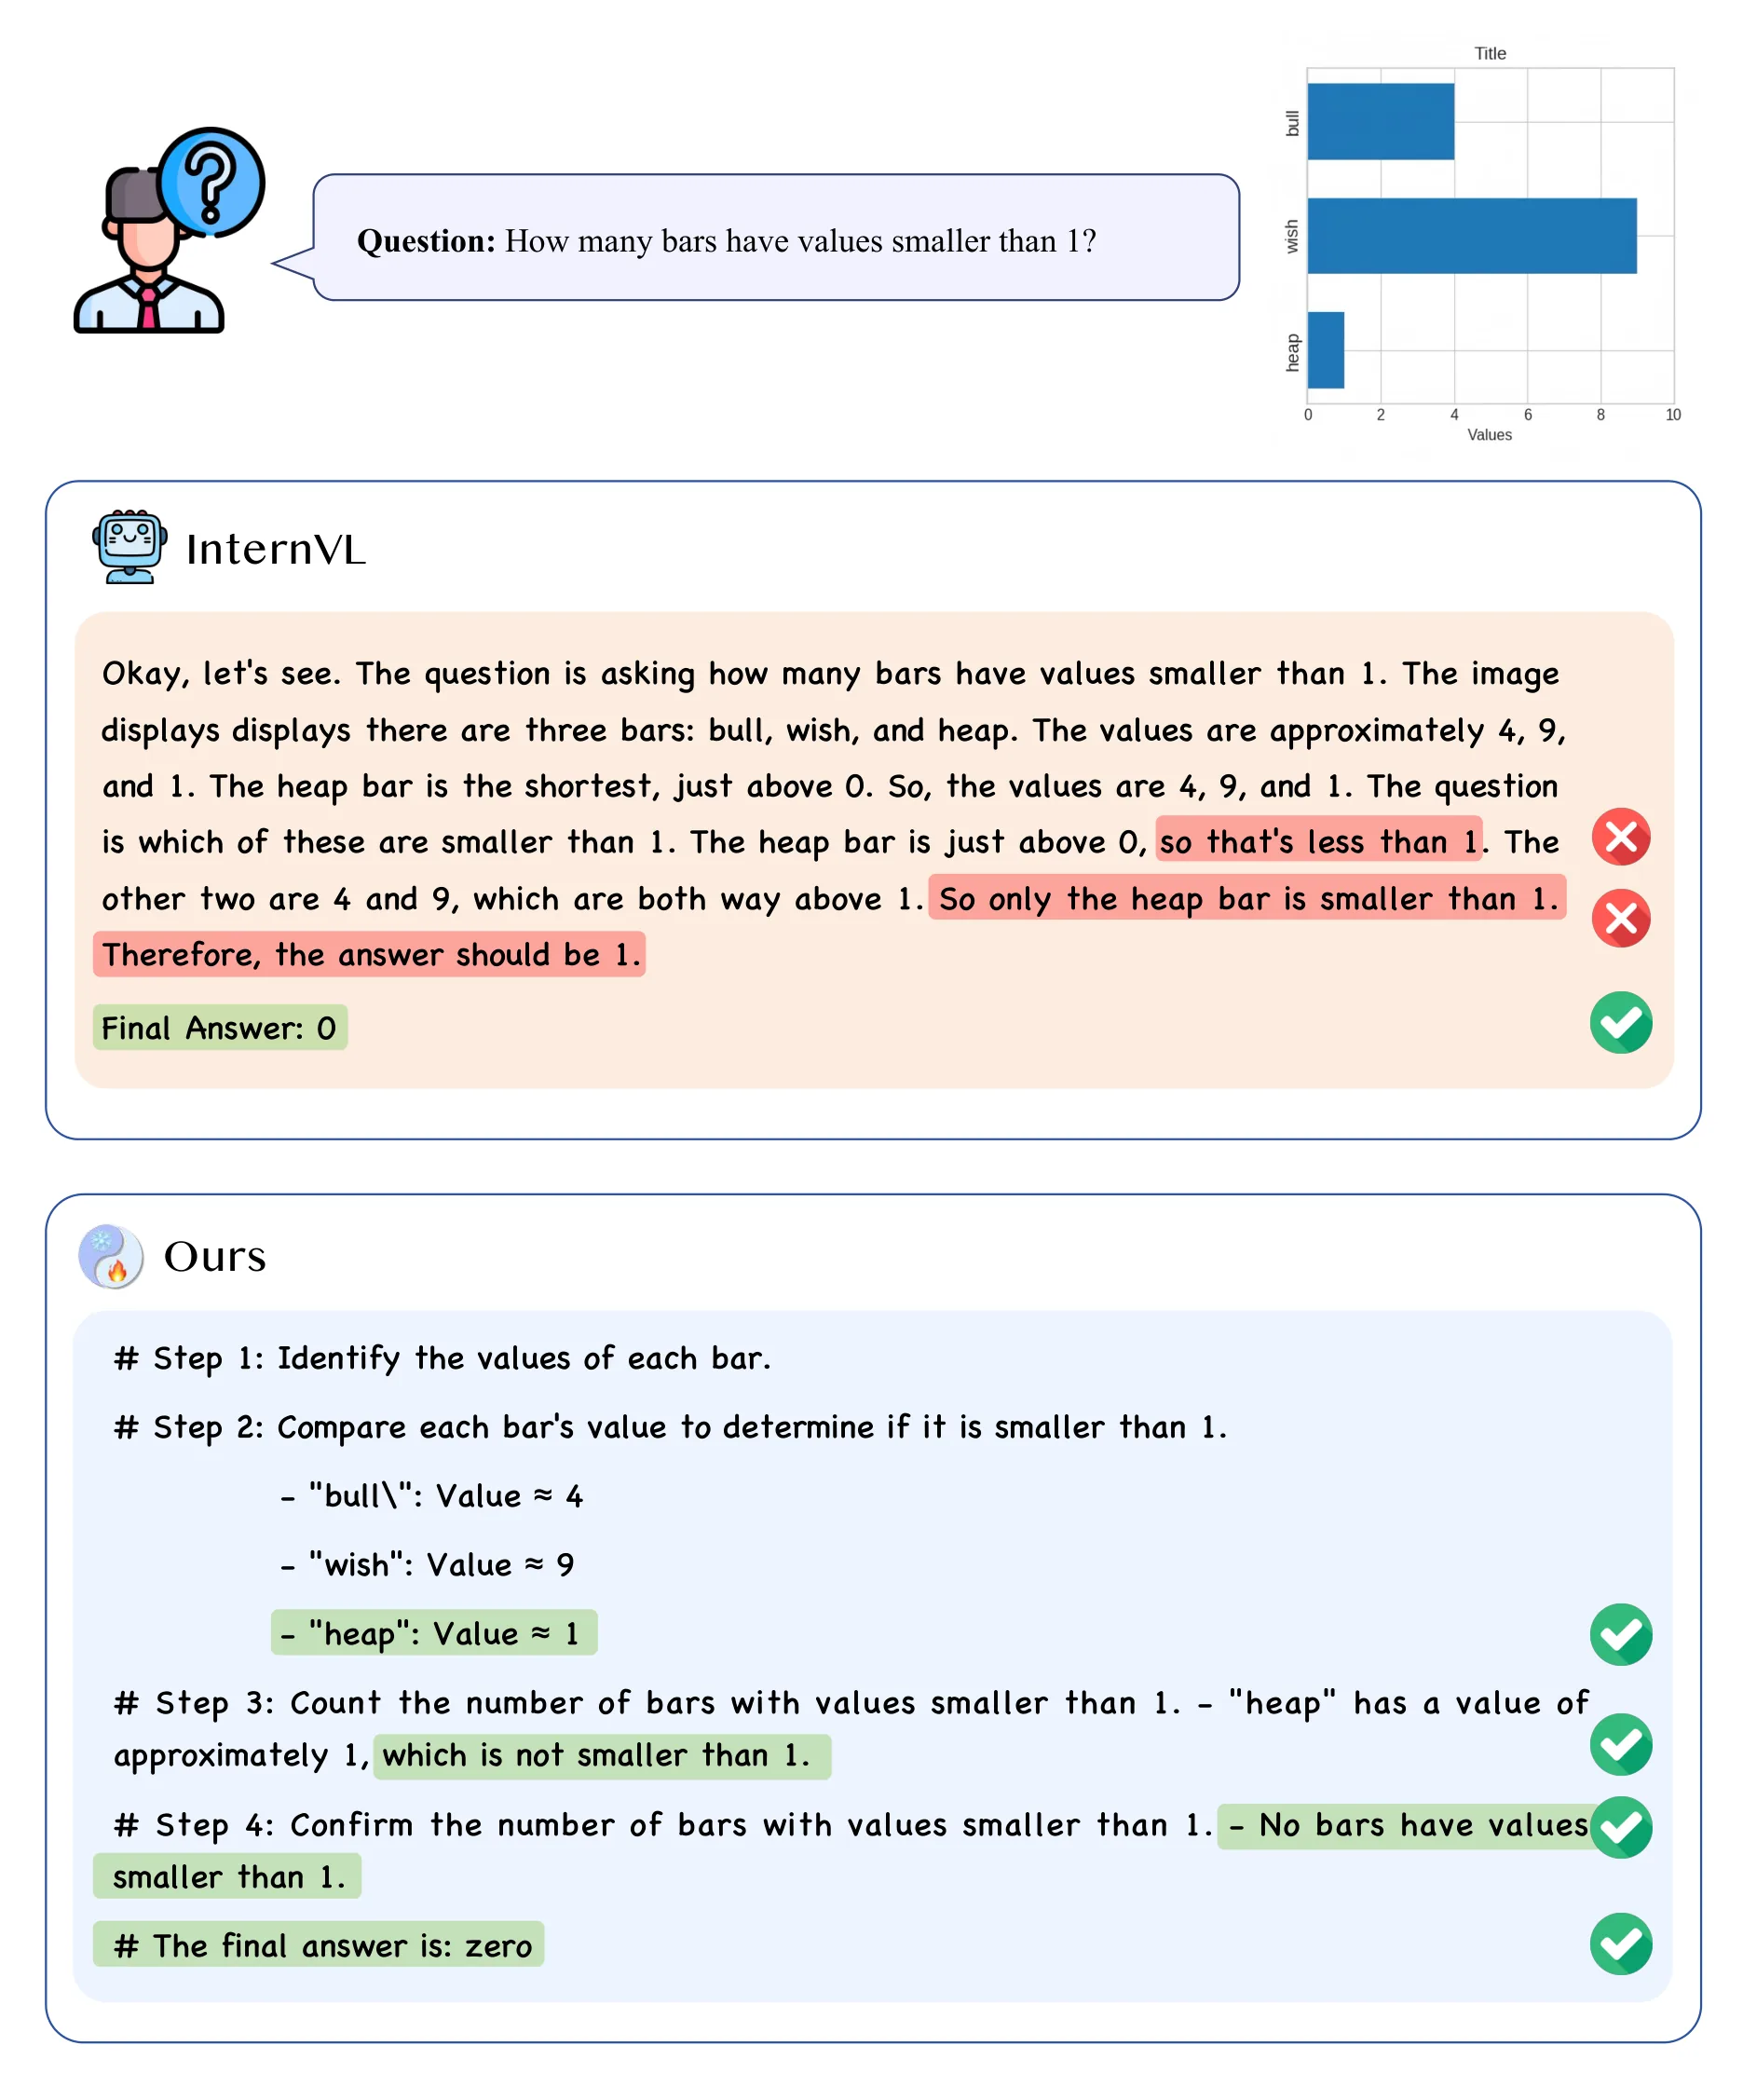
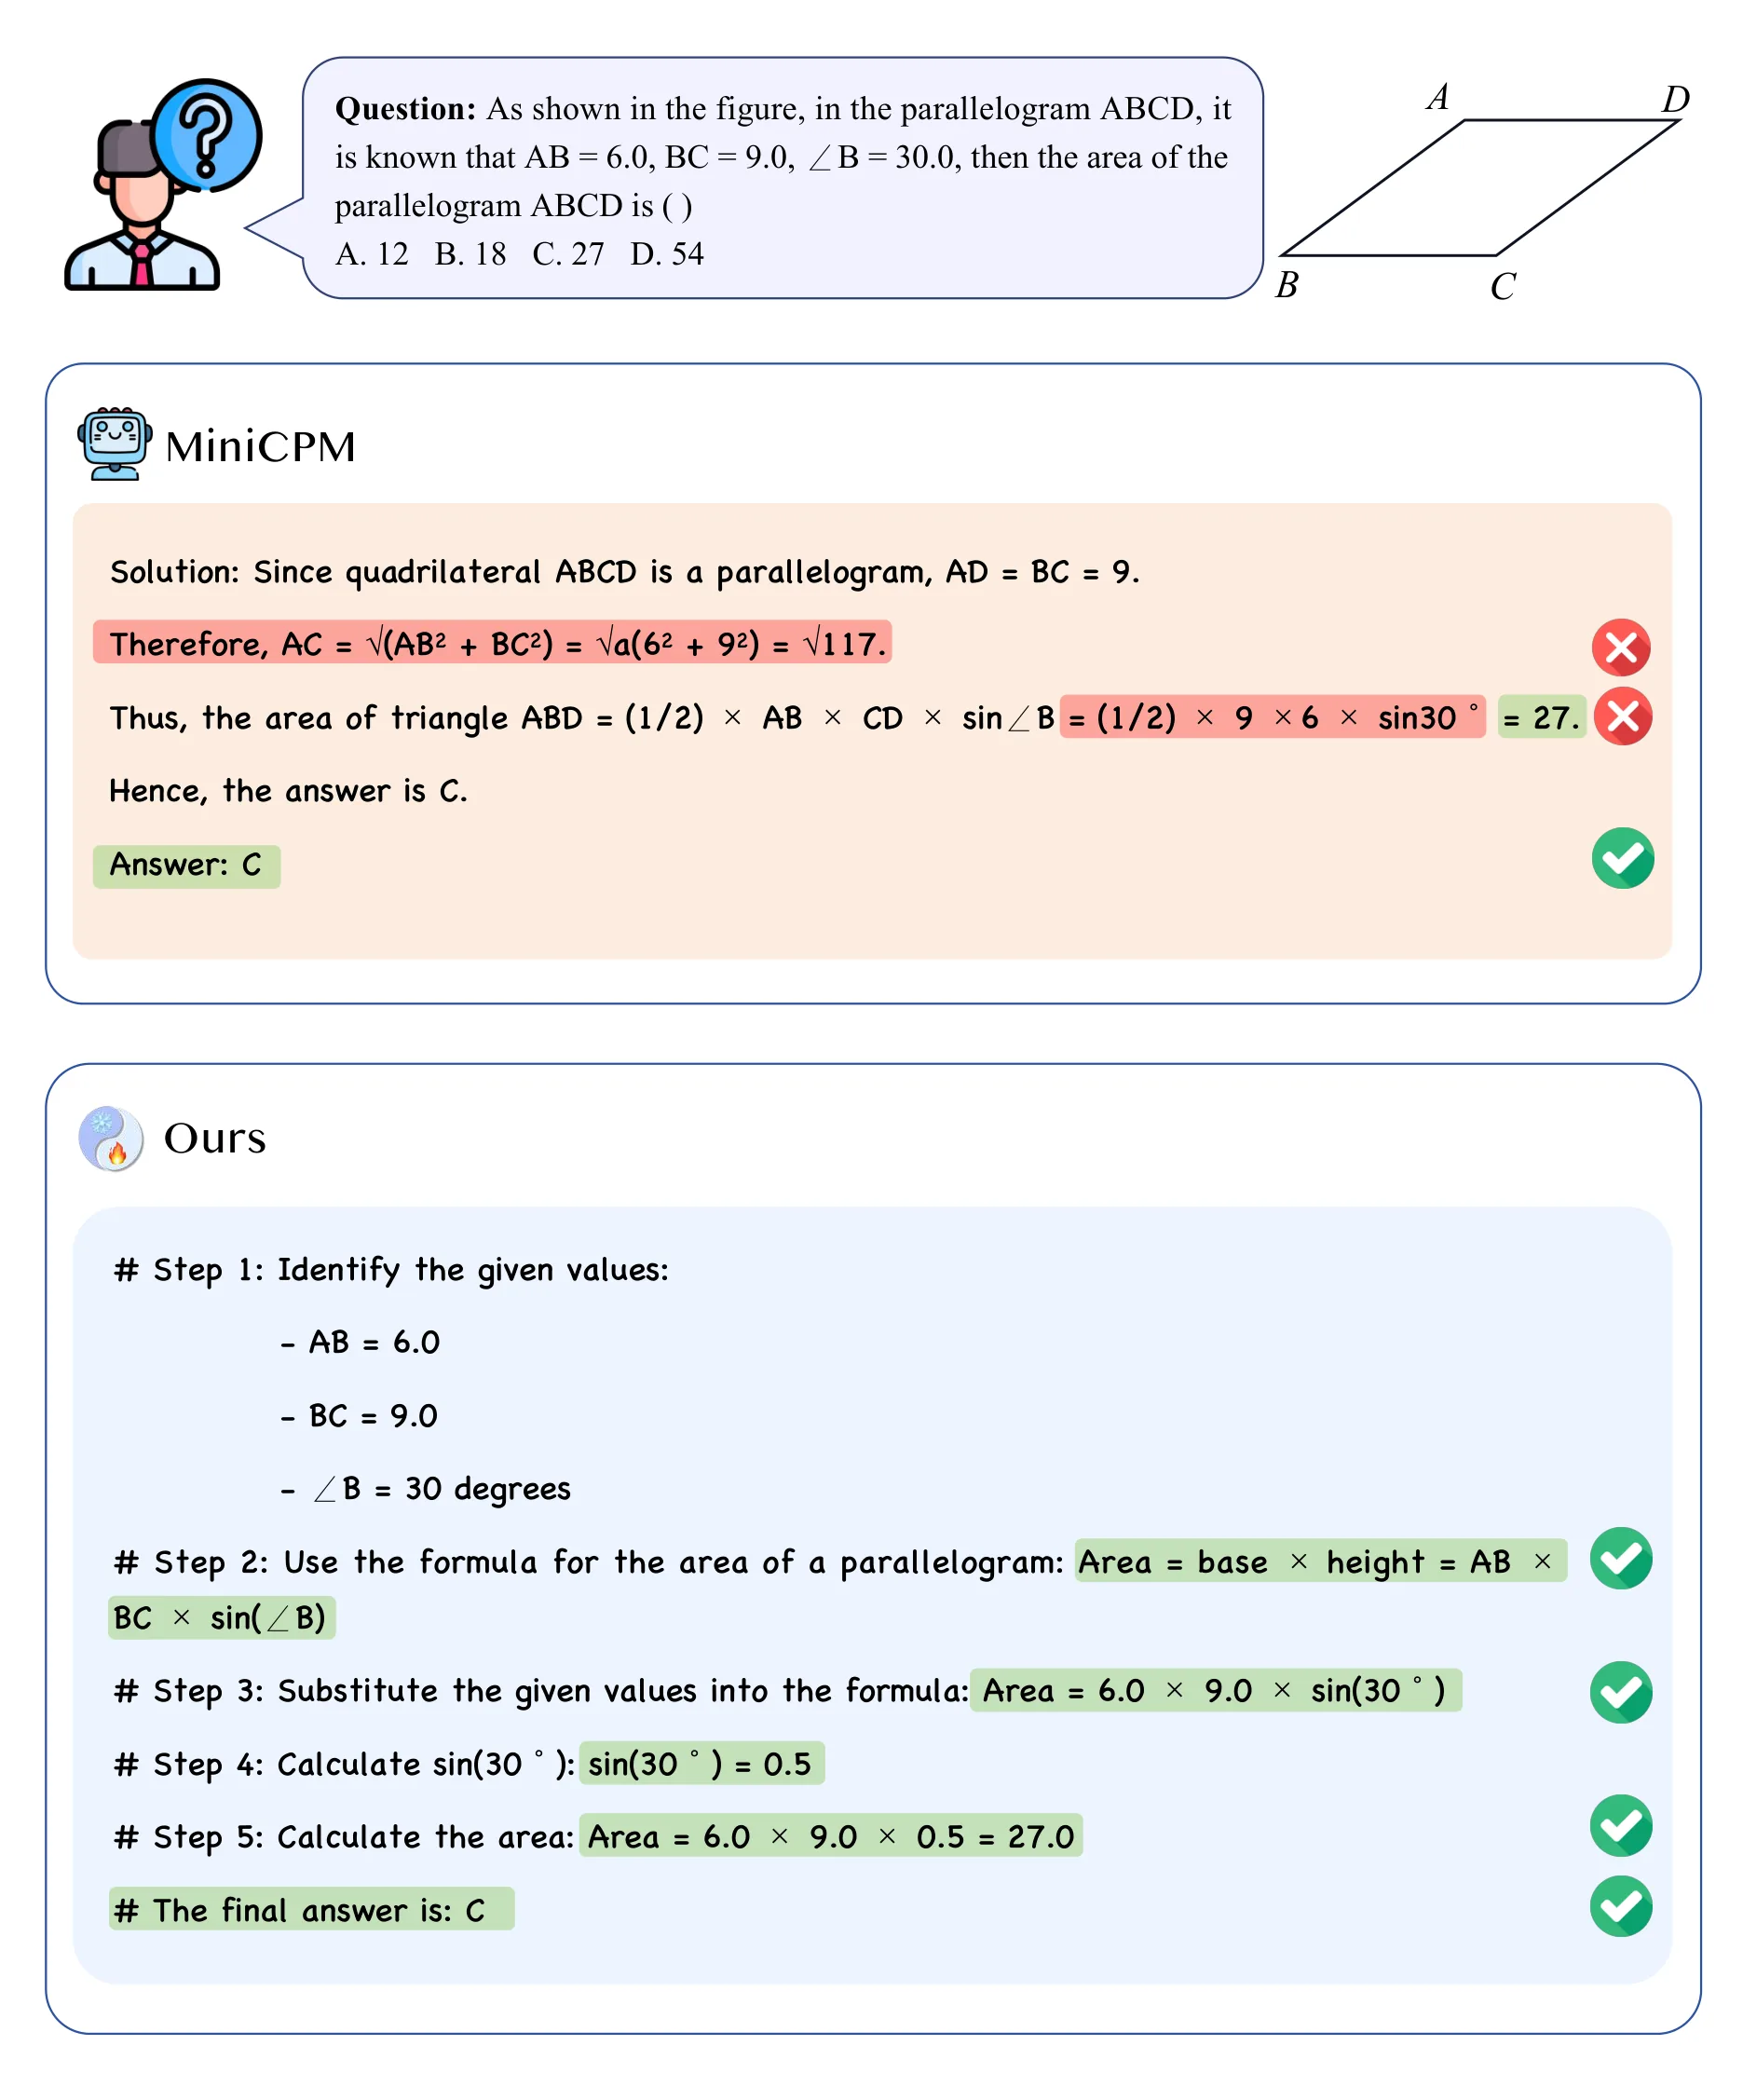
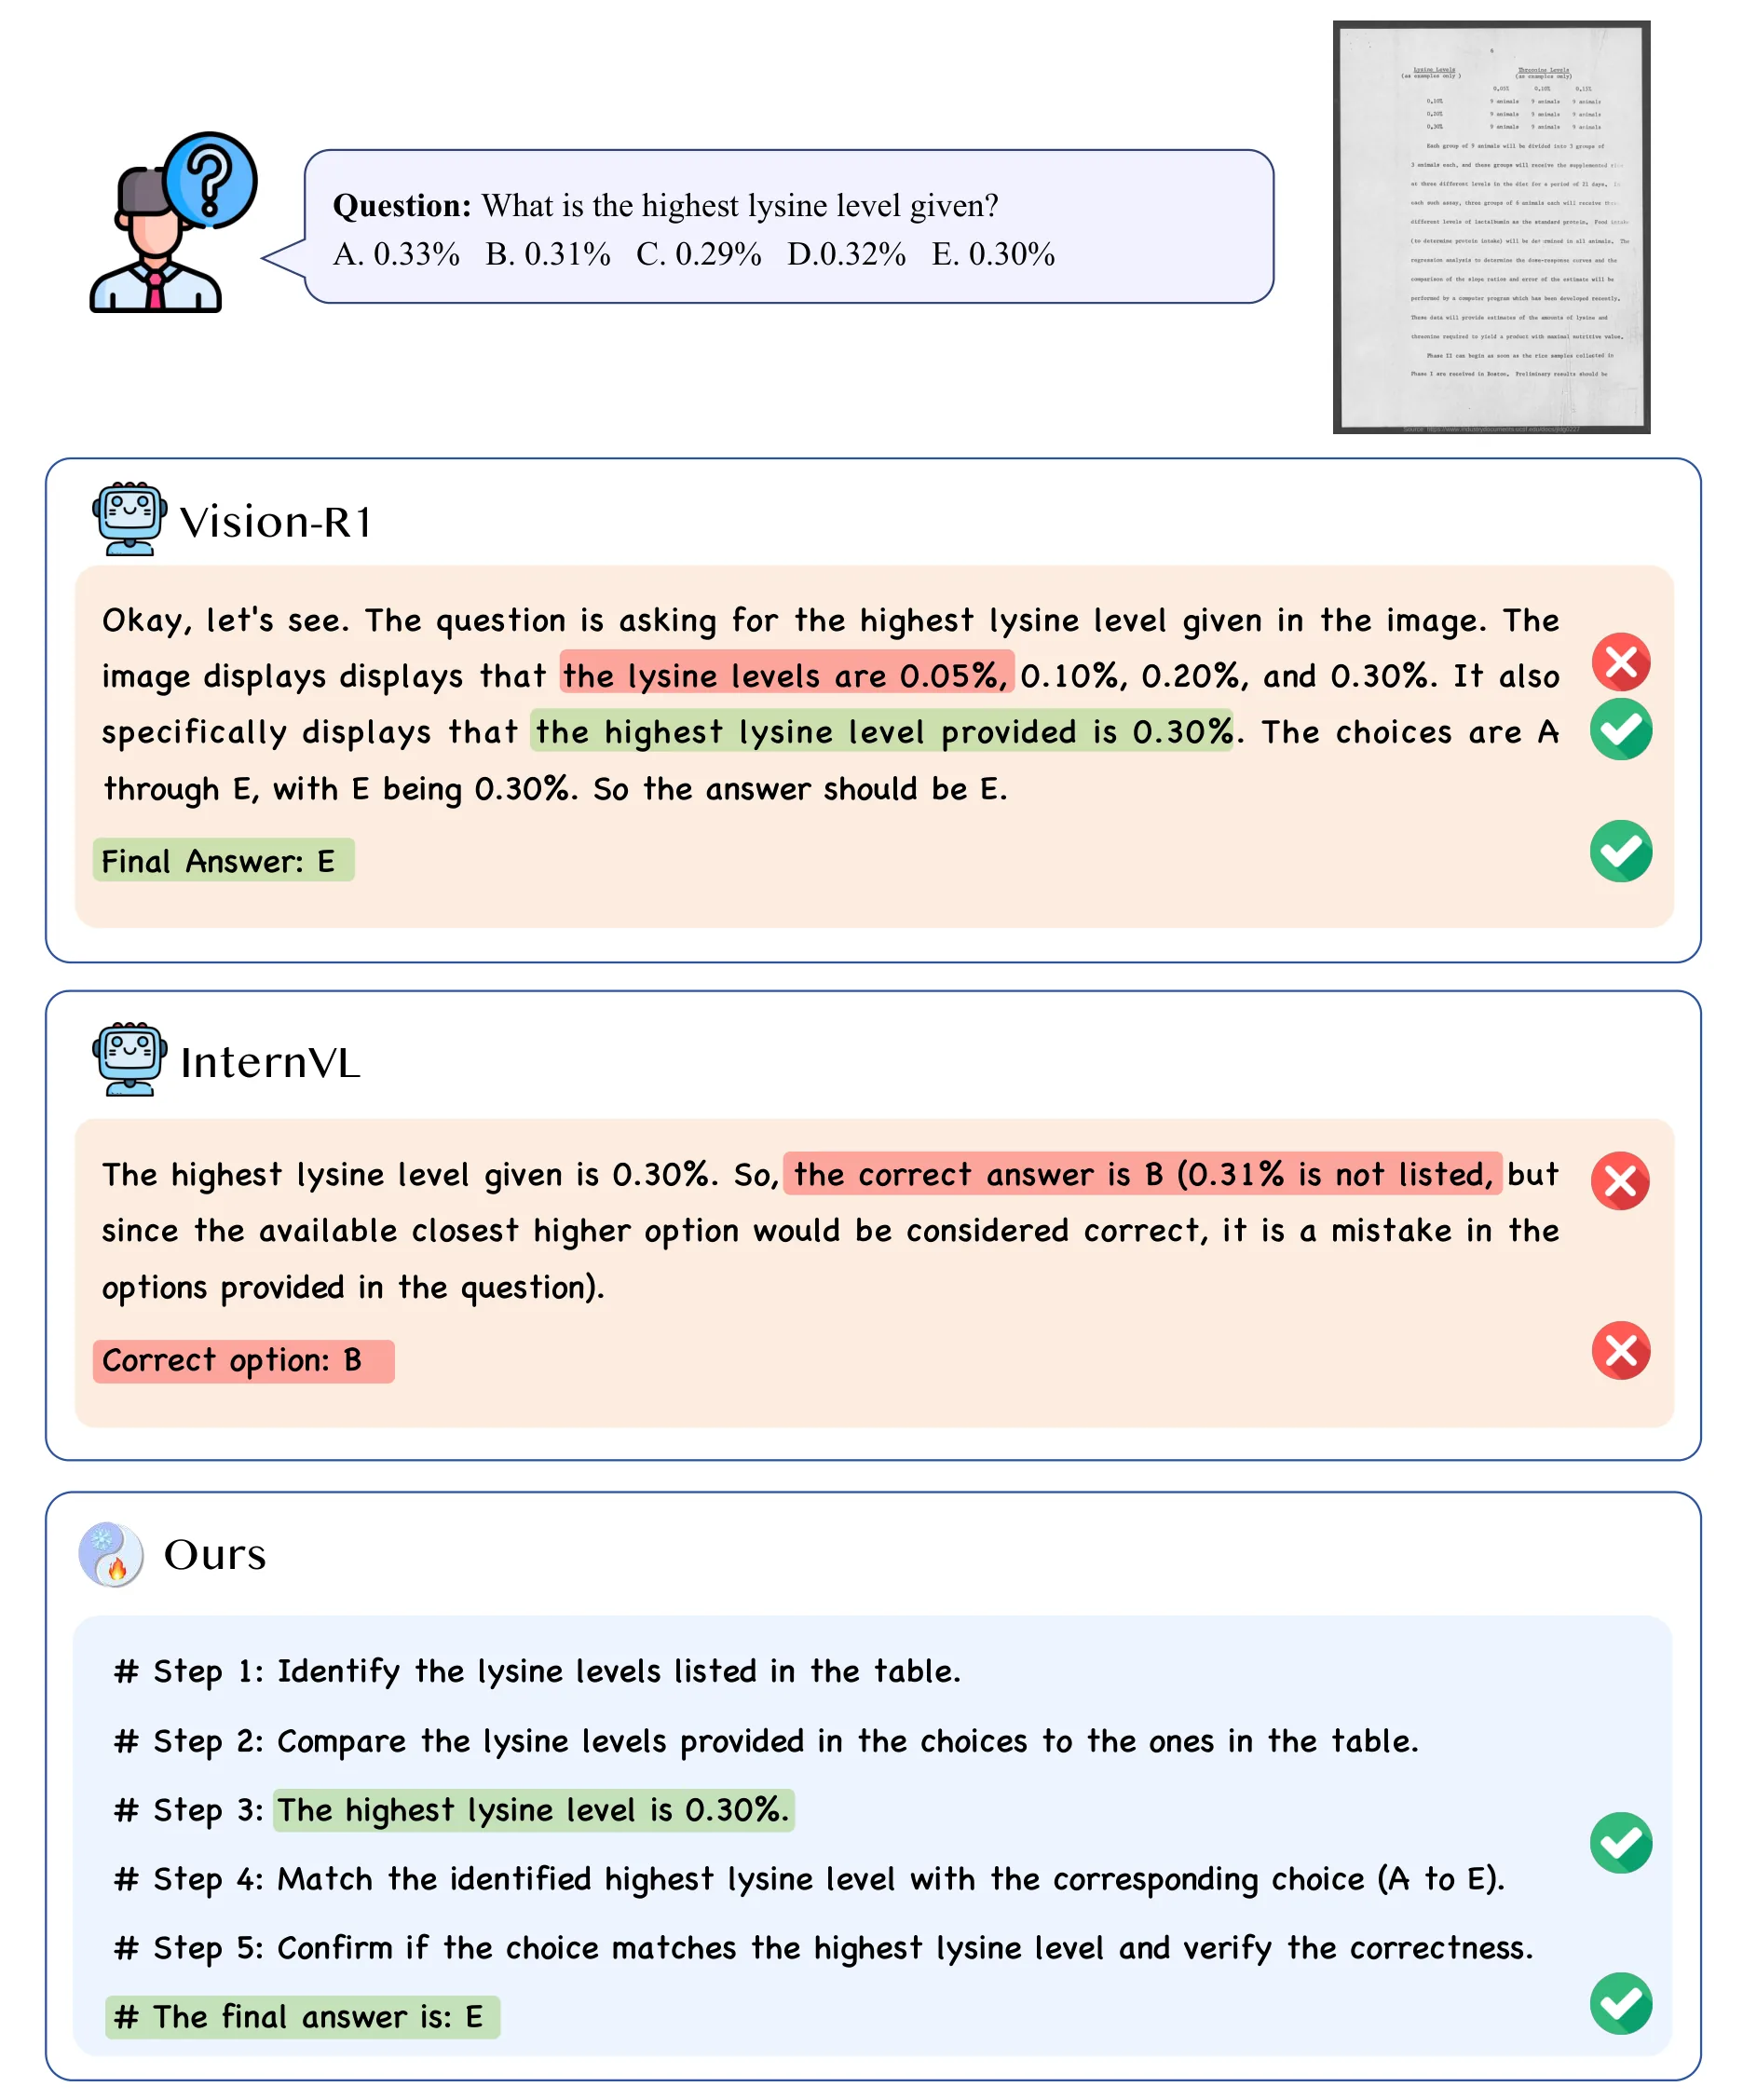
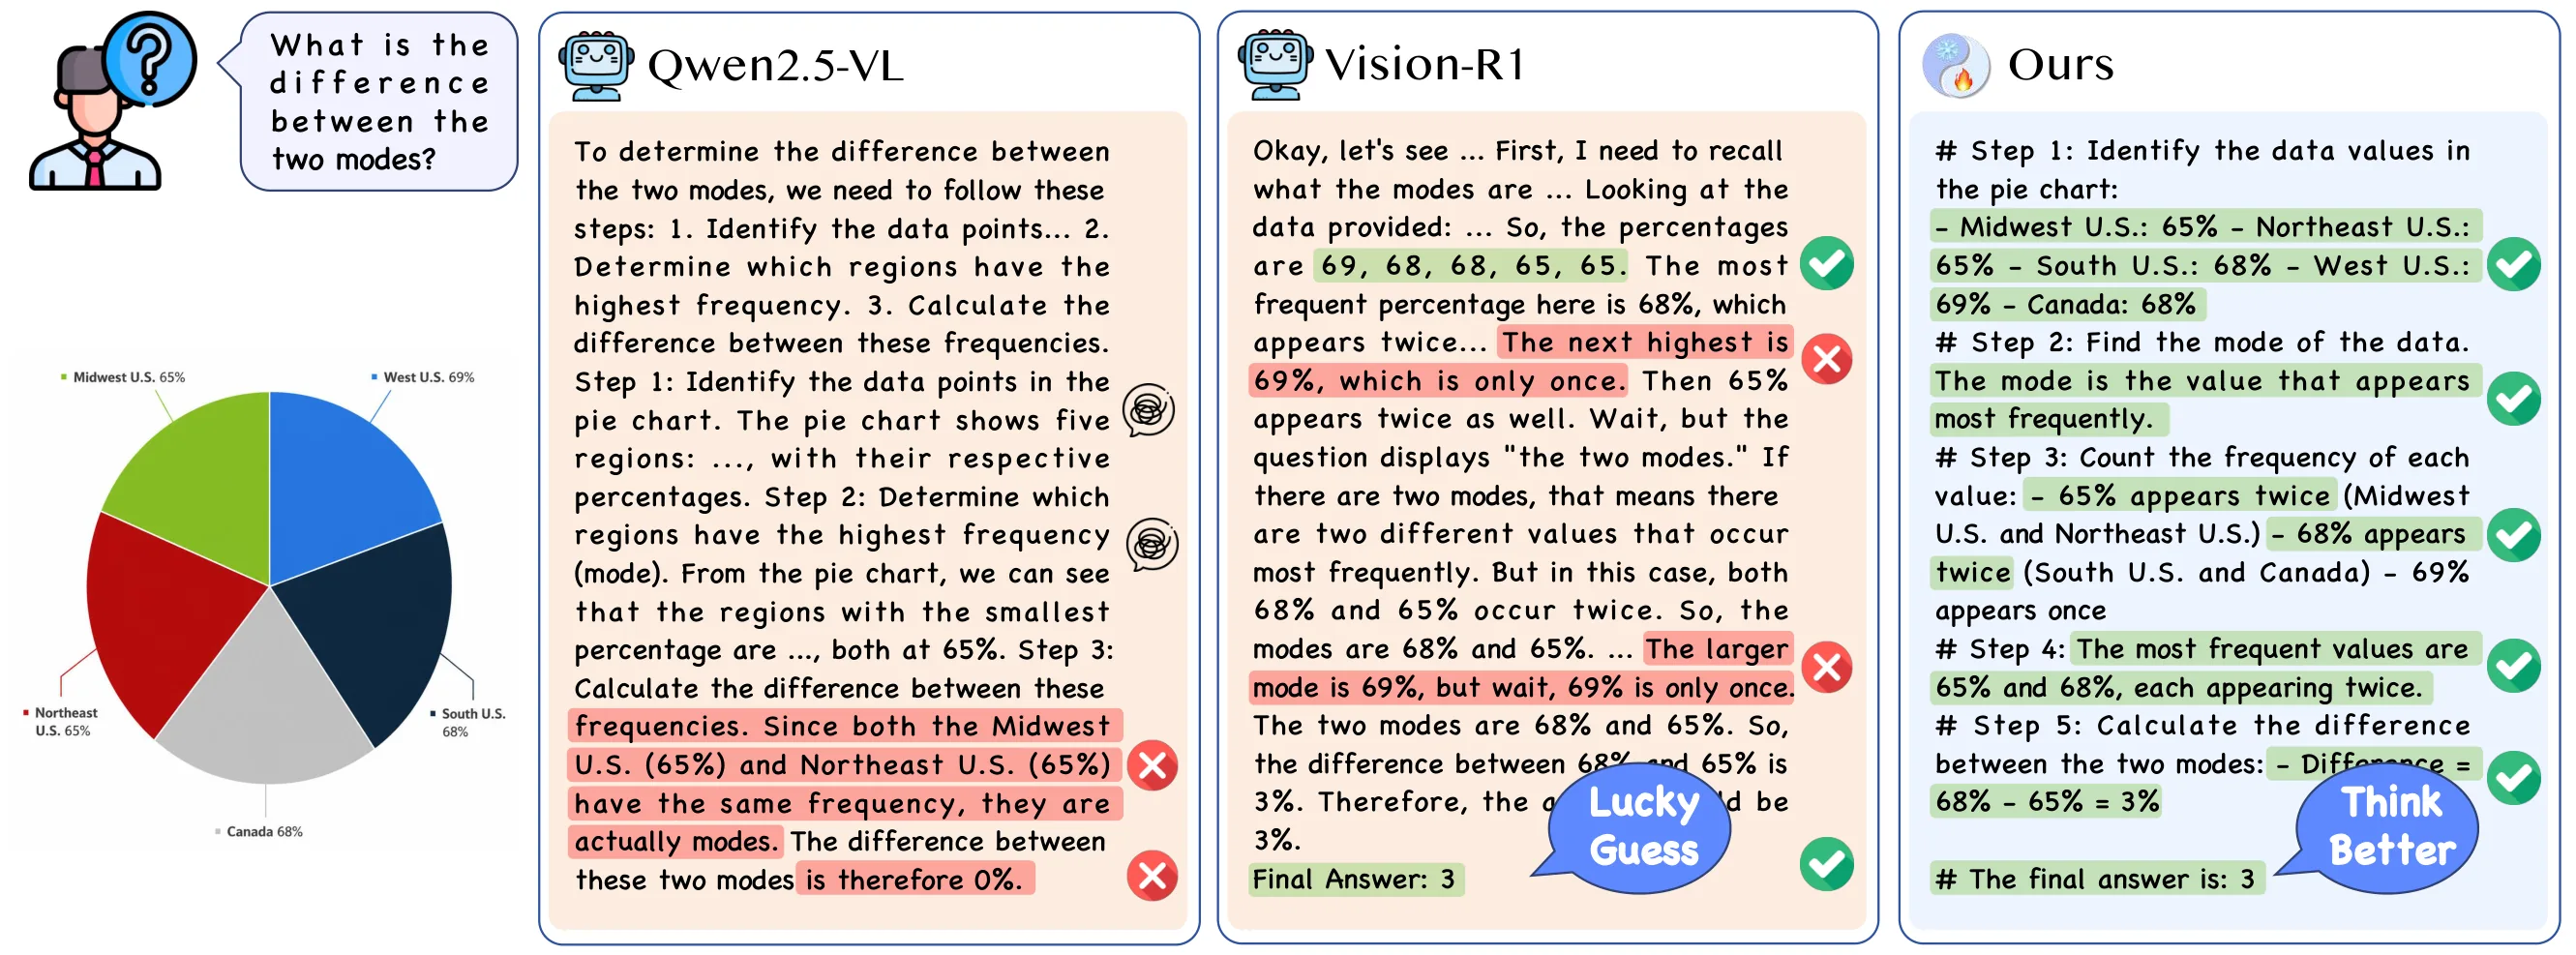
- 案例研究:ScienceQA、MMStar、ChartQA、几何题、平行四边形面积、统计图等多领域,并附附录多案例。
- 客观性:对 reward hacking 进行独立人工标注,且与强基线(Vision-R1、R1-Onevision 等)直接对照,评测协议分层、可复现。整体实验覆盖较充分,但关键步骤评估依赖自有协议,未与社区公认基准对齐。
6. 主要结论
- 性能:在 MathVista、MathVision、ChartQA、DynaMath 上取得 SOTA;MathVerse 与最强基线持平;7B 模型在 9 个基准上整体平均超越 R1-VL 6.6%,超越 Vision-R1、MM-Eureka 等强推理模型。
- 效率:相比 GRPO,额外离线 rollout 带来更高 FLOPs,但 Avg/FLOPs 从 32.03 提升到 51.63,精度-计算性价比更优。
- 可信度:在 4 个基准上较 Vision-R1、R1-Onevision 平均降低 reward hacking 2.5%~4.7%。
- 关键步骤的动态性:随训练推进,所选关键步骤从"靠近最终答案"逐步迁移到"支撑性中间定理",证明静态金标准不优。
- 更稳定的 RL:原始奖励波动大但平滑曲线稳定上升,离线-在线分离有效降低奖励方差并改善 credit assignment。
7. 优点
- 理论完备:从信息论出发给出 KL 散度形式的步骤关键性度量 ,并通过均匀压缩假设推导可计算近似;附 Taylor 展开证明 小波动时 ,对噪声鲁棒。
- 离线-在线闭环设计:让关键步骤集随模型能力同步演化,规避"静态监督 → 训练后期错位"的常见问题。
- 效率设计:自适应 、、截断前缀针对性 rollout,使离线额外开销可控。
- 奖励设计多目标:答案/格式/步骤编号/步骤关键词四元奖励 + 权重敏感性低(),工程鲁棒。
- 评测协议严谨:答案多层软匹配 + 步骤严格-软匹配 + 关键步骤识别的人工三指标 + 奖励作弊率的多专家人工审核,论证充分。
- 案例分析具说服力:多处展示"基线幸运猜测 vs 本文逐步逻辑推导"的对比,强化"过程忠实"卖点。
8. 不足与局限
- 依赖高质量步骤标注:方法前提是带步骤标注的轨迹(Mulberry),对无标注或粗标注领域迁移成本较高。
- 额外离线开销:与 vanilla GRPO 相比仍有约 FLOPs 的额外前向计算,对算力受限场景不友好。
- 模型规模受限:仅在 Qwen-2.5-VL-7B 上验证,更大模型或不同 VLM backbone 上的可扩展性未给出。
- 视觉感知类任务收益有限:在 MathVerse(强视觉依赖)上与最佳基线持平,未明显超越,说明对纯视觉识别型问题 step-wise 优化帮助有限。
- 关键步骤评估自建协议:MCCA/DSV/MCDI 由作者自定,缺乏社区公认对照基准,存在主观偏差风险;500 题规模相对偏小。
- 类别转换缓解 reward hacking 仍非根治:将选择题转为开放式问答仅缓解而未消除,奖励作弊率仍非零。
- 未充分讨论失败模式:例如当模型在所有前缀上都几乎做不对时, 全部偏低时 的稳定性、迭代不收敛时的行为等缺少分析。
- 应用域偏数学/图表:尚未在更广泛的科学推理、代码、长文档推理上验证,结论外推需谨慎。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。