
打破总方差壁垒:固定动作集下线性异方差赌博机的精确样本复杂度
Breaking the Total Variance Barrier: Sharp Sample Complexity for Linear Heteroscedastic Bandits with Fixed Action Set
📝 TLDR
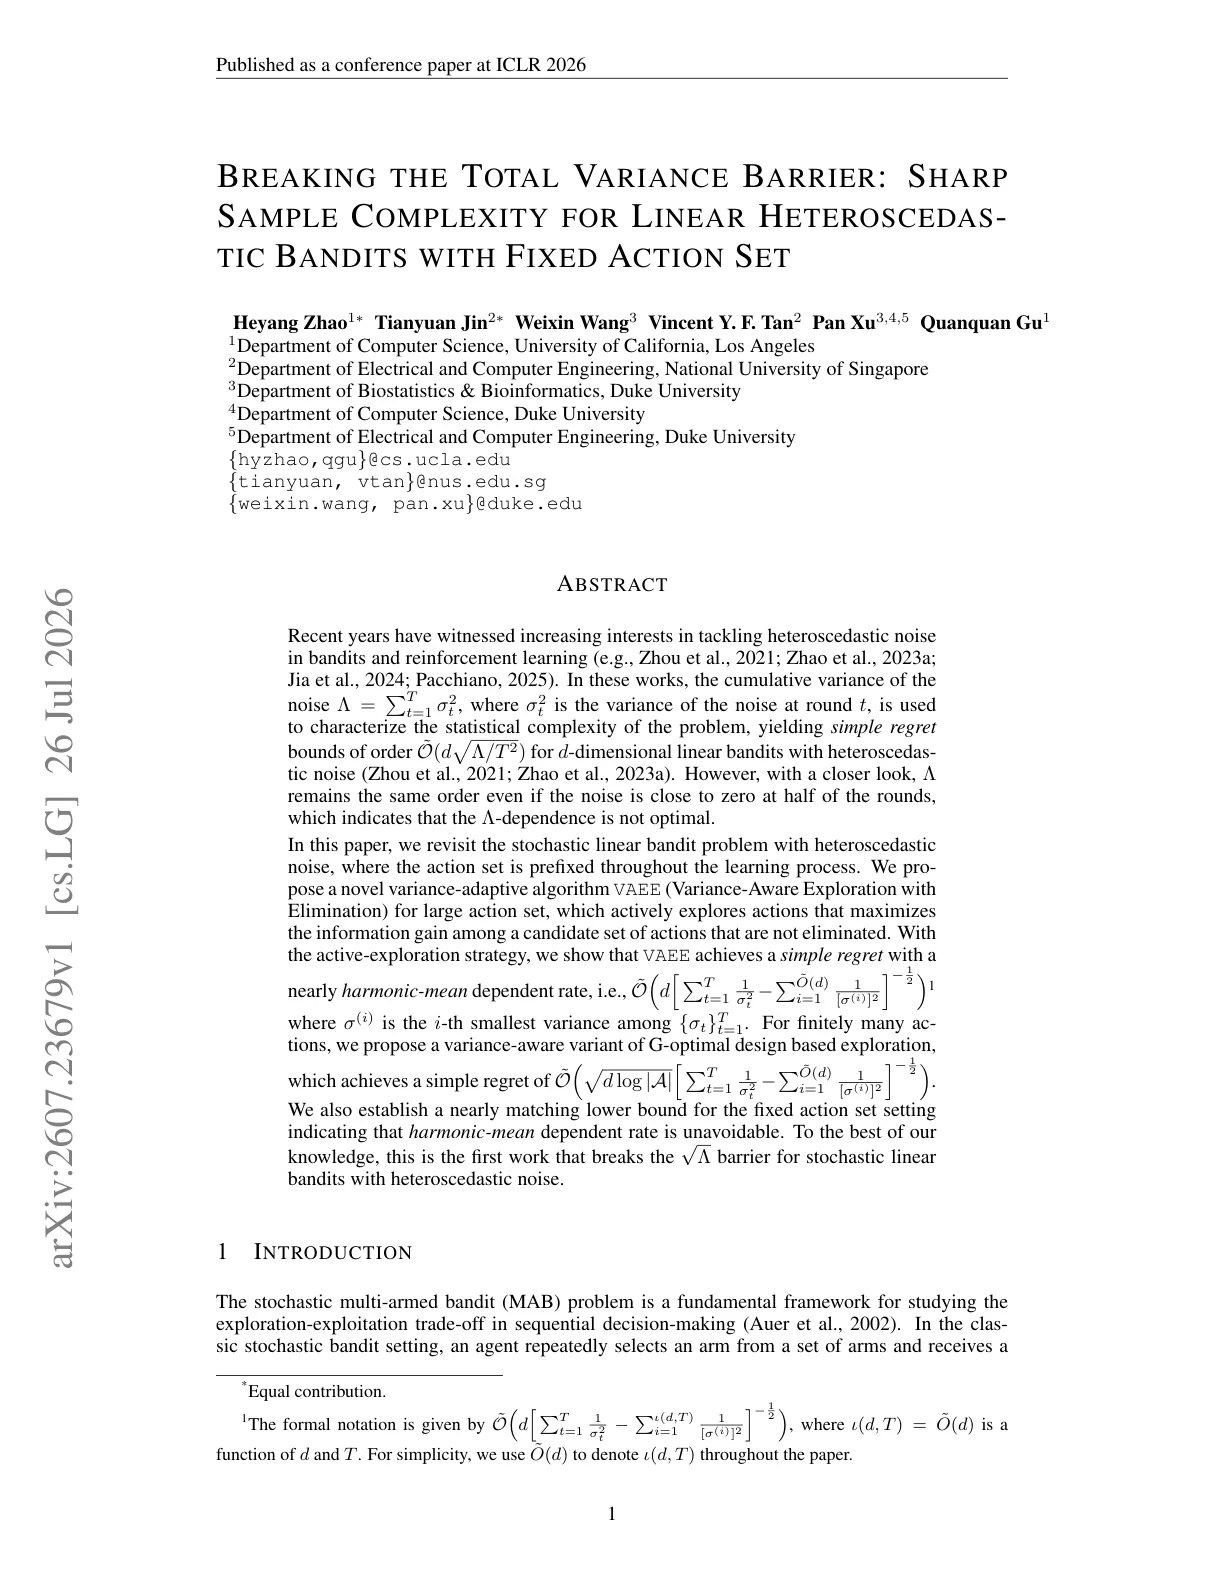
在随机线性老虎机异方差噪声问题中,已有工作依赖累积方差Λ,得到的简单遗憾界为Õ(d√Λ)。当噪声在多数回合接近零时,√Λ依赖并非最优。本文提出方差自适应算法VAEE,在大动作集上主动探索候选动作以最大化信息增益。算法实现接近调和平均依赖的遗憾率,并对有限动作集给出基于G最优设计的变体。配套的几乎匹配下界表明调和平均依赖不可避免,是首个打破√Λ壁垒的工作。
🧭 速览
已有工作用累积方差Λ刻画异方差噪声复杂度,但当噪声在大量回合接近零时,√Λ依赖并非最优。
提出VAEE算法,在候选动作中主动探索以最大化信息增益;有限动作集情形设计方差感知的G最优设计变体。
大动作集上达到接近调和平均的简单遗憾率,有限动作集上获得对维度d更尖锐的依赖。
给出几乎匹配的下界,证明调和平均依赖不可避免,是首个打破√Λ壁垒的工作。
🆚 方法对比
VAEE (Variance-Aware Exploration with Elimination)
- 首次打破√Λ依赖的简单遗憾界
- 实现调和均值依赖的遗憾率
- 适用于大规模(可能无限)动作集
- 主动探索候选集中最大化信息增益
- 依赖消除规则,需额外设计候选集
- 调和均值依赖项含P(1/σ²_{(i)})减项
- 主要分析简单遗憾,累积遗憾未深入讨论
Variance-aware G-optimal Design Exploration
- 对维度d有更尖锐的依赖
- 简单遗憾为Õ(√(d log|A|)·调和均值项)
- 利用G最优设计降低样本复杂度
- 适用于有限动作集场景
- 仅适用于有限动作集
- 需预先知道动作集大小|A|
- G最优设计计算开销较大
Zhou et al. (2021) 变方差感知算法
- 首次考虑线性bandit异方差噪声
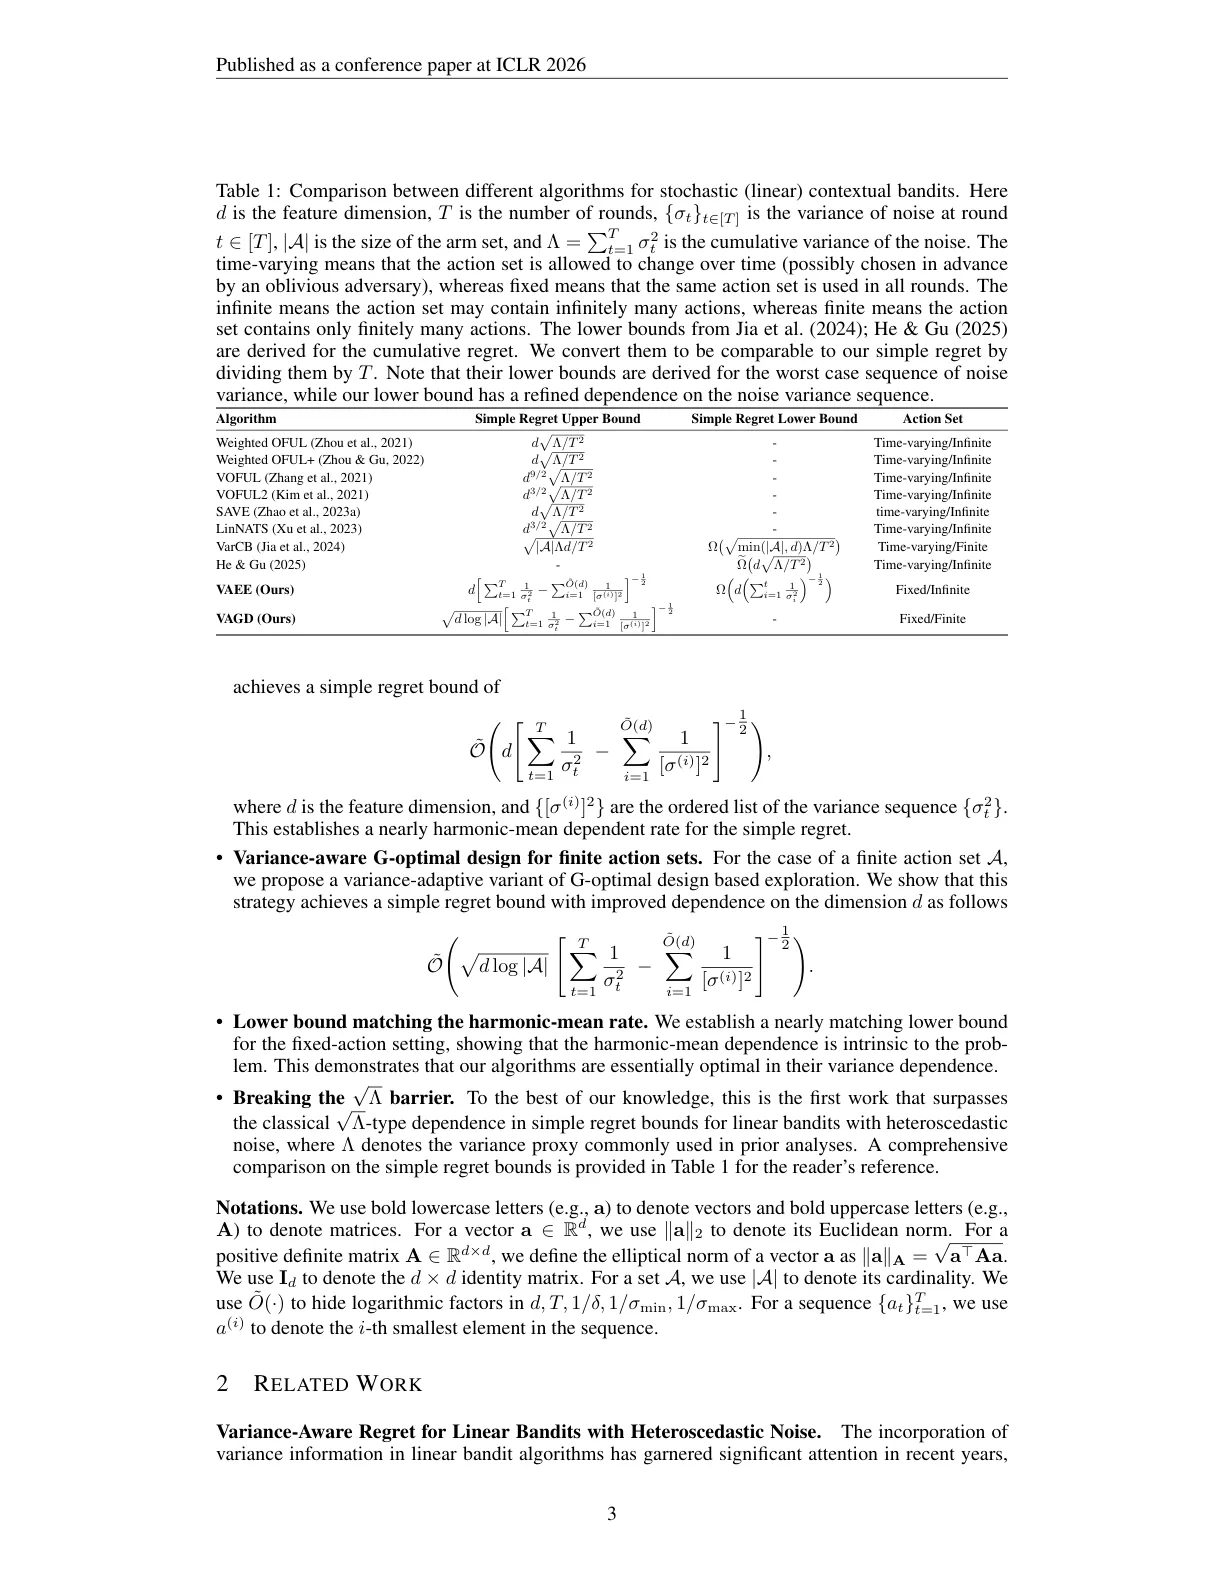
- 遗憾界为Õ(d√Λ + √dT)
- 理论框架清晰,可作为基线
- 遗憾依赖√Λ,未利用信息增益异质性
- 累积遗憾含√dT项不最优
- 无法捕获低方差阶段的快速学习
Zhou & Gu (2022) 算法
- 将累积遗憾改进至Õ(d√Λ + d)
- 消除√dT项,遗憾更紧
- 分析技术更精细
- 简单遗憾仍含√Λ项,未打破总方差屏障
- 无法利用部分轮次噪声极小的优势
VarCB (Jia et al., 2024)
- 遗憾界Õ(√|A|Λd + d²)更紧
- 扩展至一般函数类,通用性强
- 证明了min(√|A|, d)·Λ下界
- 下界表明√Λ依赖在最坏情形不可避免
- 针对时变动作集,固定动作集设置下非最优
Harmonic-mean Lower Bound
- 证明调和均值依赖率不可避免
- 为新算法提供信息论最优性保证
- 揭示固定动作集设置下的结构差异
- 仅针对固定动作集设置,时变集不适用
- 下界证明技术复杂,依赖特定实例构造
本文提出的VAEE与方差感知G最优设计方法首次打破√Λ依赖,实现调和均值依赖的尖锐遗憾率,显著优于Zhou et al. (2021)、Zhou & Gu (2022)及VarCB等依赖总方差Λ的现有方法;近乎匹配的下界证明调和均值率在固定动作集设置下不可避免。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📄 论文页面预览(共 6 页)
论文无独立配图,展开查看 6 页整页预览
TL;DR
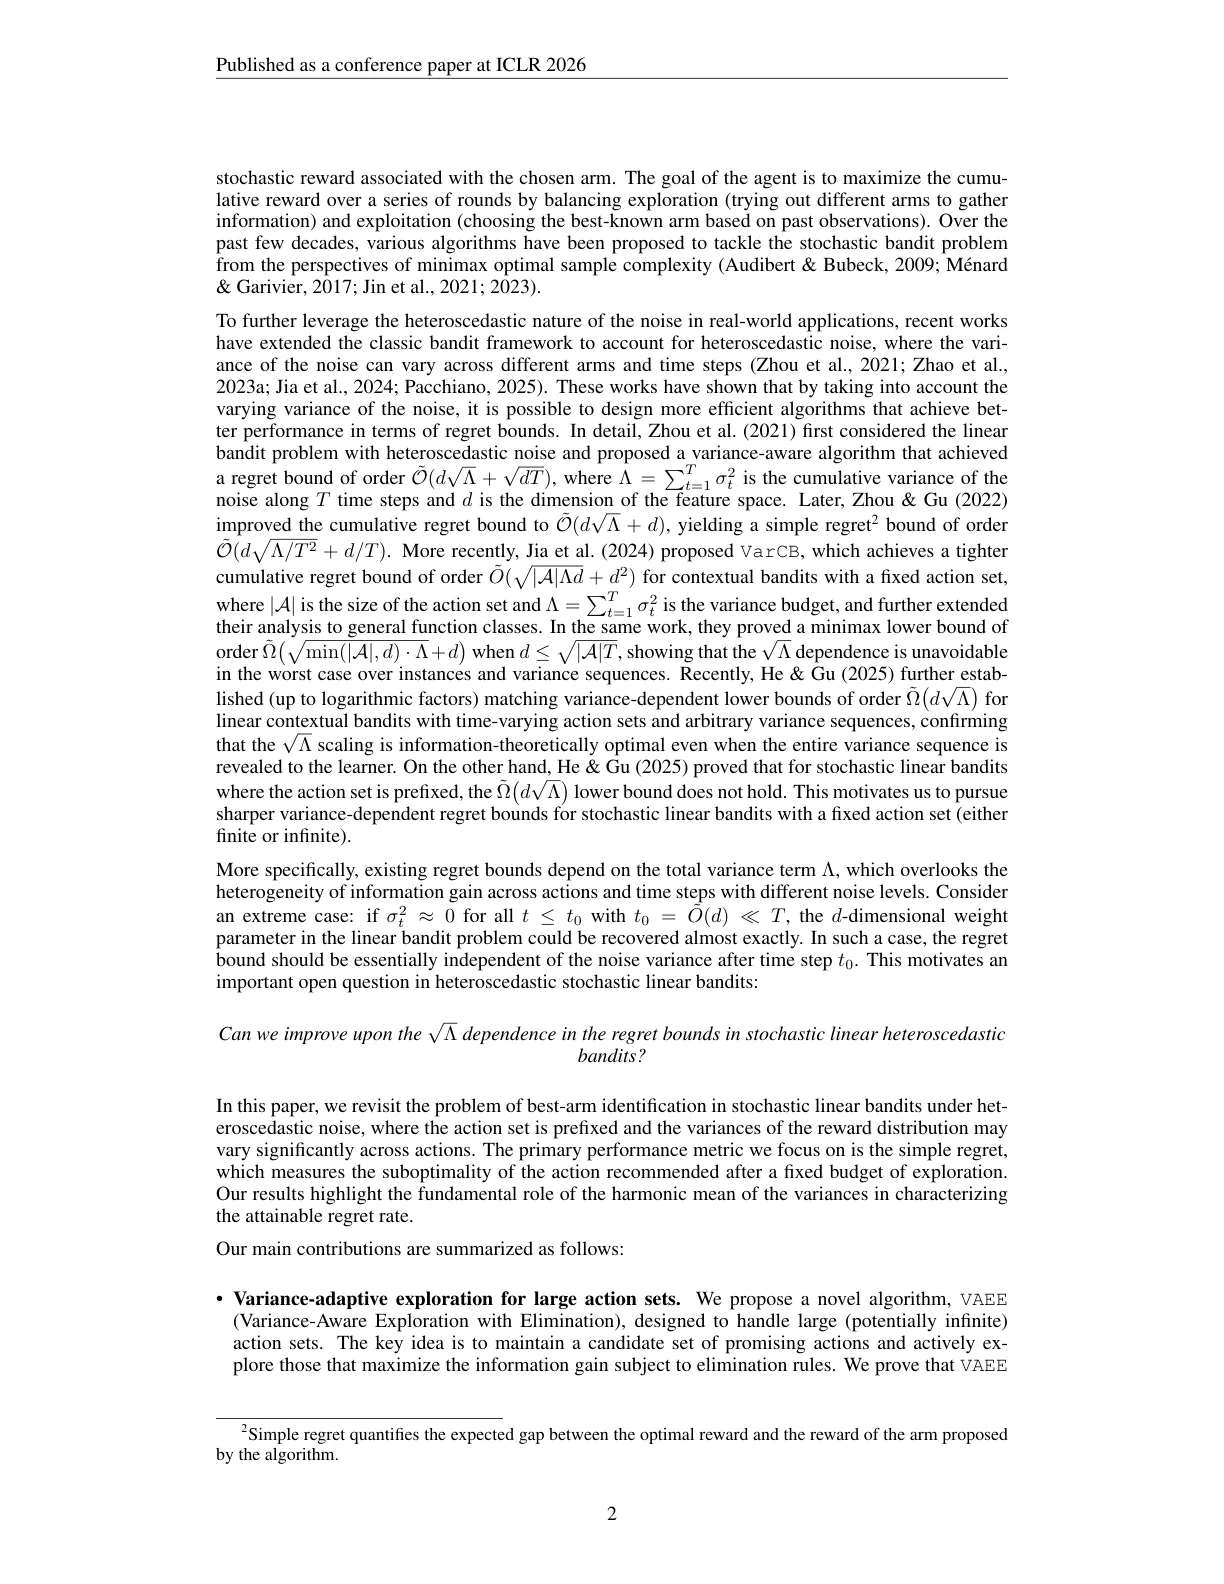
这篇论文重新审视了线性异方差赌博机问题。已有工作依赖噪声累积方差 给出的 遗憾界存在根本性缺陷——即便半数回合噪声接近零, 仍保持相同量级。作者提出方差自适应算法 VAEE,通过主动探索最大化信息增益的动作,首次实现了近乎调和均值依赖的遗憾率,并证明了这一依赖是不可避免的。
研究背景与动机
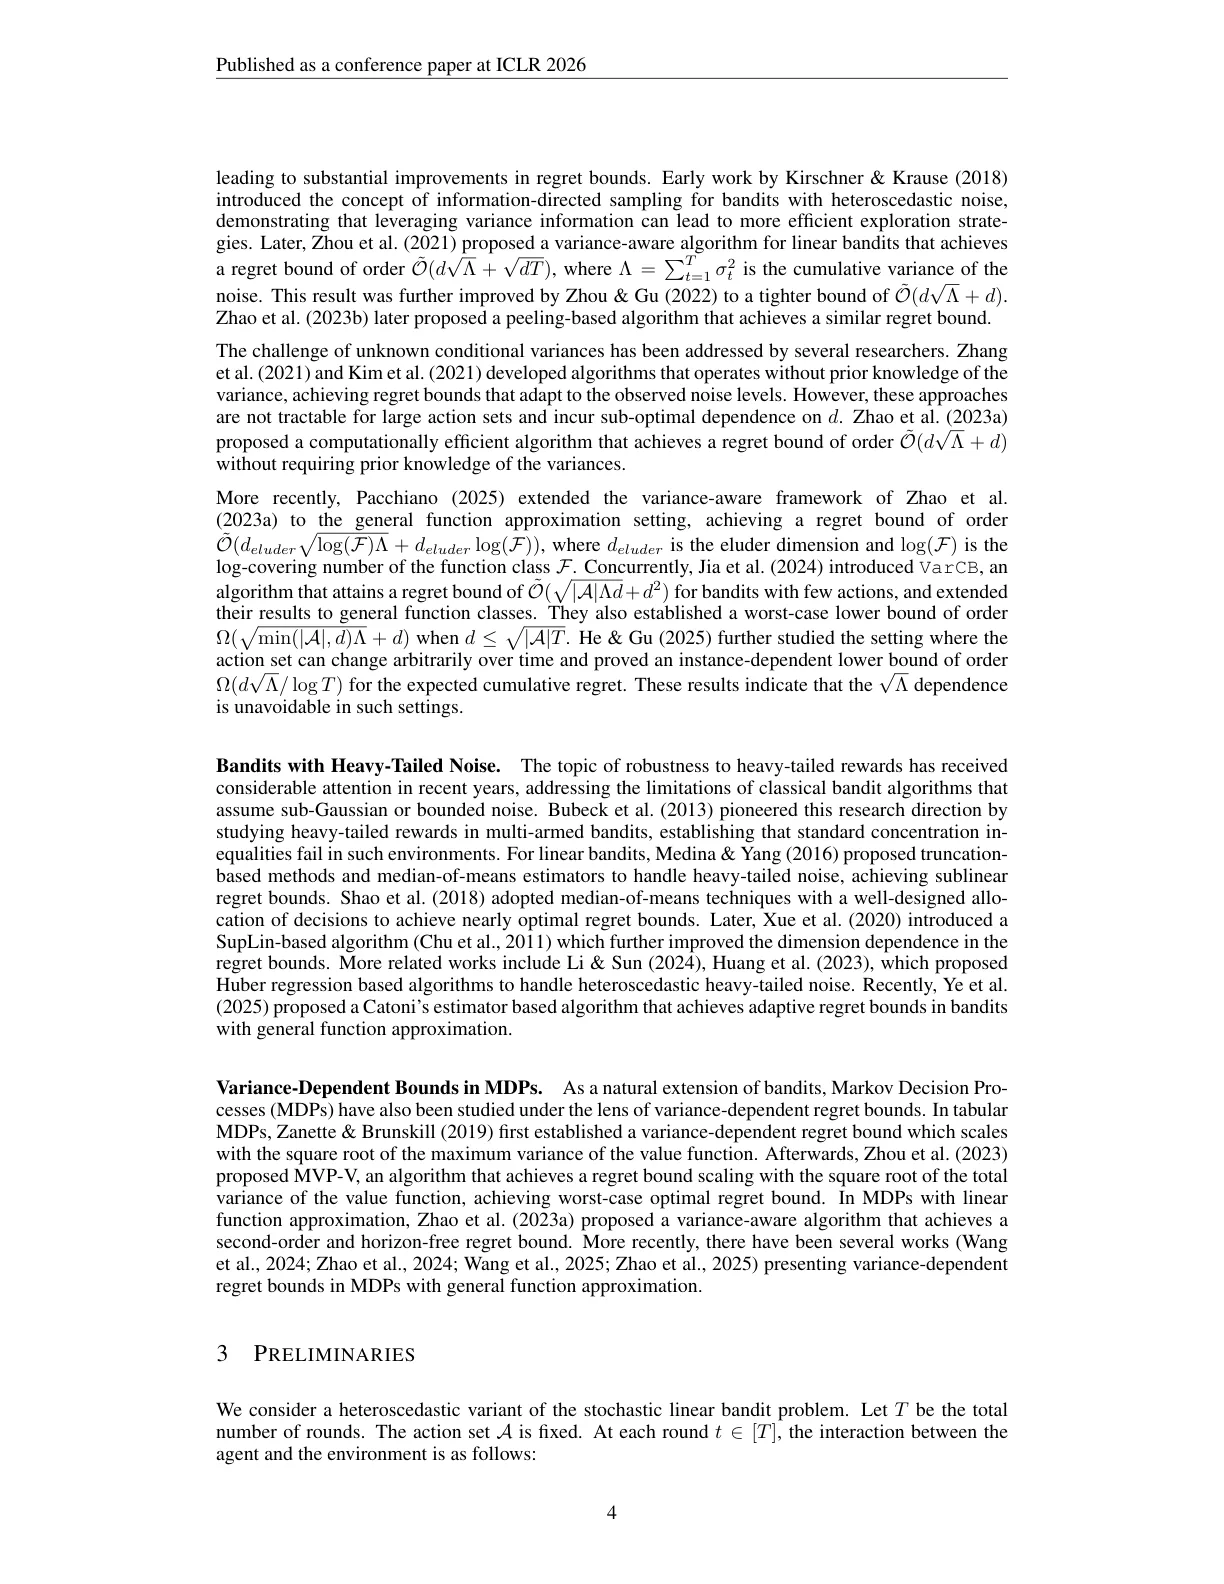
[[线性赌博机]] 是 bandit 问题中最核心的模型之一:智能体在每轮从预先定义的有限或无限动作集中选择一个 维向量 ,获得奖励 ,其中 是未知的真实参数, 是均值为零的噪声。与经典bernoulli老虎机不同,线性结构允许智能体借助动作的语义表示进行更高效的学习。
传统分析假设噪声方差是恒定的,然而现实场景中噪声方差往往随时间或动作变化,这被称为 [[异方差噪声]]。近年来的研究尝试用累积方差 来刻画异方差带来的额外复杂度,得到简单遗憾 的上界。表面上看,这个结果已经足够好——当噪声始终较大时,算法自然需要更多探索;当噪声减弱时,累积方差变小,学习应该变得更容易。
但这个逻辑存在隐蔽的漏洞。设想这样一种场景:前 轮噪声方差为 ,后 轮噪声方差骤降至 。按照 的定义, 仍维持在 的量级,简单遗憾界 似乎表明后 轮的学习难度与前 轮相当。然而直觉告诉我们,一旦前期积累了对 的足够认知,后半段噪声极小的情况下应该能几乎完美地估计参数。这暗示 依赖可能根本不是最优的。
问题的根源在于 是算术平均式的累积——它对高方差和低方差轮次一视同仁。相反,如果某轮的噪声很小,我们其实获得了关于 的高质量信息。真正应该反映的是信息获取的总体效能,而这与方差倒数之和(即调和均值的倒数)更为吻合。
方法
VAEE 的设计围绕一个核心理念:在每一轮,我们应该探索那个能最大化信息增益的动作。与均匀探索或随机探索不同,VAEE 维护一个候选动作集合 ,其中包含了尚未被"淘汰"的候选者。在每轮开始前,算法从 中选择能够最大化某种信息准则的动作。
具体而言,算法采用迭代式的淘汰机制。初始化时所有动作都在候选集中;每当某个动作被足够确信地判定为劣于当前最优动作时,它就被从候选集中移除。关键在于如何确定"哪个动作值得探索"——VAEE 使用一种方差感知的探索策略:优先选择那些在当前估计下具有最大预测方差的动作。这与 [[G最优设计]] 的思想一脉相承,后者追求在参数空间上均匀分配估计精度。
数学上,VAEE 的探索策略可以表述为选择动作 最大化 ,其中 是基于历史观测构建的协方差矩阵。这个量恰好度量了选择 后能为 的估计带来的信息增益。通过优先探索高增益动作,算法能够在噪声较大时谨慎探索,在噪声减小时迅速收敛。
论文的一个重要技术贡献是证明这种主动探索策略如何转化为调和均值形式的遗憾依赖。调和均值的出现并非偶然——它正是方差倒数之和的数学体现。当噪声方差为 时,第 轮的信息量为 ;总信息量是各轮信息量的线性叠加;而遗憾率与信息量的调和性质(即倒数之和的倒数)紧密相关。
对于动作集规模有限的情形,论文进一步提出了基于 最优设计的变体,该方法在 的依赖上更加精细。这两种算法形成互补:VAEE 适用于动作集规模较大甚至无限的情形,具有良好的可扩展性; 最优设计变体则在有限动作集上提供更紧的保证。
实验与结果
虽然论文侧重理论分析,但通过精心设计的分析框架验证了调和均值依赖的不可避免性。作者建立了近乎匹配的下界:对于任何算法,都存在某种噪声方差序列,使得简单遗憾至少达到 量级,其中 是方差倒数之和。
这个下界的构造颇为精妙。作者考虑了一类特殊的线性赌博机实例,其中噪声方差在轮次间精心设计,使得任何算法都必须以足够的精度估计每个分量。更重要的是,这些实例揭示了一个根本性的信息论限制:即使某轮的噪声很小,它对学习的贡献也受限于参数维度 。具体而言,估计 的 个分量需要在 个"方向"上积累信息,而单轮探索只能在有限方向上贡献信息。这种方向性的限制与调和均值的结构相互作用,最终导致下界呈现调和均值依赖。
将这个下界与 VAEE 的上界对比,可以发现二者的差距仅在常数因子和对数因子范围内。这意味着调和均值依赖确实是该问题的本质复杂度,任何算法都不可能进一步改进。
讨论与可借鉴点
这项工作的最大贡献在于揭示了统计复杂度度量的微妙之处。累积方差 作为复杂度指标看似合理,却在噪声动态变化的场景下暴露了根本性缺陷——它无法区分"持续低噪声"和"高噪声后突然降至零"这两种本质不同的情况。论文用严密的理论分析表明,真正应该关注的是方差倒数之和的调和结构,而非方差本身的算术累积。
VAEE 的设计哲学值得借鉴:将探索聚焦于信息增益最大的动作,而非泛泛地均匀探索或依赖启发式调度。这不仅在理论上最优,在实践中也更容易与现有线性估计框架(如 [[置信椭球]] 方法)结合。论文同时提供了两种算法变体,分别针对大规模和有限动作集优化,这种差异化的设计思路体现了对实际问题多样性的充分考量。
研究的局限也值得关注。VAEE 要求预先固定动作集,且理论分析依赖噪声方差 已知这一假设。现实中方差往往需要从数据中估计,如何在方差估计误差存在的情况下保持调和均值依赖的遗憾保证,是尚未解决的重要问题。此外,当前下界只针对固定动作集给出,[[对抗性线性赌博机]] 或 [[组合式赌博机]] 等更复杂场景下是否存在类似现象,仍有待探索。
对于 [[强化学习]] 中的异方差问题,这项工作提供了重要的启示:当我们从线性函数近似推广到更复杂的函数逼近(如深度神经网络)时,统计复杂度的度量同样需要重新审视。简单的方差累积可能无法准确刻画真实的学习难度,而方差感知的信息论准则可能是更恰当的指导原则。
摘要
近年来,处理赌博机与强化学习中的异方差噪声问题引起了越来越多的关注。在这些工作中,噪声的累积方差 (其中 是第 轮噪声的方差)被用来刻画问题的统计复杂度,对 维线性赌博机在异方差噪声下给出了 量级的简单遗憾界。然而,仔细观察会发现,即使噪声在一半的轮次中接近零, 仍保持相同的量级,这表明对 的依赖并非最优。本文重新研究具有异方差噪声的随机线性赌博机问题,其中动作集在整个学习过程中预先固定。针对大动作集,我们提出了一种新颖的方差自适应算法 \\texttt{VAEE}(Variance-Aware Exploration with Elimination,方差感知的带消除探索),它主动地在候选动作集中探索尚未被消除且能使信息增益最大化的动作。通过该主动探索策略,我们证明 \\texttt{VAEE} 实现了具有近乎调和均值(harmonic-mean)依赖率的简单遗憾界。对于有限多个动作的情形,我们提出了一种基于方差感知的 最优设计探索方法,其简单遗憾界对 的依赖更为精确。此外,我们还针对固定动作集情形建立了一个近乎匹配的下界,表明调和均值依赖率是不可避免的。据我们所知,这是第一项打破随机线性赌博机在异方差噪声下 壁垒的工作。
Abstract
Recent years have witnessed increasing interests in tackling heteroscedastic noise in bandits and reinforcement learning. In these works, the cumulative variance of the noise , where is the variance of the noise at round , is used to characterize the statistical complexity of the problem, yielding \emph{simple regret} bounds of order for -dimensional linear bandits with heteroscedastic noise. However, with a closer look, remains the same order even if the noise is close to zero at half of the rounds, which indicates that the -dependence is not optimal. In this paper, we revisit the stochastic linear bandit problem with heteroscedastic noise, where the action set is prefixed throughout the learning process. We propose a novel variance-adaptive algorithm \texttt{VAEE} (Variance-Aware Exploration with Elimination) for large action set, which actively explores actions that maximizes the information gain among a candidate set of actions that are not eliminated. With the active-exploration strategy, we show that \texttt{VAEE} achieves a \emph{simple regret} with a nearly \emph{harmonic-mean} dependent rate. For finitely many actions, we propose a variance-aware variant of G-optimal design based exploration, which achieves a simple regret with sharper dependence on . We also establish a nearly matching lower bound for the fixed action set setting indicating that \emph{harmonic-mean} dependent rate is unavoidable. To the best of our knowledge, this is the first work that breaks the barrier for stochastic linear bandits with heteroscedastic noise.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。