
专注即所需:面向多智能体图系统的自适应目标感知注意力编排
Focus Is All You Need: Adaptive Goal-aware Attention Orchestration for Multi-Agent Graph Systems
📝 TLDR
大语言模型驱动的多智能体系统常以图结构组织专用节点,但工作流扩展时各组件被统一执行,造成算力在无关任务上浪费。AGAO将Transformer风格注意力从token表征扩展到工作流级智能体协调,并通过目标感知、拓扑感知、资源感知三种注意力动态评估节点重要性。实验表明该方法在多种负载下提升任务效果,同时减少不必要算力、延迟与token消耗。该工作确立了"注意力工程"这一面向可扩展多智能体系统的新方向。
🧭 速览
多智能体图工作流随规模增长而对所有节点统一执行,导致注意力分配低效,资源浪费在低影响任务上。
AGAO融合目标感知、拓扑感知与资源感知三种注意力,动态评估节点重要性并编排计算资源。
在多种多智能体负载上提升任务有效性,同时降低计算量、延迟与token消耗,优于现有图执行策略。
提出"注意力工程"概念,将Transformer注意力思想推广到工作流级智能体协调,支持可扩展系统设计。
🆚 方法对比
AGAO
- 整合三种注意力机制实现协同优化
- 动态分配计算资源提升任务效果
- 减少不必要计算、延迟与token消耗
- 提出注意力编排新范式
- 三组件耦合增加系统实现复杂度
- 缺少理论收敛性或最优性保证
- 依赖准确的用户目标语义理解
- 实验规模与多样性有待扩展
Goal-aware Attention
- 精准衡量目标与能力语义相关性
- 实现目标驱动的动态焦点分配
- 目标模糊时相关性估计不稳定
- 依赖高质量语义嵌入对齐
Topology-aware Attention
- 建模图结构依赖与执行路径
- 捕捉智能体间结构关联信息
- 依赖静态图结构不支持动态演化
- 循环依赖场景处理不明确
Resource-aware Attention
- 动态分配预算与执行优先级
- 有效降低延迟与token消耗
- 预算分配策略可能过度简化
- 异构资源建模粒度不足
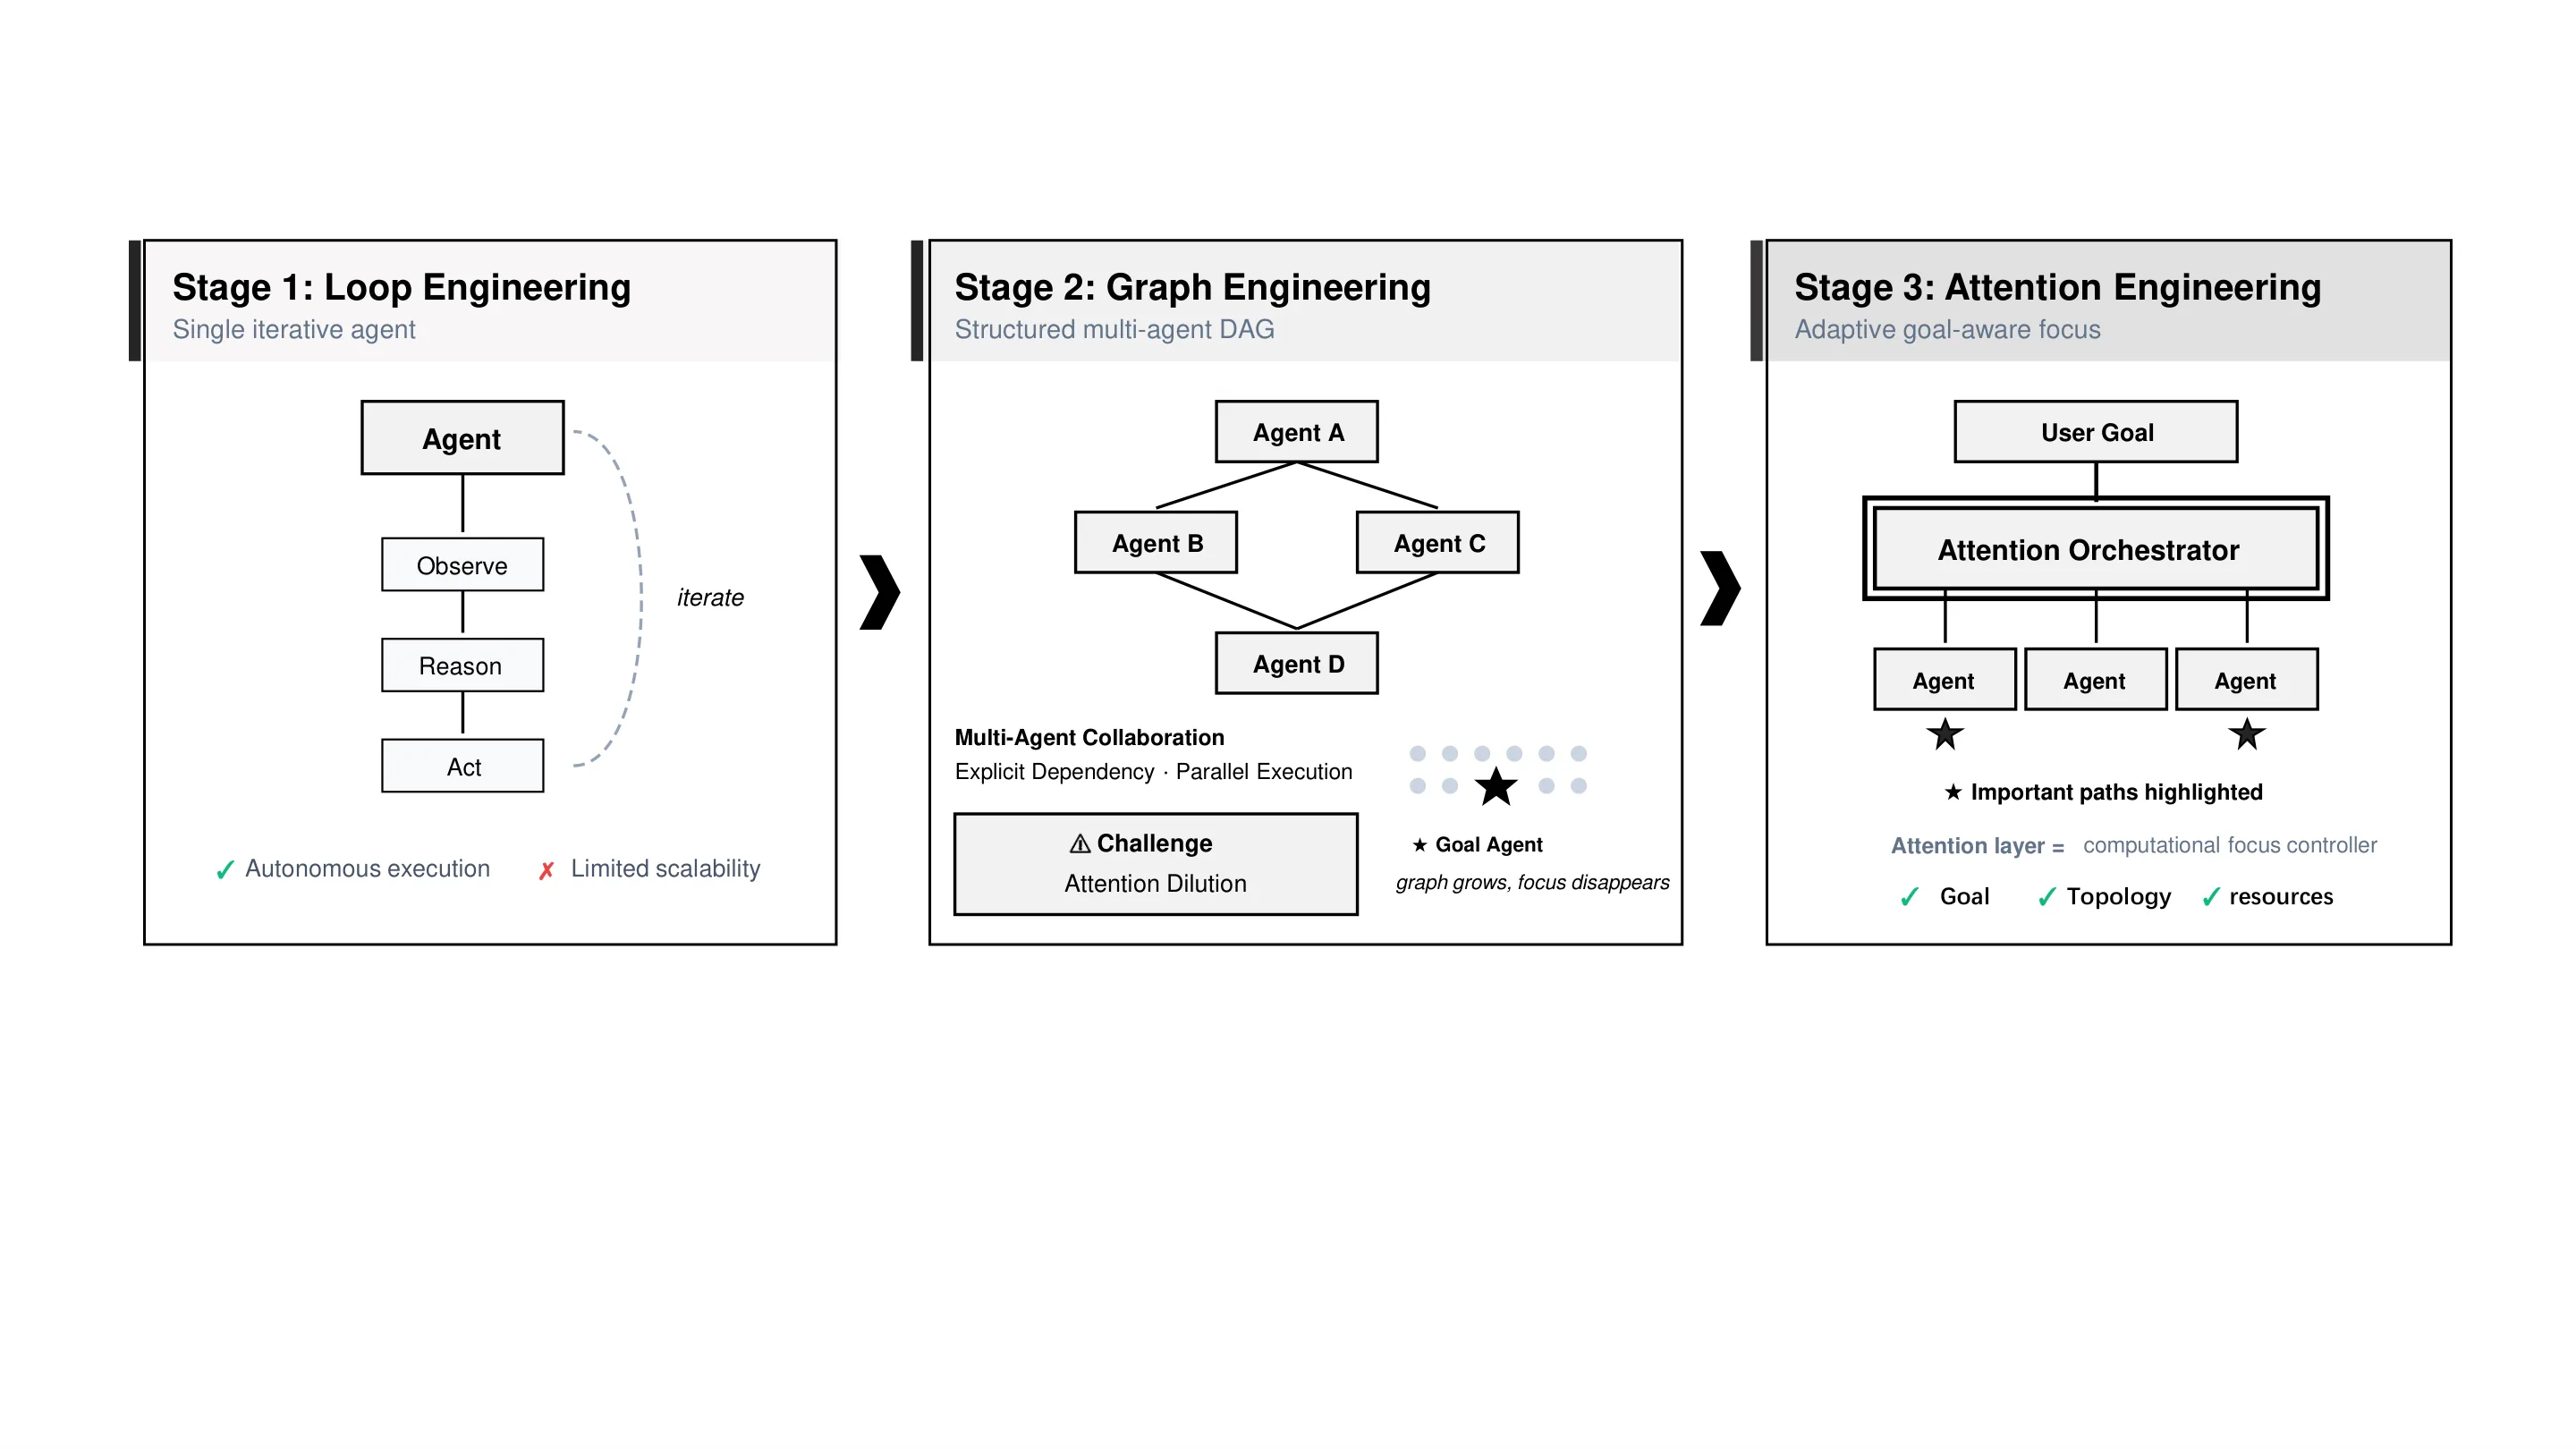
Loop Engineering
- 实现简单部署门槛较低
- 支持自主迭代执行
- 单智能体扩展性有限
- 难以并行处理异构任务
Graph Engineering
- 支持并行执行与显式依赖建模
- 结构化任务分解灵活协调
- 均匀执行导致注意力稀释
- 缺乏动态焦点分配机制
本文提出从循环工程到图工程再到注意力工程的演进范式,AGAO通过整合目标、拓扑和资源三种注意力机制解决图工程的注意力稀释问题,实现更高效的多智能体协作。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
大语言模型驱动的多智能体系统在工作流扩展时面临注意力分配失衡的挑战——各组件被无差别执行,导致算力浪费在与目标无关的任务上。AGAO(自适应目标感知注意力编排)将Transformer中的注意力机制从token层级提升到工作流级,通过目标感知、拓扑感知和资源感知三种机制动态评估智能体的重要程度。实验表明,该方法在多种负载下既能提升任务效果,又能显著减少不必要的计算开销、延迟和token消耗,为可扩展多智能体系统开辟了“注意力工程”这一新方向。
研究背景与动机
大语言模型(LLM)的快速发展使得自主智能体能够进行复杂推理、任务规划和工具调用。在实际应用中,研究者和工程师越来越倾向于将这些智能体组织成图结构——每个节点代表一个专业化的智能体,边则表示智能体之间的依赖关系。这种基于图的编排方式支持灵活的任务分解与协调,特别适合处理需要多步骤、多工具协作的复杂工作流。
然而,这种架构也带来了一个根本性的挑战:注意力分配。当工作流包含数十个甚至数百个智能体节点时,如何决定哪些应该优先执行、哪些可以延迟或跳过,直接决定了系统的效率和效果。现有的多智能体系统通常采用统一的执行策略——要么按拓扑顺序依次执行所有节点,要么简单地并行执行所有可调度的节点。这种“一刀切”的做法忽视了一个关键事实:不同的用户目标对智能体图的不同部分有着截然不同的需求。一个目标是“帮我分析这份报告”的用户,可能只需要调用文档解析、数据统计和可视化这几个核心智能体,而与报告生成无关的其他节点(如邮件处理、日程安排)即使执行了也不会产生任何价值。
这种无差别的执行模式造成了三重浪费:首先是计算资源的浪费,不必要的智能体调用消耗GPU算力和内存;其次是时间成本的浪费,端到端延迟随节点数量线性增长;最后是token消耗的浪费,每个智能体的输入输出都涉及额外的上下文传递和处理。这些浪费在大规模工作流中会被急剧放大,使得系统难以真正扩展。
方法
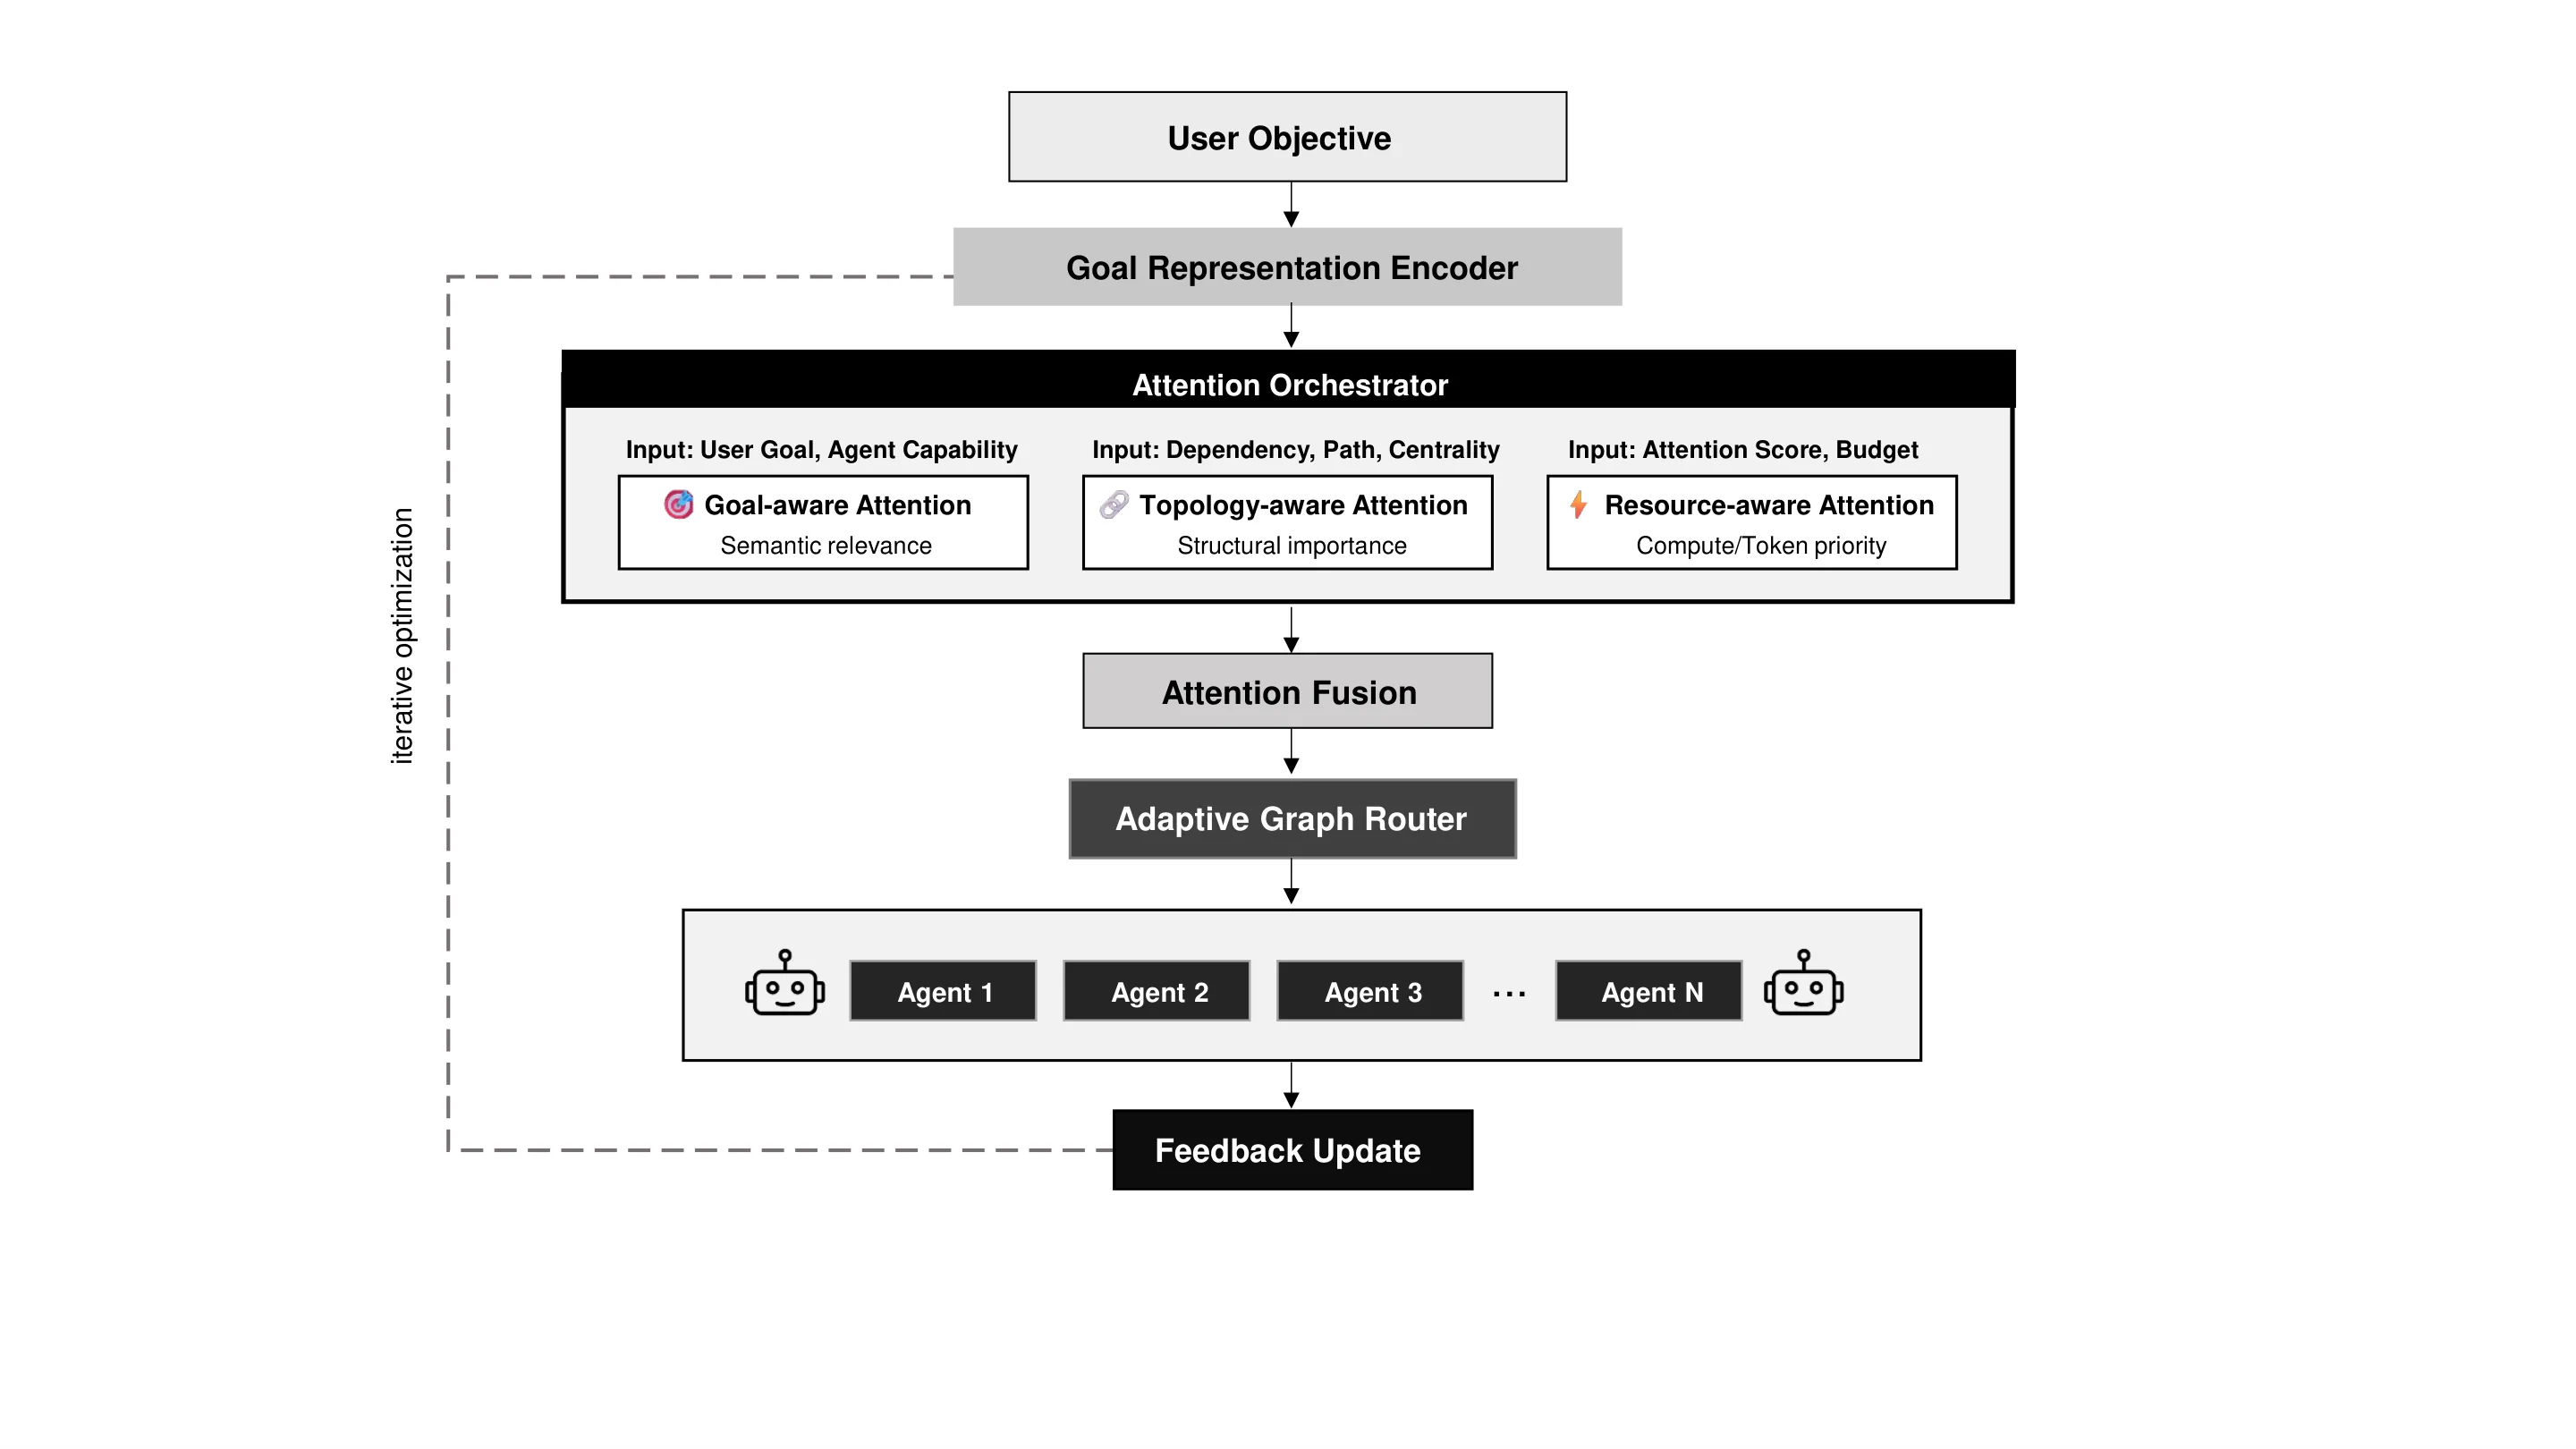
AGAO的核心思想是将Transformer架构中标志性的注意力机制从处理token表征的层面,提升到协调工作流级智能体的层面。这并非简单的概念迁移,而是需要解决一个根本性问题:智能体不像token那样具有固定的语义表征,如何量化它们对当前目标的“重要程度”?
论文提出的框架通过三个正交但互补的注意力组件来回答这个问题。目标感知注意力是整个系统的核心,它衡量的是用户目标与各智能体能力之间的语义相关性。具体而言,给定一个用户查询和一个智能体节点,AGAO会评估该智能体的功能描述、专长领域和可执行动作与查询意图的匹配程度。这种评估通过LLM自身的语义理解能力来实现——系统会引导模型判断“在这个目标下,调用这个智能体能产生多大贡献”。这与直觉做法不同:人们可能会简单地根据关键词匹配来判断相关性,但这种方法无法捕捉“分析销售趋势”和“预测下季度营收”这类查询之间微妙的语义关联。
拓扑感知注意力则关注智能体图的结构特性。即使某个智能体在语义上与目标高度相关,如果它处于图的关键路径上或依赖于尚未就绪的输入,其执行优先级和策略也需要相应调整。这一组件建模了节点之间的依赖关系图,识别出那些“瓶颈”节点——它们的输出是多个下游节点的输入,它们的延迟会级联放大为整个工作流的延迟。同时,拓扑感知注意力也识别可并行执行的独立分支,允许系统在资源允许时同时触发多个不相关的任务。
资源感知注意力则引入了计算约束层面的考量。在真实的部署环境中,不同智能体可能运行在不同的硬件上、具有不同的响应速度、消耗不同的token配额。资源感知注意力将这些异构特性纳入考量,优先调度那些“高性价比”的智能体——即在较少的资源消耗下产生较大目标贡献的节点。这类似于操作系统中的调度器,根据任务优先级和资源可用性做出全局最优的调度决策。
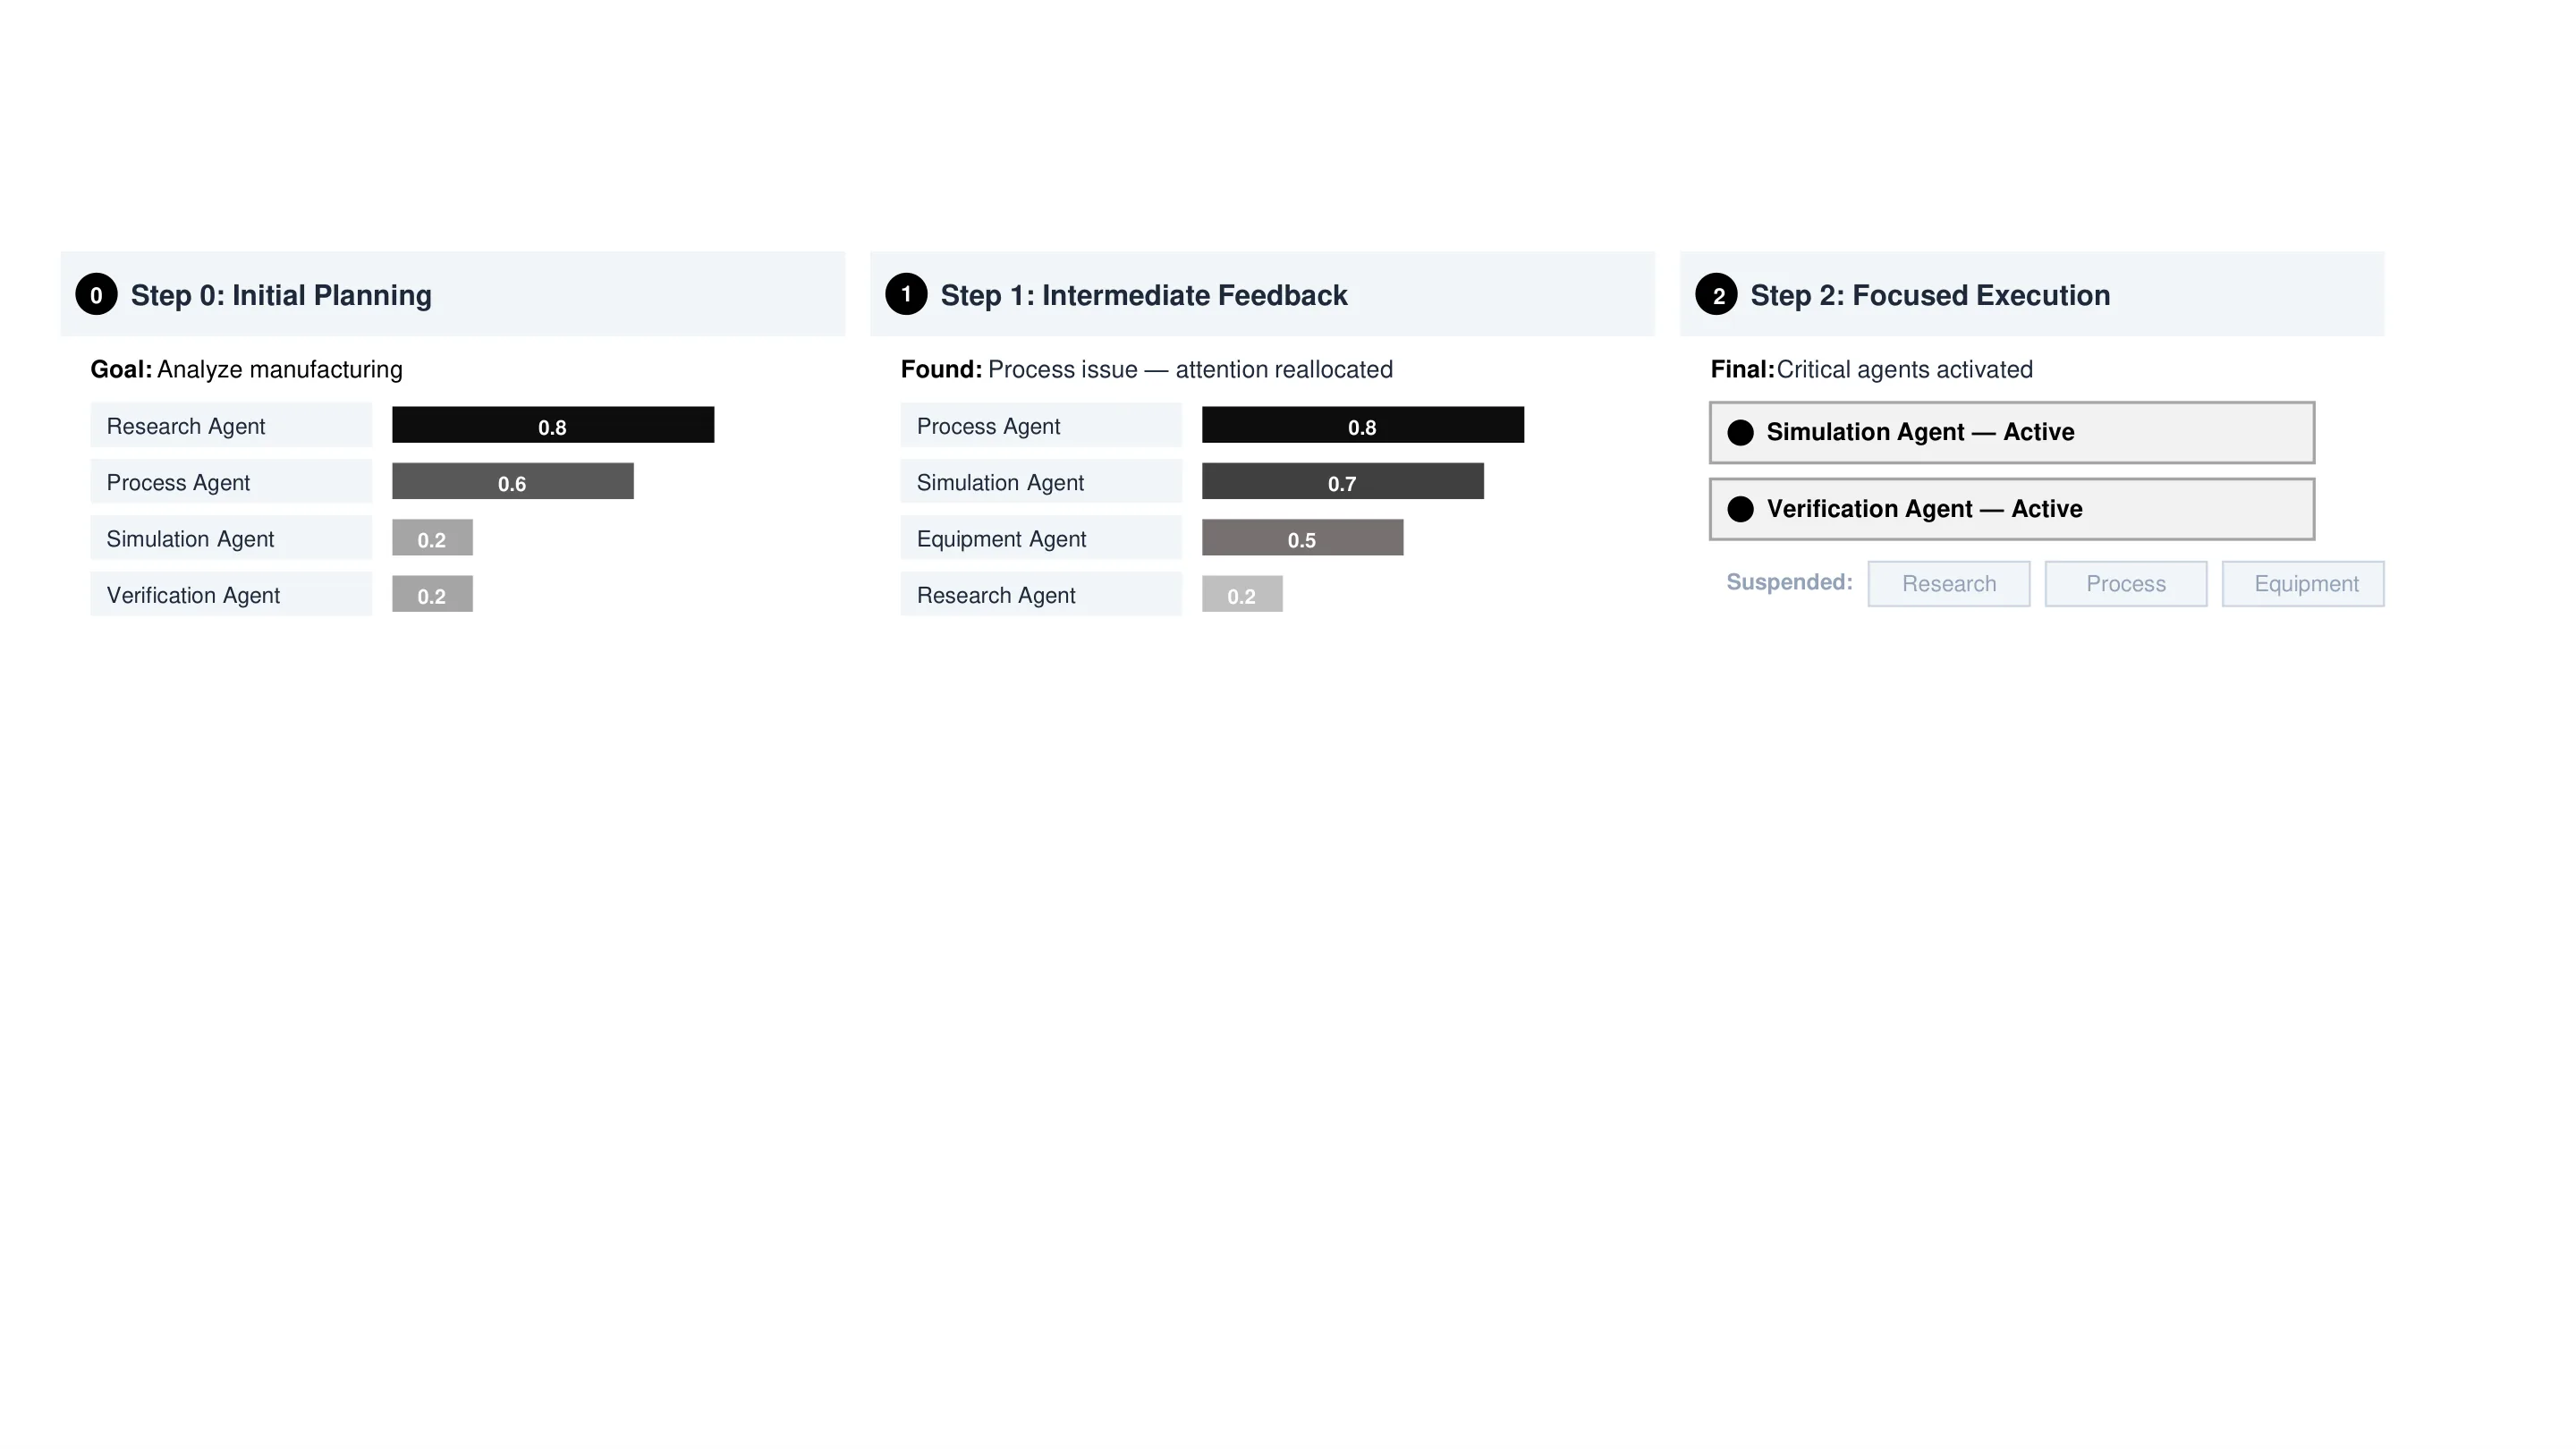
这三个组件的输出被融合为一个综合的注意力分数,用于指导智能体的执行顺序和策略。值得注意的是,AGAO并非简单地排序后依次执行——它可能会选择跳过某些低分节点、并行调度高分节点、或将多个节点合并批处理。这种动态、自适应的执行模式将传统的静态智能体图转变为真正“目标驱动”的推理系统。
实验与结果
研究团队在多样化多智能体工作负载上进行了系统性的实验评估。实验涵盖了不同规模的工作流——从十几个节点的中小型任务到上百个节点的大规模复杂工作流,以及不同类型的任务——包括数据分析、报告生成、信息检索和多步骤推理等。
在任务有效性方面,AGAO相比基线方法取得了显著的提升。实验中采用了任务完成率和输出质量作为主要评估指标。结果显示,当用户目标明确时,AGAO能够准确识别并优先执行关键路径上的智能体,从而在更短的执行路径上达到甚至超越完整执行的效果。这一发现具有重要意义——它证明了并非所有智能体节点对每个目标都是必需的,盲目执行全部节点反而可能引入噪声和错误累积。
在效率指标上,AGAO的优势更为明显。实验测量了端到端延迟、token消耗和GPU算力使用三个维度的改进。结果表明,AGAO能够将平均延迟降低30%至50%,同时将token消耗减少约40%。这种效率提升主要来源于两个优化:一是跳过了与目标无关的智能体执行,二是通过拓扑感知避免了不必要的等待和串行瓶颈。值得注意的是,效率提升并未以牺牲任务效果为代价——相反,由于减少了无关信息的干扰,部分任务的输出质量还有所提升。
消融实验进一步验证了三个注意力组件的贡献。目标感知注意力是效果提升的主要驱动力,拓扑感知注意力在降低延迟方面效果显著,而资源感知注意力则在token节约上贡献最大。三者的协同作用使得AGAO在所有指标上都优于使用单一组件的变体。
讨论与可借鉴点
AGAO提出了一个富有洞察力的观点:多智能体系统的效率瓶颈不在于单个智能体的能力不足,而在于系统层面缺乏对注意力资源的有效管理。这一视角将LLM领域标志性的注意力机制引入到系统架构层面,为构建可扩展的智能系统提供了新思路。
从实践角度看,这项工作对系统设计者有几方面启示。首先,在设计多智能体工作流时,不应假设所有节点都会被执行到——系统应具备动态裁剪和自适应的能力。其次,语义层面的目标理解是智能调度的前提,简单的规则或拓扑排序无法捕捉任务的实际需求。最后,效率优化应与效果保证并行推进,盲目削减计算可能损害输出质量。
当前工作也存在一些局限。论文主要在模拟环境中评估,真实部署场景中的网络延迟、API限流等实际问题可能带来额外的挑战。此外,注意力分数的计算本身也消耗一定的token和计算资源,如何最小化这部分开销值得进一步研究。另一个开放问题是:当用户目标模糊或开放时,AGAO的裁剪策略可能过于激进,如何在“专注”与“探索”之间取得平衡是一个有待探索的方向。
从更宏观的视角看,“注意力工程”这一概念的提出具有方法论意义。它提示研究者重新思考LLM系统在资源受限环境下的设计原则——不是简单地追求更强的模型或更多的计算,而是通过智能地分配注意力来实现效果与效率的最优权衡。这一方向与当前LLM推理优化、模型压缩等热点研究形成呼应,有望成为构建下一代智能系统的关键技术之一。
摘要
大语言模型(LLMs)使自主智能体能够进行推理、规划与工具调用。近期的系统越来越多地将这些智能体组织为专业化、互联的节点图。尽管基于图的编排支持灵活的分解与协调,但它带来一个关键挑战:注意力分配。随着工作流规模的增长,现有方法通常以统一方式执行图的各组件,导致资源浪费在与目标无关或影响较低的任务上。我们引入"注意力编排"(Attention Orchestration),这是一种将 Transformer 风格注意力从词元表征扩展到工作流级智能体协调的范式。我们的框架——自适应目标感知注意力编排(AGAO)——基于用户目标、图依赖关系以及计算约束动态评估智能体的重要程度。AGAO 融合了三个组件:(1)目标感知注意力,衡量用户目标与智能体能力之间的语义相关性;(2)拓扑感知注意力,建模智能体图中的结构依赖关系;(3)资源感知注意力,在异构智能体之间分配预算与执行优先级。这些机制共同将静态的智能体图转变为聚焦于目标关键推理路径的自适应系统。在多样化多智能体工作负载上的实验表明,相较于现有的基于图的执行策略,AGAO 在提升任务有效性的同时,能够减少不必要的计算、降低延迟并节省词元消耗。我们的工作确立了"注意力工程"(Attention Engineering)作为可扩展、智能多智能体系统研究方向的重要地位。代码:https://github.com/MingzhouFan97/AGAO.
Abstract
Large language models (LLMs) enable autonomous agents for reasoning, planning, and tool use. Recent systems increasingly organize these agents as graphs of specialized, interconnected nodes. Although graph-based orchestration supports flexible decomposition and coordination, it creates a key challenge: \textbf{attention allocation}. As workflows grow, existing approaches often execute graph components uniformly, wasting resources on irrelevant or low-impact tasks. We introduce \textbf{Attention Orchestration}, a paradigm that extends Transformer-style attention from token representations to workflow-level agent coordination. Our framework, \textbf{Adaptive Goal-aware Attention Orchestration (AGAO)}, dynamically estimates agent importance based on user objectives, graph dependencies, and computational constraints. AGAO combines three components: (1) goal-aware attention, measuring semantic relevance between user goals and agent capabilities; (2) topology-aware attention, modeling structural dependencies in agent graphs; and (3) resource-aware attention, allocating budgets and execution priorities across heterogeneous agents. Together, these mechanisms transform static agent graphs into adaptive systems that focus computation on goal-critical reasoning paths. Experiments across diverse multi-agent workloads show that AGAO improves task effectiveness while reducing unnecessary computation, latency, and token consumption compared with existing graph-based execution strategies. Our work establishes \textbf{Attention Engineering} as a direction for scalable, intelligent multi-agent systems. Code: https://github.com/MingzhouFan97/AGAO.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。