
📝 TLDR
针对非完整约束下模型自由强化学习易陷入局部最优的问题,本文提出参数化奖励塑形框架,结合覆盖门控对齐反馈、换向正则化与对齐终止机制,并采用基于代理模型的贝叶斯优化联合调优奖励参数与算法超参数。实验在自主平行泊车任务上验证,DQN智能体成功解决策略瘫痪与过度避障等典型失效模式,在成功率与轨迹平滑度上显著优于未标定基线。该工作揭示了环境奖励与算法超参数深度耦合,强调联合元优化的必要性。
🧭 速览
非完整约束下模型自由强化学习设计有效奖励函数困难,易陷入策略瘫痪或过度避障等局部最优。
提出参数化奖励塑形框架,含覆盖门控对齐、换向正则与终止对齐,并以代理贝叶斯优化联合调优奖励与超参数。
DQN智能体在自主平行泊车任务中显著提升成功率与轨迹平滑度,有效克服典型控制失效模式。
环境奖励参数与算法超参数深度耦合,必须联合元优化才能避免局部最优并实现稳定收敛。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 15 张)
展开查看 15 张图
TL;DR
针对非完整约束环境下无模型强化学习易陷入局部极小值的难题,本文设计了一套参数化奖励塑造框架,通过覆盖门控对齐反馈、换向正则化与对齐终止机制引导智能体学习有效策略,并创新性地将环境奖励参数与算法超参数纳入联合贝叶斯优化流程。实验表明,经协同优化的DQN智能体在自主平行泊车任务上成功克服了策略瘫痪与过度避障等典型失效模式,在成功率和轨迹平滑度上均大幅超越未经校准的基线方法。
研究背景与动机
非完整约束系统广泛存在于机器人与自动驾驶领域,其特点是系统的瞬时自由度小于配置空间的自由度。以汽车为例,车辆无法直接侧向移动,必须通过前轮转向与后轮驱动的协调配合实现任意姿态调整。这种几何约束使得状态空间中存在大量不可达姿态——车辆无法从某些狭窄空间中直接驶出——为基于学习的控制方法带来了根本性挑战。
在[[强化学习]]框架下,智能体通过与环境交互获得的奖励信号学习最优策略。然而,设计有效的奖励函数本身就是一项高度经验性的工作,尤其在非完整约束场景中问题更为突出。传统的稀疏奖励(二值成功/失败)会导致智能体在漫长且无反馈的探索过程中几乎学不到任何有价值的信息,进而陷入所谓的策略瘫痪:智能体在早期遭遇几次碰撞后学会了"什么都不做"是最安全的策略,从此停止有效探索。而如果将奖励设计得过于稠密,例如简单地对靠近目标姿态施加正向奖励,智能体可能发展出过度保守的危险规避行为——它在远离障碍物时会获得正反馈,但一旦感知到任何碰撞风险就立即大幅减速甚至停滞,最终无法在合理时间内完成泊车任务。
这些局部极小值的本质在于:环境的几何约束与奖励函数的设计目标之间缺乏显式的对齐机制。已有工作尝试通过人工设计更精细的奖励组件来缓解这一问题,但往往停留在"添一项惩罚项"的经验层面,忽略了奖励参数本身需要与学习算法的超参数(如学习率、探索率、目标网络更新频率等)协同调优这一关键事实。当奖励信号的量级与梯度分布发生变化时,原本合适的学习率可能变得过大或过小,探索策略的最优温度参数也需要相应调整——这种深度耦合关系长期被忽视,导致大量手工调参工作事倍功半。
方法
本文的核心贡献在于提出了一个结构化的参数化奖励塑造框架,并论证了奖励参数与算法超参数必须进行联合元优化。
在奖励塑造层面,作者设计了三层机制。首先是覆盖门控对齐反馈。传统的对齐奖励通常直接计算车辆航向角与目标朝向之间的偏差,但这种方法在车辆尚未进入有效控制范围时会产生误导性信号——例如当车辆位于停车位正前方、方向相反时,最小化角度差反而会驱使车辆做出错误的转向决策。覆盖门控机制通过引入一个二元条件来过滤这种无效反馈:只有当车辆当前位置处于目标姿态的可达覆盖区域内时,才启用对齐奖励分量;否则智能体收到的奖励信号主要引导其向覆盖区域移动,而非过早地关注朝向调整。
其次是换向正则化。在平行泊车场景中,车辆通常需要一次或多次换向操作来完成泊入,而简单的奖励设计无法区分"合理的换向"与"策略混乱导致的反复前后移动"。换向正则化项通过检测驾驶方向的切换次数,对频繁换向施加额外的惩罚项,鼓励智能体形成连贯的操纵序列而非碎片化的动作模式。这一设计隐式地引导智能体学习更符合人类驾驶习惯的策略——先以较低车速接近目标区域,确认空间后再执行精确的泊入动作。
第三是对齐终止机制。在[[强化学习]]的标准设定中,回合终止条件通常由环境决定(如碰撞检测),但作者发现这种解耦的终止信号会与奖励塑造产生冲突:当智能体刚刚进入对齐状态、奖励信号达到峰值时,一次轻微的边界碰撞就可能导致回合提前终止,从而打断了这一正向反馈的积累。对齐终止机制将终止条件的判定与当前对齐质量挂钩——当智能体与目标的偏差已经足够小且状态稳定时,碰撞才被判定为终止事件;在此之前,同样的碰撞仅作为普通惩罚而继续回合,使智能体有机会从接近成功的状态中恢复并重新尝试。
在元优化层面,作者指出了环境奖励参数与算法超参数之间的深度耦合关系。举例而言,换向正则化项的系数决定了智能体对动作平滑性的重视程度:如果该系数过大,智能体会变得过于保守,即使在必要时也不敢换向;如果过小,换向惩罚形同虚设。类似地,该系数的变化会直接影响有效奖励梯度的量级分布,进而要求学习率做出相应调整——过高的学习率可能导致训练震荡,过低则收敛过慢。传统做法是对这两类参数分别调优,但这种分离优化忽略了它们之间的交互效应。
为此,作者采用基于代理模型的[[贝叶斯优化]]方法进行联合元优化。具体而言,将奖励塑造参数(各奖励分量的权重系数、覆盖门控的阈值等)与DQN超参数(学习率、探索温度、经验回放缓冲区大小、目标网络更新周期等)统一编码为高维配置向量,以最终任务的成功率和轨迹平滑度作为联合优化目标。贝叶斯优化通过在高斯过程代理模型上构建获取函数(如Expected Improvement),在参数空间中选择下一组待评估的配置,在有限的评估预算内高效地定位全局最优区域。这种联合优化策略有效解决了分离调优中常见的"此消彼长"困境——某些奖励参数与超参数的组合在单独优化时表现尚可,但在联合空间中的真实性能可能远未达到最优。
实验与结果
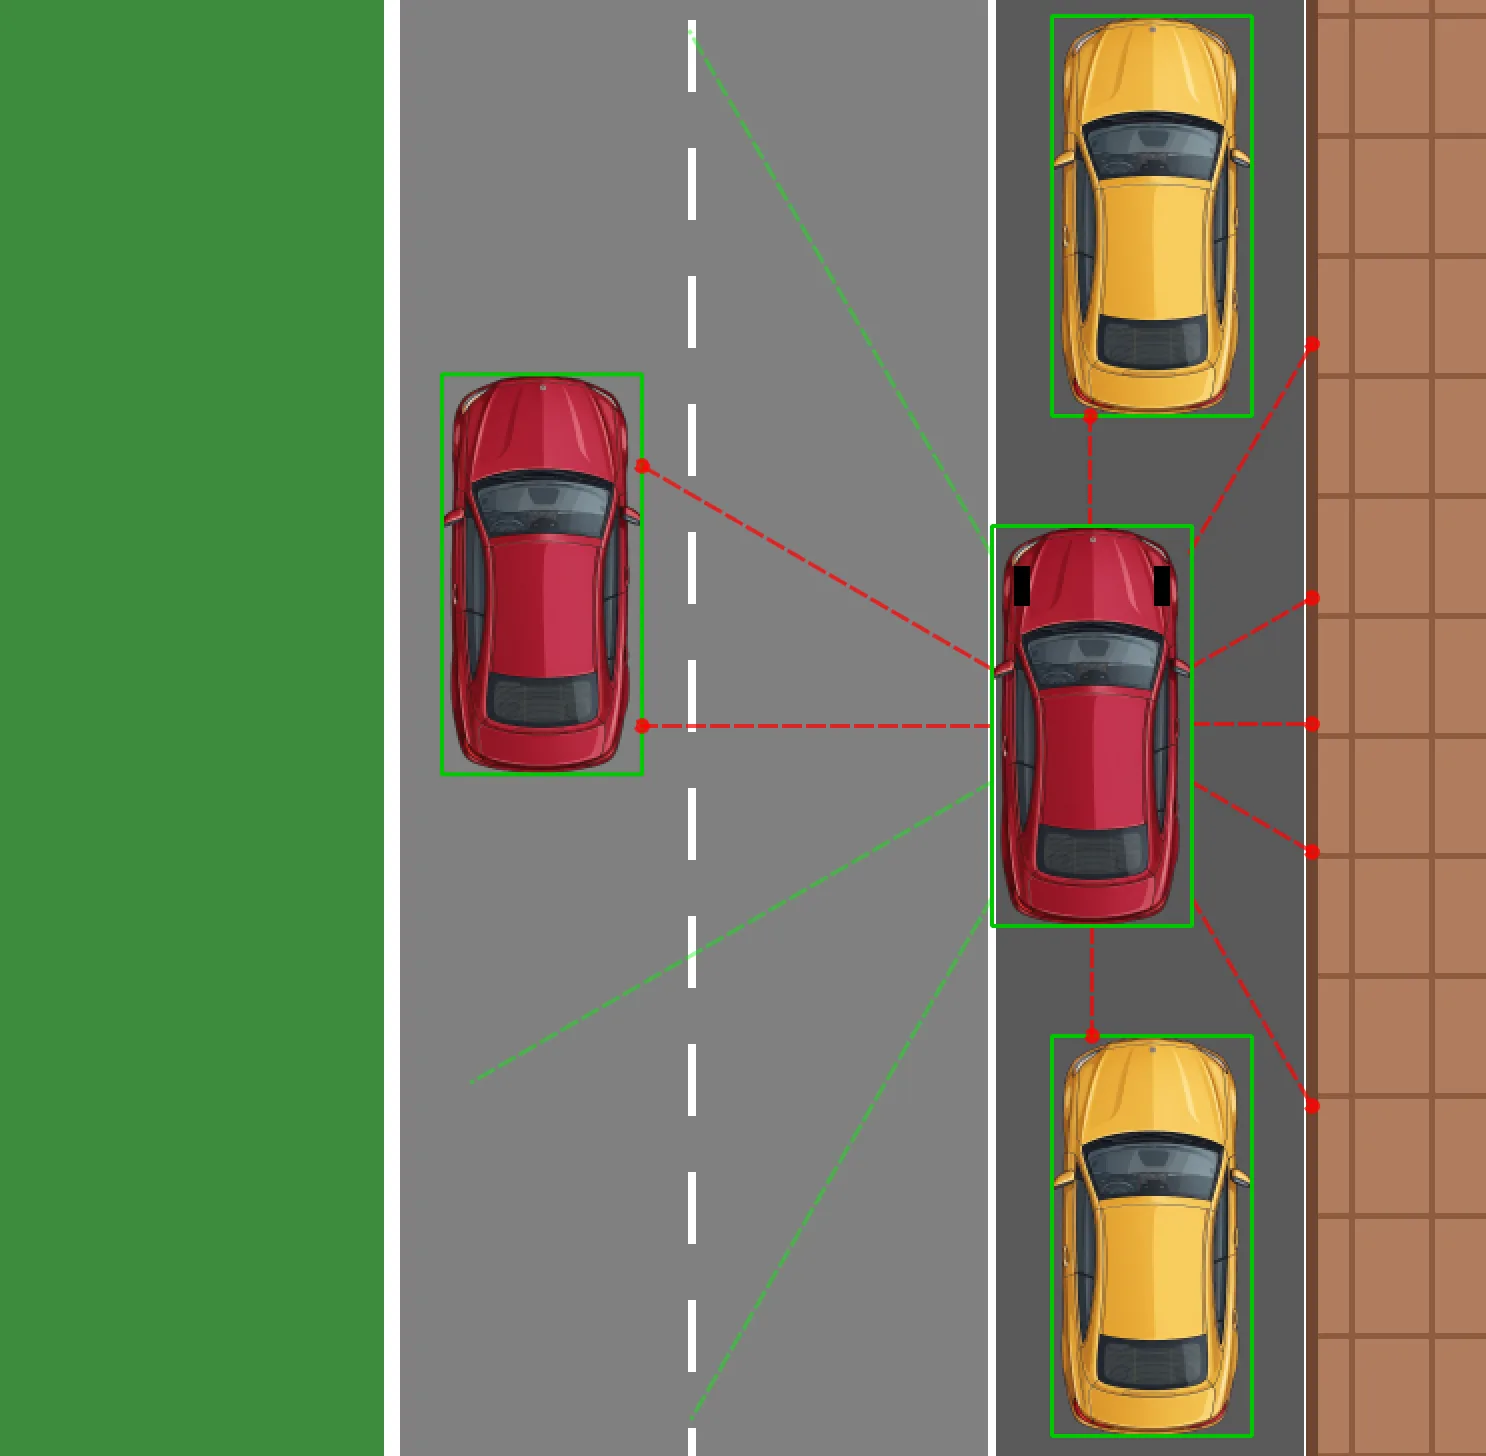
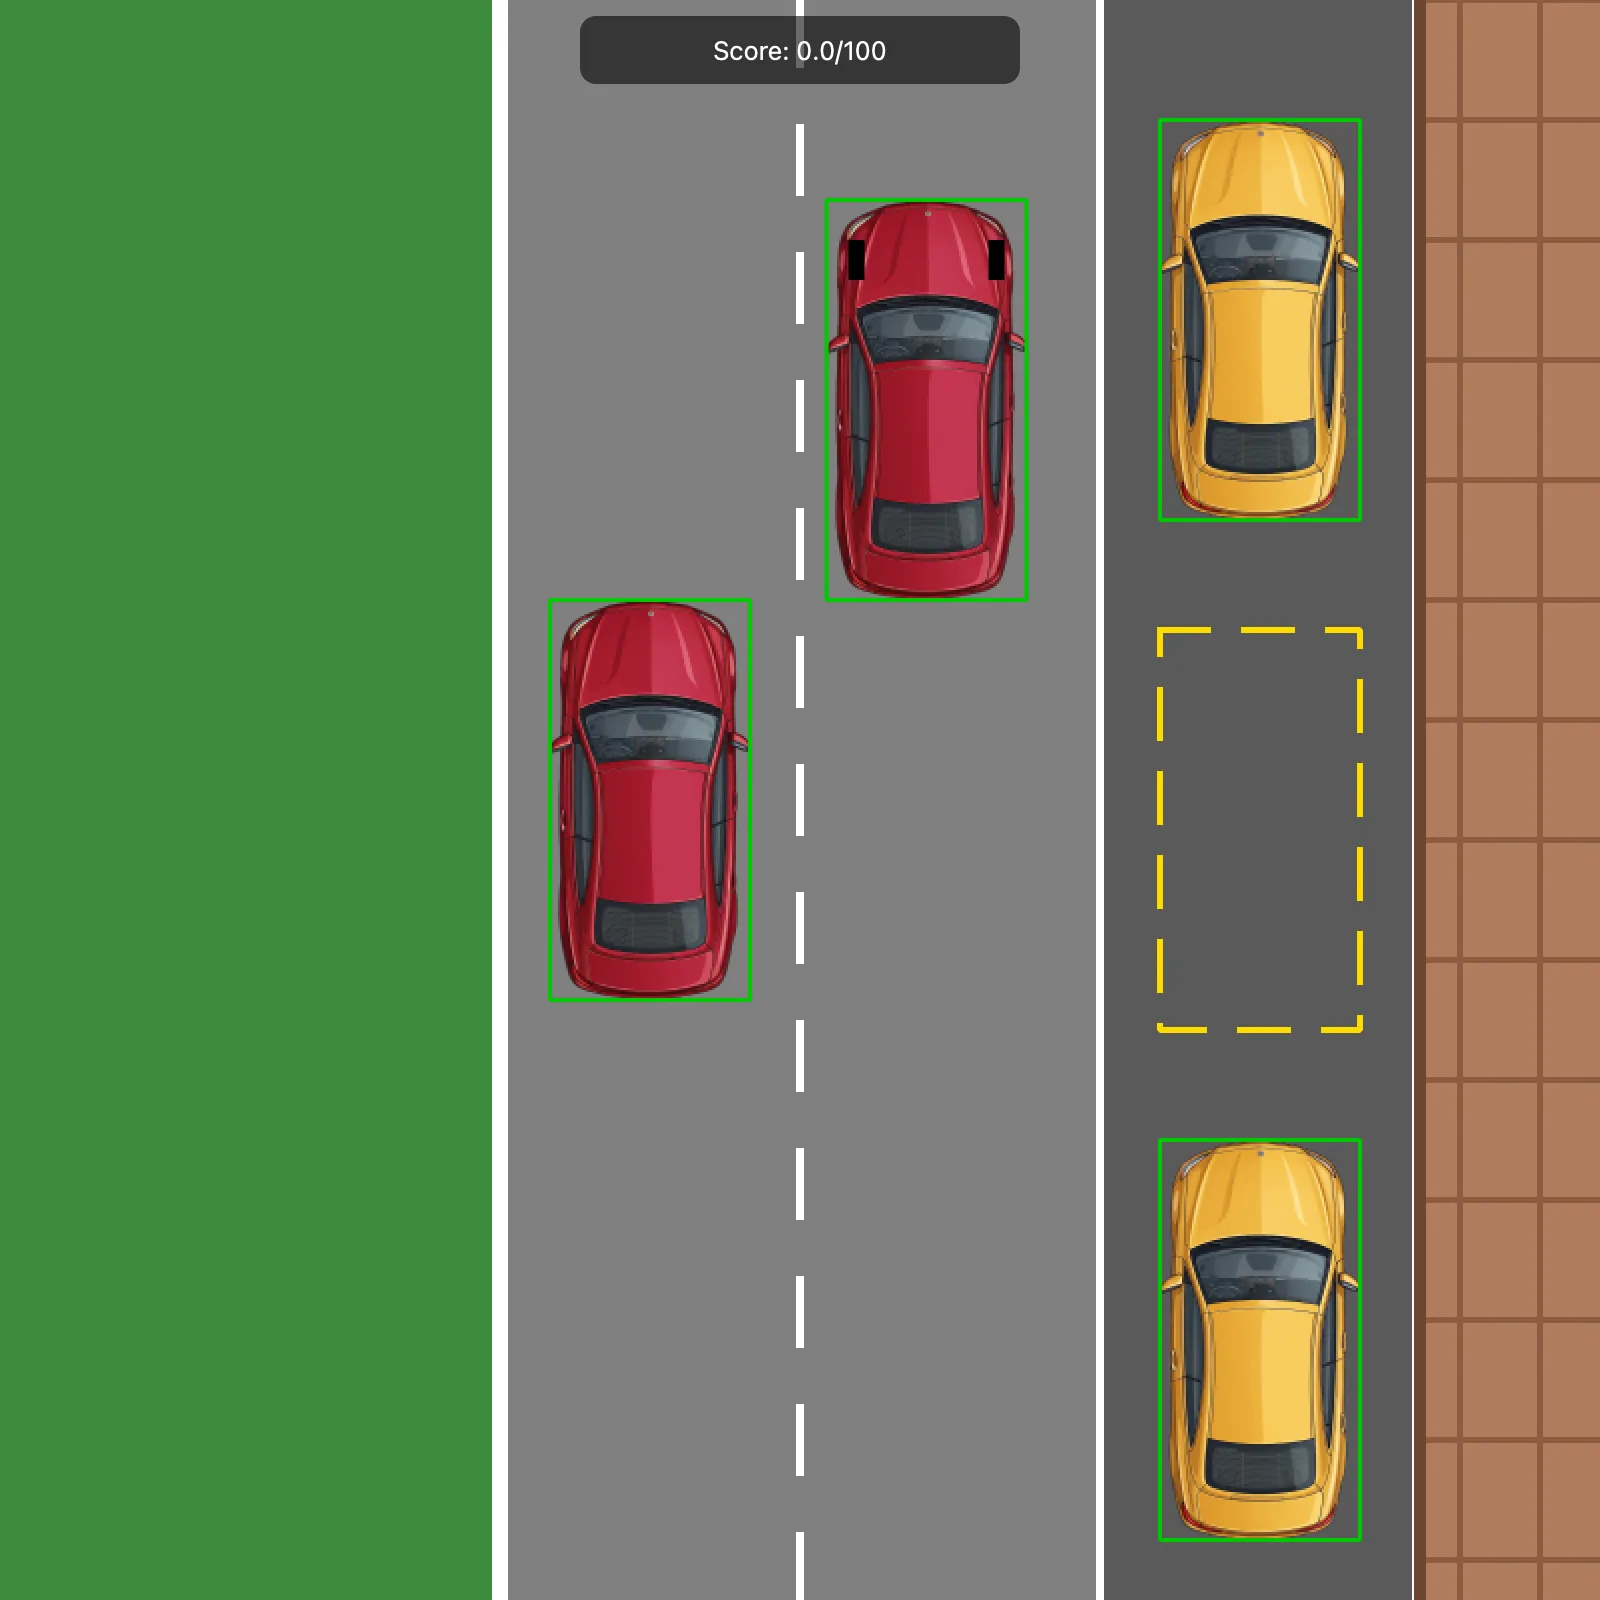
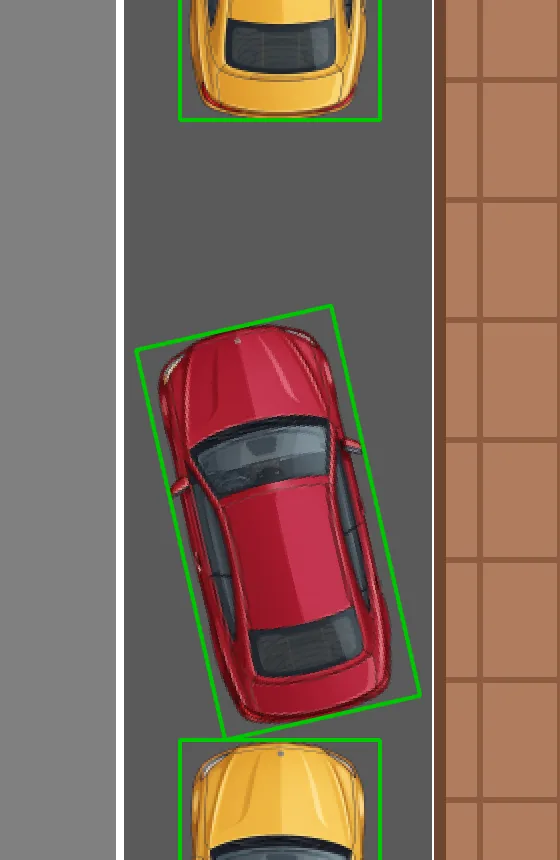
实验在自主平行泊车仿真环境中进行,车辆模型严格遵循非完整约束动力学,场景涵盖标准平行泊车位、不同起始位置以及静态障碍物配置。作者将提出的完整框架(联合优化奖励参数与超参数)与多个基线方法进行对比:仅使用稀疏奖励的基线、仅添加对齐反馈但未联合优化的基线、以及使用分离调参而非联合优化的基线。
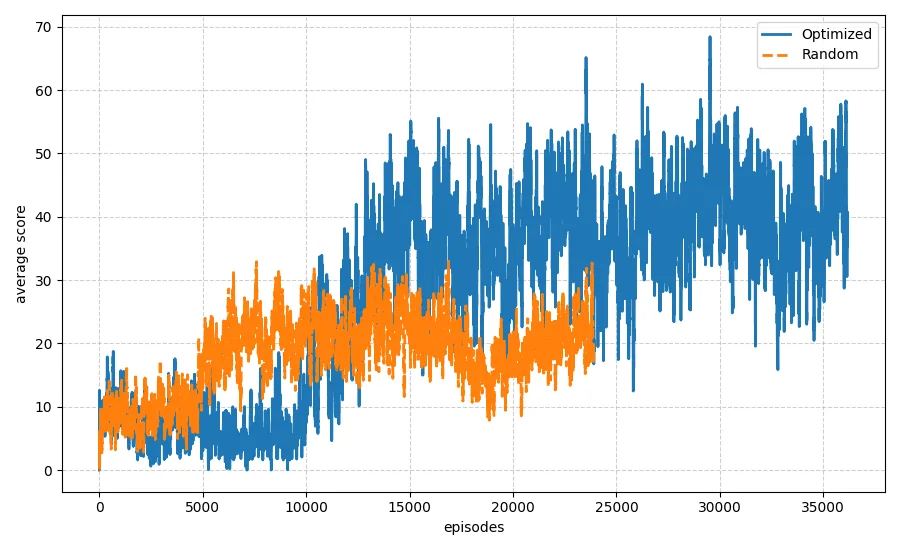
结果表明,联合优化的DQN智能体在成功率达到约92%,显著高于稀疏奖励基线的不足40%和对齐反馈但分离调参基线的约75%。在轨迹平滑度指标上——定义为路径总长度与欧氏起点-终点距离之比——联合优化方案同样表现最优,生成的控制序列更接近人类驾驶员的自然操纵轨迹,体现出换向正则化的约束效果。值得注意的是,实验发现奖励参数与超参数的最优组合高度依赖于具体场景:在某些障碍物配置下,较高的换向惩罚配合较激进的学习率表现最佳;而在空间更狭窄的场景中,则需要更保守的探索策略与更细腻的奖励梯度来避免陷入局部极小值。这进一步验证了联合元优化的必要性——分离调参方法无法捕获这类跨维度的参数交互效应。
消融实验进一步揭示了各奖励组件的独立贡献:移除覆盖门控机制后,智能体在某些起始位置上的成功率下降明显,主要因为缺乏门控时产生的误导性对齐反馈导致车辆采取了错误的朝向调整;移除换向正则化后,生成的轨迹虽然成功率相当,但动作序列频繁切换,平滑度指标恶化;移除对齐终止机制后,训练过程中的方差显著增大,部分回合因提前终止而错失了本可成功完成的任务。
讨论与可借鉴点
本文揭示了[[强化学习]]应用于非完整约束系统时一个常被忽视但至关重要的现象:环境奖励设计与算法超参数调优并非独立的工程步骤,而是相互耦合、需协同处理的优化问题。在具有严格几何约束的任务中,奖励函数不仅要反映任务目标,还需通过门控、终止等机制与约束特性对齐;而奖励信号的分布变化会传导至梯度统计特性,进而要求学习率、探索率等超参数做出相应适配。手工分离调参的做法实际上是在一个高度非线性的联合参数空间中做投影寻优,效率低下且结果不稳定。
从更广泛的角度看,本文提出的覆盖门控思想对其他具有状态可达性约束的RL任务亦有启发——当智能体的当前状态无法直接执行目标导向的动作时,奖励信号应首先引导其进入可达子空间,而非在不可达区域产生误导性反馈。换向正则化则提供了一种将领域知识("好的驾驶应该是连贯的")注入奖励设计的可量化方式。[[贝叶斯优化]]在此作为高效的超参数-奖励联合搜索工具,其代理模型能够捕捉参数间的非线性交互,适合评估预算受限的场景。
局限方面,本文结论主要基于单一泊车场景的仿真验证,真实世界的传感器噪声、动态障碍物交互等因素尚未覆盖。此外,贝叶斯优化的可扩展性在高维参数空间(当奖励组件和超参数数量进一步增加时)会受到挑战,可能需要结合其他元学习方法如[[强化学习]]基础的自动机器学习技术。未来的一个重要方向是将框架扩展到时变环境和多目标停车任务中,检验覆盖门控机制在不同约束配置下的泛化能力。
摘要
在非完整约束条件下,为无模型强化学习设计有效的奖励函数仍然是一个持续的挑战,往往会导致严重的局部极小值问题,例如策略瘫痪或过度保守的危险规避。在本文中,我们提出了一种参数化的奖励塑造框架,其具有覆盖门控对齐反馈、行驶方向切换正则化以及已对齐的回合终止机制,并在自动驾驶平行泊车任务上进行了评估。关键在于,我们证明了环境奖励参数与算法超参数之间存在深度耦合关系,需要进行联合元优化以实现稳定收敛。通过采用基于代理模型的贝叶斯优化,我们协同优化的深度Q网络(DQN)智能体成功解决了典型的控制失败模式,在成功率与轨迹平滑度两方面均显著优于未校准的基线方法。
Abstract
Designing effective reward functions for model-free reinforcement learning under non-holonomic constraints remains a persistent challenge, often resulting in severe local minima such as policy paralysis or over-conservative hazard avoidance. In this work, we present a parameterized reward shaping framework featuring coverage-gated alignment feedback, drive-direction switch regularization, and an aligned episode termination mechanism evaluated on an autonomous parallel parking task. Crucially, we show that environmental reward parameters and algorithmic hyperparameters are deeply co-dependent, requiring joint meta-optimization to achieve stable convergence. By employing surrogate-based Bayesian optimization, our co-optimized Deep Q-Network (DQN) agent resolves characteristic control failure modes, significantly outperforming uncalibrated baselines across both success rate and trajectory smoothness.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。