
面向视觉语言模型智能体强化学习的统一评论家混合优势估计
Hybrid Advantage Estimation with Unified Critic for VLM Agentic Reinforcement Learning
📝 TLDR
大视觉语言模型在交互环境中需多轮决策能力,现有方法在token级或turn级优化上各有局限。本文理论推导混合优势函数,证明统一评论器可同时估计两个层级的价值,并提出HyGAE框架。在五个多轮决策任务中取得91%平均成功率,较其他方法提升10%。分析表明混合优势的精确解析形式对优化效果至关重要。
🧭 速览
现有VLM智能体训练在token级逐token优化与turn级均匀信用分配之间存在割裂,缺少统一的层级联合优化机制。
提出HyGAE框架,从理论上推导hybrid advantage函数,并证明统一评论器在合适折扣因子与学习目标下可同时估计turn级与token级价值,联合优化双层目标。
在五个多轮决策环境中达到91%平均成功率,较其他方法提升10%,消融实验验证混合优势精确解析形式的关键作用。
为VLM智能体多轮决策强化学习提供了统一的双层级优化框架,验证了hybrid advantage与unified critic设计的有效性。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
这篇论文针对大型视觉语言模型在多轮交互环境中做决策时的训练优化问题,提出了一个从理论上统一的 actor-critic 框架 HyGAE。核心发现是:通过精心设计的折扣因子与回报公式,单一的价值评论模型可以同时服务于 token 级和轮次级两个优化层级,由此推导出的混合优势函数能够自然平衡偏差与方差。在五个多轮决策任务上,HyGAE 达到平均 91% 的成功率,比现有方法提升约 10%,且训练稳定性显著增强。
研究背景与动机
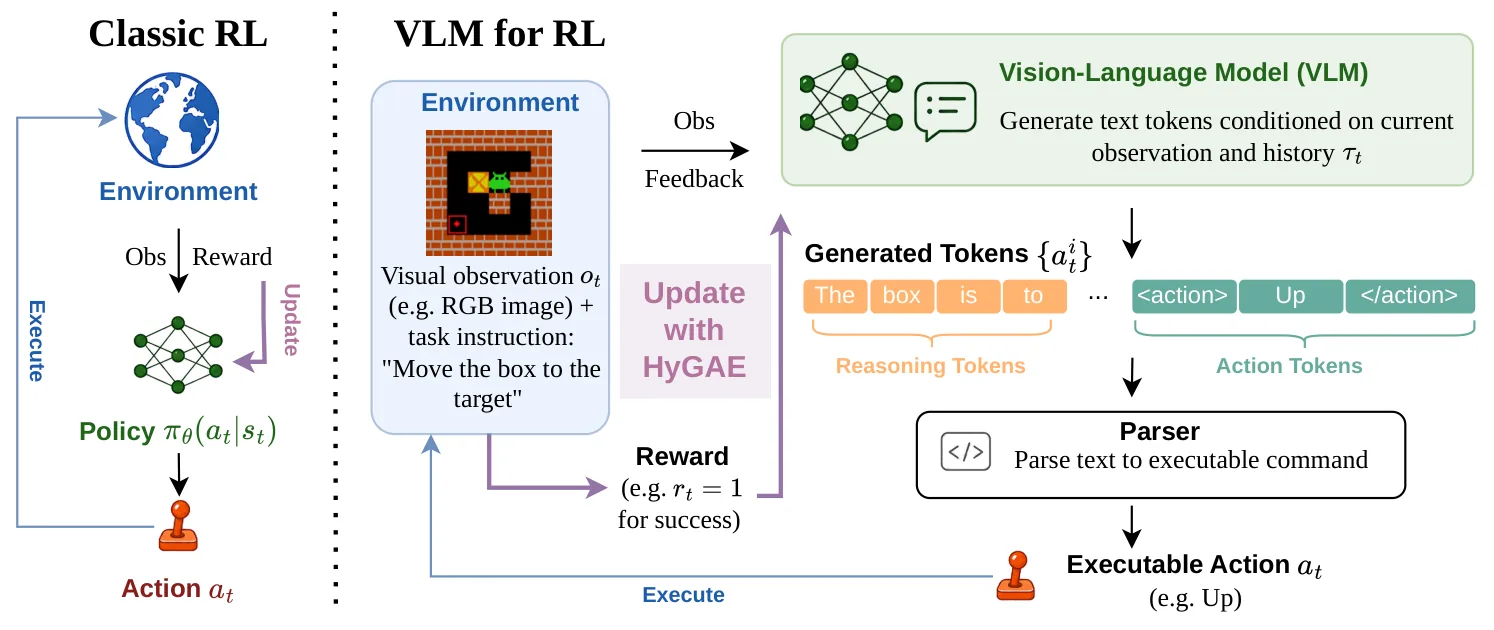
大型视觉语言模型正被广泛部署为交互式环境中的智能体——无论是导航机器人、操作机械臂,还是在模拟城市中规划路径。这类场景的共同特征是多轮决策:模型需要在多个轮次中持续接收环境反馈、调整推理策略、输出连贯的动作序列。仅仅"会说话"远远不够,模型必须学会根据历史经验做出长程规划,避免在死胡同里反复试错。
然而,现有方法在如何训练这类 VLM 智能体上存在明显分歧。一类做法将强化学习的优化粒度设在 token 级别——每个生成的 token 都被当作独立动作来计算梯度,这种细粒度的好处是能够精确指导自回归生成过程,但代价是环境奖励在长文本生成过程中被反复折扣,信息逐渐被稀释,模型容易陷入"短视"的局部最优。另一类做法则将整个轮次视为一个宏观动作,在轮内均匀分配信用,这种粗粒度简化了训练难度,却丢失了 token 级的细粒度信号,导致自回归生成的每一步缺乏有针对性的反馈。
这种割裂让研究者面临两难:选 token 级优化就面临信号衰减,选轮级优化就面临精度损失。论文的切入点正是追问:能否从理论层面统一这两个层级的优化目标,而不是在两者之间做非此即彼的取舍?
方法
论文首先将问题形式化为[[多轮决策]]环境下的[[Actor-Critic]]框架。在每个轮次 中,VLM 生成一段 token 序列 ,环境在轮末给出稀疏的奖励信号 。这催生了一个关键洞察:token 级的奖励可以被定义为轮末奖励在 turn 内的广播——即除了最后一个 token 位置之外,所有中间 token 的奖励均为零。
基于这一形式化,论文证明了两个核心定理。定理一(梯度等价性)指出,当轮级折扣因子 与 token 级折扣因子满足 的关系时,轮级策略梯度、token 级策略梯度,以及论文定义的混合策略梯度三者完全等价。这意味着通过精心选择的折扣因子,混合优化方向与原有两个层级的优化目标保持一致——不存在"两头不靠"的风险。
定理二(价值一致性)进一步证明,在同样的折扣条件下,轮级价值函数与 token 级轨迹末位的价值函数相等,因此无需为两个层级分别维护独立的[[Critic Model]]。一个价值网络足以同时估计两种层级的价值,大幅降低了训练开销。
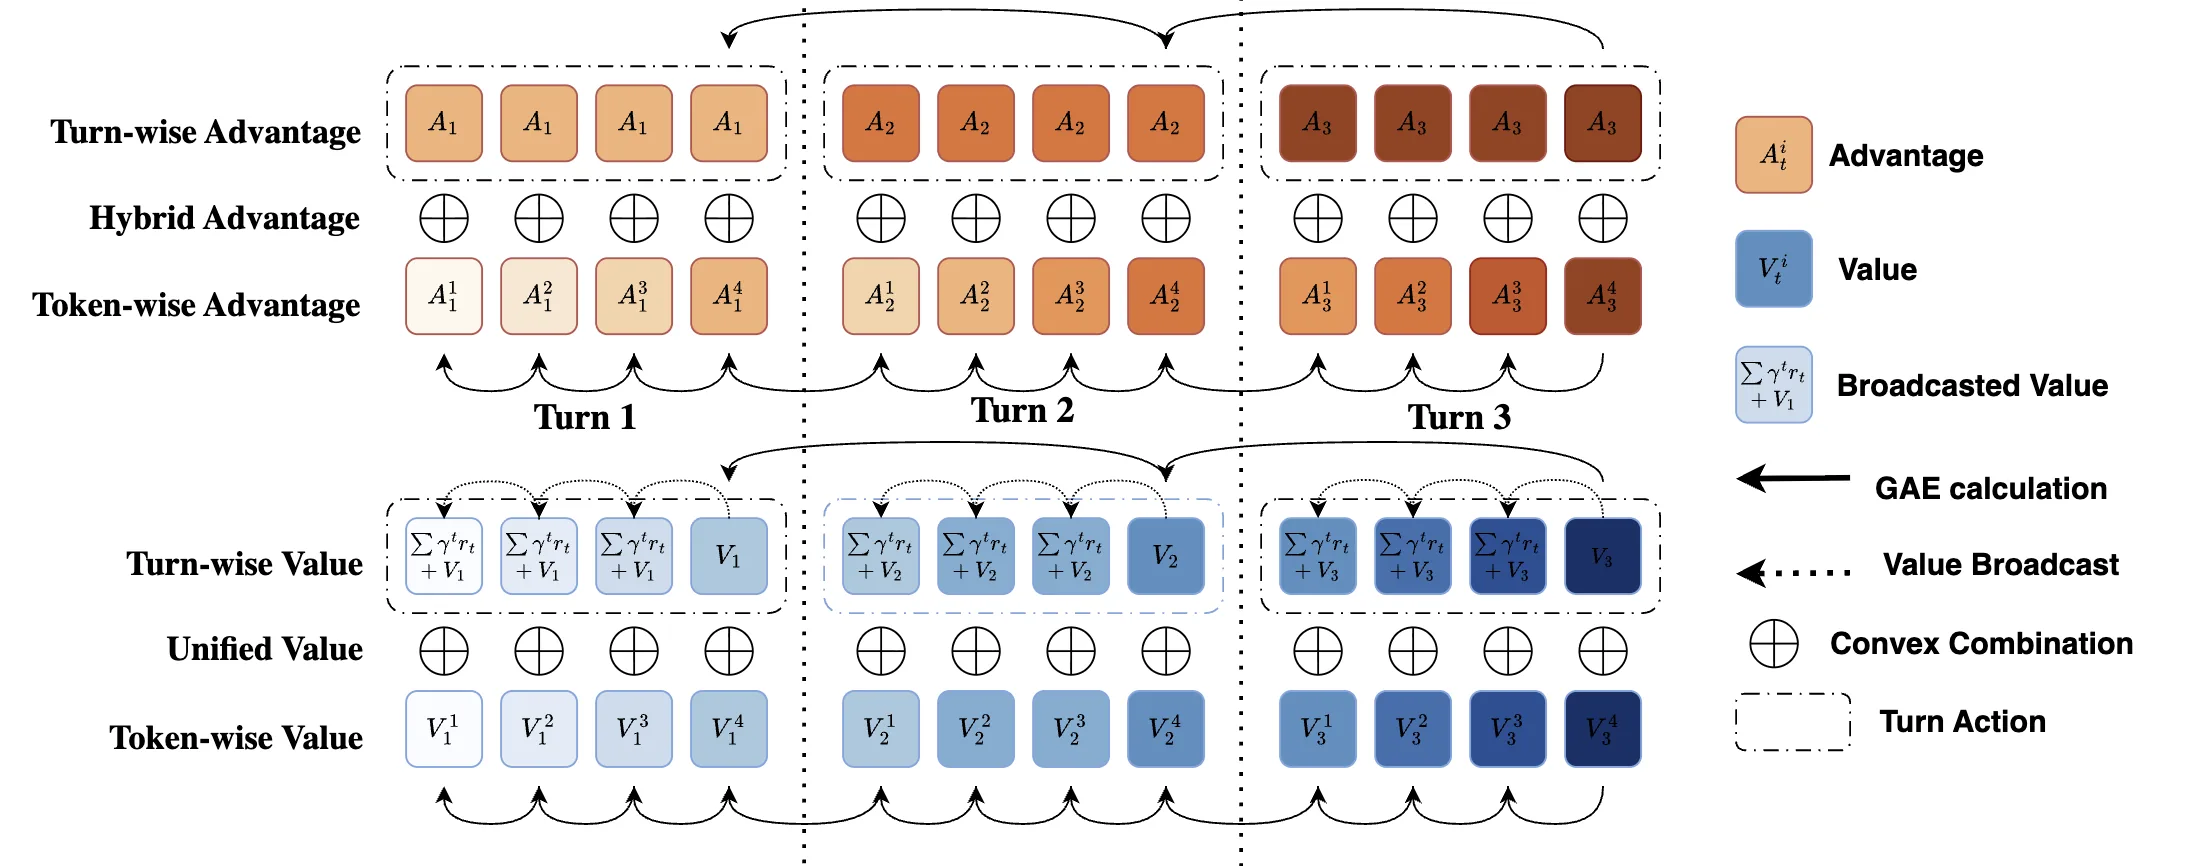
基于这两个定理,论文提出混合优势函数:
其中 是轮级优势, 是 token 级优势,超参数 控制两者的相对权重。当 时,两个层级的贡献被等权求和。
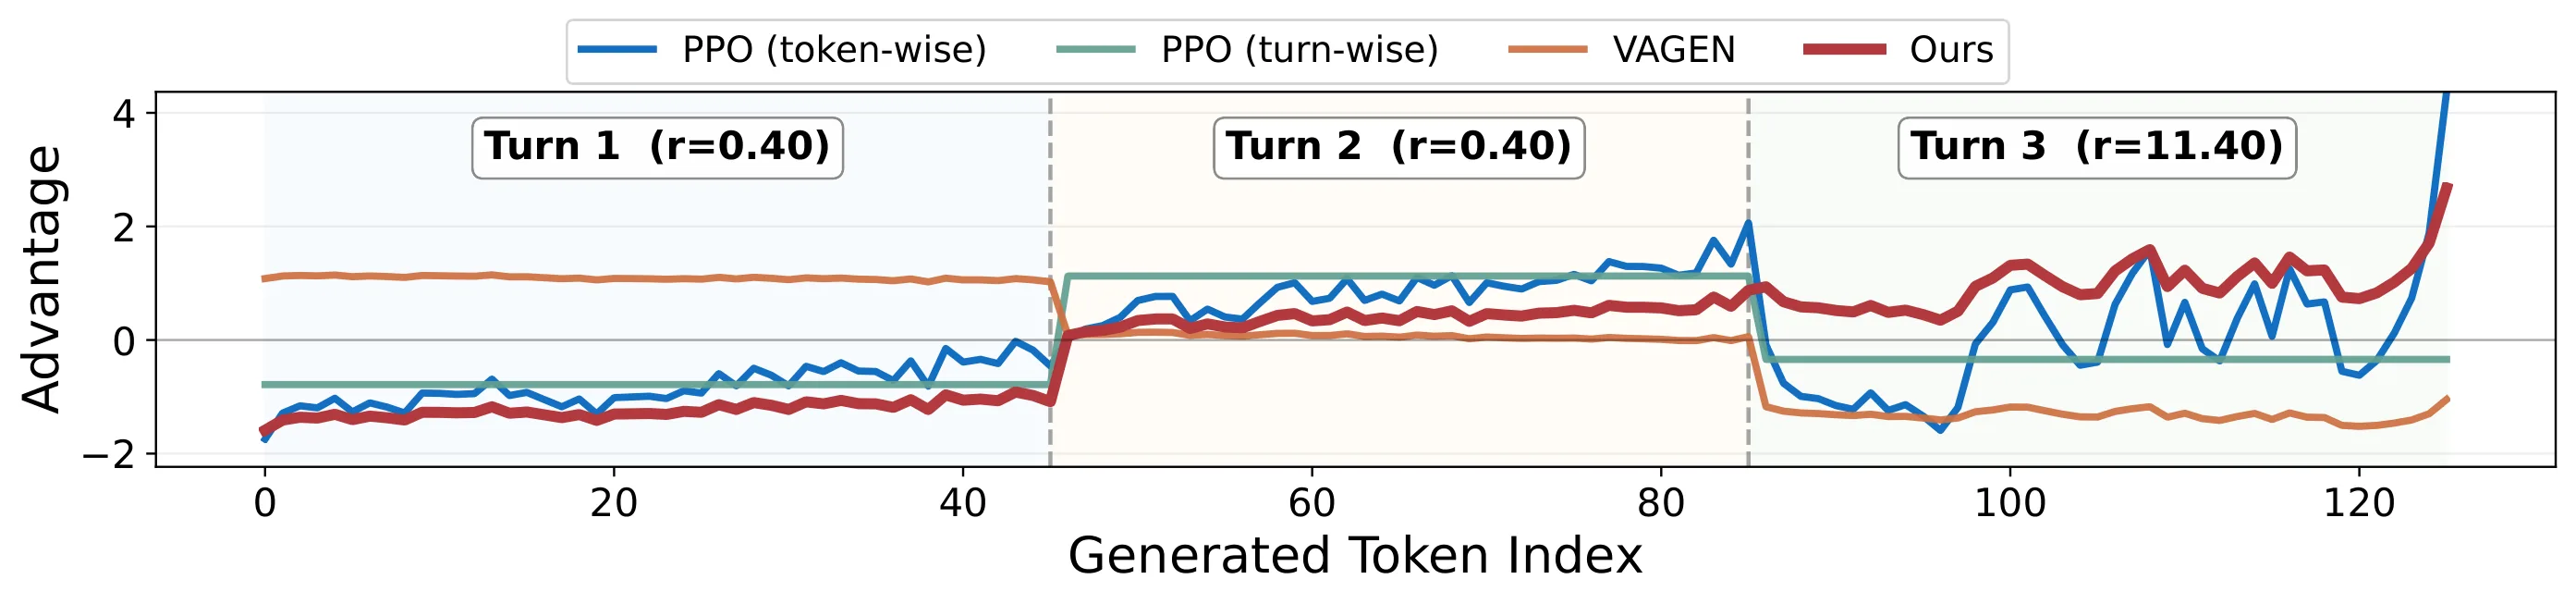
与混合优势配套的是精确的混合回报设计。轮级回报需要被正确地广播至轮内每个 token 位置,同时叠加相应的折扣奖励。论文特别强调,这种广播必须遵循特定的解析形式,而非简单地复制。定理三和定理四从统计角度解释了混合策略的合理性:轮级估计具有较低的偏差但方差较大,token 级估计方差小但偏差累积严重,混合优势自然地在[[偏差-方差权衡]]中找到了平衡点。
最终,HyGAE 采用 [[PPO]] 风格的策略更新,损失函数对 token 位置加权求和,并使用 PPO 原生的裁剪机制保证训练稳定性。
实验与结果
实验覆盖了五个多轮决策基准,涵盖了从离散格子世界到连续参数化操作再到真实街景导航的多样化任务。评估的骨干模型统一使用 Qwen2.5-VL-3B,对比基线包括 Token-PPO、Turn-PPO、GRPO、RL4VLM 等多种 [[强化学习]] 训练范式,以及 GPT-5、Gemini 2.5 Pro 等闭源大模型。
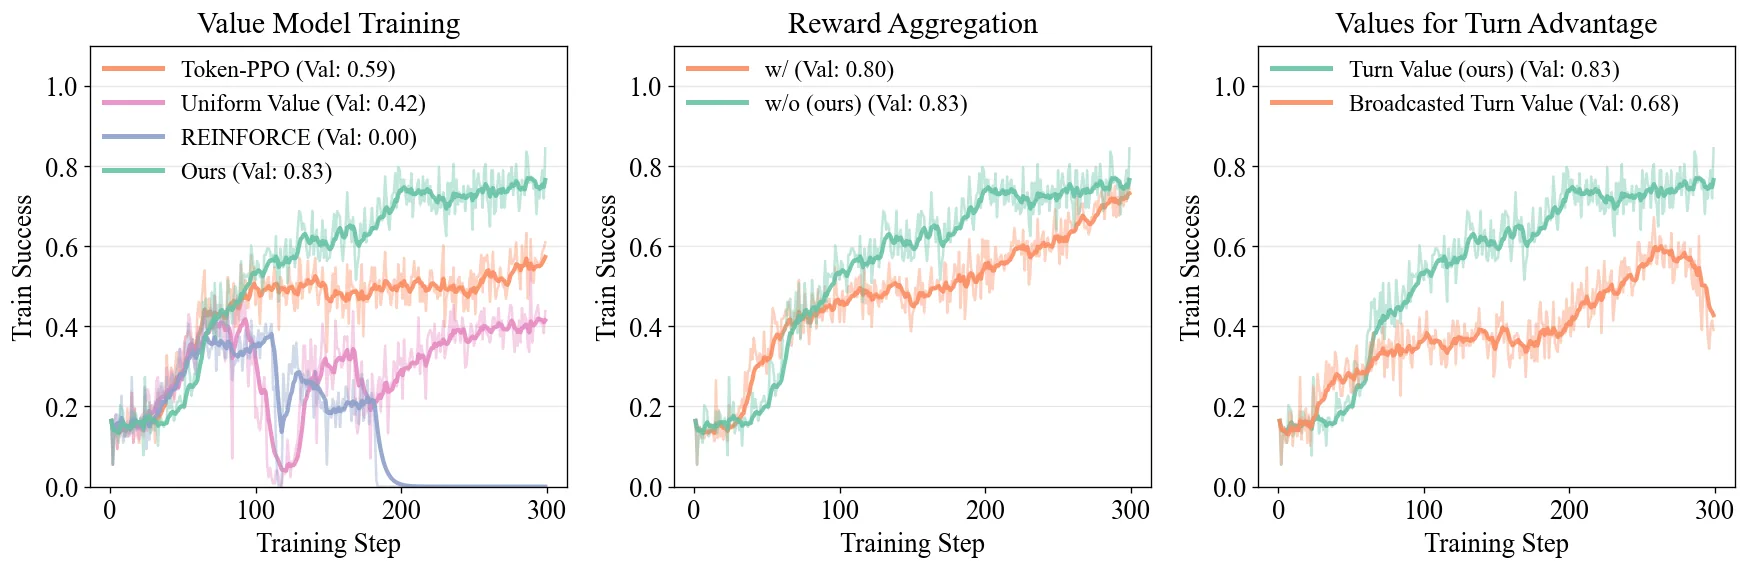
核心结果引人注目:HyGAE 在五个环境中取得平均 91% 的成功率,相较其他方法提升约 10%。分环境来看,Sokoban(空间推理任务)从 Token-PPO 的 59% 跃升至 83%,Turn-PPO 基线更是仅有 38%——这说明纯轮级优化在该任务上几乎失效。Navigation、Primitive Skill 和 VIRL 也普遍取得最优或次优成绩。
一个值得注意的细节是方差分析。在 Sokoban 上,HyGAE 的多次运行成功率为 ,而传统 PPO 基线的方差高达 。这表明混合优势函数不仅提升了平均性能,还显著增强了训练的可重复性——[[Policy Gradient]] 方法常见的"跑多次结果天差地别"问题在这里得到了缓解。
论文还通过消融实验验证了精确回报形式的必要性。简单地广播轮级回报至所有 token 位置,或者省略价值模型直接用 REINFORCE 估计,都会导致训练崩溃。这说明混合优势的数学形式不是可以随意简化的工程技巧,而是保证优化方向正确的理论前提。
讨论与可借鉴点
HyGAE 的核心贡献在于提供了统一的理论框架,将此前割裂的 token 级与轮级优化在同一个梯度方向下融合。这对 [[多轮决策]] 领域的研究有几点启发。首先,折扣因子的选择不应该是经验性的超参数搜索,而应该根据任务结构(如平均轮长)从理论上推导。其次,单一评论家同时服务多个优化层级的设计启示我们:复杂任务往往不需要引入额外的层级结构或多个辅助网络,在恰当的数学形式下"合并同类项"即可实现同样的效果。
论文的局限同样值得注意。所有实验均在 3B 参数规模的模型上验证,对更大模型的扩展性尚不明朗。此外,混合系数 目前仍是手工调节的超参数,缺乏自适应调度机制,这在一些需要动态调整探索-利用平衡的任务中可能成为瓶颈。论文也承认,KL 散度微奖励的聚合方式在理论上尚未得到充分解释,更多是经验性选择。
总体而言,这项工作为 VLM 智能体的端到端强化学习训练提供了一种简洁而理论严谨的新范式。其方法论的通用性不局限于视觉-语言场景,核心思想——即通过精心设计的优势函数与统一的评论家实现多粒度联合优化——对其他序列决策问题同样具有参考价值。
摘要
大型视觉语言模型(VLMs)如今在交互式环境中充当智能体,要在多轮交互中实现成功,需要在轮次之间进行连贯的推理与决策。尽管在智能体环境中进行端到端训练能够提升这种多轮决策能力,但现有方法主要依赖于对拼接后的 token 轨迹进行 token 级优化,或采用轮内均匀信用分配的轮级优化。在本文中,我们为这两个层级的优化建立了理论公式,并推导出一种同时服务于两类目标的混合优势函数。此外,通过恰当选取折扣因子和学习目标,我们证明了统一的评论家模型能够同时估计轮级和 token 级的价值。由此,我们提出了 HyGAE——一种结合混合优势与统一评论家、联合优化 token 级与轮级目标的 actor-critic 框架。我们在五个多轮决策环境中对 HyGAE 进行了广泛评估,其平均成功率高达 91%,相对其他方法取得了 10% 的显著提升。此外,我们还进行了深入分析,表明混合优势与回报的精确解析形式对优化至关重要。项目主页:https://wx-zhang.github.io/hygae-web/。
Abstract
Large Vision-Language Models (VLMs) now act as agents in interactive environments, where success requires coherent reasoning and decision-making across turns. Although end-to-end training in agentic environments can improve such multi-turn decision-making abilities, current methods mainly rely on either token-wise optimization over concatenated token trajectories or turn-wise optimization with uniform within-turn credit. In this work, we establish theoretical formulations for the two levels of optimization and derive a hybrid advantage that serves both objectives. Furthermore, with an appropriate choice of discount factor and learning target, we prove that a unified critic model can estimate values for both turn-wise and token-wise. As such, we propose HyGAE, an actor-critic framework that jointly optimizes token- and turn-level objectives with the hybrid advantage and unified critic. We conduct extensive evaluations of HyGAE across five multi-turn decision-making environments, where it achieves an average success rate of 91% and a significant improvement of 10% over other methods. Furthermore, we provide an in-depth analysis showing that the exact analytic form of the hybrid advantage and return is crucial for optimization. Project Page: https://wx-zhang.github.io/hygae-web/.
论文详细总结(自动生成)
HyGAE 论文详细总结
1. 论文核心问题与整体含义
研究动机:大型视觉语言模型(VLM)正越来越多地被部署为交互式环境中的智能体,需要在多轮交互中保持连贯的推理与决策。然而,现有 VLM 普遍存在"短视"问题——它们往往仅基于最当前观察进行推理,忽略历史动作与反馈,导致重复输出无效动作、缺乏长程规划能力。
核心矛盾:现有 VLM 智能体的端到端强化学习训练主要遵循两种范式,二者各有局限:
- Token 级优化(如 Token-PPO):将每个 token 视为独立动作,可提供细粒度的生成指导,但环境奖励的折扣在长文本生成中会被过度累积。
- Turn 级优化(如 Turn-PPO/RL4VLM):将整个轮次视为一个宏观动作,便于利用轮级反馈,但丢弃了 turn 内的细粒度 token 信用分配信号,影响自回归生成的稳定性。
整体含义:本文试图弥合二者的割裂,从理论上揭示 token 级与 turn 级优化的内在联系,并提出统一的双层级优化框架。
2. 方法论
2.1 核心思想
HyGAE(Hybrid Generalized Advantage Estimation)框架包含三大核心组件:
1. 混合优势估计(Hybrid Advantage):将 turn 级优势与 token 级优势以线性组合方式融合,单一 surrogate 函数同时优化两个层级的目标。
2. 统一评论家(Unified Critic):通过特定折扣因子设置,使一个价值模型可同时估计 turn 级和 token 级价值,避免双 critic 的计算开销。
3. 精确的混合回报(Hybrid Return):通过将 turn 级回报广播至 turn 内每个 token 位置并叠加折扣奖励,构建稳定的价值学习目标。
2.2 理论框架
Token 级与 Turn 级 POMDP 形式化:
在 turn ,VLM 生成 token 序列 ,token 级奖励定义为:
关键定理 1(梯度等价性):当 turn 级与 token 级折扣因子满足 时,对任意 :
这意味着混合优化方向与原目标梯度一致,理论上有保证。
关键定理 2(价值一致性):在相同折扣条件下,turn 级价值与 token 级轨迹末位价值相等:
因此无需为两个层级分别训练 critic。
2.3 混合优势与回报
混合优势:
其中 为 turn 级优势(GT 推算常量), 为 token 级优势。
混合回报(用于 Critic 学习):
Turn 级回报通过下式广播至 turn 内每个 token:
2.4 偏差-方差分析
定理 3(偏差):turn 级估计偏差 ≤ token 级估计偏差()。
定理 4(方差):turn 级估计方差 > token 级估计方差()。
这从理论上证明混合策略自然地平衡了偏差-方差权衡。
2.5 算法流程
算法采用 PPO 风格训练,policy 损失为:
完整流程见 Algorithm 1(外部循环 → 轨迹收集 → turn/token 优势计算 → 价值学习目标构造 → PPO 更新)。
3. 实验设计
3.1 测试环境(5 个多轮决策 Benchmark)
| 环境 | 评估能力 | 动作空间 | 最大轮次 | 评估任务 |
|---|---|---|---|---|
| Sokoban | 空间推理与长程规划 | 4 离散 | 3 | Base |
| FrozenLake | 约束路径规划 | 4 离散 | 3 | Base |
| Navigation | 视觉定位与指令遵循 | 8 动作 | 4 | Base + Common Sense |
| Primitive Skill | 机器人操作 | 连续参数化 | 3 | Place / Stack / Draw / Align |
| VIRL | 真实街景导航 | 10 动作 | 7 | In-Domain + Out-of-Domain |
3.2 对比方法
- 闭源专有模型:GPT-5、Gemini 2.5 Pro、Claude Sonnet 4.5。
- 开源小模型:Qwen2.5-VL-3B、Gemma-3-4B、VLM-R1-3B、Cosmos-R1-7B、Qwen3-VL-4B。
- RL 算法基线(均使用 Qwen2.5-VL-3B 作为骨干网络):
- Token-PPO
- Turn-PPO
- GRPO
- RL4VLM(Zhai et al., 2024)
- VAGEN-Base(Wang et al., 2025a)
3.3 评估指标
所有任务以成功率(Success Rate)为主要评估指标。
4. 资源与算力
- 硬件:NVIDIA A100、H100、H200 GPU。
- 训练规模:每个任务使用 2–8 张 GPU(Sokoban/FrozenLake 用 2 张,Navigation 用 2 张,Primitive Skill 用 4 张,VIRL 用 8 张)。
- 训练步数:100–300 步。
- 训练框架:基于 veRL(Sheng et al., 2024)。
- 骨干模型:Qwen2.5-VL-3B-Instruct。
- 超参数:Actor LR=1e-6,Critic LR=1e-5,,,KL 系数 0.001。
注意:论文未明确披露总训练时长(GPU 小时)或完整费用。
5. 实验数量与充分性
5.1 实验数量
- 5 个环境 × 多个子任务:共 9 个评估设置(如 Navigation 的 Base/CS、VIRL 的 ID/OOD、Primitive Skill 的 4 任务)。
- 消融实验:对混合系数 在 Sokoban、FrozenLake、Primitive Skill 上的消融(Table 2)。
- 诊断研究:在 Sokoban 上对回报聚合方式、价值选择方式、KL 微奖励聚合的消融(Figure 4)。
- 数值偏差-方差分析:PPO vs. HyGAE 在 Sokoban 上多次运行的成功率( vs. )。
- 定性分析:Sokoban 和 VIRL 上 HyGAE 与 frozen Qwen2.5-VL 的多轮决策轨迹对比(Figure 5)。
5.2 充分性评估
优点:
- 覆盖多种决策能力(空间推理、路径规划、视觉定位、连续操作、真实世界导航)。
- 对比基线层次丰富(专有模型 / 开源模型 / RL 方法)。
- 同时进行定量与定性分析,并提供多轮运行稳定性分析。
可能的不足:
- 诊断实验(Figure 4)仅在单一任务(Sokoban)上进行,跨任务泛化性未充分验证。
- 缺少对不同骨干模型(仅 Qwen2.5-VL-3B)规模与家族的泛化检验。
6. 主要结论与发现
- SOTA 性能:HyGAE 在 5 个基准上均取得最优,平均成功率 91%,较其他方法相对提升 10%。
- 关键数据:
- Sokoban:0.83(vs. Token-PPO 0.59 / Turn-PPO 0.38 / VAGEN-Base 0.61)
- FrozenLake:0.80
- Navigation(平均):0.88
- Primitive Skill(平均):1.0
- VIRL:0.86
- 精确解析形式至关重要:将 turn 级回报盲目广播至 turn 内所有 token 或省略价值模型(用 REINFORCE)会导致训练崩溃;只有式 (17) 的精确混合回报能稳定训练。
- 多轮一致性:定性分析显示 HyGAE 能根据反馈动态调整策略,而 frozen Qwen2.5-VL 容易陷入重复动作循环。
- 混合优势偏差-方差平衡:在 Sokoban 上 HyGAE 不仅平均性能提升,运行间方差也大幅降低(±0.2105 → ±0.0711)。
7. 优点
1. 理论严谨性:从 POMDP 形式化出发,证明梯度等价、价值一致性、偏差-方差权衡三大性质,区别于先前的经验性方法(如 RL4VLM、VAGEN-Base 仅使用启发式双层结构)。
2. 统一评论家设计:通过合理设置折扣因子,使一个 critic 模型同时承担两个层级的价值估计,节省内存与计算开销,避免双 critic 训练的不稳定性。
3. 简洁性:相比 ARCHER 等复杂分层模型(Zhou & Zanette, 2024),HyGAE 通过简单线性组合实现双层优化,无需引入额外的层级结构。
4. 实现轻量:与 PPO 框架兼容,仅需修改优势与回报计算,易于落地。
5. 全面评测:覆盖能力强(5 环境)、基线全(专有+开源+RL 方法)、包含定量/定性/消融/数值分析。
6. 可复现性:基于 veRL 框架与 Qwen2.5-VL-3B 骨干,配合 Appendix 中详细的系统提示、超参数、环境描述,便于复现。
8. 不足与局限
1. 骨干模型规模单一:所有 RL 训练仅在 Qwen2.5-VL-3B 上进行;未验证 7B/13B 等更大模型上的可扩展性。
2. 依赖特定 PPO 框架:value 模型训练本身困难(已知 PPO+LLM 易崩溃),HyGAE 的成功部分归功于混合回报的精确广播;该方法对非 PPO 框架(如现代 RLHF 流水线)的迁移性未充分讨论。
3. 混合系数 的手工调节:虽然 在多数任务上表现最优,但仍是超参数;缺乏自适应 调度机制。
4. Token 级奖励聚合的选择:文中承认 KL 微奖励是否聚合到 turn 级报酬是"经验性"决定(图 4 仅在 Sokoban 上验证),理论指导有限。
5. 任务领域局限:所有任务均基于视觉/语言输入的离散或受限动作空间,对长文本生成、长程工具使用等场景的适用性未测试。
6. 算力披露不完整:未公开总 GPU 小时数或碳成本;不同任务的 GPU 数量差异(2–8 张)也未在正文解释。
7. 缺乏失败模式分析:定性案例仅展示成功轨迹;未系统分析 HyGAE 失败的任务类型与原因。
8. 单调的推理过程:框架本身并未显式约束或优化"思考 token"的出现频率与质量,对推理过程崩溃(如 thought collapse)的解决方案仍依赖外部方法(如 GTR)。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。