
面向动态杂乱环境中安全飞行的前瞻性风险引导强化学习方法
Anticipatory Risk-Guided Reinforcement Learning for Safe Flight Through Dynamic Clutter
📝 TLDR
四旋翼在杂乱动态环境中飞行时,仅依赖瞬时几何感知难以保证安全。现有模块化管线存在感知延迟,而端到端学习方法缺乏物理监督,难以提取可靠的时空特征。本文提出基于最近接近点构建方向对齐的未来碰撞风险图,通过非对称Actor-Critic让策略自预测结构化风险。实验表明该方法在密集动态杂乱场景中提高了安全裕度,并实现了零样本仿真到真机迁移。
🧭 速览
现有模块化管线存在感知延迟,端到端方法缺乏物理监督,难以可靠预测动态杂乱环境中的碰撞风险。
基于CPA构建方向对齐的未来碰撞风险图,采用非对称Actor-Critic让视觉策略自预测风险,并使用轻量时空编码器从深度序列中提取运动线索。
在密集动态杂乱环境中相对基线提高了安全裕度与飞行效率,并实现了零样本仿真到真机迁移。
通过结构化风险先验与时空深度编码相结合,验证了物理引导的自监督风险预测在四旋翼安全导航中的有效性。
🆚 方法对比
预期风险引导强化学习框架
- 基于CPA构建方向对齐的未来碰撞风险图
- 特权信息蒸馏实现零样本Sim-to-Real迁移
- 无需显式目标跟踪,规避感知延迟
- 主动空间绕行而非被动紧急反应
- 依赖仿真器特权状态进行训练监督
- 仅用特权信息训练,部署时性能存差距
- 对深度序列质量有较强依赖
- 实验中动态场景范围有限
基于CPA的未来碰撞风险图
- 显式编码时间紧迫性与空间近邻性
- 提供物理基础的结构化监督信号
- 方向对齐设计匹配无人机运动方向
- 稠密监督优于稀疏标量奖励
- 依赖精确的障碍物运动状态估计
- 对仿真器精度较敏感
- 高维地图增加计算开销
- 实际场景中CPA假设可能失效
非对称Actor-Critic架构
- 训练时利用特权信息提升Critic能力
- 部署时仅用本体观测,保证实时性
- 自预测风险作为Actor的显式引导
- 风险蒸馏促进时空特征学习
- Actor与Critic间存在信息不对称
- 训练与部署分布差异需精心设计
- 特权信号质量直接影响策略性能
- Critic网络结构需额外设计
轻量级时空深度编码器
- 直接从深度序列提取运动线索
- 无需光流估计与目标跟踪
- 几何一致的观测降低训练难度
- 轻量设计满足机载实时推理
- 对深度传感器噪声较敏感
- 时空特征融合机制有限
- 遮挡场景下时空关联建立困难
- 轻量化设计可能损失表征能力
传统模块化导航流水线
- 感知-建模-规划流程清晰可解释
- 椭球建模与3D-SORT跟踪成熟
- CC-MPC可显式处理不确定性
- B样条优化实时性较好
- 严重遮挡下误差累积严重
- 感知延迟影响动态避障
- 显式状态估计计算开销大
- 依赖精确的运动预测模型
基于隐式标量奖励的端到端强化学习
- 端到端学习避免模块间误差传播
- 可从序列视觉数据直接提取特征
- 无需显式运动状态估计
- 训练流程相对简单
- 标量奖励缺乏时空结构信息
- 易激励激进、最后一刻的反应行为
- 安全边际与飞行效率难以兼顾
- 突发动态威胁下策略脆弱
本文针对传统模块化流水线感知延迟和隐式标量奖励端到端RL缺乏时空结构两大缺陷,提出基于CPA风险图与非对称Actor-Critic的预期风险引导RL框架,在安全性与Sim-to-Real迁移上均优于对比基线。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
TL;DR
本文针对四旋翼在动态杂乱环境中的安全飞行问题,提出了一种前瞻性风险引导的强化学习框架。该方法利用最近接近点(CPA)构建未来碰撞风险图,通过非对称Actor-Critic架构让策略在训练阶段学习预测这种结构化风险,从而在部署时实现"主动预判"而非"被动闪避"。实验表明,该方法在密集动态场景中将安全裕度提升至0.31–0.43米的最小间隙,且成功实现了从仿真到真实物理平台的零样本迁移。
研究背景与动机
四旋翼在杂乱且含动态障碍物的环境中实现安全导航,远不止于瞬时的几何避障。真正的挑战在于预判由相对运动引发的潜在碰撞风险——当障碍物以不同速度和方向移动时,传统的"看到即躲避"策略往往为时已晚。
现有方法分为两类,各有局限。传统模块化流水线将感知、建模、规划拆解为独立模块,依赖显式目标跟踪来预测障碍物轨迹。然而这种架构受计算延迟和误差累积影响,在严重遮挡或障碍物密集的场景中性能急剧下降。更关键的是,感知延迟在高速飞行时可能是致命的。
端到端强化学习方法试图绕过这些缺陷,让智能体直接从原始观测学习决策。但这类方法通常依赖隐式标量奖励(如距离奖励、碰撞惩罚的加权组合)进行引导,缺乏空间与时间维度的结构化监督信号。结果是特征提取器难以优先关注安全关键的动态线索,策略往往会以安全裕度换取飞行速度,表现出激进、近碰撞的被动反应式行为。
本文的核心洞察是:必须将显式的物理运动先验注入视觉特征学习。具体而言,通过最近接近点这一经典的碰撞几何度量,构建可微的稠密监督信号,引导网络的时空编码器学会"前瞻性"地感知危险区域,使策略能够主动规避,而非在最后一刻才做出反应。
方法
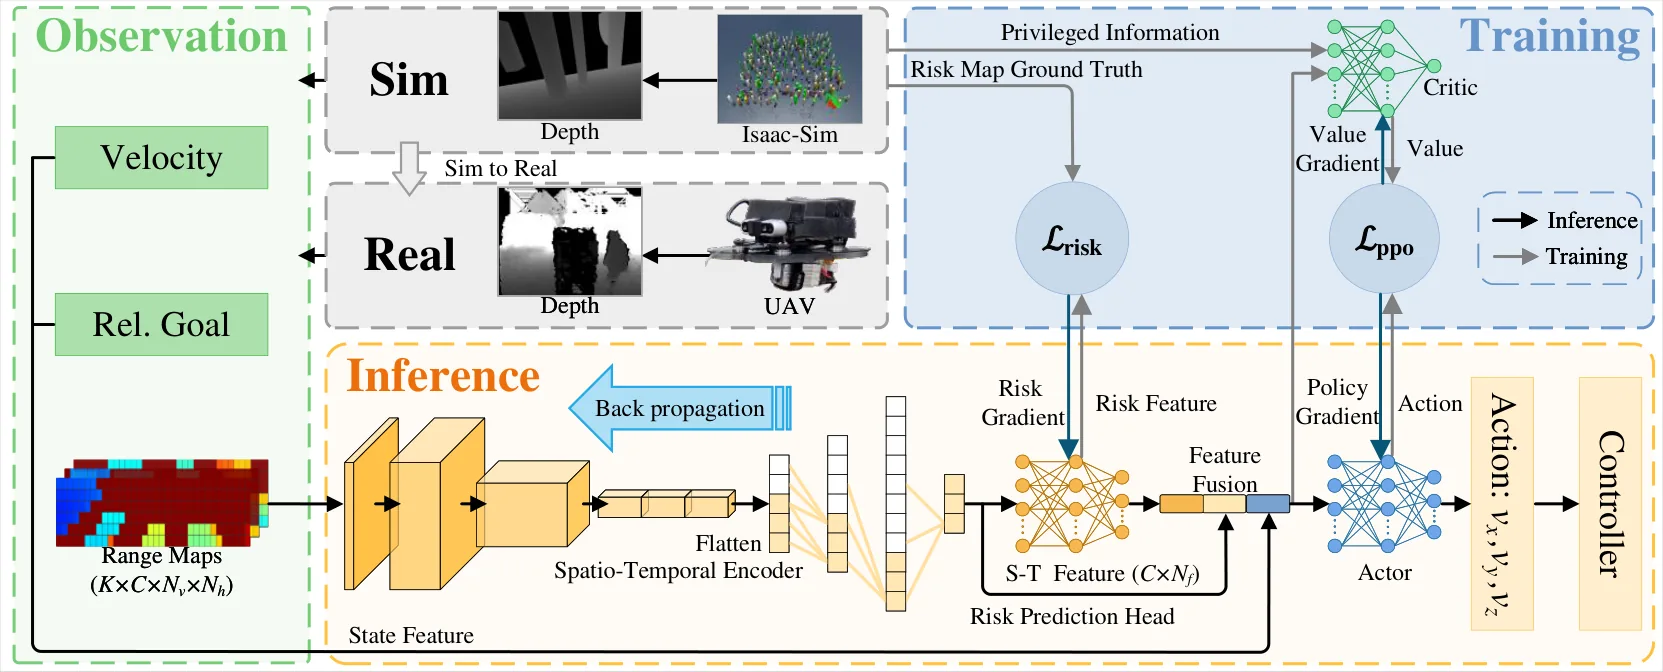
方法的整体框架基于非对称Actor-Critic架构,分训练与推理两阶段运行。训练阶段利用仿真器提供的特权状态信息构建未来碰撞风险图,作为辅助监督信号指导时空编码器的特征学习;推理阶段则完全依赖机载传感器和自预测的风险先验进行决策,无需任何特权信息。
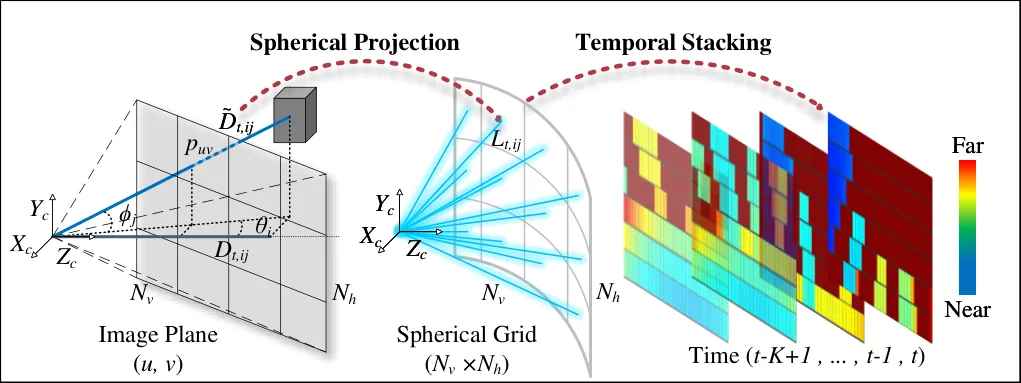
在观测表示上,论文采用反演球面距离图替代原始深度图像。这一设计的动机在于缓解光轴畸变问题,同时通过几何变换优先突出近距离的碰撞风险:
其中 、 为方位角和俯仰角的离散化分量。观测序列由最近15帧堆叠构成 ,与本体感知状态(相对位置、速度)一同输入策略网络。
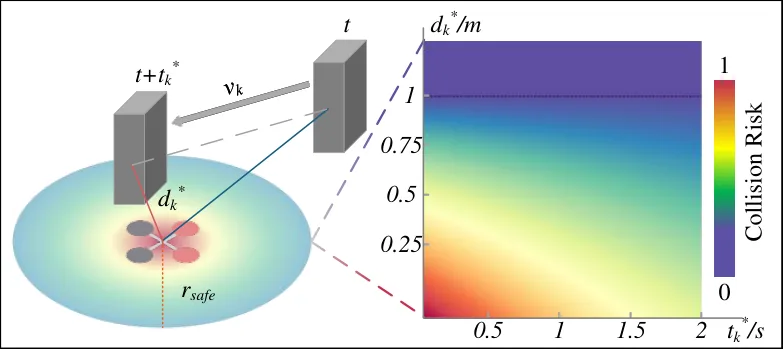
未来碰撞风险建模是该方法的核心。论文基于最近接近点(CPA)理论计算每个障碍物的最近接近时间 和对应距离 :
进而定义二元未来碰撞风险函数,同时编码时间紧迫性与空间临近性:
风险随后被投影到2D球面风险图,并经对数-和-指数平滑池化压缩为1D方位风险向量,保留水平规避这一飞行器最主要的机动维度。
时空编码器由2D CNN和时序卷积网络串联组成:每帧深度图经CNN提取空间特征,TCN聚合时序信息。关键设计是风险预测辅助头 ,由特权风险 通过均方误差监督。注意 需经停止梯度处理后融入策略输入,避免高方差的策略梯度污染辅助风险头的语义学习。
在非对称架构中,Actor仅依赖机载视觉表征和自预测风险,而Critic使用特权增强状态(含全部真实动力学信息)以稳定训练。奖励函数平衡目标追寻与绝对安全,引入风险惩罚项 显式约束策略的最大风险暴露。
实验与结果
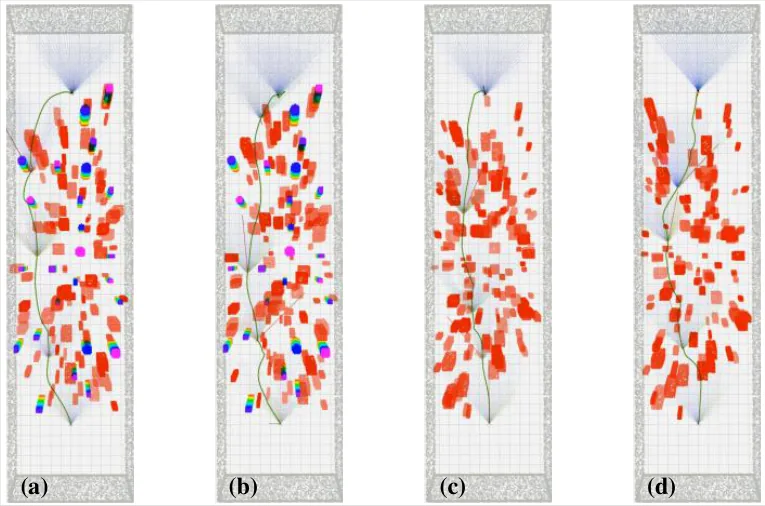
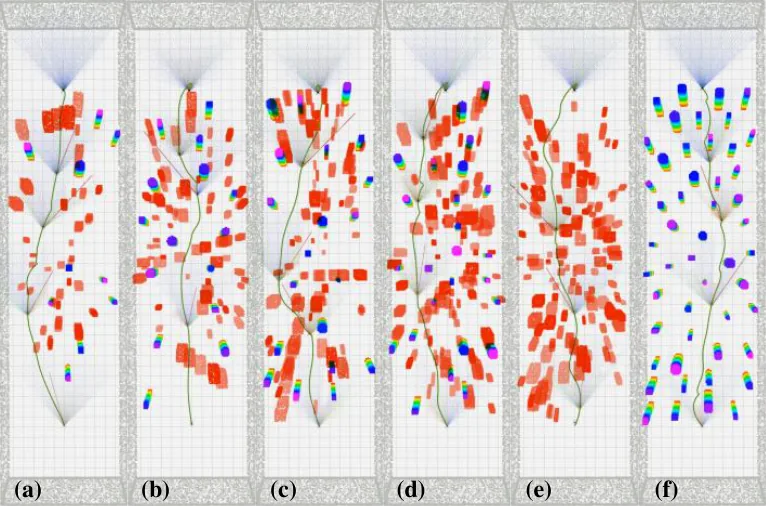
实验在NVIDIA Isaac Sim仿真平台进行,涵盖6个难度递进的benchmark场景:10S+10D、15S+15D、20S+20D、25S+25D、35D(纯动态)、50S(高密度静态),每个场景进行20次独立试验。
对比基线包括基于优化的感知规划方法FAPP、分层RL方法NavRL,以及基于点流的隐式动态表征方法P2M。实验结果表明,本文方法在所有6个场景中均取得最高成功率(55%至95%),且最小间隙指标达到0.31至0.43米,显著优于所有基线。系统延迟仅为3.22至4.07毫秒,相比FAPP的11至18毫秒和NavRL的17至23毫秒优势明显。
消融实验验证了核心组件的贡献。去除风险监督后,成功率降至30%至40%,最小间隙下降至0.23至0.29米,验证了结构化风险先验对安全性的关键作用。去除TCN时序建模后,策略退化为纯反应式,在纯动态场景(35D)中成功率跌至20%,证明时序信息对预测动态障碍物运动不可或缺。
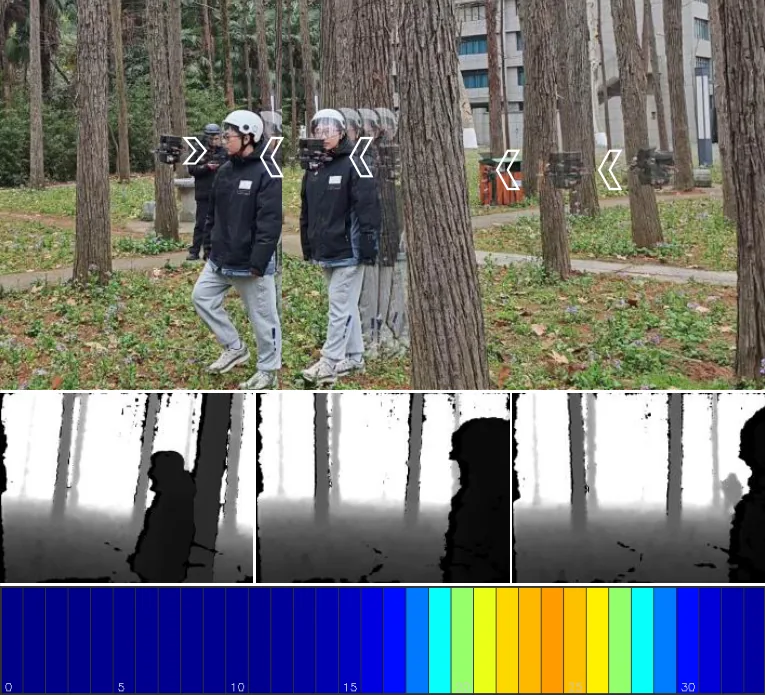
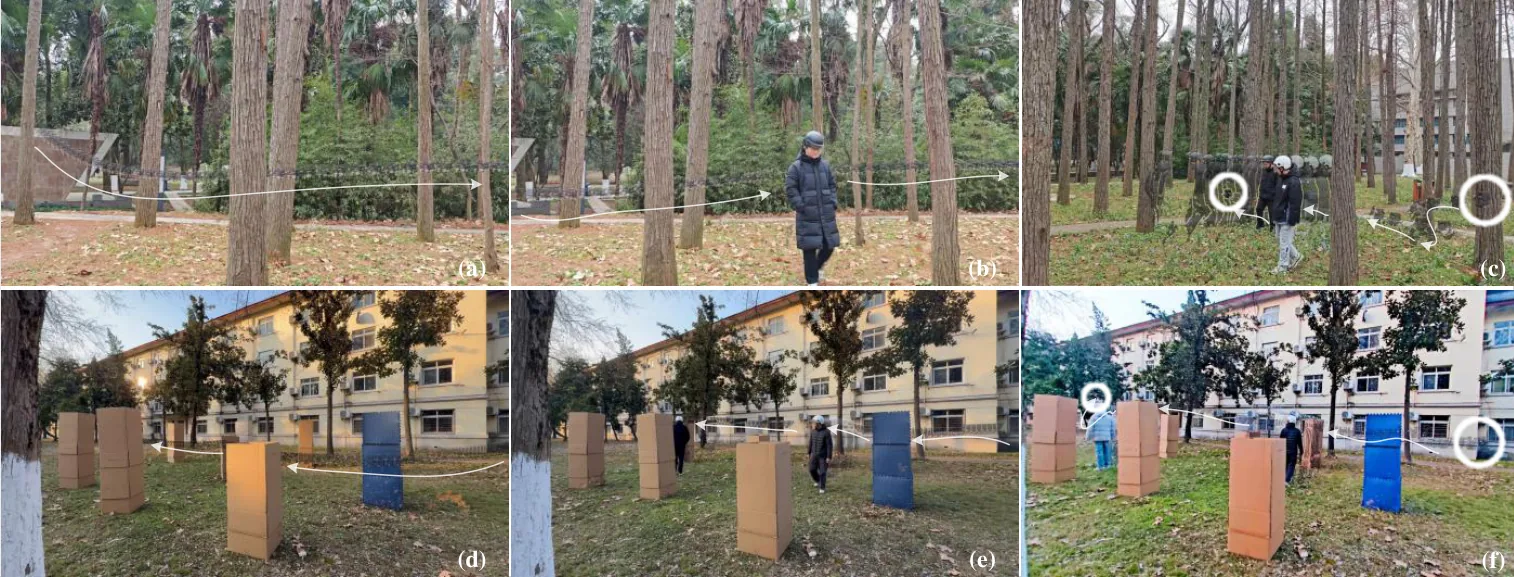
真实环境部署使用NVIDIA Jetson Orin NX机载计算平台搭配Intel RealSense D435i深度相机。在非结构化森林、堆叠箱子等未见过的静态场景中,策略展现出良好的零样本泛化能力;在含行人动态的场景中,策略表现出急停悬停后侧向绕行的极限机动能力,成功实现零样本Sim-to-Real迁移。
讨论与可借鉴点
该方法的核心贡献在于将CPA这一经典碰撞几何度量转化为可微的稠密监督信号,弥补了标量奖励的监督不足。这一思路值得借鉴:将领域知识显式编码为结构化监督,往往比隐式奖励工程更有效。
然而方法也存在局限。CPA风险建模假设障碍物在短时窗内做匀速运动,对突然变向或加减速的行人存在失效风险。此外,仅依赖前视深度传感器意味着对侧后方及顶部突发威胁存在感知盲区,这在复杂三维环境中是需要正视的约束。
从工程角度看,1D风险先验配合停止梯度设计的解耦策略是一个值得注意的细节:辅助任务与主任务梯度空间的适当隔离,可以避免多任务学习中的负迁移问题。而反演球面距离图的观测设计则说明,领域特定的传感器预处理往往比端到端学习更高效且更利于迁移。
论文在对比实验的公平性上存在一些遗憾——基线方法的速度约束和感知模态不完全一致,这使得直接性能比较的严谨性打了折扣。此外,每场景仅20次试验且缺乏统计显著性分析,也使得结论的稳健性有待进一步验证。
摘要
在杂乱且动态环境中实现安全四旋翼飞行,不仅依赖于瞬时的几何感知,更关键的是要预判由相对运动引发的碰撞风险。传统的模块化流水线常常受限于感知延迟,而依赖隐式标量奖励的端到端学习方法由于缺少物理层面的监督信号,往往难以提取可靠的时空特征。为此,本文提出一种前瞻性风险引导的强化学习框架。该框架利用仿真器提供的特权状态信息,基于最近接近点(CPA)构建一张方向对齐的未来碰撞风险地图,并通过非对称的演员-评论家架构,使网络能够自我预测这种结构化的风险信息,从而在部署阶段对视觉策略进行显式引导。此外,所设计的轻量化时空编码器可直接从机载深度序列中提取运动线索,无需进行显式目标跟踪或光流估计。大量仿真及真实环境实验表明,相较于现有基线方法,本文方法能够有效提升密集动态杂乱场景下的安全裕度与飞行效率。同时,所学得的策略在物理四旋翼平台上实现了鲁棒的零样本仿真到现实迁移,其输入仅依赖于抽象的时空深度序列及其自预测的风险先验,充分验证了本文方法的有效性以及从仿真到现实的强泛化能力。
Abstract
Safe quadrotor navigation in cluttered and dynamic environments depends not only on instantaneous geometric perception, but more critically on anticipating collision risks induced by relative motion. Conventional modular pipelines frequently suffer from perception latency, while end-to-end learning methods relying on implicit scalar rewards often struggle to extract reliable spatio-temporal features without physics-grounded supervision. To address this, we propose an anticipatory risk-guided reinforcement learning framework. Leveraging privileged simulator states, we construct a directionally aligned future collision risk map based on the Closest Point of Approach (CPA). Through an asymmetric actor-critic architecture, the network is trained to self-predict this structured risk, which explicitly guides the visual policy during deployment. A lightweight spatio-temporal encoder extracts motion cues directly from onboard depth sequences, bypassing explicit object tracking or optical flow estimation. Extensive simulated and real-world experiments demonstrate that our method effectively improves safety margins and flight efficiency in dense dynamic clutters compared to existing baselines. Furthermore, the learned policy achieves robust zero-shot Sim-to-Real transfer on a physical quadrotor, relying purely on abstracted spatio-temporal depth sequences and its self-predicted risk priors, validating the effectiveness of our approach and its robust generalization from simulation to reality.
论文详细总结(自动生成)
论文总结:面向动态杂乱环境中安全飞行的前瞻性风险引导强化学习方法
1. 核心问题与研究动机
论文聚焦于四旋翼在杂乱且含动态障碍物环境下的安全导航问题。作者指出,安全动态导航不仅依赖瞬时几何避障,更需要预判由相对运动引发的潜在碰撞风险。现有两类方法均存在明显缺陷:
- 传统模块化管线(感知-建模-规划):依赖显式目标跟踪,受计算延迟和误差累积影响,在严重遮挡下性能下降。
- 端到端强化学习:依赖标量任务奖励(如距离进度、碰撞惩罚)进行隐式引导,缺乏空间-时间结构化监督信号,特征提取器难以优先关注安全关键的动态线索,往往导致激进、近碰撞的被动反应式行为,以安全裕度换取飞行速度。
论文的核心论点是:必须将显式的物理运动先验(碰撞风险)注入视觉特征学习,使策略能够"前瞻性"地主动规避,而非"最后一秒"被动闪避。
2. 方法论
#### 2.1 整体框架
提出 Anticipatory Risk-Guided RL Framework,基于非对称 Actor-Critic 架构,分训练与推理两阶段:
- 训练阶段:利用仿真器特权状态构建未来碰撞风险图,作为密集监督信号指导时空编码器。
- 推理阶段:剥离特权模块,仅依靠机载深度序列和自预测风险先验进行决策。
#### 2.2 观测空间设计
采用反演球面距离图(Inverted Spherical Range Map)替代原始深度图像,以缓解光轴畸变并优先突出近距离碰撞风险:
其中 为方位角和俯仰角离散化分量(, )。观测序列由最近 帧堆叠构成 ,并与本体感知状态 共同输入策略。
#### 2.3 特权未来碰撞风险建模(基于 CPA)
基于最近接近点(Closest Point of Approach)理论,在仿真中以特权信息计算每个障碍物的最近接近时间 和最小距离 :
定义二元未来碰撞风险函数 同时编码时间紧迫性与空间临近性:
其中 , 为时间衰减因子, 保证边界 光滑性。
将风险投影到与传感器角度分辨率匹配的 2D 球面风险图 ,再经 Log-Sum-Exp 平滑池化压缩为 1D 方位风险向量:
温度参数 控制平滑度,并自然编码障碍物密度。
#### 2.4 时空编码器与风险引导
- 空间编码:每帧由共享 2D CNN 处理得到 ;
- 时间聚合:由 Temporal Convolutional Network (TCN) 聚合得 ;
- 风险预测头:辅助预测头 ,由特权风险 通过 MSE 损失 监督;
- 策略输入融合:
注意 经停止梯度(stop-gradient)处理,避免高方差策略梯度污染辅助风险头。
#### 2.5 非对称 Actor-Critic 与奖励函数
- Actor :仅依赖机载视觉表征;
- Critic :特权增强状态 ,含全部真实动力学以稳定训练;
- 奖励函数(平衡目标追寻与绝对安全):
其中
- 总损失:
- 优化器:PPO,仿真平台为 NVIDIA Isaac Sim,基于 OmniDrones 并行训练框架。
3. 实验设计
#### 3.1 仿真场景
6 个 benchmark 场景(30 m × 10 m 走廊),含不同密度的静态与动态障碍物组合:
- 10S+10D、15S+15D、20S+20D、25S+25D、35D、50S(S=静态,D=动态,动态障碍物速度 ∈ [1,5] m/s);
- 每个场景 20 次独立试验,起点固定、目标与障碍物轨迹随机。
#### 3.2 评估指标
6 项指标:成功率 (%)、平均速度 (m/s)、系统延迟 (ms)、路径效率 、平均间隙 (m)、最小间隙 (m)(最严苛安全指标)。
#### 3.3 对比方法
- FAPP [5]:基于优化的感知与规划方法;
- NavRL [19]:分层 RL + 显式动态目标检测;
- P2M [9]:基于点流(point flow)的隐式动态表征方法。
#### 3.4 真实环境部署
- 硬件:NVIDIA Jetson Orin NX + Intel RealSense D435i + PX4 飞控 + VINS-Mono 状态估计;
- 场景:非结构化森林、堆叠箱子、含行人动态场景。
4. 资源与算力
论文明确提到的硬件资源:
- 训练/仿真平台:Intel i7-13700KF CPU + NVIDIA RTX 3090 Ti GPU;
- 仿真器:NVIDIA Isaac Sim(基于 OmniDrones 大规模并行训练);
- 真机推理平台:NVIDIA Jetson Orin NX + TensorRT 加速,策略推理延迟约 5 ms;
- 训练时长:论文未明确报告具体训练步数与总训练时间。
5. 实验数量与充分性
- 主对比实验:6 个仿真场景 × 4 种方法 × 20 次试验 = 480 次仿真回合,覆盖多种密度梯度与动态配置;
- 消融实验:2 个高度杂乱场景 × 3 个变体(完整模型 / w/o Risk / w/o TCN),验证时空编码器与风险监督的贡献;
- 真实环境实验:包含静态空间泛化(森林、箱子)、动态行人避障、突发遮挡反应等 6 组实飞演示(图 7);
- 充分性评价:
- ✅ 多场景多密度对比设计较为系统;
- ✅ 消融实验清晰拆解两个核心组件;
- ⚠️ 每个场景 20 次试验统计样本偏少,未提供方差/置信区间或显著性检验;
- ⚠️ 基线对比未完全公平(速度约束不一致:FAPP 限速 3.5 m/s、NavRL 限速 2 m/s,而本方法与 P2M 目标 5 m/s),且感知输入也不同(本方法仅前视深度,P2M 依赖全向 LiDAR),影响直接可比性。
6. 主要结论与发现
1. 安全裕度显著提升:在所有 6 个仿真场景中,所提方法均取得最高成功率(55%–95%)与最大最小间隙 (0.31–0.43 m),相比基线提升明显;
2. 低延迟高效飞行:系统延迟仅 3.22–4.07 ms(vs FAPP 11–18 ms、NavRL 17–23 ms),平均速度 2.71–4.04 m/s,在严格前视感知约束下仍保持高速度;
3. 消融验证:
- 去除风险监督 → 成功率降至 30%–40%,最小间隙下降至 0.23–0.29 m,验证了结构化风险先验的必要性;
- 去除 TCN → 策略退化为纯反应式,在纯动态场景(35D)成功率跌至 20%,验证了时序建模的关键作用;
4. 零样本 Sim-to-Real 成功:真机实验中策略可应对森林、箱子等未见场景,并在行人突发遮挡场景表现出急停悬停后侧向绕行的极限机动能力。
7. 优点与亮点
- 物理引导的结构化监督:将 CPA 这一经典碰撞几何度量转化为可微的稠密监督信号,弥补了标量奖励的监督不足;
- 方向对齐的风险表示:1D 方位风险压缩保留水平规避主维度,与多旋翼实际机动偏好吻合;
- 轻量跟踪无关设计:用轻量时空 CNN+TCN 替代显式跟踪/光流,显著降低推理延迟;
- 反演球面距离图观测:通过几何一致性表征抽象掉高频传感器噪声,有利于零样本迁移;
- 1D 风险先验 + 停止梯度:解耦风险头与策略梯度,保证风险监督的客观语义不被高方差梯度污染;
- 完整 Sim-to-Real 验证:不仅仿真表现领先,还在物理平台上展示了真实动态避障能力。
8. 不足与局限
- 常速度假设:CPA 风险建模假设短时窗内障碍物做近似匀速运动,对突然变向/加减速的行人存在失效风险;
- 前视感知盲区:仅依赖前视深度传感器,对侧后方及顶部突发威胁无能为力(论文在结论中已指出);
- 公平性争议:与 P2M 相比感知模态不同(前视深度 vs 全向 LiDAR),与 FAPP/NavRL 速度上限不同,可比性受限;
- 统计显著性不足:每场景仅 20 次试验,缺少方差、置信区间与显著性检验,结论稳健性有待加强;
- 训练成本未披露:未给出训练迭代步数、收敛时间与能耗,难以评估方法实用门槛;
- 仿真器内训练泛化风险:真实环境行人轨迹复杂度可能远超仿真设置,对长尾运动模式的适应性未验证;
- 失败模式分析不足:未深入分析 25S+25D 场景下仍存在的 45% 失败案例的性质与根因。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。