
LEACL:用于长视野操作任务强化学习的大语言模型增强自动课程学习
LEACL: LLM-Enhanced Automatic Curriculum Learning for Reinforcement Learning in Long-Horizon Manipulation Tasks
📝 TLDR
长horizon操作任务因稀疏奖励信号和长时序难以用强化学习求解。现有自动课程学习依赖人工设计的任务参数空间与难度度量,跨任务难以泛化;基于LLM的方法虽能分解任务,仍需手工设计密集奖励。本文提出LEACL框架,利用大语言模型将复杂任务分解为子任务并自动生成任务规范,结合自动课程学习实现仅依赖稀疏奖励的端到端训练。在LIBERO五个长horizon操作任务上的实验表明,LEACL的渐近成功率优于人工设计的密集奖励基线。
🧭 速览
长horizon操作任务中稀疏奖励与长时序使RL训练困难,ACL依赖人工任务参数空间与难度定义,LLM方法仍需手工密集奖励,均难以泛化。
LLM将长horizon任务分解为子任务并生成任务规范,ACL据此构建由易到难的课程,全程仅使用稀疏奖励信号训练。
在LIBERO基准五个长horizon操作任务上,LEACL的渐近成功率高于人工设计的密集奖励基线。
LEACL框架有效消除密集奖励设计需求,展示了LLM与ACL结合解决稀疏奖励长horizon任务的潜力。
🆚 方法对比
LEACL
- 仅需稀疏奖励,无需人工密集奖励
- 融合任务分解、元任务生成与ACL
- 在LIBERO五项任务上渐近成功率更高
- 实验仅覆盖LIBERO五项任务
- 性能依赖LLM生成内容的质量
- 流程中仍会出现PDDL语法错误
- 缺少真实机器人场景验证
Automatic Curriculum Learning (ACL)
- 由易到难调整训练任务分布
- 改善稀疏奖励下的样本效率
- 支持技能跨任务渐进迁移
- 依赖任务参数空间的人工定义
- 难度度量偏差会显著影响性能
- 高维配置空间中的规格难以扩展
APT-Gen
- 展示了ACL在机器人操作中的潜力
- 通过任务参数化生成训练课程
- 任务空间和难度度量依赖手工设计
- 高维配置下难以设计有效参数
- 难以直接泛化到多样化任务
LLM-based task decomposition
- 利用LLM常识分解长时序任务
- 形成由易到难的自然课程结构
- 减少人工任务逻辑编写
- 可能生成错误或不完整子目标
- 结构化输出需要语法校验与反馈
- 依赖LLM的领域知识与推理可靠性
LLM-based PDDL generator
- 自动生成任务分解所需逻辑表达式
- 利用语法错误反馈迭代修正
- 连接自然语言子目标与ACL
- 流程中反复出现语法错误
- 修正错误会增加生成成本
- 错误PDDL会破坏课程有效性
LLM-based meta-task generation
- 自动生成各子任务参数空间
- 自动提供难度度量支持ACL
- 生成不同完成度的子任务变体
- 减少按任务手写规格
- 生成规格仍需验证正确性
- 难度度量偏差会影响课程排序
- 复杂交互空间难以可靠参数化
Task and Motion Planning (TAMP)
- 能按子目标拆解复杂操作任务
- 逻辑结构清晰,便于规划动作序列
- 适用于目标条件明确的任务
- 任务逻辑表达式常需手工编写
- 灵巧子任务仍依赖密集奖励
- 任务特定结构难以跨任务泛化
LEAGUE++
- 采用LLM驱动的结构化任务分解
- 为自动生成长时序课程提供基础
- 本文未给出其详细消融结果
- 与LEACL缺少直接性能对比
- 仍受LLM生成可靠性制约
LLM-based reward generation
- 可从自然语言直接生成奖励函数
- 利用LLM常识降低奖励设计门槛
- 支持快速适配不同任务描述
- 常依赖预设奖励原语或模板
- 密集奖励可能偏离真实稀疏目标
- 仍需较多人工监督
Sparse task completion reward
- 仅在任务完成时给出反馈
- 无需手工设计复杂密集奖励
- 目标清晰且不易产生奖励塑形
- 长时序任务中的探索极其困难
- 高维连续状态导致样本复杂
- 缺少中间步骤的信用分配
Human-designed dense reward
- 可提供逐步行为引导
- 便于学习接触与精确对齐技能
- 缓解稀疏奖励下的探索困难
- 设计整合复杂奖励需要大量人工
- 奖励偏差可能导致最终任务失败
- 难以泛化到不同长时序任务
ACL与TAMP虽能改善长时序训练,但前者依赖任务规格,后者依赖人工逻辑和密集奖励;LLM奖励生成也受模板与偏差限制。LEACL以LLM生成子任务及其规格,并仅用稀疏奖励驱动ACL,在LIBERO五项任务上取得比人工密集奖励更高的渐近成功率。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
TL;DR
LEACL 提出一种将大语言模型与自动课程学习结合的框架,用于解决长视野操作任务中稀疏奖励带来的训练困难。核心思路是利用 LLM 将复杂任务自动分解为子任务并生成任务相关的参数空间与难度度量,从而为自动课程学习提供必要的规范信息,无需人工设计密集奖励。实验在 LIBERO 基准的五个长视野任务上验证了该方法,最终成功率显著优于依赖专家设计密集奖励的基线,且在部分任务上接近人工设计课程的专家水平。
研究背景与动机
长视野操作任务是机器人领域的经典难题。一个典型的场景可能是"打开抽屉、将碗放到盘子上、关闭抽屉",这类任务的特点是动作序列长、最终成功与否的判定标准单一——只有完整执行完所有步骤才会获得奖励。这种稀疏奖励信号在高维连续状态空间中会导致探索效率极低,智能体难以仅凭随机探索找到通向目标状态的路径。
[[强化学习]] 领域的自动课程学习(ACL)为这一问题提供了有价值的思路:与其让智能体一开始就面对完整的长视野任务,不如将任务分解为由易到难的一系列子任务,逐步训练智能体掌握各个子技能,最终组合成完整任务的策略。ACL 的核心假设是,更简单的子任务能够提供更密集的学习信号,帮助智能体逐步建立对任务结构的理解。
然而,ACL 的实际应用长期受制于一个根本困难:课程设计本身需要大量人工投入。有效的 ACL 需要精确定义任务参数空间——比如抽屉的初始位置范围、碗的摆放位置——以及难度度量——即哪些参数配置更容易、哪些更难。这些规范通常是任务相关的,需要领域专家根据具体场景手工设计,难以跨任务泛化。
近年来,[[大语言模型]]在常识推理和任务分解方面展现出强大能力,催生了一批将 LLM 用于[[强化学习]]的尝试。这类方法通常利用 LLM 将复杂任务分解为可管理的子目标,再由人工为每个子目标设计密集奖励函数。虽然 LLM 降低了任务分解的门槛,但密集奖励的设计仍然需要大量人工调参,且容易引入偏差——设计者对"好奖励"的直觉可能与实际任务需求不符,导致智能体学到取巧的策略而非真正完成目标。
LEACL 的核心动机正是消除这最后一步人工干预:既然 LLM 能够理解任务语义,那么它应该也能自动生成有效的任务规范——包括参数空间和难度度量——从而让 ACL 算法完全依赖稀疏奖励信号端到端训练。
方法
LEACL 采用三阶段流水线,将 LLM 的语言理解能力与 ACL 的课程学习框架有机结合。整个框架的设计哲学是:让 LLM 承担需要常识知识的任务分析和规范生成工作,而将真正的策略学习交给成熟的 RL 算法。
第一阶段:LLM 任务分解
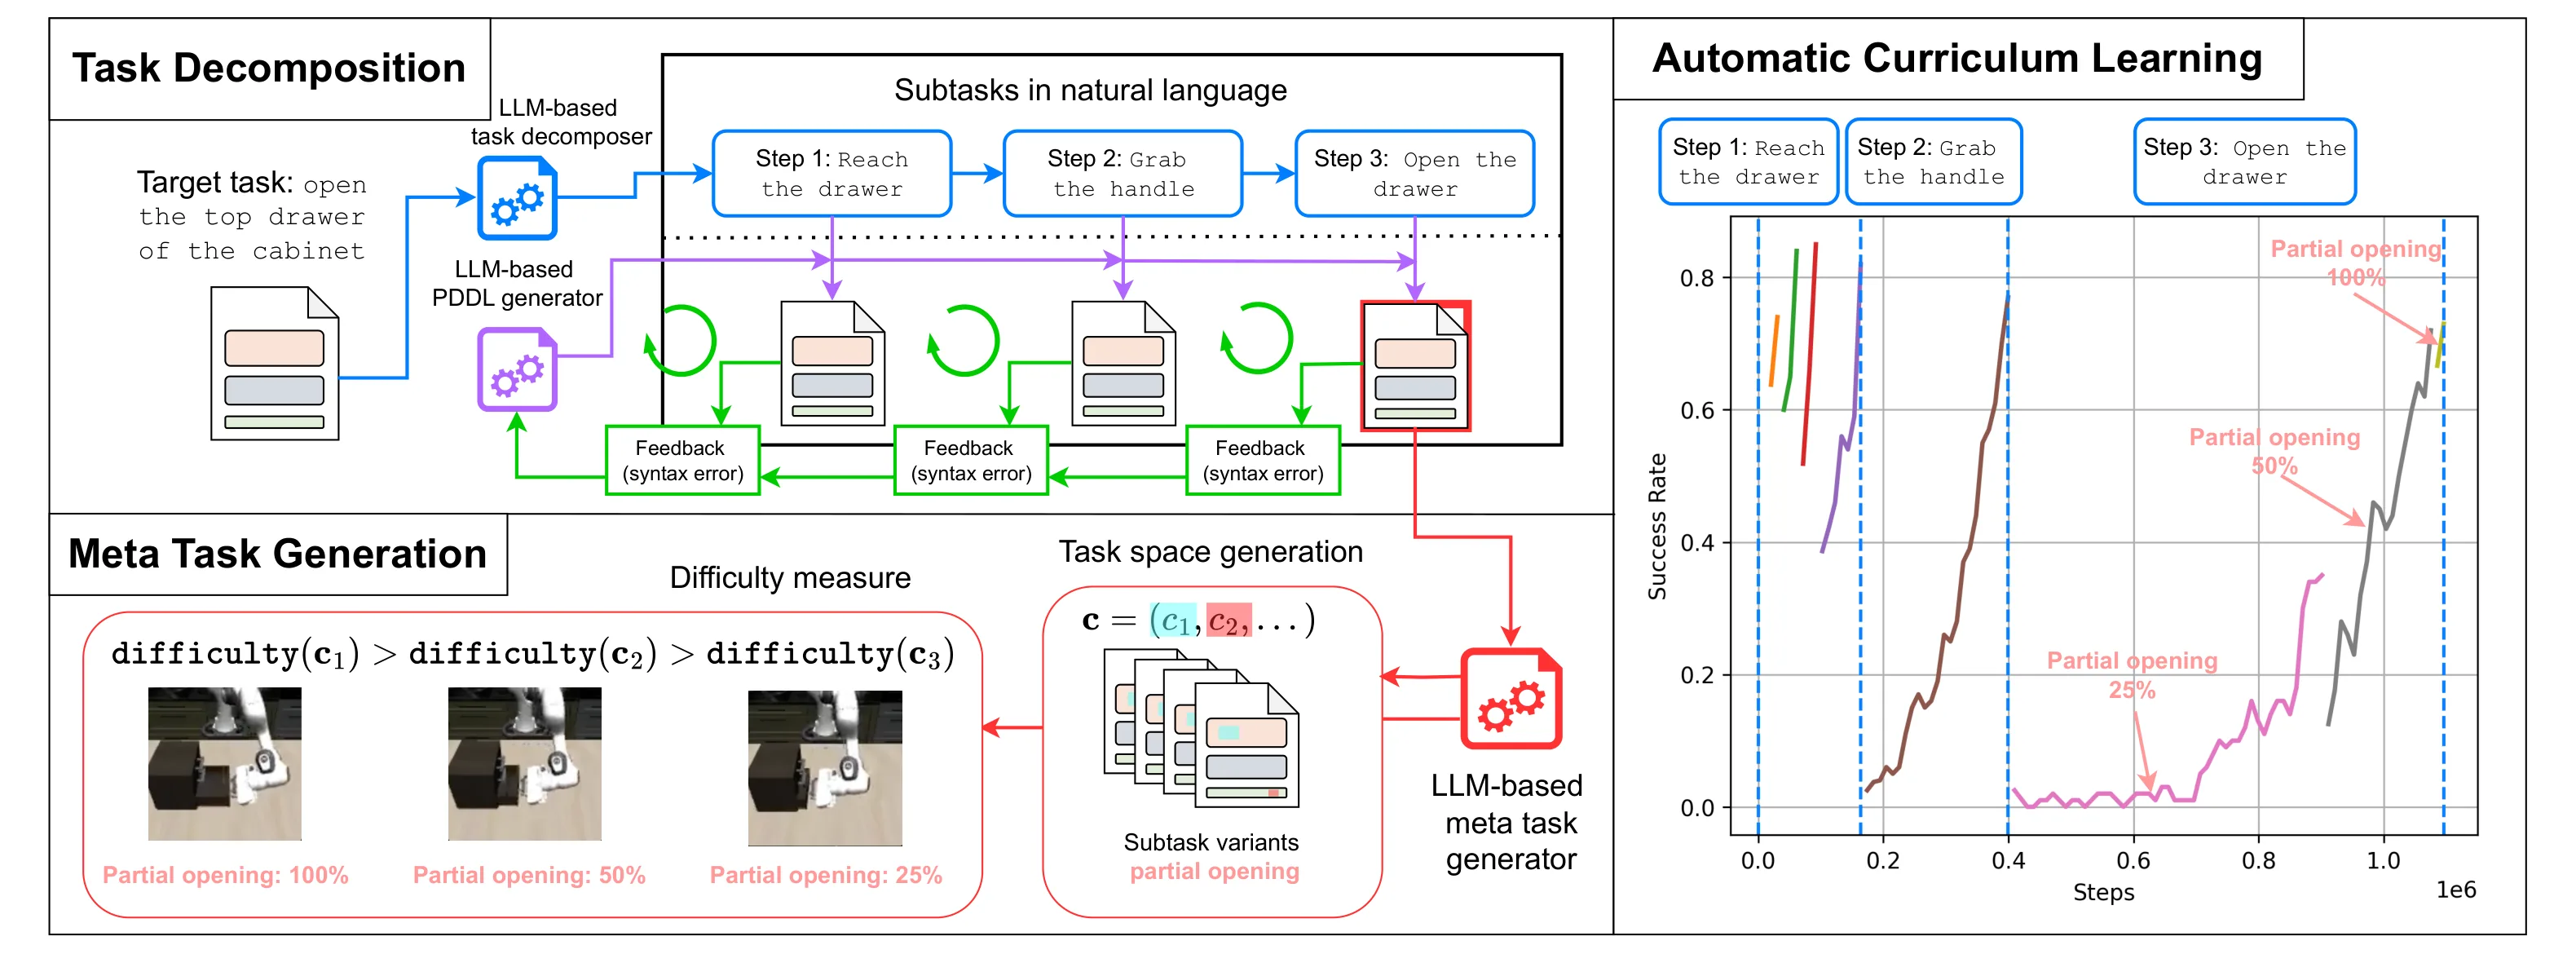
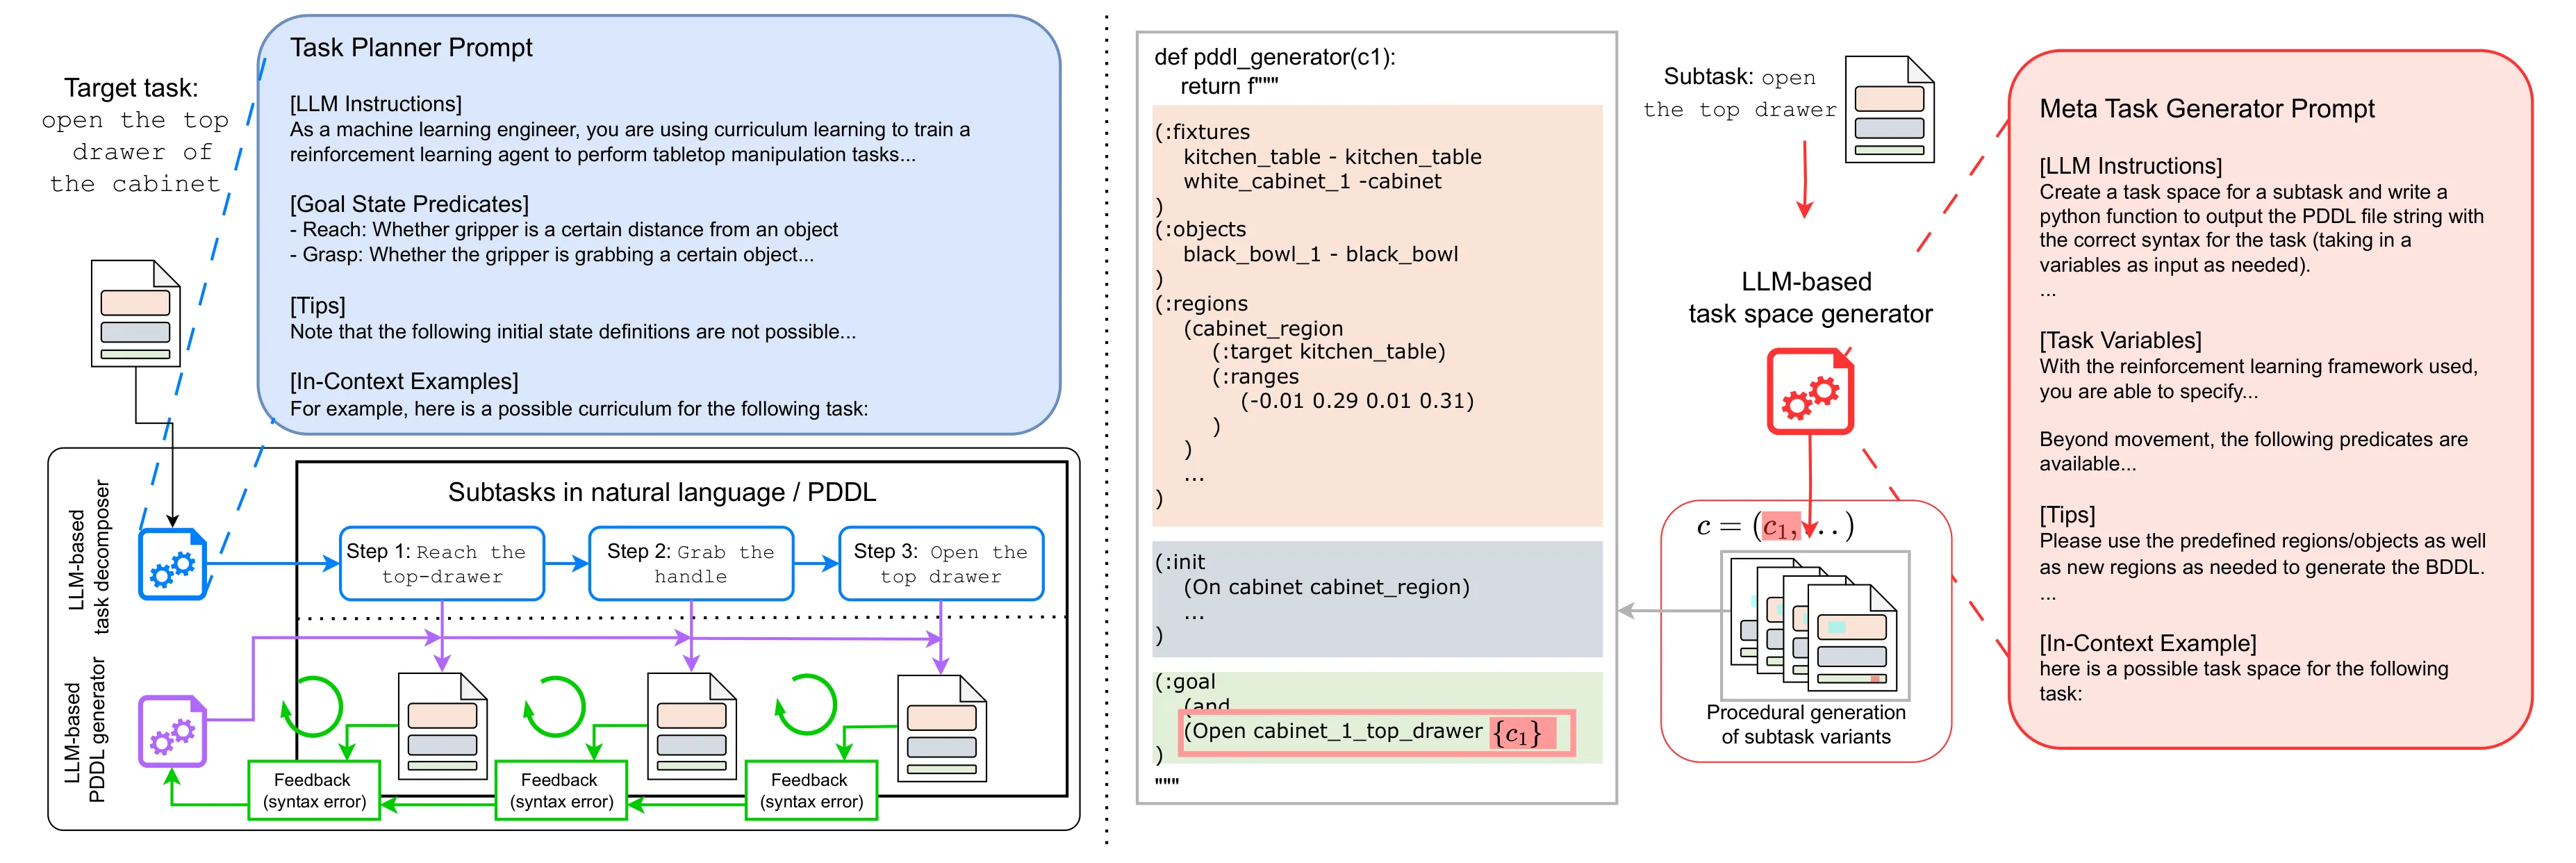
给定一个自然语言描述的长视野任务,LEACL 首先利用 LLM 将其分解为语义连贯的子任务序列。这一步采用双层提示策略:高层提示引导 LLM 从任务目标出发,推断完成目标所需的逻辑步骤序列;每个子步骤再由低层提示转换为严格的符号规范。
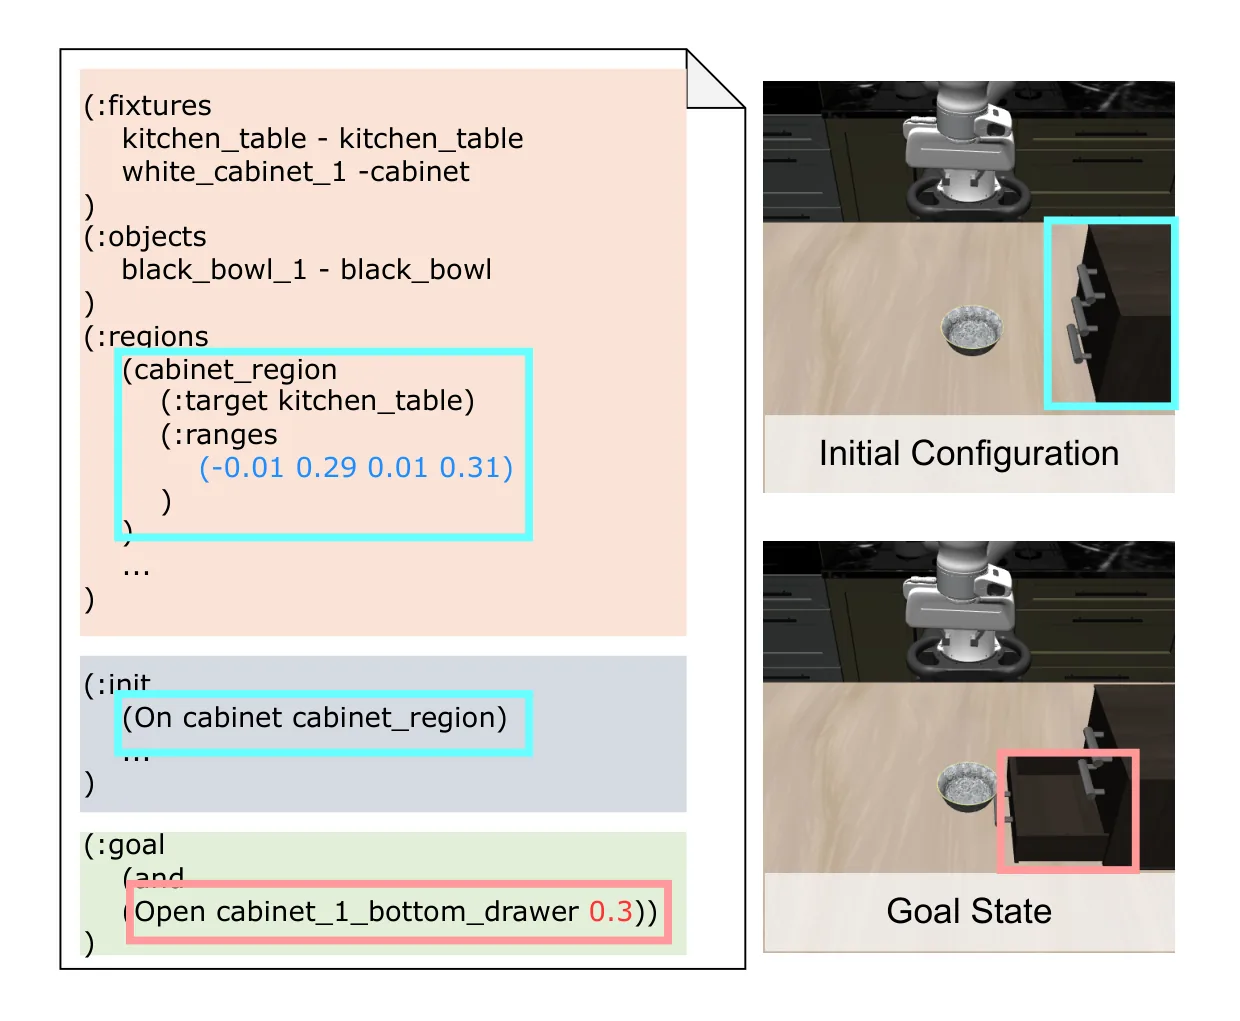
这种双层结构的必要性在于,自然语言描述本身具有歧义性,而下游的课程学习算法需要精确的数学化表示。LEACL 选择用 PDDL(Planning Domain Definition Language)作为中介表示语言。PDDL 是规划领域的标准描述语言,能够以谓词-动作-目标的形式精确定义状态转换。以"打开抽屉"为例,PDDL 规范会明确初始状态(抽屉关闭)、目标状态(抽屉打开)以及连接两者的动作前置条件和效果。
为确保生成的 PDDL 规范语法正确且可执行,LEACL 引入反思机制:在 LLM 生成 PDDL 后,系统会自动进行语法验证,若发现错误则将错误信息反馈给 LLM 进行迭代修正。这一机制类似于 LLM 编程中的自我纠错,显著提高了规范的可执行性。
形式上,每个子任务可以表示为 ,其中 是该子任务涉及的谓词集合, 是初始状态的事实集合, 是目标条件的合取形式。完整的谓词词汇表需要作为领域先验提供给 LLM,例如论文使用 LIBERO+ 基准提供的谓词库作为基础。
第二阶段:LLM 元任务生成
仅有子任务分解还不够,ACL 还需要知道如何改变任务难度。LEACL 的第二阶段让 LLM 为每个子任务生成任务参数空间和难度度量。
任务参数空间定义了子任务的可配置维度。以"打开抽屉"为例,可配置参数可能包括抽屉的初始位置、目标打开角度、抓取点的位置等。LLM 需要识别这些参数维度,并生成将参数映射到具体 PDDL 实例的函数。
难度度量则需要 LLM 对参数空间进行排序。直觉上,抽屉初始位置越远、打开角度越大,任务可能越难。LLM 基于其对物理世界的基本理解,生成按难度递增排列的参数配置序列。这些难度序列直接构成了课程学习的搜索方向。
第三阶段:自动课程学习
有了子任务分解和难度度量,LEACL 调用现成的 ACL 算法驱动 RL 训练。论文选用主动域随机化(ADR)作为默认算法,但框架本身设计为即插即用,理论上可以替换为任何 ACL 方法,如 ALP-GMM、COVAR-GMM 或 PLR 等。
ACL 算法的核心任务是自适应地选择训练参数:在课程初期选择简单配置,让智能体快速学到基础技能;随着训练进展逐渐引入更难配置,逼迫智能体泛化其策略。这种由易到难的学习顺序正是克服稀疏奖励的关键——在简单子任务上,稀疏奖励相对密集,智能体更容易获得学习信号。
整个学习目标可以形式化为:
\max_{\pi} J(\pi) = \mathbb{E}_{a_t \sim \pi, \mu}\left[\sum_{t=1}^{H} R(s_t \in \mathcal{S}_G)\right}即最大化在长度为 的视野内到达目标状态的期望累积回报,其中奖励函数是纯稀疏的——仅当状态属于目标集合 时才返回 1,否则返回 0。
实验与结果
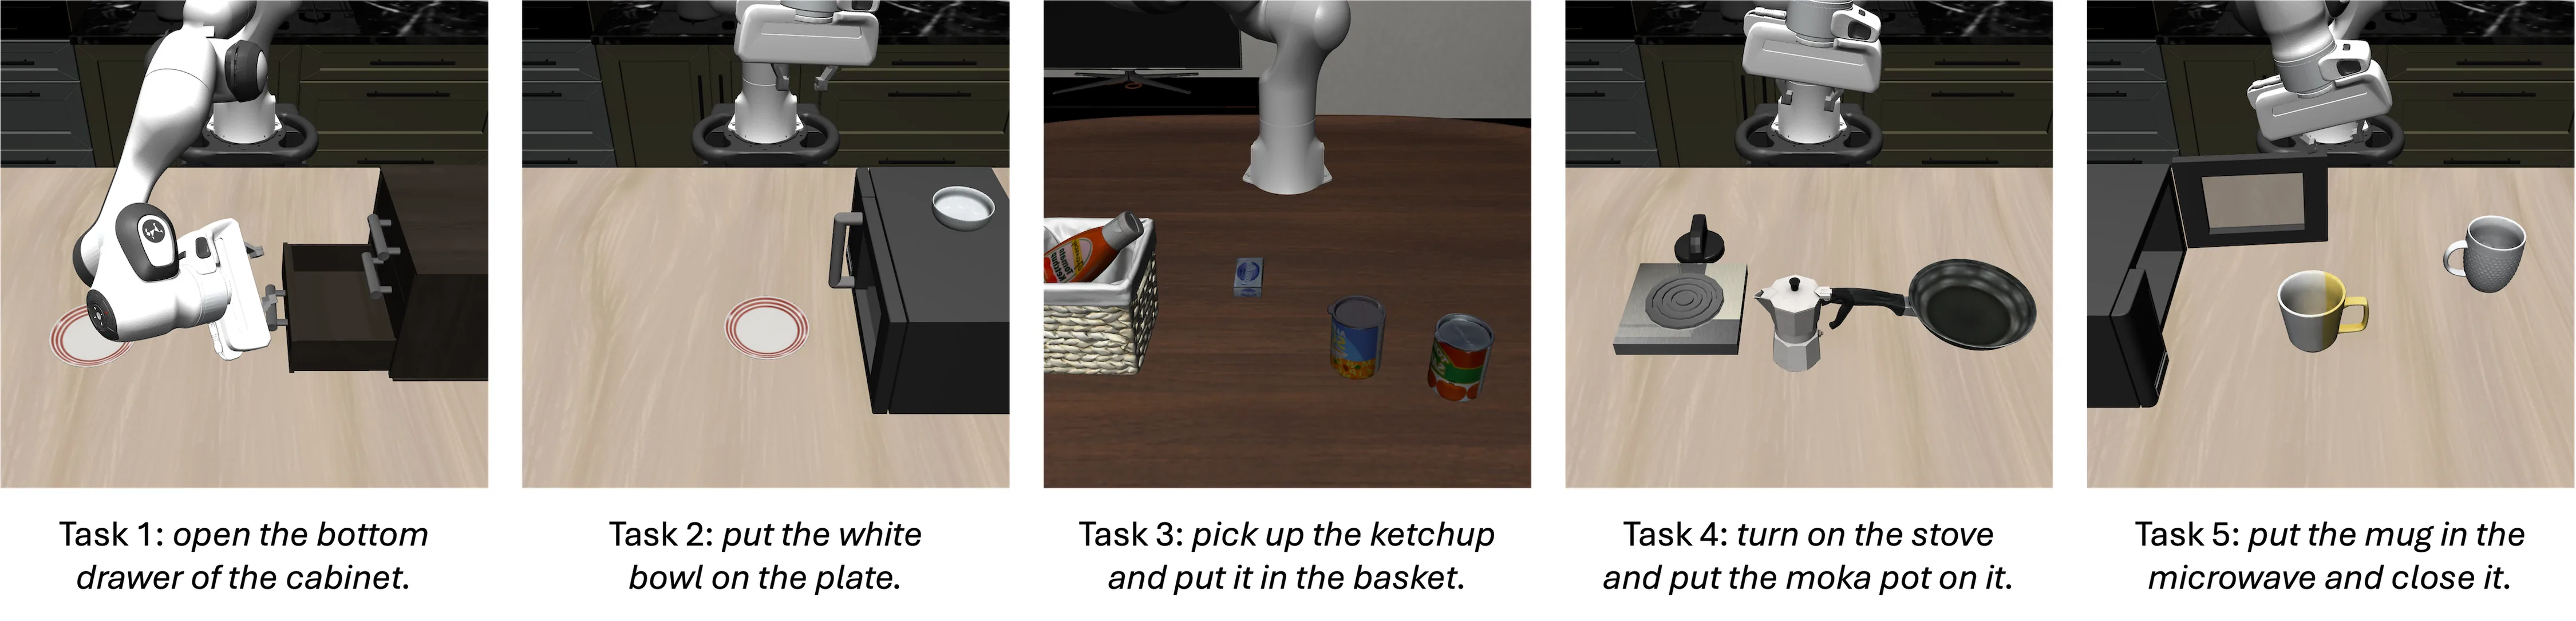
实验在 LIBERO 基准的五个长视野操作任务上进行,这些任务涵盖了从单步操作到多步规划的复杂度递增场景。具体包括:打开柜子底部抽屉、将碗放到盘子上、将番茄酱放入篮子、打开炉灶并放置摩卡壶、将杯子放入微波炉并关闭。子任务数量从 2 个到 6 个不等,形成了不同难度的测试集。
论文设计了多层次的基线对比。纯稀疏奖励基线代表没有课程学习的朴素 RL,这是最困难的设置;LEACL w/o ACL 版本仅使用 LLM 任务分解但不启动课程学习,用于验证 ACL 组件的贡献;LEAGUE 是依赖人工设计密集奖励的代表方法;Human curriculum 则是人工设计的课程加上 ACL,代表当前最佳实践。
主要结果呈现出清晰的层次结构。纯稀疏奖励在所有任务上完全失败,成功率为零,这印证了稀疏奖励问题的严重性。仅靠 LLM 分解任务而不使用 ACL 的版本也几乎全部失败,仅在两个任务上取得了个位数的成功率,说明任务分解只是必要条件而非充分条件。
有趣的是,专家设计的密集奖励(LEAGUE)表现同样不尽如人意。在五个任务中,LEAGUE 仅在一个任务上达到接近完美的成功率,其余任务表现显著差于 LEACL,最高不超过 71%。论文将此归因于密集奖励的脆弱性:当奖励函数与实际任务目标存在偏差时,智能体容易学到取巧的捷径策略,无法精确满足复合目标条件。
LEACL 在大多数任务上取得了与人工课程相当甚至更好的结果。五个任务的最终成功率分别为 99.8%、90.7%、89.4%、60.6% 和 75.9%,其中三个任务的表现优于 LEAGUE,部分任务接近 Human curriculum 的水平。考虑到 LEACL 完全不需要人工设计奖励或课程规范,这一结果相当具有说服力。
值得注意的是,LEACL 的表现在不同任务间存在较大差异。任务四(打开炉灶并放置摩卡壶)的成功率仅 60.6%,显著低于其他任务,这可能与该任务涉及更多的对象交互和更长的动作序列有关。
讨论与可借鉴点
LEACL 的核心贡献在于证明了 LLM 可以替代人工完成课程学习所需的规范设计工作,从而实现"零人工奖励"的端到端训练。这一发现对 [[强化学习]] 在机器人领域的应用具有重要启示:任务规范并非必须由领域专家手工编码,常识知识和语言理解能力足以支撑自动化的课程构建。
论文的一个重要发现是稀疏奖励与 ACL 的协同效应。实验表明,稀疏奖励配合课程学习的效果优于精心设计的密集奖励。这挑战了"稀疏奖励无法训练"的传统观念,揭示了问题可能不在于奖励密度本身,而在于缺乏有效的课程结构来组织学习过程。
然而,LEACL 仍存在若干局限。首先,方法依赖预定义的谓词词汇表作为领域先验,这意味着在面对新领域时仍需人工提供基础的符号表示。其次,LLM 的错误可能在任务分解阶段传播,导致课程质量下降,论文未报告 LLM 的失败率和需要人工干预的频率。再次,实验仅在仿真环境中评估,未涉及 sim-to-real 迁移的挑战。
从工程实践角度,LEACL 的即插即用设计值得借鉴。将 LLM 用于规范生成、将策略学习委托给成熟的 RL 算法,这种分工思路避免了端到端 LLM-RL 训练的不可控性。PDDL 作为 LLM 输出与下游程序之间的中介表示也是一个良好设计选择,兼顾了表达能力和可执行性验证。
未来的工作可以在几个方向拓展:一是在更多样的机器人操作场景(如双机械臂协调、移动操作)上验证方法的泛化性;二是探索不同 LLM(GPT-4、Claude、开源模型)对规范生成质量的影响;三是研究如何减少对预定义谓词集的依赖,使框架更适用于开放世界场景。
摘要
长视野操作任务由于奖励信号稀疏且视野跨度长,对强化学习构成了重大挑战。自动课程学习(ACL)被提出用于应对这些挑战,其方法是在一系列任务上由易到难地逐步训练智能体。然而,ACL 的成效在很大程度上依赖于任务相关的规范——例如定义良好的任务参数空间和难度度量——而这些规范通常需要人工设计,并且难以泛化到多样化的任务中。大语言模型(LLM)的最新进展提供了一条有前景的替代途径,它能够利用 LLM 在网络规模上积累的常识知识,将复杂任务分解为有意义的子任务。这种分解可以为高效学习长视野任务提供自然的课程结构。然而,现有基于 LLM 的方法通常依赖人工设计的密集奖励函数来学习每个子任务,这可能引入偏差,并且仍然需要大量的人工监督。在本文中,我们提出了大语言模型增强的自动课程学习(LEACL),一个融合 LLM 与 ACL 以克服上述局限性的框架。具体而言,LLM 既被用于将任务分解为子任务,也被用于为每个子任务生成任务相关的规范。这些规范随后被 ACL 算法用于仅依靠稀疏奖励信号来指导学习,从而消除了设计密集奖励的需求。我们在 LIBERO 基准上的五个长视野操作任务上对 LEACL 进行了评估。结果表明,LEACL 在成功率方面相比人工设计的密集奖励实现了更优的渐近性能。
Abstract
Long-horizon manipulation tasks pose significant challenges for reinforcement learning due to sparse reward signals and long horizons. Automatic curriculum learning (ACL) has been proposed to tackle these challenges by progressively training agents on a sequence of tasks, from easier to more difficult. However, the success of ACL depends heavily on task-dependent specifications-such as well-defined task parameter spaces and difficulty measures-which are often manually crafted and difficult to generalize across diverse tasks. Recent advances in large language models (LLMs) offer a promising alternative by enabling the decomposition of complex tasks into meaningful subtasks using the LLMs' web-scale common-sense knowledge. This decomposition can provide a natural curriculum structure for efficient learning of long-horizon tasks. However, existing LLM-based methods typically rely on hand-designed dense reward functions to learn each subtask, which can introduce bias and still requires significant human supervision. In this work, we propose LLM-enhanced automatic curriculum learning (LEACL), a framework that integrates LLMs and ACL to address these limitations. Specifically, LLMs are used to both decompose tasks into subtasks and to generate task-dependent specifications for each subtask. These specifications are then used by ACL algorithms to guide learning using only sparse reward signals, eliminating the need for dense reward design. We evaluate LEACL on five long-horizon manipulation tasks from the LIBERO benchmark. LEACL achieves better asymptotic performance in terms of the success rates compared to human-designed dense rewards.
论文详细总结(自动生成)
LEACL 论文总结
1. 核心问题与研究动机
长视野(long-horizon)操作任务对强化学习(RL)构成显著挑战,主要源于两个核心困难:
- 奖励稀疏:稀疏奖励信号在长视野高维连续状态空间中导致探索效率极低,样本复杂度高。
- 任务规范的工程化困境:
- 传统自动课程学习(ACL)依赖人工设计的任务参数空间与难度度量,跨任务难以泛化。
- 基于大语言模型(LLM)的现有方法(如 LEAGUE++、Text2Reward、Eureka 等)虽能分解任务,但仍需手工设计密集奖励函数,存在偏差风险且需要大量人工调参。
研究目标:构建一个通用、无需任务特定人工输入的框架,仅依赖稀疏任务完成奖励即可在长视野操作任务上获得高性能策略。
2. 方法论
2.1 整体框架(LEACL)
LEACL 由三个顺序执行的阶段构成:
1. LLM 任务分解:将长视野任务分解为一系列语义明确的子任务,每个子任务用 PDDL(Planning Domain Definition Language)规范表示。
2. LLM 元任务生成:为每个子任务自动生成任务参数空间(task parameter space)和难度度量(difficulty measure)。
3. 自动课程学习(ACL):调用现成 ACL 算法,仅使用稀疏奖励训练 RL 智能体。
2.2 关键技术细节
阶段一:LLM 任务分解
- 采用双层提示策略(bi-level prompting):
- 高层 LLM:给定自然语言目标描述,生成 K 个子任务的自然语言描述序列。
- 低层 LLM:将每个自然语言子任务转换为合法的 PDDL 规范。
- 引入反思机制(reflection):语法验证 + 迭代修正以提高 PDDL 规范的可执行性。
- 形式化表示:每个子任务规范为 ,其中 为谓词集合、 为初始文字集合、 为目标文字合取集合。
- 假设:完整谓词词汇表(grammar)作为先验提供给 LLM(如 LIBERO+ 的全套谓词)。
阶段二:LLM 元任务生成
- 任务参数空间:LLM 识别 维参数向量 ,形成控制空间 ,并生成 Python 函数模板将 映射到 PDDL 子集 。例如,开抽屉子任务的控制变量可包括抽屉初始位置与目标开度。
- 难度度量:LLM 生成 个按难度排序的参数向量 ,满足当 时 比 更难。
阶段三:自动课程学习
- 选用 Active Domain Randomization (ADR) 作为下游 ACL 算法(虽然 LEACL 设计为可即插即用,支持 ALP-GMM、COVAR-GMM、GOAL-GAN、PLR 等多种算法)。
- 基于 TeachMyAgent 框架实现。
- 优化目标为最大化后训练智能体在原始子任务 上的成功率。
2.3 形式化表述
任务建模为有限视野目标增强 MDP:
其中 为转移函数,奖励函数为:
学习目标为最大化期望累积回报:
子任务分解后获得子任务–PDDL 配对序列 。
3. 实验设计
3.1 数据集与场景
- 基准:LIBERO(终身机器人操作学习基准)+ LIBERO+(本文扩展版本)。
- LIBERO+ 扩展内容:
- 引入参数化谓词(parameterized predicates),例如将
open(object)替换为open(object, ?o)以支持连续开度。 - 增加细粒度谓词,增强任务多样性。
- 5 个长视野操作任务(按分解子任务数 2/5/6/4/5):
1. Open the bottom drawer of the cabinet
2. Put the white bowl on the plate
3. Pick up the ketchup and put it in the basket
4. Turn on the stove and put the moka pot on it
5. Put the mug in the microwave and close it
- 仿真环境:MuJoCo,全可观测设定。
3.2 基线对比
| 方法 | 任务分解 | 参数化谓词 | 规范来源 | RL 信号 |
|---|---|---|---|---|
| Sparse reward | × | × | — | 稀疏 |
| LEACL w/o ACL | ◦ | × | 人工子任务 | 稀疏 |
| LEAGUE | ◦ | × | 人工密集奖励 | 密集 |
| Human curriculum | ◦ | ◦ | 人工 + ACL | 人工 |
| LEACL (本文) | ◦(LLM) | ◦(LLM) | LLM + ACL | 稀疏 |
3.3 训练配置
- 基础算法:PPO(来自 Stable-Baselines3)
- 学习率:
- 每策略更新环境步数:
- 网络结构:Actor/Critic 各 2 层 MLP,每层 128 单元
- 超参数:所有任务保持一致以保证公平比较
- 训练预算:最少 环境步,保证所有基线达到成功率平台期
- 评估:每个随机种子训练后用最终模型评估 个回合
4. 资源与算力
- 论文未明确披露所使用的 GPU 型号、数量、训练时长、LLM 调用成本等算力细节。
- 已知 LLM 使用 ChatGPT 4o-mini(OpenAI),但调用次数、token 消耗等未报告。
- 建议读者参阅 GitHub 仓库(
https://github.com/fheravi/LIBERO-plus)或附录以获取复现细节。
5. 实验数量与充分性
5.1 数量
- 主要实验:5 个任务 × 5 种方法 × 5 个随机种子 = 125 次训练运行(实际表格数据呈现的为最终成功率均值±95% 置信区间)。
- 评估规模:每个种子 1000 个回合,总计 次回合评估。
- 消融实验:仅隐式包含(即"LEACL w/o ACL"对比 ACL 组件的贡献),未提供系统性的超参数/组件消融(如不同 ACL 算法对比、不同 LLM 对比、谓词集完备性消融等)。
5.2 充分性与公平性
- 优点:
- 多个基线覆盖了关键对照维度(无 ACL、有人工密集奖励、有人工课程)。
- 多种子 + 95% 置信区间统计较严谨。
- 任务多样性较好(涉及抽屉、容器、炉灶、微波炉等不同对象交互)。
- 不足:
- 5 个任务规模相对较小,对结论的普适性有一定限制。
- 仅使用一种 ACL 算法(ADR),未在 ACL 算法空间内进行对比,难以评估 LEACL 与不同 ACL 算法的兼容性。
- 仅使用一种 LLM(4o-mini),未对比 GPT-4、Claude、开源 LLM 等。
- 未报告 LLM 任务分解的成功率(PDDL 语法错误重试次数等)。
- 未进行统计显著性检验(如 t-test)。
6. 主要结论与发现
主要结果汇总(成功率 %,均值 ± 95% CI):
| 方法 | Task 1 | Task 2 | Task 3 | Task 4 | Task 5 |
|---|---|---|---|---|---|
| Sparse reward | |||||
| LEACL w/o ACL | |||||
| LEAGUE | |||||
| Human curriculum | |||||
| LEACL |
核心发现:
1. 任务分解单独不够:LEACL w/o ACL 在大多数任务上几乎完全失败,说明仅靠子任务分解不足以克服稀疏奖励。
2. 密集奖励设计并非易事:尽管有专家调参,LEAGUE 在 4/5 任务上显著劣于 LEACL。密集奖励在不同对象几何/动力学下表现不稳定,且易导致"sloppy"行为,无法精确满足复合谓词。
3. LLM 可与人类专家匹敌:Human curriculum 在 3/5 任务上略胜 LEACL,但需要多轮人工迭代;LEACL 通过良好提示设计即可零样本完成。
4. 稀疏奖励 + ACL 组合更鲁棒:稀疏任务完成奖励配合早终止机制能产出更精确、可靠的策略。
7. 优点
- 首次实现"完全无人工密集奖励"的 LLM-RL 课程框架:消除了 LLM 生成奖励方法对奖励原语/模板的依赖。
- 即插即用 ACL 设计:通过 TeachMyAgent 标准化接口兼容多种 ACL 算法(ADR、ALP-GMM、COVAR-GMM、PLR 等),具备良好的扩展性。
- PDDL 中介表示:将 LLM 输出统一为 PDDL 形式,便于反射式语法校验与下游 ACL 程序化使用。
- 开源贡献:LIBERO+ 基准与代码已公开(
https://github.com/fheravi/LIBERO-plus)。 - 提示设计详尽:双层提示策略 + In-Context Examples + Tips,反思机制提高 PDDL 可执行性。
- 统计严谨性:5 个随机种子 + 95% CI + 1000 回合评估。
- 跨任务通用:提示在多个不同任务上零样本适用,无需任务特定监督。
8. 不足与局限
8.1 方法层面
- 谓词集先验依赖:需要预先给定领域谓词词汇表(grammar),如 LIBERO+ 提供的全套谓词。这是 LEACL 的核心局限——若谓词不完整,LLM 无法表达所需子目标。
- LLM 错误传播:任务分解或 PDDL 生成错误会直接影响课程质量,论文未报告 LLM 失败率与人工干预频率。
- 单 LLM、单 ACL 算法实验:未对比不同 LLM(GPT-4、Claude 等)与不同 ACL 算法的组合效果。
- 幻觉风险:LLM 可能在 PDDL 中生成语义上无效但语法合法的子目标,导致无效课程。
8.2 实验层面
- 任务规模有限:仅 5 个 LIBERO+ 任务,未覆盖更广泛的机器人操作场景。
- 缺少消融:未对提示设计、ACL 算法选择、谓词参数化深度等进行系统消融。
- 算力披露缺失:GPU 型号/数量、训练时长、LLM 调用成本等未明确报告,影响可复现性评估。
- 统计检验不足:未报告跨方法的统计显著性检验(如配对 t-test)。
- 种子数较少:5 个种子在长视野任务成功率评估中方差可能仍较大,部分任务置信区间较宽(如 LEAGUE 在 Task 2 上 )。
8.3 应用层面
- 仿真局限:仅在 MuJoCo 仿真中评估,未涉及真实机器人迁移(sim-to-real)。
- 任务范围:主要聚焦桌面操作(tabletop manipulation),对移动操作、双手机器人等场景未验证。
- 对象交互类型局限:主要为抓取-放置与简单开/关类接触交互,更复杂的装配、柔性物体操作未涉及。
- LLM 推理成本:每次训练前需多次 LLM 查询生成课程(任务分解 + 元任务生成),虽强调"减少训练中查询",但离线成本仍未量化。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。