
📝 TLDR
文生图扩散模型在推理时需手动设置提示词、负向提示、CFG尺度、噪声调度等采样参数,且通常对所有提示和时间步保持固定,但不同提示与生成阶段的最优参数存在差异。为此提出LeSAMP框架,将参数选择建模为强化学习问题,由大语言模型根据用户提示输出随时间步变化的采样参数调度,并利用人类偏好模型和VLM打分作为奖励优化。在Flux.1[dev]与Stable Diffusion 3.5上的实验表明,LeSAMP相较基线的人类偏好胜率最高达68.12%,VLM评判胜率达73.37%,用户研究胜率达59.46%,证明学习采样参数策略是与现有后训练方法互补的改进路径。
🧭 速览
扩散模型推理时的CFG尺度、负向提示与噪声调度等采样参数通常全局固定,无法适配不同提示与生成阶段,限制了图像质量与提示遵循度的进一步提升。
将采样参数调度建模为强化学习任务,由大语言模型根据用户提示输出各时间步的参数配置,并以人类偏好模型与VLM评判分数作为奖励信号对策略进行优化。
在Flux.1[dev]与Stable Diffusion 3.5上,人类偏好胜率最高68.12%,VLM评判胜率最高73.37%,用户研究胜率最高59.46%,均显著优于固定参数等基线方法。
学习得到的采样参数策略为改进扩散模型输出提供了一种与模型权重后训练互补的方案,能够在不修改模型本身的情况下显著提升生成质量。
🆚 方法对比
LeSAMP
- 提示词条件化且时步变化的参数调度策略
- 在Flux.1和SD3.5上人类偏好胜率达68.12%
- VLM-as-a-judge胜率高达73.37%
- 用户研究中胜率达59.46%,效果获多维度验证
强化学习参数选择框架
- 将参数选择建模为强化学习问题,灵活可优化
- 利用人类偏好模型和VLM评分作为奖励信号
- 无需修改扩散模型权重,纯推理时优化
- 为扩散模型后训练提供互补方案
固定采样参数基线方法
- 实现简单,一次设定即可重复使用
- 无需额外训练或推理开销
- 在简单提示词下可能已足够
VLM-as-a-judge自动评估
- 提供可扩展的自动化奖励信号
- 与人类偏好评分趋势一致,验证有效
- 降低人工评估成本,加速训练迭代
本文主要讨论单一框架LeSAMP,相比固定采样参数基线实现了提示词条件化、时步变化的动态参数调度,并通过人类偏好与VLM评估验证其互补优势。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
LeSAMP 提出让大语言模型根据用户提示词动态生成采样参数的调度方案,将这一过程建模为 [[强化学习]] 问题,并利用人类偏好模型和 [[视觉语言模型]] 作为奖励信号进行优化。在 Flux.1[dev] 与 Stable Diffusion 3.5 上的实验表明,该方法相比固定参数策略在人类偏好评估中最高取得 68.12% 的胜率,证明学习采样参数策略是与模型后训练互补的改进路径。
研究背景与动机
文生图扩散模型的推理过程涉及大量可调的采样参数。用户在生成一张图像时,需要手动设定正向提示词、负向提示词、无分类器引导尺度(CFG Scale)以及噪声调度策略等多个超参数。传统做法是在生成开始前由人工选择一组参数值,然后在整个去噪时间步中保持不变。这种"一次设定、全程固定"的策略虽然简单直观,却忽视了生成过程中的两个关键差异。
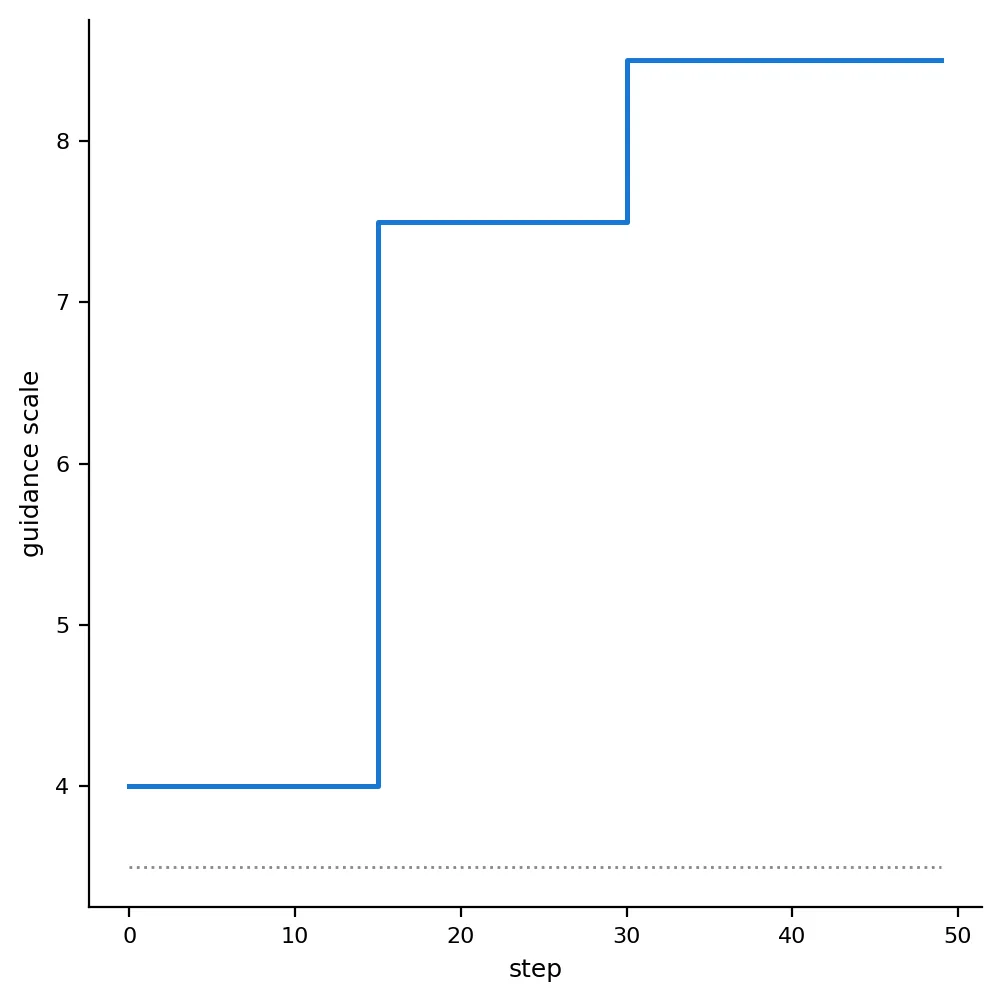
第一个差异来自提示词本身的多样性。一句简洁的动作描述和一段包含多个主体、复杂空间关系的详细场景描述,对采样参数的需求显然不同——前者可能只需要适度的引导强度,而后者往往需要更强的文本-图像对齐约束。第二个差异来自生成过程的时序特性。扩散模型的去噪过程在早期阶段主要负责构图和大尺度结构,在后期阶段则专注于细节纹理和局部一致性。直觉上,早期可能需要更高的引导强度来确保布局符合文本意图,而后期则应适当降低引导以避免过度约束导致的质量损失。
已有研究尝试通过 [[后训练]] 方法(如 LoRA、DreamIdentity 等)从模型层面改善生成质量,但这些方法需要修改模型权重、消耗大量计算资源。LeSAMP 的核心切入点是:与其改变模型本身,不如让模型在推理时获得更好的"操作指导"——即随时间和提示词动态调整采样参数,从而在现有模型基础上进一步挖掘性能潜力。
方法
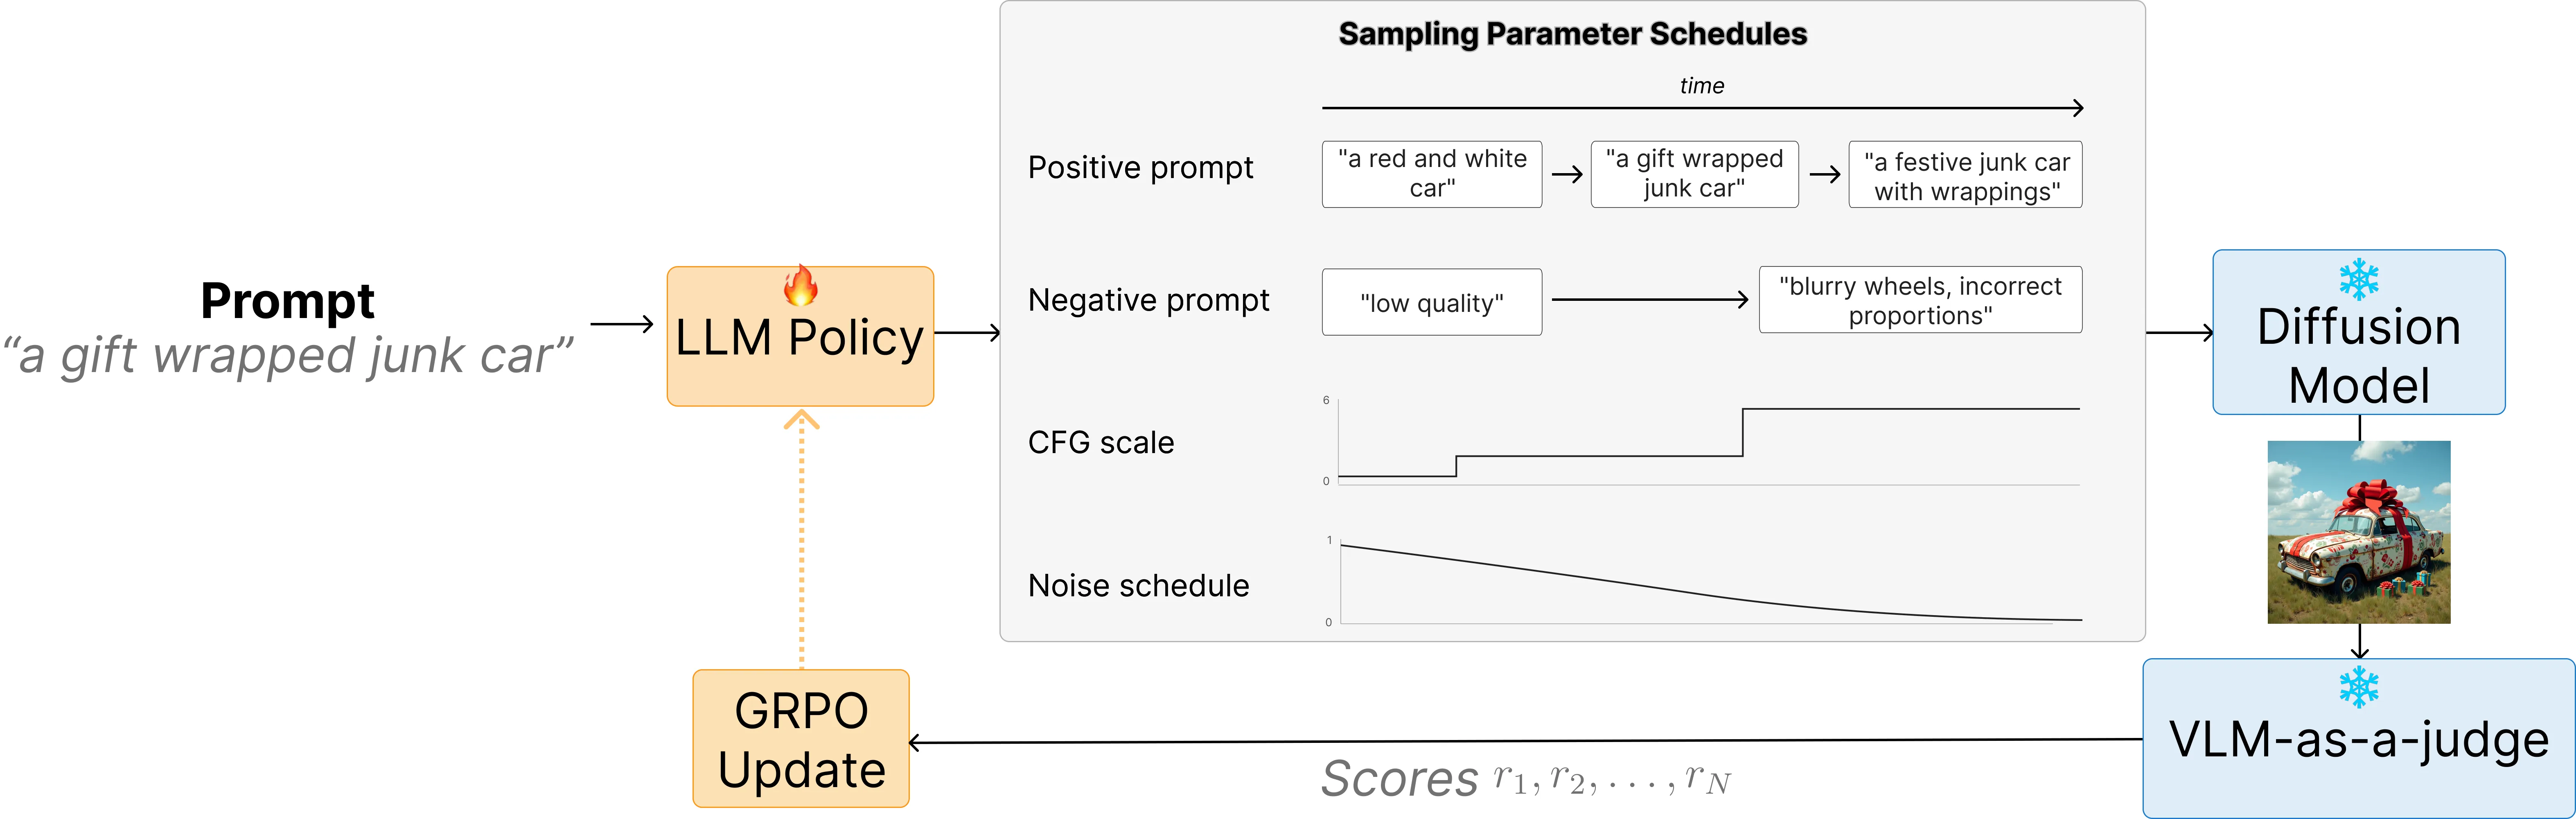
LeSAMP 将采样参数选择建模为一个 [[强化学习]] 问题,其核心由三个组件构成:策略模型、动作空间和奖励信号。
策略模型采用大语言模型来实现。大语言模型的优势在于其对自然语言的语义理解能力——它能够解析用户输入的提示词,捕捉其中的关键语义元素(如主体数量、动作关系、风格描述等),并据此推断不同生成阶段所需的参数配置。具体而言,给定一条用户提示词 ,大语言模型输出一个调度方案 ,该方案描述了在去噪过程的各个时间步 上,CFG 尺度、负向提示词强度、噪声调度系数等参数应如何变化。
动作空间的设计需要平衡表达力与可控性。LeSAMP 将每个时间步的参数调整量离散化为若干档位,例如 CFG 尺度可以设定为相对基础值的 +2、+1、0、-1、-2 等档位。离散化的好处是降低了策略学习的难度,同时通过档位边界的软约束保证输出仍在合理范围内。对于负向提示词,LeSAMP 允许模型选择在特定阶段是否启用负向提示、以及启用时使用哪类通用反义词模板。
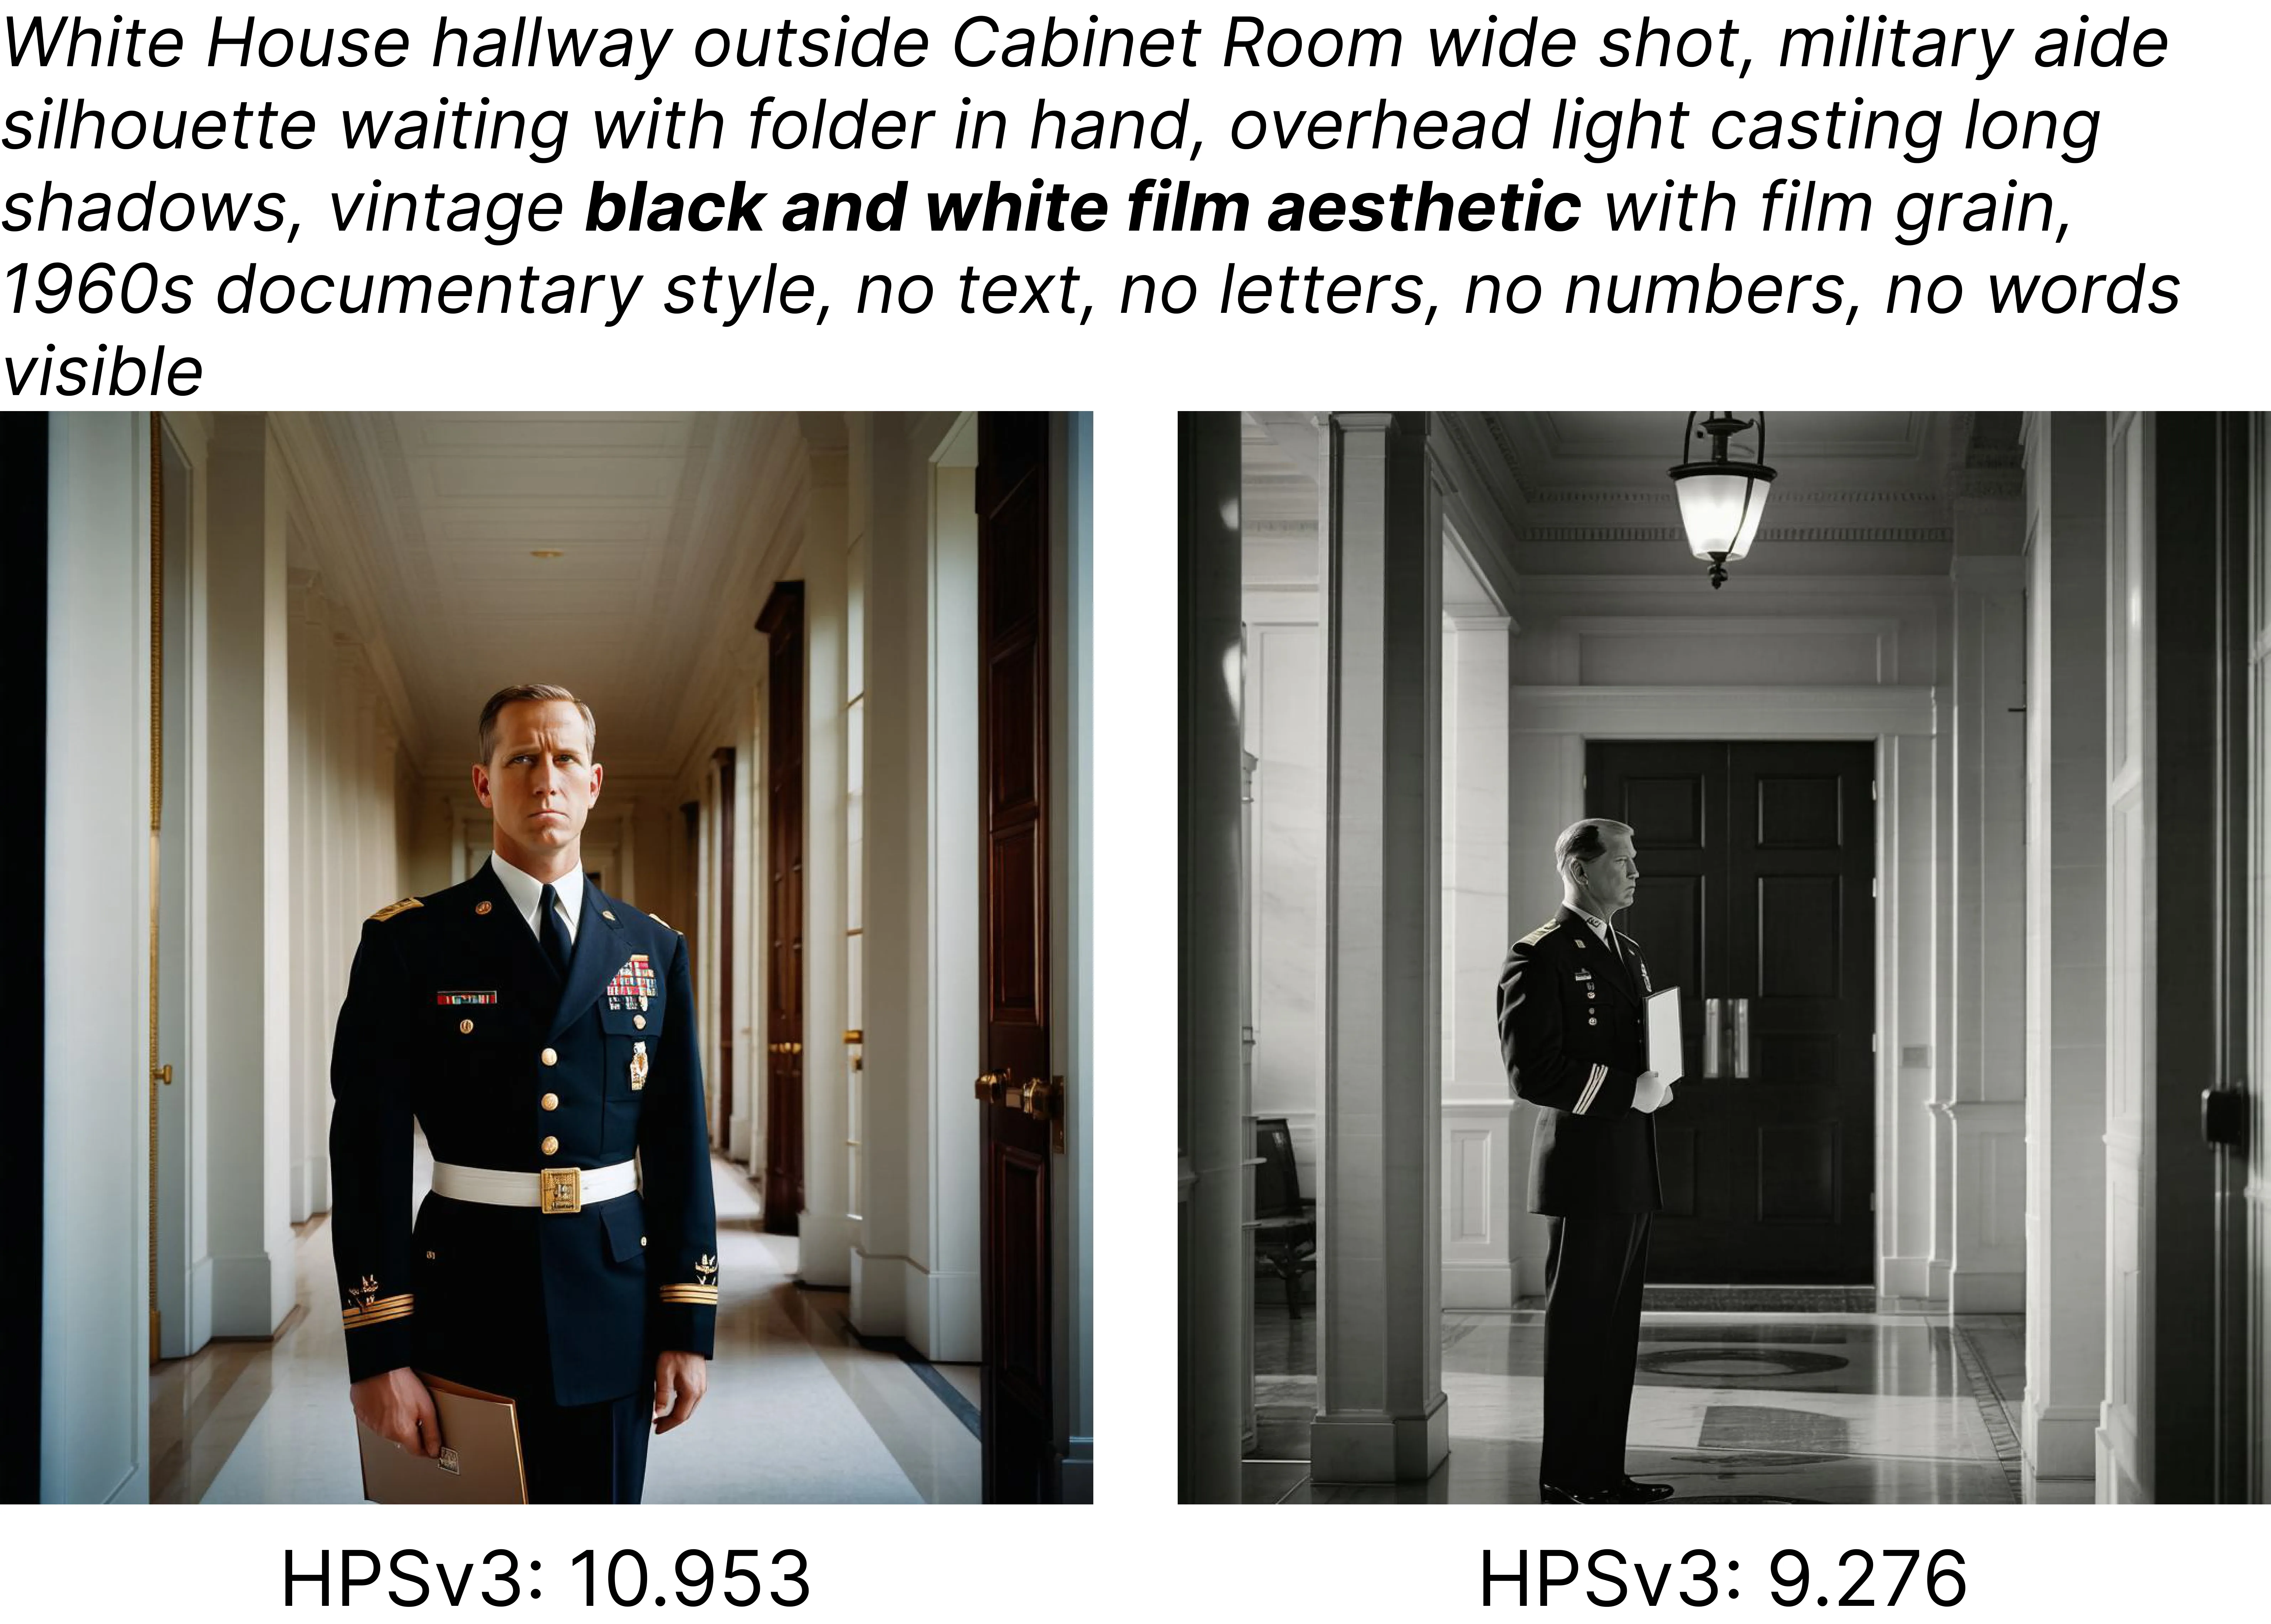
奖励信号的设计是本方法的关键创新点。直接使用人类反馈成本过高且难以规模化,LeSAMP 因此引入两类自动化的奖励源。第一类是现成的人类偏好模型,这类模型在大规模人类比较数据上训练,能够判断两张图像中哪一张更符合给定的文本描述。策略模型的输出会与固定参数策略在相同提示词下生成的结果进行比较,偏好模型给出胜者为 1、败者为 0 的二值信号。第二类是 VLM-as-a-judge,即用视觉语言模型作为评判者,直接评估生成图像在文本对齐、美学质量、构图合理性等维度上的得分。这两类奖励信号互补——偏好模型反映相对质量,VLM 评分提供绝对维度的反馈。
训练过程中,LeSAMP 使用策略梯度方法(如 PPO 的简化变体)更新大语言模型的权重,最大化累积奖励期望。考虑到训练稳定性,论文采用了保守的更新策略和 KL 散度约束,防止策略偏离初始监督微调阶段学到的合理行为太远。
实验与结果
实验选择 Flux.1[dev] 和 Stable Diffusion 3.5 两个主流扩散模型作为基座,评估 LeSAMP 在多样化提示词集合上的有效性。对比基线包括:固定 CFG 尺度的标准采样、仅在早期/后期应用高引导强度的启发式策略、以及基于提示词复杂度静态预设参数的规则方法。
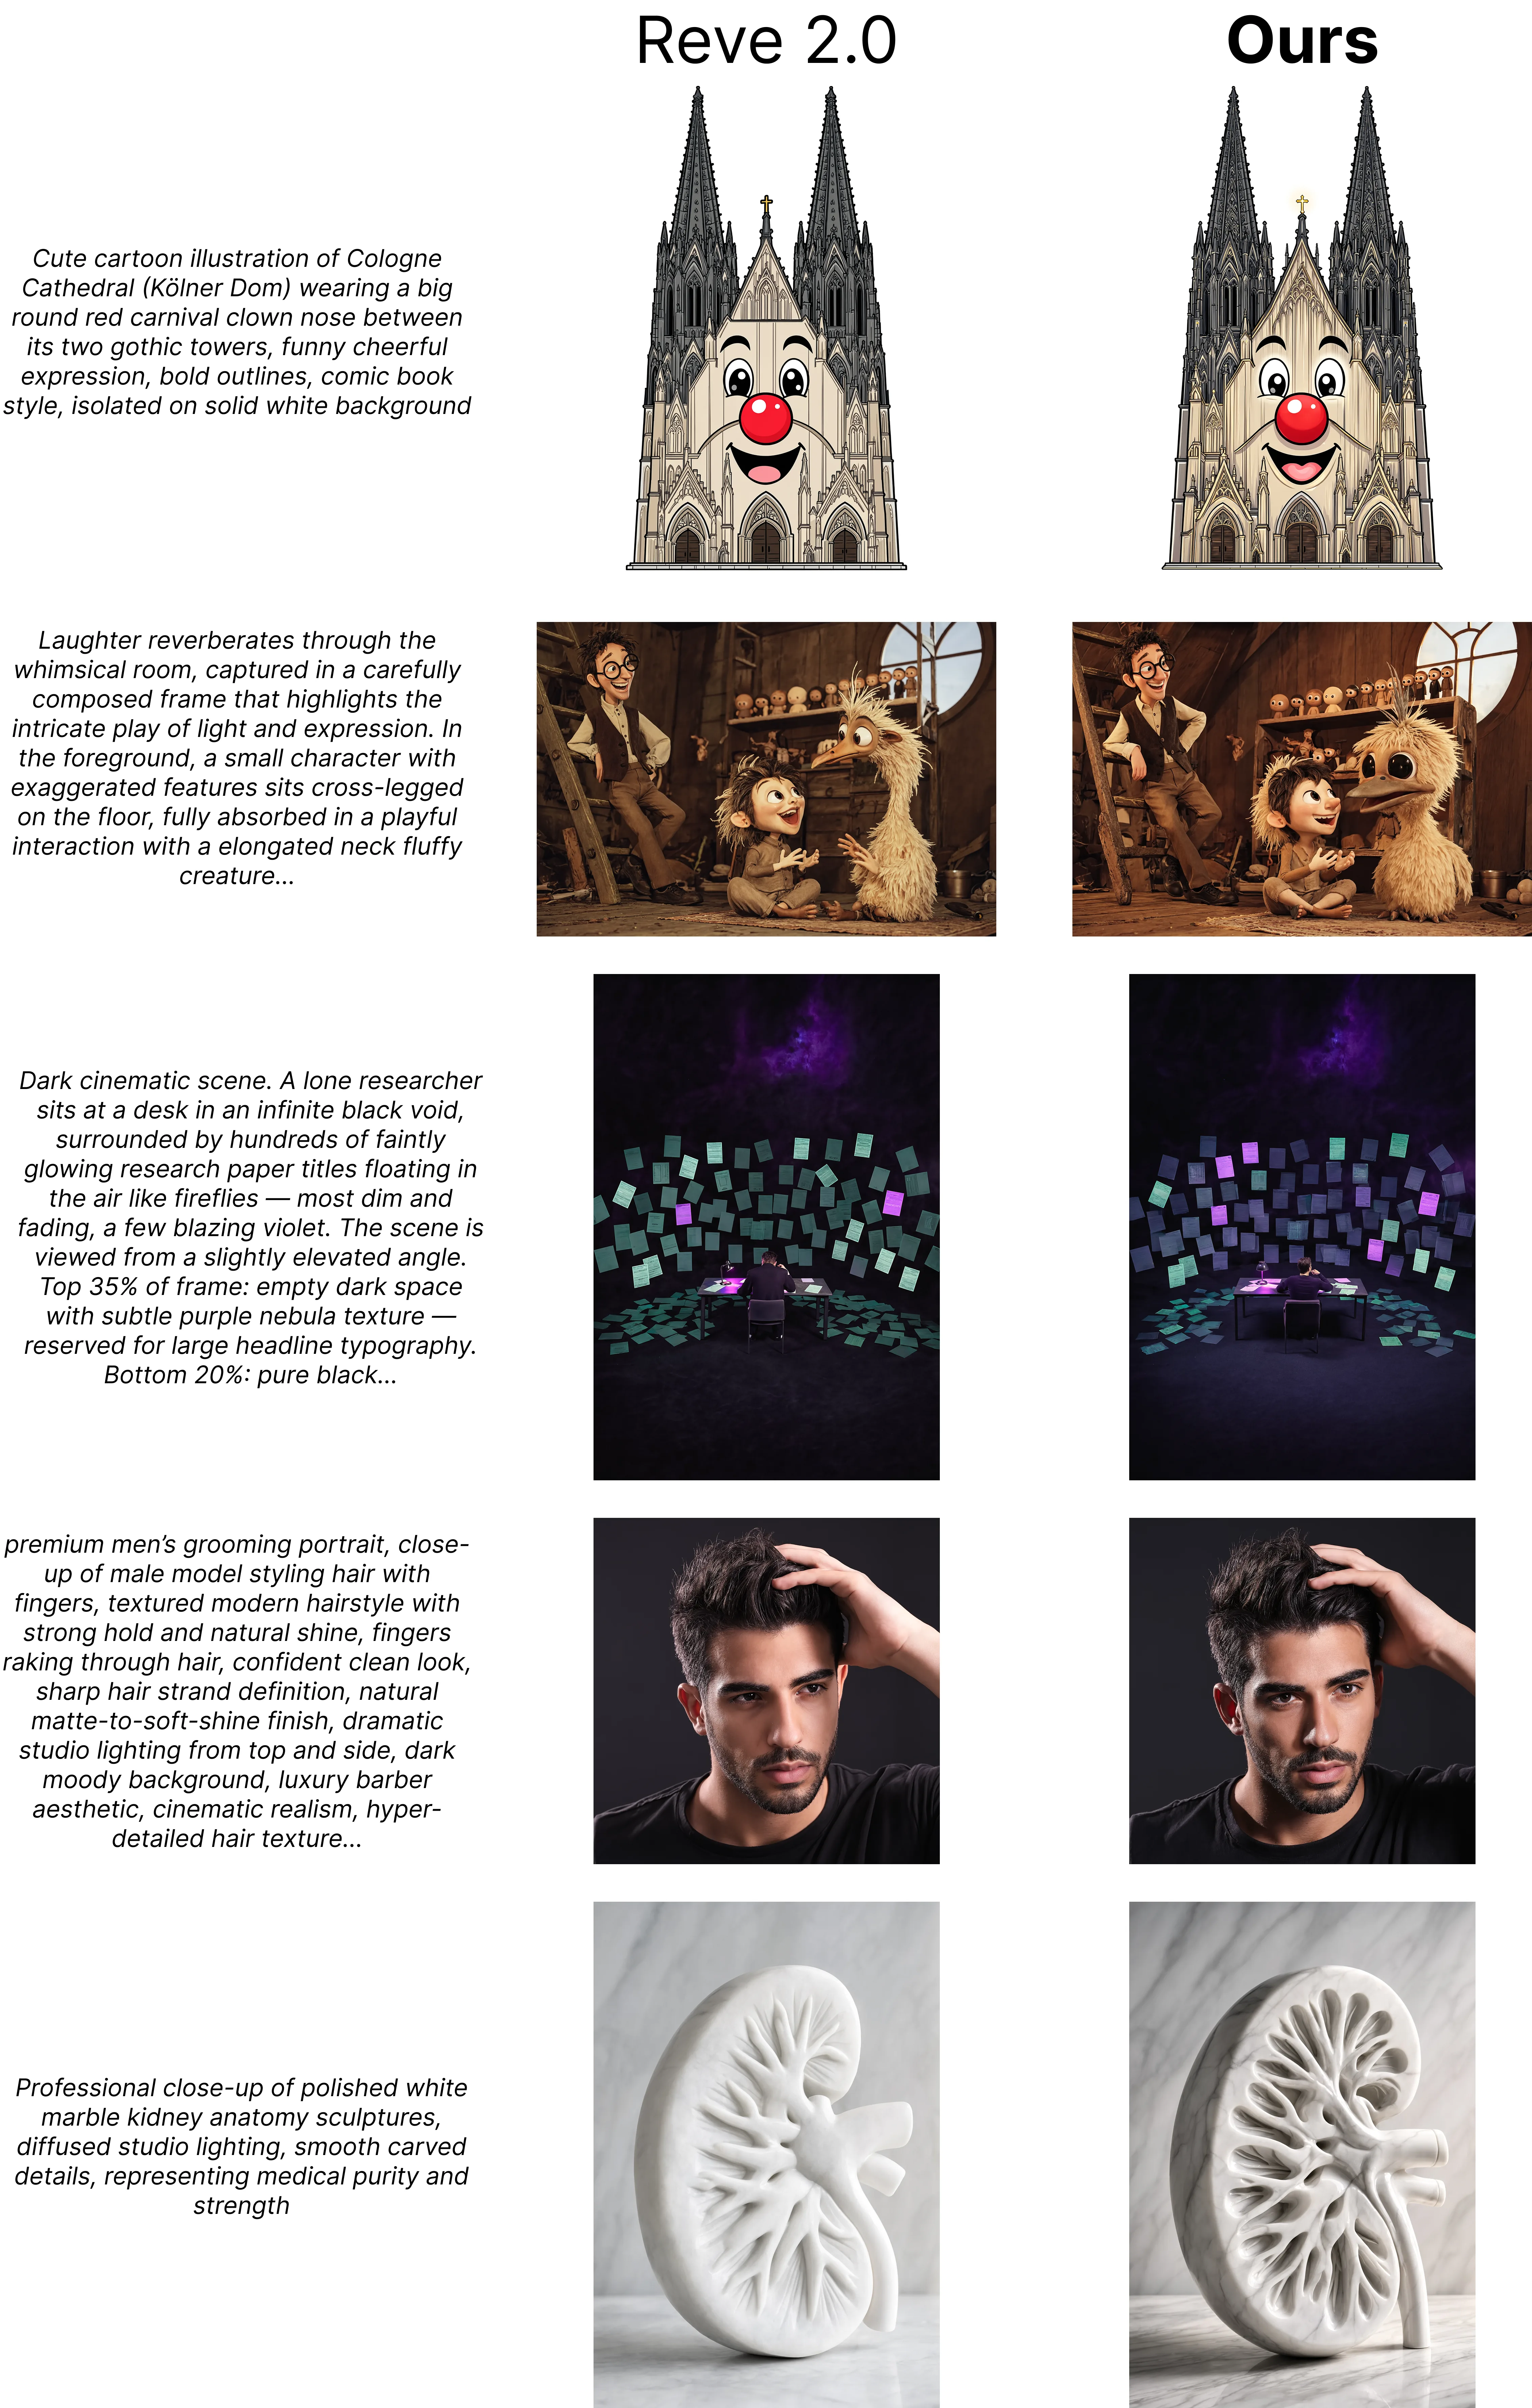
主要评估指标采用胜率(Win Rate),即在相同提示词下,LeSAMP 生成的图像被偏好模型、VLM 评判器或人类受试者选为更优结果的比例。结果显示,在 Flux.1[dev] 上,LeSAMP 相对于固定参数基线的偏好模型胜率达到 68.12%,VLM 胜率达到 73.37%。Stable Diffusion 3.5 上的结果略低但趋势一致。这表明动态调度策略确实能够适配不同模型的特性。
用户研究部分招募了 120 名参与者,每人评估 20 对来自同一提示词但使用不同策略生成的图像对。结果显示 LeSAMP 在整体偏好上取得 59.46% 的胜率,虽然绝对数值低于自动指标,但考虑到人类主观判断的高方差和样本规模限制,这一胜率在统计上显著。
消融实验进一步揭示了各组件的贡献。完全不使用 VLM 奖励仅依赖偏好模型时,胜率下降约 5 个百分点;固定时间步参数(即仅根据提示词条件调整但不随时间变化)时,性能损失更为明显,证实了时变调度本身的必要性。
讨论与可借鉴点
LeSAMP 最有价值的启发在于开辟了一条不修改模型权重即可提升生成质量的路径。传统观点认为推理时的参数调整只是"调味",真正的质量瓶颈在模型本身。LeSAMP 用实验数据证明,对于复杂场景和多样化需求,采样参数的动态优化可以带来显著且可感知的收益。
局限性方面,首先是额外推理开销——大语言模型需要处理每个提示词并输出完整的参数调度,这比直接调用扩散模型多出若干秒的延迟。其次,论文仅探索了 CFG 尺度和负向提示词两类参数,更复杂的参数(如噪声调度曲线、步数预算分配)尚未纳入动作空间。此外,奖励信号的组合策略、超参数档位的粒度选择等工程细节也存在进一步优化的空间。
从方法论角度看,将推理时决策建模为[[强化学习]]问题、用[[视觉语言模型]]作为可扩展的评估替代,这一范式具有跨任务的迁移价值。在其他需要为每个输入实例动态配置超参数的场景(如图像修复、视频生成参数调度)中,类似的框架思路值得借鉴。
摘要
文本到图像扩散模型暴露了许多推理时的采样参数,包括提示词、负向提示词、无分类器引导尺度以及噪声调度。这些参数通常由人工选择一次,然后在不同的提示词和去噪时间步中保持固定,然而不同的提示词和生成的不同阶段可能会受益于不同的参数值。我们提出了 LeSAMP,一个用于学习以提示词为条件、随时间步变化的采样参数的框架。我们将参数选择建模为一个强化学习问题:给定用户提示词,训练一个大语言模型来输出所选采样参数的调度方案。我们使用来自人类偏好模型和 VLM-as-a-judge 的奖励来优化模型。我们在 Flux.1 [dev] 和 Stable Diffusion 3.5 上评估了我们的模型,发现与基线相比,LeSAMP 在人类偏好分数下最高取得了 68.12% 的胜率,在 VLM-as-a-judge 下最高取得了 73.37% 的胜率。这些收益在用户研究中得到了验证,在该研究中我们相对此前基线取得了最高 59.46% 的胜率。我们的结果表明,学习得到的采样参数策略为改进扩散模型输出的现有后训练方法提供了一种互补的途径。
Abstract
Text-to-image diffusion models expose many inference-time sampling parameters, including prompts, negative prompts, classifier-free guidance scales, and noise schedules. These parameters are typically manually chosen once and then held fixed across prompts and denoising timesteps, even though different prompts and stages of generation can benefit from different parameter values. We introduce LeSAMP, a framework for learning prompt-conditioned, timestep-varying sampling parameters. We formulate parameter selection as a reinforcement learning problem: Given a user prompt, a large language model is trained to emit schedules for the chosen sampling parameters. We optimize our model using rewards from human preference models and VLM-as-a-judge. We evaluate our model on Flux.1 [dev] and Stable Diffusion 3.5, and find that compared to baselines, LeSAMP has a win rate of up to 68.12% using human preference scores and 73.37% using VLM-as-a-judge. These gains are validated in a user study where we achieve win rates of up to 59.46% over previous baselines. Our results suggest that learned sampling-parameter policies provide a complementary approach to existing post-training methods for improving diffusion model outputs.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。