
基于Hadamard过参数化的稀疏高斯混合模型Q函数在线强化学习
Sparse Gaussian-Mixture-Model Q-Functions via Hadamard Overparametrization for Online Reinforcement Learning
📝 TLDR
在线强化学习面临流式非平稳数据与Q函数参数空间几何结构的协调难题,且深度方法参数冗余、可解释性差。本文提出基于Hadamard过参数化的稀疏高斯混合Q函数(S-GMM-QFs),从大初始分量池中自适应识别有意义组件,由光滑正则化驱动稀疏化。在Cartesian-product黎曼流形上做在线梯度下降优化,并结合经验回放处理分布失配。实验表明该方法以显著更少的参数匹配或超越深度RL方法,每步转移提升更快,并在低参数场景下保持强泛化能力。
🧭 速览
在线off-policy RL需同时应对流式非平稳数据、参数空间几何结构与分布失配,而深度Q网络参数冗余且难以解释。
用Hadamard过参数化构建稀疏GMM Q函数,在黎曼流形上做在线梯度下降,配合光滑正则化与经验回放。
以远少于深度RL的参数在基准任务上匹配或超越其性能,每步提升更快,低参数下泛化仍稳定。
将几何可解释性与参数高效性统一到在线RL框架,为稀疏可解释RL提供基于黎曼优化的可行路径。
🆚 方法对比
S-GMM-QF (稀疏高斯混合Q函数)
- Hadamard过参数化从大池中自适应筛选组件
- 在Riemannian流形上优化,几何可解释性强
- 参数效率高,少量参数即可匹配深度RL
- 在低参数下泛化能力强,优于稀疏化深度RL
- 在线非策略框架,适配流式非平稳数据
cons
本文未提出多个独立方法进行对比
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 34 张)
展开查看 34 张图
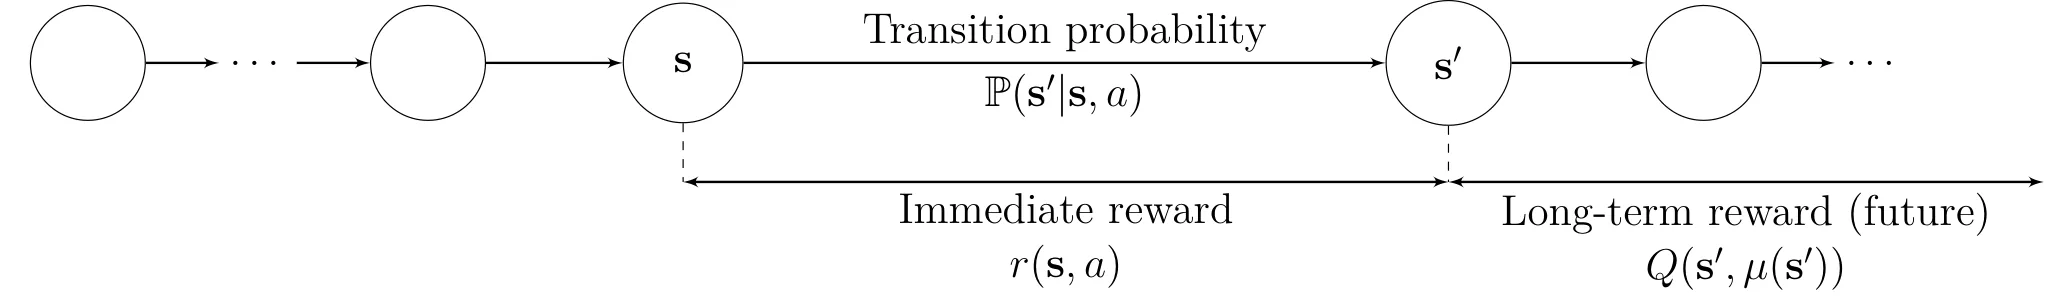
TL;DR
本文提出一种基于稀疏高斯混合模型 Q 函数(S-GMM-QFs)的在线离策略强化学习框架,通过 Hadamard 过参数化将稀疏化问题转化为光滑的正则化优化,使其能在黎曼流形上进行自适应学习。实验表明,该方法以少一到两个数量级的参数量在 Lunar Lander 和 Flappy Bird 任务上匹配或超越深度强化学习方法,且在低参数区间保持强泛化能力,稀疏后的每个高斯分量能直接解读其几何意义。
研究背景与动机
在线强化学习的一个核心矛盾在于:智能体需要从流式、非平稳的数据中持续学习,而其 Q 函数的参数空间本身具有复杂的几何结构——尤其是当使用高斯混合模型来建模 Q 函数时,协方差矩阵必须保持在正定流形上。更棘手的是,离策略学习依赖经验回放来缓解分布失配,但这又引入了额外的复杂性。传统上,研究者要么忽略参数空间的几何约束做简单梯度下降,要么借助深度神经网络强大的表达能力但牺牲了可解释性和参数效率。
深度 Q 网络及其变体虽然在许多任务上取得了成功,但其参数量庞大、在在线场景下更新成本高、决策过程难以解释。更重要的是,近年来出现的稀疏深度强化学习方法——如剪枝、SET、RigL 等——虽然能压缩网络规模,但稀疏化后的连接模式与状态-动作空间的几何结构之间没有显式关联,稀疏解的位置完全取决于训练动态而非领域知识。这催生了一个关键问题:能否设计一种 Q 函数表示,使其参数本身就编码了几何意义,同时能自适应地从大候选池中筛选出有意义的分量?
本文的切入点正是回答这个问题:利用高斯混合模型的概率解释性,结合过参数化技术实现可微的稀疏化,并在黎曼流形上执行优化,使得稀疏性的涌现自然来源于几何驱动而非后处理。
方法
该方法的核心是将稀疏高斯混合模型 Q 函数表示建立在笛卡尔积黎曼流形上,并通过 Hadamard 过参数化实现光滑稀疏化。
首先,对于离散动作空间 ,Q 函数被建模为 个高斯分量的加权和:
其中 是第 个分量的均值, 是其协方差矩阵, 是动作相关的权重。整个参数空间
构成一个笛卡尔积黎曼流形:权重和均值分量使用欧氏度量,协方差分量使用仿射不变黎曼度量。
稀疏化的关键在于避免传统 范数非光滑导致的不可微问题。本文引入 Hadamard 过参数化,将每个权重分解为 个辅助因子的乘积:
然后以所有因子矩阵的 Frobenius 范数平方和作为光滑正则化项:
这一设计的巧妙之处在于:当所有因子都较小时, 近似于隐式 准范数驱动稀疏化;而在端到端梯度下降中,这种稀疏化完全可微,不会遇到 范数在零处不可微的困境。过参数化还带来另一个好处:模型从一个大的初始候选池出发,自适应地淘汰无意义的分量,而非事先固定 值。
策略迭代的在线学习通过最小化 Bellman 残差实现。对于当前策略 和从经验回放缓冲中采样的批量数据 ,目标函数为:
梯度计算考虑了 Hadamard 结构的链式法则。例如,对因子 的梯度涉及其他因子的乘积除以该项:
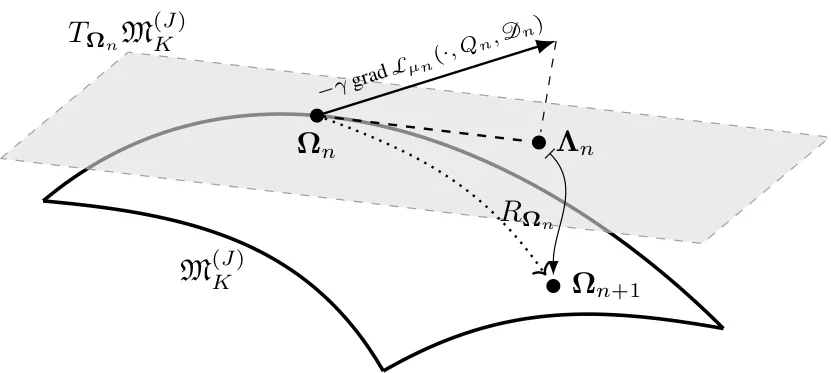
对均值和协方差的梯度则需要在仿射不变度量下推导,最终形成 RAdam 的黎曼自适应矩估计框架:在切空间累积梯度的一阶和二阶矩,通过平行迁移将历史方向对齐到当前切空间,再通过回缩操作(协方差分量使用矩阵指数回缩)保证参数始终位于正定流形上。
实验与结果
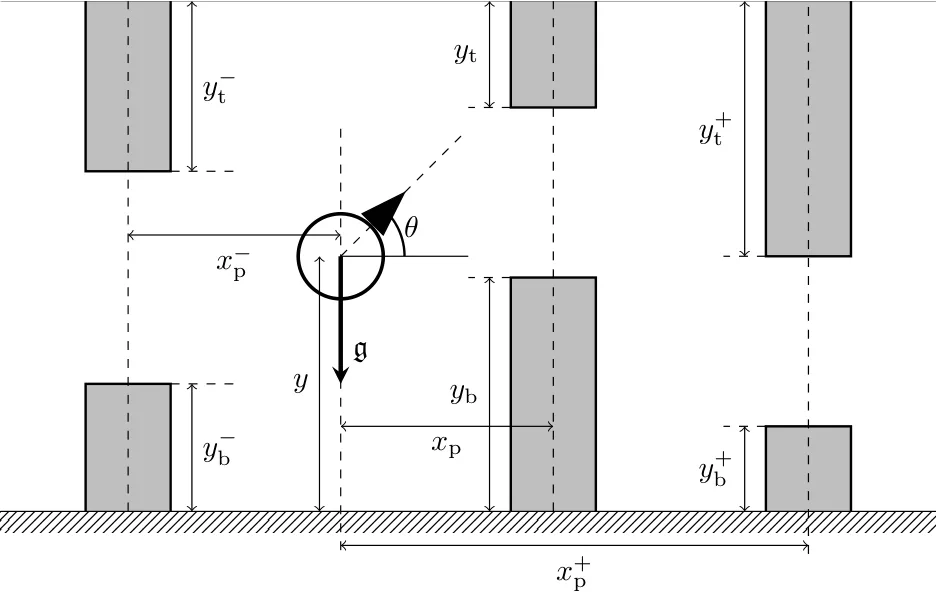
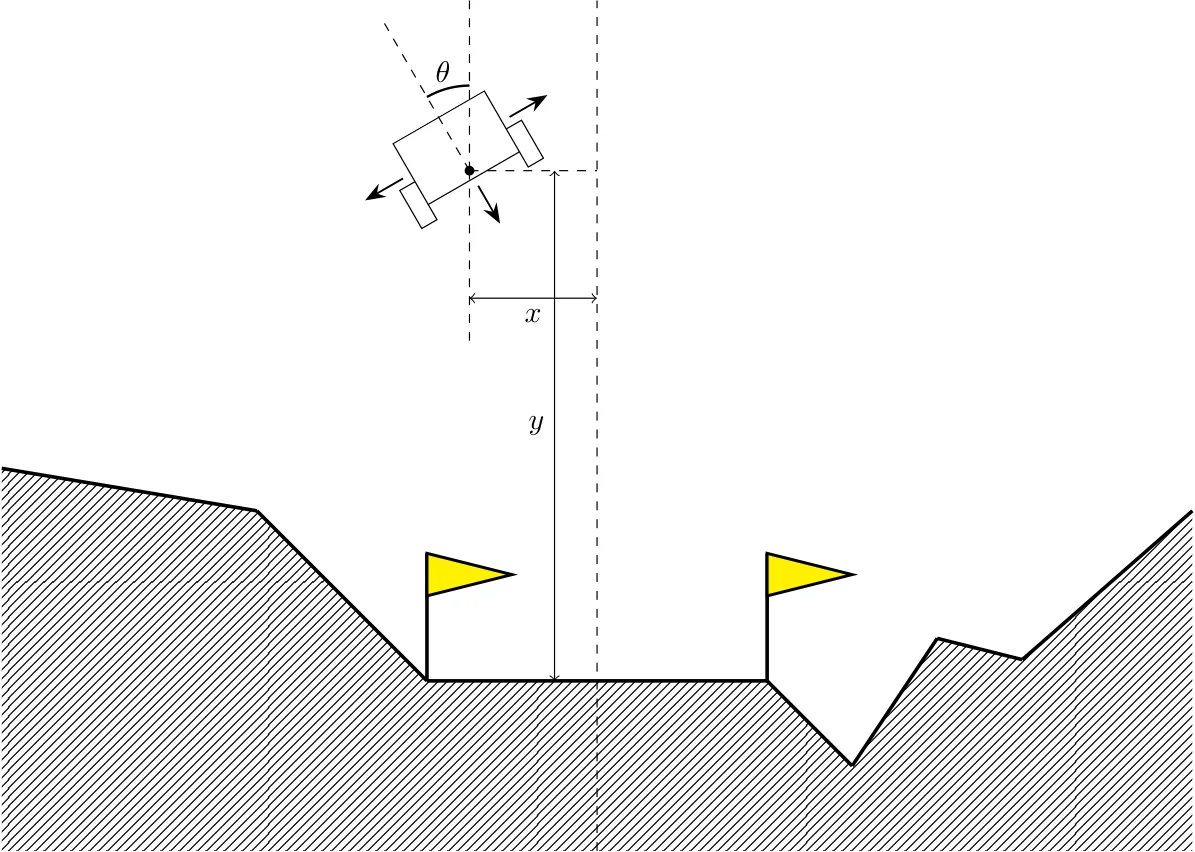
实验在两个经典基准任务上进行:Lunar Lander(8 维状态、4 个离散动作、密集奖励)和 Flappy Bird(12 维状态、2 个动作、延迟奖励和严格时序约束)。基线包括 DQN/DDQN + PER、PPO,以及多种稀疏深度强化学习方法(Pruning、SET、RigL)。
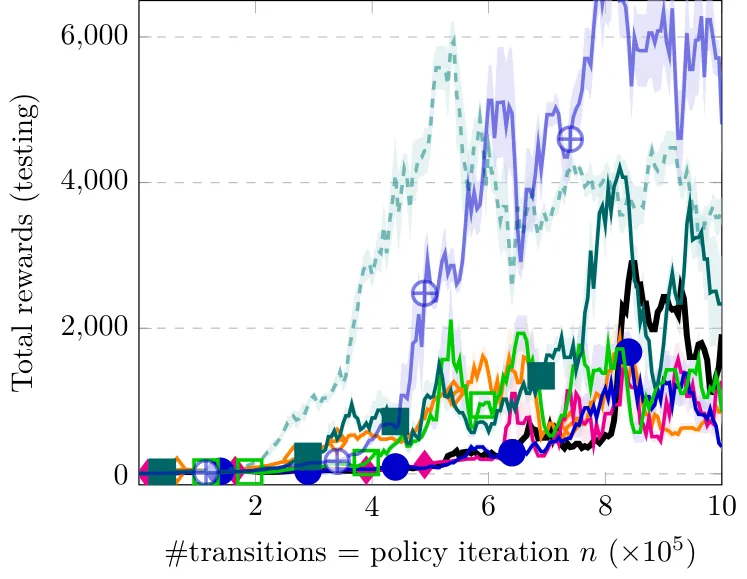
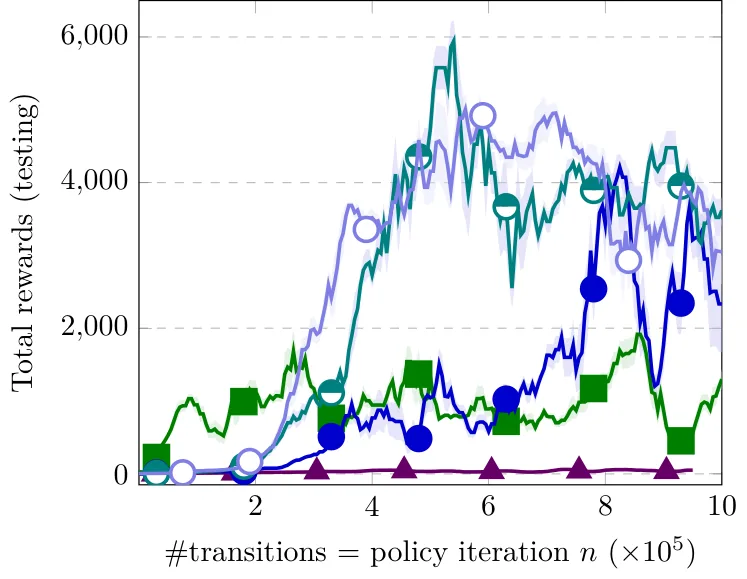
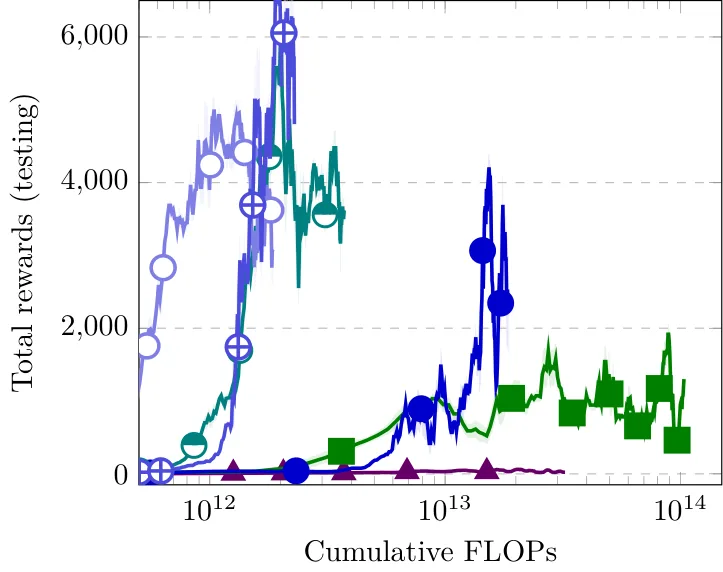
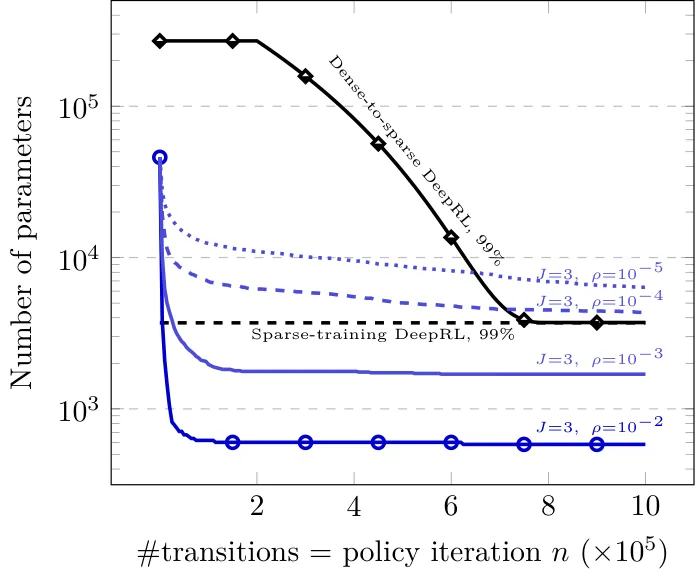
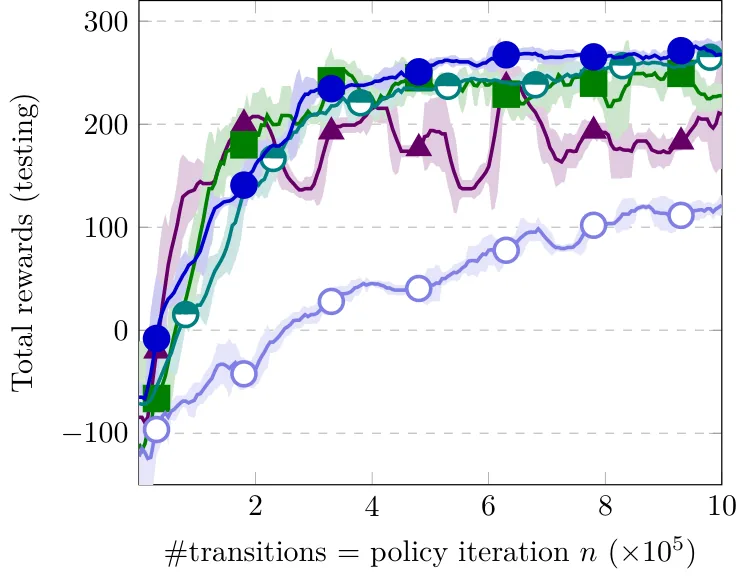
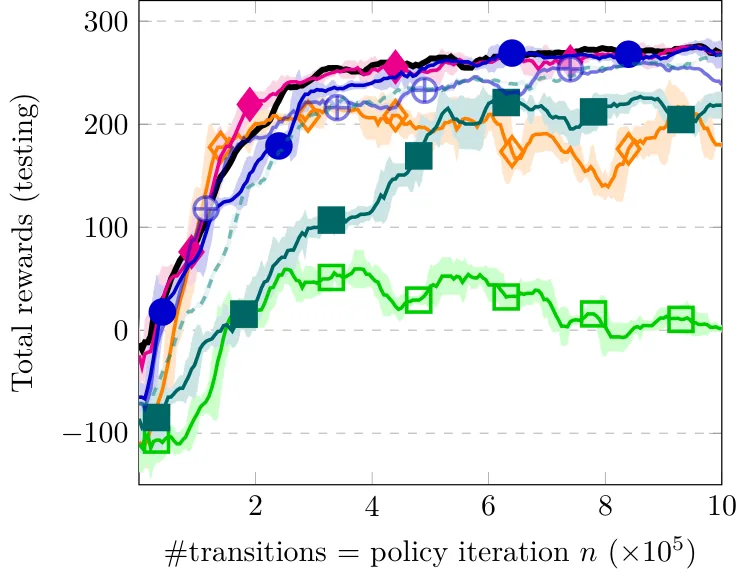
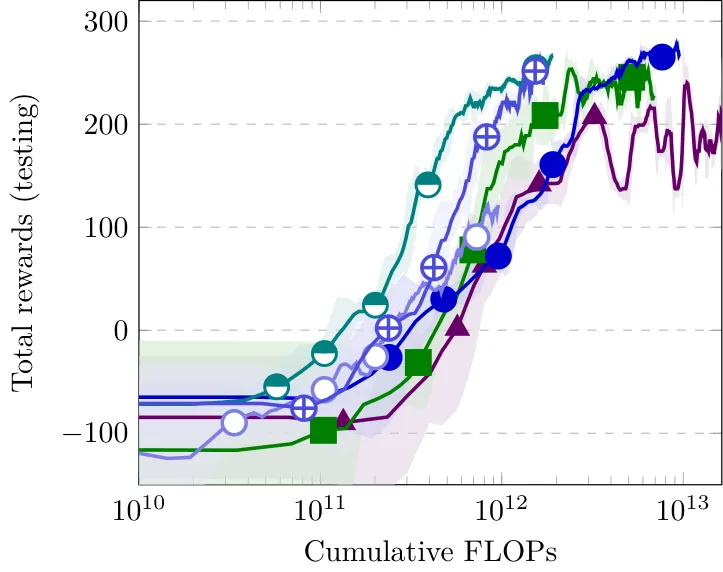
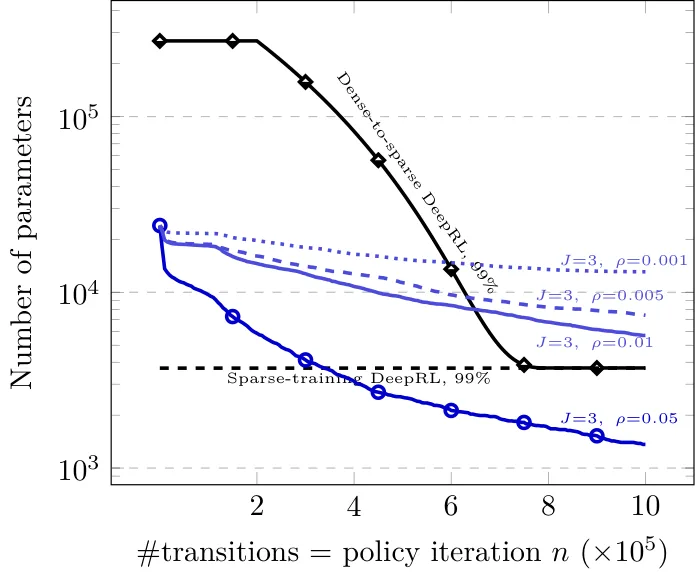
实验结果揭示了几个重要现象。首先,在数据效率上,S-GMM-QFs 在相同转移数下提升更快——在许多情况下, 的密集模型尚未收敛时,稀疏化后的模型已能达到更优性能。这说明正则化驱动的稀疏化不仅压缩了参数,还起到了隐式正则化的作用,加速了学习。其次,在计算效率上,Lunar Lander 和 Flappy Bird 上的 FLOPs 分析表明,S-GMM-QFs 仅需密集 模型一至两个数量级的浮点运算即可达到同等累计奖励。
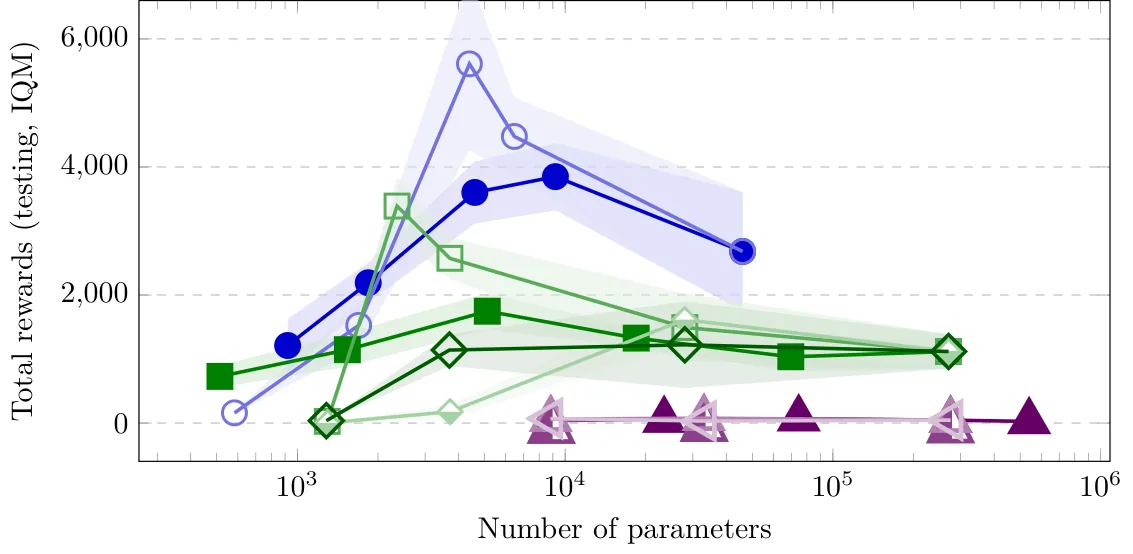
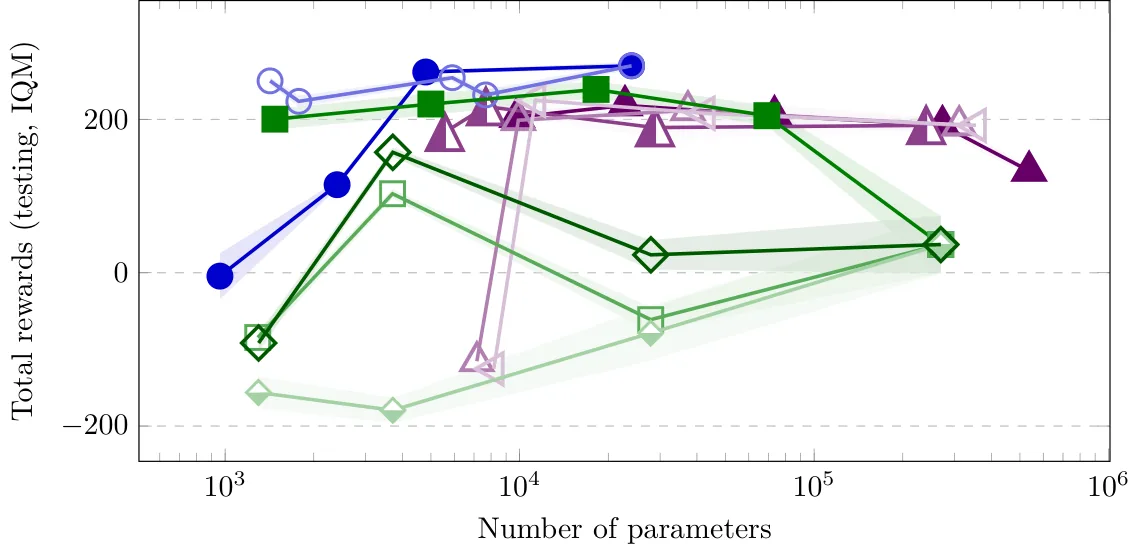
最具说服力的结果是参数-性能曲线。稀疏深度强化学习方法在低参数区间( 到 量级)显著退化甚至完全失效,而 S-GMM-QFs 在这一区间仍能保持接近最优的性能。这种差异的根本原因在于:深度方法的稀疏化是后处理操作,稀疏结构与任务几何没有关联;而本文的稀疏化源于参数本身的几何解释性——每个高斯分量的均值和协方差显式编码了其在状态空间中的"管辖范围",因此即使大幅稀疏化也能保留核心决策结构。
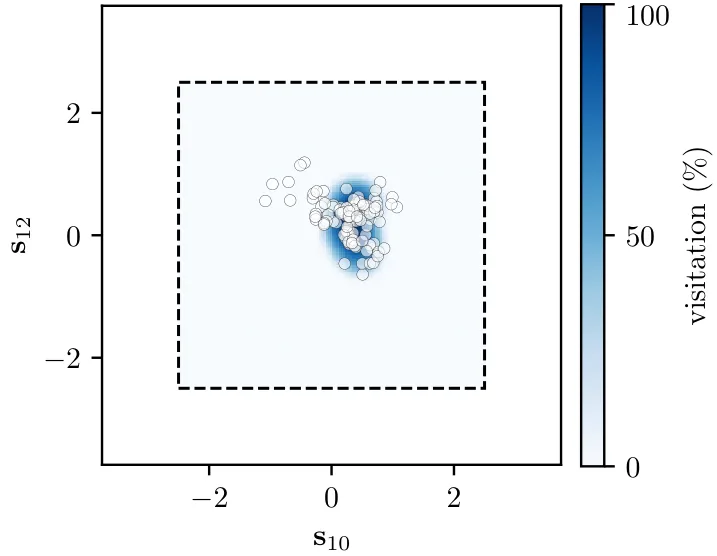
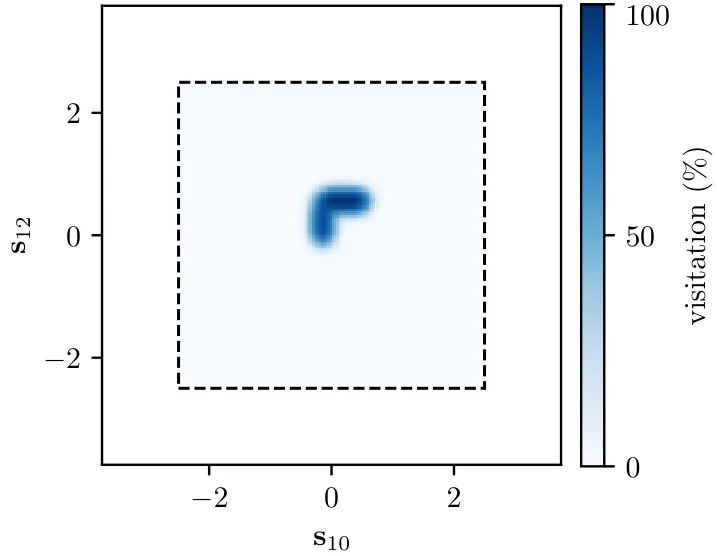
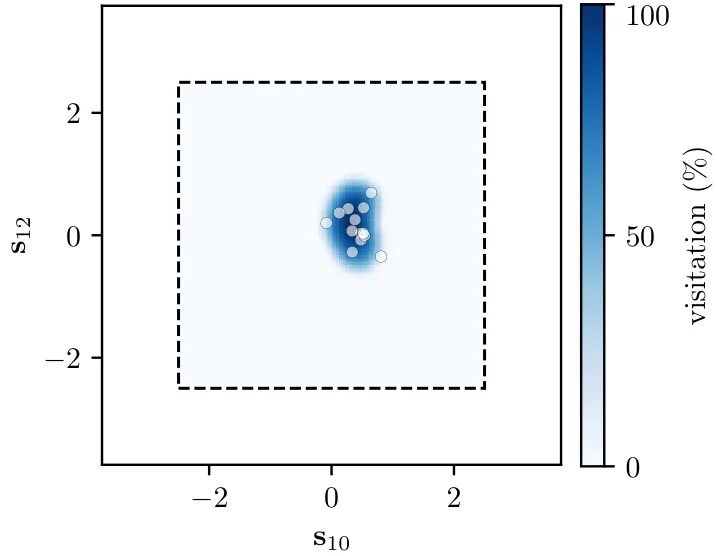
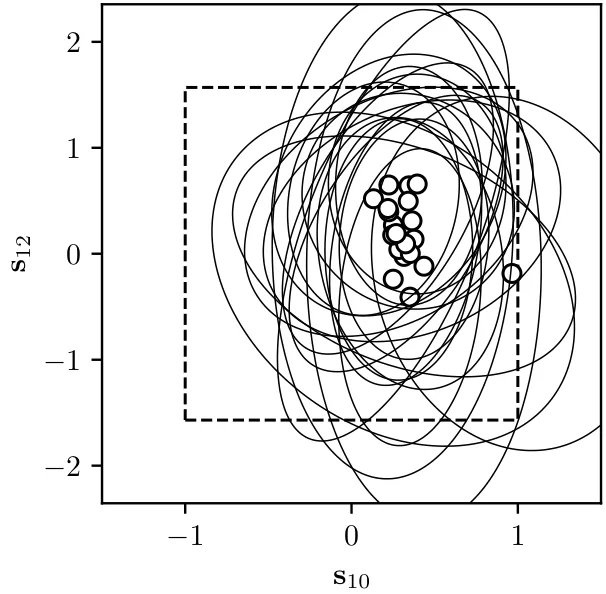
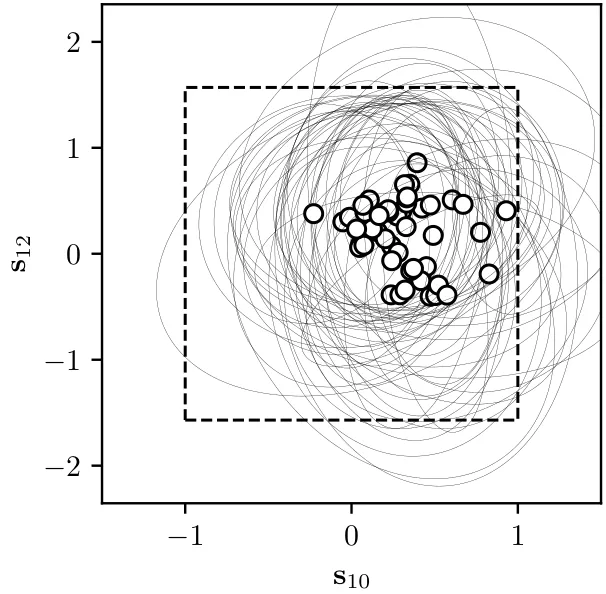
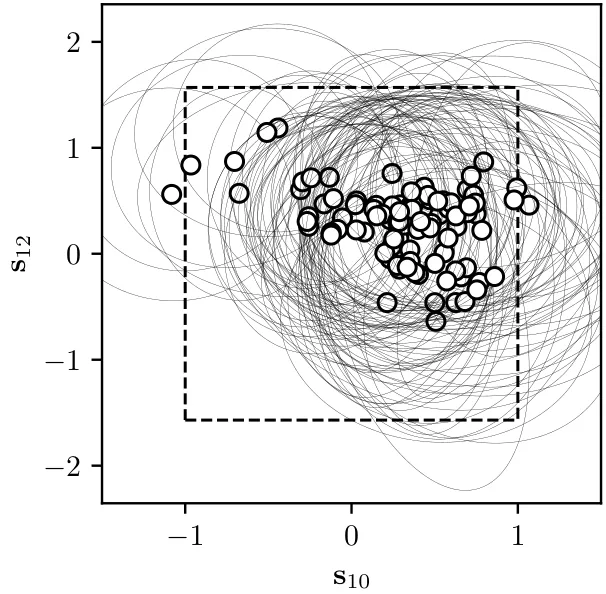
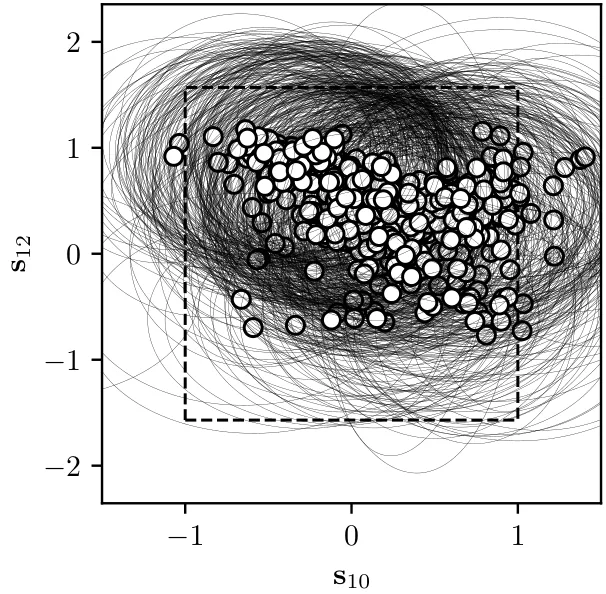
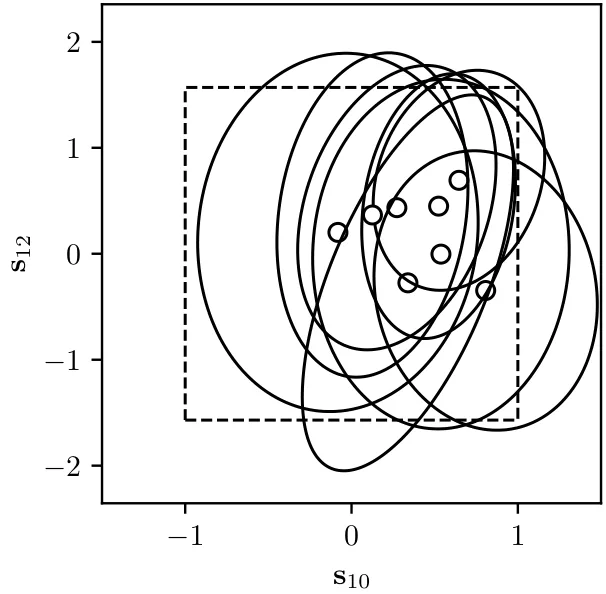
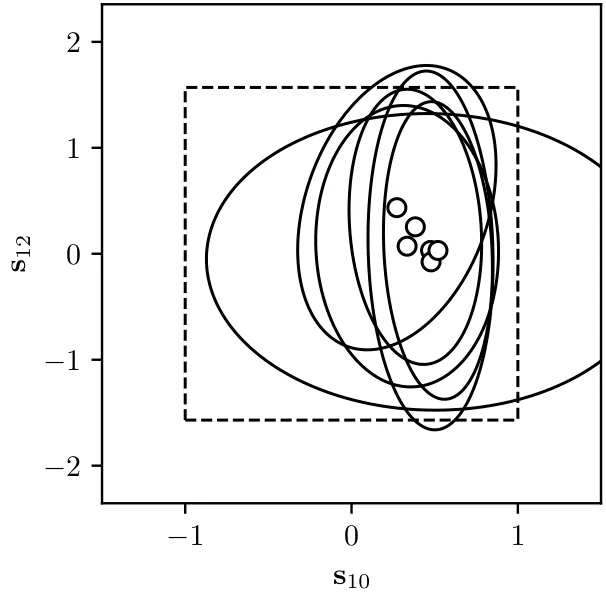
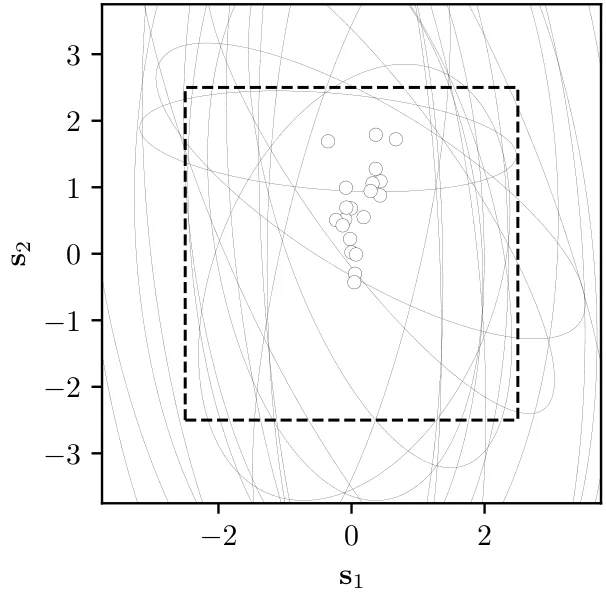
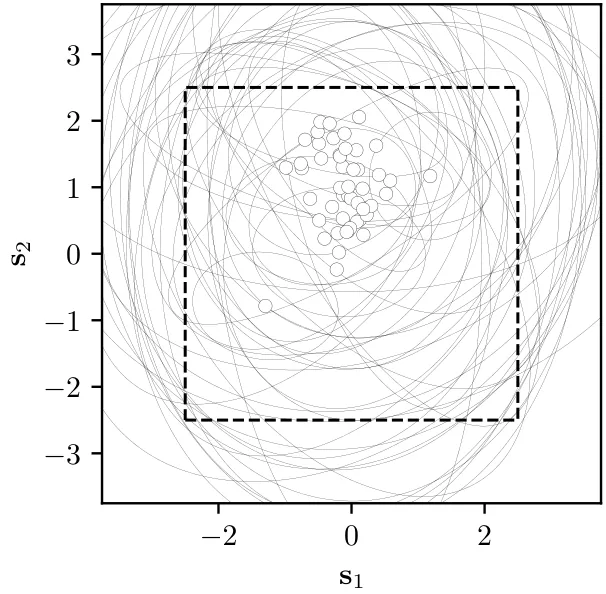
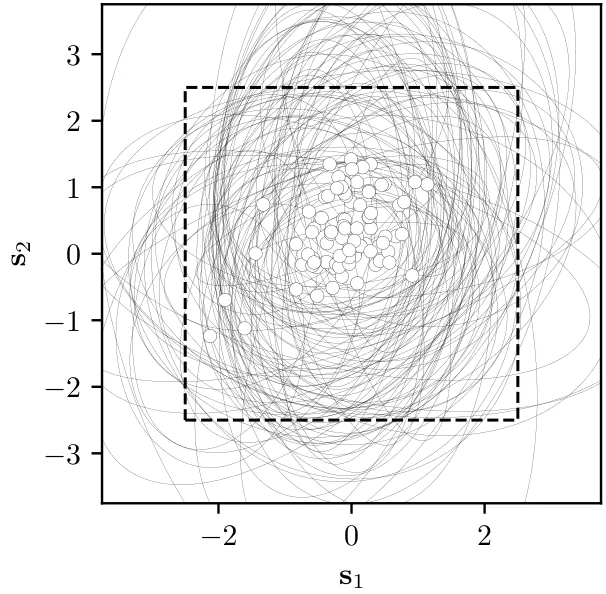
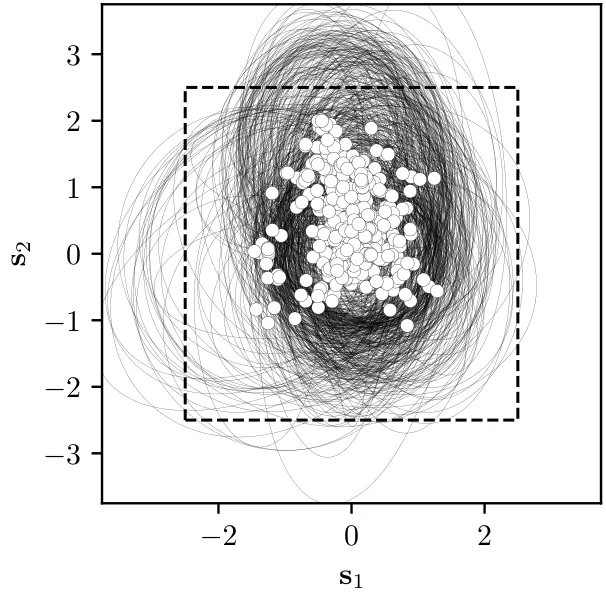
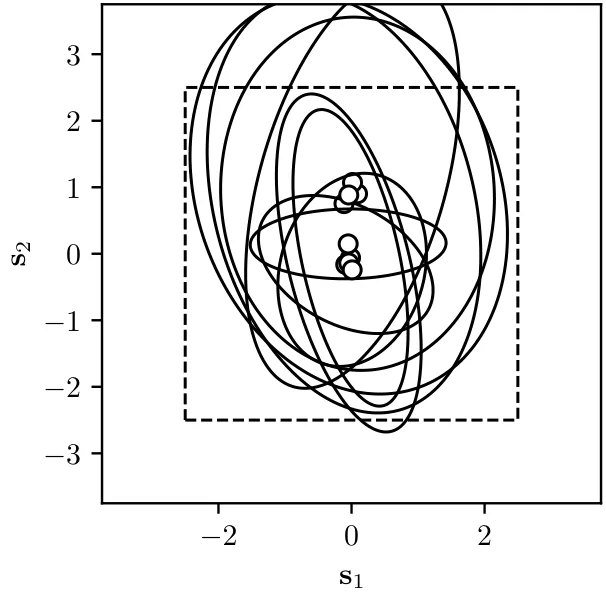
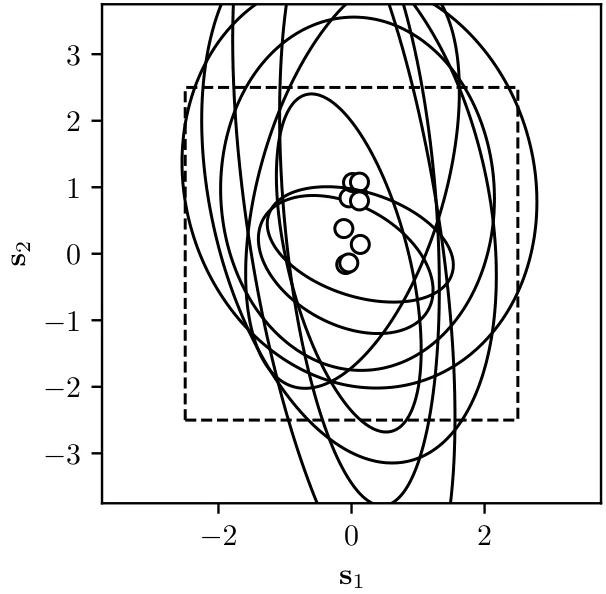
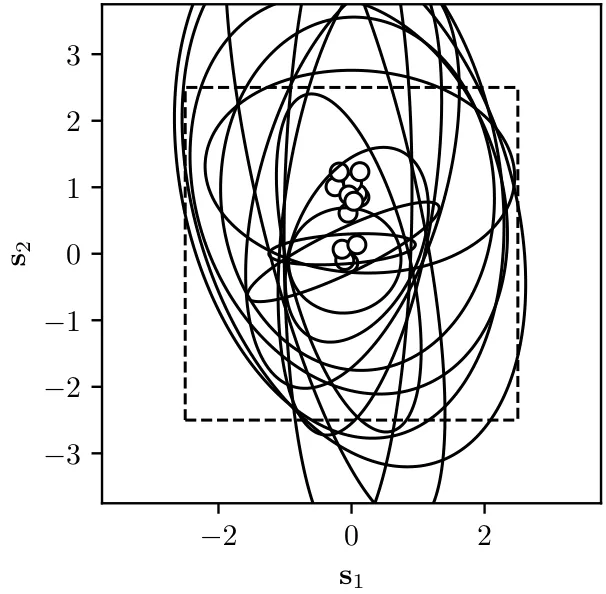
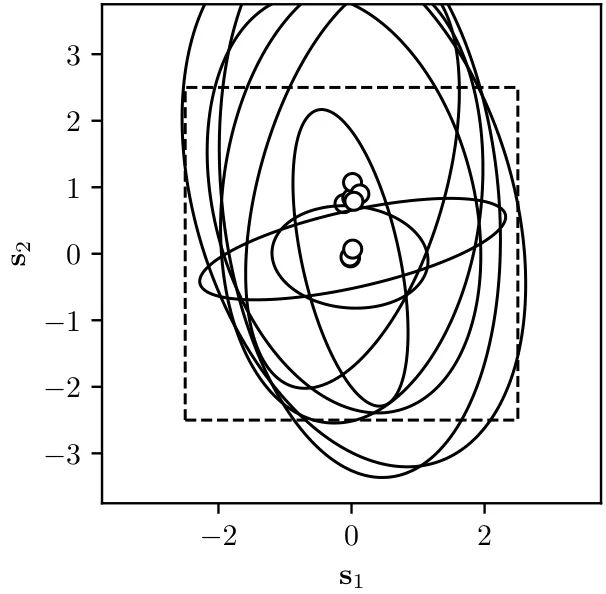
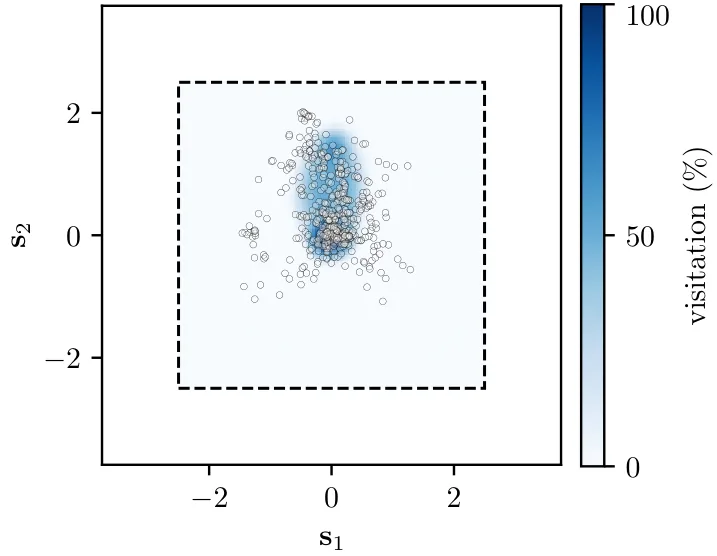
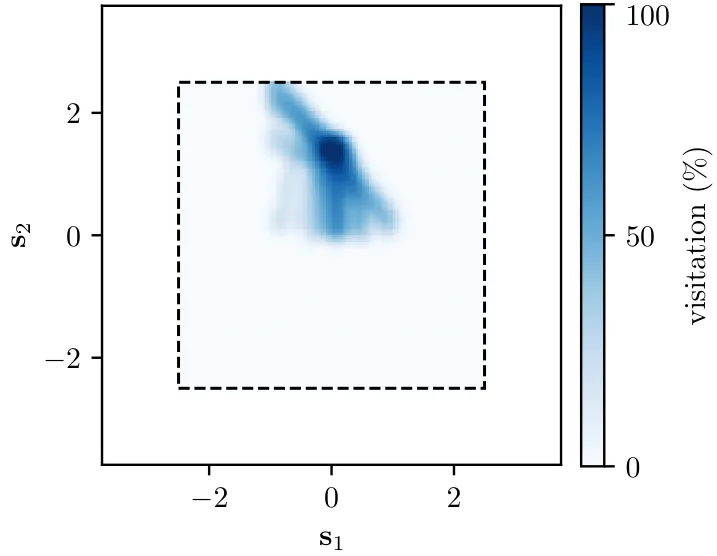
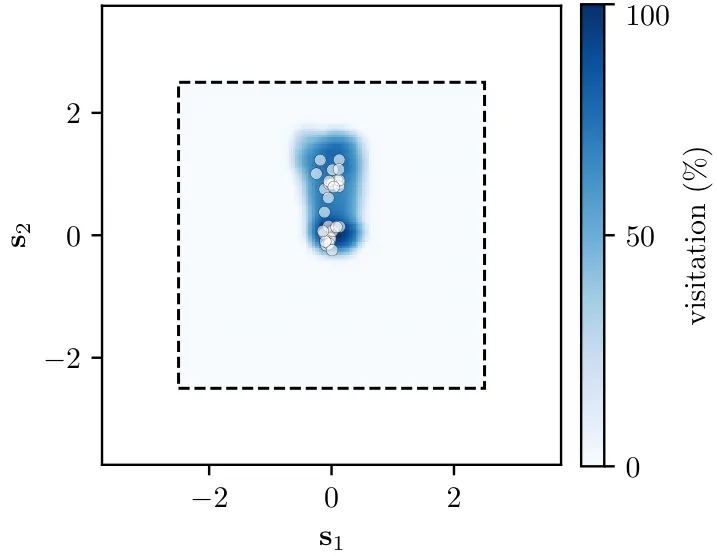
可解释性的可视化进一步印证了这一点。稀疏后每个动作仅激活 6 到 14 个高斯分量,分量中心与策略访问热图高度对齐,无需任何后验归因方法就能直观理解每个分量负责的区域。
讨论与可借鉴点
尽管 S-GMM-QFs 在参数效率和可解释性上展现了显著优势,但其局限性也值得重视。最根本的瓶颈在于协方差矩阵的求逆和黎曼回缩操作均为 复杂度,这使得当前方法难以扩展到高维输入场景(如像素级观察或激光雷达数据)。作者承认需要借助在线编码器来解决这一问题,但目前尚未给出具体方案。此外,当前方法仅支持离散动作空间,连续动作的扩展需要在 actor-critic 框架下重新设计,这仍是进行中的工作。
从研究方法论的角度,本文提供了一个值得借鉴的范式:通过过参数化将稀疏化目标转化为光滑正则化,再借助黎曼优化保证参数始终位于几何有效的空间。这种"几何优先"的设计思路不仅适用于高斯混合模型,还可能推广到其他具有结构化参数空间的函数近似器。实验中关于缓冲策略的发现也颇具启发:在延迟奖励场景下(如 Flappy Bird),多样性比 TD 误差优先级更重要,聚类缓冲配合稀疏高斯混合模型取得了最优效果,这提示我们在线学习中的数据采样策略需要与函数近似器的特性协同设计。
摘要
本文基于稀疏高斯混合模型Q函数(S-GMM-QFs),开发了一种用于强化学习(RL)的在线、离策略(off-policy)策略迭代框架。该框架通过经验回放处理分布失配问题,同时使流式、非平稳数据与参数空间的黎曼结构相协调。S-GMM-QFs通过Hadamard过参数化引入,借助平滑正则化实现可解释的稀疏化,从而便于基于黎曼的优化。过参数化使该框架能够从大量初始候选中自适应地识别有意义的分量,产生可解释性自然源于几何结构的稀疏模型:每个分量的参数(均值和协方差)显式地编码了其在环境状态-动作空间中的几何作用。这些几何作用通过在(笛卡尔积)黎曼流形上的平滑目标进行在线梯度下降来学习。数值测试表明,S-GMM-QFs在使用显著更少参数的同时,其性能可匹配或超越深度强化学习方法,并在每个观察到的转移上实现更快的改进。值得注意的是,参数效率和可解释性的结合,使S-GMM-QFs在低参数场景下仍能保持强大的泛化能力,而稀疏化深度强化学习方法在这些场景下性能会下降。
Abstract
This paper develops an online, off-policy policy-iteration framework for reinforcement learning (RL), based on sparse Gaussian-mixture-model Q-functions (S-GMM-QFs). The framework reconciles streaming, non-stationary data with the Riemannian structure of the parameter space while handling distributional mismatch through experience replay. S-GMM-QFs are introduced via Hadamard overparametrization, enabling interpretable sparsification through smooth regularization that facilitates Riemannian-based optimization. Overparametrization allows the framework to adaptively identify meaningful components from a large initial pool, yielding sparse models where interpretability emerges naturally from geometry: each component's parameters (means and covariances) explicitly encode its geometric role in the ambient state-action space. These geometric roles are learned through online gradient descent on a smooth objective over a (Cartesian-product) Riemannian manifold. Numerical tests demonstrate that S-GMM-QFs match or exceed deep RL methods while using substantially fewer parameters and achieving faster improvement per observed transition. Notably, parameter efficiency and interpretability combine to maintain strong generalization in low-parameter regimes where sparsified deep RL approaches degrade.
论文详细总结(自动生成)
论文总结:基于 Hadamard 过参数化的稀疏高斯混合模型 Q 函数在线强化学习
1. 核心问题与研究动机
- 在线免策略 RL 的三大挑战:流式非平稳数据的时序性、参数空间的黎曼几何结构、经验回放带来的分布失配。
- 深度 Q 网络(DQN/DDQN/PPO)的局限:
- 参数体量庞大,在线更新成本高;
- 频繁重训练与硬件资源需求与在线轻量化需求相矛盾;
- 缺乏可解释性,难以分析决策背后的特征;
- 稀疏化方法(剪枝、SET、RigL)虽能缩减规模,但稀疏后的连接与状态-动作空间的几何结构无显式关联。
- 本文目标:在保持参数高效的同时,使 Q 函数本身具备几何可解释性,并自适应地从大候选池中识别有意义的分量。
2. 方法论
2.1 高斯混合模型 Q 函数(GMM-QF)
对离散动作 ,固定 个高斯分量:
其中 ,,。参数空间
为笛卡尔积黎曼流形(各分量使用欧氏度量,协方差分量使用仿射不变度量)。
2.2 Hadamard 过参数化与稀疏化
每个权重被分解为 个辅助因子:
其中 。以 Frobenius 范数平方和作为光滑替代正则化:
对应隐式 拟范数稀疏化,且全程可微。整体参数空间扩张为
2.3 在线策略迭代(Bellman 残差)
对当前策略 ,在经验回放缓冲 上采样小批量 ,最小化:
每收到一个新转移 ,执行一次策略评估(梯度下降)与策略改进(贪心更新 )。
2.4 黎曼优化(RAdam 扩展)
- 切空间梯度(命题 2):
- ;
- ;
- 仿射不变度量下 ,。
- RAdam 更新:在切空间累积动量 、方差 ,并通过平行迁移 对齐到当前切空间,再用回缩 保证 ,其中协方差分量使用矩阵指数回缩。
2.5 经验回放缓冲策略
- 频率衰减(Fair)缓冲:当某转移采样次数超过阈值 时,按 衰减其优先级,避免 IS 加权对黎曼回缩的破坏;
- 在线聚类(Clustering)缓冲:维护 个聚类中心,采用指数滑动平均更新;每簇配额 ,簇内仍以 TD 误差优先级采样;
- 同时支持均匀采样、PER、Rank PER、EDER 作为对照。
3. 实验设计
- 基准任务:
- Lunar Lander:8 维状态,4 个动作(无动作/左引擎/主引擎/右引擎),密集奖励;
- Flappy Bird:12 维状态,2 个动作,延迟奖励、严格时序约束。
- 基线方法:
- 深度 RL:DQN/DDQN + PER、PPO;
- 稀疏深度 RL 变体:Pruning(dense-to-sparse)、SET(cosine 衰减)、RigL(梯度驱动 regrowth);
- 自身对比:dense GMM-QF()与 S-GMM-QF( 在 Lunar; 在 Flappy Bird);
- 评价指标:累计测试奖励、参数量、累积 FLOPs。
4. 算力与资源
- 论文未明确披露所用 GPU 型号、数量、训练时长等硬件信息;
- 仅给出FLOPs 分析:单步策略评估中黎曼回缩开销为 ,混合权重/均值梯度为 ;
- 实验规模:每种配置 10 个独立种子,每 5000 步用独立测试 emulator 评估 20 个回合;
- 已知计算瓶颈在于协方差矩阵求逆与矩阵指数,状态维度 较高(如像素/LiDAR)时不可行。
5. 实验数量与充分性
- 参数扫描:、、4 档 、6 类缓冲策略,共约 80+ 配置;
- 消融维度:dense vs sparse、6 种缓冲策略、不同正则强度、不同网络规模的 DQN/PPO;
- 充分性:
- 覆盖数据效率(图 4)、计算效率(图 5)、稀疏动力学(图 6)、参数-性能曲线(图 7)、可视化可解释性(图 8–10)、缓冲策略消融(图 11)六个维度;
- 10 seeds + IQM 平滑 + 独立测试 emulator,提升统计可靠性;
- 但未与核方法/分布式 RL 在 Lunar 上重做,理由是 Flappy Bird 上 GMM-QF 已显著优于这些方法且 [35] 在更简单任务上一致地得到类似结论(这一裁剪略有限制说服力);
- 状态维度仅 8–12,缺乏高维场景验证。
6. 主要结论与发现
- 数据效率:S-GMM-QF 在相同转移数下提升更快,常在 dense 收敛前达到更优性能;
- 计算效率:在 Lunar 与 Flappy Bird 上,S-GMM-QF 仅需 dense 的一到两个数量级 FLOPs 即达到同等奖励;
- 参数效率:图 7 表明 S-GMM-QF 在低参数区间(–)仍保持强性能,而 SET-DQN、RiGL-PPO 等稀疏深度 RL 在该区间显著退化甚至失效;
- 可解释性:稀疏后每动作仅激活 6–14 个高斯分量,分量中心与策略访问热图高度对齐,无需后验归因方法;
- 缓冲策略:Lunar 上均匀/Fair 最佳;Flappy Bird 上聚类+稀疏 GMM 取得最优,提示延迟奖励下多样性比 TD 优先级更重要;分布型策略在该环境下反而劣于均匀采样。
7. 优点
- 稀疏化与黎曼优化的兼容性:Hadamard 过参数化将非光滑 替换为光滑 Frobenius 正则化,避免稀疏解落在不可微点处;
- 自适应稀疏:模型从一个大初始池()出发,自适应淘汰而非事先固定 ,比"小 dense 模型"更灵活;
- 几何可解释性天然涌现:稀疏后每个分量由显式均值/协方差刻画,无需事后归因工具;
- 参数高效且对低参数区间鲁棒:与稀疏深度 RL 形成鲜明对比;
- 算法层面细节完备:给出命题 2 的显式梯度、回缩/平行迁移公式与六种缓冲策略的伪代码。
8. 不足与局限
- 可扩展性受限:协方差求逆与黎曼回缩均为 ,对像素/LiDAR 等高维输入不可行,作者承认需借助在线编码器解决;
- 动作空间受限:当前仅支持离散动作,连续动作需扩展为 actor-critic(作者提及在研但未给出结果);
- 硬件/算力披露缺失:未给出 GPU 型号、训练时长、能耗,难以复现与横向对比;
- 基线覆盖不全:未在 Lunar 上重做核方法/分布式 RL 比较;DeepRL 比较仅用 DQN 与 PPO,未纳入 SAC、TD3 等更新算法;
- 稀疏深度 RL 公平性:PPO 稀疏化仅作用于 critic,actor 保持 dense(图 7 中参数量已合并计入),可能对参数效率对比有偏差;
- 超参依赖:正则系数 在两任务间相差 500 倍(Lunar 0.05 vs Flappy Bird ),缺乏自适应 调节机制;
- 统计显著性:虽用 10 seeds,但未在图中给出置信区间,仅用 IQM 平滑,结论的显著性强弱不易量化。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。