
Two-Timescale Hierarchical Reinforcement Learning for Resilient Operations
📝 TLDR
面对运营系统中频发的意外冲击,文章提出双时间尺度层级强化学习框架,在不改变既有层级决策结构的前提下联合自适应调整长期与短期策略。该方法同步耦合两类策略更新并首次给出收敛性保证。二手车案例显示:联合需求-供给冲击下均值利润提升9.2%,持续冲击下提升11.8%,且利润轨迹更稳定。研究为在不重构决策架构的条件下增强运营韧性提供了可行路径。
🧭 速览
运营系统面临需求与供给等多重冲击,传统决策规则难以适应层级化、长短期交织的运营场景。
构建双时间尺度层级强化学习框架,在不同时间尺度上分别学习长期与短期策略并同步耦合更新,首次证明收敛性。
二手车案例中,联合冲击下均值利润提升9.2%,持续冲击下提升11.8%,利润轨迹更稳定;遗憾界为O(T^{-1/2}),特定情形下改进至O(log T/T)。
联合长短期自适应是提升运营韧性的关键,可在不改变组织既有层级决策结构的前提下实现更稳定的高利润。
🆚 方法对比
Two-Timescale HRL Framework
- 联合适配长短时策略,收益提升9.2%-11.8%
- 首次证明耦合双时间尺度收敛性
- 不改变既有层级决策结构,易部署
- O(T^{-1/2})收敛率,log-concave条件更优
- 需要双层策略同步更新,计算复杂度较高
- 依赖联合需求-供应冲击的具体场景设定
- 二手车案例研究的泛化性需更多验证
- 需要预先识别长短时决策的层级结构
PPO (Proximal Policy Optimization)
- 广泛验证的策略学习方法,适合随机策略更新
- 可自然适配双时间尺度的层次决策结构
- 与现有RL工具链兼容,实现门槛低
- 支持连续与离散动作空间的灵活建模
- 标准分析仅针对单一策略更新序列
- 对耦合多策略更新无现成收敛保证
- 样本效率受环境交互成本限制
- 超参数敏感,在分层场景下需重调
Synchronized Coupled Two-Timescale Learning
- 首次提供耦合双时间尺度收敛性理论保证
- 同步更新尺度解决策略间耦合依赖
- 在log-concave条件下提升至O(log T/T)
- 为联合策略学习提供严格理论支撑
- 收敛证明依赖较强函数逼近假设
- 理论分析与实际PPO近端约束存在差距
- 最坏情形率O(T^{-1/2})仍慢于单尺度
- log-concave改进条件的实际验证有限
论文核心提出Two-Timescale HRL框架,基于PPO构建长短时策略,通过同步双时间尺度更新耦合学习,相对部分适配基准在联合冲击下提升收益9.2%、持续冲击下提升11.8%,并首次证明耦合双时间尺度收敛性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
这篇论文研究的是:当运营系统遭遇意外冲击时,如何让层级决策结构中的长期策略(如库存补货)和短期策略(如动态定价)同步自适应调整,从而兼顾高利润与稳定的利润轨迹。核心贡献是提出了一个双时间尺度层级强化学习框架,通过精心设计的同步条件耦合长期与短期策略的更新,并在理论上证明了首个针对耦合双时间尺度学习的收敛性保证。在二手车案例中,该框架在需求-供给联合冲击下相比最强基准提升均值利润 9.2%,在持续冲击场景下提升 11.8%,且利润曲线更为平稳。
研究背景与动机
全球运营系统近年来频繁遭受各类意外冲击——从 COVID-19 疫情导致的供应链中断,到苏伊士运河堵塞、巴拿马运河干旱,再到霍尔木兹海峡的地缘政治紧张,这些事件都在提醒我们:传统为"常态运营"优化的决策规则,在冲击发生后往往表现出持续的性能损失。缺货、延迟、丢单、库存失衡等问题接踵而至,企业亟需在不重构决策架构的前提下增强运营韧性。
许多运营系统天然具有层级结构。以最常见的库存-定价联合决策为例:补货决策周期较长(可能以周或月为单位),决定了企业的库存水平上限;定价决策则实时或以天为单位响应市场变化,吸引顾客到达并完成购买。长期决策为短期决策创造了执行环境,而短期决策的效果又反过来影响长期决策的合理性——二者相互耦合,共同服务于企业的整体利润目标。
然而,现有研究面临一个关键缺口。一方面,[[强化学习]]领域的主流方法多聚焦于单层、单智能体的决策问题;另一方面,[[层级强化学习]]虽然尝试处理多层决策,但其在耦合双时间尺度更新下的收敛性理论几乎为空白。更重要的是,企业通常不愿为了一套新算法而推翻既有的层级决策流程——这意味着新方法必须能够"即插即用"地嵌入现有架构,而不是要求组织重新设计决策体系。
方法
论文的核心思路是:为长期策略和短期策略分别维护独立的[[强化学习]]更新节奏,但在更新时机和步长上做精心同步,使得二者能够协调学习而不相互干扰。
决策过程的形式化是理解这一框架的基础。设系统状态为 ,其中 是库存状态, 是一个刻画需求与供给冲击及恢复过程的 [[Markov 决策过程|Markov 状态分量]]。每个长周期 的开始,长期策略 采样一个补货订单 ,这个订单将贯穿整个长周期。在长周期内,系统会进行 次短时交互,短期策略 在每次交互中采样定价动作 。长周期结束时,累积的短周期收益减去补货成本构成该周期的总收益 ,同时系统转移到新状态 。
论文采用 PPO-Clip 作为策略更新的基础算法。对于长期策略和短期策略,分别有:
其中 是基于截断替代目标函数计算的梯度估计。
同步条件是这篇论文最关键的设计决策。由于长期策略的每次更新会影响短期策略面临的执行环境,而短期策略的每次更新也会改变长期策略观察到的收益信号,二者的更新节奏必须协调。论文推导出的同步条件为:
其中 是每个长周期内的短期更新次数, 是短交互次数, 是折扣因子。这一等式具有清晰的管理含义:长周期越短( 越小)或折扣越小,企业越应该保守地调整短期策略——因为此时长期策略的变化更频繁,短期策略需要更强的稳定性。
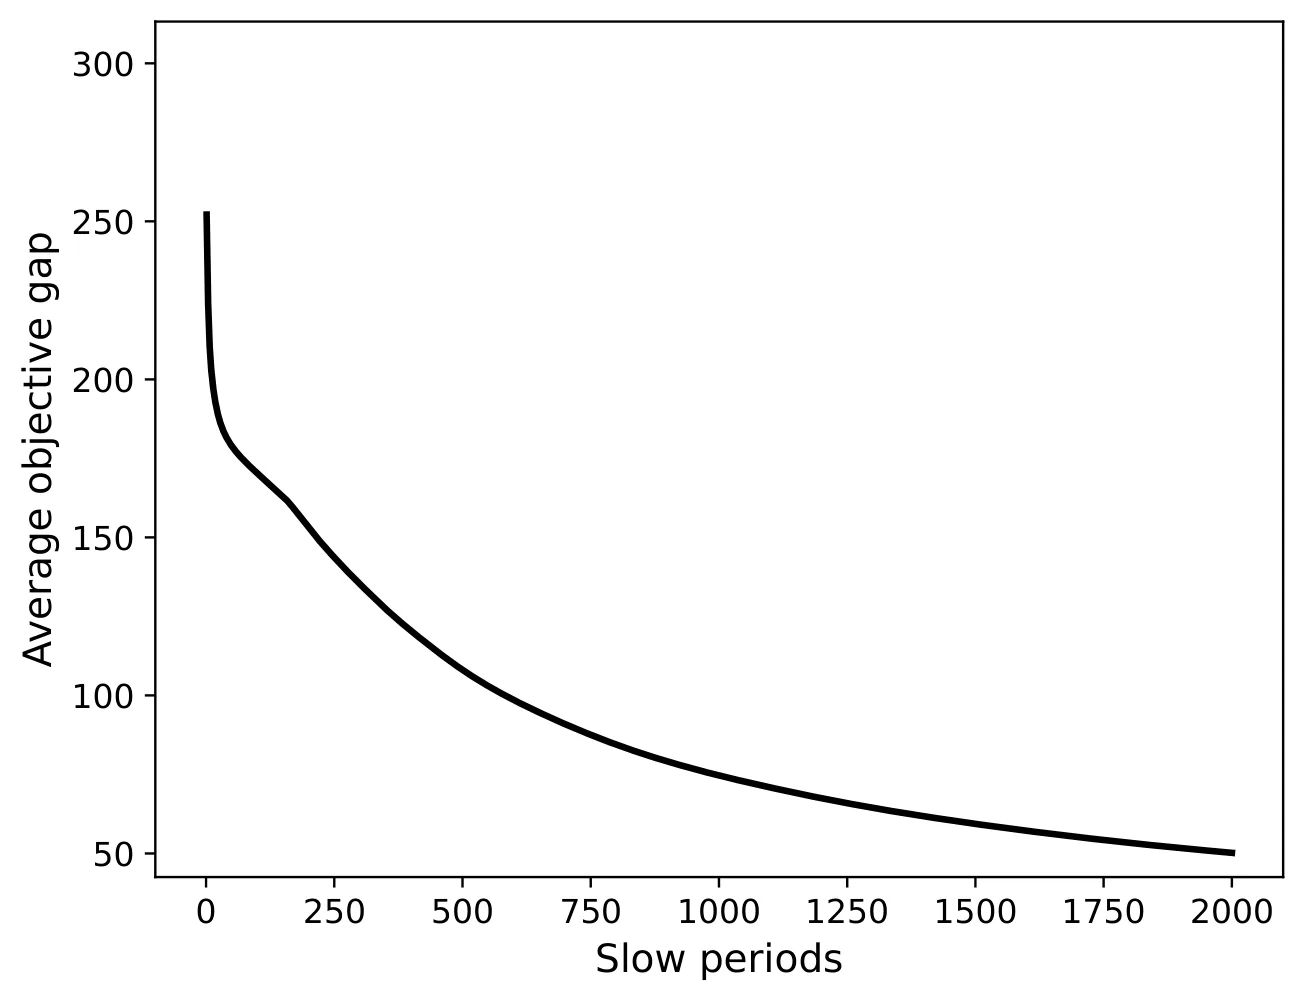
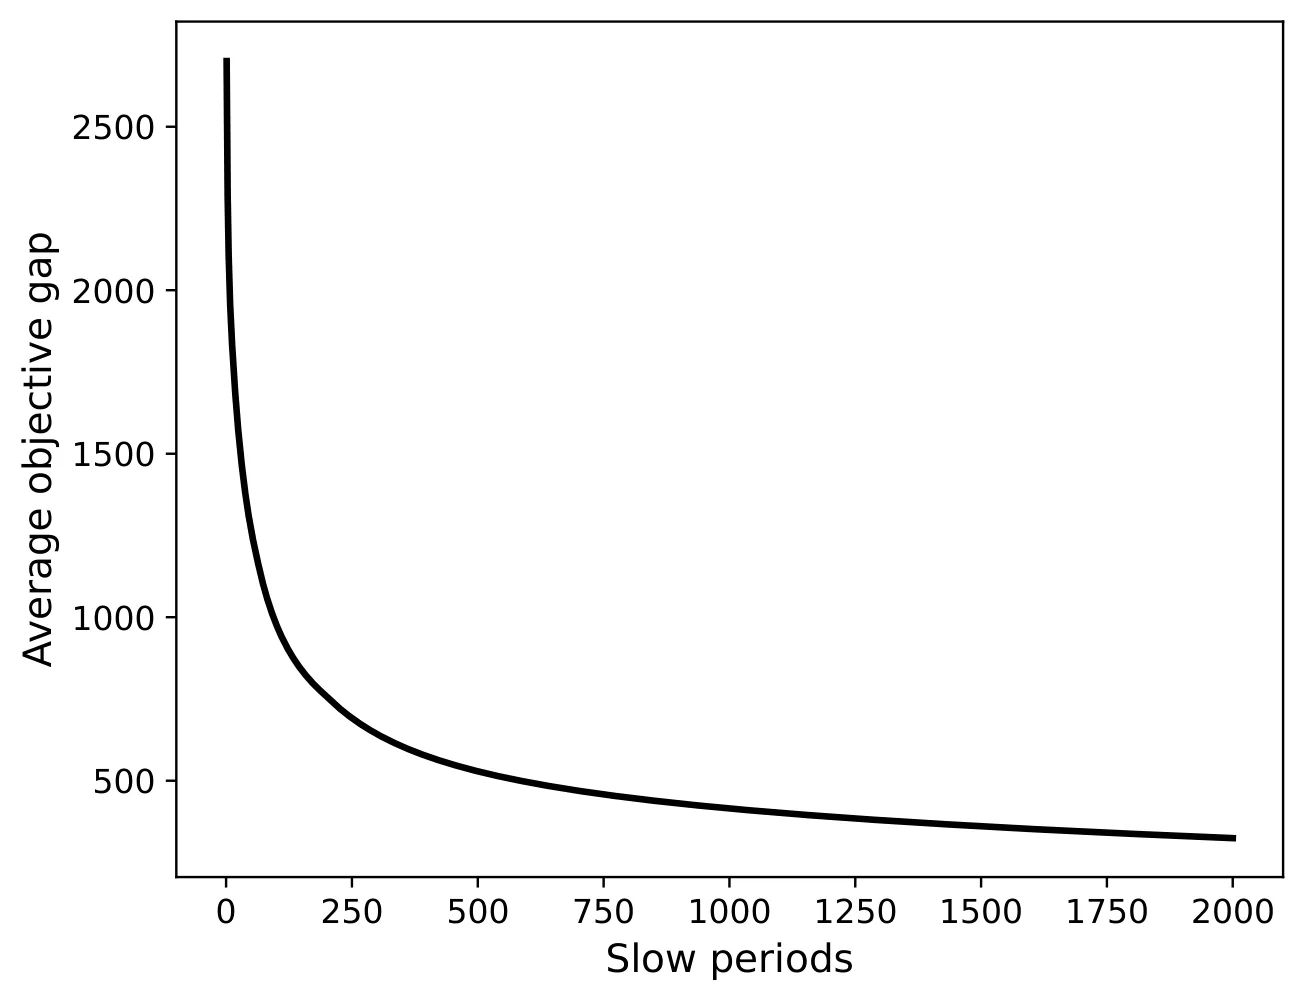
在理论层面,论文给出了两项重要结果。定理 1 证明了基础收敛性:取 ,策略对的最优性间隙以 的速率收敛到常数水平。这意味着随着训练时间延长,学习到的策略越来越接近最优策略对。定理 2 则在"市场锐度"假设下进一步改进:当糟糕的决策能产生更明显的利润损失(即性能差距与策略质量存在单调关系)时,采用时变学习率 可将收敛速率提升至 。
实验与结果
论文采用二手车零售作为验证场景,长期决策是库存补货,短期决策是客户到达时的动态定价,三类车型(经济型、中端、高端)覆盖不同的价格敏感度和需求弹性。顾客到达服从 52 周期的季节性模式,购买决策采用含参考价格、预算约束和紧迫性因素的二项 logit 模型。冲击通道则涵盖需求冲击(到达量与车型组合改变)、供给冲击(订单履约比例下降、交期延长)以及二者的联合冲击。
实验采用 2×2 配对设计,通过公共随机数技术确保四种策略在相同的随机种子下面对完全相同的客流、购买与冲击过程。具体而言:OUL+Fixed 代表仅用规则型补货(order-up-to level)配合固定加价定价,是最基础的基准;OUL+RL 用规则型补货但引入[[强化学习]]动态定价;RL+Fixed 用学习型补货配合固定定价;HRL 则是双时间尺度[[层级强化学习]]的完整实现。
结果显示,在无冲击的常态运营下,HRL 与 OUL+RL 的利润表现相近——这符合预期,因为常态下短期适应足以捕获大部分收益。但在联合需求-供给冲击下,OUL+RL 的均值利润显著下滑,而 HRL 仍能维持较高水平,相对最强部分自适应基准(OUL+RL)提升 9.2%。更显著的是在延长冲击场景(5500 周期模拟)中,HRL 相比 OUL+RL 提升 11.8%,且利润轨迹的波动明显更小。
论文进一步拆解了收益来源。RL 定价在所有评估窗口均带来显著增益(27.6K–58.1K 美元/周期),置信区间均不含零,这说明短期适应是主要的收益杠杆。RL 补货则仅在冲击期、需求激增期与恢复期显著——它不贡献常态收益,但为联合冲击和恢复阶段创造了关键的条件。协同交互项 在需求萎缩期(17.7K,CI )和恢复期(53.4K,CI )显著为正,意味着联合学习的收益大于两层各自收益之和——这正是双时间尺度设计的核心价值所在。
讨论与可借鉴点
这篇论文在理论上填补了耦合双时间尺度[[层级强化学习]]收敛性保证的空白,为后续研究奠定了分析基础。在实践层面,其模块化设计具有很强的可操作性:企业只需在现有层级结构中指定每层的状态、动作、奖励与决策时点,即可部署策略学习,无需重构组织决策流程。论文还提供了分阶段实施的路径——先上线短期定价学习验证效果,再逐步引入长期补货学习。
然而,局限性同样值得注意。实验仅基于二手车仿真的单一场景,外部效度有待在其他行业(如零售、制造、物流)中验证。理论假设(有限状态空间、有界奖励、精确优势方向)也较强,真实应用中函数逼近引入的误差尚未在收敛性分析中完全处理。此外,论文未系统探索短期更新频率 、学习率、折扣因子 等超参数的敏感性分析,这对实践者的参数调优构成一定挑战。
对于后续研究而言,这篇论文指出了几个有潜力的方向:多产品、多层级的更复杂决策场景;竞争环境下的层级学习;以及将冲击模式从外生设定拓展到自适应学习的框架中。可以预见,随着全球供应链不确定性持续上升,"在不重构决策架构的条件下增强运营韧性"这一命题将越来越重要,双时间尺度[[层级强化学习]]的思路为这一目标提供了可行的技术路径。
Abstract
Unexpected shocks recur in global operations, requiring decision rules that adapt as market and operating conditions change. Many operational systems also have hierarchical structures in which long-term and short-term decisions pursue a shared objective. We study how hierarchical reinforcement learning can strengthen resilience by adapting these interdependent rules jointly. We develop a two-timescale hierarchical reinforcement learning framework that adapts long-term and short-term policies at their respective time scales. Because the policies are interdependent, we synchronize their updates and prove, to our knowledge, the first convergence guarantees for coupled two-timescale learning. Over periods, our policies' average gap from an optimal policy pair is , improving to when poor decisions produce clearer profit losses. In a used-car case study, inventory replenishment is the long-term decision and customer-arrival pricing the short-term decision. Relative to the strongest partially adaptive benchmark, the framework increases mean profit by under joint demand-supply shocks and by under a prolonged shock scenario, while maintaining a more stable profit trajectory over time. Short-term adaptation addresses routine seasonality and one-sided disruptions by responding immediately to changing conditions. Under joint demand-supply shocks, however, it is insufficient alone; long-term adaptation is also needed to create favorable conditions for short-term decisions. Joint adaptation thus yields higher and more stable profits through disruption and recovery. Because many organizations already use hierarchical planning, the framework strengthens operational resilience without altering existing decision structures.
论文详细总结(自动生成)
论文总结:双时间尺度层级强化学习用于韧性运营
1. 核心问题与研究动机
- 现实背景:全球运营系统频繁遭遇意外冲击(COVID-19 疫情、苏伊士运河堵塞、巴拿马运河干旱、霍尔木兹海峡中断等),传统为常态运营优化的决策规则在冲击后易出现持续性能损失(缺货、延迟、丢单、库存失衡)。
- 层级决策结构:许多运营系统天然具有层级结构——长期决策(如补货、产能承诺)与短期决策(如定价、入队控制)在不同时域上追求共同目标,且二者相互耦合。
- 核心问题:如何在冲击条件下,使长短期决策规则联合自适应,以同时获得高利润与稳定利润轨迹(韧性),而不改变现有组织层级结构。
- 研究空白:现有强化学习(RL)研究多聚焦单层、单智能体或单时间尺度更新,对耦合双时间尺度的收敛性缺乏理论保证;层级强化学习(HRL)的理论也尚未覆盖 PPO 类双时间尺度联合学习场景。
2. 方法论
2.1 双时间尺度决策过程形式化
- 在每个长周期 ,系统状态 ( 为刻画需求/供给冲击与恢复的 Markov 状态分量)。
- 长期策略 采样长期动作 (补货订单),固定至周期末。
- 短周期内( 次短时交互,索引 ),短期策略 采样短期动作 (定价)。
- 周期收益:。
- 联合目标函数(折扣性能):
2.2 PPO-Clip 联合更新
- 长期策略 与短期策略 均通过 PPO-Clip 更新:
其中 为基于截断替代目标 的梯度估计。
- 训练流程(算法 1):长周期开头采样 ;每个短时交互累积数据;累积 条后触发 更新;周期末观察 与 ,更新 。
2.3 同步条件与收敛性
- 同步条件:累积短期更新规模与长期更新规模对齐:
其中 为每个长周期内的短期更新次数。
- 定理 1(基础收敛):在假设 1–3 下,取 ,则
即平均最优性间隙为 。
- 定理 2(加速收敛):在额外"市场锐度"假设()下取 ,则
即改进为 。
2.4 实现兼容性
- 框架是模块化的:企业只需在现有层级结构中指定每层的状态、动作、奖励与决策时点,即可加入策略学习,无需重构组织决策流程。
3. 实验设计
3.1 数据/场景
- 二手车零售案例:库存补货(长期)+ 客户到达定价(短期),三类车型(budget / mid / premium)。
- 顾客到达服从 52 周期季节性乘子,购买概率采用含参考价格、预算约束、紧迫性的二项 logit 模型。
- 冲击通道:需求冲击(到达量与车型组合改变)、供给冲击(订单履约比例下降、交期延长);以及二者的联合冲击。
3.2 基准与对比方法(2×2 配对设计)
| Fixed Pricing | RL Pricing | |
|---|---|---|
| OUL Replenishment | OUL+Fixed(基线) | OUL+RL |
| RL Replenishment | RL+Fixed | HRL |
- OUL(order-up-to level):周期性库存理论规则,参数随观测再估计(规则型,但非学习)。
- Fixed pricing:在采购成本上加固定加价(30%)。
- 评价指标:均值利润、累计利润、抗冲击能力()、恢复力(),以及协调交互对比 。
- 配对实验使用公共随机数(common random numbers):同一随机种子下四种策略面对相同的客流、购买、冲击与履约随机性,仅策略不同。
4. 资源与算力
- 论文未明确披露所用 GPU 型号、CPU 数量、并行规模或单次训练时长。
- 实验规模可推断:实验 1 每种冲击设置下 4 策略 × 30 种子 × 3000 周期;实验 2 为 4 策略 × 30 种子 × 5500 周期。所有为模拟环境,规模较小,但论文未给出运行时间或硬件配置说明。
5. 实验数量与充分性
- 实验 1:4 种冲击设置(无冲击 / 仅需求 / 仅供给 / 联合)× 4 策略 × 30 种子 = 480 组仿真,并辅以 52 周期滚动利润曲线、事件窗口分析、价格/库存/丢单诊断。
- 实验 2:5500 周期延长联合冲击场景,加入需求激增/萎缩子窗口与恢复窗口,2×2 三组对比(补货增益、定价增益、协同增益)。
- 补充数值实验(附录用):有限状态环境下的对照数值插图,展示基础收敛与锐度加速两种机制的运行平均间隙曲线。
- 充分性评估:
- 使用 95% 置信区间、按种子配对的成对比较,降低采样噪声。
- 2×2 设计清晰隔离"补货学习"、"定价学习"、"联合学习"的边际与交互贡献。
- 多角度诊断(利润、价格、库存、丢单)避免单一指标偏倚。
- 但仅一个行业场景(二手车)、仿真环境,外部效度有限;缺少消融(如不同网络结构、奖励塑形、PPO 替代算法)等敏感性分析。
6. 主要结论与发现
- 整体盈利能力:HRL 在多数冲击设置下取得最高均值利润,且利润路径最稳定。
- 量化收益:相对最强部分自适应基准(OUL+RL),HRL 在联合冲击下均值利润提升 9.2%,在延长冲击场景下提升 11.8%。
- 短期是主要适应杠杆:RL 定价在所有评估窗口均带来显著增益(27.6K–58.1K 美元/周期),置信区间均不含零;RL 补货仅在冲击期、需求激增期与恢复期显著。
- 联合学习的不可加性:协同交互 在需求萎缩期(17.7K,CI )与恢复期(53.4K,CI )显著为正,说明联合适应收益大于两层层各自收益之和。
- 恢复机制:HRL 通过更高售价、更强库存保留、更少丢单三者的平衡实现恢复优势,而非牺牲其一。
- 理论意义:首次给出耦合双时间尺度 PPO 类学习的全局收敛保证,并给出管理含义(短期更新次数 增多需同比降低 等)。
7. 优点
- 理论贡献:在耦合双时间尺度、长期与短期策略相互改变对方学习信号的设定下,给出首个全局平均间隙收敛界,并揭示"市场锐度"带来的加速机制。
- 同步条件可解释: 具有明确管理含义——长周期越短( 小)或折扣越小,短期更新应越保守。
- 框架兼容性好:不要求重塑组织决策结构,可分阶段部署(先短期、再长期)。
- 实验设计严谨:2×2 配对 + 公共随机数 + 多窗口诊断,避免常见仿真研究中"选最佳种子"、"单指标偏倚"等问题。
- 管理洞察具体:明确指出"短期适应处理常规与单边冲击;联合冲击与恢复阶段才需要长期适应",与现实运营经验吻合。
8. 不足与局限
- 单一场景、合成数据:仅以二手车仿真为例,未在真实运营数据上验证;外部效度受限。
- 理论假设较强:有限状态空间、有界奖励、严格正概率策略、精确优势方向(population-level 抽象);真实 PPO 实现的有限样本、函数逼近误差未在主定理中处理。
- 算力与实现细节不透明:未披露 GPU/训练时长、网络结构规模、超参数选择过程,限制复现性。
- 缺乏消融与敏感性分析:未系统比较不同短期更新频率 、学习率、折扣因子 、PPO clip 参数 对实际性能与经验常数 的影响。
- 可扩展性未充分验证:未涉及多产品、多层级(>2 层)、竞争环境、跨企业协调等更复杂层级规划场景(作者在结尾也承认这是未来方向)。
- 长期与短期奖励分离:长期策略只能获得延迟到周期末的 信号,对噪声与极端冲击的鲁棒性仍依赖经验设计,论文未提供相应的奖励塑形或鲁棒性分析。
- 冲击分布外推风险:仿真中冲击模式(对称/非对称履约削减、需求乘子等)是外生设定的固定模式,可能低估真实冲击的异质性。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。