
LA-RL:面向信息抽取强化学习的标签感知自我反思
LA-RL: Label-Aware Self-Reflection for Reinforcement Learning in Information Extraction
📝 TLDR
大语言模型在信息抽取任务中,现有自反思纠正方法难以诊断结构化错误的具体类型。本文提出LA-RL框架,通过标签感知诊断引导模型识别缺失span、错误标签、边界偏移等任务特定错误类型,并据此修正输出。实验在NER、关系抽取、事件抽取上均取得稳定提升,OOD关系抽取提升约20个F1。贡献在于将任务驱动的诊断标签融入结果监督的强化学习,无需过程奖励模型即可获得一致性增益。
🧭 速览
现有LLM自反思方法对结构化信息抽取输出不匹配,难以区分错误类型以有效纠正。
LA-RL:单骨干先预测抽取并诊断任务特定错误标签,再据此修正,通过冷启动SFT与两阶段GRPO训练。
SciER关系抽取平均F1提升6.83,OOD关系抽取提升约20 F1,DuEE1.0触发器与论元F1分别提升14.80和17.50。
反思结构具任务敏感性:关系抽取需更强约束,NER在域偏移下宜采用较宽松的修正策略。
🆚 方法对比
LA-RL (Label-Aware Reflective Reinforcement Learning)
- 在NER/RE/EE多任务上一致超越SFT基线
- 无需单独训练过程奖励模型
- 诊断标签引导精确修正错误类型
- OOD关系抽取约提升20 F1
- 三阶段训练流程较为复杂
- 冷启动依赖标注模型生成的诊断数据
- 反思结构对任务敏感需手动调优
Free-form self-reflection (free-form chain-of-thought reflection)
- 实现简单,无需额外训练
- 可复用CoT在推理任务的成功经验
- 适用于开放式自然语言生成任务
- 难以定位具体错误类型,仅能感知错误
- 在结构化IE输出上经常失效
- 修正步骤需猜测,可靠性不足
SFT (Supervised Fine-Tuning)
- 训练稳定,方法成熟易实现
- 作为基线清晰便于公平对比
- 缺乏自我反思与纠错能力
- 在结构化IE任务上明显弱于LA-RL
GRPO (Group Relative Policy Optimization)
- 基于结果的奖励机制无需独立PRM
- 奖励可直接从抽取指标计算得出
- 需要多阶段训练,流程较复杂
- 奖励设计对最终性能较为敏感
Generic Reflection (ablation baseline)
- 作为无标签反思机制的对比基线
- 结构简单,实现成本低
- 缺乏任务特定的诊断标签
- 性能明显弱于LA-RL
Label-only Correction (ablation baseline)
- 可验证诊断标签的独立贡献
- 无需反思过程即可进行修正
- 缺乏完整反思流程效果有限
- 性能明显弱于完整LA-RL框架
LA-RL通过任务特定的诊断标签将反思结构化,在关系抽取等任务上一致优于自由格式反思和纯SFT;而消融实验表明Generic Reflection与Label-only Correction均弱于完整框架,证明了诊断标签与反思机制的协同必要性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
LA-RL 针对大语言模型在信息抽取任务中自我纠错不精准的问题,引入了任务驱动的诊断标签机制,使模型能够区分「缺失片段」「错误标签」「边界偏移」等具体错误类型并针对性地修正。在命名实体识别、关系抽取和事件抽取任务上,相较于监督微调取得一致提升,尤其在分布外关系抽取上 F1 提升约 20 分,无需过程奖励模型即可实现稳定的自我纠错能力。
研究背景与动机
信息抽取是构建知识图谱、支撑下游任务的关键技术,其核心在于从非结构化文本中精准识别实体、关系和事件的结构化信息。近年来,大语言模型凭借强大的语义理解能力,在这一领域展现出显著潜力。然而,现有基于自我反思的纠错方法在实际应用中暴露出一个根本性缺陷:反思内容与结构化抽取输出之间存在语义错位。
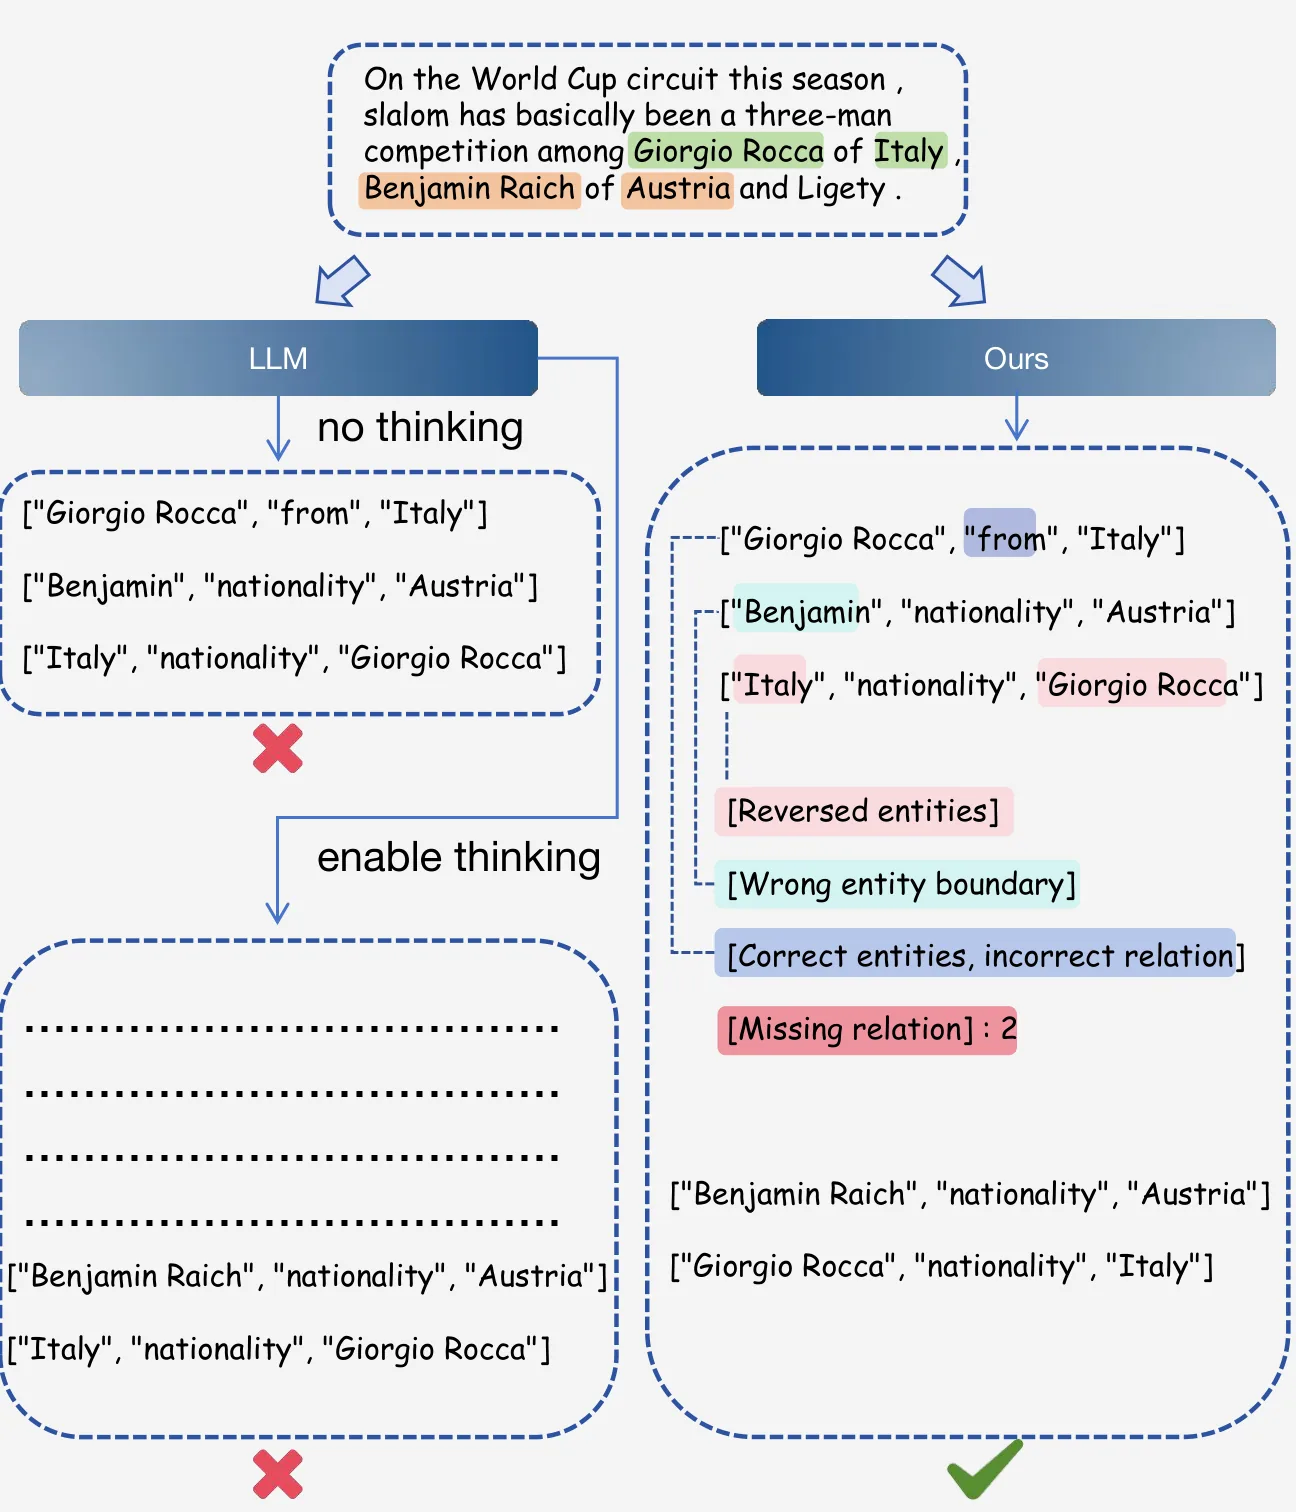
具体而言,当模型生成一段「北京是中国的首都」的关系抽取结果时,自由形式的自我反思可能只能给出「关系类型判断有误」这样的模糊反馈,却难以指出究竟是缺失了某个实体 span、关系类型标签错误、还是实体的边界划分出了问题。这种粗粒度的诊断无法为后续修正提供精准的指导,导致纠错过程如同盲人摸象。
造成这一困境的深层原因在于:现有的自我反思机制脱胎于对话或问答场景,其设计初衷是针对自然语言响应的流畅性与一致性进行评估,而信息抽取任务的输出具有严格的结构化约束——实体的起止位置必须精确、关系类型必须来自预定义集合、事件论元的角色必须符合模板规范。这种结构性差异使得通用领域的反思策略在 IE 场景下水土不服。
基于此,LA-RL 的核心切入点在于:将任务本身的结构化特性融入诊断过程,让模型不仅知道「哪里错了」,更要知道「错成什么类型」。这一设计动机看似直观,却是打通自我纠错在 IE 领域落地应用的关键一步。
方法
LA-RL 的方法论围绕一个核心假设展开:信息抽取的结构化错误可以被系统性地归类为若干有限的错误模式,而识别这些模式是实现精准修正的前提。在此基础上,论文设计了一套标签感知的诊断-修正流程。
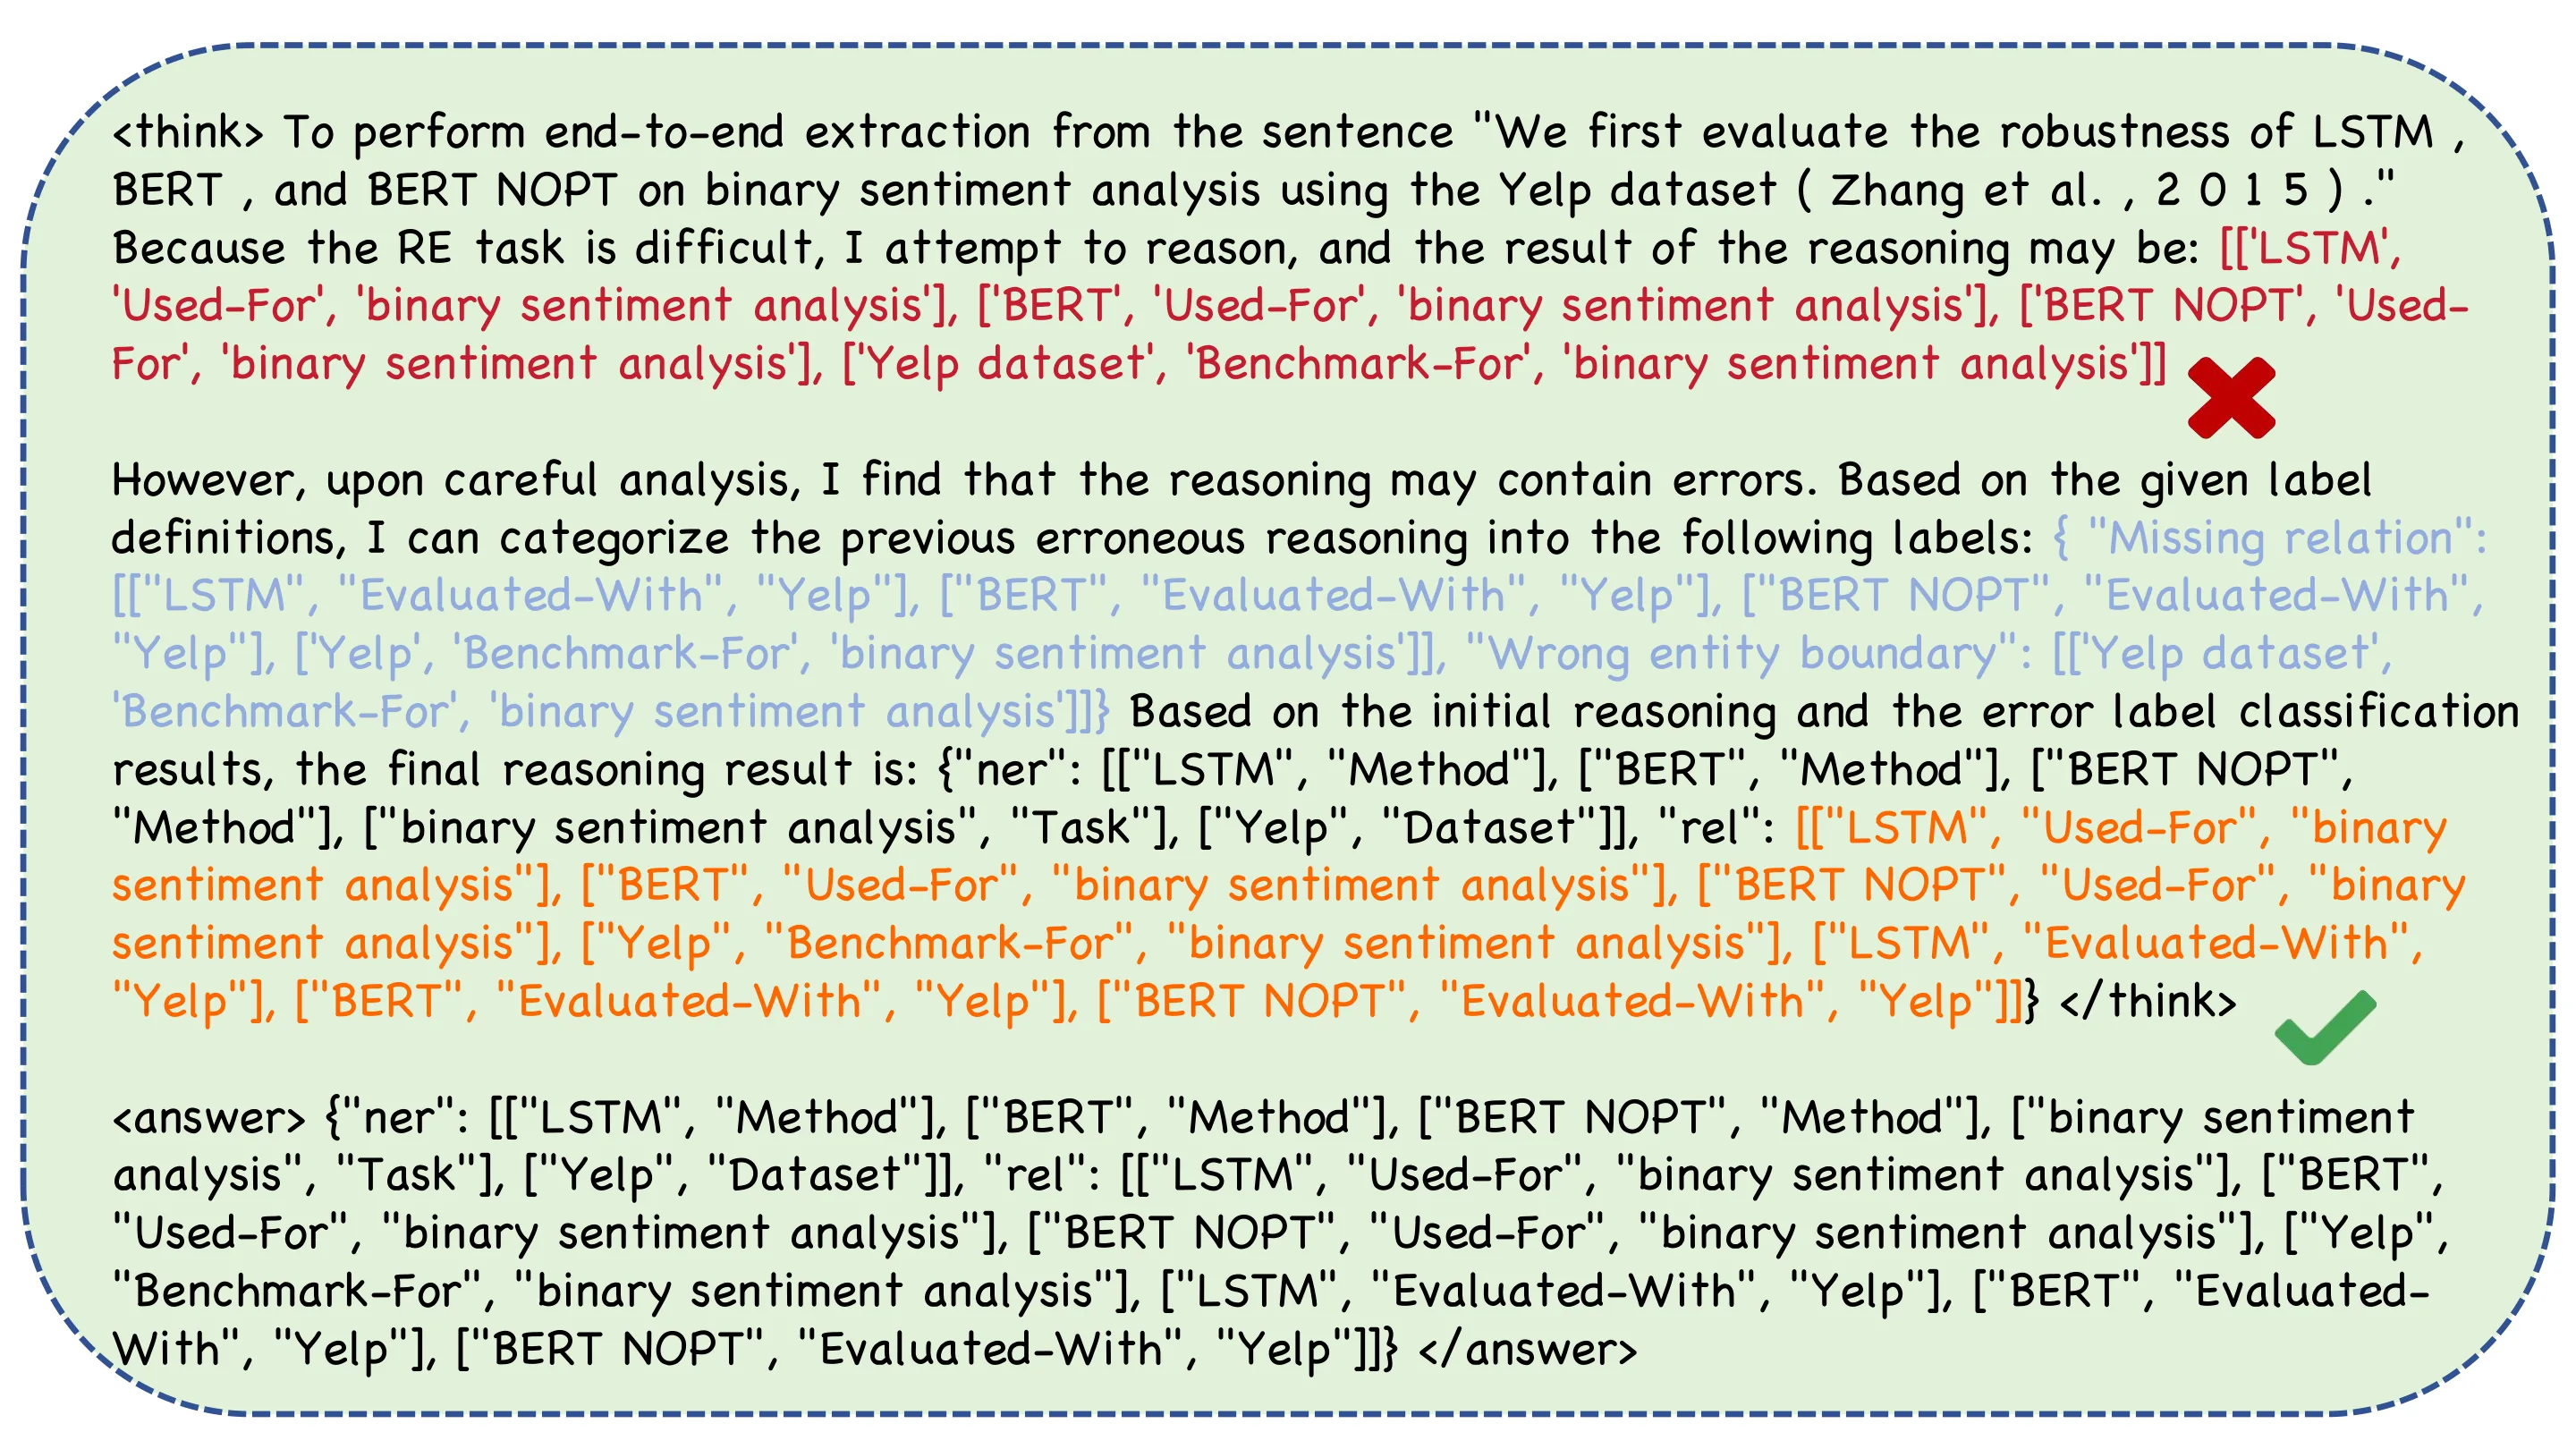
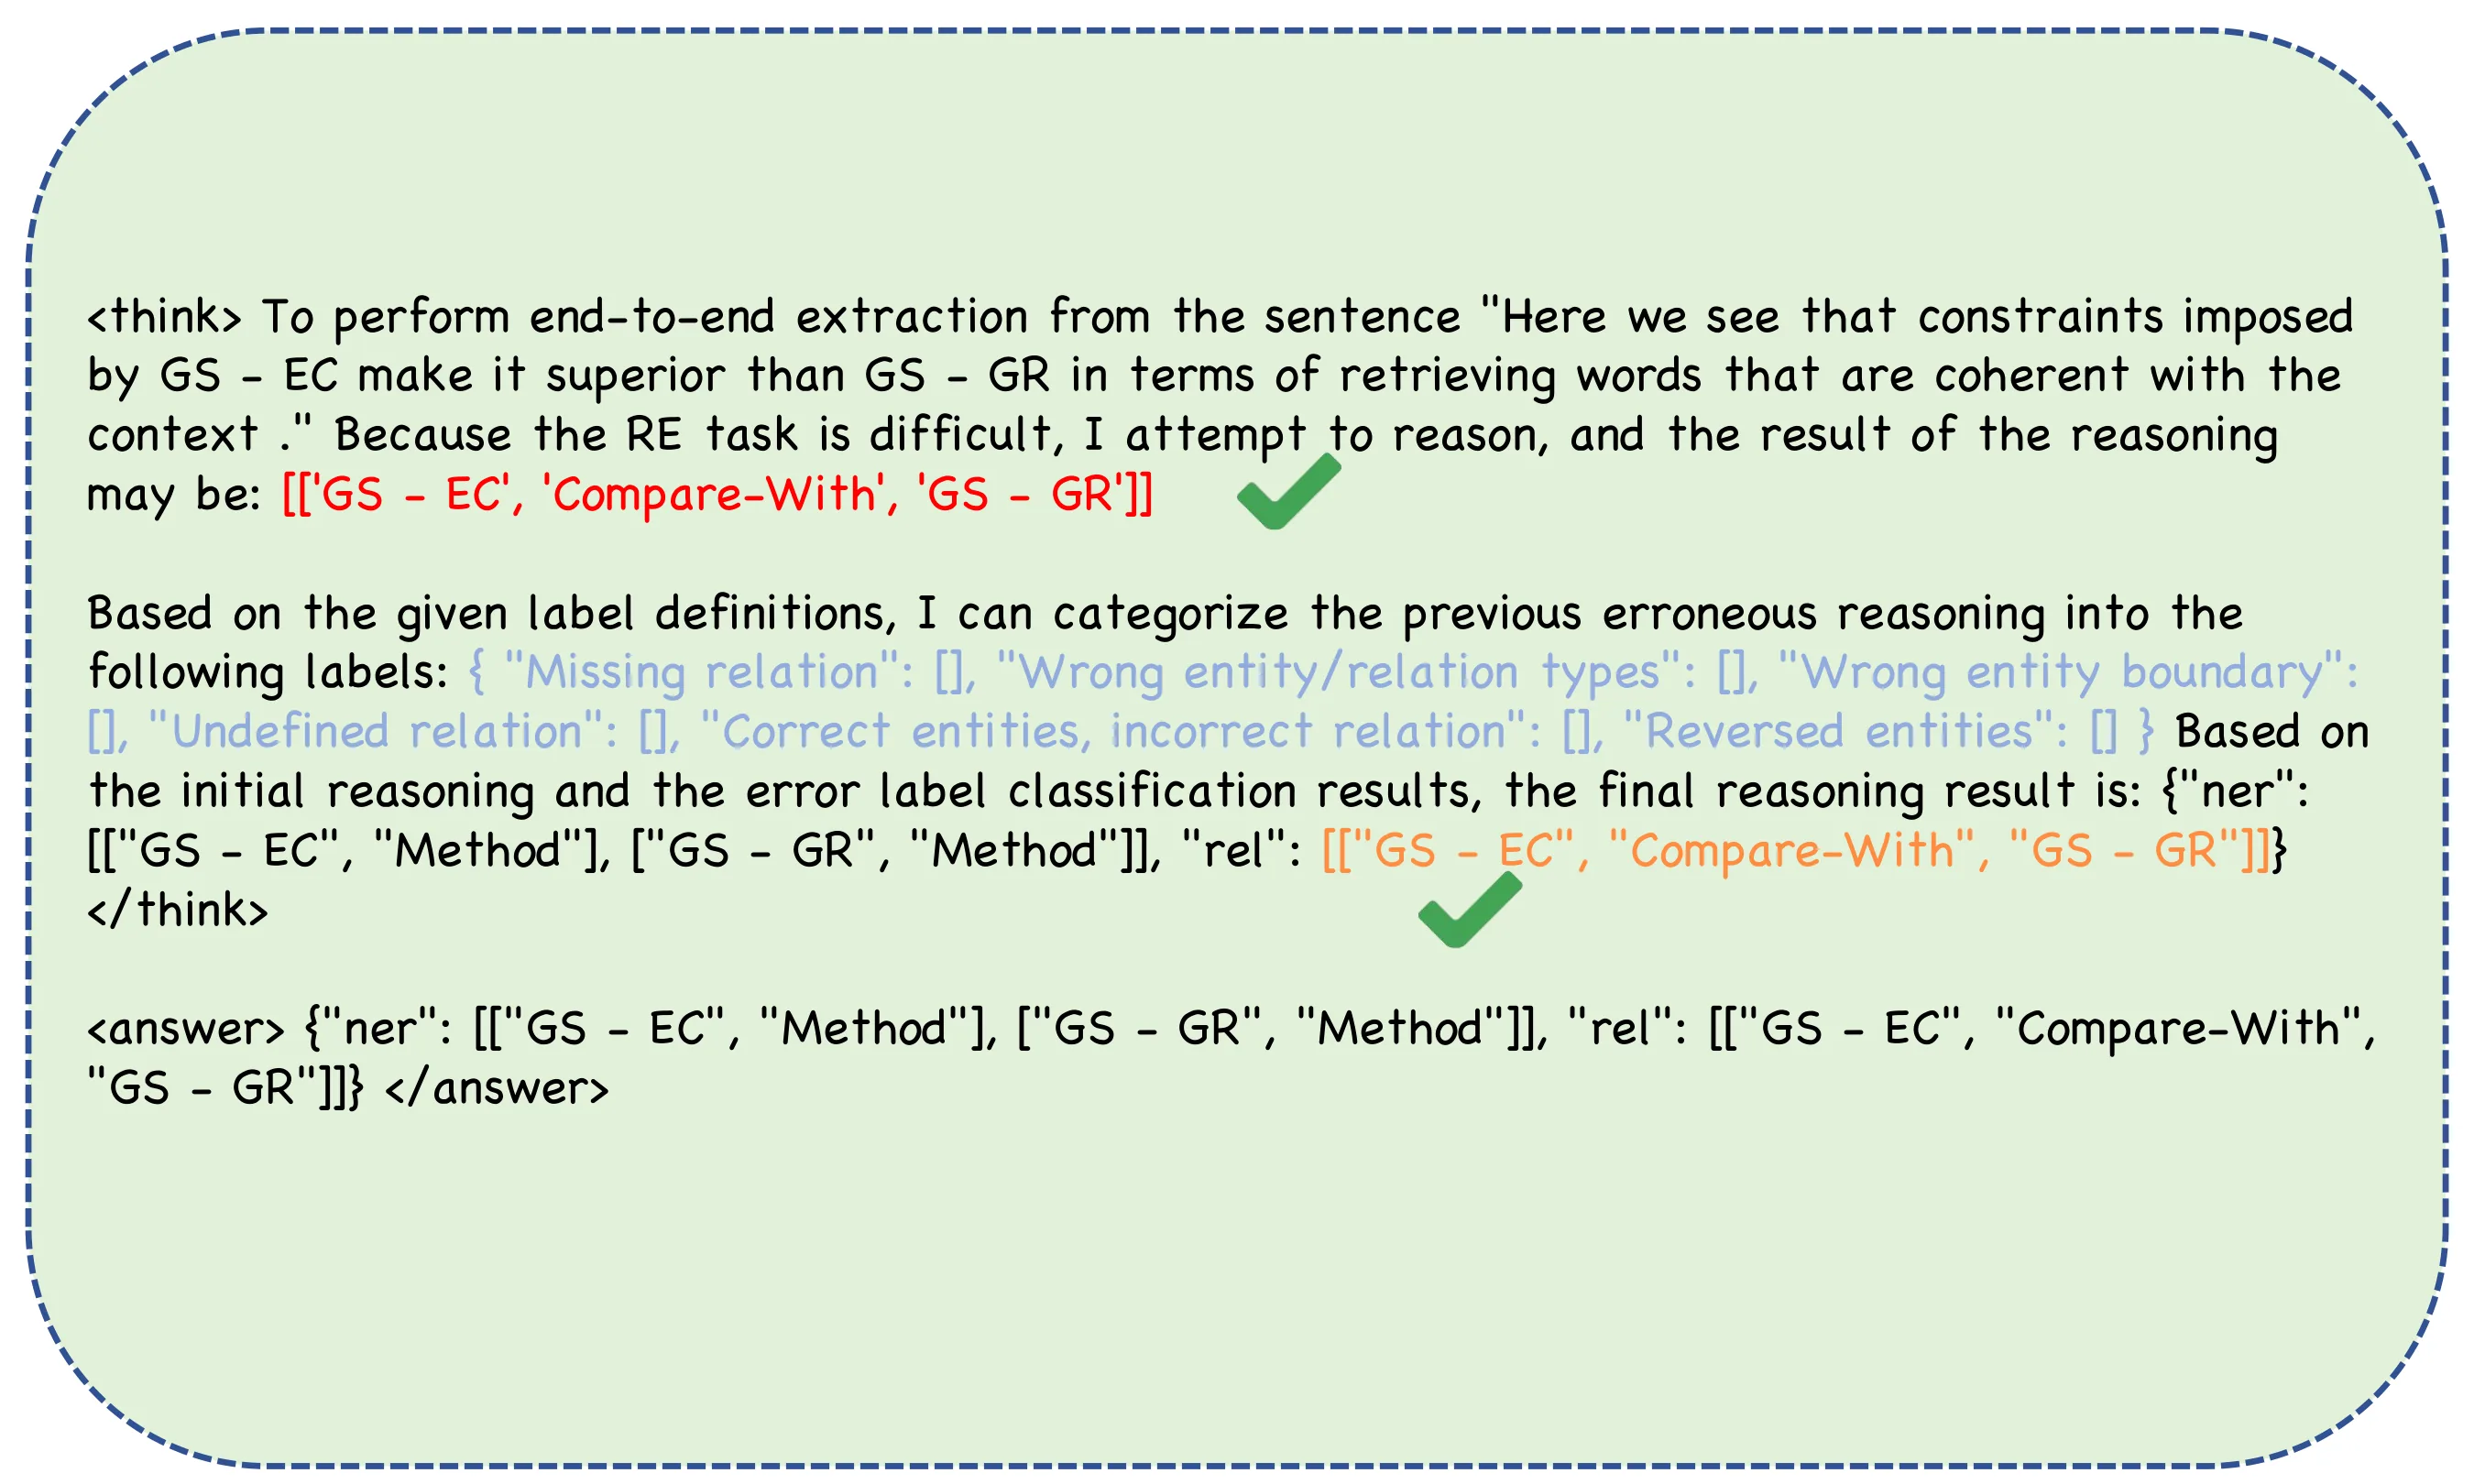
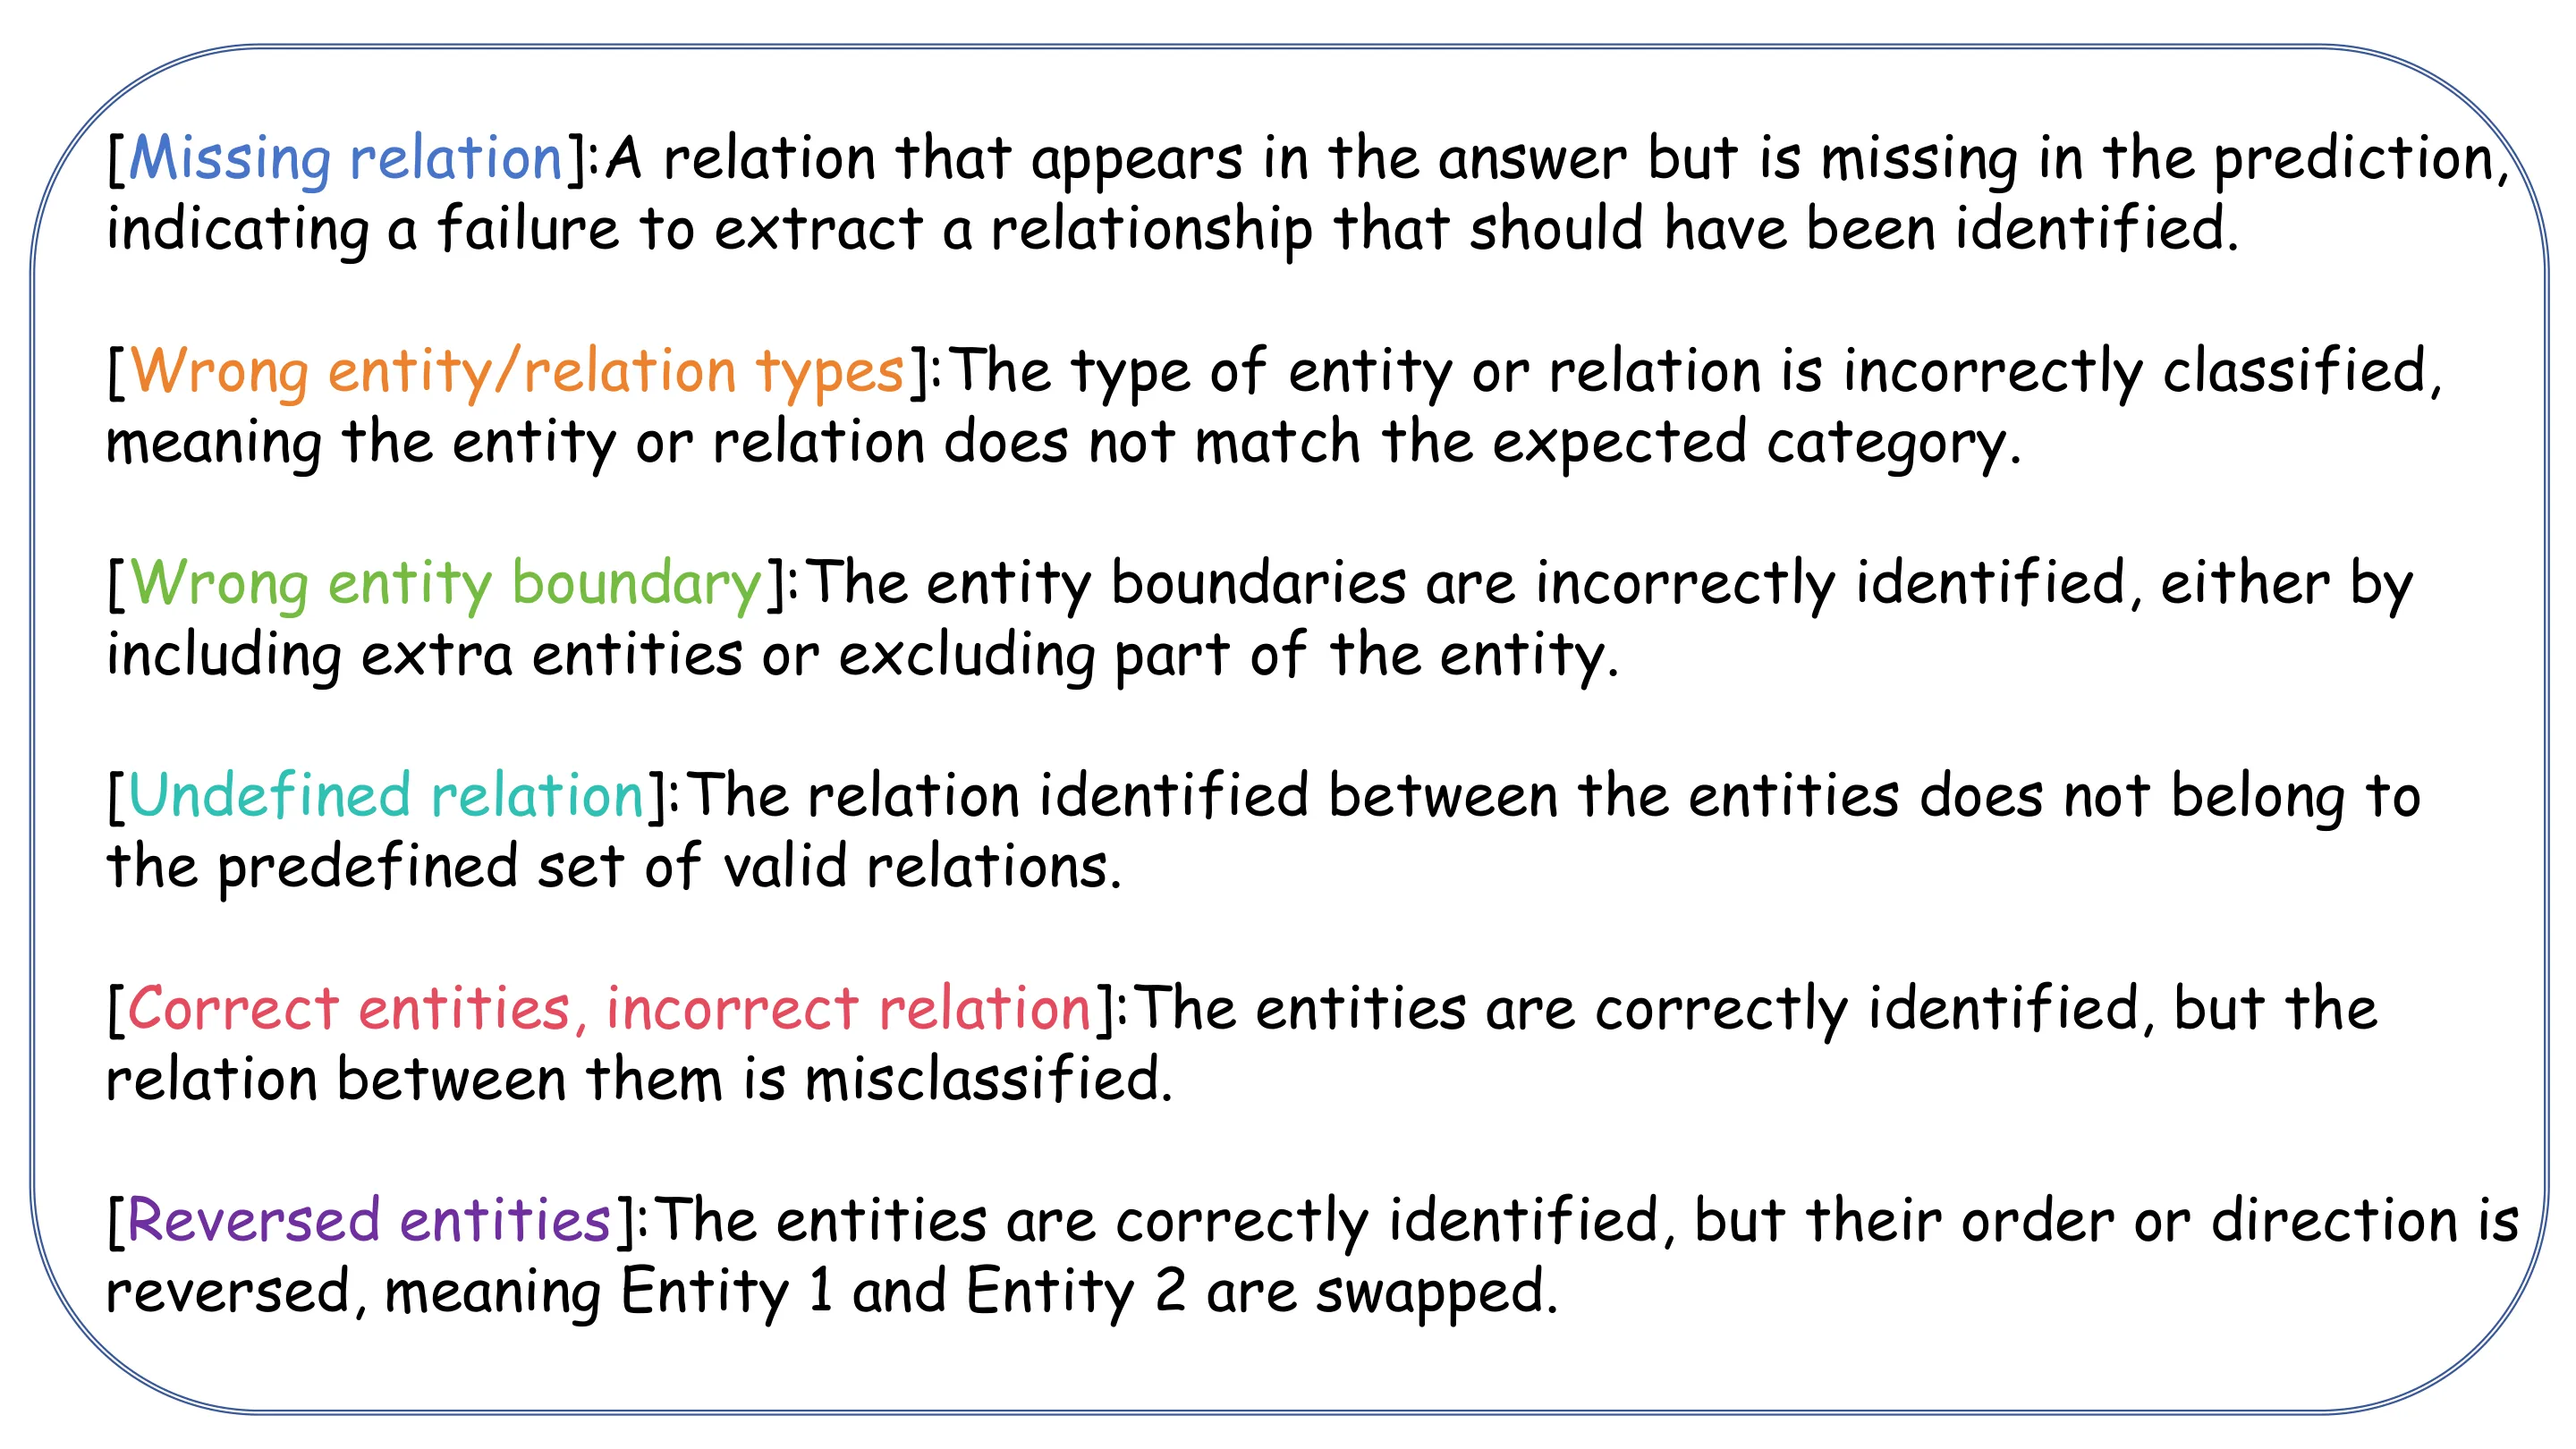
整个框架以单一大语言模型作为骨干网络,处理流程分为三个阶段:抽取预测、错误诊断、结果修正。模型首先对输入文本进行结构化抽取,生成包含实体、关系或事件论元的初步结果;随后,模型基于抽取结果和原始文本进行诊断,此时输出不再是自由形式的反思文本,而是来自预定义错误标签集合的分类结果——这些标签涵盖了 IE 任务中最典型的失败模式,包括缺失 span、错误标签、边界偏移、无效关系类型以及论元顺序颠倒等;最后,模型以诊断结果为条件,对初步抽取进行针对性修正。
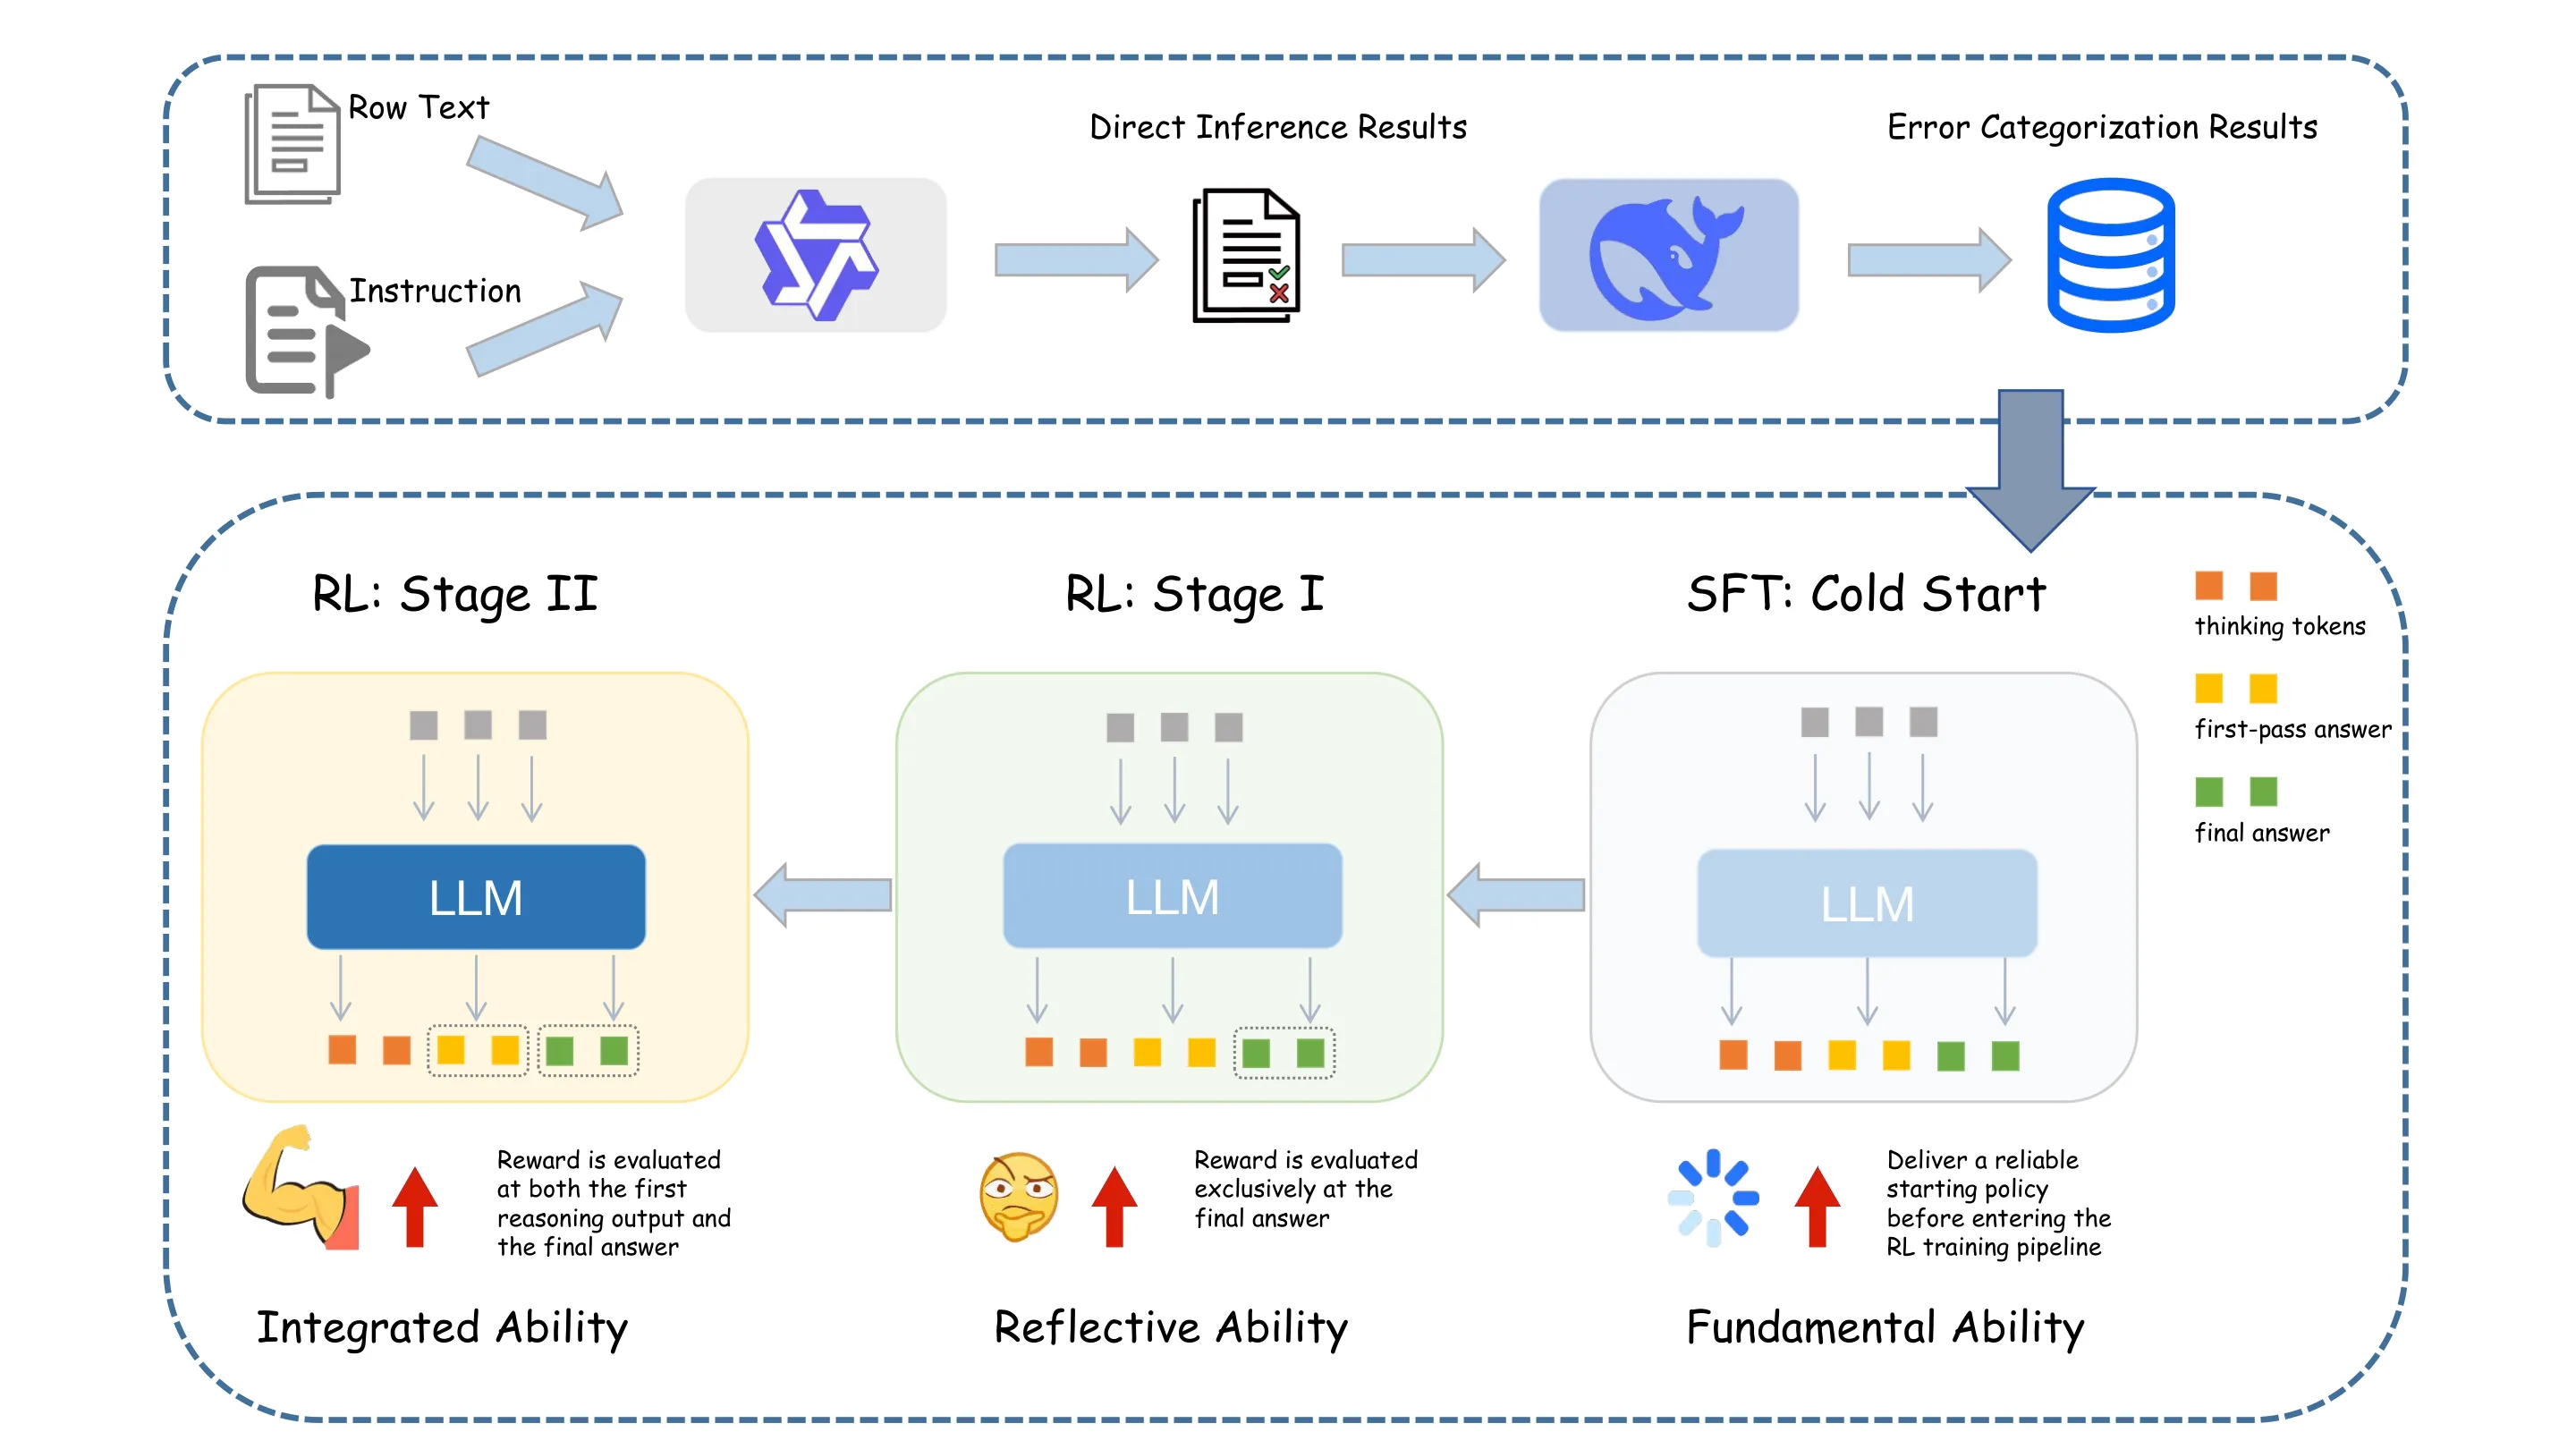
训练策略分为冷启动和强化学习两个阶段。冷启动阶段利用标注模型生成的诊断数据对骨干网络进行监督微调,使模型习得「抽取→诊断」的协同能力。这一阶段的关键在于诊断标签的质量:论文采用专门的标注模型对训练样本的抽取错误进行人工级别的诊断标注,确保模型在起步阶段就建立对错误模式的正确认知。
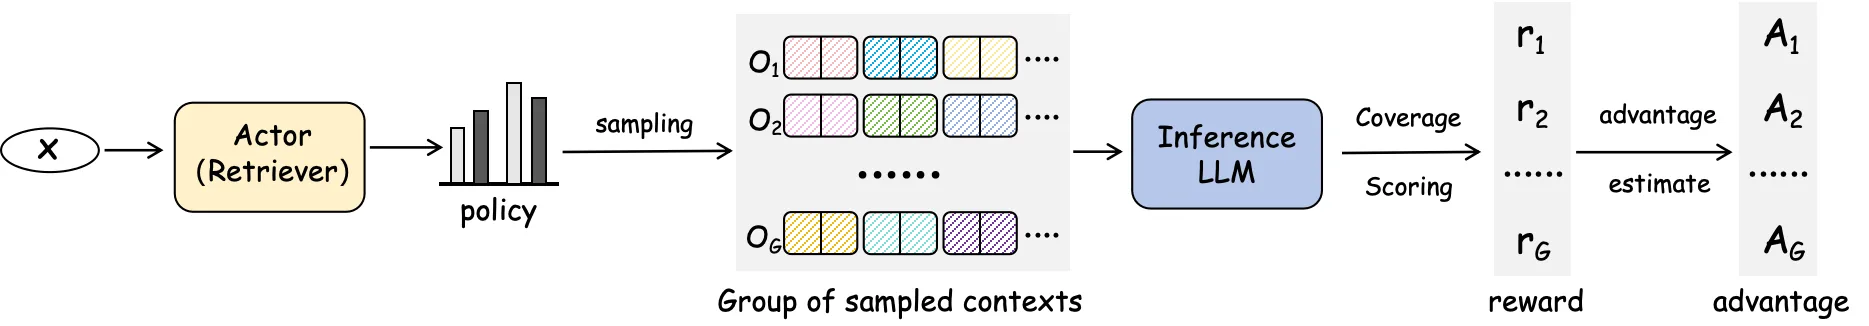
冷启动之后是两阶段 GRPO(一种结果监督的强化学习方法)训练。第一阶段侧重格式有效性和首轮正确性的奖励塑造,模型不仅因最终抽取质量获得正向激励,也因保持输出格式规范、在首轮就给出正确答案而获得奖励。第二阶段则逐步引入更难的任务变体和更大规模的训练样本,通过持续的结果反馈强化诊断-修正的协同能力。
值得注意的是,LA-RL 完全不依赖过程奖励模型。所有奖励信号均来自对最终抽取结果的客观评估,这种设计既简化了训练流程,也避免了过程奖励模型在复杂结构化输出上难以精确设计 reward function 的问题。诊断标签的作用相当于在结果监督的框架内嵌入了一层任务感知的中间表示,弥合了端到端结果监督与细粒度过程控制之间的鸿沟。
实验与结果
论文在三类主流信息抽取任务上验证了 LA-RL 的有效性:命名实体识别(NER)、关系抽取(RE)和事件抽取(EE),涵盖了领域内和分布外(OOD)两种评测设定。
在关系抽取基准 SciER 上,LA-RL 相比监督微调基线实现了平均 F1 提升 6.83 分,这一增益在结构化抽取任务上属于相当可观的幅度。更加引人注目的是分布外关系抽取的结果:在未见过的关系类型和领域上,F1 提升达到约 20 分,展现了标签感知诊断机制在泛化能力上的优势。这一现象表明,当模型被训练识别「何种错误类型」而非「如何修正特定错误」时,其纠错策略具有更强的迁移性。
事件抽取实验在 DuEE1.0 数据集上进行,LA-RL 在触发词识别上取得 14.50 的 F1 提升,在论元抽取上更是高达 17.50 的提升。事件抽取涉及嵌套的层级结构和多角色论元的协调,其结构复杂度高于实体识别和关系抽取,LA-RL 在这一任务上的显著增益进一步验证了诊断标签对复杂结构化场景的有效性。
消融实验揭示了一个富有实践意义的发现:反思结构的约束强度与任务特性存在交互效应。对于关系抽取而言,更严格的诊断标签和修正约束能够带来更稳定的增益;而在命名实体识别上,尤其是面对领域偏移时,过度约束的纠错机制反而可能限制模型的适应性,需要适当放松修正自由度。这一发现提示我们,LA-RL 的框架虽然通用,但具体的标签设计粒度和约束强度仍需针对具体任务进行调优。
讨论与可借鉴点
LA-RL 的核心贡献在于证明了任务结构先验可以作为一种有效的归纳偏置,被嵌入到结果监督的强化学习框架中,从而弥补通用自我反思机制在结构化任务上的适配缺口。这一思路的启发意义超越了单一论文的价值:当我们面对一个新的结构化输出任务时,与其从零设计过程奖励模型或依赖人工定义的修正规则,不如首先系统性地分析该任务中可能出现的典型错误模式,并以此构建诊断标签体系。
从工程视角看,LA-RL 的框架具有良好的模块化特性。诊断标签集合可以根据任务需求灵活扩展,不必拘泥于论文中定义的五类错误模式。例如,在嵌套实体识别场景下可以引入「嵌套层级冲突」标签,在事件抽取中可添加「时序逻辑矛盾」标签。这种扩展性为不同 IE 子任务的定制化提供了便利。
当然,LA-RL 也存在可进一步探索的方向。论文主要聚焦于单轮诊断-修正流程,多轮迭代纠错的效果尚未被充分探索。此外,冷启动阶段对标注模型质量的依赖,以及诊断标签体系设计本身的主观性,都是值得审慎评估的实践问题。另一个开放问题是:诊断标签的粒度是否存在理论最优区间——过粗则失去诊断意义,过细则可能导致标签噪声和训练不稳定。
总体而言,LA-RL 为大语言模型在结构化信息抽取领域的自我纠错能力提供了一条务实且有效的技术路径,其「诊断先行、修正在后」的设计哲学,或许也为其他结构化推理任务提供了可借鉴的范式参考。
摘要
大语言模型在信息抽取(IE)方面展现出很强的潜力,但现有的基于反思的纠错方法往往与结构化抽取输出存在错位。自由形式的自我反思能够标记错误,却很少能识别失败究竟属于缺失片段、错误标签、边界不匹配、无效关系类型还是论元顺序颠倒。本文提出 LA-RL(标签感知反思强化学习),一种由结果监督的框架,利用面向任务的诊断标签引导信息抽取的自我纠错。单一骨干网络首先预测抽取结果,然后诊断任务特定的错误标签,并依据诊断结果修正其输出。训练首先使用由标注模型标注的诊断数据进行冷启动监督微调,随后经过两阶段 GRPO 训练,对最终抽取质量、格式有效性以及首轮正确性进行奖励,且无需过程奖励模型。在命名实体识别、关系抽取和事件抽取上的实验表明,相较于监督微调,该方法在使用相同骨干网络时取得了一致的提升,包括在 SciER 关系抽取上平均 F1 提升 6.83,在分布外关系抽取上 F1 提升约 20,以及在 DuEE1.0 上触发词 F1 提升 14.50、论元 F1 提升 17.50。消融实验表明反思结构对任务敏感:更强的约束有利于关系抽取,而命名实体识别在领域偏移下则需要更宽松的纠错方式。
Abstract
Large language models show strong promise for information extraction (IE), but existing reflection-based correction methods are often misaligned with structured extraction outputs. Free-form self-reflection can flag an error, yet it rarely identifies whether the failure is a missing span, wrong label, boundary mismatch, invalid relation type, or reversed argument order. We introduce LA-RL (Label-Aware Reflective Reinforcement Learning), an outcome-supervised framework that guides IE self-correction with task-grounded diagnostic labels. A single backbone first predicts an extraction, diagnoses task-specific error labels, and then revises its output conditioned on the diagnosis. Training starts from diagnostic data labeled by an annotation model for cold-start supervised fine-tuning and proceeds through two GRPO stages that reward final extraction quality, format validity, and first-pass correctness, without a process reward model. Experiments on named entity recognition, relation extraction, and event extraction show consistent same-backbone gains over SFT, including 6.83 average F1 on SciER relation extraction, about 20 F1 on out-of-distribution relation extraction, and 14.80 trigger F1 plus 17.50 argument F1 on DuEE1.0. Ablations show that reflection structure is task-sensitive: stronger constraints benefit relation extraction, whereas named entity recognition needs less restrictive correction under domain shift.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。