
SeekJudge:面向计算机使用智能体强化学习的实用奖励框架
SeekJudge: A Practical Reward Framework for Reinforcement Learning in Computer-Use Agents
📝 TLDR
在计算机使用智能体训练中,轨迹是否真正完成任务决定了评估质量与强化学习奖励信号。现有规则式评估难以对齐人类意图且易随应用更新而失效,模型化评判器仍存在性能差距。SeekJudge框架通过Condense、Ground、Seek、Analyze四个角色化智能体协作完成判定,并通过种子校准蒸馏为单一9B共享骨干模型。该方法在在线强化学习中首次让模型化奖励匹配或超越规则式监督,并具备步级判断能力与更低的推理成本。
🧭 速览
计算机使用智能体的轨迹评判长期依赖规则式评估,难以对齐人类意图且易因应用更新或在线内容变化而失效。
采用Condense、Ground、Seek、Analyze四个角色化智能体通过Seek-Analyze循环达成判定,并经种子校准蒸馏为单一9B共享骨干模型。
在在线强化学习下游成功率上首次匹配或超越原生规则式监督,支持步级判断,单次调用成本远低于闭源大模型。
使模型化奖励成为计算机使用智能体强化学习中规则式监督的实用替代方案。
🆚 方法对比
SeekJudge
- 首个在线RL中匹配/超越规则奖励的模型奖励
- 单次调用上下文小,可扩展至超长轨迹
- 9B开源模型,成本比闭源低数百倍
- Seek-Analyze循环解耦定位与提取,提升精度
- 四智能体编排复杂,工程实现门槛较高
- 依赖种子校准蒸馏管线训练专用9B模型
- 多轮循环设计增加推理延迟开销
- 主要在Impress等基准验证,泛化待考
Rule-based Evaluation
- 判据明确,执行快,零模型推理开销
- 结果一致可复现,适合离线软件评测
- 无需大模型,部署成本极低
- 难以对齐人类意图,存在系统性分歧
- 仅覆盖少量应用,应用更新即失效
- 预定义答案随在线内容漂移而过时
- 无法处理开放式任务如画图等
Existing Model-based Judges
- 端到端单次前向,实现相对简单
- 可处理多样化轨迹与开放式指令
- 意图对齐能力优于纯规则方法
- 多图涌入单上下文,稀释决定性证据
- 与规则评判仍存在性能差距
- 依赖闭源大模型时成本高昂
- 上下文长度受限,难以处理长轨迹
CUAStepBench
- 密集人工标注,支持步骤级细粒度评测
- 包含Long版本,专为长轨迹设计
- 填补CUA步骤级评估基准空白
- 标注成本高昂,难以大规模扩展
- 覆盖应用领域有限,泛化性待验证
规则方法快速一致但易过时且对齐差,现有模型评判证据稀释且成本高;SeekJudge通过Seek-Analyze解耦循环与单9B蒸馏模型,首次在在线RL中实现与规则监督匹配或超越。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
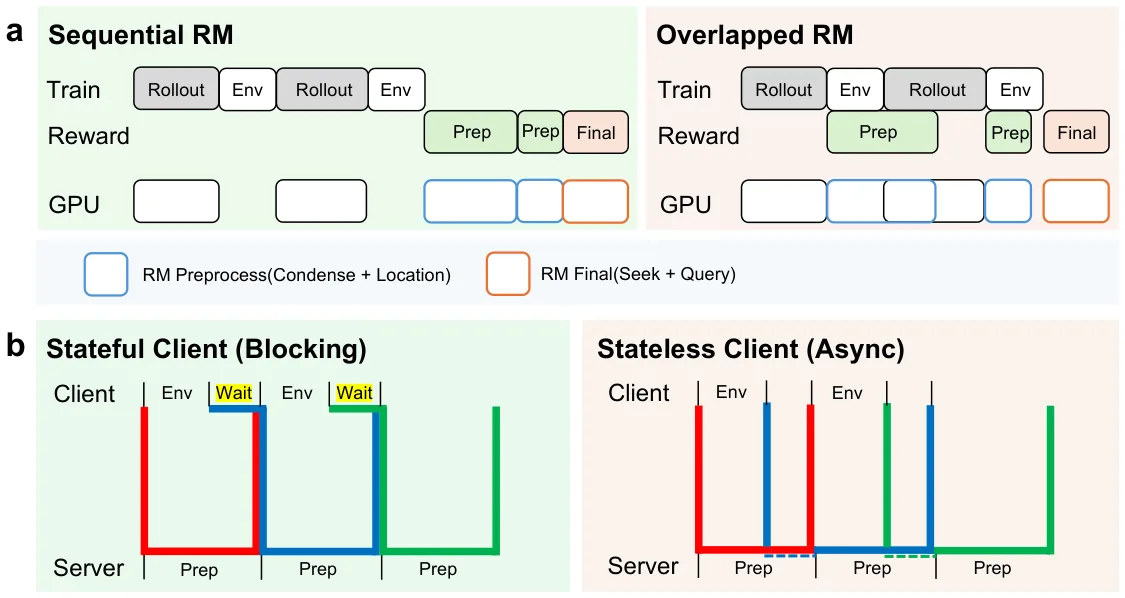
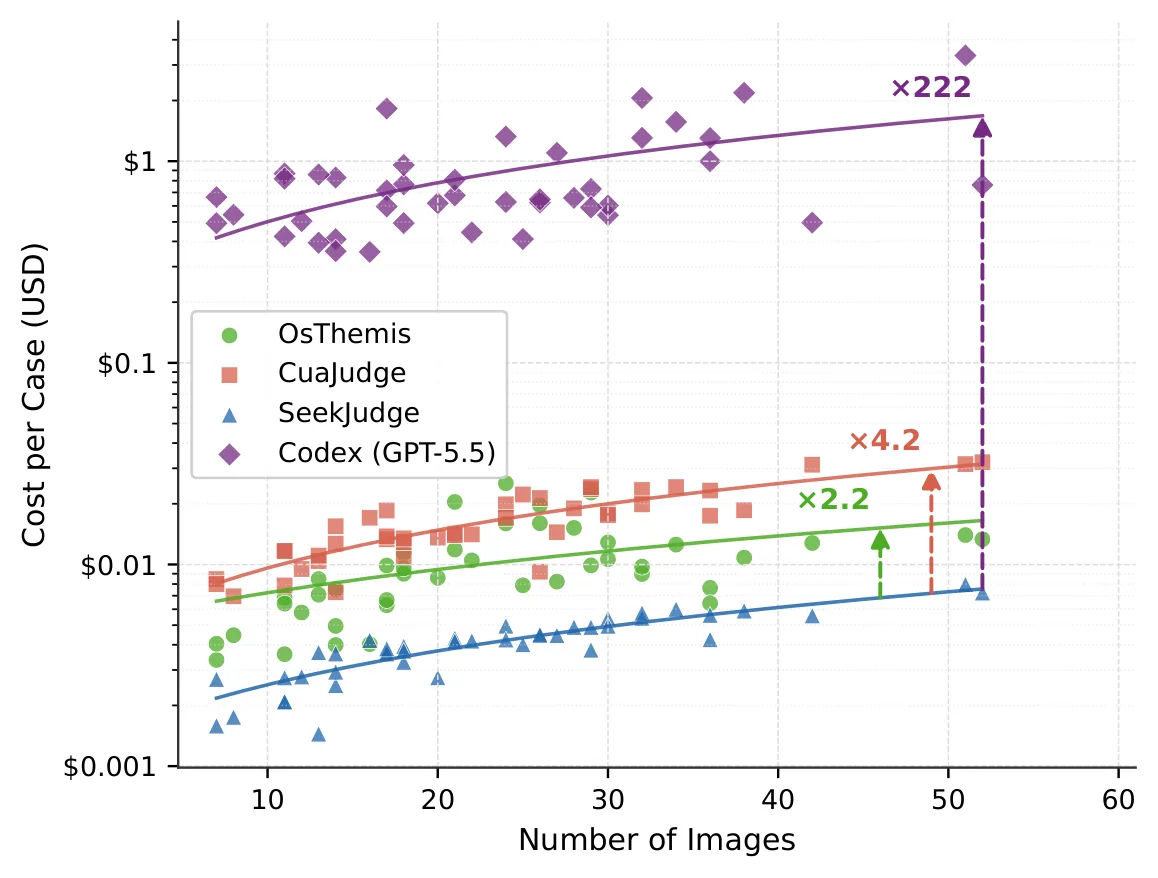
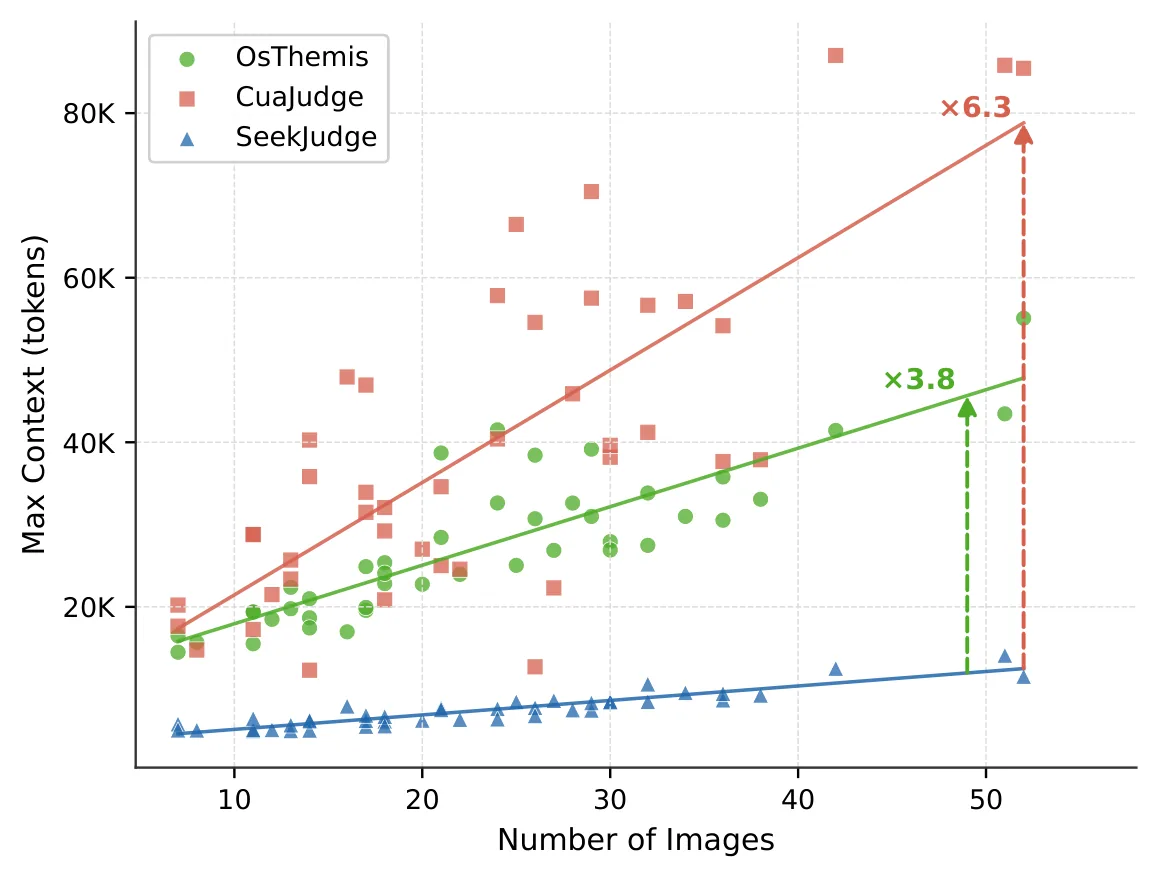
TL;DR
SeekJudge 框架通过四个角色化智能体(Condense、Ground、Seek、Analyze)的协作实现了轨迹判定,并将其蒸馏为单一 9B 参数模型。在在线强化学习实验中,该模型首次让基于模型的奖励信号在下游任务成功率上匹敌甚至超越了传统规则式监督,同时具备步级判断能力与显著更低的推理成本。
研究背景与动机
在训练计算机使用智能体(Computer-Use Agent)时,一个核心问题始终悬而未决:如何判断智能体生成的动作序列是否真正完成了用户指令?这不仅关乎评测的公平性,更决定了强化学习过程中奖励信号的质量。
传统的解决思路是依赖[[规则式评估]]——针对每个任务预设一套人工定义的检查规则。例如,若指令是“打开设置菜单并关闭蓝牙”,规则会检查最终状态是否满足特定条件。这种方式在小规模、固定场景下表现尚可,但面临两个根本性困境:其一,规则难以穷尽人类意图的细微差别,容易产生语义上的错位;其二,当应用版本更新或网页内容发生漂移时,预先编写的规则会瞬间失效,维护成本极高。
学术界随后转向[[基于模型的评判方法]],即训练一个模型来模仿人类判断轨迹是否正确。这类方法理论上更灵活,能捕捉语义层面的完成度,但早期研究始终存在一个令人不安的现象:模型化评判器的性能总是落后于规则式评估几个百分点。在强化学习的高杠杆场景下,这微小的差距会被放大,导致最终训练出的智能体表现不如直接使用规则监督的对手。
SeekJudge 的切入点是重新审视“判断”这一认知过程本身。当人类评判一条轨迹时,通常不是直接给出结论,而是反复审视状态、回顾关键步骤、搜索遗漏信息。这种[[迭代式推理]]的思路能否被显式建模并压缩到一个高效的专用模型中?
方法
SeekJudge 框架的核心洞察是:判断轨迹完成度不是一次性的分类决策,而是一个信息逐步聚合的过程。基于这一认知,框架设计了四个角色专精的智能体:
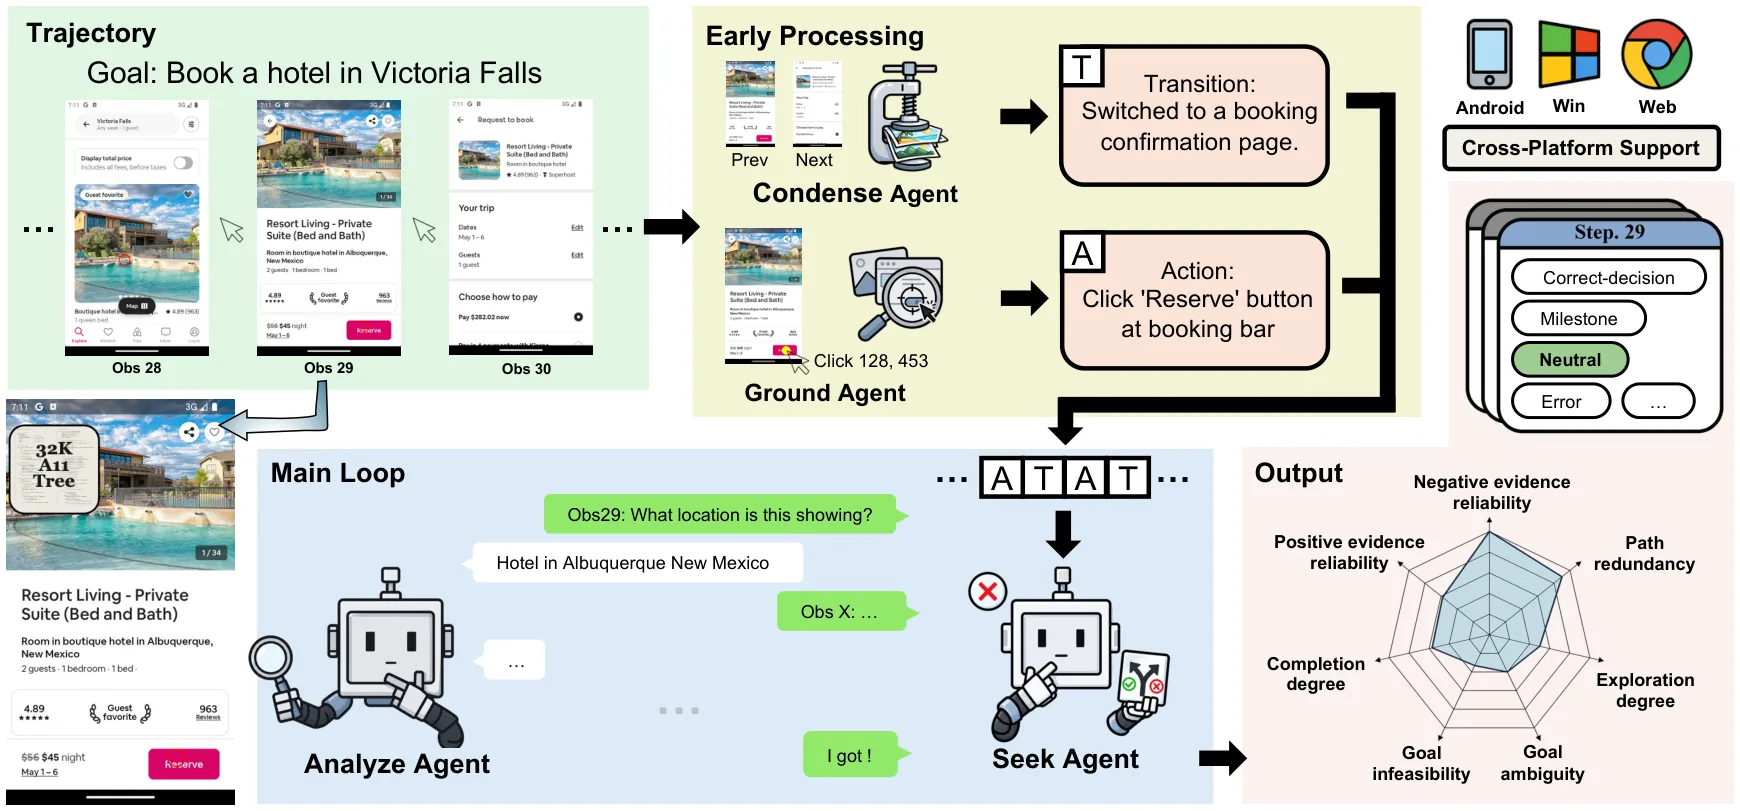
Condense(压缩) 负责从冗长的轨迹中提取关键状态快照,将原始观测压缩为语义浓缩的摘要;Ground(锚定) 将这些摘要与原始指令对齐,建立“当前走到哪一步”的基准;Seek(搜索) 在压缩后的信息中主动寻找可能遗漏的关键环节或潜在错误点;Analyze(分析) 综合前三者的输出,形成最终判定并给出置信度。
这四个智能体通过一个[[Seek-Analyze 循环]]协同工作。具体而言,Seek 组件在每一轮迭代中提出假设性的检查方向,Analyze 则结合 Ground 建立的基准评估这些假设是否成立,Condense 根据分析结果动态调整信息粒度。这一循环可以类比为人类专家审阅代码时的“反复推敲”过程——不是一蹴而就,而是迭代精化判断。
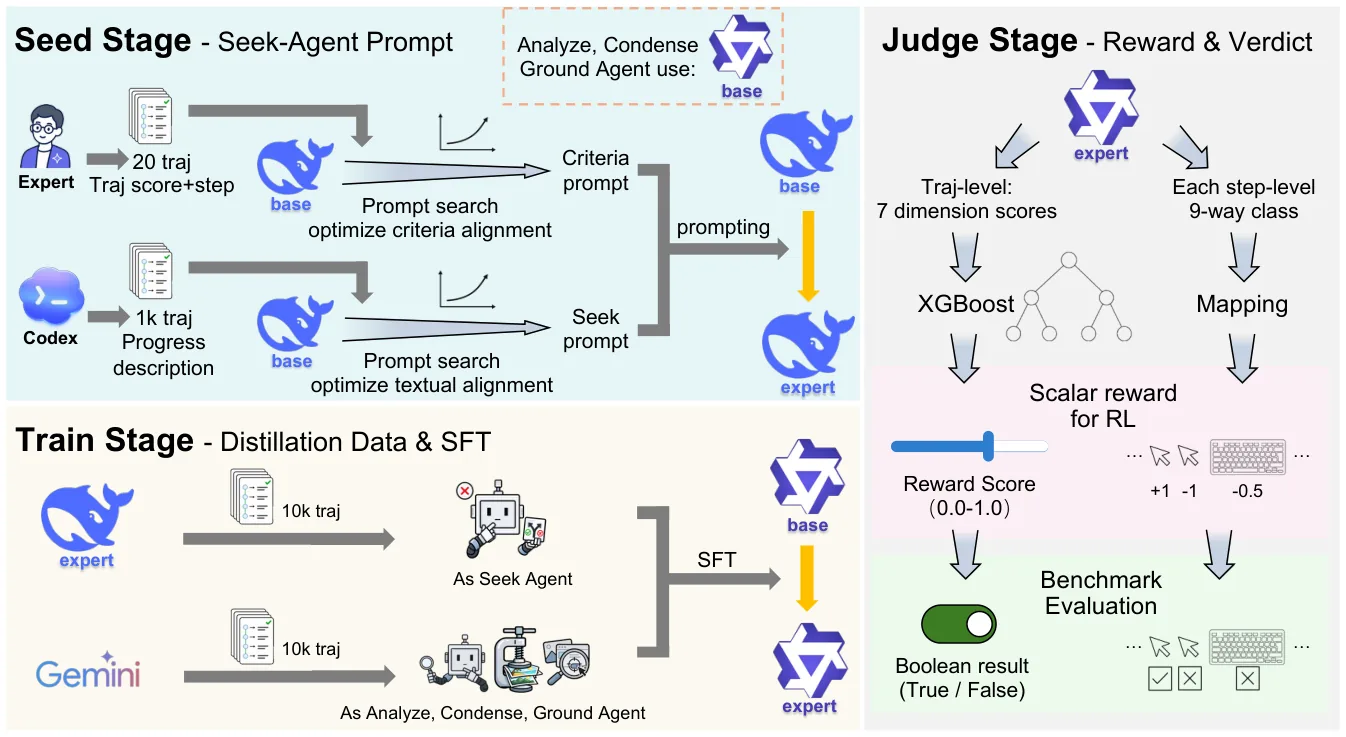
为了让四个智能体真正协同运作而非各行其是,研究团队设计了种子校准蒸馏流程。该流程的核心思想是:首先用强大的闭源大模型扮演四智能体的协调角色,在大量标注轨迹上记录其决策轨迹;随后将这些决策序列作为监督信号,训练一个 9B 参数的共享主干网络。通过这种方式,原本分散在四个模块中的复杂推理被压缩到一个统一模型中,每个角色不再是独立的实体,而是模型内部的不同“思维模式”。
值得注意的是,这一设计直接服务于[[强化学习]]中的实用性需求:单次调用的上下文窗口被严格控制,使得系统能够处理远超常规的轨迹长度,同时每次判定耗时控制在可接受范围内。
实验与结果
研究团队在在线强化学习场景下评估 SeekJudge 的效果。选择在线 RL 作为测试床的原因是:离线评估中评判器的优劣难以直接体现在智能体行为上,只有将评判器接入 RL 训练循环,才能真正验证其作为奖励信号的实用价值。
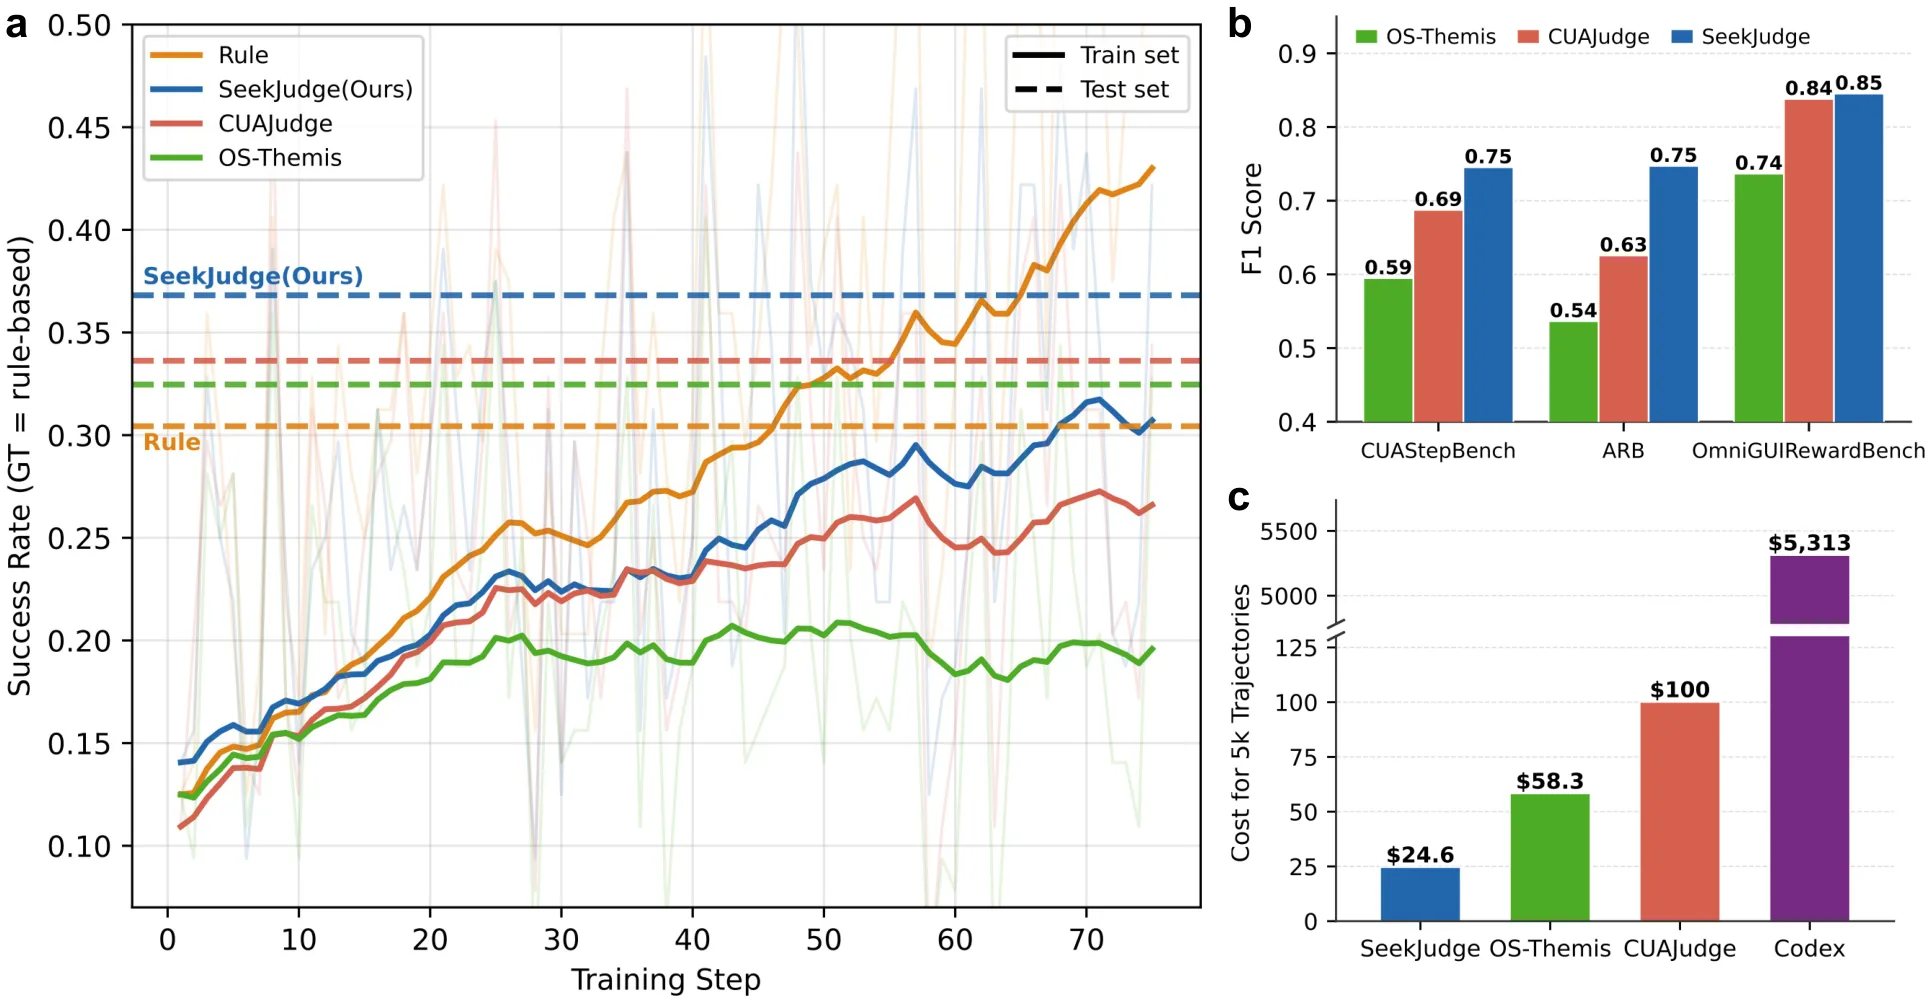
实验采用留出测试目标(held-out RL test goals),确保评判器未见过来自训练分布的数据。结果显示,SeekJudge 在该设置下首次实现了与规则式监督的帕累托最优——不仅准确率相当,而且在某些任务类型上显著超越规则基准。这打破了“模型化奖励必然不如规则监督”的固有认知。
除准确性外,论文还报告了三个关键指标的优势:步级判断能力允许在轨迹中途给出过程性反馈,而非仅在终点给出二值结果;推理成本相比 GPT-4 等闭源方案降低一个数量级;上下文效率使得单次调用的 token 消耗保持在低位,这对长轨迹场景尤为关键。
此外,团队贡献了一项奖励服务器架构改进,通过减少判定过程中的冗余通信进一步压缩延迟,使整个系统在高频 RL 训练场景中具备可行性。
讨论与可借鉴点
SeekJudge 展示了将复杂认知过程模块化、再通过蒸馏压缩为高效模型的技术路径。其局限在于:蒸馏过程中使用的闭源大模型仍是性能上限的天花板,且角色化设计是否对所有任务类型都是最优解仍有探索空间。
对于[[计算机使用智能体]]领域的研究者,SeekJudge 的启发在于:评判器不应被视为评测工具的附属品,而应作为 RL 训练的核心基础设施被单独优化。四智能体协作框架进一步暗示,未来可能存在更通用的“评判即服务”范式,使模型化奖励真正成为规则化监督的可插拔替代方案。
摘要
如何判定一条轨迹是否真正完成了对应指令,决定了我们如何在长时域图形用户界面任务中衡量计算机使用智能体,以及如何通过强化学习训练它们。长期以来,这种判定依赖于基于规则的评估,但规则评估难以与人类意图对齐,并且在应用更新或在线内容发生漂移时便会失效。已有的基于模型的评判方法试图解决这些问题,但与基于规则的评估之间仍存在性能差距。我们提出了 \textbf{SeekJudge} 框架,由四个角色专精的智能体——Condense、Ground、Seek 和 Analyze——通过在轨迹上进行的 Seek–Analyze 循环达成判定。一个经过种子标定蒸馏的流程训练出一个 90 亿参数的专用模型,作为四个智能体的共享主干网络。以在线强化学习在留出测试目标上的下游成功率衡量,SeekJudge 是首个在在线强化学习中能够匹敌或超越原生规则化监督的实用化基于模型的奖励。除了准确性之外,SeekJudge 还能提供逐步判定,运行时成本远低于闭源大模型,并且每次调用的上下文较小,可扩展至更长的轨迹。我们进一步对奖励服务器做出了一项通用架构改进,加速了强化学习中的判定过程。这些改进共同使基于模型的奖励成为计算机使用智能体强化学习中规则化监督的实用即插即用替代方案。
Abstract
Deciding whether a trajectory actually fulfills its instruction governs how we measure computer-use agents on long-horizon graphical-user-interface tasks and how we train them with reinforcement learning. This judgment has long relied on rule-based evaluation, which struggles to align with human intention and goes stale when an app updates or its online content drifts. Existing model-based judges attempt to address these problems but still leave a performance gap to the rule-based evaluation. We propose the \textbf{SeekJudge} framework, in which four role-specialized agents, a Condense, a Ground, a Seek and an Analyze agent, reach a verdict through a Seek--Analyze loop over the trajectory. A seed-calibrated distillation pipeline trains one specialized B model to serve as the shared backbone for all four agents. Measured by downstream success rate on held-out RL test goals, SeekJudge is the first practical model-based reward to match or surpass native rule-based supervision in online RL. Beyond accuracy, SeekJudge provides step-level judgments, runs far cheaper than a closed-source large model, and keeps a small per-call context that scales to much longer trajectories. We further contribute a general architectural improvement to the reward server that speeds up judging in RL. Together these make model-based reward a practical drop-in for rule-based supervision in CUA reinforcement learning.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。