
📝 TLDR
在线策略评估是风险敏感强化学习的核心难题,现有方法要么局限于特定风险度量类,要么依赖模拟器,难以应用于完全在线场景。本文提出面向动态效用基缺口风险(UBSR)的在线评估算法UBSR-TD,采用线性函数逼近,并建立几乎处处收敛性证明及加速变体。核心发现是经典风险中性TD算法可通过在时序差分误差中嵌入损失函数直接推广至UBSR场景。数值实验与易腐库存管理应用验证了方法的有效性。
🧭 速览
现有风险敏感策略评估方法受限于风险度量类别或依赖模拟器,难以在完全在线条件下应用。
提出UBSR-TD算法及加速变体,基于线性函数逼近,将损失函数嵌入时序差分误差以适配动态UBSR。
理论上证明UBSR-TD几乎处处收敛,数值实验与易腐库存应用验证了算法的有效性。
建立了风险中性TD方法向动态UBSR场景的统一推广框架,拓展了在线风险评估的适用范围。
🆚 方法对比
UBSR-TD
- 首个动态UBSR下完全在线策略评估算法
- 证明几乎处处收敛,理论保证强
- 自然扩展TD(0),只需修改TD误差中的损失函数
- 无需模拟器,完全在线适用
- 仅限线性函数近似,表达能力有限
- 继承TD类算法对超参数敏感的问题
- 动态UBSR一般缺乏相容性,分析难度大
- 未在非线性近似下验证
UBSR-TD变体(加速版)
- 利用历史和梯度信息加速收敛
- 多种风险与参数设置下均改善收敛速度
- 与基础UBSR-TD框架兼容,易于集成
- 增加算法复杂度与实现难度
- 可能引入额外超参数需调优
- 加速效果可能因场景而异
TD(0)
- 理论基础扎实,实现简单
- 风险中性MDP策略评估的经典方法
- 支撑后续大量TD类算法发展
- 仅适用于风险中性场景
- 对超参数敏感,收敛可能缓慢
- 无法处理动态UBSR等风险度量
现有ERM/相容性风险度量方法
- 分析上易于处理,理论成熟
- 在金融等领域有广泛应用
- 与凸优化工具结合紧密
- 风险类别受限,无法捕捉多样化偏好
- 多依赖模拟器采样,非完全在线
- 动态版本在函数近似下收敛性未证
Shen et al. (2014)动态UBSR Q-learning
- 支持动态UBSR的在线学习
- 考虑一般损失函数,灵活性高
- 扩展了UBSR在RL中的应用
- 缺少函数近似版本,维度扩展困难
- 未证明几乎处处收敛性
- 不适用于大规模状态空间
本文核心贡献UBSR-TD及加速变体填补了动态UBSR在完全在线线性函数近似策略评估的空白,相比现有ERM/相容性风险方法更灵活且无需模拟器,相比Shen et al.(2014)的Q-learning增加了函数近似能力与收敛性保证,而TD(0)则作为风险中性的经典基线被自然扩展。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 7 张)
展开查看 7 张图
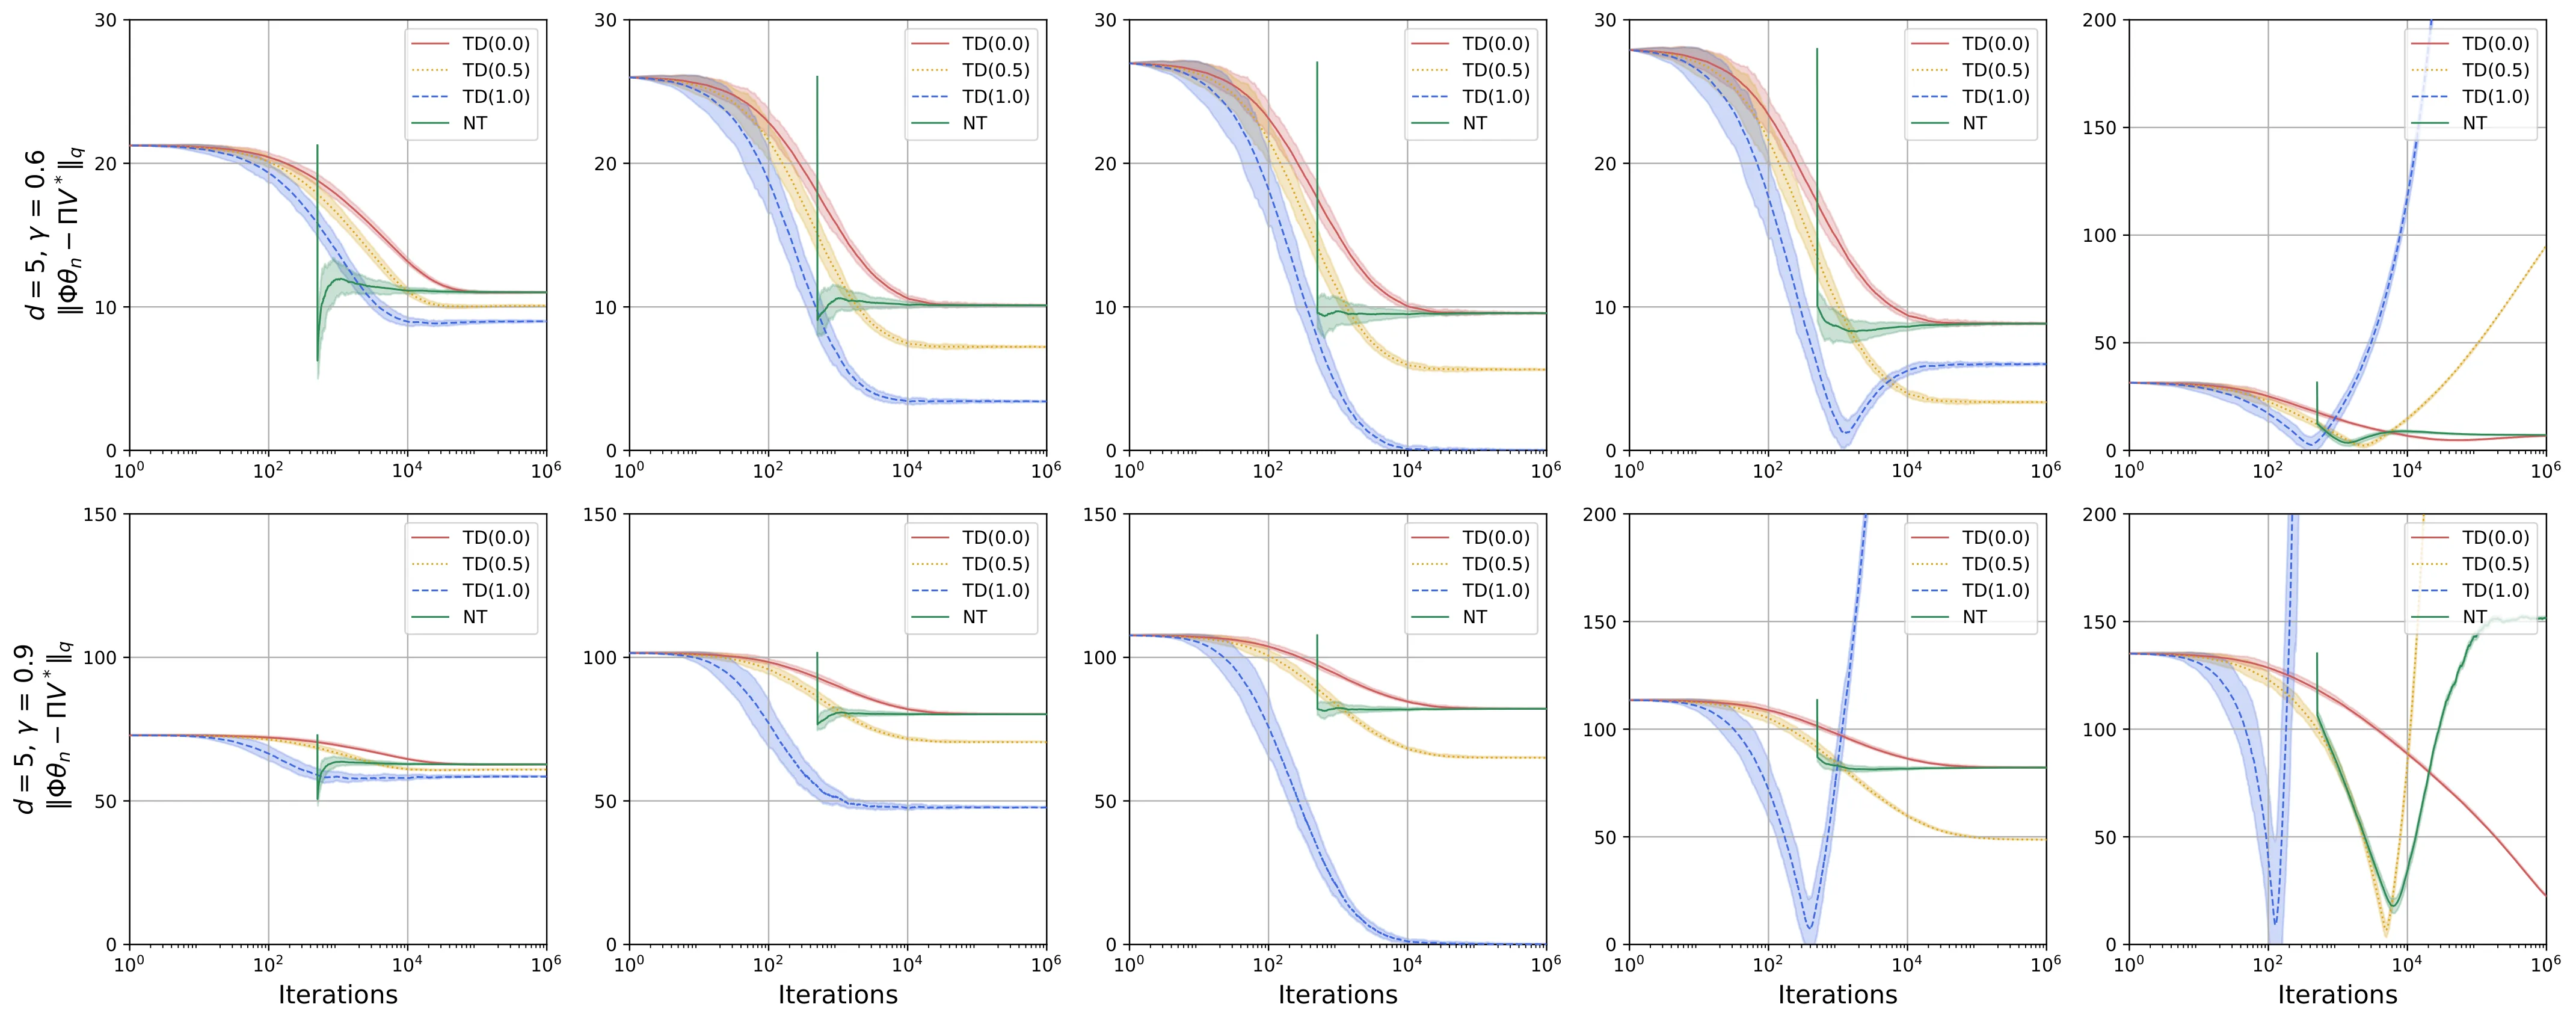
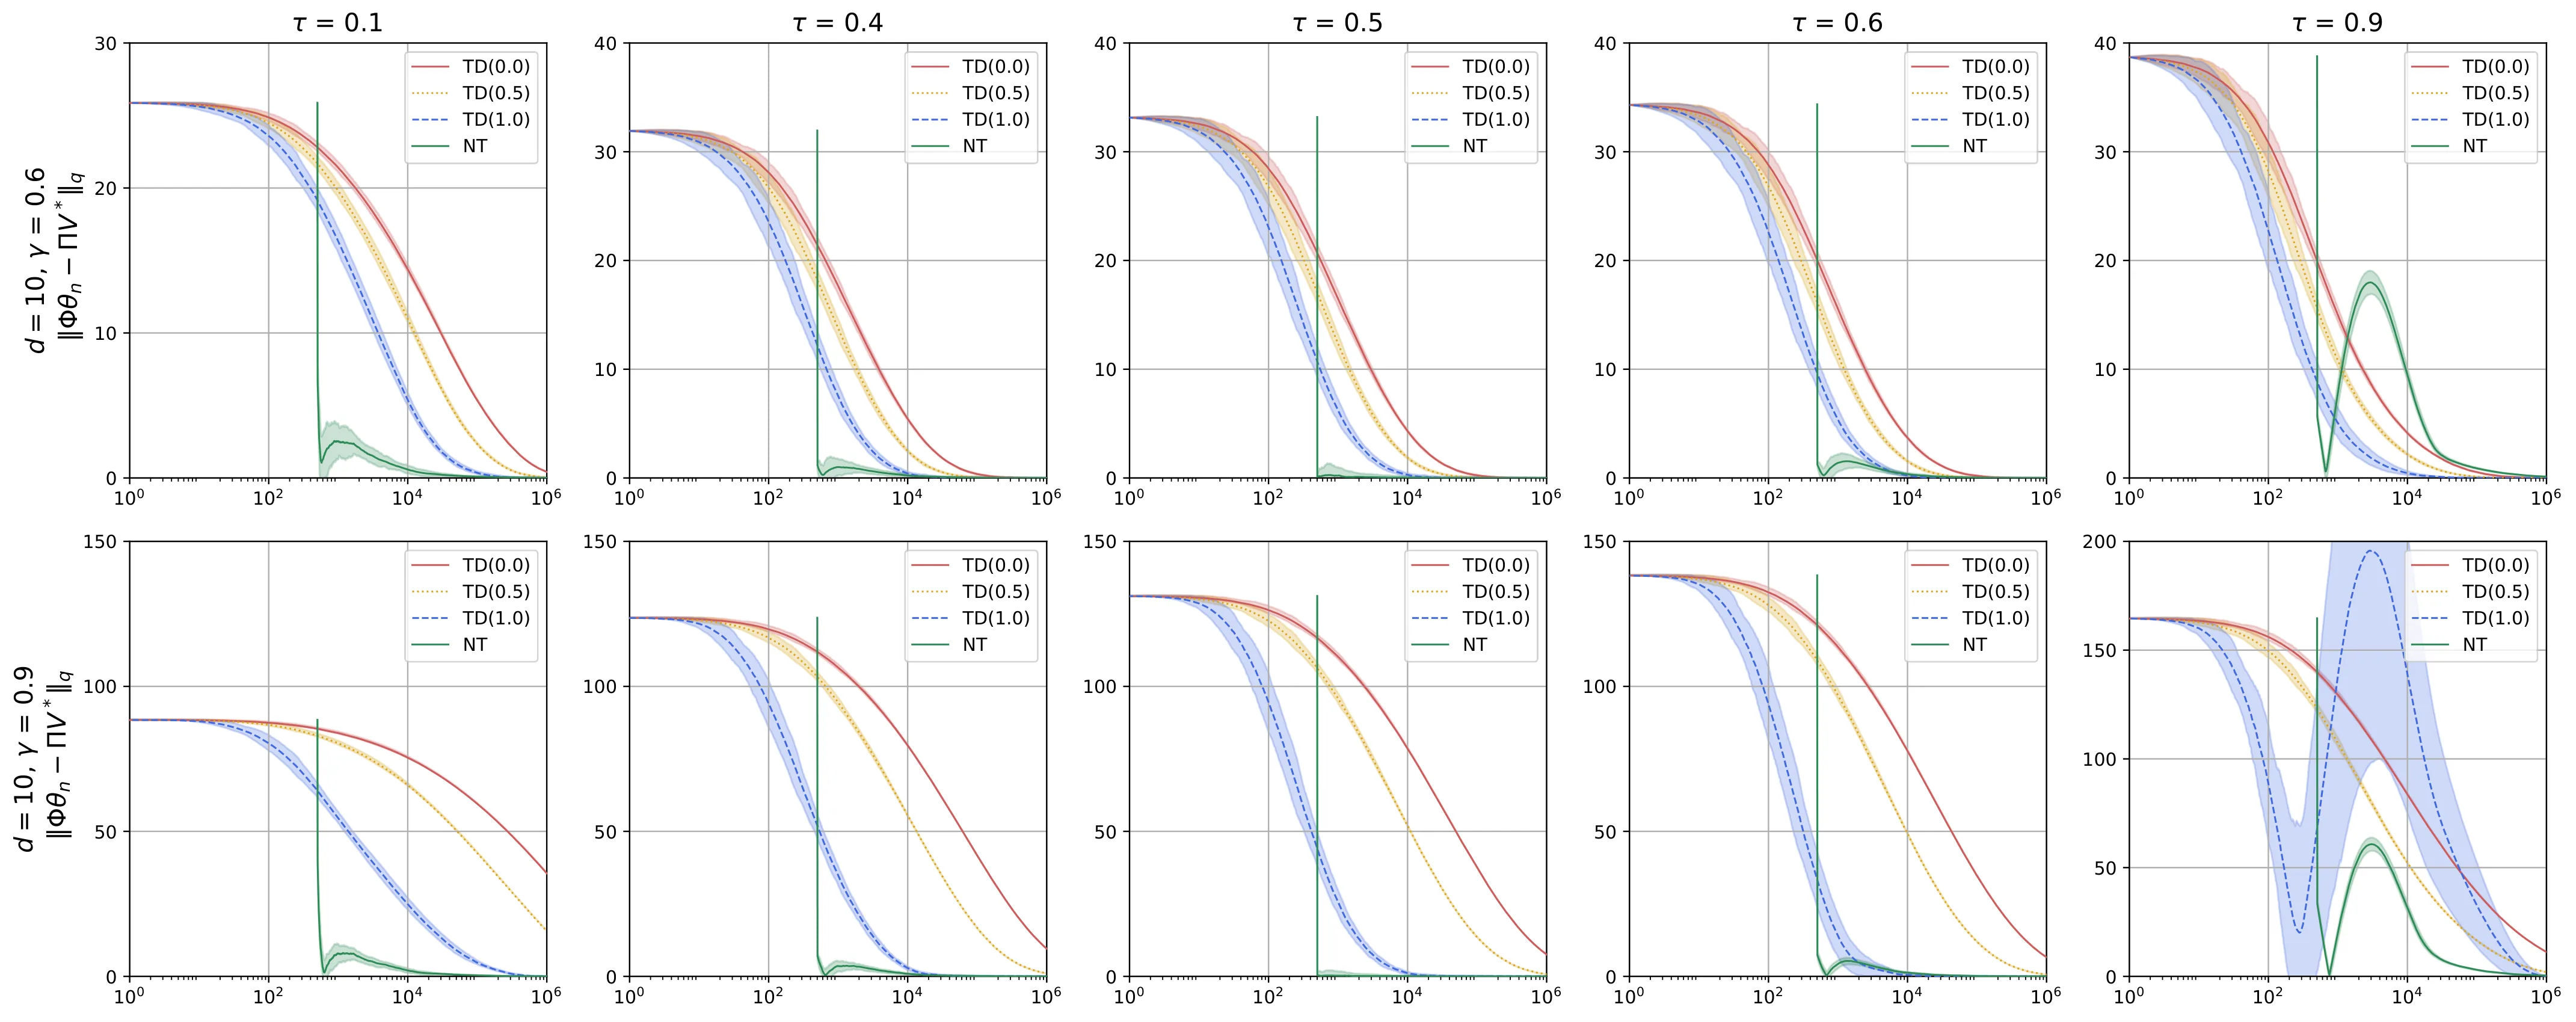
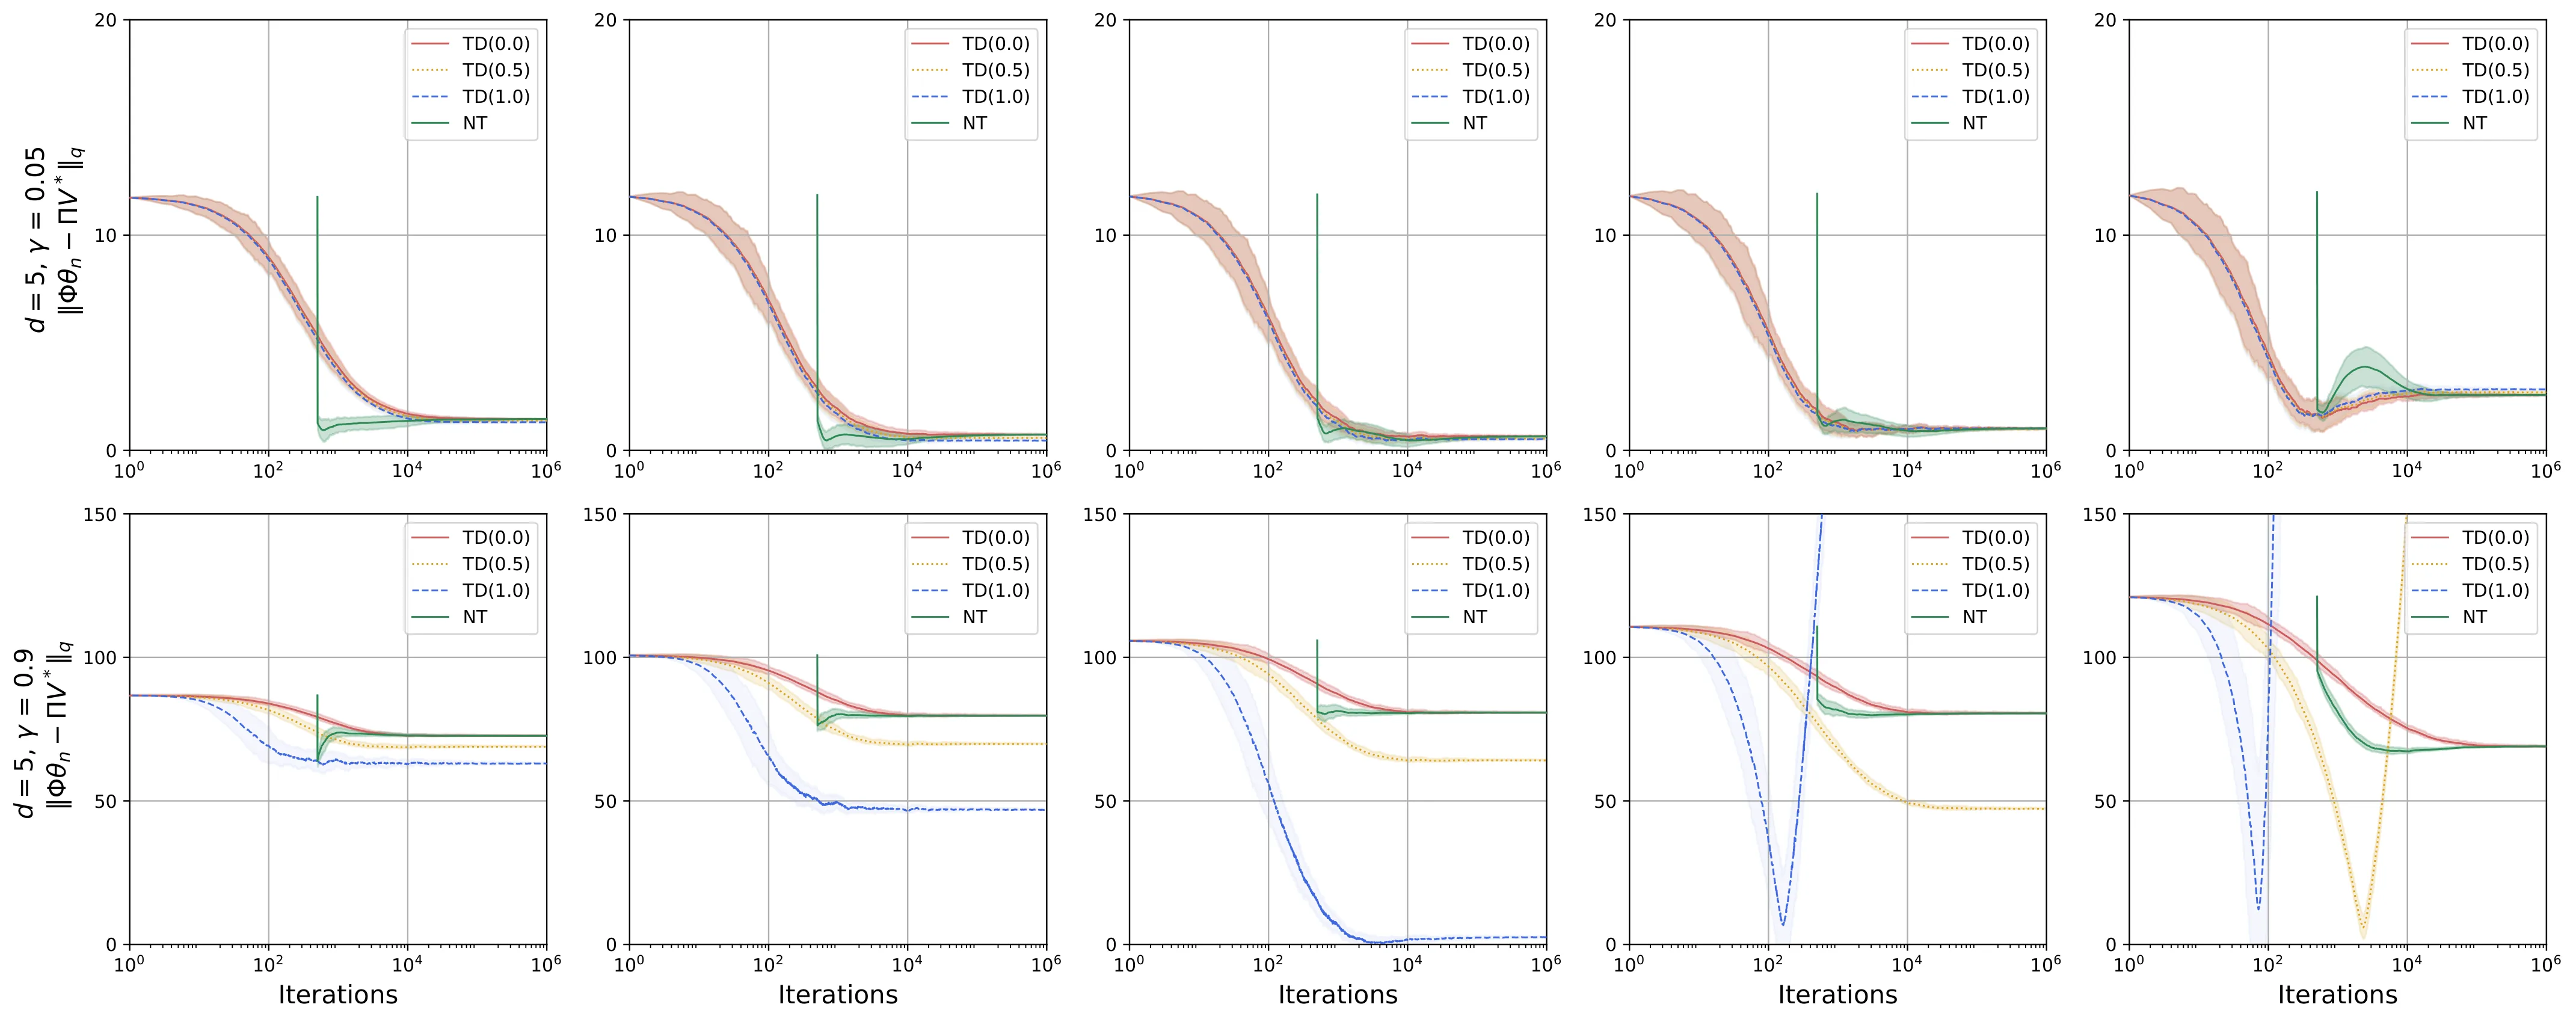
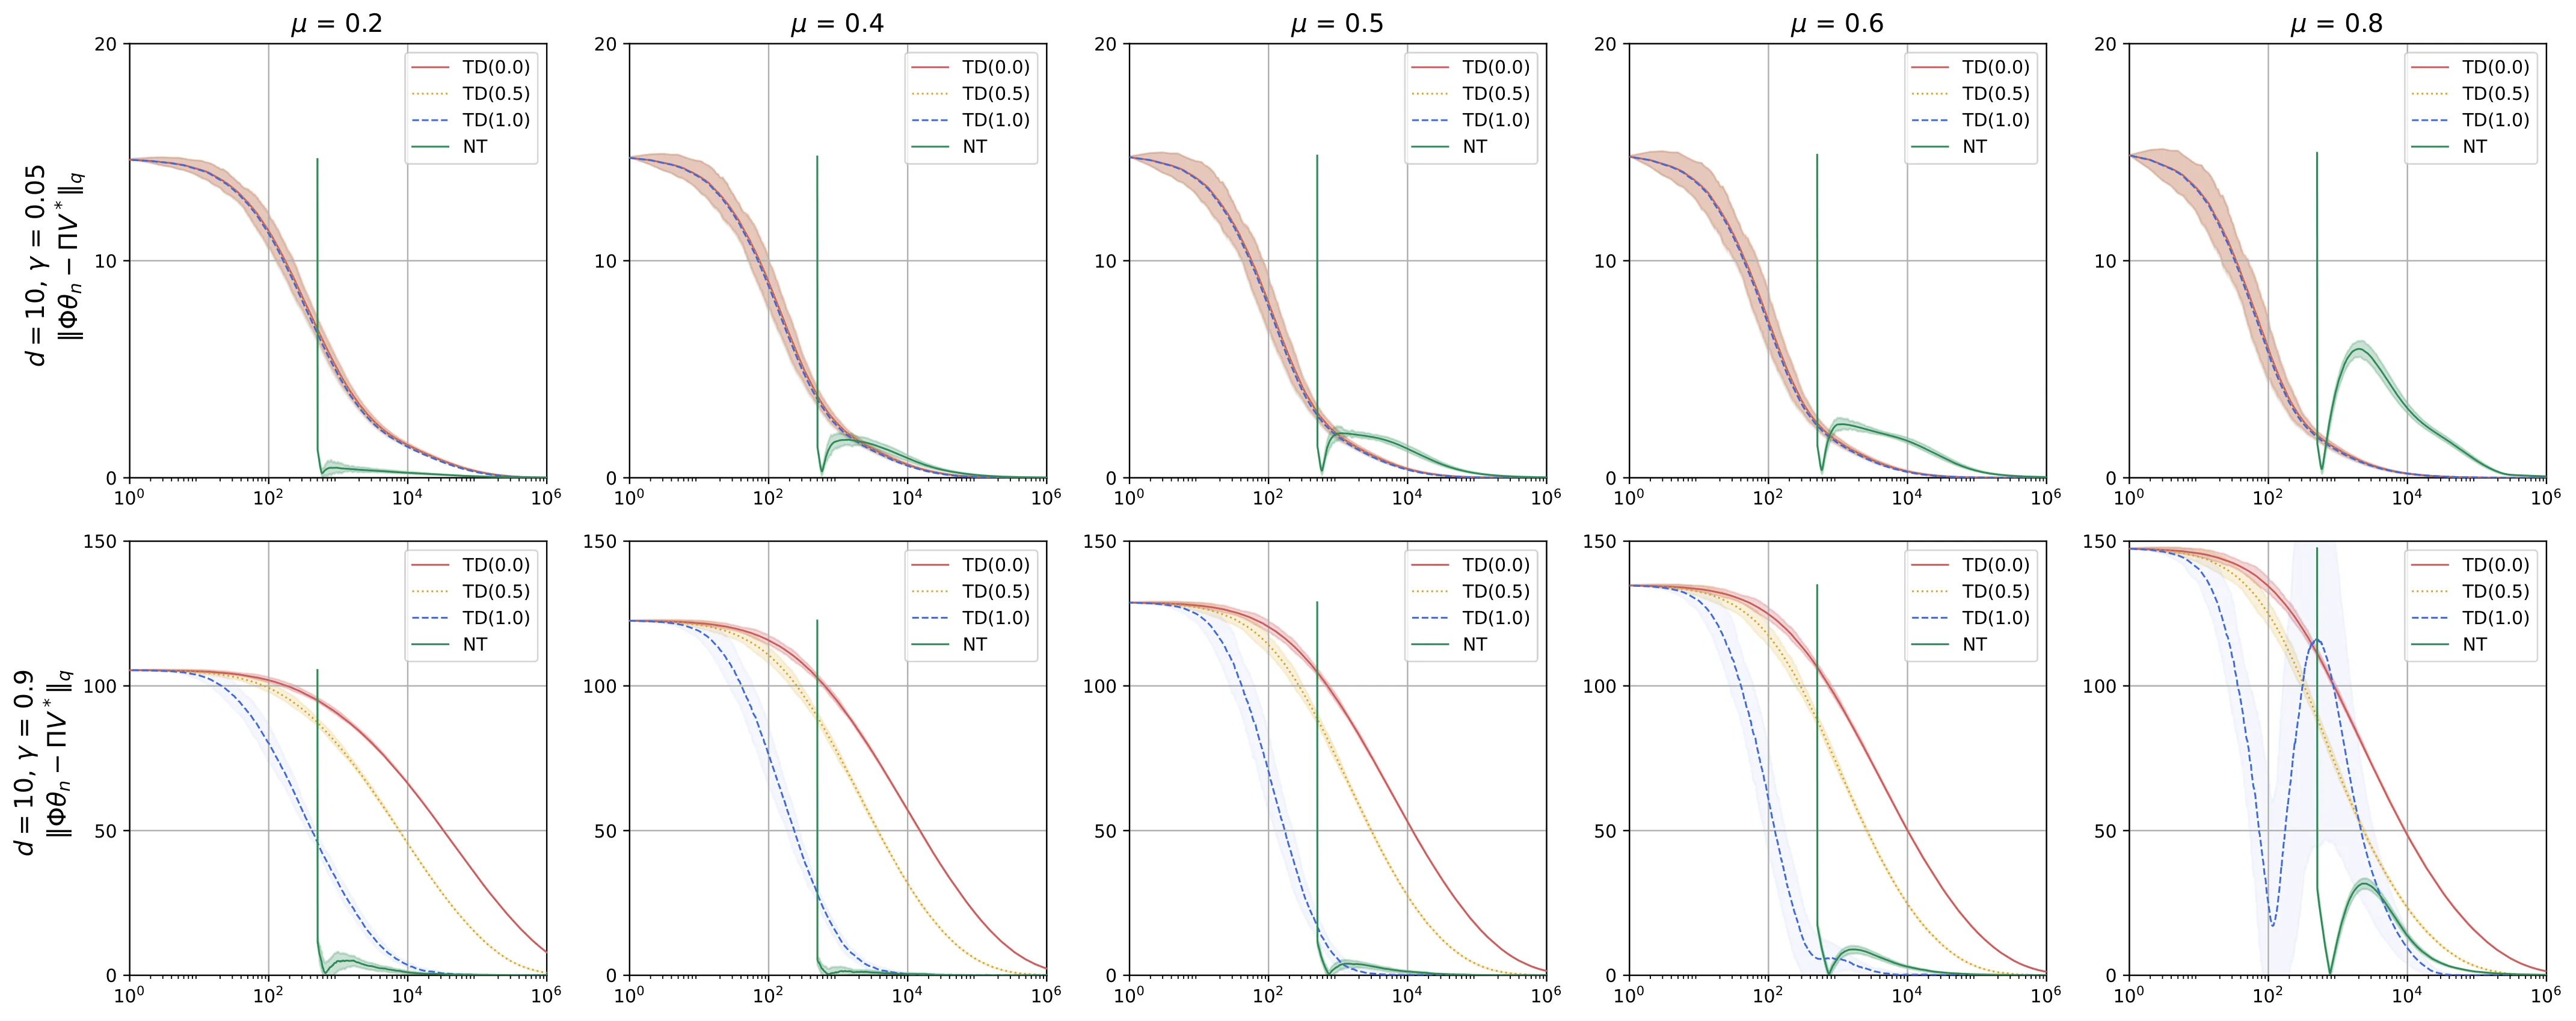
TL;DR
这篇论文针对风险敏感强化学习中的在线策略评估问题,提出了 UBSR-TD 算法。该方法将效用基缺口风险(UBSR)测度引入马尔可夫决策过程框架,在线性函数逼近条件下实现了高效在线学习。核心创新在于通过将损失函数嵌入时序差分误差,使经典的风险中性 TD 算法能够直接推广到动态 UBSR 场景。论文在理论上建立了几乎处处收敛性保证,并通过易腐库存管理问题的应用验证了方法的实用价值。
研究背景与动机
策略评估是强化学习的基础问题,其目标在于估计给定策略的价值函数。在风险中性的标准设定下,[[时序差分]](TD)算法及其变体已经建立了完善的理论基础与高效的计算框架。然而,现实决策场景中的风险因素往往不可忽视——金融投资需要控制下行风险、库存管理需要应对过期损耗、自动驾驶需要保证安全底线。这些应用场景要求算法能够处理风险敏感的优化目标,而非仅仅最大化期望累积回报。
风险测度的选择是这一问题的核心。现有方法大致分为两类:一类基于条件风险价值(CVaR)等风险度量,但这些方法往往受限于特定的数学形式,难以统一处理;另一类依赖模拟器访问,无法在完全在线、仅与环境交互的场景下部署。这一矛盾在实践中尤为突出——许多真实系统(如供应链、机械控制)只能实时采集数据,无法预先构建仿真模型。
本文的切入点正是这一空白。论文聚焦于效用基缺口风险(UBSR)这一风险测度,它具有良好的决策理论基础,能够捕捉决策者对损失的真实偏好。与 CVaR 等风险度量相比,UBSR 具有更清晰的效用解释,同时保留了动态一致性——这对于序贯决策问题至关重要。然而,如何在完全在线、无模拟器的设定下,对具有 UBSR 测度的 MDP 进行高效的策略评估,仍是一个未被充分解决的难题。
方法
论文的核心贡献在于提出 UBSR-TD 算法,实现了对动态 UBSR 测度 MDP 的在线策略评估。这一算法的设计哲学简洁而深刻:经典的风险中性 TD 算法可以通过在时序差分误差中嵌入损失函数,直接推广到风险敏感场景。
让我们从标准 TD 算法的更新规则出发。设状态价值函数的参数化近似为 ,其中 为状态特征向量, 为待学习参数。在风险中性设定下,TD 算法通过最小化时序差分误差来更新参数:
UBSR-TD 的关键思想是将 UBSR 损失函数融入这一框架。UBSR 测度本质上是度量价值函数与某个基准之间的“缺口”,其形式可以理解为对负向偏离的加权惩罚。论文证明,通过定义一个适当的损失函数 ,可以将 UBSR 下的策略评估问题转化为最小化修正后的时序差分误差:
这一转化使得 UBSR-TD 的更新规则与标准 TD 保持相同的形式,只是用 替代了原有的 。论文进一步建立了UBSR-TD 几乎处处收敛的条件,主要依赖于标准TD收敛理论中的常见假设:步长序列满足 Robbins-Monro 条件、特征映射满足持续激励条件、以及目标策略关于状态分布的遍历性。
为加速收敛,论文还提出了多个变体,包括使用批量更新策略的 UBSR-TD() 以及结合了重要性采样权重的修正版本。这些变体在保持理论收敛保证的同时,能够更有效地利用样本信息。
实验与结果
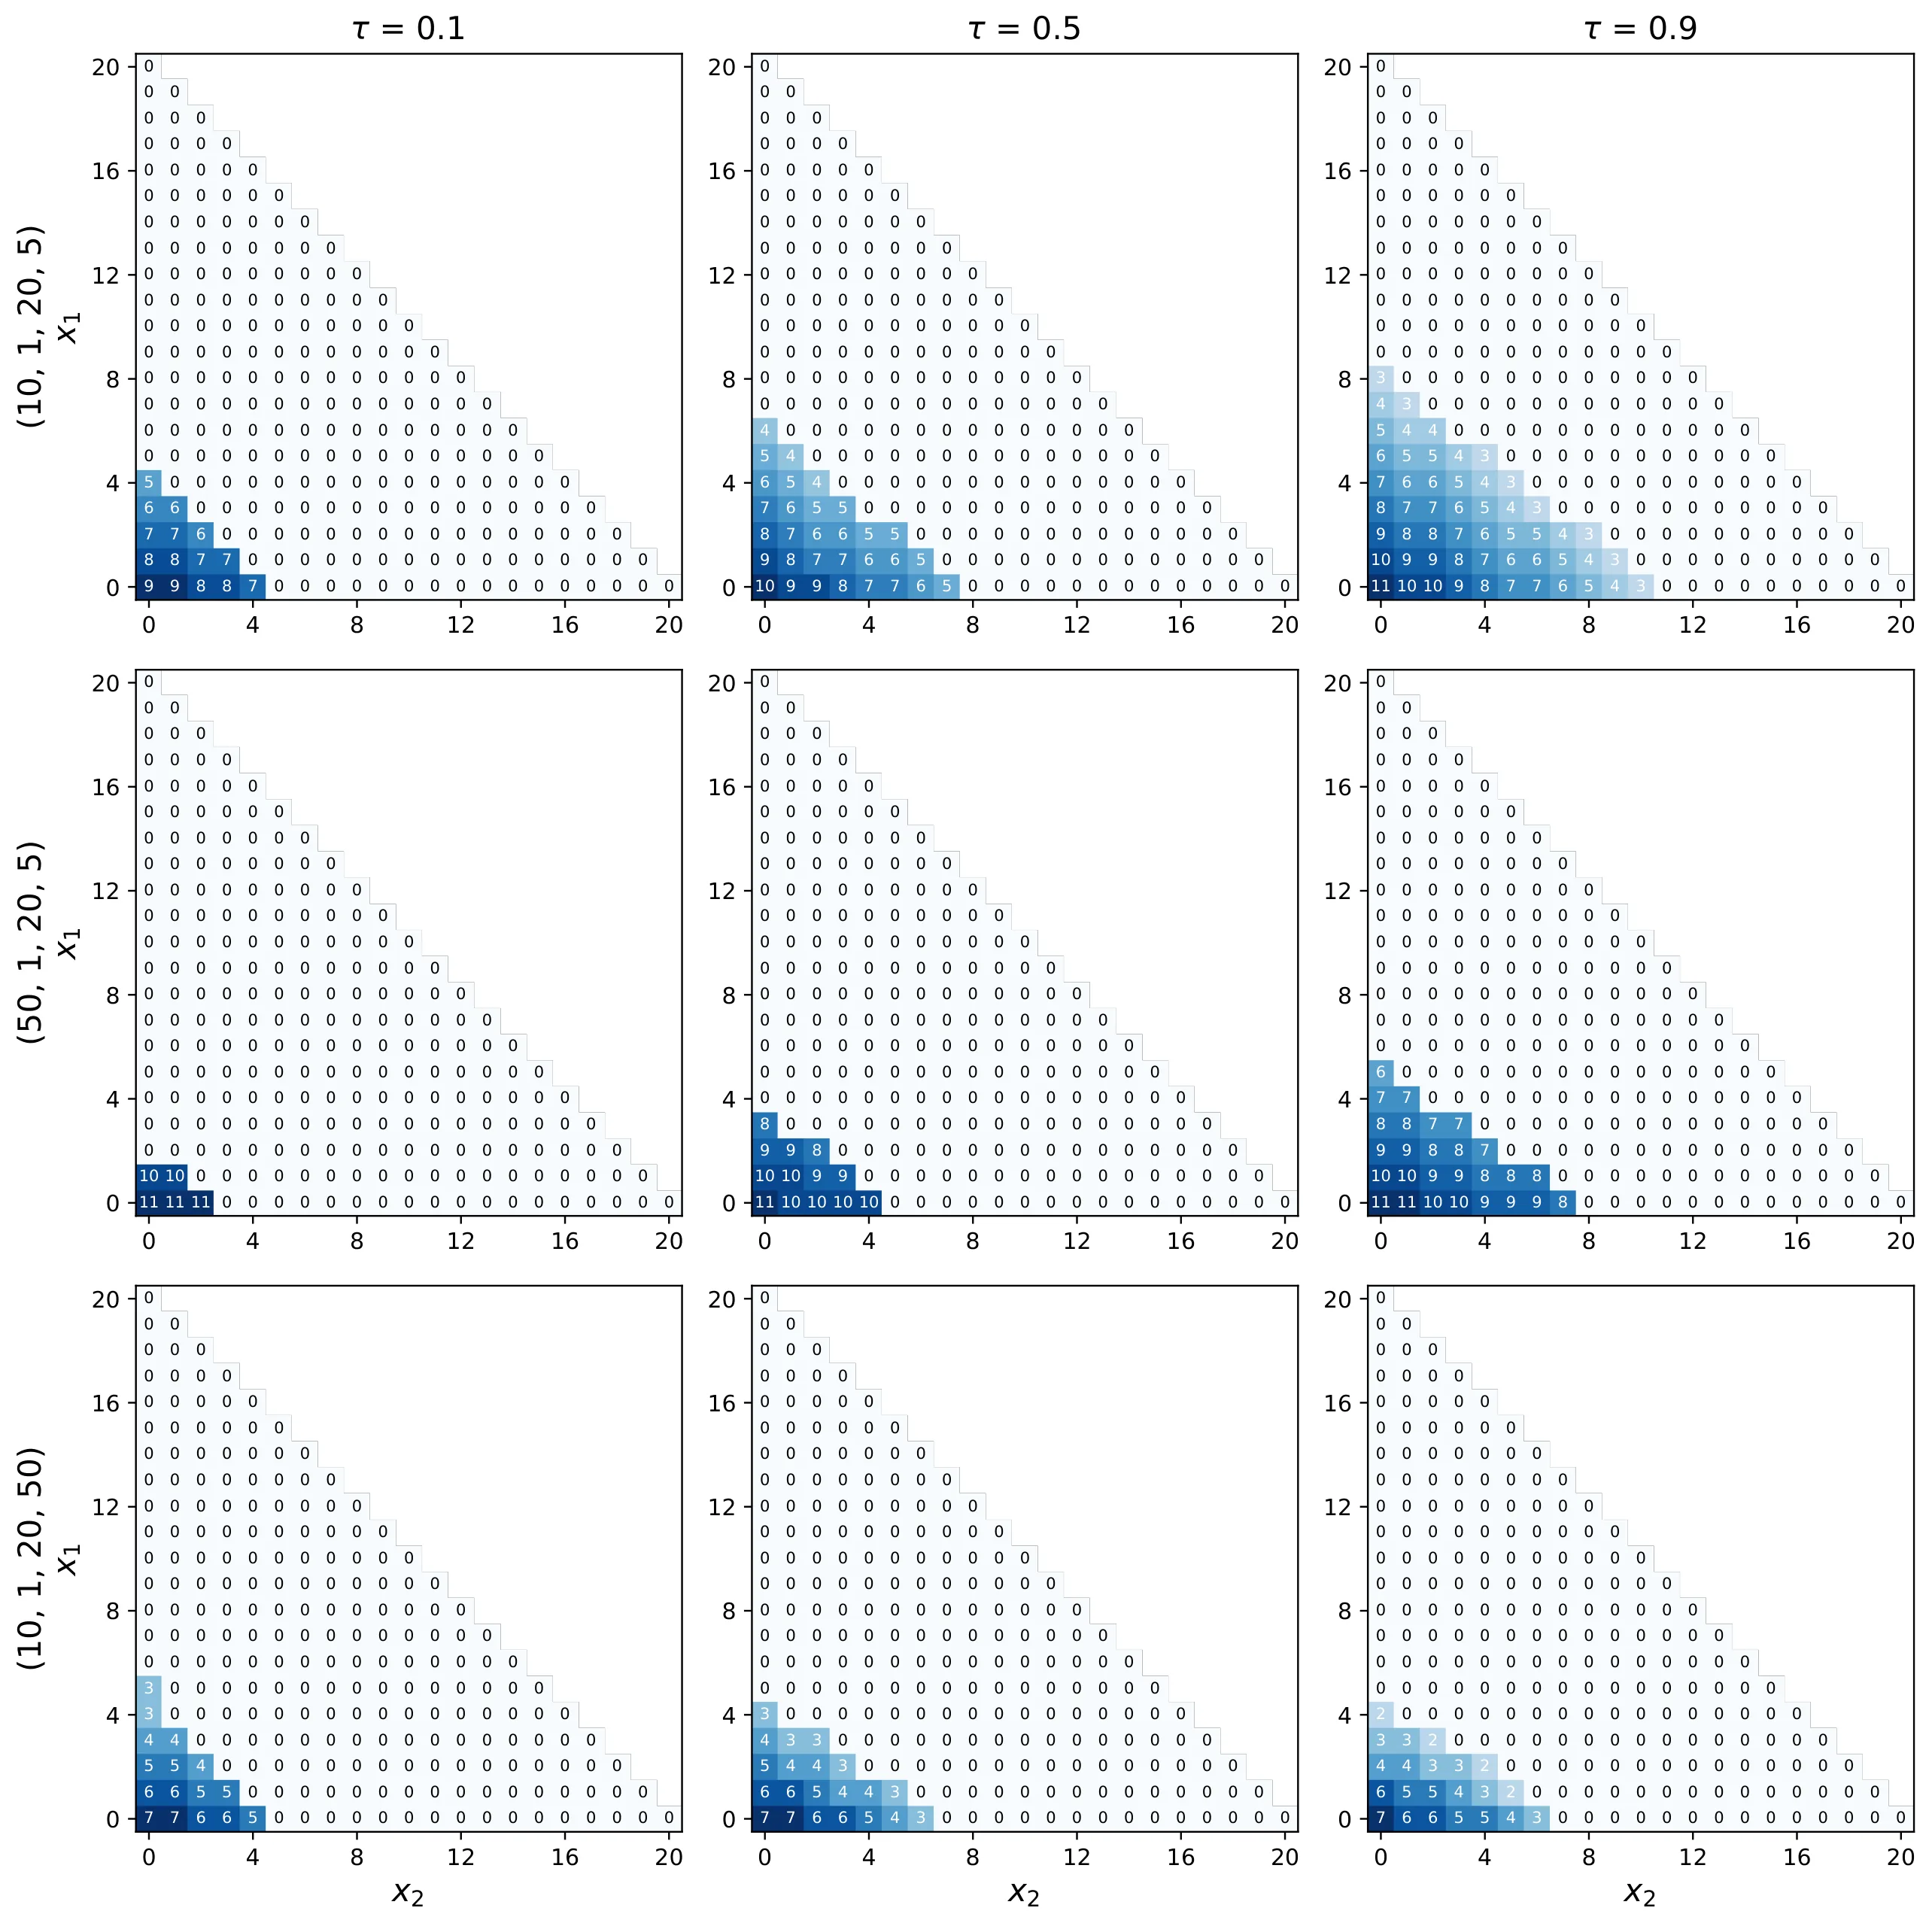
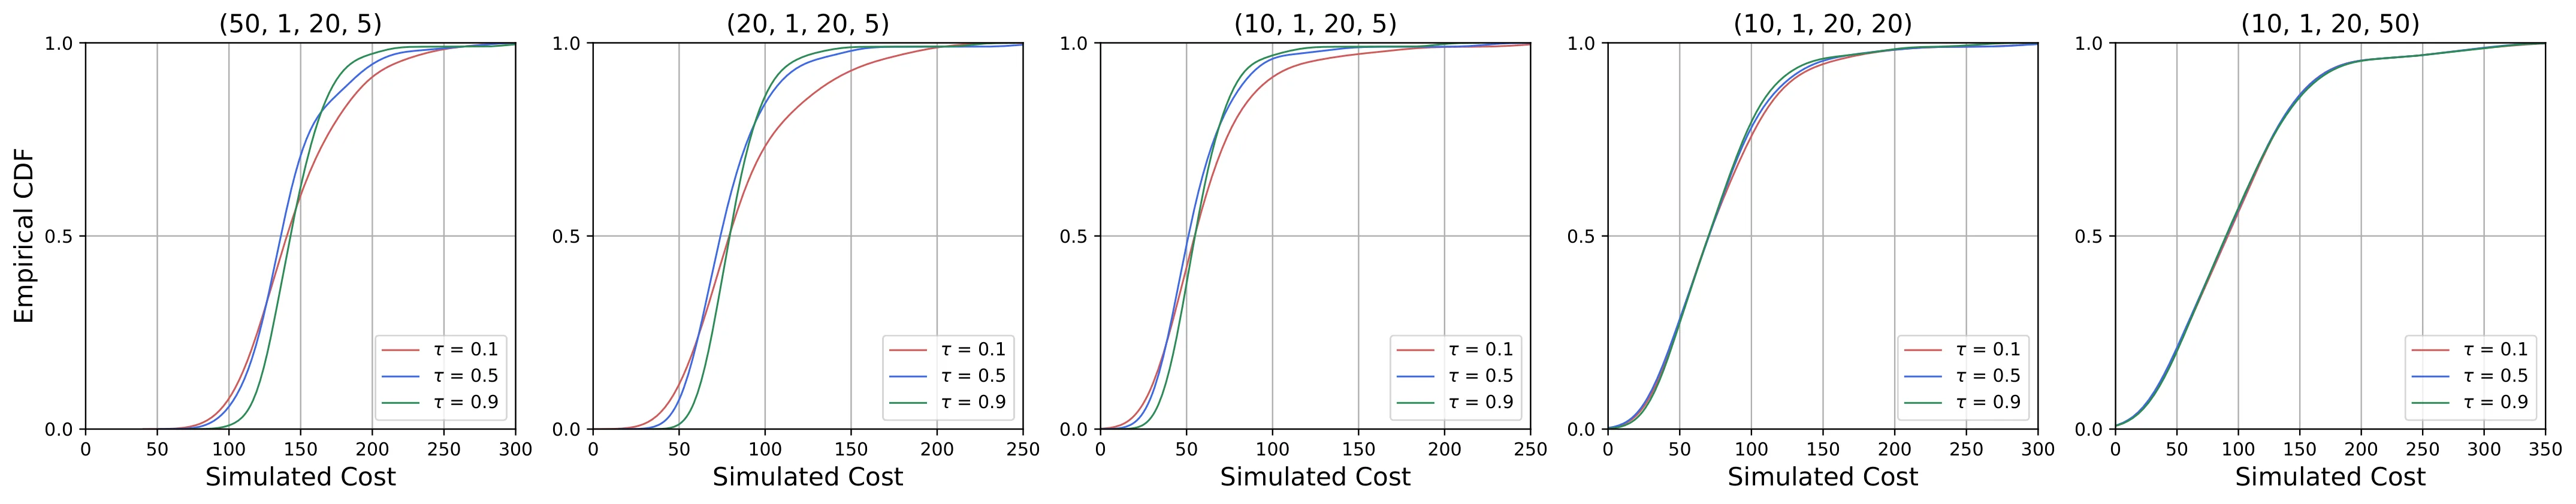
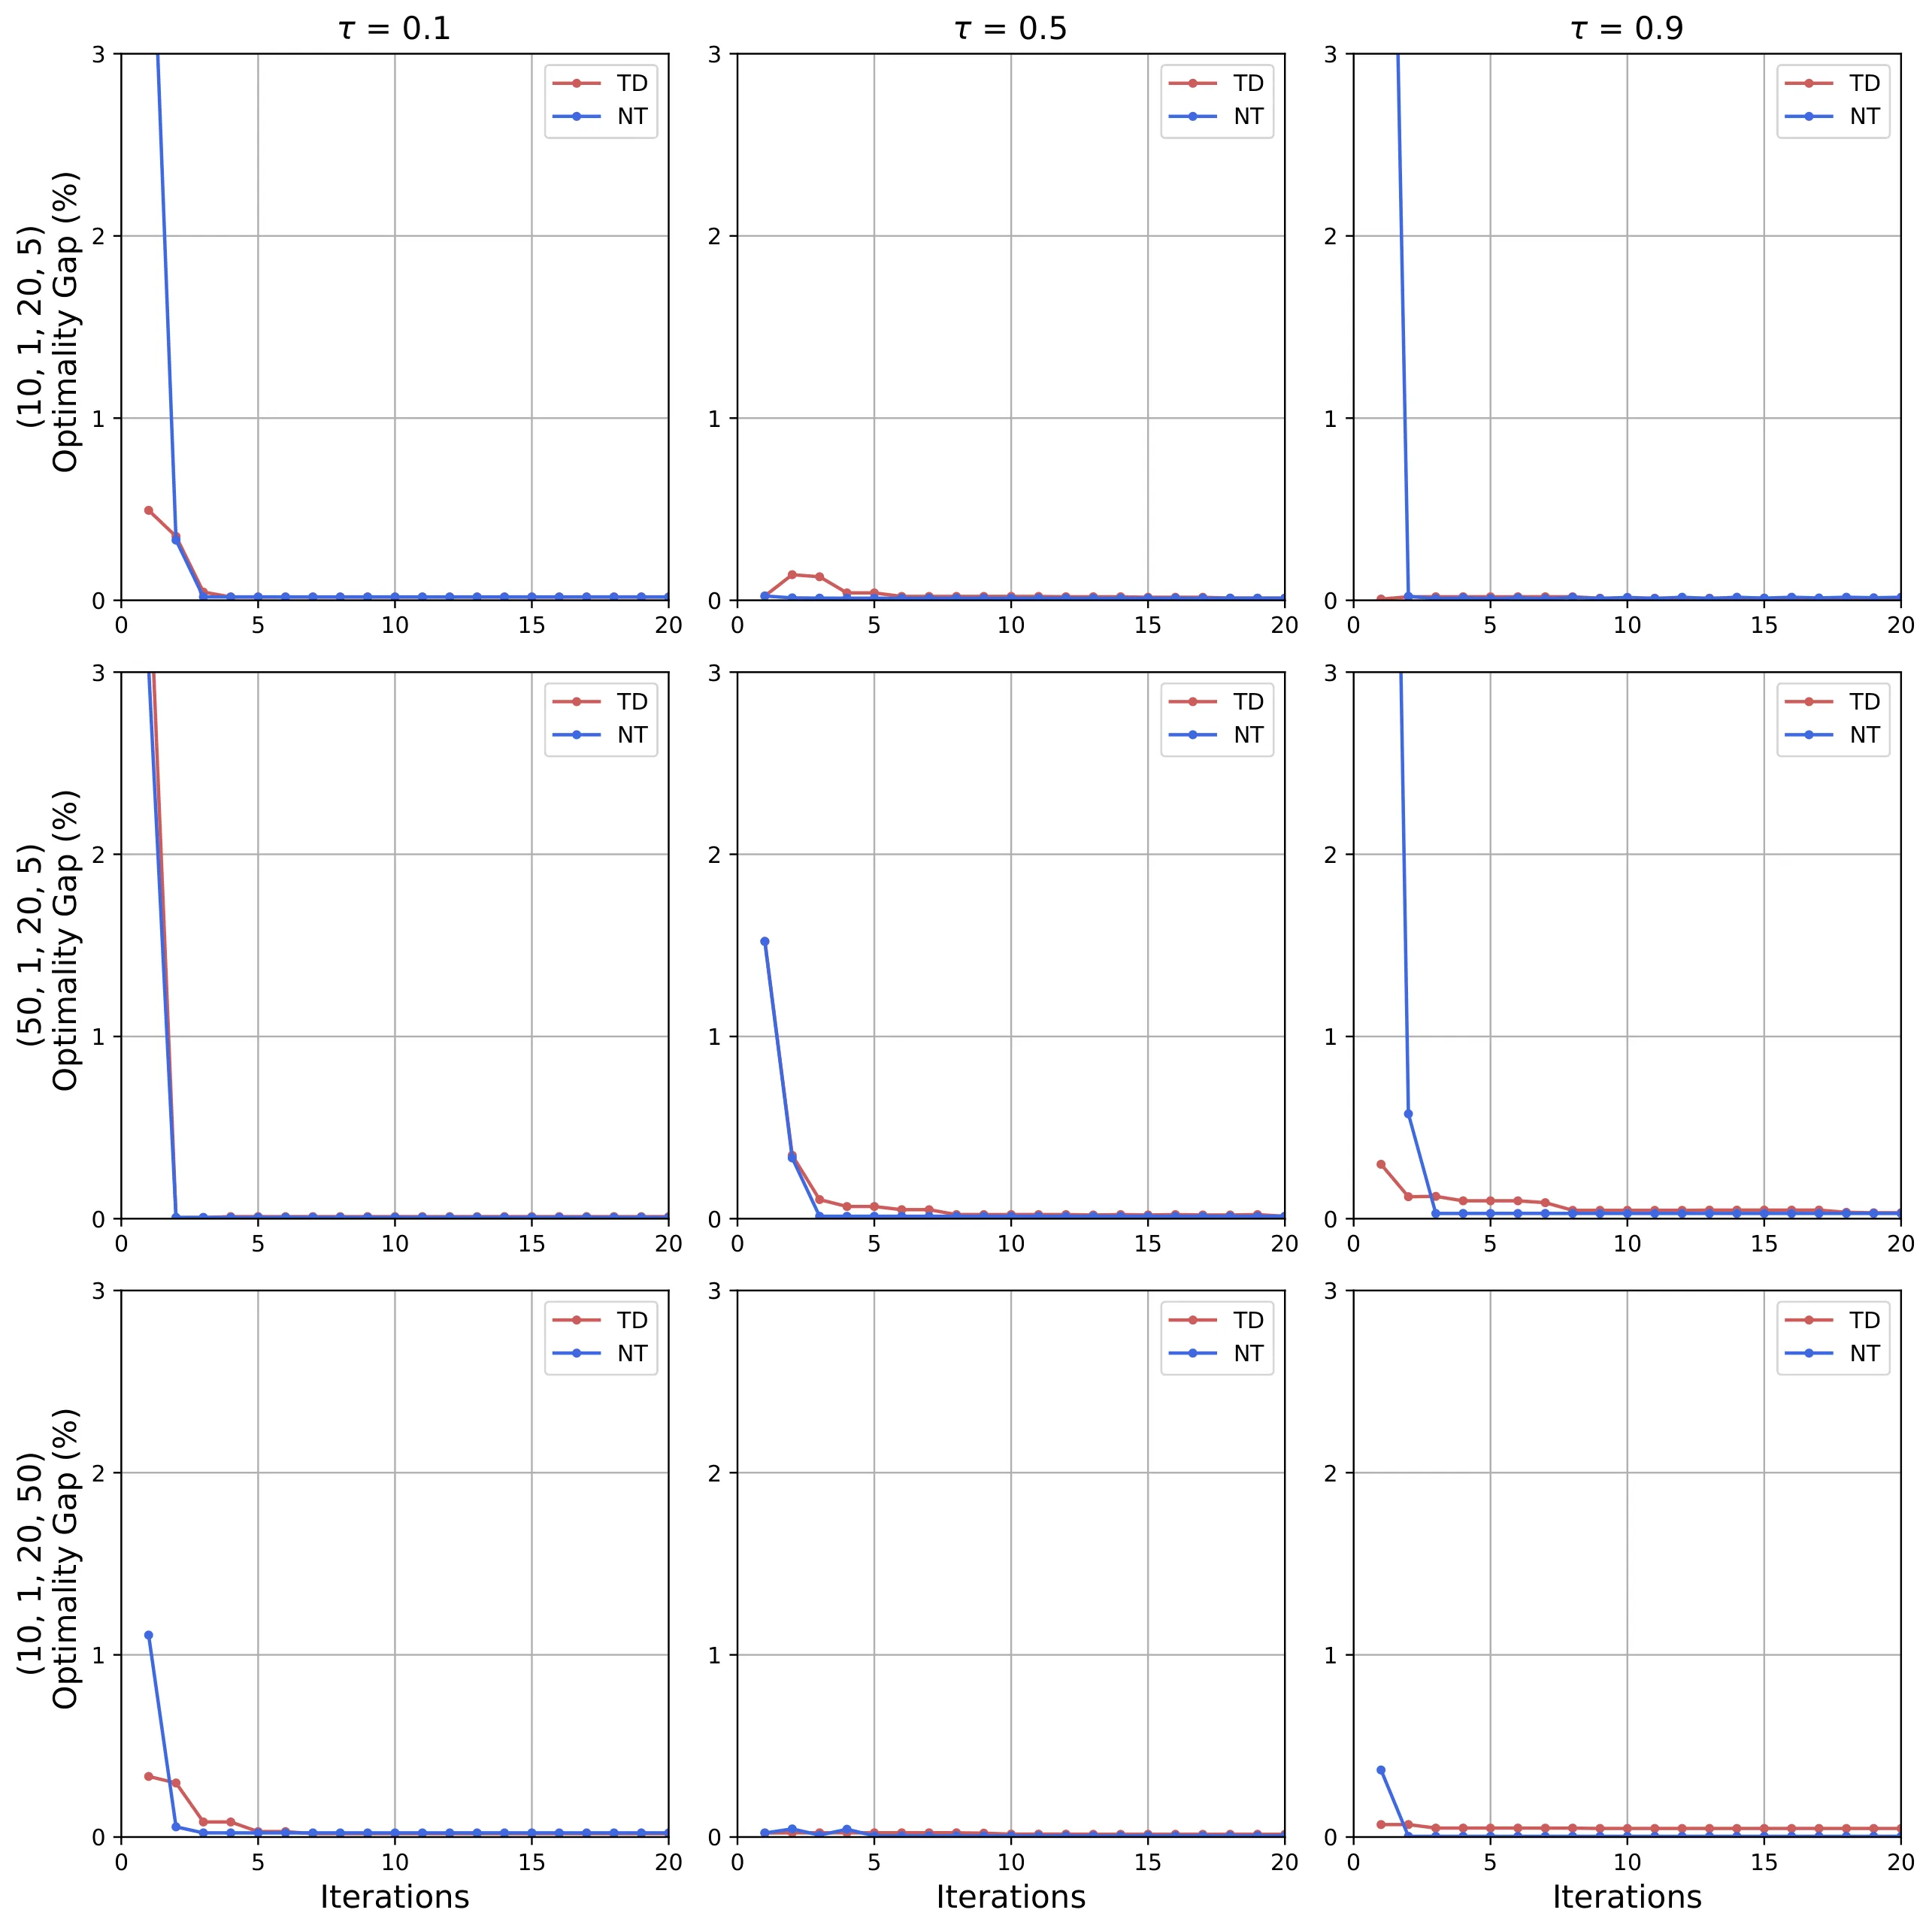
论文通过两个层面的实验验证了方法的有效性。数值实验部分考虑了典型的 MDP 测试场景,用于验证 UBSR-TD 的收敛性质与不同参数设置下的性能表现。实验结果表明,UBSR-TD 在动态 UBSR 风险测度下能够稳定收敛,且加速变体相比基础版本在样本效率上确有提升。
更具说服力的是将方法应用于易腐库存管理问题。在这一场景中,零售商需要在不确定的需求与产品保质期的双重约束下做出补货决策。库存过期造成的损失天然具有风险敏感特性,传统的期望利润最大化无法充分反映决策者对过期风险的厌恶。论文将这一问题的 MDP 模型与 UBSR-TD 算法结合,通过在线学习的方式评估不同补货策略的风险调整后价值。
实验结果显示,基于 UBSR 测度的评估能够为决策者提供更丰富的风险信息。例如,在需求波动较大的环境下,采用保守补货策略虽然在期望利润上略低,但其 UBSR 指标显著优于激进策略。这一发现印证了 UBSR 测度在捕捉决策者真实偏好方面的有效性,也展示了在线策略评估在实际问题中的实用价值。
讨论与可借鉴点
这篇论文为风险敏感强化学习的在线学习提供了新的理论框架与算法工具。其方法论层面的核心启示在于:风险敏感 MDP 的策略评估可以看作是风险中性情况下的一个优雅扩展。通过在时序差分误差中嵌入适当的损失函数,许多已有的风险中性算法都能够被推广到动态风险测度场景。这种“插件式”的设计思路为后续研究提供了可扩展的架构。
当然,论文也存在若干局限性。首先,收敛性证明依赖于线性函数逼近的设定,如何推广到深度神经网络等非线性逼近仍是开放问题。其次,UBSR 损失函数的具体形式对算法性能有显著影响,论文虽然讨论了几种选择,但缺乏系统性的选取指导。最后,在线场景下的探索-利用权衡在论文中没有深入讨论,这在实际应用中往往不可忽视。
对于从事风险敏感决策研究的研究者而言,这篇论文提供了一个坚实的起点。它既可以作为将现有风险中性方法适配到风险敏感场景的模板,也暗示了UBSR 测度在实际应用中相比 CVaR 等替代方案的理论优势。未来的工作可以沿着理论深化(从线性到非线性逼近)、算法扩展(结合策略梯度、Actor-Critic 架构)以及更多应用场景(金融、身体健康管理)三个方向展开。
摘要
为风险敏感强化学习中的策略评估开发高效的函数逼近方法是一项基本挑战。现有方法要么聚焦于受限类别的风险测度,要么依赖于对模拟器的访问,从而限制了它们在完全在线场景中的适用性。在本文中,我们针对具有动态基于效用不足风险(UBSR)测度的马尔可夫决策过程(MDP),在线性函数逼近条件下,提出了计算高效的在线学习算法用于策略评估。具体而言,我们提出了UBSR-TD算法,建立了其几乎处处收敛的条件,并设计了若干旨在加速收敛的变体。我们的研究表明,通过将损失函数融入时序差分误差,风险中性MDP的现有策略评估算法可以便捷地适配到动态UBSR场景中。数值实验支持了我们的理论结论,而对具有保质期不确定性的易腐库存管理问题的应用则展示了所提方法的实际有效性。
Abstract
Developing efficient function-approximation methods for policy evaluation is a fundamental challenge in risk-aware reinforcement learning. Existing approaches either focus on restrictive classes of risk measures or rely on access to a simulator, limiting their applicability in fully online settings. In this work, we propose computationally efficient online learning algorithms for policy evaluation in Markov decision processes (MDPs) with dynamic utility-based shortfall risk (UBSR) measures under linear function approximation. Specifically, we introduce the UBSR-TD algorithm, establish conditions under which it converges almost surely, and develop several variants designed to accelerate convergence. Our formulation shows that existing policy evaluation algorithms for risk-neutral MDPs can be readily adapted to dynamic UBSR settings by incorporating a loss function into the temporal-difference error. Numerical experiments support our theoretical findings, and an application to a perishable inventory management problem with shelf-life uncertainty demonstrates the practical effectiveness of the proposed methods.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。