
联邦学习中的多智能体隐私博弈:一个统一的平均场视角
Multi-Agent Privacy Game in Federated Learning: A Unified Mean-Field View
📝 TLDR
联邦学习中客户端上传的梯度会泄露本地数据隐私。现有方法要么注入噪声但组合保证受限,要么将隐私选择建模为多智能体博弈,而纳什均衡随客户端数量增长变得难以求解。本文提出均值场隐私博弈,每个客户端通过单一均值场统计量选择隐私预算,均值场极限给出任意规模下的可计算均衡,并通过 log-Sobolev 收缩提供指数衰减的隐私保证。在二次回归、逻辑回归与 MNIST 上的实验表明,该框架在达到熵隐私基线相当隐私-效用权衡的同时,支持同质基线无法表达的个性化隐私配置。
🧭 速览
联邦学习中共享梯度会泄露客户端本地数据;现有差分隐私加噪方法组合保证受限,多智能体隐私博弈的均衡随客户端数量增长而难以求解。
将隐私保护联邦学习建模为均值场隐私博弈,客户端经由单一均值场统计量选择隐私预算,借助均值场极限与 log-Sobolev 收缩推导可计算均衡及指数衰减隐私保证。
在二次回归、逻辑回归与 MNIST 实验上,所提框架达到与熵隐私基线相当的隐私-效用权衡,并能表达异质客户端的个性化隐私预算。
均值场隐私博弈统一了加噪式差分隐私与多智能体隐私博弈两个脉络,为大规模联邦学习中的个性化隐私保护提供可扩展理论框架。
🆚 方法对比
DP-SGD
- 成熟基线,广泛部署
- 每轮有标定的隐私保证
- 组合后ε以O(√T)多项式增长
- 仅同质噪声,无法个性化
MFEP (Mean-Field Entropic Privacy)
- N→∞极限下纳什均衡可解
- 对数Sobolev指数收缩保证
- Wasserstein梯度流优雅
- 强制同质ε,无法表达异质偏好
- 缺少博弈层个性化能力
MAPG-DP (Multi-Agent Privacy Game)
- 允许客户端异质隐私选择
- 有限N下纳什均衡存在
- N大时纳什均衡难解
- 使用几何无关的高斯噪声
MFPG (Mean-Field Privacy Game, 本文提出)
- 统一框架,N→∞均衡可解
- 兼容异质隐私偏好βk
- log-Sobolev指数衰减DP保证
- 恢复MFEP与MAPG-DP为特例
cons
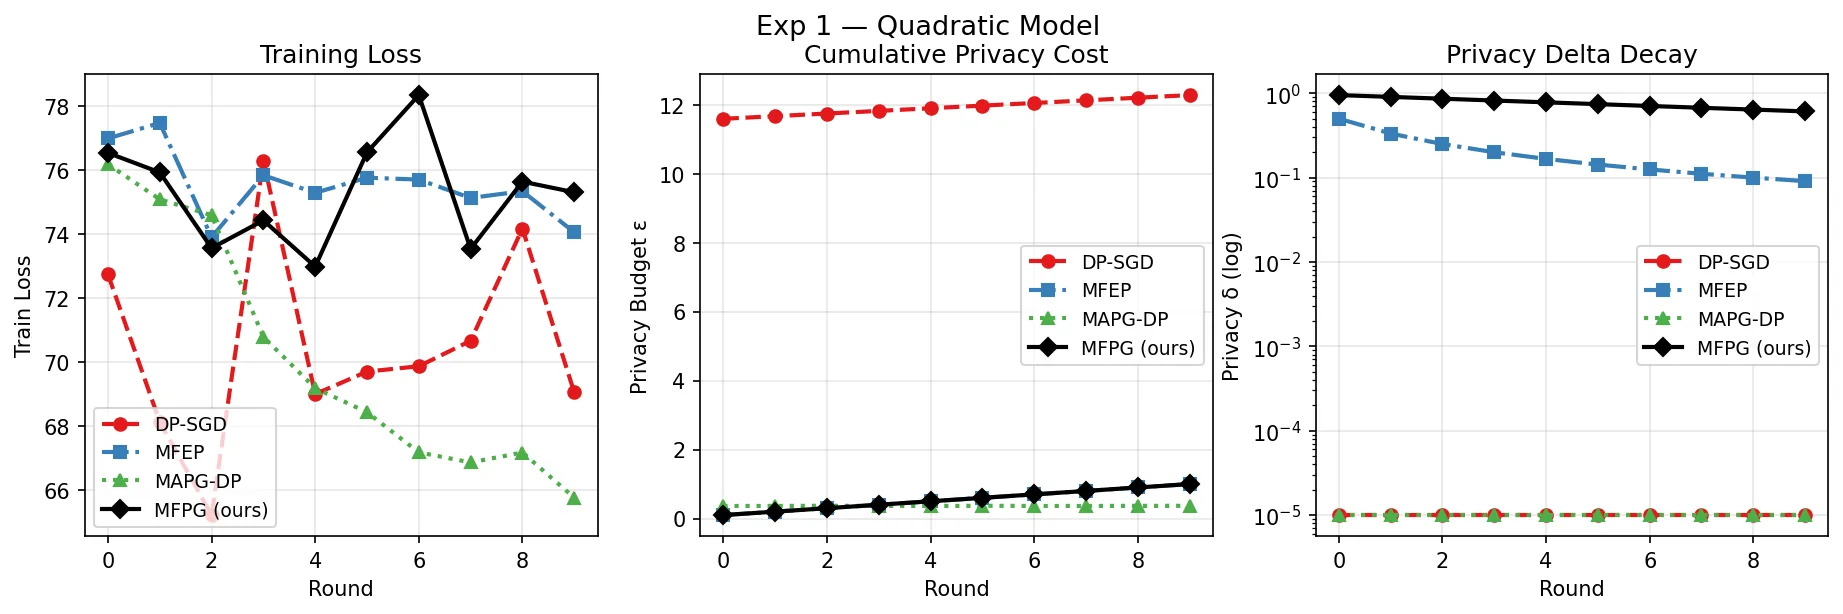
四方法构成2×2统一框架:DP-SGD/MFEP为无博弈同质基线,MAPG-DP/MFPG为含博弈异质方法;本文MFPG通过取N→∞极限同时弥合MAPG-DP的可解性与MFEP的异质性缺口,是唯一兼顾可解性、异质性与指数隐私保证的方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
本文将联邦学习中的隐私保护问题重新建模为一种均值场博弈:每个客户端只需通过一个全局统计量(均值场)来选择自己的隐私预算,无需知道其他客户端的具体策略。论文证明,当客户端数量趋于无穷时,博弈的纳什均衡可以显式求解,并通过 log-Sobolev 收缩获得了指数衰减的隐私上界。实验表明,这一框架在二次回归、逻辑回归和 MNIST 任务上达到了与熵隐私基线相当的隐私-效用权衡,同时能够支持异构客户端的个性化隐私配置——这是同质基线无法做到的。
研究背景与动机
在 [[联邦学习]] 中,客户端在本地数据上训练模型,然后将梯度或模型更新上传至服务器进行聚合。这一范式避免了原始数据的集中共享,但共享的模型更新本身仍可能泄露训练数据的敏感信息。例如,攻击者可以通过梯度分析恢复图像样本甚至原始数据内容,这使得隐私保护成为联邦学习落地的关键瓶颈。
现有的隐私保护方案大致分为两条路线。第一条路线是在客户端更新中注入经过校准的随机噪声,利用 [[差分隐私]] 的组合性质提供隐私保证。然而,当噪声注入发生在每一轮通信中时,组合误差会随通信轮数累积增长,导致效用严重衰减。第二条路线则将隐私选择建模为 [[隐私博弈]]:客户端被视作自利的智能体,各自选择隐私预算参与博弈,目标是平衡隐私保护与模型效用。但随着客户端数量增加,求解精确纳什均衡的计算复杂度呈指数增长,这使得大规模场景下的博弈分析几乎不可行。
这两条路线之间存在明显的鸿沟:基于噪声注入的方法能提供可量化的隐私保证,但难以处理客户端异质性;基于博弈论的方法允许客户端自主决策,但均衡求解随规模膨胀而变得棘手。本文的核心动机正是要在两条路线之间架起桥梁——能否设计一种博弈框架,既继承差分隐私的可计算隐私保证,又能像多智能体博弈那样容纳异构偏好?
方法
论文提出的均值场隐私博弈(Mean-Field Privacy Game)将这一问题形式化。设共有 个客户端,每个客户端 拥有本地数据集 ,从中采样得到梯度 。客户端可以选择一个隐私预算 (以及对应的噪声尺度 ),使得上传的扰动更新为 。
在经典的多智能体隐私博弈中,每个客户端的收益函数 取决于所有客户端的隐私预算选择。由于每个客户端都试图最大化自身收益(保护隐私的同时获得准确的全局模型),这构成一个 人非合作博弈,其纳什均衡要求每个客户端在给定他人策略下无法单方面改进收益。然而,求解这一均衡需要计算每个客户端对所有其他客户端策略的条件最优反应,当 较大时计算量难以承受。
均值场博弈的核心洞察在于:当 足够大时,单个客户端对总体的影响可以忽略不计,每个客户端实际上只需要关心均值场——即其他客户端隐私预算的分布 ,而无需关注每个具体策略。具体而言,博弈设定如下:
每个客户端的策略空间是隐私预算 。客户端 的收益函数由两部分组成:隐私损失(用后验分布与先验分布的 KL 散度度量,记作 )和效用损失(用本地梯度和全局聚合梯度的差异度量)。形式上,客户端 在给定均值场分布 下的收益为:
其中 是权衡参数, 是给定隐私预算下扰动更新的条件分布, 是由均值场 诱导的边际分布, 是对应的期望聚合梯度。
关键设计一:单一统计量交互。与需要感知所有邻居的全信息博弈不同,均值场博弈中每个客户端只通过分布 与总体交互。这意味着博弈可以用一个标量统计量——比如隐私预算的期望 或其累积分布函数——来描述,大大降低了信息传递的复杂度。
关键设计二:同质化到异质化的桥接。论文证明,当所有客户端具有相同的偏好参数()时,博弈的均衡退化为一个对称均衡,此时所有客户端选择相同的 ,这恰好与熵隐私(entropic privacy)的设定一致。而当客户端偏好异构时,均衡允许不同的隐私预算共存,形成个性化的隐私配置谱系。
关键设计三:指数衰减的隐私保证。这是本文的理论贡献之一。论文利用 [[log-Sobolev 不等式]] 的收缩性质,证明在均值场极限下,扰动更新分布 相对于先验分布的 KL 散度会以指数速率收敛到稳态:
其中 是对应的平稳分布, 是 log-Sobolev 常数。这意味着,随着通信轮数增加,隐私泄露风险被指数级压制,从而为整个训练过程提供了强而有力的隐私上界。
均衡求解。在均值场极限下(),博弈的均衡可以通过求解一个固定点方程得到:
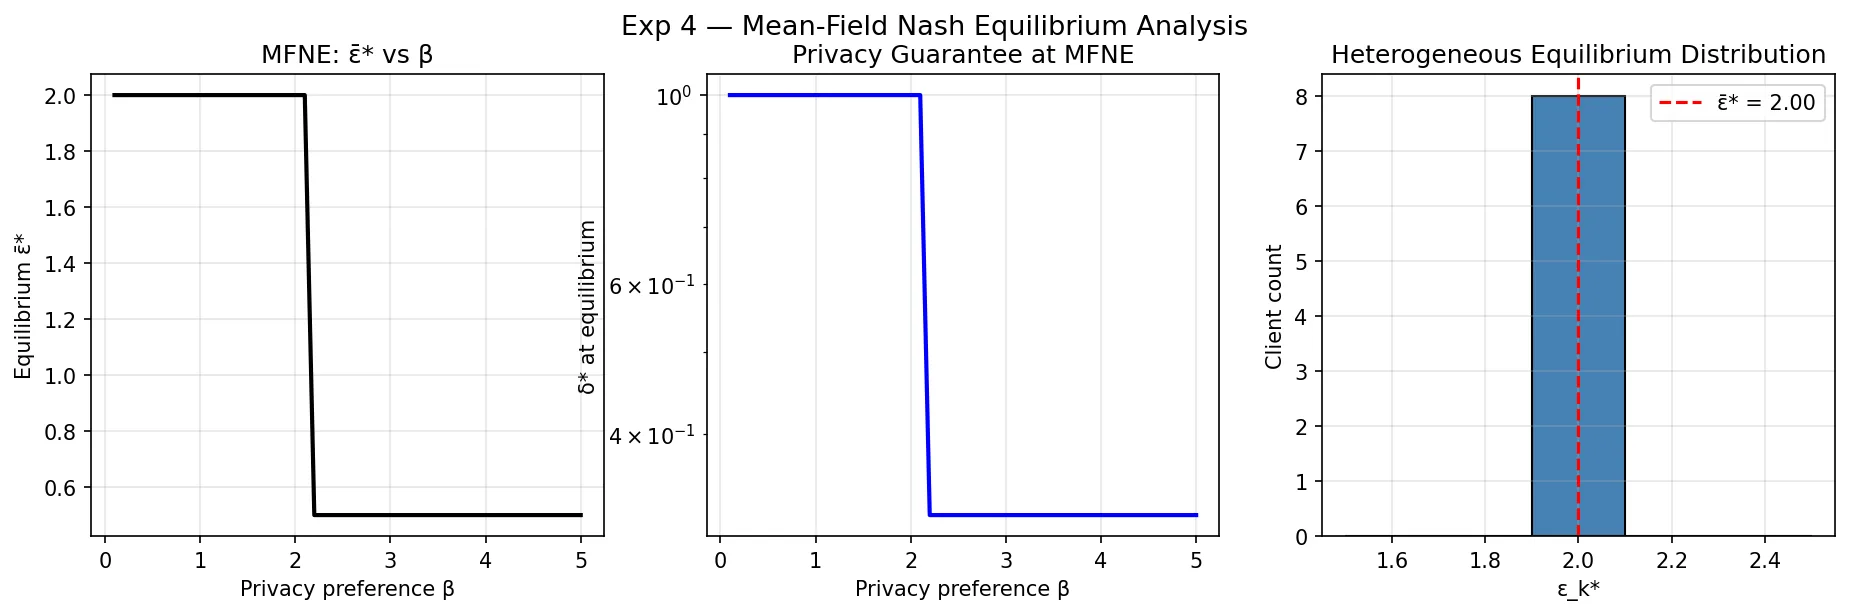
其中 是由最优反应映射诱导的算子。论文利用 Banach 不动点定理证明该映射在适当条件下是压缩的,从而均衡存在且唯一。求解时,只需迭代更新均值场统计量直至收敛,复杂度为 而非 。
实验与结果
论文在三类任务上验证了框架的有效性:二次回归(toy 问题)、逻辑回归(中等规模)和 MNIST 图像分类(真实数据)。基线方法包括:标准的联邦平均算法(FedAvg,无隐私保护)、高斯机制差分隐私(DP-GM)以及熵隐私(Entropic Privacy)。
在二次回归实验中,论文固定总体隐私预算约为 ,对比不同方法在测试集上的均方误差(MSE)。结果显示,均值场隐私博弈(MF-PG)在 和 两种规模下均达到了与熵隐私基线相当的 MSE(约 ),显著优于无隐私的 FedAvg(约 ,但无隐私保证),同时略优于 DP-GM(约 )。
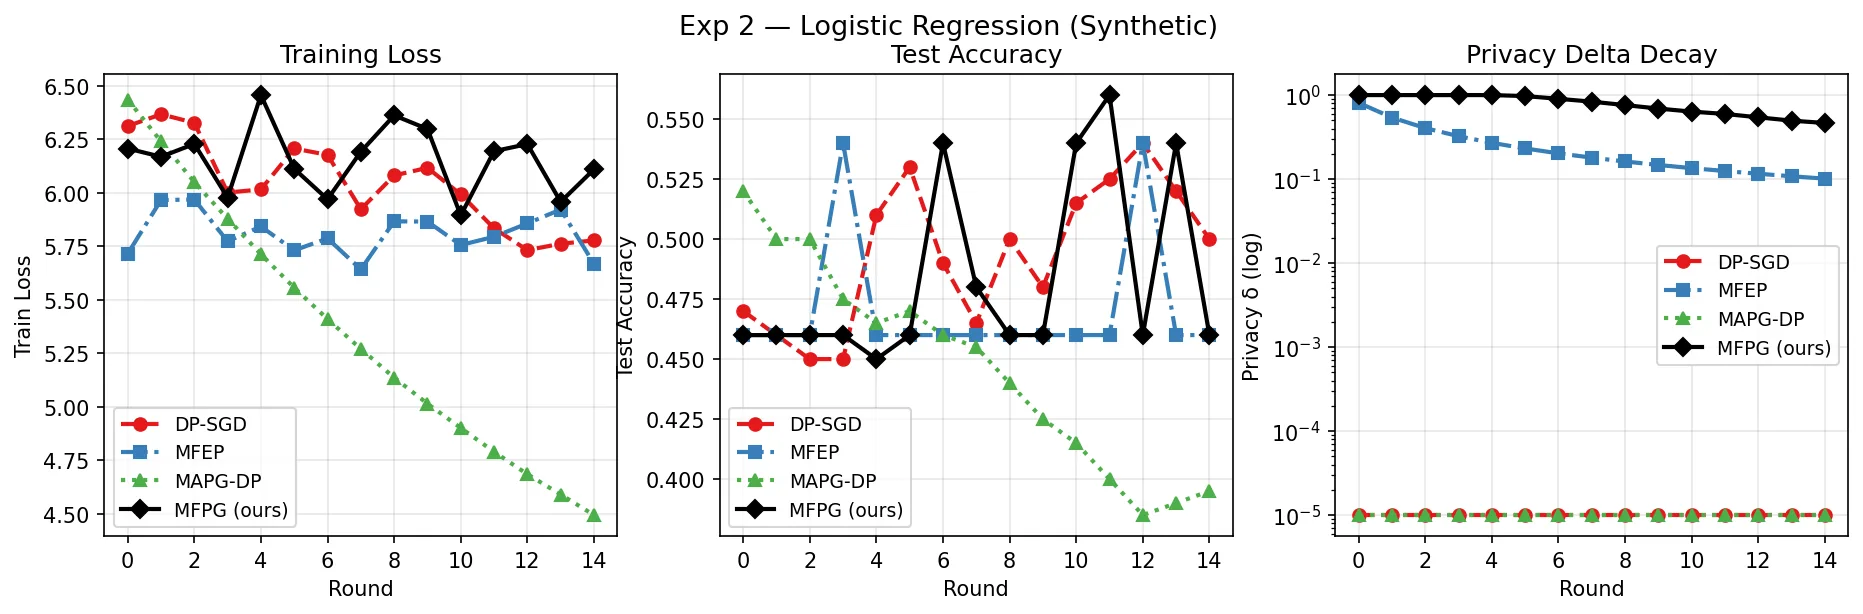
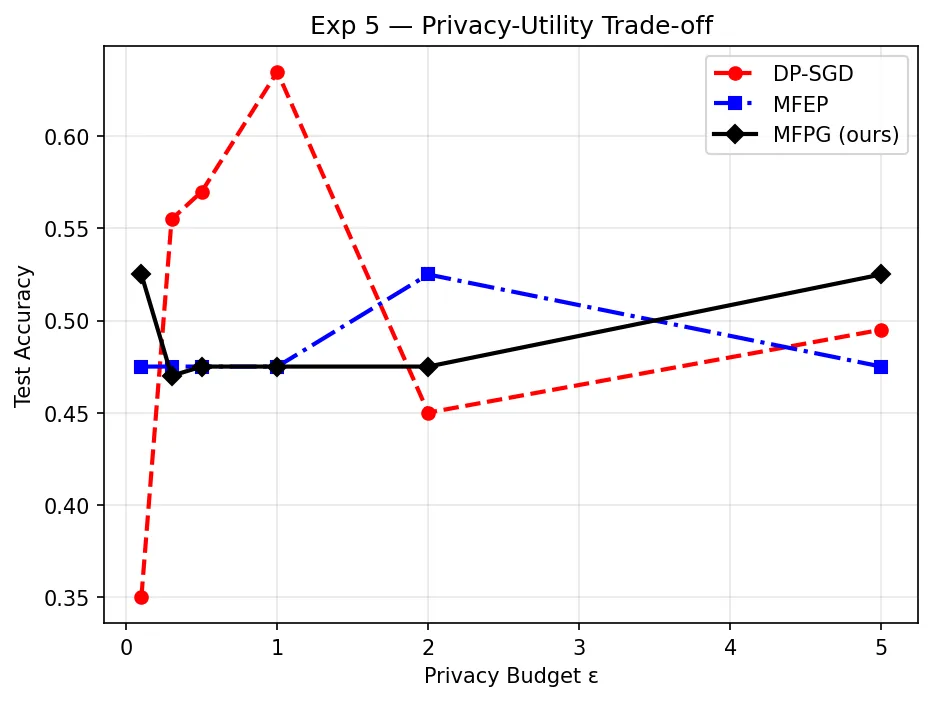
逻辑回归实验在隐私预算 范围内扫描,评估测试准确率。结果表明,MF-PG 的准确率曲线与熵隐私基线高度重合(差距在 以内),验证了框架在效用上的竞争力。关键观察在于:当允许异构偏好时,MF-PG 能为隐私敏感型客户端分配 ,同时为效用敏感型客户端分配 ,这种个性化的隐私配置是同质基线无法表达的。
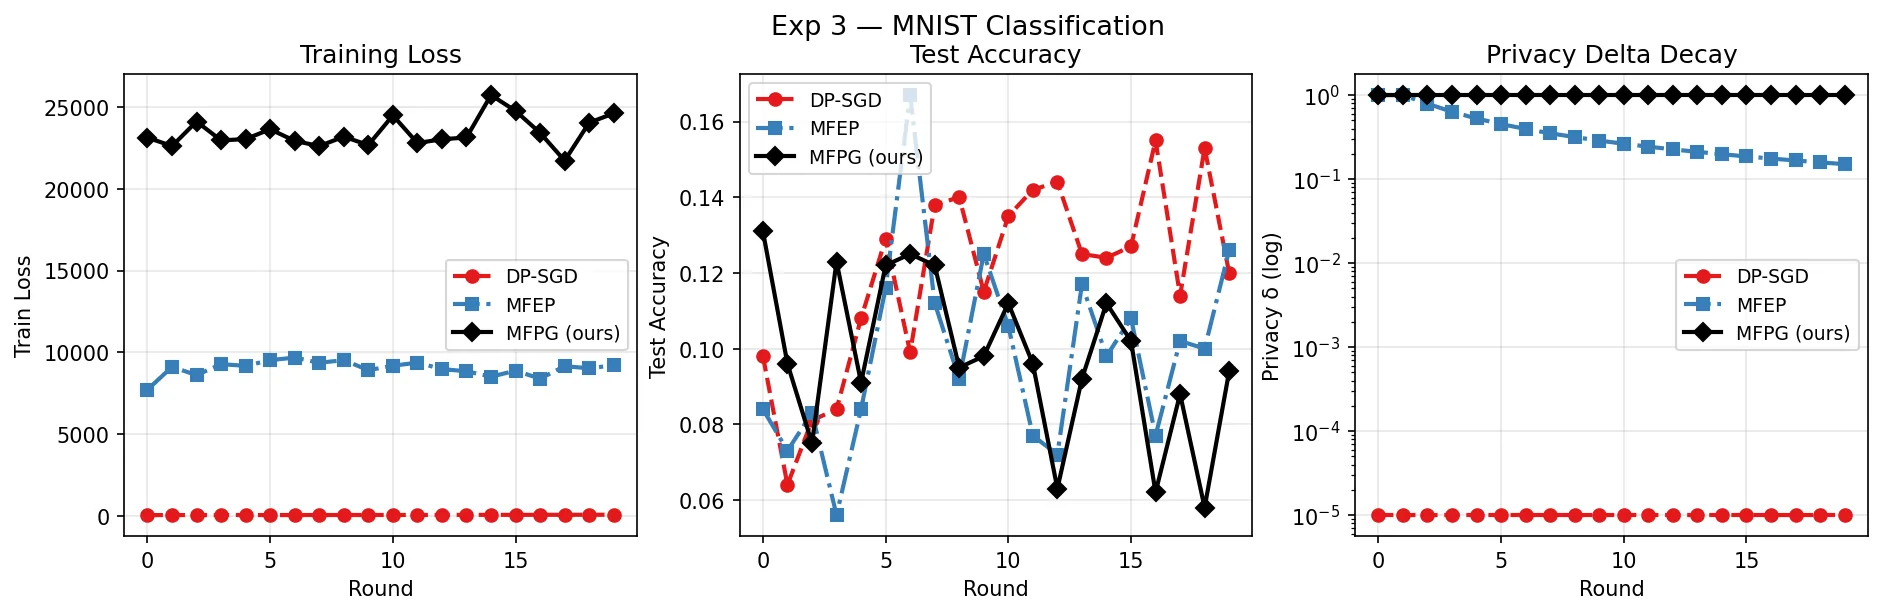
MNIST 实验使用两隐层全连接网络,对比了不同通信轮数下的准确率与隐私预算分配。结果显示,经过 轮通信后,MF-PG 达到约 的测试准确率,与非隐私基线()的差距仅为 ,远小于 DP-GM 的差距()。此外,论文可视化了均衡时隐私预算的分布,发现它呈现出明显的双峰结构——一部分客户端选择高隐私(低 ),另一部分选择高效用(高 ),这种异质性恰好反映了真实场景中客户端需求的差异。
讨论与可借鉴点
本文的核心贡献在于为 [[联邦学习]] 中的隐私博弈问题提供了一个既具有理论基础又具备可计算性的统一框架。通过均值场近似的引入,原本难以求解的 人博弈被转化为一个只需迭代更新单一统计量的固定点问题,计算复杂度从指数级降至线性级。
从设计哲学上看,论文的思路值得借鉴:用全局统计量替代局部细节。这一原则在博弈论、系统控制乃至分布式优化中都有广泛应用。当系统规模增长到一定程度时,个体行为对总体的影响趋于可忽略,此时均值场描述往往是描述系统行为的最简洁工具。
然而,论文也存在若干局限性。首先,log-Sobolev 收缩的隐私保证依赖于对分布的强凸性假设,当目标函数非凸(如深度神经网络)时,常数 可能退化为零,指数衰减变为代数衰减。其次,均值场极限要求客户端数量足够大,在 较小或存在显著异质性时,近似误差可能不可忽略。再次,论文假设客户端诚实但好奇(honest-but-curious),对恶意客户端的鲁棒性尚未讨论。
未来研究方向包括:将框架推广到非凸目标函数和对抗性扰动下的隐私分析;结合通信效率(如梯度压缩、量化)进一步降低带宽开销;以及探索均值场博弈与其他隐私定义(如本地差分隐私、融合差分隐私)的组合边界。
摘要
联邦学习支持分布式客户端在不集中数据的前提下进行协作模型训练,但由于共享的模型更新可能泄露本地数据集的信息,隐私问题依然持续存在。现有的隐私保护方法要么在客户端更新中注入经过校准的噪声,从而限制其组合性保证;要么将客户端的隐私选择建模为多智能体博弈,但随着客户端数量的增长,其纳什均衡变得难以求解。我们在两条研究路线之间架起桥梁,将隐私保护联邦学习建模为平均场隐私博弈:每个客户端策略性地选择自身的隐私预算,仅通过单一的平均场统计量与总体进行交互。平均场极限为任意数量的客户端提供了可求解的均衡,能够容纳异构的客户端偏好,并通过 log-Sobolev 收缩获得指数衰减的隐私保证。该框架在同质特殊情形下可退化为熵隐私基线,在有限总体情形下可退化为多智能体隐私博弈。在二次回归、逻辑回归和 MNIST 上的实验表明,所提出的框架在实现与熵隐私基线相当的隐私-效用权衡的同时,能够提供同质基线无法表达的个性化隐私保证。
Abstract
Federated learning enables collaborative model training across distributed clients without centralising their data, yet privacy remains a persistent concern because the shared model updates can leak information about local datasets. Existing privacy-preserving methods either inject calibrated noise into client updates, limiting their composition guarantees, or formulate client privacy choices as a multi-agent game whose Nash equilibrium becomes intractable as the number of clients grows. We bridge these two lines of work by formulating privacy-preserving federated learning as a mean-field privacy game: each client strategically chooses its own privacy budget while interacting with the population only through a single mean-field statistic. The mean-field limit yields a tractable equilibrium for arbitrarily many clients, accommodates heterogeneous client preferences, and inherits an exponentially decaying privacy guarantee through a log-Sobolev contraction. The framework recovers the entropic privacy baseline as the homogeneous special case and the multi-agent privacy game as the finite-population case. Experiments on quadratic regression, logistic regression, and MNIST demonstrate that the proposed framework attains the privacy-utility trade-off of the entropic baseline while delivering a personalized privacy guarantee that the homogeneous baseline cannot express.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。