
超越直接回答:基于启发式强化学习将教育大语言模型对齐为苏格拉底式引导者
Beyond Direct Answering: Aligning Educational LLMs as Socratic Guides via Heuristic Reinforcement Learning
📝 TLDR
教育场景中大语言模型倾向于在首轮直接给出目标概念答案,而非以苏格拉底式提问引导学生渐进探究。本文提出HeuristicEdu两阶段对齐流程,先以监督数据热身,再用GRPO对Qwen2.5-7B进行启发式强化学习优化,训练数据来自797条中文儿童科学多轮对话。最佳变体将脚手架有效性从30.0%提升至63.3%,关键词泄露率从30.0%降至13.3%。同时发现显式防泄露惩罚与梯度对齐存在冲突,且72B基线未能自发产生苏格拉底行为。
🧭 速览
现有教育LLM在首轮即泄露目标概念,未遵循苏格拉底式渐进引导教学法。
HeuristicEdu两阶段流程:监督热身+GRPO,融合认知深度、好奇参与、直接性启发式奖励与K_query纠错。
30道题上SE由30.0%升至63.3%,关键词泄露由30.0%降至13.3%;未对齐Qwen-72B基线SE为0%、泄露96.7%。
启发式强化学习可有效对齐LLM的苏格拉底引导行为,但显式防泄露惩罚可能与梯度对齐冲突。
🆚 方法对比
HeuristicEdu
- 两阶段SFT+GRPO流水线有效对齐苏格拉底式辅导
- 在30个测试问题上SE从30%提升至63.3%
- 关键词泄露率从30%降至13.3%
- 7B模型优于未对齐的72B基线
- 依赖LLM评判器评分,可能存在评分偏差
- 仅在7个小学科学领域验证,泛化性待考察
- 样本仅797条轨迹,规模较小
SocraticEdu
- 来源于真实在线平台10512条问题
- 包含395真实轨迹+402合成轨迹,风格可控
- 涵盖7个小学科学领域
- 经意图过滤器F1=0.98筛选
- 仅限中文对话,跨语言适用性受限
- 797条轨迹规模偏小
- 仅针对8-12岁学生,年龄范围有限
GRPO
- 无需训练评论器,降低成本
- 组内归一化奖励适配启发式评分
- 有效实现行为级对齐
- 对奖励设计敏感,去掉R_dir反而最优
- 直接使用显式反泄露项会与梯度对齐冲突
SFT Warm-up
- 提供苏格拉底风格的初步对齐基础
- 降低GRPO探索空间,提高收敛效率
- 单独使用SE仅30%,需配合RL
- 仅SFT无法解决关键词泄露问题
- 依赖高质量标注数据
启发式奖励设计
- R_cog基于Bloom分类法有理论支撑
- R_eng关注学生好奇心参与
- R_dir推理时约束有效但GRPO中需谨慎
- R_dir作为GRPO惩罚项反而损害性能
- 依赖LLM评判器,可靠性待提升
- 三维奖励权重需精细调参
K_query修正
- 处理学生主动引入的术语,区分来源
- 避免对学生提及的概念误判泄露
- 提升对话公平性
- 增加推理预处理复杂度
- 依赖术语检测准确性
SE与CD评估指标
- SE衡量学生自主表达目标概念,超越表面流畅度
- CD评估对话语义推进,避免BLEU/ROUGE局限
- 闭环LLM模拟辅导四轮交互可执行
- 依赖LLM模拟学生,模拟偏差影响结论
- 仅30个测试问题,统计显著性不足
Qwen-72B未对齐基线
- 规模大、能力强,基线参考价值高
- SE为0%,泄露率96.7%,纯规模无法诱导苏格拉底行为
- 直接回答失败模式根深蒂固
- 验证了行为问题非能力问题
BLEU/ROUGE
- 计算简单、广泛使用
- 与教学质量相关性差,不适合开放领域
- 无法衡量辅导对话的教学价值
- 多有效回答存在时不可靠
RLHF
- 经典对齐方法,效果已被广泛验证
- 收集教学偏好对成本高昂,本文放弃采用
HeuristicEdu以SFT+GRPO两阶段流水线优于纯SFT、提示工程和未对齐72B基线;GRPO优于RLHF因无需评论器;启发式奖励中R_dir推理时有效但作为GRPO惩罚项反而降低SE;SE/CD优于BLEU/ROUGE,因其衡量教学结果而非表面相似度。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
大语言模型在教育场景中往往扮演「直接给答案」的角色,首轮就泄露核心概念,而非引导学生自主探究。本文提出 HeuristicEdu 两阶段对齐方案,在监督数据预热后引入 GRPO 强化学习,对 Qwen2.5-7B 进行启发式奖励优化。在 30 道保留测试题上,脚手架有效性从 30% 提升至 63.3%,关键词泄露率从 30% 降至 13.3%。有趣的是,最优变体在训练中取消了直接性惩罚,暗示防泄露约束可能与梯度对齐产生冲突;72B 基线模型完全无法自发产生苏格拉底行为,进一步证明规模并非答案。
研究背景与动机
大语言模型在教育辅导场景的潜力被寄予厚望,但一个根本性的行为错位始终困扰着实际应用:这些模型倾向于充当「直接回答者」,在对话开场便揭示目标概念的答案。以儿童科学教育为例,当学生问到「为什么天空是蓝色的」时,理想的教学者应当通过层层追问引导学生自己发现瑞利散射原理,而非直接说出「因为光的散射」就结束对话。这种直接给答案的模式剥夺了学生主动建构知识的机会,也违背了 [[Socratic tutoring|苏格拉底式教学法]] 的核心理念——通过提问激发思考,让学习者在探究过程中留下更深刻、更持久的学习痕迹。
然而,让模型学会「克制地不直接说答案」这件事远比表面看起来困难。传统的 [[reinforcement learning alignment|强化学习对齐]] 方法多聚焦于使模型输出更有帮助、更符合人类偏好,却鲜少针对「不做什么」这一维度进行优化。更关键的是,教育场景中的「正确答案」往往并不唯一——引导学生绕路思考可能比直接给答案更有教育价值,但这与常规 RLHF 追求的「给出有用回答」目标存在本质冲突。论文的切入点正在于此:如何设计一套对齐流程,既能抑制模型的直接泄露冲动,又能保留甚至增强其引导探究的教学能力?
方法
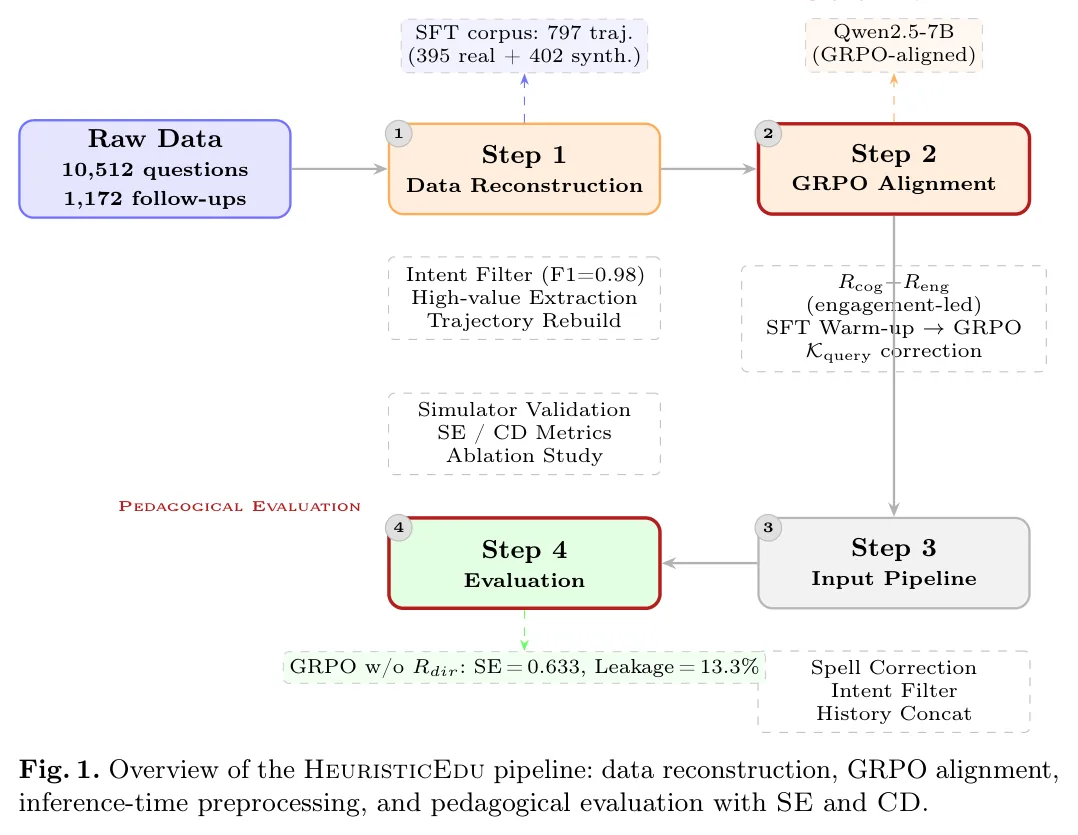
HeuristicEdu 的核心设计遵循两阶段流水线,论文称之为「监督热身 + 强化微调」的递进模式。这种两阶段设计并非随意拼凑,而是针对教育场景的特殊挑战做了务实考量:强化学习虽然擅长发现复杂行为模式,但若直接从随机初始化开始探索,样本效率极低且极易学到扭曲的行为;监督预热阶段先用高质量的苏格拉底对话样本教会模型「基本像样的提问方式」,再在强化学习阶段引入奖励信号精修行为。
第一阶段的监督预热依赖 SocraticEdu 数据集——这是一个从真实在线教育平台重构而来的数据集,包含 797 段中文儿童科学多轮对话。在预训练模型眼里,这些对话展现了「好的教育引导」应当是什么样子:包含恰当的认知深度递进、维持学生好奇心的互动节奏,以及在学生未主动提及时不轻易揭示答案的克制。监督微调让 7B 规模的 Qwen2.5 在这些样本上学习到基础的行为模式。
第二阶段引入了 [[GRPO|群组相对策略优化]] 进行强化学习微调。GRPO 是近年来兴起的一种高效 RL 方法,它不需要单独训练价值网络,而是通过组内相对比较来估计优势函数。论文为这一阶段设计了多层启发式奖励结构:
其中认知深度奖励 鼓励模型提出需要学生深入思考的问题;好奇心参与奖励 评估模型能否维持对话的吸引力;直接性奖励 则是一个「惩罚项」,对模型过早泄露关键词施加负向信号。此外还有一个 修正机制,专门处理学生自己主动提到关键词的情形——此时模型不应因为「学生说了」而受到惩罚。
实验与结果
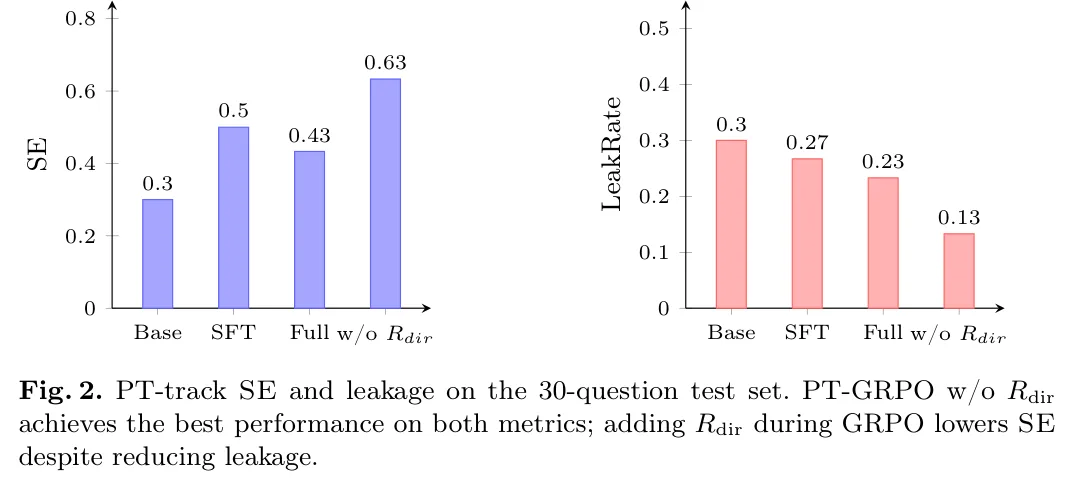
论文在 30 道保留测试题上评估模型表现,采用脚手架有效性(SE)和关键词泄露率作为核心指标。前者衡量模型能否有效引导学生深入思考,后者追踪核心概念是否在首轮被直接暴露。
实验结果呈现出清晰的对比图景。经过 HeuristicEdu 两阶段对齐的 Qwen2.5-7B 最佳变体将 SE 从基线的 30.0% 显著提升至 63.3%,同时将泄露率从 30.0% 大幅压低至 13.3%。这些数字表明强化学习确实捕捉到了「苏格拉底式引导」与「直接给答案」之间的行为差异,并能有效驱动模型向教学目标优化。
然而最值得玩味的是实验揭示的一个内在张力:最优模型变体在 GRPO 训练阶段取消了直接性惩罚项 。这意味着如果论文同时激活认知深度奖励和直接性惩罚,模型的表现反而更差。论文将此解读为显式防泄露约束与梯度对齐之间的冲突——强制模型「不直接说答案」的反向奖励可能干扰了正向教学行为的学习,导致模型在多个目标之间陷入拉扯而难以收敛。这一发现对 RLHF 实践中「简单叠加多个奖励项」的常见思路提出了警示。
另一组对照实验则回答了一个更宏观的问题:单纯放大模型规模能否解决这一问题?答案是否定的。未做任何对齐的 Qwen2.5-72B 基线达到 0% 的脚手架有效性和 96.7% 的关键词泄露率——几乎没有引导行为,几乎首轮就泄露答案。这表明苏格拉底式教学是一种需要专门训练的行为模式,而非大规模预训练的自然涌现结果。
讨论与可借鉴点
HeuristicEdu 的工作揭示了教育 AI 领域一个关键的方法论洞察:[[reinforcement learning alignment|行为对齐]] 在不同任务场景下需要不同的奖励设计哲学。传统 RLHF 以「给出好答案」为目标,而教育场景的真正挑战是学会「不直接给答案、但给出更好的引导」。这种「克制」的 reward shaping 比「主动追求」类目标更微妙,也更容易与其他训练目标产生冲突。
论文的局限同样值得正视。SocraticEdu 数据集规模相对有限(797 条对话),且集中于儿童科学领域,这限制了结论向其他学科或年龄段的可迁移性。此外,论文主要评估关键词泄露这一可量化的代理指标,而苏格拉底式教学真正重要的「学生认知变化」——即学生是否在引导后真正理解并能复述原理——并未在当前评测框架中得到直接衡量。SE 和 CD 指标抓住了表面行为,但学习效果的深层评估仍是开放的难题。
对于这一方向的后续研究,HeuristicEdu 提供了几点可借鉴的启发:两阶段设计在冷启动困难时值得优先考虑;多奖励项叠加时需警惕目标冲突,逐一消融验证比简单加总更稳妥;模型规模与任务特定行为之间并非自动对齐,在教育这类需要后天训练的复杂行为上,规模红利可能相当有限。
摘要
部署在教育场景中的大语言模型(LLMs)通常充当直接回答者的角色:它们在首轮对话中便揭示目标概念,而未能按照苏格拉底式教学法所要求的那样,通过渐进式探究来引导学生。我们提出了 HeuristicEdu,一个两阶段流水线,通过监督预热和群组相对策略优化(GRPO)将 Qwen2.5-7B 对齐为苏格拉底式辅导。训练使用了 SocraticEdu——一个由真实在线平台重构而来的、包含 797 段多轮中文儿童科学对话的数据集,并采用涵盖认知深度(R_cog)、好奇心参与(R_eng)和直接性(R_dir)的启发式奖励,以及针对学生引入术语的 K_query 修正。我们引入脚手架有效性(SE)和对话深度(CD)来评估超越表面流畅度的结果。在 30 个保留测试问题上,最佳 GRPO 变体将 SE 从 30.0% 提升至 63.3%,并将关键词泄露从 30.0% 降低至 13.3%。值得注意的是,这一最佳变体在优化过程中省略了直接性惩罚,表明显式反泄漏项可能与基于梯度的行为对齐产生冲突。未对齐的 Qwen-72B 基线达到 0% 的 SE 和 96.7% 的泄漏率,表明仅靠模型规模无法诱导苏格拉底式行为。
Abstract
Large language models (LLMs) deployed in educational settings often behave as direct answerers: they disclose target concepts in the opening turn instead of guiding students through progressive inquiry, as Socratic pedagogy prescribes. We present HeuristicEdu, a two-phase pipeline that aligns Qwen2.5-7B toward Socratic tutoring via supervised warm-up and Group Relative Policy Optimization (GRPO). Training uses SocraticEdu, 797 multi-turn Chinese children's science dialogues reconstructed from a live platform, with a heuristic reward over cognitive depth (R_cog), curiosity engagement (R_eng), and directness (R_dir), together with a K_query correction for student-introduced terms. We introduce Scaffolding Effectiveness (SE) and Conversation Depth (CD) to evaluate outcomes beyond surface fluency. On 30 held-out questions, the best GRPO variant improves SE from 30.0% to 63.3% and lowers keyword leakage from 30.0% to 13.3%. Notably, this best variant omits the directness penalty during optimization, suggesting that explicit anti-leakage terms can conflict with gradient-based behavioral alignment. An unaligned Qwen-72B baseline reaches 0% SE and 96.7% leakage, showing that scale alone does not induce Socratic behavior.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。