
基于对抗性逆强化学习的无标签工业故障检测:一种面向全寿命失效预测的系统
Label-free Industrial Fault Detection via Adversarial Inverse Reinforcement Learning: A System for Run-to-Failure Prognostics
📝 TLDR
工业机械故障检测面临故障标签稀缺的难题,现有所谓RL方法实质退化为静态上下文老虎机,丢失时序结构。本文提出对抗逆强化学习AIRL框架,将故障检测建模为离线逆强化学习问题,从状态转移中恢复内在健康度奖励,无需人工设计奖励或故障标签。在HUMS2023、IMS、XJTU-SY三个Run-to-Failure基准上,AIRL是唯一在所有数据集上实现非饱和后检测一致性的方法,而上下文老虎机无法捕捉渐变性退化、重建模型则退化为始终异常状态。
🧭 速览
现有监督式与所谓RL方法无法应对真实场景故障标签稀缺问题,且忽略退化的时序动态结构。
将故障检测建模为离线逆强化学习,利用AIRL从观测状态转移中恢复健康度奖励,无需故障标签与人工奖励设计。
在三个Run-to-Failure基准上,AIRL是唯一实现非饱和后检测一致性的方法,CB基线漏检渐变退化,重建模型陷入全异常状态。
证明了时序逆强化学习范式在无标签工业故障检测中的有效性与鲁棒性。
🆚 方法对比
AIRL (Adversarial Inverse Reinforcement Learning)
- 首个将AIRL应用于MFD,无需故障标签
- 离线学习内在健康奖励,免去手工奖励设计
- 奖励与动力学解耦,跨三个数据集非饱和检测
- 紧凑架构适合边缘部署,计算成本低
- 依赖状态序列建模,对短序列可能效果有限
- GAN框架训练不稳定,需调参收敛
- 依赖充足的正常运行轨迹数据进行训练
- 尚未在在线交互场景中验证
Contextual Bandit (CB) formulation
- 实现简单,每个片段独立决策
- 可直接复用监督分类的成熟工具链
- 忽略状态转移与折扣因子,退化为监督分类
- 无法捕捉渐变退化过程,检测一致性差
- 丢弃时间序列结构,不建模长期健康趋势
Supervised Learning for MFD
- 占据约81%研究份额,工具和经验成熟
- 在充足标注数据下分类精度高
- 依赖大量故障标注,真实场景中标签稀缺
- 无法处理未见过的新型故障模式
- 对变工况条件下鲁棒性不足
Reconstruction-based methods
- 可学习正常数据的紧凑表示,无需标签
- 对异常点具有天然的重建误差敏感性
- 依赖静态误差阈值,泛化性差
- 易退化为始终异常状态(饱和失败)
- 难以捕捉时序退化趋势
One-class methods
- 仅用正常数据训练,符合工业数据分布
- 部署简单,适合边缘实时检测
- 对运行工况变化敏感,鲁棒性有限
- 依赖手工阈值策略,难以自适应
State-Only Imitation Learning (SOIL)
- 无需动作标注,适合纯传感器序列数据
- 与AIRL结合可实现免奖励工程流水线
- 对状态表征质量依赖较强
- 在工业传感器噪声下泛化能力待验证
Offline Reinforcement Learning
- 可直接利用预记录的工业数据进行训练
- 无需在线交互,安全性高
- 仍依赖手工设计奖励函数,迁移困难
- 在MFD场景中应用研究极少
论文提出AIRL框架,同时系统对比了监督学习、上下文老虎机、重建方法和单类方法,指出CB与重建方法在渐变退化和饱和失败上的固有缺陷,而AIRL通过离线逆强化学习恢复内在健康奖励,实现唯一跨三个数据集非饱和的后检测一致性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
工业机械故障检测长期受困于故障标签稀缺的问题,现有"基于强化学习"的方法实质退化为静态上下文赌博机,丢失了故障演化的时序结构。本文提出对抗性逆强化学习(AIRL)框架,将故障检测建模为离线逆强化学习问题,直接从正常状态转移中恢复设备内在的"健康度"奖励函数,无需人工设计奖励或故障标签。在三个全寿命失效基准数据集上的实验表明,AIRL是唯一在所有数据集上均实现非饱和后检测一致性的方法,而上下文赌博机无法捕捉渐变性退化,重构模型则退化为始终判为异常的状态。
研究背景与动机
工业设备的故障检测长期依赖监督学习方法,但在真实工业场景中,获取故障标签代价极高且实际操作困难。统计数据表明,约 的故障检测研究采用监督方法,而真正利用强化学习的仅约 。这背后的根本原因是:监督学习需要大量已标注的故障样本,而工业设备的故障本身就是小概率事件,正常运行数据远多于故障数据。
更值得关注的是现有所谓"基于强化学习"的方法存在的根本缺陷。这些方法将问题简化为上下文赌博机形式——把每个传感器片段视为独立的上下文样本,采用单步决策、折扣因子 的设定。这种处理方式完全丢弃了故障退化过程的时序动态特性。工业机械的故障大多是渐变性的:齿轮磨损、裂纹扩展、轴承剥落,这些退化过程都对应着传感器信号的连续变化。静态上下文赌博机无法建模这种时间尺度上的依赖关系,实质上等同于标准的监督分类器。
工业数据的特性进一步加剧了这一困境。设备运行数据通常是离线观测收集的,缺乏明确的控制动作,难以直接应用标准的在线强化学习框架。如何在无标签、无人工奖励设计的约束下,从正常运行时采集的观测序列中学习能够表征设备健康状态的信号,成为一个亟待解决的问题。
方法
本文的核心创新在于将故障检测建模为离线逆强化学习问题,采用 AIRL 框架从状态转移中恢复设备内在的"健康度"奖励。由于离线数据缺乏控制动作,论文引入了 State-Only Imitation Learning 范式,将下一时刻的观测作为代理动作。具体而言,给定标准化的振动信号 ,状态定义为 ,代理动作定义为 ,从而将状态转移建模为 。
AIRL 判别器的形式为:
其中 为奖励网络, 为价值函数提供基于势能的奖励塑形, 为策略网络, 为折扣因子。这一设计的精妙之处在于:时间折扣因子 的引入使得奖励信号能够沿着时间轴传播,健康状态的微小恶化会在未来多个时间步上累积体现,从而捕捉渐变性退化过程。
网络架构采用极简设计,三个网络均为两层 MLP(隐藏层 64 单元),总参数量仅 644 个。奖励网络输入状态-动作对 输出标量奖励,价值网络输入状态输出累积奖励估计,策略网络采用高斯策略。这种轻量化设计使得推理阶段仅需对标量对 进行运算,无需高维矩阵乘法,非常适合工业边缘设备部署。
训练过程中,判别器通过交叉熵损失区分专家轨迹(正常状态转移)与策略生成的轨迹,同时策略网络通过 REINFORCE 梯度最大化期望奖励。价值函数提供基于势能的奖励塑形,确保学到的奖励函数在状态空间中是平滑变化的,从而刻画出健康的流形结构。异常分数定义为 ,训练完成后可直接用于实时推理。
实验与结果
实验在三个全寿命失效基准数据集上进行:直升机齿轮箱数据集 HUMS2023、轴承数据集 IMS、以及轴承数据集 XJTU-SY。对比基线覆盖了传统方法(Isolation Forest、OCSVM)、多种重构方法(AE、VAE、LSTM-AE、USAD)、注意力方法(Anomaly Transformer)以及上下文赌博机基线(CTQN)。
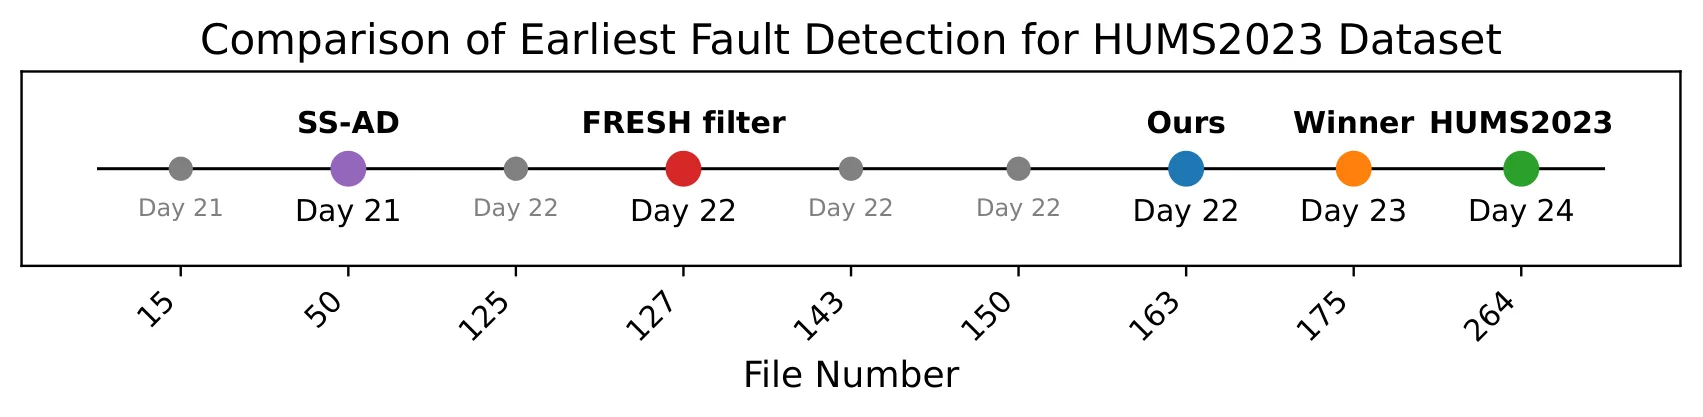
核心发现是:AIRL 是唯一在所有三个数据集上均保持非饱和检测的方法。在 HUMS2023 数据集上,AIRL 在 Day 22 #163 检测到异常,性能介于 FRESH 滤波器(Day 22 #127)与挑战赛冠军(Day 23 #175)之间。在 IMS 数据集上,AIRL 在 11 月 17 日精确落入退化窗口,而消融版本()在 11 月 9 日就产生误报,说明时间折扣因子对于避免噪声干扰至关重要。在 XJTU-SY 数据集上,AIRL 在第 459 分钟检测到异常,与约 500 分钟的真实退化起点相距仅 45 分钟,属于有价值的早期预警。
消融实验提供了强有力的证据说明序列化建模的必要性。当 时(退化为上下文赌博机设定),AIRL 在三个数据集上的检测性能均显著下降:HUMS 数据集上全部样本被判为异常(饱和失败),IMS 数据集上提前产生大量误报。这直接验证了论文的核心论点——时序结构对于捕捉渐变性退化至关重要。
重构类方法则呈现出另一种失败模式:AE、VAE、USAD 等模型在训练阶段接触大量正常数据后,学到的正常流形过于"紧致",导致测试阶段几乎所有样本都产生高重构误差,表现为持续误报状态。这种"always-anomalous"的现象说明,仅依靠静态误差阈值难以处理非平稳的退化过程。
讨论与可借鉴点
这篇论文最深刻的方法论启示在于揭示了时序结构丧失的代价。故障检测领域长期存在两条路线:基于重构误差的方法和基于分类置信度的方法,但两者都倾向于将时序数据扁平化为静态向量处理。本文通过系统的对比实验表明,时间折扣因子不仅仅是超参数,它决定了方法能否建模跨时间步的因果依赖——设备状态的微小恶化会在未来多个时间点上累积体现,只有序列化的建模才能捕捉这种信号。
从工程角度看,AIRL 的极轻量设计(644 参数)为工业边缘部署提供了新思路。推理阶段仅需处理标量对操作,无需 GPU 或复杂矩阵运算,可以直接嵌入到振动传感器的微控制器中实现实时监测。这种"小模型、大框架"的策略值得借鉴:在边缘侧部署轻量模型,利用云侧进行离线逆强化学习训练,奖励函数更新后再部署到边缘。
当前方法的局限性主要体现在几个方面。单通道标量输入的设计虽然简洁,但丢弃了多传感器工业系统中跨通道的相关性信息。IMS 数据集上高达 的预故障虚警率提示,非平稳退化过程的阈值自适应仍需改进。此外,论文仅在 3 个公开数据集上验证,工业现场的多变工况、传感器噪声等因素的实际影响尚需进一步评估。
对于后续研究而言,AIRL 框架的可扩展性是一个有价值的探索方向——如何将标量状态扩展到多传感器融合,如何在运行时自适应更新健康流形以应对工况漂移,以及如何为学到的奖励函数提供不确定性量化,这些都是值得深入的问题。
摘要
机械故障检测(MFD)仍然严重依赖监督学习,而监督学习在真实场景中难以应对故障标签稀缺的问题。尽管强化学习(RL)提供了建模退化过程时序性的框架,但当前"基于RL"的MFD方法将问题简化为静态上下文赌博机(CB)形式:它们忽略状态转移并舍弃时间折扣因子,从而退化为标准的监督分类。我们提出一种对抗性逆强化学习(AIRL)框架,将MFD视为离线逆强化学习问题。不同于依赖静态误差阈值的重构方法,或忽略动态特性的CB方法,我们的方法直接从观测状态转移中恢复内在的"健康"奖励,既无需手工设计奖励函数,也不需要故障标签。在三个全寿命失效基准数据集(HUMS2023、IMS、XJTU-SY)上,AIRL是唯一在所有数据集上均实现非饱和检测后一致性的方法,而CB基线无法检测渐进性退化,重构模型则退化为始终判为异常的状态。代码与数据:https://github.com/dhirajneupane/AIRL-MFD-DN
Abstract
Machinery fault detection (MFD) remains heavily reliant on supervised learning, which struggles with the scarcity of fault labels in real-world settings. While reinforcement learning (RL) offers a framework to model the sequential nature of degradation, current ``RL-based'' MFD methods reduce the problem to a static contextual bandit (CB) formulation: by ignoring state transitions and discarding the temporal discount factor, they collapse to standard supervised classification. We propose an adversarial inverse reinforcement learning (AIRL) framework that treats MFD as an offline IRL problem. Unlike reconstruction-based approaches that rely on static error margins, or CBs that ignore dynamics, our method recovers an intrinsic "health" reward directly from observational state transitions, requiring neither manual reward engineering nor fault labels. On three run-to-failure benchmarks (HUMS2023, IMS, XJTU-SY), AIRL is the only method achieving non-saturated post-detection consistency across all datasets, while CB baselines fail to detect gradual degradation and reconstruction models collapse into always-anomalous states. Code and data: https://github.com/dhirajneupane/AIRL-MFD-DN.
论文详细总结(自动生成)
论文总结:基于对抗性逆强化学习的无标签工业故障检测
一、核心问题与研究动机
- 标签稀缺瓶颈:工业机械故障检测(MFD)严重依赖监督学习,但真实场景中故障标签代价极高;约 的研究采用监督方法,仅约 真正使用强化学习。
- "伪 RL"问题:现有所谓 RL-based MFD 方法普遍将问题简化为静态上下文赌博机(Contextual Bandit, CB)——把每个传感器片段视为独立上下文、单步动作、,从而退化为标准监督分类,无法建模故障退化的时序动态。
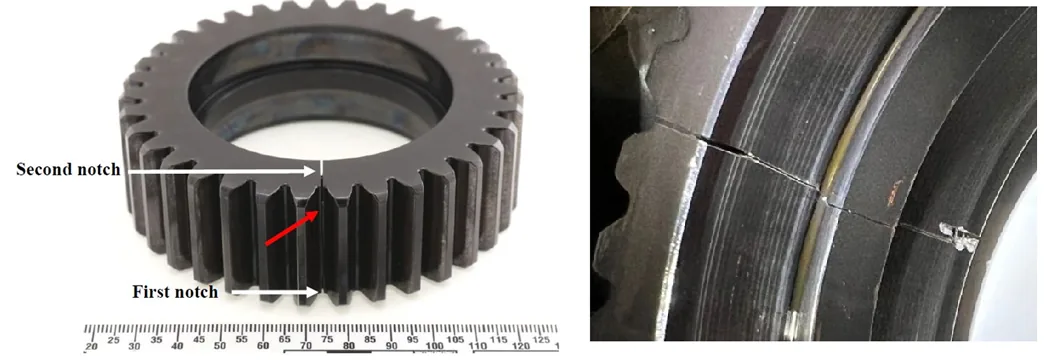
- 工业数据特性:故障多为渐变性(磨损、裂纹、断齿),工业数据多为离线观测、缺乏控制动作,难以进行在线 RL 或手工设计精确奖励函数。
- 研究空白:逆强化学习(IRL)能够直接从正常轨迹中学习奖励,但尚未在 MFD 领域被探索。
二、方法论:AIRL 框架
1. 整体思路
将 MFD 建模为离线逆强化学习问题,采用对抗性逆强化学习(AIRL)从状态转移中恢复内在"健康度"奖励,无需手工奖励或故障标签。
2. 状态转移构建(SOIL 范式)
由于离线数据无控制动作,采用 State-Only Imitation Learning,将下一观测作为代理动作:
其中 为基于健康训练统计量做 -normalization 的振动信号。
3. AIRL 判别器
其中 为奖励网络, 为价值函数(提供基于势能的奖励塑形), 为策略, 为折扣因子。
4. 网络架构
- 三个网络均为两层 MLP(隐藏层 64 单元,ReLU 激活)
- 奖励网络 :输入 ,输出标量奖励
- 价值网络 :输入 ,输出累积奖励
- 策略网络 :高斯策略 , 与状态无关
- 总参数量仅 644(reward 257 + value 193 + policy 194),比深度基线小 1–4 个数量级
5. 训练流程
- 判别器损失(AIRL 交叉熵):
- 策略改进:REINFORCE 梯度 ,使用 50 步回报,附加熵正则
- Adam 优化器 , epochs,每 epoch 50 条策略回合
- mini-batch=128,
6. 异常评分与阈值化
- 异常分数:
- 评估了 7 种阈值策略:、、max 系列(max / max-SE / max-2SE)、percentile 、Otsu、-means 中点、GPD 尾部分位
- 所有阈值由健康训练分数一次性校准,测试时固定
三、实验设计
1. 数据集(3 个 Run-to-Failure 基准)
| 数据集 | 类型 | 采样/处理 | 训练(健康) | 测试(混合) | GT 起始 |
|---|---|---|---|---|---|
| HUMS2023 | 直升机齿轮箱 | H-SSA(4095 点) | Day 17–20(282) | Day 21–27(526) | Day 24 #264 |
| IMS Test 1 | 轴承(通道1) | 4096 点,5 段/样本 | Oct 1–31(1840) | Nov 1–25(8940) | mid-Nov |
| XJTU-SY | 轴承 3_1(40 kHz, 10 kN) | 4096 点,8 段/样本 | 前 2000(~250 min) | 剩余 18295 | ~500 min |
2. 对比方法(共 10 个基线)
- 传统一类方法:IF(400 estimators)、OCSVM(RBF 核,)
- 重构方法:AE/VAE(~8.95M 参数)、LSTM-AE/LSTM-VAE(~167K/184K)、TCAE(~14K)、CTCAE(~47K)、USAD(~13.4M)
- 注意力方法:ATF(Anomaly Transformer,~146K)
- Contextual-Bandit 基线:CTQN(重新实现的 LiteDPER-CTQN)
3. 评估指标
- 不采用 AUROC 的理由:缺乏逐样本二值标签、回溯故障起点具不确定性
- 替代指标:Timeliness(最早检测时刻)、Pre-GT FAR(误报率)、Post-Detection Consistency (PDC)(检测后一致性)
- 显式标记饱和失败(Saturation Failure):当 FAR 时,高 PDC 实为误报持续而非真实识别
四、资源与算力
- 论文未明确给出 GPU 型号、数量或训练时长
- 仅提供了参数量与架构规模对比:AIRL 仅 644 参数,TCAE ~14K、LSTM-AE ~167K、ATF ~146K、AE ~9.0M、USAD ~13.4M
- 推理阶段 AIRL 仅对标量对 操作,无需对高维序列做矩阵乘法,适合边缘部署
- 每个方法运行 10 个随机种子取平均分数
五、实验数量与充分性
- 跨数据集实验:3 个数据集 × 10 个基线 × 10 随机种子,矩阵化比较
- 评估框架:同时报告 7 种阈值策略下的最早检测时刻(Table 5),覆盖两种阈值类型(max-2SE 严格 vs Otsu 自适应)
- 消融实验:(myopic / CB 退化版)vs (完整 AIRL),在三个数据集上对比,揭示序列化的三大优势
- 基线对比广度:包含 8 个深度方法 + 2 个传统方法 + 1 个 CB 代理,覆盖重构、对比、对抗、注意力等多种范式
- 公平性:所有方法共享同一阈值规则、相同训练/测试划分、相同阈值化协议;AIRL 与 CTQN 直接对比以验证时序性主张
- 局限性:仅 3 个公开数据集,工业部署验证缺失
六、主要结论与发现
- AIRL 在三个数据集上均为唯一非饱和方法:FAR 均低于 90% 饱和阈值,PDC 分别为 79.09%(HUMS)、90.15%(IMS)、68.38%(XJTU-SY)
- HUMS:AIRL 检出 Day 22 #163,介于 FRESH filter(Day 22 #127)与挑战赛冠军(Day 23 #175)之间,对齐委员会验证起点
- IMS:AIRL 检出 Nov 17 12:22:30,精确落入 mid-Nov 退化窗口; 消融版却检出 Nov 9(噪声误报)
- XJTU-SY:AIRL 检出 minute 459,与 ~500 min 起点相距 45 min 的早期预警窗口
- 失败模式归纳:
- 重构类(AE/VAE/USAD/ATF)→ 早触发、持续误报(饱和)
- 静态 CB(CTQN)→ HUMS 模式崩溃(全部报故障)、IMS 提前误报
- 对比类(CTCAE)→ 完全漏检(PDC=0)
- 阈值推荐:Max-2SE(早期预警)、Max-SE(保守确认)
- 消融三大结论:序列化 → 健康流形更紧致、对噪声具时间信用分配能力、跨阈值稳定性更强
七、优点与亮点
- 方法论创新:首次将 AIRL 系统性引入 MFD,提出"RL ≠ CB"的批判并给出实证证据
- 理论-工程闭环:使用 SOIL 巧妙规避无控制动作问题,将下一观测作为代理动作
- 极轻量架构:644 参数即可在工业边缘部署,推理仅需标量对
- 创新评估框架:明确弃用 AUROC,引入 PDC + 饱和失败标记,避免高 PDC 由误报堆砌产生的假象
- 跨数据集一致性:是唯一在齿轮箱 + 两种轴承数据集上同时保持非饱和表现的方法
- 实用性强:给出 ≥250 健康文件即可部署的完整流程、阈值自校准、不需验证集
八、不足与局限
- 仅单通道标量输入:当前为 ,丢弃了多传感器工业系统的跨通道相关性
- 数据集多样性有限:仅 3 个公开 run-to-failure 基准,缺少工业现场在线试验
- IMS 表现偏弱:渐变性轴承退化导致分数范围压缩,预 GT FAR 高达 88%,提示需要非平稳/分布漂移自适应的阈值机制
- 奖励不确定性未量化:缺乏对所学奖励函数的置信区间或分布外检测能力
- AIRL 假设敏感性:对状态转移模型假设较强,传感器噪声、工况变化可能影响健康流形刻画
- 饱和失败标记虽合理,但缺乏定量"去饱和"机制:当前仅做定性识别,并未提供算法层面的自动修正
- 算力信息缺失:未报告 GPU 型号、训练时长,难以复现成本评估
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。