
LLM 游戏智能体中的空间推理:因果上下文与多步规划的影响
Spatial Reasoning in LLM Game Agents: Impact of Causal Context and Multi-Step Planning
📝 TLDR
LLM 游戏智能体在复杂任务上表现不佳,本文聚焦其空间推理能力。基于开源 Qwen3 系列模型,在自建的 GVGAI 三游戏五难度基准上,评估位置定位准确率与游戏胜率,并引入因果提示增强与多步规划。实验表明更大模型结合思维模式定位更准,加入因果上下文显著提升胜率,多步规划还缩短了单步响应时间。
🧭 速览
LLM 游戏智能体在复杂任务中表现差,怀疑空间推理能力不足,且缺乏针对空间导航的系统评测基准。
基于 Qwen3 模型族,在自建 GVGAI 三游戏五难度基准上,通过定位实验与游戏胜率评估,测试不同模型规模、思维模式与规划步数下因果提示与多步规划的效果。
大模型开思维模式定位更准;因果上下文显著提升胜率,尤其是大模型;多步规划降低单步响应时间;胜率随难度与布局复杂度上升而下降,验证基准难度梯度有效。
因果提示增强与多步规划可有效改善 LLM 游戏智能体的空间推理与执行效率,模型规模与推理深度是关键因素,存在推理深度与速度的实用折中。
🆚 方法对比
暂未生成 — 点击下方按钮
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 6 张)
展开查看 6 张图
TL;DR
这篇论文探索了大语言模型在游戏场景中的空间推理能力,发现即使是最强的模型在精确坐标匹配上仍存在明显短板,但通过引入因果上下文提示和结合多步规划策略,可以显著提升游戏胜率并有效控制响应延迟。研究者基于开源的 Qwen3 系列模型构建了一套分级基准测试,将空间导航能力从复杂的游戏表现中剥离出来进行独立测评。
研究背景与动机
基于 LLM 的游戏智能体近年来吸引了大量关注,但当任务复杂度上升时,这些系统往往表现出明显的局限性。研究者们此前倾向于将失败归因于模型规模不足或缺乏领域知识,却忽略了一个更基础的问题:LLM 是否具备足够精确的空间推理能力?
空间推理在游戏环境中至关重要——智能体需要知道自己在哪里、目标在哪里、如何在复杂布局中导航到目标位置。如果模型连自身位置的精确坐标都无法准确判断,那么无论后续的决策策略多么精巧,都像是建立在流沙之上的建筑。这一问题的关键在于,传统的游戏表现指标往往混合了空间推理、策略规划和执行控制等多种能力,使得研究者难以定位瓶颈的真正所在。
本研究的核心动机是将空间推理能力从复杂的游戏表现中解耦出来,单独进行测评。为此,研究者没有使用现成的游戏 benchmark,而是专门构建了一套聚焦于空间导航能力的评估体系,以便更清晰地诊断 LLM 在这一基础能力上的短板,并验证因果提示与规划策略能否对症下药。
方法
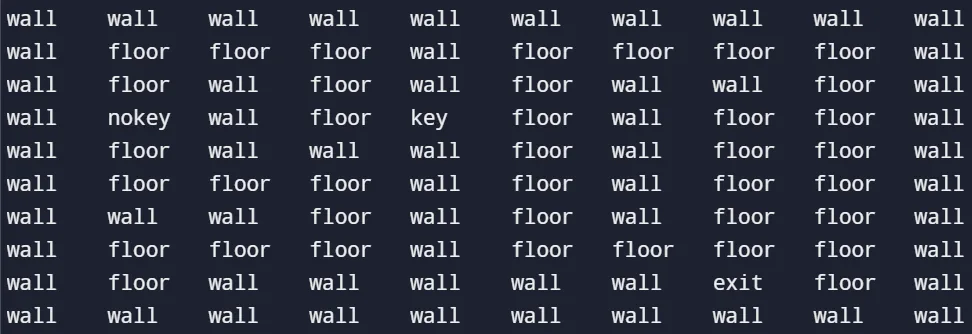
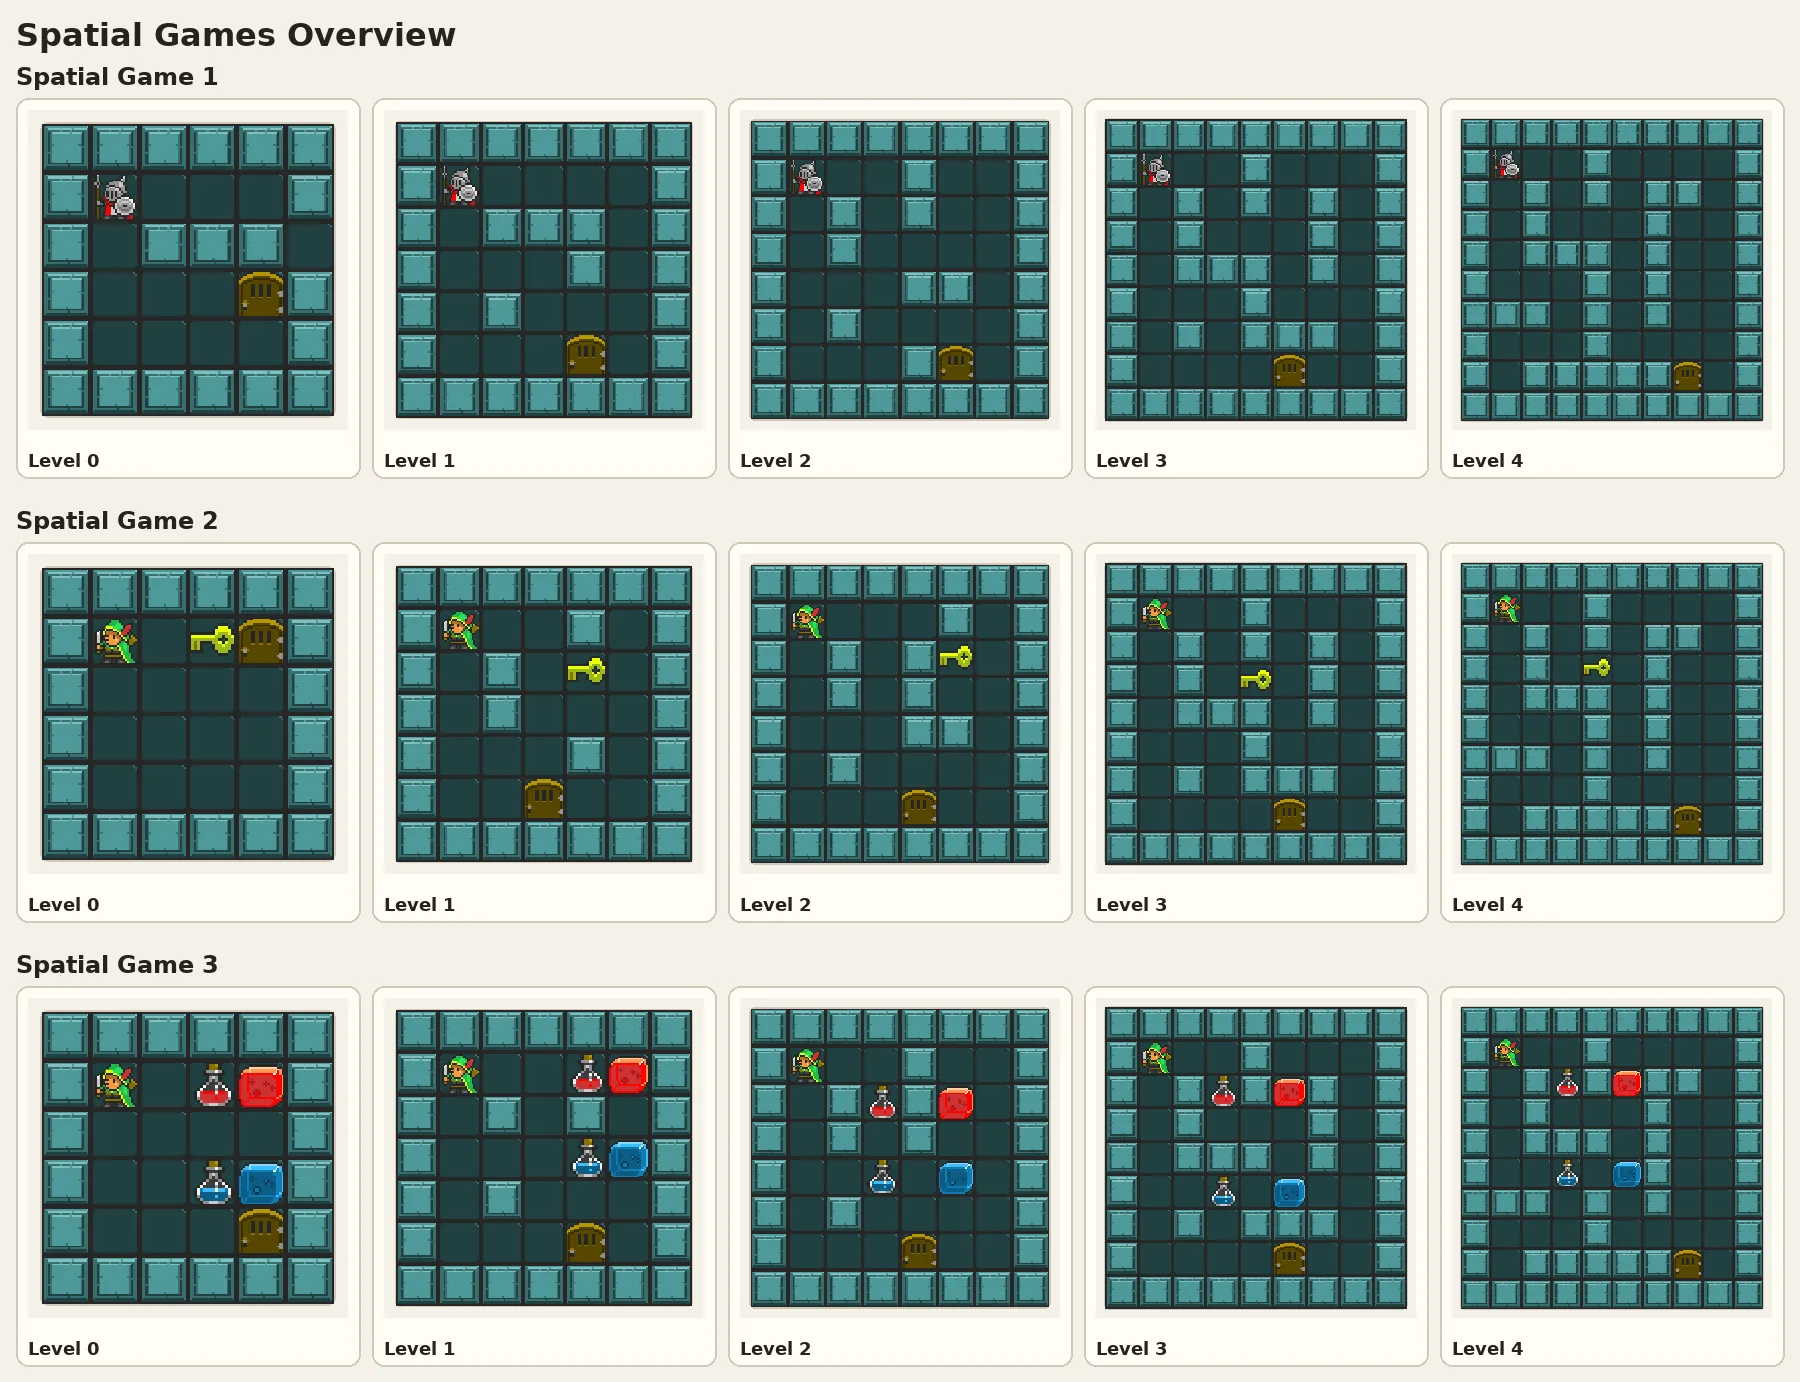
研究者选取了阿里巴巴开源的 Qwen3 系列模型作为测试对象,该系列覆盖了从 0.6B 到 72B 参数的多个规模档位,便于系统性地考察模型尺度对空间推理的影响。实验的核心是基于 GVGAI(Video Game Generative Artifacts)框架构建的自定义基准测试,包含三个不同规则的自定义游戏,每个游戏设有五个递进的难度级别,难度梯度主要体现在环境布局复杂度和关卡规模上。
评估采用两种互补的范式。定位实验要求智能体在游戏开始时判断自身的精确坐标——这是一个纯空间推理任务,不涉及任何策略选择或动作规划,可以直接反映模型对空间信息的编码与提取能力。游戏胜率研究则让智能体完整地游玩整个关卡,记录其最终通关的成功率,这衡量的是空间推理与决策能力的综合表现。
在干预策略上,研究者引入了因果提示增强,具体做法是在标准提示中显式加入游戏机制之间的因果关系描述——例如说明「按下开关会打开特定门」「敌人会沿固定路径巡逻」等因果规则,让模型在推理时能够调用结构化的因果知识而非仅依赖上下文模式的匹配。同时,实验还评估了多步规划策略,即让模型在每一步行动前生成一个规划序列(类似思维链的变体),并在一定跨度内累积规划结果后再执行,以牺牲部分即时响应速度换取更深入的前瞻推理。
实验与结果
定位实验的结果揭示了模型规模与推理模式之间复杂的交互效应。启用思维模式(thinking mode)后,较大规模的模型(尤其是 30B 参数以上的版本)能够更准确地识别自身所在网格的坐标,但对于小规模模型,思维模式的加入并未显著改善定位精度,整体的坐标匹配准确率仍然偏低。这表明小模型即使获得更多「思考」机会,也难以真正补足空间表征能力的缺陷。
游戏胜率的实验结果进一步验证了基准测试设计的有效性:随着游戏关卡难度和布局复杂度的提升,所有模型的胜率都呈现单调下降趋势,说明五级难度的梯度划分确实捕捉到了任务难度的真实变化。关键发现是,引入因果上下文后,智能体的成功率普遍有所提升,尤其是在较大的模型上效果更为显著——这暗示大模型具备更强的能力来吸收和利用显式的因果规则,并将其转化为更优的决策。
多步规划的表现则呈现出推理深度与执行速度之间的经典权衡。启用更长规划跨度后,模型在游戏中的整体表现明显改善,胜率提升的同时还伴随着一个意外的收益:单步的平均响应时间反而缩短了。这是因为规划序列的生成可以跨步骤共享计算结果,避免了为每一步单独进行完整推理的冗余开销,从而在保持推理深度的同时提高了运行效率。
讨论与可借鉴点
这项研究最直接的价值在于提供了一套可复现的空间推理测评范式——将导航能力从游戏综合表现中剥离出来单独测量,使得研究者能够更精准地诊断 LLM 在复杂环境中的能力短板。无论是设计新的游戏 AI benchmark 还是构建具身智能体的仿真测试,都可以借鉴这种「定位实验 + 任务成功率」的双轨评估思路。
从实践角度看,因果提示增强作为一种几乎不增加推理成本的干预手段,对大模型的胜率有稳定提升,这为开发者提供了一个低门槛的优化方向。而多步规划所展现的「推理更深、速度反而更快」现象也值得关注——它暗示在某些任务上,为模型提供更宽阔的规划视野可能比追求单步响应速度更为明智。
研究的局限性同样值得正视。首先,仅测试了 Qwen3 一个模型家族,结论在其他模型架构上的泛化性尚待验证。其次,自定义的三款游戏虽然覆盖了不同的规则类型,但样本量仍然偏小。此外,定位实验中的「精确坐标匹配」可能是一个过于严苛的指标——在真实游戏中,智能体或许只需要知道「自己在房间A的角落」这样的粗粒度位置就能做出有效决策,过于精确的坐标要求可能高估了任务的必要性。未来的工作可以从更丰富的模型族、更大规模的游戏库以及多粒度的位置表征等方面继续深入。
摘要
基于 LLM 的游戏智能体在处理更复杂的任务时往往表现不佳。本研究考察这些失败是否与有限的空间推理能力相关,并评估因果提示增强与多步规划是否能够在管理响应延迟的同时提高胜率。我们使用开源的 Qwen3 模型系列,在不同的模型规模、推理模式和规划跨度下开展实验。此外,我们还引入了一个聚焦的 GVGAI 基准测试,该基准包含三个自定义游戏和五个难度级别,用于隔离空间导航能力。评估遵循两种范式:初始的"定位实验"用于测试智能体寻找其精确坐标的能力,以及一项关于游戏玩法成功率的研究。我们的结果表明,尽管启用了思维模式(thinking mode)的较大模型能够更准确地识别自身位置,但在坐标匹配方面,整体性能对于较小模型仍然有限。随着游戏关卡和布局复杂度的增加,胜率随之下降,这验证了基准测试的难度梯度。将因果上下文整合到提示中往往会提高智能体的成功率,尤其是对于较大的模型而言。虽然启用思维模式和更长的规划跨度能够显著提升性能,但多步规划进一步降低了每步的平均响应时间,为推理深度与执行速度之间提供了一个实用的权衡。
Abstract
LLM-based game agents often perform poorly on more complex tasks. This work examines whether these failures are linked to limited spatial reasoning and evaluates whether causal prompt augmentation and multi-step planning can improve win-rates while managing response latency. Using the open-source Qwen3 model family, we conduct experiments across varying model scales, reasoning modes, and planning horizons. We further introduce a focused GVGAI benchmark consisting of three custom games with five difficulty levels to isolate spatial navigation. The evaluation follows two paradigms: an initial ``positioning experiment'' to test an agent's ability to find its exact coordinates, and a study of game-play success. Our results show that while larger models with an enabled thinking mode identify their positions more accurately, overall performance in coordinate matching remains limited for smaller models. Win rates decrease as game levels and layout complexity increase, validating the benchmark's difficulty scaling. Integrating causal context into the prompts tends to improve the agents' success rates, particularly for bigger models. While enabling thinking mode and longer planning horizons significantly improve performance, multi-step planning further reduces mean per-step response times, offering a practical trade-off between reasoning depth and execution speed.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。