
解构离策略比率:面向异步强化学习的熵缩放信任域
Deconstructing Off-Policy Ratios: Entropy-Scaled Trust Regions for Asynchronous Reinforcement Learning
📝 TLDR
异步强化学习通过重叠rollout生成与策略优化来加速LLM后训练,但陈旧off-policy数据会破坏优化并引发策略崩溃。现有方法仅以重要性比的绝对幅值作为统一过滤阈值,忽略其与token熵的系统性耦合。本文揭示二者耦合关系并提出熵缩放信任域ESTR,无需额外前向传播或版本切换检测。在长程智能体与数学推理上,ESTR优于现有异步方法,train-inference一致性最佳,相对同步GRPO精度相当但训练提速2.6倍。
🧭 速览
重要性比的绝对幅值随token熵系统变化,导致统一阈值在低熵处放大采样噪声、在高熵处误剪由in-flight更新触发的有意义探索。
提出熵缩放信任域ESTR,按token局部熵动态缩放off-policy偏离作为信任域,无需额外前向传播或显式版本切换检测。
在长程智能体与数学推理基准上,ESTR优于现有异步方法,train-inference一致性最佳,相对同步GRPO精度相当但训练提速2.6倍。
熵缩放视角为异步RL中off-policy修正提供原则性方案,在加速训练的同时有效防止策略崩溃。
🆚 方法对比
ESTR (Entropy-Scaled Trust Region)
- 无需辅助前向传播或版本切换检测
- BrowseComp-Plus上达37.3 avg@1,优于最优基线34.9
- 训练推理一致性最佳,比同步GRPO快2.6×
- 按token熵动态调整信任区域边界
- 依赖熵与重要性比率的经验关系
- 熵阈值参数仍需调优
- 仅在长视野任务上验证,未覆盖短任务
区间裁剪 (Interval Clipping)
- 实现简单,仅约束比率到固定区间
- 在标准场景下能有效控制方差
- 全局统一阈值忽略token位置差异
- 低熵处错误接纳放大噪声,高熵处错误抑制探索
- 假设单一明确定义的行为策略
硬掩码 (Hard Masking)
- 直接丢弃超出范围的token贡献
- 机制简单,易于部署
- 与裁剪共享统一阈值缺陷
- 无差别地抑制权重更新触发的真实探索
- 忽略token熵的局部不确定性差异
陈旧度解耦 (Staleness-Mismatch Decoupling)
- 显式建模版本滞后问题,更具原则性
- 可区分不同陈旧程度的样本
- 增加系统实现复杂度
- 陈旧度定义和阈值仍依赖经验设定
离策略目标设计 (Off-Policy Objective Design)
- 提供替代优化目标以提升鲁棒性
- 可与重要性比率修正正交使用
- 目标重构可能带来额外计算开销
- 可能牺牲异步训练吞吐量优势
ESPO (基于熵的序列重分组)
- 引入熵作为修正信号
- 在序列级别进行重分组
- 假设熵与修正的静态关系
- 未能处理轨迹内版本切换现象
- 重分组粒度仍较粗
同步GRPO (Synchronous GRPO)
- 在策略训练,收敛性有理论保障
- 无陈旧数据问题,优化稳定
- 吞吐量受限,比ESTR慢2.6×
- 长视野多轮任务中效率瓶颈明显
现有方法(区间裁剪、硬掩码、ESPO等)均依赖重要性比率幅值的统一阈值,而ESTR首次将信任区域与token熵耦合,揭示了低熵放大噪声、高熵承载真实探索的本质差异,在保持异步吞吐量优势的同时达到同步GRPO的精度水平。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 28 张)
展开查看 28 张图
TL;DR
异步强化学习通过重叠 rollout 生成与策略优化显著加速 LLM 后训练,但离策略数据会破坏优化稳定性甚至导致策略崩溃。本文发现重要性比率的「自然尺度」与 token 熵存在系统性耦合:低熵处训练-推理差异被放大为采样噪声,高熵处 in-flight 权重更新则产生合理探索。现有方法仅用固定阈值过滤,陷入「接纳噪声、扼杀探索」的两难。论文提出熵缩放信任域 ESTR,根据每个 token 的局部熵动态调整信任域边界,在无需额外前向传播的情况下实现最佳训练-推理一致性,精度媲美同步 GRPO 的同时训练速度提升 2.6 倍。
研究背景与动机
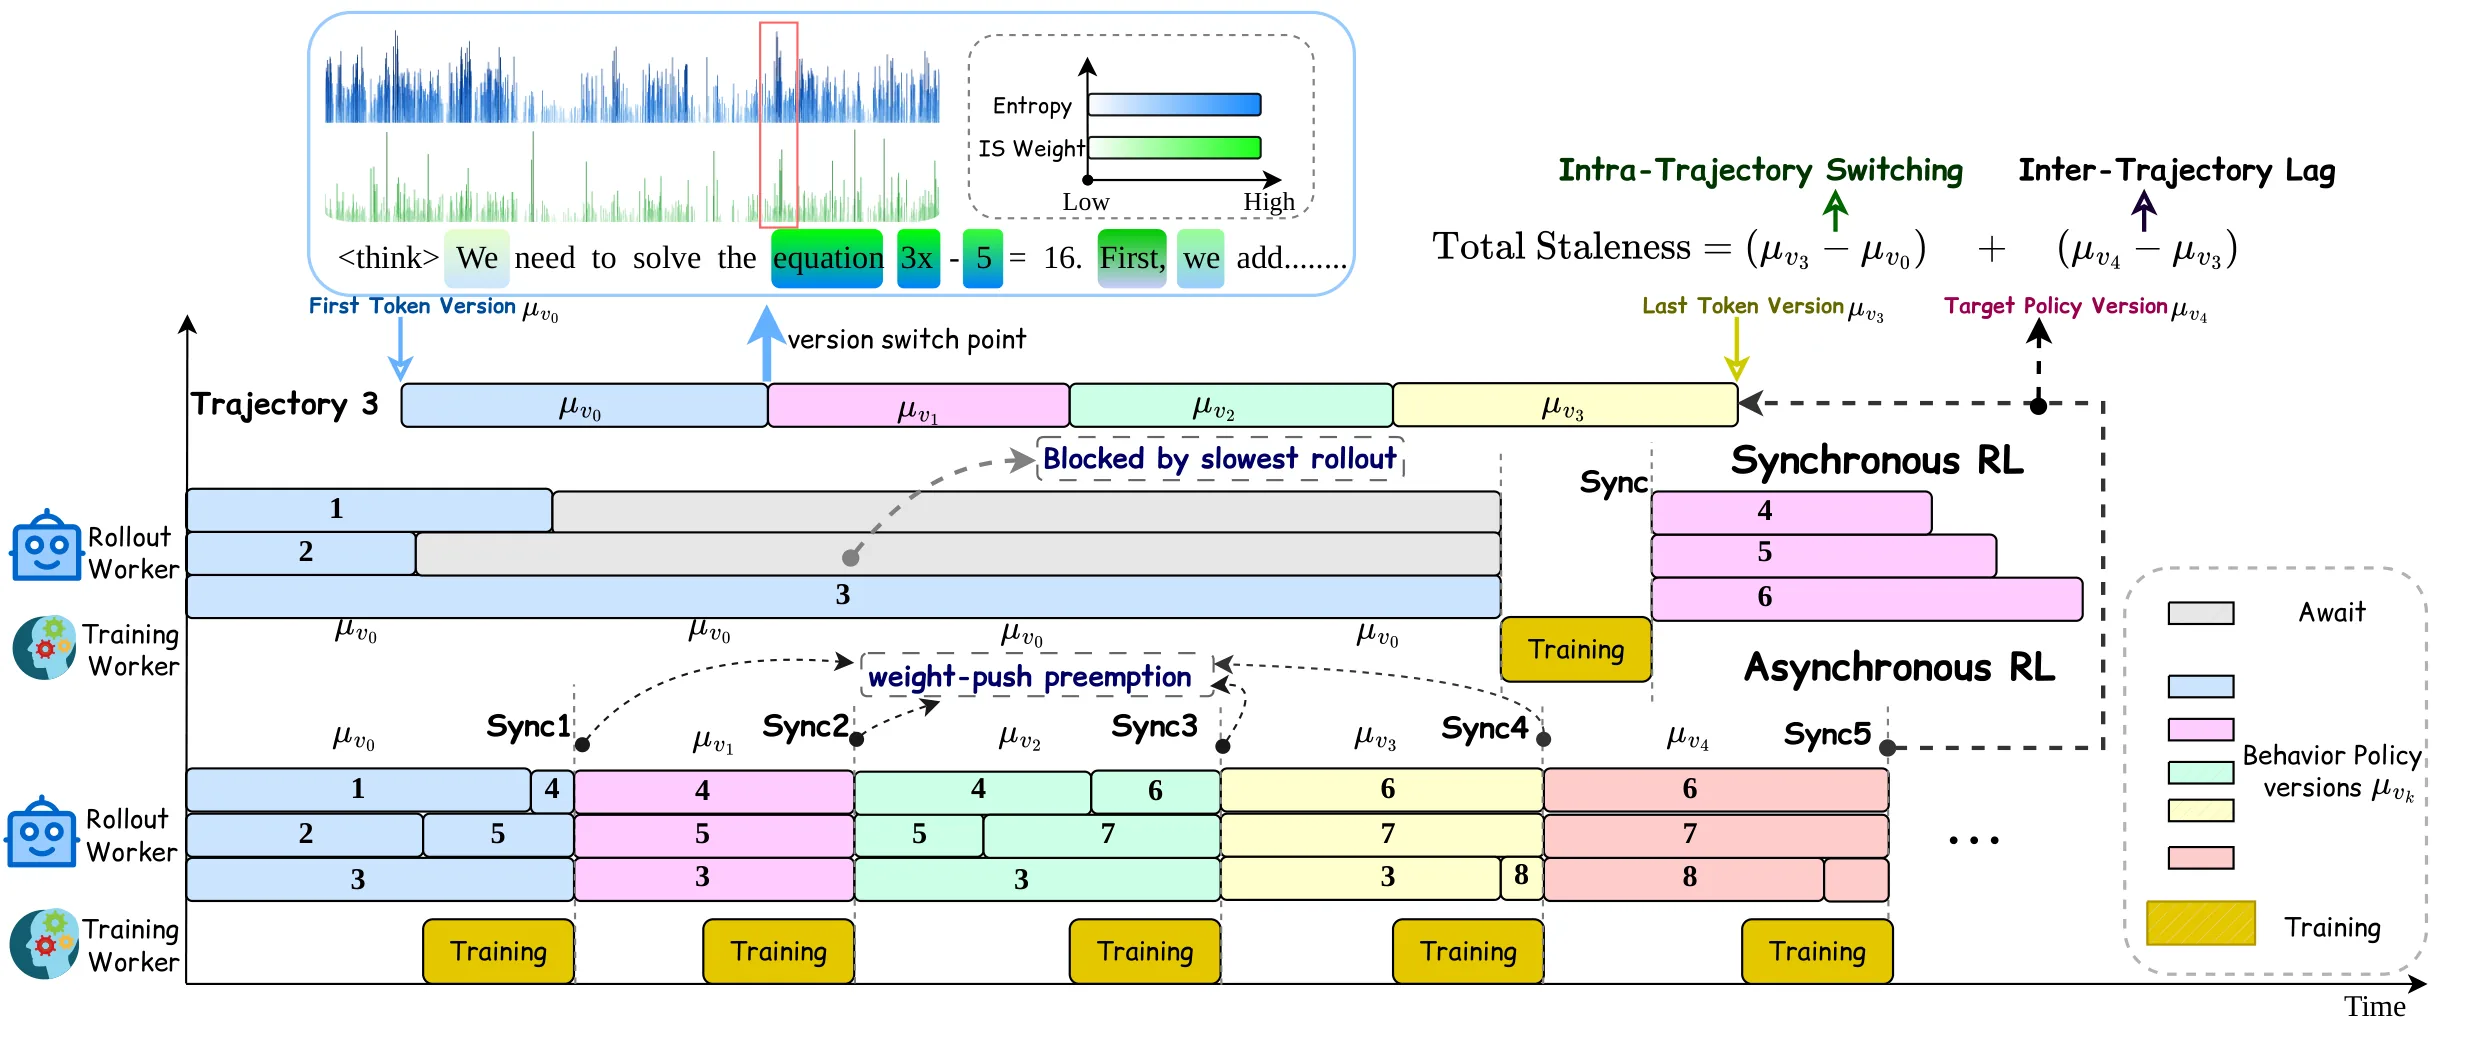
异步强化学习已成为大规模 LLM 后训练的主流范式。与传统的同步训练不同,异步模式将 rollout 生成与策略优化并行运行——当一个 worker 还在用旧策略 采样轨迹时,策略权重可能已经更新了多个版本。这种设计带来了显著的吞吐量收益:在同等硬件配置下,训练速度可提升数倍。然而,其代价是用于训练的 rollout 数据不可避免地变得「陈旧」(stale):轨迹是由滞后的行为策略生成的,而优化目标却是当前策略。
这种 off-policy 特性在理论上需要用重要性比率(importance ratio) 来修正已有方法(如 GRPO 或 PPO)的主流稳定化方案——无论是最基础的区间裁剪(IcePop)还是更精细的双向 KL 散度掩码(KPop)——都遵循同一逻辑:计算每个 token 的重要性比,根据其绝对幅值 决定保留或丢弃,并在线上统一施加固定阈值。
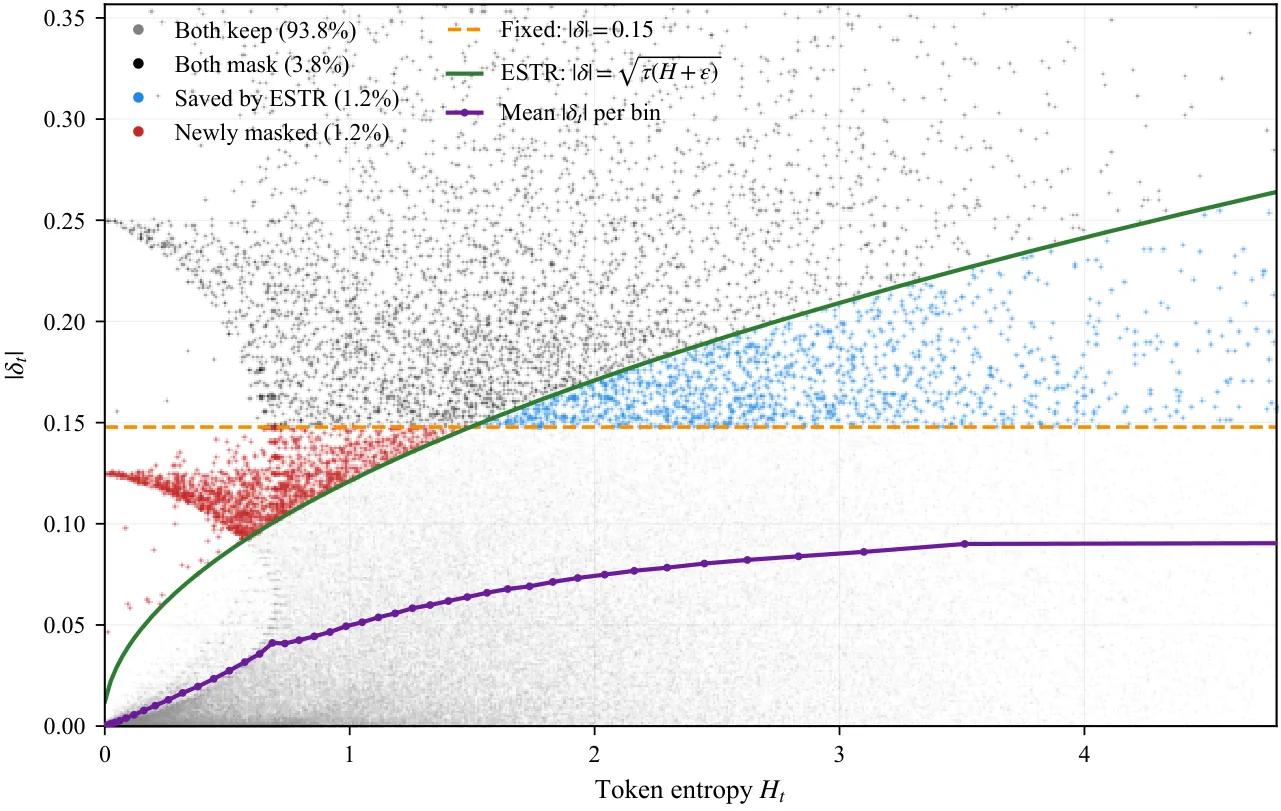
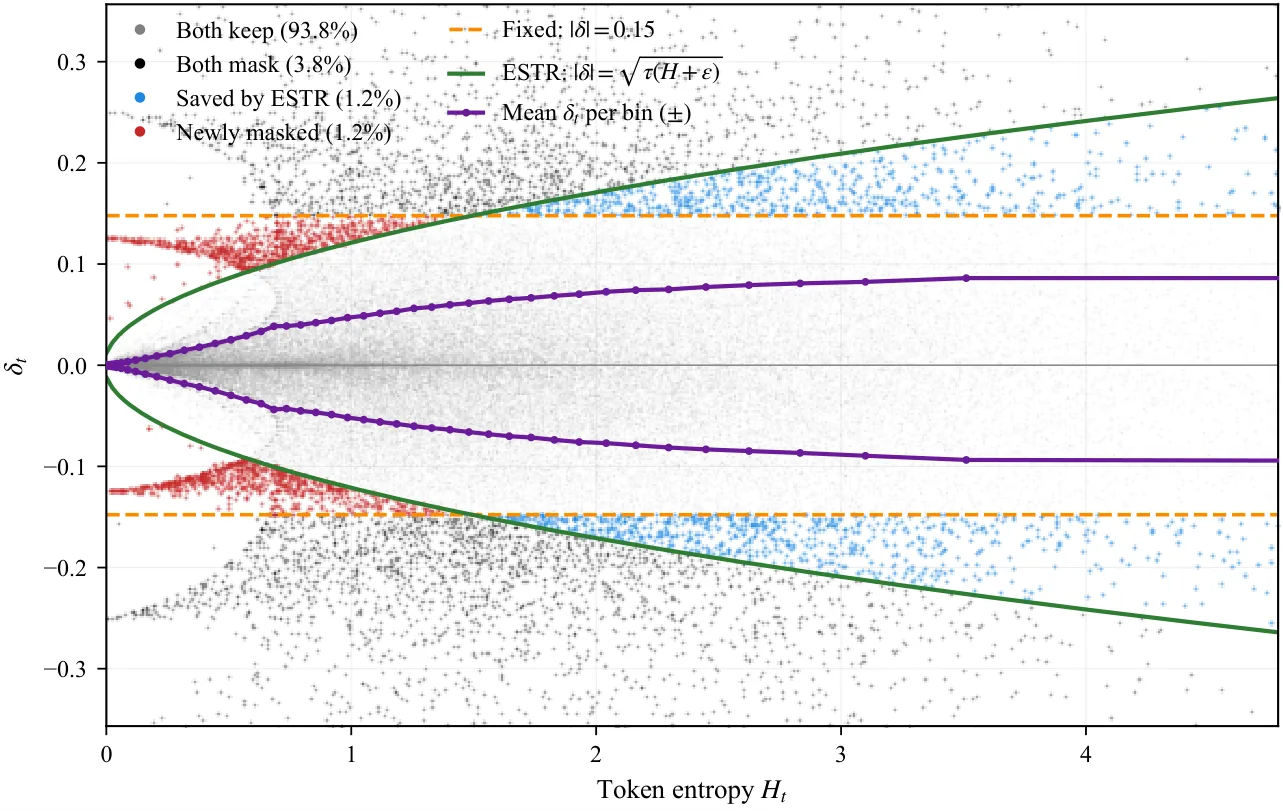
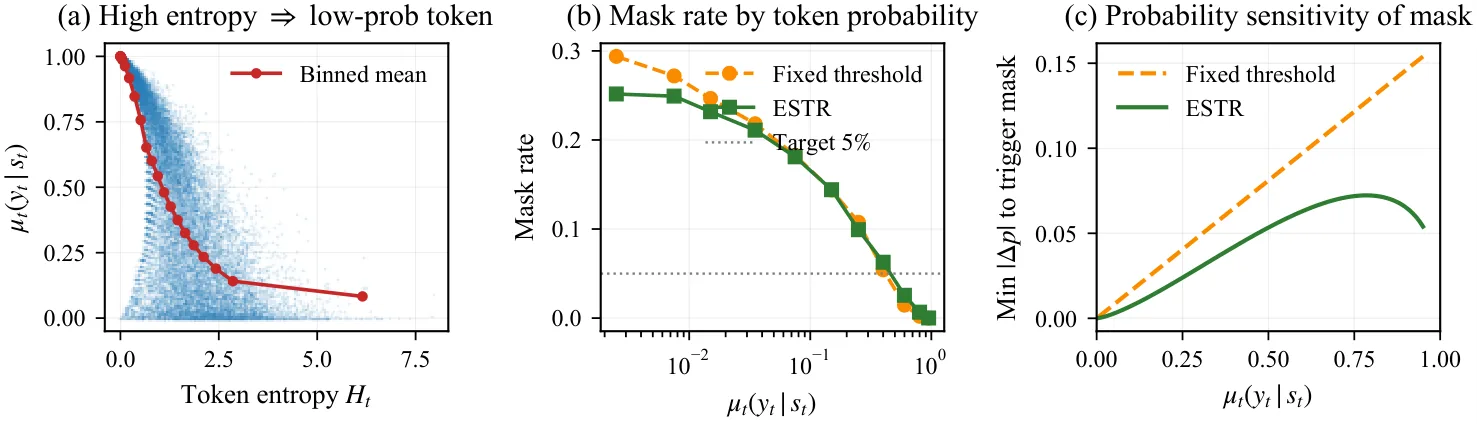
这些方法隐含两个假设:一是单凭 的绝对大小就能判断该 token 的可信度;二是同一条轨迹可以视为由单一、明确的行为策略生成。然而,本文指出这两个假设在异步动态下均难以成立。核心发现在于:off-policy 偏离的二阶矩与 token 熵存在理论关联 。在低熵位置(模型对下一个 token 高度确信),分母 接近零,即使训练-推理之间存在微小差异,重要性比也会被急剧放大,产生严重的采样噪声而非真实的策略漂移;在高熵位置(模型在多个选项间犹豫),in-flight 权重更新自然会引发较大的 ,但这恰恰反映的是有意义的探索行为。固定阈值方法面对这两种截然不同的现象只能「一刀切」,要么接纳被放大的噪声(阈值设高),要么扼杀必要的探索(阈值设低),无法同时解决。
方法
解决这一困境的关键思路是:将离策略偏差的容忍边界从全局固定值改造为依赖 token 局部熵的动态边界。这一转变来自对 off-policy 偏离统计性质的深入分析。
考虑 logit 扰动模型:,其中 是采样噪声。通过一阶 Taylor 展开可以证明(Proposition 2),重要性比的二阶矩满足 ,即偏离的方差与局部熵 线性相关。这意味着数据天然是异方差(heteroscedastic)的,而非传统固定阈值所假设的同方差。
从 KL 散度的二阶近似 出发,传统方法施加固定预算 ,实际上是在假设所有 token 的偏离方差相同。ESTR 的核心创新是将这个预算分解为两部分:局部方差 和标准化偏离 ,然后对标准化偏离施加统一约束:
其中 控制总预算, 防止 时分母为零。在此框架下,ESTR 的 token 保留决策变为:
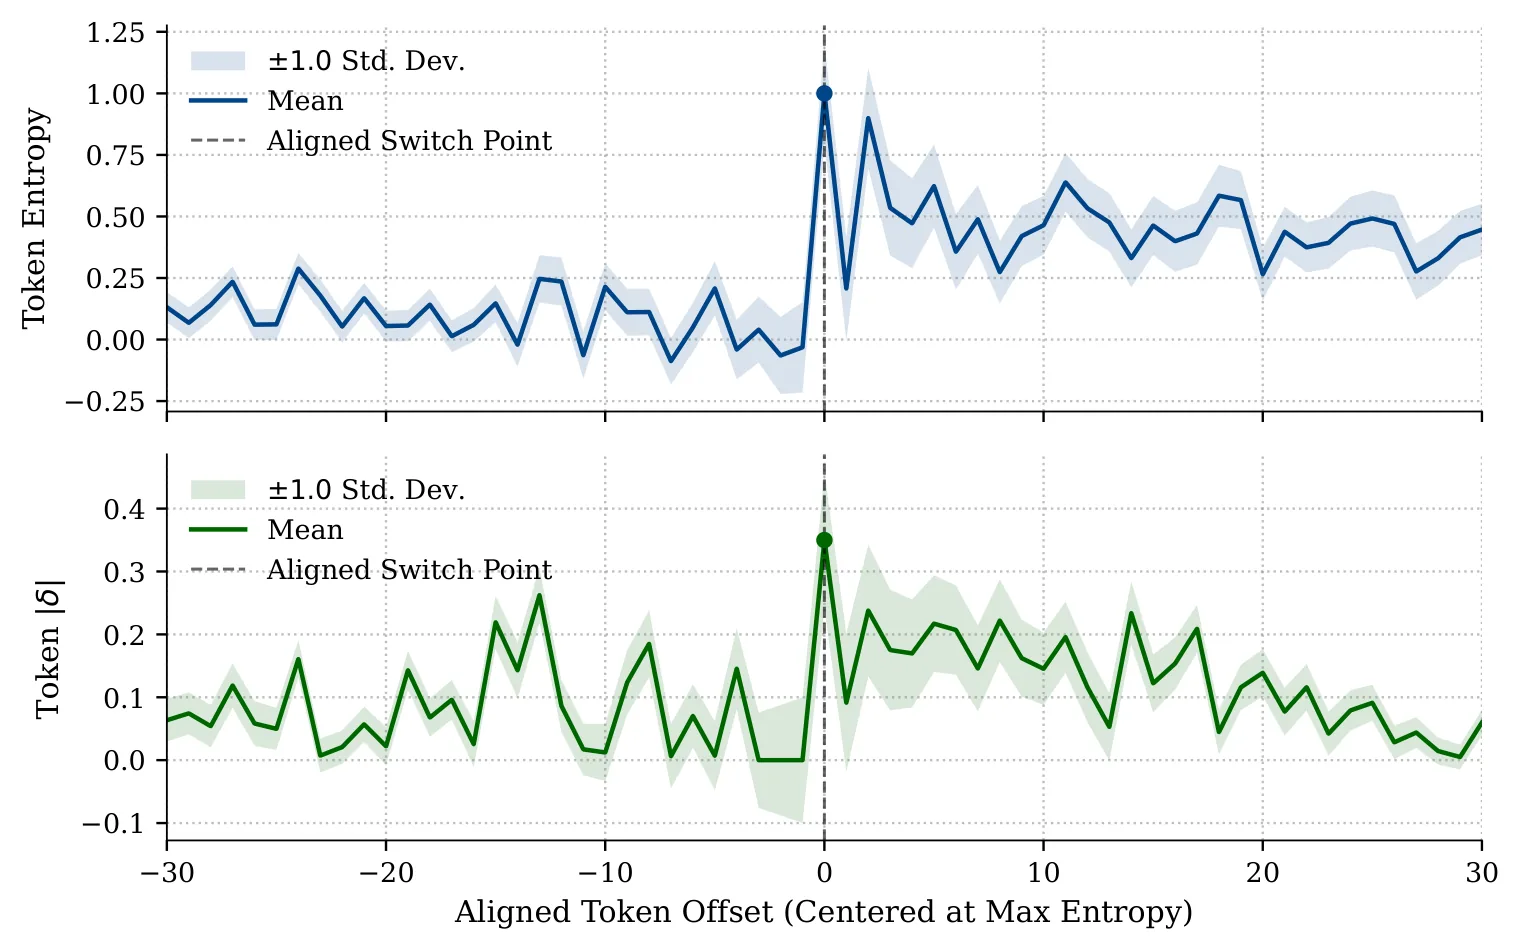
论文进一步证明(Proposition 3),在轨迹内版本切换点(switch point)附近,尽管 和 同步飙升,但 仍近似保持 的尺度,与熵无关——这意味着 ESTR 天然能识别高熵处的大幅偏离是「真实探索」而非「噪声放大」。
在严格广义性方面(Proposition 4),如果强制 为常数,ESTR 的边界退化为固定阈值 ,这说明固定阈值是 ESTR 在同方差假设下的特例。ESTR 的边界在低熵处比固定阈值更紧(消除放大噪声),在高熵处更宽(保留探索),仅在交叉点 处与固定阈值重合。
完整的目标函数将 ESTR 掩码与 PPO 风格的 clip 相结合:
其中 作为 hard mask 直接丢弃违反熵缩放边界的 token(stop-gradient),非对称 clip 则控制受信任 token 的步长范围。
值得注意的是,ESTR 的实施极为轻量: 直接从推理侧的 logit 分布中读取,无需任何额外前向传播,也无需显式检测版本切换点。这与那些需要维护多版本策略或周期性同步的方法形成鲜明对比。
实验与结果
论文在三类任务上验证 ESTR 的有效性,覆盖不同模型架构和任务复杂度。
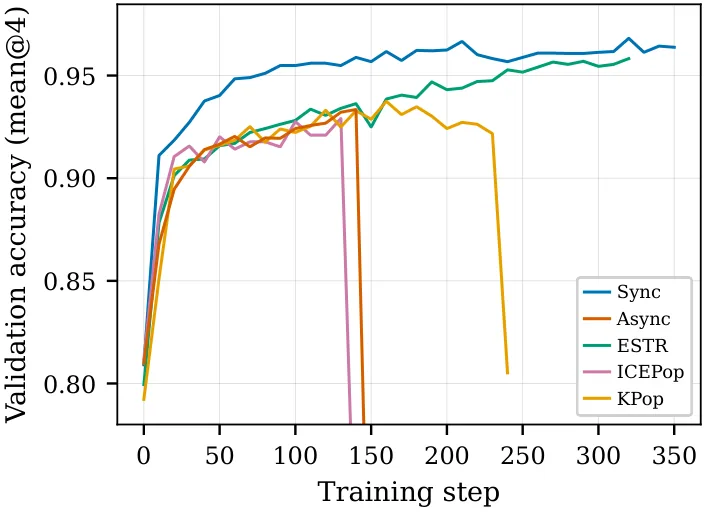
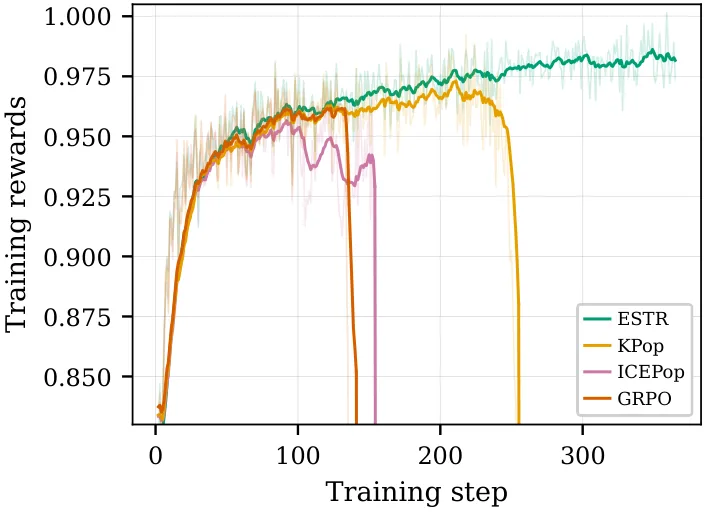
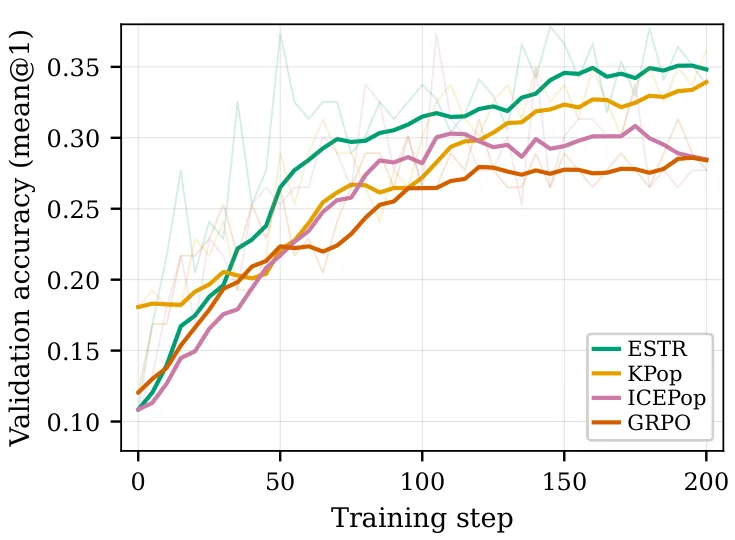
在长程智能体搜索任务 BrowseComp-Plus(使用 MoE 模型 Qwen3-30B-A3B,多轮 agentic 场景),ESTR 达到 37.34 avg@1,显著超过最强的异步基线 KPop(34.94)和 IcePop(32.53),且逼近同步 GRPO 的参考上界(38.55)。在多轮工具调用数学任务 Multi-turn GSM8K(Qwen2.5-7B)上,ESTR 达到 95.69,几乎匹配同步 GRPO(96.07),而基线方法 IcePop/KPop 在数百步内不可逆崩溃至 60–71。在数学推理基准 AIME 2024-2026 上,ESTR 的 avg@4 达到 17.04(同步 GRPO 为 17.54),pass@4 达到 28.38,甚至超过了同步 GRPO 的 27.68。
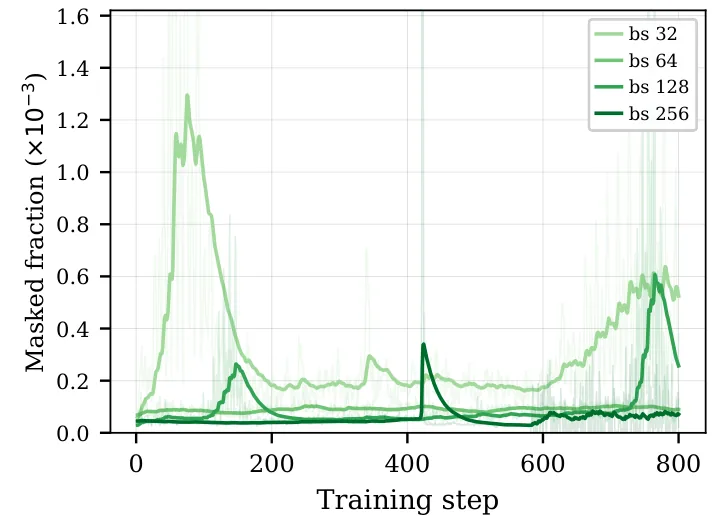
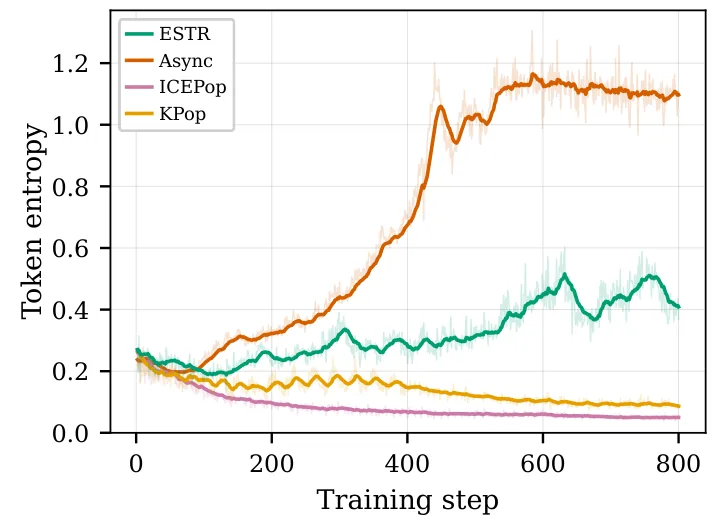
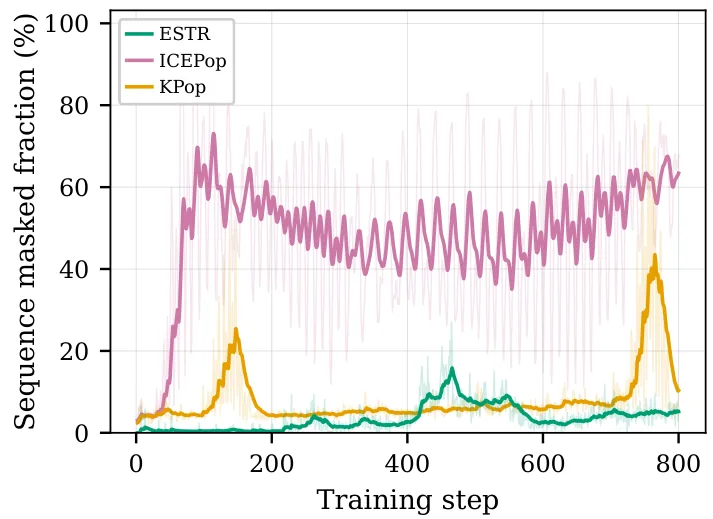
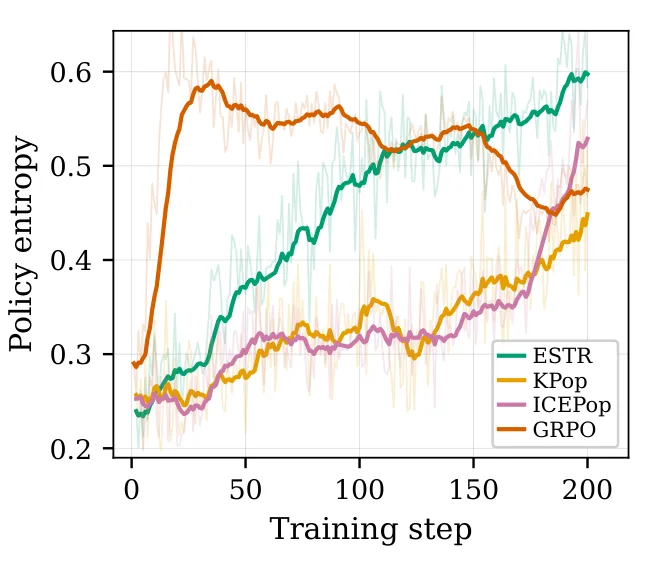
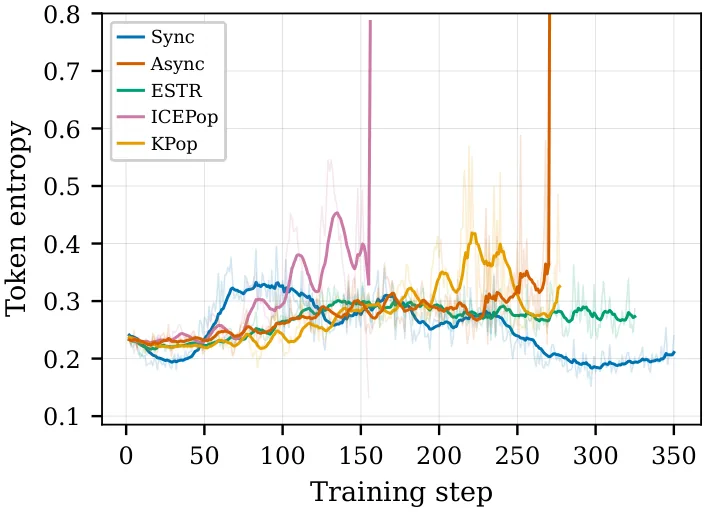
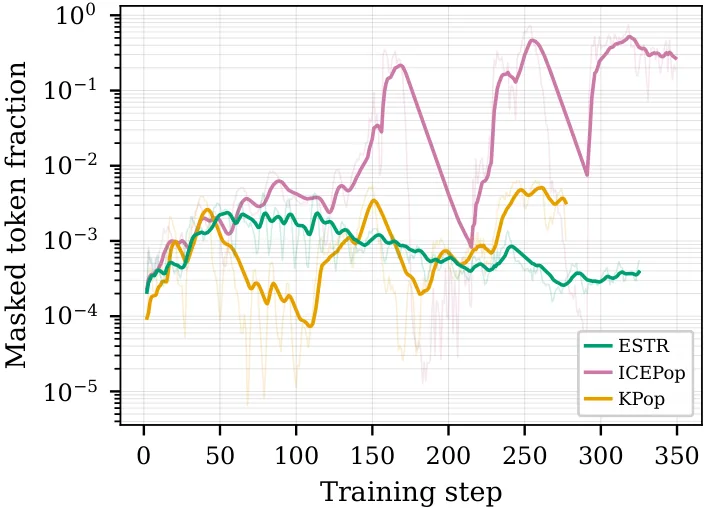
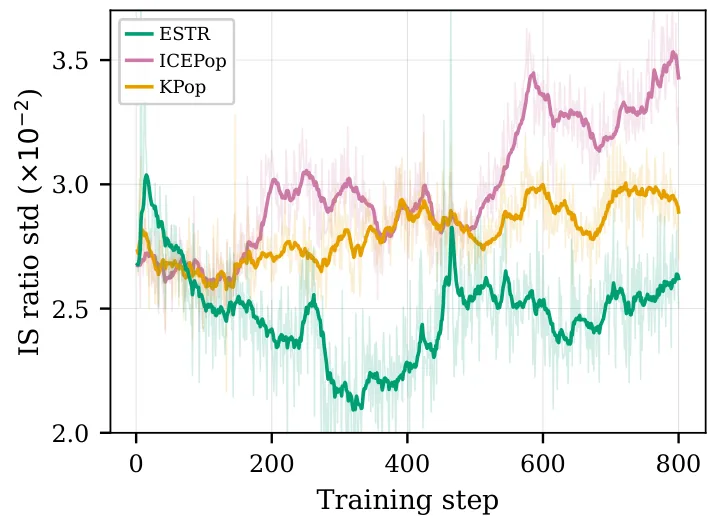
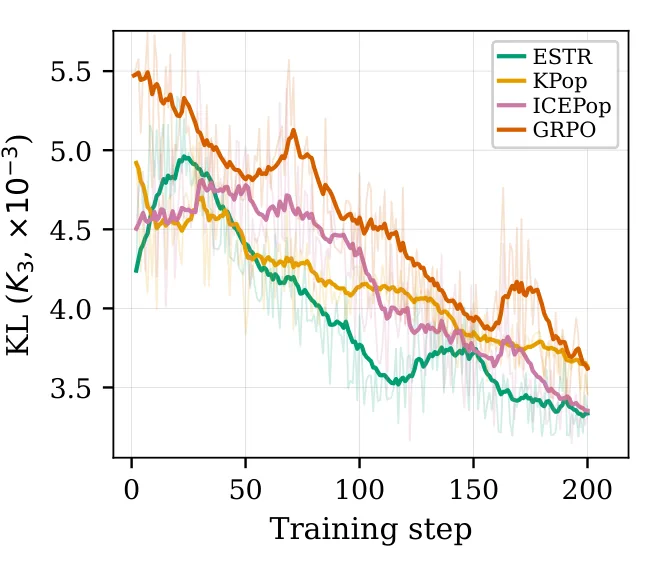
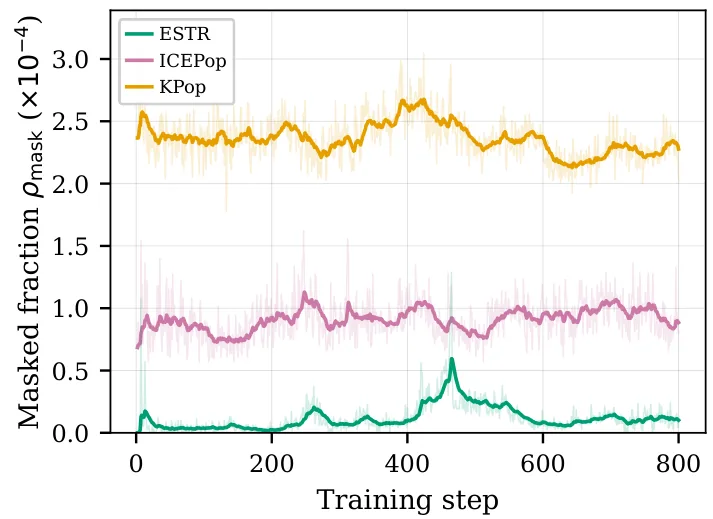
稳定性分析揭示了 ESTR 的核心优势:在整个训练过程中,ESTR 维持最低且最稳定的 rollout-target KL 散度,策略熵稳步上升(表明健康探索),而固定阈值基线的 masked fraction 高出 ESTR 约一个数量级——但这并非因为 ESTR「更宽松」,而是因为它精准区分了噪声 token(应丢弃)和探索 token(应保留),从而在极低的掩码率下实现了更好的离策略修正效果。
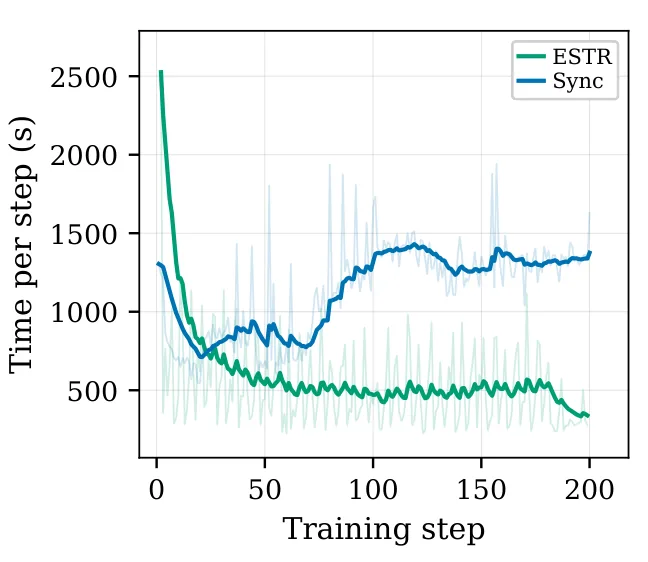
效率方面,在 DAPO-Math 训练中,同步 GRPO 的吞吐量为 82.56 tokens/s/GPU,ESTR 达到 214.38 tokens/s/GPU;单步耗时从 1356 秒缩短至 514 秒,加速比达 2.6 倍。由于 的计算完全复用 rollout 阶段的 logit,几乎不引入任何额外开销。
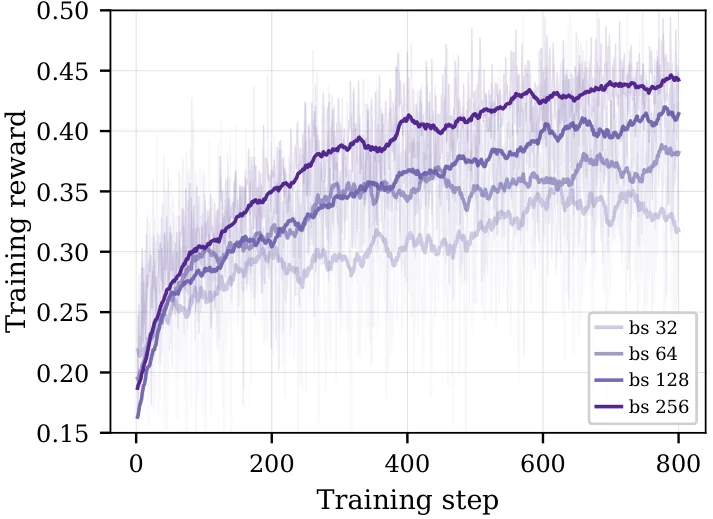
消融实验表明,ESTR 对超参数 和全局 batch size 的选择不敏感,默认配置在两个量级范围内性能波动在 1 个百分点以内,验证了方法的鲁棒性。
讨论与可借鉴点
ESTR 的核心贡献在于揭示了 off-policy 偏离与 token 熵之间的系统性耦合关系,并据此将离策略偏差的修正从「全局一刀切」升级为「局部自适应」。这一发现具有超越特定方法的理论意义:它确立了一个统一原则,即在异步强化学习中,离策略偏差的「容许尺度」应由 token 级别的局部熵来标准化,而非依赖任何固定的全局阈值。
从工程角度看,ESTR 的实施极为简洁——仅需在推理阶段读取 logit 分布的熵,无需额外前向传播、版本切换检测或复杂的掩码机制。这使得它可以无缝集成到现有的异步训练框架中,不会破坏 pipeline 的效率。
论文也存在若干局限:理论分析基于一阶 Taylor 展开,在 logits 扰动较大时近似精度可能下降;实验主要集中在语言模型的后训练阶段,对其他模态(如视觉-语言模型)的适用性尚待验证; 的选取虽鲁棒,但缺乏自动调节机制,在极端分布偏移场景下可能需要人工干预。
对后续研究的启发在于:异方差性(heteroscedasticity)可能是 off-policy 修正领域的普遍特征,类似的熵标准化思路或许可以推广到其他 off-policy 场景,如离线强化学习或多任务学习中的数据复用问题。
摘要
异步强化学习(RL)通过将 rollout 生成与策略优化重叠来加速大语言模型(LLM)的后训练,但由此产生的陈旧离策略数据会使优化变得不稳定,并最终导致策略崩溃。现有方法通常仅依据重要性比率的大小来保留或丢弃 token,在所有 token 位置上一致地应用相同的阈值。在本工作中,我们揭示了重要性比率的自然尺度随 token 熵系统性地变化。在异步动态下,这种熵-比率缩放关系会导致两种不同的现象:在低熵情况下,固有的训练-推理差异被急剧放大成显著的采样噪声;在高熵情况下,飞行中的权重更新自然地引发显著且合理的探索性偏离。因此,仅基于幅度的修正会无意中接纳被放大的噪声,同时严格屏蔽掉由飞行中更新所触发的必要探索。为解决这一问题,我们提出了熵缩放信任域(ESTR),它通过每个 token 的局部熵来缩放其离策略偏差,无需额外的前向传播或显式的版本切换检测。在长视野智能体任务和数学推理基准测试中,ESTR 一致地优于现有异步方法,并实现了最佳的训练-推理一致性。与同步 GRPO 相比,ESTR 在达到相近准确率的同时,将训练速度提升了 2.6 倍。
Abstract
Asynchronous reinforcement learning (RL) accelerates large language model (LLM) post-training by overlapping rollout generation with policy optimization, but the resulting stale, off-policy data can destabilize optimization and ultimately cause policy collapse. Existing methods typically retain or discard tokens based solely on the magnitude of their importance ratios, applying the same threshold uniformly across token positions. In this work, we reveal that the natural scale of the importance ratio varies systematically with token entropy. Under asynchronous dynamics, this entropy-ratio scaling dictates two distinct phenomena: at low entropy, the inherent train-inference discrepancy is drastically amplified into substantial sampling noise; at high entropy, in-flight weight updates naturally induce pronounced, legitimate exploratory deviations. Consequently, magnitude-only correction inadvertently admits the amplified noise while strictly masking out the essential exploration triggered by in-flight updates. To address this, we propose the Entropy-Scaled Trust Region (ESTR), which scales each token's off-policy deviation by its local entropy, requiring no auxiliary forward passes or explicit version-switch detection. Across long-horizon agentic tasks and mathematical reasoning benchmarks, ESTR consistently outperforms existing asynchronous methods and achieves the best train-inference consistency. Compared with synchronous GRPO, ESTR attains comparable accuracy while improving training speed by .
论文详细总结(自动生成)
论文总结:ESTR(熵缩放信任域)
1. 核心问题与研究背景
- 研究场景:异步强化学习(Asynchronous RL)已成为大规模 LLM 后训练的主流范式。它通过将 rollout 生成与策略优化并行运行,显著提高吞吐量,但同时也引入了严重的 off-policy 陈旧性(staleness)问题:用于训练的 rollout 是由滞后甚至快速发散的行为策略(behavior policy)生成的。
- 核心矛盾:长程多轮 rollout 中,一条轨迹可能跨越多个权重版本,导致 intra-trajectory version switching(轨迹内版本切换)与 inter-trajectory lag(轨迹间滞后)。在高 GIP(梯度-推理失配)情况下,训练容易陷入 不可逆的策略崩溃。
- 现有方法的局限:主流稳定化方案(如 IcePop、KPop 等)均属于"基于幅值"的过滤——它们仅以重要性比 的大小为标准,对所有 token 统一施加固定阈值。这隐含两个有缺陷的假设:
- 单凭 的绝对幅值即可判断 token 的"可信度";
- 单条轨迹可视为由单一、明确的行为策略生成。
- 本文发现:重要性比的"自然尺度"与 token 熵 系统性耦合,满足 (理论推导见附录 A)。这导致异步 RL 中出现两种反向现象:
- 低熵处:分母近零放大训练-推理微小差距,产生被严重放大的 采样噪声(不是策略漂移);
- 高熵处:in-flight 权重更新自然引发的大 实际为 真实探索,应被保留。
- 固定阈值无法区分这两种现象,导致"接纳噪声、扼杀探索"的系统性偏差。
2. 方法论:熵缩放信任域(ESTR)
2.1 核心思想
将"信任域边界"从 全局固定阈值 改造为 依赖 token 局部熵 的动态边界:
其中 控制总预算, 为防止 的常数项。
2.2 关键技术细节
- 重要性比定义:
- 熵-比值缩放定律(Proposition 2):在 logit 扰动模型 下,一阶展开得到
即 off-policy 偏离的二阶矩与局部熵线性相关。
- 二阶信任域推导:由 KL 散度的 Taylor 展开
传统固定预算 假设数据为同方差(homoscedastic),与上述 异方差(heteroscedastic)性质矛盾。
- 熵标准化预算:定义标准化偏离
在开关点(switch point),尽管 与 同步飙升, 仍近似保持 的尺度,与熵无关(Proposition 3)。
- ESTR 保留掩码:
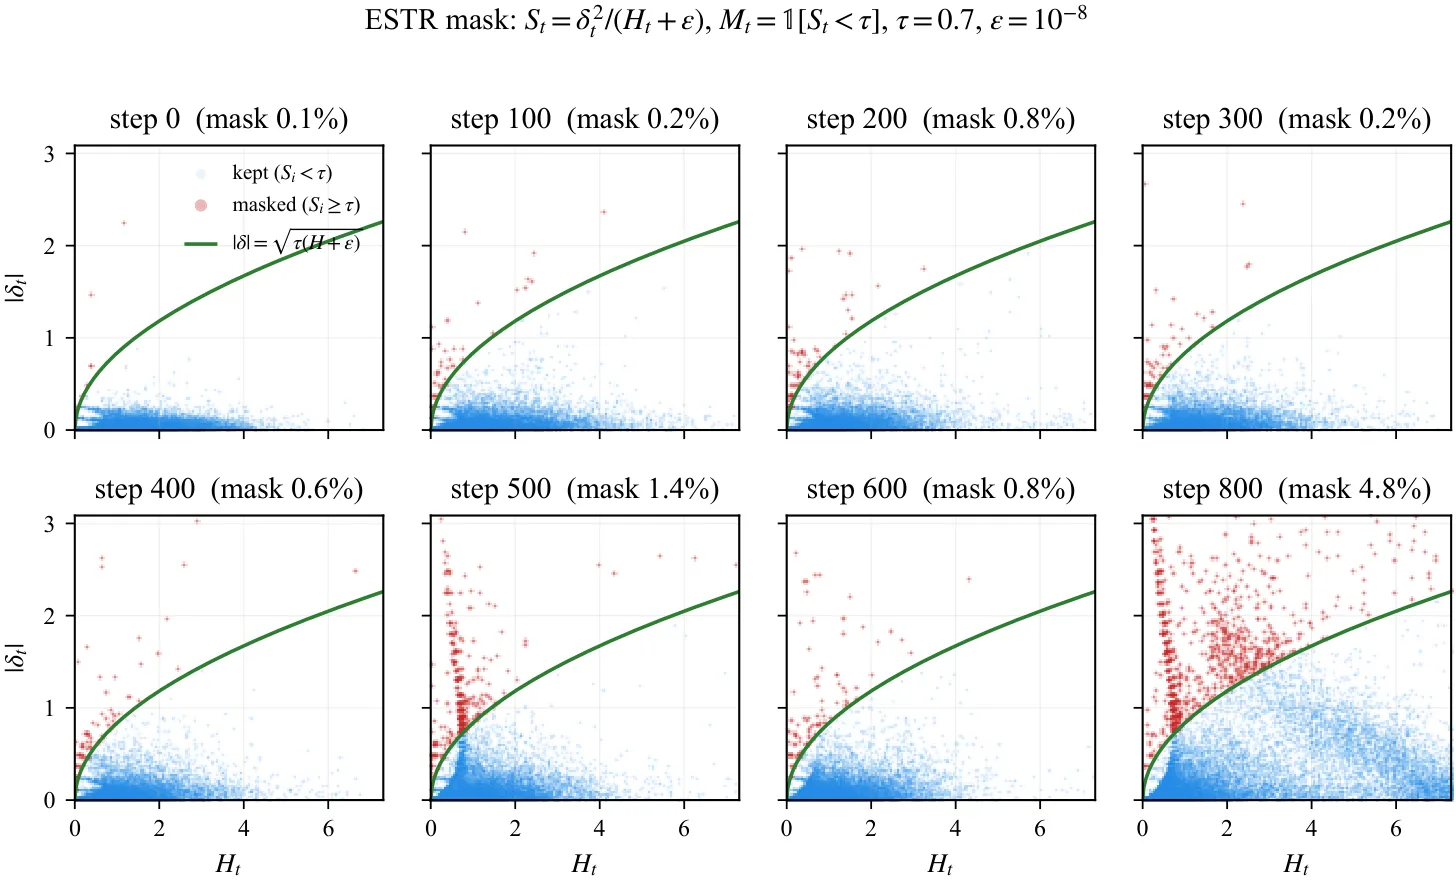
- 严格广义性(Proposition 4):若强制 ,则规则退化为固定阈值 。ESTR 的边界在低熵处严格更紧(消除放大噪声),在高熵处严格更宽(保留探索),二者仅在交叉点 处重合。
- 完整目标函数(结合 PPO 风格 clip):
其中 clip 控制受信任 token 的步长, 则直接丢弃违反熵缩放边界的 token(hard mask,stop-gradient),梯度形式为
- 实施优势: 直接读自推理侧 logit,无需任何额外前向传播,也无需显式探测版本切换点。
3. 实验设计
3.1 任务与数据集
| 任务 | 数据集/基准 | 模型 | 类型 |
|---|---|---|---|
| 长程智能体搜索 | BrowseComp-Plus | Qwen3-30B-A3B (MoE) | 多轮 agentic,LLM judge 奖励 |
| 工具集成数学 | Multi-turn GSM8K | Qwen2.5-7B | 多轮工具调用,规则奖励 |
| 数学推理 | DAPO-Math 训练 + AIME 2024/2025/2026 评测 | Qwen2.5-7B | 单轮生成 |
3.2 对比基线
所有方法仅在 token 级接受规则 上有所不同,共用同一实验配置:
- GRPO (Sync):同步 GRPO(参考上界)
- GRPO (Async):原始异步训练,无任何修正
- IcePop:固定区间裁剪
- KPop:基于双向二元 KL 散度的自适应掩码
- ESTR (Ours):本文提出的熵缩放信任域
3.3 评测维度
- 准确性指标:
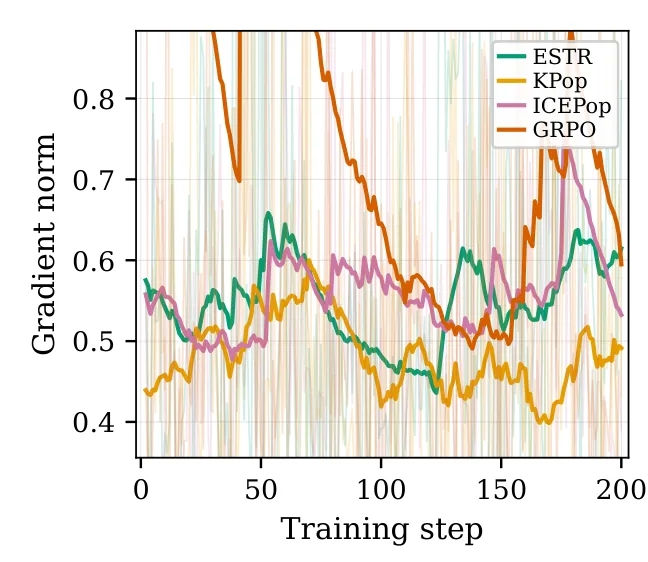
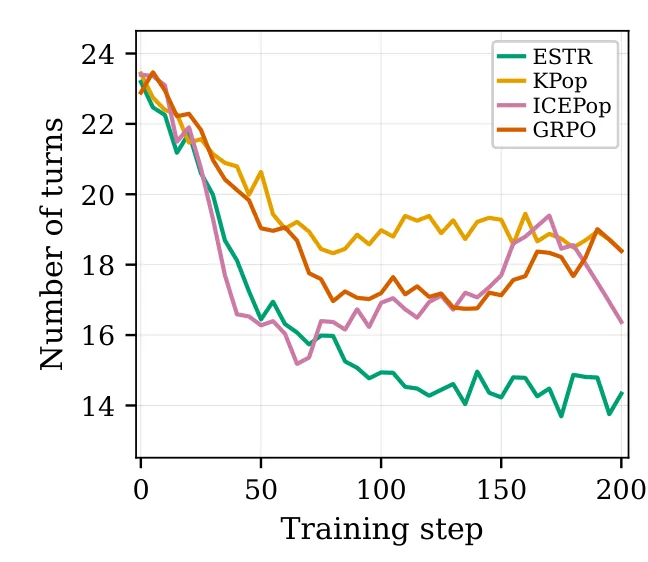
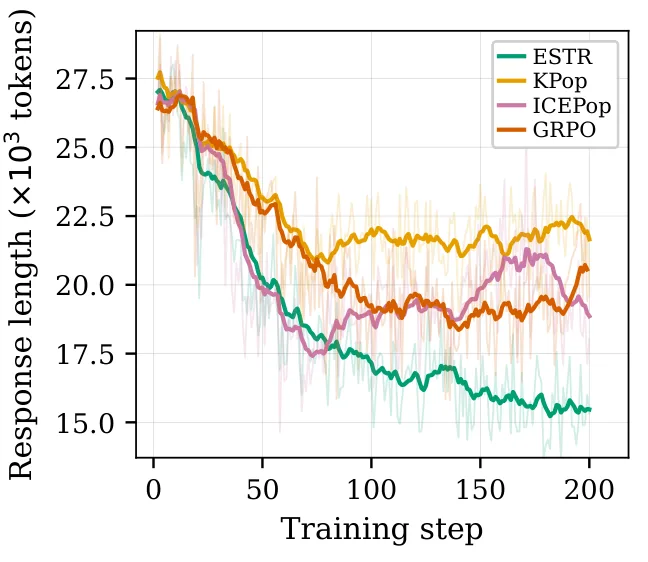
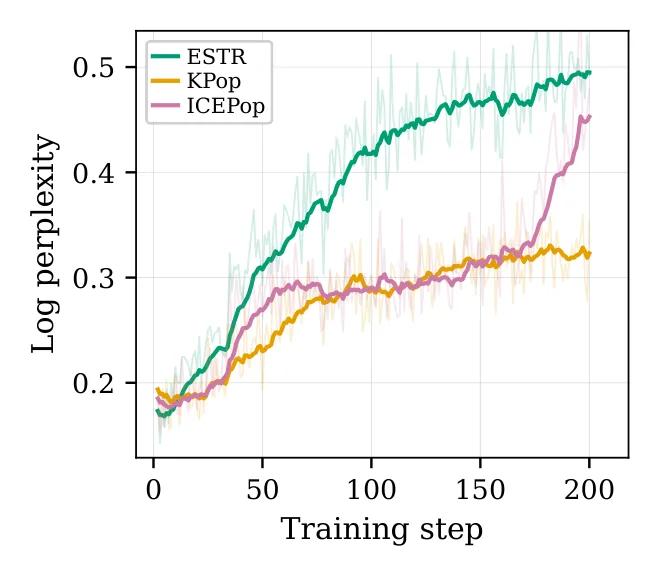
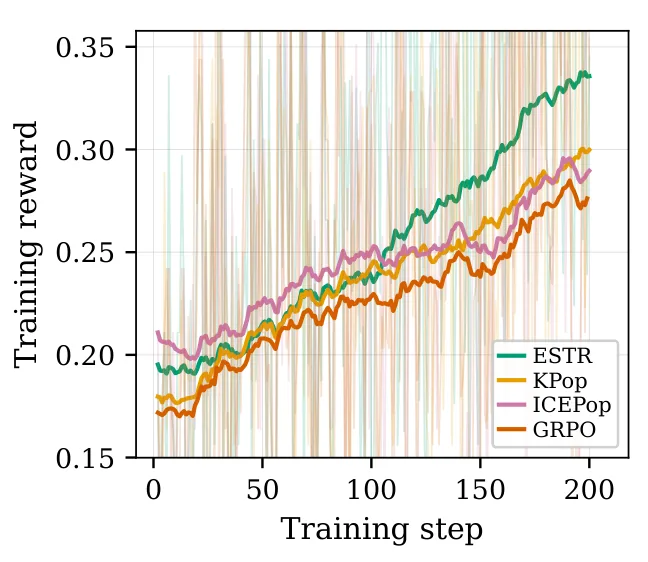
avg@1、avg@4、pass@4 - 训练动态:策略熵、rollout–target KL、masked fraction、IS 比值标准差、梯度范数、训练奖励、log-perplexity、响应长度、交互轮数
- 鲁棒性:、 的 staleness 扫描
- 超参敏感度:,global batch
4. 资源与算力
- GPU:H800,8 卡/节点
- 框架:verl(HybridFlow),分别用 Megatron 作训练后端,SGLang 作 rollout 引擎
- 算力配置(来自附录 Table 3):
- BrowseComp-Plus:4 节点 = 16 训练 GPU + 16 rollout GPU
- DAPO-Math:2 节点 = 8 训练 + 8 rollout
- GSM8K:2 节点 = 8 训练 + 8 rollout
- 效率对比(DAPO-Math):同步 GRPO 82.56 tokens/s/GPU vs ESTR 214.38 tokens/s/GPU;单步耗时 1356 s → 514 s(约 2.6× 加速)
- 训练配置:AdamW,lr = ,无 KL 惩罚,,GRPO 优势,token-mean loss,非对称 clip
- 超参默认值:BrowseComp-Plus ,DAPO-Math/GSM8K ,
- 训练 token 数:最长响应长度 32768,prompt 长度 4096,最大轮数 100(BrowseComp-Plus)
> 注:原文未给出每个任务的 绝对训练小时数,仅给出 per-step 时间与吞吐量。
5. 实验数量与充分性
- 任务覆盖:3 类任务(长程 agentic / 多轮工具调用 / 单轮数学推理),2 个不同规模模型(MoE 30B-A3B、dense 7B),跨域且异质。
- 基线对照:4 个基线(sync / async / IcePop / KPop),其中 3 个异步方法形成公平对比(同一 off-policy 数据集、同一 keep mask 接口)。
- 鲁棒性测试:
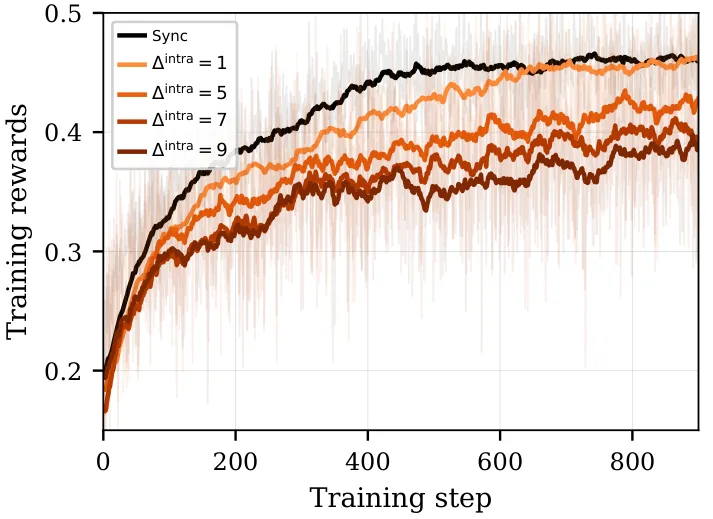
- Intra-trajectory staleness 扫描(4 个值)
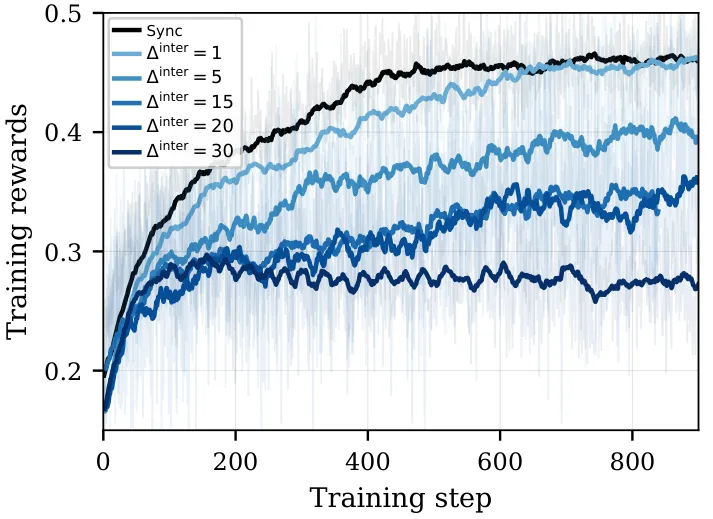
- Inter-trajectory staleness 扫描(5 个值)
- 超参 扫描(3 个值 × 2 个任务)
- 全局 batch size 扫描(4 个值)
- 诊断与可视化:mask 演化图(训练 step 0–800 的联合分布演化)、IS 比值标准差、masked fraction、log-perplexity、wall-clock 时间等 6+ 条曲线。
- 超参搜索:默认 与 batch size 对结果影响在 1 个百分点以内,表明方法对阈值不敏感。
- 消融:通过理论 Proposition 4 严格证明 ESTR 是固定阈值的严格广义化,构成一种"结构化消融"。
- 公平性:所有方法共享同一 rollout 池、同一 logprob、同一 PPO clip 设置;同步与异步在 相同总硬件预算 下比较。
总体而言,实验较为充分,覆盖了精度、稳定性、效率、鲁棒性多个维度,且对比设置公平。
6. 主要结论与发现
- 精度层面:
- BrowseComp-Plus:37.34 avg@1,超过最强异步基线 KPop (34.94) 与 IcePop (32.53),逼近同步 GRPO (38.55)
- Multi-turn GSM8K:95.69,几乎匹配同步 GRPO (96.07);基线崩溃至 60–71
- AIME 2024–2026:avg@4 = 17.04(vs 同步 17.54),pass@4 = 28.38,超过同步 GRPO (27.68)
- 稳定性层面:
- 在 GSM8K 上,IcePop/KPop 在几百步内 不可逆崩溃;ESTR 全程稳定
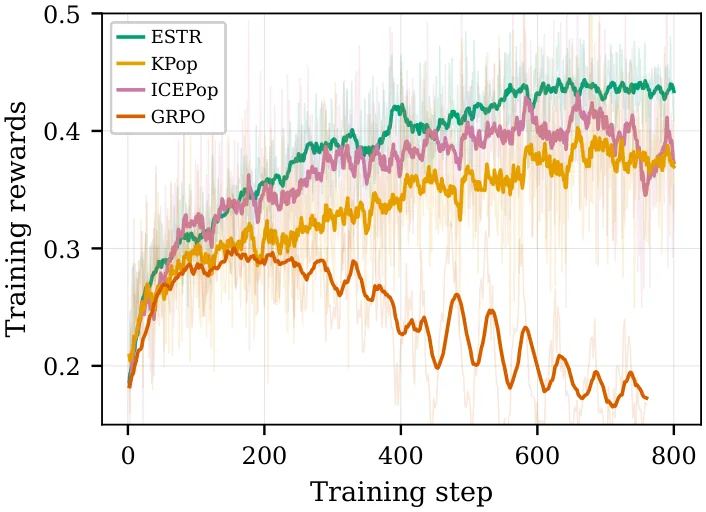
- 在 DAPO-Math 上,原生异步 GRPO 早期即崩塌,IcePop/KPop 平台化,ESTR 持续上升
- ESTR 维持最低且最稳定的 rollout–target KL,且策略熵稳步上升(健康探索)
- 效率层面:在 相同硬件 下训练速度 2.6×,单步时间缩短 62%,且 几乎不增加任何 overhead(每 token 仅一次熵读取)
- 掩码行为:ESTR 的 masked fraction 比固定阈值基线 低约一个数量级,却仍保持最低的 IS 比值标准差——证明它精准丢弃噪声 token 而非探索 token
- 健壮性:在 、 的所有扫描下都不崩溃,奖励随 staleness 单调优雅下降
- 理论意义:确立了"off-policy 偏离应按 token 局部熵标准化"的统一原则
7. 方法与实验设计的亮点
- 理论驱动:从 logit 扰动模型一阶展开严格推导出 ,揭示 token 熵与重要性比之间的内禀耦合,而非经验观察
- 二阶 KL 一致性:将信任域约束直接联系到 (KL 二阶近似),与 PPO/TRPO 的数学框架一致
- Switch-point 不变性(Proposition 3):标准化后的偏离在 in-flight 版本切换点保持尺度稳定,使方法天然吸收 staleness
- 严格广义性(Proposition 4):固定阈值是 ESTR 在 单一交叉点 处的特例,提供了优雅的"前向兼容"关系
- 零额外开销:熵值可由推理 logit 直接读取,无需额外前向传播,也无需显式探测版本切换点
- Stop-gradient 掩码:与 PPO clip 各司其职(clip 约束步长,mask 移除违反信任域的 token),工程实现简洁
- mask 自适应:随训练进行 自动调节(0.1% → 4.8%),无需手工 schedule
- 充分诊断:mask 在 平面上的演化图直观展示方法的运作机制
8. 不足与局限
- 模型覆盖有限:仅在 Qwen3-30B-A3B 与 Qwen2.5-7B 上验证,未涵盖 dense 更大规模(如 70B+)、其它架构(Llama、DeepSeek 等)以及更多模态
- token 熵估计依赖推理端 logit:若 rollout 与训练侧的 logit 计算精度不一致(如不同 attention 实现、量化),熵标准化可能引入偏差;论文未深入讨论该鲁棒性
- 超长 horizon 的累积误差:作者明确指出"未来工作将探索更长 horizon 与极端异步场景",暗示当前结果尚未覆盖超长程 agentic 任务
- 的迁移性:BrowseComp-Plus 默认 、DAPO-Math/GSM8K 默认 ,任务间需要重新调参;附录敏感性表显示影响不大但非零
- 缺乏对极小 batch / 极小 rollout 场景的测试:batch size ≥ 32 起步,对极小 batch 的稳定性未验证
- 理论假设简化:logit 扰动模型为 一阶近似,未考察
二阶及高阶扰动项对结论的影响
- 奖励模型/法官依赖:BrowseComp-Plus 依赖 LLM judge,存在评测噪声与潜在偏置;论文未做多次种子或多模型 judge 的稳定性验证
- 缺乏对失败模式的具体分析:未深入剖析 ESTR 在何种极端情况(如全部 token 同时高熵或全部低熵)下可能失效
- 理论结果与实践之间存在"一阶近似"鸿沟:Proposition 2 仅为一阶展开,实际训练中 logit 扰动幅度可能更大,缺乏有限样本/有限扰动的误差界
- 未与 RLHF 通用管线整合测试:本文聚焦 RL 后训练中的 GRPO 范式,对 actor-critic、PPO with value model、online DPO 等场景的迁移性未验证
9. 总体评价
ESTR 提出了一种理论驱动的、面向异步 RL 的"熵缩放信任域"机制。其核心贡献在于:
1. 揭示了一个被长期忽视的内禀耦合——token 熵与重要性比方差之间的 关系——并由此诊断出固定阈值方法在异步 RL 中的"反直觉偏差"(接纳噪声、扼杀探索)。
2. 给出了形式简洁、可解释性强的修正——仅用一个标准化分数 取代固定阈值,且严格包含固定阈值作为特例,具有优雅的理论兼容性。
3. 在工程层面几乎"零额外开销"——熵值直接从推理 logit 读取,无须额外前向、无须探测版本切换点,使其极易集成到现有异步 RL 框架(如 verl、AsyncRLHF)。
4. 实验覆盖与稳定性论证充分——跨三类异质任务、两个模型规模、多个 staleness 扫描、超参敏感度与硬件公平对比下,均展示出"逼近同步 GRPO 精度 + 2.6× 训练加速 + 鲁棒抗崩溃"的综合优势。
本文的主要价值在于将异步 RL 的稳定性问题从"经验调参"提升到"理论指导的统计修正",并以最小工程代价落地。其局限(模型族覆盖不足、超长 horizon 未验证、对 rollout/训练侧 logit 一致性的依赖)为后续工作留下了明确的方向。
适用场景推荐:ESTR 特别适合以下情形——长 horizon 多轮 agentic 任务、大规模 MoE 模型 RL 后训练、严格延迟容忍但硬件紧缺的工业级 RL 系统。对于推理与训练使用不同 attention kernel 或量化精度的部署,建议在使用前做一轮 logit 分布一致性检验。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。