
面向稀疏信令空中网络弹性覆盖的预测式轻量级多智能体强化学习
Predictive Lightweight MARL for Resilient Coverage in Sparse-Signaling Aerial Networks
📝 TLDR
无人机蜂群在带宽受限场景下因稀疏信令和信息老化而协调失效。本文提出预测式轻量多智能体强化学习框架PL-MARL,引入运动学感知推理引擎,基于物理先验主动重构邻居轨迹,实现以计算换通信。在极端信令稀缺与节点失效条件下,PL-MARL仍能维持更优覆盖与任务连续性,验证主动推理作为可扩展、低时延空中协同方案的有效性。
🧭 速览
带宽受限下无人机蜂群因稀疏信令与信息老化出现协调崩溃,传统MARL难以兼顾鲁棒性与低控制开销。
提出PL-MARL框架与运动学感知推理引擎,利用物理先验预测性重构邻居轨迹,以计算替代通信开销。
仿真表明PL-MARL在极端信令稀缺和节点失效下保持更优覆盖与任务连续性,显著降低控制信令开销。
主动推理是可扩展、低时延的鲁棒空中协同方案,能将控制开销最小化,为载荷业务保留频谱。
🆚 方法对比
PL-MARL (Predictive Lightweight MARL)
- 实现亚毫秒级推理,延迟极低
- 解耦策略执行与通信频率
- 在稀疏信令与节点失效下保持任务连续性
- 以计算换通信,节省频谱资源
- 依赖物理运动先验,泛化受限
- 仅通过仿真验证,缺乏实测
- 主动推断存在预测偏差风险
Kinematic-Aware Inference Engine
- 利用物理先验主动重构邻居轨迹
- 作为本地生成单元克服黑盒递归瓶颈
- 亚毫秒级推理,突破串行处理限制
- 无需频繁信令即可推断未观测状态
- 依赖准确的运动学模型假设
- 模型不匹配时推断误差累积
- 轻量化设计可能牺牲复杂场景精度
TAG-MAPPO (Topology-Aware Graph MAPPO)
- 通过集中式图聚合实现弹性重构
- 图注意力机制增强拓扑可观测性
- 在连续同步下覆盖性能较好
- 依赖持续状态同步,信令开销大
- 缺乏生成未观测状态的能力
- 稀疏信令下出现协调崩溃
Digital Twin (DT) 框架
- 提供稳定的训练底座
- 缓解非平稳性问题
- 支持中心化训练与去中心化执行
- 稀疏信令下状态感知困难
- 去中心化执行仍受通信瓶颈限制
- 数字孪生与实际部署存在同步延迟
Quantum-Assisted Frameworks
- 算法层面具有潜在计算优势
- 探索量子加速应用于通信
- 理论上可处理复杂优化问题
- 依赖专用硬件,资源受限UAV不实用
- 当前硬件成熟度不足难以部署
- 与现有无人机平台兼容性差
基于时空注意力的部分可观测框架
- 利用时空注意力增强部分可观测性
- 在频繁信令下性能优越
- 能捕捉时空依赖关系
- 根本依赖频繁信令机制
- 缺乏板上生成未观测状态能力
- 在极端FANET稀疏信令下不可行
Topology-Aware Graph Attention Mechanism (PL-MARL子模块)
- 平衡计算效率与任务可靠性
- 以拓扑内聚换空间覆盖扩展
- 支持优雅性能降级
- 牺牲部分拓扑紧密度,可能影响协同
- 图注意力计算仍有一定开销
Conventional MARL Schemes
- 框架成熟,易于实现
- 在高带宽下协调性能良好
- 依赖高频同步,信令开销巨大
- 带宽受限时频谱资源被耗尽
- 加剧同信道干扰与信息老化
PL-MARL通过物理先验驱动的主动轨迹重构,将去中心化策略执行与通信频率解耦,在稀疏信令下显著优于依赖持续同步的TAG-MAPPO及时空注意力框架;而量子辅助框架受限于硬件实用性尚不可部署。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
本文针对带宽受限无人机蜂群中稀疏信令导致协同崩溃的难题,提出 PL-MARL 框架,通过运动学感知推理引擎基于物理先验主动重构邻居轨迹,以机载计算换稀缺频谱资源。实验表明,该方法在 50 秒信令静默期下仍能维持超过 0.8 的稳态覆盖率,节点失效后 10 步内即可稳定恢复,推理时延保持在亚毫秒级且与蜂群规模解耦。
研究背景与动机
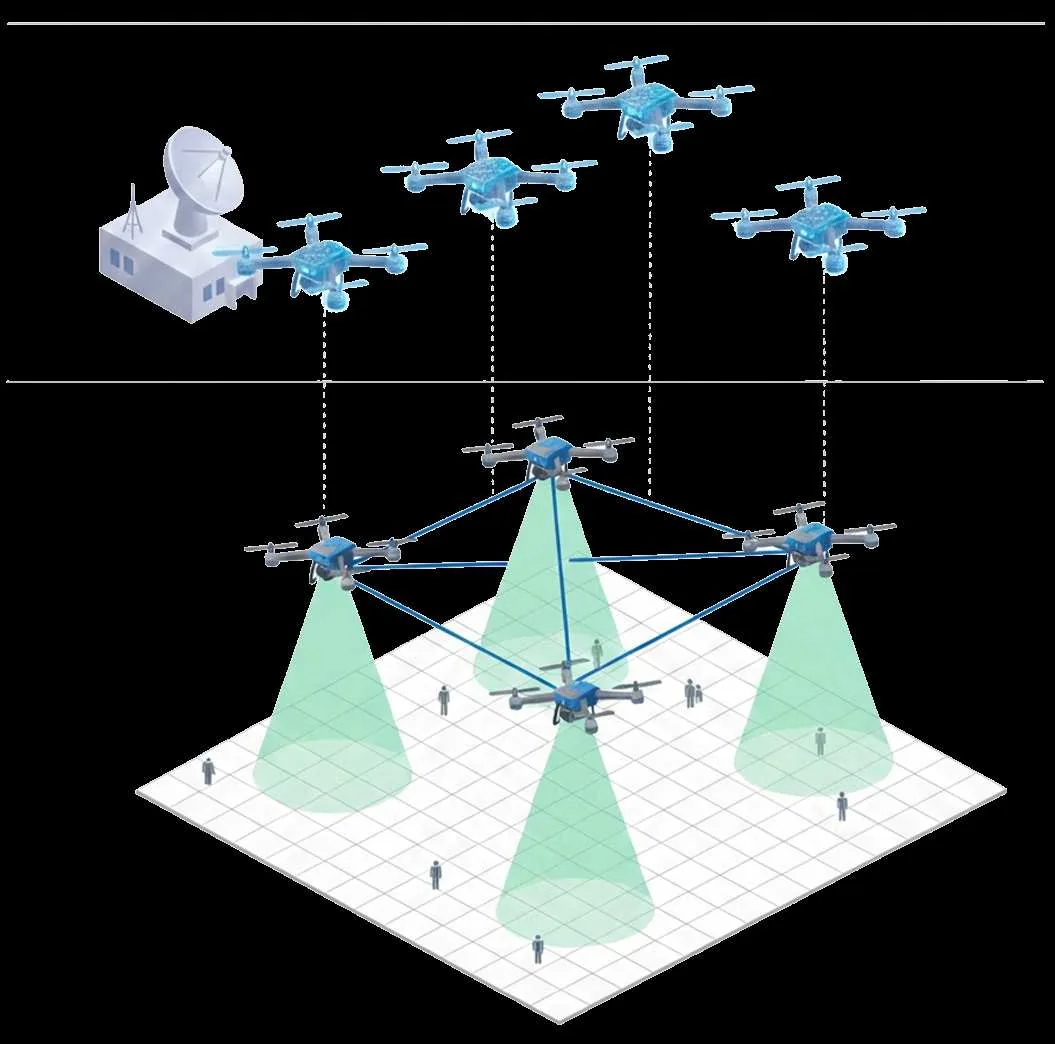
无人机自组织网络(FANET)在 6G 场景下承担着灵活覆盖、快速响应等关键任务,但当集群运行于城区低空或偏远区域时,往往面临严重的带宽约束。传统多智能体强化学习方法依赖高频状态同步来维持协同一致性——每个节点需要持续广播自身位置、速度等信息,邻居节点据此更新对环境的认知并调整行为策略。这种「反应式同步」范式在带宽充裕时运转良好,但一旦频谱资源紧张,信令开销便会挤占载荷业务的传输能力,同时加剧同频干扰,导致信息严重老化。
具体而言,当信令间隔从常规的几秒拉长到几十秒甚至更长时,邻居节点接收到的状态信息会严重过时。例如,某架 UAV 在 时刻广播了自己的位置,但直到 秒后下一次广播前,所有邻居都只能基于陈旧数据进行决策。更棘手的是,UAV 本身在持续移动——在这段静默期内,其真实位置可能已经偏离陈旧数据数十米乃至上百米。当这种偏差累积到一定程度,协同策略所依赖的拓扑结构感知便会出现根本性错误:原本期望的邻居关系不复存在,需要协作覆盖的区域与实际编队脱节,最终引发论文所定义的「协同崩溃」现象。
现有研究试图通过时空注意力机制或图结构建模来缓解这一问题,但这些方法本质上仍依赖于频繁的信令交互——它们擅长处理「如何更好地利用已有信息」,却缺乏在长时间静默期内「主动生成未观测状态」的能力。团队此前的工作 TAG-MAPPO 虽然引入了图拓扑感知来增强可观测性,但依然无法摆脱对持续状态同步的依赖。核心矛盾在于:协同质量与信令频率牢牢绑定,频谱越稀缺,协同越脆弱。
本文的切入点是重新审视这一绑定关系:如果能够让每个 UAV 基于物理规律主动「猜测」邻居的运动轨迹,而非被动等待广播,那么协同便能从「被动响应」转变为「主动推理」,从而将结构弹性与信令频率解耦。这正是 PL-MARL 的核心思想——以计算换通信。
方法
PL-MARL 的整体架构遵循集中式训练分布式执行(CTDE)范式,训练阶段在数字孪生平台上利用完美全局信息保证稳定性和收敛性,部署阶段每个 UAV 仅依赖本地观测和预训练的推理网络独立运行。这种设计既解决了多智能体环境中的非平稳性难题,又符合真实场景中地面控制站难以实时获取全网状态的约束。
系统的核心创新在于运动学感知推理引擎。与其等待邻居的下一条广播消息,不如基于 UAV 的运动学先验知识自行推演其轨迹。具体实现中,每个节点维护一个长度为 的重构轨迹缓冲区,记录过去若干时刻对各邻居状态的预测结果。这些历史预测以扁平向量的形式输入到一个两层的 MLP 网络(各层维度分别为 64 和 32),一次性前向传播即可生成对未来状态的预测:
其中 是历史预测序列, 是该邻居上次广播以来的时间间隔——这个间隔信息至关重要,因为它量化了预测需要外推的时间长度。
预测质量的关键在于物理一致性正则化。单纯的轨迹预测容易出现「物理上不可能」的结果:例如预测某邻居突然掉头、速度骤变,或者与周围邻居的相对位置关系发生突变。PL-MARL 通过双重损失函数约束预测结果,使其不仅在欧氏空间中逼近真实状态,还在位置编码层面保证局部拓扑结构的一致性:
第一项确保位置和速度的预测精度,第二项则要求预测产生的相对位移变化符合物理连续性。
推理引擎生成的预测状态随后通过注意力机制与本地状态进行融合。值得注意的是,PL-MARL 采用单头注意力机制而非复杂的多头设计——这是出于轻量化的考量。注意力系数通过 LeakyReLU 激活的线性变换计算:
其中 是融合了预测状态和相对位移编码的邻居嵌入。最终每个节点的策略输入由邻居消息的加权聚合得到,聚合权重由注意力机制动态确定。这种设计的计算复杂度与邻居数量 成线性关系,与全网规模 完全解耦——这对于大规模蜂群扩展至关重要。
训练过程中采用 MAPPO 算法,配合自适应奖励机制。当发生拓扑扰动(如节点失效)后,奖励函数中的覆盖项权重保持不变,但收缩项权重 会自适应增大以促进 UAV 向内聚拢维持覆盖密度,同时降低移动成本项权重 以减少不必要的机动。SINR 约束并未以显式惩罚项形式加入奖励函数,而是作为隐式约束由策略自主学习——实验观察表明,模型能够自发涌现出覆盖能力与拓扑连通性之间的合理权衡。
实验与结果
实验在 的三维城区空间中进行,训练阶段使用 4 架 UAV 和 240 个服从 Gauss-Markov 移动模型的用户终端。每架 UAV 的最大速度为 ,加速度限制为 ,通信和感知半径分别为 350 米和 100 米。信令间隔从 5 步到 50 步变化(每步对应 3 秒决策间隔),以模拟从轻度到极端的带宽受限场景。
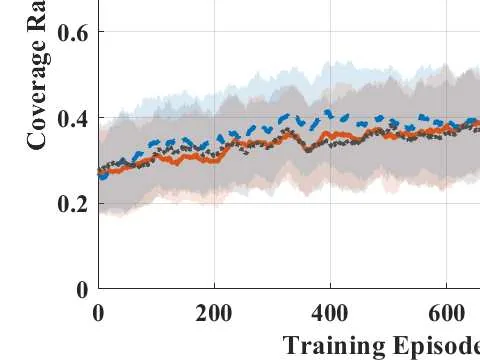
收敛性分析表明,PL-MARL 在训练过程中能够稳定趋近于理论上限 Oracle Bound(基于完美全局信息的序贯贪心网格搜索),而缺乏轨迹推理能力的 TAG-MAPPO 基线收敛速度明显更慢。引入标准门控循环单元的 GRU 基线虽然具备时序预测能力,但预测效果远不如物理先验引导的推理引擎——这验证了将运动学规律作为先验嵌入的重要性。
稀疏信令鲁棒性是核心测试维度。当信令间隔达到 50 步(对应 150 秒的静默期)时,PL-MARL 的稳态覆盖率仍维持在 0.8 以上,而 TAG-MAPPO 和 GRU 基线的覆盖率分别下降至约 0.5 和 0.6 且波动剧烈。这一结果直观说明了主动推理机制的价值:在信令极度稀缺的情况下,PL-MARL 能够基于物理规律持续生成可信的邻居状态估计,使协同策略不至于因信息老化而崩溃。
节点失效场景进一步验证了系统的弹性能力。在训练阶段后期,每步以 0.2 概率随机触发单节点失效。测试时,在 步时刻注入失效后,PL-MARL 的覆盖率最低点约为 0.81,并在随后 10 步内稳定恢复;相比之下,TAG-MAPPO 的覆盖率跌至 0.65 且无法收敛到稳定状态。这一差异源于推理引擎使存活节点能够快速估计失效节点的预期轨迹变化,从而调整自身位置以弥补覆盖缺口。
代数连通性分析揭示了拓扑结构的内在平衡。PL-MARL 维持 的特征值,表明编队在保持覆盖分散性与维护通信连通性之间取得了良好折中;TAG-MAPPO 的 说明其倾向于过度凝聚以确保连通性,但牺牲了覆盖均匀性;GRU 的 则反映出预测误差导致拓扑过度稀疏,存在断网风险。
零样本扩展性测试从 训练直接部署到 的场景。推理时延始终保持在约 0.5 毫秒的亚毫秒级,与蜂群规模无关;而 GRU 基线的时延随节点数增加呈多项式增长,在 时已达到 3.0 毫秒。覆盖率方面,PL-MARL 在扩展场景下略有下降但始终维持在可接受水平,验证了轻量化设计对大规模部署的适应性。
讨论与可借鉴点
本文最值得关注的方法论启示在于「以计算换通信」的范式转换。传统观点认为多智能体协同必须以频繁通信为前提,而 PL-MARL 通过将领域知识(运动学先验)嵌入推理过程,证明了对通信的依赖存在松绑空间。这一思路在频谱资源日益稀缺、干扰日益严重的 6G 场景中具有重要的实践价值——将充裕的机载算力转化为稀缺的频谱资源,是一条值得深挖的技术路径。
架构层面的轻量化设计也提供了有益参考。采用扁平 MLP 替代循环网络避免了时序展开的并行化瓶颈,单头注意力在保证表达能力的同时将计算复杂度降至线性。论文中关于推理引擎局部复杂度 的分析,以及与全网规模 完全解耦的论断,为后续研究评估算法可扩展性提供了可借鉴的分析框架。
然而,本文也存在若干局限性值得读者留意。首先,运动学先验的有效性建立在 UAV 运动符合物理规律的前提之上——若遭遇突发机动、强风扰动或电子对抗场景下的非物理运动模式,推理引擎的预测质量可能显著下降,文中并未给出针对这类情况的鲁棒性分析。其次,实验评估主要集中在拥挤城区场景,郊区与乡村环境仅给出了初步结果,不同信道特性和移动模式对推理准确性的影响尚不清晰。此外,推理引擎、注意力机制与位置编码三者的独立贡献缺乏消融实验验证——现有结果难以判断性能增益究竟源于哪个组件。
从更宏观的视角看,PL-MARL 所解决的问题本质上是一个「状态估计与决策的联合优化」问题。在带宽受限条件下,如何最小化通信需求同时最大化协同效能,是多智能体系统领域的核心挑战之一。本文通过物理先验引导的主动推理提供了一种解决思路,但更一般的框架——例如如何为不同运动模式自动选择合适的先验知识、如何在先验失效时优雅降级而非崩溃——仍有广阔的研究空间。
摘要
本信提出预测式轻量级多智能体强化学习(PL-MARL)框架,以确保带宽受限无人机集群的弹性覆盖。为应对稀疏信令和信息老化所导致的协同崩溃问题,我们引入了一种运动学感知推理引擎,借助物理先验主动重构邻居轨迹。该方法实现了计算与通信之间的高效权衡,使结构弹性与信令频率解耦。仿真验证了PL-MARL在极端信令稀缺和节点失效条件下仍能保持优异的覆盖能力与任务连续性。我们的结果证实了主动推理作为一种可扩展、低时延的空中鲁棒协同方案,能够在确保抗干扰能力的同时有效降低控制开销,从而为载荷业务保留宝贵的频谱资源。
Abstract
This letter proposes the Predictive Lightweight Multi-Agent Reinforcement Learning (PL-MARL) framework to ensure resilient coverage in bandwidth-constrained UAV swarms. To counter coordination collapse caused by sparse signaling and information aging, we introduce a Kinematic-Aware Inference Engine that proactively reconstructs neighbor trajectories via physical priors. This approach enables an efficient computation-for-communication trade-off, decoupling structural resilience from signaling frequency. Simulations confirm that PL-MARL maintains superior coverage and mission continuity under extreme signaling scarcity and node failure. Our results validate proactive inference as a scalable, low-latency solution for robust aerial coordination, effectively minimizing control overhead to preserve spectrum for payload services while ensuring resilience against interference.
论文详细总结(自动生成)
PL-MARL 论文结构化总结
一、核心问题与研究动机
在 6G 无人机自组织网络(FANET)中,UAV 集群协同需要持续的状态交换。传统多智能体强化学习(MARL)依赖高频信令同步,但在带宽受限的飞行场景下:
- 信令开销挤占载荷业务的频谱资源
- 加剧同频干扰,导致严重的信息老化(AoI)
- 集中式数字孪生(DT)训练虽稳定,但分布式执行时稀疏信令下难以维持状态感知
- 现有基于时空注意力机制的方案仍依赖频繁信令,缺乏在长时间静默期生成未观测状态的能力
- 团队前期工作 TAG-MAPPO 依赖持续状态同步实现图拓扑可观测性,在稀疏信令下出现"协同崩溃(coordination collapse)"
研究目标:将协同范式从"反应式同步"转变为"主动、物理引导的状态重构",在极端信令稀缺与节点失效下保障覆盖与任务连续性。
二、方法论
1. 系统建模
- UAV 集群 ,节点状态
- 信道质量用 SINR 表征,要求
- 稀疏更新间隔 ,节点 仅在 广播真实状态
- 定义感知信息年龄(P-AoI):
2. 问题形式化(Dec-POMDP)
最大化拓扑扰动后 至 的累积覆盖率:
约束包括:信令频率上限 、干扰约束 (2c)、安全距离 、速度与加速度上限。
3. 核心框架:运动学感知推理引擎(Kinematic-Aware Inference Engine)
- 每个节点维护长度为 的重构轨迹缓冲区
- 将 个时序状态拼接为单一扁平向量,由 MLP(2 层,64/32 维)单次前向传播生成预测:
- 物理一致性正则化(双重损失):
其中 为位置编码函数,保证局部拓扑结构保持。
> 重要说明:真实轨迹仅在 DT 集中训练阶段作为监督信号;分布式执行时仅依赖本地观测与预训练推理。
4. 主动运动学特征融合(Proactive Kinematic Feature Fusion)
- 邻居嵌入显式融合相对位移信息:
- 注意力系数:
- 聚合消息:
- 采用单头注意力(SHA),每节点局部复杂度为 ,关于邻居数 线性扩展,与全网规模 解耦
5. 训练与自适应奖励
- 采用 CTDE + MAPPO 框架;DT 集中训练,UAV 分布式执行
- 自适应奖励:
- 拓扑扰动后自适应增大 (促进向内收缩),减小 (降低移动成本)
- 有意省略 SINR 约束的显式惩罚,促使模型自主涌现"覆盖–拓扑连接"权衡
- 关键算法伪代码(Algorithm 1)实现"预测→协调"流程
三、实验设计
1. 场景与配置
| 配置项 | 取值 |
|---|---|
| 覆盖区域 | ,3D |
| UAV 数量 | 4(训练) |
| 地面用户 | 240 个 Gauss-Markov 模型, |
| UAV 动力学 | , |
| 通信/感知半径 | |
| 信令间隔 | 步 |
| 决策间隔 | 3 s |
| 缓冲区长度 | 10 |
| Episode 长度 | 步 |
| 训练 Episodes | 1000(前 500 正常,后 500 注入 0.2 概率单节点失效) |
| 混合移动模型 | Random Waypoint + Gauss-Markov + RPGM |
2. 对比方法(Baselines)
1. TAG-MAPPO(团队前期工作的消融基线):仅使用陈旧观测,无轨迹推理
2. GRU-based MARL:用标准门控循环单元替换推理引擎,验证物理先验的必要性
3. Oracle Bound:基于完美全局信息的序贯贪心网格搜索理论上限
3. 测试场景
- 主场景:拥挤城区(Crowded Urban,文中主要压力测试)
- 简要验证:郊区(Suburban)、乡村(Rural)
4. 统计方法
- 100 次独立 episode 运行;95% 置信区间
- 非参数 Mann–Whitney U 检验()严格验证增益显著性
四、资源与算力
- GPU 型号、数量、训练时长等算力信息:论文中未明确说明
- 仅给出超参数:PPO batch=800、PPO 内部 epoch=5、Actor/Critic 学习率 、学习率退火 800 episodes(min ratio 0.1)、熵调度
- 多速率架构:环境物理与推理引擎 1 s 分辨率连续跟踪;策略每 3 s 更新一次动作以节省计算
五、实验数量与充分性
论文共展示了 6 组核心实验:
1. 图 3(a) 收敛分析:训练曲线对比 Oracle Bound 与 GRU、TAG-MAPPO
2. 图 3(b) 覆盖率 vs. 信令间隔 :测试稀疏信令下稳态覆盖率
3. 图 4(a) 推理时延 vs. : 零样本扩展性
4. 图 4(b) 覆盖率 vs. :零样本扩展下的覆盖保持
5. 图 5(a) 节点失效后动态覆盖率: 单节点随机失效下的瞬态恢复
6. 图 5(b) 代数连通性 vs. :拓扑平衡性分析
充分性评估:
- ✅ 多维度评估(覆盖率、时延、弹性、连通性、收敛性)
- ✅ 显著性检验(Mann–Whitney U,)
- ⚠️ 主实验仅在 Crowded Urban 详细展开,Suburban/Rural 仅给出"初步结果"
- ⚠️ 缺少消融实验(推理引擎与注意力机制各自的独立贡献未拆解)
- ⚠️ 未与最新 SOTA(如 QMIX、CommNet 等通信学习 MARL)对比
六、主要结论与发现
1. 协同模式转变:物理先验推理使结构弹性与信令频率解耦,无需高频同步即可维持覆盖
2. 时延优势:PL-MARL 保持约 0.5 ms 推理时延(近常数),对比 GRU 基线在 时达 3.0 ms 的多项式增长
3. 稀疏信令鲁棒性:(50 s 静默期)下 PL-MARL 仍稳态覆盖 > 0.8,GRU 波动剧烈
4. 弹性恢复:节点失效后 PL-MARL 覆盖率最低点约 0.81,10 步内稳定;TAG-MAPPO 跌至 0.65 且无法稳定
5. 拓扑平衡:PL-MARL 维持 的最优折中,TAG-MAPPO (过度凝聚)、GRU (过度稀疏易断网)
6. 零样本扩展:训练于 可直接部署至 ,验证轻量化设计的可扩展性
七、优点与方法亮点
- 物理先验嵌入:用运动学规律代替纯数据驱动的黑盒推理,预测误差有界、可解释
- 计算换通信:将稀缺资源(频谱)转化为充裕资源(机载算力),契合 UAV 能量预算特性
- 架构轻量化:扁平 MLP + SHA 实现亚毫秒级推理,规避 RNN 顺序展开瓶颈
- CTDE + DT 协同:集中训练解决非平稳性,分布式执行符合真实部署约束
- 自适应奖励设计:扰动状态下动态调整 ,涌现智能权衡
- 公平性保障:95% CI + Mann–Whitney U 检验确保结论统计显著
- 多速率架构:环境物理 1 s 跟踪 + 策略 3 s 更新,分离快慢变量降低算力负载
八、不足与局限
1. 算力信息缺失:未报告训练所用 GPU 型号、训练时长等,实验可复现性受限
2. 主场景单一:核心实验仅详细评估 Crowded Urban,Suburban/Rural 仅"初步结果"
3. 消融实验不足:推理引擎 vs. 注意力机制 vs. 位置编码 PE 三者的独立贡献未拆解
4. 先验依赖风险:性能高度依赖运动学先验的准确性;若 UAV 运动违反物理假设(如突发机动、风扰),推理可能失真,文中未给出鲁棒性分析
5. 对比基线范围:未与近期通信学习类 MARL(如 NDQ、MAGIC、TarMAC 等)对比
6. 物理可行性简化:连续动作加加速度在真实 UAV 控制中需考虑动力学延迟与执行器响应
7. GCS 与干扰建模简化:SINR 概率约束被设计为"自然惩罚",但未与真实信道衰落模型(如 Rayleigh/Rician)对接验证
8. 零样本扩展的代价: 增大时虽时延稳定,但覆盖率曲线显示 PL-MARL 略低于 GRU 基线,通信节省与任务性能的严格权衡未深入量化
9. 失效模式单薄:仅考虑单节点随机失效(0.2 概率),未涉及多节点级联失效或对抗性失效
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。