
随推理展开而学习:面向高效强化学习的渐进式采样分配
Learning as Reasoning Unfolds: Progressive Rollout Allocation for Efficient Reinforcement Learning
📝 TLDR
RLVR已成为提升大语言模型推理能力的主流范式,但GRPO需为每个样本生成大量长链推理轨迹,多数rollout信息量低,造成训练开销大且不稳定。现有方法通过prompt级过滤缓解问题,但收益有限。本文提出VIGOR,对batch内样本从小预算出发,按组奖励方差迭代追加rollout至总预算耗尽。理论证明奖励方差控制梯度幅度,实验显示在数学推理任务上节省2.3倍rollout,编码任务上节省1.49倍且平均通过率提升3.4点。
🧭 速览
GRPO需为每个样本生成固定数量的长链推理轨迹,多数rollout信息量低,导致训练开销大且不稳定。
提出VIGOR:先为batch内所有样本分配少量rollout,再按组奖励方差迭代追加分配,直至总预算耗尽。
数学推理任务以2.3倍更少rollout达到目标精度;编码任务以1.49倍更少rollout匹配GRPO,平均通过率提升3.4点。
VIGOR通过自适应分配rollout显著提升RLVR训练效率,为推理模型的强化学习训练提供高效可行方案。
🆚 方法对比
GRPO
- 采样多rollout基于组内相对奖励更新策略
- RLVR中高效变体,已广泛验证有效
- 实现简单,是主流推理强化学习方法
- 训练时间随rollout数量线性增长
- 大量rollout信息量低,因奖励方差为零
- 7B规模训练需多天,计算开销大
- 优化过程不稳定,存在训练波动
VIGOR
- 数学任务少2.3倍rollout达目标精度
- 编码任务少1.49倍rollout匹配GRPO
- 编码平均通过率提升3.4个百分点
- 有闭式加速比理论保证,不修改目标
- 自适应分配算力至最高方差样本
- 依赖组奖励方差作为信息量信号
- 理论分析假设奖励方差服从Pareto分布
- 需多轮迭代分配,增加调度复杂度
DAPO
- 率先探索动态rollout分配方向
- 可筛选非零方差困难样本提升效果
- 生成额外rollout用于过滤,计算开销大
- 使用早期统计信号仅带来边际提升
GRESO
- 利用历史信号进行rollout过滤
- 在数学推理任务上有一定效率提升
- 效率提升有限,被VIGOR超越56.9%
- 依赖历史信号,适应性受限
RL-ZVP
- 利用零方差提示进行样本筛选
- 在GRPO基础上引入价值信号
- 整体过程偏慢,性能提升温和
- 相对VIGOR需更多rollout达相同精度
陈旧rollout/辅助信号方法
- 通过辅助信号提升rollout利用效率
- 可提高数据利用效率
- 修改GRPO原始训练目标
- 增加复杂度但效率增益有限
GRPO是基础方法但存在大量低信息量rollout和训练不稳定问题;DAPO类方法通过预生成再过滤产生额外开销,GRESO/RL-ZVP和陈旧rollout方法修改目标或依赖历史信号,效率增益有限;VIGOR通过方差引导的自适应在线分配,在不修改GRPO目标的前提下实现2.3倍数学加速和1.49倍编码加速,显著优于现有基线。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
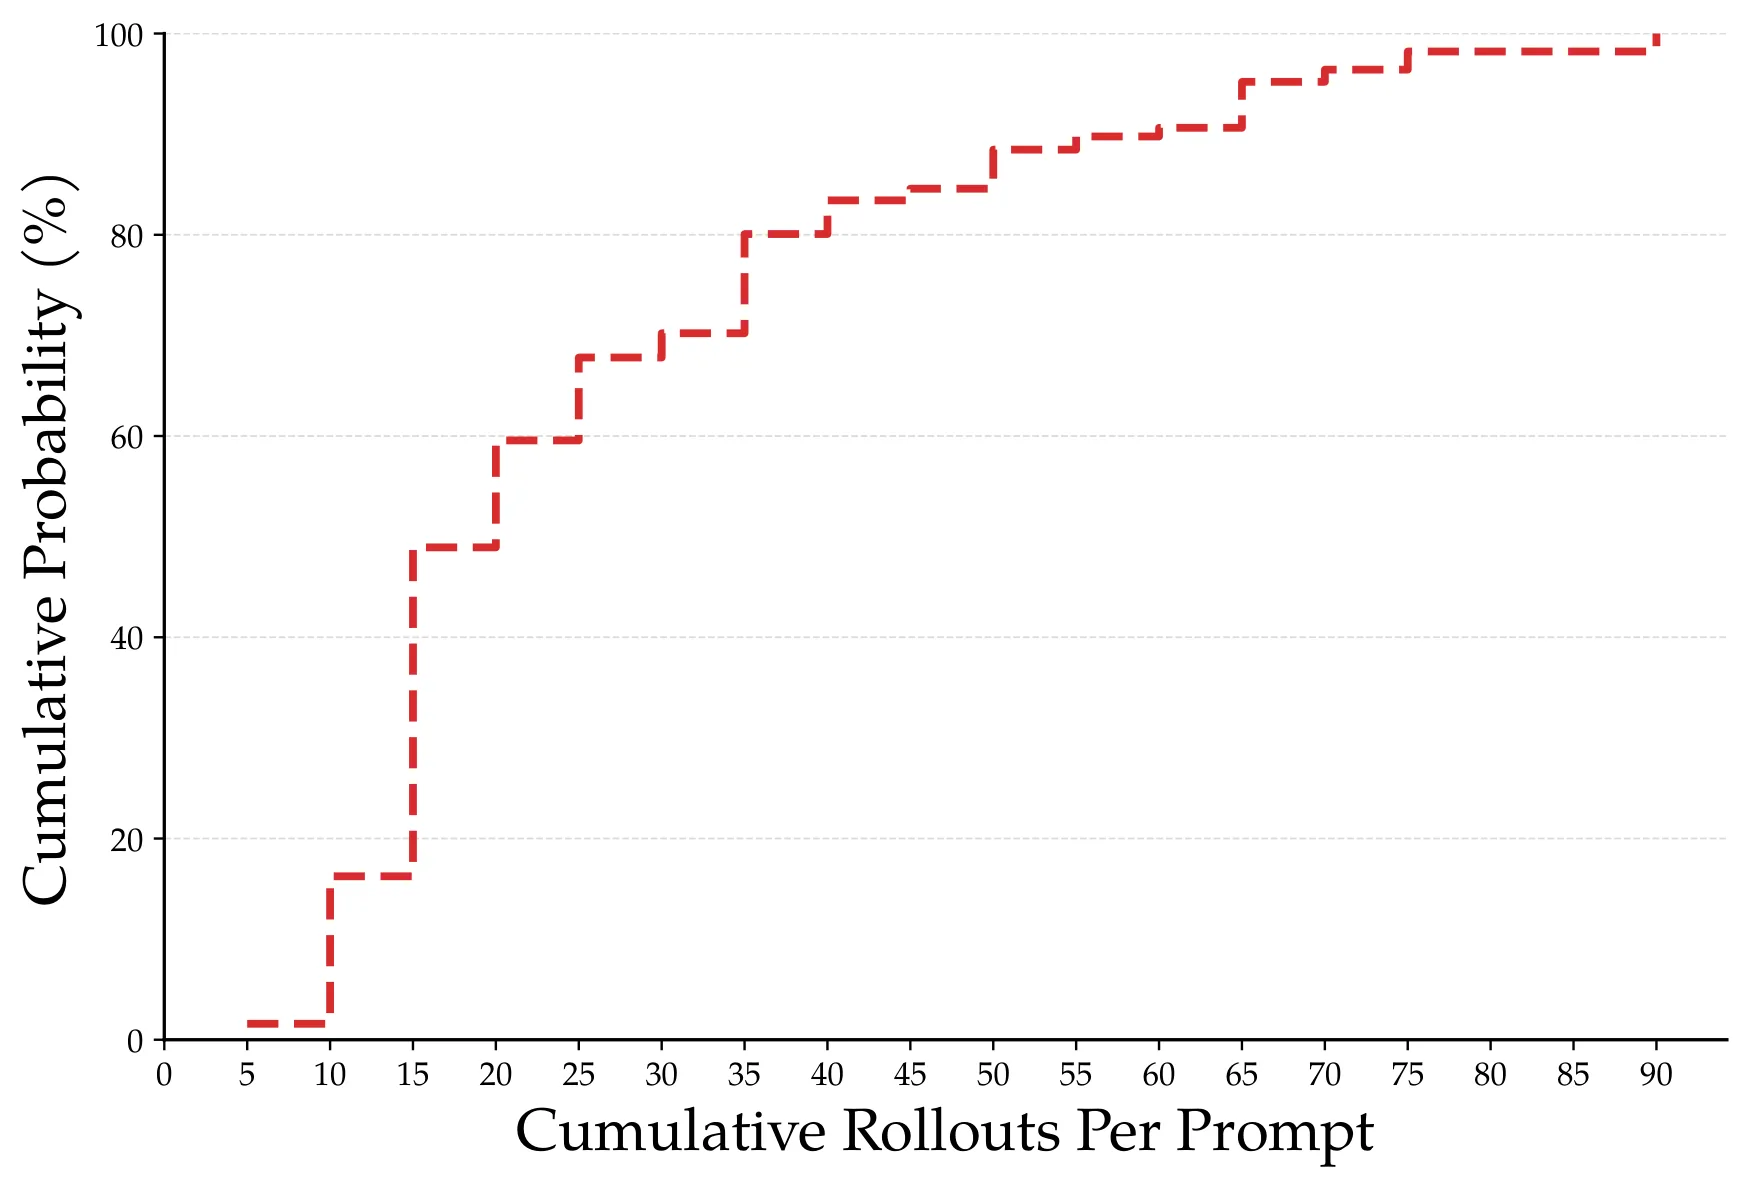
TL;DR
VIGOR 提出了一种面向大语言模型强化学习的高效采样分配策略,其核心思想是在训练过程中动态识别高信息量样本,将更多 rollouts 集中分配给奖励方差最大的 prompt。理论分析证明奖励方差直接控制 GRPO 梯度幅值,且在 Pareto 分布假设下可推导出闭式加速比。实验在数学推理和代码生成任务上验证了该方法:在保持甚至超越 GRPO 性能的同时,数学任务节省最多 2.3 倍 rollouts,代码任务以 1.49 倍 rollouts 达到 GRPO 的最终通过率。
研究背景与动机
大语言模型在复杂推理任务上的能力突破,很大程度上得益于带可验证奖励的强化学习(RLVR)这一训练范式。与依赖人类反馈的传统 RLHF 不同,RLVR 根据任务特性设计自动化奖励信号——数学题有唯一正确答案、代码可通过单元测试验证——这使得大规模、高质量的无人类标注训练成为可能。GRPO 作为该范式最成功的实现之一,通过组内相对排序机制避免了传统 PPO 对价值网络的依赖,显著降低了训练复杂度。
然而,GRPO 的运作机制埋藏着效率陷阱。它需要为 batch 中的每个 prompt 生成多条 rollouts 以估计组内 reward 分布,进而计算相对优势。那些奖励方差为零或极低的样本——要么全部答对、要么全部答错——对策略更新的贡献微乎其微,却仍消耗等额的生成算力。论文的诊断实验揭示了一个关键事实:在 Qwen2.5-1.5B 模型上,rollout 生成时间占据单步训练时间的 50% 以上;更严峻的是,1.5B 和 3B 模型在第一个训练 epoch 就能贡献约 80% 的验证精度提升,后续 epoch 的边际收益急剧下降。这意味着如果能尽早识别并集中资源于高信息量样本,训练效率将获得质的飞跃。
现有方法试图解决这个问题,但各自存在局限。DAPO 类方法通过扩大候选池再筛选来提升采样质量,但生成更多 rollouts 本身已构成开销。GRESO 等利用训练历史信号识别困难样本的方法只能在训练后期发挥作用,而论文的分析表明,早期阶段恰恰是最需要高效采样的时期——那时模型尚未收敛,大量 prompt 的奖励分布尚不稳定,最具优化价值。改变训练目标(如 RL-ZVP、M2PO)或依赖陈旧采样的方法(PODS)则引入了额外的工程复杂度和训练不稳定性。
方法
VIGOR 的设计哲学可以用一句话概括:把采样预算当作一种需要动态分配的稀缺资源,而非固定摊派给每个样本的开销。
方法的理论根基建立在一个关键观察之上:在二元奖励(对错信号)设置下,GRPO 的梯度范数上界与组内奖励标准差成正比。具体而言,当 rollout 样本的奖励 时,梯度范数满足 ,其中 是该 prompt 组内奖励的标准差, 是统一的重要性采样梯度上界。这一定理揭示了一个核心直觉:组奖励方差最大的样本同时也是对策略更新贡献信号最强的样本。方差为零意味着模型对该 prompt 的输出分布已经饱和稳定,继续投入 rollouts 是纯粹的浪费;方差越大,说明模型对该问题的响应尚不稳定,每一次正确的更新都可能带来显著的策略改进。
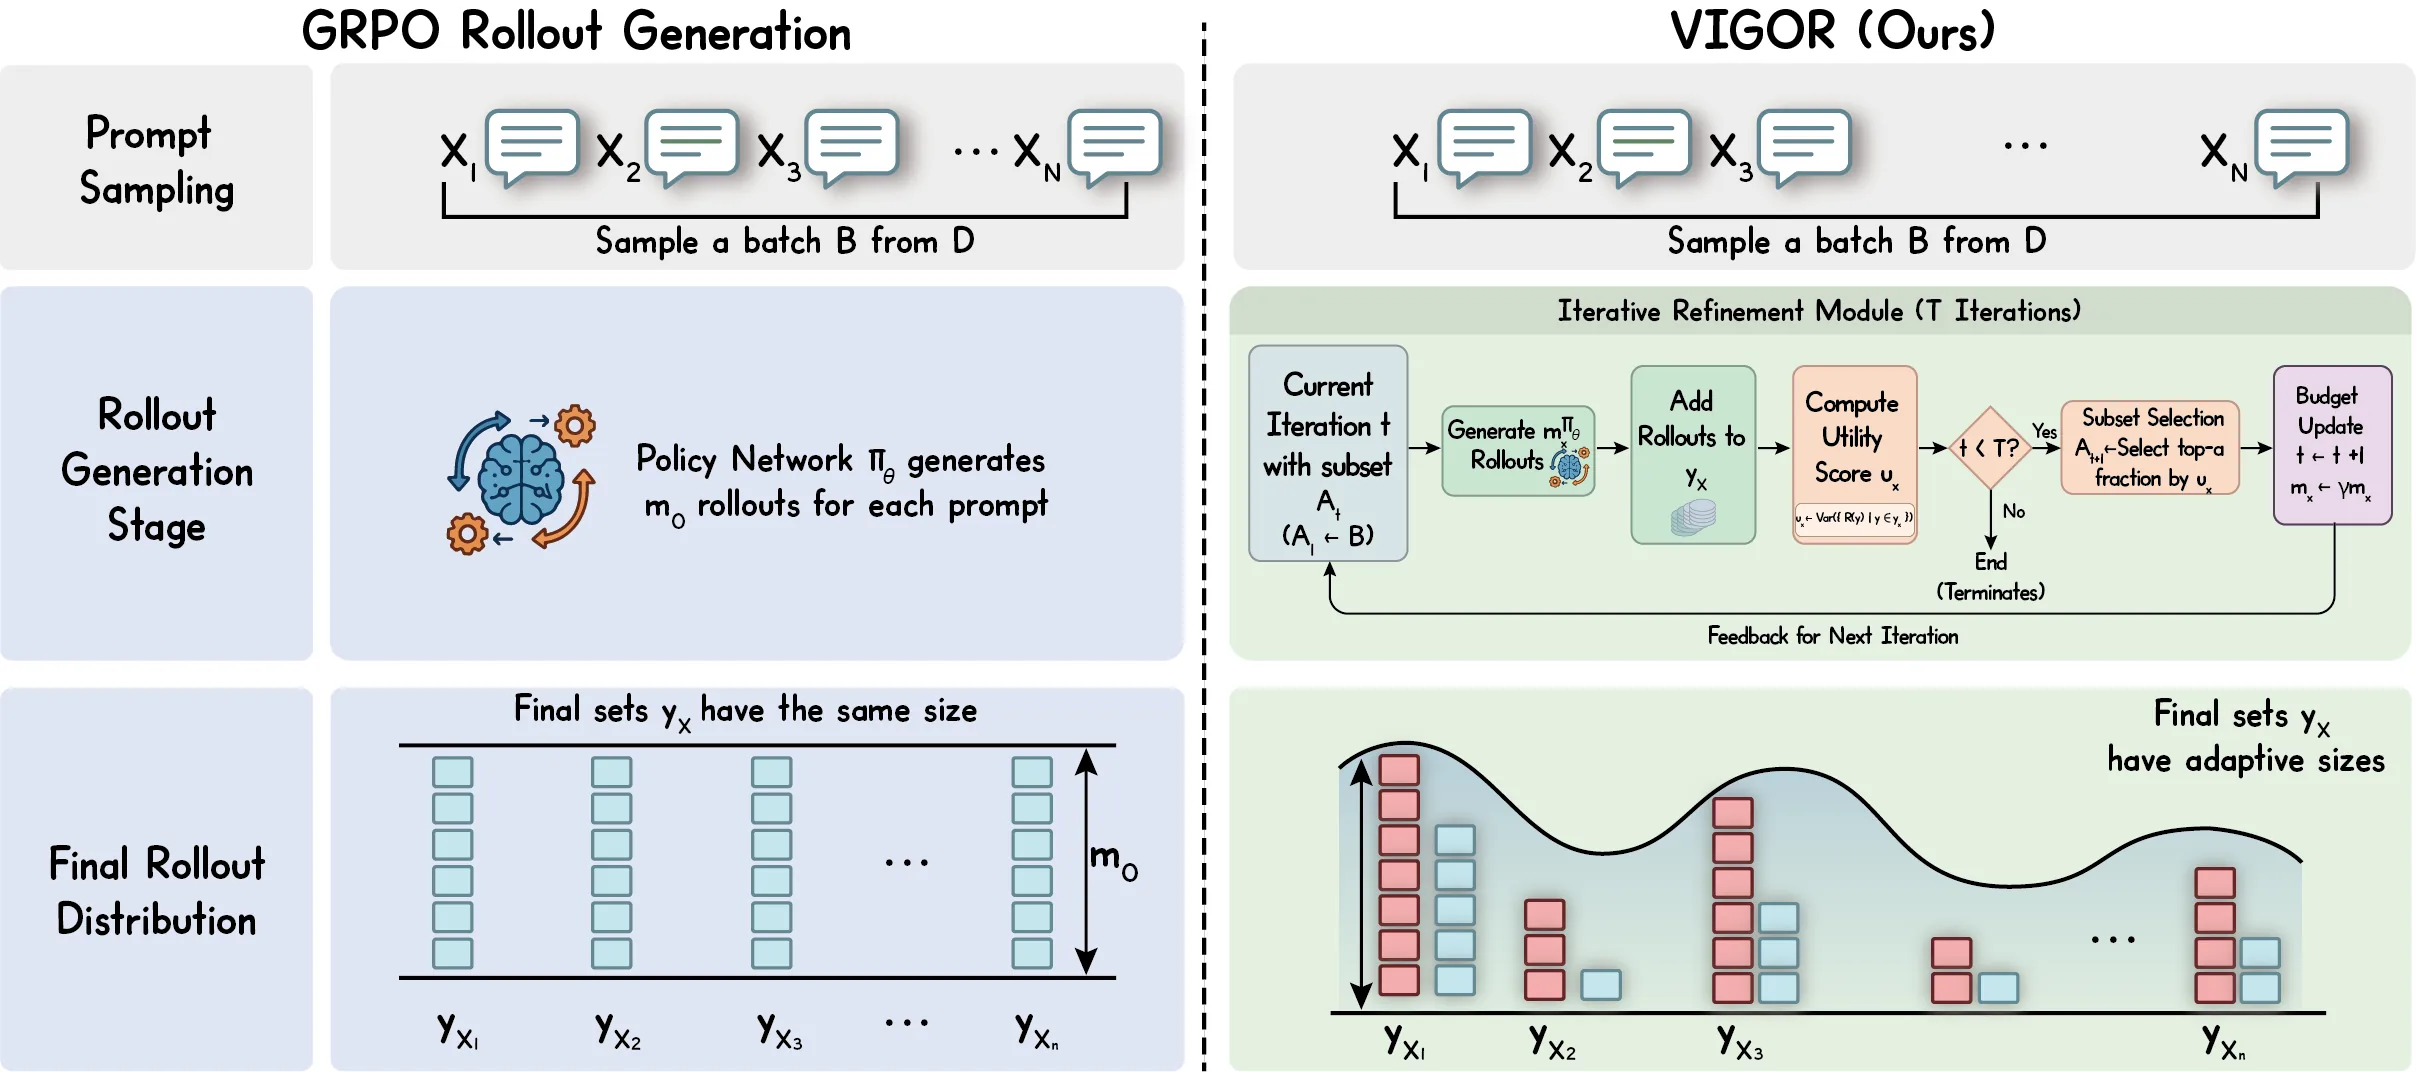
基于这一理论洞察,VIGOR 设计了一套迭代式采样分配机制。算法从为 batch 中所有 prompt 分配少量初始 rollouts(默认 )开始,在每一轮 中,计算每个 prompt 的组奖励方差 ,然后按照方差大小排序,仅保留 top- 比例(默认 50%)方差最高的 prompt,并为它们按扩展比 (默认 2)增加采样预算。这一过程迭代进行,直到总采样预算耗尽或达到预设轮数 (默认 4)。最终,使用所有保留下来的 rollouts 执行标准 GRPO 更新。
整个流程的巧妙之处在于预算守恒:虽然每个 prompt 的预算在迭代中动态变化,但 batch 总预算保持固定——部分样本的预算增加必然以其他样本的预算减少为代价。默认配置下,初始每 prompt 2 个 rollouts,经过 4 轮扩展后最终达到 16 个(),但由于每轮只保留一半样本,总预算恰好与 GRPO 的 持平。这种设计确保 VIGOR 不会比 GRPO 生成更多 rollouts,其效率收益完全来自采样分配的优化。
论文进一步在理论上分析了 VIGOR 相对于 GRPO 的收敛加速比。假设 prompt 级奖励方差的上尾服从 Pareto 分布(这在真实数据中常能观察到重尾特性),则加速比可表示为优化轮数 的函数。在预算守恒情形()下,加速比随 增长而增大;在计算倾斜情形(,即高方差样本获得不成比例的更多预算)下,加速比随 呈指数增长。值得注意的是,方差分布越重尾(即 ),加速效果越显著,这暗示 VIGOR 在真实数据上的表现可能优于理论分析的基准场景。
实验与结果
实验在两个核心任务上验证了 VIGOR 的有效性:数学推理和代码生成,分别对应 RLVR 最典型的两类应用场景。
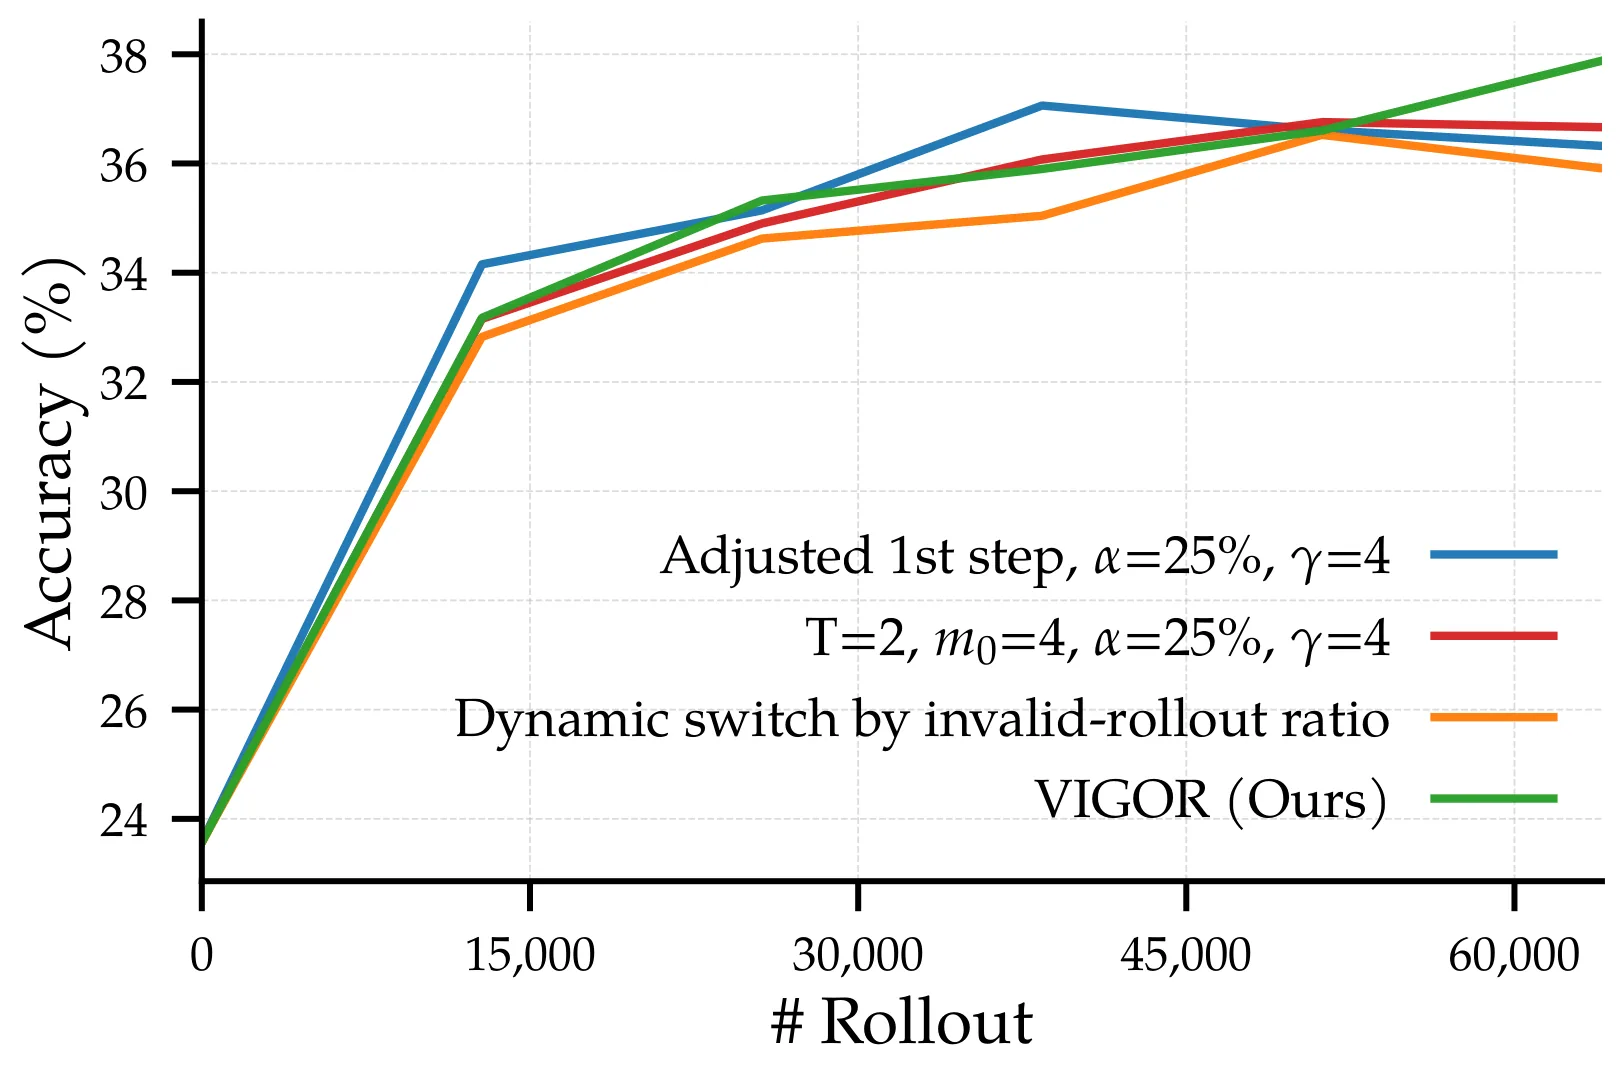
数学推理实验覆盖了 Qwen2.5-1.5B/3B/7B 和 Phi-4-Mini-Instruct 等多个规模的模型,训练数据涵盖 MATH 和 DAPO 数据集,评估则在 Math500、AIME24、AMC、Gaokao、Minerva Math、Olympiad Bench 等六个基准上进行。在 rollout-matched 对比下(即总采样预算相同),VIGOR 在所有模型规模上均取得最优或持平的平均分数。以 Qwen2.5-3B 为例,VIGOR 在仅消耗 2.3 倍更少 rollouts 的条件下达到目标准确率 37.8%,而 GRPO 和 GRESO 分别需要更多步数才追平该指标。从 wall-clock 时间看,VIGOR 实现了 2.65 倍的端到端加速。
代码生成实验在 LiveCodeBench v6 上训练 Qwen3-8B,采用 rich-feedback 设置,兼顾 full pass rate(所有测试用例通过的比例)和平均测试通过率两个指标。结果显示,VIGOR 以 1.49 倍更少的 rollouts 达到 GRPO 的最终 full pass rate,同时将平均测试通过率从基线水平提升了 3.4 个百分点。
消融实验进一步揭示了设计选择的合理性。方差引导的选择策略显著优于基于样本难度或随机选择的方法,证实了 reward variance 作为信息量指标的理论预测。大 group 设置(每 prompt 32 个候选 rollouts)下,VIGOR 仍能保持 2.77 倍 rollout 加速,相比同设置下的 PODS 方法节省了 5.34 倍 rollouts 和 3.97 倍 wall-clock 时间。此外,论文还观察到一个有趣的涌现现象:随训练推进,被选中样本的加权平均难度自然上升,形成了一条隐式的课程学习轨迹,无需人工标注难度等级。
讨论与可借鉴点
VIGOR 的核心贡献在于揭示了 RLVR 中 reward variance 与 gradient magnitude 之间的内在联系,并据此设计了一套无需修改训练目标、无需引入额外辅助信号的采样分配机制。这种"方差即信号"的洞察具有超越具体方法的启发价值——它提醒我们,在 rollouts 生成阶段的信息筛选,可能比在优化目标上的改动更能从根本上提升训练效率。
然而,这一方法也存在值得关注的局限性。Theorem 2 的收敛加速分析建立在 prompt 奖励方差服从 Pareto 分布的假设之上,尽管论文用重尾特性为这一假设提供了动机性解释,但并未在所有实验数据集上严格验证该假设的成立。小样本方差估计(尤其是初始 时)的噪声较大,论文通过假阴性率分析(约 7.9%)表明这一风险可控,但缺乏理论保障的自适应策略。Theorem 1 的二元奖励假设在数学场景下天然成立,但代码生成中可能存在中间执行反馈等更细粒度的 reward 信号,其与梯度幅值的关系未被探讨。
从工程实践角度看,VIGOR 的超参数()在论文的实验配置下表现稳健,但迁移到更长响应、更大模型或不同领域时, 与 的最优取值可能需要调整。代码实验中仅与 GRPO 进行了对比,与 GRESO、RL-ZVP 等基线方法的对照因算力限制未能展开,这在一定程度上限制了方法全面性的评估。
对于后续研究而言,VIGOR 的框架具有较强的可扩展性。将 reward variance 替换为其他信息量指标(如策略熵、token-level 置信度)可能捕捉不同的优化信号;结合训练历史信号与在线方差估计的混合策略或许能兼顾早期效率与后期精度;在其他 RLVR 变体(如带价值网络的 PPO、结合 DPO 的混合训练)上验证 VIGOR 的迁移性,也是值得探索的方向。
摘要
带可验证奖励的强化学习(RLVR)已成为提升大语言模型推理能力的极为有效的框架,其中 GRPO 等方法是最成功的实例化代表。然而,GRPO 依赖于反复生成长链式思维采样。训练时间随采样数量增长,而其中很大一部分采样不具有信息量。因此,GRPO 计算开销大且训练不稳定。为缓解这一问题,现有方法要么生成更大规模的采样池并筛选最具信息量的提示词,要么利用历史信号在训练后期进行过滤。这些策略带来有限的性能提升,但会拖慢整体流程。为解决此问题,我们提出了方差引导的在线采样分配(VIGOR)方法。它不再为每个样本分配固定的采样预算,而是先为批次中所有样本分配少量采样,然后在达到固定总采样预算之前,将额外采样迭代地分配给组奖励方差最大的样本。理论上,我们证明在 RLVR 框架下,奖励方差控制梯度幅值,并推导出 VIGOR 相对于 GRPO 的闭式加速比,该加速比在奖励方差服从帕累托分布时随优化轮次增加而增大。在数学推理与代码任务上的实验表明,VIGOR 在数学任务上以多达 2.3 倍更少的采样达到目标准确率,在代码任务上以 1.49 倍更少的采样达到 GRPO 的最终完全通过率,并将代码任务的平均测试通过率提升 3.4 个百分点。
Abstract
Reinforcement learning with verifiable rewards (RLVR) has emerged as a highly effective framework for improving LLM reasoning, with methods such as GRPO among its most successful instantiations. However, GRPO relies on repeated generation of long chain-of-thought rollouts. Training time scales with the number of rollouts, a large fraction of which are uninformative. Thus, GRPO is computationally expensive and unstable. To mitigate this, existing approaches either generate a larger pool of rollouts and filter the most informative prompts, or leverage historical signals for filtering at later stages of training. These strategies offer modest performance gains, but slow down the overall process. To address this, we propose VarIance Guided Online Rollout allocation (VIGOR) which instead of allocating a fixed rollout budget per example, begins with a small number of rollouts for all examples in a batch and iteratively allocates additional rollouts to those with the highest group reward variance until a fixed total rollout budget is reached. Theoretically, we show that under RLVR, reward variance controls the gradient magnitude, and derive VIGOR's closed-form speedup ratio over GRPO, which grows with refinement rounds under Pareto-distributed reward variance. Experiments on mathematical reasoning and coding tasks show that VIGOR reaches target accuracy with up to 2.3 fewer rollouts on math, reaches GRPO's final coding full pass rate with 1.49 fewer rollouts, and improves the coding average test pass rate by 3.4 points.
论文详细总结(自动生成)
论文总结:VIGOR — 面向高效 RLVR 的方差引导渐进式采样分配
一、核心问题与研究动机
- 背景:带可验证奖励的强化学习(RLVR)已成为提升大语言模型(LLM)推理能力的主流范式,其中 GRPO(Group Relative Policy Optimization)是最成功的实现方式。然而 GRPO 需要为每个提示词生成长链式思维(CoT)采样(rollout),大量采样因奖励方差为零而信息量极低,导致训练既慢(7B 规模需多日)又不稳定。
- 现有方法的不足:
- DAPO 类:对每个提示词生成大量采样再过滤,计算开销大;
- GRESO / DPS 类:依赖训练历史信号做困难样本采样,但只能在后期生效,对早期贡献最大的训练阶段无能为力;
- RL-ZVP、M2PO、PODS 类:改变训练目标或需要陈旧采样,复杂度高但效率提升有限;
- VIP、AR3PO、XRPO 类:自适应采样分配,但依赖辅助信号或改进探索。
- 两个关键观察:
1. 采样生成是主要成本:在 Qwen2.5-1.5B 上,rollout 生成至少占训练总时间 50%,且随 batch size 近似线性增长;
2. 早期训练贡献最大:在 MATH 数据集上,1.5B/3B 模型的第一个 epoch 即可贡献 ~80% 验证精度提升,7B 模型首个 epoch 提升与后续 6 个 epoch 相当。
- 核心需求:在训练早期即应把计算资源集中于最具信息量的提示词,且不引入额外 rollout 开销。
二、方法论
2.1 核心理论支撑(Theorem 1)
在二元奖励 设置下,GRPO 目标梯度范数上界与组内奖励标准差成正比:
其中 为重要性采样梯度的统一上界。该结果通过两个引理得到:
- Lemma 1:KL-free 设置下 ;
- Lemma 2:二元奖励下 ,从而总信号 直接控制梯度幅值。当正负奖励均衡()时信号最大。
含义:组奖励方差最大的样本同时也是对 GRPO 优化最"信息量大"的样本。
2.2 VIGOR 算法(Algorithm 1)
输入为数据集 、奖励函数 、batch size 、初始采样预算 、优化轮数 、扩展比 、选择率 。
核心流程:
1. 初始化:每个提示词 初始化 rollout 集 ,预算 ,激活子集 ;
2. 对第 轮():
- 对每个 ,从 生成 个 rollout,合并入 ;
- 计算效用分数 ;
- 若 :保留分数最高的 top- 比例 prompt,得 ;对保留下来的 prompt 更新预算 ;
3. 用所有保留下的 rollout 执行标准 GRPO 更新。
预算约束:默认配置 ,与 GRPO(每 prompt 8 个 rollout)总预算匹配。
2.3 收敛速度分析(Theorem 2)
假设 prompt 级奖励方差 上尾服从 Pareto 分布 (,):
- 预算守恒情形():
- 计算倾斜情形():
加速比随优化轮数 指数增长,且越重尾()优势越大。
三、实验设计
3.1 数据集与基准
- 数学推理:训练数据为 MATH(1.5B/3B)或 MATH+DAPO(7B/Phi-4-Mini-Instruct);评估 6 个基准:Math500、AIME24、AMC、Gaokao、Minerva Math、Olympiad Bench;
- 代码生成:在 LiveCodeBench v6 (LCBv6) 上训练 Qwen3-8B,采用 SDPO 的 rich-feedback 设置,使用公开单元测试作在线奖励,隐藏测试作验证集;报道 full pass rate(全部通过)与平均测试通过率。
3.2 模型与基线
- 模型:Qwen2.5-1.5B/3B/7B、Phi-4-Mini-Instruct、Qwen3-8B;
- 基线:
- GRPO:标准 baseline;
- GRESO-r / GRESO-g:动态采样困难 prompt(前者 rollout 预算匹配,后者更新步数匹配,约 2 倍 rollout);
- RL-ZVP:用熵引导奖励替代零方差 prompt;
- PODS:n=32 大候选池下采样;
- Difficulty-based / Random:消融基线。
- 超参数:所有方法统一 batch size 和优化器配置,使用 verl + vLLM 训练栈,AdamW 常学习率 。
3.3 评测指标与公平性
- rollout-matched 对比(与 GRPO、GRESO-r、RL-ZVP 同 rollout 预算);
- gradient-step-matched 对比(与 GRESO-g 同更新步数,约 2 倍 rollout);
- 3 随机种子,多基准平均分。
四、资源与算力
- 主训练: GPU;部分统计实验在 上完成;
- 代码训练:;
- 数学训练 batch size:1.5B/3B 为 160,7B/Phi 为 640;每步 20 个梯度更新 mini-batch(mini-batch 32/64);
- 代码训练:batch size 64,PPO mini-batch 8;
- 上下文长度:Qwen 系最大 prompt=1536、response=2560;Phi-4 prompt=2048、response=6144;代码 prompt=2048、response=8192;
- 端到端 wall-clock:Qwen2.5-3B 上 VIGOR 50 步达目标 37.8% 精度,GRESO 需 105 步,2.65× wall-clock 加速;
- 5×GH200 测量(Figure 4):生成+验证时间随 batch size 与 response 长度接近线性/超线性增长,VIGOR 与 GRPO/RL-ZVP 相近,远快于 GRESO。
> 备注:论文未直接给出总训练小时数或总 GPU-hour。
五、实验数量与充分性
- 数学实验:4 个模型规模 × 6 基准 + 完整 rollout-accuracy 曲线(Figure 1、6);
- 代码实验:3 随机种子,2 种 pass rate 指标;
- 消融与扩展:
- 选择策略消融(variance vs difficulty vs random);
- n=32 大 group 与 PODS 对比;
- 替代分配计划消融(调整 α、γ、T);
- 超参数与初始方差估计的假阴性率分析(仅 7.9% miss);
- 有效采样率与涌现课程效应(按 MATH Level 1–5 加权难度随训练上升);
- Case study 高/低选频率 prompt 实例;
- 公平性:所有方法同一 verl 管线、统一优化器与 batch 规模;rollout-matched 与 step-matched 两套对照;多 seed 报标准差。
- 总体评价:实验规模较大、横跨数学与代码、覆盖多个模型尺寸,设置了对照消融与多 seed 鲁棒性实验,具有较高的充分性与客观性。
六、主要结论与发现
1. 效率提升显著:数学任务最高 2.3× rollout 效率提升(Qwen2.5-3B),代码任务 1.49× rollout 即可达到 GRPO 最终 full pass rate,平均测试通过率提升 3.4 点;
2. 精度提升:在公平 rollout-matched 对比下,VIGOR 在 4 个数学模型规模上全部取得最高平均分(最高 51.0 vs GRPO 49.8 于 Qwen2.5-7B);
3. 资源消耗可控:wall-clock 与 GRPO/RL-ZVP 相近,远优于 GRESO;
4. 大 group 仍有效:n=32 下对比 GRPO 仍有 2.77× rollout 加速,相比 PODS 节省 5.34× rollout 与 3.97× wall-clock;
5. 涌现课程:随训练推进,加权平均 prompt 难度自然上升,无需难度标签;
6. 有效样本率提高:VIGOR 显著降低零方差无效采样比例。
七、优点
- 理论扎实:同时给出 gradient-variance 关系(Theorem 1)与 Pareto 分布下的闭式加速比(Theorem 2);
- 实现简洁:不修改 GRPO 优化目标与管线,仅在 rollout 生成阶段做迭代方差排序,工程代价低;
- 早训练即时生效:克服了 GRESO 等依赖训练历史的"延迟过滤"问题;
- 跨域通用:数学与代码两类任务、1.5B 至 8B 多尺度模型均验证有效;
- 配套鲁棒性分析:包括假阴性率、有效采样率与涌现课程等额外诊断;
- 启发性发现:揭示了 RLVR 中"方差即梯度信号"的核心直觉,为后续 variance-based data selection 提供思路。
八、不足与局限
- 分布假设较强:Theorem 2 依赖 prompt 奖励方差上尾 Pareto 分布假设,论文未实证该假设在所有数据集(如 LCBv6、不同模型)上是否严格成立;
- 超参数敏感性:默认 在更大/更长响应模型上的迁移性未充分测试;Appendix B 消融仅针对 Qwen2.5-3B 单个数据集;
- 小方差估计的初始风险:m0=2 时方差估计噪声较大,作者通过假阴性率分析(7.9%)部分回答,但未给出理论保障或自适应策略;
- 二元奖励依赖:Theorem 1 建立在二元奖励上,对于 dense reward(如代码 rich-feedback 中虽然最终是 pass/fail,但中间文本执行反馈未纳入)情形是否仍成立未明确讨论;
- 代码实验范围:仅在 Qwen3-8B 单模型上对比 GRPO,未在代码任务上与 GRESO、RL-ZVP 等基线对比(受成本限制);
- 缺乏更广 RL 算法适配性验证:仅在 GRPO(KL-free 变体)上验证,未验证在 DPO、Kahneman–Tversky optimization 或 PPO+value baseline 等其他 RLVR 范式中的可迁移性;
- 方差数据隐私与选择偏差:未讨论当某些提示词反复被分配高方差信号时是否会引入分布漂移或对特定主题产生过拟合;
- 算力与时长未公开:未给出具体 GPU-hour、训练总时长等可复现指标。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。