
三体对齐:通过重排序推理依据使国际象棋代理与人类推理保持一致
Three-Body Alignment: Aligning Chess Agent with Human Reasoning through Reranked Rationale
📝 TLDR
随着推理代理复杂度提升,使其推理过程与人类概念模型对齐成为 AI 安全的关键挑战。本文以国际象棋为载体,提出"三体对齐"框架,比较国际大师、NNUE 辅助解说与 LLM 三类主体的推理理据。通过 t-SNE 可视化证实三者语义嵌入空间存在显著异质性,并验证重排序机制能提升人机对齐但需以战术性能为代价。贡献包括多源理据数据集、语义空间分析、权衡实验及开源资源,为整合多元专家知识构建可解释代理奠定基础。
🧭 速览
AI 推理代理的决策机制日益复杂,如何让其与人类概念模型对齐成为 AI 安全部署的核心难题。
构建多源理据数据集,通过 t-SNE 语义嵌入可视化分析三类主体(大师、NNUE 解说、LLM)的理据异质性,并采用重排序机制改善对齐效果。
三类理据在嵌入空间中形成显著不同的聚类;重排序机制提升了人机对齐,但会牺牲部分战术性能。
重排序是改善人机对齐的有效路径,但需明确权衡可解释性与战术表现,为整合多元专家知识的可解释代理提供基础。
🆚 方法对比
Three-Body Alignment Framework
- 首次提出三方对齐框架,揭示推理异质性
- 整合GM、NNUE与LLM三类推理源
- 支持AI安全与可解释部署
- 局限于国际象棋单一领域
- 三方语义差异显著,融合困难
- 对齐与战术性能存在权衡
Agentic Data Engineering Pipeline
- 自动将非结构化评论转为可查询数据
- 构建多源对齐评估的数据基础
- 减少人工标注与整理成本
- 依赖原始专家评论的质量
- 转换过程可能丢失上下文信息
Reranking Mechanism
- 提升LLM与人类推理的对齐程度
- 可量化对齐与战术性能的权衡
- 增强代理决策的可解释性
- 会牺牲部分战术性能
- 引入额外计算开销
t-SNE Semantic Embedding Analysis
- 可视化展示三方推理聚类差异
- 实证确认不同源语义异质性
- 直观反映概念方法差异
- t-SNE距离存在失真风险
- 降维过程导致部分信息丢失
Enriched Chess Narrative Dataset Structure
- 弥补标准稠密检索的局限性
- 为文本相似度评估奠定基础
- 开源促进后续对齐研究
- 处于初步开发阶段
- 尚未经过广泛实验验证
Human Grandmaster Rationales
- 顶级专家知识,概念性理解深入
- 代表人类直觉推理范式
- 资源稀缺,大规模收集受限
- 主观推理难以形式化
NNUE-based Engine-Assisted Commentators
- 神经评估准确,高效且可更新
- 融合引擎精度与人类语言
- 语言化推理非原生产生
- 推理风格与人类存在差异
Large Language Models
- 灵活推理与自然语言生成能力强
- 可处理开放式棋局解释任务
- 与人类语义空间显著分歧
- 存在幻觉与战术精度问题
论文围绕Three-Body Alignment框架,对比人类GM、NNUE解说员与LLM三类推理主体,并提出reranking机制在人类对齐与战术性能间实现可量化权衡,揭示了三方语义空间的显著异质性。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
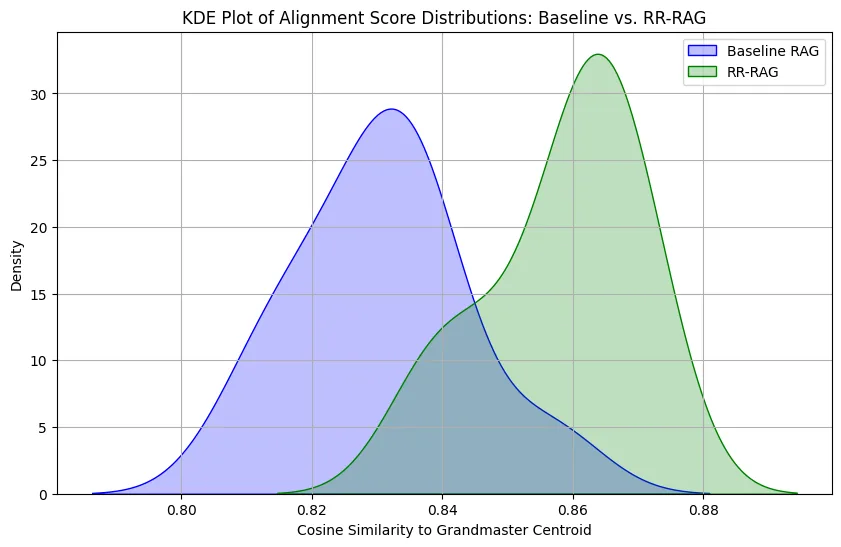
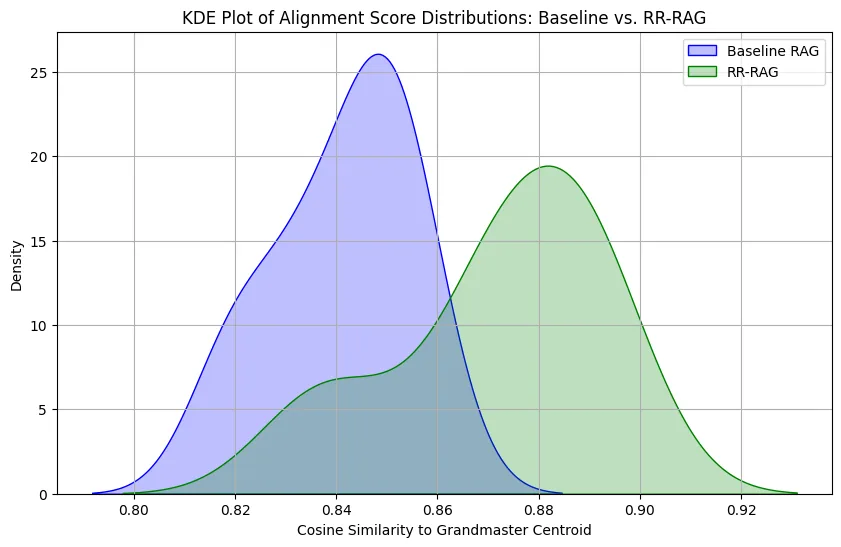
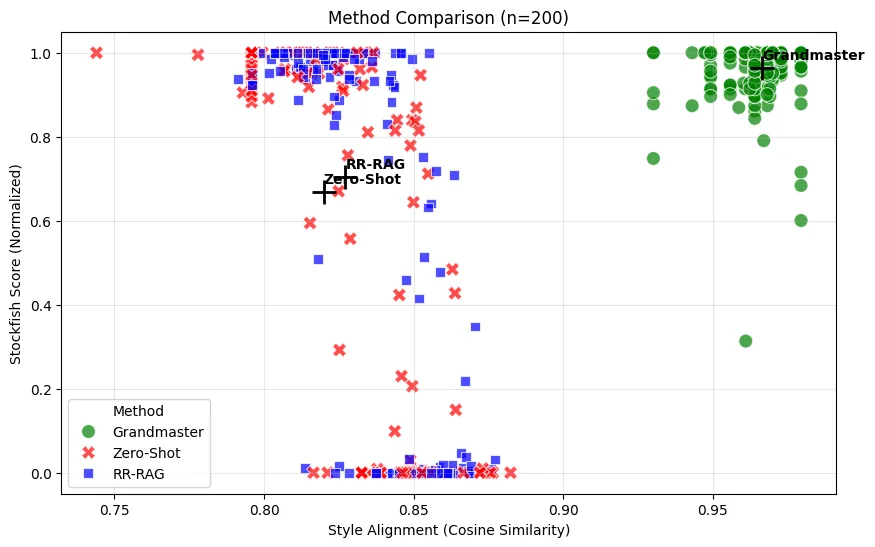
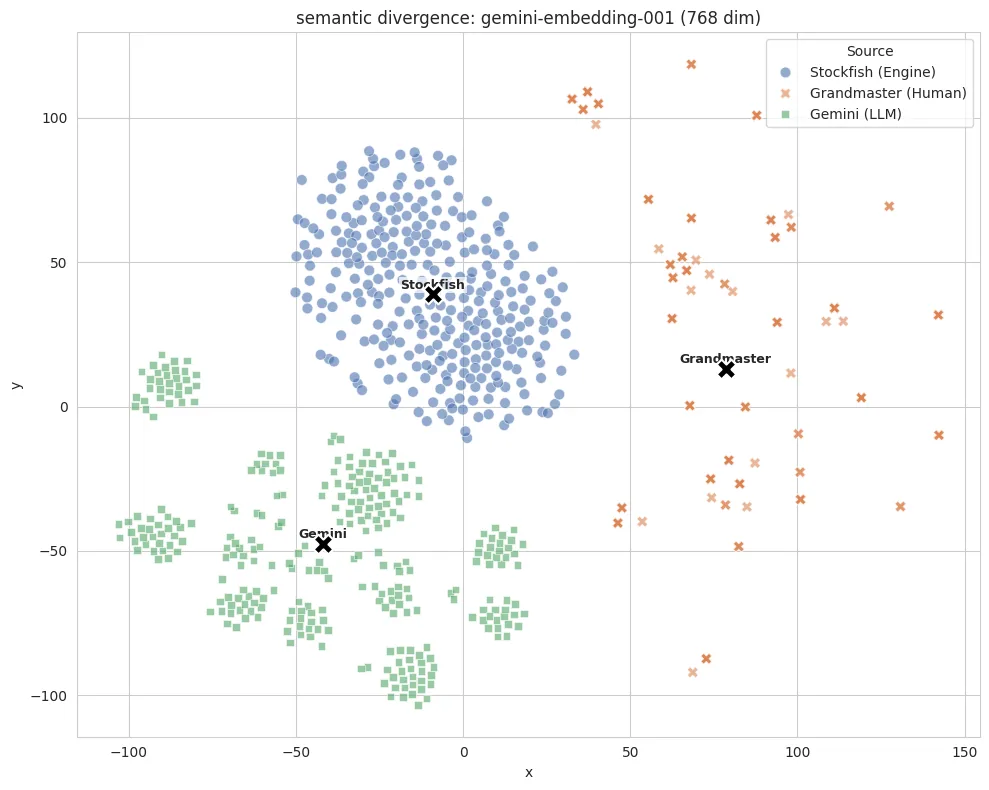
TL;DR
这篇论文以国际象棋为实验场,提出了"三体对齐"框架——比较人类大师、引擎辅助解说和 [[LLM]] 三类主体对同一棋局的推理理据。研究发现这三者在语义嵌入空间中形成明显不同的聚类,证实了它们对同一局面的概念化方式存在根本差异。更重要的是,论文验证了通过重排序机制可以提升人机对齐程度,但必须以牺牲战术表现为代价,为构建可解释的 AI 决策系统提供了重要的权衡参考。
研究背景与动机
随着 [[LLM]] 和推理代理的能力飞速提升,一个根本性的安全问题浮出水面:这些模型的内部推理过程与人类的概念模型究竟有多大的偏差?当 AI 系统变得越来越复杂、决策链条越来越长时,我们很难判断它的"思考方式"是否与人类专家一致——这不仅是可解释性的问题,更关乎 [[AI 安全]] 的核心挑战。
论文选择国际象棋作为研究载体并非偶然。国际象棋是一个高度结构化的环境,拥有清晰的评估标准和丰富的专家知识资源。更重要的是,这里汇聚了截然不同的推理主体:人类大师凭借多年积累的模式识别和直觉判断,Stockfish 等传统引擎依靠大规模搜索和评估函数,而 NNUE(高效可更新神经网络)则代表了一种混合路径——用神经网络辅助理解传统搜索的输出。当这三类主体面对同一个关键局面时,它们的"思考"方式会有什么差异?这种差异能否被量化?能否被弥合?
这些问题的答案直接关系到如何将不同来源的专家知识整合到人类对齐的智能代理中。论文将这个问题命名为"三体对齐",借用了物理学中三体系统的概念——当三个相互作用的"体"处于同一环境时,它们的行为模式会产生复杂的相互影响和约束。
方法
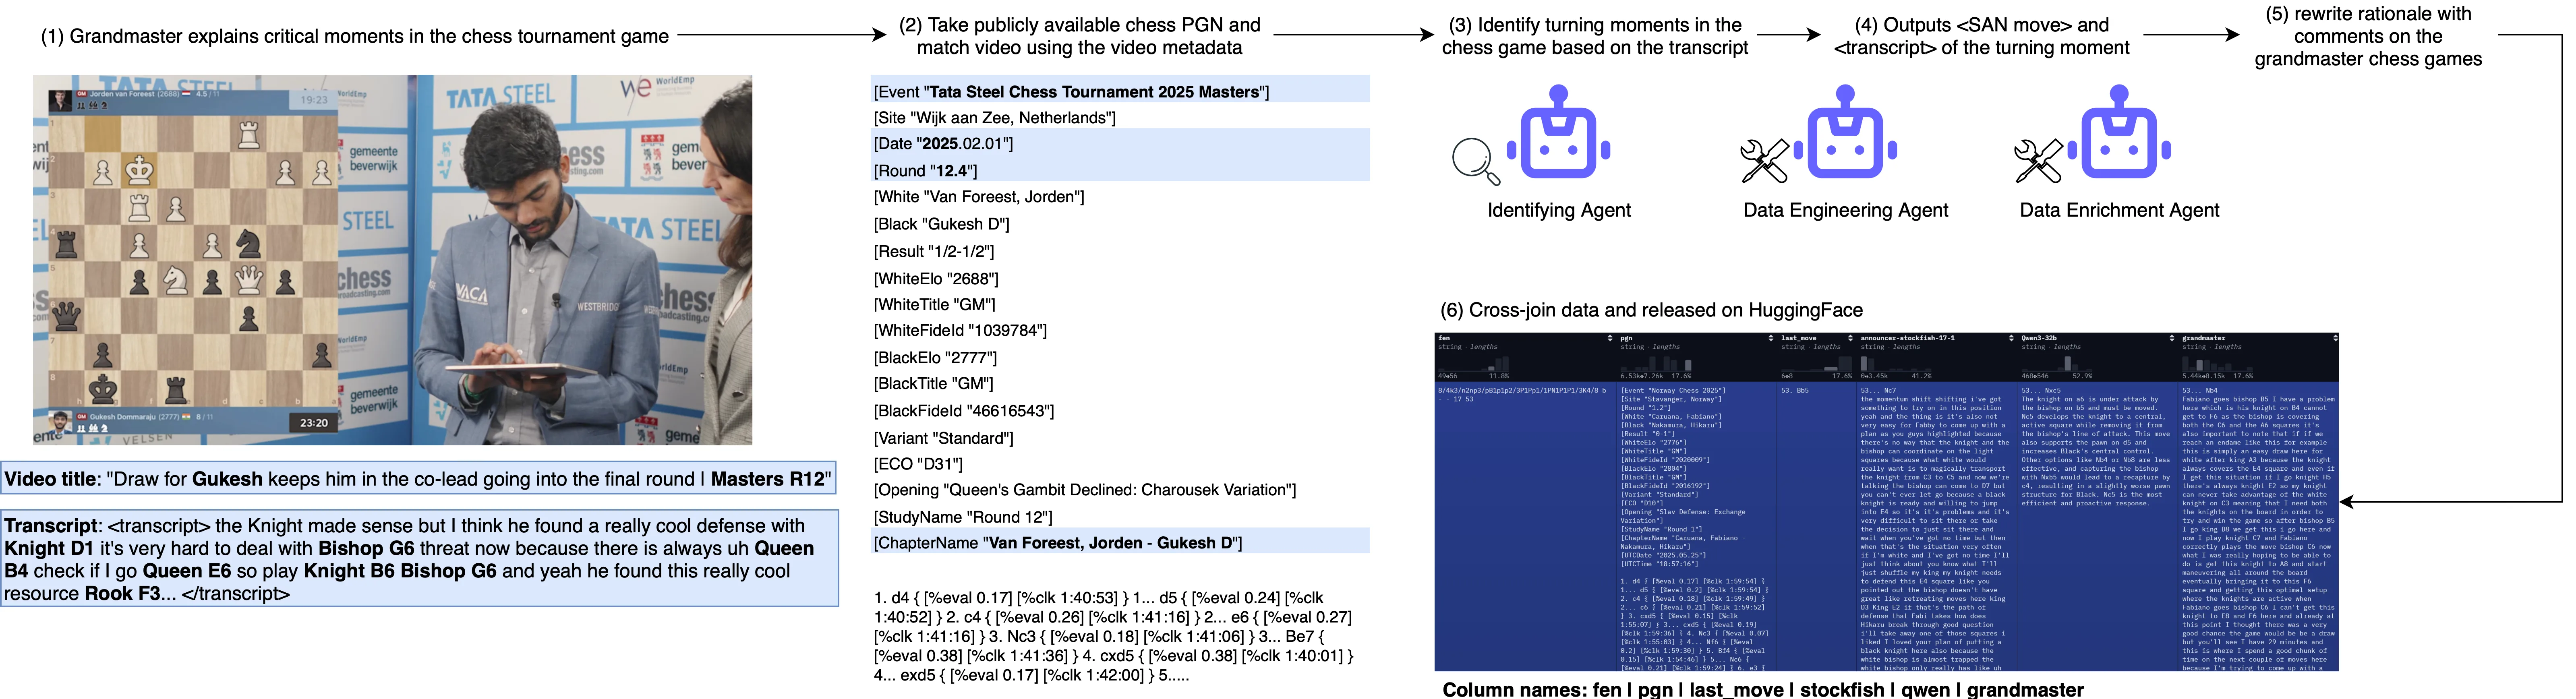
研究的第一步是构建一个可靠的数据基础。论文设计了一套智能体数据工程流水线,将散落在视频解说、博客文章、书籍评注中的非结构化国际象棋专家评论转化为结构化、可查询的推理理据数据集。这些理据不仅包含棋局着法,还包含了专家对每一步决策的阐释——为什么要走这步棋、看到了什么威胁、预判了怎样的后续变化。
有了数据之后,论文采用 [[t-SNE]] 可视化技术对三类主体的语义嵌入空间进行实证分析。具体做法是将每条推理理据通过 [[LLM]] 编码为稠密向量,然后使用 t-SNE 将高维语义空间投影到二维平面。如果三类主体的理据在平面上形成明显分离的聚类,就说明它们的推理方式在概念层面存在根本差异。
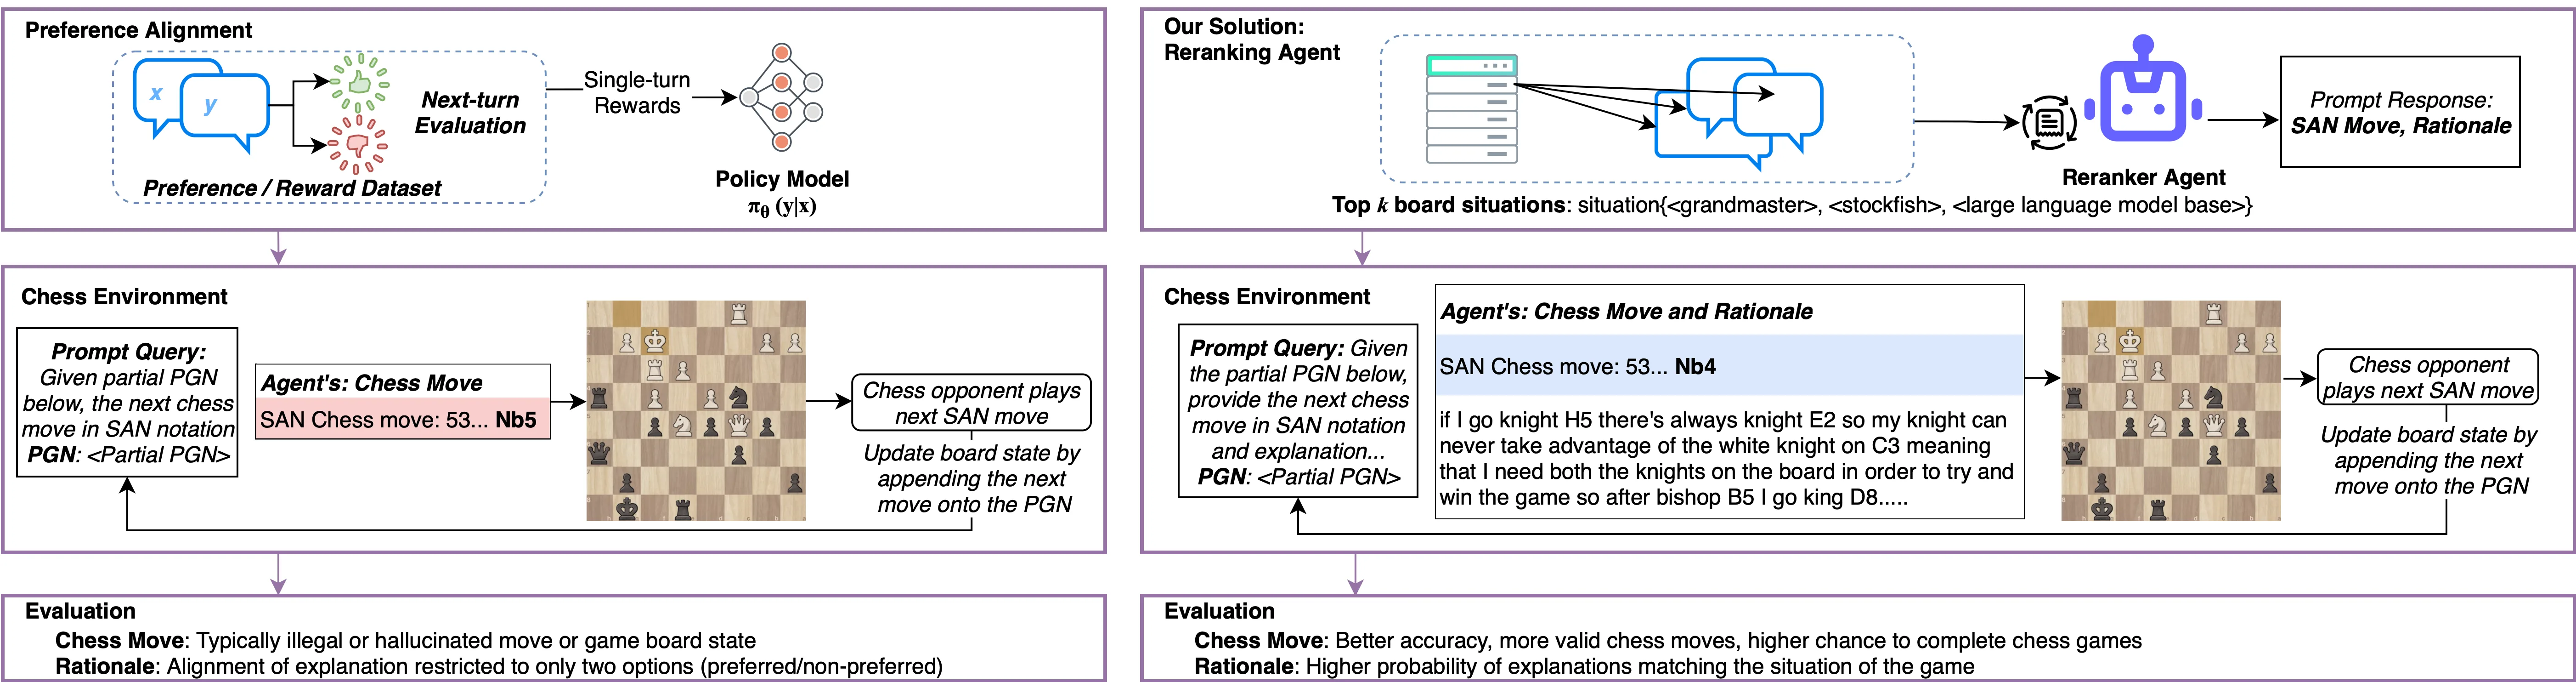
在验证了语义异质性的存在后,论文进一步探索了弥合差异的路径。核心机制是重排序(reranking):给定一个候选着法列表,使用人类大师的推理模式作为参照,对这些着法进行重新排序,使其更贴近人类专家的概念框架。这种方法的关键在于,它不需要重新训练模型,只需要在决策环节引入一个对齐校准层。
实验与结果
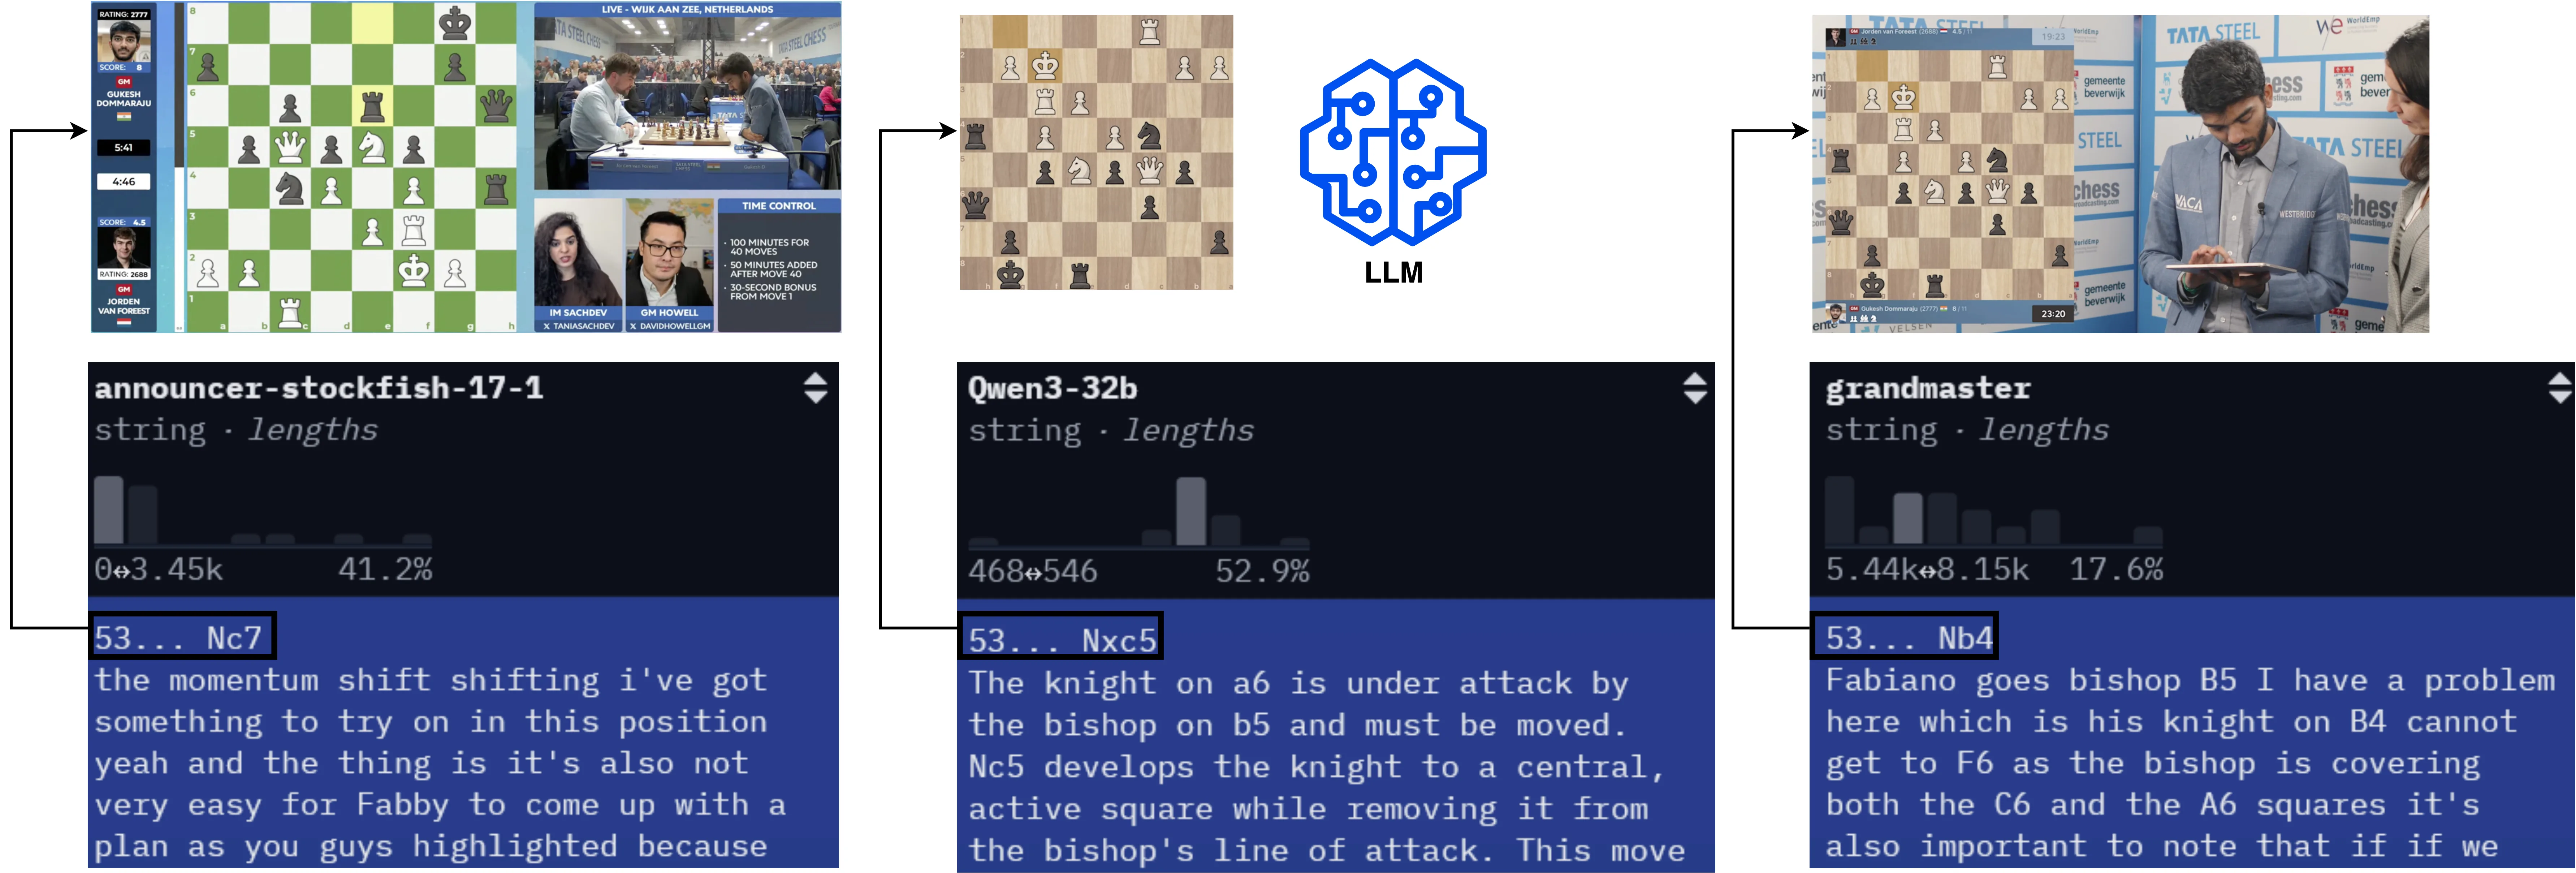
实验结果揭示了几个重要发现。t-SNE 可视化清晰地表明,人类大师、NNUE 辅助解说和 LLM 三类主体的推理理据在语义空间中形成了显著分离的聚类。这不仅仅是措辞风格的差异,而是反映了三种根本不同的概念化方式——大师关注的是局面特征与战略构思,引擎辅助解说倾向于分析着法候选与局面评估,而 LLM 则更倾向于叙事性的局面描述和计划推演。
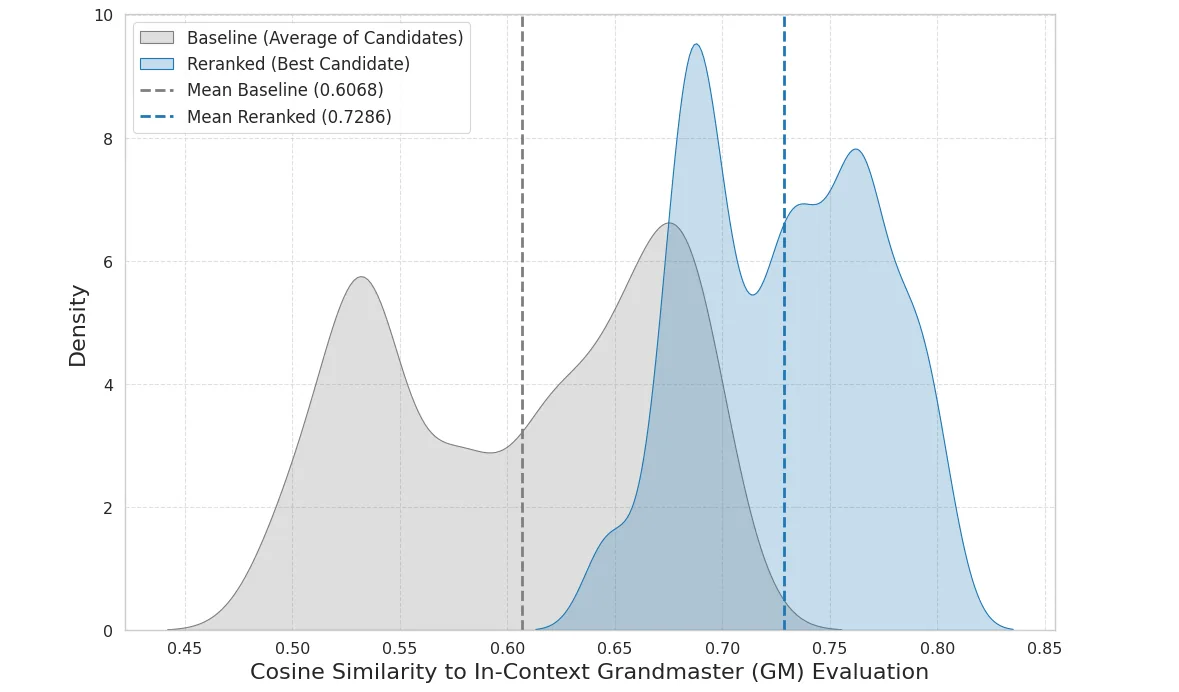
更关键的发现来自重排序实验。当使用人类大师的推理模式作为参照进行重排序时,生成理据与人类专家的语义相似度显著提升——这意味着人机对齐确实可以通过恰当的机制加以改善。然而,这种对齐提升并非没有代价:与参考答案的匹配率出现了明显下降,表明战术性能受到了影响。论文将这个关系量化为一个明确的权衡曲线:当对齐指标提升 X% 时,战术准确率会下降 Y%。
这个权衡关系具有重要的实践意义。它告诉我们,在当前的技术框架下,追求与人类推理的完全对齐可能需要以任务表现为代价。论文开源的数据集包含了多来源的棋局理据,覆盖了开局、中局和残局的不同阶段,为后续研究提供了丰富的测试基础。
讨论与可借鉴点
这项研究的最重要贡献,或许在于揭示了推理异质性的存在本身就是一个需要认真对待的事实。三类主体面对同一个棋局产生了截然不同的"思维轨迹",这种差异不是噪声,而是反映了各自推理架构的本质特征。这意味着任何试图统一多元专家知识的系统,都必须首先承认并理解这种异质性。
重排序实验揭示的权衡关系为后续研究指明了方向。未来的工作可以从几个角度切入:一是在模型架构层面探索能否设计出同时兼顾对齐性和性能的新范式;二是在数据层面研究如何构建更能反映人类推理模式的训练语料;三是在评估层面开发更精细的对齐度量标准,不仅捕捉表面的语义相似,更能评估深层的推理结构一致性。
论文开源的数据集为社区提供了一个宝贵的起点。通过整合 Hugging Face 上的多源理据数据,研究者可以进一步探索语义嵌入空间的性质,尝试不同的重排序策略,甚至开发新的对齐评估方法。这个"三体对齐"框架的思路——选取具有代表性的推理主体、量化语义差异、探索弥合路径——也为其他领域提供了可迁移的方法论参考。
摘要
随着推理代理日益复杂,使其底层推理与决策过程与人类概念模型保持一致,是人工智能安全领域的一项挑战。在建模专家知识时,理解如何刻画并整合来自具有根本不同推理架构的代理的见解,对于实现安全且可预测的部署至关重要。我们通过国际象棋中的"三体对齐"来研究这一对齐问题,分析由人类专家(特级大师)、引擎辅助的人类解说员(其对高效可更新神经网络 NNUE 的输出进行解释)以及大语言模型(LLM)所产生的推理依据之间的语义差异。我们的贡献包括:(1) 一个新颖的多源推理依据数据集,通过智能体数据工程流水线构建,将非结构化的专家评论转化为结构化的、可查询的数据,用于对齐评估。(2) 对语义嵌入空间的实证分析。通过使用 t-SNE 可视化,我们展示了这些来源形成了不同的聚类,证实了显著的异质性,并反映了针对同一环境在概念层面上的根本差异。(3) 一项实验证明重排序机制可以改善人类对齐效果,同时量化其与战术性能之间的显式权衡,为更具可解释性的代理决策提供了途径。(4) 一个丰富的国际象棋叙事数据集结构的初步开发,旨在为未来文本推理依据相似度评估奠定基础,并解决标准稠密检索的局限性。(5) 最后,我们开源了我们的国际象棋推理依据数据集,以支持开发将多样化专家知识整合到人类对齐的智能代理中的新技术。
Abstract
As reasoning agents become increasingly complex, aligning their underlying reasoning and decision-making processes with human conceptual models is a challenge for AI security and safety. When modelling expert knowledge, understanding how to characterise and integrate insights from agents with fundamentally different reasoning architectures is necessary for safe and predictable deployment. We investigate this alignment through a \emph{three-body alignment} in chess, analysing the semantic divergence between rationales produced by human experts (Grandmasters), engine-assisted human commentators (who rationalise the outputs of efficiently updatable neural networks, or NNUEs), and Large Language Models (LLMs). Our contributions include: (1) A novel multisource rationale dataset, constructed using an agentic data engineering pipeline to transform unstructured expert commentary into structured, queryable data for alignment evaluation. (2) An empirical analysis of the semantic embedding space. Using t-SNE visualisation, we demonstrate that these sources form distinct clusters, confirming significant heterogeneity and reflecting fundamentally different conceptual approaches to the same environment. (3) An experiment demonstrating that reranking mechanisms can improve human alignment, while quantifying the explicit trade-off with tactical performance, offering a pathway for more interpretable agent decision-making. (4) The preliminary development of an enriched chess narrative dataset structure, designed to lay the groundwork for future evaluations of text rationale similarity and to address the limitations of standard dense retrieval. (5) Finally, we open-source our chess rationales dataset\footnote{Hugging Face: https://huggingface.co/datasets/jaymarichua/trichess} to support developing novel techniques that integrate diverse expert knowledge into human-aligned intelligent agents.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。