
教会大语言模型自我演化:通过强化学习培养核心元技能
Teaching LLMs to Self-Evolve: Cultivating Core Meta-Skills with Reinforcement Learning
📝 TLDR
以AlphaEvolve为代表的测试时自演化方法依赖反思与多轮精炼等元技能,传统后训练未充分培养这些能力。MetaEvolve框架结合演化轨迹数据合成、演化感知强化学习与推理时演化搜索,在代码执行反馈信号下训练模型自演化。实验显示其在7个代码基准分布内任务提升10.01%、分布外提升24.12%,开放式算法优化任务获得46.9%相对改进。表明显式培育自演化元技能为更自主的AI提供了可行路径。
🧭 速览
测试时自演化方法的成功依赖于反思、多轮精炼等元技能,而传统后训练未充分培养这些核心能力。
基于演化轨迹数据合成、演化感知强化学习与推理时演化搜索,以代码执行反馈为可验证奖励训练模型。
7个代码基准分布内提升10.01%、分布外提升24.12%,开放式算法优化任务获得46.9%相对改进。
显式培育自演化元技能可使模型获得可迁移的反思与精炼能力,是迈向更自主AI的可行路径。
🆚 方法对比
MetaEvolve
- 在七个编码基准上超越最强基线,分布内提升10.01%,分布外提升24.12%
- 在开放域算法优化任务上取得46.9%的相对改进
- 基于代码执行的细粒度奖励信号,比数学领域的二元奖励更具学习价值
- 无需人工标注即可端到端规模化训练
- 泛化能力尚需在更多非编码领域验证
- 依赖代码执行环境作为奖励源,迁移到其他领域受限
- 框架包含三个子组件,整体实现复杂度较高
数据合成流水线
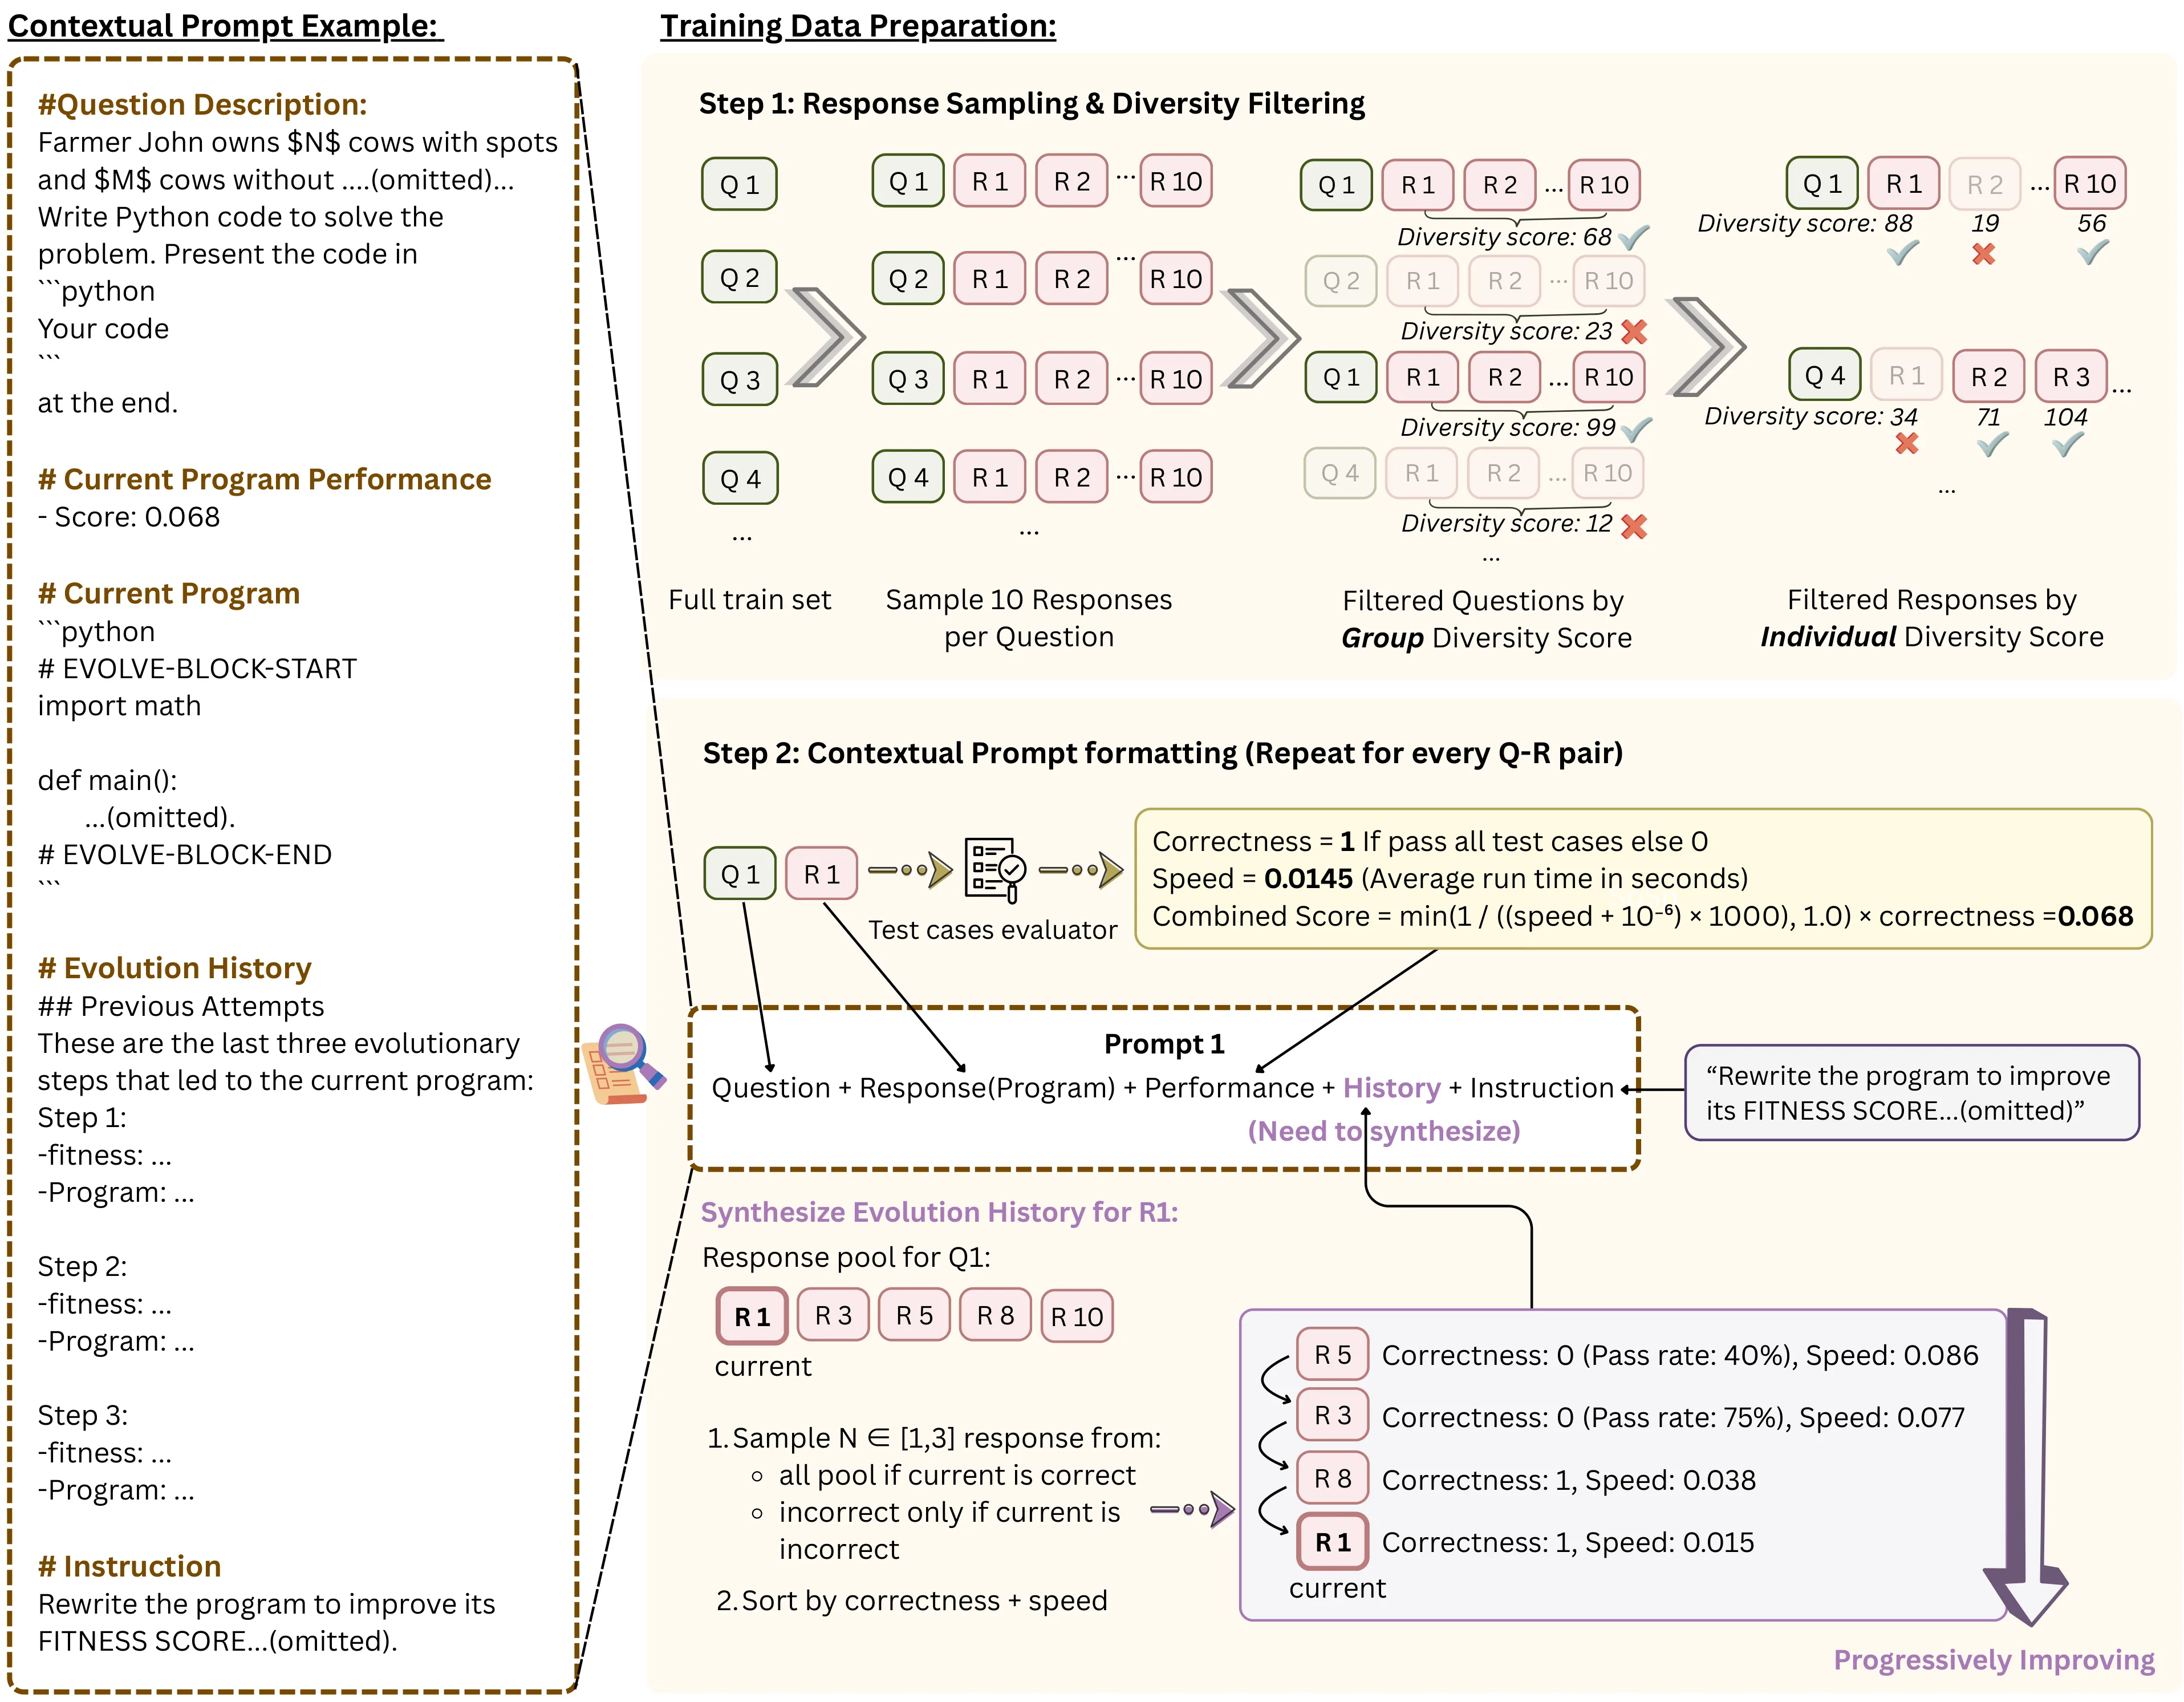
- 合成包含历史尝试的进化轨迹样本,模拟推理时自进化过程
- 基于TACO/APPS/Codeforces等多源数据,问题类型覆盖广泛
- 两阶段多样性过滤保留高信息量的问答对
- 依赖现有编码基准数据集,存在分布偏移风险
- 每题采样10个候选响应,计算开销较大
进化感知强化学习
- 使用可验证奖励自动评估,无需人工标注
- 将迭代优化能力作为显式训练目标而非推理启发式
- 同时激励正确性与运行效率的提升
- 奖励设计仅基于编码领域,跨领域迁移性未知
- RL训练对算力和数据量需求较高
AlphaEvolve
- 展示迭代自进化在测试时扩展中的强大潜力
- 能发现超越人类现有知识的新颖结果
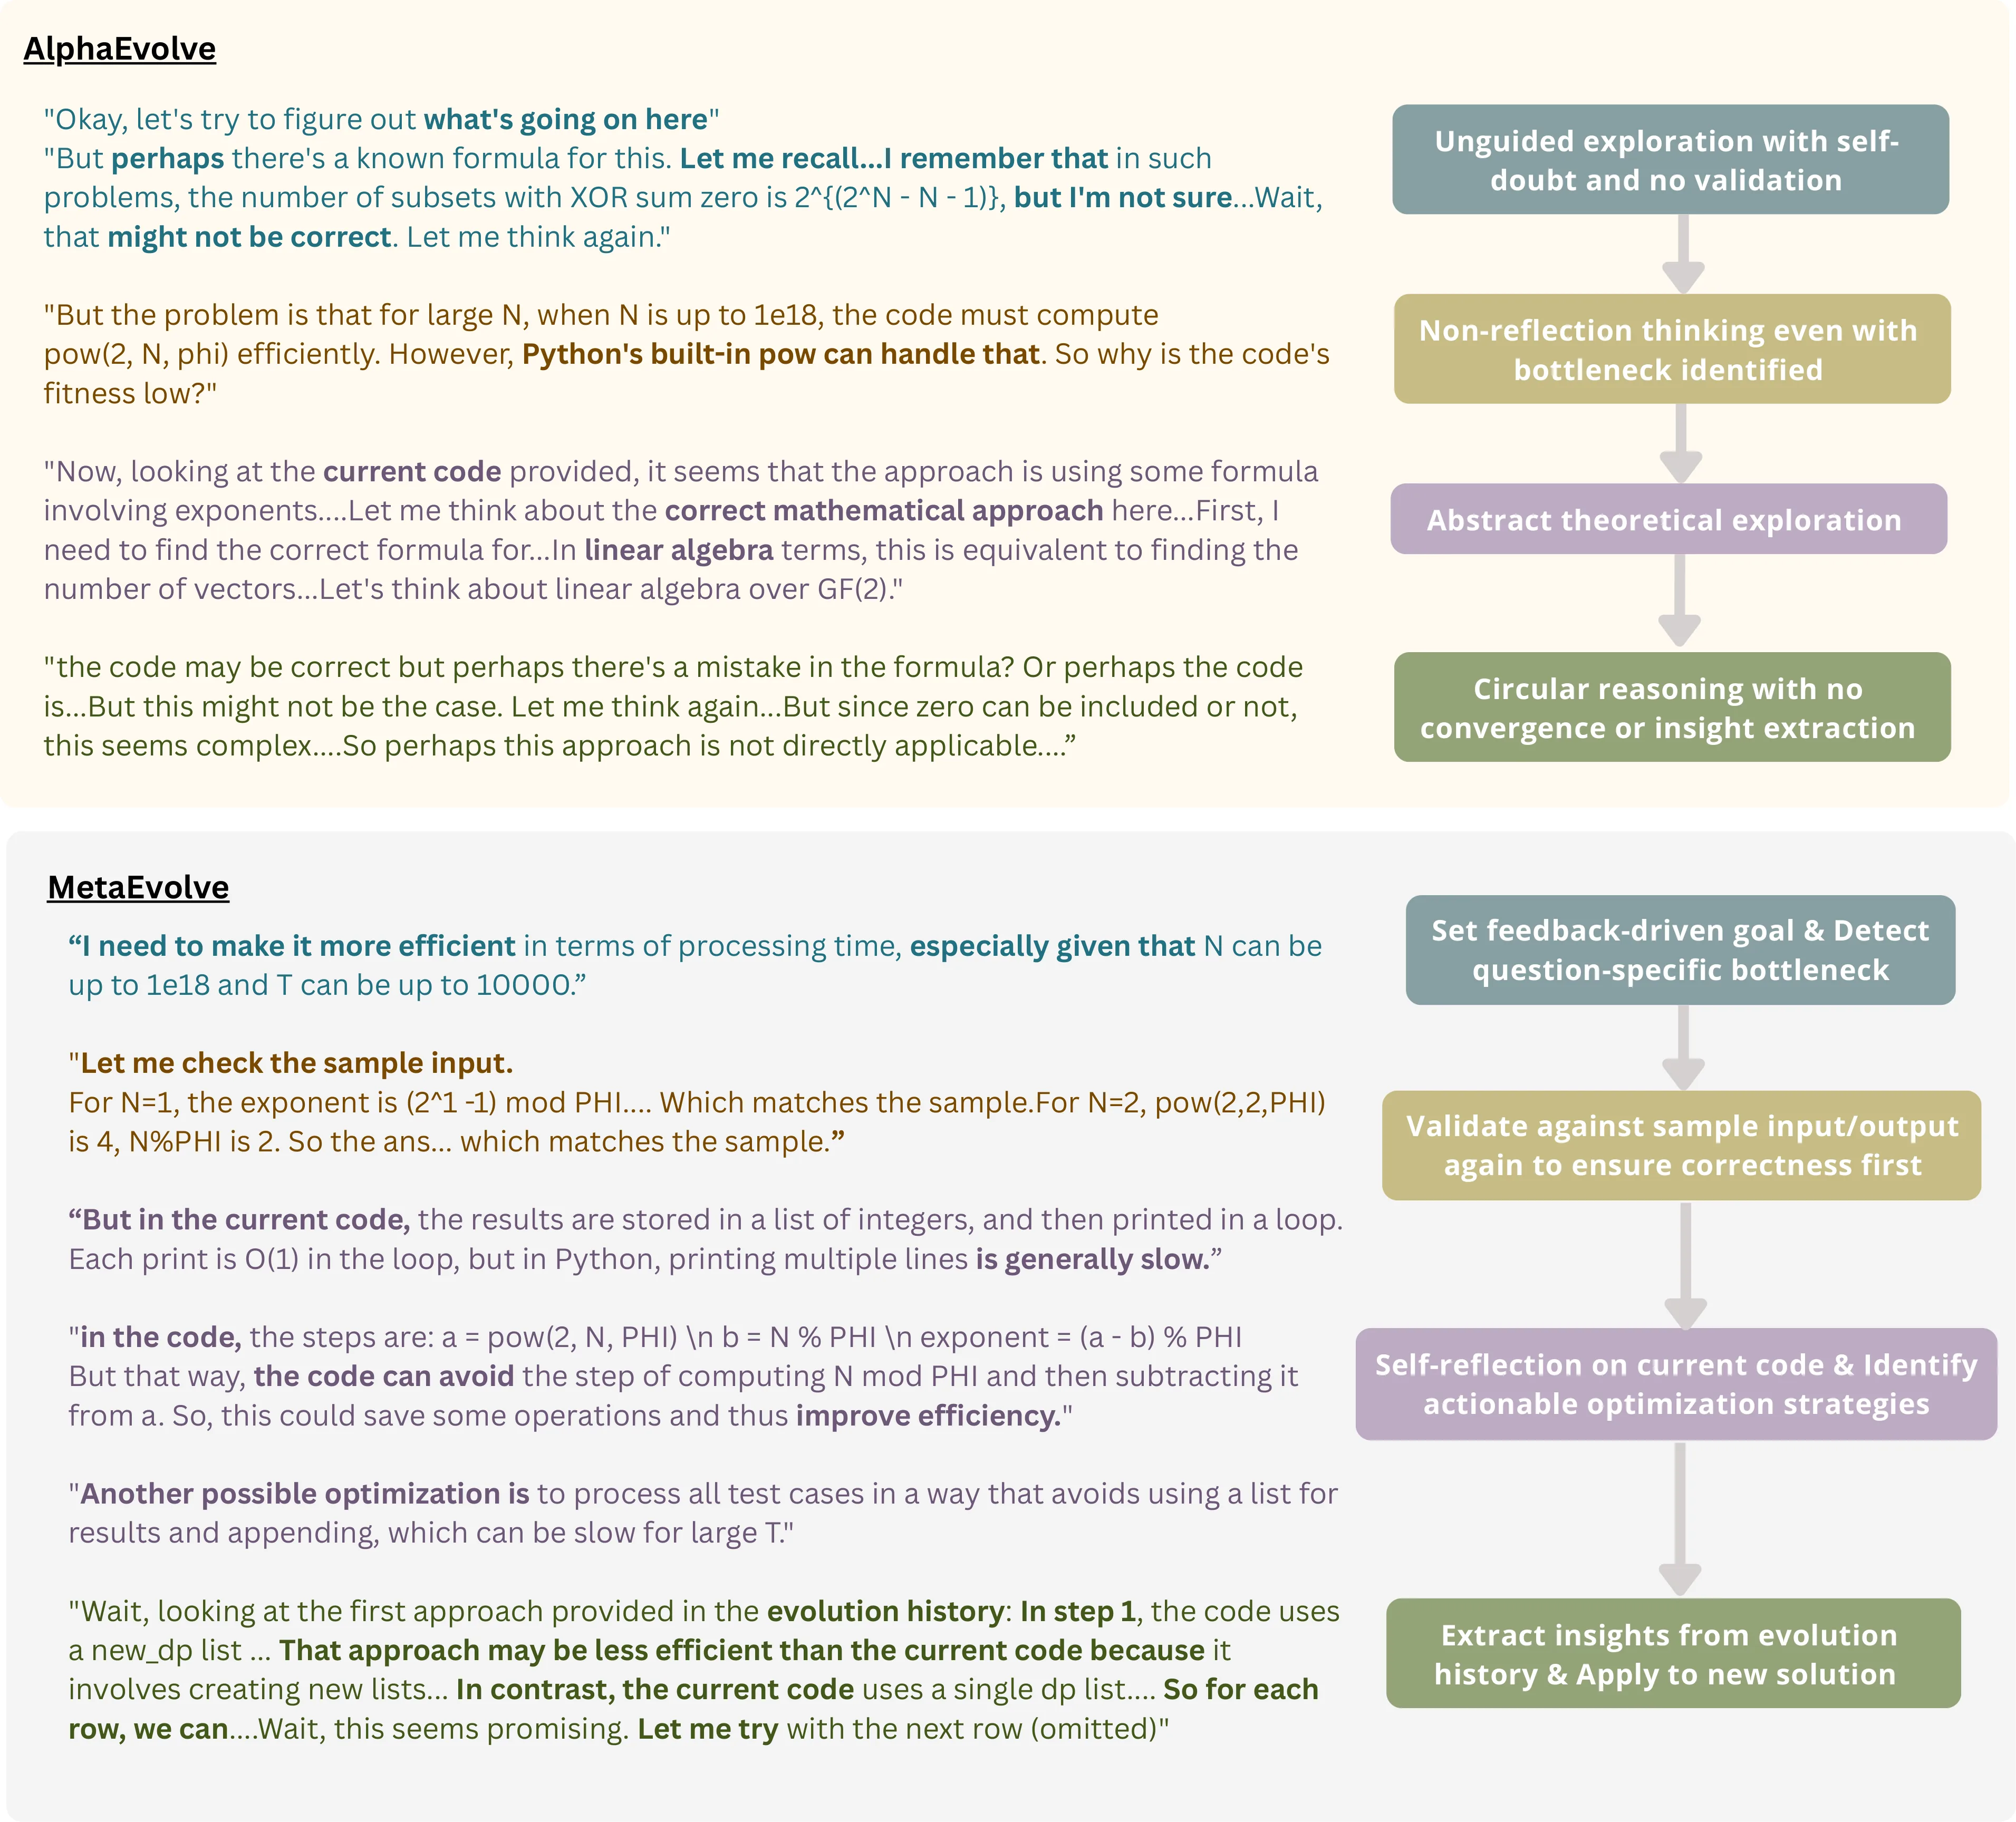
- 缺乏对自进化元技能的显式训练,行为未被定向优化
- 论文中提到其缺少有针对性的自反思行为
传统后训练方法
- 单轮/多轮监督微调实现相对简单,训练成本低
- 在大规模数据上已有成熟的训练流程
- 优化目标为任务完成而非反馈驱动的自进化
- 忽略了元技能作为直接优化目标
本文提出统一框架MetaEvolve,包含数据合成、进化感知RL、推理时进化搜索三个子组件;与AlphaEvolve相比显式训练自进化元技能,与传统后训练相比将迭代优化作为可学习能力而非推理启发式。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 2 张)
展开查看 2 张图
TL;DR
这篇论文提出了一种名为 MetaEvolve 的框架,旨在让大语言模型像 AlphaEvolve 那样具备“自我演化”能力——通过反复反思、环境反馈和多轮精炼来持续提升自身表现。与传统后训练方法不同,MetaEvolve 通过合成演化轨迹数据、设计面向演化的[[强化学习]]训练信号和推理时的演化搜索,专门培养模型的“元技能”。实验表明,经过这种训练的模型在分布内代码任务上提升 10.01%,在完全陌生的分布外任务上提升 24.12%,在开放式算法优化任务上更是取得了 46.9% 的相对提升。研究表明,显式培育自演化元技能是一条通往更自主 AI 的可行路径。
研究背景与动机
近年来,测试时扩展(test-time scaling)范式引起了广泛关注。以 DeepMind 的 AlphaEvolve 为代表的方法展示了这样一种可能性:模型不再仅仅依赖训练时吸收的知识,而是在推理阶段通过迭代自我演化、结合环境反馈不断精炼解决方案,从而取得惊人的性能突破。这类系统的核心在于元技能——例如基于环境反馈的自我反思能力,使得模型能够从每一次尝试中学习、在多轮交互中持续改进。
然而,问题在于传统的大语言模型后训练流程并未充分培养这些能力。标准的后训练方法通常关注单轮响应质量,通过人类偏好数据或静态评测来优化模型输出。这种范式存在两个根本性缺陷:其一,它假设训练信号在模型生成之前就已经完备,无法建模“尝试—反馈—改进”这一循环过程;其二,它倾向于让模型收敛到某种静态最优,而非保持持续演化的能力。正如论文所指出的,元技能在传统训练中被“大规模忽视”,导致模型虽然知识丰富,却缺乏主动改进自身的内驱力。
这一问题的关键瓶颈在于数据。自我演化本质上是一个序贯决策过程:模型需要看到自己在多轮迭代中的进步与失败,从适应度变化中推断何种策略有效、何种策略需要调整。这种演化轨迹数据在自然语言处理数据集中几乎不存在——真实世界的代码提交记录虽然存在,但往往缺乏完整的试错历史和细粒度的执行反馈。论文选择以编程任务为切入点,正是因为程序执行能够提供一种“丰富的自然连续奖励信号”:模型不仅能知道自己对了或错了,还能看到运行时间、内存消耗、边界条件处理等多元维度上的表现差异,从而为元技能的习得提供了肥沃的土壤。
方法
MetaEvolve 的设计围绕三个核心组件展开:演化轨迹数据合成流水线、面向演化的[[强化学习]]训练、以及推理时的演化搜索机制。这三者的协同作用使得模型能够从零开始学习如何自我演化。
演化轨迹数据合成是整个框架的基础。论文构建了一套数据生成流程,针对每个编程问题,模型会生成多个候选解决方案,每个方案都附带完整的执行反馈信息——包括单元测试通过情况、运行时间、代码复杂度等指标。通过对同一问题的多次尝试进行追踪,研究者得以构建出一条“演化轨迹”,记录了模型从最初的粗糙方案逐步精炼到最终解决方案的完整历程。每条轨迹包含当前程序、其适应度分数(综合正确性与效率的多维度评价)、以及历史尝试的记录。这种数据结构的核心价值在于,它将“如何改进”这件事本身变成了可供模型学习的目标。
在获得演化轨迹数据后,论文采用了一种面向演化的[[强化学习]]方法进行训练。传统的 RLHF(基于人类反馈的强化学习)优化的是单轮响应的质量,而 MetaEvolve 的训练目标则是让模型学会“从适应度变化中推断有效策略”。具体而言,模型在训练时接收当前的代码片段和其适应度分数,然后被要求生成改进版本。奖励信号直接来自测试用例的执行结果——一个代码片段能否通过更多测试、是否更高效,都直接转化为训练信号。这种设计的精妙之处在于,它让模型不仅学习如何解决特定问题,更学习了一种可迁移的元策略:当面对新的挑战时,模型知道如何分析当前状态的不足、从历史尝试中提取经验、探索可能的改进方向。
第三个组件是推理时的演化搜索。在部署阶段,MetaEvolve 并非简单地让模型输出一个答案然后结束,而是启动一个迭代演化的循环:模型生成多个候选解,评估它们的适应度,基于反馈选择有前景的方向继续探索,然后重复这一过程。这本质上是一个在解空间中的定向搜索,而前面两个组件——演化轨迹预训练和演化感知 RL——为这个搜索提供了强大的初始化策略和高效的探索启发。
值得强调的是,这种设计选择的动机源于对“直觉做法”的超越。如果只是让模型在推理时随机尝试多次然后选择最优结果,这固然是一种搜索策略,但效率极低且泛化能力差。MetaEvolve 的关键洞察在于:模型应该内化一种“元技能”,使其能够根据执行反馈推断改进方向,而非机械地枚举候选方案。这种能力一旦习得,就能跨越具体任务迁移到全新的问题领域,这正是论文所强调的“领域无关”泛化特性。
实验与结果
论文在七个编程基准测试上进行了全面评估,涵盖了从标准算法题到真实世界代码修复的多样化任务。评估策略被分为三个层次:分布内任务(与训练数据同分布)、分布外任务(训练时见过的任务类型但具体实例不同)、以及完全超出训练领域的开放式算法优化问题。
在分布内任务上,MetaEvolve 相比最强的基线方法取得了 10.01% 的绝对提升。这一结果本身并不令人意外——专门针对某类任务进行强化学习训练通常能带来提升。但真正值得关注的数字出现在更严格的评估设置中。在分布外任务上,MetaEvolve 相比基线实现了 24.12% 的提升,这意味着经过演化轨迹预训练的模型学到的并非针对特定问题的记忆,而是一种可迁移的改进策略——当面对训练时从未见过的具体问题时,模型仍然能够有效地进行自我精炼。
最引人注目的结果出现在开放式算法优化任务上。这类任务的特点是:没有标准答案,需要模型在正确性、效率、优雅性等多个维度上持续迭代改进。MetaEvolve 在这些任务上实现了 46.9% 的相对改进,幅度远超其他评估场景。这一结果有力地验证了论文的核心假设:显式培养元技能确实能够解锁在开放式问题上的自主演化能力,而这些正是传统训练范式最难触及的领域。
消融实验进一步揭示了各组件的贡献。单独使用演化轨迹数据而不进行演化感知 RL 训练,只能带来有限提升;而没有推理时演化搜索的情况下,模型的表现在需要深度探索的任务上显著下降。三者的协同作用——预训练提供基础能力、RL 微调塑造元策略、推理搜索激活显式演化——共同构成了完整的自演化pipeline。
讨论与可借鉴点
MetaEvolve 的工作为如何培养 AI 系统的自主演化能力提供了一个有原则的框架,同时也留下了值得深思的问题。
最明显的局限在于当前方法对编程任务的依赖。虽然代码执行提供了丰富的连续奖励信号,但并非所有领域都能获得类似的反馈——比如开放式写作、数学证明、或创意设计等任务,往往缺乏可量化的中间反馈机制。论文也坦承,将这套框架迁移到这些“信号贫瘠”的领域需要额外的研究探索,例如设计合理的代理指标或利用人类偏好作为弱反馈来源。
另一个开放问题是演化轨迹数据的质量和多样性。当前数据合成流程在很大程度上受限于模型本身的生成能力——如果基础模型在某些任务上本身就表现不佳,它生成的演化轨迹也会充满低质量的尝试。如何在缺乏强基线模型的领域构建有意义的演化数据,仍然是一个待解决的问题。
尽管存在这些局限,MetaEvolve 的核心洞察具有超越具体实现的启发价值。它揭示了“学会学习”(learning to learn)这一元认知能力在构建更强大 AI 系统中的关键作用。传统观点认为,只要模型足够大、训练数据足够丰富,涌现能力就会自然出现;而这项工作表明,特定能力的培育可能需要针对性的训练信号设计,而非单纯依靠规模效应。对于后续研究而言,这种“元技能工程化”的思路——明确识别成功完成某类任务所需的底层能力,然后设计专门的数据和训练流程来培养它们——或许是一条比单纯扩大模型规模更具效率的路径。
摘要
通过迭代自我演化并结合环境反馈实现的测试时扩展(如 AlphaEvolve 所展示的)取得了显著的性能提升。我们假设,此类演化框架的成功依赖于元技能——例如结合环境反馈的自我反思——这些技能能够支持有效的多轮精炼,但在传统的训练后阶段却往往被忽视。为填补这一空白,我们提出了 MetaEvolve 框架,旨在通过数据合成流水线、面向演化的强化学习(RL)以及推理时的演化搜索来培养这些元技能。具体而言,我们将 MetaEvolve 建立在编程任务之上,因为程序执行能够提供超出二元正确性判断的、丰富的自然连续奖励信号。基于这些信号,我们合成演化轨迹作为训练数据,每条轨迹包含当前程序、其适应度分数(综合正确性与效率)以及历史尝试记录,并通过基于测试用例执行所得可验证奖励的强化学习对模型进行训练。通过在大规模代码数据上进行训练,我们期望激发可泛化的、与领域无关的元技能,使其能够广泛迁移至开放式问题——此类任务中丰富的训练信号通常十分稀缺。在七个编程基准测试中,MetaEvolve 在分布内任务上相较最强基线取得了 10.01% 的绝对提升,在分布外任务上取得了 24.12% 的提升。在完全超出训练领域的开放式算法优化问题上,它进一步实现了 46.9% 的相对改进。这些结果表明,显式地培养自我演化元技能为构建更强大、能够自主演化的智能体提供了一条富有原则的路径。
Abstract
Test-time scaling through iterative self-evolution with environment feedback, as demonstrated by AlphaEvolve, shows remarkable performance gains. We hypothesize that the success of such evolution frameworks hinges on meta-skills, such as self-reflection with environment feedback, that enable effective multi-round refinement, yet are largely neglected by traditional post-training. To bridge this gap, we present MetaEvolve, a framework designed to develop these meta-skills via a data synthesis pipeline, evolution-aware reinforcement learning (RL), and inference-time evolutionary search. Concretely, we ground MetaEvolve in coding, where program execution provides natural, continuous reward signals beyond binary correctness. Building on these signals, we synthesize evolution trajectories as training data, each containing a current program, its fitness score (combining correctness and efficiency), and a history of prior attempts, and train the model via RL with verifiable rewards derived from test case execution. By training on large-scale code data, we aim to inspire generalizable domain-agnostic meta-skills that can transfer broadly to open-ended problems where such rich training signals are scarce. Across seven coding benchmarks, MetaEvolve outperforms the strongest baseline by 10.01% absolute on in-distribution tasks and 24.12% on out-of-distribution tasks. On open-ended algorithm optimization problems entirely outside the training domain, it further achieves a 46.9% relative improvement. These results demonstrate that explicitly cultivating self-evolution meta-skills offers a principled path toward more capable and autonomously self-evolving AI.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。