
基于深度强化学习的蛇形机器人在动态粘性环境中的自适应波动运动
Adaptive Undulatory Locomotion of Snake-like Robots in Dynamic Viscous Environments via Deep Reinforcement Learning
📝 TLDR
针对蛇形机器人在黏度动态变化流体环境中的运动控制难题,由于缺少直接流场传感器,传统模型方法难以适应。本文将其构建为部分可观测马尔可夫决策过程,并采用非对称 actor-critic 框架:仿真中以特权信息训练教师策略,再向仅依赖本体感知的学策略蒸馏知识。仿真结果显示,在 10⁻⁷ 至 10⁻² m²/s 黏度区间内,DRL 学到的非正弦自适应步态有效提升推进速度与传输效率,超越了经典正弦与运动学控制的固有性能上限。
🧭 速览
蛇形机器人在动态黏度流体中缺乏直接流体感知,经典正弦与运动学控制在可变流体动力学下存在固有性能限制。
将任务建模为部分可观测 MDP,采用非对称 actor-critic,由特权信息教师策略向仅依赖本体感知的学策略蒸馏知识。
在 10⁻⁷–10⁻² m²/s 黏度范围内,DRL 学到的非正弦步态提升推进速度与传输效率,突破经典控制性能上限。
通过特权信息蒸馏实现隐式环境推断,可有效绕开经典模型在不可预测流体下的限制。
🆚 方法对比
Asymmetric Actor-Critic with Privileged Information Distillation
- 教师策略利用特权信息训练,性能上限高
- 学生策略仅依赖本体感知,适合实际部署
- 覆盖10⁻⁷至10⁻² m²/s宽粘度范围
- 自主生成非正弦自适应步态,突破经典方法极限
- 教师策略依赖仿真器特权信息,迁移到真实环境有差距
- 蒸馏过程可能损失部分特权信息优势
- 非正弦步态可解释性较差
- 训练需要大量仿真计算资源
POMDP Problem Formulation
- 准确建模流体环境下不可观测的流体属性
- 匹配蛇形机器人缺乏流体传感器的实际约束
- 为隐式环境推断提供理论框架
- 将速度估计的循环依赖问题形式化
- 部分可观测导致策略学习难度增加
- 隐藏状态空间增大,样本效率降低
- 需要专门的不对称架构解决
- 奖励信号设计需要间接指标
Serpenoid Curve / Sinusoidal Control
- 数学表达简洁,关节控制易于实现
- 在特定流体环境下设计高效推进运动
- 计算开销低,适合实时控制
- 作为经典基准方法有明确性能参考
- 波形预定义,无法灵活适应流体变化
- 在未知或时变粘度环境下性能退化
- 本质上受限于周期性正弦框架
- 无法覆盖连续变化的未知环境参数
CPG (Central Pattern Generator)
- 模仿生物神经系统,具有节律稳定性
- 对外部扰动可维持稳定运动节奏
- 无需复杂建模即可生成基础波形
- 硬件实现相对成熟
- 环境大幅变化时需要复杂参数调优
- 生成波形仍受限于特定周期函数
- 难以灵活应对未知流体环境变化
- 参数调优依赖经验,难以自动化
DRL + CPG Hybrid
- 结合了DRL的自适应性与CPG的稳定性
- 同时追求步态稳定性与适应性
- 比纯CPG方法具有更强的环境适应性
- 利用DRL优化复杂的CPG参数
- 仍依赖周期性的CPG固定波形模板
- 在未知环境中灵活性受限
- CPG结构本身限制了波形自由度
- 比纯端到端DRL方法多了一层复杂度
Symmetric DRL (Baseline)
- 架构简单,无需教师-学生分离
- 训练流程标准化,易于实现
- 作为对比基线可凸显特权信息的价值
- 无需仿真器特权信息
- 无法利用特权信息,性能受限
- 在部分可观测任务中难以学习有效策略
- 证明标准方法在此任务上的不足
- 本体感知信息不足以推断流体属性
Model-based Control (Navier-Stokes)
- 基于精确流体力学建模,理论最优
- 可深入理解流体-机器人交互机理
- 在已知环境下预测准确性高
- 提供可解释的控制策略
- Navier-Stokes方程实时计算不可行
- 对未建模扰动和参数变化敏感
- 建模复杂度高,需要精确流体参数
- 难以应对未知和时变的流体环境
论文对比了经典正弦控制、CPG、DRL+CPG混合、对称DRL基线及作者提出的不对称特权信息蒸馏DRL方法,证明不对称DRL框架在宽粘度范围内自主学习非正弦步态,显著超越传统周期波形方法的性能极限。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 11 张)
展开查看 11 张图
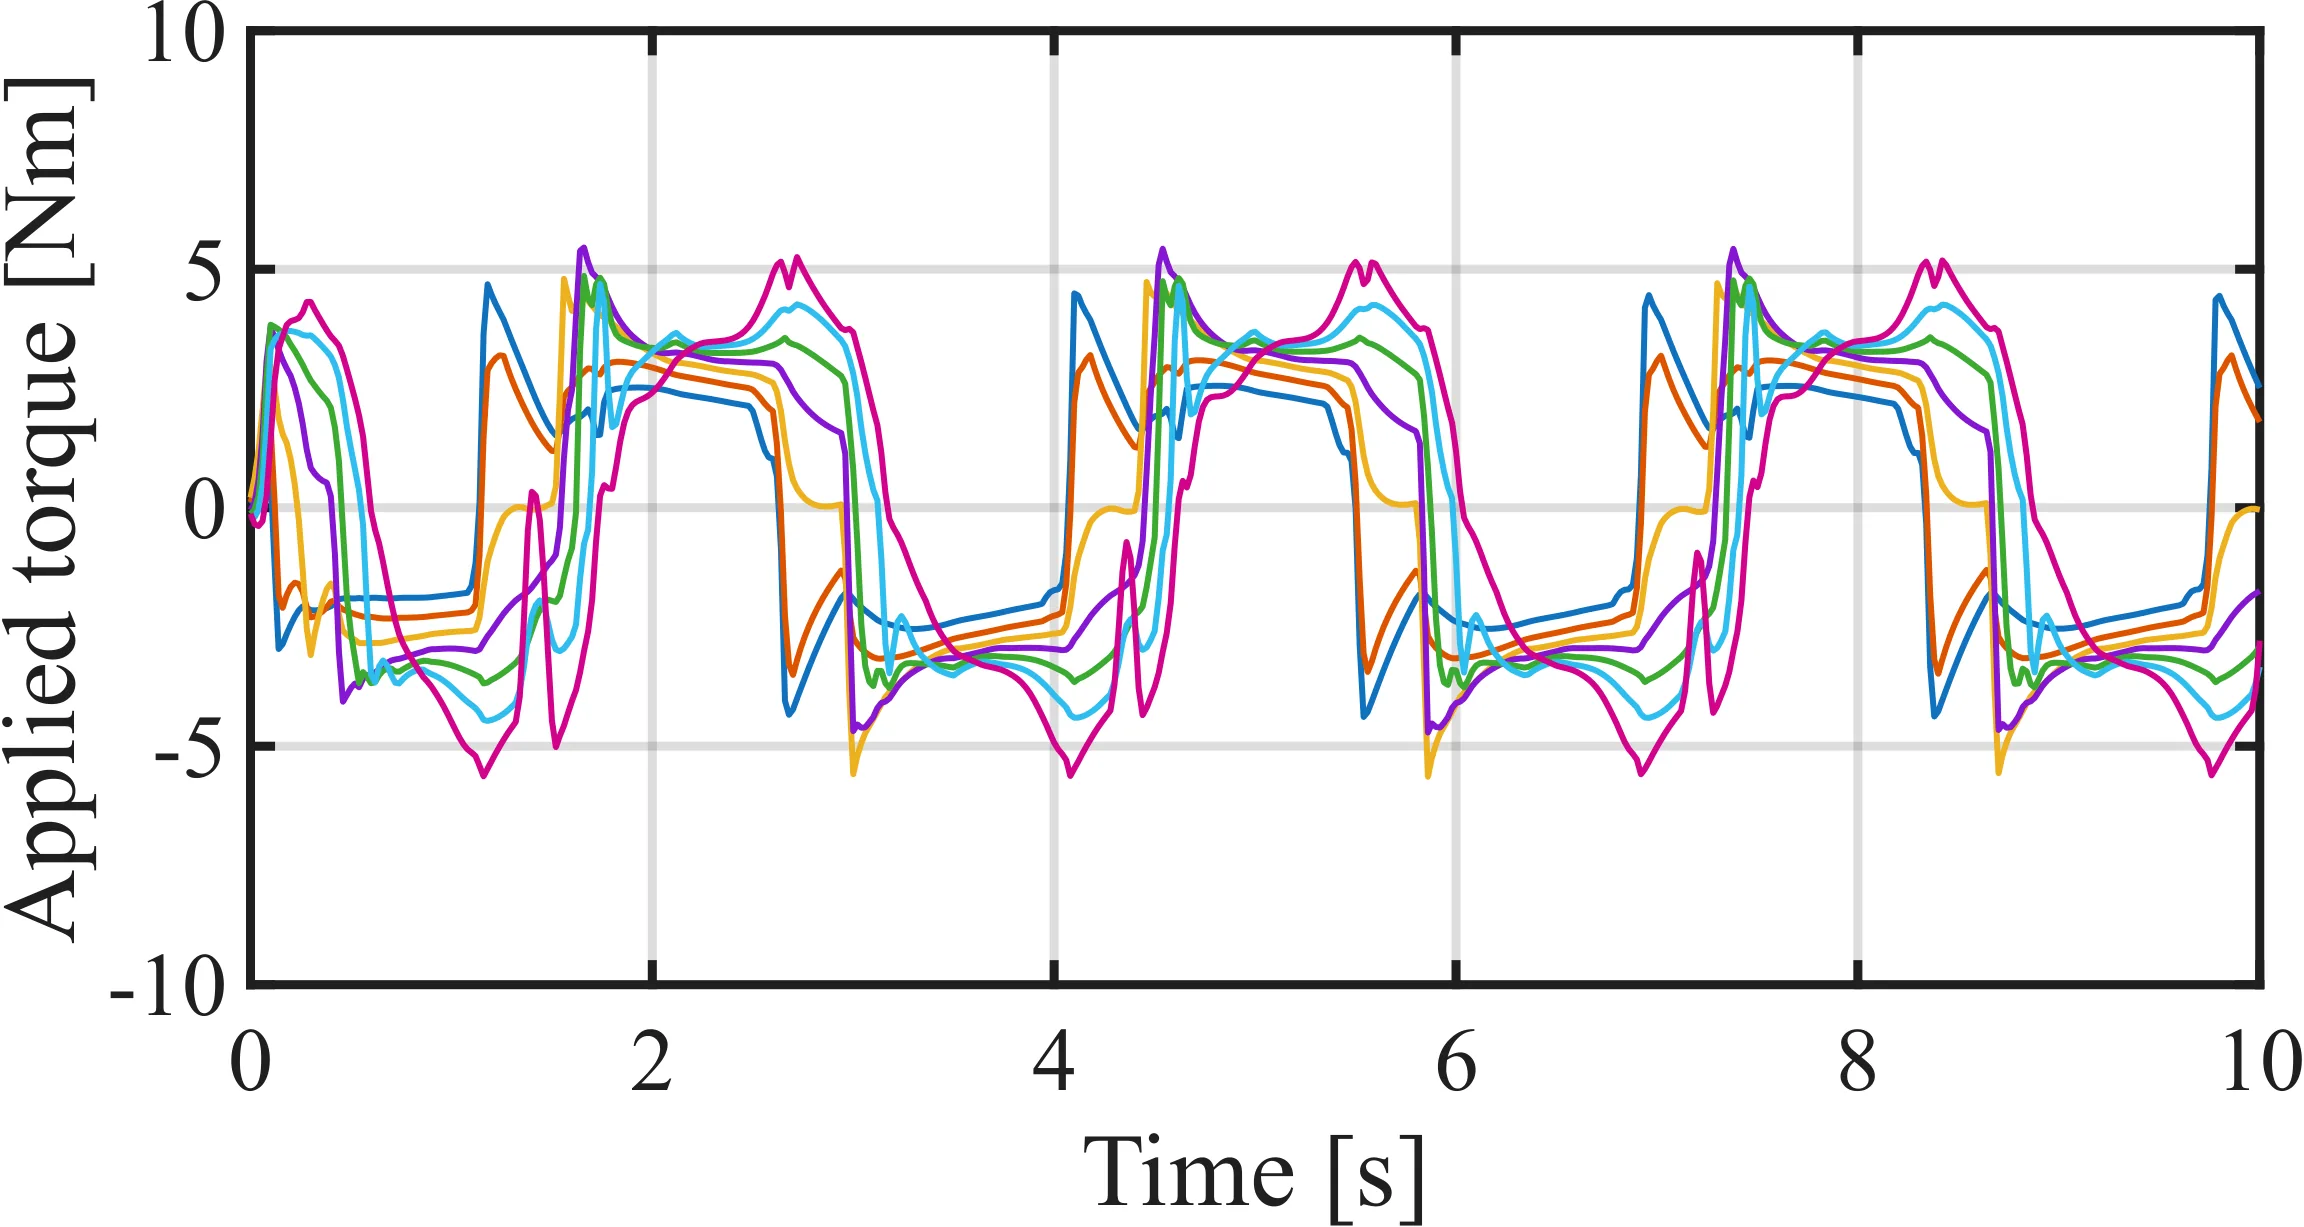
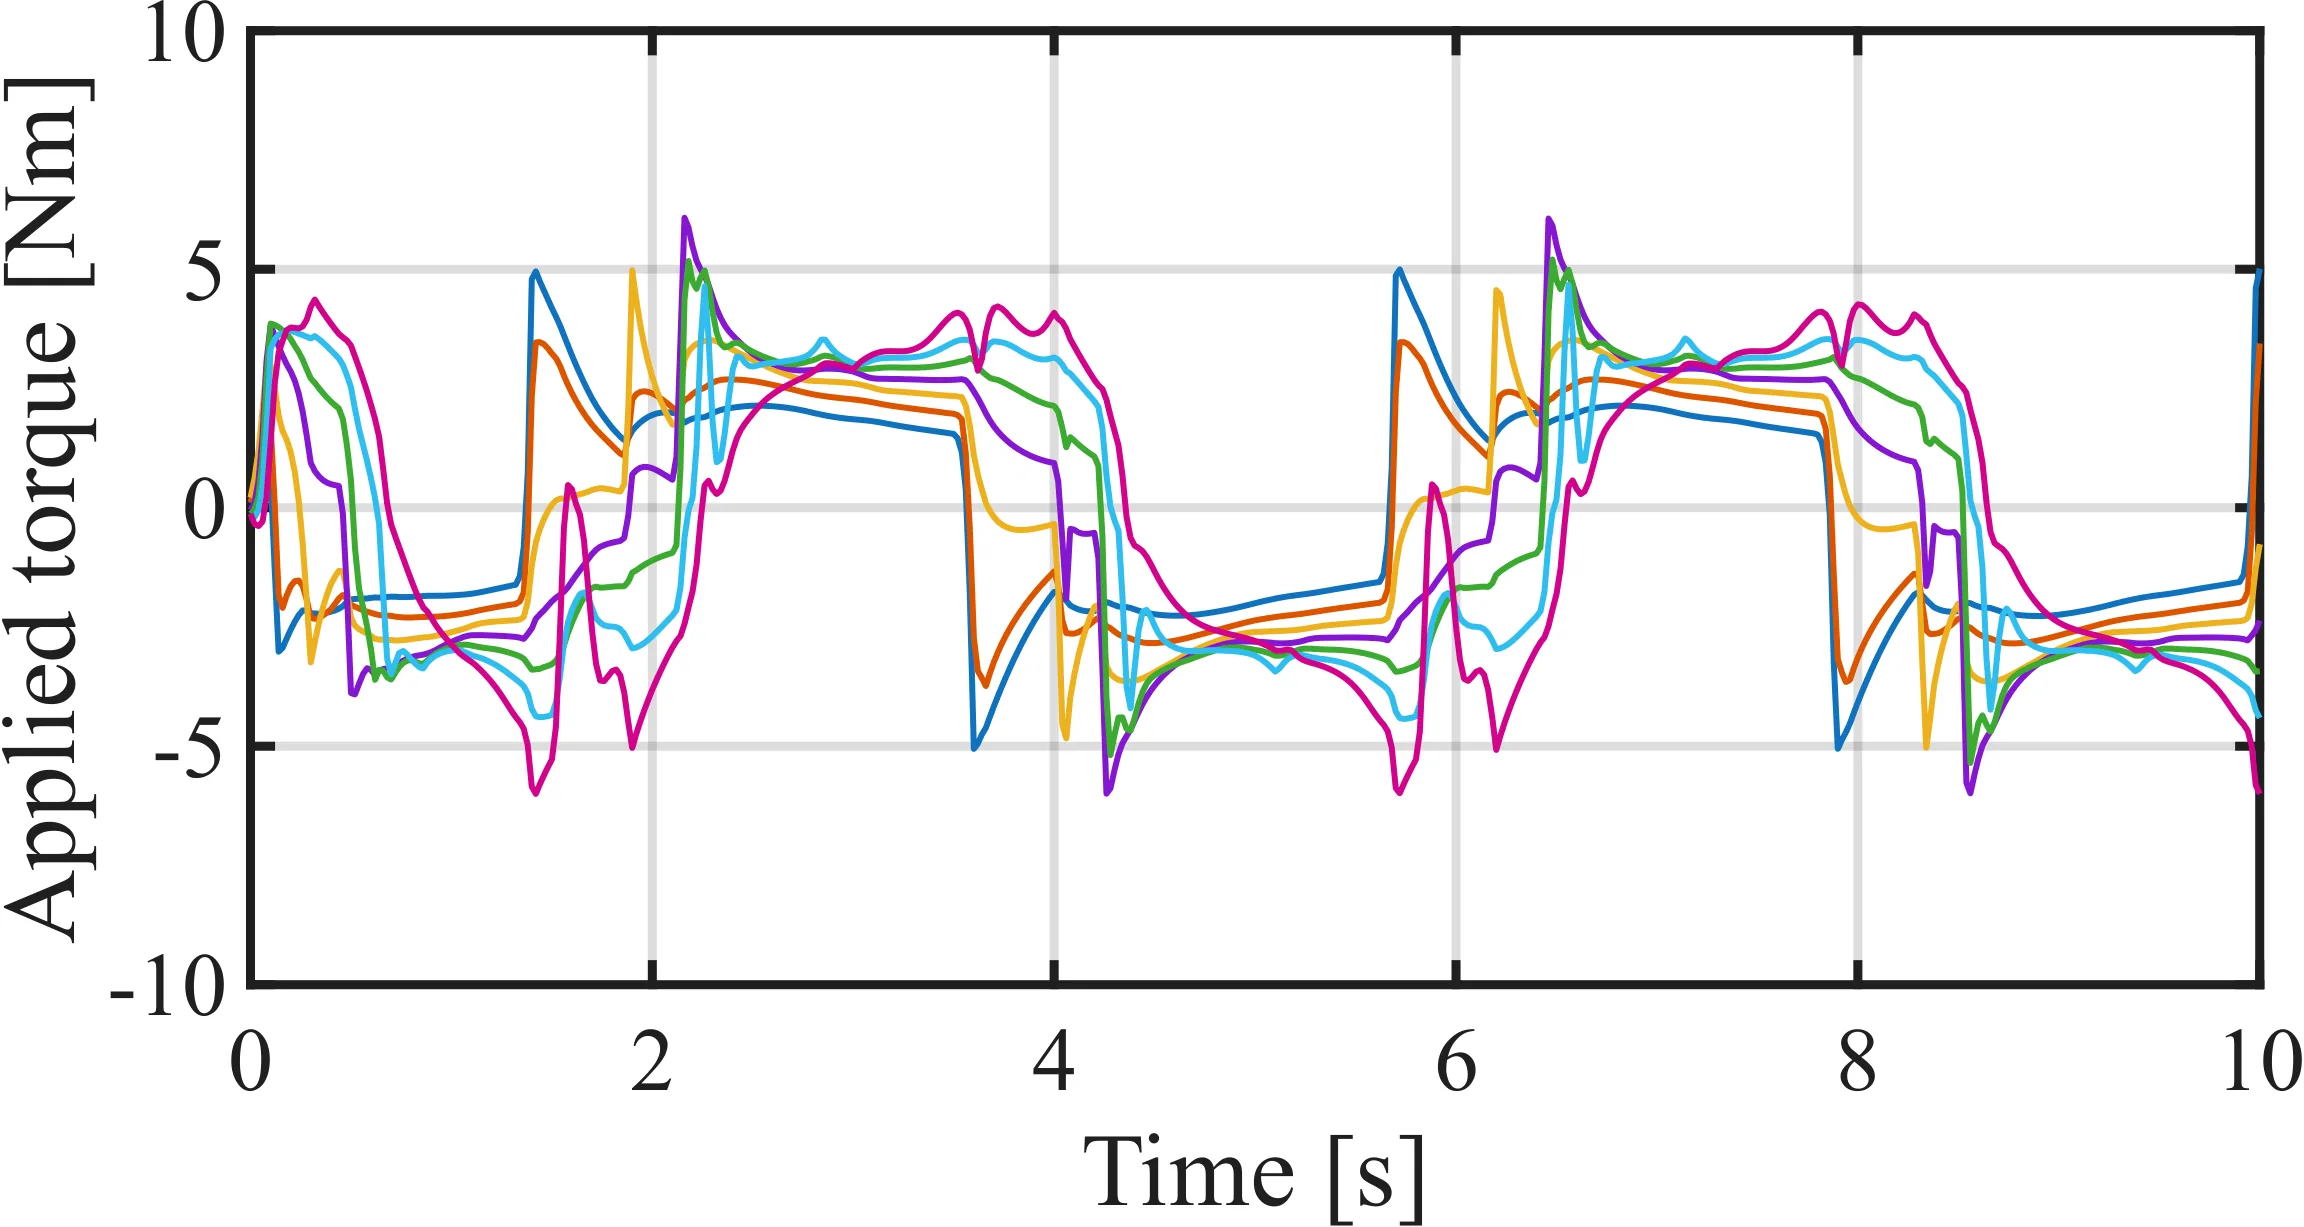
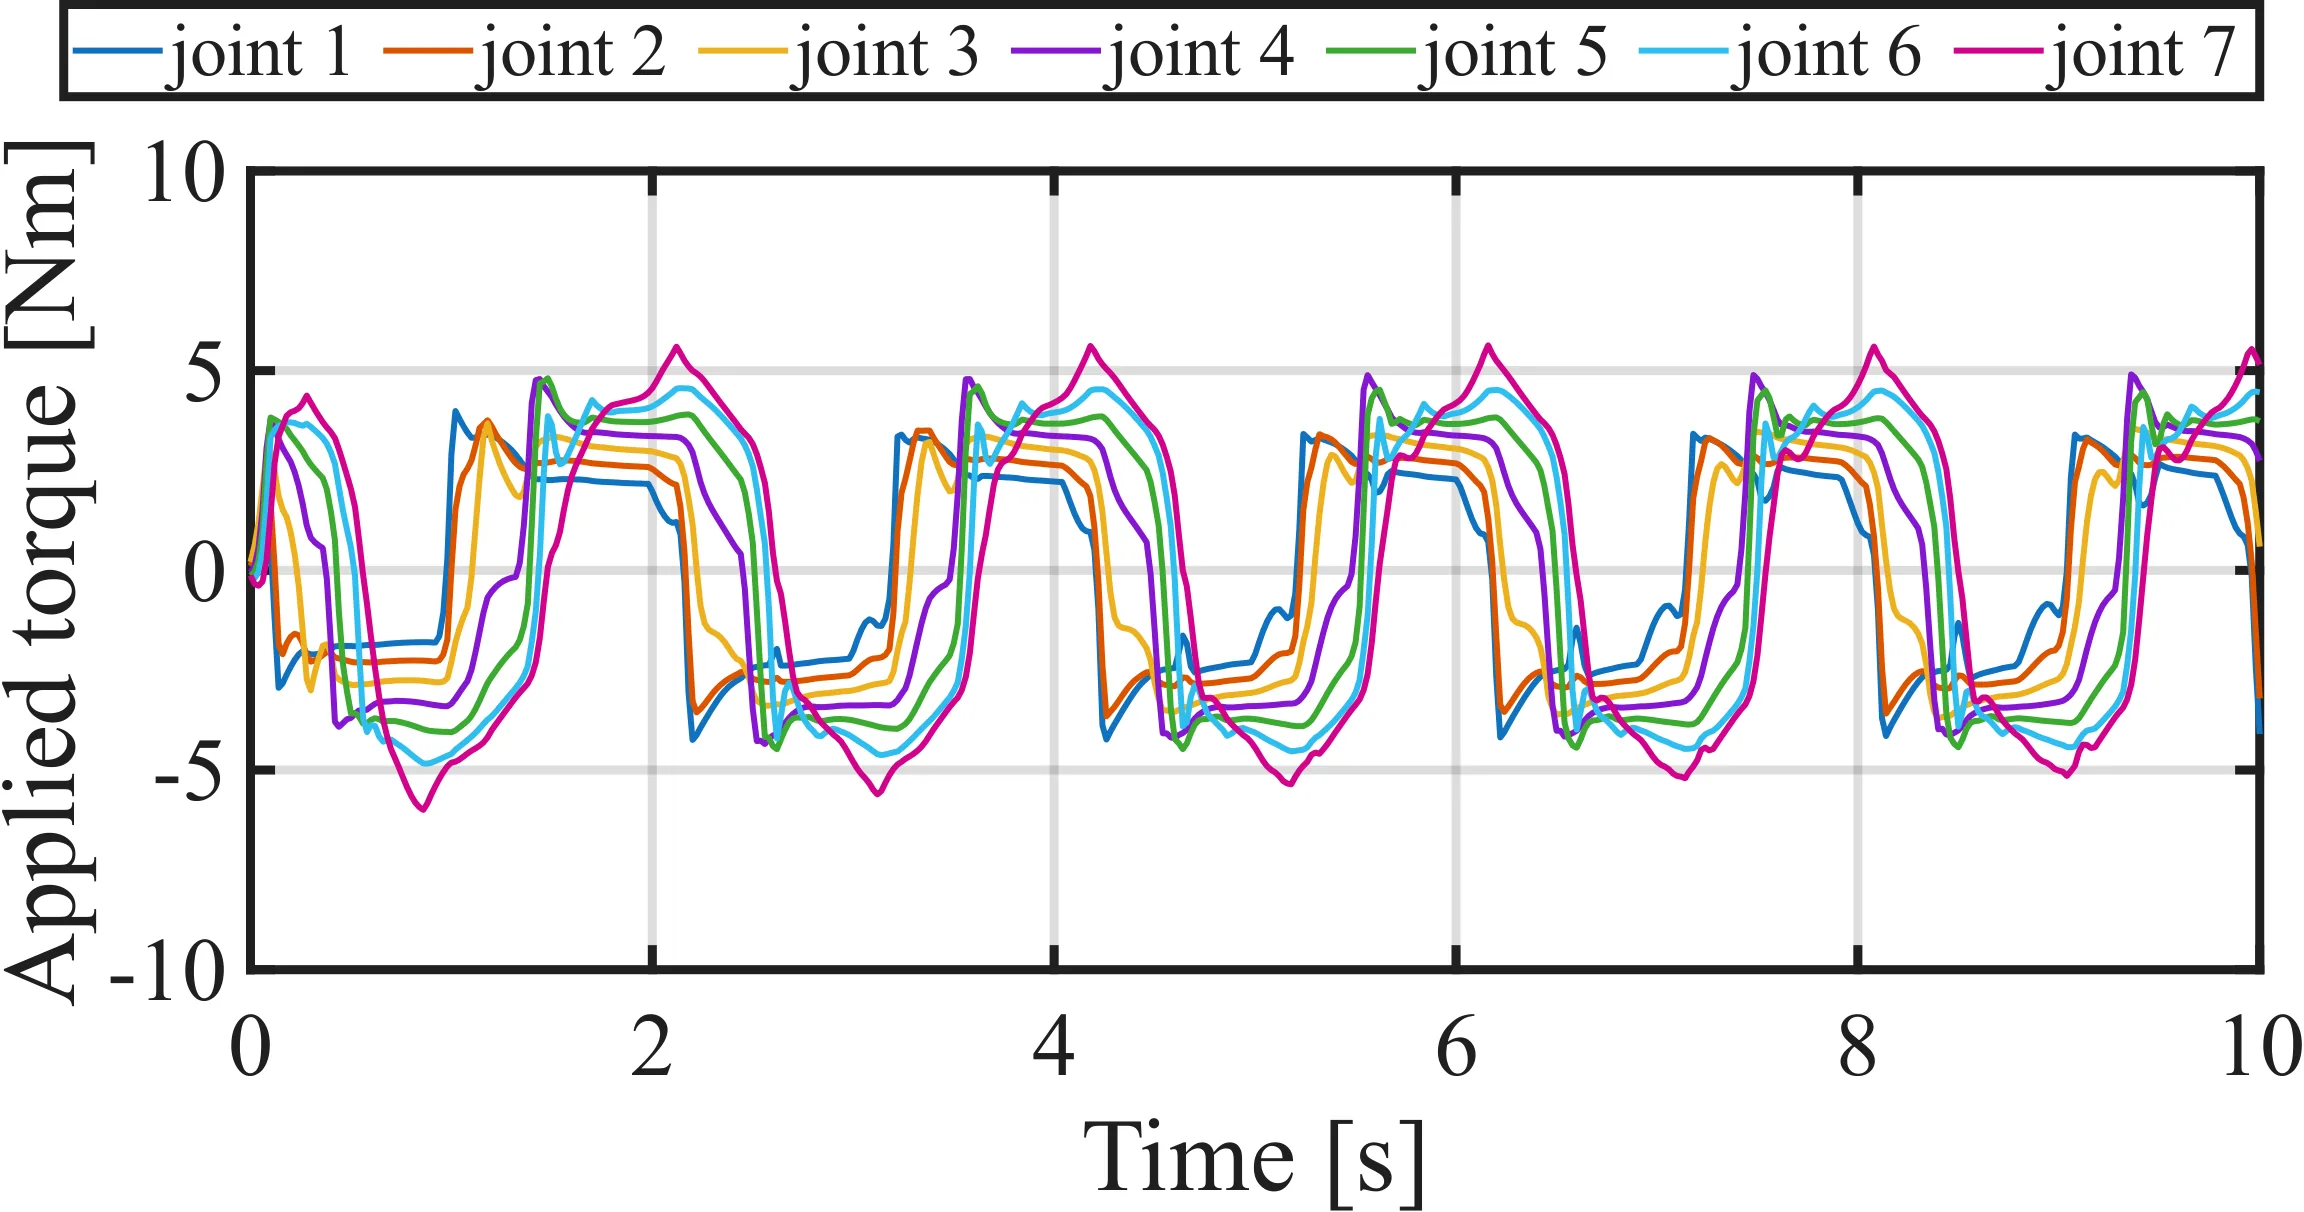
TL;DR
这篇论文让蛇形机器人在粘度不断变化的液体里学会了自己"游泳"——通过[[深度强化学习]]和一套巧妙的"教师-学生"知识蒸馏框架,机器人在无需任何流场传感器的情况下,自主演化出了非正弦的自适应步态。实验证明,这套策略在 至 的宽广粘度区间内,显著超越了传统正弦控制和海蛇运动学方法的性能上限。
研究背景与动机
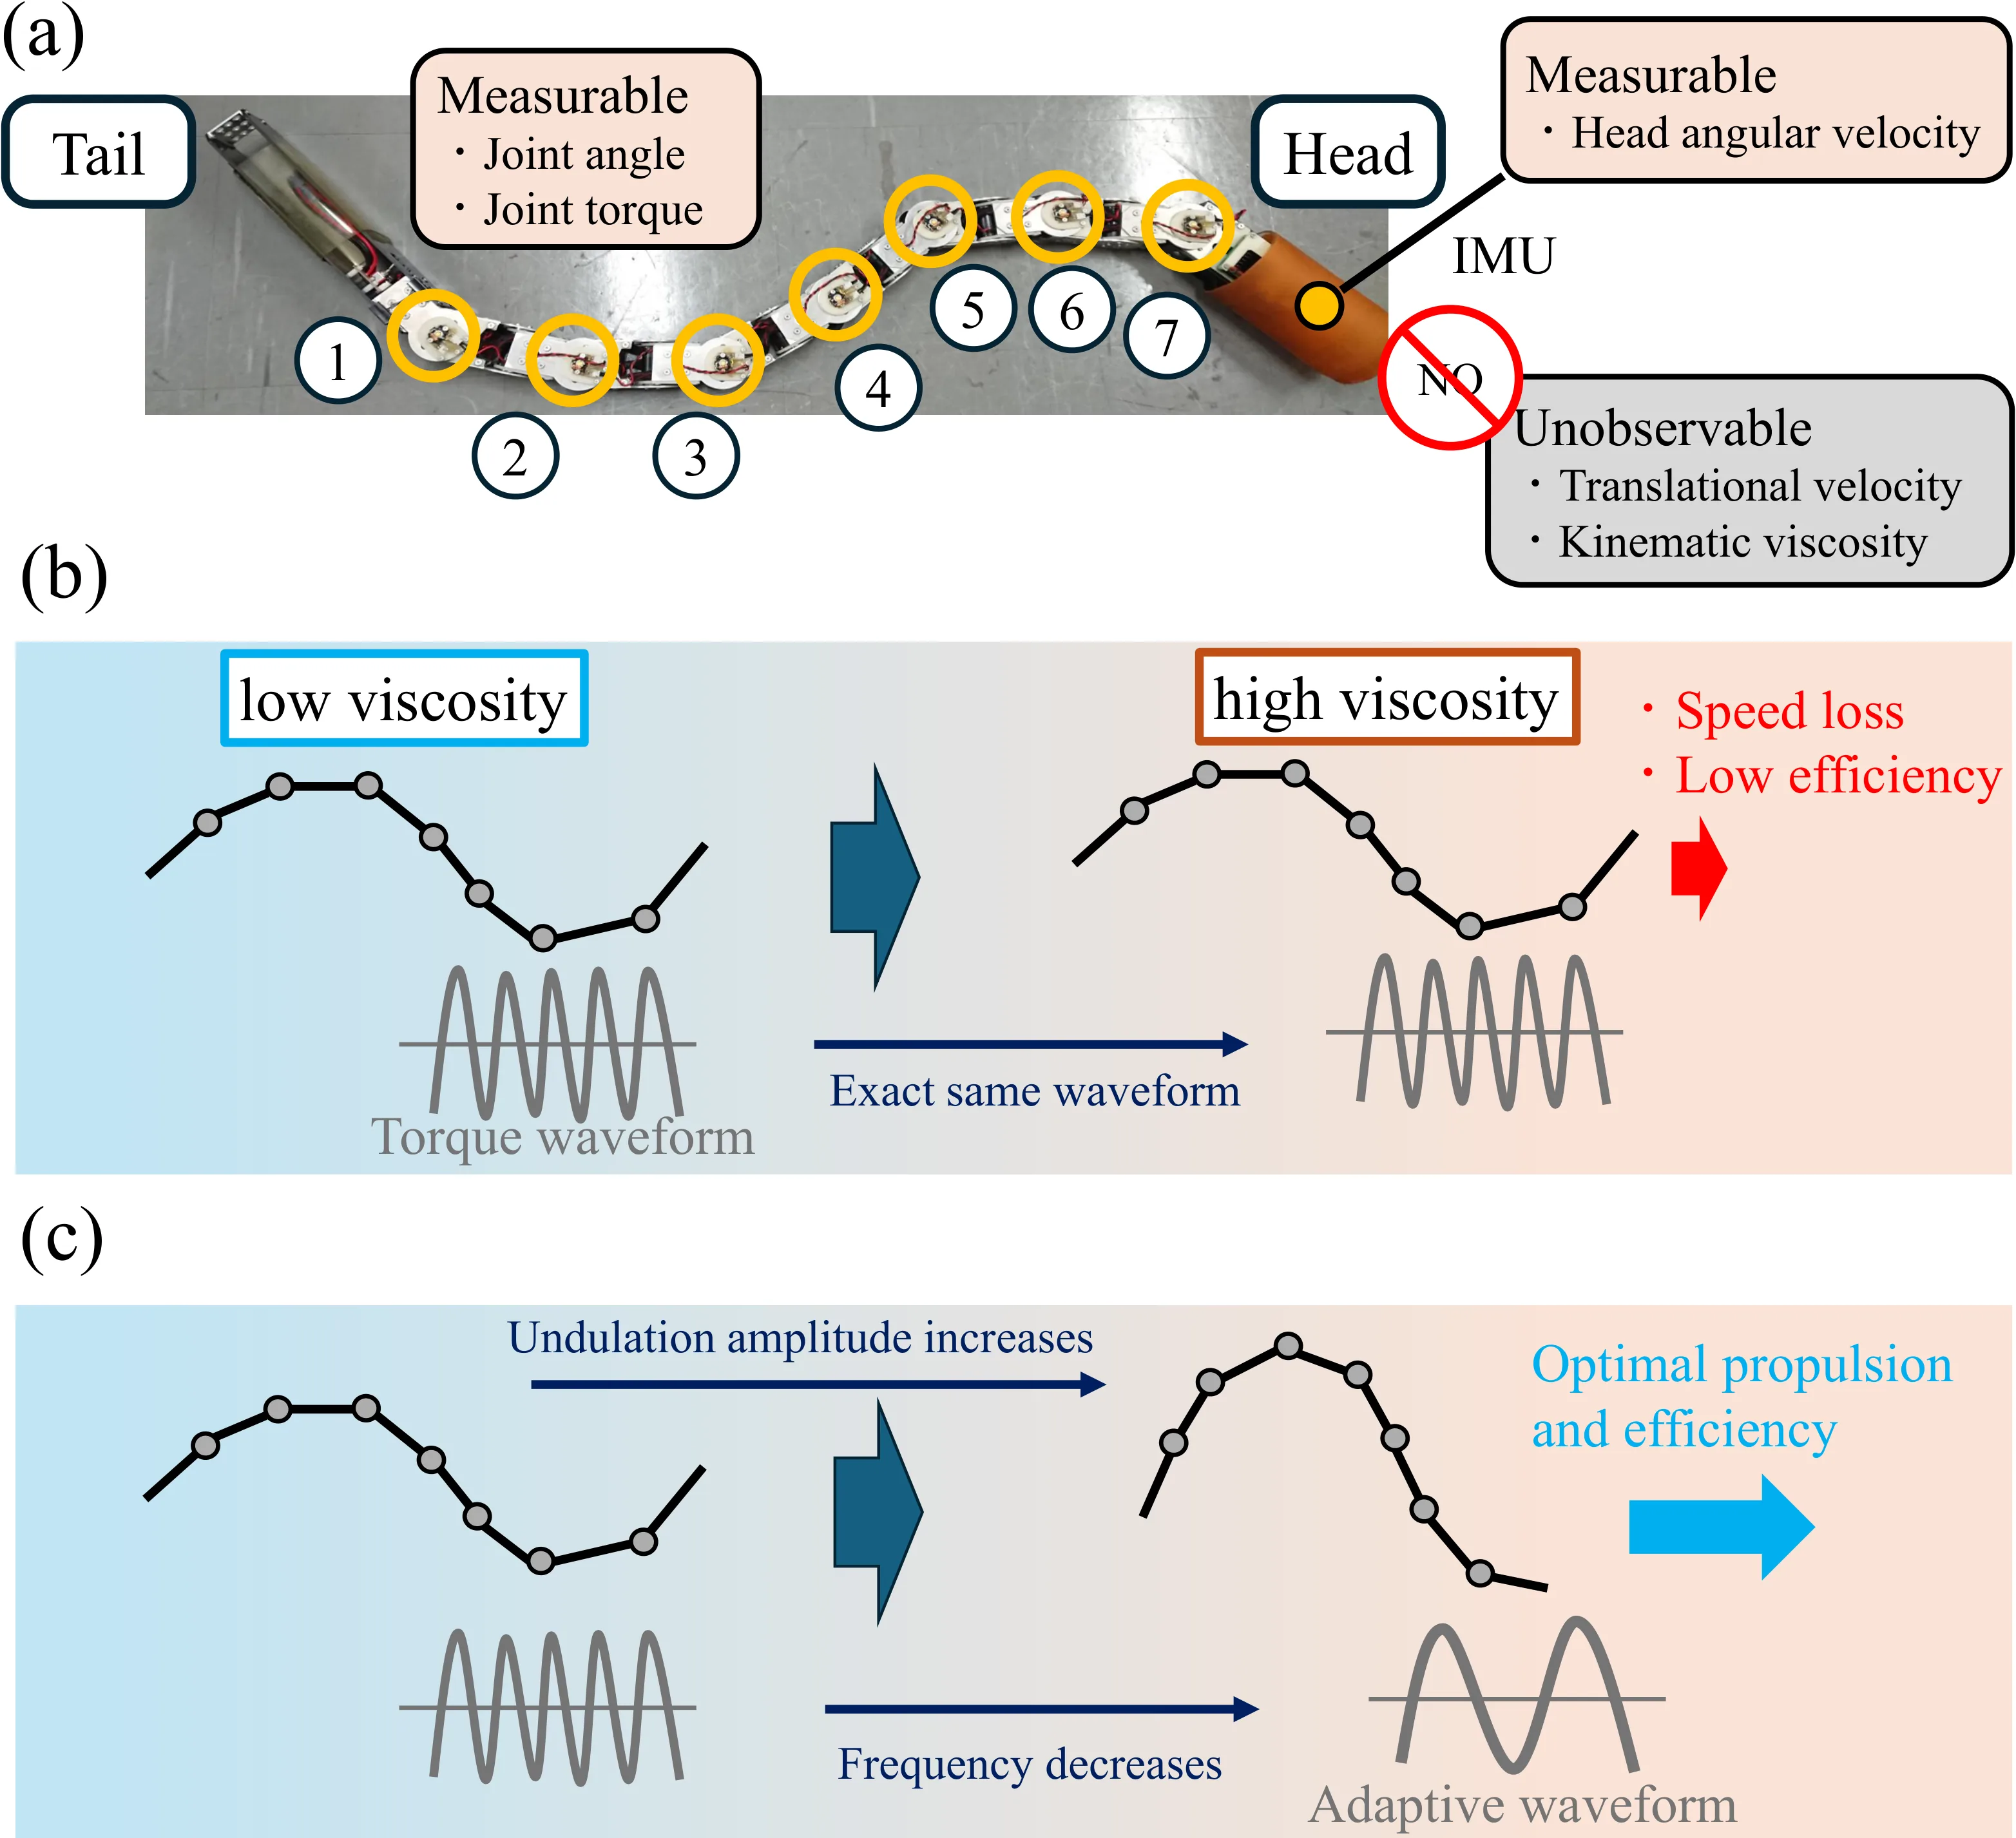
蛇形机器人在水下探测、灾害搜救、管道检测等场景中具有独特的结构优势,其细长的身体能够穿越狭窄空间。然而,波动推进的核心在于机体与周围流体之间的力学耦合——当流体粘度发生剧烈变化时(比如从清水进入高粘油液),同一种"游法"的效率会急剧下降。问题在于,粘度这个关键参数在实际环境中会随温度、杂质浓度等因素连续变化,而紧凑型蛇形机器人根本没有空间安装粘度计或速度传感器。
面对这一困境,传统控制方法遭遇了三重瓶颈。第一,基于 Navier-Stokes 方程的精确建模虽然物理上严谨,但计算量巨大,根本无法在毫秒级时间内生成控制动作。第二,CPG(中枢模式发生器)等预定义步态波形本质上是"写死"的,正弦函数或 Serpenoid 曲线无法灵活响应未知的流体变化。第三,即便引入自适应控制,也面临一个信息论层面的"死循环":需要知道粘度才能估计流体阻力,从而估计速度来调整步态——但粘度本身就是一个隐藏变量。
论文的核心切入点在于:与其费力去直接测量或估计那个测不到的粘度,不如让智能体通过大量交互经验,隐式地"感受"不同粘度下的运动差异,从而学会自适应调整步态。这一思路自然地导向了[[POMDP]](部分可观测马尔可夫决策过程)的建模框架。
方法
论文将控制问题建模为一个确定性 POMDP。状态空间中,关节角、角速度、输出力矩是机器人能够通过本体传感器直接获取的信息,而流体运动粘度 和质心平移速度 则是无法直接观测的隐藏变量。动作空间定义为 7 个关节的目标角度,构成一个 7 维连续向量。状态转移则由 NVIDIA Isaac Sim 中的流体-结构耦合仿真器实现。
在控制律层面,论文采用了两层叠加结构。首先,PD 控制器根据目标角度与实际角度的偏差生成输入力矩:
然后,叠加一个虚拟的扭转弹簧与阻尼器来模拟防水外壳带来的被动阻力:
这种分离设计让学习任务聚焦于步态生成本身,而非底层的关节动力学。
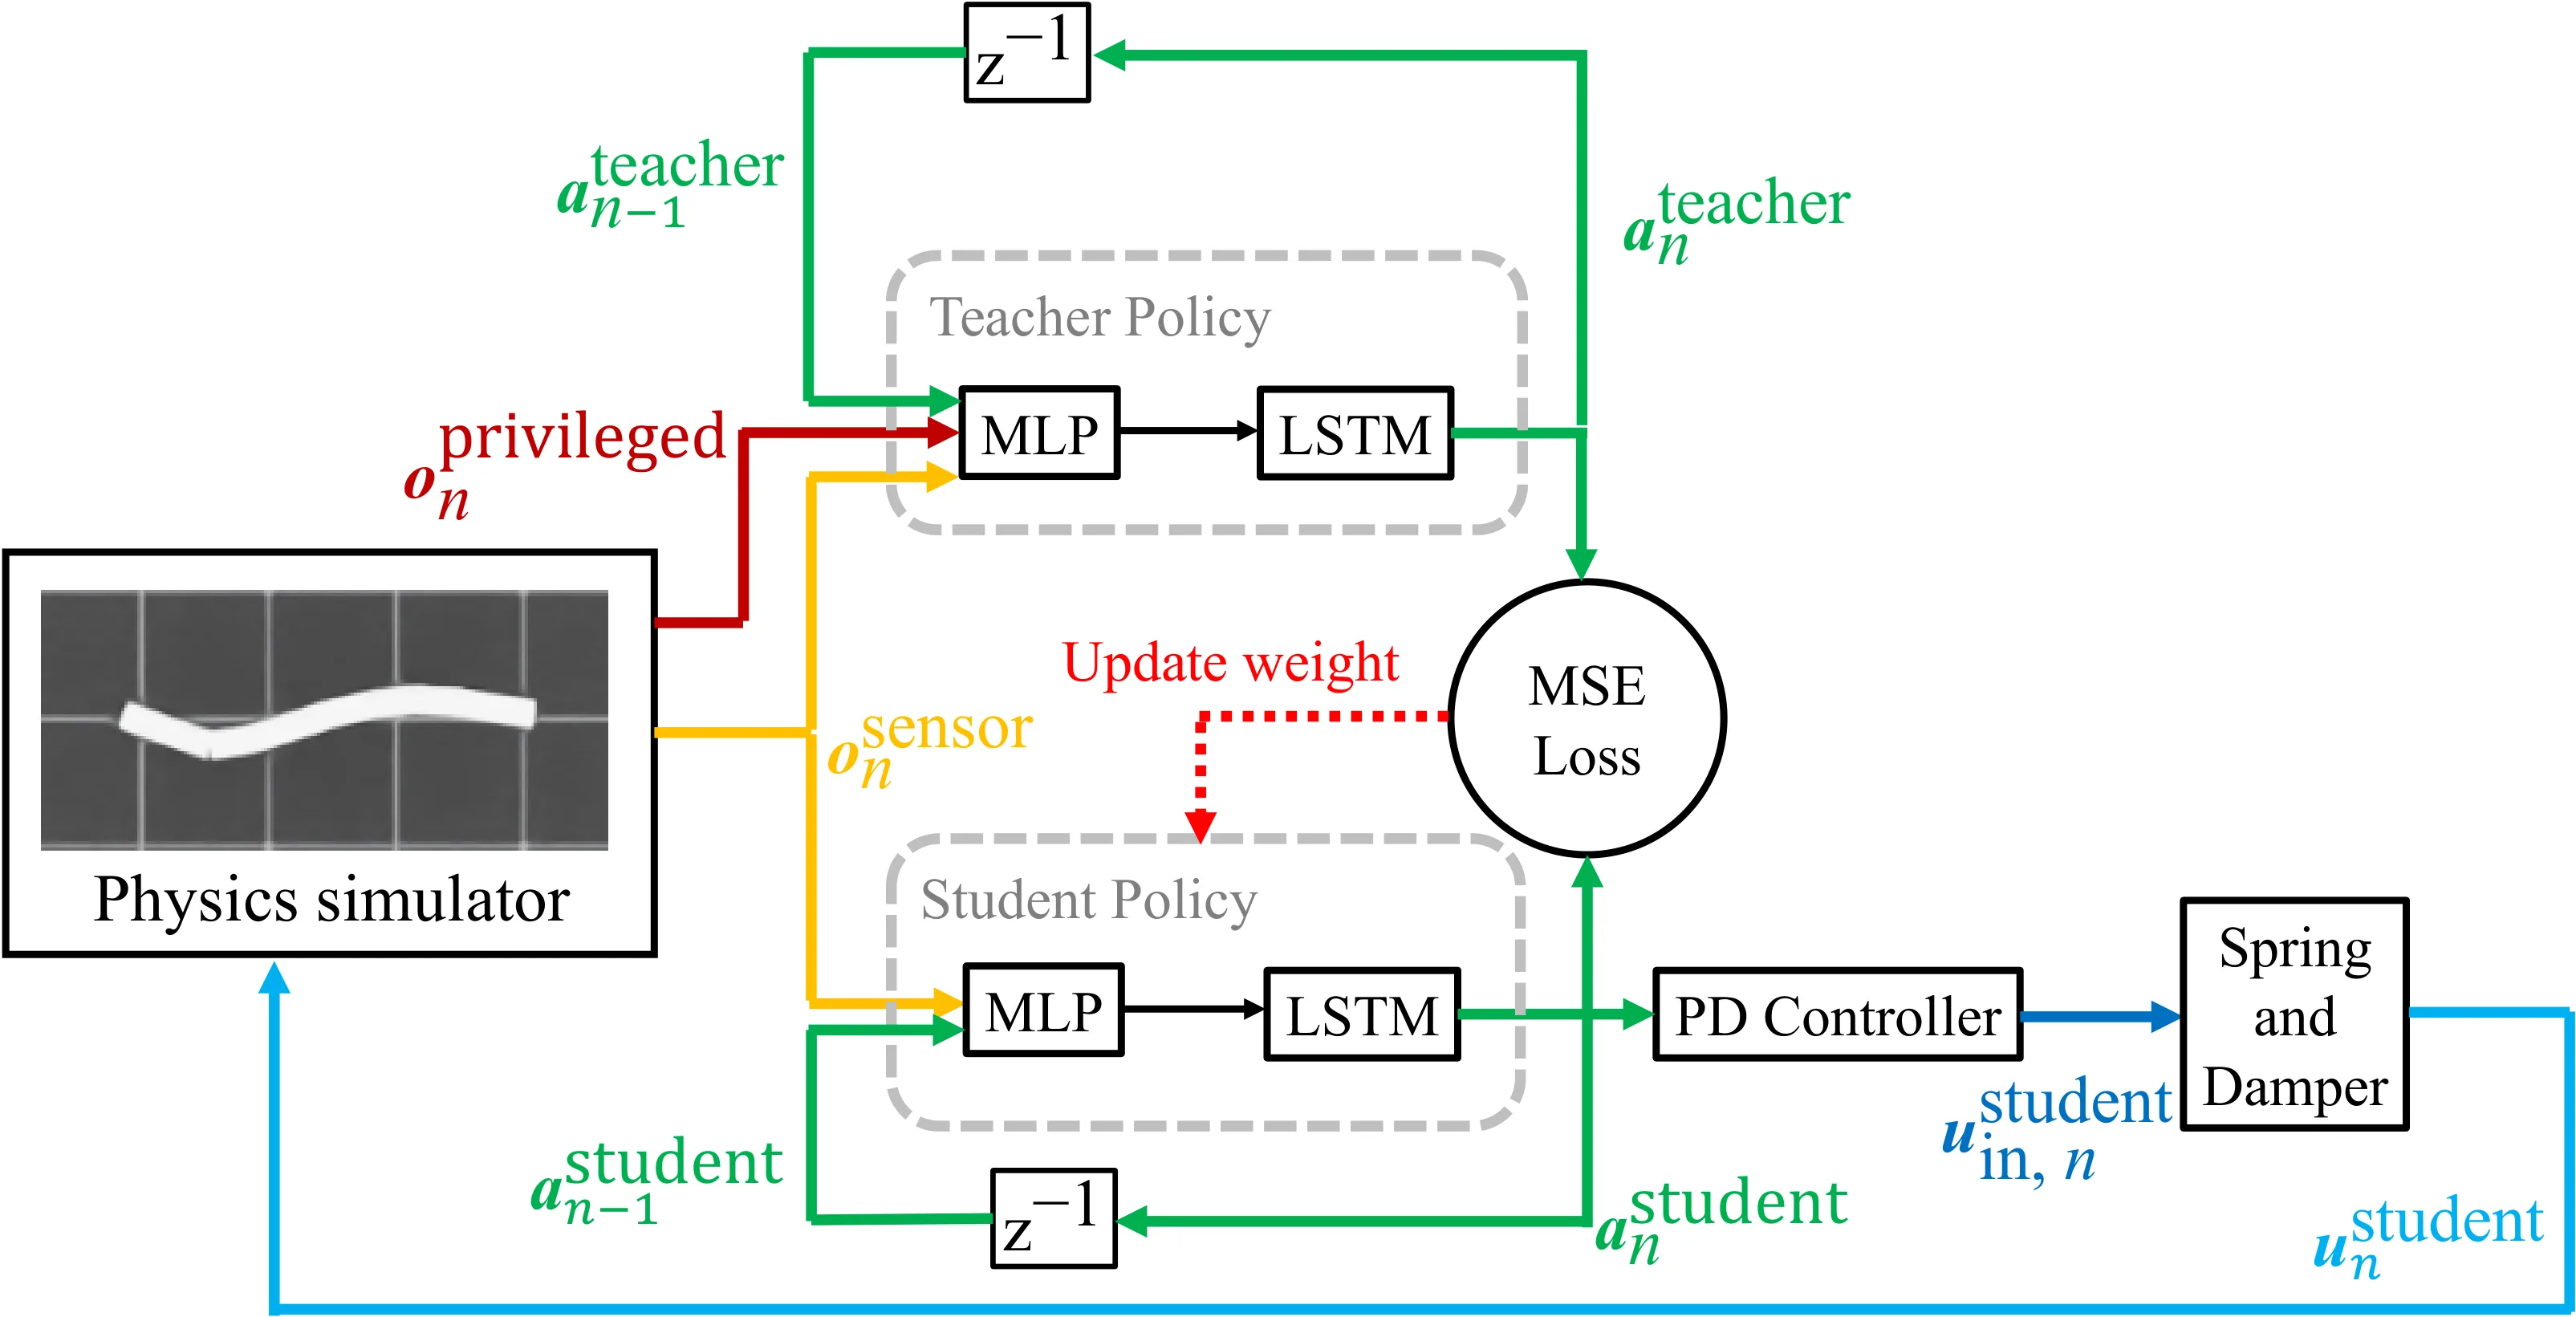
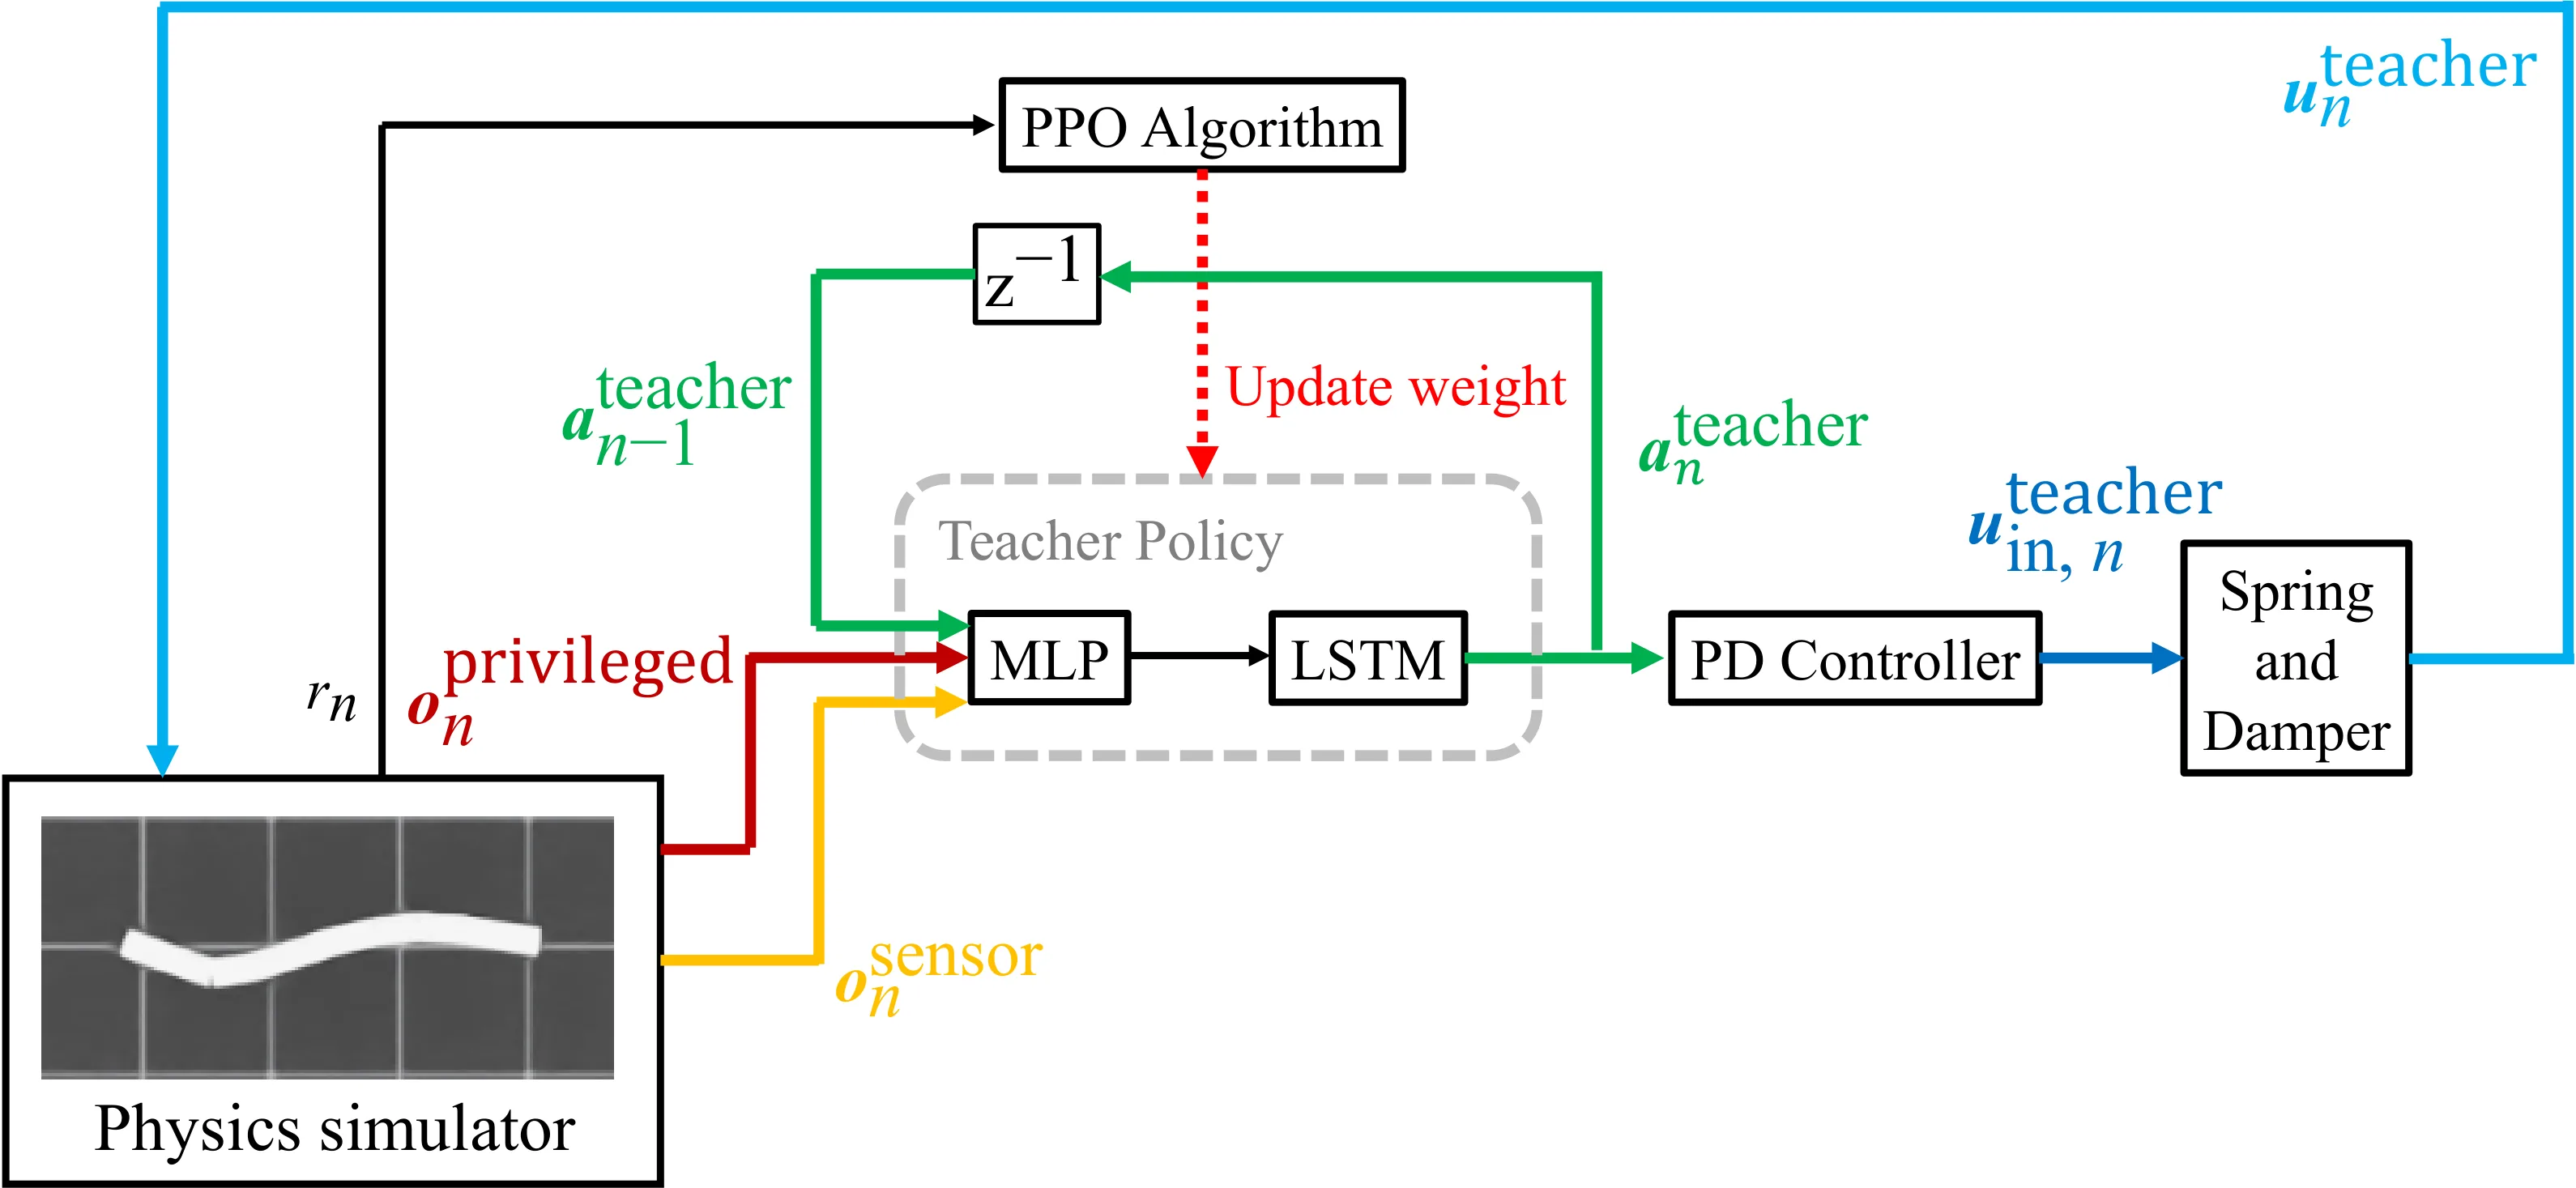
核心创新在于非对称 Actor-Critic 框架的设计。论文同时训练两套策略:教师策略 在仿真器中享有"特权"——它能直接获取当前流体粘度 与头部线速度 作为输入特征,基于 [[PPO]] 算法进行训练;学生策略 则只依赖本体感知信息(关节角、角速度、输出力矩、头部角速度以及上一时刻动作),通过均方误差损失从教师策略蒸馏知识得到。两套网络采用相同的架构:2 层全连接网络(各 64 单元)做特征提取,随后 2 层 LSTM(各 128 单元)处理时序依赖,最后输出动作分布。
这一设计的精妙之处在于:教师策略在特权信息的辅助下能够学到"当前粘度下应该如何调整步态"的专家知识,而学生策略通过蒸馏被迫从教师的行为中提取出那些不依赖显式粘度信息就能判断的隐含规律——本质上是在建立一套从本体感觉到环境状态的间接映射。
奖励函数的设计同样经过仔细考量:
其中 赋予速度最高的正奖励权重, 对动作幅度施加惩罚以避免能量浪费, 在机器人倒退或速度超过阈值时施加强惩罚。为了防止策略在低粘度区间过拟合,训练过程中还逐步衰减了 。整个训练过程中,流体粘度在 范围内随机采样,这种[[域随机化]]策略迫使智能体必须学会通用而非特化的步态调整能力。
实验与结果
实验在 NVIDIA Isaac Lab + Isaac Sim 仿真平台上进行,采用了比过去同类研究更宽的粘度跨度——从接近水的低粘度一直覆盖到高粘油液。流体力学模型综合考虑了附加质量力、压差阻力(与速度平方成正比)以及粘性阻力,阻力系数 按雷诺数分段定义,在低雷诺数区间使用 Oseen 方程的解析解进行平滑连接。
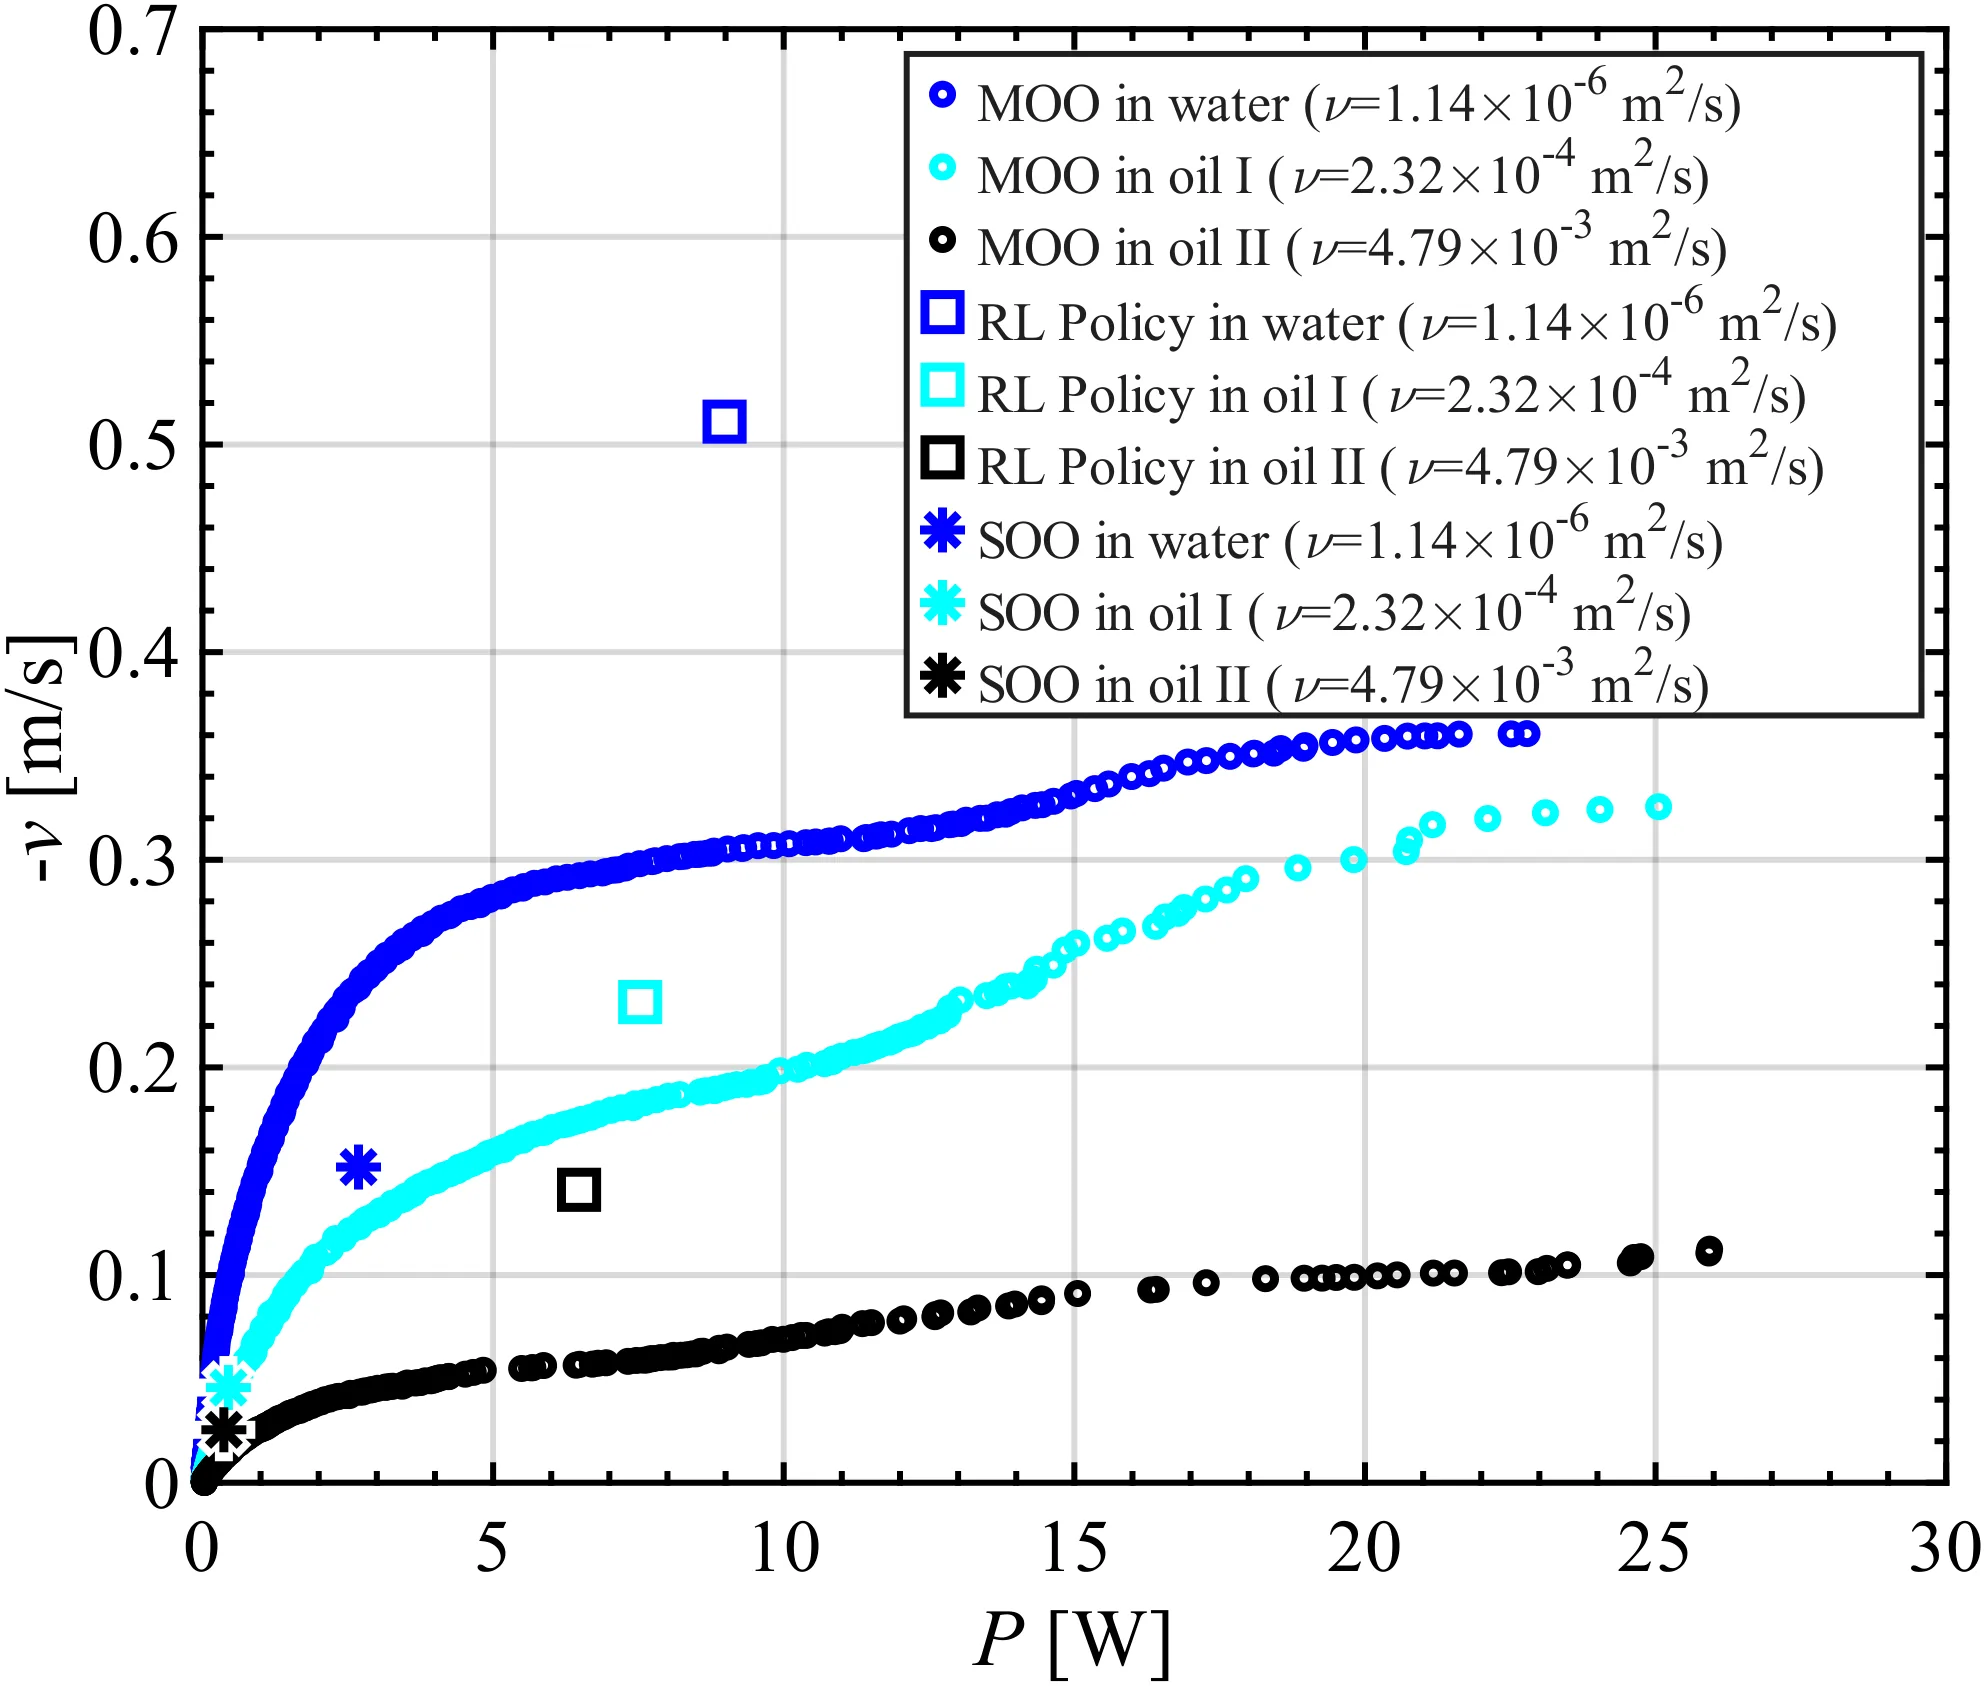
对比基线包括两类经典方法:SOO(单目标优化)基于海蛇运动学模型参数进行贝叶斯优化,代表预定义步态的性能上界;MOO(多目标优化)在正弦力矩参数空间求解 Pareto 前沿,代表传统正弦控制方法能够达到的性能极限。此外还设有标准对称 DRL 消融实验——即不借助特权信息,仅用本体感知从头训练。
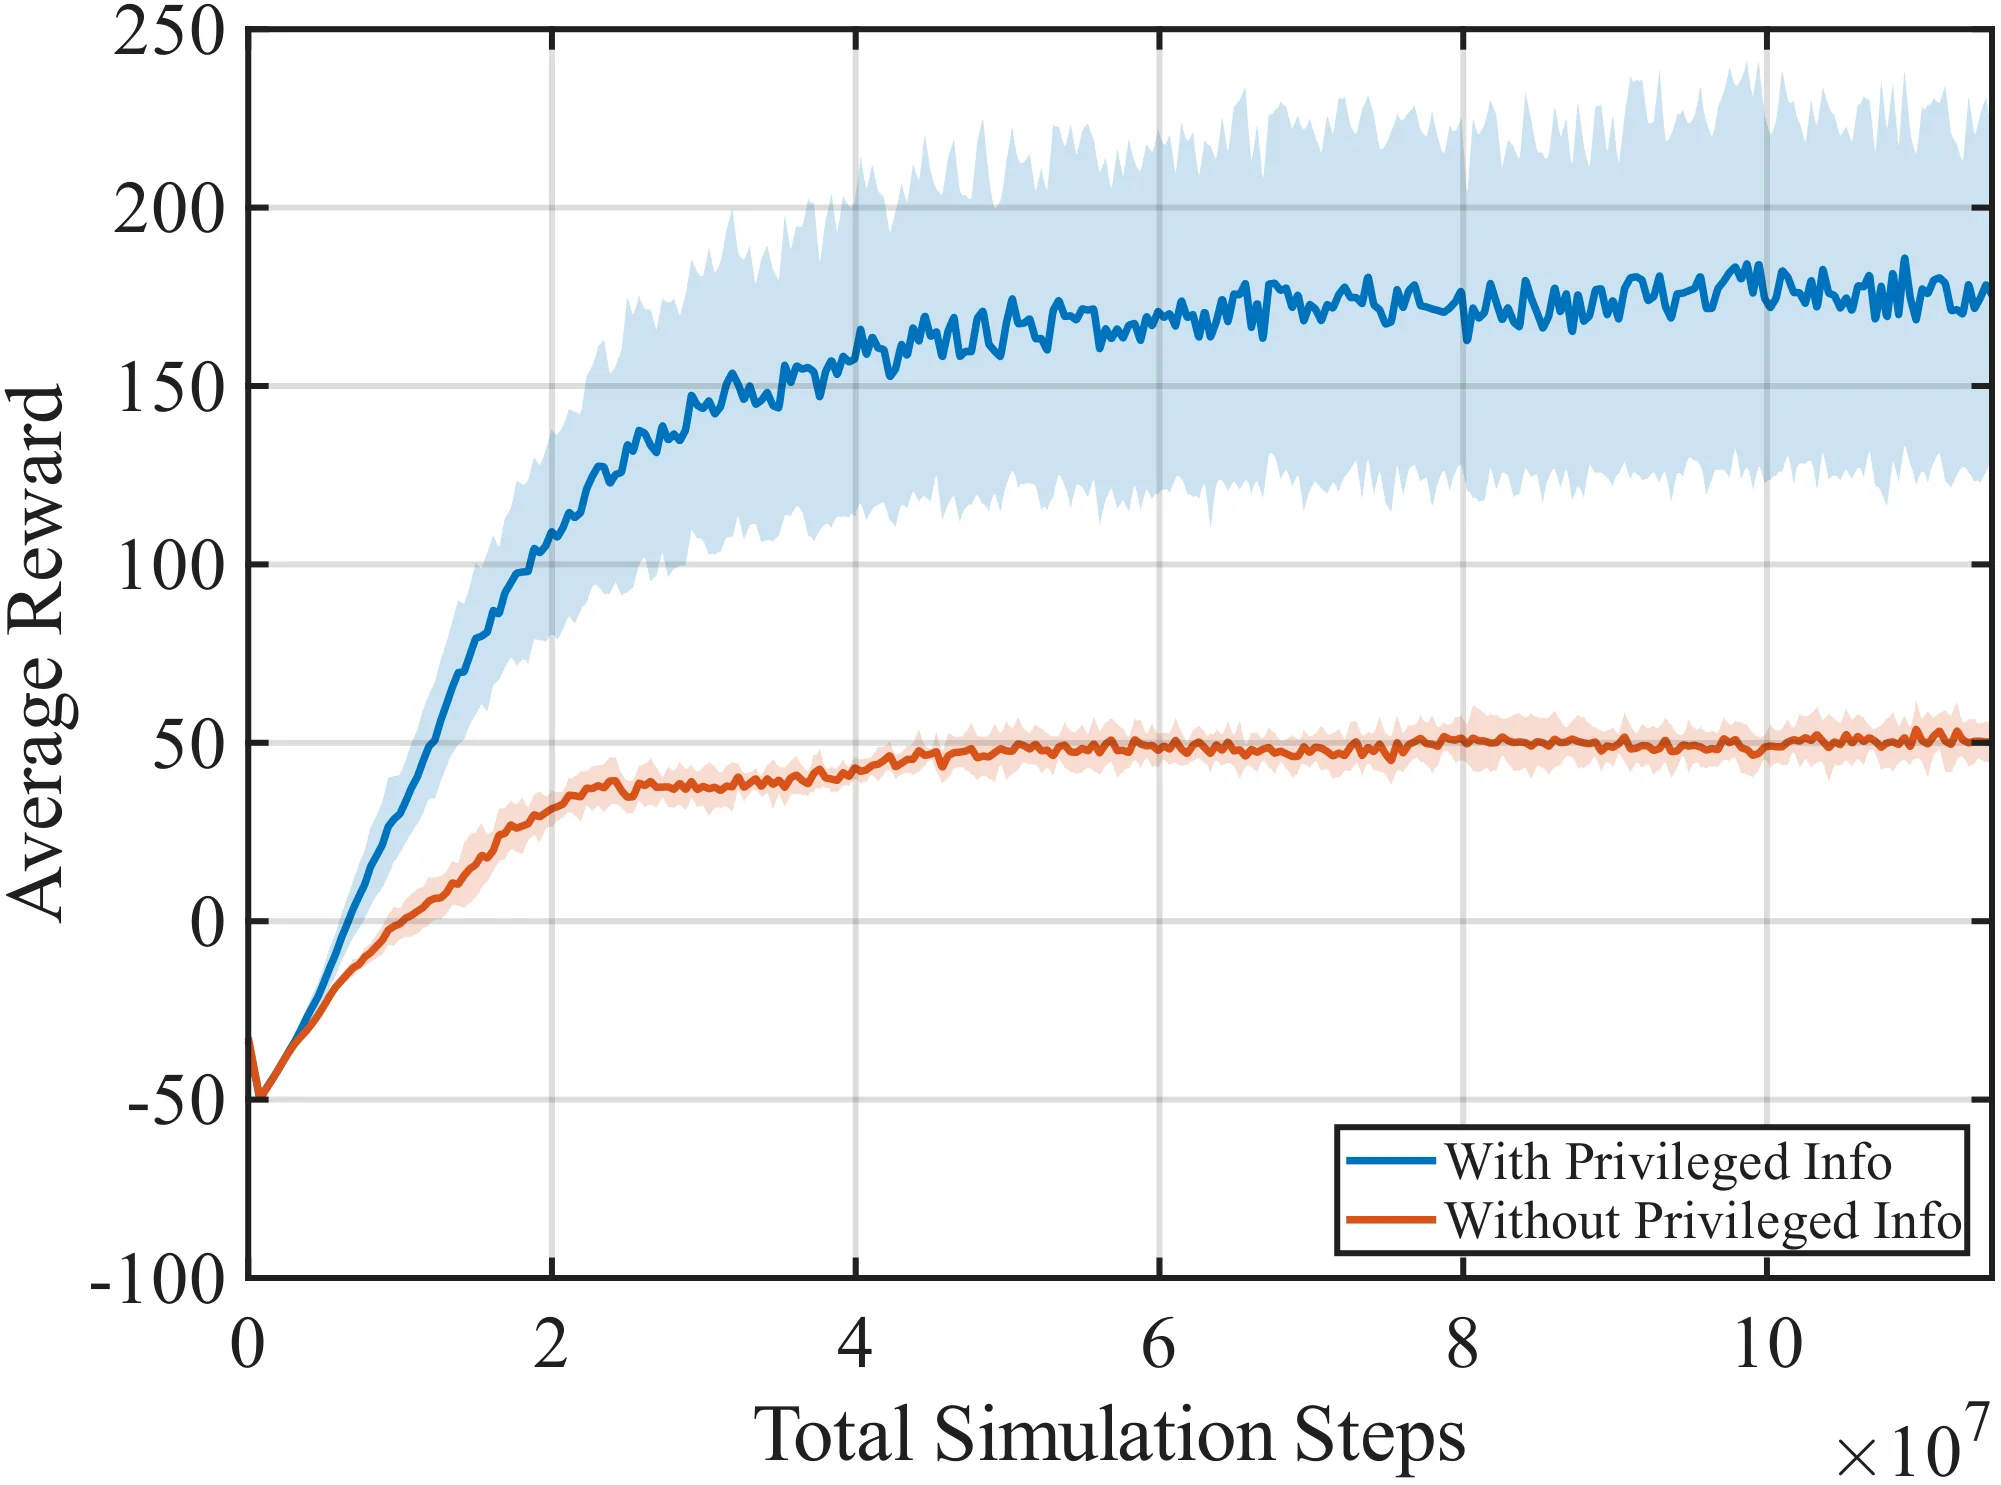
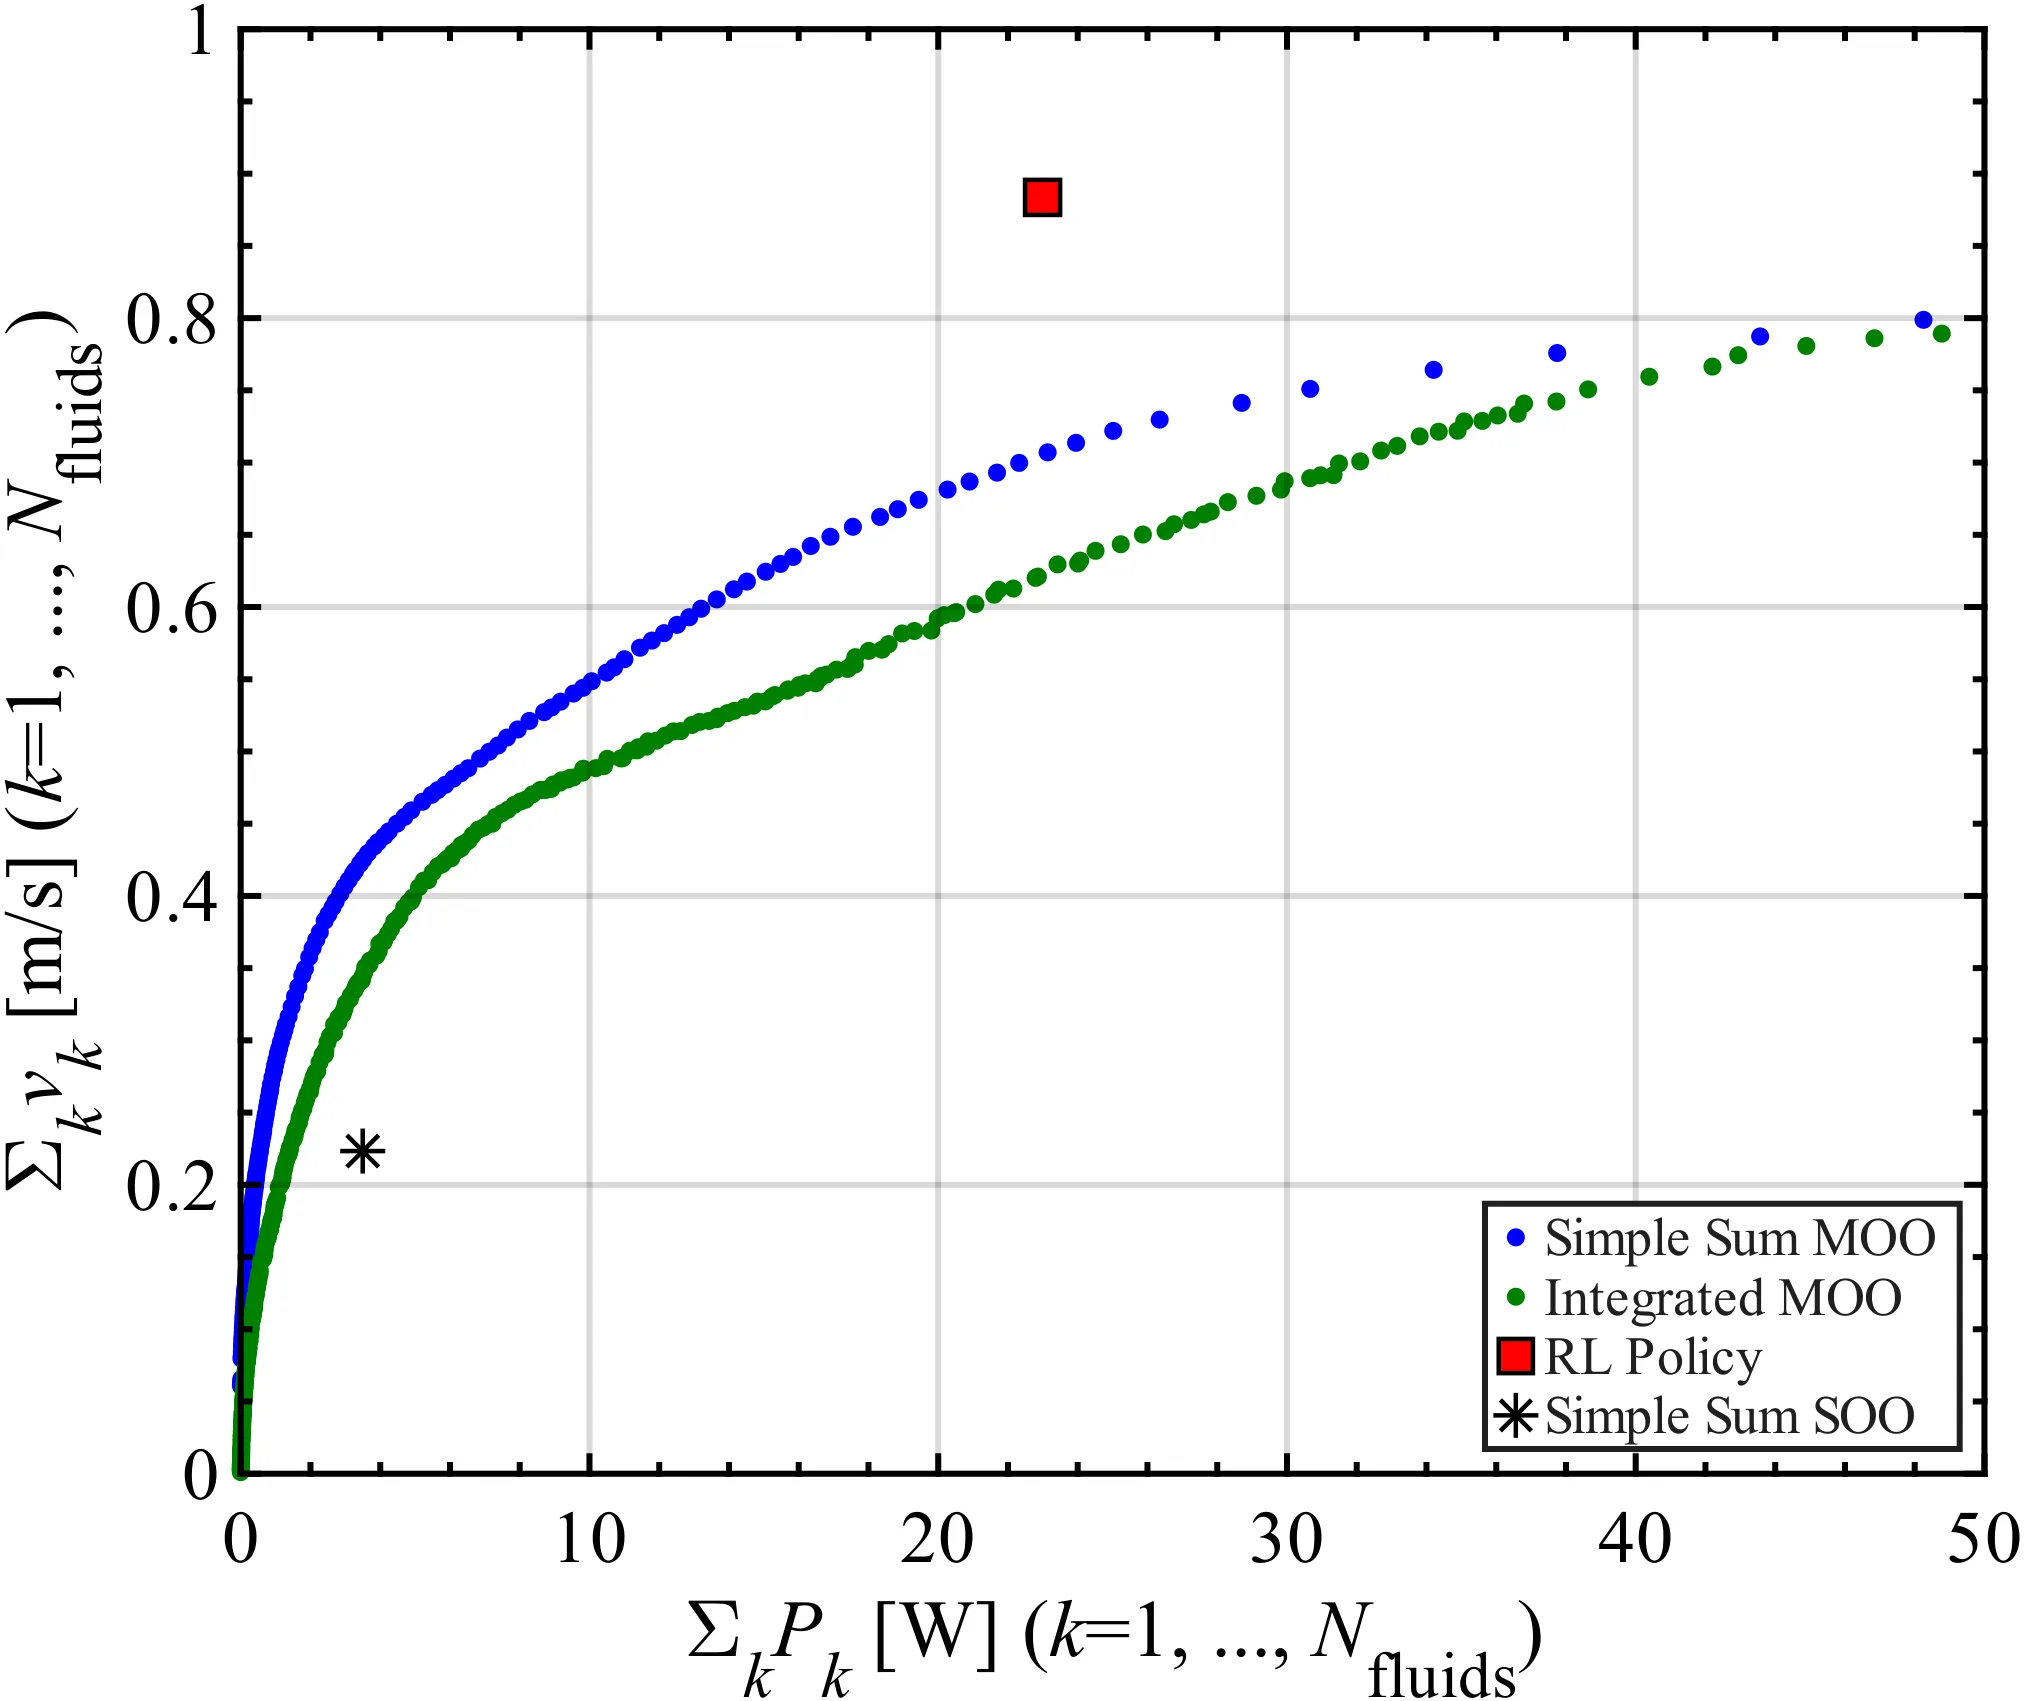
结果呈现出清晰的阶梯格局。在水、Oil I、Oil II 三种代表性流体中,蒸馏得到的学生策略推进速度与运输成本(CoT)均突破了 MOO Pareto 前沿,意味着它超越了"针对每种流体单独优化的最优正弦控制"所能达到的效果。标准对称 DRL 的平均奖励仅约 50,难以收敛到有效步态,而引入特权信息蒸馏的框架则稳定收敛至约 170,证明了在部分可观测条件下教师知识的引导作用不可替代。
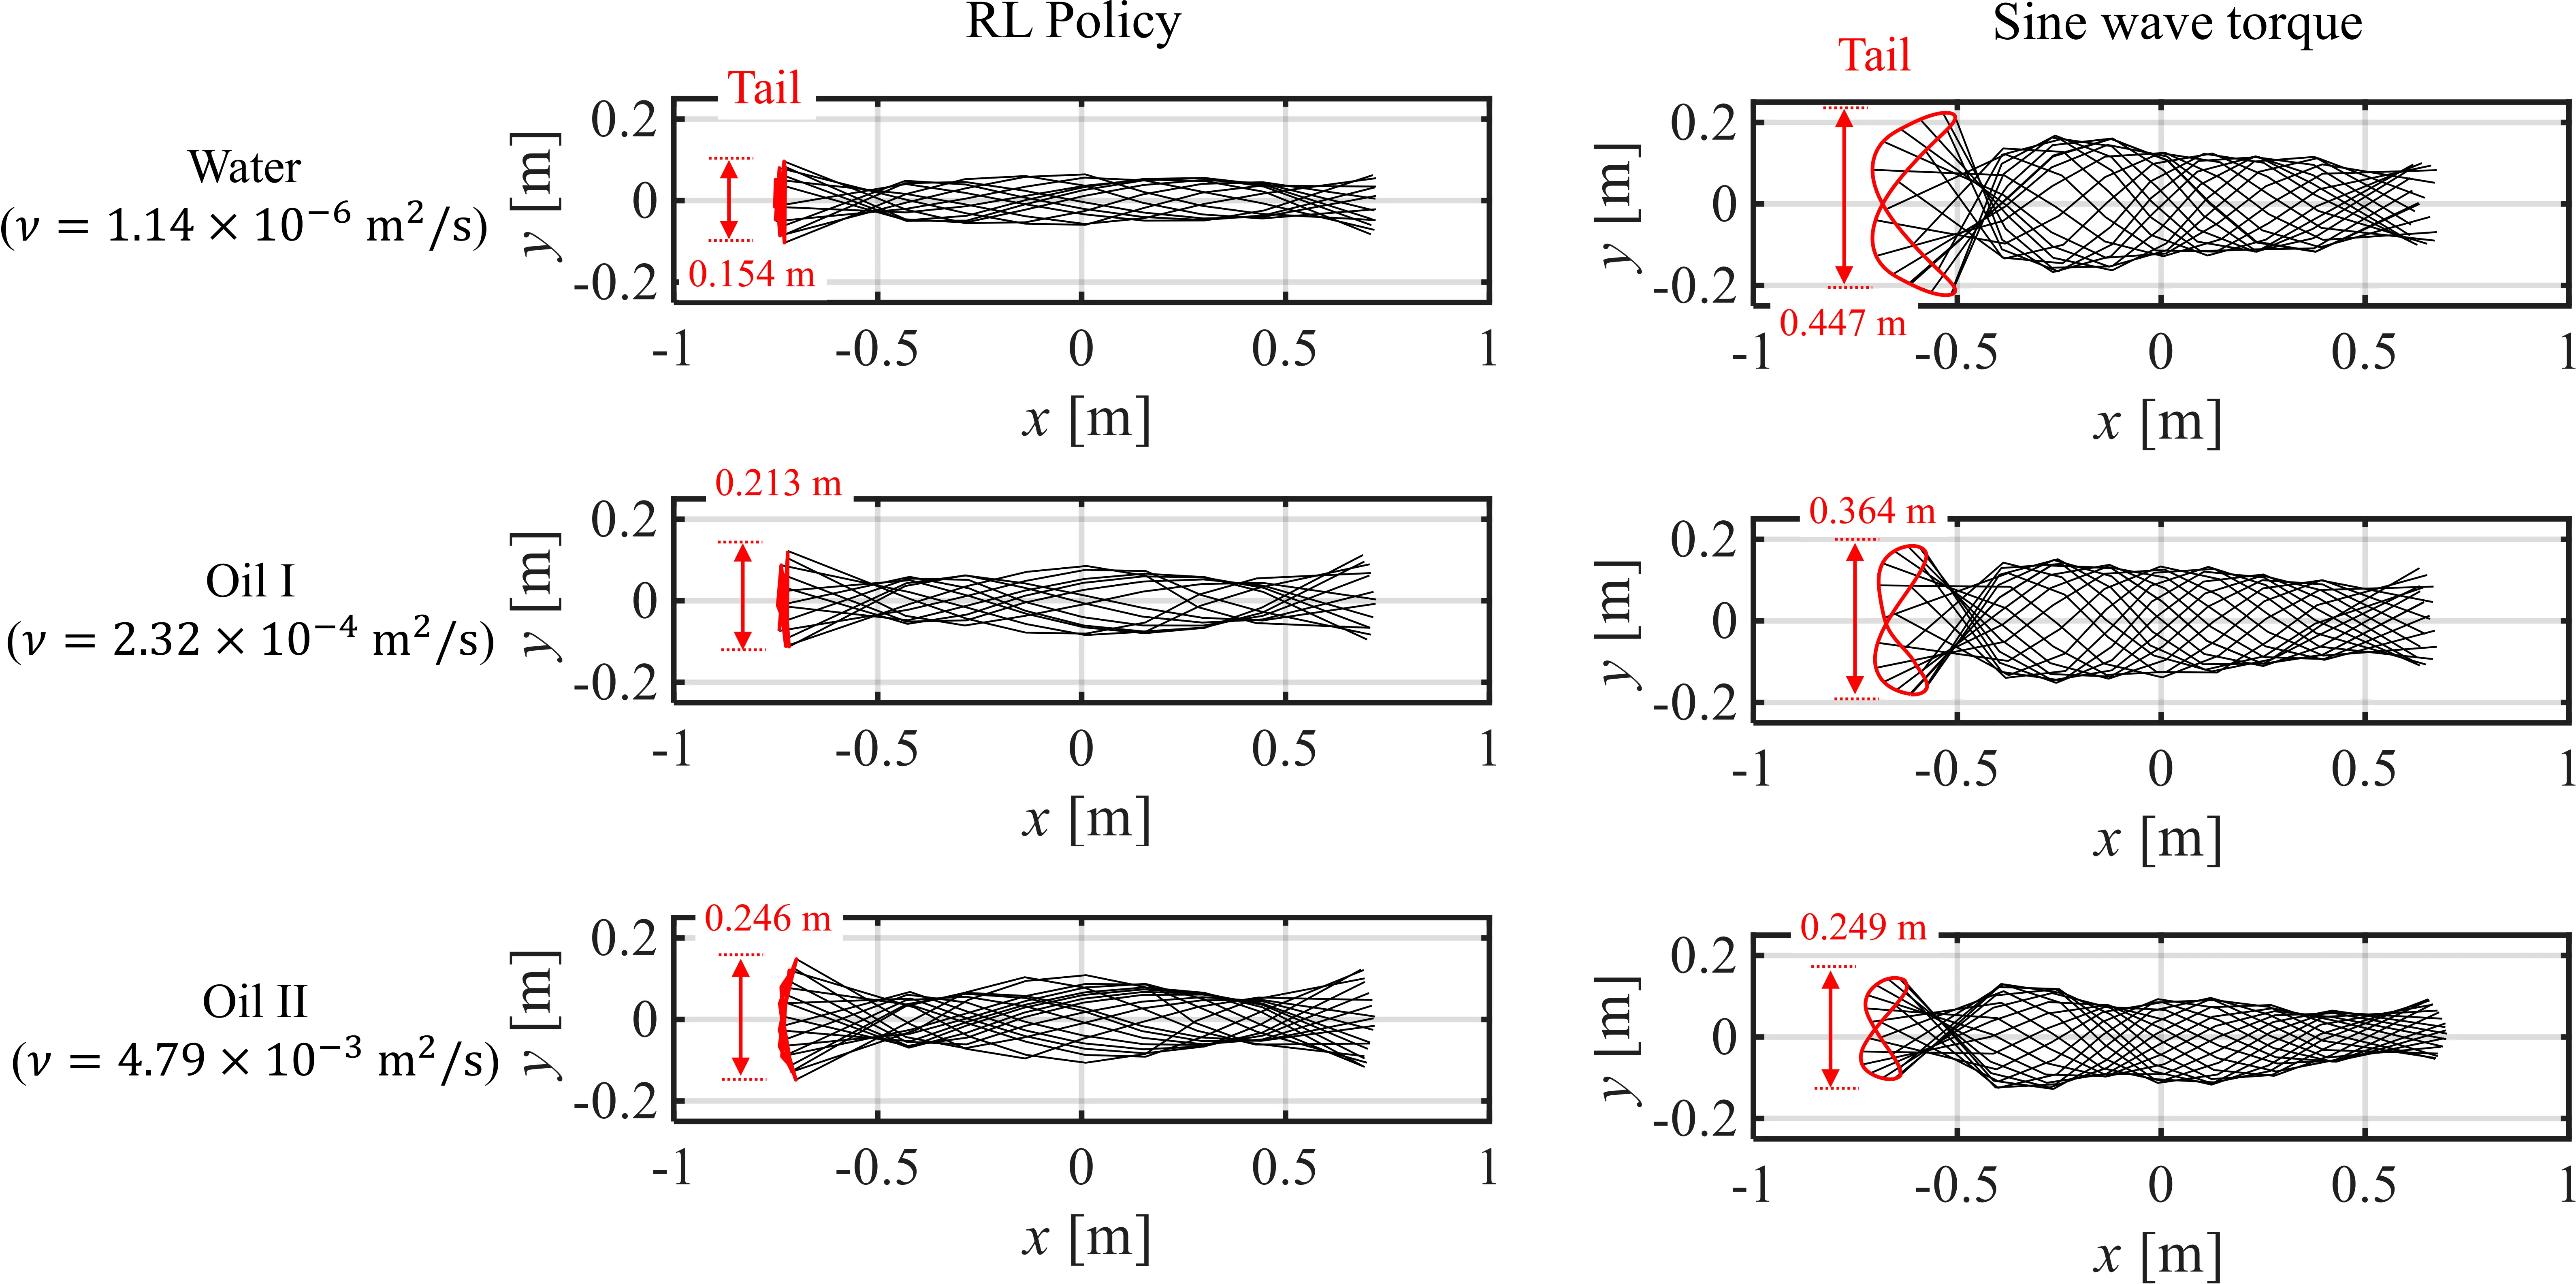
更有趣的是步态本身的质变分析。在高粘度流体中,DRL 策略自主学会了"降低摆动频率、增大尾部摆幅"的策略——这与线虫、水蛭等生物在粘性介质中的运动模式高度一致。从力学角度理解,频率降低意味着机体与流体之间的相对速度变化减缓,从而减少了粘性耗散;而更大的尾部弯曲在受限力矩下提供了足够的推进力。FFT 分析进一步确认了这一趋势。
的交叉测试矩阵(三种步态 × 三种流体)揭示了对角线元素的一致优势:当步态与其训练对应的流体匹配时,速度最高、CoT 最低;错配时性能显著下降。这直接证明了策略确实在"自适应调整"而非依赖某种万能波形。
讨论与可借鉴点
论文最重要的启示在于方法论层面:将物理上难以直接测量的环境参数(粘度)视为隐藏状态,通过[[知识蒸馏]]让智能体从特权信息中学习隐式推断,是一种绕过建模不确定性而非与之对抗的有效策略。这一思路在自动驾驶、机器人视觉控制等领域已有成功先例,如今被拓展到流体力学这一更具挑战性的领域,验证了范式迁移的可行性。
然而,仿真层面的局限同样值得重视。论文坦承防水罩的非线性摩擦和执行器延迟尚未在 sim-to-real 迁移中解决,而当前使用的经验公式+Oseen 近似拼接的流体力学模型与高保真 CFD 之间缺乏交叉验证。更重要的是,研究仅聚焦于前向推进这一单一目标,尚未涉及转向、轨迹跟踪或外部扰动流场下的鲁棒性验证。
从工程视角看,7 关节的固定配置和算力信息的缺失(GPU 型号、训练时长未披露)给复现工作带来了一定的不确定性。未来的延伸方向可能包括:更大规模的关节数消融、真实油槽实验验证、更复杂的异质流体条件(密度变化、温度梯度、障碍物)以及多目标权衡下的策略鲁棒性分析。
总体而言,这项工作在问题建模的严谨性和基线对比的系统性上都表现出色,为[[深度强化学习]]在流体交互类机器人控制中的应用提供了一个扎实的基础。
摘要
本文展示了深度强化学习(DRL)如何使蛇形机器人在动态变化的粘性环境中实现自适应运动,克服了经典预定义控制方法固有的性能局限性。由于缺少直接测量流体特性的板载传感器,需要将该任务建模为部分可观测马尔可夫决策过程。通过采用非对称 actor-critic 框架,利用仅在物理仿真器中可获取的特权信息训练的教师策略,将其知识蒸馏到仅依赖本体感知传感器信息的学生策略中。在广泛动态粘度变化范围( 至 m²/s)下的仿真结果表明,DRL 智能体自主学习到了非正弦的自适应步态。这些步态提高了推进速度与运输效率,突破了传统正弦运动学与运动控制方法的固有局限。研究结果表明,通过特权信息蒸馏进行隐式环境推断是绕过不可预测流体动力学下经典模型约束的有效方法。
Abstract
This paper demonstrates how deep reinforcement learning (DRL) enables adaptive locomotion of snake-like robots in dynamically changing viscous environments, overcoming the inherent performance limitations of classical predefined control methods. The lack of direct onboard sensors for fluid properties necessitates formulating this task as a partially observable Markov decision process. By employing an asymmetric actor-critic framework, a teacher policy trained using privileged information available only in the physics simulator distills its knowledge into a student policy that relies solely on proprioceptive sensor information. Simulation results across a wide range of dynamic viscosity changes ( to ) reveal that the DRL agent autonomously acquires non-sinusoidal adaptive gaits. These gaits improve propulsion velocity and transport efficiency, breaking the inherent limits of conventional sinusoidal and kinematic control. The findings establish that implicit environment inference via privileged information distillation is an effective approach to bypass the constraints of classical models under unpredictable fluid dynamics.
论文详细总结(自动生成)
论文总结:基于深度强化学习的蛇形机器人在动态粘性环境中的自适应波动运动
1. 核心问题与研究动机
蛇形机器人在水下探索(如洪涝基础设施、泥泞灾害现场等异质环境中)具有重要的应用价值。然而,其波动推进性能严重依赖于流体运动粘度 ,而该参数在实际场景中会随温度、杂质等因素发生时空连续变化。
传统方法面临三重根本性挑战:
- 建模困境:基于 Navier-Stokes 方程的模型控制计算量过大,无法实时生成动作;
- 感知困境:紧凑型蛇形机器人无法搭载粘度计等流体测量设备;
- 规划困境:基于 Serpenoid 曲线或正弦力矩的预定义步态(以及 CPG 周期性波形)无法灵活适应连续未知的流体变化;同时,推进速度本身也无法被本体传感器直接测量,存在"需要粘度才能估计流体阻力、又要估计流体阻力才能估计速度"的循环依赖。
因此,论文将核心问题定义为:蛇形机器人在流体运动粘度未知且时变条件下的实时自适应波动运动控制。
2. 方法论
2.1 POMDP 建模
将任务建模为确定性 POMDP,记为 。其中:
- 状态 :包含关节角 、关节角速度 、关节力矩(可观),以及流体运动粘度 与质心平移速度 (不可观,是核心隐藏变量);
- 动作 :7 个关节的目标角度构成的 7 维连续向量;
- 转移 :由 NVIDIA Isaac Sim 中的流体-结构耦合仿真实现,输出下一时刻姿态与速度。
2.2 关节动力学模型
PD 控制器生成指令力矩:
再叠加虚拟扭转弹簧与阻尼器(表征防水罩的被动阻力):
其中 ,,,。
2.3 非对称 Actor-Critic 框架(核心创新)
采用两阶段学习:
- 教师策略 :在仿真器中使用特权信息(运动粘度 与头部线速度 )训练,算法为 PPO;
- 学生策略 :通过 MSE 损失从教师蒸馏,仅依赖本体感知(关节角、角速度、输出力矩、头部角速度、上一步动作),部署时不需任何外部传感器。
教师与学生网络结构一致:2 层 MLP(各 64 单元)做特征提取,2 层 LSTM(各 128 单元)做时序处理,激活函数为 ELU。
2.4 奖励设计
各项权重为:,,,,,(终止惩罚阈值 )。
2.5 域随机化
每个回合的运动粘度 在 间随机采样,覆盖水到高粘油的整个跨度。
3. 实验设计
3.1 仿真环境
- 仿真平台:NVIDIA Isaac Lab v0.41.1 + Isaac Sim v4.5.0;
- 流体力学模型:每段杆件所受总力
分别为附加质量力、压差阻力()、粘性阻力(含边界层压缩效应);
- 阻力系数 按 Reynolds 数分段定义: 时按圆柱绕流经验公式,低雷诺数区使用 Oseen 方程 Lamb 解平滑连接。
3.2 对比基线
- SOO(单目标优化):基于海蛇运动学模型 的 TPE 贝叶斯优化,最大化综合奖励;
- MOO(多目标优化):基于正弦力矩控制 的 Pareto 前沿求解,代表传统正弦控制的性能上界;
- 标准对称 DRL:不使用特权信息,仅以本体感知训练,作为消融对比。
3.3 测试场景
3 种代表性流体:水()、Oil I()、Oil II()。
3.4 评估指标
- 推进速度 (基于两周期间隔位移除以时间);
- 平均功耗 ;
- 运输成本 ;
- 摆动频率 (FFT 分析第 7 关节角度时序)。
4. 资源与算力
论文未明确说明所用 GPU 型号、数量以及训练时长。文中仅提及:
- 使用 NVIDIA Isaac Lab/Isaac Sim(GPU 加速仿真框架);
- 使用 RSL-RL v2.0.2 作为训练库;
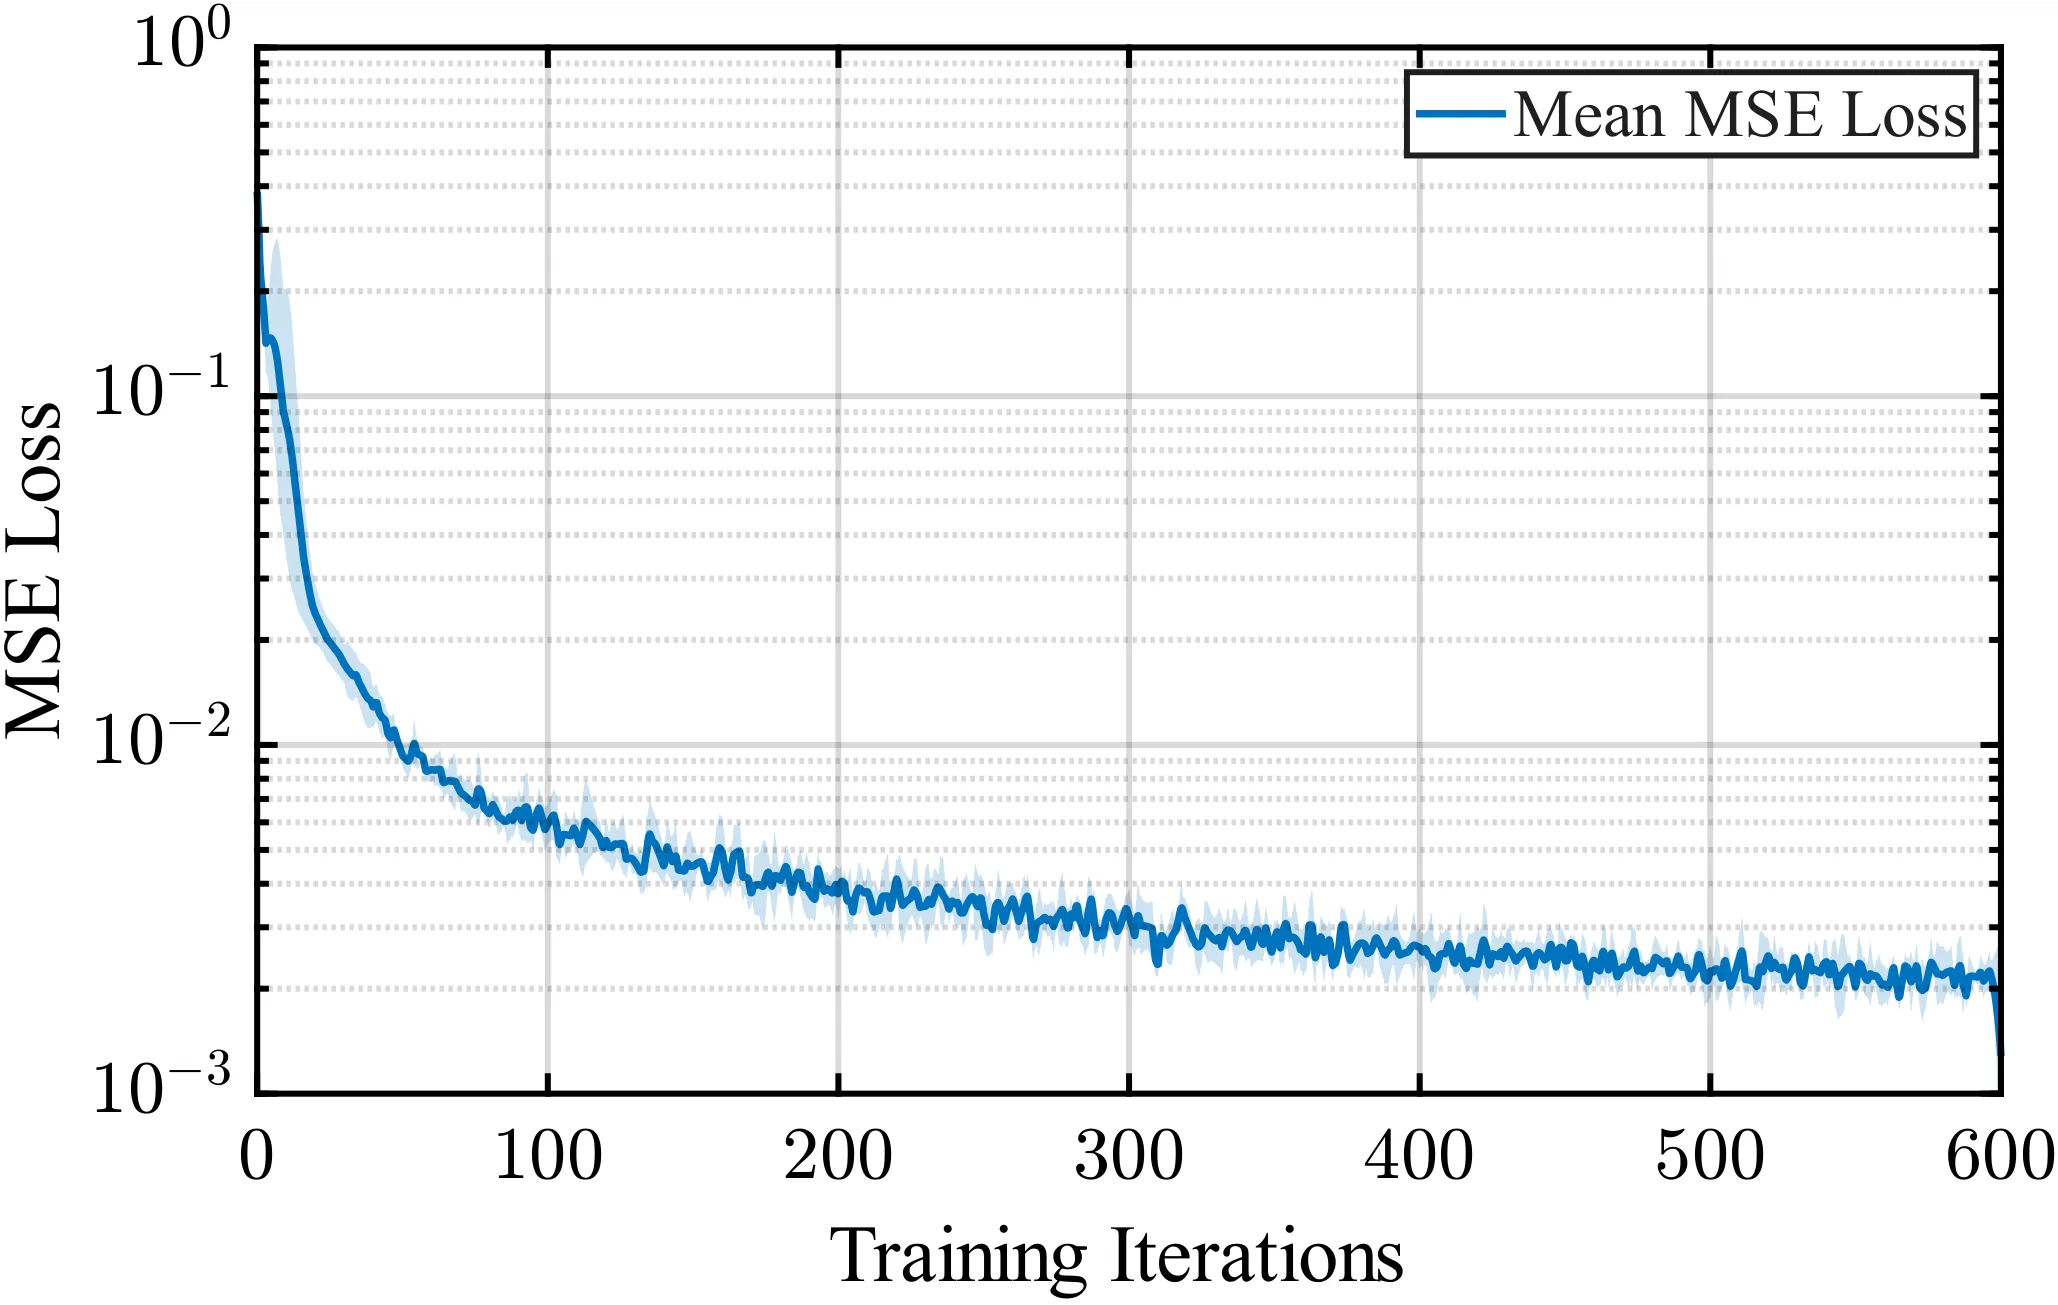
- 学生蒸馏阶段约 600 次迭代后 MSE 收敛;
- 训练与评估在 5 个独立随机种子下进行。
具体计算硬件配置、每次训练的 wall-clock 时间未在文中披露,存在一定的复现成本评估盲点。
5. 实验数量与充分性
- 训练收敛实验:1 组 PPO 训练 + 1 组对称 DRL 对比 + 1 组蒸馏曲线(图 3);
- 基线对比:3 个环境(水、Oil I、Oil II)下与 SOO、MOO 的 Pareto 前沿对比,含 Integrated MOO、Simple Sum MOO 两层基线(图 4);
- 步态可视化:3 种流体下的稳态运动快照对比(图 5);
- 时序分析:3 种流体下 7 个关节的力矩时序(图 6);
- 跨环境适应验证: 组交叉测试矩阵(表 8);
- 统计方法:5 个独立随机种子,所有曲线给出均值±标准差。
整体实验设计较为系统,涵盖训练动力学、对比基准、跨环境泛化与步态可视化四个维度。但仍局限在仿真层面,未提供任何真实硬件数据或 sim-to-real 验证。
6. 主要结论与发现
1. 必要性结论:标准对称 DRL 平均奖励仅约 50(难以学到有效步态),而所提非对称框架收敛至约 170,证明在部分可观测条件下特权信息蒸馏不可或缺;
2. 性能突破结论:在三种流体下,所提方法的推进速度与 CoT 超过对应环境的 MOO Pareto 前沿与 SOO 海蛇运动学方法,超越理想自适应正弦控制(Simple Sum MOO);
3. 步态发现:在高粘环境下,DRL 自主学到"降低摆动频率、增大尾部摆幅"的策略,与生物(线虫、水蛭、肺鱼)的实证行为相似;
4. 机理解释:频率降低减少瞬时粘性阻力,使尾部在受限力矩下能实现更深弯曲从而保证足够推力;
5. 跨环境验证:表 8 显示对角线元素(即"自适应步态匹配对应流体")始终取得最高速度与最低 CoT,错配时性能显著恶化,证实了策略确实是在自适应调整步态而非泛化的单一波形。
7. 优点
- 问题建模严谨:将流体粘度与速度视为隐藏变量后自然转化为 POMDP,理论与工程衔接自然;
- 跨学科融合:将"特权信息蒸馏"范式从自动驾驶、视觉控制领域推广到蛇形机器人粘性流体推进问题上,方法论层面有迁移价值;
- 对比基线扎实:SOO 与 MOO 的 Pareto 前沿组合提供了"单点最优 vs 性能上限"两维度对照,避免单基线偶然性;
- 跨环境矩阵清晰刻画了步态与流体的耦合关系,论证严谨;
- 奖励工程精细:对终止惩罚、权重衰减做了详细分析,避免策略坍缩。
8. 不足与局限
- 完全仿真验证:未进行任何真实水池/油槽实验,sim-to-real 风险显著(文中也坦承防水罩非线性与执行器延迟尚未解决);
- 算力信息缺失:GPU 型号、节点数、单次训练时长未披露,影响他人复现工作量评估;
- 隐藏变量集合有限:仅考虑运动粘度 变化,未涵盖流体密度 、温度场非均匀、障碍物等更复杂异质条件;
- 节数固定为 7:作者自评指出更多节数可能带来进一步提升,但未做节数消融;
- 未涉及鲁棒性测试:未测试外部扰动流场、非平稳粘度切换率、传感器噪声或延迟对策略的影响;
- 离散化与简化:流体力学为经验公式+Oseen 近似拼接,未与 CFD 高保真仿真进行交叉验证,可能放大或缩小某些粘度区间的差距;
- 轨迹跟踪能力缺失:仅追求前向推进速度,未验证曲线/转向等任务场景下的适应性;
- 偶发依赖奖励工程:权重 、 等参数较敏感,作者也提及逐步衰减 防止过拟合低粘区,但缺乏消融敏感性分析。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。