
📝 TLDR
多智能体通过静态或时变网络协同学习共享MDP的最优Q函数,是去中心化强化学习的核心问题。现有方法难以兼顾通信效率与样本效率,通信开销往往随协作加速增益而增长。本文提出基于轮次的分布式方差缩减Q学习算法VRDQ,在每轮内结合局部Bellman最优算子估计与共识信息扩散。在静态与时变网络下均建立高概率有限时间收敛率,证明样本复杂度随智能体数量呈线性加速,且仅需Õ(1)通信开销,显著优于已有工作。
🧭 速览
现有去中心化Q学习方法难以同时获得通信效率与样本效率的协作加速,通信开销随加速增益增长。
提出VRDQ算法,按轮次执行:每轮内各智能体局部估计Bellman最优算子,再通过共识协议扩散信息,并引入方差缩减技术。
在静态与时变网络下均建立高概率有限时间收敛率,样本复杂度随智能体数线性加速,通信成本仅为Õ(1)。
VRDQ首次以Õ(1)通信实现样本复杂度的线性加速,显著降低分布式强化学习协作的通信负担。
🆚 方法对比
VRDQ (Variance-Reduced Diffused Q-learning)
- 收敛率Õ(1/√(NT)),对单智能体有线性加速
- 通信成本仅O(log²(NT)),对数级别
- 同时适用于静态和时变网络
- 局部算子估计与扩散解耦,分析简洁
- 依赖网络连通性及混合矩阵W的假设
- 限于表格型MDP,连续空间不适用
- 基于epoch的结构设计较为复杂
- 时变网络分析需额外正则性条件
Classical Q-learning (单智能体)
- 实现简单,无需智能体间通信
- 收敛性已被广泛理论证明
- 无协调开销,单智能体独立运行
- 收敛率Õ(1/√T)无协作加速
- 样本复杂度高,学习效率低
- 无法利用多智能体并行数据
Prior decentralized Q-learning/TD methods [2][5]-[8]
- 支持去中心化网络化RL框架
- 已有有限时间收敛分析结果
- 实现多智能体协作学习
- 通信成本随时间步数线性增长
- 有限时间界未体现协作加速
- 多为渐近收敛,非渐近分析不足
Centralized multi-agent RL [9]-[11]
- 集中协调便于理论分析
- 可实现协作带来的统计加速
- 需中央协调器,假设过强不实用
- 不适用于纯去中心化部署
- 存在单点故障,鲁棒性较差
本文核心提出VRDQ算法,相比单智能体Q-learning获得线性加速,同时相比现有去中心化方法和集中式方法,VRDQ以仅O(log²(NT))的对数级通信成本实现协作加速,并同时覆盖静态与时变网络,显著优于现有线性通信开销的方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 3 张)
展开查看 3 张图
TL;DR
这篇论文研究了多智能体通过通信网络协同学习共享[[马尔可夫决策过程|马尔可夫决策过程(MDP)]]最优[[Q学习|Q函数]]的问题。论文提出了名为VRDQ的分布式[[Q学习]]算法,其核心创新在于将局部方差缩减估计与共识信息扩散并行执行。理论分析表明,该算法在静态和时变网络下均能实现接近最优的 样本复杂度加速(其中 为智能体数、 为单智能体样本数),同时将通信开销控制在仅 的 poly-log 量级,显著优于已有工作中 的线性通信成本。
研究背景与动机
多智能体协同学习一直是[[去中心化强化学习]]领域的核心挑战之一。在许多实际场景中,多个智能体需要与同一个未知环境交互,通过交换信息来协作学习最优策略。这种设置具有重要的现实意义:智能体可能各自拥有有限的传感能力,但通过网络协作能够获得远超单智能体的学习效果。
然而,协作学习面临一个根本性的权衡:样本效率与通信效率之间存在张力。一方面,智能体数量越多,理论上能够获得的协作加速就越显著——每个智能体能否从单智能体的 收敛速度提升到 的线性加速?另一方面,通信本身需要消耗带宽和计算资源,已有方法往往难以在获得统计加速的同时控制通信开销,导致"提高精度必然伴随高额通信"的两难困境。
具体而言,现有去中心化[[Q学习]]方法存在两大不足。首先,许多工作的误差界中未能显式体现协作带来的统计加速收益,理论分析不够精细。其次,通信成本通常随时间步数线性增长( 级别),这在实际部署中构成了严重的瓶颈。论文的核心动机正是要同时解决这两个问题:在获得近最优样本复杂度的同时,将通信开销降低到仅与 、 成 poly-log 增长的量级。
方法
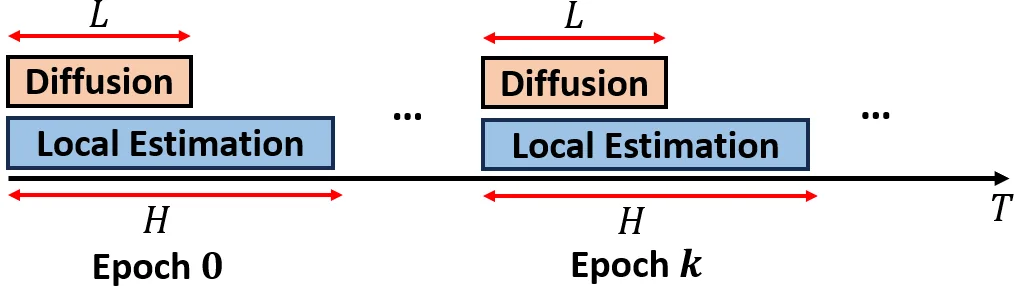
VRDQ算法的核心设计基于一个关键洞察:统计误差与网络诱导误差可以解耦处理。具体而言,算法采用基于轮次(epoch-based)的更新架构,每个轮次包含两个并行执行的模块。
局部方差缩减模块是算法获得高效样本复杂度的关键。在传统[[Q学习]]中,每一步都使用单样本高方差地估计[[贝尔曼最优算子]]。VRDQ则在一个轮次内积累 个样本,通过聚合这些样本来构造低方差的经验转移核估计:
从而得到方差大幅降低的Bellman算子经验版本。这种设计使得估计误差从单样本的 降低到 ,为整体算法的样本高效性奠定基础。
共识扩散模块负责在网络中的智能体之间同步信息。该模块在每个轮次的前 步执行平均一致性协议:
其中 是双随机通信矩阵, 初始化为上一轮次产生的更新方向 。经过 步扩散后,每个智能体获得的 都融合了全网信息,且扩散步数 仅需与网络谱性质 成对数关系。
这两个模块的并行执行(而非串行)是论文的重要创新。扩散过程仅占用轮次的前 步,而统计估计利用剩余的 步完成,两类误差在分析上相互独立。这种解耦设计使得算法既能享受方差缩减带来的样本效率增益,又能保持对网络拓扑变化(静态或时变)的鲁棒性。
最终的Q表更新在轮次末执行一次:
其中步长 与轮次数 、扩散步数 的选取都经过精心设计,确保在高概率意义下达到最优收敛速率。
实验与结果
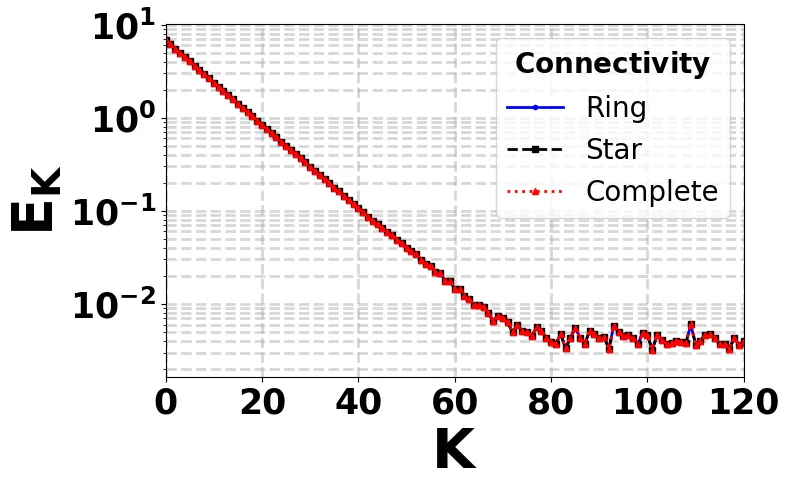
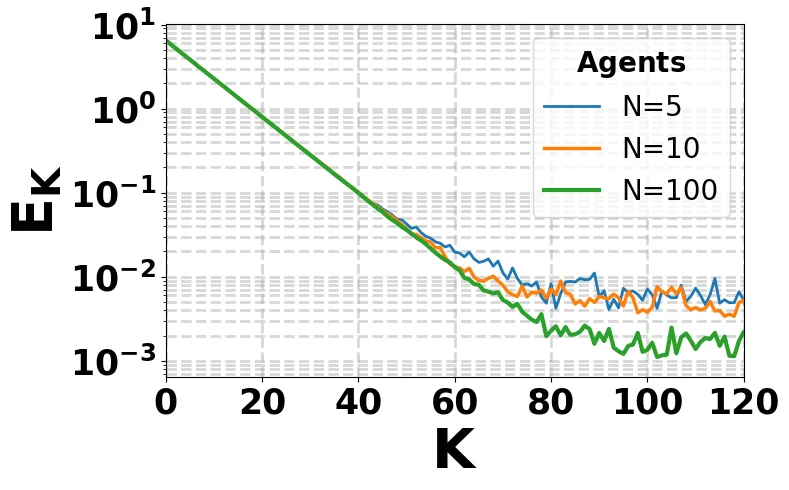
论文在合成网格世界上进行了验证性实验。环境设置为10个状态、5个动作的表格MDP,折扣因子 ,奖励范围 。实验主要从两个维度考察算法性能。
第一组实验改变智能体数量 (从较小值逐步增加到较大值),验证协作是否能够带来误差的线性下降。实验结果表明,随着 增大,所有智能体的平均 误差均呈现明显下降趋势,定性地验证了理论预测的 加速效果。
第二组实验固定 ,考察不同网络拓扑(完全图、环形、随机稀疏图等)对收敛速率的影响。结果显示,虽然不同拓扑所需的最小扩散步数 有所不同(这与理论中 的取值相对应),但最终的稳态收敛率与拓扑选择基本无关,进一步印证了理论分析中"拓扑仅影响热身阶段"的结论。
需要指出的是,该论文的实验属于概念验证(proof of concept)性质,仅在小型表格MDP上进行了示意性测试。论文未与已有去中心化[[Q学习]]方法(如QD-learning)进行端到端的数值对比,也未在实际通信量层面验证 通信开销的声明,实验的充分性和公平性相对有限。
讨论与可借鉴点
VRDQ论文在理论层面做出了重要贡献,首次在去中心化[[马尔可夫决策过程|马尔可夫决策过程]]设定下同时建立了线性样本加速与对数量级通信开销的有限时间高概率保证。这一结果的理论意义在于揭示了样本效率与通信效率并非不可调和——通过精巧的算法设计,两者可以实现近乎最优的平衡。
论文的分析框架也具有借鉴价值。将统计误差与网络误差解耦并行处理的思想,不仅适用于[[Q学习]],还可以推广到其他分布式策略评估或优化问题中。论文对时变网络的扩展(仅需将静态矩阵 替换为时变序列 )展示了方法的灵活性。
然而,该工作也存在明显的局限性。在应用层面,算法目前仅限于表格设定和同步生成式采样,对函数近似、异步采样、大规模状态空间等实践中的挑战场景尚未涉及。在实验层面,缺乏与同类方法的数值对比和实际通信开销的测量,理论声明的验证尚不完整。在假设层面,双随机、对称、primitive 的网络矩阵要求较为严格,部分实际网络(如稀疏P2P网络)可能难以满足。
尽管如此,VRDQ为去中心化强化学习领域提供了一种新的算法范式,其核心理念——通过方差缩减与共识扩散的并行化实现样本-通信双重效率——为后续研究指明了可能的方向。
摘要
我们研究了一个去中心化强化学习问题,其中多个智能体与同一马尔可夫决策过程(MDP)进行交互。智能体可以通过网络交换信息,以协同学习最优状态-动作值函数。针对该问题,我们提出了一种新颖的基于轮次的分布式 Q 学习算法,称为 VRDQ,在每个轮次内,智能体局部估计贝尔曼最优算子,并使用基于一致性的协议扩散信息。对于静态网络和时变网络,我们均建立了 VRDQ 的高概率有限时间收敛率,其因协作而获得了线性加速。关键的是,我们证明样本复杂度上的此类加速仅需 的通信成本,大幅优于现有工作中的通信开销。
Abstract
We investigate a decentralized reinforcement learning problem involving multiple agents that interact with the same Markov Decision Process (MDP). The agents can exchange information over a network to collectively learn the optimal state-action value function. For this setting, we introduce a novel epoch-based distributed -learning algorithm called VRDQ, where within each epoch, agents locally estimate the Bellman optimality operator and diffuse information using a consensus-based protocol. For both static and time-varying networks, we establish high-probability finite-time convergence rates for VRDQ that enjoy linear speedups from collaboration. Crucially, we prove that such speedups in sample-complexity require only communication, substantially improving upon the communication costs in prior work.
论文详细总结(自动生成)
论文总结:静态与时变网络下的方差缩减 Q 学习(VRDQ)
1. 核心问题与研究动机
论文聚焦于去中心化多智能体强化学习(Decentralized MARL)的样本效率与通信效率之间的张力。具体设置是:
- 个智能体共享同一个未知 MDP ,每个智能体通过生成式采样模型独立采集 个样本。
- 智能体通过(潜在时变的)通信网络 交换信息,目标是协同学习最优 Q 函数 。
- 关键问题:
- (i) 样本效率:通过协作,每个智能体能否从单智能体的 加速到 ?
- (ii) 通信效率:若能加速,所需通信开销是多少?
论文指出已有去中心化 Q 学习工作(如 QD-learning [Kar et al., 2013]、分布式 TD(0)/Q-learning [Doan et al., 2019; Heredia et al., 2020])存在两大不足:
1. 最终误差界中未显式体现协作带来的统计加速;
2. 通信成本随时间步数线性增长(),导致提高精度必然伴随高额通信开销,限制了实际部署。
本文的目标正是同时获得近最优的样本复杂度协作加速 ,并把通信开销降至 (即关于 、 仅 poly-log 增长),且覆盖静态与时变网络。
2. 方法论
2.1 核心思想
提出 VRDQ(Variance-Reduced Diffused Q-Learning),核心由两个并行模块组成:
- 模块一:局部算子估计(Variance Reduction):每个智能体在一个 epoch 内用 个样本聚合估计 Bellman 最优算子的低方差版本,而非每步都用单样本高方差估计;
- 模块二:共识扩散(Diffusion):在 epoch 的前 步并行运行平均一致性协议,扩散上一 epoch 产生的更新方向 。
由于估计阶段耗时远长于扩散阶段,两者并行执行(详见图 1),从而将统计误差与网络诱导误差解耦。
2.2 关键公式
Q 函数真值所满足的 Bellman 最优算子不动点:
传统单样本噪声算子(每步更新,方差高):
VRDQ 的低方差经验算子(每 epoch 一次,使用 个样本聚合估计转移核):
扩散协议(仅在 epoch 内前 步执行):
初始值 (按惯例 ),并且
Q 表更新(每 epoch 末一次):
2.3 超参数选择(Theorem 1)
算法 1 中的步长 、epoch 数 、扩散步数 选为:
其中 是双随机矩阵 的谱收缩常数(见 Fact 1)。
2.4 时变网络扩展(Theorem 2)
对满足标准 Assumption 1 的双随机时变矩阵序列 ,仅需将扩散过程替换为 驱动,且每个 epoch 扩散 步:
的取值与 类似,只是把 替换为 。
3. 实验设计
论文在第 V 节给出一个合成网格世界上的仿真验证:
- 环境:10 个状态、5 个动作的合成 MDP,折扣因子 ;
- 奖励范围:;
- 超参设置:步长 ,每个智能体时间步 ,失败概率 ;
- 度量: 平均误差 ;
- 左图:改变智能体数量 ,验证协作带来的误差下降;
- 右图:固定 ,对比不同网络拓扑对收敛速率的影响。
对比方法:文中并未明确列出 baseline 方法名称,主要是 VRDQ 在不同 与不同拓扑下的消融式自对比,强调协作增益与拓扑无关性这两条理论预测。
4. 资源与算力
论文未披露 GPU 型号、CPU 数量、训练时长或任何具体算力开销。由于实验规模仅为 、、 的小规模表格 MDP,估计在普通工作站上即可完成,未报告算力属于合理范畴。这是该论文实验部分的一个明显空白。
5. 实验数量与充分性
- 仅做了 2 组仿真(左:不同 ;右:不同网络拓扑,固定 ),附 1 张双面板图;
- 没有与已有去中心化 Q-learning 方法(如 QD-learning [Kar et al., 2013]、分布式 Q-learning [Heredia et al., 2020]、Lim & Lee 2025)做端到端的数值对比;
- 没有在更大规模 MDP 或异步/Markovian 采样下验证;
- 没有消融 epoch 长度 或扩散步数 的影响;
- 没有对通信开销(实际通信量)做实验测量,仅停留在理论 的声明层面。
总体看,实验仅作为理论的示意性验证(proof of concept),充分性和公平性较弱,不足以替代全面的数值基准比较。
6. 主要结论与发现
Theorem 1(静态网络):在 Theorem 1 给定的参数选取下,VRDQ 以至少 的概率满足:
这给出三个核心发现:
1. 近最优的协作加速:,与单智能体 相比获得关于 的线性加速,达到集中式/联邦式方法的最佳统计效率(在 多项式因子内)。
2. 通信成本对数化:总通信量 ,相对已有工作 的通信成本是数量级提升。
3. 网络拓扑仅影响"热身"阶段:稳态收敛率与拓扑无关,但 决定了所需的最小扩散步数 ,进而要求 不小于某下界。
Theorem 2(时变网络):在 Assumption 1 下 VRDQ 保持完全相同的 收敛界,且通信开销仍为 poly-log( 关于 为对数量级),其中 与 无关(但可能与 相关)。
7. 优点
- 方法层面:
- 将"方差缩减 + 共识扩散"解耦并行,是该论文最核心的算法创新,使得统计误差与网络误差的分析相互独立;
- 不需要中心协调器,兼容静态和时变网络,覆盖面广;
- 算法结构简单:仅 次更新,每 epoch 仅 步扩散;
- 理论层面:
- 在表格 MDP、同步生成式采样下,首次同时给出线性样本加速与对数量级通信的有限时间高概率保证;
- 三个 Lemma(boundedness、diffusion error、estimation error)的组合分析清晰、可推广;
- 时变网络的扩展保留了完整结论,是相对 [Kar et al., 2013] / [Doan et al., 2019] 等静态假设工作的一般化;
- 形式化:结论形式简洁,依赖标准混合矩阵谱性质与次高斯集中不等式,便于后续工作复现和拓展。
8. 不足与局限
- 实验严重不足:仅有 1 个合成 10 状态环境的 2 组示意图,缺乏与同类算法的端到端数值对比,结论难以独立验证;
- 通信开销未实测:理论上 的结论没有在仿真中通过实际消息计数/比特数验证;
- 设置局限:仅考虑表格 + 同步生成式采样,而实践中更常见的 Markovian / asynchronous sampling、函数近似、大规模状态空间均未涵盖(作者在 Remark 1 与 Conclusion 中已明确承认);
- 网络假设较强:双随机 + 对称 + primitive 矩阵 ;时变网络需满足 Assumption 1 的有限一致性窗口 ,某些实际网络(如稀疏、间歇式、P2P)可能不满足;
- 拓扑影响仅隐式:、 等网络常数会反向约束所需最小 ,但未给出不同 下的实际容忍度;
- 奖励函数假设为确定性: 无噪声,但实际场景常含噪声奖励;
- 算力/可复现信息缺失:未提供代码、种子、超参搜索协议或硬件说明。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。