
QLPO:面向长度感知策略优化的象限加权采样方法
QLPO: Quadrant-weighted Sampling for Length-aware Policy Optimization
📝 TLDR
大型推理模型在强化学习后易产生超长链式思维响应,推高推理延迟与部署成本。现有长度控制方法依赖显式惩罚或额外模块,调参繁琐且可能损害推理质量。本文提出QLPO——一种基于重采样的GRPO变体,通过过采样再按象限加权筛选,无需修改奖励即可隐式引导短输出。在1.5B至32B参数模型上一致将响应长度压缩30%–70%,同时保持推理精度,为高效推理训练提供了简洁而稳健的新路径。
🧭 速览
大型推理模型长CoT响应带来高延迟与部署成本;现有长度控制方法依赖显式惩罚或额外控制模块,需精调且可能损害推理质量。
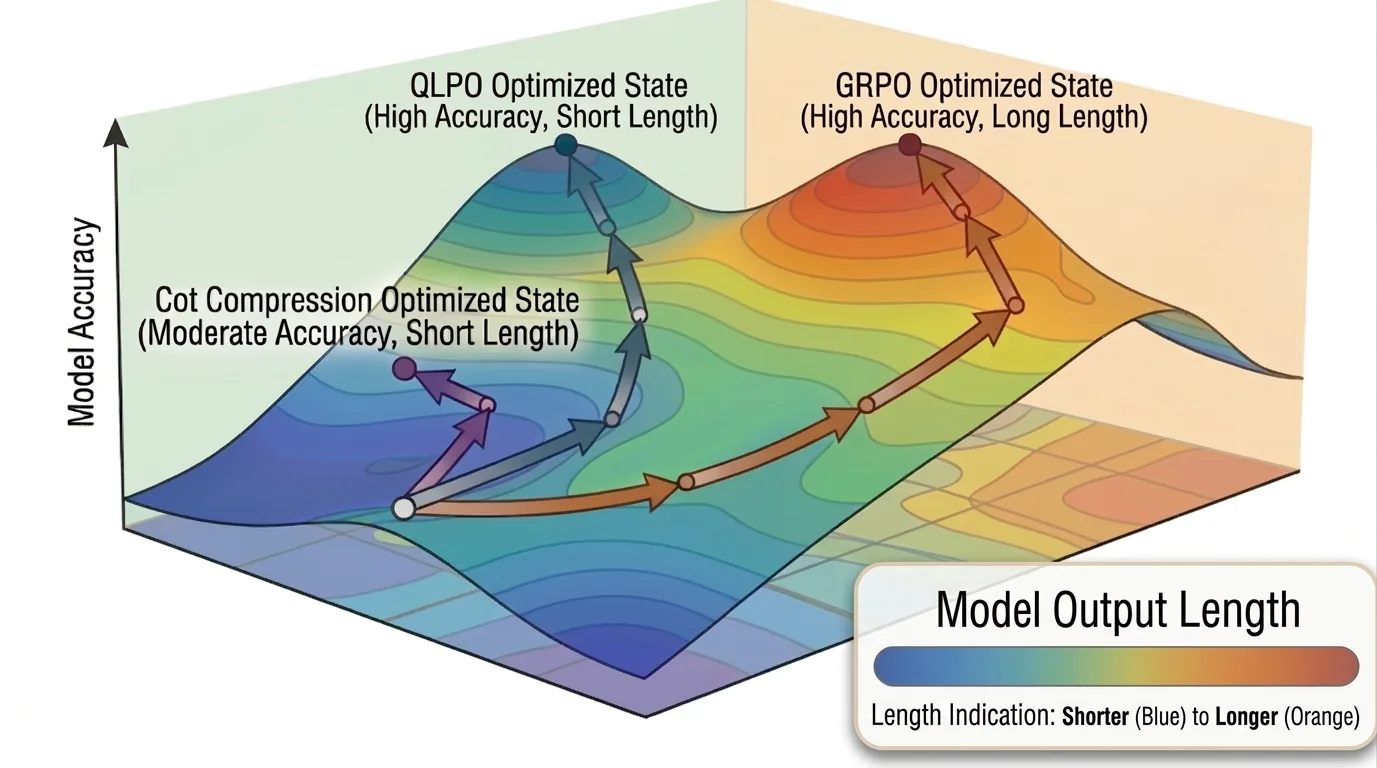
QLPO是GRPO的重采样变体:过度生成候选响应后,按正确/错误比例进行象限加权重采样,偏好短正确与长错误样本以隐式压缩输出。
在1.5B至32B参数基座与强推理模型上,响应长度减少30%–70%,精度-长度权衡一致改善,推理性能基本无损。
结构化重采样为高效推理提供了一种无需修改奖励函数、稳健有效的隐式长度控制新范式。
🆚 方法对比
QLPO
- 响应长度减少30%–70%同时保持推理性能
- 不修改奖励函数和优势估计器,实现简单
- 在1.5B到32B基础与推理模型上均有效
- 象限采样保留正/负样本贡献,保护复杂任务能力
- 需过生成K个候选响应,增加rollout计算开销
- 依赖正确答案信号的正确判别
- 正确率/长度权衡的边界条件仍待进一步理论分析
GRPO
- 通过分组采样估计优势,无需critic模型
- 促进长链思维推理,提升自反思与复杂任务能力
- 被广泛使用的成熟RL算法基础
- 纯正确奖励驱动,引发长度爆炸现象
- 产生大量冗余token,推理成本过高
- 缺乏长度感知机制,输出过于冗长
GRPO with length penalty
- 显式引入长度惩罚可直接控制输出长度
- 思路直观,易于在现有框架中集成
- 惩罚系数需精细调参,调不好会扭曲RL目标
- 在需要深度推理的难题上性能急剧下降
- 属于奖励hack,可能损害推理质量
GFPO
- 采用启发式重采样策略过滤样本
- 在特定场景下选择最短响应可提升效率
- 忽略错误样本的负梯度贡献,可能适得其反
- 存在泛化挑战,在某些情况下推理效率更差
- 缺乏对正确性的细致区分机制
QLPO通过象限加权重采样在不修改奖励函数的前提下隐式控制长度,兼顾效率与推理质量;GRPO存在长度爆炸问题,GRPO加长度惩罚调参困难且损害推理能力,GFPO忽略负梯度导致泛化性差,QLPO在精度-长度权衡上全面优于这些对比方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
TL;DR
QLPO(面向长度感知策略优化的象限加权采样)是一种基于重采样的强化学习方法变体,通过过采样候选响应后按"正确/错误×短/长"四象限加权筛选,无需修改奖励函数即可隐式压缩模型输出长度。在1.5B至32B参数模型上的实验表明,QLPO能在保持甚至提升推理准确率的同时,将响应长度缩减30%至70%,为解决大型推理模型的"长度爆炸"问题提供了一条简洁且鲁棒的技术路径。
研究背景与动机
近年来,以DeepSeek-R1、OpenAI o系列为代表的大型推理模型在数学推理、代码生成、Agent任务上展现出令人瞩目的能力。这些模型通常采用[[强化学习]]算法(如GRPO)进行训练,通过大量的思维链(Chain-of-Thought)探索来提升推理质量。然而,一个显著的副作用随之而来——模型倾向于生成包含数千个冗余token的长思维链响应,导致推理延迟高、部署成本急剧攀升,成为制约这类模型大规模落地的关键瓶颈。
面对这一挑战,现有解决方案大致可分为两类。第一类是显式的长度惩罚,即在奖励函数中加入长度相关的正则项,惩罚过长的输出。这类方法需要精细调节惩罚系数,且过强的惩罚可能扭曲[[强化学习]]的优化目标,在复杂推理任务上损害模型质量。第二类是设计额外的控制模块或步级/段级控制器,这类方案通常设计复杂、超参数敏感,增加了训练 pipeline 的负担。
一个看似更简洁的思路是重采样——在训练过程中只保留"最好"的响应来更新策略。GFPO(Good First Policy Optimization)就是这样一种方法,它仅选择每个问题组中最短的正确响应。然而,论文通过理论分析和实验发现,这种策略在某些情况下反而会加剧长度问题:当负优势的样本在token级别具有更高"质量"时,单纯选择最短正确响应会导致token级平均优势为负,从而抑制短响应的学习。
这些观察促使论文作者转换思路:从"显式奖励塑形"或"经验式过滤"转向"结构化数据重采样",在不修改奖励函数的前提下隐式引导模型生成更短的输出。
方法
QLPO的核心设计围绕一个关键洞察展开:在[[强化学习]]训练中,梯度同时承载着正确性信号和token级实现两个层面的信息。论文提出了组级-轨迹级两层梯度分解框架:组级优势决定了优化的方向(向正确还是向错误),而轨迹级的token梯度决定了该方向如何被参数化实现。这意味着,如果我们只改变采样的轨迹而不改变优势估计,那么组级正确性信号得以完整保留,只是改变了这些信号如何被参数落实。
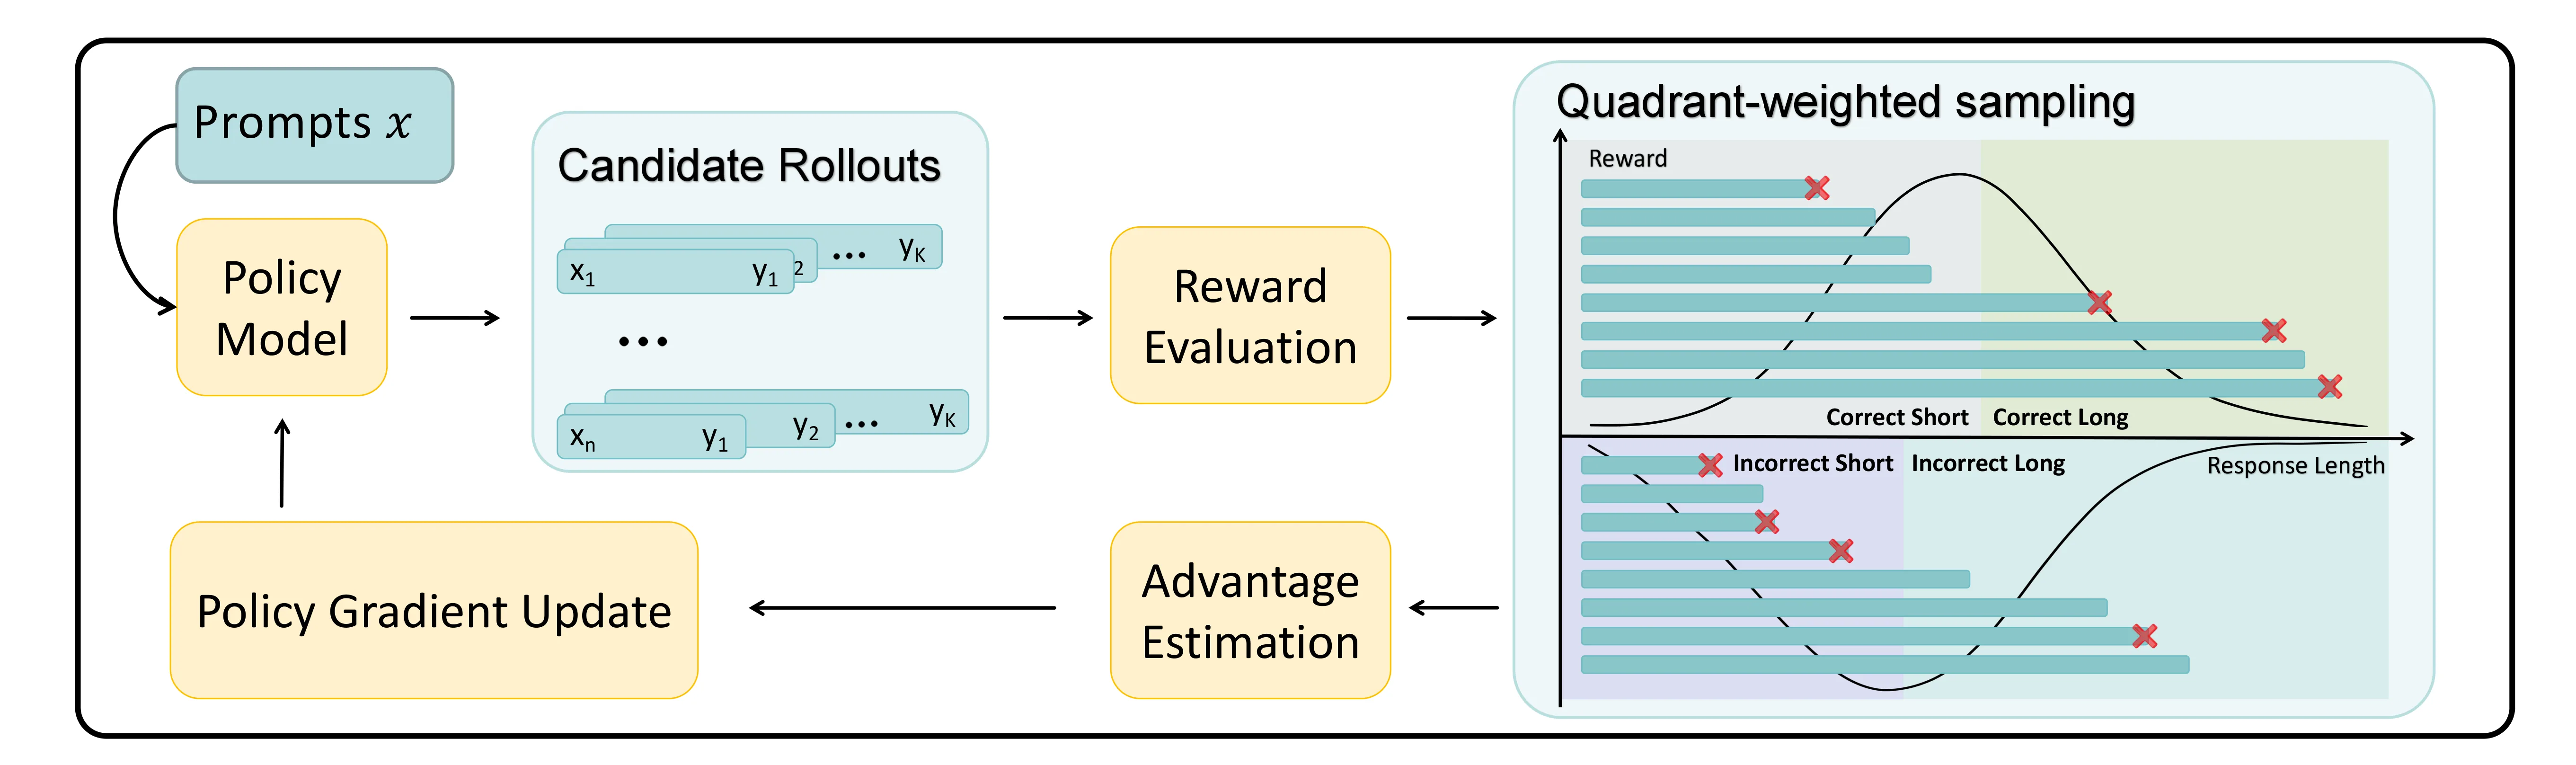
基于这一洞察,QLPO对每个prompt 执行以下操作流程。首先是过采样阶段:从旧策略采样个候选轨迹,构成候选池 。这里的大于最终使用的样本数,为后续筛选提供足够的候选空间。
接下来是正确性划分。将候选池拆分为正确响应集 和错误响应集 ,分别包含 和 个样本。关键设计在于比例保持:根据候选池中的经验正确/错误比例来确定最终训练组的构成,即
这一约束确保了重采样不会扰动组级的正确性信号。
随后在每个正确性类内按长度排序,将样本对半拆分为"短"和"长"两组,由此形成四个象限:Correct Short、Correct Long、Incorrect Short、Incorrect Long。论文引入长度偏好系数 来控制象限间的采样权重。设 决定了对短正确响应和长错误响应的相对偏好:
这意味着在正确响应中更倾向于选短的,在错误响应中更倾向于选长的。各象限内部则均匀采样,最终凑齐条轨迹组成训练组。
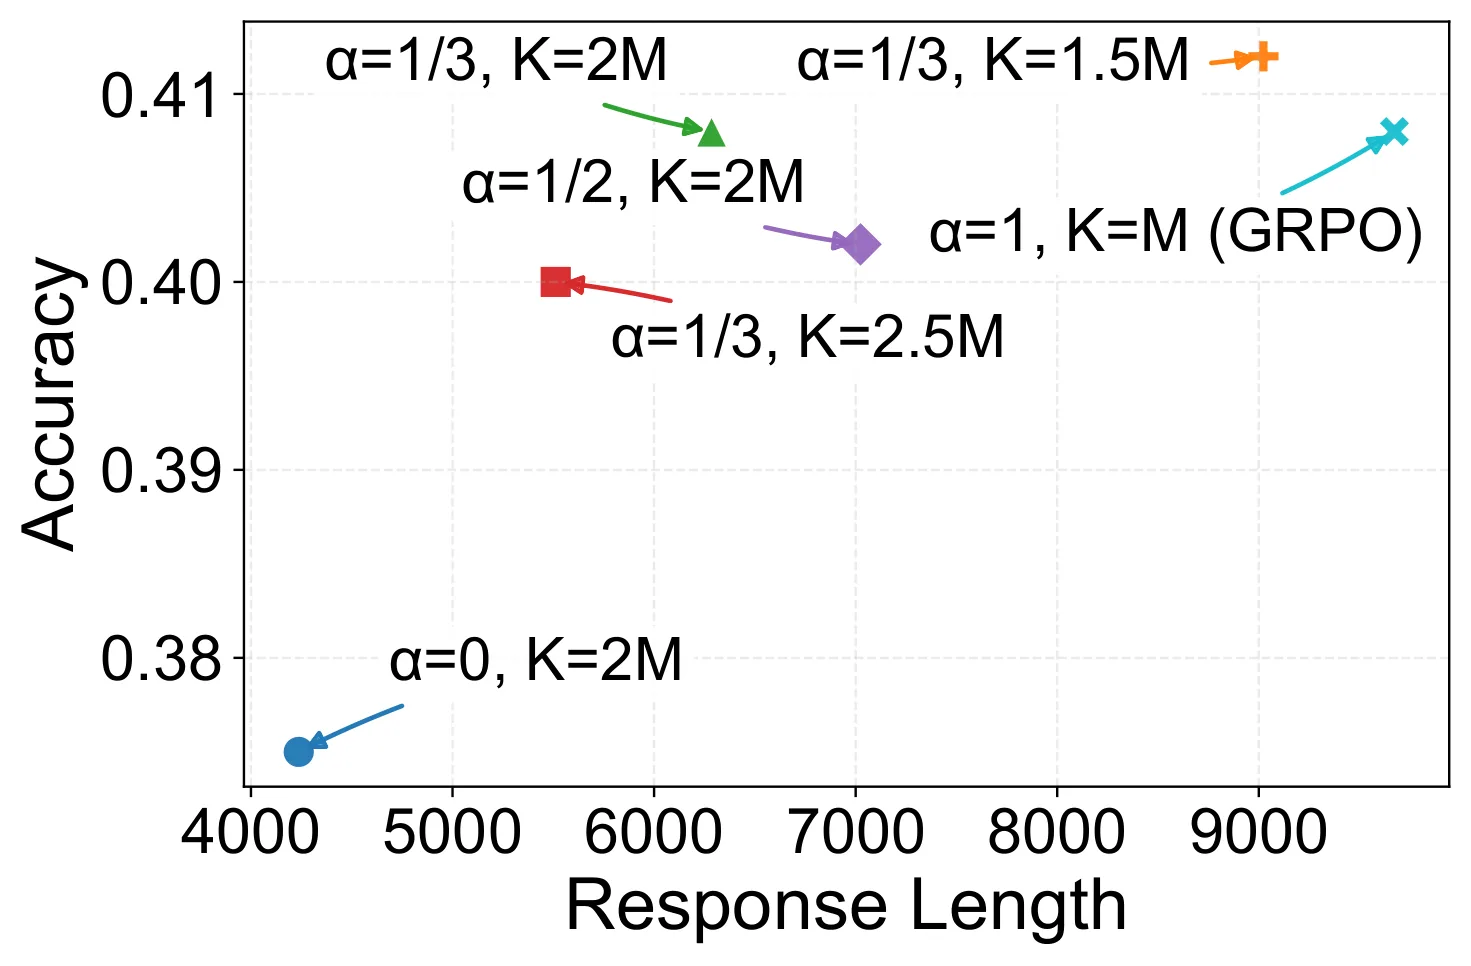
这个设计的精妙之处在于"短正确、长错误"的组合策略。选择较短的正确响应让模型学习到更简洁的推理路径;保留较长的错误响应则维持了对复杂推理空间的一定探索,避免过度压缩导致推理能力退化。当时,QLPO退化为标准GRPO;当时策略过于激进,可能损害模型的长程推理能力;论文默认采用,在长度压缩与推理质量之间取得了良好平衡。
与显式长度惩罚相比,QLPO不重新计算优势,避免了改变梯度符号和量级的风险;与GFPO相比,比例保持约束防止了组级正确性比例被扰动,且避免了token级平均优势为负时的反向效果。
实验与结果
论文在多种模型和任务上进行了全面验证。文本推理主实验涵盖1.5B到32B参数规模,包括Qwen2.5-3B、Qwen2.5-32B、Qwen3-30B-A3B(MoE架构)、DeepScaleR-1.5B-Preview以及DeepSeek-R1-Distill-Qwen-7B,训练数据涵盖MATH-lighteval和DAPO-MATH。评测基准包括GSM8K、MATH-500、OlympiadBench、GPQA和AIME 2024五项任务,既有相对简单的数学题也有高难度的竞赛级别问题。
核心结果呈现出一致的模式:在所有测试设置中,QLPO均实现了准确率与响应长度的同时改善。具体而言,DeepScaleR-1.5B在OlympiadBench上将平均输出长度从17138 tokens压缩至6621 tokens,降幅达61.4%,而准确率保持持平;Qwen2.5-3B在GPQA上长度缩减67.6%,从2225 tokens降至721 tokens;即便是参数规模较大的Qwen2.5-32B,在OlympiadBench上也实现了37.9%的长度压缩,从1397 tokens降至867 tokens。整体来看,30%至70%的压缩幅度在所有测试单元上普遍成立。
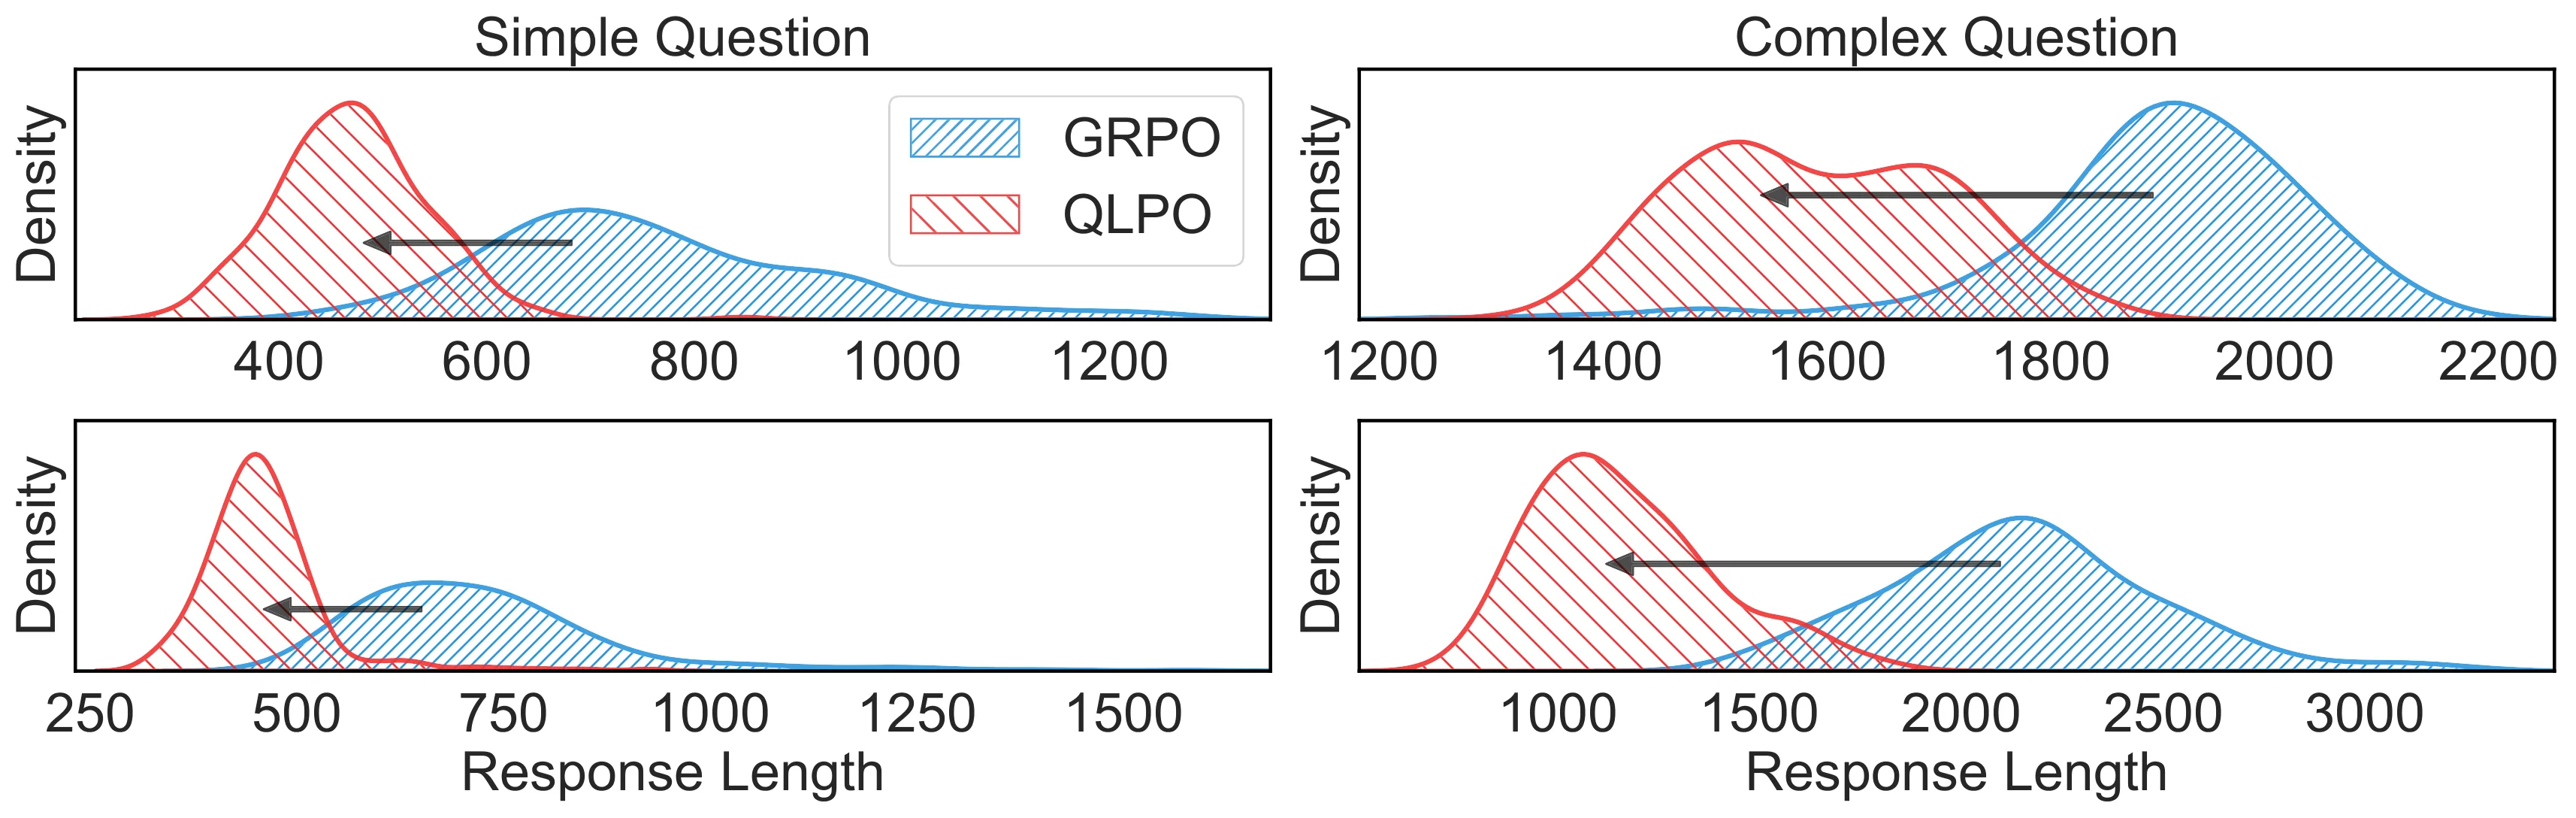
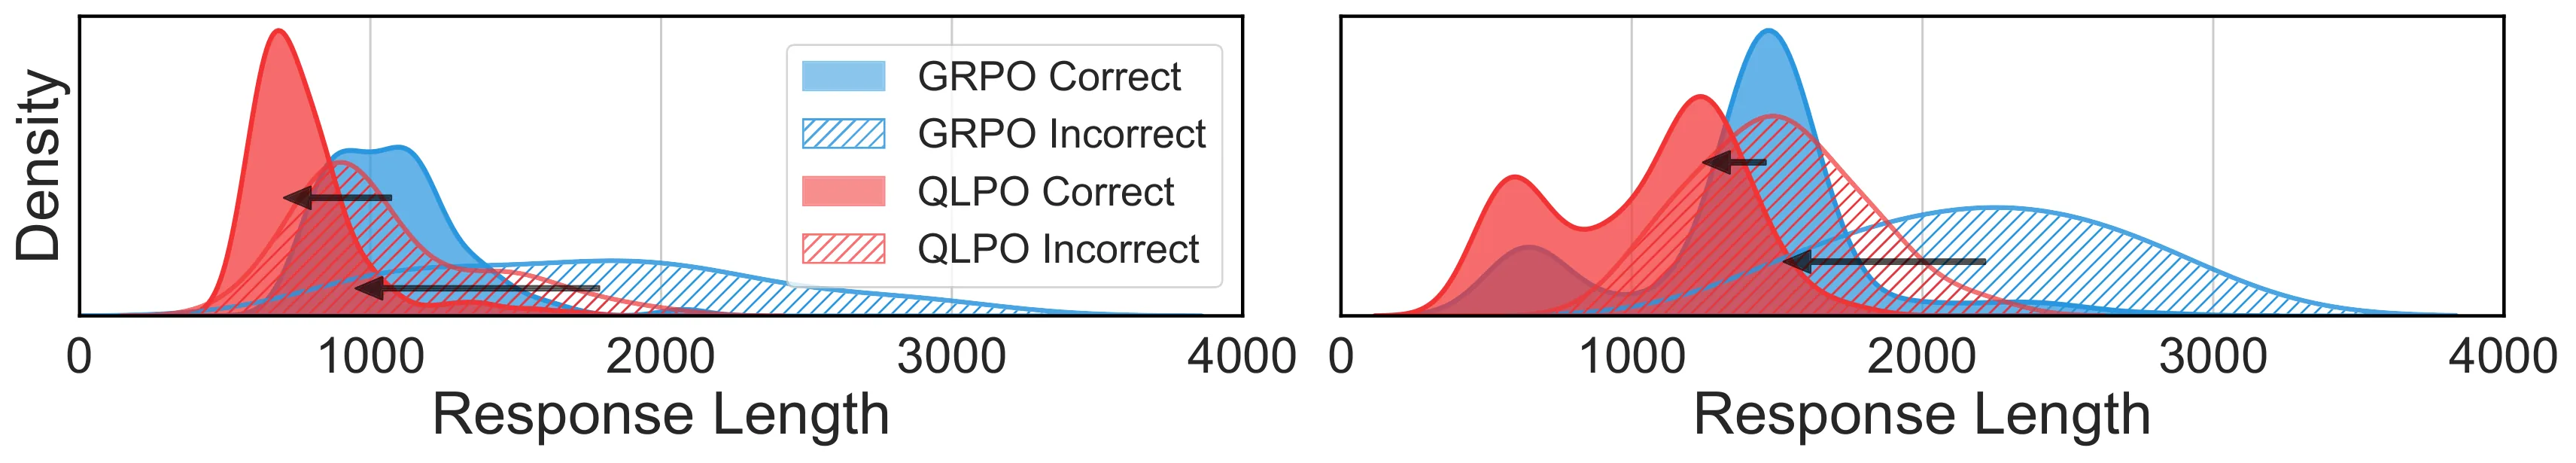
值得注意的是,长度缩减并非简单截断。论文的分布分析显示,错误轨迹长度平均下降约38%,正确轨迹下降约23%;无论问题难度高低,压缩幅度均在30%至38%之间,说明压缩来自对冗余表达(如重复陈述、过度口头脚手架)的系统性去除,而非对长推理链的粗暴截断。样例分析进一步证实,QLPO保留了关键中间推理步骤,仅移除了低价值的填充内容。
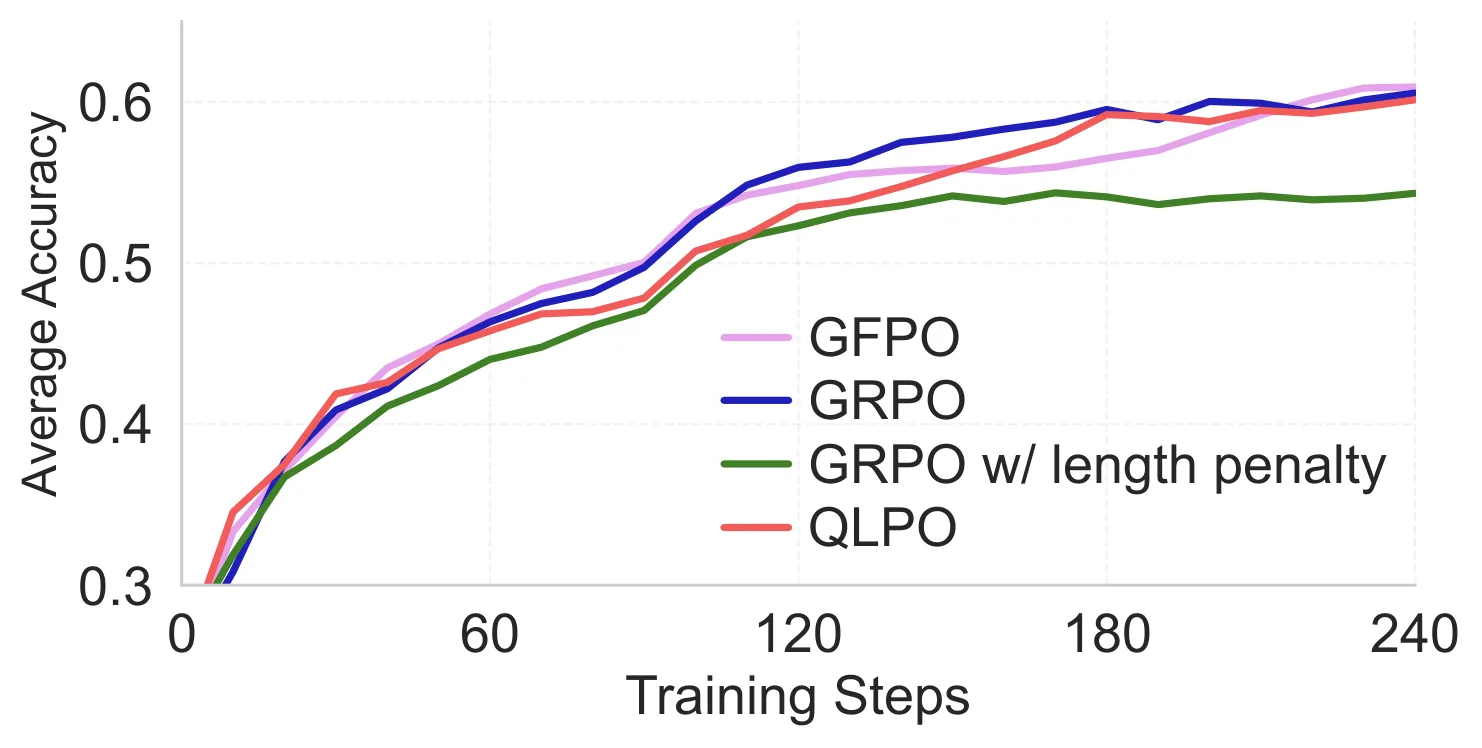
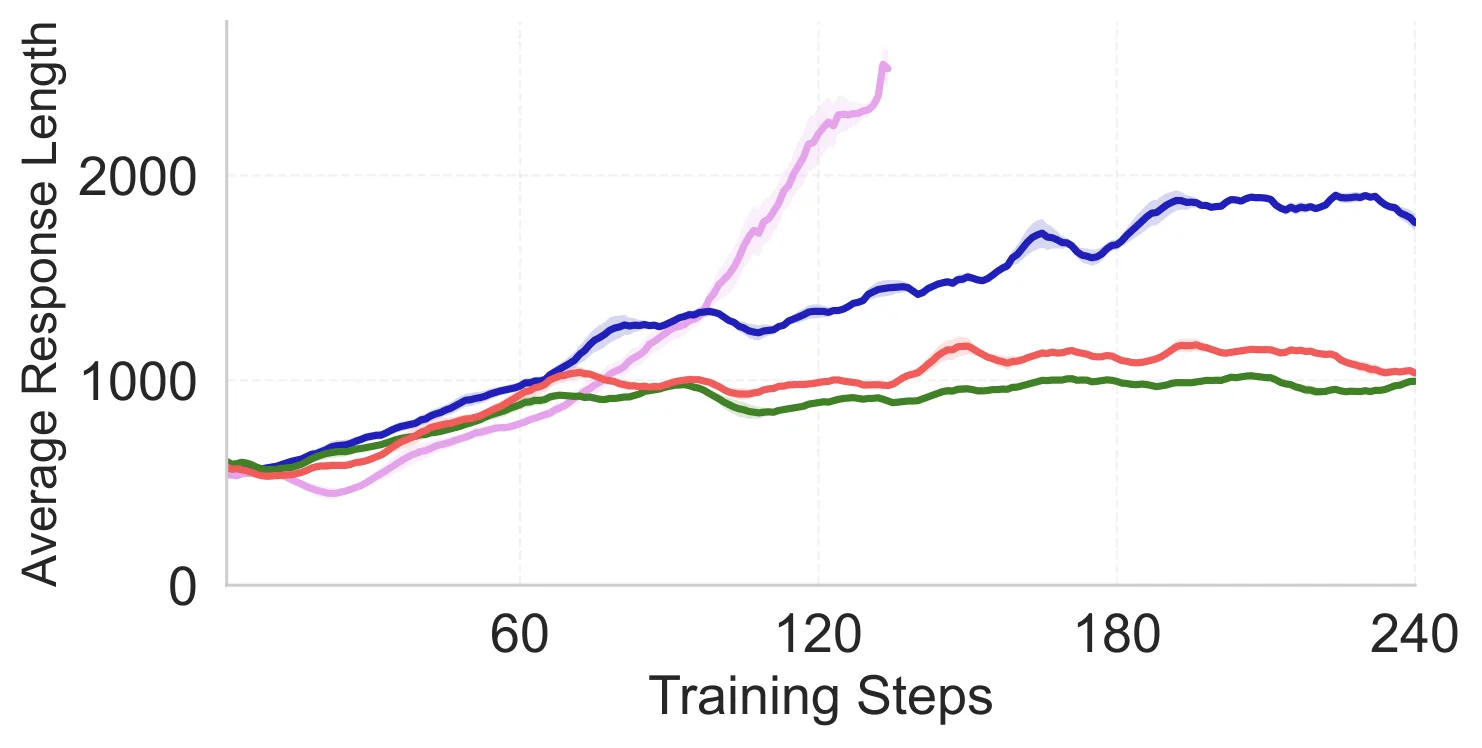
论文还设置了严格的对照实验来验证收益来源。同rollout预算对照实验表明,在使用相同16次采样的情况下,QLPO比16-rollout GRPO在长度控制上表现更好,且训练速度更快。这排除了"多采样"本身作为收益来源的可能性,证实了"选择性采样"机制的核心作用。GFPO的对比同样说明,简单的最短选择策略在某些设置下会失效甚至适得其反——GFPO在DeepScaleR-1.5B训练后期出现长度回升,而QLPO全程保持稳定下降。
稳定性验证基于三个随机种子的实验,平均准确率的差异小于种间方差,长度缩减效果在所有种子下均稳定成立。
讨论与可借鉴点
QLPO的成功揭示了一个重要的设计原则:在[[强化学习]]框架下,采样策略与优化目标可以相对独立地发挥作用。传统思路倾向于通过修改奖励或优势函数来引导行为,但这往往引入复杂的调参需求和潜在的优化冲突。QLPO通过"干净的采样器"角色证明了结构化数据选择本身足以产生显著的行为改变,且不干扰已有的优化信号。
论文的两层梯度分解框架具有更广泛的方法论价值。它为理解和设计group-based强化学习方法提供了统一的分析视角,可以系统地诊断不同采样策略对组级信号和轨迹级实现的影响。例如,这一框架清晰地解释了为什么GFPO在特定条件下会失效,也为未来设计更复杂的选择策略奠定了理论基础。
当然,QLPO也有其局限。首先,当前实验主要集中在数学推理任务上,在开放式对话、复杂Agent任务等场景下的效果尚待验证——这些场景中"长度爆炸"的表现形式可能有所不同。其次,论文采用的是经验性选择,虽然实验表明它优于更极端的设置,但对不同任务类型是否存在更优的默认值仍需探索。再者,QLPO仅处理训练阶段的长度控制,对推理时的解码策略(如束搜索、采样温度)如何与训练好的短推理模型协同,并未涉及。
从工程实践角度看,QLPO的实现极为轻量——基于VeRL框架仅需约200行Python代码,无需引入额外的控制模块或超网络。这种简洁性使其易于集成到现有RL训练 pipeline 中,对希望控制推理成本同时保持模型质量的团队具有较高实用价值。展望未来,将QLPO与推理时加速技术(如投机解码、模型蒸馏)结合,探索其在多模态推理、Agent规划等更复杂场景中的应用,以及研究自适应的调节策略,都是值得推进的方向。
摘要
近期的大型推理模型在强化学习(RL)训练过程中常常产生较长的思维链响应,导致推理延迟高、部署成本大。现有用于控制响应长度的方法通常依赖显式的长度惩罚或额外的控制模块,这需要精心调参,并可能损害推理质量。我们提出了面向长度感知策略优化的象限加权采样方法(QLPO),一种基于重采样的 GRPO 简单变体,可在不修改奖励函数的前提下实现隐式的长度控制。QLPO 首先过度生成候选响应,随后通过保留经验上的正确/错误比例,并倾向于选择较短的正确响应和较长的错误响应,对训练组进行重采样。这重塑了训练分布,隐式地鼓励模型生成更短的输出。在参数规模从 1.5B 到 32B 的模型(包括基础模型与强推理模型)上,QLPO 一致性地改善了准确性与长度之间的权衡。它在保持推理性能的同时,将响应长度缩减了 30% 至 70%。这些结果表明,结构化重采样为高效推理提供了一种有效且鲁棒的方法。
Abstract
Recent large reasoning models often develop long chain-of-thought responses during reinforcement learning (RL), resulting in high inference latency and deployment cost. Existing methods for response length control typically rely on explicit length penalties or additional control modules, which require careful tuning and may compromise reasoning quality. We propose Quadrant-weighted Sampling for Length-aware Policy Optimization (QLPO), a simple resampling-based variant of GRPO that introduces implicit length control without modifying the reward function. QLPO first over-generates candidate responses and then resamples the training group by preserving the empirical correct/incorrect ratio while favoring short correct responses and long incorrect responses. This reshapes the training distribution and implicitly encourages shorter model outputs. Across models ranging from 1.5B to 32B parameters, including both base models and strong reasoning models, QLPO consistently improves the accuracy-length trade-off. It reduces response length by 30% to 70% while preserving reasoning performance. These results suggest that structured resampling provides an effective and robust approach to efficient reasoning.
论文详细总结(自动生成)
论文总结:QLPO——面向长度感知策略优化的象限加权采样
1. 核心问题与研究动机
- 背景:随着 DeepSeek-R1、OpenAI o 系列、Gemini 3、Claude 4.5、Qwen3、Kimi-K2 等大型推理模型(Large Reasoning Models, LRMs)的兴起,基于 GRPO 等 RL 算法训练的模型在数学、代码、Agentic 任务上表现出色,但伴随出现严重的"长度爆炸(Length Explosion)"现象——模型倾向于生成数千冗余 token 的长思维链响应。
- 代价:推理延迟高、部署成本剧增,已成为实际落地的关键瓶颈。
- 现有方法痛点:
- 显式长度惩罚:需精细调节惩罚系数;过强的惩罚会扭曲 RL 目标,在难题上损害推理质量。
- 步级/段级控制器:设计复杂、超参数敏感。
- 启发式重采样(如 GFPO):仅选择"最短正确响应",在 token 级归一化下若负优势样本 token 质量更高,反而可能恶化长度问题(论文 Figure 2 显示其失效案例)。
- 本文视角转变:从"显式奖励黑客(reward hacking)+ 经验式过滤"转向"结构化数据重采样",在不改奖励函数的前提下隐式缩短输出。
2. 方法论:QLPO 核心思想与算法
#### 2.1 整体流程
QLPO 是 GRPO 的重采样变体,对每个 prompt :
1. 过采样:从旧策略 采样 个候选轨迹():
2. 正确性划分:
记 ,。
3. 比例保持:构造最终 个样本的训练组,保持经验正确/错误比:
4. 长度分半:在每个正确性类内按长度排序、对半拆分为 short/long,得到四个象限。
5. 象限加权采样:设长度偏好系数 :
- Correct Long : Correct Short =
- Incorrect Short : Incorrect Long =
优先取偏好象限(Correct Short, Incorrect Long),各象限内均匀采样,凑齐 条:
- 当 :QLPO 退化为标准 GRPO。
- 当 (本文默认):偏好短正确、长错误。
- 当 :过度激进,可能损害长程推理能力。
#### 2.2 基础 GRPO 目标(作为对照)
其中组相对优势 。
#### 2.3 Group–Trajectory 梯度视角(理论贡献)
论文提出两层梯度分解框架:
- 组级梯度分配:
- 轨迹级梯度实现:
关键洞察:
- 组级优势 承载主要的正确性信号,决定优化方向;
- 轨迹级 token 梯度决定该方向如何被参数化实现;
- QLPO 不修改奖励或优势,仅通过轨迹选择改变最终实现,是"选择器"而非"奖励塑形";
- 显式长度惩罚会重新计算 ,可能改变符号和量级(长正确轨迹可能被错误抑制);
- GFPO 最短选择会扰动组级正确性比例,且在 token 加权平均优势 为负时,反而抑制短响应,加剧长度爆炸——解释了 Figure 2 中 GFPO 失效现象。
3. 实验设计
#### 3.1 模型与训练数据
- 文本推理主实验:Qwen2.5-3B、Qwen2.5-32B、Qwen3-30B-A3B(MoE)、DeepScaleR-1.5B-Preview、DeepSeek-R1-Distill-Qwen-7B。
- 训练数据:MATH-lighteval(3B 设置)、DAPO-MATH(其余模型)。
- 多模态与代码(初步实验):Qwen2.5-3B-VL + Geo3K;Phi-3.5-mini-instruct + Eurus-2-RL-Data。
#### 3.2 评测基准
- 数学与科学推理 5 项:GSM8K、MATH-500、OlympiadBench、GPQA、AIME 2024。
- 指标:pass@1 准确率、平均输出 token 数。
- 生成设置:温度 ,最大长度 32k tokens;AIME24 每 prompt 采样 16 次,其余 3 次。
- 评判方式:GSM8K/MATH-500 用结构化抽取 + 标准化精确匹配;其余先规则匹配,失败再用 GPT-4.1 兜底。
#### 3.3 对比基线
- 主基线:标准 GRPO()。
- 同 rollout 预算对照:Rollout-matched GRPO(),用于剥离"多采样"与"选择性采样"的贡献。
- 同类型方法:GFPO()。
- 开源高效推理模型:L1、Laser、ThinkPrune 等公开发布的 checkpoint。
- 辅助对照:GRPO + 长度惩罚。
4. 资源与算力
- 硬件:32 张 NVIDIA H20 GPU。
- 并行策略:FSDP + vLLM,TP=4,启用 offloading。
- 优化器与超参:Adam,学习率 ,warm-up 10 步,weight decay 0.1,梯度裁剪 1.0;KL 系数 0.01,KL 奖励关闭;token 级 loss 归一化;PPO clip 。
- 批大小:全局 prompt batch=128,PPO mini-batch=256。
- 最大长度:prompt 2k,response 32k;论文声明训练/评估中触达 32k 上限的样本 <0.1%,长度缩减并非源于截断。
- 训练时长(标准化):相对于 8-rollout GRPO,QLPO 训练时长在 0.916× 到 1.163× 之间(即 至 ),平均开销很小,部分设置(如 Qwen2.5-32B)甚至更快。
- 代码量:基于 VeRL,仅约 200 行 Python。
5. 实验数量与充分性
- 主实验表(Table 1):5 个模型 × 5 个基准 = 25 个 (模型, 基准) 单元,覆盖 1.5B/3B/7B/30B(A3B)/32B 与 base/instruct 两类模型,结果在 5 维 accuracy-length 平面上比较 GRPO/QLPO。
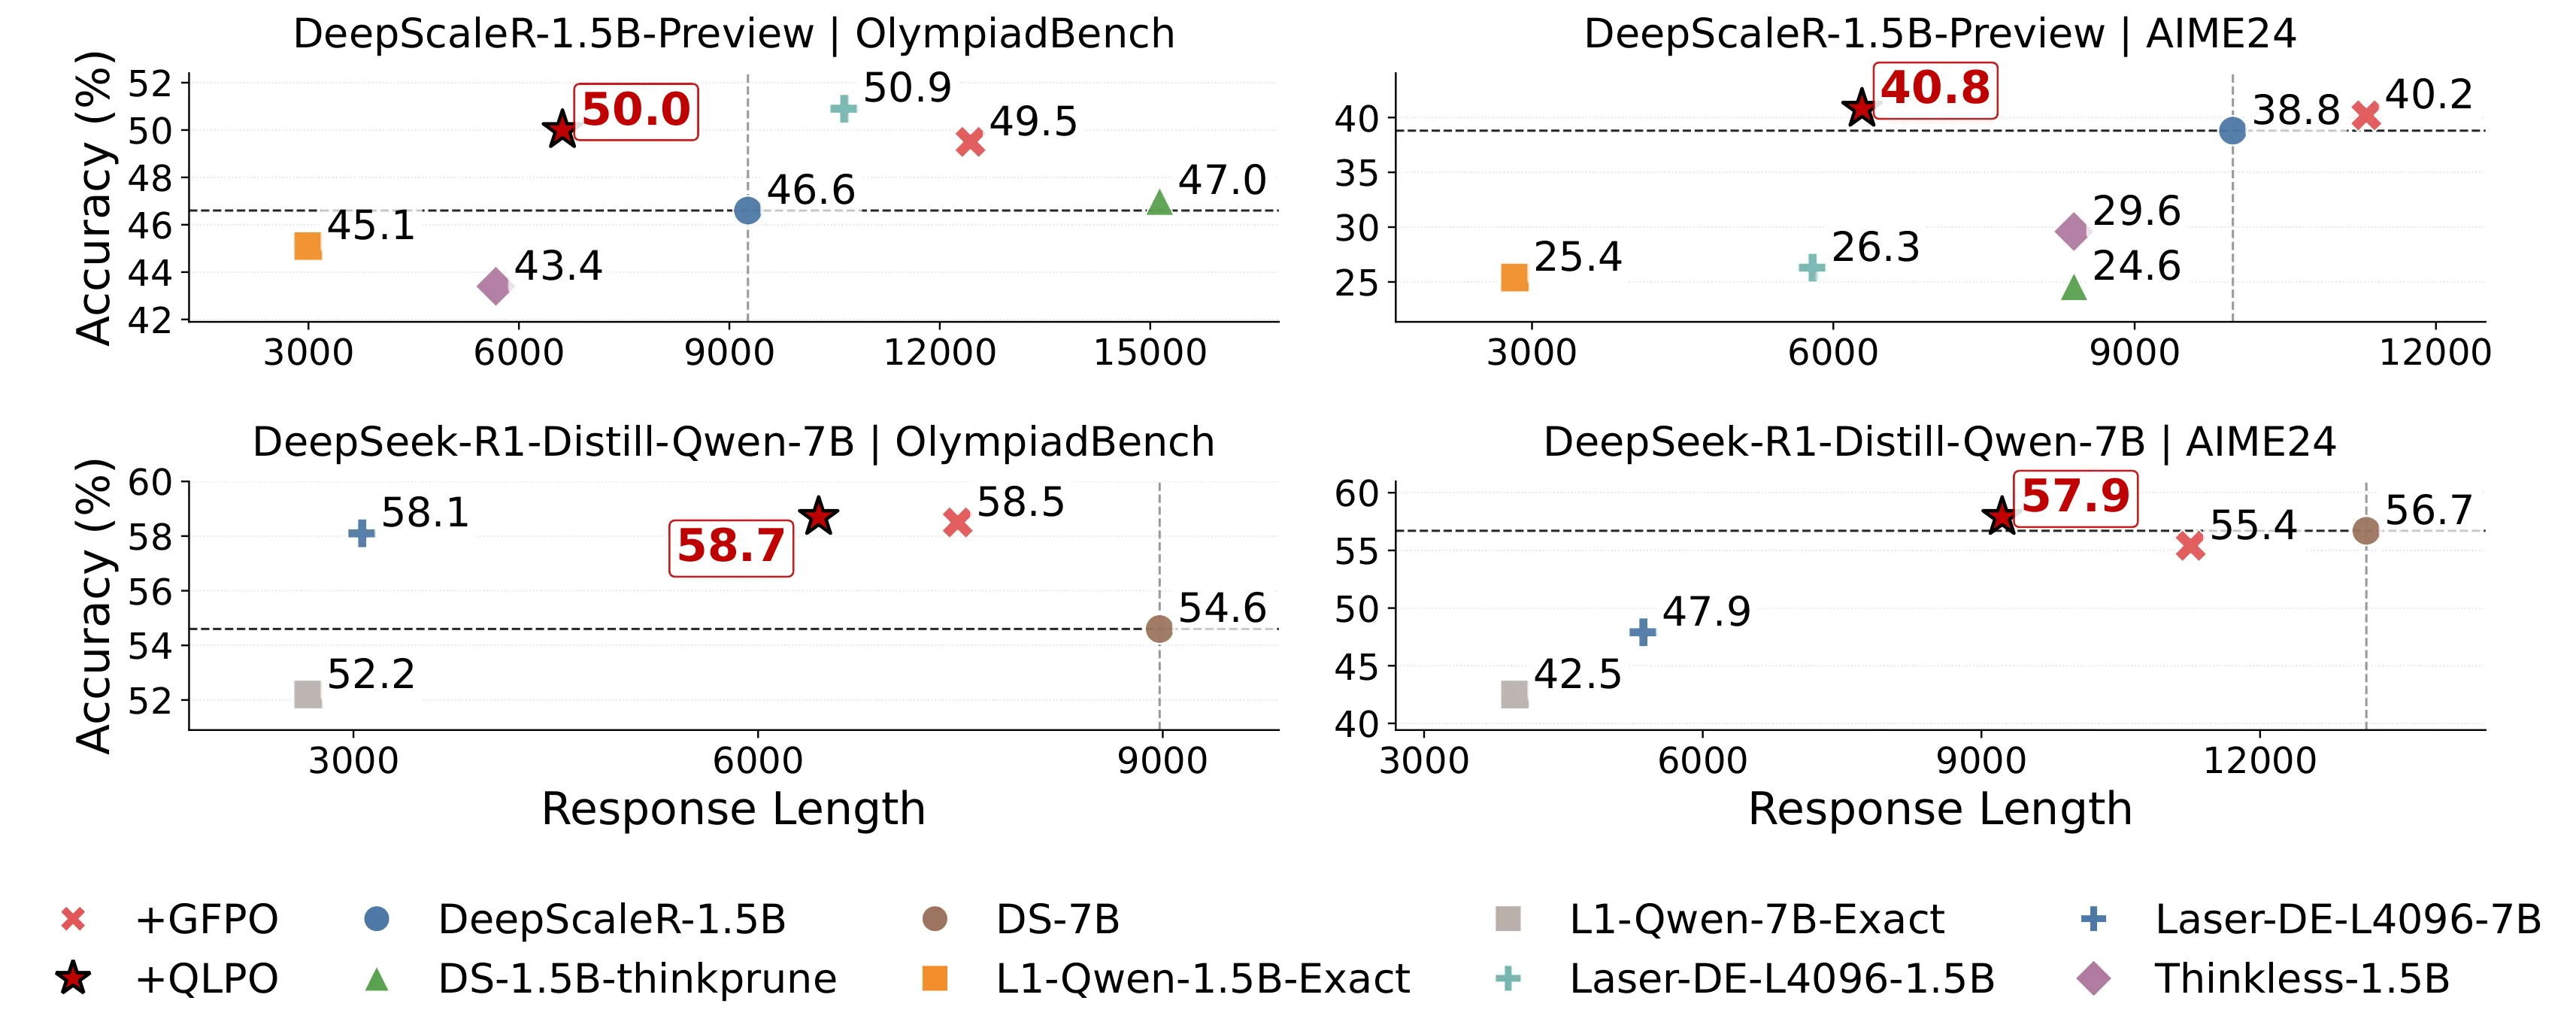
- 对比压缩基线(Figure 4):1.5B 与 7B 两个规模上比较 QLPO、GFPO、L1、Laser、Thinkless、ThinkPrune 等多个 SOTA 压缩方法在 OlympiadBench 与 AIME24 上的双指标权衡。
- 消融(Figure 6):在 DeepScaleR-1.5B 上对候选池大小 (1.5M/2M/2.5M)与长度偏好 (0、1/3、1/2、1)联合扫描,约 6 组配置。
- 同 rollout 预算对照(Table 2):2 个模型 × 3 种设置(GRPO-8/GRPO-16/QLPO),用于排除"多采样"带来的偶然增益。
- 多模态与代码(Appendix A):2 组额外训练曲线,分别对应 Eurus-2-RL-Data 与 Geo3K。
- 分布分析(Figure 5、Figure 7):按正确性、按问题难度的响应长度分布偏移对比。
- 训练-推理权衡(Table 4):5 个模型的标准化训练时长。
- 稳定性(Appendix C,Table 3):DeepScaleR-1.5B 与 Qwen2.5-3B 上 3 个随机种子的均值与标准差。
- 样例分析(Appendix B):给出真实 GRPO vs. QLPO 输出对比,定性论证压缩来自冗余去除而非推理截断。
充分性评估:实验覆盖文本/多模态/代码、base/instruct、dense/MoE、1.5B–32B 多种设置,并设置 rollout 预算匹配对照、随机种子验证、消融、分布分析,相对充分。不过所有压缩均以"采样-选择-更新"为单一变量,缺少对不同温度、不同 、不同数据集(如非数学推理)的大规模敏感性测试。
6. 主要结论与发现
- 准确性-长度权衡一致改善:在 5 个模型 × 3 个最难的 OlympiadBench/GPQA/AIME24 共 15 个 (模型, 基准) 单元中,QLPO 与 GRPO 持平或略有提升,同时大幅缩短输出。压缩幅度 30%–70%:
- DeepScaleR-1.5B 在 OlympiadBench 上 17138→6621(−61.4%)。
- DS-7B 在 AIME24 上 12237→9223(−24.6%),GSM8K 上 2388→1176(−50.8%)。
- Qwen2.5-3B 在 GPQA 上 2225→721(−67.6%,相对降幅最大)。
- Qwen2.5-32B 在 OlympiadBench 上 1397→867(−37.9%)。
- Qwen3-30B-A3B 在 AIME24 上 13355→9692(−27.4%)。
- 不是简单截断:分布分析显示错误轨迹长度平均下降约 38%,正确轨迹下降约 23%;简单/难题均有 30%–38% 的压缩,证实压缩是广泛性的而非只针对简单题。
- 相对 GFPO 更可靠:在 DeepScaleR-1.5B + DAPO-MATH 上,QLPO 训练后期长度稳定下降,GFPO 反而出现长度回升(Figure 2)。
- 收益并非来自多采样:同 16 rollout 预算下,16-rollout GRPO 比 8-rollout GRPO 略长且训练更慢;QLPO 在同等采样预算下大幅缩短且更新量更小,验证了"选择机制"是收益主因。
- 样例分析:定性示例显示 QLPO 通过去除重复陈述、过度口头脚手架等低价值 token 实现压缩,关键中间推理步骤保留。
- 稳定性:3 个随机种子下,平均准确率差异小于种间方差,而长度缩减稳定(DS-7B −27.0%、Qwen2.5-3B −48.9%)。
7. 优点与亮点
- 方法层面:
- 完全不改奖励函数与优势估计器,仅做选择器,理论分析清晰(Group–Trajectory 梯度视角),与显式惩罚类方法形成鲜明对比。
- 实现极简(基于 VeRL +200 行),无新增超网络或控制模块;唯一关键超参 ,对调参负担极小。
- 保留经验正确/错误比的设计避免扰动组级正确性信号,相比 GFPO 更稳健。
- 与压缩幅度并不"越激进越好"的反直觉特性( 优于 )切合直觉,可解释性好。
- 理论层面:
- 提出 group-level 与 trajectory-level 的两层梯度分解,不仅用于解释 QLPO,还能用于解释 GFPO 失效机制——为后续 group-based RL 研究提供了新的分析工具。
- 实验层面:
- 涵盖模型规模、架构(dense/MoE)、训练阶段(base/强推理)、任务类型(数学/科学/多模态/代码)多维度。
- 设置 rollout-budget-matched GRPO 关键对照,剥离了"多采样"与"选择策略"的贡献,回答了"QLPO 是否只是因为采样更多轨迹而变短"的潜在质疑。
- 报告训练时长,证明训练开销可控。
- 给出分布偏移、随机种子稳定性与定性样例,证据链较完整。
8. 不足与局限
- 额外 rollout 的潜在开销:尽管论文报告平均训练开销 ≤16.3%,但过采样 在算力受限或长上下文场景下仍可能成为瓶颈;附录 F 也承认这一点。
- 与 的全局固定:实际中不同 prompt 难度差异巨大,统一 与统一 可能不是最优;论文未来工作提到可改为自适应策略,但当前未实现。
- 未充分验证的领域:
- 仅在数学、科学推理主导的数据集与少量多模态/代码上验证,未涉及开放对话、创意写作、长文档理解、Agent 多轮推理等场景;这些场景中长度本身可能是任务需求。
- 32k 上限下未触达 1‰ 截断,但更激进的"长度爆炸"模型(如更长 CoT)在 64k/128k 场景是否仍稳定压缩未经验证。
- 消融不完整:
- 缺少对 在不同模型规模上的差异分析、(更新组大小)的扫描、与 token 级 vs. trajectory 级 loss 归一化交互作用的检验。
- 与 RL 中其他"动态采样"方法(如 DLER、LSPO、DAPO 的过滤机制)的正交组合未探讨。
- 正确性信号依赖:QLPO 假设奖励函数可判定正确/错误,但开放式任务下二值正确性难以获得,可能限制方法推广。
- 基线覆盖局限:与 L1/Laser/ThinkPrune 等压缩模型相比时,使用的是公开发布 checkpoint,并非在同一训练流程与数据下复现,公平性存在一定偏差。
- 长度评估的简化:以平均 token 数作为效率指标,未考虑 wall-clock 推理时延、显存峰值或 KV cache 压力等部署相关指标。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。