
将调整速度作为非平稳强化学习的安全约束
Adjustment Speed as a Safety Constraint for Nonstationary Reinforcement Learning
📝 TLDR
在非平稳环境中,强化学习的安全问题不仅源于瞬时决策失误,还取决于环境变化时系统能否及时适应。本文提出以调整速度作为安全约束,基于上下文表示与短期预测估计适应需求,并与校准的恢复能力比较;一旦预测需求超出能力,则主动收紧可行动作集并激活动作级防护。驾驶环境实验表明,该方法主要在上下文切换的短窗口内降低违规,防护层对峰尾风险抑制更保守,优化层进一步减少切换条件下的违规。
🧭 速览
现有安全强化学习方法多假设环境平稳,未将延迟适应本身视为安全隐患,难以应对环境演化。
利用上下文表示与短窗口预测估计适应需求,对比校准的恢复容量,超限时收紧动作集并激活动作级屏蔽。
在非平稳驾驶环境中,方法在上下文变化的短窗口显著降低违规,防护层对峰尾风险抑制更保守,优化层额外削减切换相关违规。
将适应可行性确立为非平稳强化学习的实用安全原则,证明前瞻干预可在环境变化期改善安全性。
🆚 方法对比
ASASC-NS(调整速度作为非平稳强化学习安全约束)
- 首次将安全定义为适应可行性而非静态规范
- 通过上下文预测主动收紧动作集与启用屏蔽机制
- 提供预测上下文偏移与安全干预的条件理论刻画
- 在短时窗内主要减少与环境变化对齐的安全违规
- 仅在单一非平稳驾驶环境验证,泛化性待检验
- 恢复容量需经验校准,依赖预测准确性
- 上下文预测误差可能触发过度保守干预
动作级屏蔽(Action-level Shielding)
- 在峰值与尾部风险抑制上更保守可靠
- 直接过滤不安全动作,防止违规发生
- 独立于策略优化,作为最后防线介入
- 可能过度保守,限制智能体正常行为能力
- 依赖上下文预测质量,预测失误会失效
优化级调整(约束收紧)
- 在切换条件短时窗违规上提供额外削减
- 主动调整约束而非被动响应违规
- 与屏蔽机制互补,形成多层保护
- 收紧约束可能牺牲最优性能
- 调节幅度依赖于适应需求的准确估计
现有安全强化学习方法(CMDP/CPO等)
- 理论基础成熟,如约束MDP与拉格朗日方法
- 在平稳或缓慢变化环境中经验丰富
- 实现相对简单,已被广泛验证
- 假设环境平稳,未考虑适应速度安全问题
- 在非平稳环境中可能产生瞬态不安全行为
- 无法主动应对分布偏移引发的安全风险
现有安全RL方法基于平稳性假设无法处理非平稳适应延迟问题,ASASC-NS通过将安全重新定义为适应可行性,并结合优化级约束收紧与动作级屏蔽形成双层主动防护机制,在短时窗内有效抑制安全违规。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 4 张)
展开查看 4 张图
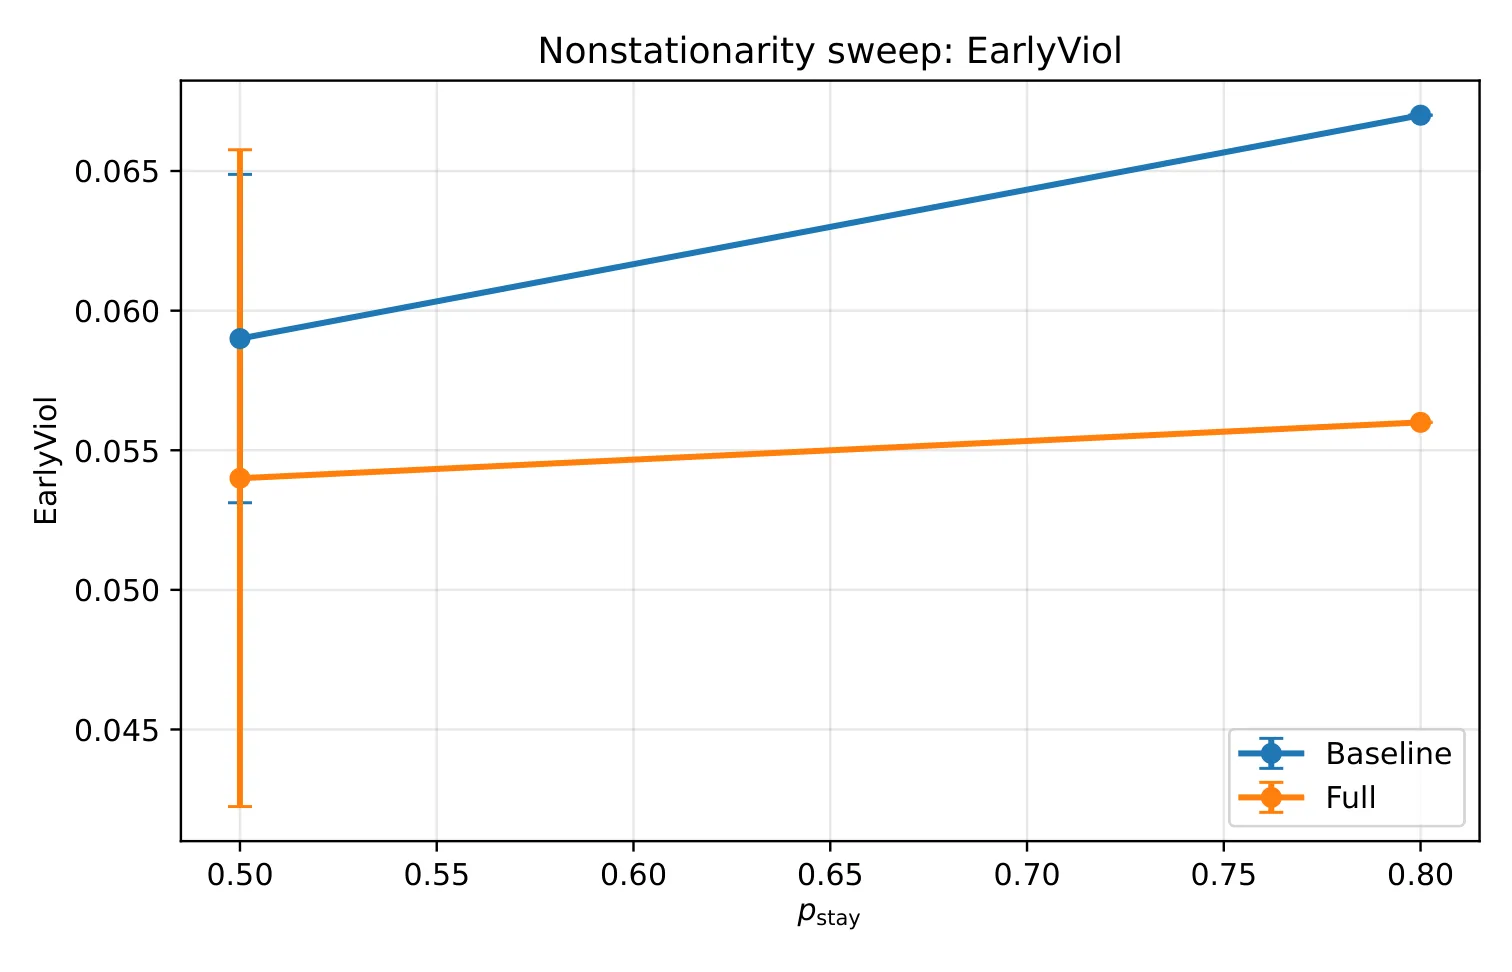
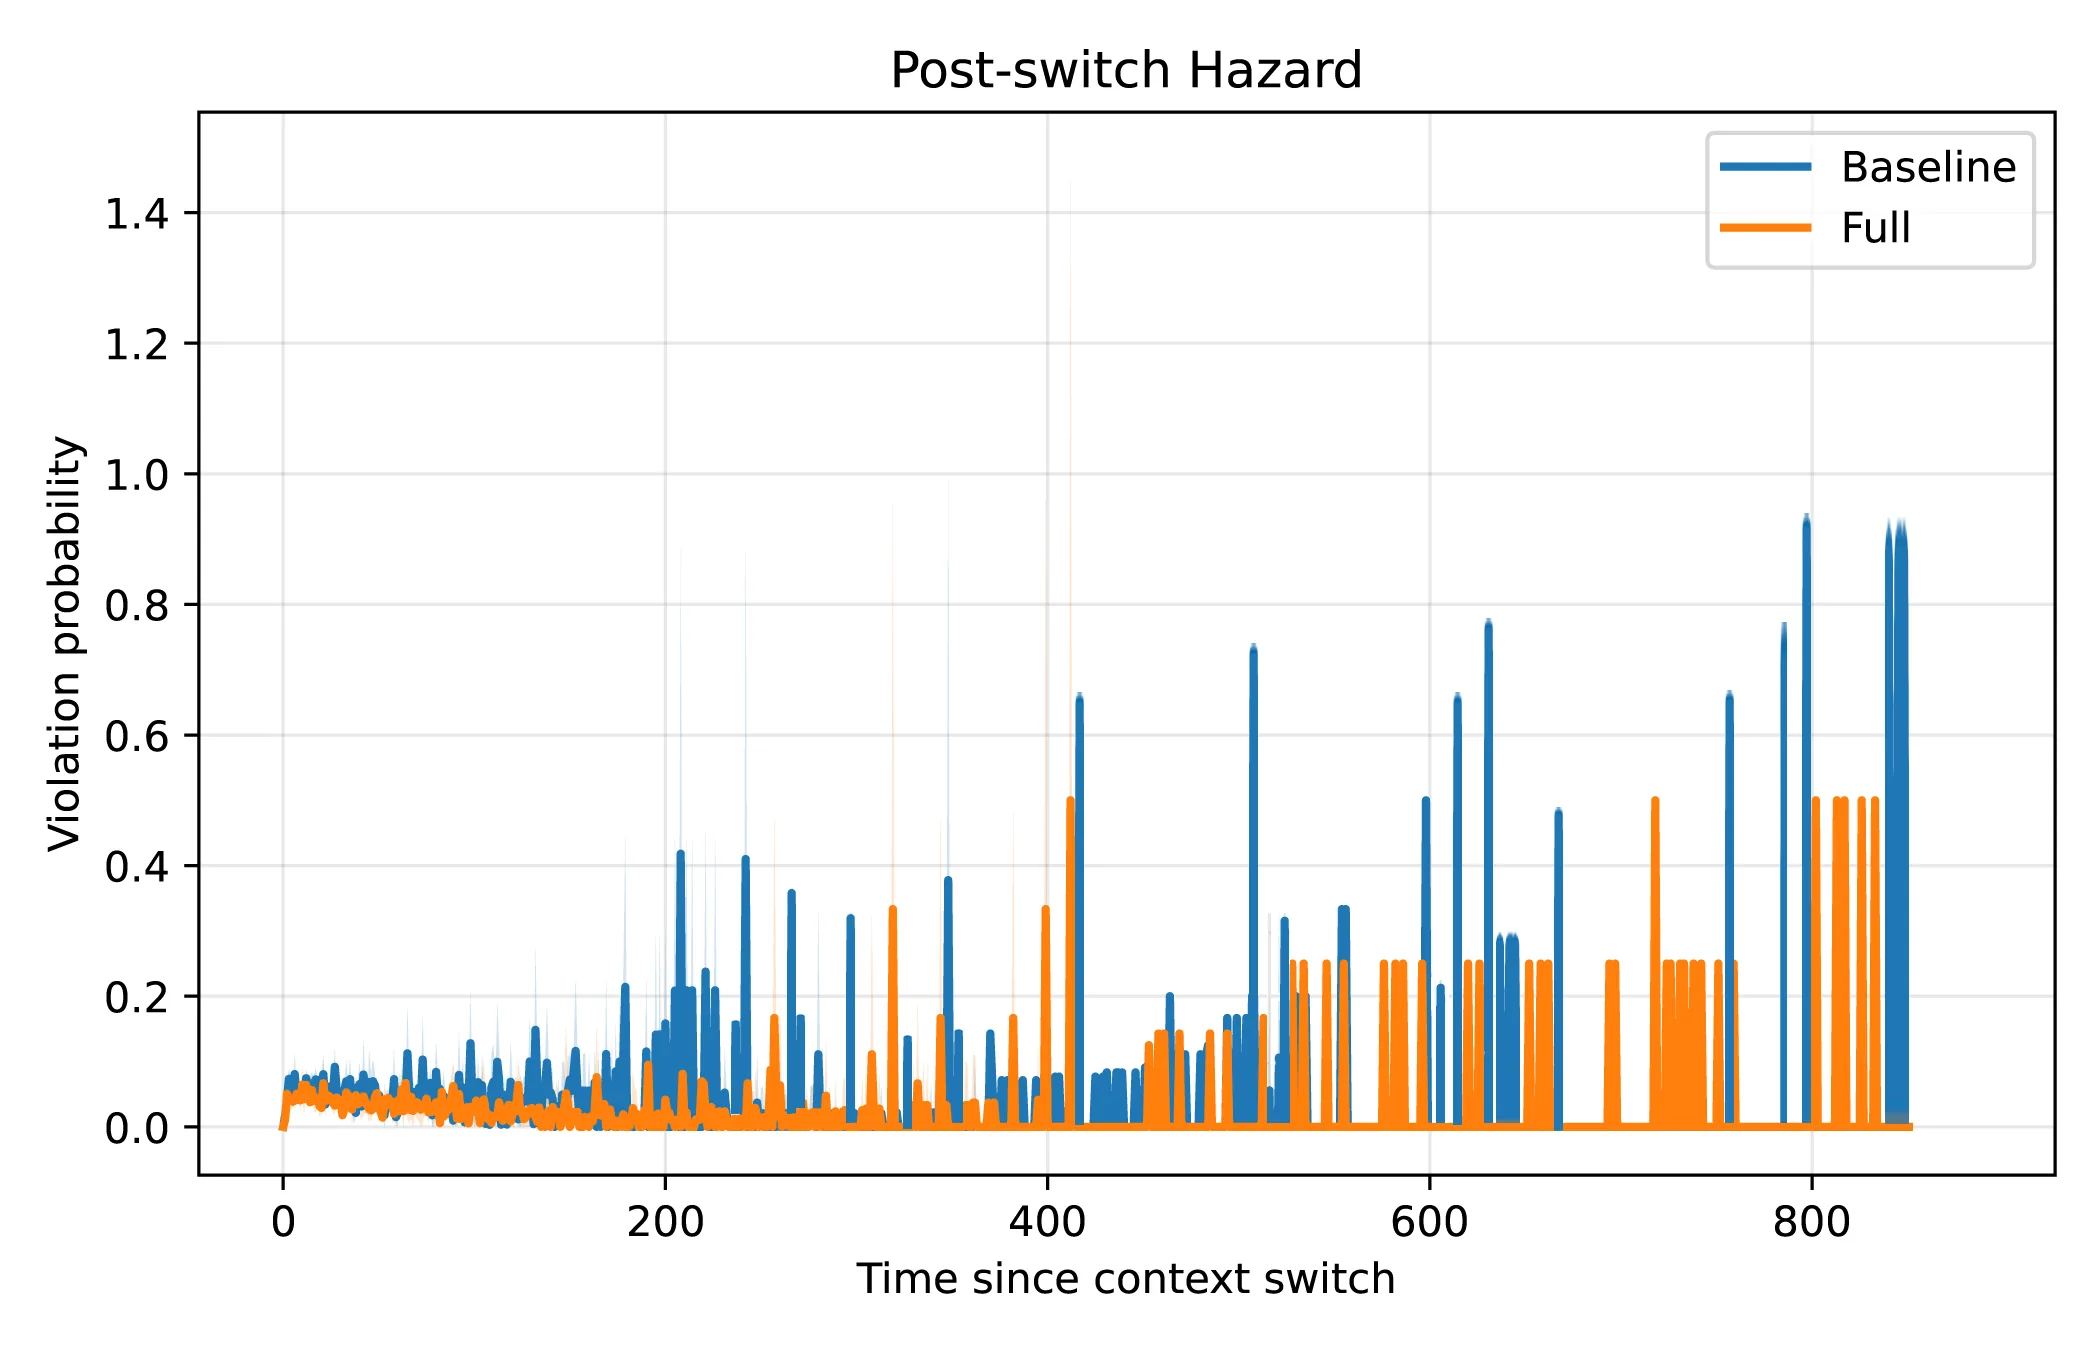
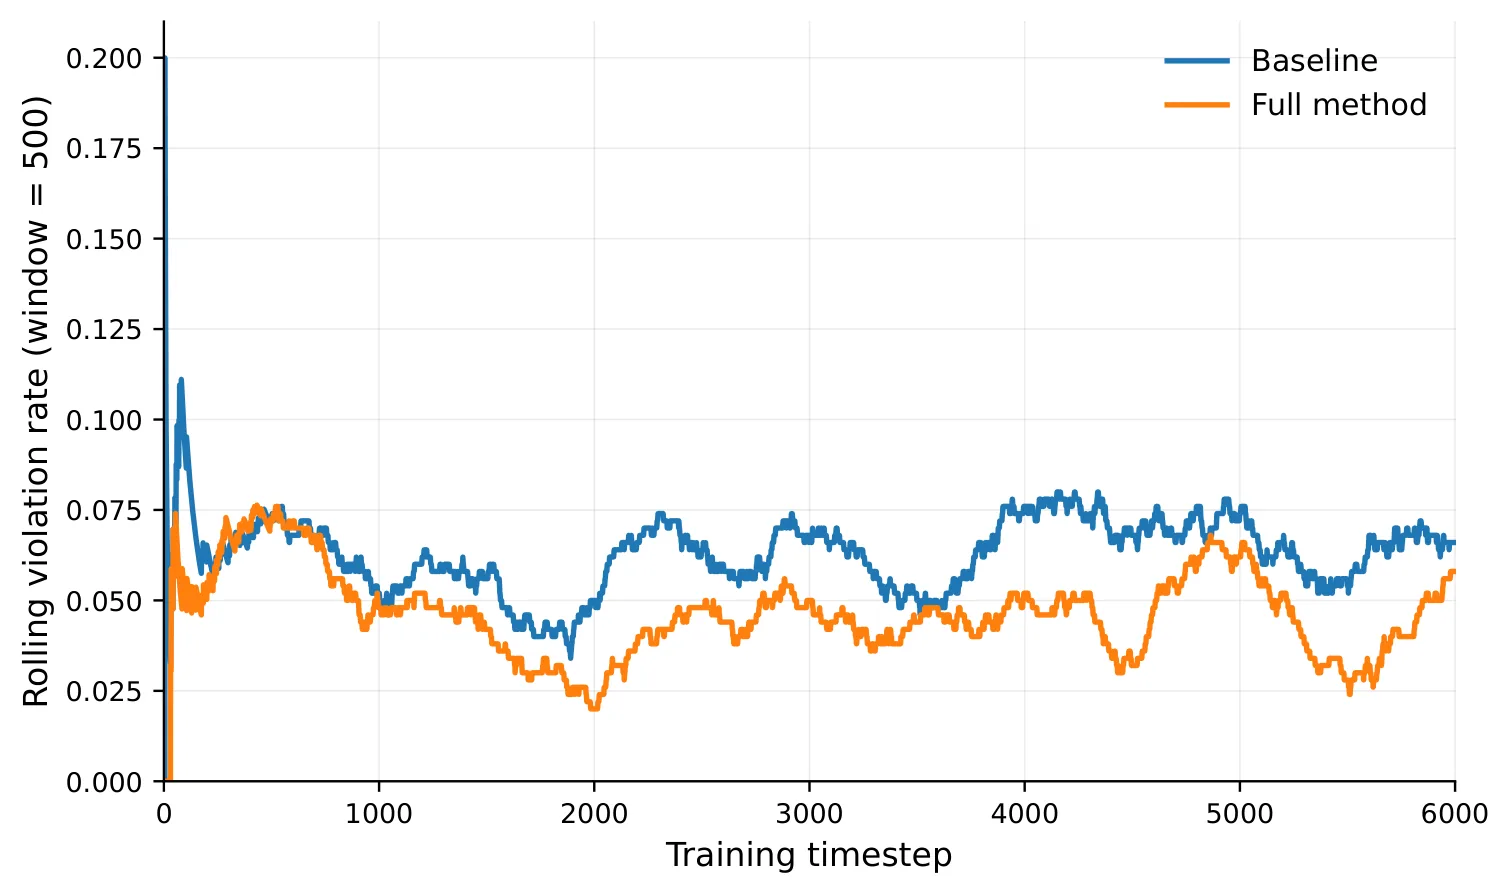
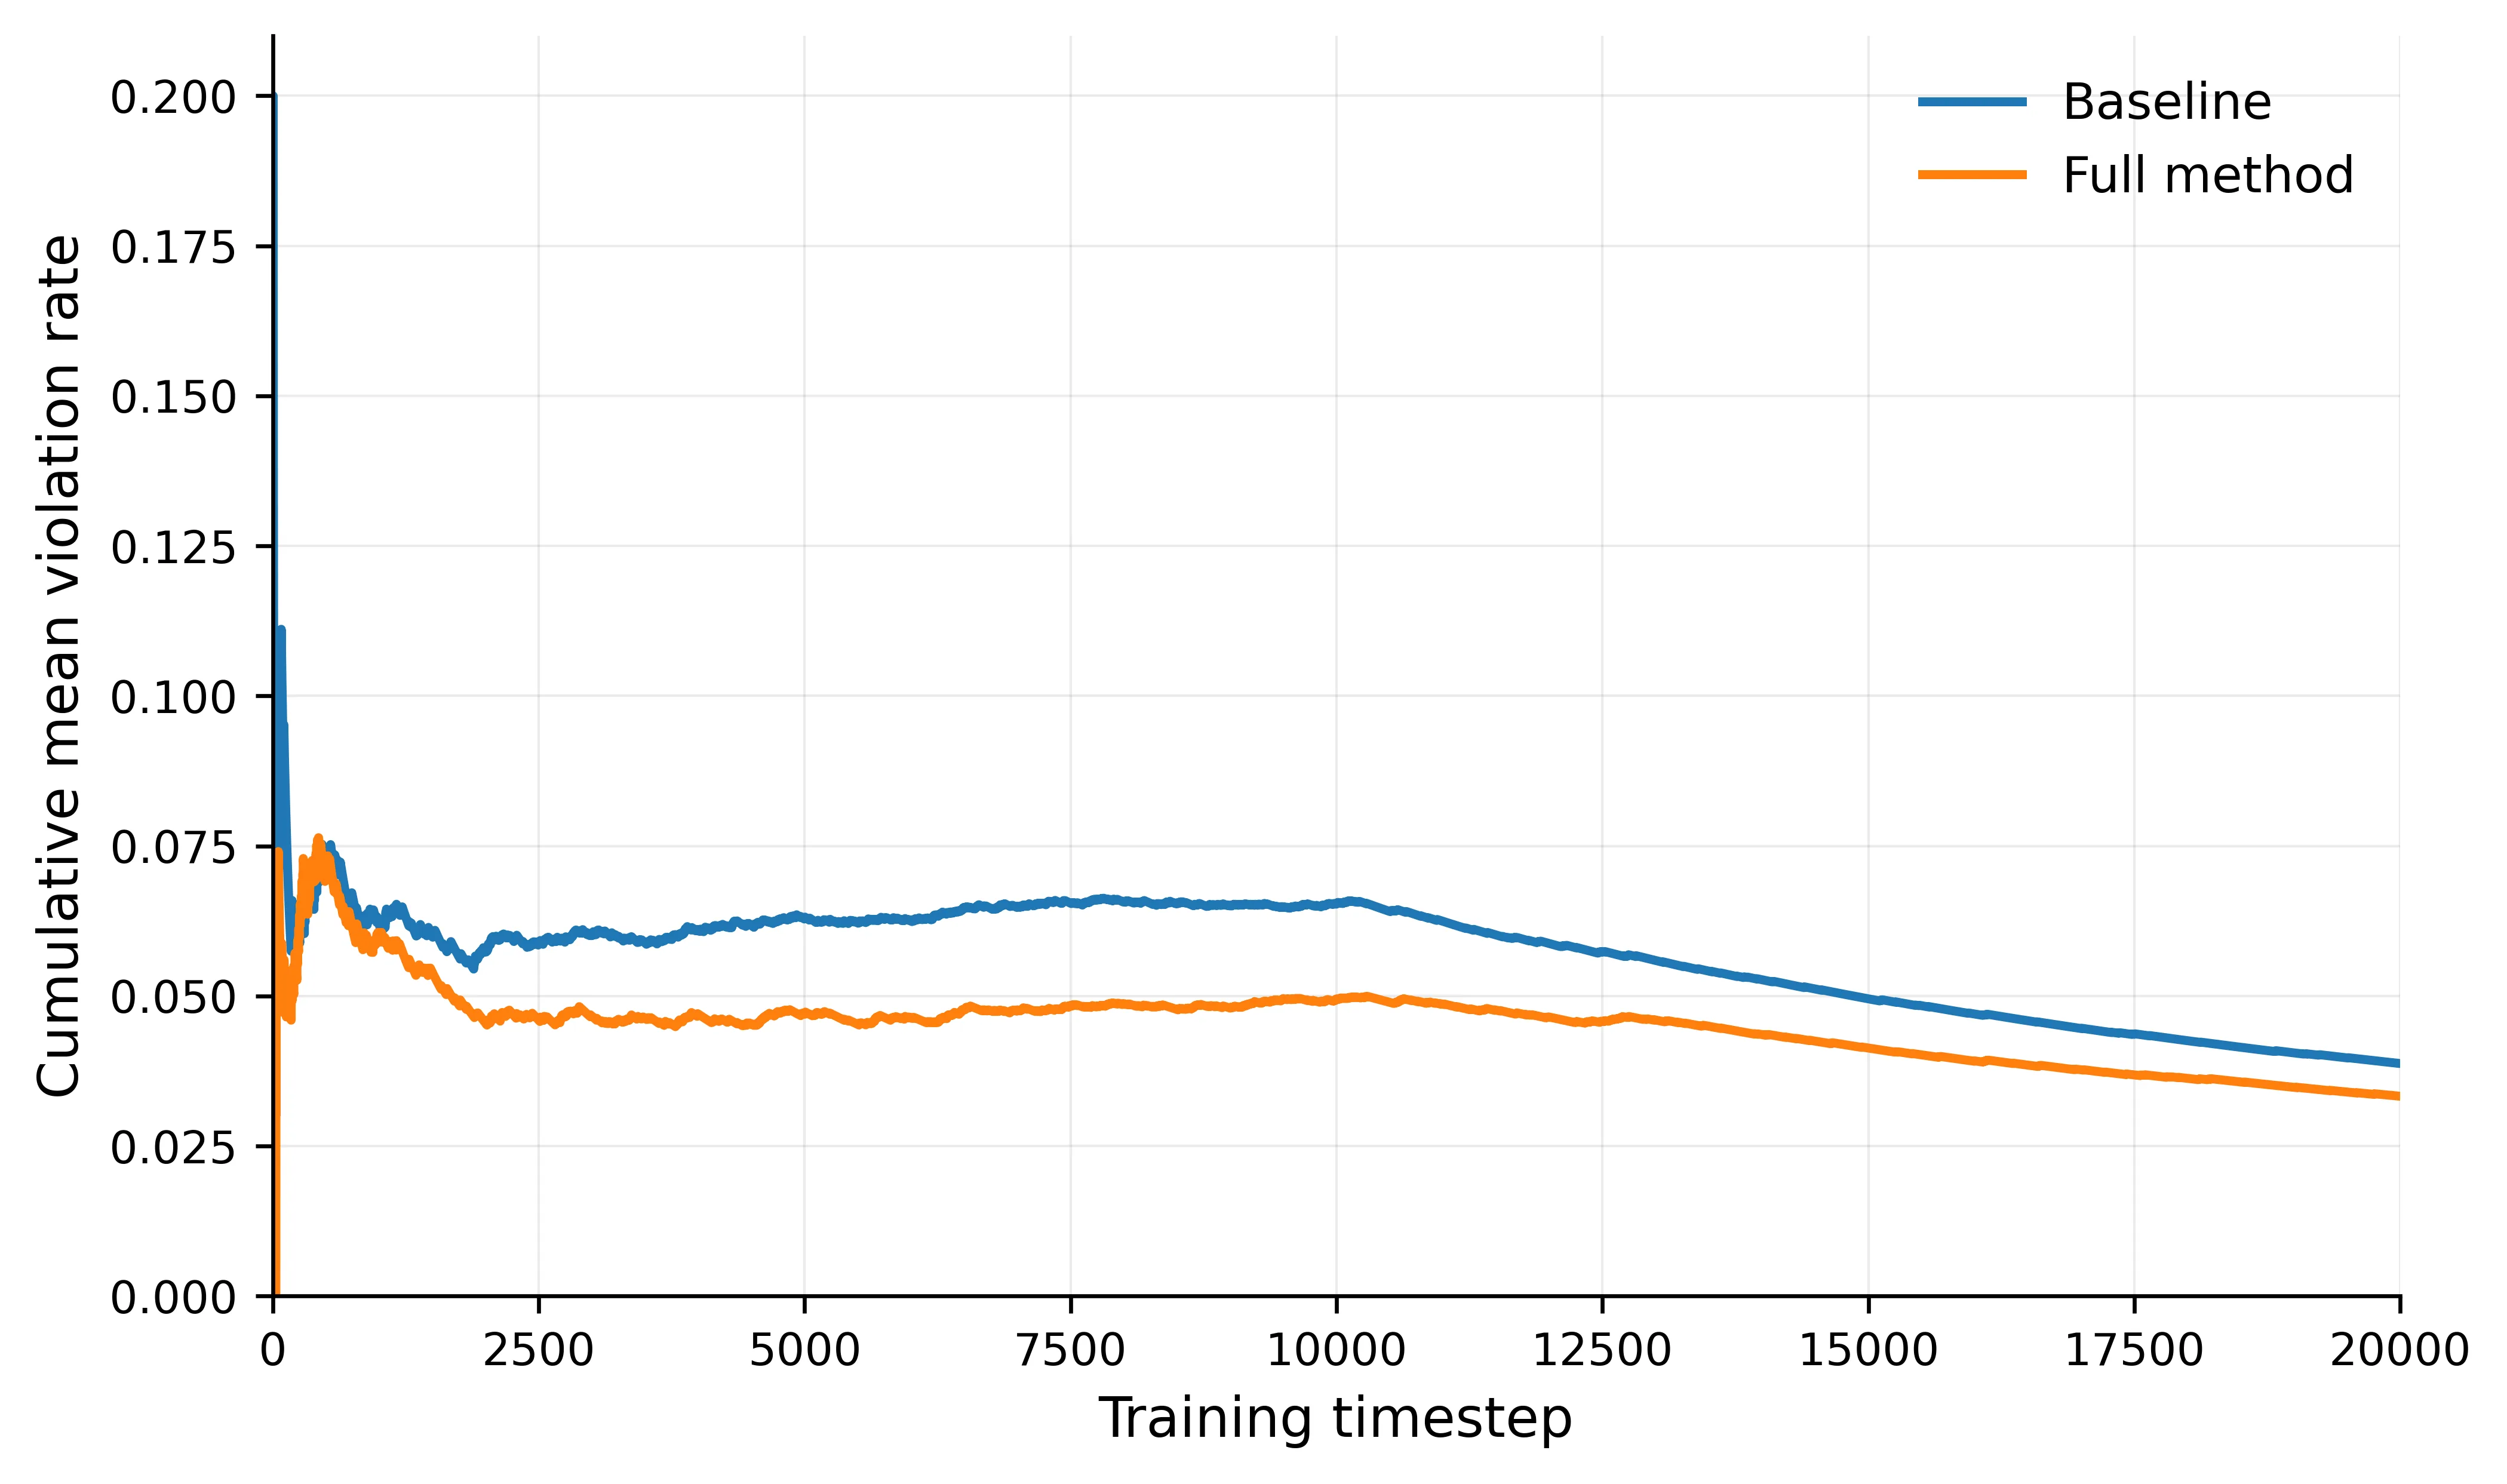
TL;DR
这篇论文针对非平稳强化学习环境中的安全问题,提出了将「调整速度」本身视为安全约束的核心思想。方法通过学习上下文表示和短期上下文预测来估计「适应需求」,并与智能体校准后的「恢复能力」进行比较;当预测的需求超出能力边界时,主动收紧可行动作集并激活动作级防护层。在非平稳驾驶环境中的实验表明,该方法主要在上下文切换的短窗口内显著降低安全违规,防护层对峰值和尾部风险抑制更保守,而优化层的调整则在切换条件下带来进一步的违规削减。
研究背景与动机
在真实世界的许多应用场景中,强化学习系统所面对的环境并非一成不变。以自动驾驶为例,路面状态可能从干燥变为湿滑,视野可能从晴朗转为雨雾,乃至交通规则的局部调整都会改变系统的最优决策空间。这类环境随时间演变的特性在强化学习领域被称为「非平稳性」,它给安全关键应用带来了独特的挑战:即使智能体在某一时刻做出了看似合理的决策,当环境发生变化时,如果它不能及时调整行为,就可能在过渡期内产生瞬态的不安全行为。
传统的安全强化学习方法主要关注如何确保智能体在每个时间步做出的即时决策满足安全约束,例如通过 [[安全强化学习]] 框架中的约束优化、屏障函数或对抗训练等技术来保证状态-动作空间中的安全性。然而,这些方法通常隐含地假设环境是平稳的,即认为一旦某个策略被证明是安全的,它就能够在未来持续保持安全。当环境发生漂移时,这种假设会失效——智能体可能在旧环境下学习到的安全策略在新环境下成为危险的根源。
本文的出发点正是要打破这一隐含假设,将环境变化本身纳入安全分析的范畴。作者认为,在非平稳环境中,安全问题不仅关乎单步决策的合理性,更关乎系统能否在所需的时间窗口内完成从旧策略到新策略的平稳过渡。如果适应过程太慢,即使最终能够收敛到安全区域,过程中的过渡行为也可能导致事故。这引出了一个关键问题:如何量化「系统能否足够快地适应环境变化」?
方法
为了回答这个问题,作者提出了一种从「适应可行性」角度定义安全性的新框架。这一框架的核心思想可以表述为:当维持安全所需的适应速度超出智能体校准后的恢复能力时,未来状态或区域可能变得不安全。换言之,安全不再是关于当前状态是否满足约束条件的静态判断,而是关于智能体能否在环境变化的时间尺度内完成必要调整的动态评估。
具体实现上,该框架包含两个关键模块:适应需求估计器和适应能力校准器。适应需求估计器利用学习到的上下文表示来感知当前环境状态的语义信息,并通过短期上下文预测来推断环境接下来可能如何变化。这里的「上下文」指的是能够捕捉环境本质特征的低维表示,例如驾驶场景中的路面摩擦系数、视野可见度等级或交通密度指标。通过对这些上下文变量进行数步预测,系统能够估计出为保持安全所需达到的性能调整幅度。
适应能力校准器则负责建立智能体实际可达的调整速度模型。这一校准过程通过系统辨识实验完成:让智能体在受控的环境变化下执行策略,然后测量其性能指标随时间收敛到新稳态的速率。这一收敛速率即为智能体的恢复能力,它反映了在给定硬件限制和策略结构下,智能体能够多快地修正其行为以响应环境变化。
将这两个模块结合起来,框架的核心决策逻辑如下:对于任意给定的未来时间窗口,如果预测的环境变化幅度(来自上下文预测)对应的适应需求,超过了智能体在相同时间窗口内能够实现的调整幅度(来自校准后的恢复能力),则系统判定在过渡期间存在安全风险。此时,框架采取两层防御策略。首先在优化层面,通过调整目标函数或约束条件的权重,使策略倾向于选择更保守的动作,减少在适应期间暴露于高风险状态的概率。其次在防护层面,当检测到即将到来的高风险窗口时,主动收紧可行动作集合,将那些可能导致不可逆后果的动作屏蔽掉,只允许相对安全的子集被选择。
这种设计的精妙之处在于它的事前干预特性。与传统的事后安全检验不同,框架在违规行为实际发生之前就根据预测信息采取了防御措施。这类似于人类驾驶员在看到前方路面从干燥变为湿滑时的本能反应——不是等到车辆打滑后才采取补救,而是在预判到抓地力下降时提前减速。
实验与结果
实验在非平稳驾驶环境中进行,这一环境设计模拟了多种上下文切换场景,包括路面摩擦系数的变化、视野条件的改变以及交通流密度的波动。作者将所提方法与若干基线进行比较,包括没有安全约束的标准强化学习、智能体只考虑即时安全的保守基线,以及仅在优化层面进行调整而不激活防护层的消融版本。
实验结果首先验证了方法在总体安全性能上的提升。相较于无安全约束的基线,论文提出的框架在累积安全违规指标上实现了显著下降,且这一改善主要发生在上下文切换后的短时间窗口内。这表明方法确实捕捉到了环境变化带来的瞬态风险,并有效地对其进行了抑制。
消融实验进一步揭示了优化层和防护层各自的作用机制。结果显示,单独启用防护层时,系统在抑制峰值风险和尾部风险方面表现更为保守——换言之,它宁可牺牲部分任务性能也要确保不突破安全边界。这一保守性源于防护层的设计哲学:当检测到适应需求超出恢复能力时,最安全的做法是大幅限制动作空间,即使这意味着放弃某些可能带来高回报但同时伴随高风险的选择。相比之下,优化层面的调整能够在保持一定任务性能的同时,通过调整策略参数来平滑过渡曲线,从而在切换条件下带来额外的违规削减。
值得注意的是,实验还观察到上下文预测的准确性对整体性能有显著影响。当预测时域过短时,系统几乎没有足够的反应时间来激活防御;当时域过长时,预测误差会累积,导致频繁的误报和过于保守的动作选择。这一敏感性分析为实际应用中的参数调优提供了重要参考。
讨论与可借鉴点
尽管实验结果支持将适应可行性作为非平稳强化学习的一项实用安全原则,但论文也坦诚地指出了若干局限。首先,上下文表示的学习本身依赖于领域知识或大规模预训练,在完全陌生的环境中可能难以获得有效的表示。其次,恢复能力的校准假设环境变化具有某种可辨识的结构,对于完全随机或高度非线性的漂移,校准结果的可迁移性可能受限。
从更宏观的视角来看,这篇论文为 [[安全强化学习]] 研究开辟了一个新的维度:不仅关注智能体「做什么决策」是否安全,还要关注智能体「多快地调整决策」是否足以应对环境变化。这种将动态特性纳入安全定义的思路,可能对其他涉及时变环境的AI应用(如金融交易、工业控制、机器人持续学习)也有借鉴意义。
此外,论文所展示的两层防御架构——优化层面的策略调整与防护层面的动作屏蔽——提供了一种将安全要求分级实现的有效范式。当可预测性较高时,可以让优化层发挥作用,在保持动作空间完整性的同时平滑过渡;当预测置信度较低或风险极高时,则激活防护层以硬约束的方式兜底。这种可调节的保守性设计在工程实现上具有很好的灵活性,值得在其他安全关键系统中参考。
摘要
在非平稳环境下确保强化学习的安全性,需要确定学习系统能否在所需的恢复时域内安全地适应预测到的环境变化。现有的安全强化学习方法通常假定环境是平稳的,并且没有明确地将适应速度视为安全问题。然而,当环境随时间演变时,适应延迟可能导致瞬态的不安全行为。本文提出将调整速度作为非平稳强化学习的一项安全约束。其核心思想是从适应可行性的角度定义安全性:当维持安全所需的适应超出学习系统校准后的恢复能力时,未来状态或区域可能变得不安全。所提框架利用学习到的上下文表示和短时域上下文预测来估计适应需求,并将其与智能体可达的适应能力进行比较。当预测的适应需求超出校准后的恢复能力时,该框架主动收紧可行动作集合,并激活动作层面的屏蔽机制,以在违规行为发生之前减少不安全行为。在非平稳驾驶环境中的实验表明,所提方法主要在与上下文变化对齐的短时域窗口内减少了安全违规。消融研究进一步表明,屏蔽机制在抑制峰值风险和尾部风险时更为保守,而优化层面的调整则在短时域切换条件下的违规方面带来进一步的削减。这些结果支持将适应可行性作为非平稳强化学习的一项实用安全原则,并表明主动干预能够在环境变化时期改善安全性。
Abstract
Ensuring safety in reinforcement learning under nonstationarity requires determining whether a learning system can safely adapt to forecasted environmental change within the required recovery horizon. Existing safe reinforcement learning methods typically assume stationary environments and do not explicitly consider adaptation speed as a safety concern. However, when environments evolve over time, delayed adaptation may result in transient unsafe behavior. This paper proposes adjustment speed as a safety constraint for nonstationary reinforcement learning. The central idea is to define safety in terms of adaptation feasibility: future states or regions may become unsafe when the adaptation required to remain safe exceeds the learning system's calibrated recovery capacity. The proposed framework uses learned context representations and short-horizon context forecasts to estimate adaptation demand and compare it with the agent's achievable adaptation capacity. When predicted adaptation demand exceeds the calibrated recovery capacity, the framework proactively tightens the admissible action set and activates an action-level shield to reduce unsafe behavior before violations occur. Experiments in a nonstationary driving environment show that the proposed approach primarily reduces safety violations in short-horizon windows aligned with context changes. Ablation studies further show that shielding is more conservative for peak- and tail-risk suppression, while optimization-level adjustment provides additional reductions in short-horizon switch-conditioned violations. These results support adaptation feasibility as a practical safety principle for reinforcement learning under nonstationarity and demonstrate that proactive intervention can improve safety during periods of environmental change.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。