
带世界状态寄存器的流式多智能体自回归扩散模型
Streaming Multi-Agent Autoregressive Diffusion Model with World State Registers
📝 TLDR
多智能体交互式世界模型需在生成一致观测的同时维护跨智能体持久世界状态。现有自回归视频扩散以历史观测为条件,难以共享全局状态。WorldWeaver (W²) 引入跨智能体世界状态寄存器与Mixture-of-Transformers架构,在双智能体Minecraft视频生成中提升逻辑一致性与画面质量,为流式多智能体世界建模提供显式状态跟踪方案。
🧭 速览
多智能体自回归视频扩散中,历史观测作为条件难以维持跨智能体共享的持久世界状态。
引入跨智能体可学习世界状态寄存器跟踪共享与个体状态,每块生成后动态更新;采用Mixture-of-Transformers分离世界状态与视觉帧建模权重。
在双智能体Minecraft视频生成中,显式世界状态建模显著提升逻辑一致性与生成质量。
显式跨智能体世界状态寄存器有效维持多智能体场景状态持久性,为流式世界模型提供新思路。
🆚 方法对比
WorldWeaver (W^2)
- 显式建模共享世界状态而非隐式推断
- 在双智能体Minecraft中改善逻辑一致性
- 支持跨智能体与跨视角的状态持久化
- 动态更新寄存器适应长时生成
- 框架复杂度较高
- 实验仅限双智能体Minecraft场景
- 额外寄存器带来计算开销
- 未验证更多智能体扩展性
World State Registers
- 可学习令牌存储共享世界信息
- 每次生成后动态增量更新
- 支持多源监督信号接地
- 缓解每步重新推断世界信息问题
- 依赖多类标注信号(BEV、文本等)
- 寄存器容量限制可能影响表达
- 动态更新增加训练不稳定性
- 需要额外监督数据
Mixture-of-Transformers (MoT)
- 状态建模与帧建模权重解耦
- 减少目标竞争提升寄存器学习
- 稳定流式自回归生成过程
- 保持状态与视觉路径耦合
- 参数量增加带来存储压力
- 架构更复杂训练成本上升
- 两分支需协同调优
- 推理时可能增加延迟
Self-Forcing 自回归范式
- 减少训练-测试分布差异
- 支持分钟级长视频流式生成
- 与寄存器更新机制兼容性好
- 成熟扩散生成基线
- 原始设计面向单智能体
- 每块需重推断世界状态
- 多智能体一致性不足
- 依赖KV缓存带来显存压力
Chunk-based Autoregressive Video Diffusion
- 块级因果注意力支持流式生成
- 时空联合注意力保证视觉连贯
- 框架成熟易于实现
- KV缓存提高推理效率
- 历史上下文有限难共享状态
- 多视角下与世界状态存在失配
- 无法捕捉未观察到的变化
- 每步重推断世界信息效率低
Semi-supervised World-State Training
- 少量标注即可锚定寄存器语义
- 无标注视频继续改善生成质量
- 降低标注成本与数据门槛
- 充分利用大规模无标注数据
- 标注质量影响锚定效果
- 半监督训练引入额外调参负担
- 无标注数据下监督信号弱
- 收敛性可能不如全监督
本文以WorldWeaver (W^2)为核心框架,将现有基于块的因果视频扩散与Self-Forcing范式作为基线,指出其在多智能体共享世界状态建模上的不足,并提出世界状态寄存器结合MoT架构实现显式、持久、可动态更新的世界状态建模,显著优于仅依赖观测历史的隐式一致性方法。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
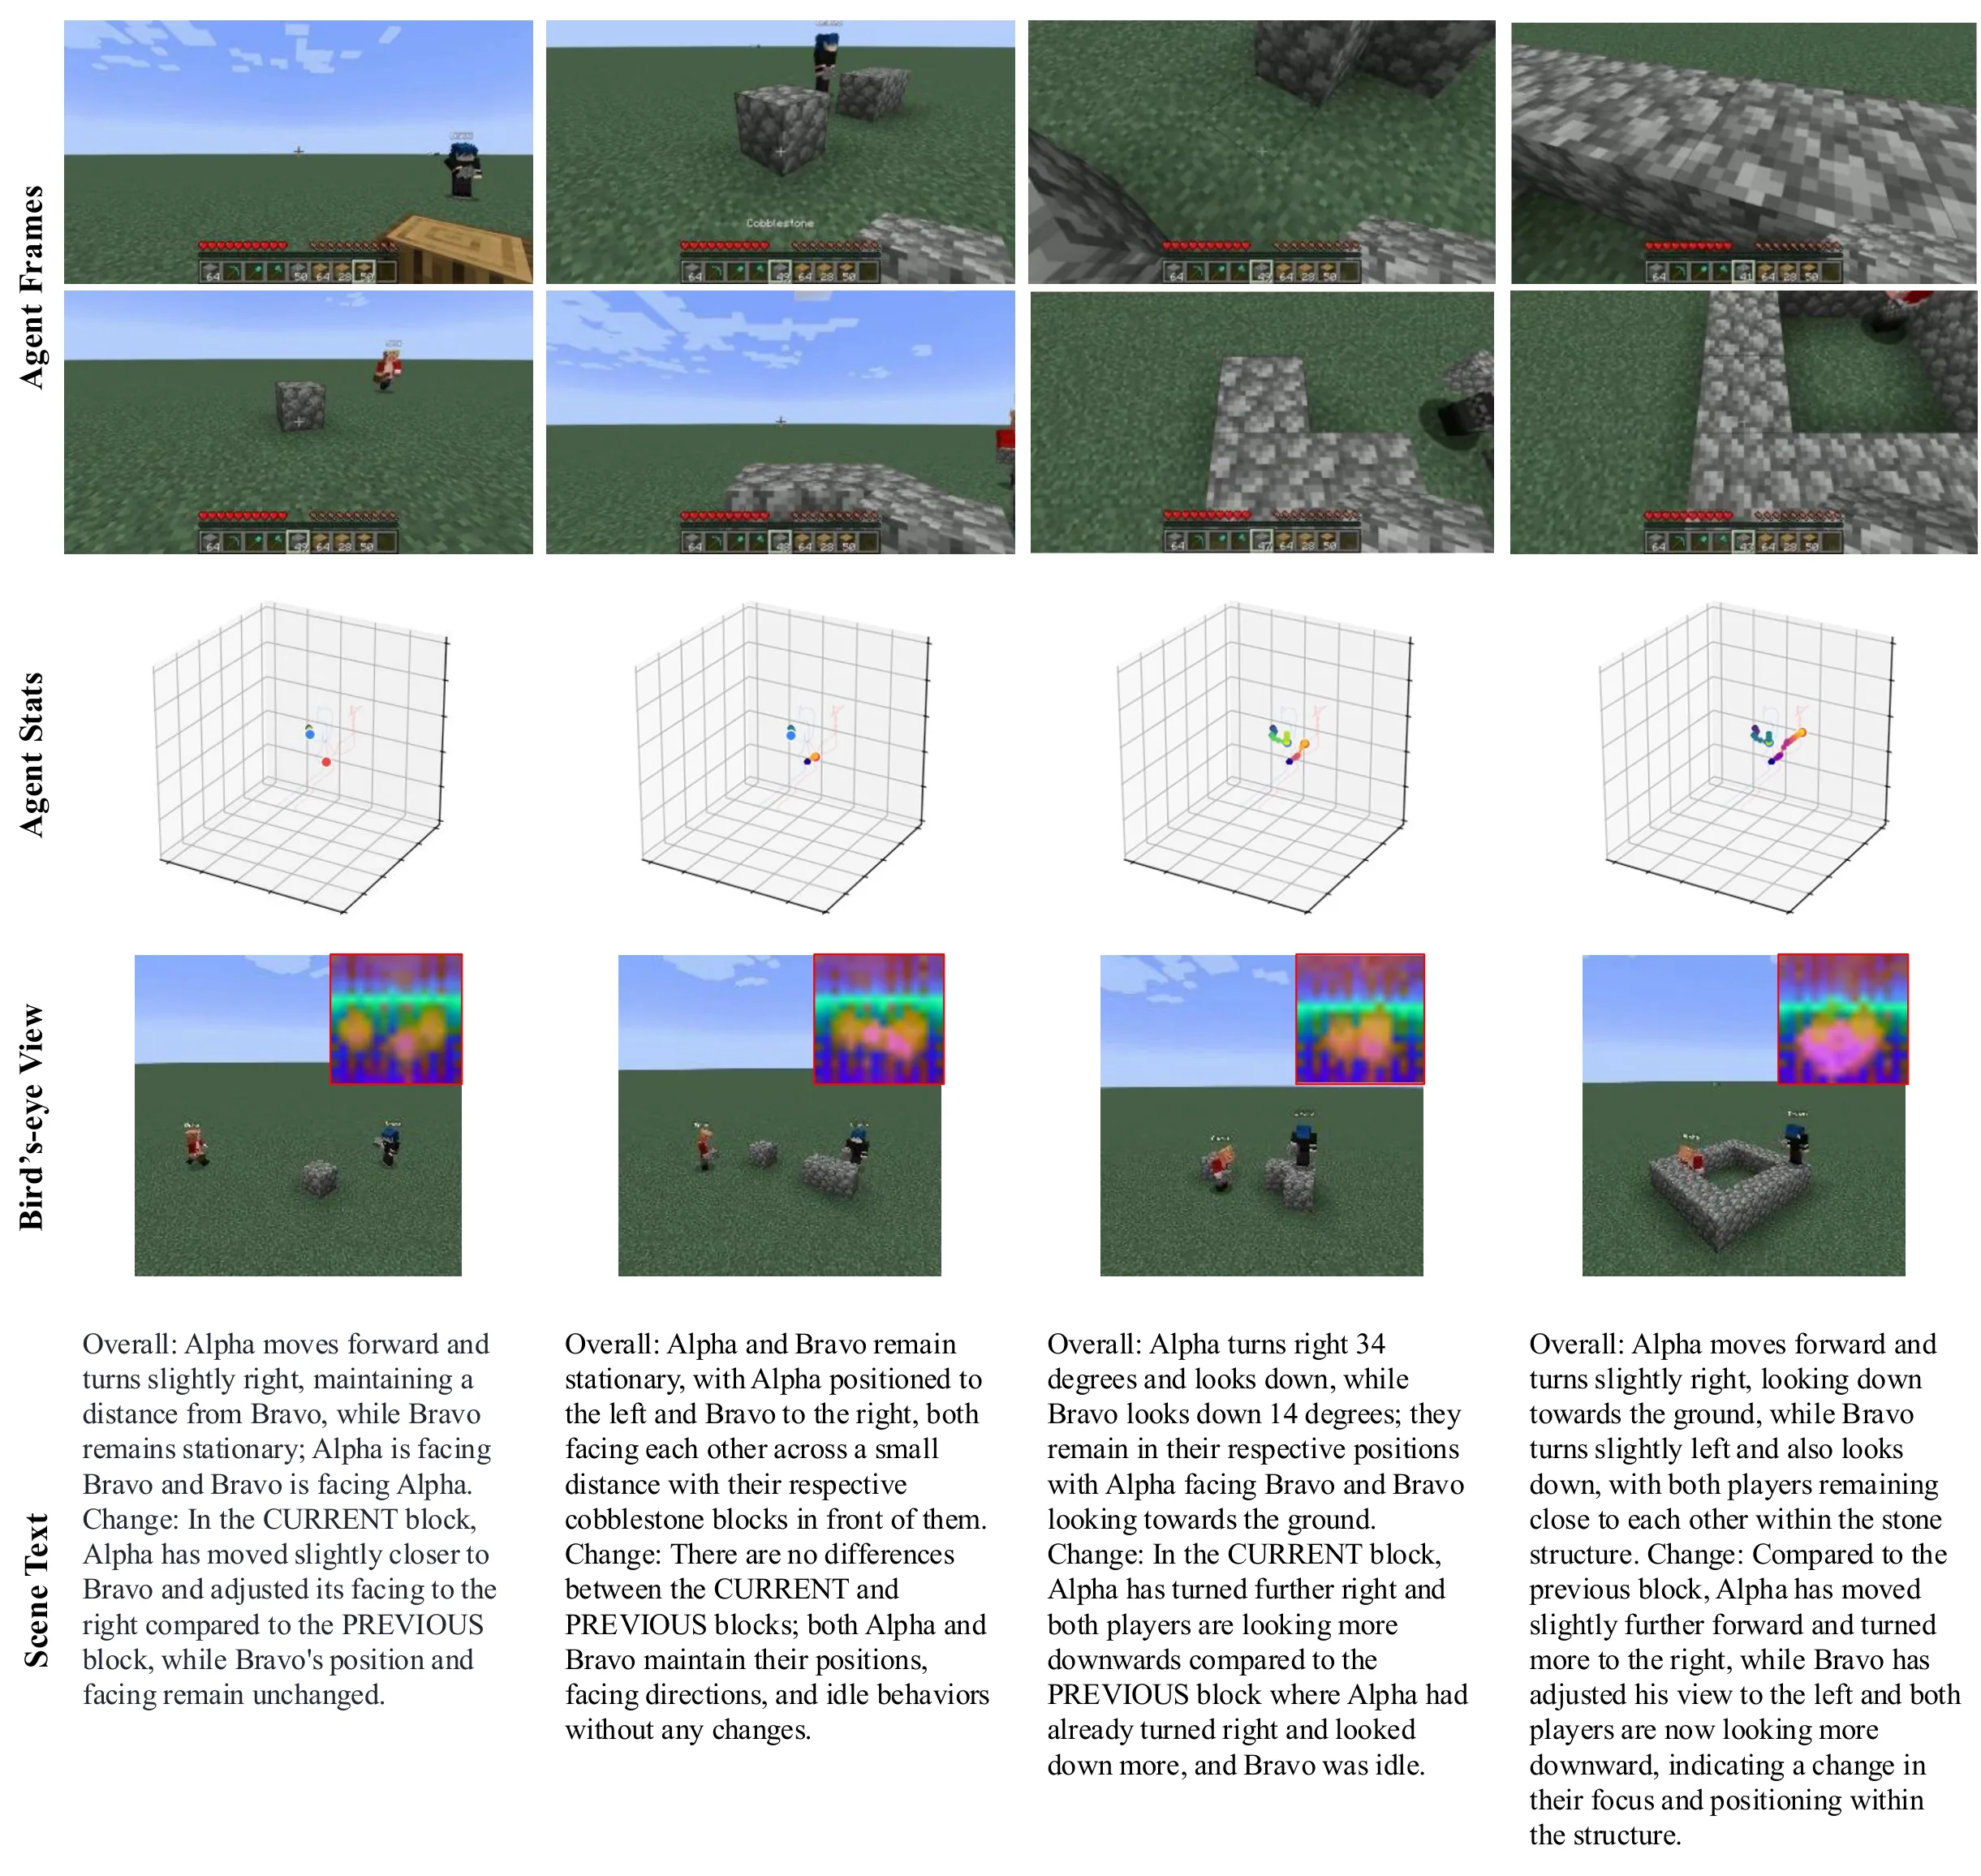
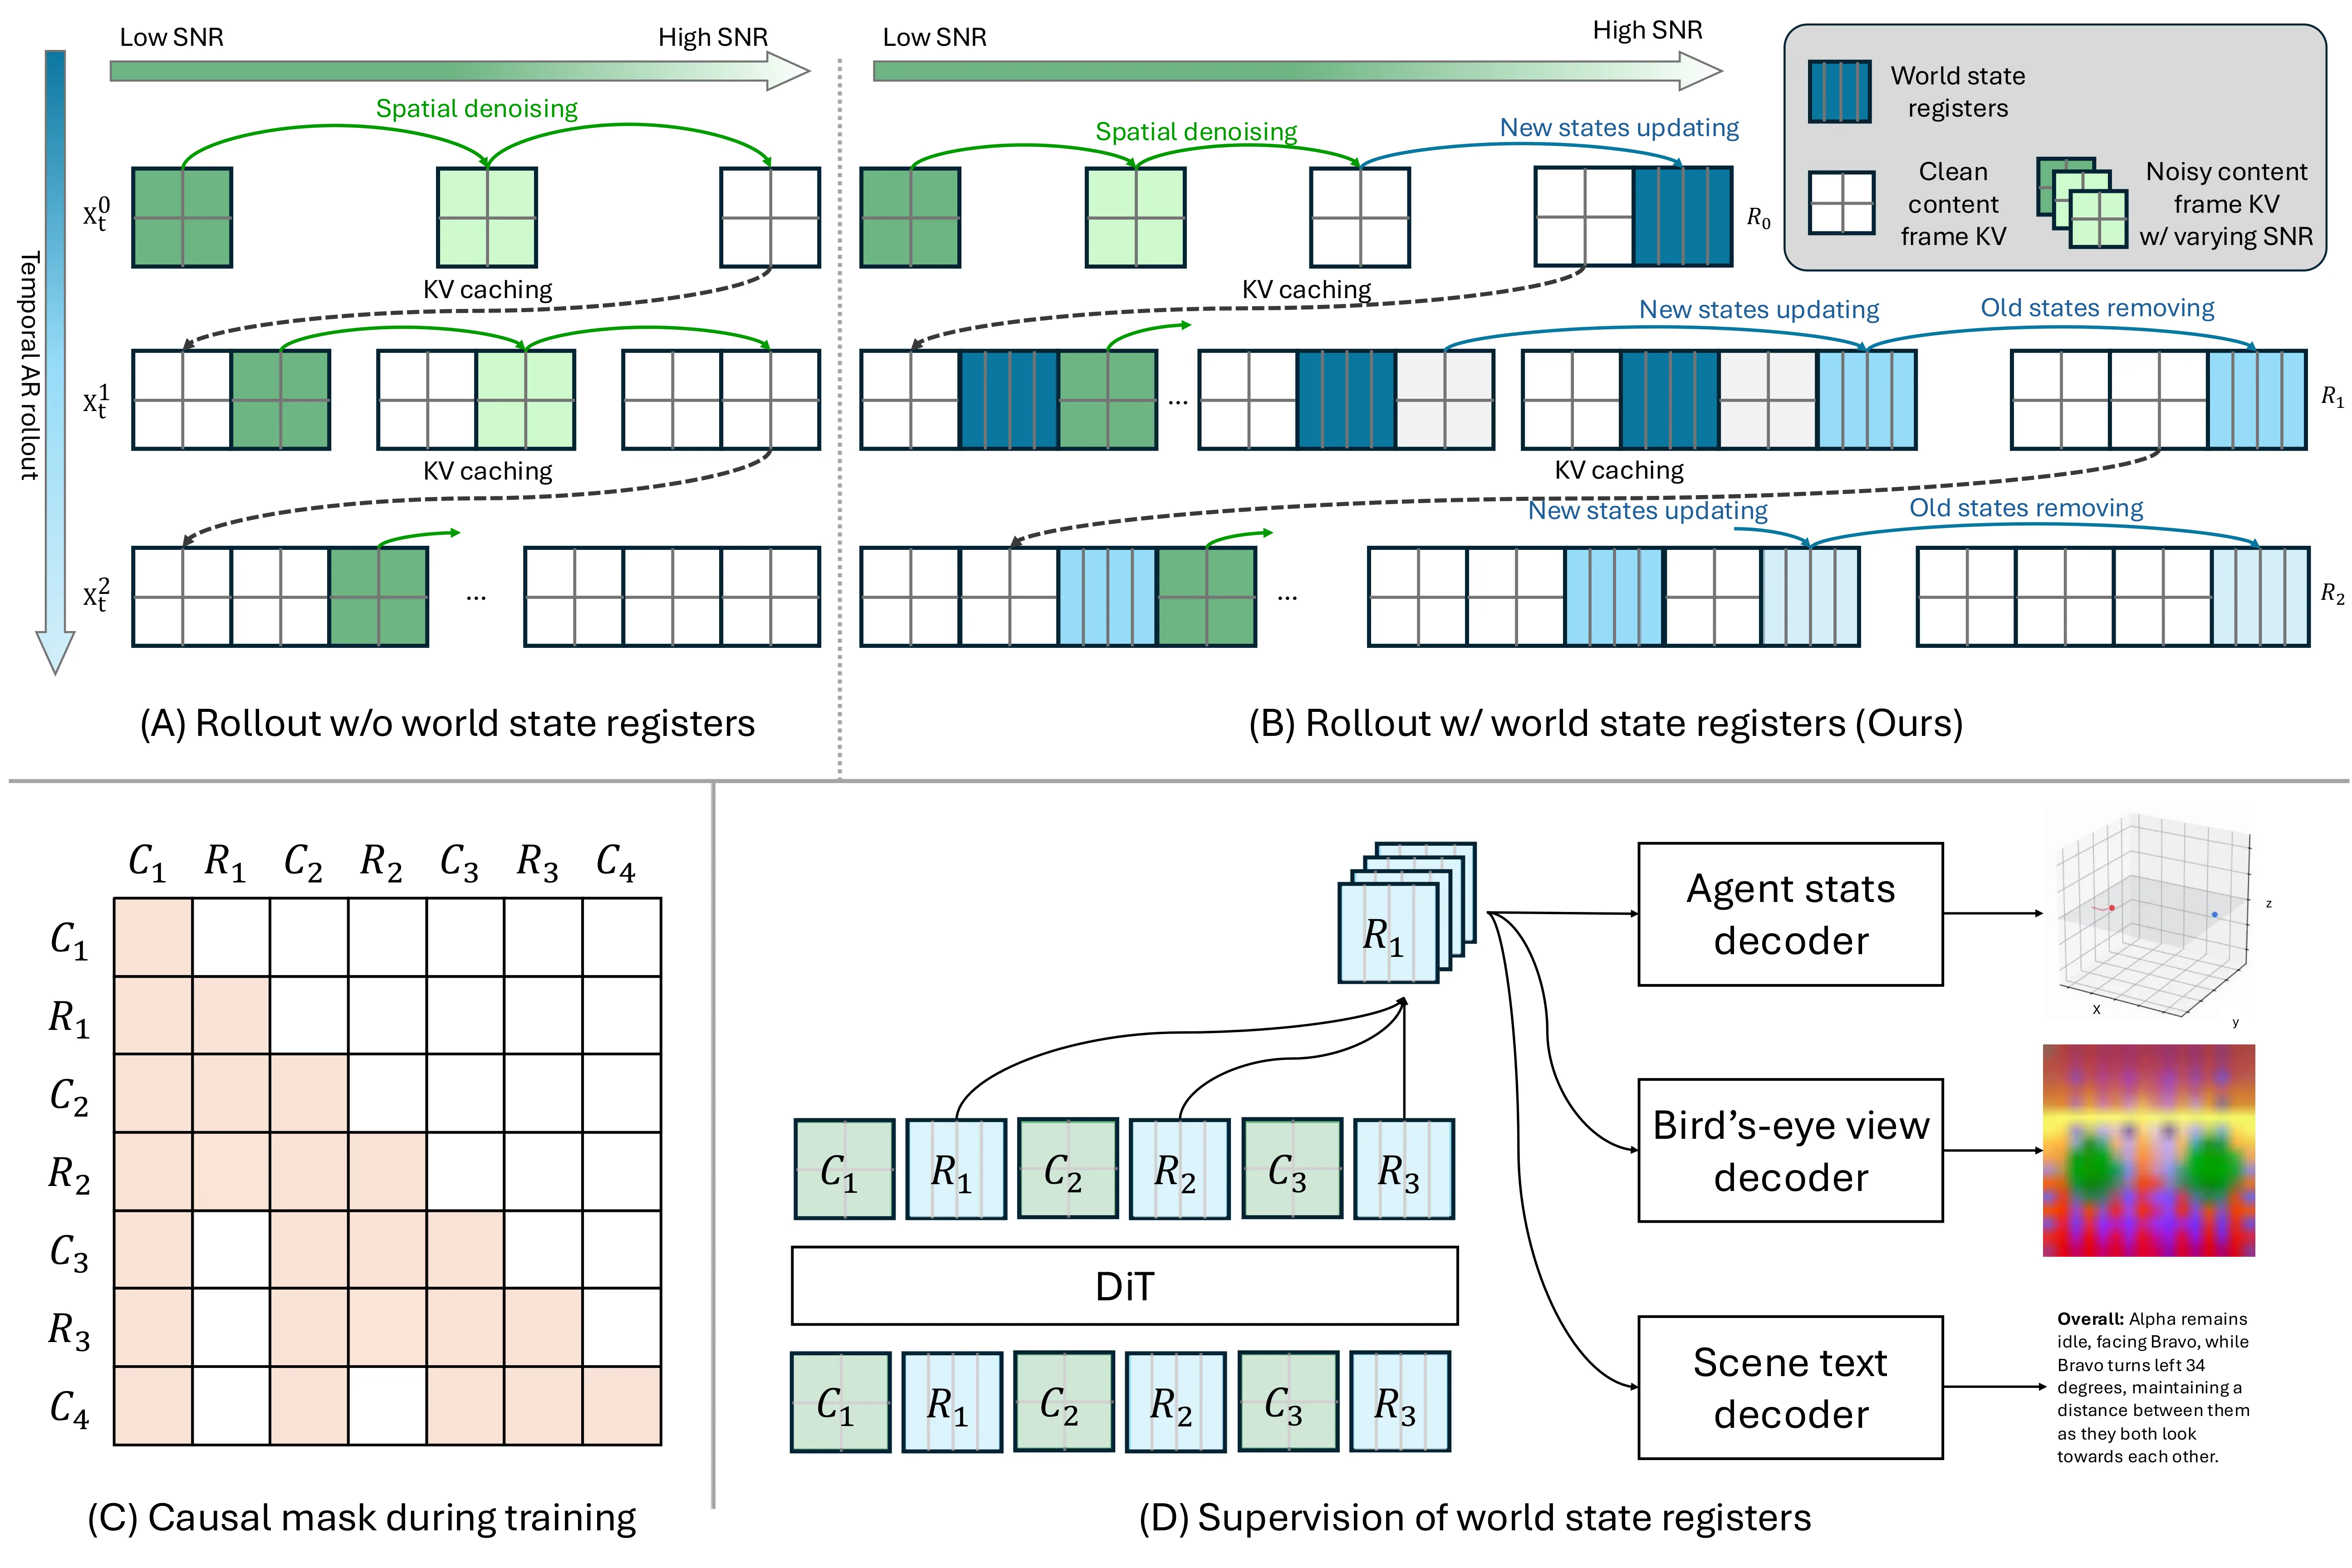
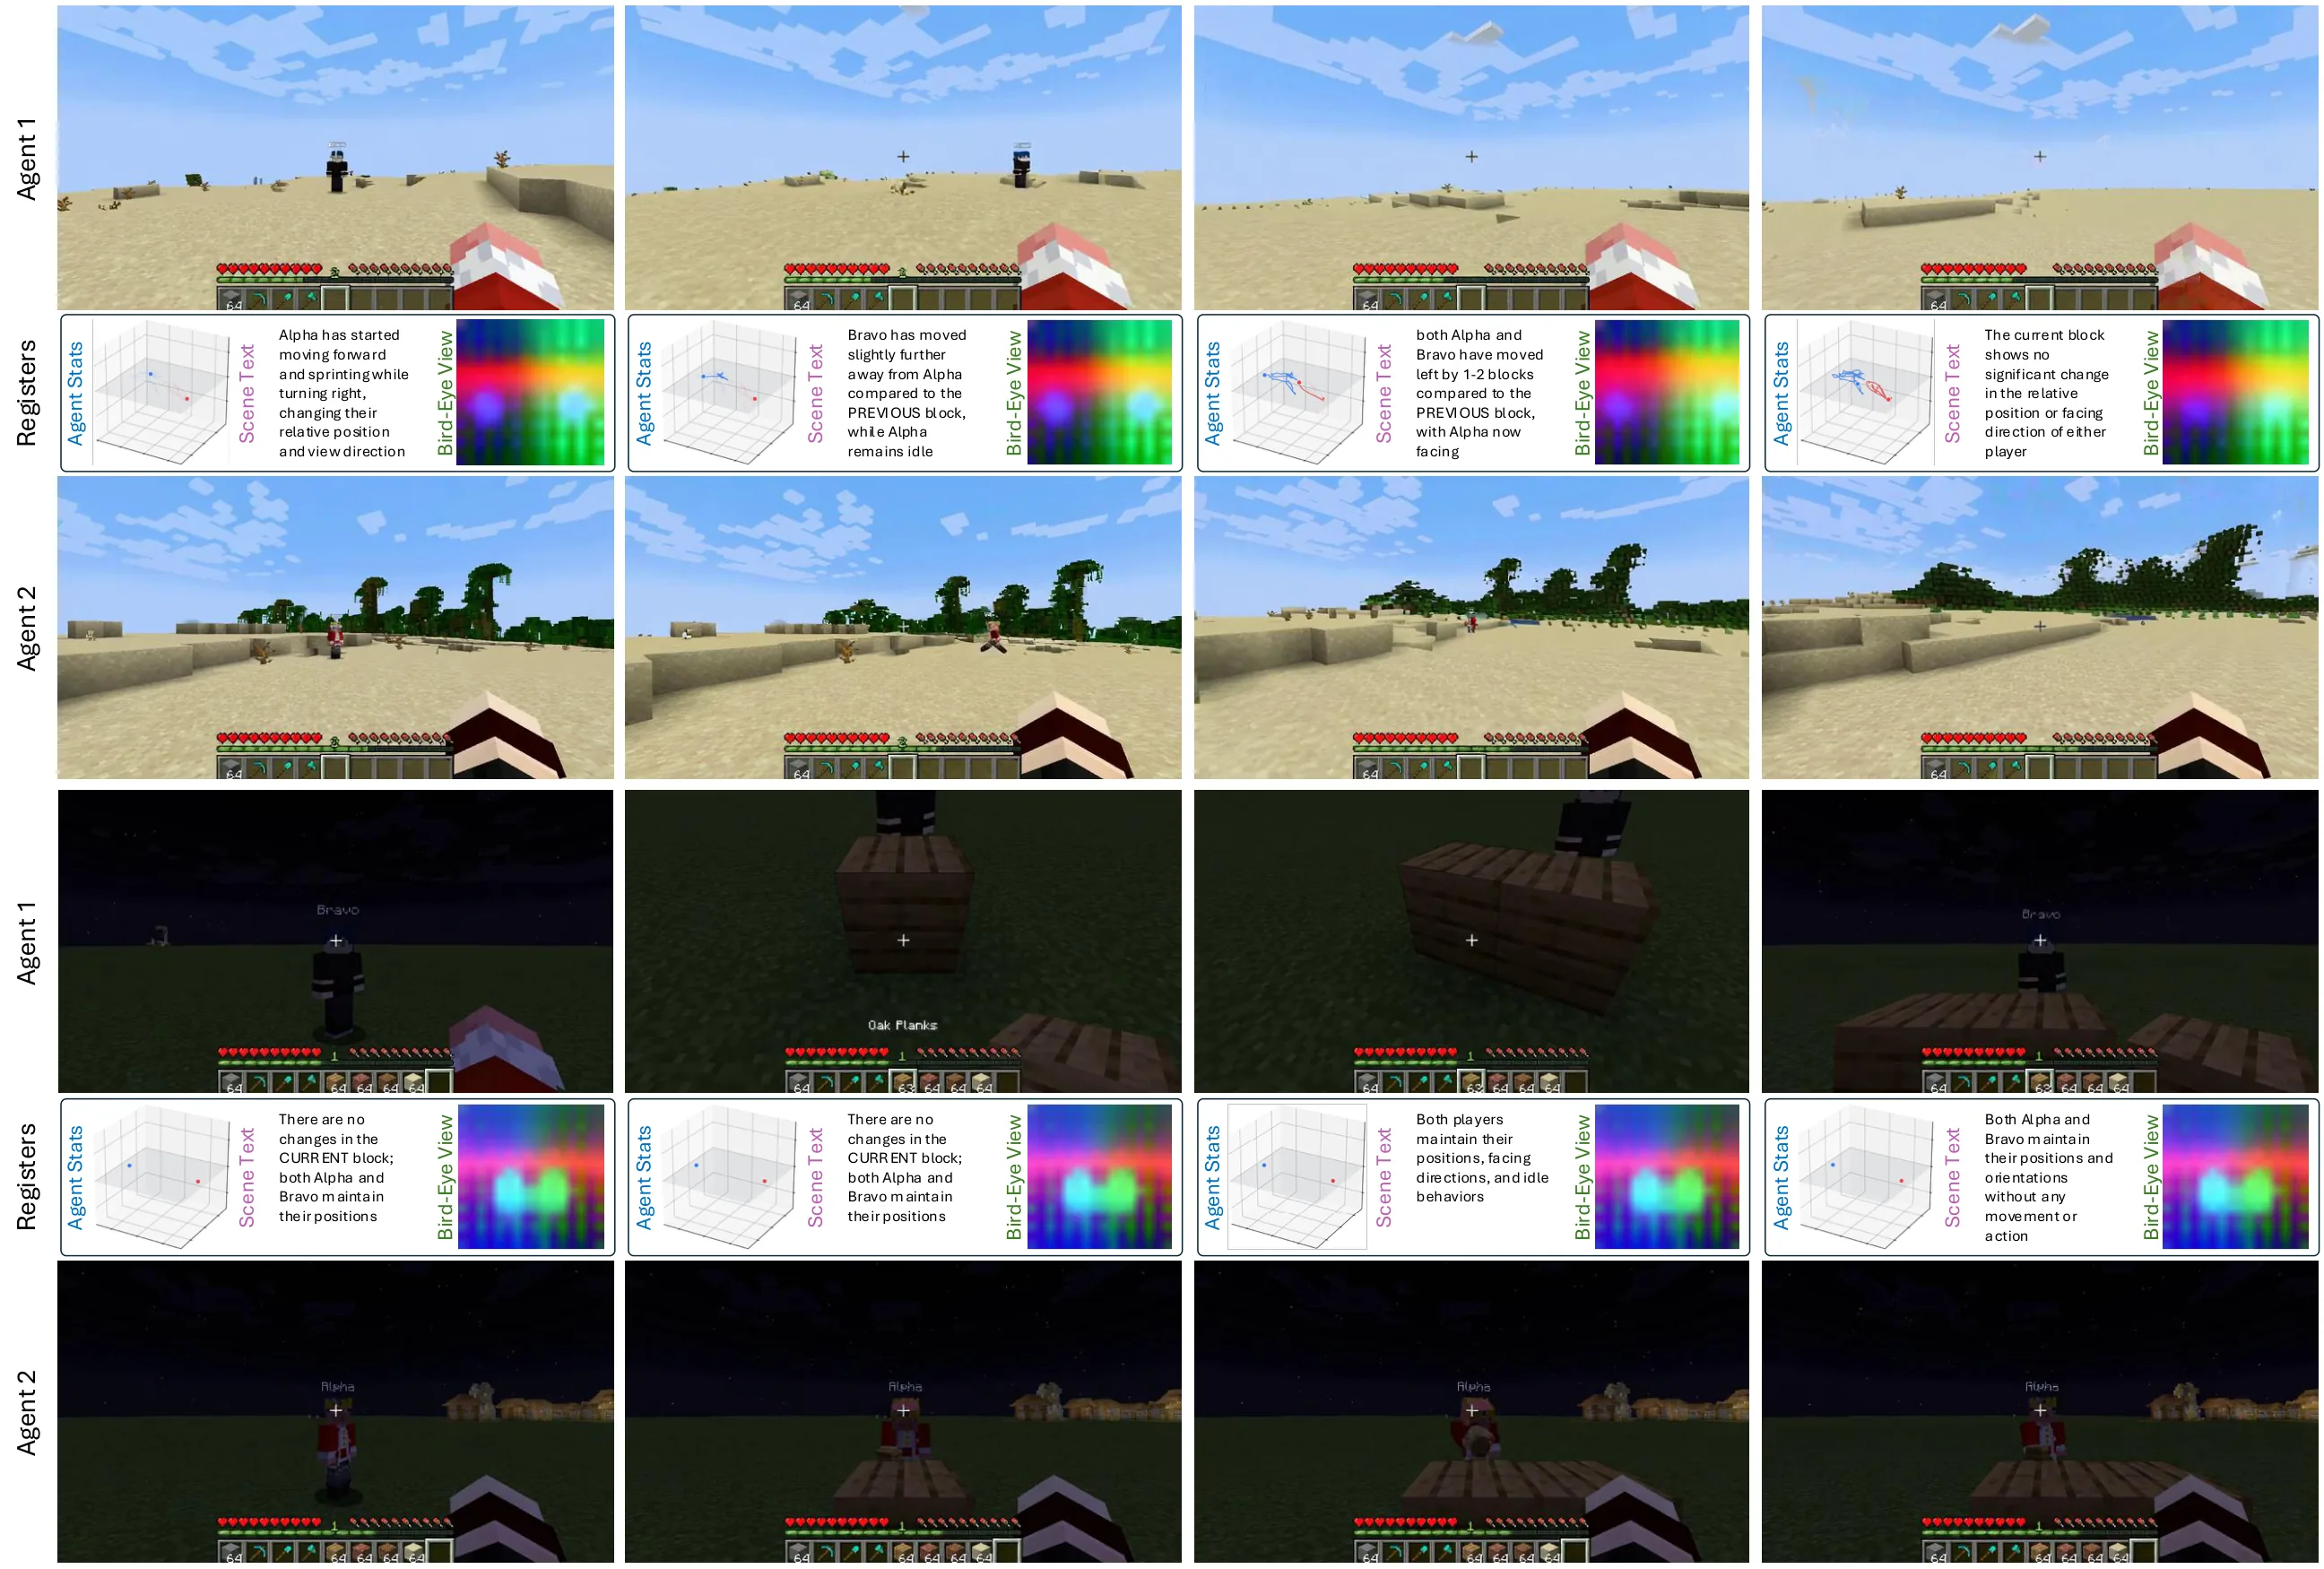
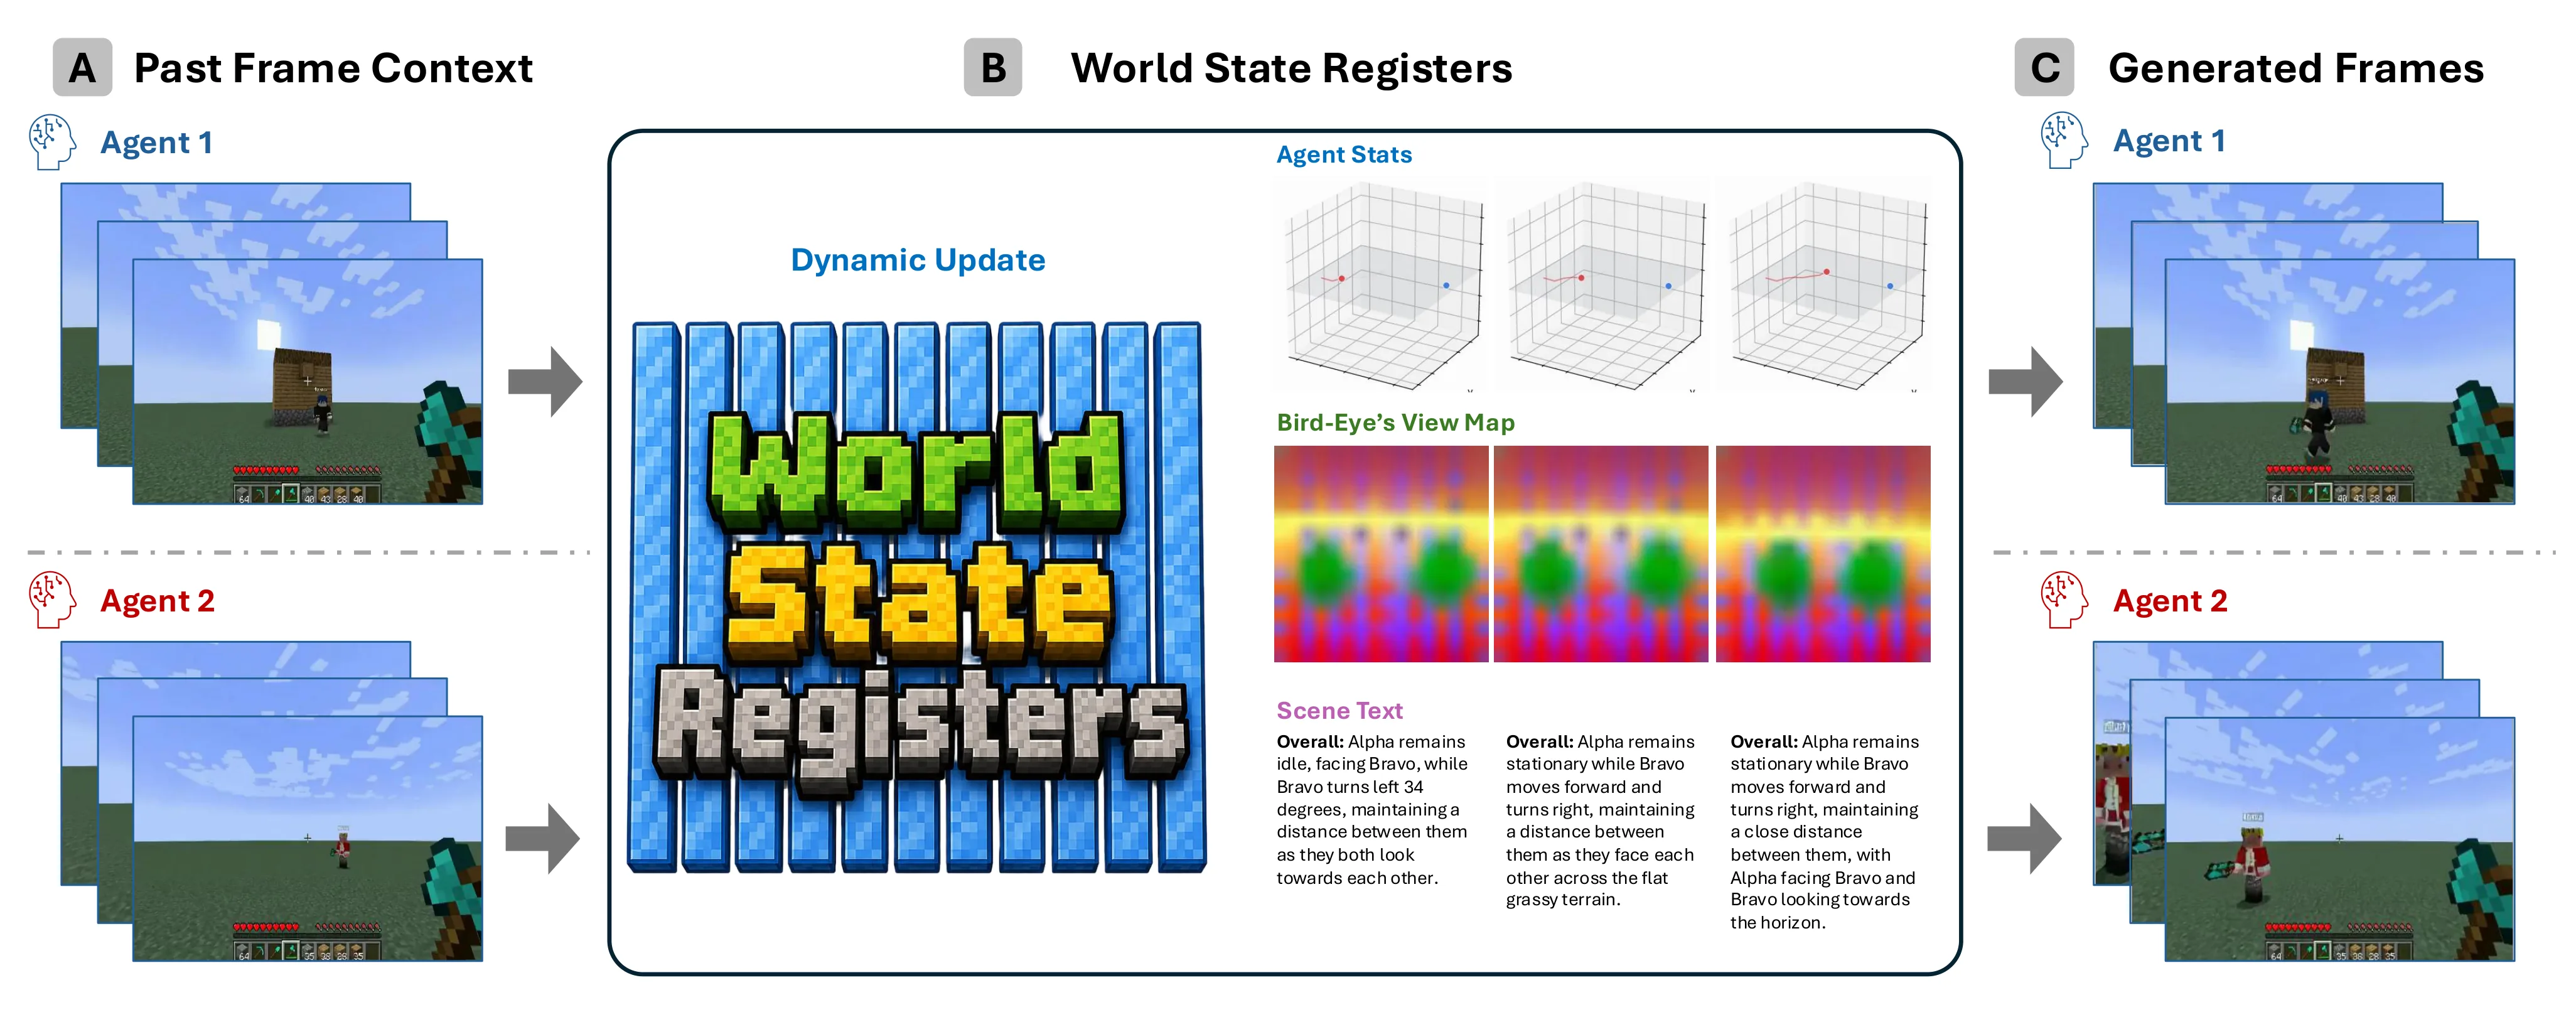
TL;DR
WorldWeaver(W²)提出了一种流式多智能体视频扩散模型,通过引入可学习的世界状态寄存器在多智能体交互场景中维护共享的全局状态。与传统方法仅依赖观测历史作为条件不同,这些寄存器以 token 形式存储跨智能体的共享信息、追踪各智能体状态,并在每个生成块后动态更新。在双智能体 Minecraft 视频生成任务中,该方法显著提升了逻辑一致性与画面质量。
研究背景与动机
构建能够模拟真实世界的多智能体交互式世界模型是人工智能研究的核心目标之一。这类模型不仅要生成逼真的观测结果,还需要维护一个在智能体之间持续存在、随视角演化而更新的世界状态——例如物体的位置、智能体的生命值、游戏中的资源状态等。理想情况下,当多个智能体从不同视角观察同一场景时,它们应当对世界的当前状态形成一致的理解。
然而,现有主流方法在这一问题上存在根本性困难。当前的自回归视频扩散模型通常采用将观测历史作为条件上下文向前传递的方式:给定过去几帧的生成结果,模型预测下一帧或下一个视频片段。这种设计在单智能体场景下运作良好,因为所有历史信息都可以被视为该智能体自身的记忆。但在多智能体、多视角的复杂场景中,这种方式面临严峻挑战:不同智能体需要共享的全局状态难以通过单纯的观测历史传递,每个智能体只能看到自己视角内的信息,而无法直接访问其他智能体看到的画面或世界的客观状态。这导致了状态不一致、逻辑冲突等问题。
WorldWeaver 的核心洞察是:要让多智能体世界模型真正工作,需要一个显式的状态表示机制,能够跨智能体共享、随时间演化、并通过多模态监督信号进行约束。这正是该论文的出发点——设计一个能够主动维护和更新世界状态的架构,而不是被动依赖历史观测。
方法
WorldWeaver 的核心创新在于引入了世界状态寄存器(World State Registers)这一概念。这些寄存器本质上是若干个可学习的 token,它们在生成过程中扮演着“共享记忆”的角色:每个寄存器 token 编码了世界的特定方面(如某个智能体的位置、某个物体的状态),而所有寄存器共同构成了对当前世界状态的完整表示。
具体实现中,WorldWeaver 在标准视频扩散模型的 Transformer 架构基础上增加了一个专门的寄存器组件。在每个生成块(chunk)开始时,当前的世界状态寄存器 token 与视觉 token、时序位置编码等一同输入模型。模型在生成该块的所有帧的同时,会输出对寄存器的更新信号。更新后的寄存器随后被馈入下一个生成块的计算中,形成一个动态的状态传播链。
这种方法的一个关键设计考量是多模态锚定。仅有寄存器 token 本身并不能保证它们真正学到有意义的世界状态——模型完全可能让这些 token 退化为单纯的隐变量,无法解释其含义。为此,WorldWeaver 采用了三重监督信号对寄存器进行约束:针对个体智能体状态的监督(确保每个智能体的寄存器副本与其实际状态一致)、针对全局状态视图的监督(使用鸟瞰图作为世界状态的客观参照)、以及针对场景文本的监督(将文字描述的世界状态也作为监督信号)。这三种信号从不同角度对寄存器进行约束,形成多视图的监督学习。
在模型架构层面,WorldWeaver 采用了Mixture-of-Transformers设计。传统的做法是让同一个 Transformer 同时处理世界状态建模和视觉帧生成两项任务,但这可能导致两者相互干扰。WorldWeaver 的解决方案是为这两类任务使用相互独立的权重——状态建模分支和视觉生成分支各有自己的参数空间,通过精心设计的交互机制在必要时进行信息交换。这种设计允许每个分支专注于自己的目标,同时保持整体的一致性。
整体流程可以形式化为:设 表示第 个生成块开始时的世界状态寄存器, 表示待生成的视频片段,模型学习一个条件分布 ,同时学习更新规则 ,其中 由监督信号共同约束。
实验与结果
WorldWeaver 的实验聚焦于双智能体 Minecraft 视频生成任务,这是一个具有挑战性的多智能体交互环境:两个独立的智能体(可以理解为两个玩家或角色)在同一个世界中活动,它们的行为可能相互影响,生成视频需要保持像素级的画面质量和更高层次的逻辑一致性。
实验采用了多种基线方法进行对比,包括标准自回归视频扩散(仅用观测历史条件)、不带寄存器增强的基线、以及使用其他状态表示方法的变体。主要评估指标涵盖视频质量指标(如 FID、CLIP Score)和逻辑一致性指标——后者专门衡量生成视频中多智能体状态的一致程度,例如两个智能体的相对位置关系是否合理、一个智能体的动作是否在另一个智能体的视野中得到正确反映等。
实验结果清晰地表明,世界状态寄存器的引入带来了显著提升。在视频质量方面,使用寄存器的模型在 FID 分数上优于基线方法,这意味着生成的画面更加逼真。更重要的是,在逻辑一致性指标上,提升幅度更为明显——这直接验证了核心假设:显式的世界状态建模确实能帮助模型维护跨智能体的状态一致性。
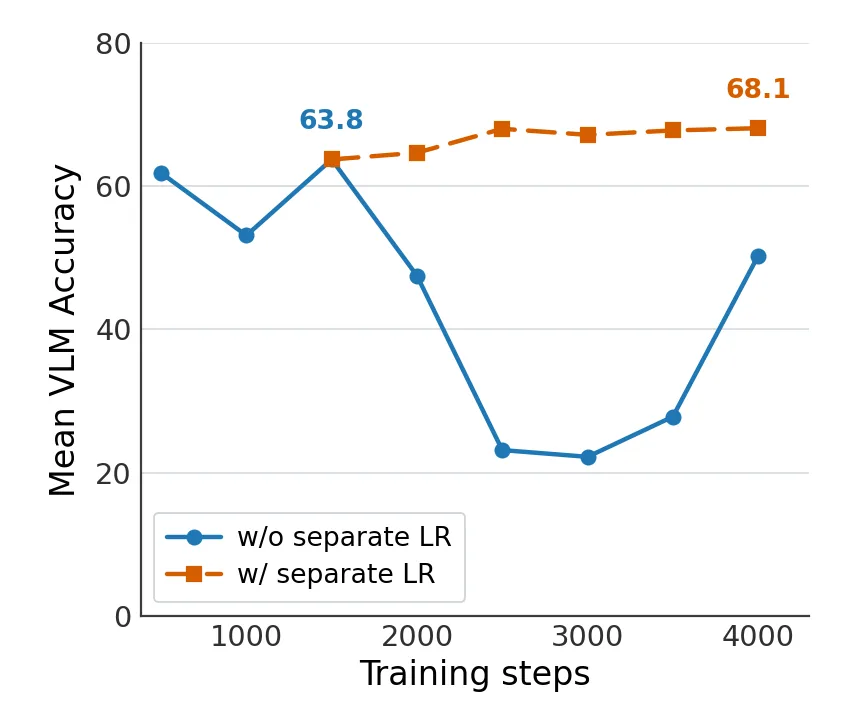
消融实验进一步揭示了各组件的贡献。三重监督信号的引入逐项提升了寄存器质量,其中鸟瞰图监督的作用尤为突出——它为模型提供了一个客观的全局视角,显著降低了状态不一致的发生概率。Mixture-of-Transformers 架构设计同样带来了可观收益,表明分离状态建模与视觉生成任务是合理的。
讨论与可借鉴点
WorldWeaver 为多智能体世界建模提供了一条清晰的思路:通过显式的可学习状态表示来弥补纯观测历史方法的不足。这篇论文的方法论有几个值得借鉴的要点。
首先,多模态监督信号设计的理念具有广泛适用性。当引入难以直接解释的隐变量时,单一监督往往不足以保证其学习到有意义的内容。从多个互补角度(本文中的个体状态、全局视图、文本描述)为隐变量提供监督,是一种有效的正则化策略。
其次,Mixture-of-Experts 的轻量化应用也值得关注。完整的 MoE 架构通常需要复杂的路由机制和大参数量,而 WorldWeaver 仅将专家分离的思想应用于两个相对有限的任务(状态建模与帧生成),用较少的额外参数获得了收益。这种“小而精”的架构设计思路在资源受限场景中很有价值。
当然,当前工作也存在局限。论文目前仅验证了双智能体场景,在更多智能体、更复杂交互下的扩展性有待考察。寄存器的容量(需要多少个 token 才能完整表示复杂世界状态)也是一个未充分讨论的问题。此外,实验集中在 Minecraft 这一特定环境,迁移到其他领域(如自动驾驶、机器人仿真)时的泛化能力尚不明确。
总体而言,WorldWeaver 为流式多智能体世界建模开辟了一个有前景的方向——用显式状态寄存器代替隐式历史传递,或许是未来构建大规模多智能体交互系统的关键组件之一。
摘要
多智能体交互式世界模型不仅应生成一致的观测结果,还应维护在智能体之间持续存在并随视角演化更新的世界状态。现有的自回归视频扩散流水线将观测历史作为条件上下文向前传递,这使得在多智能体和多视角场景下难以维护共享状态。我们提出了 WorldWeaver(W^2),一种流式多智能体视频扩散模型,它通过跨智能体世界状态寄存器来增强推演过程:这些是可学习的 token,用于存储共享世界信息、追踪各智能体状态,并在每个生成的块之后进行动态更新。我们利用涵盖个体智能体状态、包括鸟瞰图在内的全局状态视图以及场景文本的监督信号来对这些寄存器进行锚定。我们还通过混合 Transformer(Mixture-of-Transformers)设计进一步改进架构,为世界状态建模和视觉帧建模使用相互独立的权重。在双智能体 Minecraft 视频生成任务中的大量实验表明,显式的世界状态建模能够提升逻辑一致性和生成质量。
Abstract
Multi-agent interactive world models should not only generate consistent observations, but also maintain world states that persist across agents and evolve across views. Existing autoregressive video diffusion pipelines carry forward observation history as conditioning context, which makes shared state difficult to maintain in multi-agent and multi-view settings. We present WorldWeaver (W^2), a streaming multi-agent video diffusion model that augments rollout with cross-agent world state registers: learnable tokens that store shared world information, track individual agent status, and are dynamically updated after each generated chunk. We ground these registers with supervision signals spanning individual agent status, global state views including bird's-eye views, and scene text. We further improve the architecture with a Mixture-of-Transformers design that uses separate weights for world state modeling and visual frame modeling. Extensive experiments in two-agent Minecraft video generation show that explicit world-state modeling improves logical consistency and generation quality.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。