
📝 TLDR
4D动态物理世界从自然语言自动生成面临物理合理性与可控性难题。GS-Agent提出端到端多智能体框架,将任务分解为3D资产生成、材质调节、放置、运动控制的实体管理,以及相机光照的渲染配置。多个专家智能体通过代码与物理引擎交互,借助多模态反馈迭代协作。实验证明该方法能生成包含液体、可变形体与刚体丰富交互的物理世界,并实现电影级渲染控制,开创4D生成新范式。
🧭 速览
传统CG依赖大量人工调优,生成式基础模型难以兼顾4D世界的物理合理性与精细可控性。
端到端多智能体框架,将任务拆解为实体管理与渲染配置,智能体以代码与物理引擎交互并基于多模态反馈迭代协作。
可将自然语言高效转化为多样、物理合理的4D动态世界,呈现液体、可变形体与刚体间的丰富交互,并支持电影级相机光照控制。
为4D世界生成与物理AI研究提供了基于智能体协同的新基础范式,赋能创意内容自动生产。
🆚 方法对比
GS-Agent
- 端到端多智能体框架,自动化4D世界创建全流程
- 集成物理引擎,生成动态且物理合理的4D世界
- 支持液体、可形变体与刚体的丰富交互
- 多模态反馈驱动迭代优化,具备相机与光照控制
- 依赖底层基础模型能力,生成质量受限
- 多智能体迭代流程计算开销较大
- 物理合理性与可控性的评估仍具挑战
- 3D资产筛选与材质调优依赖检索质量
传统计算机图形学方法
- 材质、运动与视觉保真度精细可控
- 物理仿真成熟,结果确定性可复现
- 需大量人工调优,人力成本极高
- 难以从自然语言直接生成,扩展性差
- 创作周期长,难以规模化部署
现有生成式基础模型4D生成方法
- 可从大规模数据学习并自动生成4D世界
- 降低人工门槛,支持自然语言输入
- 物理合理性不足,易产生不合理交互
- 可控性差,难以精确操控实体与运动
物理引擎(Physics Engines)
- 保障刚体、液体、可形变体的物理真实性
- 提供确定性仿真与可复现的物理行为
- 仿真计算成本高,复杂场景耗时长
- 与生成模型集成存在接口适配难题
传统CG方法可控但费人力,现有生成模型易自动化但缺乏物理保真;GS-Agent通过多智能体协同将生成模型与物理引擎结合,在自动化、物理合理性与可控性之间取得更优平衡。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 8 张)
展开查看 8 张图
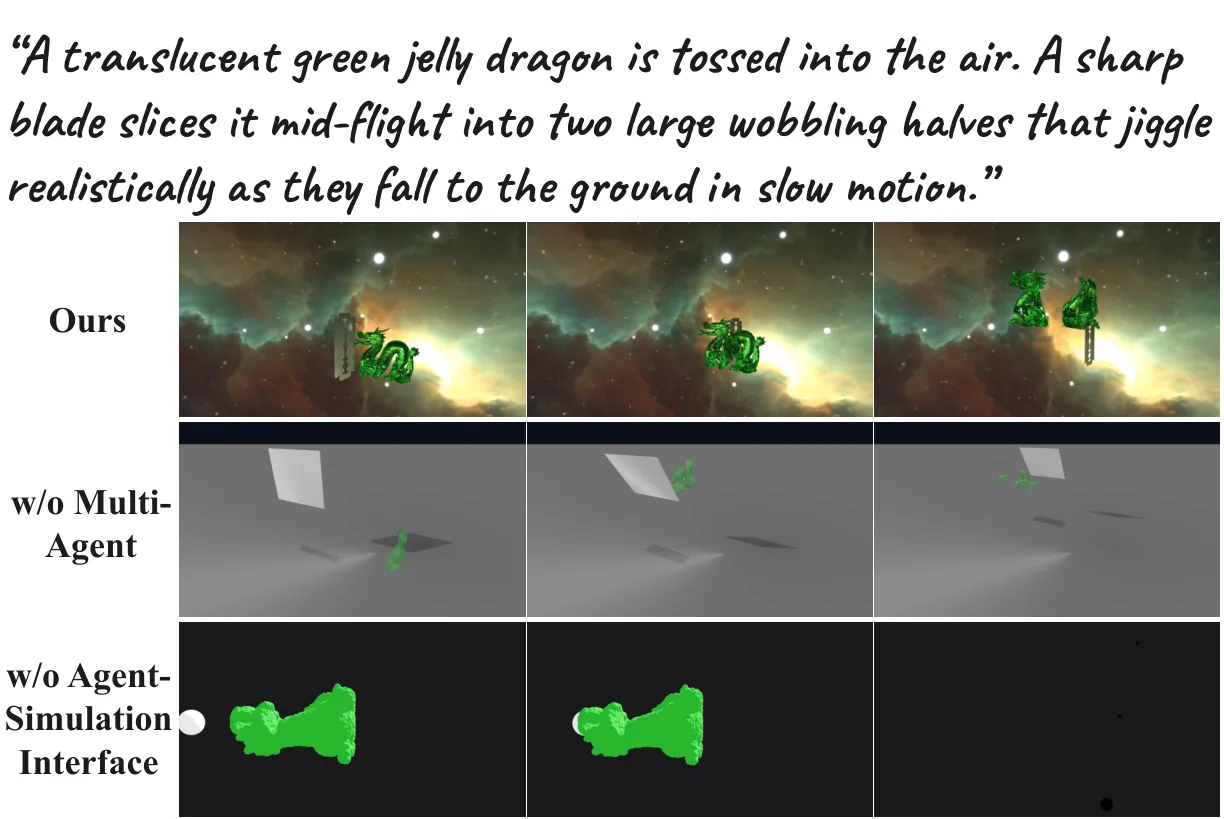
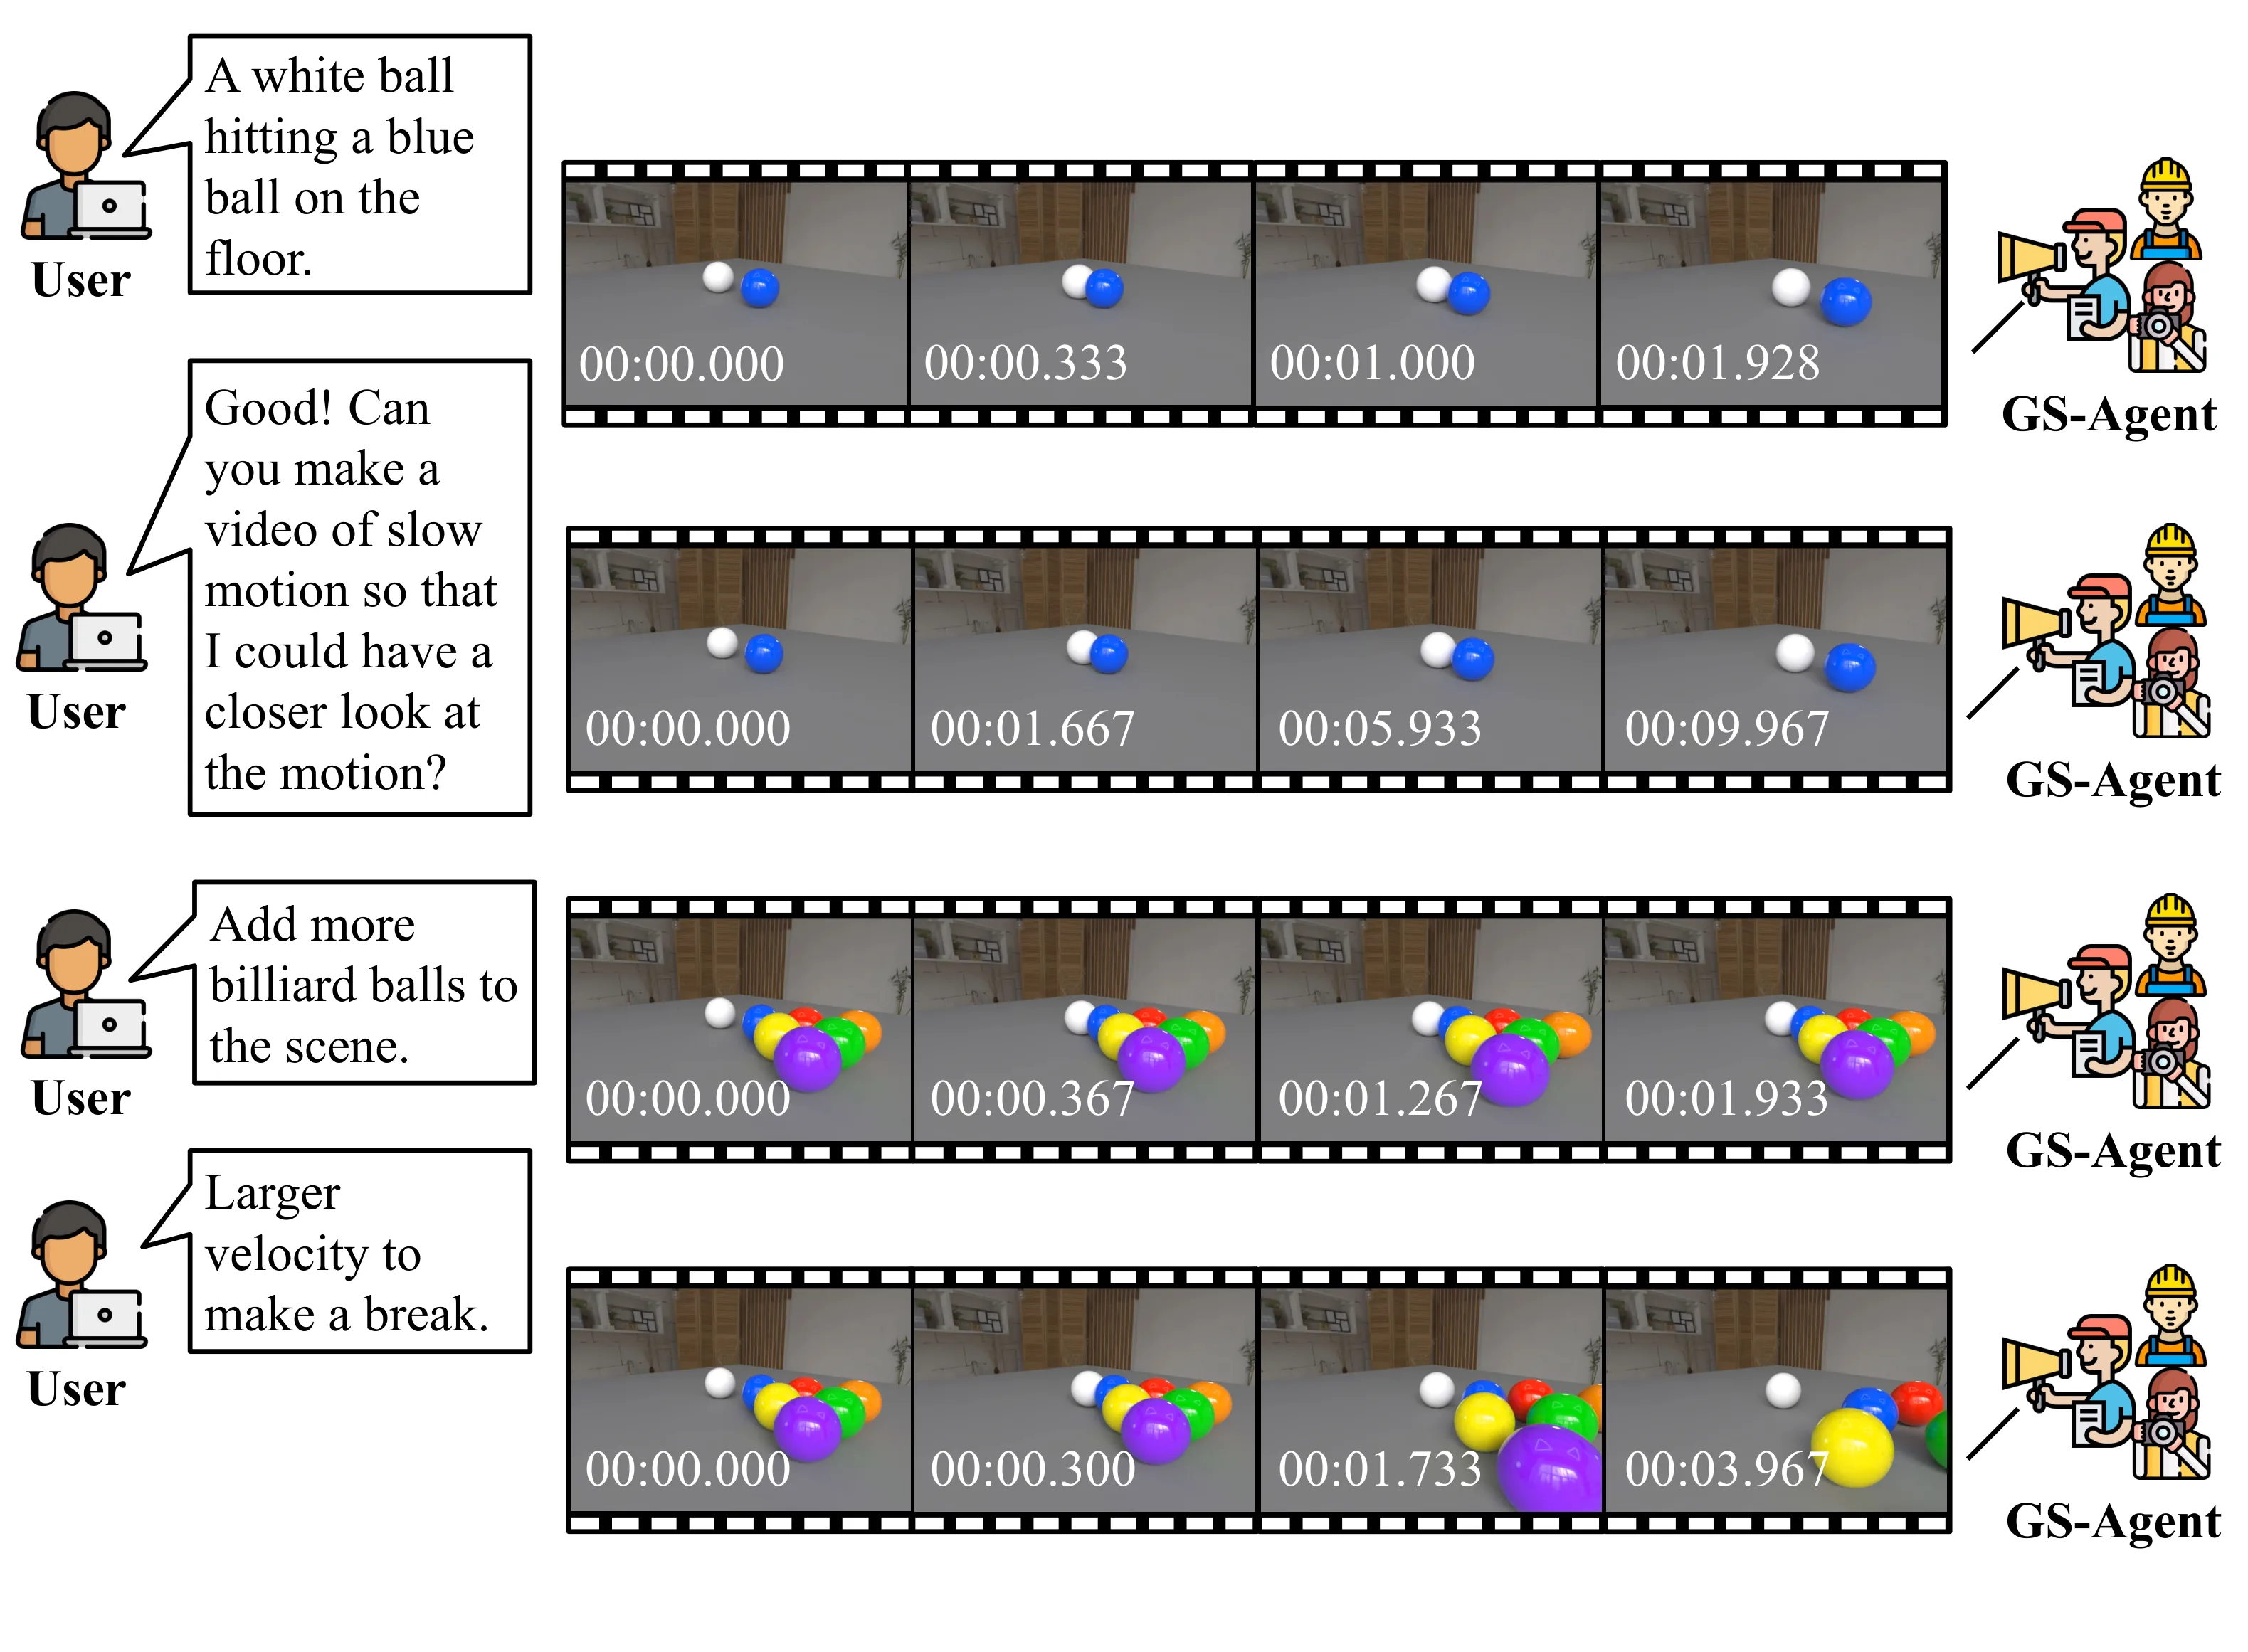
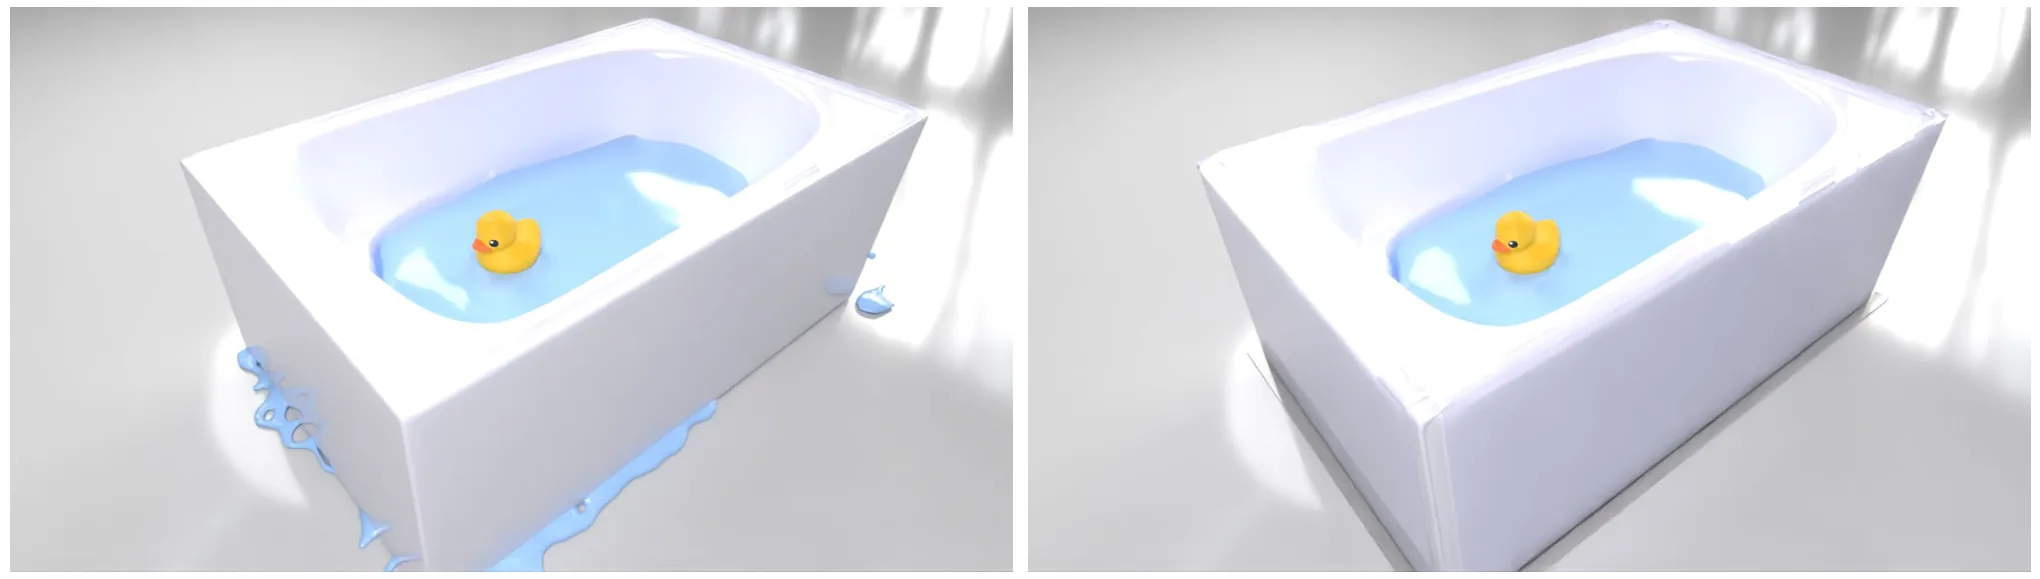
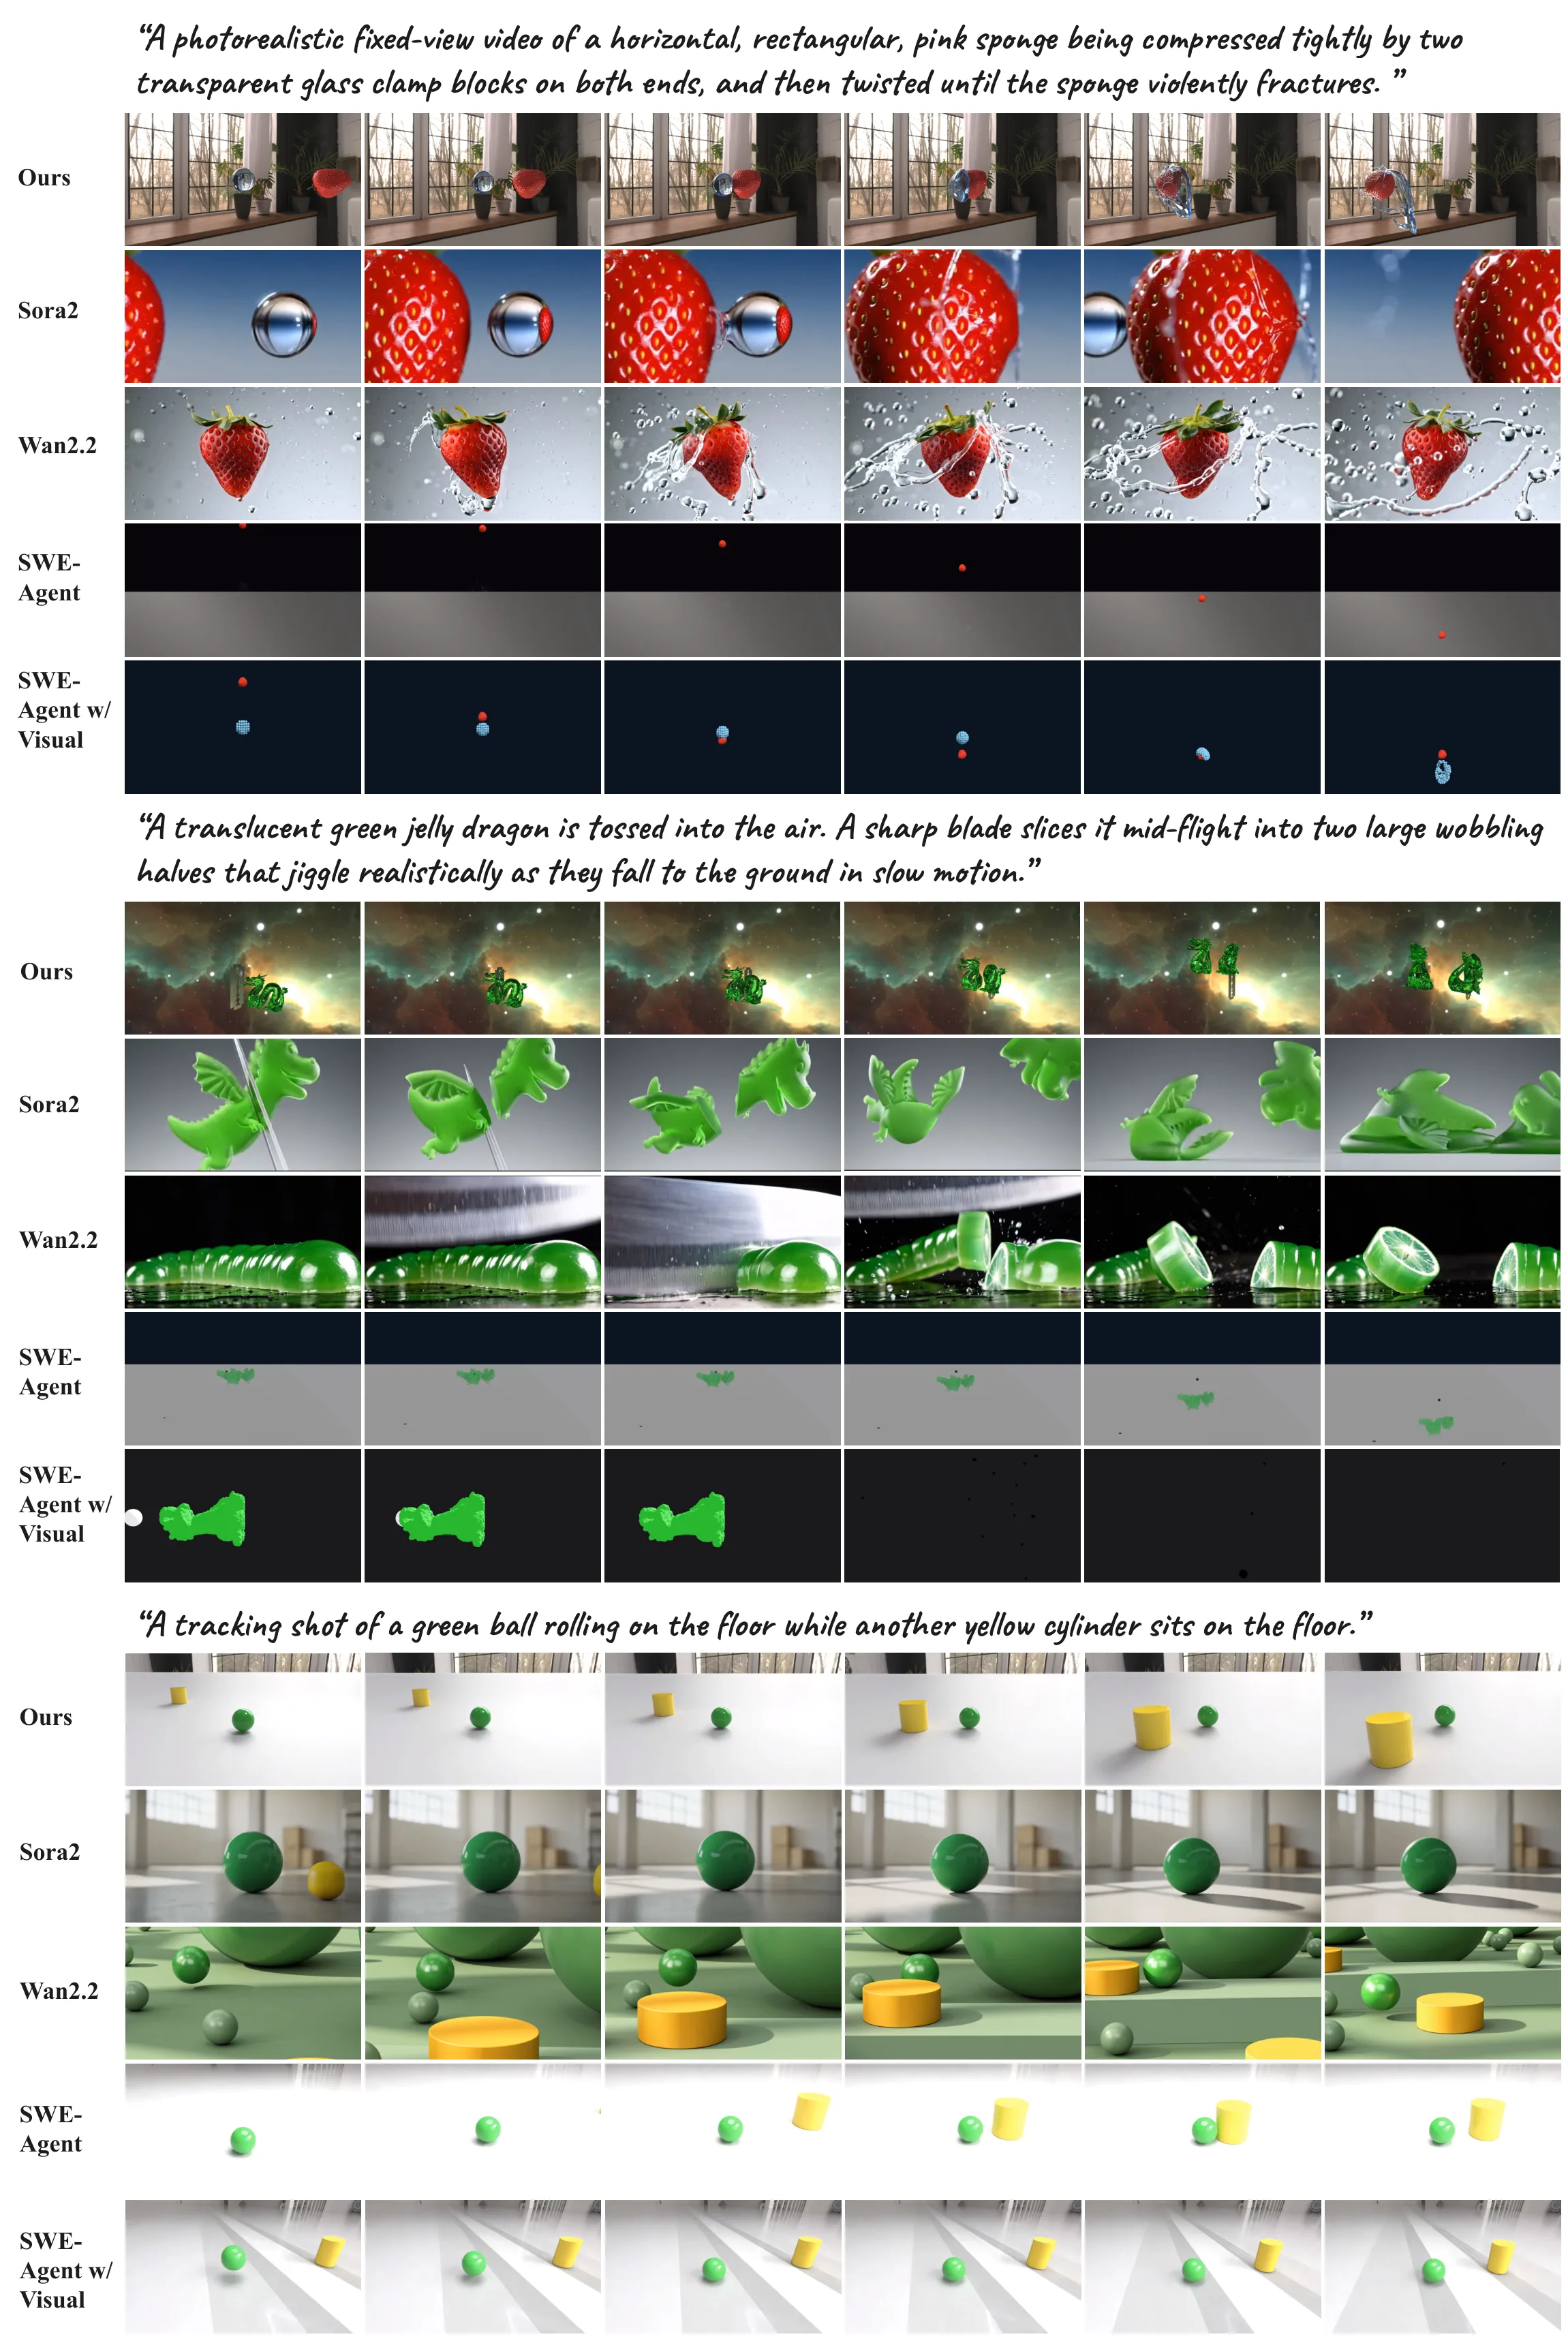
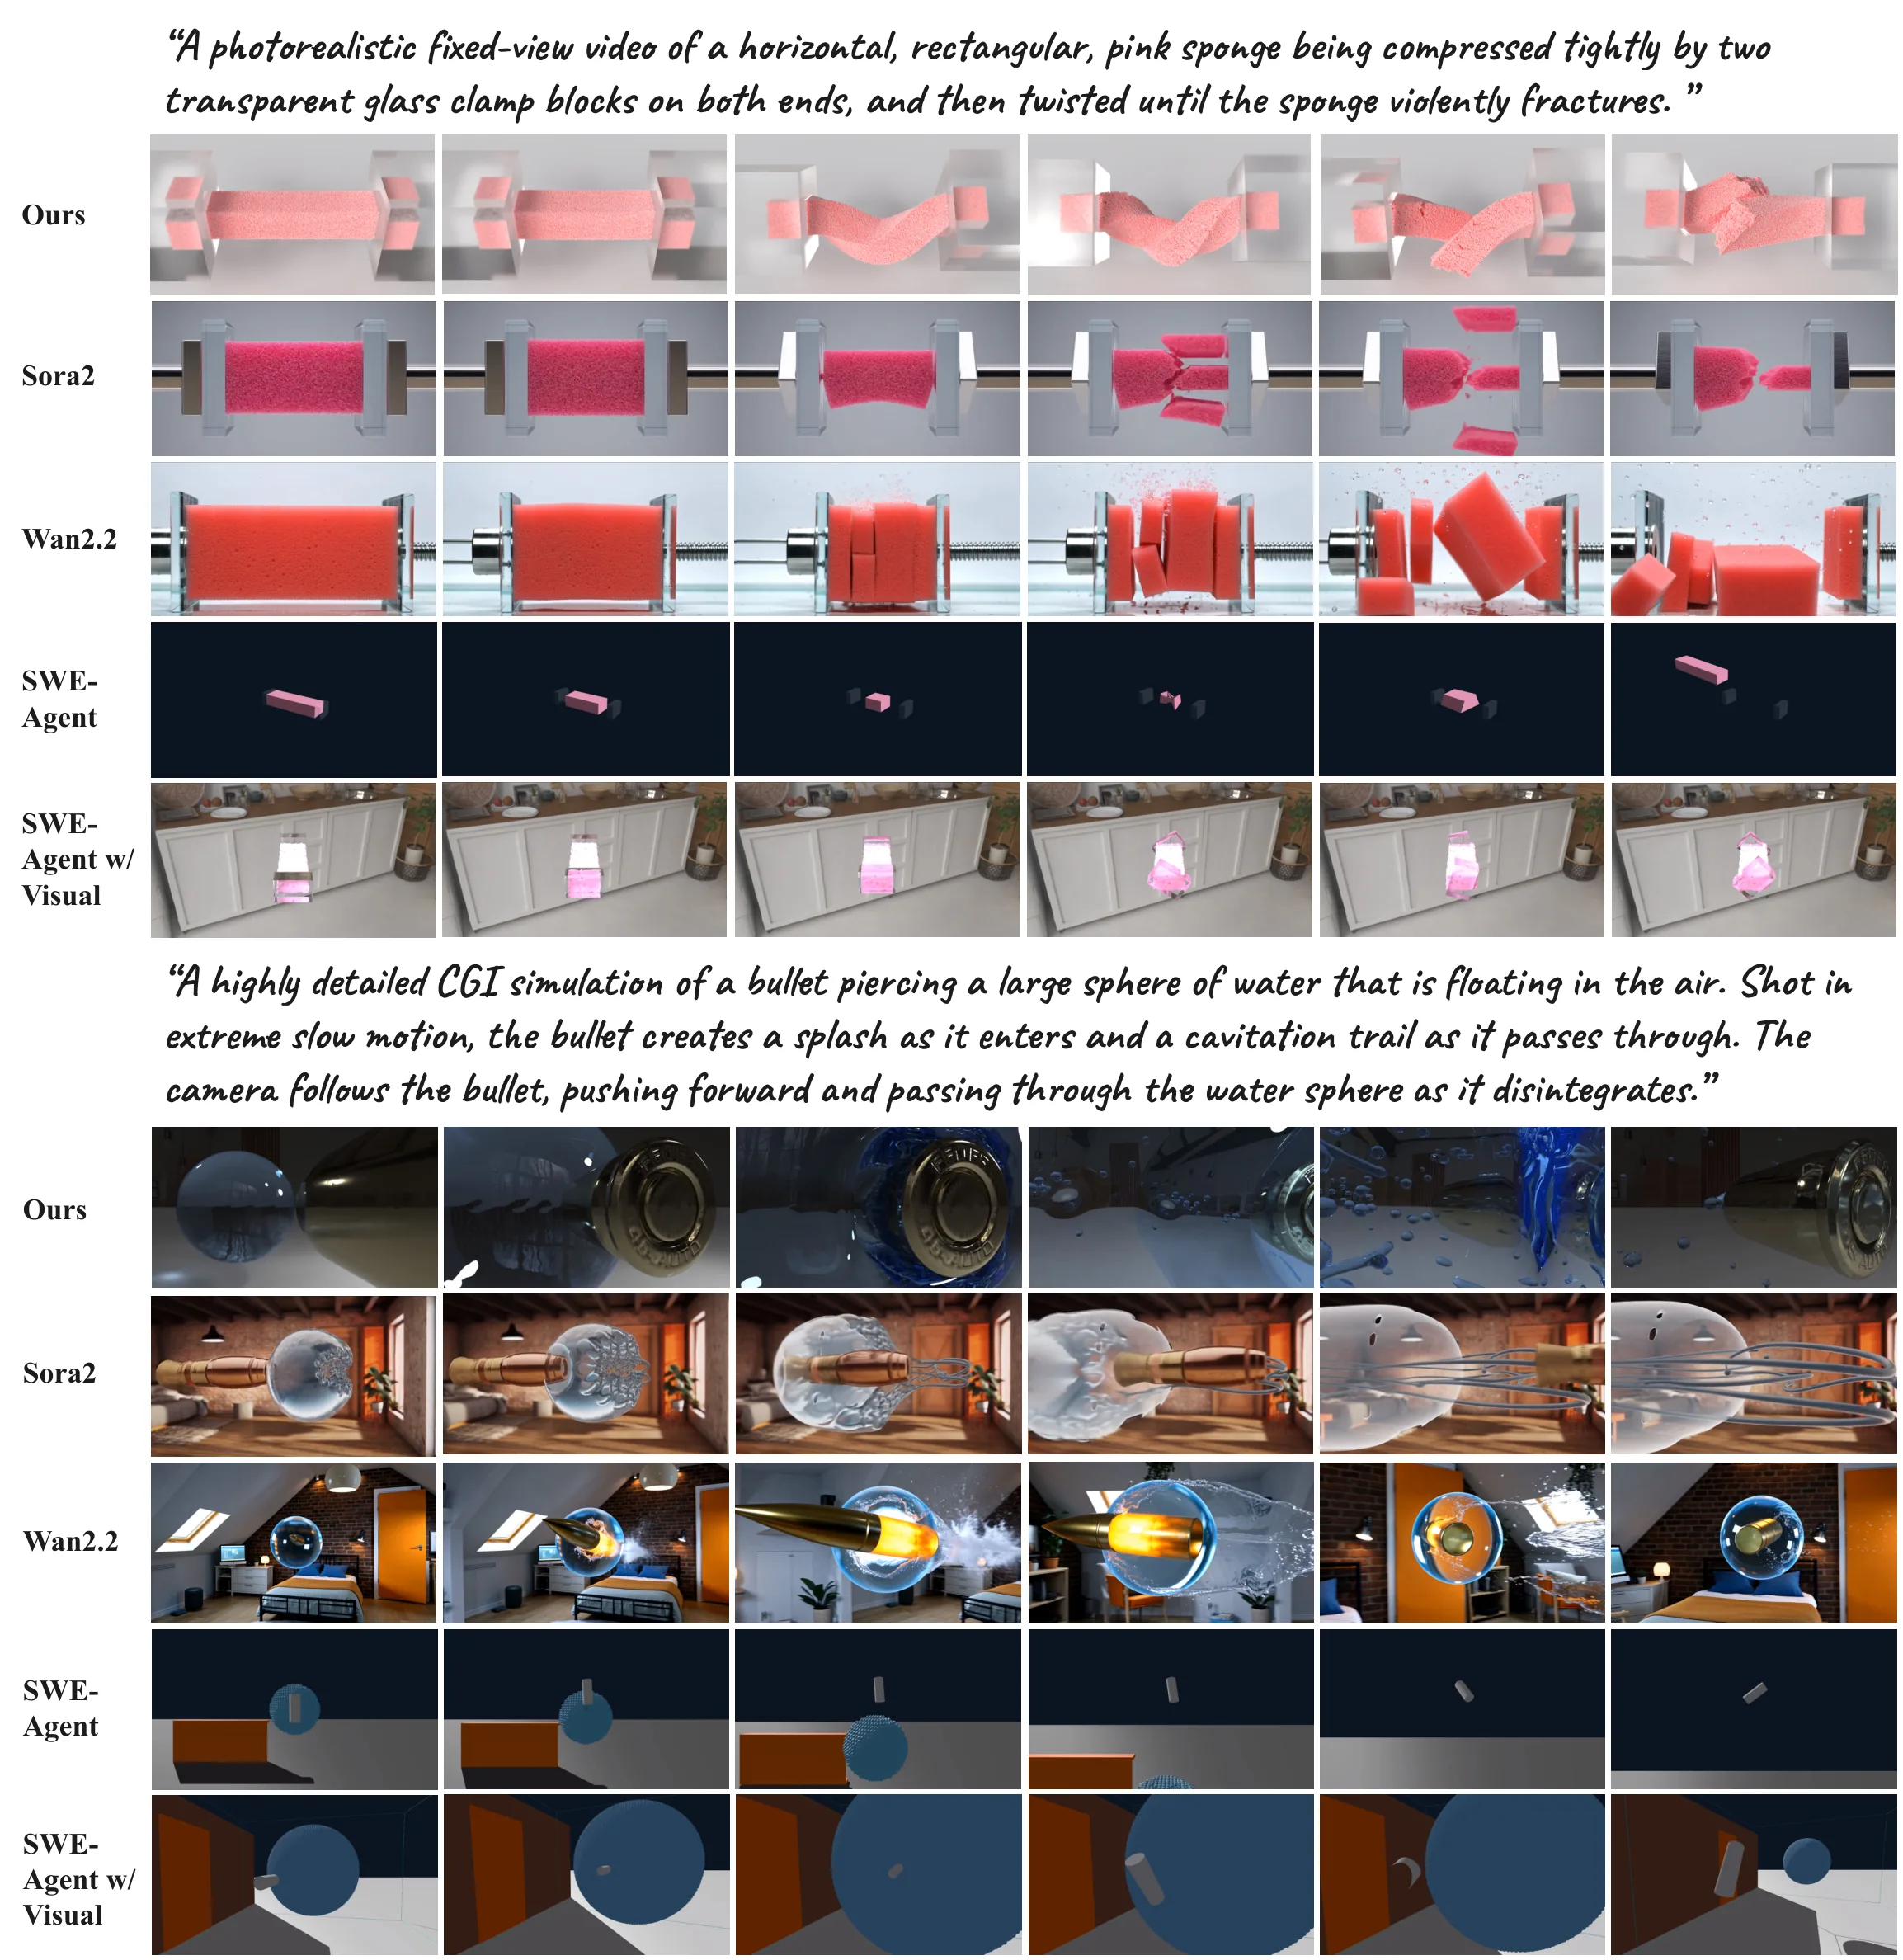
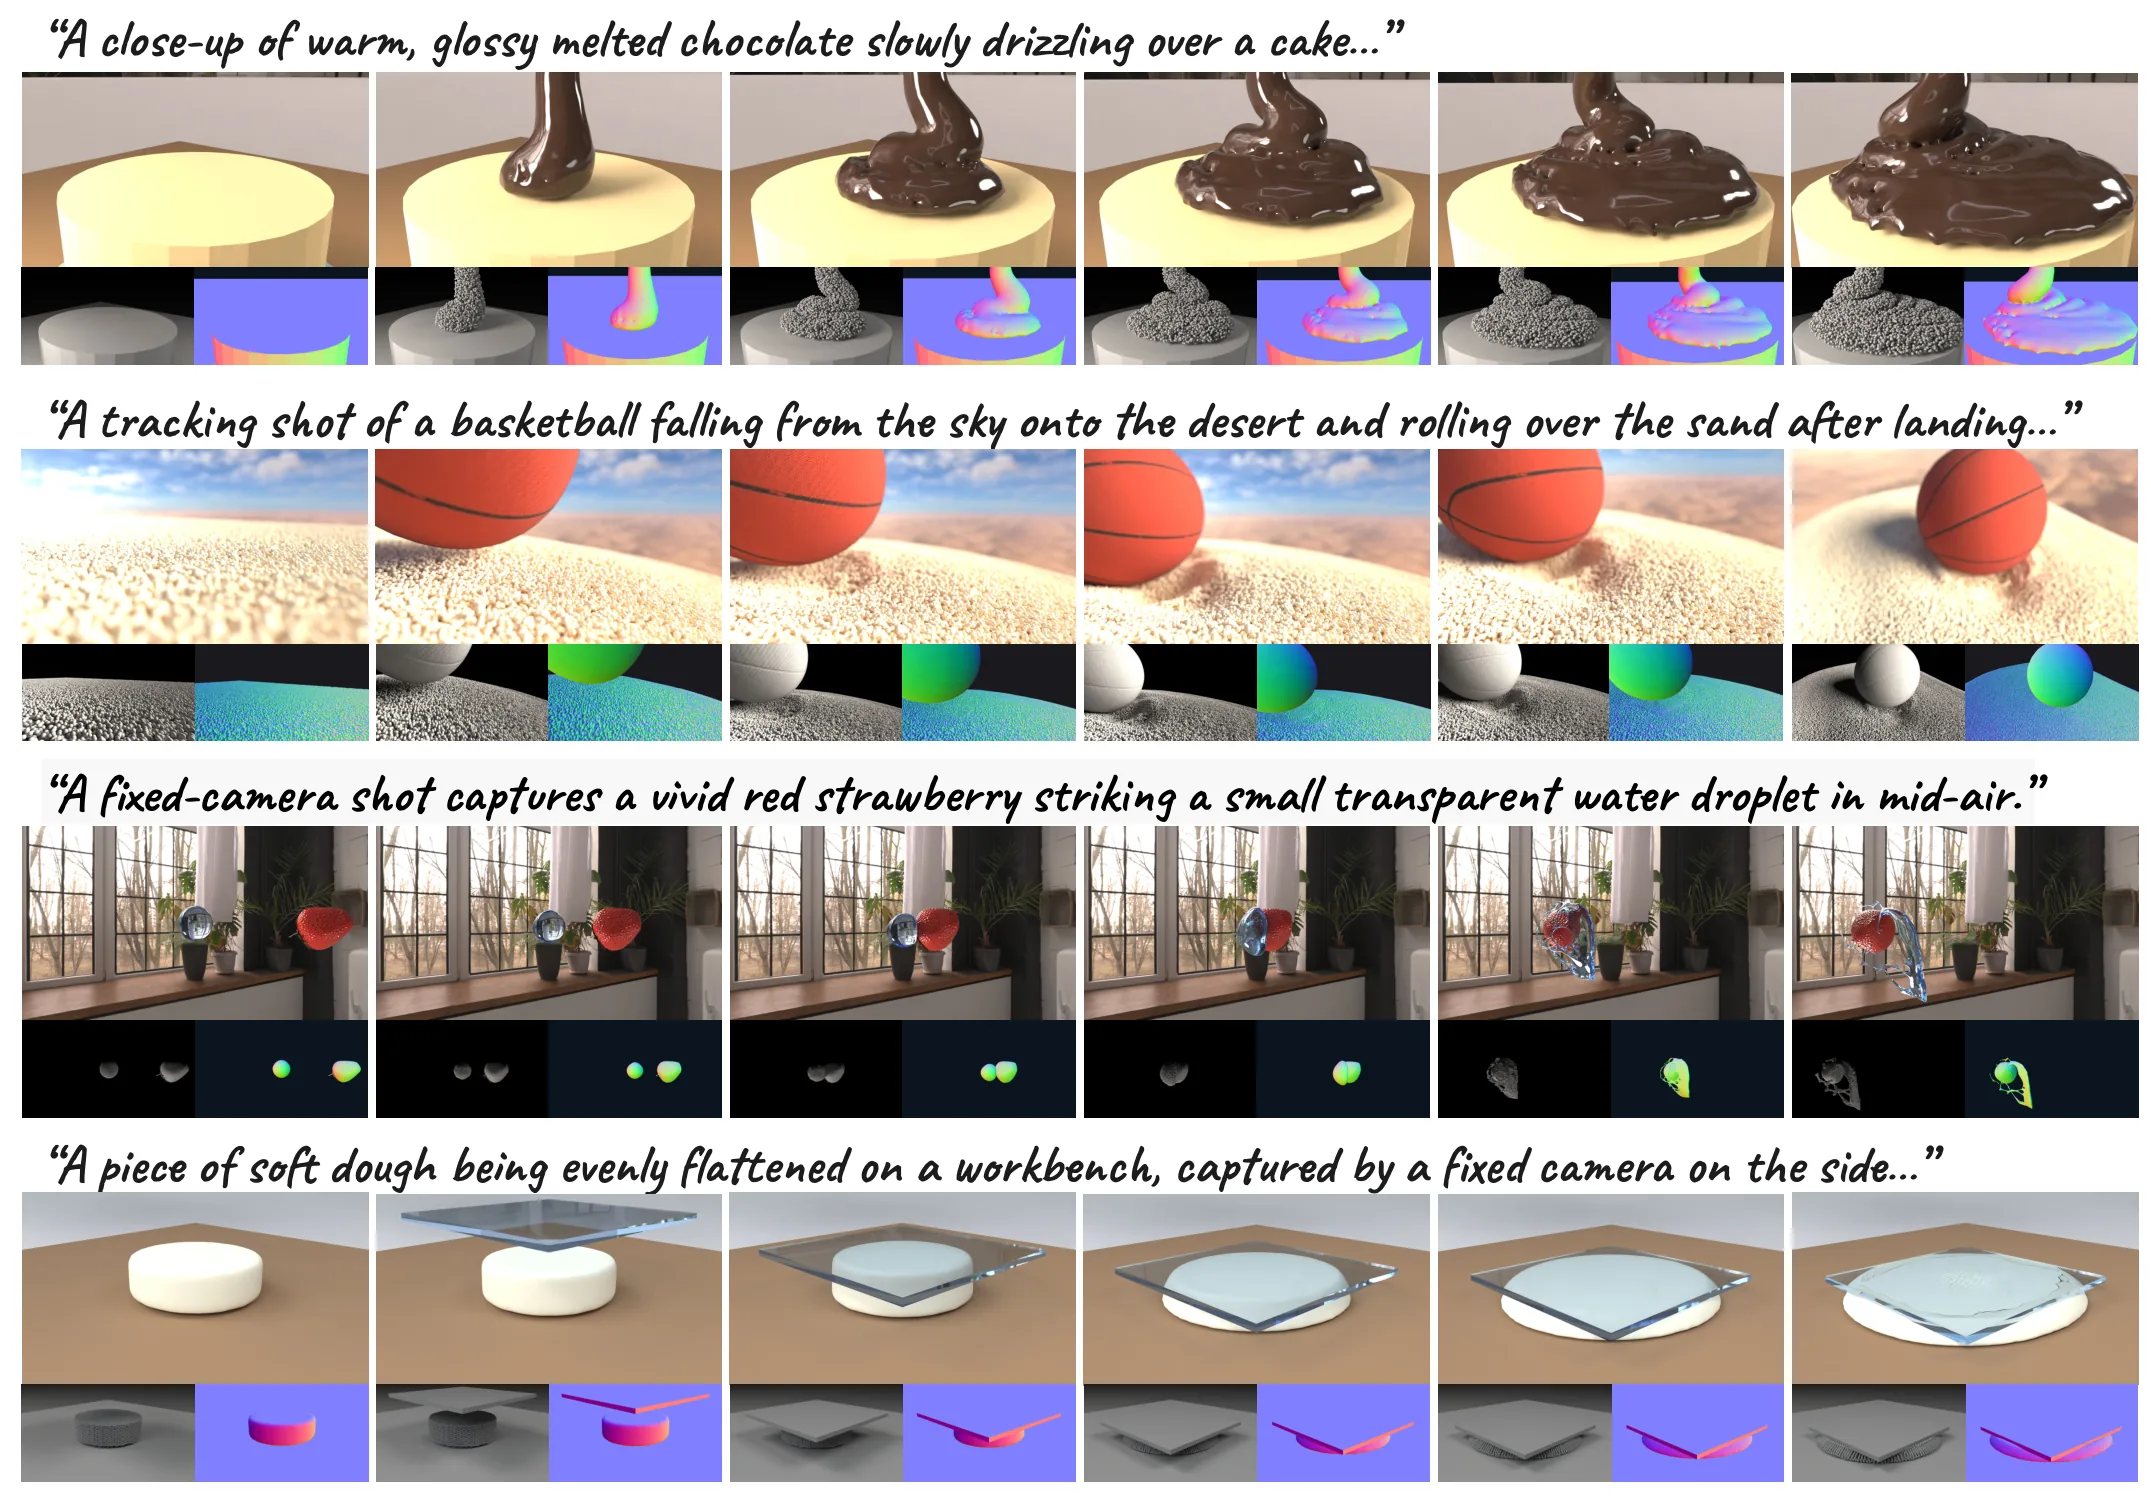
TL;DR
GS-Agent 是一个端到端的多智能体系统,能够将自然语言描述自动转化为包含液体、可变形体与刚体等丰富物理交互的 4D 动态世界。该框架通过多个专家智能体协作调用物理引擎,实现了物理合理性与可控渲染的兼顾,开创了「生成式仿真」这一 4D 世界构建新范式。
研究背景与动机
从自然语言描述中自动生成一个栩栩如生的动态世界——这个愿景长期吸引着计算机图形学与生成式 AI 两个领域的研究者。一个真正令人信服的 4D 世界不仅需要视觉上逼真的渲染,还必须在时间维度上展现物理上合理的运动:物体下落、液体流动、柔性体变形,这些现象的背后是牛顿力学、流体力学等物理规律的约束。
传统的计算机图形学生产管线完全依赖人工构建,艺术家需要逐帧调整材质属性、设计运动轨迹、打光布景,整个过程耗时耗力且高度依赖专业经验。近年来,[[扩散模型]]与[[视觉语言模型]]等基础模型的突破让研究者看到了一丝曙光——能否让机器像学习图像生成那样,从大规模数据中学会「创造」动态物理世界?然而,现有方法在这一方向上遭遇了两个根本性瓶颈:物理合理性与可控性难以兼得。单纯依赖数据驱动生成的运动往往违背物理常识(比如物体穿墙、能量凭空消失),而试图加入物理约束的方法又常常牺牲了用户意图的表达自由度。
GS-Agent 的切入点是重新审视一个被忽视的类比:人类创造 4D 世界的方式本身就是一个绝佳的「算法」。当我们构思一个场景时,大脑会先决定需要哪些物体(实体管理),再考虑它们长什么样、放在哪里、怎么动,最后才是相机该摆在哪里、光线应该从什么角度打过来(渲染配置)。这个分而治之的思路天然具有可解释性与可控性。GS-Agent 的核心赌注是:与其让一个端到端的神经网络从零学习所有物理规律,不如让多个专家智能体各司其职,在 [[物理引擎]] 的监督下协作构建——这样既能利用基础模型的语义理解能力,又能保证物理约束不被打破。
方法
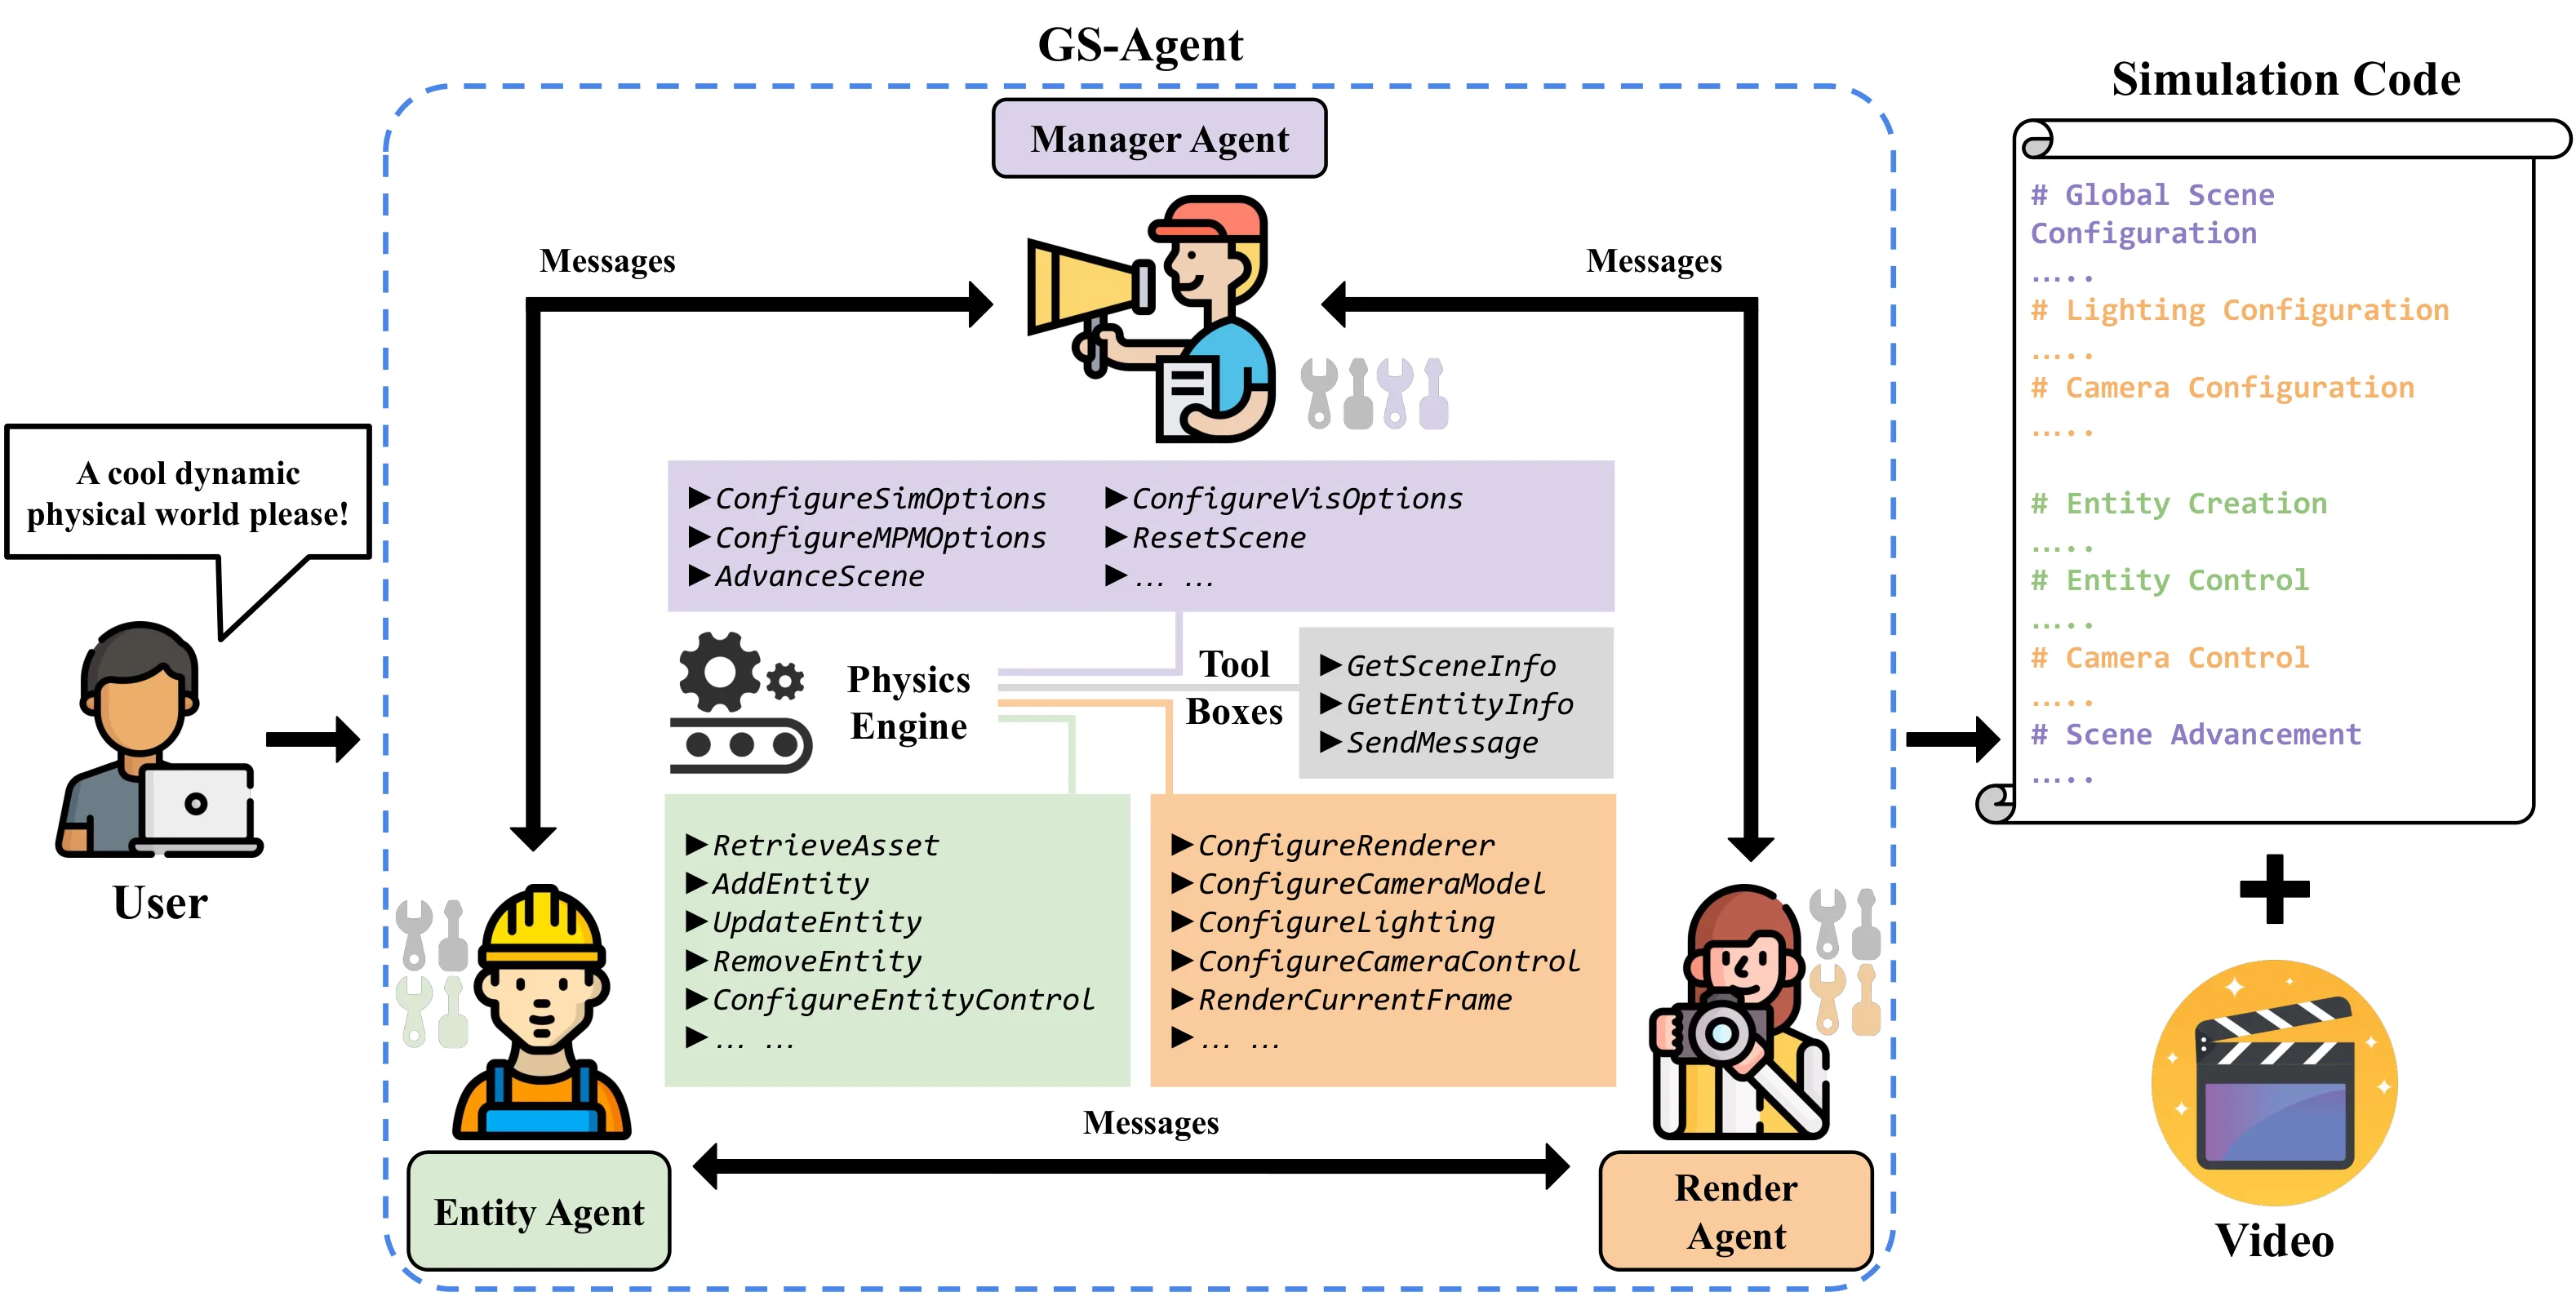
GS-Agent 的整体架构可以理解为一个多智能体协作系统,其设计哲学是「让专业的人做专业的事」。整个框架将 4D 世界生成任务拆解为两大子任务流水线:实体管理与渲染配置,二者并非串行执行,而是通过迭代反馈不断调优。
实体管理是整个系统的核心支柱,涵盖了从资产筛选到运动控制的完整生命周期。在资产筛选阶段,智能体需要根据自然语言描述从庞大的 3D 模型库中检索候选资产。这一步的难点在于,用户的描述往往是抽象而模糊的(「一个温馨的客厅」),而库存资产则是具体的文件名和标签。GS-Agent 借助视觉语言模型的零样本理解能力,在语义层面建立描述与资产之间的匹配桥梁。选中的资产并非直接拿来就用,还需要经过材质调优这一步——同一个椅子,塑料材质和木质材质给人的感觉完全不同,智能体需要根据场景氛围动态调整[[PBR材质]]的各项参数(金属度、粗糙度、颜色等)。放置阶段考验的是空间推理能力:智能体需要理解「桌子靠墙放」「椅子围着小桌摆」这类空间约束,生成合理的相对位置关系。运动控制是实体管理的最高阶能力,也是最体现物理引擎价值的环节。当用户要求「一个玻璃杯从桌上滑落摔碎」时,智能体需要将这个语义指令转译为物理引擎可以执行的代码——设定初始位置和速度、选择合适的刚体参数(如密度、摩擦系数)、触发碎裂效果的多面体破裂模块。
渲染配置子任务负责处理相机与光照的设置。GS-Agent 的设计理念是「先有世界,后有镜头」——先确保物理场景本身合理,再考虑如何用电影级的镜头语言来呈现它。相机智能体负责规划相机轨迹,包括位置关键帧、朝向变化、焦点跟踪等,这些决策需要理解不同镜头语言的语义(如推镜头暗示聚焦、拉镜头暗示全局)。光照智能体则根据场景氛围(温馨的室内黄昏、阴森的森林夜晚)选择合适的光源类型、强度、色温与位置。
多智能体协作的核心机制是代码交互与多模态反馈。每个专家智能体并非独立做决定后再汇总,而是通过生成可执行代码来操控物理引擎和渲染器。代码执行后返回的结果是「多模态」的:既有渲染图像,也有物理模拟的中间状态(如速度场、碰撞检测日志)。智能体根据这些反馈判断当前构建是否符合预期,若不符合则进入下一轮迭代——调整材质参数、重置物体位置、修改运动轨迹,直到输出结果满足质量阈值。这种「生成-验证-修正」的循环机制是物理合理性的根本保障。
实验与结果
研究团队在两个维度上评估了 GS-Agent 的能力:物理合理性与渲染质量。物理测试场景涵盖了三种典型物理现象的组合:刚体碰撞与堆叠、可变形体的软体模拟、以及流体动力学(如液面晃动、水花溅射)。一个具有说服力的实验案例是「玻璃杯从桌面滑落撞上花瓶」这一序列:系统需要让玻璃杯经历倾倒、滑行、撞击、碎裂的全过程,同时保证碎片飞溅的轨迹符合物理规律,且花瓶在冲击下发生可感知的晃动或位移。定性结果显示,GS-Agent 能够生成包含 2-3 种物理现象协同发生的复杂场景,且物体的运动轨迹、速度变化、能量耗散均符合物理引擎的内部约束。
在渲染质量方面,团队邀请了标注人员对生成结果进行美学评估,涵盖光源合理性、材质质感、相机构图等维度。GS-Agent 在「光照氛围匹配」这一指标上表现突出——当用户描述「月色下的宁静湖畔」时,系统能够生成具有恰当色温(偏蓝的冷光)、合适阴影分布(新月位置对应的阴影方向)的渲染结果,而非简单地在场景中堆砌一个泛泛的「环境光」。
与基线方法的对比进一步凸显了 GS-Agent 的优势。纯数据驱动的[[NeRF]]或[[3D Gaussian Splatting]]方法虽然能生成视觉效果惊艳的场景,但在物理合理性测试中频频「穿帮」——物体在没有外力作用下自行加速、运动中的物体突然消失。另一类依赖物理引擎但缺乏智能体协作的方法则受限于手动参数调优,难以扩展到复杂场景。GS-Agent 通过「智能体编排+物理引擎验证」的组合,在两个维度上都取得了竞争力的表现。
讨论与可借鉴点
GS-Agent 最值得关注的设计启示在于其对「物理引擎」的角色重新定义。在传统生成式 AI 研究中,物理引擎往往被视为一个「验证工具」——生成完了再检查对不对。而 GS-Agent 将其提升为系统架构中的「一等公民」,智能体通过代码直接调用引擎的能力,将物理约束嵌入生成过程本身,而非事后补救。这一思路对于需要强物理约束的领域(如[[具身智能]]的仿真训练数据生成、工业装配序列合成)具有直接的借鉴价值。
多模态反馈循环的设计同样值得注意。GS-Agent 的迭代修正机制本质上构建了一个轻量级的「世界模型自检」流程——即使单个智能体的决策不够完美,多轮反馈也能逐步将系统拉回到物理合理的轨道上。这种设计比单纯追求单次决策准确率更为务实,也为缺乏大规模物理模拟数据的场景提供了一条可行的工程路径。
当然,GS-Agent 也存在明显的局限性。首先,其能力边界受限于物理引擎本身的模拟精度——当前主流物理引擎对大规模流体或复杂软体交互的计算开销仍然很高,这直接制约了系统处理极端复杂场景的能力。其次,智能体协作的效率尚未经过大规模压力测试,当场景中涉及数十个实体与数百个自由度时,多轮迭代的开销可能成为瓶颈。此外,系统对自然语言歧义的处理能力仍有提升空间——「看起来有点乱」这种主观评价难以被精确转译为可执行的物理参数调整。
面向未来,GS-Agent 的框架为「物理 AI」时代的内容创作提供了一个可扩展的基础设施。随着物理引擎模拟能力的进步和多智能体协作效率的提升,这一范式有望从实验室走向更广阔的应用场景——从影视特效的快速预演,到具身智能体的仿真训练数据工厂,再到普通人通过自然语言构建自己想象中的动态世界。
摘要
从自然语言描述中创建动态且物理真实的 4D 世界既令人着迷又充满挑战。传统的计算机图形学方法依赖人工创建,需要大量人力来微调材质、运动和视觉保真度。近年来生成式基础模型的进展激发了从大规模数据中学习生成此类 4D 世界的兴趣;然而,现有方法仍难以保证物理合理性和可控性。在本工作中,我们采用了一条不同的路径,利用基础模型构建一个智能体系统,模拟人类传统创建 4D 世界的方式,同时将整个过程自动化。我们提出了 GS-Agent,一个端到端的多智能体框架,在循环中集成物理引擎,以从自然语言生成真实、动态且可控的 4D 物理世界。受人类构建 4D 世界方式的启发,GS-Agent 将任务分解为实体管理(涵盖 3D 资产筛选、材质调优、放置和运动控制)以及渲染配置(包括相机和光照操控)。多个具有不同专长的智能体通过代码与物理引擎交互,寻求多模态反馈,并协作迭代地构建与给定描述一致的 4D 世界。实验结果表明,GS-Agent 能有效地将自然语言转化为多样化且物理合理的 4D 世界,展现出液体、可变形物体和刚体之间丰富的交互,同时实现电影级相机和光照控制。我们期望 GS-Agent 成为 4D 世界生成新范式的基础,赋能创意内容创作和物理 AI。项目页面:https://umass-embodied-agi.github.io/gs-agent/
Abstract
Creating dynamic and physically realistic 4D worlds from natural language descriptions is both fascinating and challenging. Traditional computer graphics methods rely on manual creation, requiring extensive human effort to fine-tune materials, motions, and visual fidelity. Recent advances in generative foundation models have sparked interest in learning to generate such 4D worlds from large-scale data; however, existing methods still struggle to ensure physical plausibility and controllability. In this work, we take a different path by leveraging foundation models to construct an agentic system that emulates how humans traditionally create 4D worlds, yet automates the entire process. We present GS-Agent, an end-to-end multi-agent framework that integrates physics engines in the loop to generate realistic, dynamic, and controllable 4D physical worlds from natural language. Inspired by how humans build 4D worlds, GS-Agent decomposes the task into entity management, covering 3D asset curation, material tuning, placement, and motion control, and rendering configuration, including camera and lighting manipulation. Multiple agents with distinct expertise interact with the physics engine via code, seek multimodal feedback, and collaborate to iteratively construct 4D worlds that align with the given descriptions. Experimental results show that GS-Agent effectively converts natural language into diverse and physically plausible 4D worlds exhibiting rich interactions among liquids, deformable objects, and rigid bodies, while achieving cinematic camera and lighting control. We envision GS-Agent as a foundation for a new paradigm in 4D world generation, empowering creative content creation and physical AI. Project page at https://umass-embodied-agi.github.io/gs-agent/
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。