
面向无信号交叉路口自动驾驶车辆的紧凑型潜在协同机制
Compact Latent Coordination for Autonomous Vehicles at Unsignalized Intersections
📝 TLDR
针对无信号交叉口自动驾驶车辆协同难题,现有MARL方法受困于组合动作空间与特权信息依赖。本文提出分层架构MAPS:由中心Master生成紧凑连续潜变量proto-plan编码全局策略,分布式Worker融合局部观测执行控制。在HighwayEnv 72种场景中实现零碰撞并显著缩短通行时间,3车训练模型零样本迁移到5车场景成功率达94%,证实潜变量分层协同框架具备良好泛化能力。
🧭 速览
无信号交叉口下多车协同存在组合动作空间大、依赖特权信息等问题,传统MARL方法难以兼顾灵活性与可扩展性。
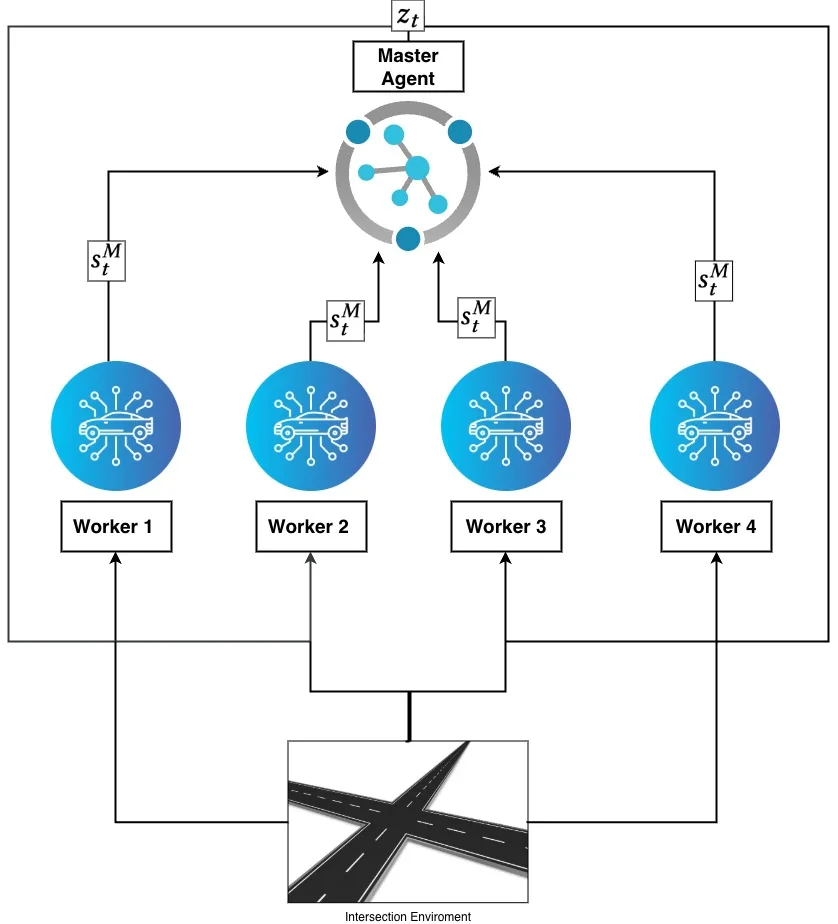
MAPS采用分层结构:中心Master输出紧凑连续proto-plan潜变量编码全局策略,分布式Worker融合该嵌入与局部观测执行车辆控制。
在HighwayEnv 72种配置中实现零碰撞导航并显著降低通行时间,3车训练模型零样本迁移到5车场景成功率达94%。
proto-plan分层协同机制有效解耦战略意图与战术执行,为多车协同提供兼具性能与泛化能力的解决方案。
🆚 方法对比
Master-Agent Proto-plan System (MAPS)
- 72种配置评估均零碰撞
- 平均7.8步,较最佳基线改善38%
- 三代理训练后五代理零样本达94%
- 通信与动作复杂度保持为O(d)
- 仅在HighwayEnv完成概念验证
- 依赖全局交通状态生成计划
- 未验证高保真感知与车辆动力学
Proto-plan
- 连续编码避免联合动作组合爆炸
- 三到五代理迁移成功率达94%
- 不依赖未来轨迹或专家示范
- 固定维度O(d)便于车队扩展
- 潜变量缺少直接可解释性
- 集中生成仍需全局交通状态
- 未验证复杂感知模块的兼容性
Centralized Master agent
- 一次编码全局协调策略
- 固定维度输出控制通信开销
- 与Worker模块可独立优化
- 依赖全局交通状态
- 中心节点可能成为扩展瓶颈
- 高层编码偏差会下传Worker
Decentralized Worker agents
- 结合本地观测执行差异化控制
- 局部策略可独立优化
- 无需共享完整联合动作
- 执行受原型计划质量制约
- 多车辆时仍需部署多个Worker
- 未验证复杂动力学下的稳定性
Multi-Agent Reinforcement Learning (MARL)
- 支持多车协作与联合策略学习
- 可覆盖部分可观测等复杂场景
- 兼容分散式执行方式
- 非平稳性使联合学习困难
- 部分可观测限制全局判断
- 固定动作结构扩展性差
Value-decomposition methods
- 可分解联合价值并辅助信用分配
- 适配合作式多智能体训练
- 联合动作数仍可随车辆增长
- 部分可观测下价值估计可能失真
Graph-based representations
- 显式编码智能体结构关系
- 支持通信扰动下的多机器人协调
- 可结合数字孪生管理大网
- 对节点数变化仍需重新适配
- 大规模图计算带来额外开销
Policy optimization
- 可直接优化车辆协同控制目标
- 支持端到端策略更新
- 适用于连续控制策略
- 联合策略受环境非平稳性影响
- 固定动作结构难随车辆扩展
- 复杂交通场景样本需求高
Hierarchical frameworks
- 可分离协调意图与车辆控制
- 各模块能独立优化
- 便于复用高层协调策略
- 层级接口设计增加训练复杂度
- 模块误差可能逐级累积
- 高层与低层目标可能不一致
Ma et al. model-based MARL
- 局部解耦全局动力学建模
- 近似全局价值以提升样本效率
- 可降低大规模建模负担
- 局部模型难以完全表示全局耦合
- 仍可能受固定动作结构限制
- 模型偏差会传播到策略更新
Zhang et al. local trust-region MARL
- 用κ跳邻域近似联合约束
- 无需集中式评论家可分散训练
- 面向安全关键协作任务
- 约束范围仅覆盖κ跳邻域
- 局部更新可能牺牲全局最优性
- 安全收益依赖邻域设定
Hsu and Pajic safe MARL
- 提供函数逼近下遗憾保证
- 系统研究安全合作MARL
- 兼顾安全与长期性能
- 理论保证未在真实交通验证
- 函数逼近误差可能影响保证
- 安全与效率仍需权衡
GNN-based methods
- 天然表达智能体间拓扑关系
- 增强故障与通信扰动韧性
- 可扩展至大规模协作系统
- 图变化时泛化仍具挑战
- 训练和消息传递开销较高
- 依赖合理图结构先验
Decentralized graph-based MARL with traffic digital twins
- 支持大规模路网信号优化
- 可结合图结构表达交通关系
- 数字孪生便于状态同步分析
- 依赖高保真且同步的数字孪生
- 仿真到实车存在域差异
- 部署成本与维护负担较高
EECG
- 融合GNN、好奇探索和进化优化
- 改善部分可观测任务信用分配
- 结合结构先验与探索机制
- 多种机制叠加提高训练复杂度
- 进化优化增加额外计算开销
- 复杂超参数更难以调优
Fixed discrete action-space methods
- 动作接口明确,便于执行约束
- 低层控制逻辑易于工程实现
- 行为验证与安全审查更直接
- 车辆增加导致动作空间组合爆炸
- 车辆能力变化时需重新设计
- 难以编码细粒度协调策略
Privileged-information methods
- 利用未来轨迹可提前规避冲突
- 专家示范可改善早期策略学习
- 规则安全层可直接约束危险行为
- 部署时特权信息可能不可用
- 依赖先验限制现实泛化能力
- 仿真安全不等于实车闭环安全
MAPS以固定维度连续Proto-plan替代随车队增长的联合离散动作,使通信与动作复杂度保持O(d),并以94%的三到五代理零样本成功率展示规模迁移。相关模型式、图式、价值分解和安全MARL方法分别侧重样本效率、结构关系、信用分配与理论保证,而MAPS更直接地压缩高层协调接口;其证据仍限于HighwayEnv概念验证。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 9 张)
展开查看 9 张图
TL;DR
本文针对无信号交叉路口的多车协同自动驾驶难题,提出一种名为 MAPS(Master-Agent Proto-plan System)的分层深度强化学习架构。该系统让一个集中式 Master 智能体生成一个紧凑的连续潜变量——proto-plan,用以编码全局协同意图;分布式 Worker 智能体接收这个潜变量后结合自身局部观测输出车辆专属动作。在 HighwayEnv 的 72 种交叉路口配置中,MAPS 实现了评估期零碰撞、平均通行时间缩短 38% 的效果,且在仅用 3 辆车训练的情况下能够零样本迁移到 5 车场景并保持 94% 的成功率,验证了基于紧凑潜在表示的分层协同框架的有效性与泛化潜力。
研究背景与动机
无信号交叉路口是自动驾驶系统中公认的高难度场景:多辆车需要同时决定通行顺序与时机,既要避免碰撞,又要在有限时间内高效通过。传统的解决方案往往依赖预设的交通规则或中心化的调度系统,但前者缺乏灵活性,后者在真实道路中面临通信延迟与单点故障风险。
近年来,[[多智能体强化学习]](MARL)被视为解决这一问题的有前途范式,因为它允许车辆通过与环境交互自主学习协同策略。然而,现有方法普遍存在三重困境。其一是组合动作空间爆炸:当车辆数量增加时,联合动作空间呈指数级增长,导致学习困难。其二是特权信息依赖:许多方法需要专家演示、轨迹预测或全局感知等额外信息,这些在量产车上难以部署。其三是泛化能力不足:多数系统只在训练时使用的特定场景数下有效,无法适应车辆数量的动态变化。
本文的核心动机正是打破这三重困境:能否设计一种不依赖特权信息、通信开销与车队规模解耦、能够向未知规模车队零样本迁移的分层协同架构?这成为 MAPS 提出的出发点。
方法
MAPS 的核心思路源于对战略意图与战术执行进行解耦的直觉:在一个交叉路口中,所有车辆首先需要"协商"一个全局通行策略(比如谁先走、谁等待),随后每辆车再根据自身位置与状态执行具体的加减速操作。这种"先议后行"的逻辑恰好对应了分层强化学习中的高层规划与低层控制分离。
具体而言,MAPS 采用 Master-Worker 两级结构。Master 是一个集中式智能体,它观测全局交通状态 ( 辆车各自的坐标与速度),输出一个 维的连续向量 ,记为 proto-plan。这个 proto-plan 经 层约束在 范围内,论文发现 是最优维度选择。值得注意的是,这个向量是一对多的:所有 Worker 接收同一个 ,而非像点对点通信那样需要 条链路,因此通信开销恒定。
Worker 是分布式执行的智能体,每个 Worker 仅观测自身的运动学状态 ,并接收来自 Master 的 proto-plan ,将二者拼接为 作为输入。Worker 输出离散动作(加速或减速),修改目标速度 ,控制频率为 。所有 Worker 共享参数 ,这不仅减少了待学习参数总量,还使得学到的控制策略天然具备车辆无关性。
奖励设计是 MAPS 的另一关键创新。Worker 的奖励是稀疏的:成功通过得 ,发生碰撞得 ,其余步骤得 。而 Master 的奖励采用 maximin 聚合:
这种设计的深意在于:它防止 Master 学到"牺牲某一辆车换取整体效率"的策略。如果用均值替代 ,论文实验显示成功率会从 100% 骤降至 80%,说明 maximin 聚合是保障安全优先的关键机制。
训练采用 [[集中训练分散执行]](CTDE)范式,使用 PPO 算法,交替冻结 Master 与 Worker 的更新以缓解多智能体训练中的非平稳性问题。对于零样本迁移,论文设计了渐进式训练协议:先在 1 车场景训练收敛,再扩展到 3 车继续训练,测试时直接部署到 5 车配置而不做任何微调。
实验与结果
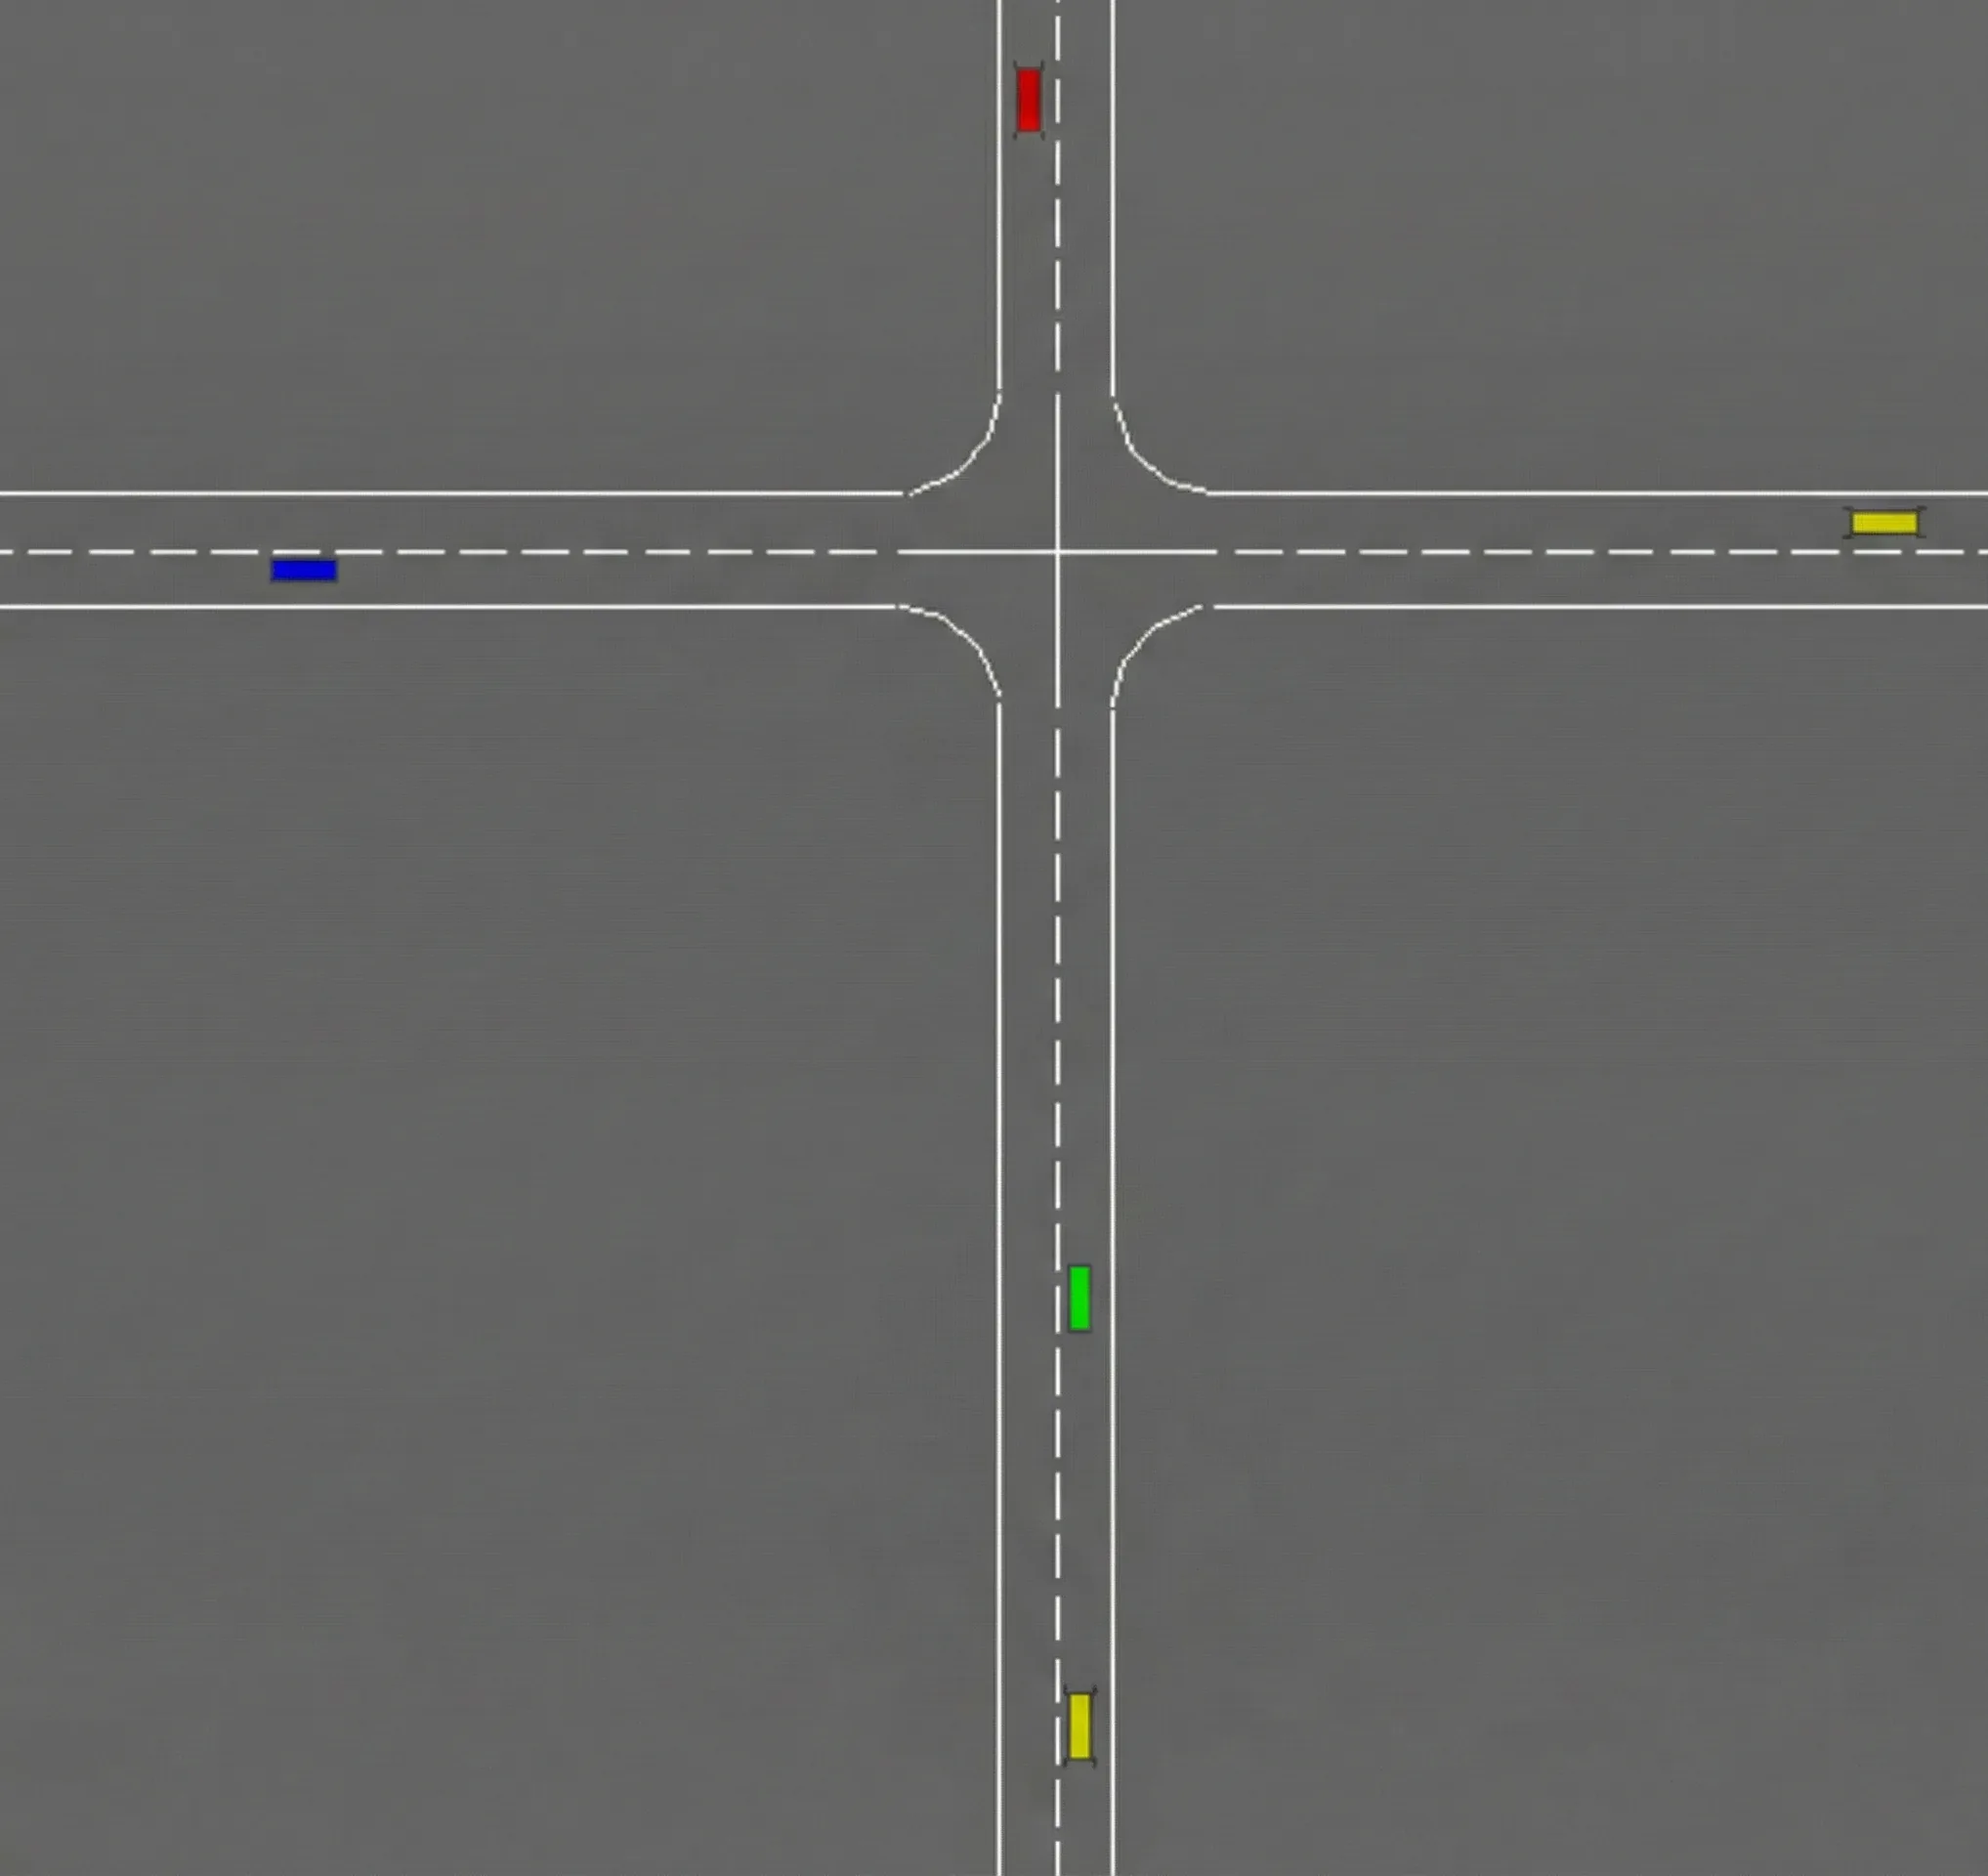
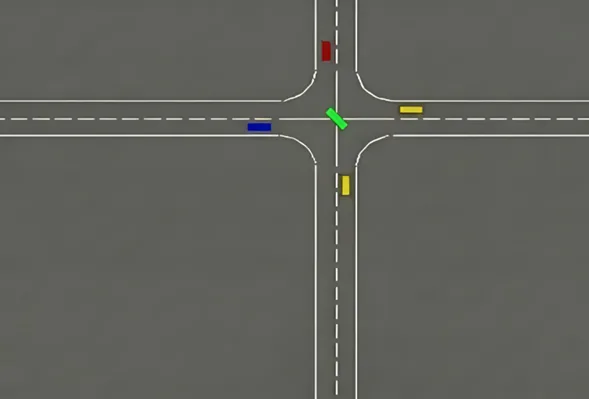
论文在 HighwayEnv 仿真平台上进行了系统评估,覆盖 18 种基础场景配置(不同进入方向、初始距离、转弯意图)乘以 4 种旋转角度,共 72 种交叉路口设置。每集包含 3 辆 MAPS 学习车辆和 2 辆以 20 m/s 匀速行驶的背景车辆,用于模拟非合作交通。
主对比实验结果如下表所示:
| 方法 | 成功率 | 训练碰撞数 | 平均通行步数 |
|---|---|---|---|
| MAPS | 100% | 21 | 7.8 |
| VN-MADDPG | 65% | 35 | 12.5 |
| QMIXwD | 69% | 31 | 12.6 |
从数据可以看出,MAPS 在安全性与效率两个维度均显著优于基线方法:评估期实现零碰撞,训练碰撞数比基线减少 84%–85%,平均通行时间相比最佳基线缩短了约 38%。
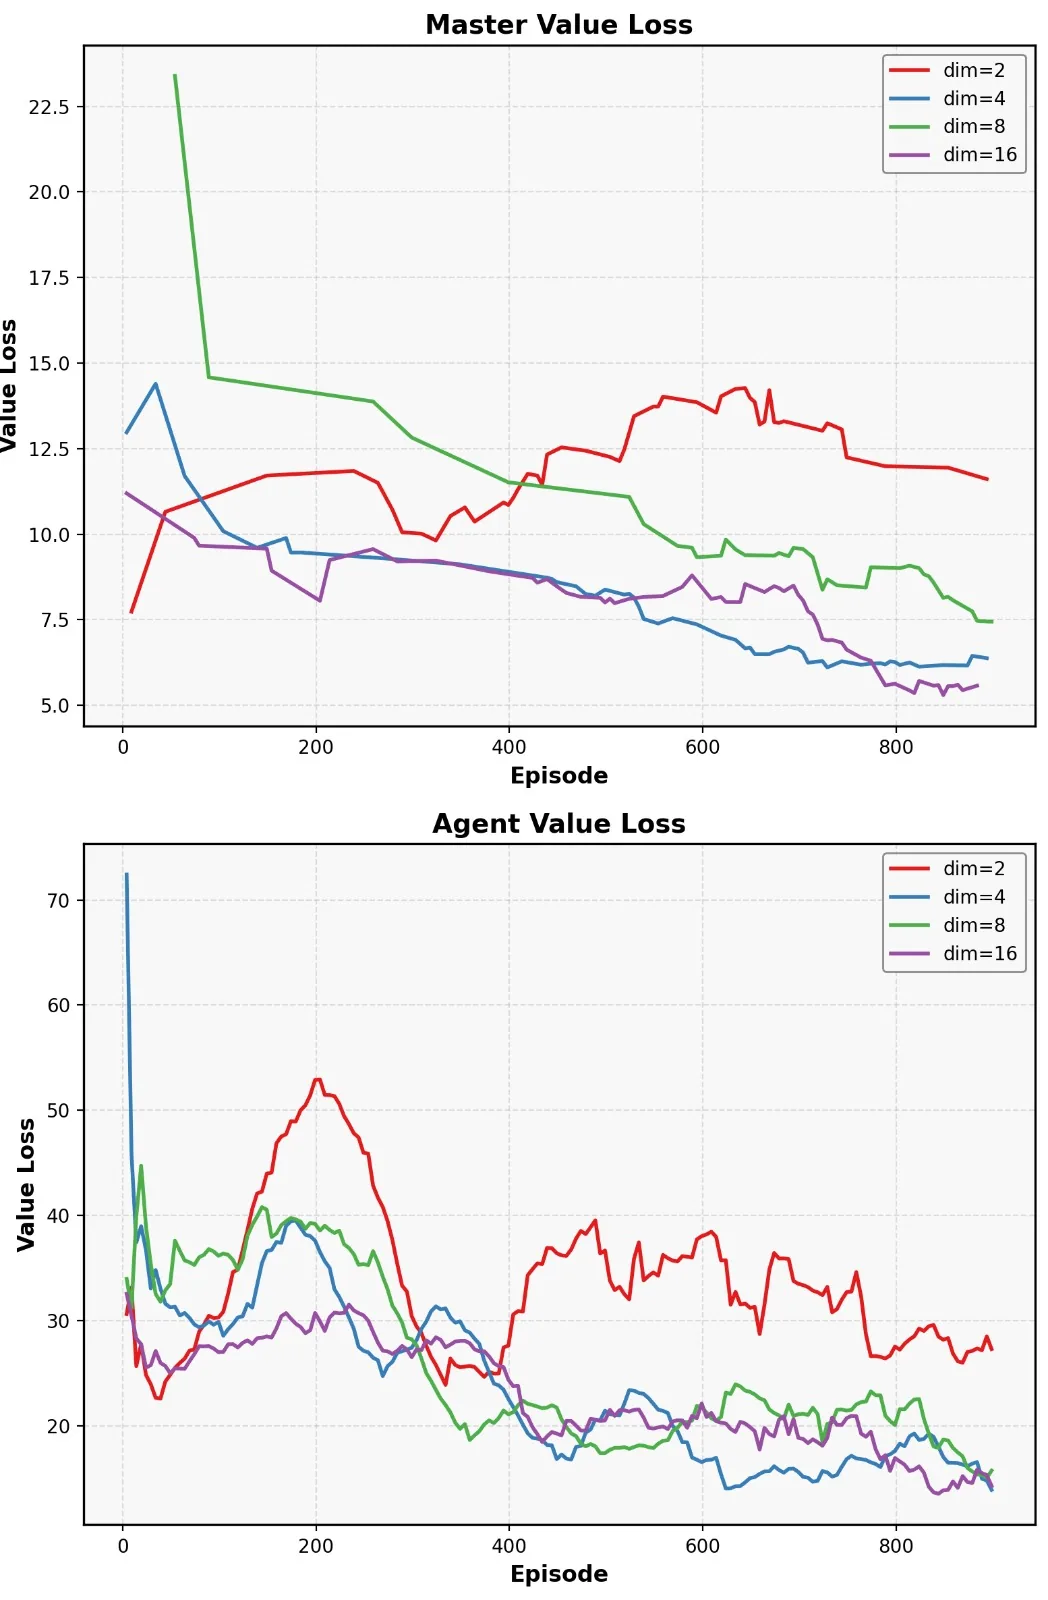
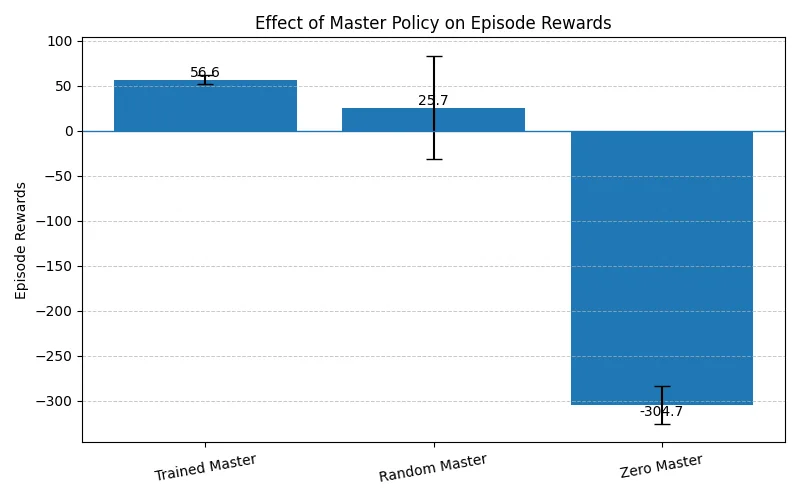
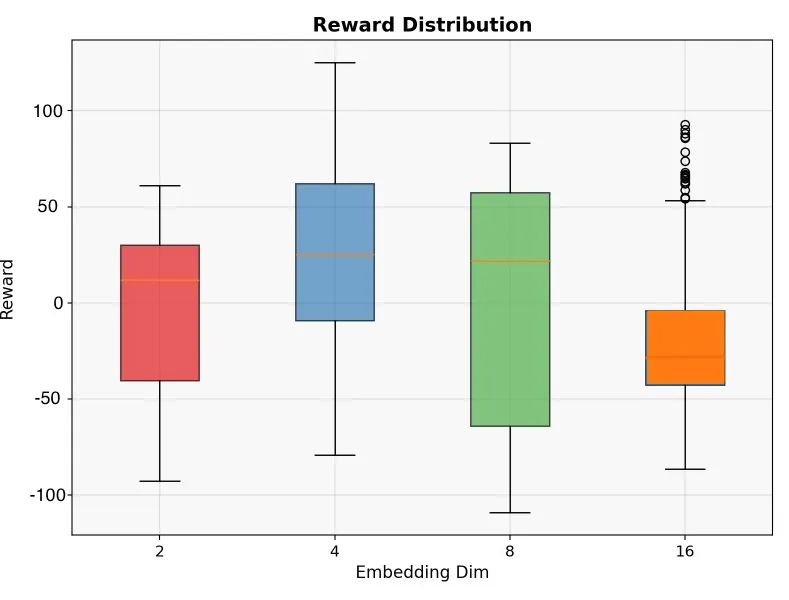
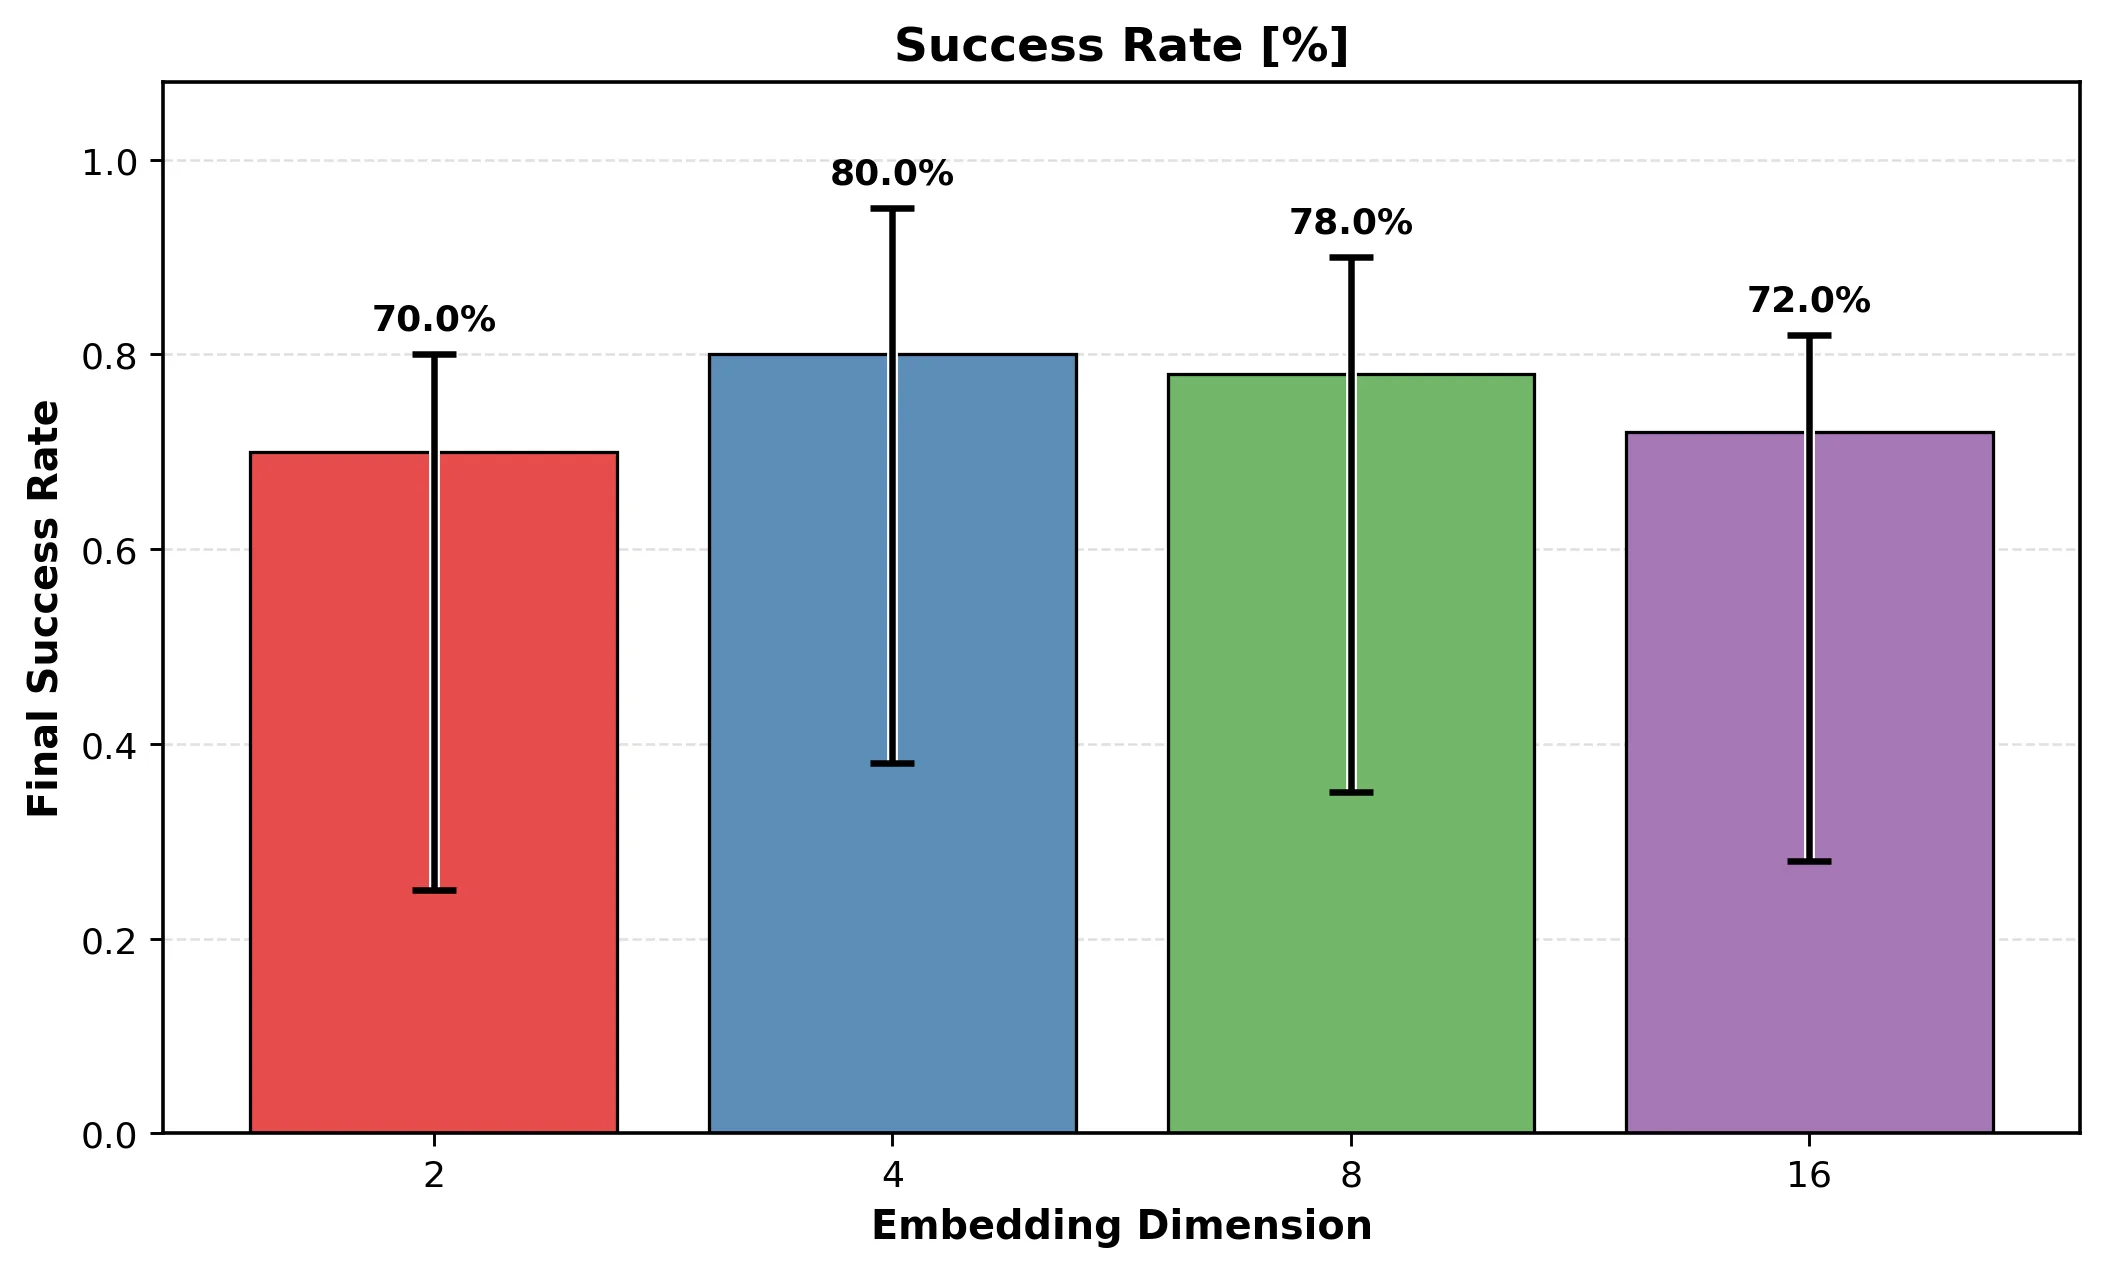
消融实验进一步揭示了 proto-plan 的重要性:当 Worker 固定而 Master 分别为 trained、random、zero 时,对应奖励分别为 56.6、25.7、-304.7,说明 proto-plan 确实编码了有意义的全局协同信息,而非仅仅是噪声。此外,嵌入维度分析表明 是最优选择:虽然 达到 80% 的成功率,但 在保持相同成功率的同时展现出更稳定的训练曲线与更紧凑的表示。
最引人注目的结果是零样本迁移能力:在 3 智能体配置下训练的 MAPS,直接部署到 5 智能体场景仍能达到 94% 的成功率。这一结果证实了 proto-plan 作为紧凑协同表示的泛化潜力:多车协同所需的关键信息可以被压缩至仅 4 维的连续信号,在未见过的更大规模车队中依然有效。
讨论与可借鉴点
MAPS 的设计为 [[多智能体强化学习]] 中的协同控制提供了一条值得借鉴的新思路。其核心贡献在于证明了多车协同意图可以压缩为极低维的连续潜变量,这对带宽受限的 V2X(车联网)通信场景具有直接意义——只需传输 4 维实数向量即可实现有效协同,而非需要完整的车辆间通信或全局状态广播。
然而,这项工作也存在若干局限。首先,动作空间过于简化:Worker 仅能执行纵向加减速,缺少横向控制、换道或停车等真实驾驶中的必要操作,这限制了方法的实际部署价值。其次,Master 的输入采用固定维度的状态拼接,本质上无法扩展到大规模车队;作者建议未来采用注意力机制或集合操作来处理变长输入,但当前尚未实现。此外,实验仅在 HighwayEnv 的简化运动学模型中进行,缺少在高保真仿真器(如 CARLA)或真实数据上的验证。
从方法论角度看,maximin 奖励聚合与交替冻结训练策略是两项可迁移的设计选择。前者自然实现了安全约束,避免了复杂的势函数或安全层设计;后者提供了一种缓解 MARL 非平稳性的轻量方案。这些设计选择背后的权衡逻辑——用全局最差收益而非均值来约束协同策略——值得在类似的安全关键协同任务中借鉴。
总体而言,MAPS 在受控环境下验证了潜变量分层协同框架的可行性,但其从仿真到真实、从简化动作空间到完整驾驶能力、从固定规模到开放规模车队的跨越,仍需后续工作进一步探索。
摘要
在无信号交叉路口协同自动驾驶车辆是多智能体强化学习(MARL)系统面临的一项关键挑战,此类系统通常受困于组合动作空间、对特权信息的依赖或僵化的智能体设计。我们提出主智能体-原型规划系统(MAPS),一种分层深度强化学习(DRL)架构。在该架构中,集中式主智能体生成一个紧凑的连续嵌入(即原型规划),用以编码全局协同策略;分散式工作智能体将该嵌入与局部观测相结合,执行车辆专属的控制动作,从而将战略意图与战术执行解耦,并使各模块能够独立优化。作为对该协同机制的原理性验证,我们在 HighwayEnv 中的 72 种交叉路口配置下对 MAPS 进行了测试。MAPS 在实现无碰撞导航的同时显著缩短了平均通行时间,性能优于当前最先进的基线方法。所学到的原型规划还表现出良好的泛化能力:在三种智能体配置下训练的系统,在零样本迁移至五种智能体场景时仍能达到 94% 的成功率,这证实了基于原型规划的分层学习为多车辆协同提供了一条富有前景的框架。
Abstract
Coordinating autonomous vehicles at unsignalized intersections remains a critical challenge for multi-agent reinforcement learning (MARL) systems, which typically struggle with combinatorial action spaces, reliance on privileged information, or rigid agent designs. We propose Master-Agent Proto-plan System (MAPS), a hierarchical deep reinforcement learning (DRL) architecture in which a centralized Master agent generates a compact, continuous embedding, denoted as proto-plan, that encodes a global coordination strategy. Decentralized Worker agents integrate this embedding with local observations to execute vehicle-specific control, decoupling strategic intent from tactical execution and enabling independent optimization of each module. As a proof-of-concept evaluation of this coordination mechanism, we test MAPS across 72 intersection configurations in HighwayEnv. MAPS achieves collision-free navigation while significantly reducing average travel time, outperforming state-of-the-art baselines. The learned proto-plans further exhibit robust generalization: a system trained with three agents achieves a 94% success rate when deployed zero-shot to five-agent scenarios, confirming that proto-plan-based hierarchical learning provides a promising framework for multi-vehicle coordination.
论文详细总结(自动生成)
面向无信号交叉路口自动驾驶车辆的紧凑型潜在协同机制(MAPS)论文总结
一、核心问题与研究动机
无信号交叉路口下的多车协同是自动驾驶与多智能体强化学习(MARL)领域的一项关键难题,主要存在三类瓶颈:
- 组合动作空间爆炸:传统联合动作空间随车辆数呈 增长,难以扩展。
- 特权信息依赖:许多先进方法依赖专家演示、博弈论先验、安全层、轨迹预测等信息,部署成本高。
- 泛化能力受限:多数方法在固定、简化的布局上训练与测试,难以应对真实场景多样性。
论文的核心问题是:能否设计一种不依赖特权信息、能向更大车队规模零样本迁移、且通信开销恒定的分层协同架构。
二、方法论
2.1 整体框架
论文提出 MAPS(Master-Agent Proto-plan System)——一种分层深度强化学习架构,由两类模块组成:
- 集中式 Master:观测全局交通状态,输出一个 维连续潜变量 proto-plan ,编码全局协同策略。
- 分散式 Worker:每个 Worker 接收 proto-plan 与自身局部观测,输出车辆专属动作。
二者协同实现 集中训练-分散执行(CTDE),将战略意图与战术执行解耦。
2.2 问题建模(Dec-POMDP)
定义元组 ,优化目标为:
2.3 状态空间
- Master 状态(按到达方位 N/E/S/W 排序并按距离填充):
- Worker 状态(仅自身运动学 + proto-plan):
Worker 不感知其他车辆,所有协同信息必须通过 proto-plan 传输,这既保护隐私又使输入维度恒定。
2.4 动作空间与 proto-plan
- Master 输出:,经 层约束到 。
- Worker 输出:离散二值动作(加速/减速),修改目标速度 ,控制频率 。
proto-plan 的关键特征:单向、一对多、固定维度 ,与 CommNet、TarMAC 等对称 P2P 通信有本质区别。
2.5 奖励函数
Worker 奖励(带非对称量级以保证安全优先):
其中 ,,。
Master 奖励采用 maximin 聚合(关键设计选择):
论文报告,若用均值替代 ,成功率会从 100% 降至 80%。
2.6 网络结构与训练
- Master:三层 MLP(128, 256, 128),tanh 输出层。
- Worker:四层 MLP(64, 32, 16, 8),Softmax 策略头。所有 Worker 共享参数 。
- 训练算法:PPO,Adam 优化器,,学习率 ,clip 。
2.7 交替优化算法(Algorithm 1)
- 第 0 周期:Master 与 Worker 联合更新。
- 后续周期:交替冻结,奇周期冻结 Master 更新 Worker,偶周期冻结 Worker 更新 Master。
- 优点:缓解多智能体训练的非平稳性,提升梯度估计稳定性。
2.8 渐进式训练协议(用于零样本迁移)
- Phase 1:1 个学习智能体训练至收敛。
- Phase 2:增至 3 个学习智能体继续训练。
- 测试:直接部署到 5 智能体配置(输入层预设 ),不微调。
三、实验设计
3.1 仿真平台
使用开源 HighwayEnv,采用其简化运动学模型以隔离协同问题与感知噪声。
3.2 场景集
- 18 个基础场景(不同的进入方向、初始距离、转弯意图)× 4 个旋转角度 = 72 个配置。
- 场景设计原则:可解性(规则策略可通关)+ 非平凡性(简单反应式避让无效)。
- 每集 5 辆车:3 辆 MAPS 学习车 + 2 辆 20 m/s 匀速背景车(模拟非合作交通)。
3.3 训练与评估协议
- 训练 900 集,每集 ≤ 50 步,固定种子 42。
- 评估 100 集,确定性策略,统一采样 72 配置。
3.4 对比基线
| 基线 | 范式 | 是否依赖特权信息 |
|---|---|---|
| QMIXwD | 值分解 + 专家演示 | 是(10% 专家轨迹) |
| VN-MADDPG | Actor-Critic + 变噪声 + 重要性采样 | 否 |
论文明确指出未引入 MA-GA-DDPG、SafeR-ADAIM 等带博弈先验/安全层的层级方法,以保证对比公平性。
3.5 评估指标
- Success Rate (SR):无碰撞通过的比例。
- Training Collision Count (CC):训练期总碰撞数。
- Cumulative Episode Reward (R)。
- Average Travel Time (ATT):活跃车辆平均通行步数。
四、资源与算力
论文仅给出非常有限的硬件信息:
- 框架:PyTorch + Stable-Baselines3。
- 硬件:仅 CPU,无 GPU。
- 训练时长:约 20 分钟完成 900 集训练。
- 未给出 CPU 型号、内存规模、并行 worker 数等细节。
> 总体算力门槛极低,但作者也坦诚这是对问题的简化。
五、实验数量与充分性
主要实验组成:
1. 主对比实验(Table 1):3 种方法在 72 场景上的 SR、CC、ATT。
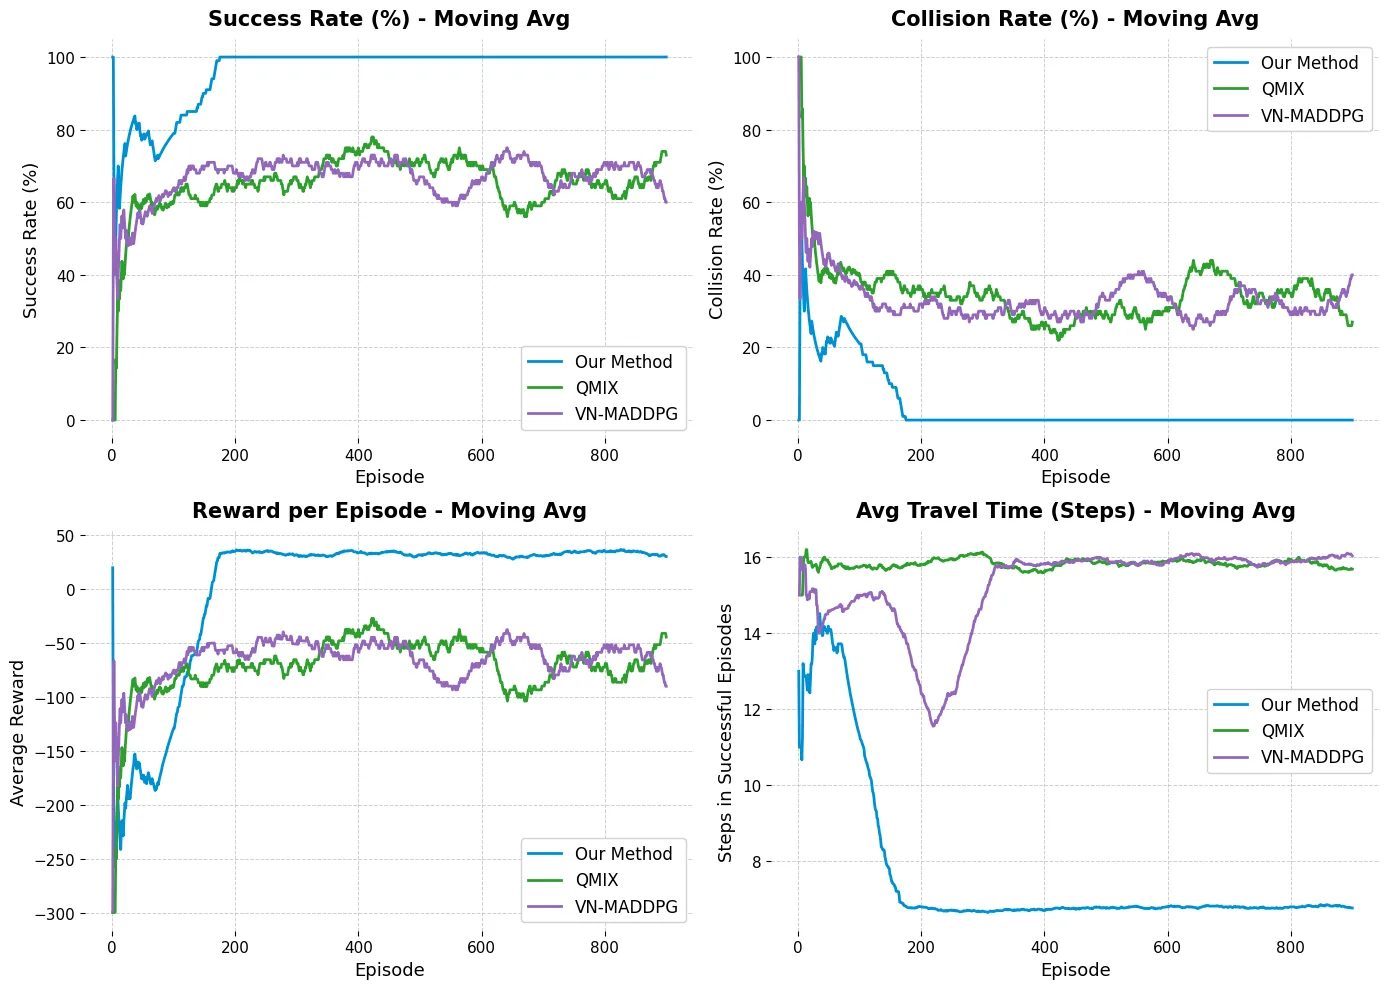
2. 训练动力学分析(Figure 3):成功率、碰撞率、奖励、通行时间随集数变化曲线(移动平均窗口 20)。
3. 消融实验 A:proto-plan 内容的重要性(trained / random / zero),400 集评估。
4. 消融实验 B:嵌入维度敏感性 。
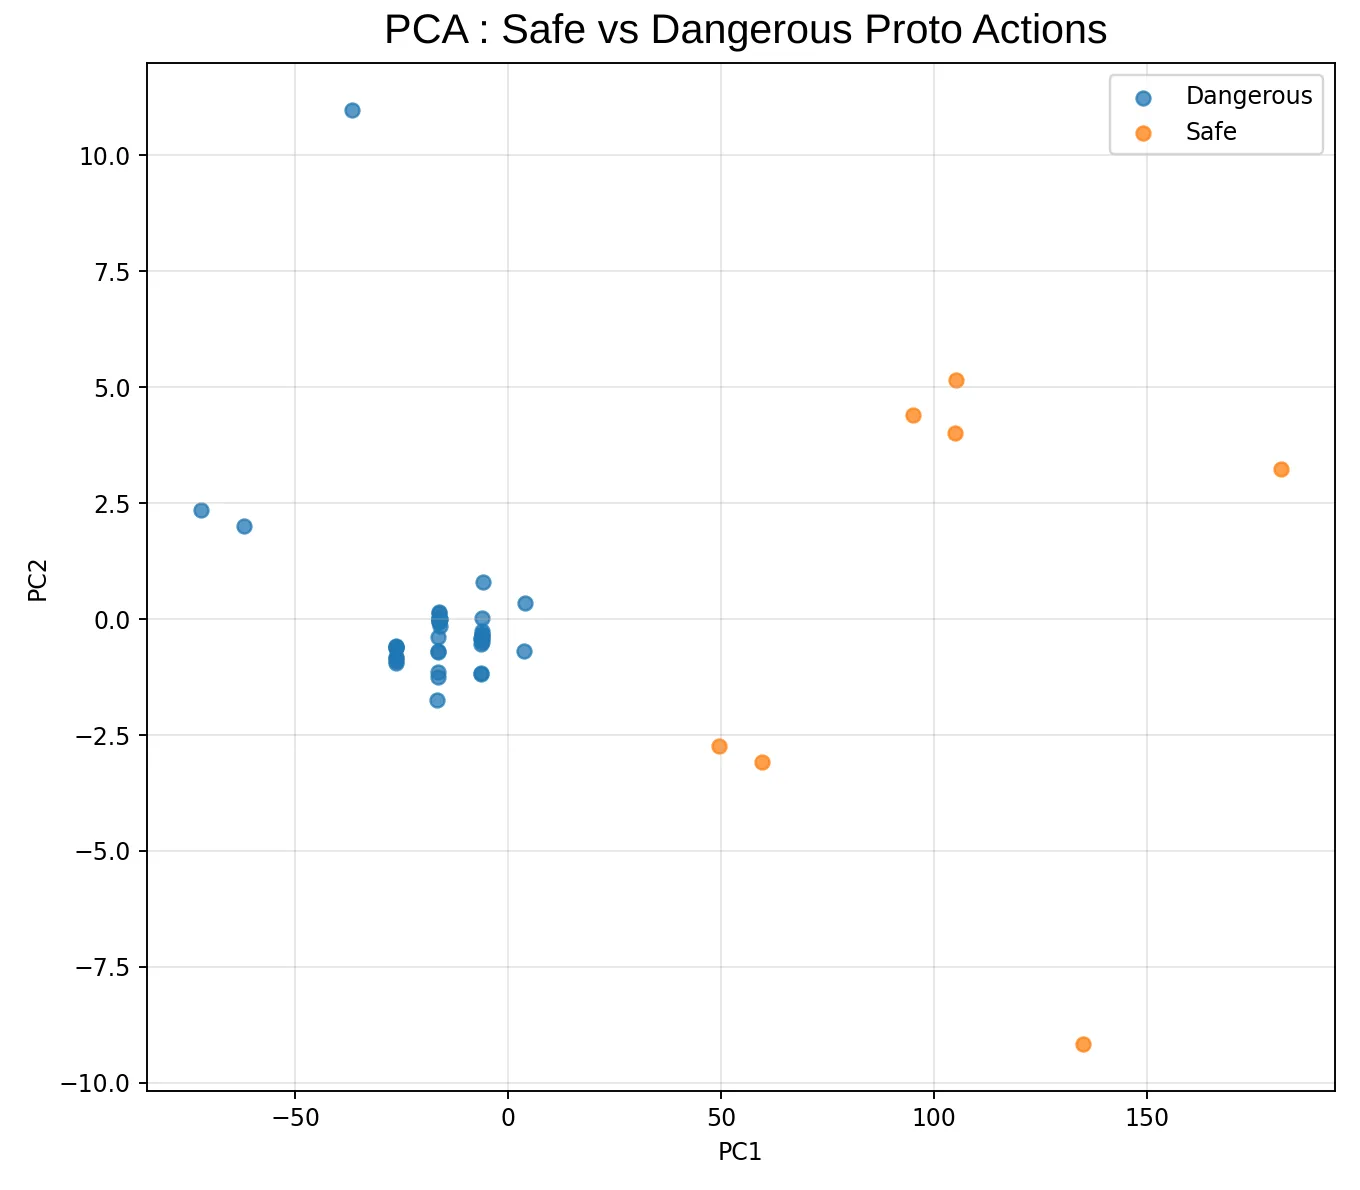
5. 嵌入可视化:PCA 投影 + 安全谓词标注(Figure 5)。
6. 值损失与奖励分布分析(Figure 7, 8):维度选择的优化稳定性证据。
7. 零样本迁移:3 智能体 → 5 智能体,100 集测试。
8. 奖励聚合消融:min vs mean 聚合对成功率的影响。
充分性评价:
- 统计检验:主对比采用双比例 z-test,,结果具有显著性。
- 维度选择实验结合了 多维度证据(SR + 损失轨迹 + 奖励分布),说服力较好。
- 场景多样性:72 配置涵盖四方位、转弯、距离变化;具备一定外推压力。
- 可能的偏差:
- 仅用 HighwayEnv 一种仿真器,缺少 SUMO/CARLA 验证。
- 基线仅 2 个,且排除层级基线,可能略嫌狭窄。
- 评估种子固定为 42,未报告多种子置信区间。
- 动作空间极简(仅纵向两动作),限制了现实意义。
总体来看,实验 在 MAPS 的设定范围内是充分且客观的,但 跨仿真器、跨动作空间、跨基线 的普适性仍显不足。
六、主要结论与发现
- 安全性:MAPS 评估期 0 碰撞(100% SR),VN-MADDPG 35 次、QMIXwD 31 次碰撞。
- 训练期碰撞:MAPS 仅 21 次,相比基线减少 84–85%。
- 效率:平均通行时间 7.8 步,相比最佳基线减少 38%。
- 收敛速度:约 180 集后接近最优,且曲线方差显著低于基线。
- proto-plan 必要性:固定 Worker 时,trained Master 奖励 56.6 > random 25.7 > zero -304.7。
- 最优嵌入维度:,SR = 80%,同时具备最佳优化稳定性。
- 零样本迁移:3 智能体训练 → 5 智能体部署,94% SR。
- 核心洞察:多车协同信息可压缩至极低维(4 维)连续信号,利于带宽受限的 V2X 场景。
七、优点与方法亮点
1. 架构创新:用连续潜变量替代离散高层指令,通信开销恒为 ,与车队规模解耦。
2. 简洁且通用:不依赖专家演示、博弈先验、安全层,仅需运动学状态。
3. maximin 奖励设计:自然防止策略牺牲单个车辆,实验证明是关键。
4. 参数共享 + 交替训练:缓解非平稳性,降低可学习参数数量。
5. 嵌入维度系统化分析:从 SR、损失、奖励分布三角度交叉验证 的最优性。
6. 零样本迁移实证:在层级 MARL 文献中较少见的泛化能力证据。
7. 场景设计严谨:明确区分"可解"与"非平凡",保证基线与方法的对比有意义。
八、不足与局限
1. 仿真器单一:仅用 HighwayEnv 简化运动学模型,缺少感知噪声、传感器延迟、车辆动力学细节,未在高保真环境(SUMO、CARLA)中验证。
2. 动作空间过于简化:Worker 只有"加速/减速"两动作,缺少横向控制、换道、停车等真实驾驶必需动作。
3. 车队规模受限:Master 输入为固定拼接向量 ,本质上仍是定长输入,无法扩展到大规模车队;作者建议采用基于注意力或集合的输入处理,但未实现。
4. 基线数量有限:仅 2 个基线,且排除所有层级方法,可能不足以全面反映 MAPS 的相对地位。
5. 未做多随机种子报告:固定种子 42 限制了结果统计可信度的展示。
6. 安全性"零碰撞"的实际意义有限:评估期仅 100 集,未给出长时间尺度下的安全保证(如 worst-case 分析、形式化验证)。
7. proto-plan 可解释性:PCA 显示安全/危险状态的聚类,但 4 维向量中每个维度的物理语义仍不清晰,缺乏对潜在维度的细粒度分析。
8. 背景交通假设过强:固定为匀速 20 m/s 的 2 辆车,难以代表真实非合作交通多样性。
9. 未来方向尚未验证:论文提到长时间跨度规划、中层 Master 分层、异构车队等扩展,但仅是设计建议,缺少实验支撑。
(完)
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。