
GRADRAG:面向协同多智能体 RAG 的跨组件提示适配
GRADRAG: Cross-Component Prompt Adaptation for Coordinated Multi-Agent RAG
📝 TLDR
多智能体RAG系统中各组件常被孤立优化,缺乏跨组件协同改进机制。本文提出GRADRAG框架,将RAG流水线建模为计算图,通过Evaluator对下游答案与证据的批评反馈,由Prompt Optimizer迭代更新检索器、图构建器与回答器等上游智能体,并支持早停。在SQUALITY与QMSUM基准的两种检索范式下,较仅优化最终生成器的一步精炼基线取得12-15个百分点净偏好优势,多数增益在两轮迭代内达成。
🧭 速览
多智能体RAG流水线中检索、生成等组件通常被孤立优化,缺乏跨组件协调改进机制。
将RAG流水线建模为计算图,Evaluator生成结构化反馈,Prompt Optimizer据此迭代更新上游智能体,并触发早停。
在SQUALITY与QMSUM两种检索范式下均优于一步精炼基线,LLM成对判断净偏好优势达12-15个百分点。
证明跨组件提示优化能有效提升多智能体RAG整体质量,且多数增益可在两轮迭代内获得。
🆚 方法对比
GRADRAG
- 跨组件提示优化,性能显著超越基线
- LLM评判下12-15个百分点净偏好优势
- 前两轮迭代即可实现大部分增益
- 仅更新提示,不修改模型参数
- 依赖评估器LLM质量,存在级联误差
- 多轮迭代推理,计算成本较高
- 早期停止阈值与反馈质量需调优
One-step refinement baseline
- 仅优化最终生成器,实现简单
- 单步更新,计算开销低
- 作为对照基准便于隔离分析
- 只更新最终组件,错误向上游传播
- 无法协调多组件联合改进
- LLM评判下显著低于GRADRAG
Flat chunk-based retrieval (IRCoT)
- IRCoT风格迭代查询改写,检索相关性强
- 混合稠密与词法检索,鲁棒性好
- 流水线结构清晰,易于集成
- 块级粒度难以捕捉实体间结构关系
- 长文档场景下检索精度受限
Graph-based retrieval
- 显式建模实体关系图,证据组织清晰
- 支持迭代图丰富,适合多跳推理
- 可结构化呈现跨段落关联证据
- 实体与关系抽取依赖LLM,质量不稳
- 图构建与维护计算成本较高
- 对图模式设计敏感
Self-reflection / self-correction
- 后置答案改写,无需修改上游组件
- 实现门槛低,易于集成到现有RAG
- 允许模型自主识别并修正错误
- 属于事后局部优化,无法根除上游错误
- 改进范围局限于最终生成阶段
GRADRAG在两种检索范式(IRCoT式平面检索与图检索)上均一致优于仅优化最终生成器的单步精炼基线,其核心优势在于将下游评估反馈跨组件传播至检索与图构建等上游代理,实现协调式提示优化,而非局限于事后答案改写。
🔬 深度抽取
深度抽取提供:指标/数据集/算力需求/局限性/可复现性评分
📊 论文图表(共 5 张)
展开查看 5 张图
TL;DR
GRADRAG 针对多智能体 RAG 系统中各组件孤立优化、缺乏协同的痛点,提出将整条流水线建模为计算图,让评估器的批评反馈反向传播到检索器、图构建器、回答生成器等上游智能体,由提示优化器迭代更新它们的提示。在 SQUALITY 和 QMSUM 基准的两种检索范式下,GRADRAG 较仅优化最终生成器的一步式基线取得 12–15 个百分点的净偏好优势,且大多数增益在两轮迭代内即可达成。
研究背景与动机
检索增强生成(RAG)系统在大模型应用中扮演着核心角色,它让模型在回答问题时能够"查阅"外部知识库,从而缓解幻觉、提升时效性。随着任务复杂度不断提升,单一的检索-生成两阶段流水线已难以满足需求,越来越多的系统开始引入多个专用的 LLM 智能体——检索器负责从海量文本中定位相关片段,图构建器从文档中抽取实体与关系形成结构化知识,回答生成器综合检索到的证据生成最终答案。这种多智能体协作的架构理论上能更好地处理复杂推理与多跳问答。
然而,一个根本性的问题在于:这些组件通常被独立优化。以往的工作要么专注于改进检索策略,要么单独调优生成模型或提示词,但忽略了一个关键事实——RAG 流水线是一个有机整体。当检索器的输出发生变化时,它会直接影响图构建器的输入质量,进而影响最终答案的满意度。反过来,如果仅优化最终生成器而不动上游组件,系统可能只是学会了"弥补"检索质量问题,而不是真正解决它。这种"头痛医头"的局部优化策略,导致整条流水线的天花板被人为压低。
GRADRAG 的核心动机正是打破这一困局:如何在不引入额外训练或微调的前提下,让多个组件在一条流水线中协同进化、互相适应?作者选择了一条优雅的路径——将 RAG 流水线建模为计算图,并在图上传播结构化的评估反馈。
方法
GRADRAG 的设计围绕一个核心洞察:RAG 流水线本质上是一个从检索到回答的有向计算图,其中每个节点是一个智能体组件,每条边代表信息流向。将这个图结构显式建模出来之后,优化器就可以从下游向上游"回溯",分析每一环节对最终答案质量的影响。
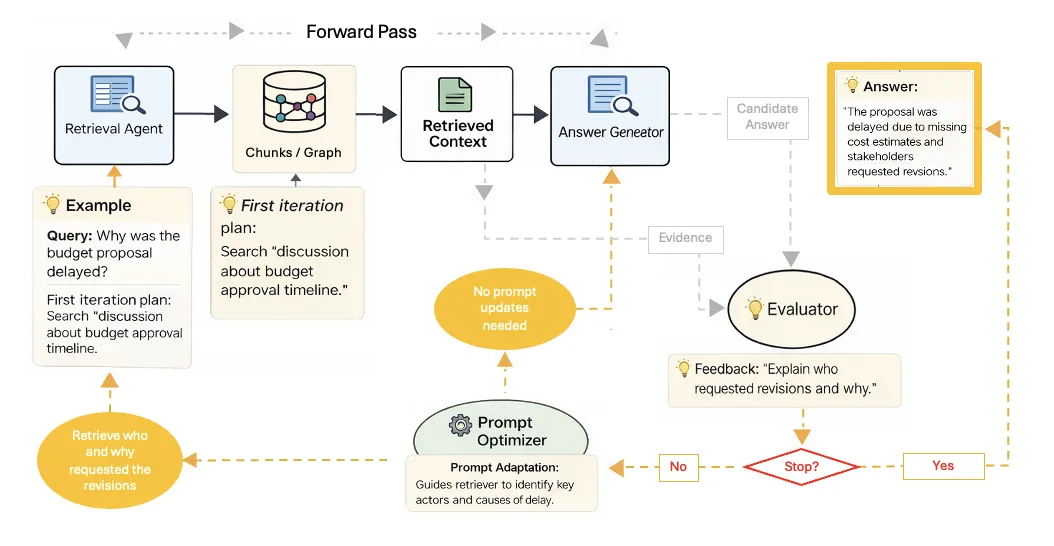
整个框架由三个核心角色构成。Evaluator(评估器) 扮演质量把关的角色,它不仅评判最终答案的正确性与完整性,还会对支撑该答案的证据进行批评——也就是说,它会指出哪些检索到的片段真正有助于回答,哪些是无关干扰,哪些证据虽然相关但表述模糊不足以支撑结论。这种"答案-证据"双层批评机制使得反馈信息量远大于简单的评分。Prompt Optimizer(提示优化器) 接收评估器的结构化反馈,将其翻译为对上游智能体提示词的具体修改建议。这里 GRADRAG 并不直接修改模型权重,而是通过迭代改写提示词来实现组件升级——这也是为什么它能适用于任意基座模型,无需额外的训练成本。Adaptive Agents(自适应智能体) 包括检索器、图构建器和回答生成器,它们根据优化后的提示词调整自身行为,构成一轮迭代更新的完整闭环。
整个迭代过程可以理解为一个"批评-反馈-改进"的循环:系统在初始提示下运行流水线,Evaluator 对输出进行双层评估并生成结构化批评,Prompt Optimizer 解读这些批评并生成改进后的提示词,上游各组件使用新提示重新执行,最终再次进入评估。这个循环一直持续到 Evaluator 判定输出质量令人满意,此时触发早停机制,节省不必要的计算开销。
一个值得注意的设计细节是 GRADRAG 对两种不同检索范式的兼容性。在基于平面分块的检索场景下,系统使用 IRCoT 风格的查询改写——在每轮迭代中,检索器会基于上一轮的回答质量动态调整搜索查询,使之更精准地定位相关文本。在基于图的检索场景下,图构建器从原始文档中抽取实体和关系构建实体-关系图,并在迭代过程中持续丰富图的节点与边,使检索在结构化空间中展开。这两种范式分别代表了 RAG 系统中最常见的两种技术路线,GRADRAG 的框架对二者均能无缝适配。
实验与结果
作者在两个公开基准上验证了 GRADRAG 的效果:SQUALITY 是一个面向摘要质量评估的数据集,QMSUM 则是一个多会议摘要数据集,二者均要求系统从大量文本中检索相关信息并生成高质量摘要。针对每个基准,实验分别测试了平面分块检索与图结构检索两种范式。
对比基线方面,最核心的参照是"一步式改写"(one-step refinement)——即仅更新最终回答生成器的提示词,保持检索器等其他组件不变。这种基线代表了当前大多数 RAG 优化工作的实际做法:将所有改进努力集中在流水线末端。
实验结果呈现出清晰且一致的模式。在两种检索范式和两个基准的全部四个测试组合中,GRADRAG 均显著优于一步式改写基线。具体而言,在 LLM-as-a-Judge 的两两对比评判中,GRADRAG 取得了 12–15 个百分点的净偏好优势——这意味着在随机抽取的 100 对比较中,有 50 多对明确偏好 GRADRAG 的输出,幅度相当可观。
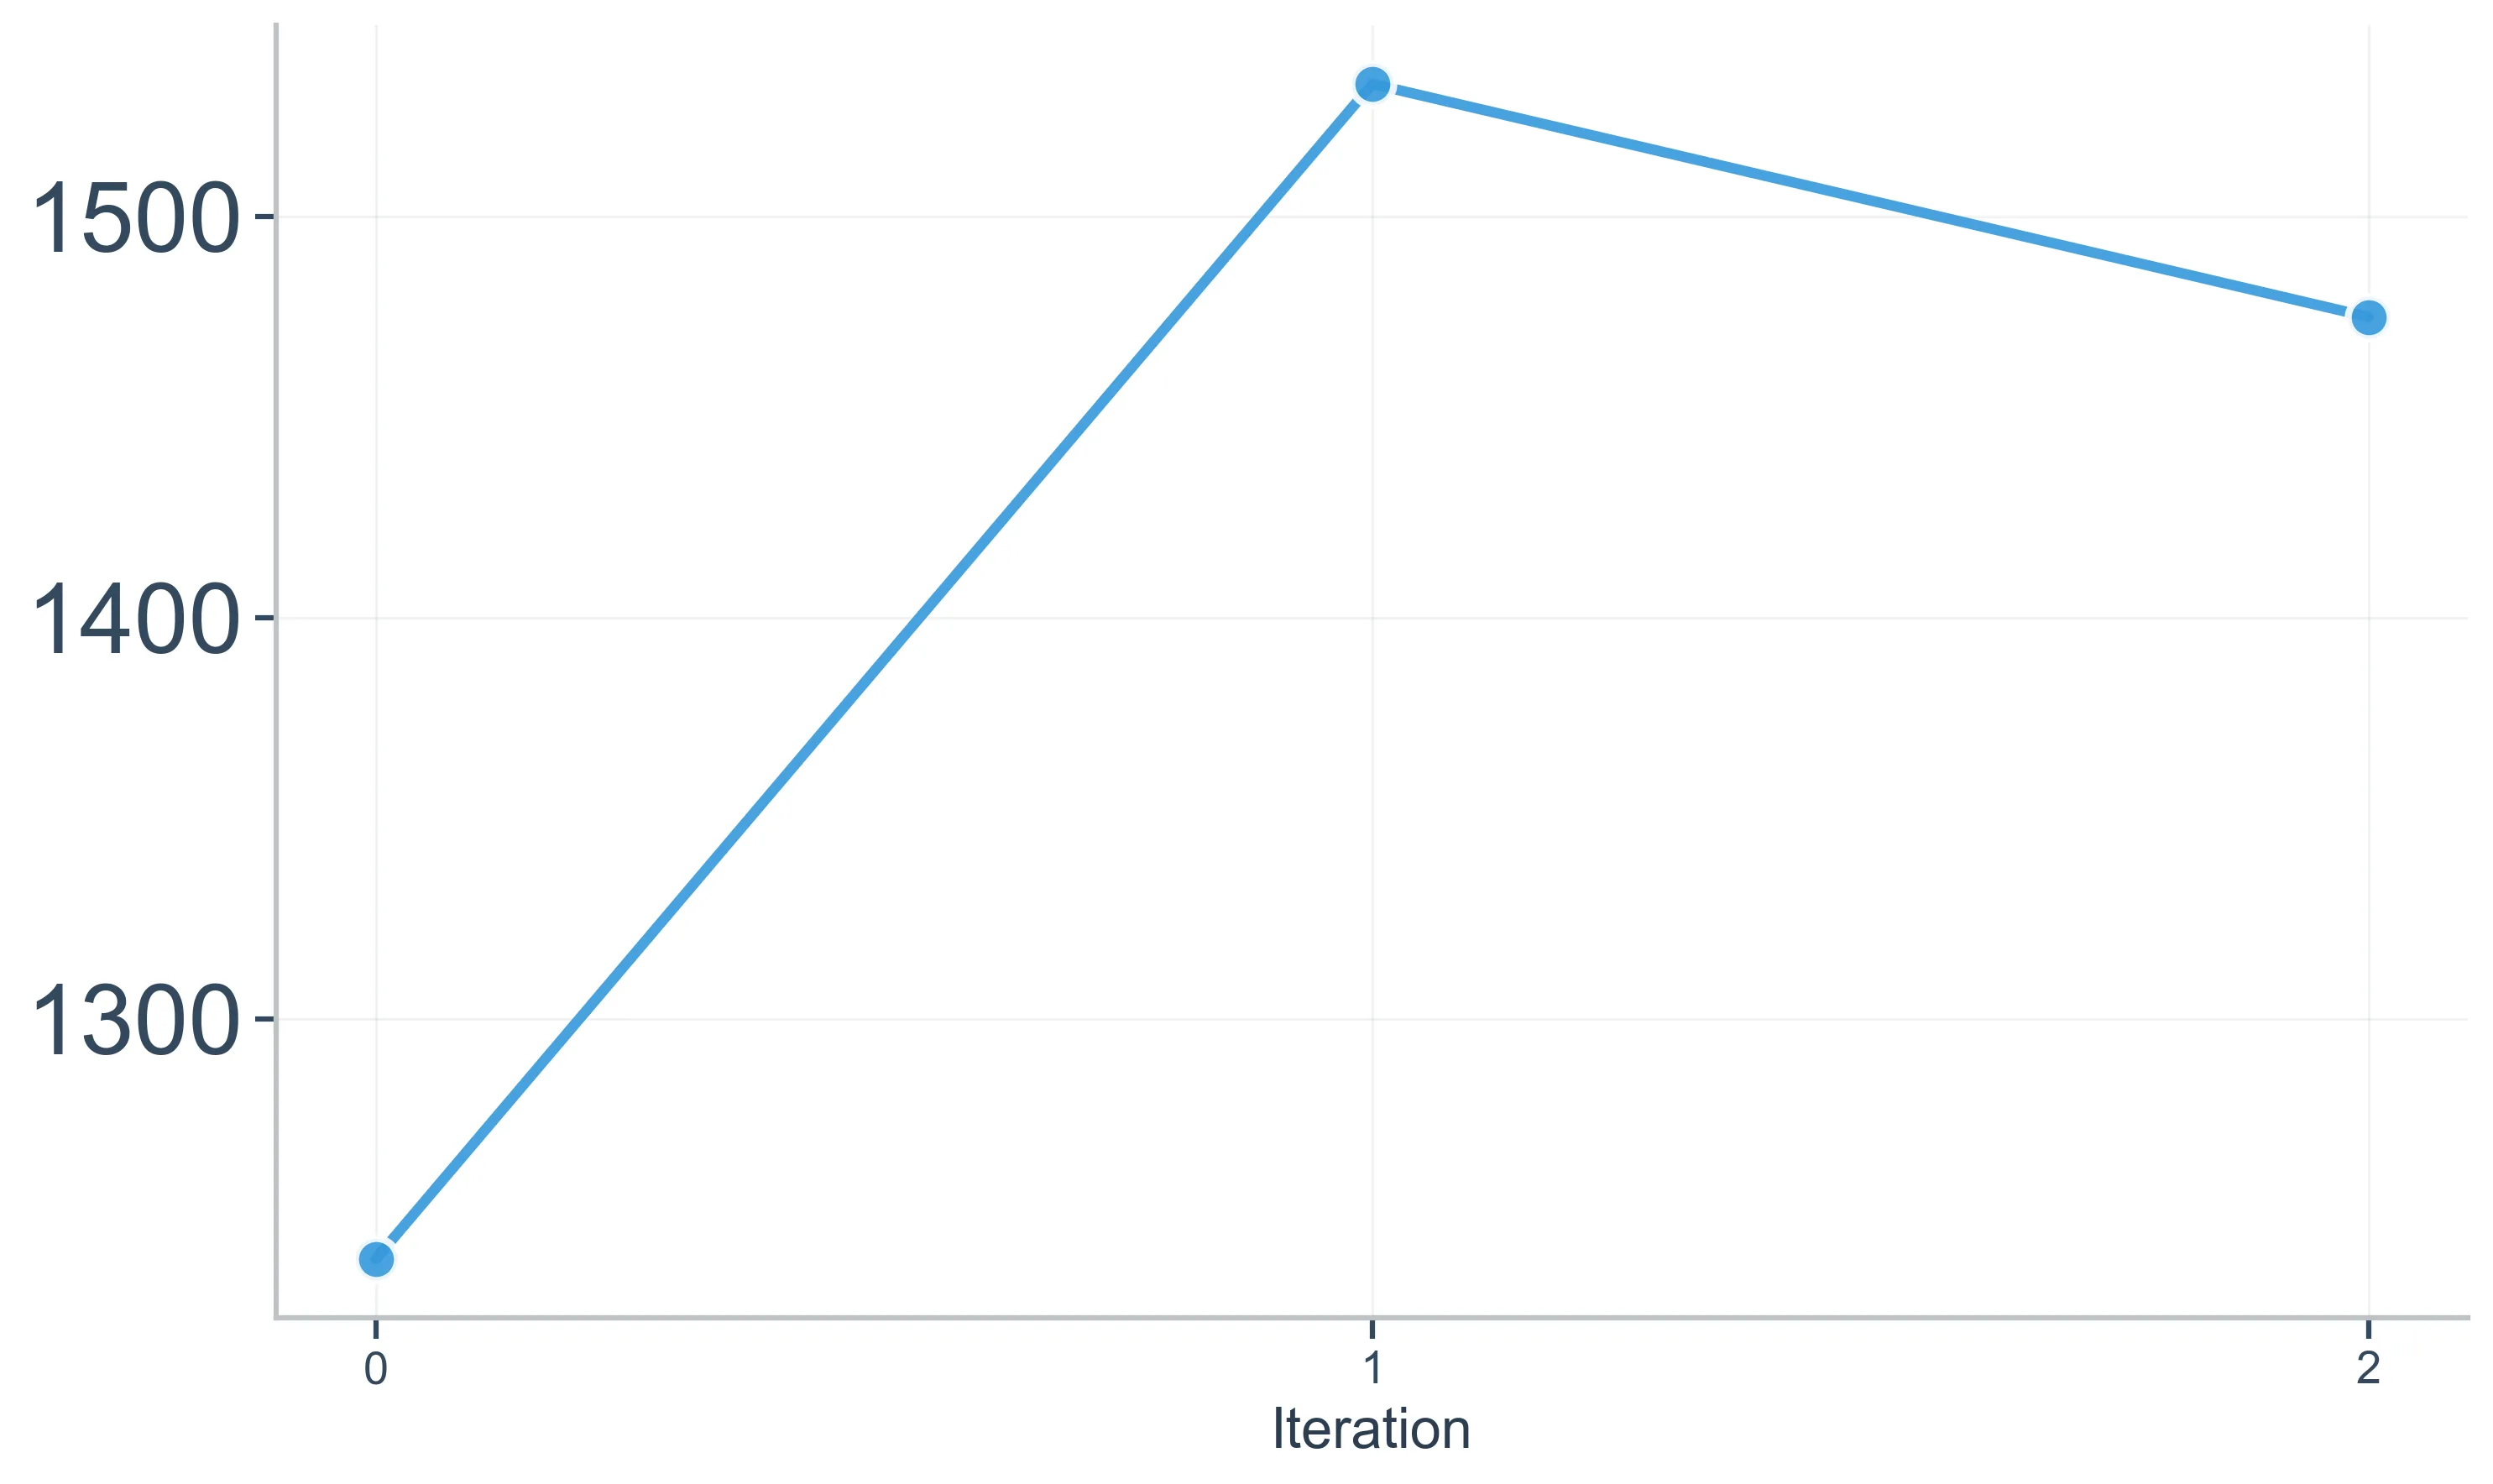
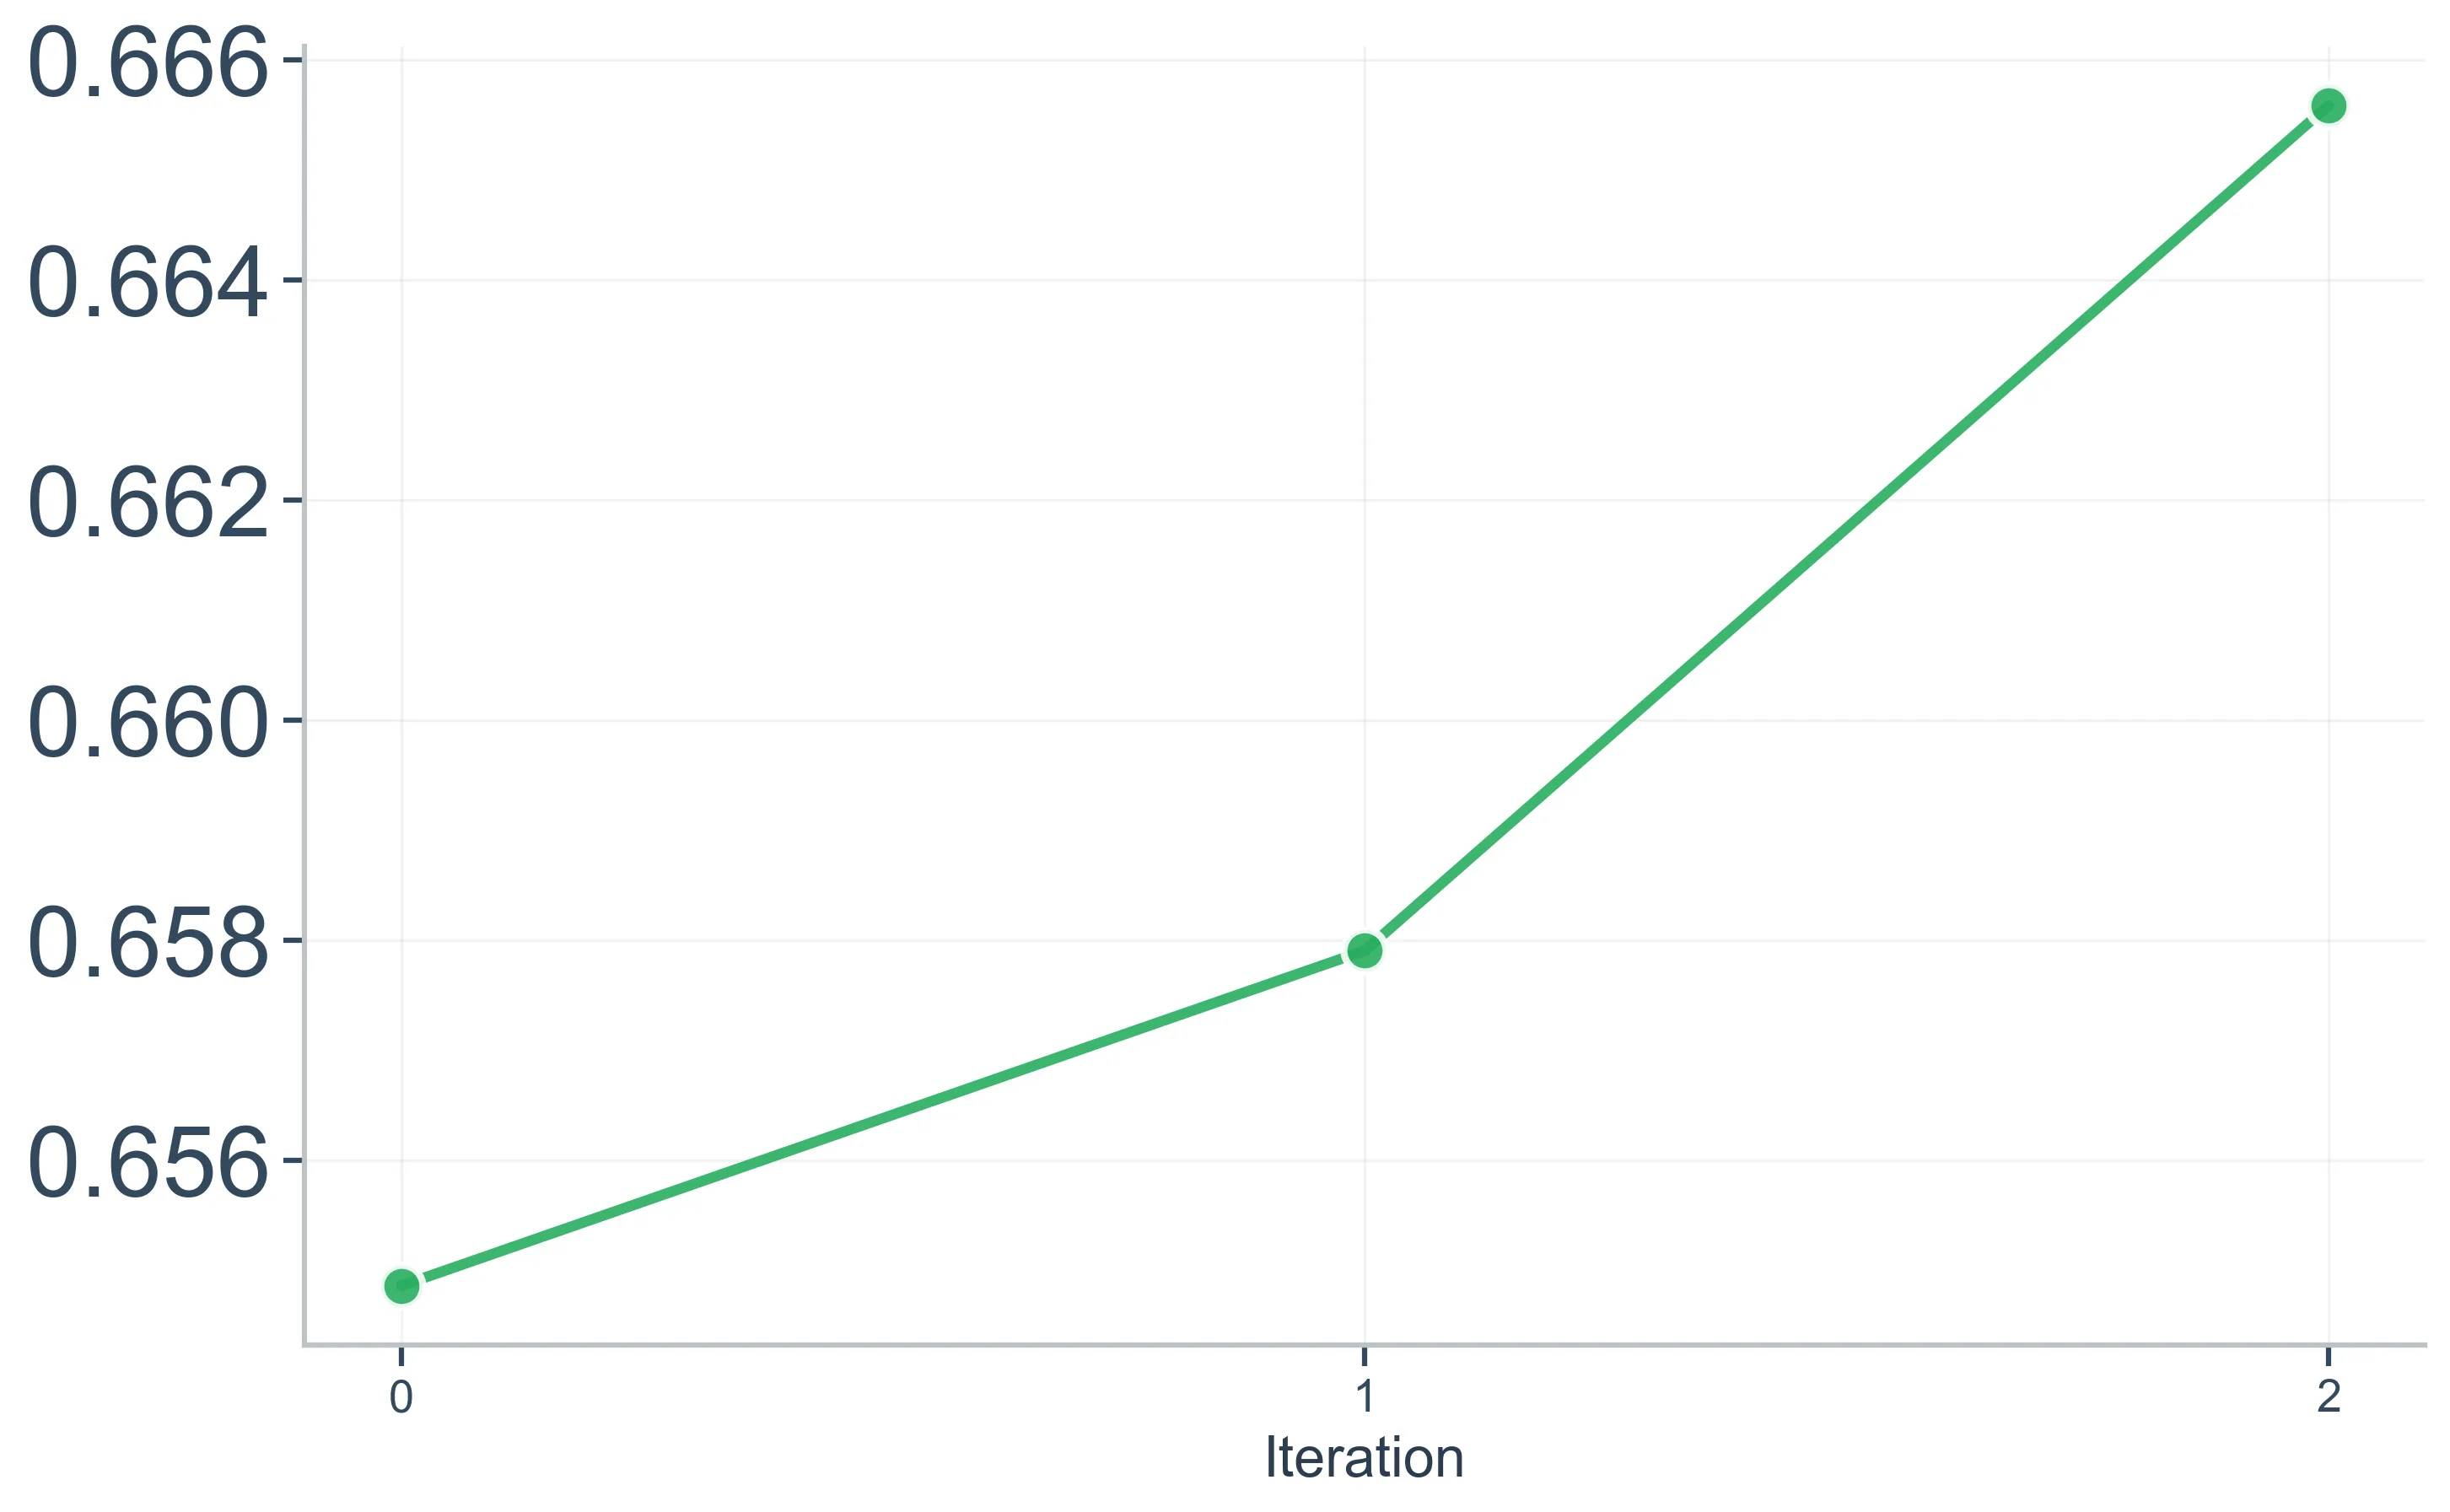
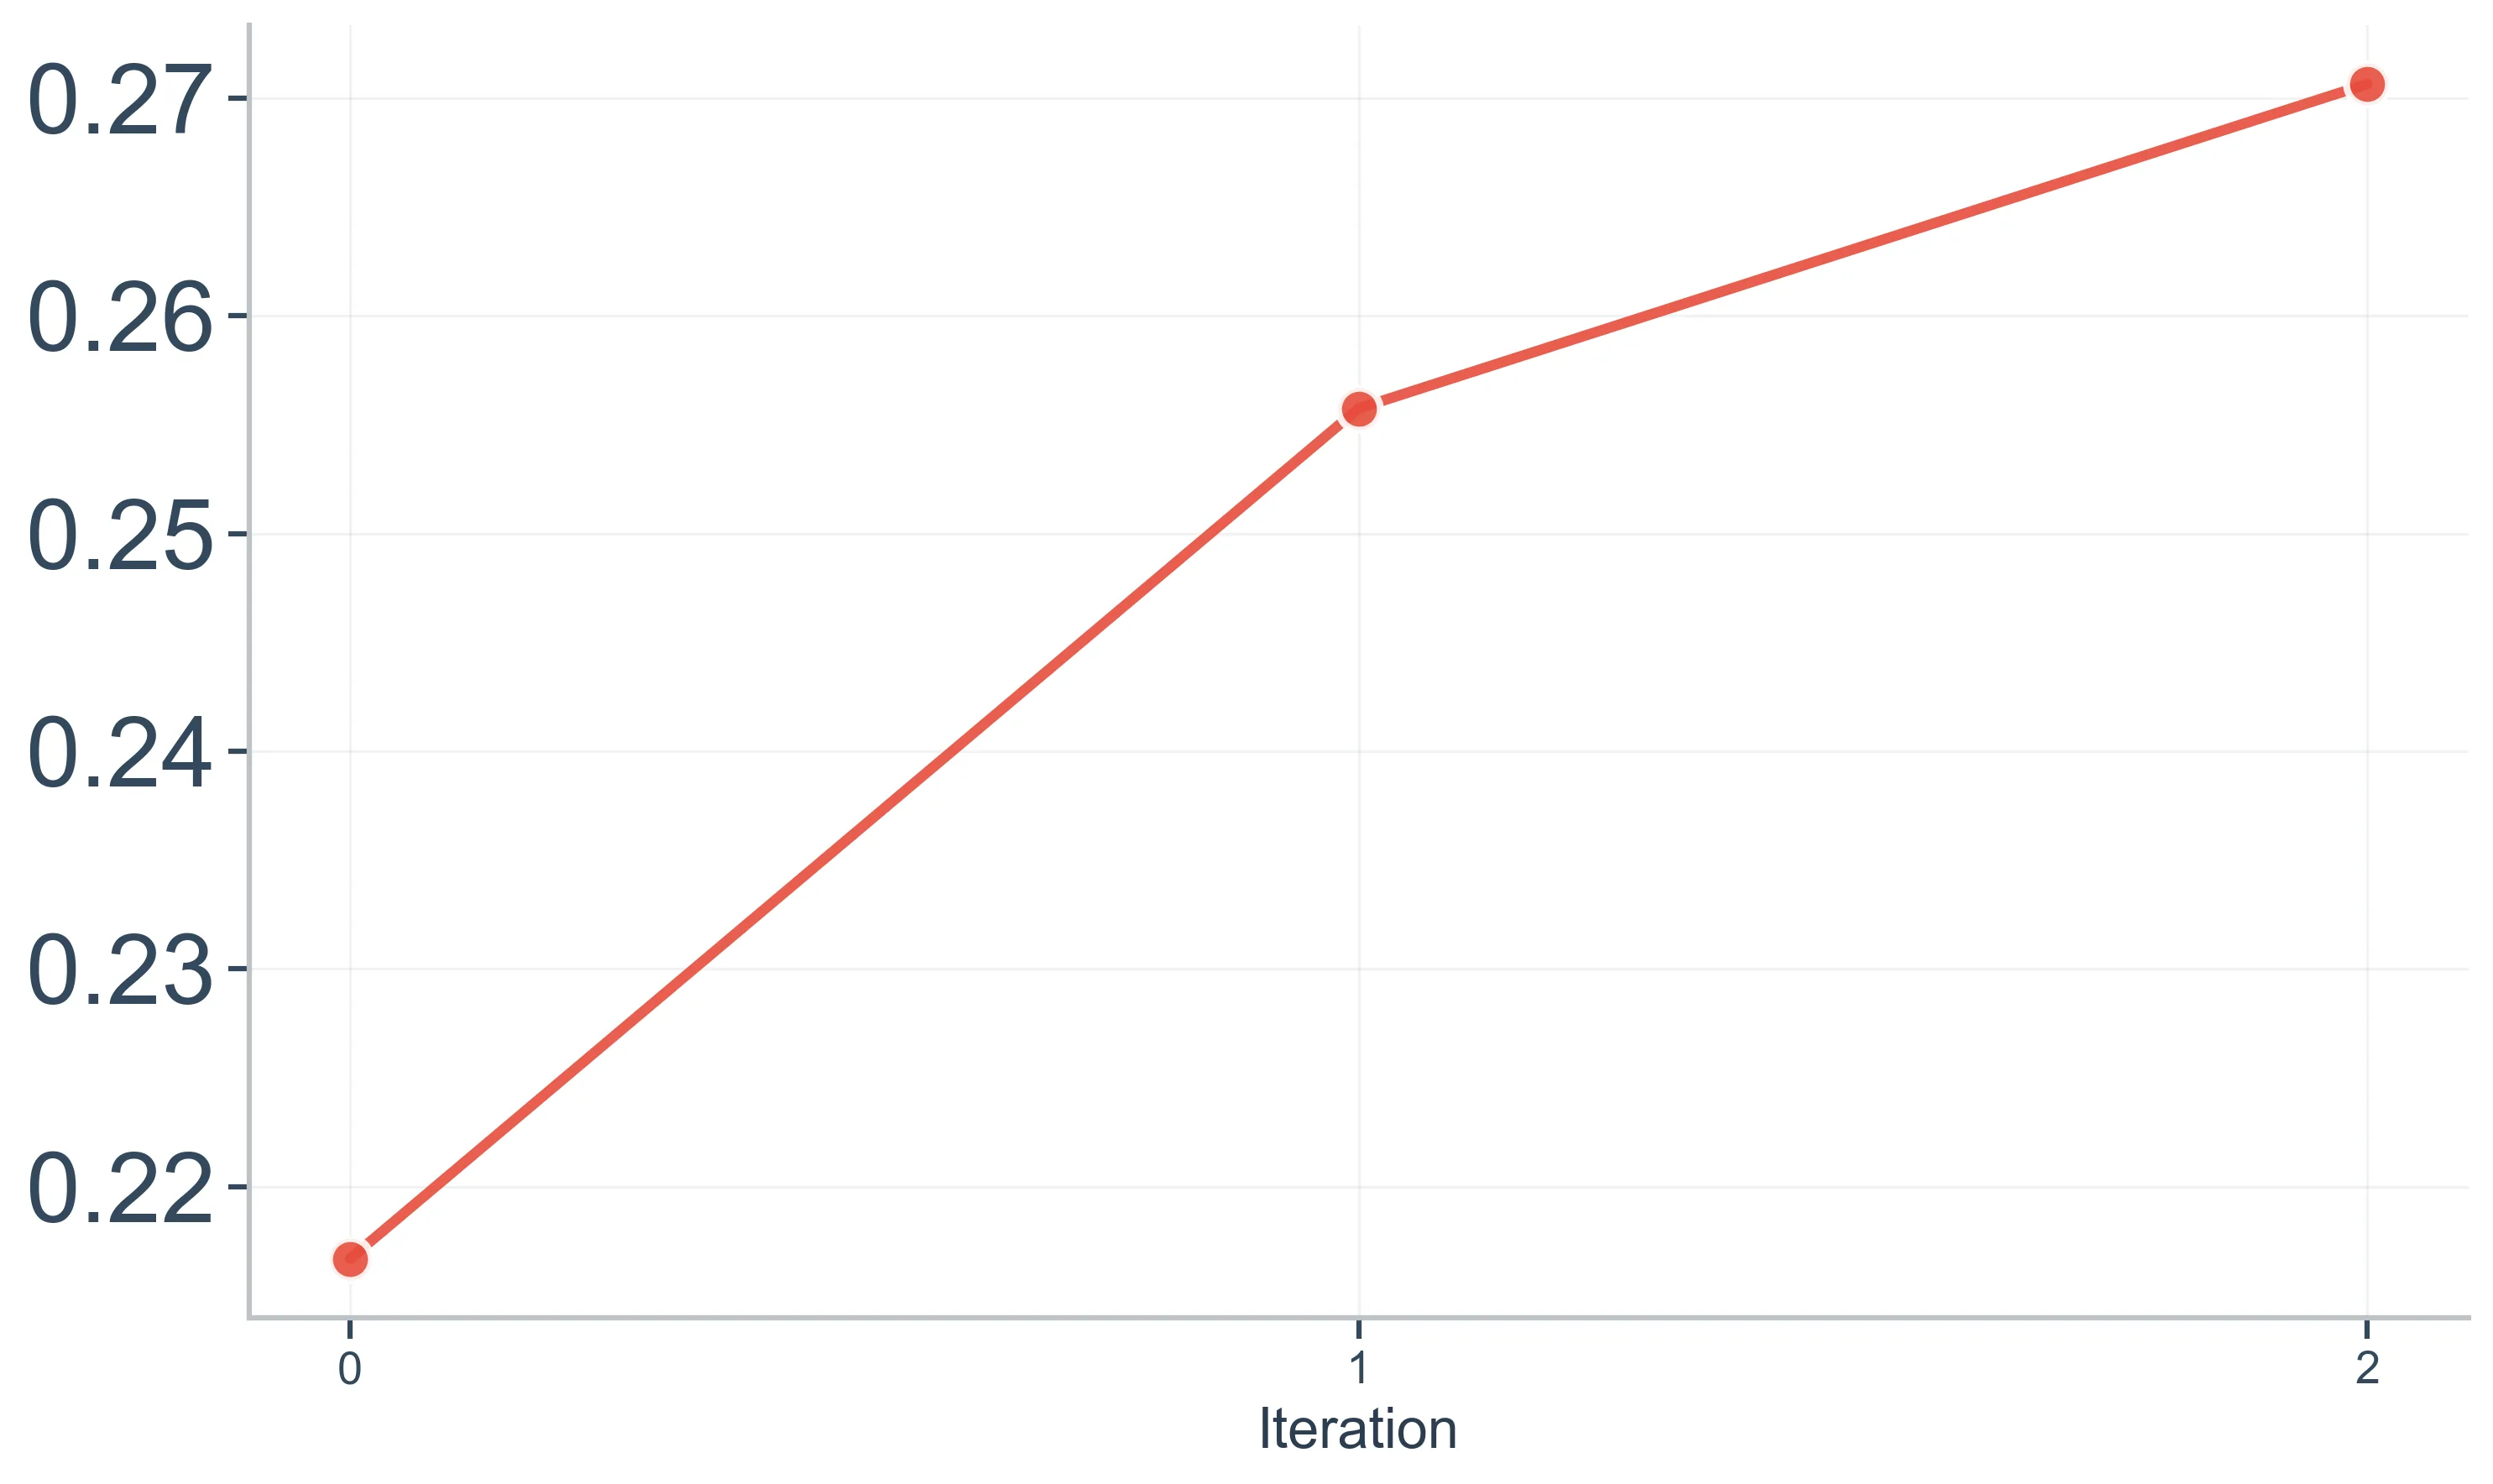
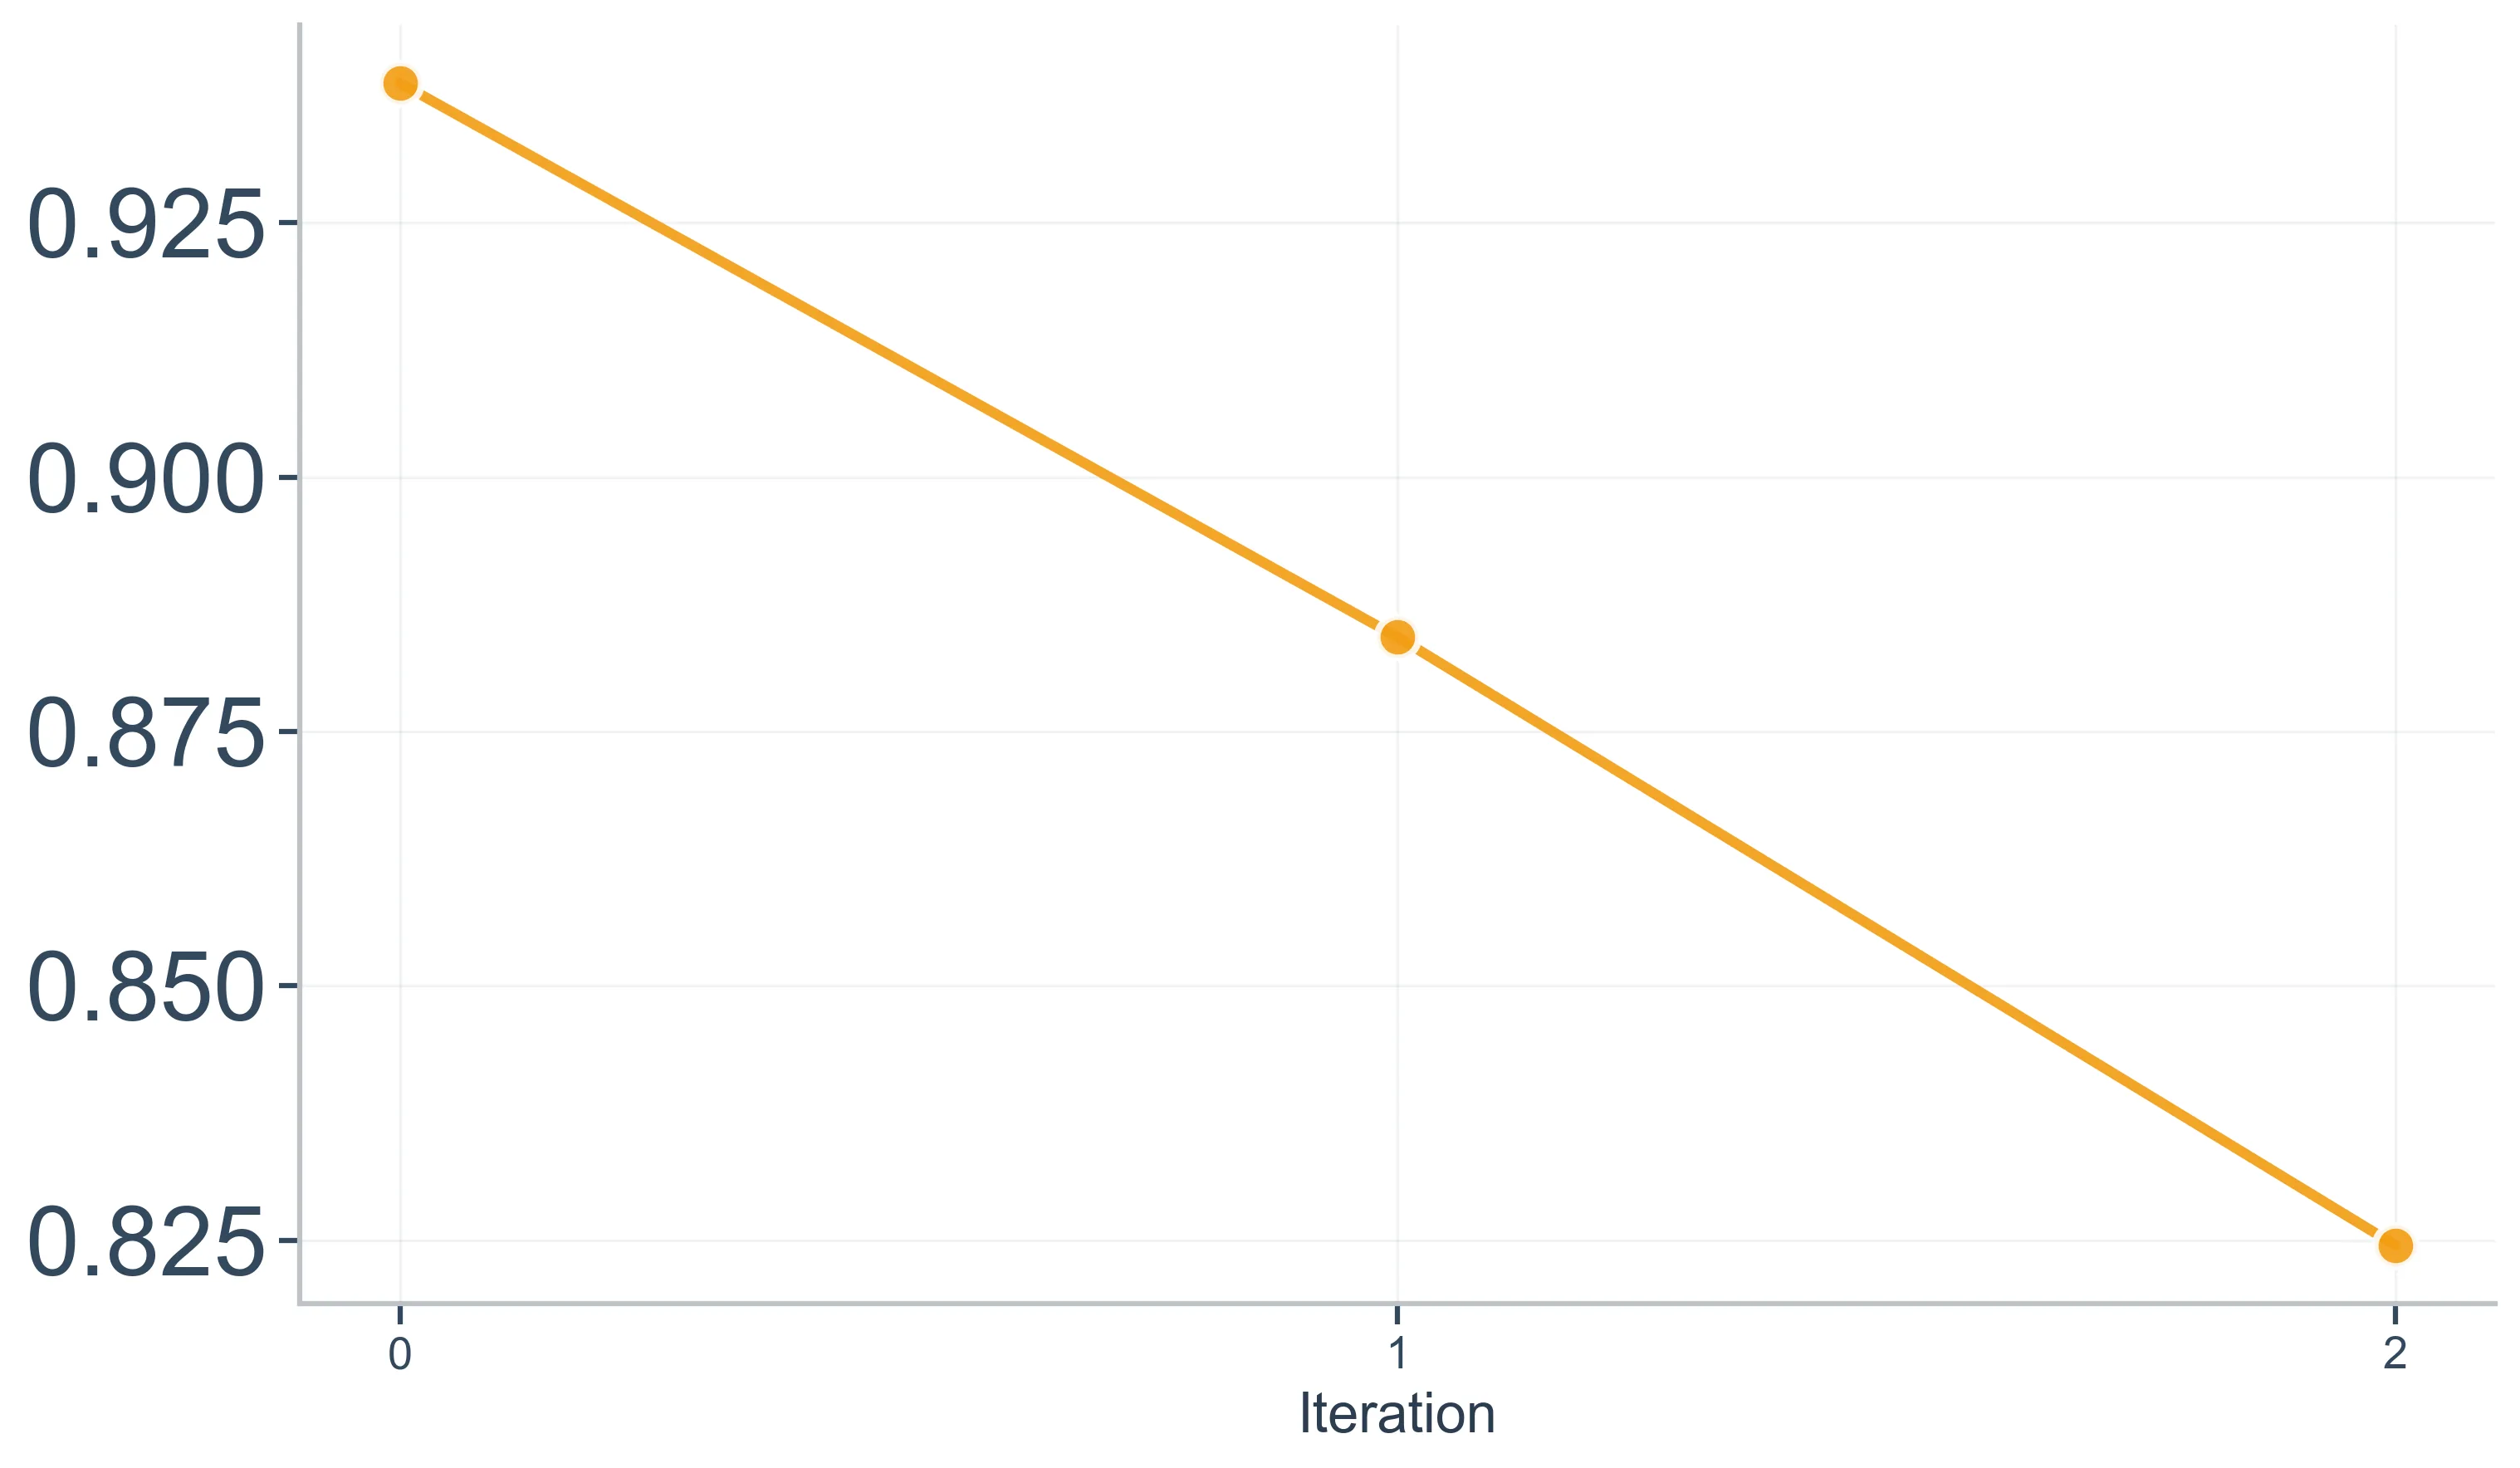
更值得关注的是效率层面的发现:大多数性能增益在两轮迭代内即可实现,此后边际收益快速递减。这说明 GRADRAG 的协同优化机制具有很高的样本效率——它不需要大量的迭代循环来逐步逼近最优解,而是通过一次跨组件反馈就能捕捉到问题的关键所在。两轮早停的设计因此在效果与效率之间取得了良好的平衡。
讨论与可借鉴点
GRADRAG 最引人注目的是其方法论上的启示:将 RAG 流水线显式建模为计算图,然后在图上反向传播结构化评估反馈——这个思想本身并不复杂,但恰恰戳中了当前多智能体 RAG 系统设计中的一个盲区。许多研究者在提升单个组件性能时,可能忽略了一个基本事实:在流水线上游犯的错误,往往需要在上游修复,而不是靠下游"弥补"。GRADRAG 用实验数据有力地论证了这一点。
该框架也有几个值得思考的局限。首先,它依赖于一个能力足够强的 Evaluator 来生成有效的结构化批评——如果评估器的判断本身就存在偏差,反馈链条会将这个偏差放大并传递给所有上游组件。其次,迭代式反馈虽然效率较高,但在某些对延迟敏感的场景下,每轮迭代的计算成本仍然不可忽视,早停机制在一定程度上缓解了但未能根除这一问题。第三,实验目前只在摘要类任务上验证了效果,对于需要精确事实匹配的多跳问答等任务,跨组件协同优化的收益尚待进一步探索。
从更宽广的视角看,GRADRAG 代表了一种有前景的方向:在不引入模型训练的前提下,通过巧妙的反馈回路设计让已有模型"学会"更好地协作。随着 LLM 应用逐渐从单点能力走向系统级编排,如何让多个组件像一个团队一样高效配合,将成为一个越来越重要的课题。GRADRAG 在这一方向上迈出了扎实的一步。
摘要
检索增强生成(RAG)系统日益采用多个大语言模型智能体。然而,已有的大多数工作仅孤立地优化各组件,而非在整条流水线间协调改进。我们提出了 GRADRAG,一个跨组件提示适配框架,它将 RAG 流水线建模为计算图,并传播结构化的评估反馈以更新上游智能体。评估器对下游答案及其支撑证据进行批评,生成可操作的反馈,提示优化器据此迭代更新检索器、图构造器和回答生成器等自适应智能体。当评估器判定输出令人满意时,还会触发提前停止机制。我们在 SQUALITY 和 QMSUM 基准上,针对两种检索范式对 GRADRAG 进行了评估:基于平面分块的检索(采用 IRCoT 风格的查询改写,Trivedi 等人,2023)以及基于图的检索(从文档构建并迭代丰富实体-关系图)。在两种设置下,GRADRAG 均持续优于仅更新最终生成器的一步式改写基线,在由大语言模型评判的两两对比中获得了 12 至 15 个百分点的净偏好优势,且大部分增益在两轮改写迭代内即可实现。
Abstract
Retrieval-Augmented Generation (RAG) systems increasingly employ multiple LLM agents. Yet, most prior work optimizes components in isolation rather than coordinating improvements across the pipeline. We introduce GRADRAG, a framework for cross-component prompt adaptation that models the RAG pipeline as a computational graph and propagates structured evaluation feedback to update upstream agents. An Evaluator critiques downstream answers and supporting evidence, producing actionable feedback that a Prompt Optimizer uses to iteratively update adaptive agents, such as retrievers, graph constructors, and answerers. The Evaluator also triggers early stopping when the output is deemed satisfactory. We evaluate GRADRAG on the SQUALITY and QMSUM benchmarks under two retrieval paradigms: flat chunk-based retrieval using IRCoT-style query refinement (Trivedi et al., 2023), and graph-based retrieval that constructs and iteratively enriches an entity-relation graph from the document. Across both settings, GRADRAG consistently outperforms one-step refinement baselines that update only the final generator, achieving a 12-15 percentage point net preference margin in LLM-judged pairwise comparisons, with most gains realized within two refinement iterations.
✨ 编译论文
点「✨ 编译」开始,LLM 会按 Polaris 风格翻译并把图片/表格嵌到对应位置。结果存到浏览器 localStorage,下次访问自动加载。